

サポート人員予測は、ループする5つのステップです。30分間隔でボリュームを予測し、平均対応時間(AHT)を掛け、ライブチャネルにアーランCを適用し、シュリンケージを加え、最後に予測を実績と照合します。どれか1つでも飛ばすと、日次平均で人員を組んだチームが月曜の10時にあふれる、という定番の失敗になります。
数字の振れ幅は、多くのチームが思うより大きいものです。30分あたり60チャット、対応時間6分の場合、60秒以内に80%を応答するにはアーランCが求めるキュー上の人数は15人で、シュリンケージ30%を加えるとシフトには22人が必要になります。メールとチケットは待てるので別です。アーランCではなく、SLAの時間枠に合わせて配置してください。
私が確認したヘルプデスクのうち、本格的な予測機能を備えているのはZendesk(WFMアドオン)だけです。Gorgias、Help Scout、HubSpotはヒートマップとエクスポートを提供するだけで、予測は別の場所で作ります。そしてAIエージェントは、多くの計画が見落とす形で計算を変えます。簡単なチケットを引き受けるため、ボリュームは減りますが、残りの対応時間は長くなります。eesel は2023年から、実際のキューでAIヘルプデスクチームメイトを運用しています。最もわかりやすい例はNorden-Frisiaです。ドイツのフェリー会社で、繁忙期は月10,000件のやり取りを見込み、夏のために採用するのではなく、10月から3月にかけて規模を戻しています。
サポートチームはなぜ毎回人手不足に陥るのですか?
私はRiellで、eeselのサポートキューを毎日担当しています。この記事の元になる質問は、たいてい「先四半期に2人採用したのに、なぜ毎週月曜は手が回らないのか」という形で届きます。答えが人数だけであることはほとんどありません。人数を日次や週次の平均で計画しているのに、顧客は平均どおりには来ないからです。
1日400件のチケットが届くチームは、8時間にわたって1時間50件ずつ受け取るわけではありません。9時から10時に90件、昼食後に20件、そして帰宅した人が注文を確認する18時に急増することもあります。1時間50件で配置すると、1日の半分は人が余り、残りの半分は埋もれます。この差を埋めようとするのがカバレッジ計画で、予測はその土台の計算です。
コンタクトセンターは何十年も前に、ワークフォースマネジメント(WFM)でこれを解決しました。用語(アーランC、シュリンケージ、占有率、サービスレベル)は少し取っつきにくいですが、どれも素朴な問いに答えるもので、手法全体をスプレッドシートで回せます。新しいのは、今のサポートチームの多くが電話システムではなくヘルプデスク上で動き、ボリュームの一部がまずAIエージェントに向かうことです。どちらも、従来の手法の使い方を変えます。
サポート人員予測はどう機能しますか?
Zendesk WFMからAssembledまで、私が見たWFMツールはすべて同じ流れで動きます。ボリュームをどのアルゴリズムで予測するか、どこまで調整できるかはベンダーで違いますが、骨格は変わりません。
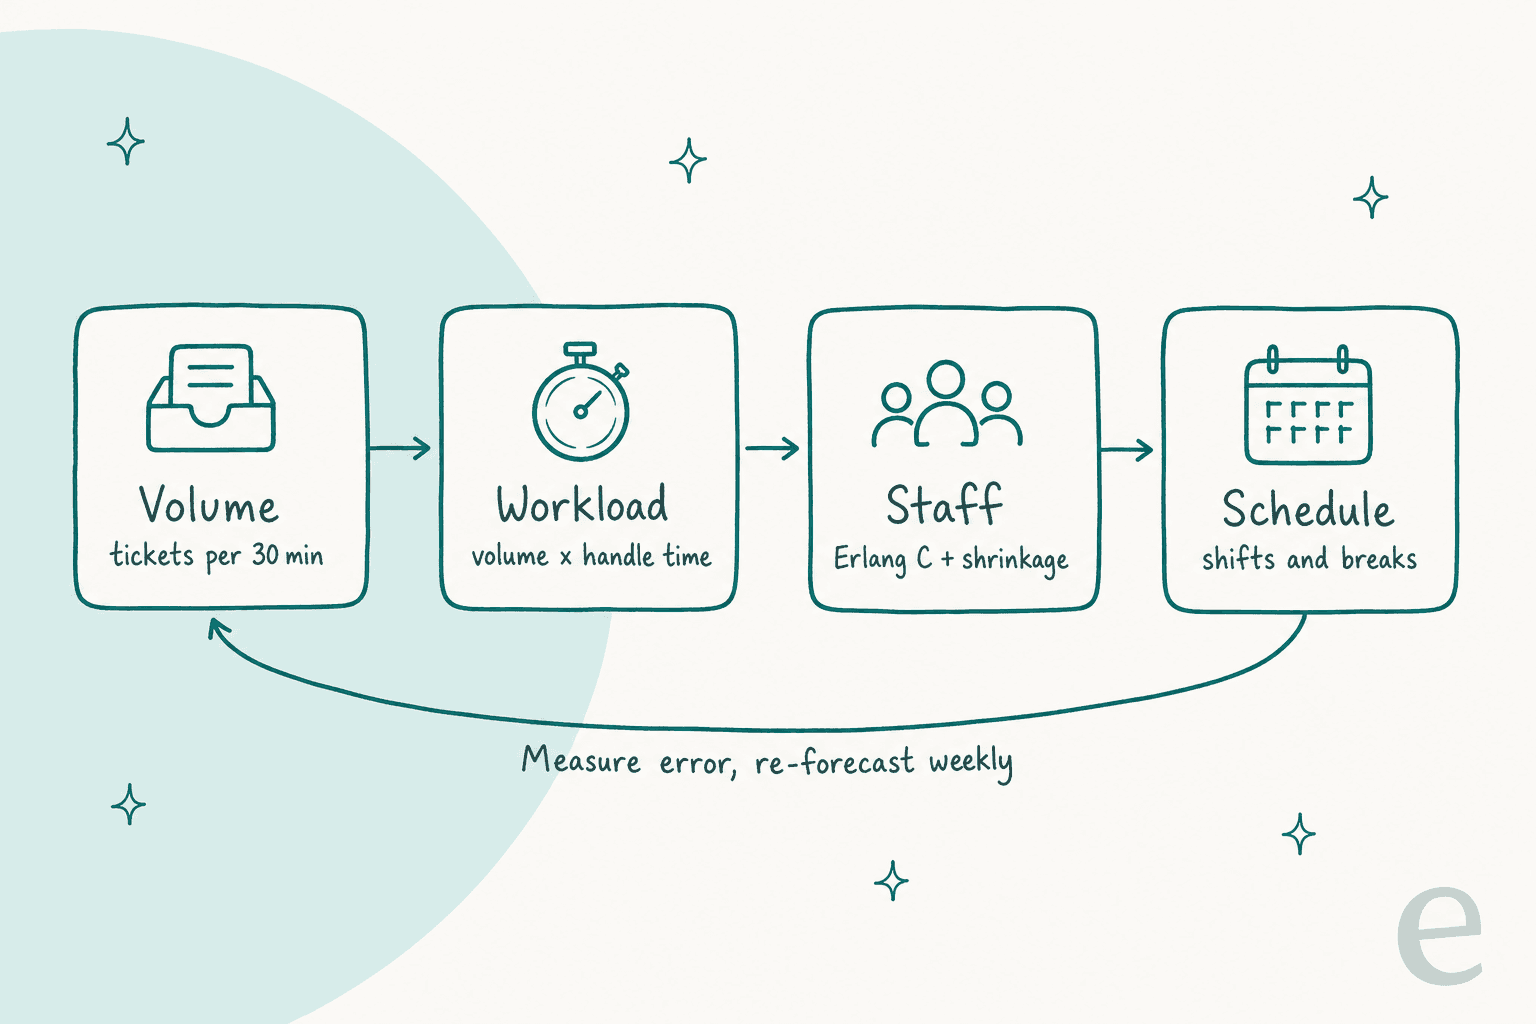
- **ボリューム:**チャネルごとに、15分または30分の各間隔に何件の連絡が届くか。
- **作業量:**ボリュームに平均対応時間を掛け、各間隔に必要なエージェントの分数を出します。
- **人員配置:**サービスレベルを達成するのに必要なエージェント数。ライブチャネルにはアーランCを使い、そのうえでシュリンケージ分を上乗せします。
- **スケジュール:**必要人員に重ねるシフトと休憩。カバレッジが需要の曲線に沿うようにします。
- **測定:**間隔ごとに予測と実績を比べ、入力を直し、毎週繰り返します。
この記事の残りでは各ステップを順に見たうえで、ヘルプデスクが何をしてくれるか、ピークをどう計画するか、AIエージェントがキューに入ると何が変わるかを見ていきます。
時間帯別のチケットボリュームはどう予測しますか?
まず履歴から始めます。チャネルごとの連絡を、日付と15分または30分の間隔でまとめ、自分のタイムゾーンで用意します。Zendesk WFMは1か月未満のデータでは予測を出さず、既定で6か月分を取り込みます(Zendesk docs)。スプレッドシートでも、これは妥当な下限です。
定番の手法はN週平均です。次の火曜10:00〜10:30なら、直近N回の火曜10:00〜10:30の平均を取ります。Assembledのドキュメントはこれを推奨の既定値とし、「generally very accurate for short term forecasting (~1 to 4 weeks)」としたうえで8週間を勧めています(Assembled forecast models)。Zendesk WFMの最も単純なアルゴリズムも同じ考え方で、同じ15分の枠を過去8週間で平均します(Zendesk algorithms)。
N週平均には盲点があり、トレンドや季節が見えません。ボリュームが月5%伸びるなら、8週平均は常に後追いになります。そこで高度なモデルの出番です。Assembledには、モメンタム型、12か月の成長ラインに年の週、曜日、15分のパターンを掛ける季節モデル、MetaのProphetライブラリがあります。ZendeskはXGBoost、LightGBM、LSTMニューラルネットワークを加え、ワークストリームごとに最良のものを自動で選びます。どちらのベンダーも、季節モデルや機械学習モデルが力を発揮するには1年以上の履歴を求めます。
優れたアルゴリズムよりも予測を改善する要素が3つあります。
- **入力をきれいにする。**Zendesk WFMはスパムもボリュームに数え、チケットが新しいワークストリームに入るたびに再度数えます(Zendesk best practices)。HubSpotを使うフランスのオンライン学習プラットフォームMentorShowは、時期によって月
5,000〜13,000件のチケットが届き、「a large share is not a question at all」だと eesel に話しました。PayPalの通知、自動返信、アンケートの回答、「merci」とだけ書くメンバーなどです。ノイズではなく、作業を予測してください。 - **ドライバーがあるなら、そこから予測する。**営業通話で eesel に話したDTCサプリメントブランドは、月3万件の注文に対してGorgiasのチケットが約
7,000件、つまりチケット対注文比は25〜30%で、繁忙期は11月から5月です。マーケティングが注文予測を出してくれるなら、この比率を使えば、どの時系列手法よりも早くチケット予測にできます。 - **外れ値に印を付ける。**障害やバズった投稿は履歴を膨らませ、それを含むすべての平均を狂わせます。Zendesk WFMでは外れ値を除外でき、既知のイベントには手動のボリューム調整を加えられます。Assembledにも同じ調整と外れ値ツールがあります。
中規模ならスプレッドシートで足ります。35人のエージェントを抱えるWFMリードの説明です。
"I use salesforce reports to build Google sheets forecasts based on volume history. This allows me to analyze the historic volume for specific days of the week and days of the month. Using a rolling last 60 days report, I built several pivot tables breaking down volume by hourly intervals by days of the week. ... For context, we have 35 agents and handle around 400-600 contacts per day, 24/7"

きれいな履歴がまだないなら、WFMツールを買う前にそこを直してください。タグを一貫させ、チャネルを分け、チケットのトリアージが連絡を正しいキューに振り分けているか確認します。キューごとの予測は、それを満たすルーティングの質で決まるからです。
ボリュームを対応時間で作業量に変えるには?
作業量は、ボリュームに平均対応時間(AHT)を掛けたものです。AHTとは、後処理を含め、エージェントが1件の連絡に使う分数です。30分間に60チャット、各6分なら、360エージェント分の作業、つまり全員が30分間ずっとチャットだけをしたとしても12人分の時間です。コンタクトセンターはこの数字をトラフィック強度と呼び、アーラン(Erlang)で測ります:60 × 6 ÷ 30 = 12 Erlangs。
サポートのチャネルでは、2つの調整が重要です。
- **チャットの同時対応数。**エージェントが2件を同時に扱うなら、チャット1件あたりの実効対応時間はおよそ半分になります。ただし、設定と現実は違います。あるWFM実務者は、エージェントが2チャットまで受けられる環境での実際の同時対応数を「between 1.2 and 1.6」、チャットのAHTを「maybe 130% of voice at least」としています(Reddit thread)。上限値ではなく、実測の平均を使ってください。
- **AHTはチケットの種類で変わる。**パスワードのリセットは1分、請求の紛争は20分かかります。両方の平均は、構成が安定しているなら問題ありませんが、構成が変わると誤解を招きます。AIエージェントが入ると、まさにそれが起こります(後述)。
ヘルプデスクは通常、AHTに近いものを報告しますが、同じとは限りません。たとえばZendeskの所要時間指標は、営業時間ベースの指標と暦時間を分けており、完全な解決時間は対応時間ではありません。実際の対応時間が取れないなら、1週間かけてチケットのサンプルを手で計測してください。推測よりずっとましです。
アーランCによると、エージェントは何人必要ですか?
作業量が示すのは最小値です。12アーランに対して12人ちょうどを配置すると、占有率は100%でキューは延々と伸びます。連絡は整列して届かないからです。アーランCは、ランダムな到着のもとで「連絡のX%をY秒以内に応答するには、エージェントが何人必要か」に答える式です。Zendesk WFMは15分間隔ごとの必要人員を「a modified version of Erlang C」で計算し(Zendesk docs)、Assembledは同期チャネルにアーランCを使います。
入力は、すでにある3つに目標2つを足したものです。
- **サービスレベル:**目標時間内に応答した連絡の割合。たとえば60秒以内に80%。
- **最大占有率:**ログイン時間のうち、エージェントが連絡対応に使う割合。Zendeskは設定として公開しています。占有率95%はすぐに人を疲弊させるため、75〜85%前後で計画するのが一般的です。
60チャットの例を実際に解いてみます。12アーランなら、アーランCは15人で60秒以内80.6%、平均待ち時間は約38秒、占有率は80%と示します。14人に減らすと、サービスレベルは大きく足りなくなります。12人から15人への跳ね上がりが、ランダム性のコストです。ボリュームが増えるほど小さくなります。大きなキューは効率よく回り、小さなキューはそうなりません。30分あたり6チャット(1.2アーラン)なら、同じ目標に3人が必要で、占有率は40%です。Zendeskも自社ドキュメントでそう述べています。少量のワークストリームでは「Erlang C may give slightly higher staffing recommendations」とあります(Zendesk best practices)。
アーランCはライブのキュー向けで、メール向けではない
アーランCは、顧客が今まさにキューで待っていると仮定します。チャットと電話は当てはまります。メールとチケットは違います。顧客はそこに座って待っているのではなく、数時間以内の返信を期待しているからです。あるWFM実務者は、チケットのキューの問題をこう率直に述べました。
"If you have very consistent handle times and a good way to capture it, you basically have a live queue and Erlang C works really well. Most of the time, that is pie in the sky because, for example, Zendesk tickets can take 30 seconds or 45 minutes…so how do you get a good handle time for those tickets?"
非同期サポートでは、SLAの時間枠に合わせて配置します。理由はAssembledのドキュメントが説明しています。旧来の間隔ベースのモードは、15分の間隔に届いた仕事はその間隔内にさばけると仮定しており、それが「significantly over-staffs async work」になるのです。新しいモードは作業量を応答目標の時間に分散させるため、9時に届いた100通のメールにSLA 24時間があっても、全員が9時にエージェントを必要とするわけではありません(Assembled async staffing)。Zendesk WFMも、営業時間外に届いたメールには似た処理をします。そのボリュームを、次の営業時間帯の初回応答の時間枠にわたって再配分します。
スプレッドシートなら、非同期版は単純です。1日の作業量をエージェント時間で合計し、エージェント1人あたりの生産的な時間で割り、バックログがSLAポリシーを超えて古くならないか確認します。ある時間帯で超えるなら、その時間帯に人が足りません。
アーランC計算機で人員配置を求める
下の計算機は、ライブチャネルの30分間隔1つについてアーランCを実行し、そこにシュリンケージを加えます。待てるキューにはメールモードに切り替えてください。AIの欄では、エージェントがボリュームの一部を引き受け、残りのチケットが長引いた場合に何が起こるかを試せます。
既定値:30分あたり60チャット、AHT 6分、60秒以内80%、シュリンケージ30%、AIエージェントが40%を解決し、残りの対応時間は8分。
既定値では、人間だけの計画はチャットのキューに15人、シフトには22人が必要です。AIがチャットの40%を引き受け、残りのチャットが8分かかる場合は、キューに13人、シフトに19人です。解決率40%でシフトは約14%減り、40%減にはなりませんでした。これが計算機で最も役立つ点で、AIベンダーのデフレクション率だけを根拠に採用凍結を計画しない理由です。
シュリンケージはどのくらい見込むべきですか?
アーランCは、キューに何人必要かを示します。シュリンケージは、それとシフトに必要な人数との差です。休憩、会議、研修、コーチング、病欠、休暇、ログインしているが応対できない時間が含まれます。式はscheduled = required ÷ (1 - shrinkage)です。Zendesk自身の例:生産的なエージェント100人にシュリンケージ40%なら、シフトには167人です(Zendesk docs)。
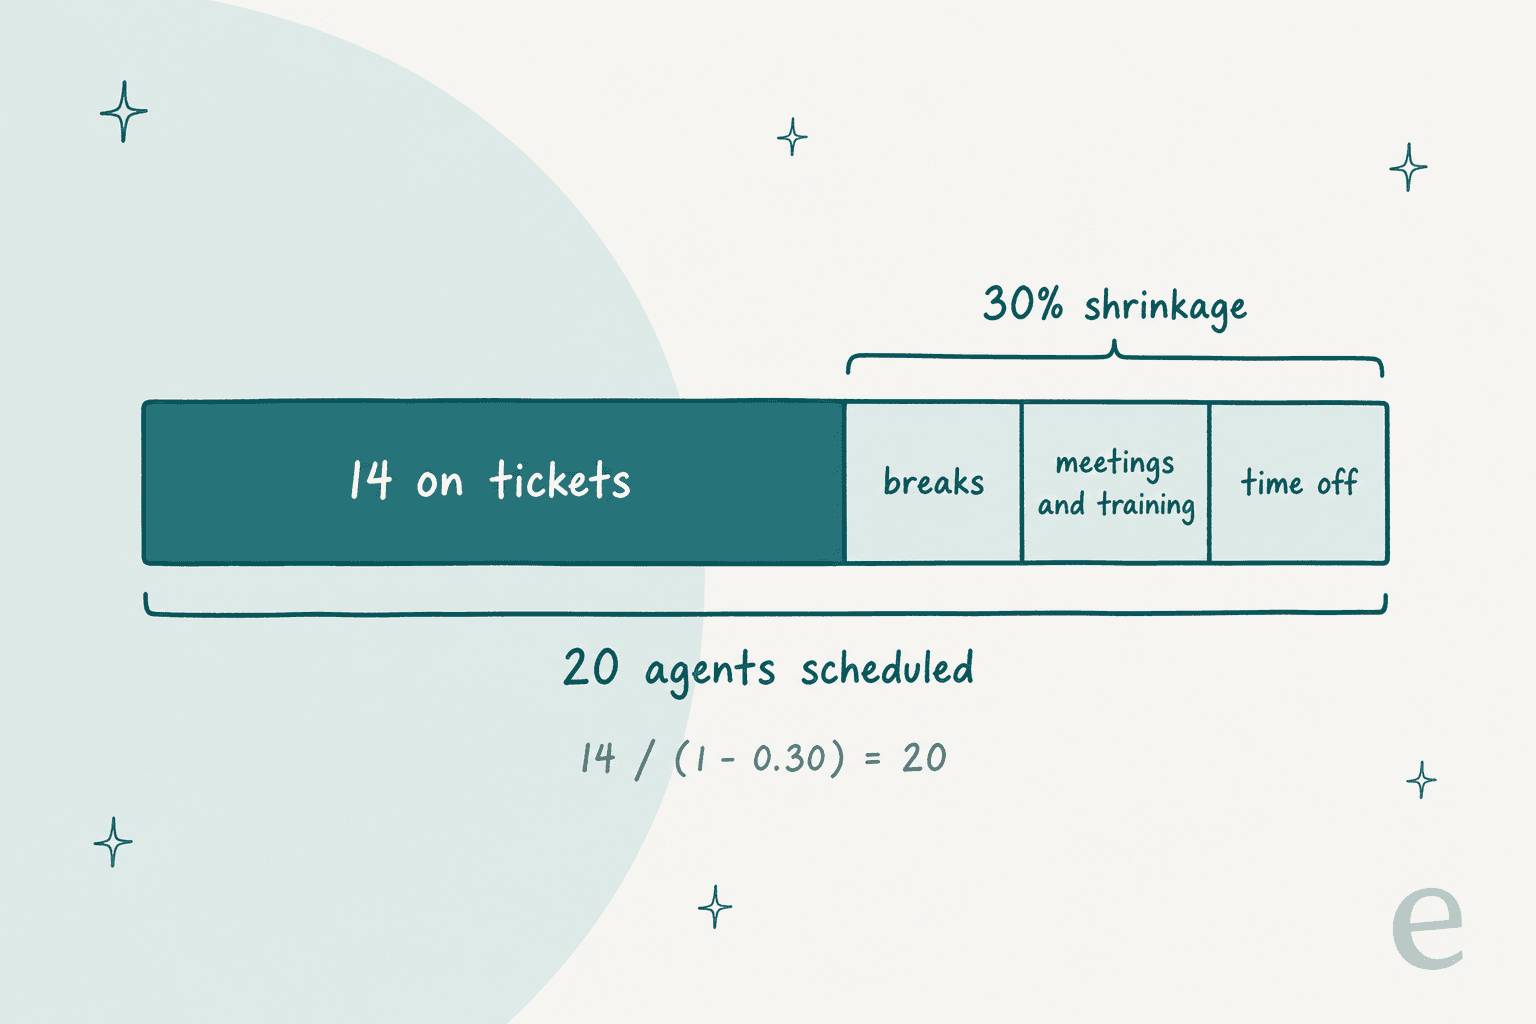
チームが使う数字は、たいてい低すぎます。2つの定義が出回っており、混ぜるのが人員不足のよくある原因です。
- 狭いシュリンケージは、スケジュールされたのに提供されなかった時間だけを数え、おおよそ
100% - adherenceです。Assembledはこの定義を使い、休憩、休暇、会議は別にスケジュールします。ドキュメントでは音声5〜10%、オムニチャネル10〜15%、複雑なデジタルファーストのチームで15%以上とされています(Assembled staffing docs)。 - 完全なシュリンケージは、報酬を受けるエージェントをキューから外すものすべてを数えます。多くのスプレッドシート予測が必要とするのはこちらで、ずっと大きくなります。
"A 15% shrinkage rate seems low. Breaks alone account for approximately 6.25% on a standard 8-hour schedule. Most of our teams average shrinkage in the low 30% range once you factor in absenteeism, PTO, meetings, training, etc."
シュリンケージは動きます。r/workforcemanagementの別の実務者は、月曜のシュリンケージが通常いちばん高く、自分のチームでは1月も高いと述べています(thread)。新人も影響します。最初の数か月の人は、扱う件数が少なく、内容も簡単なものなので、5人を採用したばかりのチームは、人数が示すより容量が小さいのです。ピークに向けて採用するなら、初週の新人を一人前のエージェントとして数えるのではなく、エージェントの立ち上がり期間と、きちんとした繁忙期のオンボーディング計画を見込んでください。
サポートの予測はどのくらい正確であるべきですか?
それをもとに組んだシフトがサービスレベルを達成できる程度に正確であることです。逃げ口上に聞こえますが、これが正しい基準です。週の合計で2%しかずれていない予測でも、重要な時間帯では外れていることがあるからです。
標準的な指標は**平均絶対誤差(MAE)と平均絶対パーセント誤差(MAPE)**です。AssembledのForecast Managementレポートは、MAEが最も低いモデルに「most accurate」のタグを付け、過大と過小の誤差も別々に表示します。過小予測がめったに起きないモデルを好む場合があるからです(Assembled docs)。また、実際のボリュームがゼロだとMAPEが成り立たないとも警告しています。小さな間隔ではよくあることです。Zendesk WFMには、アクティブなシナリオを確認するための、予測と実績のページが早期アクセスで用意されています。
「良い」の基準は、期間によって変わります。ある実務者の経験則です。
"Unless you tie forecast accuracy to a specific business metric, you setup the forecasting team for failure. Also 3% intra-day (in)accuracy? Maybe annual 3%, 5% monthly, 10% weekly and 25%-40% daily."
2つの習慣で、ほとんどの問題を拾えます。1つ目は、合計だけでなく間隔を確認することです。「Many wfm teams only look at the daily total to forecast as a kpi, which doesn't help if the call arrival pattern is wrong」(Reddit)。2つ目は、実績を入力に使うことです。計画が同時2チャットとシュリンケージ15%を前提にしているのに、チームの実績が1.4と30%なら、予測は達成できないサービスレベルを約束します。予測とあわせて、間隔ごとの初回応答時間とバックログの古さを見てください。入力がずれたことを最初に教えてくれる指標です。
Zendesk WFMやほかのヘルプデスクは実際に何を予測しますか?
ここは、サポートチームがコールセンターと最も違う点です。電話システムは何十年も前からWFMを提供してきましたが、ヘルプデスクの多くはそうではありません。各ベンダー自身のドキュメントで確認した内容は次のとおりです。
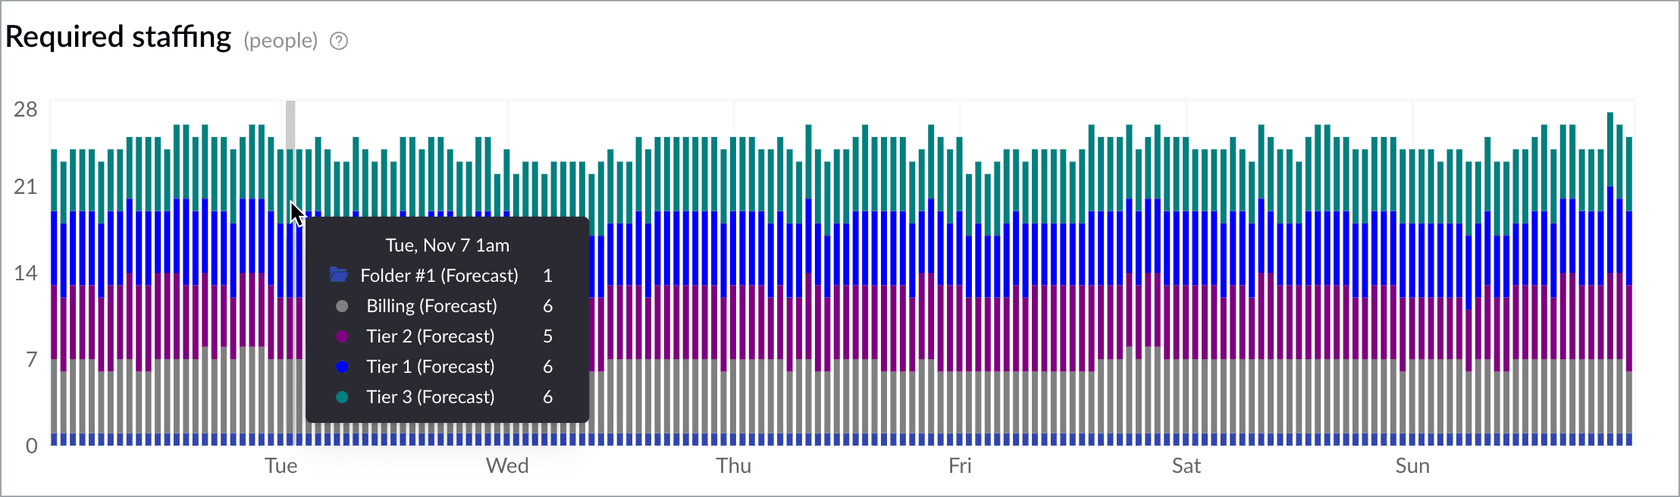
Zendesk WFM
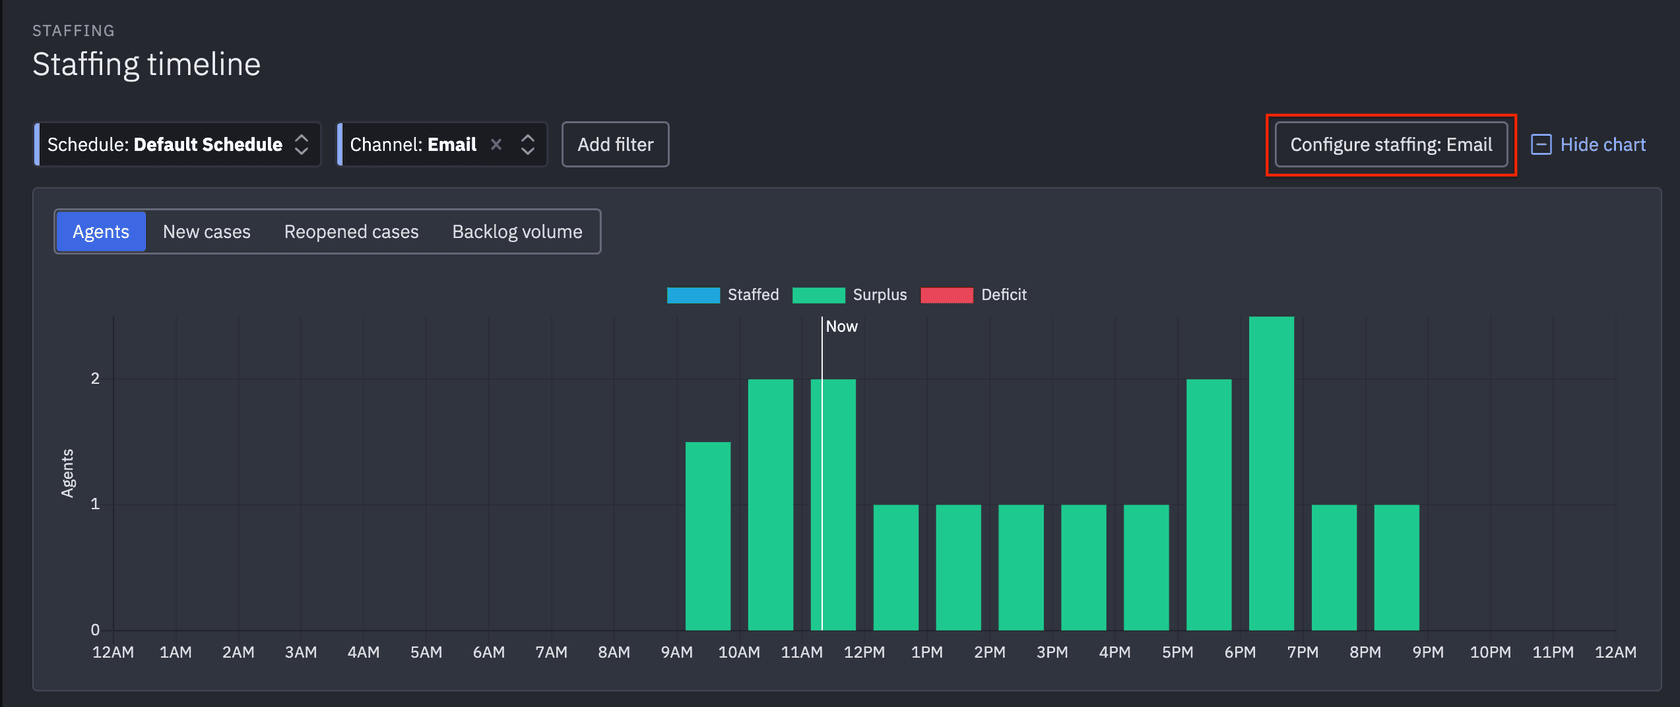
ここで取り上げたヘルプデスクの中でネイティブの予測を持つのはZendeskだけで、しかも本格的なものです。WFMアドオンでは次が得られます。
- ボリューム予測:最大1年先まで、15分間隔で、移行済みの6か月分のチケットデータをもとにします(依頼すれば最大2年)。
- アルゴリズムの選択:ワークストリームごとに、8週間平均、モメンタム付き8週間平均、Prophet、XGBoost、LightGBM、LSTMニューラルネットワーク。WFMはすべてをテストして最良を選び、上書きもできます(Zendesk algorithms)。
- 必要人員:修正版アーランCによる算出で、占有率、チャットの同時対応数、AHT、SLA目標、シュリンケージ、最小人員配置(既定は1 FTE)が入力です。
- シナリオ:有効な予測に触れずに仮定を試せ、ボリューム調整や外れ値の除外も可能です(Zendesk setup guide)。
知っておくべき制限があります。WFMは複数のワークストリームを合算した予測はできず(回避策は、それらを合計するフォルダー)、スパムはボリュームに数えられ、予測に関するドキュメントのどれもAIエージェントの解決分を人間のボリュームから分けることに触れていないため、AIの導入は手動調整でモデル化することになります。費用面では、アドオンはアカウントの全エージェント分を購入する形で、Zendeskの料金ページはWorkforce Engagement Bundle(WFMとQA)を年払いでエージェント1人あたり月$50としています(Zendesk pricing)。基本プランの全体像は、私のZendeskの料金の解説をご覧ください。
Assembled
Assembledはヘルプデスクではなく、Zendesk、Salesforce、Gorgiasなどと連携する独立したWFMツールです。N週、モメンタム、季節、Prophetのモデル、既定で30分の人員配置間隔、ライブチャネルのアーランC、メール向けのSLA時間枠モードで、同じ流れを実行します。料金ページではWFMが月$25(Core)、$45(Pro)、$75(Enterprise)で、ヘルプドキュメントでは予測モデル、精度レポート、非同期SLAの人員配置はProとEnterpriseの機能とされています(Assembled pricing)。Assembledのマーケティングは、人員配置計画に人間とあわせてAIエージェントの容量も反映すると述べていますが、仕組みを説明するヘルプドキュメントは見つかりませんでした。選択肢を比べているなら、Assembledの代替は別記事で扱っています。
Gorgias
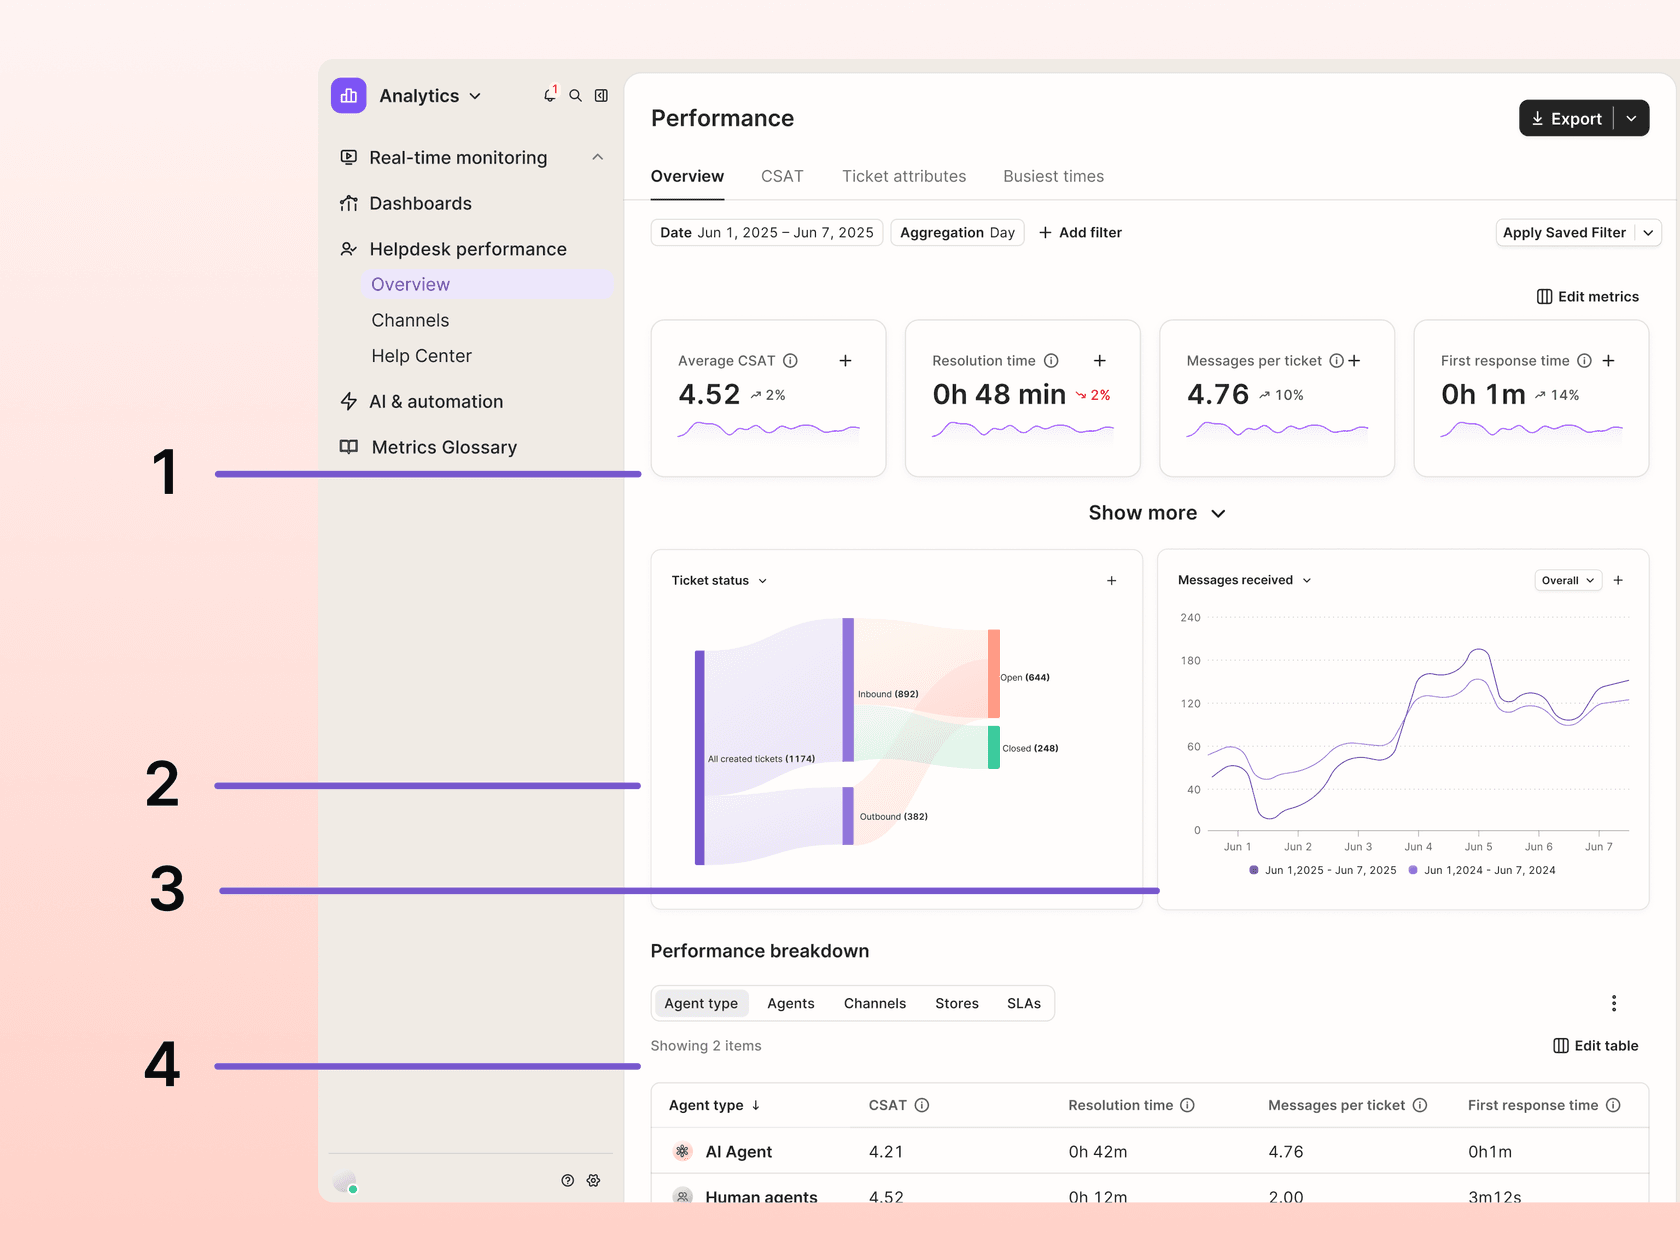
Gorgiasにはボリューム予測はありませんが、レポートで入力の大半が揃います。Busiest timesタブは、1つの指標(作成されたチケット、受信メッセージなど)を、営業時間を示した時間×曜日のヒートマップとして表示し、Gorgias自身のヒントは「A dark cell outside your business hours is demand arriving when nobody is scheduled」です(Gorgias docs)。トレンドチャートは前年を重ねて、本当の変化と季節パターンを見分けられ、すべてのレポートは1範囲あたり最大365日分をCSVにエクスポートできます。GorgiasのAI Agentを使っているなら、そのレポートの自動化率で、AIと人間のボリュームを分けられます。
Help Scout
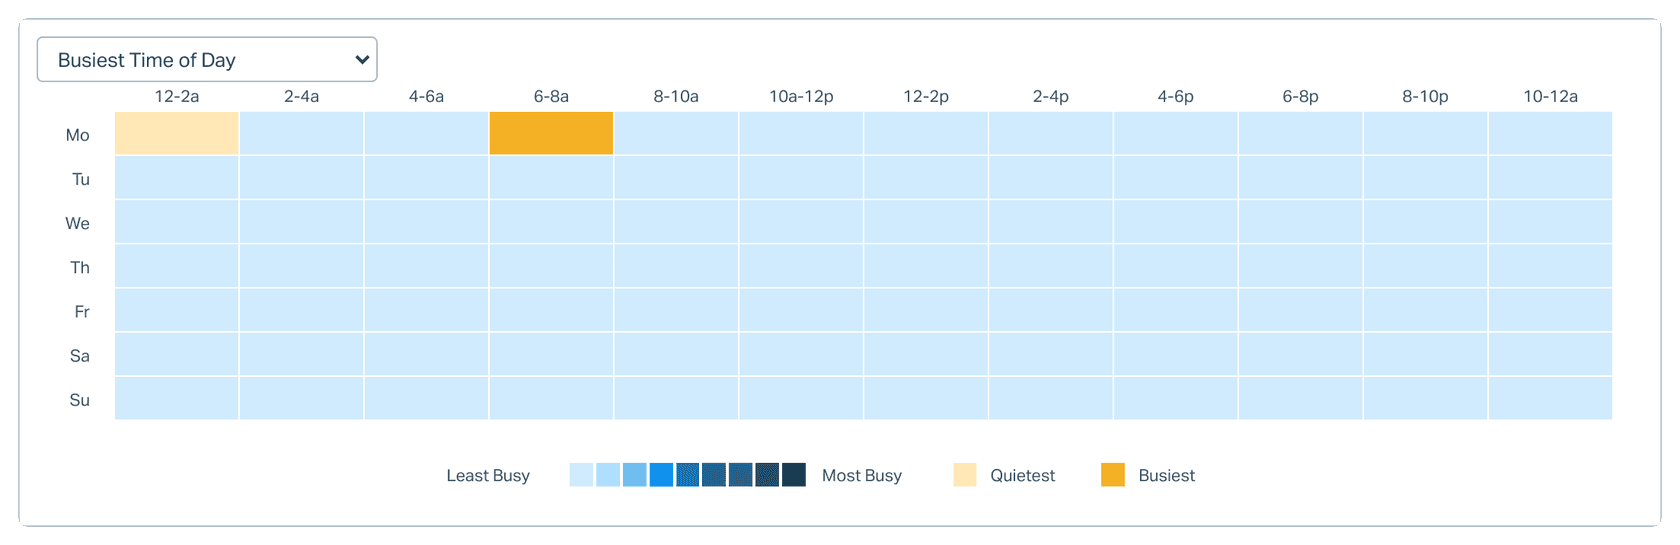
Help Scoutのレポートは過去データのみで、アプリ内でカスタムレポートは作れないとドキュメントに書かれています。All Channelsレポートには、Help Scoutが「helpful for hiring」と説明するBusiest Time of Dayヒートマップがあります(Help Scout docs)。Standardプランは2年分の履歴、PlusとProはアカウント開設以来の履歴をレポートします。エクスポートは会話単位のCSVまたはXLSXで、予測に欲しい形ですが、落とし穴が1つあります。XLSXのタイムスタンプはUTCで、CSVは会社のタイムゾーンを使います。間違った方で集計すると、ピークの時間がずれます。プランの制限については、私のHelp Scoutの料金の記事もご覧ください。
HubSpot Service Hub
HubSpotの予測ツールは、チケットではなく取引ステージに基づく売上ツールです。サポートで最も近いのは、サービス分析スイートのレポート設定にある「predictive」なトレンドライン機能で、過去のチャートに適用します(HubSpot docs)。ただし役立つ入力は揃っています。サポートボリュームのレポート、「to help inform team planning」とされる時間帯レポート、ピーク時に人が働いていたかを示すMaximum available repなどの計画レポートです。HubSpotのCustomer Agentを使う場合、返信ベースの解決が確定するまで72時間の遅れがあるため、今週の解決率は常に低く見える点に注意してください。
比較
| ネイティブのボリューム予測 | 間隔の細かさ | 人員配置の計算 | レポートでのAI分離 | スプレッドシート用エクスポート | |
|---|---|---|---|---|---|
| Zendesk(WFMアドオン) | あり、最大1年 | 15分 | 修正版アーランC、シュリンケージ、占有率、同時対応数 | 予測ドキュメントにはなし | あり、インポートも可 |
| Assembled | あり、4モデル | 15〜30分 | アーランC(ライブ)、SLA時間枠(非同期) | マーケティング上の主張のみ | APIまたはCSVインポート |
| Gorgias | なし | 時間単位のヒートマップ | なし | AI Agentの自動化率 | CSV、1範囲あたり365日 |
| Help Scout | なし | 2時間のヒートマップ | なし | 対象外 | CSVまたはXLSX、会話単位 |
| HubSpot Service Hub | なし(トレンドラインのみ) | 時間帯レポート | なし | Customer Agentのレポート | 集計されていないエクスポート |
後ろの3つのいずれかを使っていて、チームが20人未満なら、上記の手法を使ったスプレッドシートで足ります。それを超える場合や、複数のチャネルとシフトがある場合は、ピボットテーブルを作り直す時間が減る分、WFMツールが元を取り始めます。ヘルプデスク自体を比較検討しているチームには、レポート面も扱っている大量チケット向けのヘルプデスクのまとめが役立ちます。
スパイクや繁忙期のピークはどう計画しますか?
平均で作った予測は、構造上、必ずスパイクを外します。対策は、スパイクを独自のシナリオとして計画することです。私は各ピーク期間について、通常、+30%、**+60%**のボリュームの3つを用意し、それぞれに人員配置とスケジュールを持たせます。最悪のケースに合わせて配置するわけではありません。それが近づくのが見えたときに何をするか(残業、他チームからの兼務スタッフ、オーバーフロー計画、緊急でない業務の一時停止)を、あらかじめ決めておくのです。
スパイクに人を配置する前に、なぜ起きるのかを問います。
"Why is it spiky? Do you send bills to customers all on the same day? Does your ad campaign run at a certain pattern? Identify "the why" in spikes and see if you can educate on the impacts to the call center."
ほとんどのスパイクには、社内の誰かがすでに知っている原因があります。請求の締め処理、販促メール、製品ローンチ、出荷の締め切りなどです。その日付をサポートのカレンダーに載せ、手動の調整として加えましょう。小売向けには、ホリデーシーズンのサポート急増とブラックフライデーのAI活用のガイドで、11月から12月の繁忙をさらに詳しく扱っています。
季節性のある事業は最も難しい形に直面します。夏のために採用すれば、冬の間も人を抱え続けることになるからです。TL;DRで触れたフェリー会社のNorden-Frisiaは、乗客からの問い合わせの大半が5月から9月に集中します。時刻表、車、ルーフラック、自転車などです。季節に合わせて増減するチームを採用し、育てるのは高くつき、時間もかかったため、最初の繁忙期の前に、チームは eesel のプランを月10,000件のやり取りに変更し、10月から3月は規模を戻すことで合意しました。AIチームメイトがZendeskのFAQから繰り返しの質問に答え、解決できないものは人間のチーム向けのZendeskチケットになります。ソフトウェアの判断であると同時に、人員の判断でもあります。
Gorgiasを使うノルウェーのクライミングウェアブランドRúngneは、週ごとの揺れの例です。2026年8月8日から9月8日の間に、eesel は同社のために約2,100件のチケットを処理し、週あたり約300〜780件でした。1か月の中でこれだけ振れるのは、平均に基づくシフトが外す典型で、まずまずの予測があっても日中のチェックが重要な理由です。複数のタイムゾーンをカバーするチームは、フォロー・ザ・サン型サポートでピークをならすこともできます。1つのシフトを延ばすのではなく、リージョン間でキューを引き継ぎます。
AIエージェントは人員予測をどう変えますか?
多くの予測ガイドがまだ追いついていないのがここです。AIエージェントがキューの一部に応答するようになると、従来の予測は2つの方向で同時に外れます。
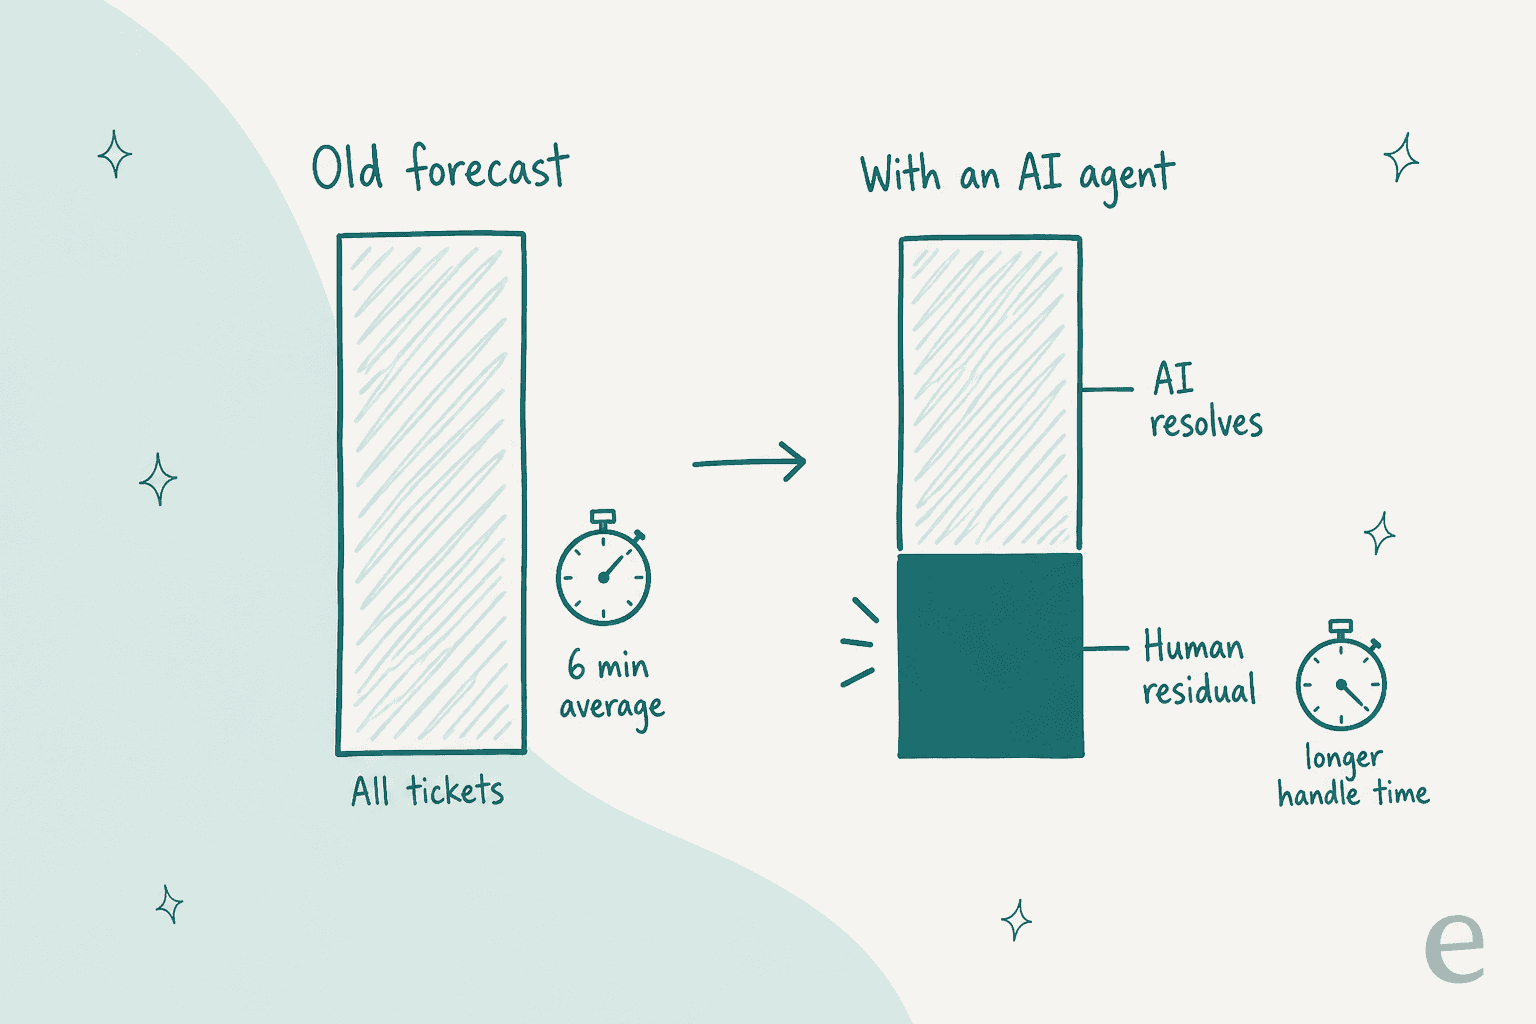
チームに届くボリュームは、AIが注文状況、パスワード、ポリシーの質問を解決するため減ります。しかし、それらは最も速く終わるチケットでもあったので、残った分の対応時間は長くなります。総ボリュームからAIの解決率を引き、昔のAHTのままにすると、人員が足りなくなります。上の計算機が効果の大きさを示しています。解決率40%でAHTが6分から8分に変わると、シフトは約14%減ります。
AIエージェントがキューにいる場合、私ならこう予測します。
- **キューは1つではなく2つ予測する。**総到着数はこれまでどおり、次に人間側に残る分を独立した系列として、AIが引き継いだチケットで測った独自のAHTで予測します。
- **デフレクションではなく解決を使う。**人が介在せずに終わった会話が、必ずしも解決した問題とは限りません。翌日に別のチャネルから戻ってくるものもあります。デフレクション率と解決率の差が、予測の誤差です。
- **変更のたびに数週間、測り直す。**AIに任せる新しいトピック、新しいチャネル、ポリシーの変更。どれも残りの分を動かします。Assembledの8週間平均は追いつきますが、ゆっくりです。
- **ベンダーの目玉の数字で採用を凍結しない。**まず自社のチケットでサポートのパイロットを行い、測定した残りの分だけで計画してください。
これが機能するには、AIに明確な範囲が必要です。月約7,000チケットのDTCブランドのCXリーダーは、すべてのAI回答を手で確認していては意味がないと eesel のセールスチームに話し、こう付け加えました。
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
それが予測を安定させる理由でもあります。Rúngneの構成は良いモデルです。1つの eesel エージェントがすべてのチケットをトリアージしてタグ付けし、1つがチーム向けに下書きを残し、3つ目はチームが選んだトピック(配送と返品のポリシー、注文の所在、在庫、予約注文)にだけ回答します。その月、回答エージェントは約2,100件のうち約280件で動き、「around one ticket in seven」でした。範囲が固定のトピックリストなので、残りの分は予測可能です。どのチケットの種類が人間のキューを離れたかがわかり、残ったものの新しいAHTを測れます。WFMの実務者も、予測の面で同じ結論に至っています。
"I wouldn't trust an LLM to replace forecasting, Erlang/staffing calculations, shrinkage modelling or proper statistical analysis. Those should still be handled by the right models, tools and validated data. ... Basically: it would let AI explain the spreadsheet, not become the spreadsheet."
私も同意見です。AIはキューから仕事を減らし、数字を説明するために使い、予測は実データに基づかせてください。AIがチームの形をもっと大きく変えるのかを検討しているなら、AIファーストのサポートチームの作り方と、AIがチームの代わりになるかの記事が、その話を続けています。お金の面では、AIあり・なしで解決あたりのコストを比べてください。
eesel を試す
3か月しかないピークのために採用せよと予測が言い続けるなら、eesel のAIヘルプデスクチームメイトがもう1つの手段です。すでに運用しているZendesk、Gorgias、HubSpot、Help Scoutのキューに参加し、過去のチケットとヘルプセンターから学び、任せたチケットの種類だけを扱います。これにより、人間側に残る分が計画できるほど予測しやすくなります。
料金も季節的な予測に合います。eesel の料金では、チケット1件またはチャット1件が1クレジットで、プランは500クレジットで月$299から、アップグレードは即座に反映されます。ピークの間は1段階上げ、その後に戻せるので、Norden-Frisiaが毎年夏にしているのと同じ使い方ができます。100クレジットの無料枠から始めて、シフトを1つも変える前に、キューのどれだけを引き受けられるか確かめられます。
