

AI対応の監査がコンテンツ整理ではない理由
私はeeselでAIエージェントを作っているので、ヘルプセンターをエージェントと同じように読みます。つまり、断片に切り分けられて意味で検索されるテキストの山としてです。Zendeskはそのプロセスをドキュメントではっきり説明しています。ナレッジコンテンツはチャンクに分割され、各チャンクは数値ベクトルとともに保存され、最も一致したチャンクが返信の作成に使われます。モデルは、人間のようにヘルプセンターを読むことはありません。その質問に対して最もスコアが高かったチャンクを読むだけです。
これにより、「良いコンテンツ」の意味が変わります。人間は、新しい記事があると知っているので、古い記事を読み飛ばします。検索システムにはその判断力がないため、両方が一致すれば両方が使われうるのです。これが検索拡張生成の核心であり、人間にはうまく機能するヘルプセンターでもAIの誤答を生みうる理由です。
実際のアカウントで、これがうまくいかない場面を見てきました。あるB2B技術サポートチームは、ヘルプセンターに「すべてのモデルに対応しています」と書かれており、データベースにないブランドに対してボットがすでに「はい」と答えていたと話してくれました。有料顧客が、検索で関連するものが見つからないときにボットが一般知識から答えるのを見たこともあります。どちらもモデルの問題である前にナレッジの問題で、本番稼働前のほうが見つけるコストは安く済みます。この記事はAI対応の確認を扱います。保持、統合、アーカイブという一般的な整理については、別途サポートナレッジベース監査のガイドを書いています。
ナレッジベースがAIに誤答させる4つの経路
私がたどる誤答はすべて、4つの原因のいずれかに行き着きます。名前を付けると監査が速くなります。それぞれテストも対処も異なるからです。
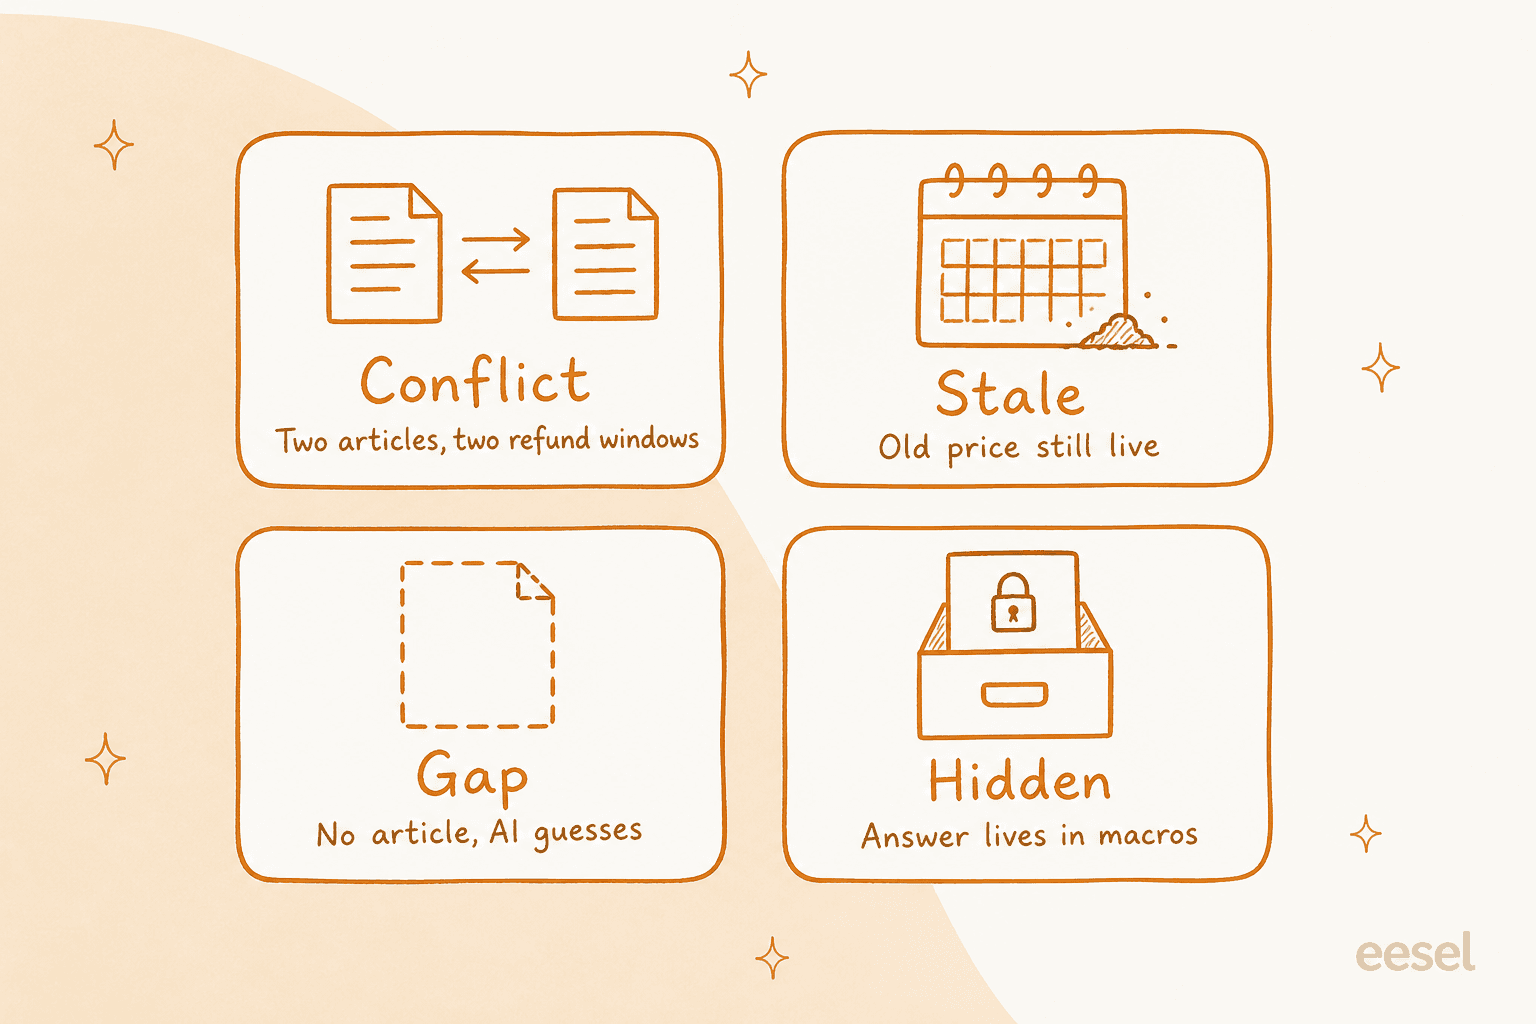
私が確認する順に並べた4つの不具合:食い違う2つの記事、古くなった事実、記事のないトピック、AIが読めない場所にある回答。
矛盾。 2つの記事が異なる答えを出します。Gorgiasは自社のドキュメントで例を挙げています。ヘルプセンター記事が返品期間を30日と書き、ガイダンスのエントリが14日と書いている場合、エージェントは毎回同じように答えないかもしれません(Gorgiasのドキュメント)。AIは混乱しているわけではありません。両方を取得し、どちらが優先かを教えるものが何もなかっただけです。
古い情報。 その記事はかつては正しかったのです。価格、プラン名、発送の締め切り、機能名は最も早く古くなり、古い一文が自信満々に繰り返されます。Zendeskの記事検証ルールはこのためにあります。最大20のルールで、スケジュールに従って記事を未検証に戻し、担当者が再確認する必要があるようにします。
抜け。 その質問をカバーする記事がありません。行儀のよいエージェントは引き継ぎます。設定の悪いエージェントは、沈黙を一般知識で埋めます。Gorgiasは、カバーされていないトピックでは、エージェントがしばしば会話をチームに引き継ぐと述べています。安全ですが、ボリュームの大きいトピックでは高くつきます。
隠れた回答。 チームは答えを知っているのに、それがマクロ、社内wiki、Loom動画、あるいはベテランエージェントの頭の中にあります。これは、メール量の約半分を自動化したいDTCブランドから聞いた話で、ナレッジはSOPツール、文字起こしされていない動画、古いマクロの中にありました。AIは接続したものからしか答えられず、接続された部分が最も薄かったのです。
自信のない記事には、下のウィジェットを使ってください。不具合がどう見えるか、どう見つけるか、本番稼働前に私が適用するルールが分かります。
この記事はどの不具合ですか?
不具合の種類を選ぶと、見つけ方と私が使う本番稼働ルールが表示されます。
各不具合の種類をクリックすると、その見た目、見つけ方、本番稼働前に私が確認するルールが表示されます。
アルファベット順ではなく、リスク順に監査する
よくある間違いは、ヘルプセンター全体を均等に監査することです。店舗の営業時間についての誤答と、返金についての誤答は、コストが同じではありません。そこで私は、トピックを2つの基準で順位付けします。どれだけのチケットを生むかと、誤答のコストです。返金、返品、解約、支払いを最上位の層に置きます。
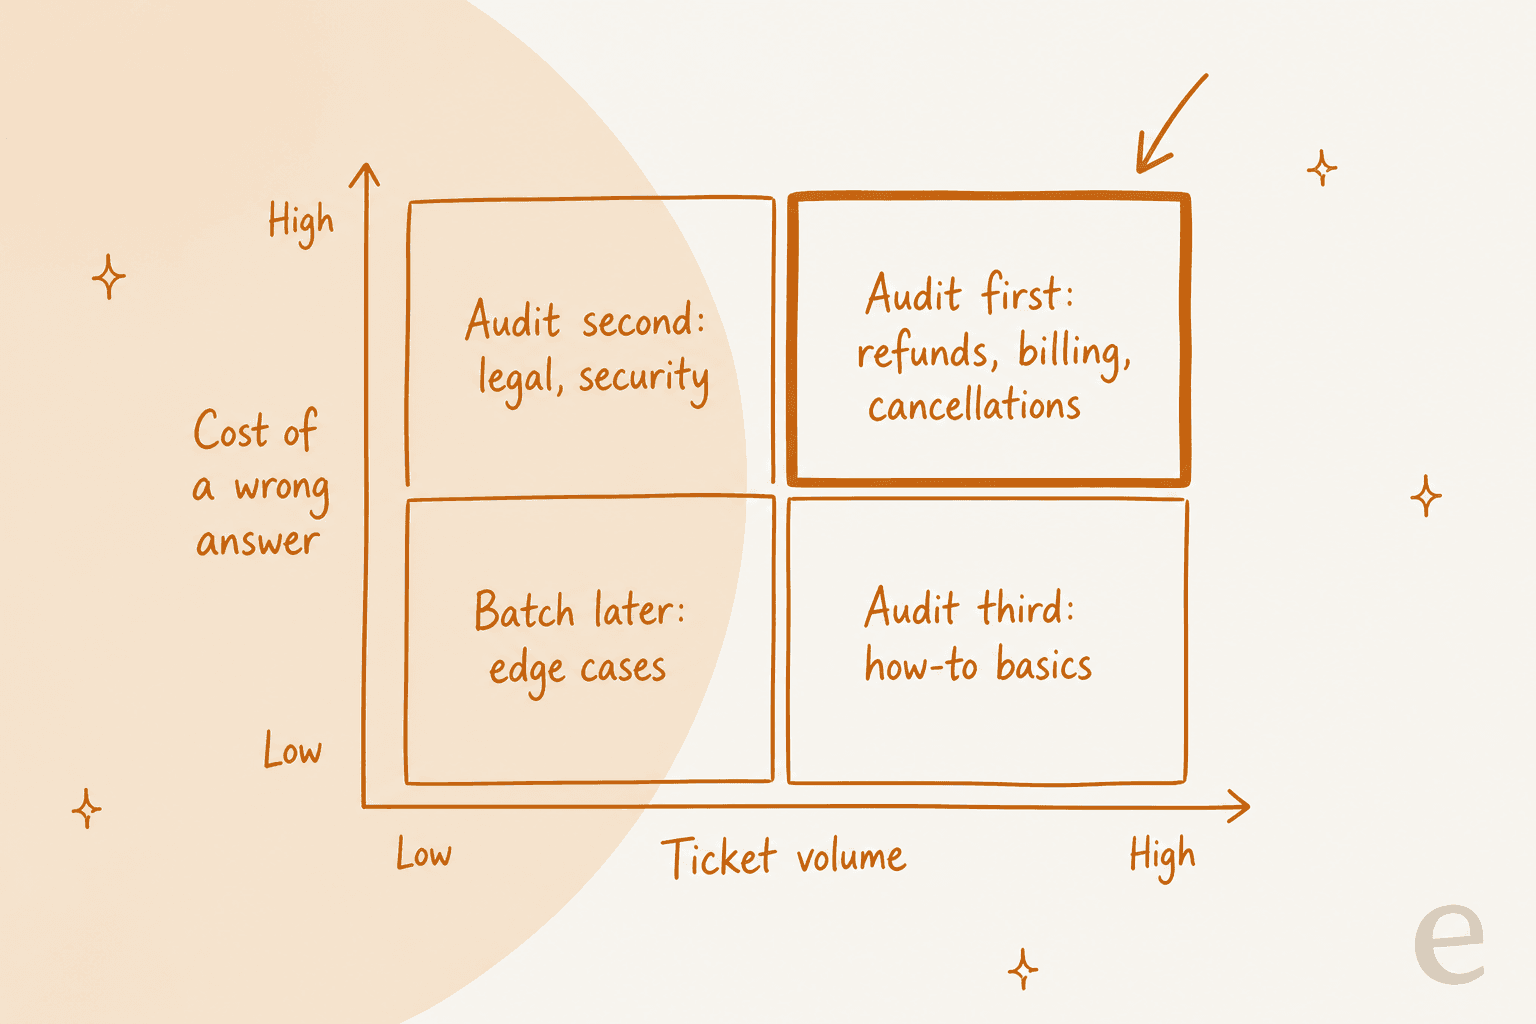
誤答のコストとチケット量による監査の順序:お金に関するトピックが最初、法務とセキュリティが2番目、基本的なハウツーが3番目、例外的なケースは後でまとめて。
| 層 | トピック | 確認すること | 一般的な本番稼働の基準 |
|---|---|---|---|
| 1:お金 | 返金、返品、解約、請求、支払い失敗 | 矛盾、古い数字、例外、承認できる人 | テストでの誤答ゼロ |
| 2:リスク | 法的条件、セキュリティ、プライバシー、アカウントアクセス | 適切な担当者が承認した文言、明確な引き継ぎ | 誤答ゼロ、迷ったらエスカレーション |
| 3:ボリューム | 配送、サブスクリプション、基本的なハウツー、トラブルシューティング | 正確さ、完全さ、分かりやすい言葉 | ほとんどの回答が正確で、残りは適切にエスカレーション |
| 4:テール | 例外的なケース、まれな製品の質問 | 後でまとめて対応し、それまでは引き継ぎを使う | 引き継ぎで許容 |
層1では、返金ルールもエージェントが読むように読みます。例外を承認できるのは誰で、いくらまでか、正確な文言は何か。返金承認マトリクスの記事でそれを整理しており、返金リクエストのAI活用のガイドでは何を自動化するかを扱っています。層1の回答に判断が必要なら、そのトピックは回答ではなく引き継ぎに設定します。Rúngneはまさにこれを行っています。チームはAIが直接答えるトピック(ポリシーや追跡など)を選び、解約、破損品、紛失した荷物は人に任せています。トピックを移すのはリストの編集であり、プロジェクトではありません。その設定はRúngneの事例にあります。
各ヘルプデスクのAIはナレッジをどう読むか
ほとんどの監査が飛ばす部分です。記事を直す前に、AIがそれを見られるか、そのコピーがどれだけ新しいかを知る必要があります。これについては各ベンダー自身のドキュメントを読みました(すべて2026年9月と10月に編集または更新されたページ)。違いは重要です。
| ヘルプデスクAI | 読むもの | 鮮度 | 確認すること |
|---|---|---|---|
| Zendesk AI agents | Zendeskヘルプセンター、ウェブクローラー、ナレッジコネクタ(外部ソースは最大50) | ヘルプセンターはリアルタイムで検索。外部ソースは最後の同期時点で、通常24時間ごと。クローラーは30分ごと、Confluenceは24時間ごとに更新 | 制限付き記事は認証済みの顧客にのみ届く。ソースが多すぎると精度が下がり、遅延が増えることがある |
| Freshdesk Freddy AI Agent | URL、ファイル、公開のソリューション記事、カスタムQ&A、Google DriveとSharePointのアプリ | 手動の再同期、最終同期のタイムスタンプ。SharePointの変更は約15分ごと | 公開記事のみ。ログインが必要なURL、非公開記事、画像や表の中のテキストはスキップされる |
| Gorgias AI Agent | ガイダンス、ヘルプセンター記事、ストアのウェブサイト、公開URL、ドキュメント | ウェブサイトとURLの再同期は手動で、24時間に1回 | 公開ページのみ。埋め込みのPDF、動画、画像は抽出されない。下書きは本番の返信には使われない |
| Help Scout Scout | Docsサイト、ウェブサイトのページ、PDF、WordとExcelのファイル、テキストソース | Docsは同期され続ける。ウェブサイトは手動の再同期が必要 | サイト全体ではなく特定のページを選ぶ。Googleのファイルはリンクで共有する必要がある |
| HubSpot Customer Agent | HubSpotの記事とページ、公開URL(関連するものは最大5,000)、ファイル | HubSpotの記事は編集時に再同期。その他のソースは週1回 | 非公開ソースは引用されないが、回答に影響しうる |
Zendesk。 Zendeskのドキュメントによれば、接続したヘルプセンターは質問の時点で検索され、外部ソースは最後の同期時点の内容で、通常24時間ごとです。実務上の教訓は、外部wikiでの編集は1日間は反映されず、ウェブクローラーはConfluenceコネクタよりはるかに頻繁に動くということです。制限付きのヘルプセンター記事は顧客が認証されている場合にのみ使われ、ドキュメントには、制限付きコンテンツの回答はテストウィジェットではテストできないとあります。最良の回答がログインの向こうにあるなら、ローンチ前のテストでは分かりません。詳しくはZendesk AIの概要をご覧ください。
Freshdesk。 Freddyのナレッジガイドには、何かを接続する前に読んでおきたい上限が載っています。エージェントあたりURL10件、サイトあたり最大3,000ページ、エージェントあたりファイル200件で各35MB、ソリューション記事は全ユーザーに表示されるものだけです。非公開または制限付きの記事は除外されます。便利な監査ツールもあり、会話の後、詳細パネルにエージェントがどのソースから取得したかが表示されます。Confluenceについては、専用のサービスアカウントが推奨されています。セットアップした管理者がアクセスを失うと、それらの記事は削除されたものとして扱われるためです。FreddyのナレッジソースとeeselのFreshdesk連携をご覧ください。
Gorgias。 Gorgiasは、ナレッジの種類の中でガイダンスが最も重みを持つと述べており、ヘルプセンターとの矛盾を最初に探すべき場所はガイダンスです。ストアのウェブサイトとURLの同期は公開ページのみで、自動では更新されず、24時間に1回再実行できます。ウェブサイトから取り込んだスニペットは編集できませんが、古い内容が含まれる場合は無効にできます。Opportunities機能(ベータ)は、実際の会話から抜けや矛盾を見つけてくれる便利な近道です。詳しくはGorgias AI Agent 2.0の解説をご覧ください。
Help Scout。 AI Answersから発展したエージェントのScoutは、Docsサイトと常に同期された状態を保ちますが、ウェブサイトのソースは、料金やプロセスが変わったときに手動の再同期が必要です。Help Scoutは、サイト全体ではなく、最良の情報がある特定のページを指定することを勧めており、画像や動画だけに重要な手順を載せるべきではないとも述べています。詳細はHelp ScoutのAI活用とeeselのHelp Scout連携をご覧ください。
HubSpot。 Customer Agentは、ナレッジベース記事を編集時に再同期し、その他のソースは週1回再同期します。二度読むべきなのは非公開コンテンツに関する一文です。非公開ソースは引用されませんが、その内容は回答に現れることがあります。そのため「隠れた回答」はより微妙なリスクになります。参照用に接続した社内ドキュメントでも、その文言が漏れる可能性があるからです。全体像はHubSpot AI agentをご覧ください。
実際のチケットでカバー範囲を確認する
記事を読めば、それが正しいかが分かります。チケットを見れば、それが正しい記事かが分かります。私は直近90日のチケットを取り出してトピック別にグループ化し、各トピックに4つの印のいずれかを付けます。
- カバー済み。 記事があり、最新で、エージェントが実際に返信している内容と一致している。
- 一部。 記事はあるが、近い質問に答えている、またはエージェントがいつも言及する例外が抜けている。
- 矛盾。 2つの情報源が食い違っている、または記事が実際にエージェントが送っている内容と食い違っている。
- 欠落。 記事がない。エージェントは記憶やマクロから答えている。
ここで最も役立つ証拠はエージェントの返信です。最良のエージェントが、記事にない一文を一貫して付け足しているなら、その一文が抜けです。私が話したあるサポートマネージャーのヘルプセンターは管理者向けにだけ書かれていて、チケットはエンドユーザーから来ていました。記事を一つずつ読んでいては、これは見つかりません。チケットとの比較なら見つかります。
結果はボリューム順に並べます。層1で「一部」または「欠落」の印が付いたトピックは、修正リストの最上位に上がります。方法については、クエリと抜けの対応付けとZendeskのナレッジギャップ分析のワークフローについて書いており、より広い導入については導入時の失敗のガイドに書いています。
テストセットを作り、本番稼働ルールを決める
テストを実行する前に、合格ラインを決めてください。後から決めると、どんな結果も許容できるように見えてしまいます。
実際の質問からセットを作る。 実際の顧客メッセージを50〜100件取り、層1と層2に重みを置き、AIが答えるべきでないものも少し含めます。ポリシー外の返金、法的な質問、アカウントの照会が必要なリクエストなどです。それぞれについて、正しい回答または正しい引き継ぎがどのようなものかを書き、どの記事から来るべきかを明記します。
1回答につき4つを採点する。 正しい情報源を取得したか。回答は正確だったか。例外を含めて完全だったか。エスカレーションすべきときにしたか。最後の項目が最も省略されがちで、本番稼働後はエスカレーション率と自己解決率につながります。
ベンダーのテストツールを、その制限の範囲内で使う。 Help ScoutにはTestエリアがあり、Gorgiasでは公開前に下書きをテストできます。Zendeskのテストウィジェットは、制限付きコンテンツの回答をテストできません。
ツールが対応していれば、過去のチケットを再生する。 eeselのSimulationスキルは、過去のチケットを取り出し、AIの返信を生成し、人間が実際に送った内容と比較し、一致度を採点してギャップレポートを作ります。顧客に誤答を見せることなく自分のデータでテストするのに、私が知る限り最も近い方法です。より詳しい計画はAIサポートエージェントのテストの記事で説明しています。
私が勧める本番稼働ルール。 これは私自身の基準でベンダーの標準ではないため、リスクに合わせて調整してください。
- 層1と層2のトピック:テストセットで誤答ゼロ、不確かなケースはすべて引き継ぐ。
- 層3:10件中少なくとも9件が正解で、外れはすべて推測せずに引き継ぐ。
- 層1に未解決の矛盾がなく、層1のすべての記事が直近90日以内に検証されている。
- すべての高ボリュームのトピックが、カバー済みか、エスカレーションに設定されている。
- 公開後の週次レビューの担当者が決まっている。
本番稼働後の週次ループ
ローンチ時の監査は、ポリシーと同じ速さで古くなります。最初の1か月は毎週同じ短いループを回し、その後は月次に、さらにポリシーが変わるたびに回します。
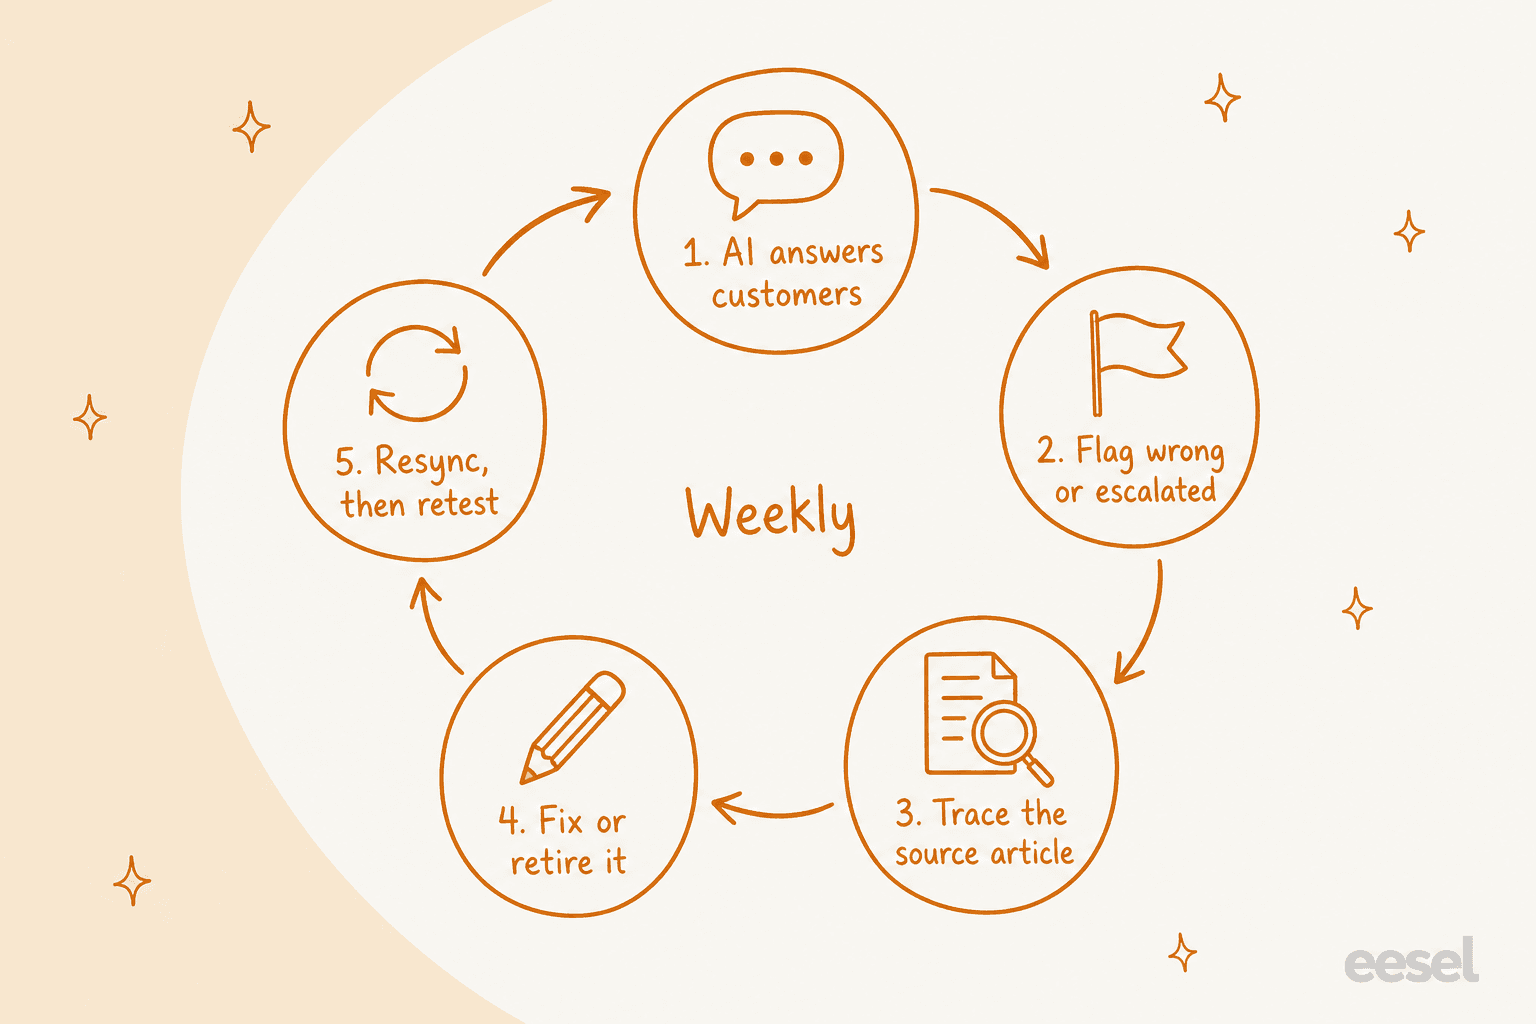
週次ループ:AIが誤答またはエスカレーションした内容を読み、情報源をたどり、修正し、再同期して、再テストする。
- 誤答とエスカレーションされた会話を取り出す。 Help Scoutでは、Reports > Scoutを解決状況で並べ替えると、顧客を助けられなかったものが見つかります。Freshdeskでは、会話の詳細に使われたソースが表示されます。
- それぞれを情報源までたどる。 矛盾、古い情報、抜け、隠れた回答のどれでしたか。同じ4つのラベルを使えば、パターンが見えてきます。
- 情報源を修正または廃止する。 2つの記事が重なっているなら、パッチを当てるより廃止するほうが良いです。
- 再同期する。 人が忘れがちなステップです。Gorgiasのウェブサイトソース、Help Scoutのウェブサイトソース、FreshdeskのURLは、AIが編集内容を見る前に手動の更新が必要です。
- 再テストする。 失敗した質問と、層1からいくつかを再実行します。
注目する価値のある指標は、AIカスタマーサービスの指標のガイドにあります。
eeselが実際に監査をどう扱うか
eeselのAIヘルプデスクチームメイトは、ヘルプセンター、過去のチケット、ConfluenceやGoogle Docsなどのドキュメントから学習し、既存のヘルプデスクの中で働きます。名前を挙げた2社の顧客が、現場での監査の様子を示しています。
- SamCartは、Freshdeskのメールチケットとウェブサイトのチャットで別々のeeselエージェントを運用しており、どちらも約280件のヘルプセンター記事から回答します。エージェントには公開記事だけをリンクするよう指示されているため、古い社内資料が回答の材料になっても、販売者に送られることはありません。記事がもう利用できないものを説明している場合は、チームが訂正を追加し、エージェントはそれを案内しなくなります。これは、記事全体を書き直さずに行う、古い情報への対処です。
- Rúngneは、Gorgias上で役割別に3つのエージェントを運用しています。1つはトリアージとタグ付け、1つは人が送る返信の下書き、もう1つは単純なポリシーと追跡の質問に自分で答えます。解約、破損、紛失した荷物はチームが担当します。トピックのリストが調整ダイヤルです。
パターンは同じです。AIが答えてよいトピックを決め、お金と判断が必要なものは人に任せ、訂正を習慣として扱うこと。構築面については、AIサポートエージェントのトレーニングの記事とAIナレッジベースのガイドで扱っています。
eeselを試す
監査は、ヘルプセンターの準備ができているかを決めます。テストは、それが十分かを決めます。そのテストを自分のチケットで行いたいなら、eeselのAIヘルプデスクチームメイトはZendesk、Freshdesk、Gorgias、Help Scout、HubSpotに接続し、ヘルプセンターと過去のチケットから学習し、顧客に返信する前に過去の会話で再生できます。料金はプランごとで、プランを見ることができ、無料で始められます。
eeselを無料で試すか、デモを予約してください。お客様自身のチケットをどう扱うかをお見せします。