

FrontのAIエージェント評価はCompassというツールで、稼働前に実行する部分がSimulationsタブであり、これはAutopilotエージェントのみで動作します。シミュレーションは、あなたが書いた基準に対して実際の会話を再生し、顧客には何も送信せず、1回の実行を10往復までに制限します。公開後は、CompassがSmart QAとSmart CSATで本番の返信を採点します。これはあなたが記述した振る舞いを確認するものであり、回答がヘルプセンターと一致しているかは確認しないため、トランスクリプトも読む必要があります。Compassに追加料金はかかりませんが、Autopilotは会話1件0.05ドルからです。
eeselはFrontの中でAIヘルプデスクチームメイトとして動き、内部コメントとしてドラフトを作成し、どのロールアウトもまずチーム自身の過去の会話に対してシミュレーションされます。eesel CLIを使えば、AIコーディングエージェントが承認済みの知識、たとえば書き出したFrontのヘルプ記事や保存済みの回答をアップロードし、テストの質問をして回答を確認し、何かが本番に出る前にチェックできます。Frontの受信箱自体を接続するには、依然として管理者の承認が必要です。
FrontのAIエージェント評価とは何で、どこにありますか?
それがCompassで、会社の設定内にあるエージェント自身のページにあります。FrontのCompass記事によると、管理者がAIエージェントをテストし、会話の品質を測定し、パフォーマンスのシグナルを追跡し、推奨事項を得るのに役立ちます。会社の管理者権限と既存のエージェントが必要です。3つのタブが作業を担います。展開前にテストするSimulations、健全性を監視するPerformance、すべてのAIメッセージを読むRepliesです。
名前が定まるまで数か月かかったため、「スコアカード」や「評価レポート」で検索してもFrontのドキュメントでは何も見つかりません。8月にFrontのコミュニティマネージャーがデザインパートナーをSNSで募集し、「すべてのAIのやり取りを採点し、何が問題だったかを診断し、稼働前に変更を検証する」ツール群を求めました。10月6日、Frontは製品アップデートでCompassを発表し、10月26日のまとめでは、エージェント評価とエージェントテストが2つの別項目として挙げられています。
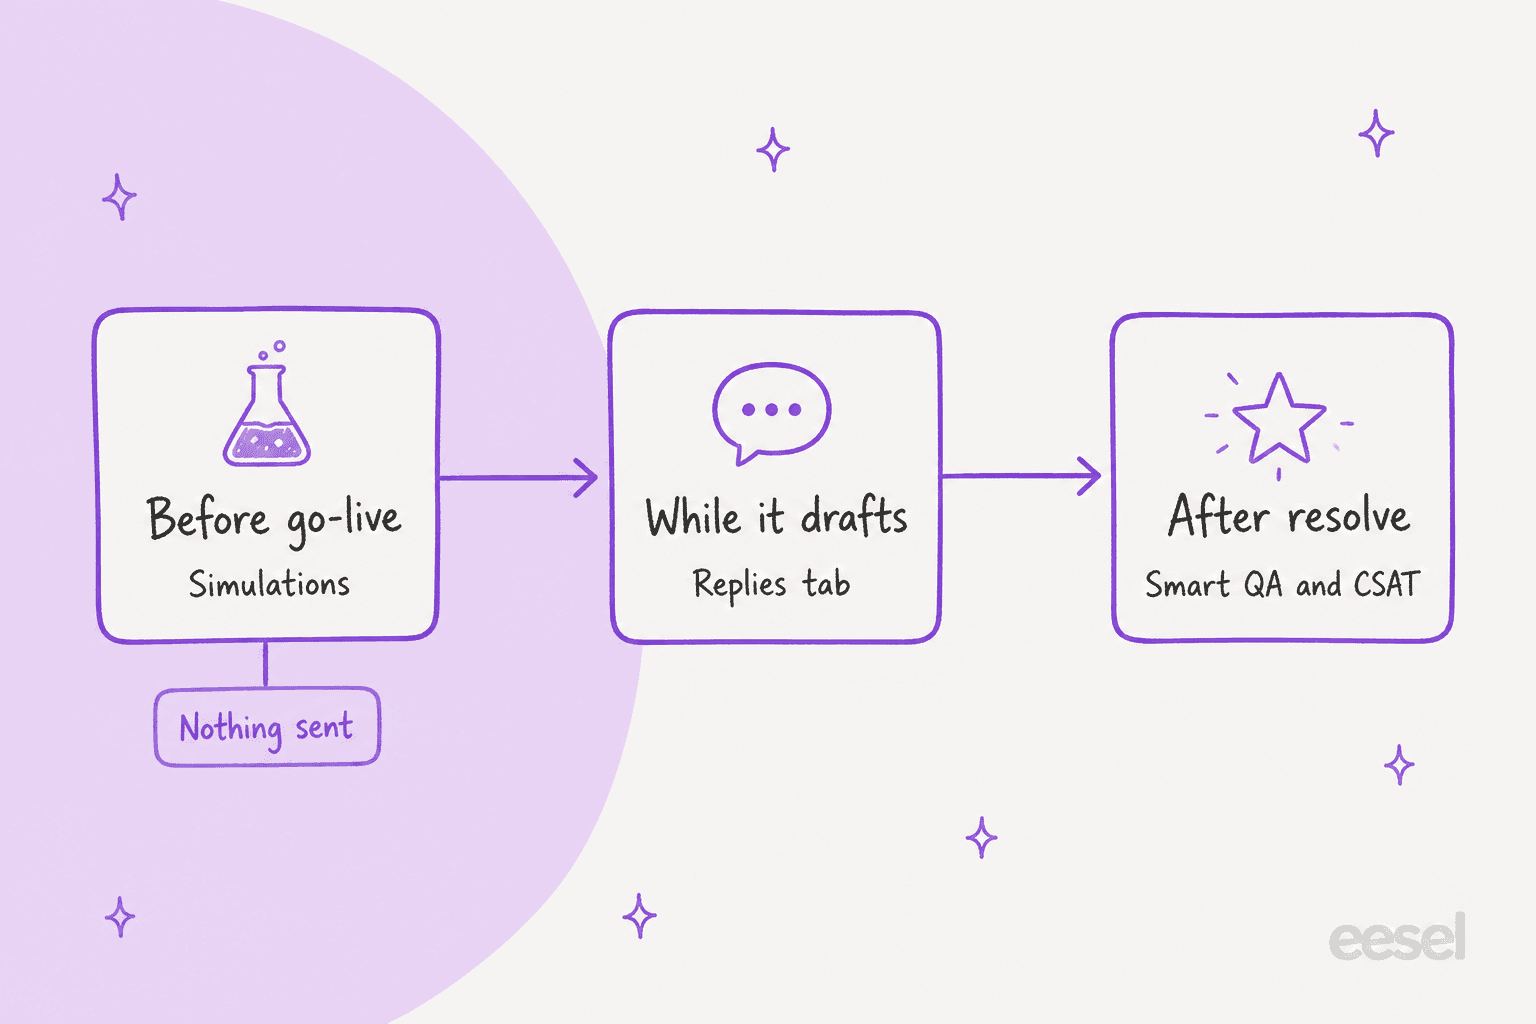
私はこの評価を3つの層として読み解いており、上の画像はサポートリーダーに説明するときのイメージです。稼働前にシミュレーションを実行し、エージェントがドラフトを作成する間はRepliesタブを読み、会話が解決した後はSmart QAとSmart CSATがそれを採点します。各層は異なる質問に答えるものであり、これはこの先のウィジェットで重要になります。
どのFrontプランとアドオンが必要ですか?
Compass自体は無料ですが、それが評価する対象はたいてい無料ではありません。Frontのローンチ記事によると、外部エージェントは全プランで利用可能で、Autopilotは全プランで使用量課金のアドオンであり、Compassは両方で追加料金なしに動作します。AutopilotでCompassを使うにはAutopilotアドオンが必要です。
| 項目 | Frontの説明 | 出典 |
|---|---|---|
| 外部エージェント(Claude、Codex、Sierraなど) | 全プランで利用可能 | Frontローンチ記事 |
| Autopilotエージェント | 全プランで使用量課金のアドオン、会話1件0.05ドルから | Front料金 |
| Compass(Simulations、Performance、Replies) | 追加料金なし、Autopilotエージェントには Autopilotアドオンが必要 | Compass記事 |
| Smart QAとSmart CSAT | 最新のEnterpriseプランに追加料金なしで含まれる | Smart QA記事 |
| Enterprise席 | 年間契約で席1つにつき月105ドル | Front料金 |
Smart QA記事には、ルールテンプレートから開始する、他プランのチーム向けの30日間のEnterprise無料トライアルが追加されています。ドキュメントが述べていないのは、AutopilotをAutopilotを追加したProfessionalの顧客がAIの返信に対してSmart QAの採点を受けられるかどうかです。Compass記事はSmart QAがAIエージェントに対して自動的に有効になるとしており、Smart QA記事はこれをEnterprise機能だとしているため、予算を組む前にFrontに確認してください。私のFront料金の記事には席単位の数字があり、Front AIではより広い製品ラインを扱っています。
Frontのシミュレーションはどう機能しますか?
テスト用の会話セットを作り、それぞれに基準を与えて実行します。セットとは、Compass記事によれば、変更ごとにベースラインとして再実行する、関連するシミュレーションの名前付きグループです。手順は次のとおりです。
- エージェントを開き、Simulationsを選択してCreate setをクリックします。名前を付け、必要に応じてSmart QAのスコアカードを選びます。
- Create simulationをクリックします。選択した受信箱から最近の未解決の会話を選ぶか、会話IDまたはチケットIDを入力します。
- シミュレーション基準を追加し、Create and runをクリックします。
- 多数の会話を一度に扱うには、カンマ区切りのIDを貼り付けます。それぞれが独立したシミュレーションになり、Run setがすべてを実行します。
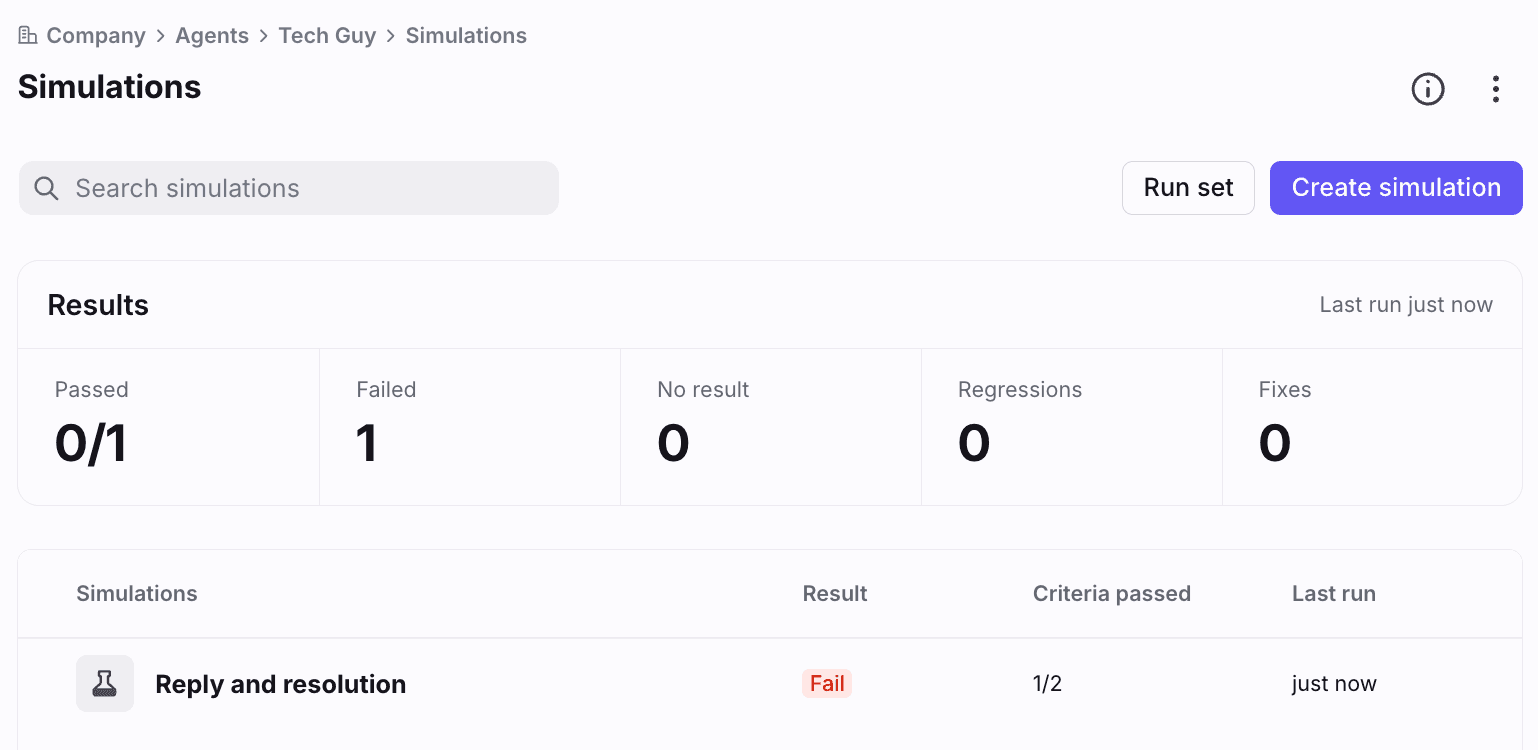
上の結果パネルは、合格、不合格、結果なし、リグレッション、修正済みを数えます。Frontのヘルプ記事によると、各会話はシミュレーションされた顧客を使ってエージェントに対して実行され、往復10回までに制限されますが、実行回数自体は無制限です。実際の顧客には何も届かず、ライブの会話は変更されず、分析にも影響しません。
基準こそが本当の作業です。期待される振る舞いの名前と説明を書き、Generate scaleをクリックすると合格・不合格の条件が得られ、バリデーターが「Good definition」と表示されるまで、曖昧、まとめすぎ、検証不能な部分を指摘します。Frontは3つの出発点を提案しています。エージェントは行っていない行動を行ったと主張しない、必要なときにエスカレーションする、必要でないときにエスカレーションしない、です。これは私がどのサポートエージェントの最初のテストセットにも入れる、同じ3つの失敗パターンです。
Frontのシミュレーションは何が見えて、何が見えませんか?
これが最も重要な限界です。シミュレーションは可視的な証拠から振る舞いを判断し、Compass記事はその証拠が何かを列挙しています。バリデーターは送信済みメッセージ、内部ノート、タグ、受信箱の移動、担当割り当て、チケットのステータス、コネクタの呼び出し、会話の終わり方を確認できます。見えないのはPlaybookの内容や順序、ナレッジ記事の本文、カスタムフィールド、連絡先レコード、ドラフト、添付ファイルです。
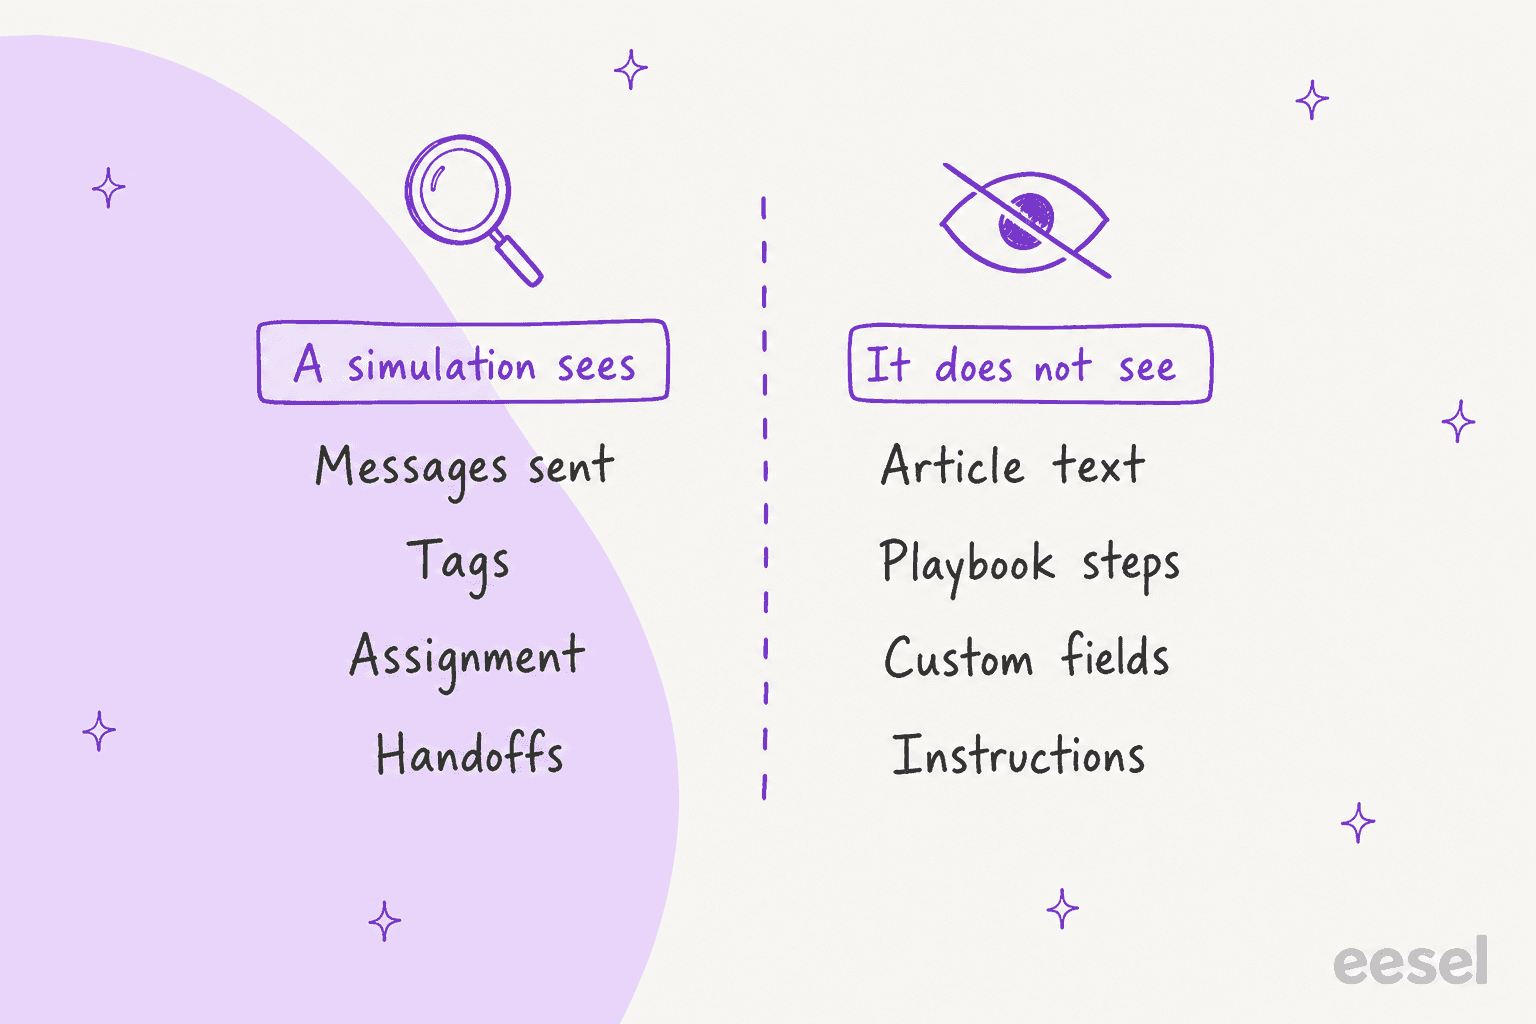
エージェントの指示、ガイドライン、トーン設定も、エージェントがそれを明言せずに参照する場合を除いて隠されています。FrontのFAQは、基準がナレッジソースやPlaybookに対して回答を検証できないことをはっきり述べており、その助言は行動に基づく基準を書き、正確性のためにトランスクリプトを読むことです。シミュレーションの合格は、エージェントが記述どおりに振る舞ったことを証明するだけで、その回答が正しかったことを証明しません。この記事は、トーンとフォーマットをSmart QAスコアカードの仕事として分類し、基準からは外しておくよう述べています。
返金に関する質問であれば、「顧客がお金を返してほしいと言ったときに人にエスカレーションする」は良い基準であり、「正しい30日間の期間を引用する」は検証できません。なぜなら記事の本文はバリデーターから見えないからです。後者はトランスクリプトを読むことで見つけられるもので、私のadversarial testingのガイドや、AI hallucinationとAI groundingのグロッサリー項目が、この読み込みがなぜ重要かを扱っています。
シミュレーションの結果はどう読みますか?
シミュレーションを開くと、トランスクリプト、基準、判定が表示されます。Frontの記事によると、詳細ビューには会話のプレビューと結果が表示され、三点メニューに実行履歴と再実行があり、現在の実行を過去の実行と比較して進歩や後退を示す矢印インジケーターがあります。
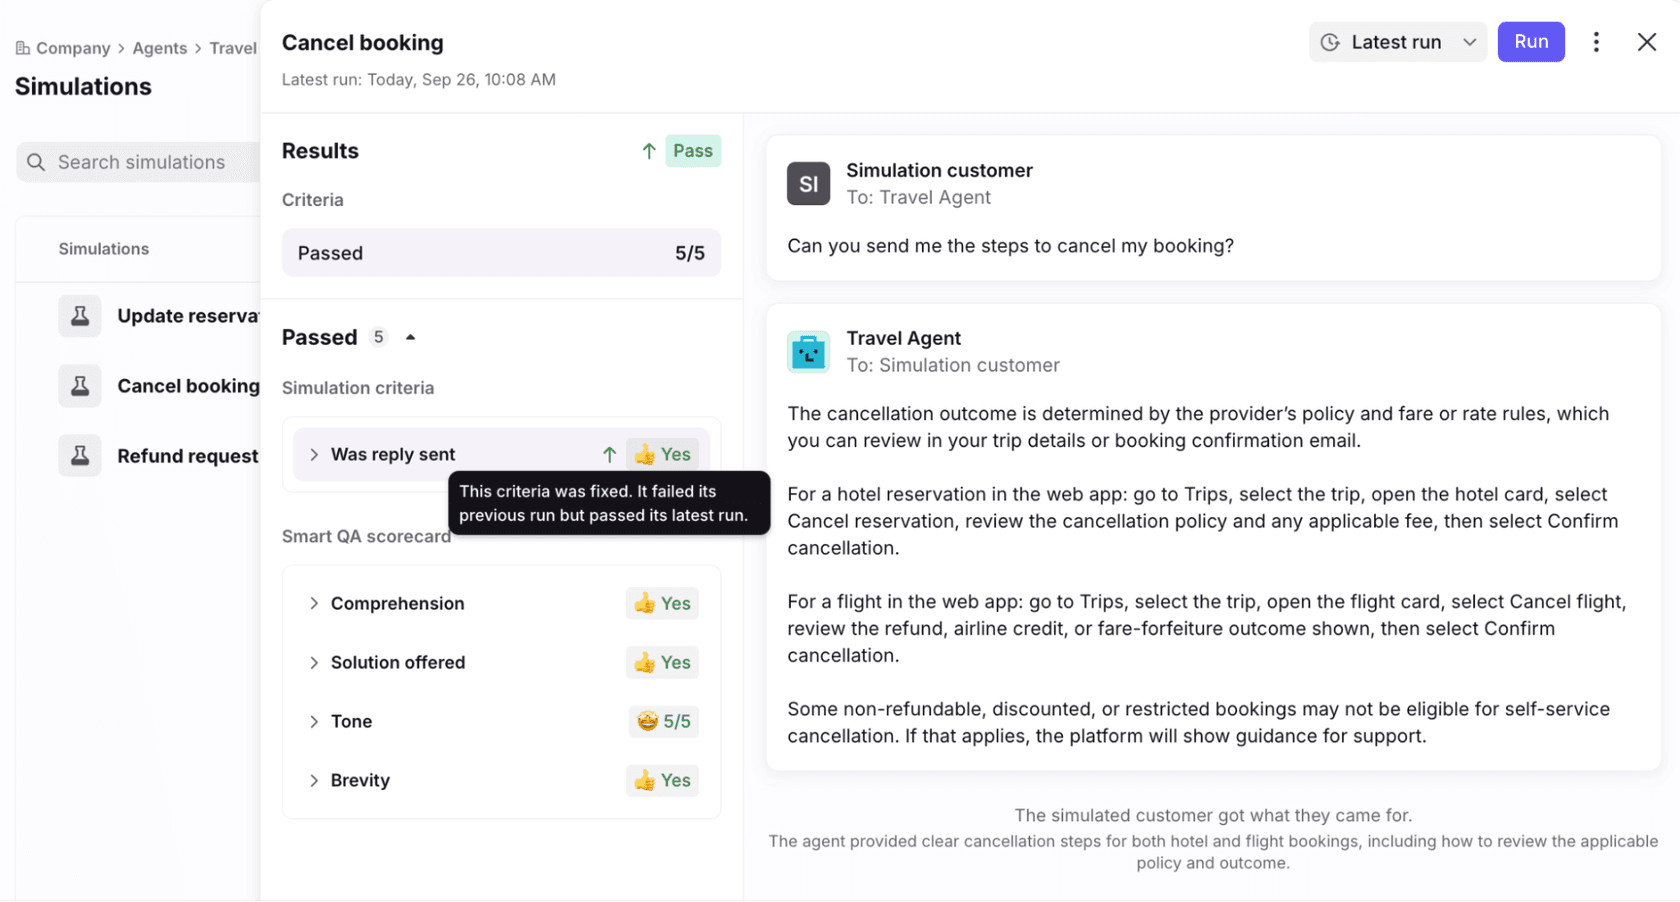
スクリーンショットでは、前回の実行で不合格だった基準が今回合格し、修正済みであることを示すツールチップが付いており、Smart QAスコアカードがその下に添付されています。これがFrontが想定しているループです。指示やナレッジを変更し、同じセットを再実行し、後退と修正の両方を見守ります。Smart QAは返信のみを評価するため、エージェントが正しく沈黙してエスカレーションした場合、スコアカードは適用されませんが、あなたの基準は適用されます。
エージェントが稼働した後、Compassは何を測定しますか?
Compassは各返信を「シグナルなし」「良い」「まあまあ」「悪い」のいずれかとして評価し、5つのシグナルから構成されます。Compass記事はそれらを次のように挙げています。
- Smart CSAT。 解決済みの会話内のAIの返信に対して自動的に実行され、満足度を推測します。人間のチームメイトはこの経路で評価されません。
- Smart QA。 解決から24時間後にAIの返信に対して実行され、デフォルトのスコアカードは簡潔さ、トーン、提示された解決策、理解度です。
- ドラフトの編集レベル。 AIのドラフトがそのまま送信されたか、軽く編集されたか、大きく編集されたか、破棄されたかを検出します。
- チームメイトからのフィードバック。 ドラフトや返信への高評価・低評価で、詳細は管理者のみが見られる任意項目です。
- 推測されたフィードバック。 FrontのAIが修正や大きな編集からシグナルを推測します。
Performanceタブはこれらを解決率やエンゲージメントの指標、Opportunitiesというリストとまとめています。Frontによると、これはエージェントがカバー範囲を広げたり、ドラフトから自動返信に移行したりするのに十分健全かどうか、そして最初に何を直すべきかを判断するのに役立つとされています。
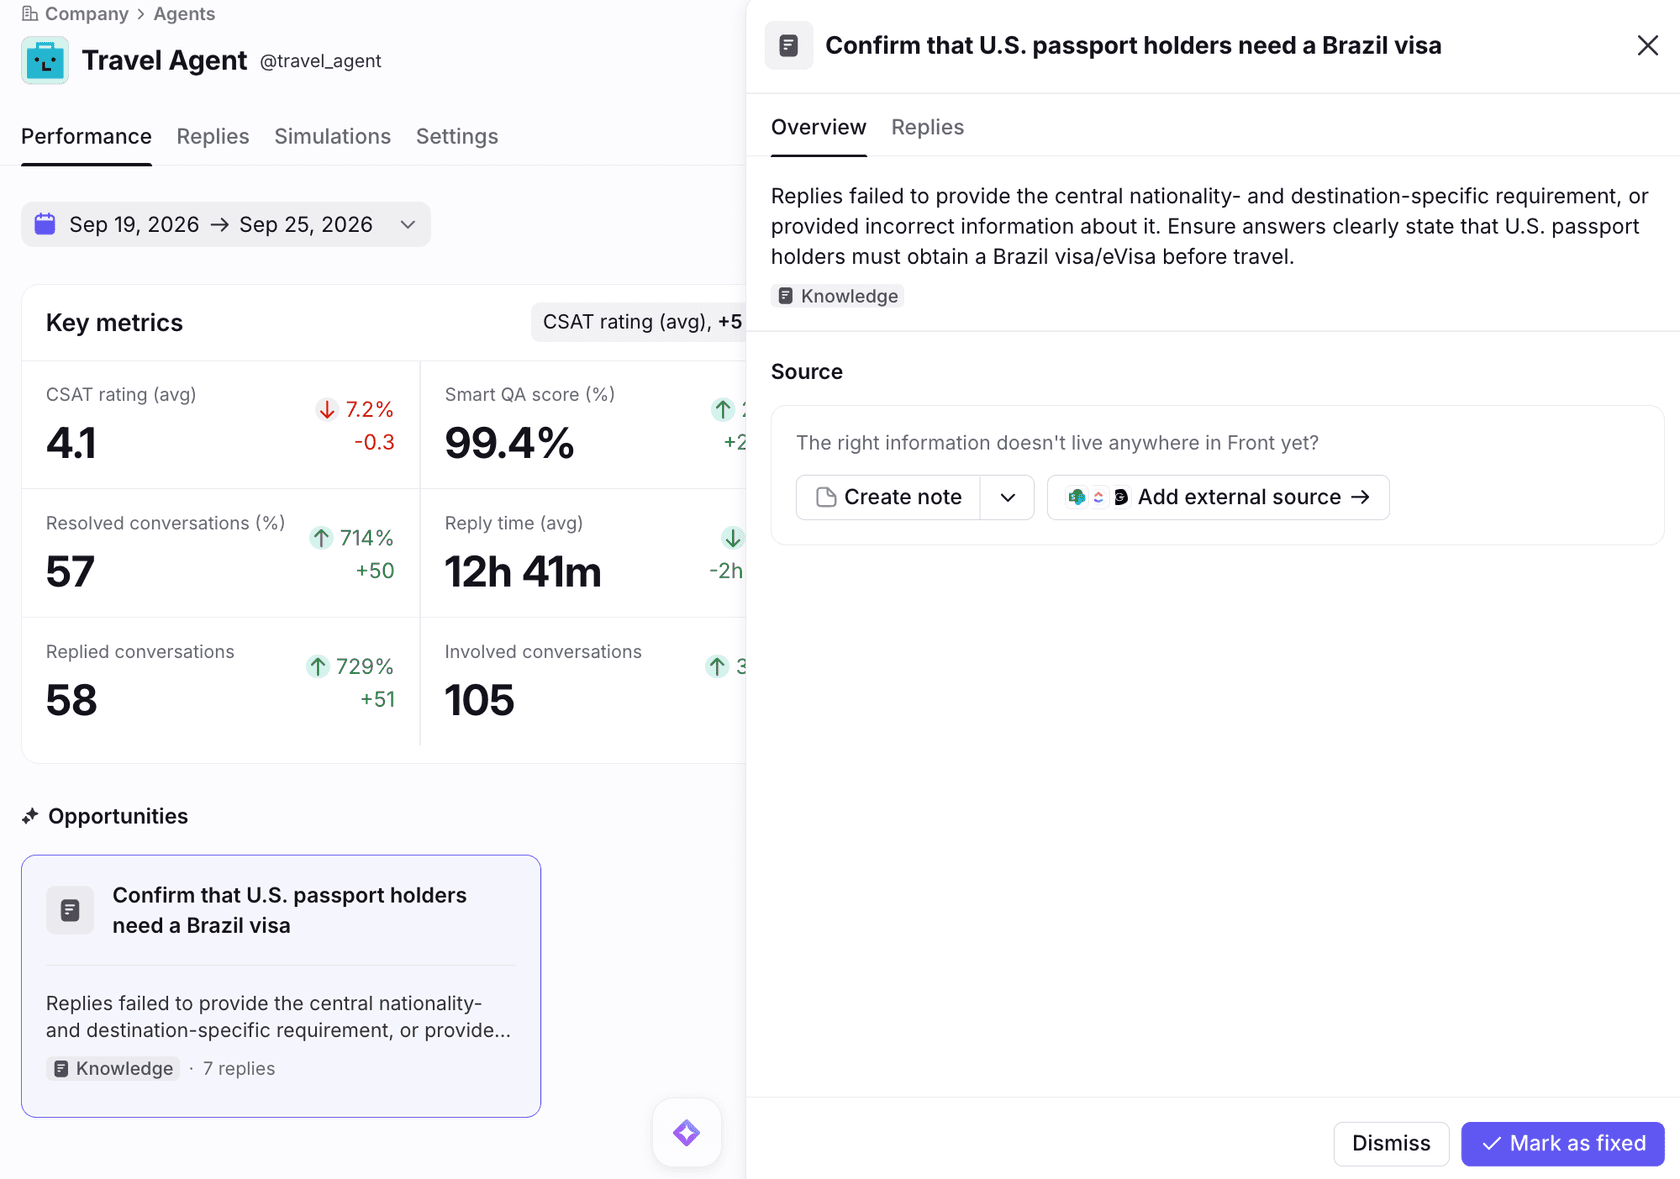
Opportunityには要約、ギャップの種類、影響を受ける返信の数が表示され、推奨される修正は通常ナレッジかエージェントの指示を指します。Frontの例では、ブラジルビザの要件に関する返信が間違っていて、パネルはノートの作成または外部ソースの追加を提案しています。Repliesタブは、受信箱、返信タイプ、トピック、シグナルでフィルタリングできるすべてのドラフトと自動返信を一覧表示し、それぞれの裏にあるソースを示します。CSATを主要な指標として重視するなら、ここでは推測値であることを忘れないでください。どこまで信頼すべきかは私のAI CSATの記事で扱っています。
FrontのSmart QAとSmart CSATの記事が境界線を定めています。カウントされるのは共有受信箱の会話のみで、それぞれ少なくとも1件の受信メッセージと1件の送信メッセージが必要で、会話はResolvedまたはArchivedでなければなりません。公式にサポートされる言語は英語のみです。ルールは遡及的ではないため、ルールが存在する前の履歴は採点されません。FrontはSmart QAについて事実内容で約99%の精度、Smart CSATについて顧客CSATとの一致が約90%と報告していますが、これらはFront自身の数字です。
ClaudeやSierraのような外部エージェントでも評価は機能しますか?
部分的にです。Frontのローンチ記事によると、Compassは、Autopilotまたは他のプロバイダー上のエージェントが処理するすべての会話を評価し、Compassは両方で無料です。Compass記事によると、エージェントのテストであるSimulationsタブはAutopilotエージェントのみが対象で、外部エージェントについてはRepliesタブのソースがMCPを通じて渡されたナレッジになります。つまり外部エージェントはライブ採点を受けますが、接続する前に自分のテストシステムでテストすることになります。Frontのローンチ記事は、Next Level Sportsという顧客の声を引用しており、CompassがサポートとエンジニアリングのチームにAIの返信を確認し品質を測るための一つの場所を与えてくれると述べています。
どのFrontツールがどの質問に答えますか?
答えたい質問を選ぶと、使うツールが変わります。このウィジェットはFrontの記事に対する私自身のまとめであり、各パネルの最後の行が詳細を読む場所です。
Rule testingは例外的な項目なので、これも挙げておきます。Frontのrule testing記事は、どのプランでも、会話がルールの条件とアクションを通過するかを確認でき、ゼロからシミュレーションされた会話を組み立てるオプションもあります。これはエージェントに会話を割り当てるルールに対して実行する価値があり、割り当ての制限については私のFront load balancingの記事で説明しています。
これらのツールでFrontのAIエージェントをどうロールアウトしますか?
ドラフトから始め、セットでテストし、シグナルが一致したときだけ範囲を広げます。FrontのAutopilotエージェント記事は、新しい会話にドラフトを作成するドラフト専用のエージェントについて説明しており、ドラフトのみのガイダンスと、Assign to AI agentテンプレートから作られたルールで設定されています。そこから:
- 15〜20件の会話のセットを作ります。 簡単な質問、返金依頼、怒っている顧客、エージェントが拒否すべき内容を混ぜます。Frontは多様なサンプルがより広いカバー範囲をもたらすとしており、私なら直近1か月の実際のトラフィックから引き出します。
- 3つの出発点となる基準を追加します。 行っていない行動を行ったと主張しない、必要なときにエスカレーションする、必要でないときにエスカレーションしない。
- 実行し、すべてのトランスクリプトを読み、修正し、再実行します。 指示やナレッジを変更するたびに、リグレッションの矢印を確認します。
- ドラフト専用エージェントとして稼働させます。 平均スコアだけでなく、Repliesタブでドラフトの編集レベルとチームメイトの評価を確認します。
- トピックを1つずつ自動返信に移行します。 Performanceタブと Opportunitiesリストを使って判断し、ルールと時間目標をスコアボードとして維持します。私のFront time goal rulesとSLA best practicesの記事がこの側面を扱っています。
引き継ぎの振る舞いには、それ自体の基準が必要です。エージェントがエスカレーションする場合、会話は文脈とともに正しい担当者に届く必要があり、これは私のAI agent handoff best practicesとAI escalationの記事で扱っています。グロッサリーにはescalation rateとAI guardrailsの項目があります。
AIエージェントの評価について、Frontのドキュメントが言っていないことは何ですか?
かなりあります。それぞれのギャップは、信頼する前にFrontに尋ねるかテストすべきことです。
- AIの返信に対するSmart QAのプラン制限。 ある記事ではEnterpriseに含まれるとされ、別の記事では自動的に有効化されるとされており、AutopilotつきのProfessional顧客についてこれを整合させるページはありません。
- シミュレーションがライブのシステムを呼び出すかどうか。 バリデーターはコネクタの呼び出しを見られますが、ドキュメントはシミュレーションされた実行が実際のツールかサンドボックス化されたツールに触れるかどうかを述べていません。
- 合格の基準値。 「多様なサンプルを使う」以上の、推奨される合格率やセットサイズはありません。
- チームが実際に送った内容との比較。 基準は振る舞いを記述します。記事は、その会話で人が実際に書いた返信に対する採点については説明していません。
- Compassにおける言語。 Compass記事はこれについて何も述べていません。Smart QAとSmart CSATの記事は、公式にサポートされるのは英語のみだとしています。
- エクスポートやAPIアクセス。 シミュレーション結果のエクスポートや、APIを介したセットの実行についての記載は見つかりませんでした。
- 外部の声。 私が読んだ時点で、コミュニティ内のFrontのCompassに関する投稿は返信0件、閲覧122件で、引用できる実務者のレビューはまだありません。
これらはCompassを弱いツールにするものではありません。バリデーター、実行履歴、リグレッションの矢印を備えた基準ベースのシミュレーターは、本物のテストシステムです。これは履歴を再生するという設計とは異なるものであり、次に私が気にする比較はそちらです。
eeselはFrontの顧客に返信する前にAIエージェントをどうテストしますか?
eeselはあなた自身の過去の会話に対してテストし、Frontはあなたが書いた基準に対してテストします。この2つは補完的であり、それだけで片方を選ぶことはしません。eeselのシミュレーションは送信をオフにしたまま過去のチケットを再生し、それぞれに対して返信を作成し、チームが実際に送った内容と比較し、テーマ別に結果をグループ化し、影響度で修正の優先順位をつけます。レポートは、一致、部分的な不一致、正しい引き継ぎ、明確な不一致を分けています。eesel自身のドキュメントの例では、解決済みの20件のチケットのうち17件がチームの返信品質と一致しています。
| Front Compassのシミュレーション | eeselのシミュレーション | |
|---|---|---|
| テスト対象 | あなたが書いた基準に対する振る舞い | チームが実際に送った内容に対する回答 |
| テストの入力 | 受信箱からの会話ID | 過去のチケット、またはヘルプデスクなしで生成されたケース |
| 顧客側 | シミュレーションされた顧客、最大10往復 | 過去のチケットごとに1件の作成された返信 |
| 対象 | Autopilotエージェントのみ | eeselエージェント |
| 顧客への送信 | なし | なし |
| 実行後 | セットを再実行し、矢印を読む | 修正を平易な文のルールとして保存し、再実行する |
Frontの複数ターンのシミュレーションされた顧客は、eeselのリプレイが再現していないものであり、eesel自身のシミュレーションのページでは、AIが演じるペルソナを使った複数ターンのチャットはヘルプデスク自体のシミュレーターで対応するほうが向いていると述べています。逆に、Frontの記事は回答を基準となる返信と比較することを説明していませんが、これは履歴を再生することが役立つ部分です。
私にとって得られた部分はロールアウトの順序です。eeselは何年もライブのサポートキューでAIを稼働させており、定着している習慣は、そのチーム自身の履歴に対して再生され、その後1〜2週間ライブのチケット上でドラフトとして作成されるまで、何も顧客には返信しないということです。ドイツのフェリー会社Norden-Frisiaは、契約前に過去3か月分のチケットとマクロでトライアル週を使いました。Textlaは、eeselが内部ノートだけを残すトライアルから始め、チームが何を言っていたはずかを確認できるようにしました。Innrは今もすべてのドラフトを確認しており、選ばれたトピックの集合について自律的な返信に向けて取り組んでいます。この3社のいずれもFrontを使っていないため、他のヘルプデスクでの同じ手法として読んでください。
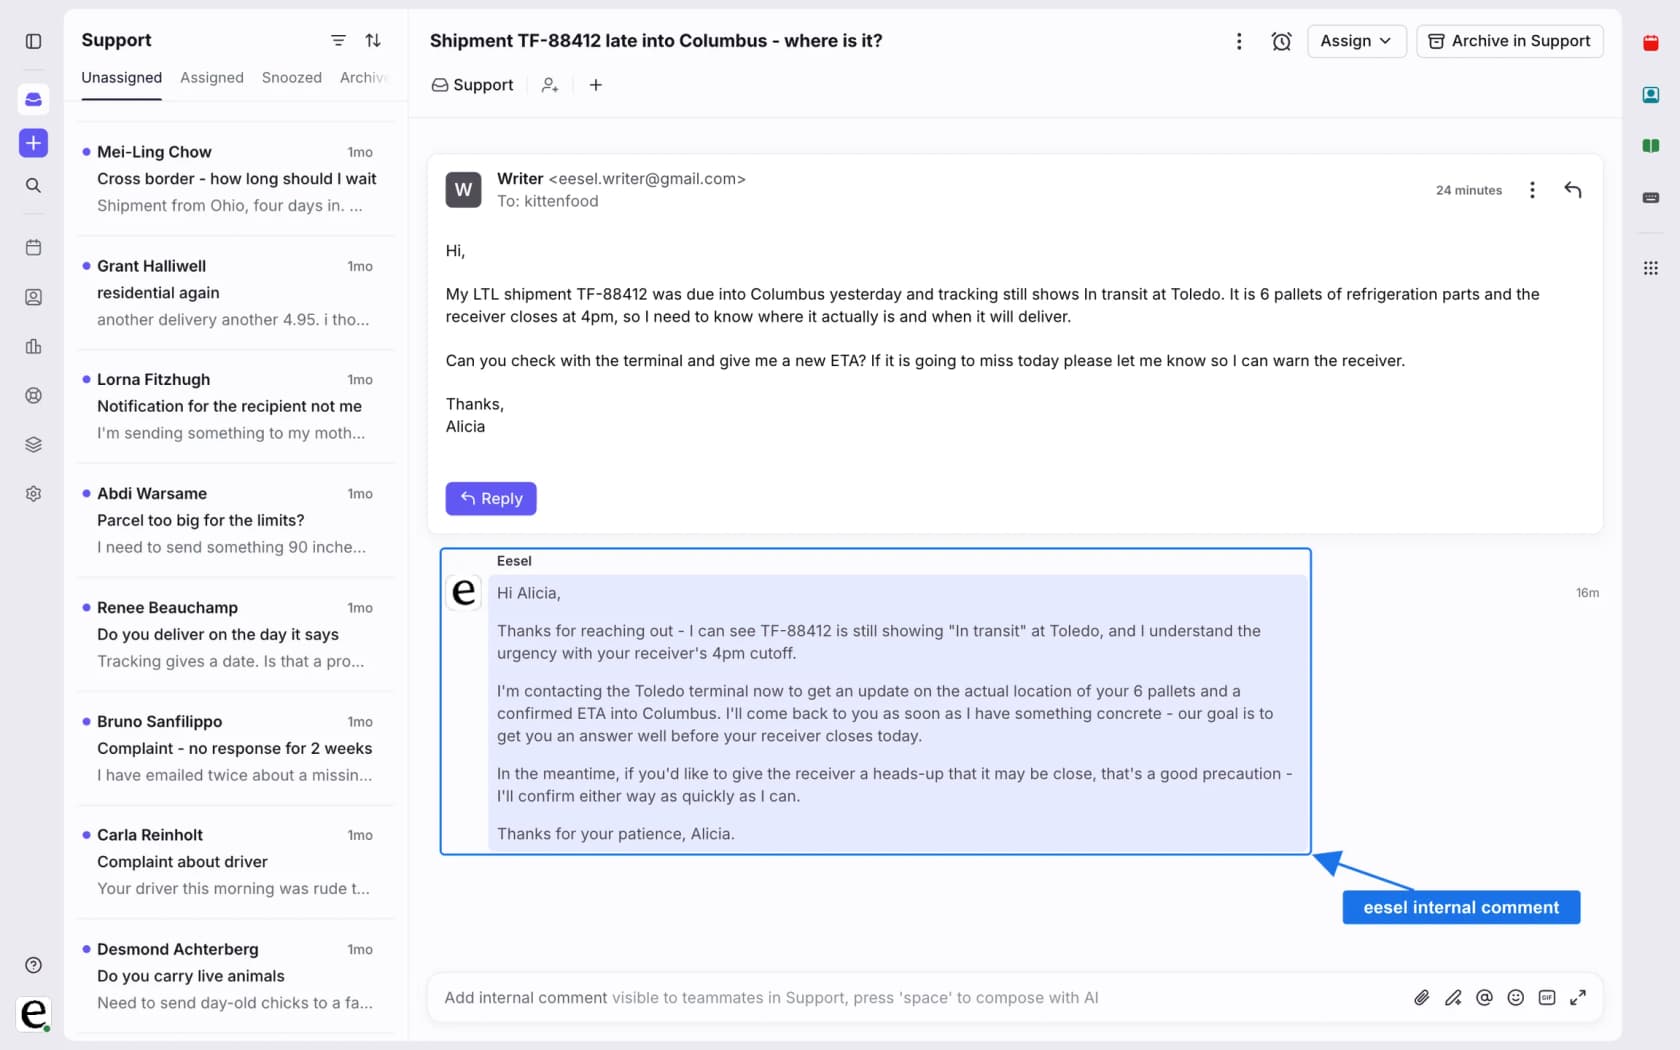
Frontでは、eeselの連携ドキュメントが、顧客からのメッセージ、最初のメッセージ、@eeselへのメンション、アーカイブされた会話に対するトリガーを挙げ、返信、内部コメントの追加、タグ付け、担当割り当て、フィールドの更新、アーカイブといったアクションがあります。ドキュメントは内部コメントから始めることを推奨しており、Front固有のシミュレーションについては説明していないため、私なら小さなバッチでリプレイを実行し、レポートを読みます。CLIはそのループを助けます。eesel files upload ./refund-policy.pdfは承認済みの知識を追加し、eesel chat "what's our refund policy?"は回答をテストし、eesel approvalsは保留中のアクションを一覧表示し、--dry-runは書き込みのプレビューを表示します。CLIのドキュメントはシミュレーションについて触れていないため、それらはダッシュボードで実行されます。
あなたのFrontの受信箱でeeselを試す
このプロセスのリプレイ優先版を望むなら、eeselはあなたの共有Front受信箱にAIヘルプデスクチームメイトとして参加します。ヘルプセンターと過去の会話を読み、内部コメントとして返信を作成し、タグ付けや担当割り当てもできるため、何かが送信される前にチームが実際のドラフトを確認できます。自分自身の履歴に対してシミュレーションを実行し、ルールと時間目標をスコアボードとして維持し、ドラフトが人が書く内容と一致するようになったら直接返信に範囲を広げてください。有料プランは500クレジットで月299ドルからで、100クレジットの無料プランもあり、いくつかの実際の会話で試すことができます(eeselの料金)。
セットアップについては、私のガイドadding AI to Front、まとめbest AI for Front、そしてFront vs eeselをご覧ください。ツールの比較には、私のFront reviewとFront alternativesをご覧ください。Frontのセットアップの残りの部分については、Front ticket status rules、Front shared inbox ownership、Front required resolution fieldsがエージェントの作業がどこに行き着くかを示しており、グロッサリーではshared inbox、support quality assurance、resolution rateを解説しています。決める前に、いくつかの実際の会話でTry eeselしてみてください。