

AIサポートのシミュレーションテストとは、チームがすでに解決したチケットを、送信をオフにしたままAIエージェントに通して再現し、顧客が一件でも目にする前にすべての回答を採点することです。スコアの価値は、3つの要素で決まります。トピックごとに何件再現したか、何を基準に採点したか、そしてテストが実際のシステムに触れ得たかどうかです。20件で一致率85%という結果は、実際には64%から95%のどこにでもなり得ます。トピックごとに読み、小規模な実行は判決ではなく最初の確認として扱ってください。
私が調べたヘルプデスクのうち、自社の解決済みチケットを再現できるのはFreshdeskのメールエージェントとeeselだけでした。Zendeskのシミュレーターは架空のシナリオを実行し、HubSpotは過去の会話のテーマから質問を生成し、Salesforceはテストケースを生成またはアップロードし、Gorgiasは1回に1つの会話をテストします。
私が見た中で最も役に立った実行は、実際のECの受信箱で行った100件のクロスチェックです。方向性は88%正しかったものの、修正なしでそのまま送れた下書きは12%にとどまり、7%に事実の誤りがありました。同じ実行から、3つの正直なスコアが出たのです。だから私はどの導入も、シミュレーションを行い、そのあと本番チケットで下書きを行う期間から始めます。eeselはその両方に対応しており、Norden-Frisiaは自社の過去チケットで試用期間を1週間行い、数日以内に契約しました。
AIサポートのシミュレーションテストとは?
AIサポートのシミュレーションテストは、現実的な顧客メッセージに対するAIエージェントの予行演習で、すべての返信は送信されず、記録されて採点されます。本番前に次の問いに答えるものです。もしこのエージェントが先月あなたのキューを担当していたら、その回答のうち何件を喜んで送れたでしょうか。
シミュレーションに入力を与える方法は3つあり、それぞれ捉えるものが違います。
| シミュレーションの種類 | テストメッセージの出どころ | 捉えられるもの | 見落とすもの |
|---|---|---|---|
| 過去チケットの再現 | 自社ヘルプデスクの解決済みチケット(顧客自身の言葉) | 実際の言い回し、実際のトピック構成、ナレッジベースの穴 | まだ見ていない新しい問題、複数メッセージにわたる反論 |
| 生成されたシナリオ | AIがドキュメント、トピック、プロンプトから顧客メッセージを作成 | 履歴の少ないトピックのカバー、自分で指定したエッジケース | 顧客が実際にどう言うか、各トピックの本当の割合 |
| 手書きのテストセット | あなたやチームが手書きした質問 | 既知のリスク:返金、法務、プロンプトインジェクション | 誰も書き留めようと思わなかったこと |
私は常に再現から始めます。顧客が実際に送る内容から作られている唯一の方法だからです。生成テストや手書きテストは、再現が残す穴を埋めます。特に、頻度が低くてサンプルに出てこないリスクの高いトピックで役立ちます。以前のAIサポートエージェントのテストガイドでは3つすべてを4段階の導入計画にまとめており、導入前チェックリストでは引き継ぎ、アクション、停止スイッチを扱っています。この記事ではシミュレーションそのものを深掘りし、実施方法と得られたスコアの読み方を説明します。
良いシミュレーションスコアでも誤解を招くのはなぜ?
私はeeselにチケット履歴を取り込む連携を作っているので、再現が実際に何を読んでいるかを見る機会が多くあります。何度も学び直す教訓は、「85%合格」は、「合格」が何を意味したかがわかるまで何の意味も持たないということです。
TL;DRの100件のクロスチェックは、私が持つ最もわかりやすい例です。月に約1,000件のチケットがある実際のECの受信箱での試験でした。振り分けの精度は93%、スパム検出は100%。下書きは88%の割合で正しい方向を向いていました。しかし、書かれたとおりそのまま送れたのは12%だけで、7%に事実の誤りがありました。書き直しのうち約65%は長さとトーンの問題で、チーム自身の送信済み返信から学習すれば直せるものでした。エージェントが事実を誤っていたのは約5%にすぎません。「88%」で止めていたら、見えていない7%の誤り率のまま本番投入することになったでしょう。顧客があなたより先に見つける、静かなAIのハルシネーションです。
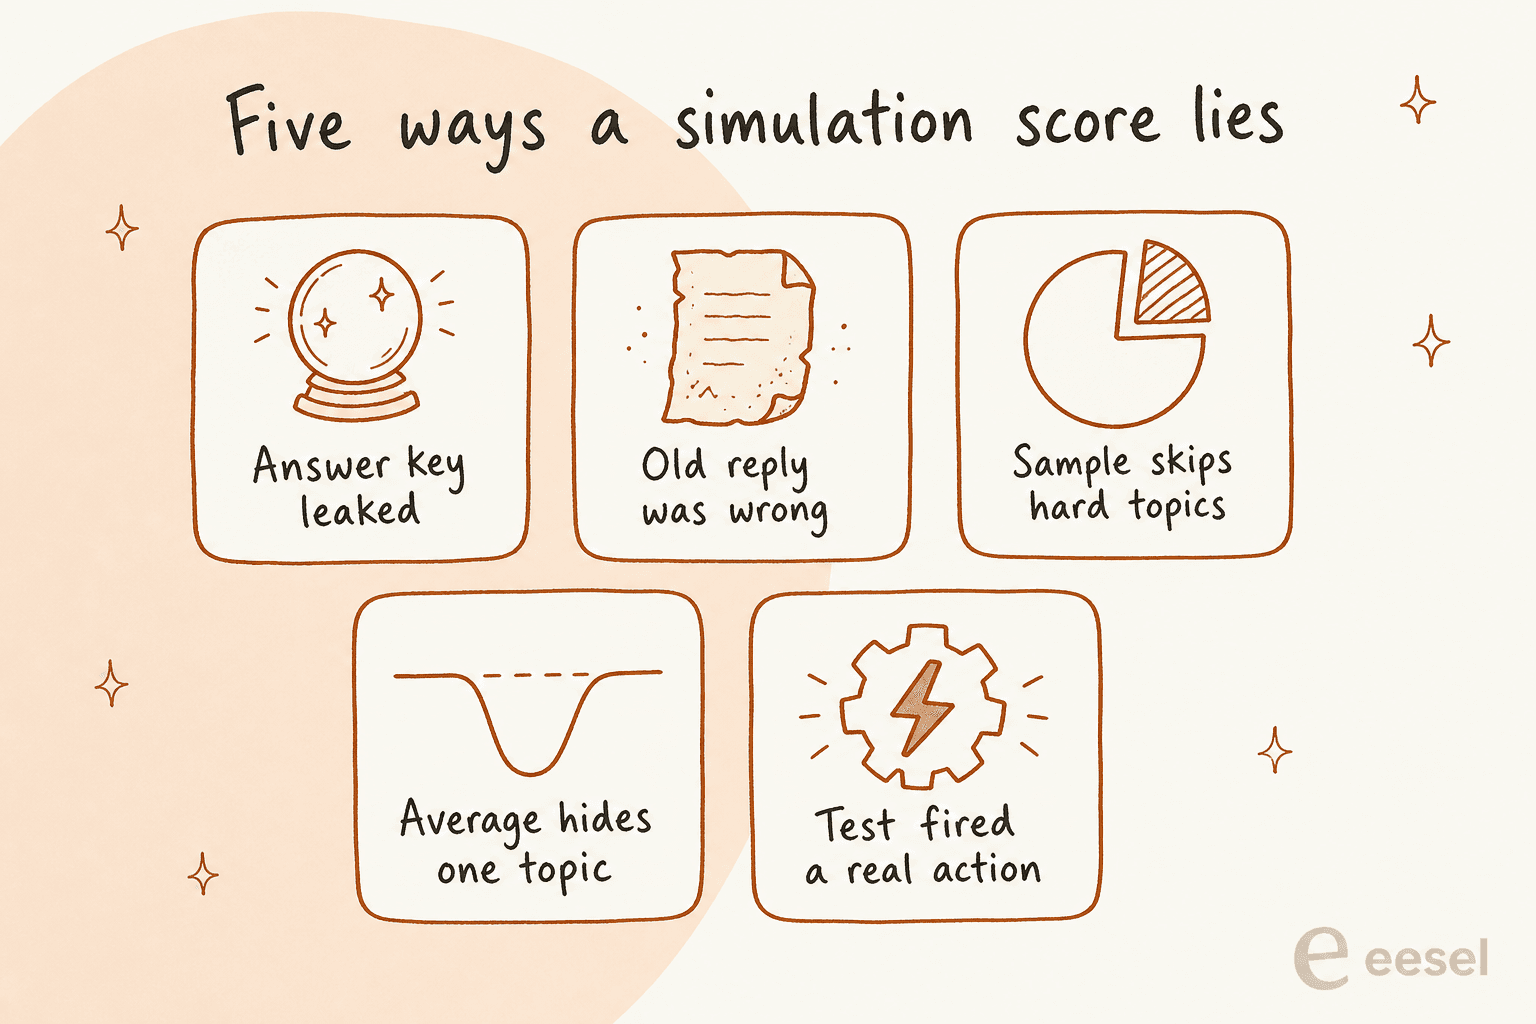
シミュレーションのスコアが本番当日の姿から離れていくのを、私は次の5つの形で見てきました。
- 正解が漏れた。 テスト対象のチケットそのもの、またはそのチケットが解決した後に書かれたマクロをエージェントが読めるなら、答えを手に自己採点しているのと同じです。エージェントが学習していないチケットを選ぶか、テスト中はそのチケットソースをオフにしてください。
- 古い返信が間違っていた。 チームが送った内容に合わせるのは良い初期設定ですが、その返信の中には、すでに変更したポリシーを使ったものや、単なるミスもあります。今日のポリシーで採点し、古くなったチケットでの「不一致」は合格として扱ってください。
- サンプルが難しいトピックを飛ばす。 落ち着いた2週間の最近の20件には、返金トラブルが1件もないかもしれません。サンプルはトピックごとに埋め、まれでリスクの高いものには手書きのケースを加えてください。
- 平均が1つのトピックを隠す。 全体で90%でも、毎回失敗するトピックが1つ潜んでいることがあります。Redditのコメント投稿者がうまく言っています。「A clean average can still hide one common path that fails every time」(u/Bitter_Big4525)。
- テストが実際のアクションを実行した。 送信されない返信は安全です。テスト中に実行された返金、キャンセル、CRM更新はそうではありません。これについては下のステップ3でさらに説明します。
"the biggest failure i've seen was an agent that kept pulling data from the wrong user's account because the session token wasn't being passed correctly to the api call, the text responses looked perfect so nobody caught it until a customer complained about seeing someone else's balance"

この最後の例が、シミュレーションはエージェントが何と言ったかだけでなく、何をしたかを見なければならない理由です。
AIサポートのシミュレーションには何件のチケットが必要?
最初の確認なら20件で十分です。トピックの本番投入を判断するなら、そのトピックで100件に近い数がほしいところです。小規模な実行では、スコアの誤差の幅が非常に大きくなるからです。
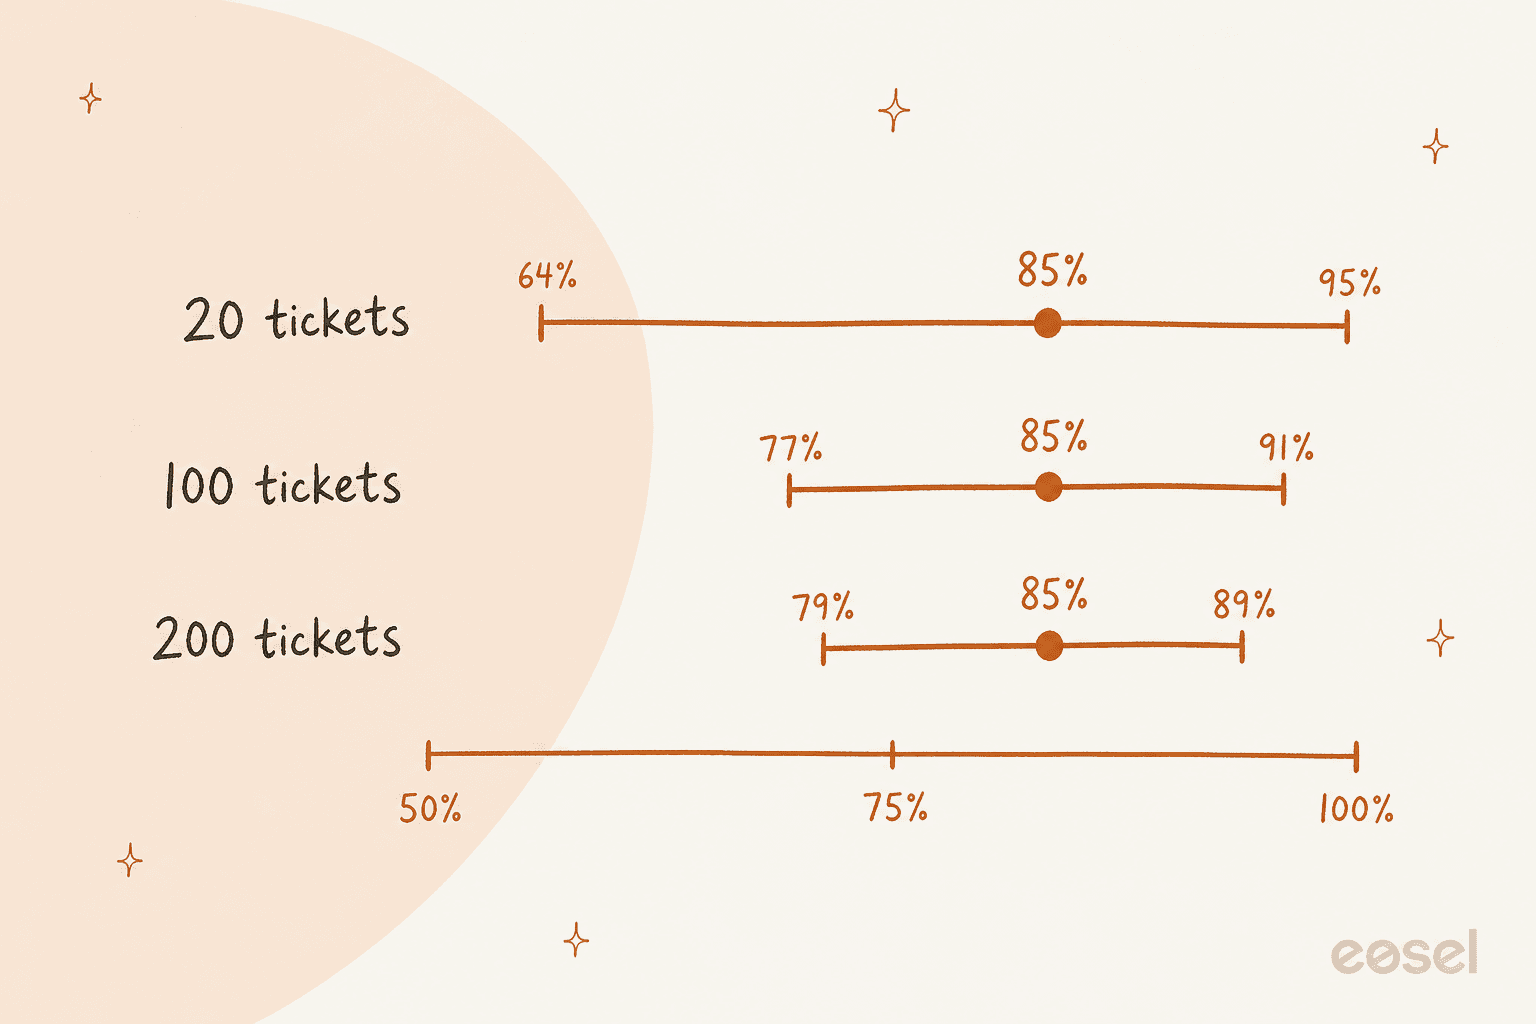
同じ85%のスコアを、3つのサンプルサイズで、標準的な95%信頼区間(検算したい場合のためにWilson区間です)を使って示します。
| 再現したチケット数 | 合格数 | スコア | 本当の率はおそらくこの範囲 |
|---|---|---|---|
| 20 | 17 | 85% | 64%〜95% |
| 50 | 42 | 84% | 72%〜92% |
| 100 | 85 | 85% | 77%〜91% |
| 200 | 170 | 85% | 79%〜89% |
| 20 | 20 | 100% | 84%〜100% |
注目すべき点が2つあります。20件中17件という結果では、65%のエージェントなのか95%のエージェントなのか判断できません。そして20件中20件の満点でも、本当の失敗率はおそらく約16%未満、ということしかわかりません。初回の実行としては素晴らしい兆候ですが、トピックを完全な自動運転に切り替えるには足りません。
対処は簡単です。シミュレーションをトピックごとに実行し、自動化したいトピックには、範囲の下限があなたの基準を超えるまでチケットを追加し続けます。ご自身の数字をここに入れてみてください。
月に数件しかチケットが来ないトピックでは、どちらとも証明できるだけの履歴がありません。小規模な実行の結果がどれだけ良く見えても、そのトピックは自動運転ではなく、下書きか人への引き継ぎにすべきです。
信頼できるAIサポートのシミュレーションはどう実施する?
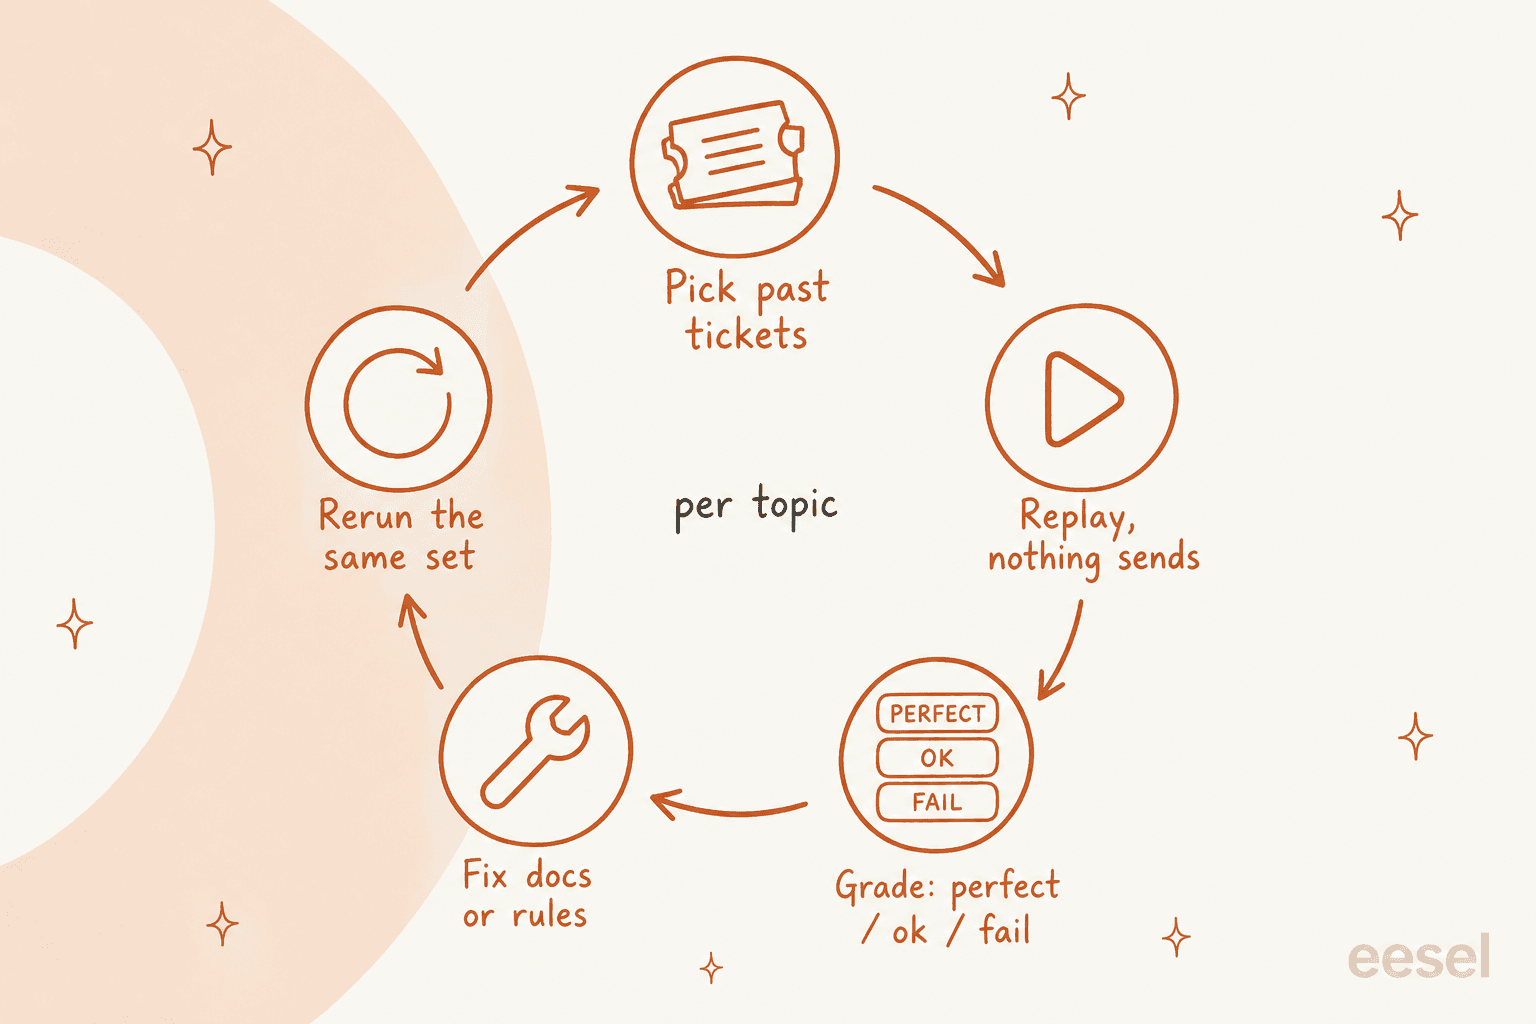
6つのステップを、この順番で行います。ヘルプデスク組み込みのテスター、スプレッドシート、専用のAIヘルプデスクエージェントのどれを使っても同じように機能します。最初の1回は午後いっぱい、その後の再実行はそれぞれ数分で終わります。
ステップ1:トピックごとにチケットを選ぶ
現在の製品やポリシーを反映するよう、直近2〜3か月の解決済みチケットを取得します。トピックごとにグループ化し(ヘルプデスクのタグやチケットフィールドで通常は足ります)、各トピックから届く頻度に近い割合で抽出します。そのうえで、まれでリスクの高いケース用に、少数の手書きセットを加えます。期限を過ぎた返金、上司を求める顧客、エージェントのルールを上書きしようとするメッセージ、ドキュメントにまったく答えがない質問などです。
最後の種類は、見た目以上に重要です。eeselの顧客履歴で見た初期の最悪の失敗のいくつかは、ナレッジベースに関連情報がないときにボットが答えをでっち上げたものでした。答えのない質問を含まないテストセットでは、これを捉えられません。これがサポートでのハルシネーション防止の核心です。
"The one that worried me most was refund amounts. I ran AI models through support emails with a written refund policy, and 7 of them promised the wrong amount on the same email. The reply reads polite and confident, so nobody catches it until the customer quotes it back. On the easy emails they all looked great. It only showed up on hard emails I wrote and held back."
ステップ2:エージェントの知識を固定し、漏れがないか確認する
エージェントには、初日に使うのと同じヘルプセンター、マクロ、指示だけを参照させ、それ以外は与えません。すべての回答は、示せる情報源に根拠づけられているべきで、採点者がその出どころを確認できるようにします。次に、再現するチケットと、その回答のために書かれたものが、エージェントの知識の中に入っていないことを確認します。エージェントが過去のチケットから学習する場合は、学習していないチケットを選ぶか、テスト実行ではそのソースを除外してください。
ステップ3:書き込みを行うアクションをすべてオフにする
送信をオフにしたら、次にアクションを確認します。これが自動ではないことは、各ベンダーがはっきり述べています。
- Gorgiasは、エージェントがテスト会話でアクションを使うと"it can affect real customer and order data (like cancelling an order)"と警告し、架空の顧客プロフィールを使うことを勧めています(Gorgiasのドキュメント)。
- Salesforceは"Testing agents can modify CRM data"とし、Testing Centerはサンドボックスでのみ実行するよう伝えています。
- HubSpotのテストパネルは、テスト中に"any records that were created or updated"を表示するようになりました(HubSpotのドキュメント)。
私のルールはこうです。シミュレーションでは、エージェントは本番で読むものをすべて読んでよく、何も書き込んではいけません。返金アクションをテストしたいなら、架空の注文に対して別途テストし、本番に出す際は承認付きのアクションで採点してください。
ステップ4:3段階に「絶対NG」の枠を加えて採点する
合格・不合格だけの採点では、最も有用な情報が捨てられてしまいます。私はすべての回答を次のいずれかで採点します。
- 完璧: そのまま送れる。
- 許容: 答えは正しいが、長さやトーンの軽い修正が必要。
- 不合格: 間違っている、不完全、または引き継ぐべきなのに引き継がなかった。
そのうえで、平均に関係なく本番投入を止める失敗用に、別枠の「絶対NG」を設けます。作り話のポリシー、ポリシー上許されない返金の約束、他の顧客のデータ、法務や安全に関わるチケットでの引き継ぎ漏れなどです。あるRedditのコメント投稿者は、自分の区分を「annoying」「bad」「burn it down」と表現し、burn it downの区分は"has to be zero or we don't ship"だと述べています(u/Evening_Event4634)。
最初の採点をAI採点者に任せるのは問題なく、今ではほとんどのツールがそうしています。Salesforceは各返信を期待される回答と比較する"LLM judge"を使っていますが、そのSalesforceでさえ、品質スコアは"are not absolute measures of success or failure"だと述べています(Salesforce)。私は、すべての不合格、「絶対NG」の候補、合格のランダムな一部を人に読ませます。これにより、採点者が最も弱いところに人の目が入ります。OpenAIの評価のベストプラクティスも、モデルによる採点を人と突き合わせて確認することについて同じことを述べています。これはQAキャリブレーションのセッションと同じ習慣で、対象がエージェントに向いているだけです。
ステップ5:結果をトピックごとに読み、トピックごとに判断する
ここで、実行結果が展開計画に変わります。各トピックについて、次の3つのうち1つを決めます。
| トピックの結果の状態 | 私ならこうする |
|---|---|
| 範囲の下限が基準を超え、「絶対NG」の失敗がゼロ | 本番チケットでの1週間の下書きを経て、単独返信の候補にする |
| ほぼ完璧か許容で、理由のわかる少数の不合格 | 人が送る下書きにして、原因を直し、再実行する |
| 不合格が多い、または「絶対NG」の失敗が1件でもある | 人に引き継ぎ、まずドキュメントやルールを直す |
一度にではなくトピックごとに本番投入するのが、eeselの顧客の大半が取っている方法です。Rúngneは、どれに直接回答し、どれに下書きを付けるかを決めるトピック一覧を持っており、トピックの移動は一覧の編集だけで済みます。smavaは、月27,000件のチケットのうち約1,100件を自動返信の対象とし、残りは下書きにしています。
ステップ6:直して、同じチケットを再実行する
トピックが失敗するとき、原因は多くの場合、欠けている、または曖昧なヘルプ記事、緩すぎる指示、作動しない引き継ぎルールです。変更を加えたら、まったく同じセットを再実行して比較します。すでに合格したチケットもセットに残してください。あるトピックの修正が、別のトピックを気づかないうちに壊すことがあるからです。モデル、指示、信頼度のしきい値、ナレッジベースの大きな部分を変えたときは、そのたびに再実行します。「小さな変更」の後に再実行を省くのは、私が最もよく目にする導入ミスの一つです。
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
過去チケットでAIエージェントをシミュレーションできるヘルプデスクはどれ?
今ではほとんどのAIエージェントに何らかのテスト実行機能がありますが、「シミュレーション」が指す内容は大きく異なります。ツールを選ぶなら、これをベンダー評価チェックリストに加える価値があります。私は2026年10月30日に、各ベンダーのヘルプセンターを確認しました。
| ツール | 実際の過去チケットを再現できる? | テスト入力 | 1回の実行の上限 | 回答の採点方法 | テストが実データに触れる可能性は? | 実行の保存 |
|---|---|---|---|---|---|---|
| Zendeskの会話シミュレーター(アーリーアクセス) | いいえ、架空データのみ | 自分で書く、またはAIが生成する顧客プロフィールとシナリオ | 記載なし | 会話ごとのステータス、解決の見積もり | 記載なし。テスト用ウィジェットはCRMアクションをスキップ | バージョン管理されたシナリオ、実行履歴 |
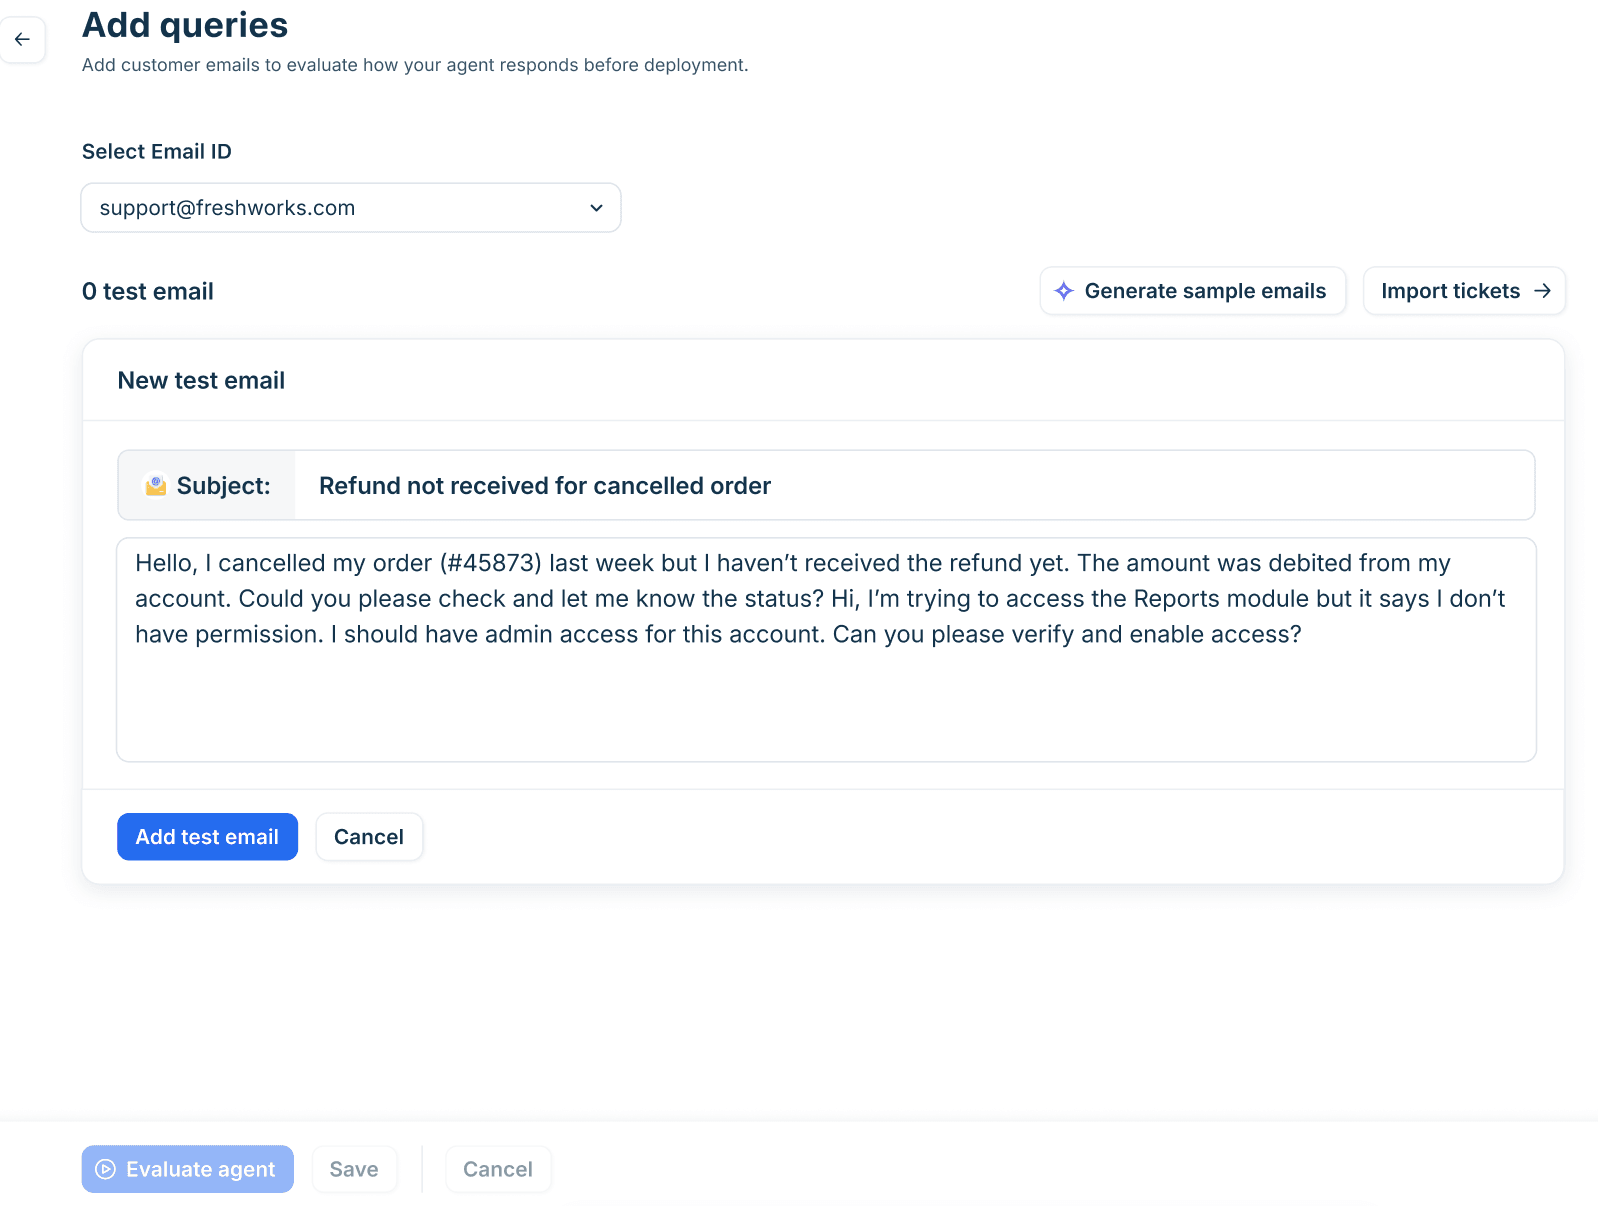
| FreshdeskのメールAIエージェント | はい、解決済みチケット | 取り込んだチケット、入力または生成したメール | 50 | Answered、Unanswered、Error、加えて自分の評価 | ワークフローは作動。本番かどうかは記載なし | はい |
| FreshdeskのチャットAIエージェント | いいえ | 入力または生成した質問 | 100 | AnsweredかUnanswered、加えて自分の評価 | 記載なし | はい |
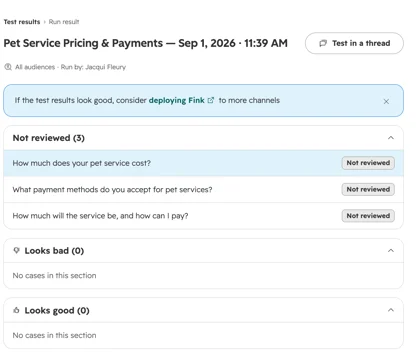
| HubSpotのカスタマーエージェント | いいえ、過去の会話のテーマから質問を生成 | 生成または入力した質問 | 8つのテストセット | Looks goodかLooks badを自分でマーク | レコードが作成または更新され得る | はい |
| Gorgias AI Agent | 既存のチケットを1件ずつ | 入力したメッセージ、または過去チケット1件 | 1会話 | スコアなし。推論の内容を自分で読む | はい、アクションがオンの場合 | いいえ |
| Salesforce Agentforce Testing Center | いいえ | トピック、アクション、ナレッジから生成、またはCSVアップロード | 生成100、CSVあたり1,000 | 期待される回答に対するAI採点、0〜5の品質スコア | はい、サンドボックス推奨 | はい |
| Atlassian Customer Service Management | 記載なし | 質問のデータセット | 記載なし | 解決か否か、人がレビュー | 記載なし | はい |
| eesel | はい、解決済みチケット | 過去チケット、またはヘルプデスクなしで生成したケース | ドキュメントの例:20チケット | チームが送った内容と比較し、テーマごとにグループ化 | いいえ、"It sends nothing to customers" | はい、スケジュール実行も可 |
それぞれについて、知っておくと良い点をいくつか挙げます。
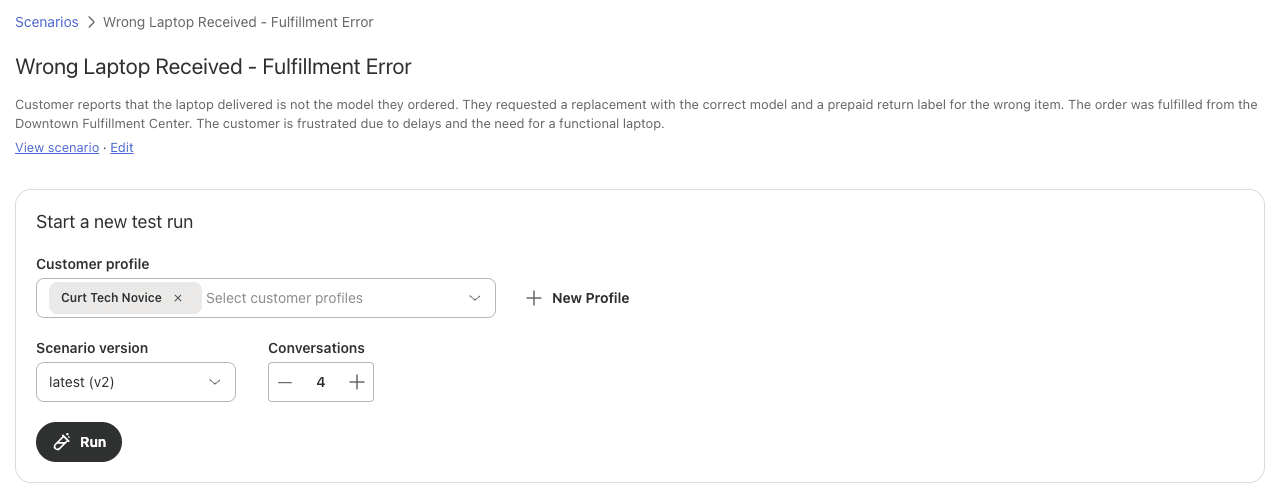
Zendesk。 会話シミュレーターはアーリーアクセスプログラムの段階にあり、メッセージング用のAIエージェントでしか動作しません。シナリオ(背景、最初の問題、期待する結果、モック値)を書き、顧客プロフィールを選ぶと、AIが顧客を演じます。Zendeskはこれを"designed for testing with fictional data"としており、複数メッセージのチャットには強く、「先月ならどう対応したか」には弱いと言えます。ここでのテストは自動解決数を消費しないので、Zendeskの解決ごとの課金では重要です。本番後は、会話ログとZendesk QAが採点を引き継ぎます。
Freshdesk。 メールエージェントのEvaluateステップは、組み込みの機能の中で実際の再現に最も近いものです。"Import tickets to use solved historical tickets"で、最大"50 queries per evaluation run"まで取り込めます(Freshdesk)。Freshdesk自身の目安は"at least 20 representative queries before deploying"で、上の表からすると、私はこれを下限として扱います。スコアはエージェントが答えたかどうかであり、担当者が送った内容と回答が一致したかではないので、結局1件ずつ読むことになります。Freshdesk Omni Growth、Pro、Enterpriseで利用でき、完全に分離したコピーが必要ならサンドボックスもあります。
HubSpot。 バッチテストは"generate them from existing customer conversations"できますが、これはテーマごとに一般的な質問を作るという意味で、テーマとして表示されるには"5 or more conversations on a similar topic"が必要です。採点は手動で1回答ずつ行い、テストセットは再実行用に保存されます。テストでHubSpotクレジットは消費されません。
Gorgias。 Playgroundでは"an existing ticket"を再実行でき、Gorgiasはこれを"re-simulating a conversation where AI Agent did not initially respond as expected"の用途として紹介しています(Gorgias)。1件のチケットで修正を確認するには最適ですが、バッチ実行はないため、100件にわたるスコアは得られません。Gorgiasはむしろ本番でのレビューを重視しており、導入ガイドでは最初の週に"at least 10 tickets"をレビューするよう求めています。
SalesforceとAtlassian。 Agentforce Testing Centerは、このグループの中で最も詳細な採点を備えています。正しいトピックとアクションが選ばれたかの確認に加え、AI採点者とオプションの品質スコアラーがあり、エージェント用アドオンライセンス付きのEnterprise、Performance、Unlimited、Developerの各エディションで使えます(Agentforceの料金を参照)。ただし過去のケースは再現せず、テストを生成するかCSVをアップロードします。Atlassianの評価はもっと単純で、質問のデータセットを使い、それぞれを解決か否かでマークし、修正のたびに再実行します。
Zendesk、Gorgias、HubSpotを使っていて、実際に解決したチケットの再現がしたい場合、その穴はヘルプデスクの外で埋めることになります。スプレッドシートと大量のコピー&ペーストで行うか、チケット履歴を直接読めるツールを使うかです。
シミュレーションでは何がわからない?
シミュレーションからわかるのは、すでに似た形を見たことのあるチケットの最初のメッセージを、エージェントがどう扱うかです。次の4つは完全にはわかりません。
- 顧客がどう食い下がるか。 再現には顧客メッセージが1つと回答が1つあるだけです。実際の顧客は「それは違う」と返したり、もう一度聞いたり、怒ったりします。台本付きの複数メッセージのテストは役立ちますが、本番での下書きのほうがもっと役立ちます。
- 今週何が新しいか。 製品のリリース、障害、ポリシー変更は、履歴にないチケットを生みます。
- 顧客がどう感じるか。 AIサポートの導入を率いたHacker Newsのコメント投稿者は、"did our own intensive testing"を行ったのに、"our customers just hated it"とわかったと述べています(victor106)。トーン、速さ、人に連絡できる選択肢は、正確さと同じくらい重要です。
- ドキュメントが正しいままかどうか。 シミュレーションはスナップショットです。来月ポリシーのページが変われば、スコアは古くなります。再実行をスケジュールしてください。
"Shipped a customer service agent for a mid-size e-commerce client last year, manual testing looked clean across every flow we ran. First week in production, users started interrupting mid-response to rephrase their question, agent would drop the original context entirely and answer the new phrasing with confident, wrong information. Support tickets spiked, client was fielding churn risk conversations by day ten. We caught exactly zero of that in manual testing because we were too polite during QA."
だからこそ私は、シミュレーションを自動運転ではなく、下書きへの入り口として扱います。次のステップは、エージェントが本番チケットで下書きを作り、人が送る1〜2週間です。InnrはまさにFreshdeskでその段階にいます。今はすべての返信が下書きで、チームは選んだトピックを1つずつ自律返信へ移しています。SE Rankingは、件名で選んだテストチケットでメールの直接返信を試し、その後に範囲を広げようとしています。この期間は、トピックごとの解決率と再開率を見てください(あなたの元に届かなかったチケットを数えるデフレクションではありません)。それを使って、何を自律にするかを決めます。この段階が通常どのくらいかかるかは、私の導入スケジュールの記事で紹介しています。
eeselが過去チケットでシミュレーションを実行する方法
eeselでどう動くかを具体的に説明します。製品の中で最も質問が多い部分だからです。
チャットで依頼します。ヘルプデスクを接続していると、eeselのヘルプデスクシミュレーションは"replays your past tickets and scores its answers against what your team actually sent"します(eeselのドキュメント)。接続していない場合は、代わりに現実的なテストケースを作成します。実行では各チケットに対する返信を下書きし、チームの返信と比較し、結果をテーマごとにまとめ、影響の大きい順に修正点を並べます。ドキュメントの例では、解決済みの20チケットのうち17件がチームの返信品質と一致し、その下にテーマごとの内訳が示されています。これはレポートの例であり、あなたのキューの予測ではないと捉えてください。
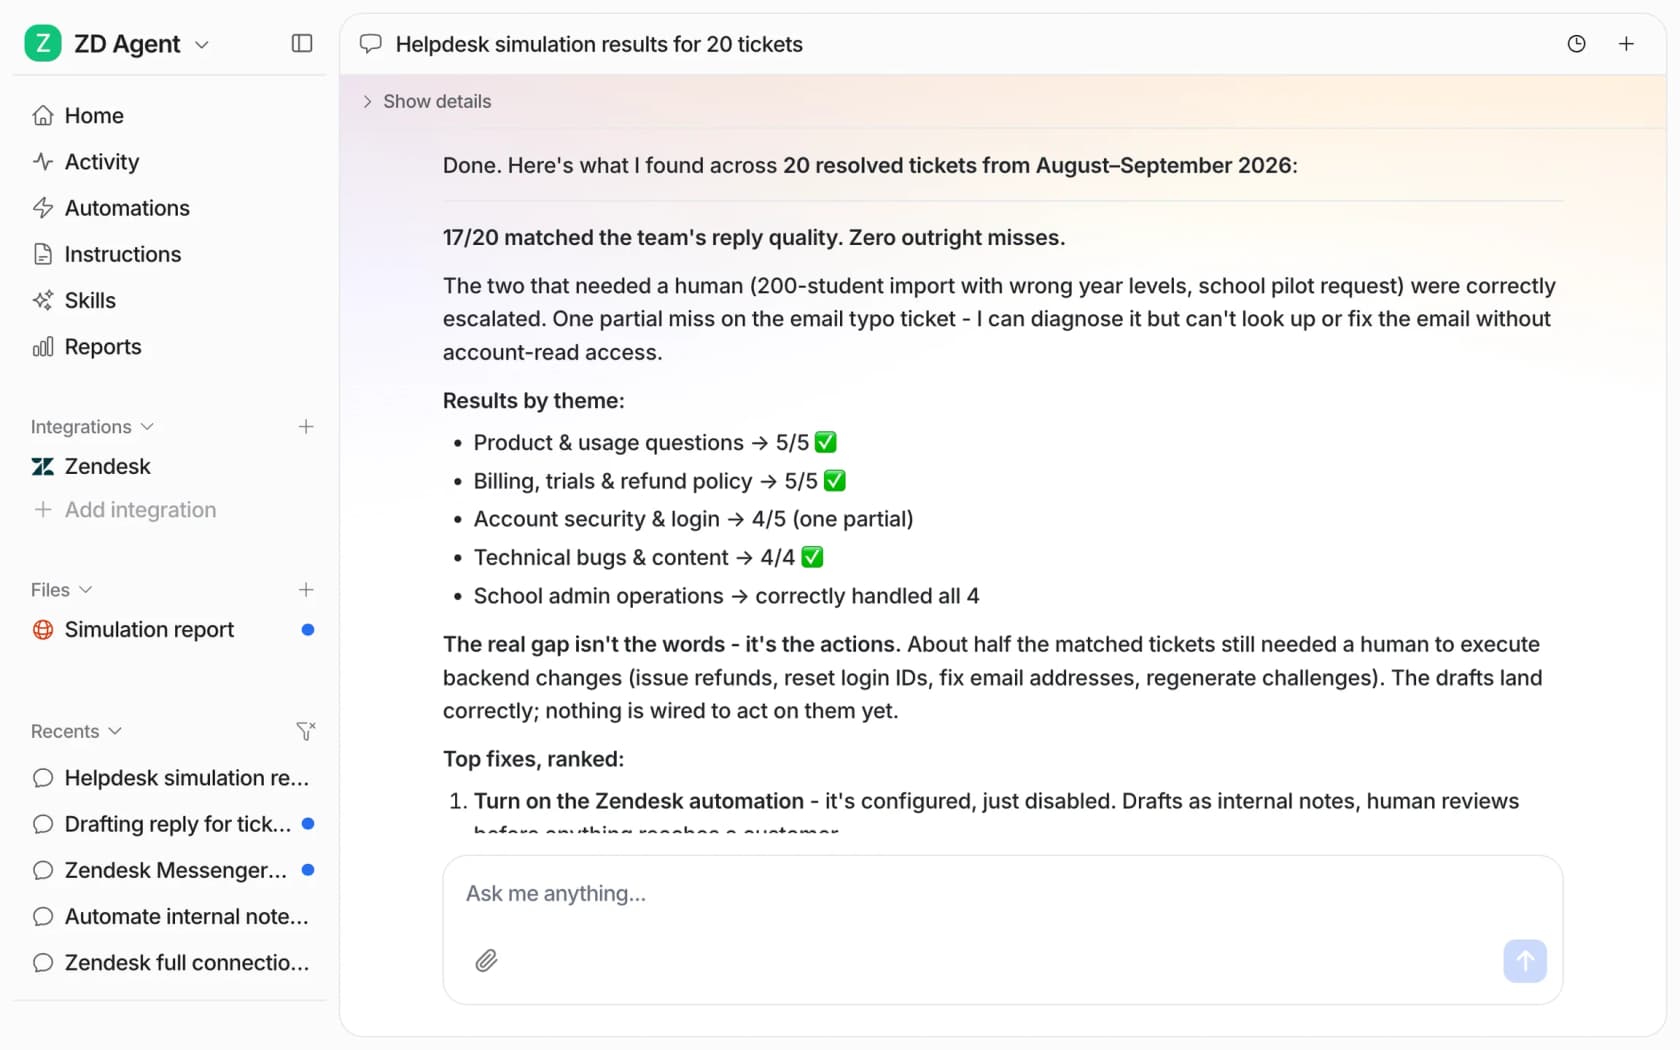
完全なレポートはチャットの横に開き、チケットごとに、顧客が何を尋ね、チームが何を返信し、エージェントの回答がどう比較されたかが表示されます。Skillsのドキュメントにある2つのシミュレーションレポートの例は、どちらも同じ一文で終わります。"It sends nothing to customers"。これでステップ3がカバーされます。
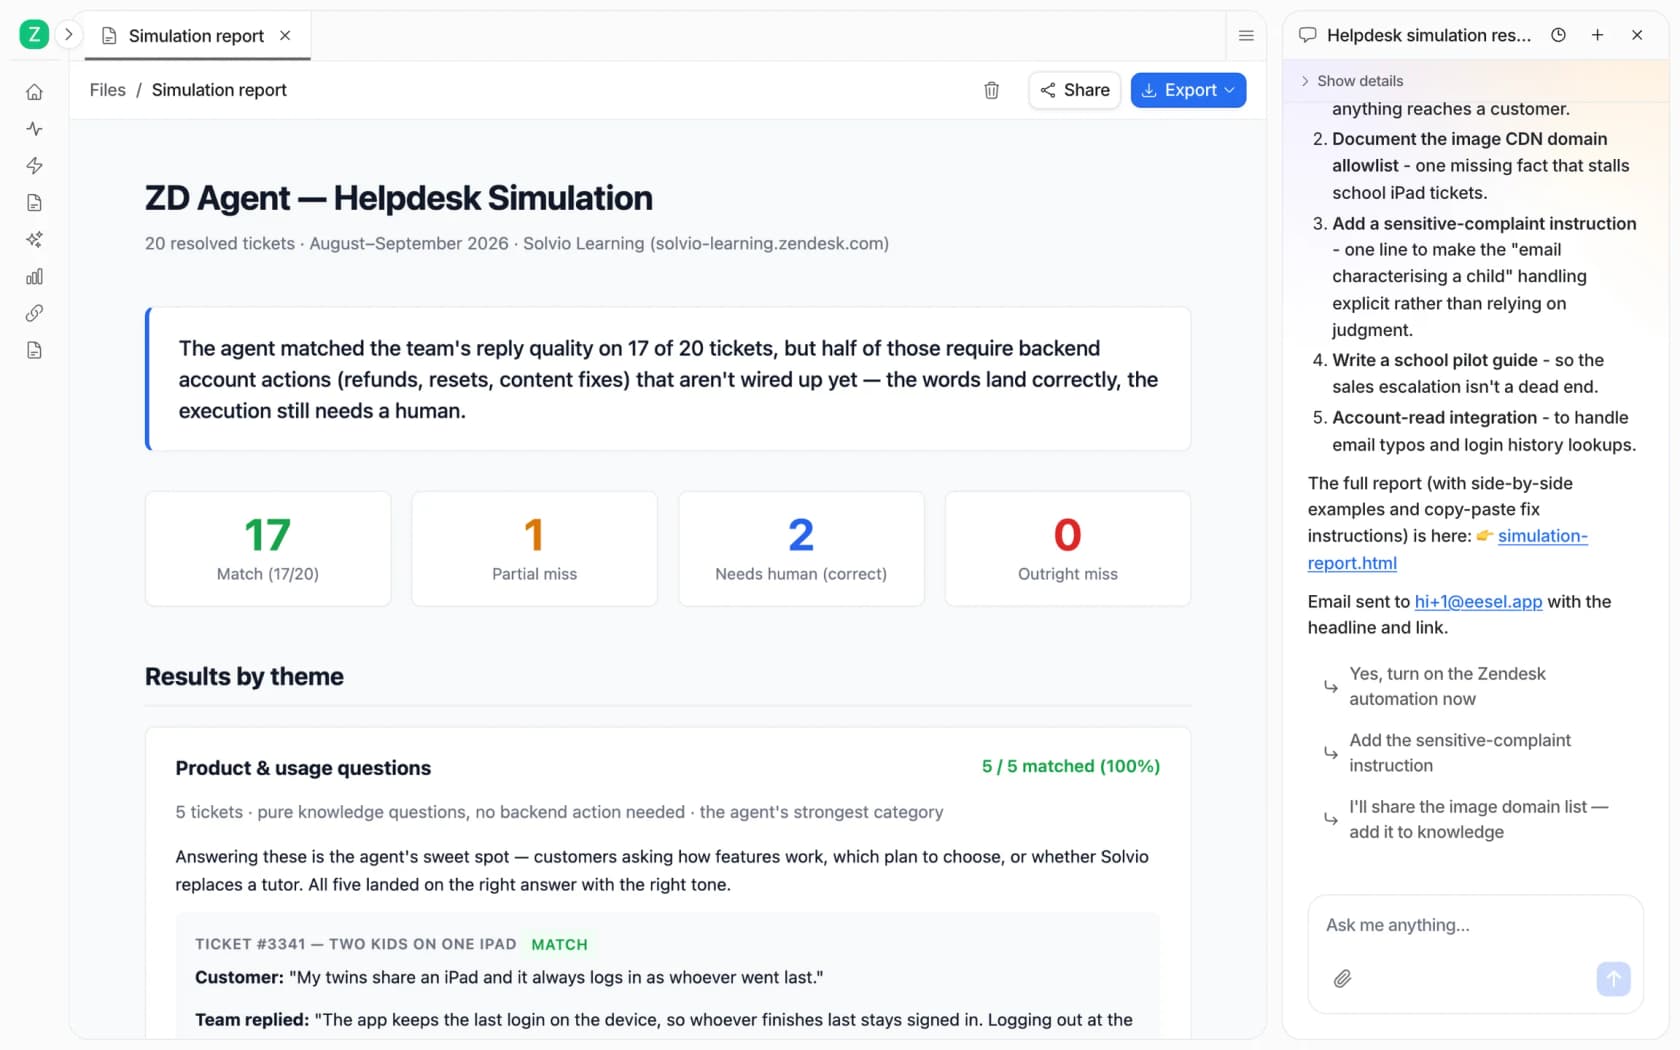
レポートが「一致」で終わらないことに注目してください。部分的なミスと、正しく人を必要としたチケットを分けており、ステップ4の3段階採点が組み込まれています。チャットでエージェントを訂正すると、その訂正を平易な一文のルールとして自分の指示に書き込むので、次の再実行で修正がテストされます。シミュレーションをオートメーションに付けてスケジュール実行することもでき、誰も覚えていなくてもステップ6が回ります。
シミュレーションの後は、すべての返信が下書きまたは社内メモから始まり、準備ができたらトピックを「単独で回答」に移します。お金がかかるものは承認の後ろに置かれたままです。ターミナルで作業したい場合は、eesel CLIで、eesel chat "what's our refund policy?"として同じエージェントをテストし、eesel approvalsで待機中のものを確認し、書き込みは--dry-runで実行前にプレビューできます。Claude CodeやCursorのようなコーディングエージェントも、同じコマンドを操作できます。
eeselが適していない場合:Zendesk内で、AIが演じる顧客ペルソナによる複数メッセージのチャットシミュレーションが必要なら、Zendesk自身のシミュレーターがそのために作られています。eeselのシミュレーションは、エージェントが実際の履歴にどう答えたかを扱うものです。
eeselで、自社のチケットでAIエージェントをシミュレーションする
AIエージェントをオンにする直前で、先に自社のキューからスコアがほしいなら、eeselは数分でZendesk、Freshdesk、Gorgias、HubSpotに接続し、チームがすでに解決したチケットを再現し、何も送らずに、どのトピックが準備できていて、どこにドキュメントの穴があるかをトピックごとに教えてくれます。Norden-Frisiaは、3か月分の過去チケットとマクロで試用期間の1週間を行い、数日以内に契約しました。無料プランにはすべての機能を試せる100クレジットが含まれ、有料プランは500クレジットで月額299ドルから始まります。
eeselを試して、今日の午後に最初のシミュレーションを実行しましょう。