

よいAIサポートのRFPテンプレートは3つの部分でできています。合否ゲート(セキュリティ、データ利用、自社のヘルプデスク)、書面の質問集、そしてすべてのベンダーが同じ方法で実行する、自社の過去チケットでのテストです。ベンダーの順位づけはゲートの後に行い、デモよりチケットテストを高く採点してください。
最もお金の節約になる質問は、課金単位についてです。Zendeskは「verified resolution」ごとに課金し(コミット契約で$1.50、従量課金で$2.00)、Salesforce Agentforceは1会話あたり$2、eeselは対応した1チケットまたは1チャットにつき1クレジット(500クレジットで$299)です。すべてのベンダーに、同じ1か月分のチケットで見積もってもらってください。そうしないと、見積もりは比較できません。
署名の前にそのチケットテストを実行してくれるベンダーがほしいなら、eeselは解決済みチケット20件を再現し、自社の下書きとチームが実際に送った返信を比較します。顧客には何も送りません。以下のテンプレートは、eeselを含むどのベンダーにも使えます。
なぜ多くのAIサポートRFPは間違ったベンダーを選ぶのか?
ベンダーが言うことを採点していて、あなたのチケットでAIが何をするかを採点していないからです。典型的なRFPは80問を尋ね、80個の自信に満ちた回答を受け取り、最もデモがよかったベンダーを選びます。そのデモは、ベンダーが選んだシナリオ、整ったナレッジベース、そしてセールスエンジニアの操作で行われたものです。
私はeeselで連携を作っているので、契約後の買い手の疑問という反対側が見えます。それはほとんど機能の話ではありません。「なぜこのチケットにそう答えたのか」「なぜ11月に請求額が増えたのか」「なぜ対応していない製品にイエスと言うのか」といったものです。そのどれもがRFPの質問になり得たはずです。
解決策は質問を増やすことではなく、作業の順序を変えることです。
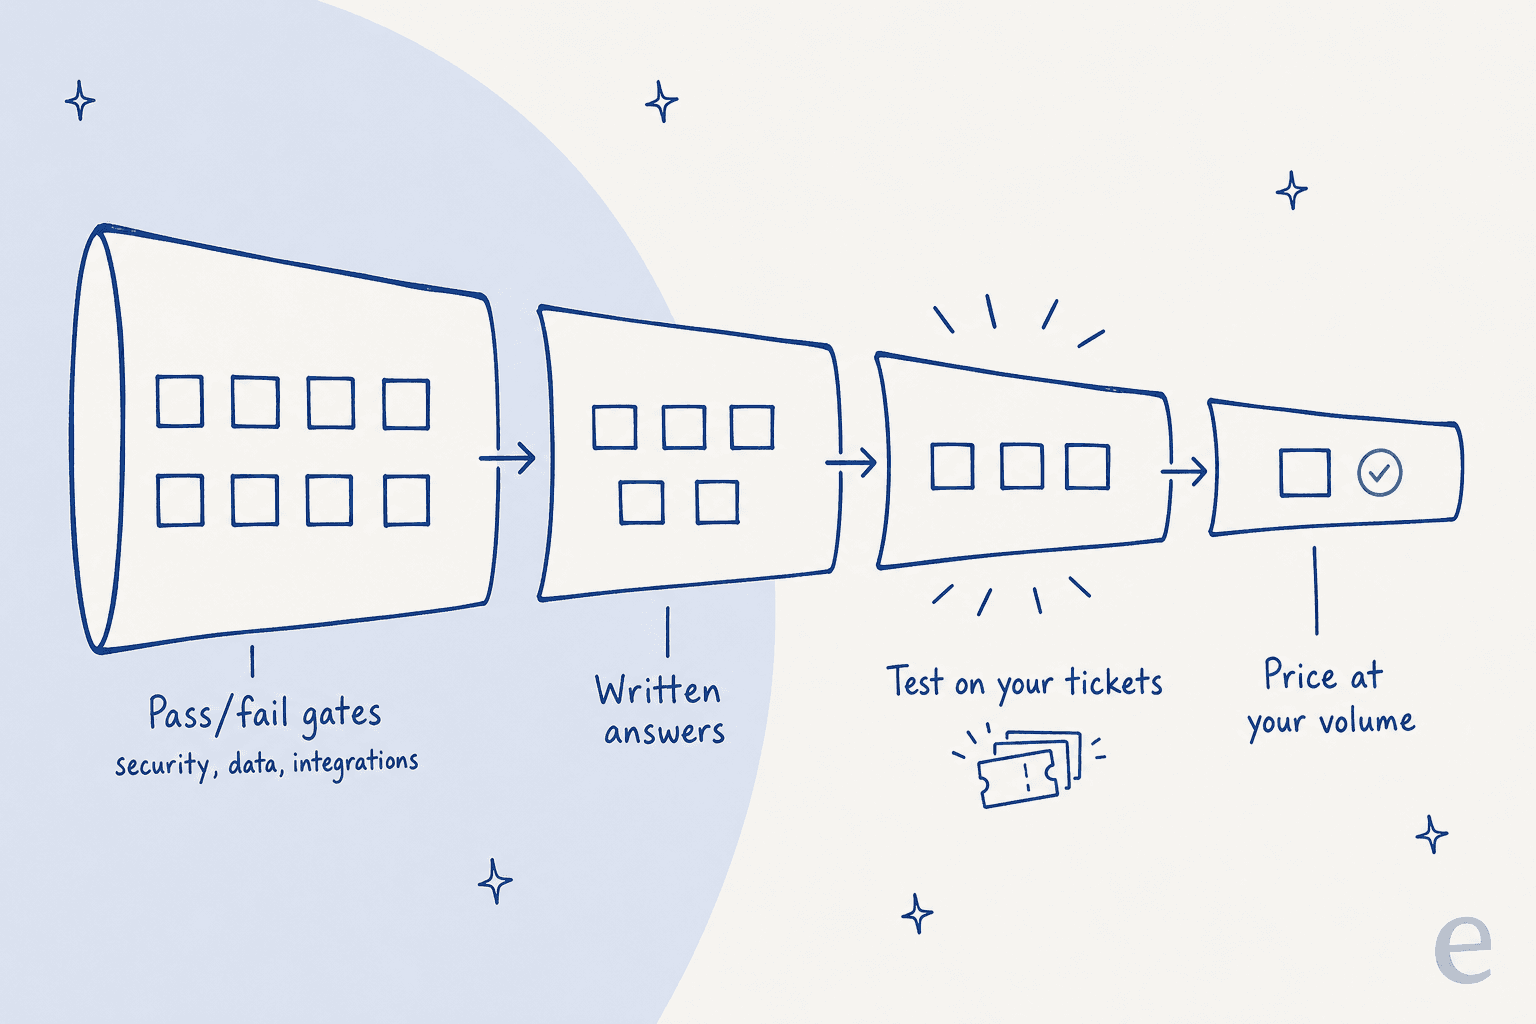
- **まずゲート。**取引を壊しかねないもの(セキュリティ認証、データ利用、自社のヘルプデスク、HIPAA)は、誰かが採点を始める前に確認するイエス/ノーの項目です。
- **次に書面の回答。**下の質問集を、根拠つきで書面で回答してもらいます。
- **3番目に自社のチケット。**残った2、3社が、履歴から作った同じテストセットを実行します。
- **価格は最後に、自社の件数で。**すべてのベンダーが同じコスト行を埋めます。
eeselの営業通話で最も多いリクエストは、買い手自身の過去チケットでAIを学習させることです。同僚のAmoghは、一連のデモの後にこう率直に言いました。「past ticket training strikes again」。買い手はすでに、自社の履歴こそ本当のテストだと知っています。ただ、ほとんどのRFPテンプレートはそれを求めていないのです。
AIサポートのRFPテンプレートには何を入れるか?
10のセクションです。それぞれが、のちにCFO、セキュリティチーム、あるいはエージェントに説明することになる判断に対応しています。
| # | セクション | 何を決めるか | 合否か、採点か? |
|---|---|---|---|
| 1 | 自社の背景と目標 | 自社にとっての「よい」の意味(件数、チャネル、言語、目標成果) | 背景情報のみ |
| 2 | ベンダー概要と参考事例 | 自社の規模、自社のヘルプデスクでの実績があるか | 採点 |
| 3 | 解決品質と精度 | 正しく答えるか、答えられないときにそれを認めるか | 採点(最も重い配点) |
| 4 | 引き継ぎとコントロール | 答えるべきでないときに何をするか | 採点 |
| 5 | ヘルプデスク連携とアクション | 自社のツール内で動き、会話だけでなく実際に作業できるか | ゲート、その後採点 |
| 6 | セキュリティ、プライバシー、データ利用 | 認証、モデル学習、保持、個人情報 | ゲート |
| 7 | 料金と課金単位 | 自社の件数で、忙しい月と暇な月にいくら払うか | 採点 |
| 8 | 導入とサポート | 誰が作業し、どのくらいかかり、自社が何を用意するか | 採点 |
| 9 | チケットテスト | 自社の履歴でどれだけできるか | 採点 |
| 10 | 契約と解約 | 価格固定、データのエクスポート、解約時にどうなるか | ゲート、その後採点 |
セクション1はチームが飛ばしがちですが、ベンダーの回答を比較可能にするのはこのセクションです。実際の数字を渡してください。チャネル別の月間チケット数、問い合わせ理由の上位10件、言語、ヘルプデスク、そしてAIに絶対に触らせたくないチケットの種類です。あるサポートリーダーは、eeselとの通話で最後の点をはっきり言いました。「There are certain tickets I don't want to go through AI.」そのリストはフォローアップの通話ではなく、RFPに書いてください。
AIサポートのベンダーにどんな質問をすべきか?
これらを書面の質問としてRFPにコピーしてください。それぞれに、強い回答がどんなものかを添えています。弱い回答はどれも似た響きで、違いは細部にあるからです。
解決品質と精度
このセクションが最も重い配点で、ベンダーが最も慣れている部分でもあります。見出しの数字の先まで踏み込んでください。
- **解決率は何を数えていますか?**強い回答:正確な定義、誰または何がチケットを解決済みと判断するか、スパム、自動クローズされたチケット、単に離脱した顧客が含まれるかどうか。
- **私たちと同じようなチケットでの解決率はどのくらいですか?**強い回答:問い合わせ理由とチャネル別の結果、サンプル数と期間。全顧客を混ぜた単一の数字では何もわかりません。
- **ナレッジベースに答えがないとき、どうしますか?**強い回答:わからないと伝え、引き継ぎます。実際に見せてもらいましょう。
- **自社のコンテンツではなく、モデルの一般知識から答えることはありますか?**強い回答:ない、またはあるがオフにする設定がある。eeselの営業通話で技術評価者がまさにこれを尋ねました。AIはわからないときChatGPTのようなものに頼るのか、それをオフにできるのか、と。
- **リリース後に誤答をどう見つけますか?**強い回答:名前のついたプロセス(サンプリング、採点、アラート)と、製品内のどこで確認できるか。
- **モデル提供元がモデルを変更したらどうなりますか?**強い回答:変更が届く前に自社の履歴でテストをやり直し、通知する。
最初の質問は見かけ以上に重要です。
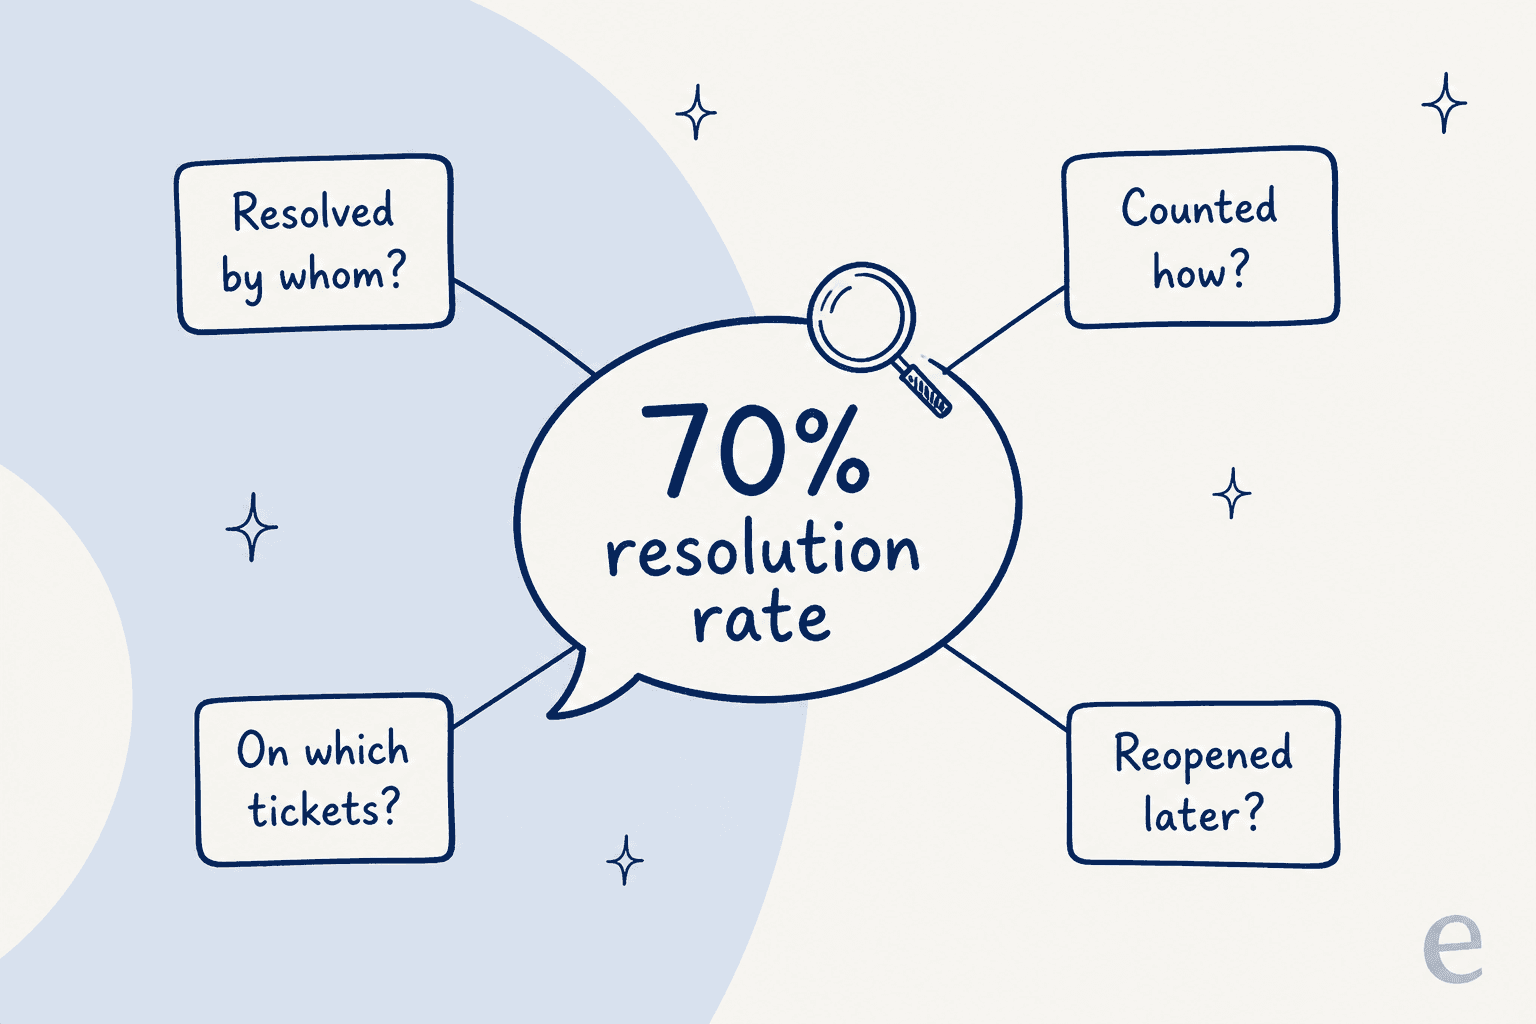
eeselが実際のECのZendeskトラフィックで行ったトライアルでは、受信チケットの22%がスパムでした。スパムのクローズを「解決」と数えるベンダーは、顧客に1件も答えないまま解決率を22ポイント押し上げられます。デフレクションと解決率の記事では、9つのヘルプデスクがこれをどう違う方法で数えているかを解説しています。
Redditのある運用担当者は、「解決済み」の意味を誰も確認しないとどうなるかを書いていました。
"So we audited a week's worth of auto tickets and found 3 separate cases where the bot made up a policy that doesn't exist. The scary part is the customers believed what it said and walked away feeling that WE were wrong. It even marked the ticket as "resolved" so we didn't notice until they dropped a negative review."

そこで7つ目の質問を加えてください。**顧客が再オープンした、または7日以内に再び問い合わせてきたチケットを、どう数えていますか?**ベンダーの数字がそれらを差し引いていなければ、それは問題が解決したかではなく、会話の終わり方を測っているにすぎません。
引き継ぎとコントロール
- **どのチケットを完全に除外でき、どうやって除外しますか?**強い回答:タグ、フォーム、チャネル、顧客セグメント、トピックで、先方のサポートチームへのチケットではなく、自社で設定できる。
- **何かを送る前に、まずエージェント向けの返信を下書きすることから始められますか?**強い回答:はい。トピックまたはチャネルごとに、下書きから送信へ切り替えるスイッチがある。
- **引き継ぎ時に担当者は何を見ますか?**強い回答:要約、すでに試したこと、使った情報源が、チケットに書き込まれる。
- **顧客はいつでも担当者につながれますか?**強い回答:はい。どのくらいの頻度で求められているかも確認できる。
これについて私が見た最も明快な例は、月に約7,000件のチケットを扱うD2Cブランドのカスタマーエクスペリエンス責任者からのものでした。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. Then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これは要件なので、要件として書いてください。「AIは、当社のコンテンツから答えられるチケットにのみ返信し、それ以外はすべて人が対応できるよう手を付けずに残すこと」。そしてテストします。きれいな引き継ぎとはどういうものかは、私の記事AIエージェント引き継ぎのベストプラクティスで扱っています。
ヘルプデスク連携とアクション
これは私の本業なので率直に言います。「Zendeskと連携」は、チケット内でタグ付け、振り分け、返信を行う本格的なエージェントから、ヘルプセンターを読むだけのウィジェットまで、何でも意味し得ます。
- **自社のヘルプデスクの内側でエージェントとして動きますか、それとも横で動きますか?**強い回答:ヘルプデスク内のチケット、タグ、フィールド、社内メモを読み書きでき、具体的にどれかの一覧がある。
- **答えるだけでなく、どんなアクションを実行できますか?**強い回答:名前のついた一覧(注文の照会、フィールドの更新、上限内での返金など)と、それぞれの承認とログの方法。
- **何から学習しますか?**強い回答:ヘルプセンター、マクロ、過去チケット、社内ドキュメント。それぞれ任意でフィルタ可能。どの過去チケットを読むか(期間、タグ)を選べるかも聞いてください。
- **自社のヘルプデスクのAPIが停止または低速のときはどうなりますか?**強い回答:再試行、重複返信なし、読めるログ。
- **どのくらい速く返信しますか?**強い回答:実トラフィックで測定したチャットとメールの時間。ある買い手は67件のテストで評価し、回答は堅実だと判断しましたが、チャットウィジェットが遅く、よく固まるため離脱しました。速度はスコアカードに入れるべきです。
特定のヘルプデスクを使っているなら、同じヘルプデスクの顧客を参考事例として求めてください。各ベンダーの主張を、ヘルプデスク自身のAIができることと比べましょう。Zendesk AIの料金、Freshdesk Freddy AIの料金、Gorgias AIの料金の解説が、よい基準になります。
セキュリティ、プライバシー、データ利用
このセクションの大半は合否です。この段階で止まった案件を見てきましたが、理由はそれぞれひとつでした。SOC 2レポートがない、ベンダーが通過できなかった社内ISOレビュー、あるいはHIPAAの事業提携契約(BAA)がない、です。6週目ではなく1週目に確認してください。
- **現在取得済みの認証と、進行中の認証はどれですか?**レポートまたはブリッジレターと、対象範囲を求めてください。「SOC 2 Type II進行中」と「NDAのもとでSOC 2 Type IIレポート提供可能」は、別の回答です。
- **当社のデータは、御社のものでも提供元のものでも、モデルの学習に使われますか?**強い回答:契約書に明記されたはっきりしたノー。細部を読みましょう。Zendeskのトラストセンターは、生成AIは顧客データで学習されないとしていますが、サニタイズされたサービスデータは、アカウント横断の独自の機械学習モデルの学習に使われます。
- **当社のデータはどこに保管・処理され、どの再委託先が関わりますか?**強い回答:リージョンつきの一覧。
- **保存する前にカード番号などの個人データをマスキングできますか?**eeselを評価していたあるメディア企業は、トライアルを始める前から、これを最大の懸念事項にしていました。
- **HIPAAのBAAに署名しますか?どのプランですか?**健康データを扱う場合のみですが、扱うならゲートです。
- **当社が解約したとき、データはどうなりますか?**強い回答:名前のついた形式でのエクスポート、確認つきの削除、期限。
標準的なセキュリティ質問票だけでは、これらのすべては拾えません。従業員200人のB2B SaaS企業の買い手が、そのギャップをうまく言い表していました。
"My company (200 people, B2B SaaS) is starting to use AI vendors for customer support and internal tools. Our procurement process is basically "fill out security questionnaire, get SOC 2, done." But I'm realizing SOC 2 doesn't cover AI-specific stuff. Like what happens when the vendor updates their model and it starts giving wrong answers? What if the training data had customer info in it?"
だから、精度のセクションにあるモデル変更の質問は、製品レビューだけでなく、セキュリティのゲートの隣にも置くべきなのです。
完全版としては、AIサポートベンダーのセキュリティチェックリストをRFPの付録として使い、セキュリティチームがAIベンダーに不慣れならSOC 2とGDPRのガイドも使ってください。
料金と課金単位
ここでの回答は比較できそうに見えて、できません。あるベンダーは解決ごと、別は会話ごと、別はクレジットごと、別は席ごとに課金し、3社は価格をまったく公開していません。次を聞いてください。
- **課金の1単位とは正確には何ですか?**定義を書面でもらってください。
- 会話が課金対象かどうかは誰が決め、私たちはそれを確認・異議申し立てできますか?
- **最も忙しい月はどうなりますか?**通常の件数の2倍での請求額を求めてください。
- 超過料金はありますか?初期設定でオンですか?
- **契約期間中、値上げに上限はありますか?**eeselを評価していたあるハードウェアサポートチームは、以前のベンダーの価格が2倍以上になった経験があり、今回は価格固定を書面で求めていました。
- **この行を埋めてください:**直近12か月の月別チケット件数を、御社の料金で見積もったもの。
課金単位は、失敗のコストを誰が負担するかを変えます。
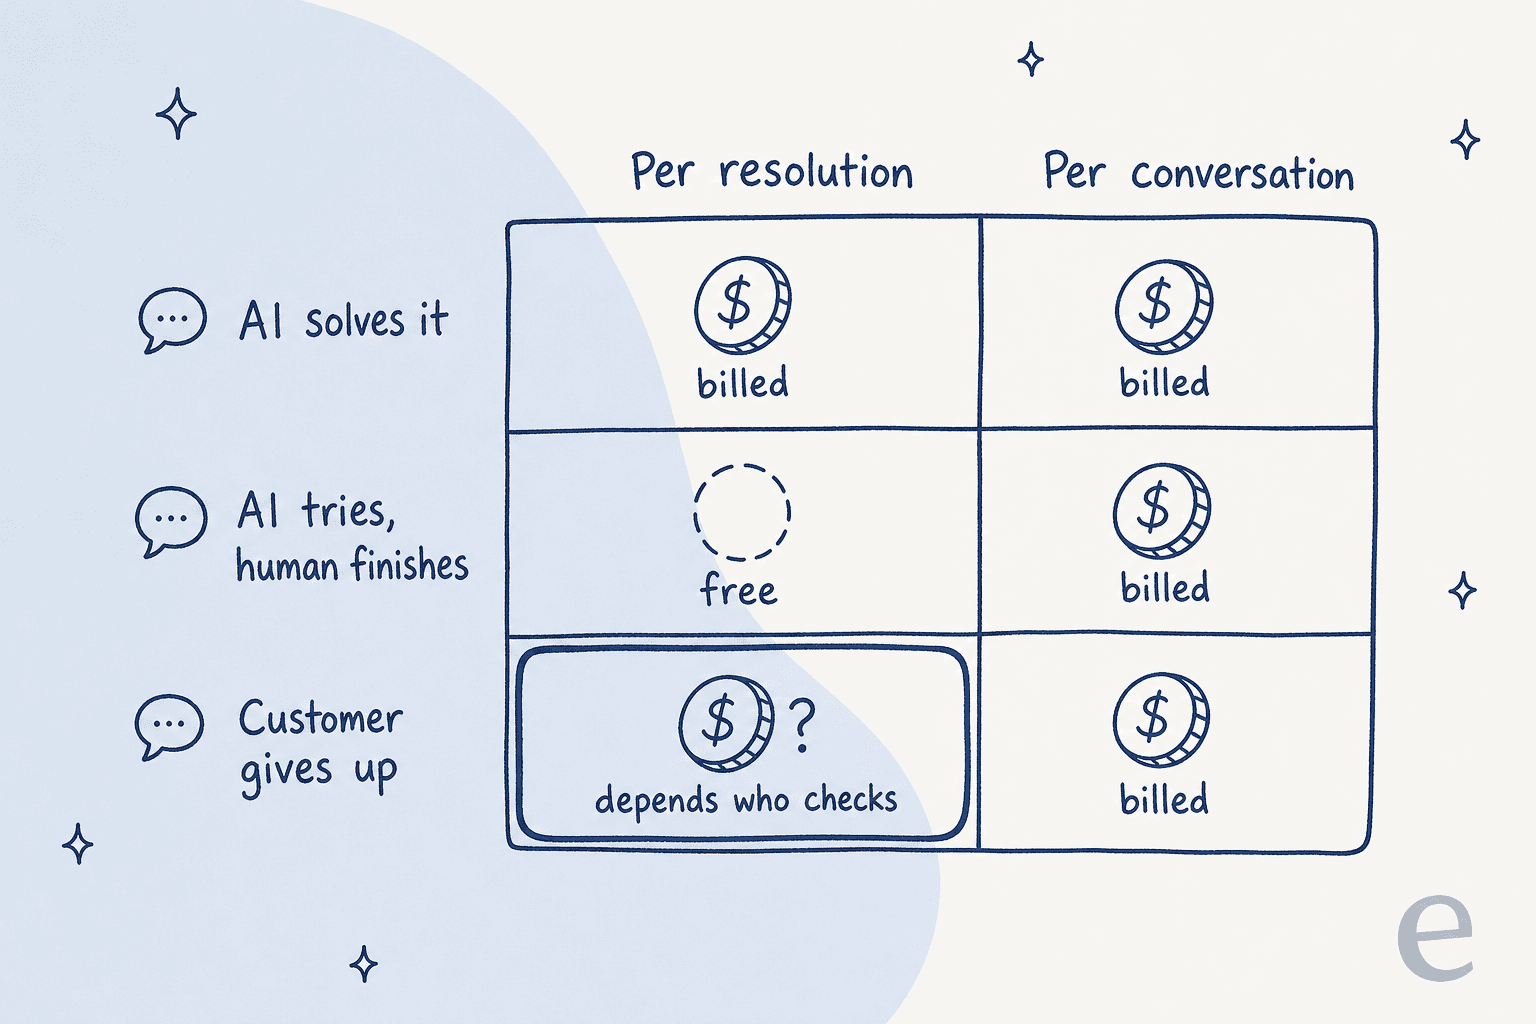
その左下のセルが、いまやこのセクションで最も重要な質問です。2026年5月18日以降、ZendeskはすべてのAI会話を3つの階層に分類し、「verified resolution」だけが利用枠を消費します。その判定はZendesk自身のモデルが、最初のメールから72時間後、またはメッセージングチャットの開始から2時間後に行います。エスカレーションに支払わなくてよいという点では公平ですが、それでも判定をどう監査できるかは確認すべきです。
顧客がどちらのモデルも選べるDecagonは、自社の料金ブログで解決単位課金に反対しています。"You never want to be in a situation where you're arguing over what a 'resolution' is." Sierraは逆に、成果は顧客ごとに合意する成果ベースの料金を採用しています。
Hacker Newsでは、成果ベース課金を売り込むスタートアップへの返信で、あるエンジニアが、成果ごとの見積もりが答えるべき質問を挙げていました。
"can you clearly explain how you will measure and track the outcomes? That's the key detail that matters. Relying on customers to self-report is not sufficient, and an automated self-report-system is not a true improvement."

同じ1か月で見たときの公開価格表は次のとおりです。スライダーを自社の数字に動かしてください。
触ってみると、2つのことが目につきます。解決単位の料金は、AIの解決が減るほど安くなるので、安い見積もりが弱いエージェントを隠していることがあります。そしてベンダー間の差は、解決率によってまるで変わるため、価格の見積もりはチケットテストの前ではなく後に行います。さらに詳しくは、解決あたりの本当のコストとAgentforceの料金の解説をご覧ください。
導入とサポート
- **私たちに必要なものを、役割別に時間で教えてください。**強い回答:サポート運用、エンジニアリング、セキュリティの工数の見積もり。「最小限の労力」ではない。
- **最初のチケット種別が稼働するまでどのくらいかかりますか?**強い回答:スコープに結びついた日付と、遅れ得る要因。
- **リリース後のチューニングは誰が担当しますか?**強い回答:担当者の名前と、価格に含まれる内容。
- **導入が停滞する最も多い理由は何ですか?**実際の導入経験があるベンダーなら、具体的で正直な答えがあります。あいまいな答えは警告サインです。
- **立ち上げ期間中は、支払いを抑えられますか?**eeselのある営業通話で、CFOは導入期間中の割引価格を求め、「this is not just for you, but for any tech vendor」と言いました。ごく普通の要望です。
導入ガイドと導入の失敗例の一覧は、プロジェクト責任者に送るのに役立ちます。
契約と解約
- **会話、設定、テスト結果をエクスポートできますか?**どの形式ですか?
- 解約の通知期間はどのくらいで、中途解約の手数料はありますか?
- **最初のユースケースが合意した目標に届かなかった場合はどうなりますか?**強い回答:書面の救済措置(パイロットの延長、クレジット、または解約する権利)。
初めて導入するのではなく、AIベンダーを乗り換えるなら、AIサポートベンダーの乗り換えのガイドも読書リストに加えてください。
AIサポートのベンダーをどう採点するか?
まずゲートを実行します。ゲートに通らなければ、デモがどれだけよくても脱落です。そのうえで、残ったベンダーを各行で1から5で採点し、重みを掛けます。
| カテゴリ | 重み | 5点になる条件 |
|---|---|---|
| 自社の履歴でのチケットテスト | 25% | ほとんどの問い合わせ理由でチームと同等以上で、残りはきれいに引き継ぐ |
| 解決品質と精度(書面) | 15% | 正確な定義、問い合わせ理由別の数字、できないことを認める |
| 引き継ぎとコントロール | 10% | 何に触るかを自社で選べる。まず下書き、その後送信 |
| ヘルプデスク連携とアクション | 15% | 自社のヘルプデスク内で動き、名前のついたアクションとログがある |
| 自社の件数での価格(12か月) | 15% | 実際の件数での合計が最も低く、繁忙月の数字と上限がある |
| 導入とサポート | 10% | 現実的な工数、担当者の指名、最初のトピック稼働までが短い |
| 速度 | 5% | 実トラフィックで測定したチャットとメールの返信時間 |
| 参考事例とベンダーの安定性 | 5% | 自社のヘルプデスクで、自社規模の顧客がいる |
**ゲート(合否、採点の前):**必要な認証またはレポートの提供、自社データを学習に使わないという契約上の約束、自社のヘルプデスクへの対応、必要なデータ所在地、健康データを扱う場合のHIPAA BAA、解約時のデータエクスポート。
ここでの2つの選択は意図的です。チケットテストは、書面の回答と引き継ぎを合わせたよりも重く配点しています。ベンダーが文章で乗り込めない唯一の行だからです。そして速度に独立した行を設けたのは、遅いチャットウィジェットが、正確な回答が勝ち取った案件を失わせるからです。小項目のスコアがほしければ、AIサポートのパイロット用スコアカードにより長いバージョンがあります。
自社のチケットでベンダーをどうテストするか?
これはRFPのセクション9で、私が最も強く推したい部分です。結果が比較可能になるよう、次のように実施してください。
- **直近90日からテストセットを抜き出します。**解決済みチケット100〜200件を、件数に比例して主な問い合わせ理由から抽出します。共有できないものは取り除いてください。
- **難しいものを意図的に加えます。**正直な答えが「いいえ」や「それは対応していません」であるチケット10〜20件と、怒っている顧客数件、アクション(返金、注文変更)が必要なものを数件。
- **すべてのベンダーに同じセットと同じ知識を渡します。**同じヘルプセンターのエクスポート、同じマクロ。ベンダーが選んだシナリオは使いません。
- **各回答を、チームが実際に送った返信と照らして採点します。**そのまま使える正解、修正が必要な正解、誤り、または正しい引き継ぎ。
- **数字は1つではなく複数を報告します。**精度、そのまま送信できた率、誤答率、引き継ぎ率、返信時間。
真実が明らかになるのはステップ5です。eeselが実際のECのZendeskトラフィック(284チャットと100チケットのクロスチェック)で行ったトライアルでは、AIは振り分け精度93%を達成し、すべてのスパムチケットを検出しました。それでも、エージェントがその下書きをそのまま送ったのは12%だけでした。チームが掘り下げると、書き直しの約65%は長さとトーンのためで(エージェントは8〜15文の下書きを1〜3文に削っていました)、事実の誤りによるものは約5%にすぎませんでした。1つの数字なら「素晴らしい」か「使えない」としか言えなかったでしょう。5つの数字は「正確だが、冗長で、トーンを直す必要がある」と教えてくれました。
ステップ2の「正直なノー」のチケットは、思う以上に重要です。あるB2B技術チームは、eeselとの営業通話で、ナレッジベースに「we support all models」とあったせいで、データベースにないブランドにも、ボットが「はい、お客様の車種に対応しています」と確認してしまったと話しました。ベンダーのデモには決して出てこない、まさにそういう回答です。
eeselはこのステップを中心に作られています。ヘルプデスクシミュレーション機能は、チームが最近解決したチケット20件を取り、それぞれに自分で返信を下書きし、チームが送った返信と比較し、結果をテーマ別にまとめ、顧客には何も送りません。
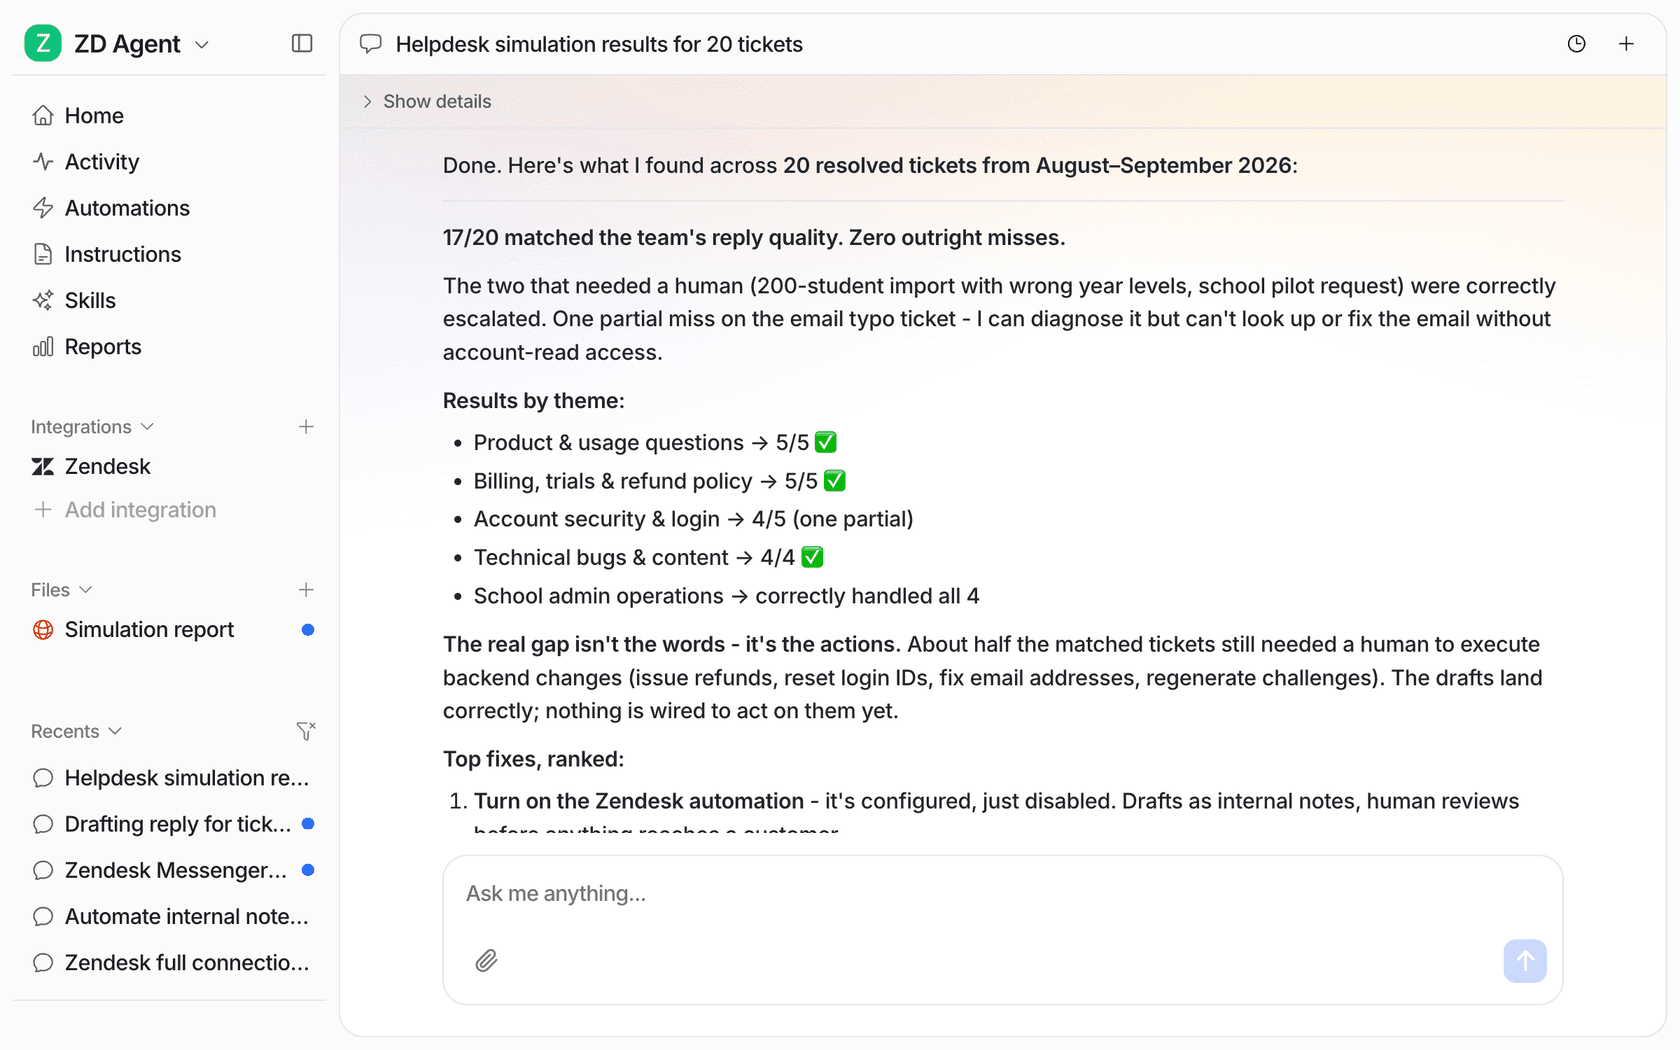
そのレポートがギャップだと述べている点に注目してください。文面ではなく、アクションです。一致したチケットの約半分は、依然として人がバックエンドのシステムで何かをする必要がありました。署名の前にほしいのはこうした発見です。どの連携について尋ねるべきかがわかるからです。ベンダーが自社の履歴でこのようなことを実行できないなら、ほかにどうやって知るのかを尋ねてください。テストセットの作り方については、AIサポートエージェントのテストのガイドがさらに詳しく解説しています。
借りる価値のあるもう1つのテストを、ライブデモが何を証明すべきかを論じたRedditのスレッドから紹介します。
"Make them do the demo with a knowledge base that's deliberately outdated by like 6 months, and see if the agent just confidently spits wrong info or admits it don't know. That's the real test for me"
自社の実際のナレッジベースも、どこかしら少し古くなっているので、これはひっかけ問題ではありません。ごく普通のケースです。
RFPを送る前に、AIサポートのベンダーは何を公開しているか?
RFPの一部は、ベンダーのページから自分で埋められます。2026年10月に各ベンダー自身のサイトで確認した内容は次のとおりです。
| ベンダー | 課金単位 | 公開価格 | 認証(自社申告) | 自社データで学習するか? |
|---|---|---|---|---|
| eesel | 対応した1チケットまたは1チャットにつき1クレジット | 500クレジットで$299から5,000クレジットで$1,749まで。無料プランは100クレジット | SOC 2 Type II 監査進行中、EnterpriseでHIPAA BAA、GDPR DPA | しない |
| Zendesk | 利用枠からのverified resolution | コミット契約で$1.50、従量課金で$2.00 | SOC 2 Type II、ISO 27001と42001、アドオンでHIPAA BAA | 生成AIではしない。サニタイズされたデータは独自の分類モデルの学習に使用 |
| Salesforce Agentforce | 会話、Flex Credit、またはユーザー | 1会話$2、100,000 Flex Creditsで$500 | 料金ページには記載なし | サードパーティモデルではしない |
| Ada | 非公開 | 見積もりのみ | SOC 2 Type 2、HIPAA、GDPR、PCI | 匿名化したデータでファインチューニング |
| Decagon | 会話単位または解決単位 | 見積もりのみ | SOC 2 Type II、ISO 27001、HIPAA、GDPR | モデル提供元ではしない |
| Sierra | 成果ベース | 見積もりのみ | SOC 2 Type II、ISO 27001と42001、HIPAA、FedRAMP High | 記載なし |
6社中3社が価格を公開していません。エンタープライズ営業としては問題ありませんが、RFPでは各社に同じコスト行を求める必要があるということです。候補リストがもっと多い場合は、私の最高のAIカスタマーサポートエージェントのまとめで、さらに多くのベンダーを扱っています。
AIサポートのRFPで、チームはどんな失敗をするか?
- **200問を送る。**ベンダーは長い質問票に、前回の回答のコピーで答えます。鋭い40問のほうが、一般的な200問よりよい回答を引き出します。
- **ベンダーにデモのシナリオを選ばせる。**どのベンダーも自社の例ではよく見えます。自社のチケットを使ってください。
- **単位の違う見積もりを比べる。**解決単位と会話単位は、どちらも自社の1か月で見積もるまで比較できません。
- **「進行中」を「完了」として扱う。**進行中の認証は問題ないかもしれませんし、ゲートかもしれません。デモの後ではなく前に決めてください。
- **繁忙月を飛ばす。**平均ではなくピークで見積もってください。単位課金は、件数とともに上がっていきます。
- **エージェントを入れない。**AIの下書きを編集することになる人たちが、チケットテストを採点すべきです。要約を読むマネージャーには見えないトーンの問題に気づきます。
最悪の顧客という点は、最も飛ばしやすいので、繰り返す価値があります。
"test it as your worst customer not your best one vague question, typo in it, missing half the context. if it handles that you're probably fine. most people only test the clean version and then wonder why it breaks on real customers"
eeselならこのRFPにどう答えるか?
厳しい質問をするよう勧めてきたので、決め手になりがちな質問への、eeselの答えを示します。eeselが脱落するかもしれないものも含みます。
- **何か:**ヘルプデスクの中で、もう1人のエージェントとして働くAIヘルプデスクのチームメイトです。返信の下書きや送信、チケットのタグ付けと振り分けを行い、ヘルプセンター、マクロ、過去チケットから学習します。Zendesk、Freshdesk、Gorgias、Help Scout、HubSpot、Front、Salesforceなどに接続します。
- **課金単位:**返信の数に関係なく、対応した1チケットまたは1チャットにつき1クレジット。プランは500クレジットの
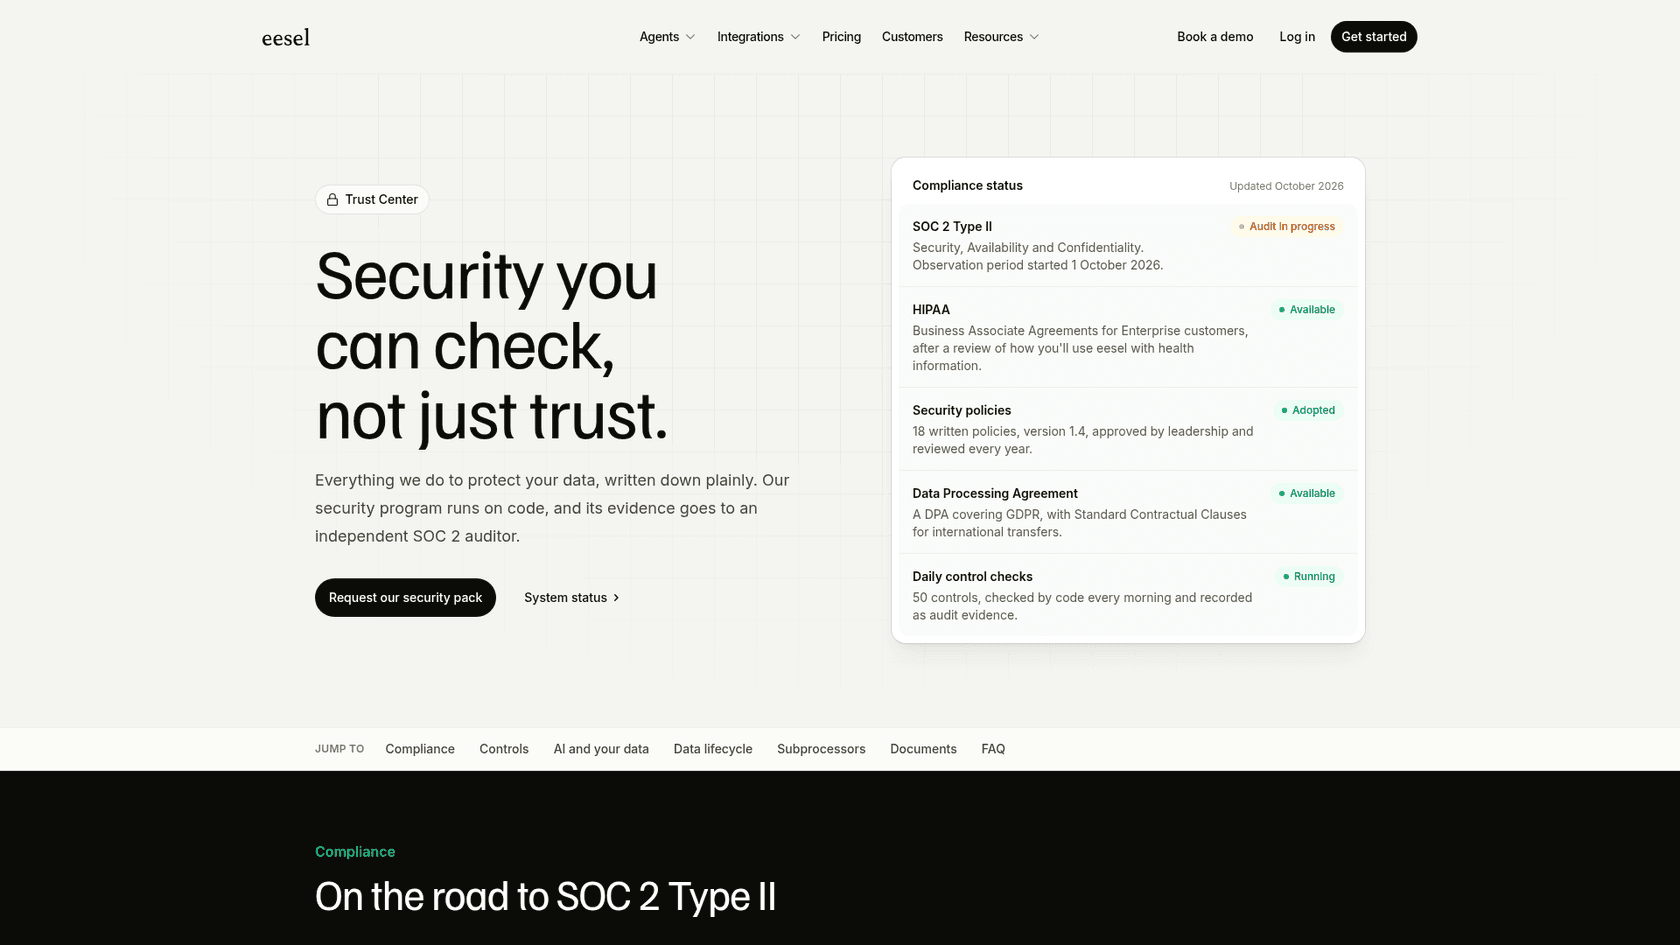
$299から5,000クレジットの$1,749まで、席料金はなし。超過は1クレジット$0.80で、オンにしない限りオフ、上限は自社で設定します。無料プランは100クレジットで、カードは不要です。 - セキュリティ:SOC 2 Type II監査進行中で、観察期間は2026年10月1日に開始しました。今日の時点で完成したレポートが必要な場合、eeselはまだ通過できないゲートです。HIPAA BAAはEnterpriseで提供しています。eeselはお客様のデータでモデルの学習やファインチューニングを行いません。
- **チケットテスト:**標準搭載。顧客に何かが届く前に、自社の解決済みチケットで実行します。
公開されている顧客事例から見た、本番での姿です。
- **規制される金融業、まず下書き。**ドイツのローン比較企業smavaは、1つのZendeskで3つのeeselエージェントを運用しています。1つはすべてのチケットを分類し、1つはマクロライブラリから下書きし、1つは顧客向けにそのまま出せる回答を準備します。1か月で27,000チケットを処理し、15,300件の下書き返信を作成していますが、eesel自身がそれらを送ることはありません。
- **自社ドキュメントだけからの回答。**ある産業オートメーション企業は、技術ライブラリをチャットの裏側に置きました。チャットはドキュメントからのみ答え、情報源にリンクし、ないときは認めます。すべてのサポートチケットには、エンジニアが編集するための下書きが付いて届きます。
- 固定プランでの大量処理。SamCartは、Freshdeskのチケット用とウェブサイトのチャット用に1つずつエージェントを運用し、月8,000件のインタラクションのプランで、280件のヘルプセンター記事から回答しています。
RFPのベンダーの1社としてeeselを試す
今四半期にAIサポートのRFPを書いているなら、eeselを候補に入れ、まずセクション9を実行させてください。ヘルプデスクを接続し、最近解決したチケットでシミュレーションするよう依頼すれば、営業通話の前に、顧客には何も送らずに、問い合わせ理由別の採点済みレポートが手に入ります。そのうえで、ほかのすべてのベンダーと同じゲートと同じコスト行で評価してください。
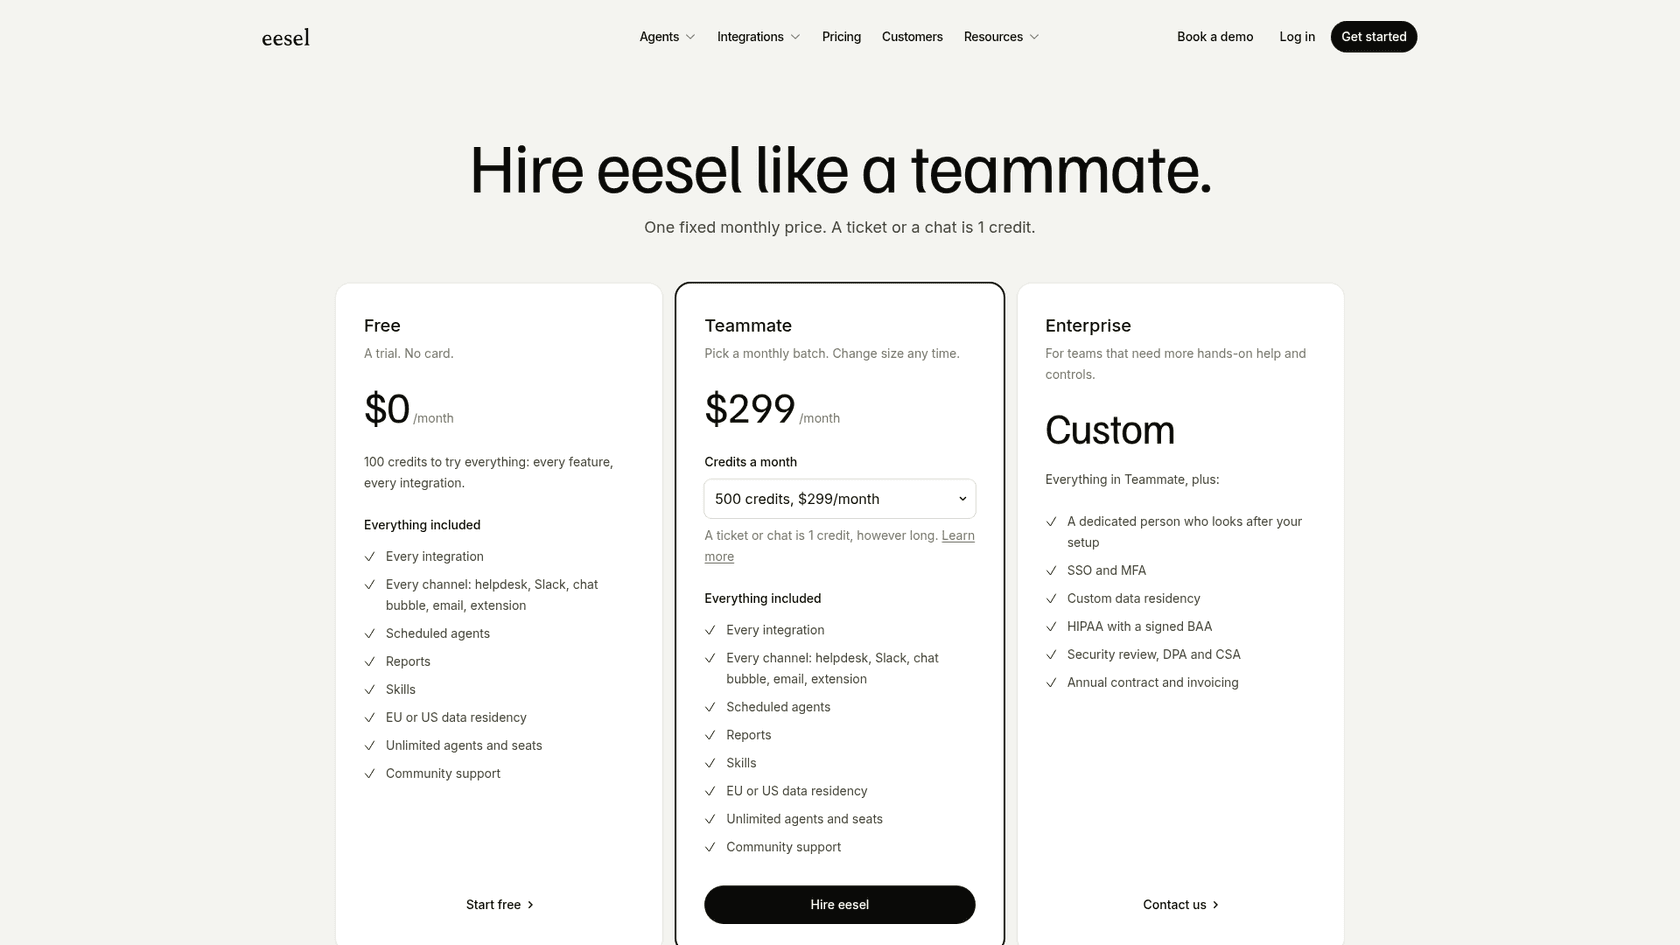
eeselを無料で試すか、セキュリティチームが先にコントロールを確認したい場合はデモを予約してください。