

要点
担当者1人につき月5件のチケットをレビューするだけでは、品質スコアが約31ポイントもずれる可能性があります。解決策は、より良いスプレッドシートではなく、AIで全チケットをスコアリングし、その結果を人が確認するシグナルとして扱うことです。Zendesk、Gorgias、Front、HubSpot、Freshdeskはそれぞれ何らかの形でこれを提供していますが、カバーするチケットの範囲は大きく異なります(GorgiasはAIで3つの基準を採点し、HubSpotも3つ、Zendeskは自分で基準を書けます)。
多くのガイドが見落としている点があります。AIエージェントが定型的なチケットを引き受けると、人間に残るチケットは難しいものになります。その結果、対応時間は延び、担当者1人あたりの件数は減り、AI導入前に作ったスコアカードでは最も優秀な人を低く評価してしまいます。Question Beautyでは、eeselが1か月に990件のGorgiasチケットのうち約280件を自力でクローズし、約250件をメモ付きで人に割り当てました。つまり、人間のキューは、旧来の目標が設定された頃とは別の仕事になっています。本記事では、サンプルサイズの計算、私が出発点にするであろう再配分したスコアカード、そしてAIスコアの公平性を保つ方法を解説します。
担当者1人のスコアには、実際に何件のレビューが必要ですか?
5件よりはるかに多く必要です。レビュー5件のスコアはほぼ運任せで、その計算はあらゆる合格率に共通する標準的なものです。
ある基準に実際には85%の確率で合格する担当者を考えます。月5件のレビューでは、95%の誤差範囲は約31ポイントです。同じ人が同じ月でも、ダッシュボードには55%と出ることも100%と出ることもあります。20件なら約16ポイント、100件なら約7ポイント、500件(全チケット)なら約3ポイントです。これは正規近似による私自身の計算で、下のウィジェットでは有限母集団補正も加えています。
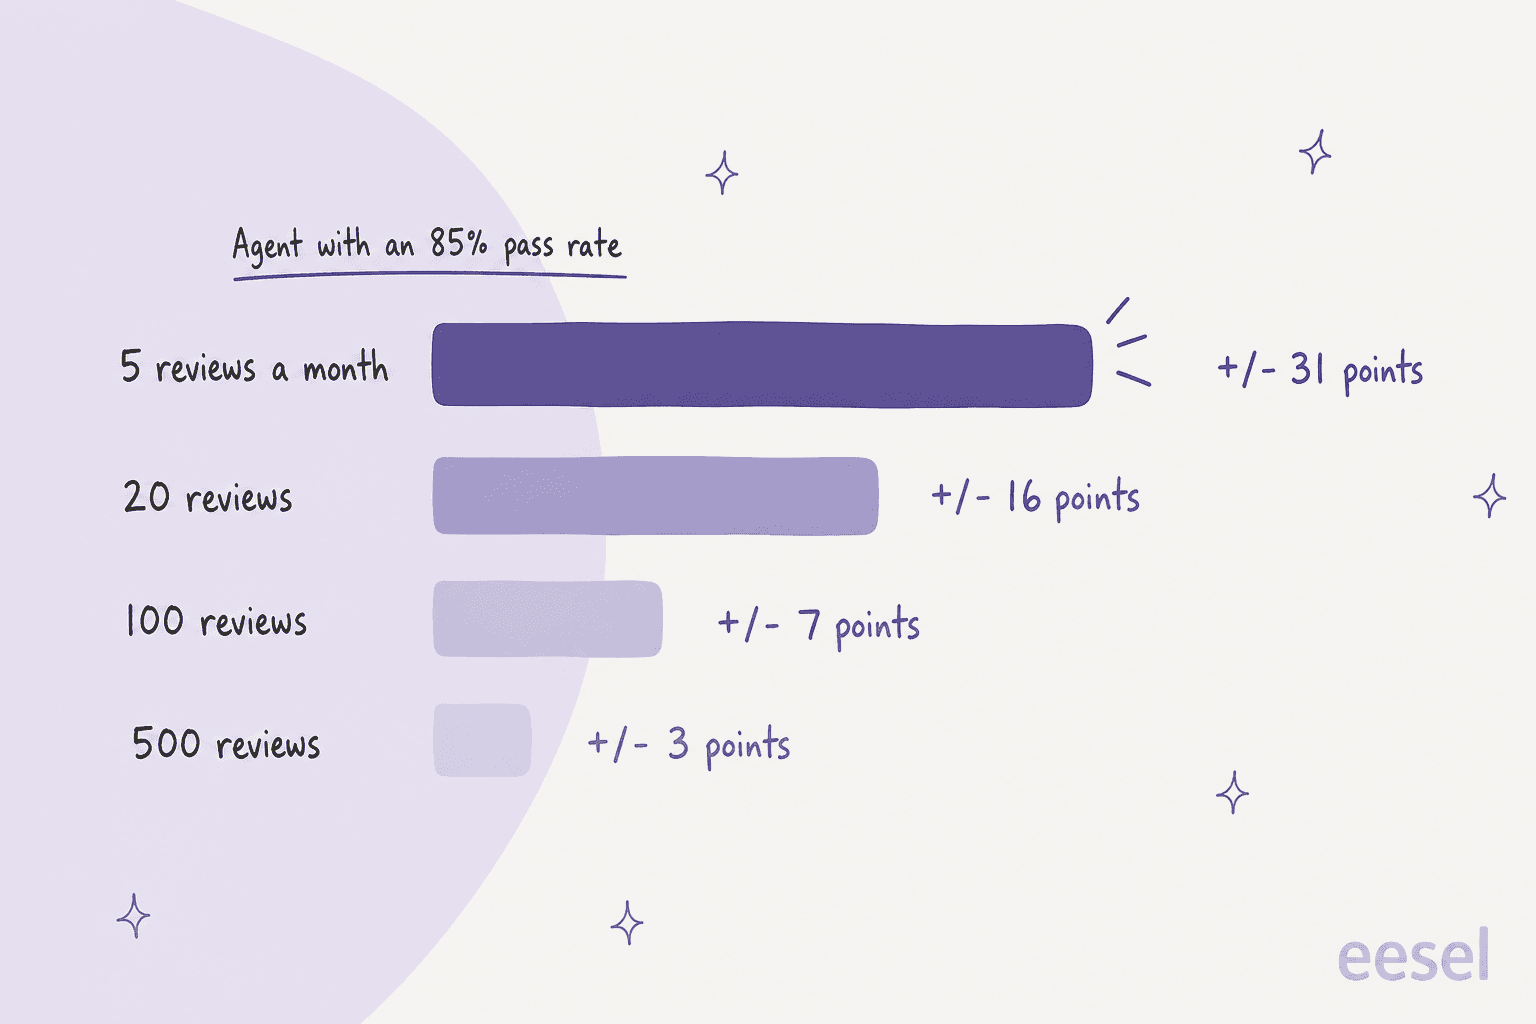
人同士を比べるとさらに厳しくなります。85%の担当者と75%の担当者を自信を持って区別するには、それぞれ約120件のスコア付きチケットが必要です。1人の担当者が月に約500件を対応する中で、チームリーダーが週に5〜10件をレビューしても、そこには到達しません。Leo Gasperinは以前のチームでまさにその状況を述べており、あるコメント投稿者がそれにこう名前を付けました。
"sampling creates confidence, but not clarity."

ご自身の数字で試してみてください。下のウィジェットは、あなたのチケット数とレビュー件数を使います。
ご自身のチケット数とレビュー件数を入力すると、範囲の広さがわかります。最後のカードは、10ポイント差の2人の担当者を区別するために必要なレビュー件数です。
サンプリングをやめるべき理由の全体像はコールセンターの品質保証で、実践編はAIによるサポートQAで取り上げました。ここでの要点は、母数の確保だけでもAIスコアリングを導入する価値があるということです。
担当者のパフォーマンススコアカードでは何を測るべきですか?
4つです。品質、成果、顧客の評価、そしてチケットタイプ別の効率で、速度だけで測るものはありません。一般的なアドバイスは加重スコア(たとえば品質40、生産性25、顧客体験25、信頼性10)で、その形自体は問題ありません。多くのチームが間違えるのは重みの付け方です。
| 区分 | 測定の例 | わかること | 落とし穴 |
|---|---|---|---|
| 品質 | AIが採点する共感、正確さ、解決 | 返信は役目を果たしたか? | AIが判断できない基準(Gorgiasは正確さとブランドボイスを人の判断に任せています) |
| 成果 | 再オープン率、初回問い合わせ解決率 | 解決したままか? | 早くクローズして後で再オープンされる担当者 |
| 顧客の評価 | CSAT | 顧客は助けられたと感じたか? | 担当者ごとのアンケート回答が少なく、同じノイズの問題が起きる |
| 効率 | チケットタイプ別の平均対応時間 | 仕事の進め方は整っているか? | 簡単なチケットと難しいチケットを1つの数字にまとめてしまう |
指標の全リストは、カスタマーサービスKPIとコールセンター担当者の生産性の記事でさらに詳しく説明しています。レビュー基準をゼロから作る場合は、QAフィードバックの例に、評価ではなく指導につながる文言があります。
AIエージェントが簡単なチケットを引き受けると、何が変わりますか?
人間のキューは難しくなり、AI導入前に設定した担当者ごとの数値はすべて、別の仕事を測ることになります。AIが注文状況の確認や使い方の質問に答えるので、人に届くのは返金の判断、怒っている顧客、そしてボットが解決できなかった案件です。
AI音声エージェントが電話の窓口に導入された後の様子を、Redditのコールセンター担当者がこう述べています。
"At this point, it's handling a lot of "routine" calls. Which means the calls that come through to us humans are more complicated, or people who are upset about the AI messing something up."

数字もその実感を裏付けています。Question Beautyでは、eeselは1か月(2026年8月8日〜9月8日)に約990件のGorgiasチケットを処理し、約960件の返信を送り、約280件のチケットを自力でクローズし、約250件を社内メモ付きで人に割り当てました。返金、クレーム、卸売の依頼は常に人に回ります。このチームの担当者が以前より遅くなったわけではなく、単に「注文はどこ?」という問い合わせを見なくなっただけです。チケット1件あたりの対応時間は延び、担当者1人あたりのチケット数は減りますが、どちらもパフォーマンスの問題ではありません。
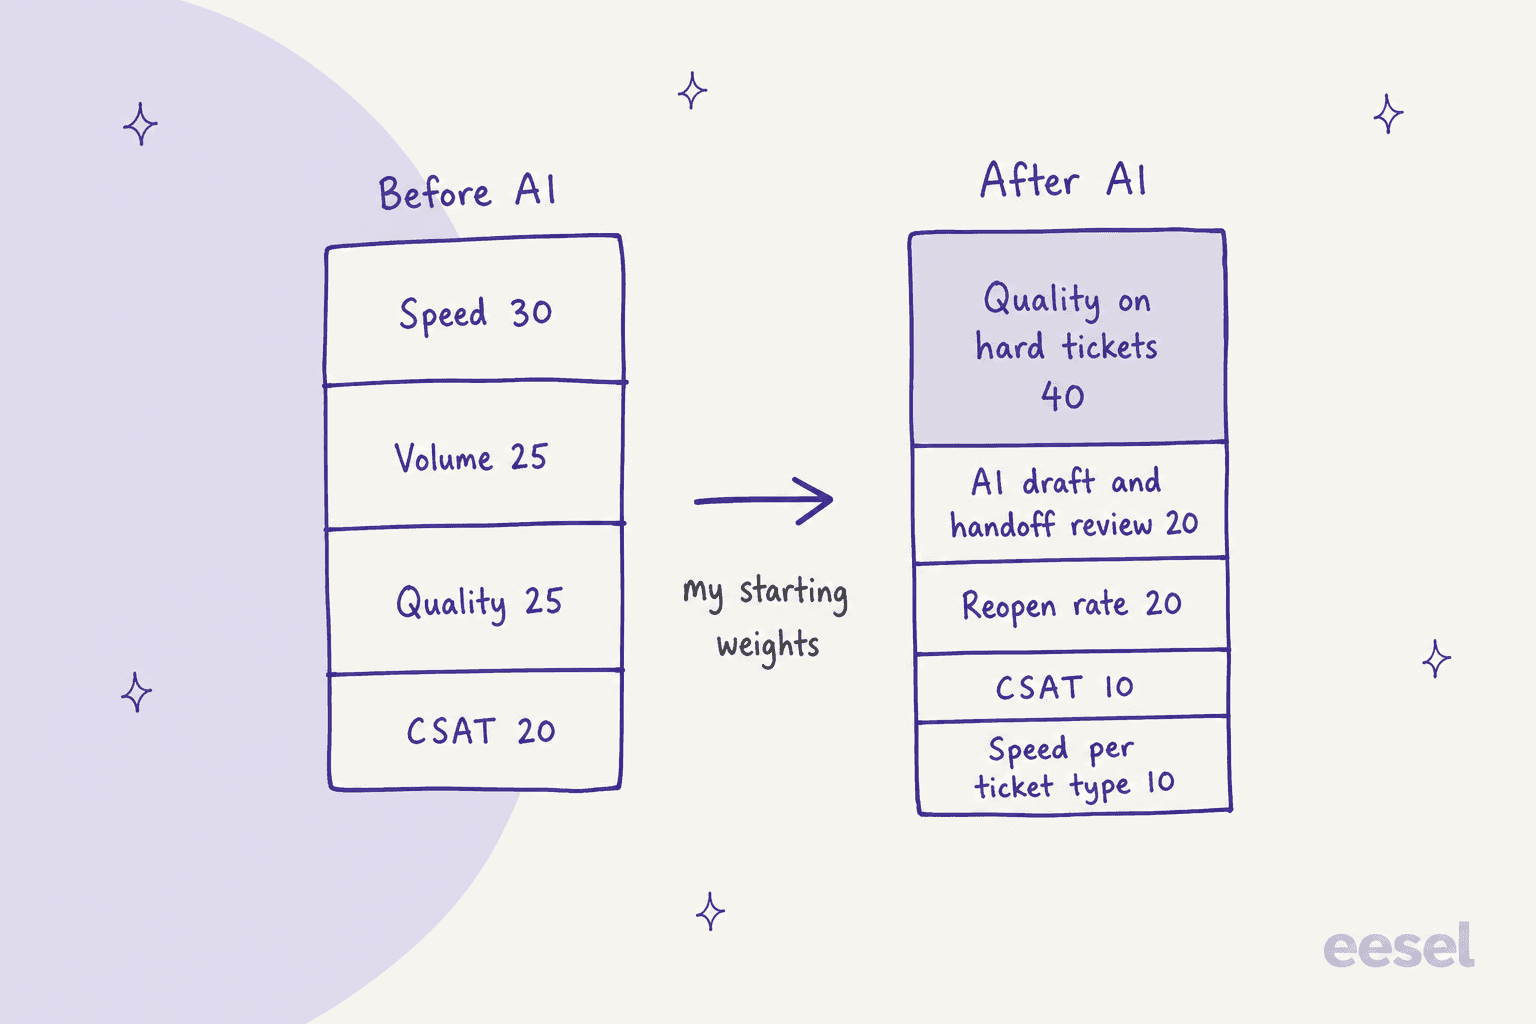
これが、私が出発点にする重みの付け替えです。ベンチマークではなく初期値なので、最初のキャリブレーションの後に調整してください。変更点は次のとおりです。
- 個人の件数目標をなくす。 AIが簡単なチケットを振り分けると、担当者1人あたりのクローズ数は構造的に減ります。代わりに、キューに費やした担当者の合計時間を追跡しましょう。詳しくは対応時間短縮のためのAIで説明しています。
- 速度はチケットタイプ別に測る。 返金チケットとパスワードリセットが同じ基準を共有してはいけません。Gorgiasはすでに、人が対応したチケットだけでチケット対応時間を計算し、AI Agentが解決したチケットは除外しています。このルールはどのヘルプデスクでもまねできます。
- AIと協働する項目を加える。 担当者は今や、下書きを承認、編集、却下し、ハンドオフを受け取ります。smavaでは、eeselが共有のZendesk上で1か月に約15,300件の返信下書きを用意し、担当者は下書きを承認するか、メモに@eeselと書いて別のマクロを依頼します。これをうまくレビューすることはスキルであり、「誤った下書きを見抜いた」「有用なハンドオフメモを残した」という項目はスコアカードに入れるべきです。
- 返信だけでなく、ハンドオフもレビューする。 AIが注文確認済みの状態で引き継ぐなら、それはハンドオフの質であり、担当者のタイピング速度よりも数字に影響します。
サポート歴が30年近いRedditのコメント投稿者は、これを無視した場合の代償をはっきりこう述べています。
"Except now imagine an eight-hour shift where practically EVERY conversation you receive is an escalation, an angry customer, an unusual problem or something the AI already couldn't solve."
これはコーチングとシフト編成の問題でもあります。人員配置の面はサポート人員配置のためのAI、シフトの面はシフト引き継ぎのためのAIで取り上げています。
AIで担当者の品質を採点できるヘルプデスクツールはどれですか?
標準機能を備えたヘルプデスクは5つあり、宣伝文句が示す以上に違いがあります。各ベンダー自身のドキュメントと料金ページを読んだので、下の表は各社の表現と価格だけを使っています。
| ヘルプデスク | 採点対象 | AIが判断するチケットの範囲 | 掲載価格 |
|---|---|---|---|
| Zendesk QA | 人とAIエージェントの全やり取り。共感や解決策などの組み込みカテゴリと、プロンプトベースの独自カテゴリ | スコアカードに書いた内容すべて | すべてのSuiteプランでQAアドオンとして提供、価格は非掲載。Workforce Engagement Bundleは年払いで担当者1人あたり月額$50 |
| Gorgias Auto QA | クローズ済みチケット。クローズの12時間後に採点 | 3つの基準(解決の完全性、コミュニケーション、言語)。ほかの4つ(正確さ、効率、社内コンプライアンス、ブランドボイス)は手動のみ | AI Agentサブスクリプションでデフォルトでオン。プランの上限を超えた自動対応は1件あたり$1.50 |
| Front Smart QA | カスタマイズ可能なスコアカードに基づく全チケットと、Smart CSAT | 自分で定義した基準 | Enterpriseに含まれると記載。年払いで1席あたり月額$105 |
| HubSpot QA score | クローズ済みのヘルプデスクチケット、1〜5で評価 | 3つの基準(トーン、明瞭さ、共感)。ベータ版 | Service Hub Enterprise、1席あたり月額$150 |
| Freshdesk Quality Coach | 解決済みの会話。担当者の受信トレイに表示され、管理者向けのQuality Scoreレポートもある | 6つのパラメータ(冒頭と締め、迅速さ、返信の質、感情、文法、フィラーワード) | Freddy Copilotの設定で有効化。Freddy AI CopilotはProとEnterpriseで担当者1人あたり月額$29 |
並べて読んで気づいた点をいくつか挙げます。
- Zendeskは最も柔軟ですが、価格は最も不透明です。 基準は自分で書き、Spotlightが解約リスクや堂々巡りを知らせてくれます。AI Agent QAでは、ボットと人のスコアを並べて比較することもできます。代償は営業担当との商談です。設定方法はZendesk QAスコアカードの基準とAIエージェントのためのZendesk QAで説明しています。
- Gorgiasは、自社の限界について最も正直です。 ドキュメントには、正確さとブランドボイスは手動でしか採点できないこと、カスタム基準は現時点では利用できないこと、250文字未満のチケット、ソーシャルのチケット、電話は対象外であることが明記されています。これは役に立ちます。スコアカードのどの半分に人の判断がまだ必要かがわかるからです。コスト面はGorgias AI Agentの料金をご覧ください。
- Frontは、QAとCSAT推定をまとめて提供します。 品質の視点と、AIが推定した満足度の視点を1か所で見られます。プランの詳細はFrontの料金にあります。
- HubSpotは最も慎重です。 ベータ版でEnterprise限定です。席の価格に見合うかどうかは、HubSpot Service Hub AIで取り上げています。
- Freshdeskは最も歴史があります。 ただしヘルプ記事は2024年のものなので、運用を組む前にご自身のプランと照らして確認してください。プランはFreshdeskの料金にあります。
これらのどれも使っていない場合や、ベンダーに依存しない視点がほしい場合は、カスタマーサポート品質保証ツールで単体のQAプラットフォームを比較しています。
AIスコアを担当者にとって公平に保つには?
すべてのスコアを、人が読むチケットを選ぶためのシグナルとして扱い、決して判定としては扱わないでください。ベンダー自身もそう言っています。HubSpotのヘルプ記事は、QAスコアは不正確な場合があり、コーチング、業績評価、報酬、懲戒、その他個人に関する判断の唯一の根拠にすべきではないと警告しています。
私が回す流れは次のとおりです。
- 全チケットをAIで採点する。 これは最初のセクションで述べた、母数の問題への対策です。
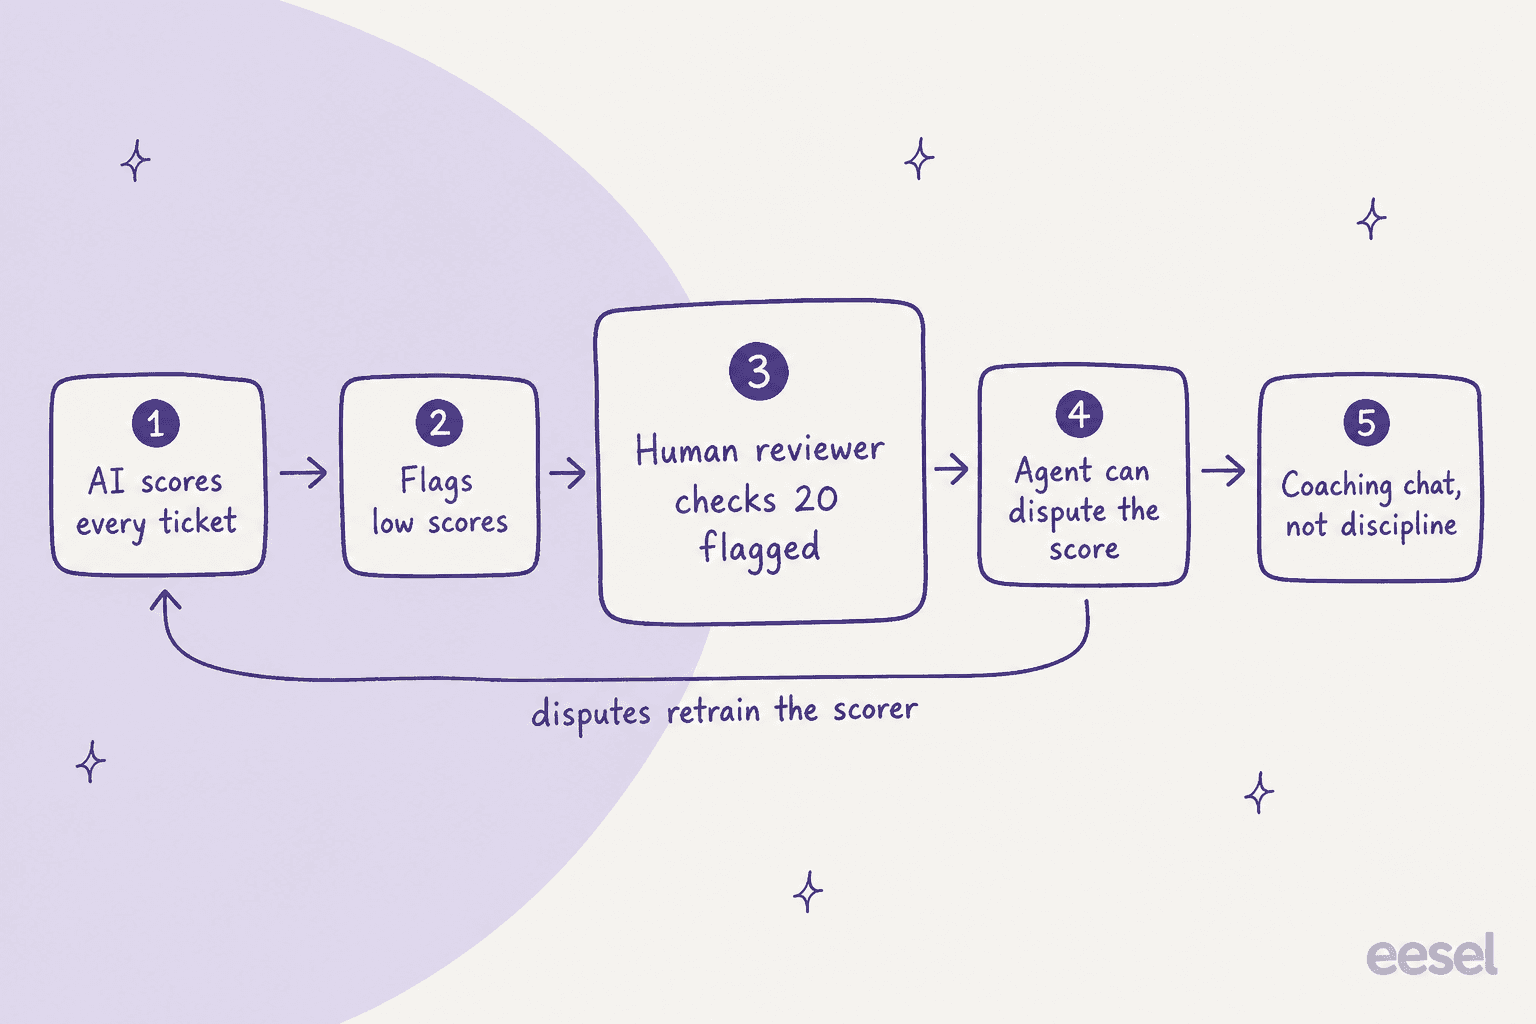
- フラグが付いたものは自分で読む。 チーム全体で週20件のフラグ付きチケットを読むほうが、担当者ごとに無作為の5件を読むより優れています。シグナルがある場所を読むことになるからです。
- キャリブレーションする。 2人の人間に同じ20件のチケットを採点してもらい、AIと比較します。食い違った箇所は、人ではなく基準の文言を直します。G2のスレッドでは、AIスコアリングと並行して人によるキャリブレーションをどう維持しているかが問われており、よくある答えは、AIが最初の選別を行い、人によるセッションは残すというものです。
- 担当者に異議を申し立てさせる。 Gorgiasでは、レビュー担当者がスコアのどの部分でも編集でき、その編集内容はモデルのファインチューニングに使われます。お使いのツールにその機能がなくても、「このスコアは間違っている、理由はこれ」と言える担当者がいれば、システムはより正確になり、信頼も高まります。
- 感情スコアだけで懲戒しない。 感情やトーンのスコアは、最も怒った顧客を引き当てた人を不利にします。AIによる振り分けの後は、それが全員です。
感情が個々の担当者の評価に向かない理由は、サポートのためのAI感情分析の記事で説明しています。公平性の観点からも、AIエージェントをシミュレーションするのと同じように、採点ツールを信頼する前にテストすべきだと考えます。
スコアをコーチングにつなげるには?
月に1人1つの行動を選び、2件のチケットを見せて、1つの変更に合意します。スコアはチケットを見つけ、対話が仕事をします。
私が行う順番での30日間の計画です。
- 第1週:母数を整える。 ヘルプデスクのAI QAをオンにして、クローズした全チケットを採点させます。担当者ごとのランキングはまだ見ません。
- 第2週:キャリブレーション。 上記の20件チェックを行い、人とAIで読み方が分かれた基準を書き直します。
- 第3週:重みを付け替える。 AI導入後のスコアカードに移行します。個人の件数目標はなし、速度はチケットタイプ別、下書きレビューとハンドオフの項目を追加します。
- 第4週:1on1を始める。 担当者1人につき強み1つと習慣1つを、2件のチケットを根拠に話します。ツール面はAIによる担当者コーチングとカスタマーサポートコーチングソフトウェアで、AI自体をコーチングする方法はサポートのためのAIエージェントコーチングで扱っています。
新人の場合も同じ流れがより速く機能します。AIの下書きが実践例の役割を果たすからです。詳しくはカスタマーサポート担当者のオンボーディングをご覧ください。
eeselは担当者のパフォーマンスにどう関わりますか?
eeselは人間の担当者をスコアリングしません。担当者が取り組む仕事そのものを変えます。eeselは既存のヘルプデスクの中に入るAIヘルプデスクチームメイトで、定型的なチケットに回答または下書きを行い、残りをメモ付きで人に引き継ぎます。そのため、チーム向けに作るスコアは、残った仕事を反映したものになります。eeselは長年、実際のサポートキューでAIを運用しており、導入のたびに過去のチケットでシミュレーションを行います。これにより、公平なスコアカードに必要な、人間のキューの前後比較が得られます。
公開されている3つの顧客事例が、異なるヘルプデスクでの同じパターンを示しています。
- Gorgias: Question Beautyでは、eeselが1か月に約960件の返信を送り、990件のうち約280件をクローズしました。約250件は、注文照会が添付された状態で人に渡りました。
- Zendesk: smavaは、2つのブランドにまたがる1つのZendeskで月に約27,000件のチケットを処理しています。eeselはそのうち約14,600件を分類し、約15,300件の下書きを用意しました。人が各下書きを承認するか、別の担当に回します。
- Freshdesk: SamCartでは、担当者が割り当てられていない間だけeeselがチケットに返信し、チームメイトがチケットを引き取った時点でeeselの担当は終わります。どのチケットをどのスコアカードに載せるかを決めるうえで、明確な線引きになります。

AI自体を評価するには、AIサポートパイロットスコアカード、AI解決率のガイド、封じ込めとエスカレーションの質を使ってください。コスト面は、AIエージェントと人間のエージェントのコスト比較に比較があります。
スコアの対象にすべきでないチケットは、eeselで試してみませんか
担当者がパスワードリセットや注文状況の質問で評価されているなら、まずそれらをeeselに任せ、残った仕事を中心にスコアカードの重みを付け替えましょう。eeselはZendesk、Freshdesk、Gorgias、HubSpot、Frontに接続し、ヘルプセンターと過去のチケットから学習します。
eeselの料金は固定のクレジットプランです。チケットまたはチャット1件は、長さにかかわらず1クレジットで、無料プランには全機能を試せる100クレジットが含まれ、有料プランは500クレジットで月額$299からです。ご自身のチケットでeeselを試して、キューのどれだけが簡単なタイプなのかを確かめてください。