

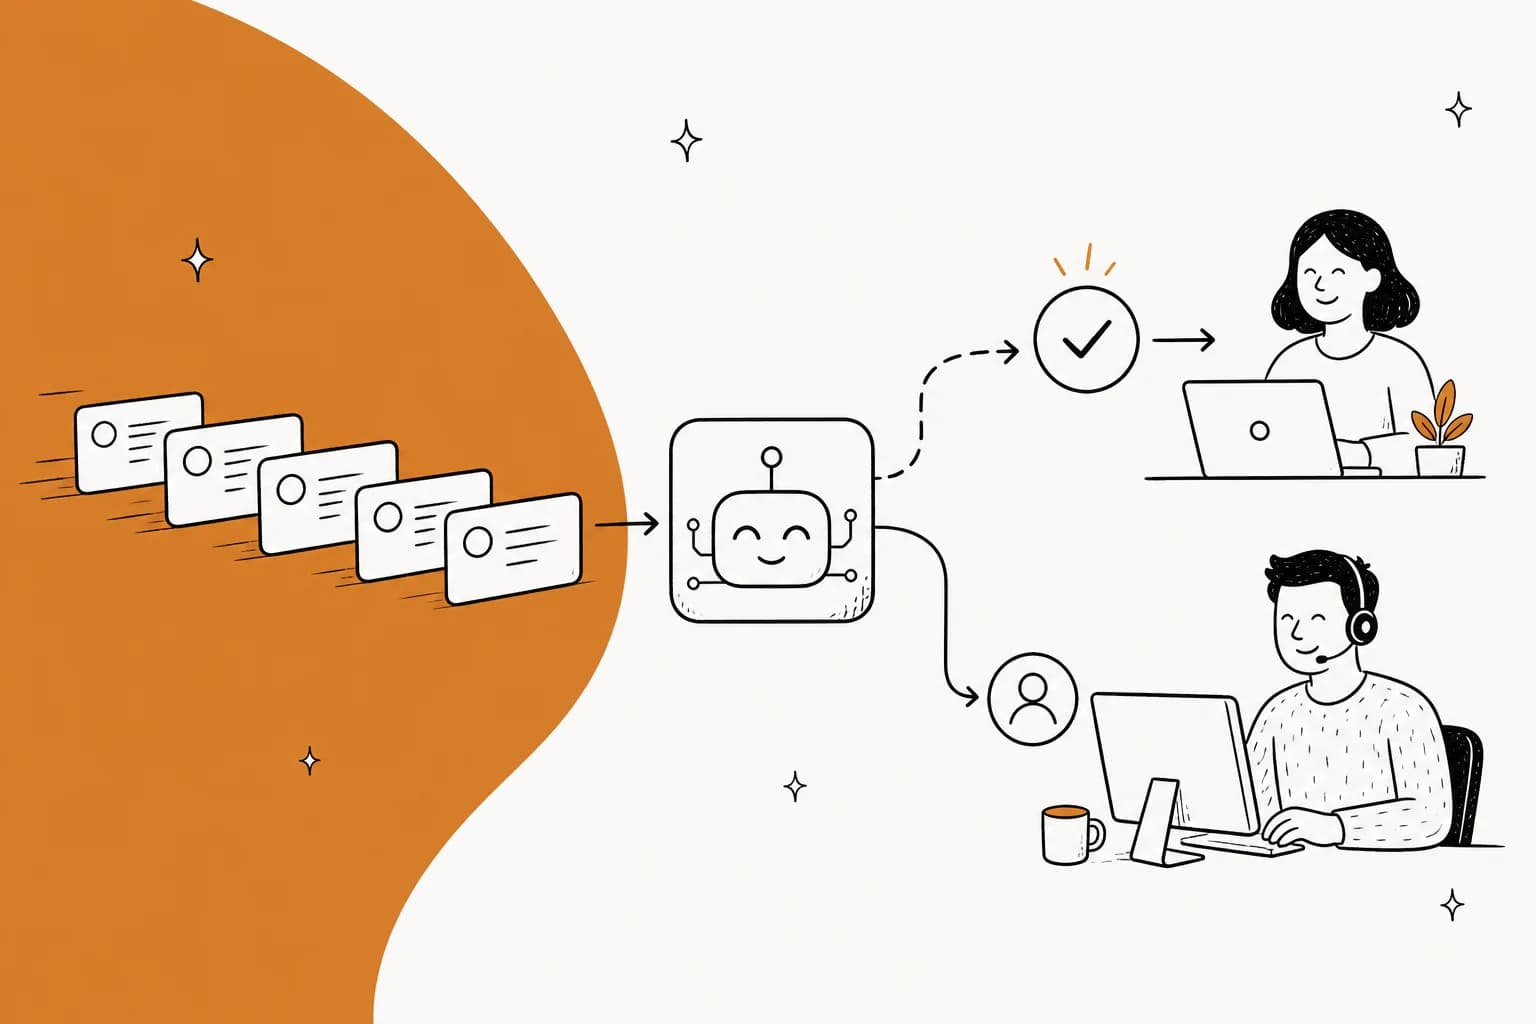
Suporte ao cliente com IA é um software que lê uma mensagem recebida, busca a resposta nos seus próprios documentos e tickets passados, e então responde ou entrega a conversa para uma pessoa. A parte interessante não é responder. É a entrega. A maioria das implantações que decepcionam acertou a busca e errou a escalada.
A regra de escopo que se sustenta em filas reais: automatize os tickets de alto volume e baixo julgamento, e deixe de fora tudo em que errar seja caro ou difícil de reverter. É no meio que as equipes se queimam, e a solução é um limiar de confiança que deixa a IA recusar em vez de adivinhar.
Uma implantação realista leva de duas a quatro semanas, não dois dias, e a parte lenta é sua base de conhecimento, não o software. Comece em modo rascunho, em que uma pessoa ainda aperta enviar, deixe exatamente um tipo de ticket ser enviado automaticamente, e então amplie. Eu construo IA de suporte na eesel há anos, e o padrão é consistente: o primeiro mês já vale a pena só pela velocidade de rascunho, bem antes de qualquer coisa se resolver sozinha.
Se a eesel for a ferramenta que você vai testar, um agente de código com IA pode cuidar da primeira configuração. Assim que você aprova o acesso, ele conecta seu helpdesk, adiciona os documentos a partir dos quais a IA deve responder, e começa em modo rascunho, para que uma pessoa continue apertando enviar. Isso dá a você a velocidade de rascunho desde a primeira semana enquanto decide qual tipo de ticket enviar automaticamente primeiro. Veja o guia de configuração com um agente de código.
O que o suporte ao cliente com IA realmente é
Tirando o marketing, são quatro passos. Uma mensagem chega. O sistema busca na sua central de ajuda, nos seus tickets passados e em qualquer outra coisa que você tenha conectado. Ele decide se conhece a resposta bem o suficiente para enviar uma. Então ele responde, rascunha algo para uma pessoa verificar, ou escala.
É isso. Todo o resto, cada "agêntico" e "autônomo" e "inteligente", é uma afirmação sobre o quão bem cada um desses quatro passos é executado.
Os termos se confundem o tempo todo, então aqui está a separação que sobrevive a uma demo. Três perguntas dizem a você qual categoria está diante de você: quem lê a saída, se ela pode escrever em um sistema de registro, e se decide raciocinando ou seguindo um roteiro.
| Quem lê a saída | Pode mudar seus sistemas | Como decide | |
|---|---|---|---|
| Chatbot baseado em regras | O cliente | Não | Uma árvore de decisão que você desenhou |
| Agente de IA | O cliente | Sim, se você permitir | Raciocina sobre seu conteúdo |
| Copiloto | Seu atendente | Só quando um humano envia | Raciocina, o humano aprova |
Um chatbot baseado em regras quebra no momento em que um cliente formula algo do jeito que uma pessoa real formularia. Um agente de suporte com IA raciocina sobre seu conteúdo e pode agir. Um copiloto rascunha e deixa seu atendente apertar enviar. A diferença entre agentes de IA e chatbots não está no modelo por baixo, está em se essa coisa tem permissão para terminar uma tarefa.
Mais uma frase que vale a pena desmontar, porque aparece em quase toda página de fornecedor: "treinado com seus dados". Isso cobre três mecanismos completamente diferentes.
- O fine-tuning assa seu conteúdo nos pesos do modelo. Lento para atualizar, e seus dados já saíram de casa.
- O retrieval indexa seus documentos e os cita no momento da resposta. É o que RAG significa, e é o que quase todo mundo realmente faz. Edite um artigo, e a próxima reindexação captura isso.
- As chamadas de ferramentas em tempo real consultam sua API de pedidos no momento. A única das três capaz de responder "onde está meu pedido", porque a resposta não existia quando o índice foi construído.
Pergunte a um fornecedor qual das três ele quer dizer. Isso muda a velocidade com que uma mudança de política se propaga, quanto dos seus dados sai dos seus sistemas, e se a coisa consegue responder perguntas específicas da conta. Vale a pena entender o trade-off entre RAG e fine-tuning para centrais de ajuda antes de sentar em uma demo, e se você quiser a camada por baixo, busca vetorial para suporte cobre a mecânica do retrieval.
Como funciona, ticket a ticket
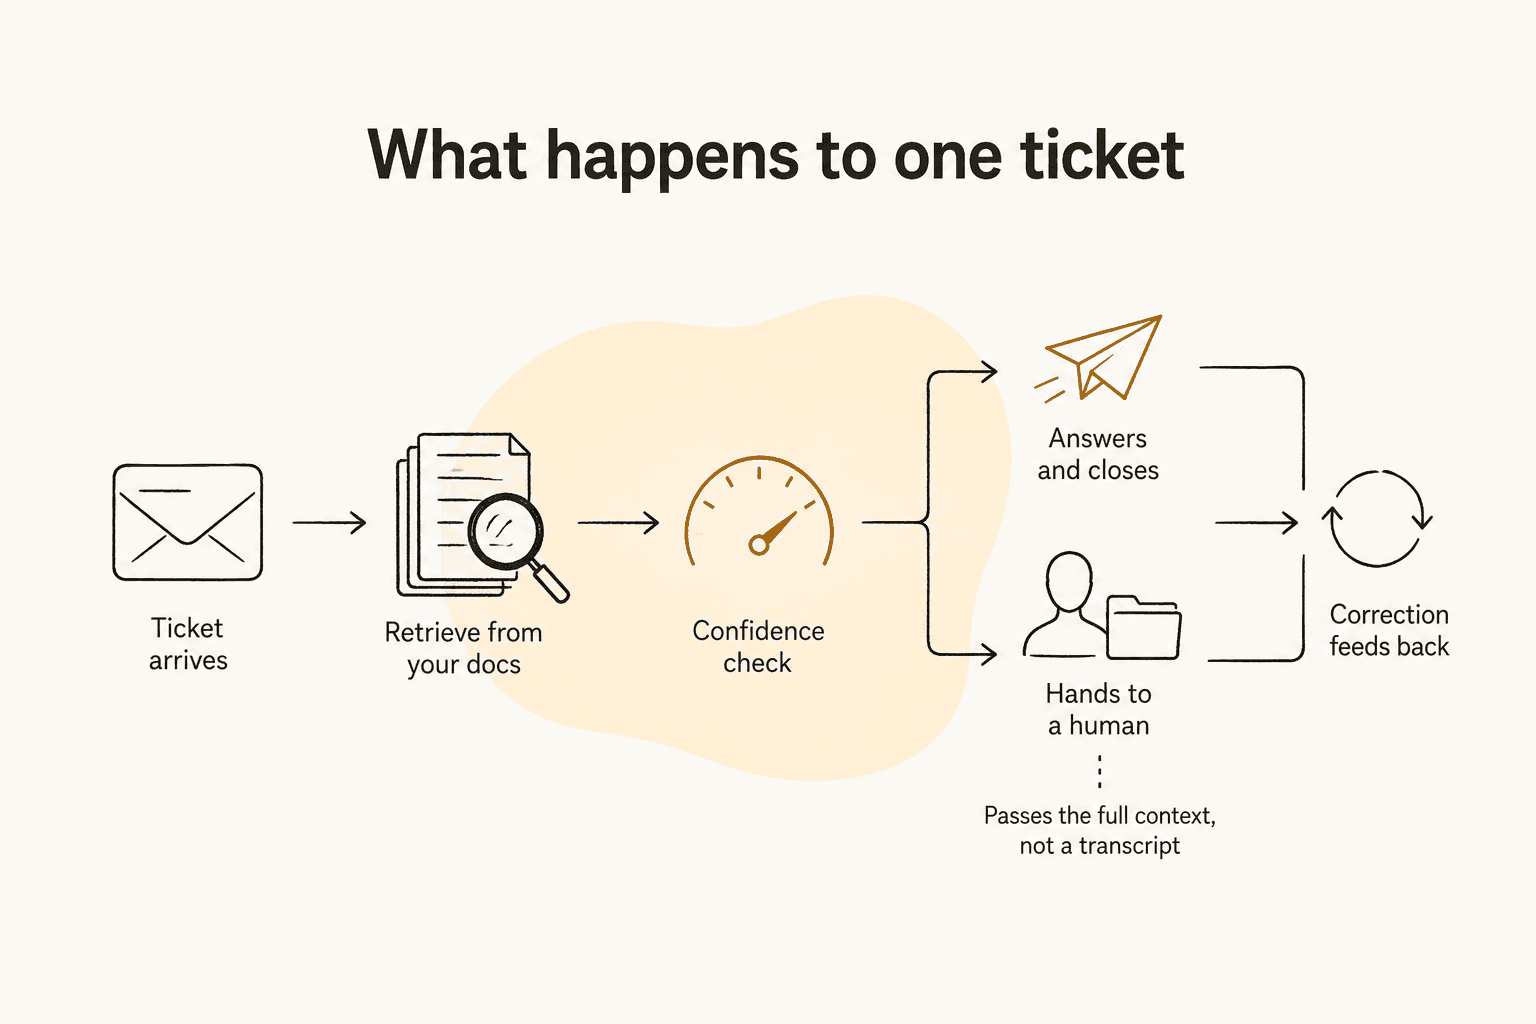
Siga um ticket, e o mecanismo deixa de ser misterioso.
Ele lê o ticket e descobre o que está sendo pedido. Não é correspondência de palavras-chave. Classificação de intenção mais extração de entidades mais uma leitura de sentimento, de modo que "essa é a terceira vez que pergunto sobre o pedido 44182 e estou perdendo a paciência" se resolve em uma pergunta de status de pedido, um número de pedido, e um cliente irritado. Esse último sinal importa mais do que se espera, e a análise de sentimento é muitas vezes o que decide se a IA responde ou não.
Ele busca em tudo o que você conectou, ao mesmo tempo. Artigos da central de ajuda, tickets passados resolvidos, macros, uma wiki interna, PDFs enviados. Bons sistemas agrupam isso em vez de isolar por integração, de modo que uma resposta pode se apoiar tanto nos seus documentos públicos quanto no seu runbook interno. Grounding é o termo para amarrar a resposta ao texto recuperado em vez da memória do modelo, e é a maior palanca única de precisão.
Ele verifica se deveria falar. Essa é a etapa da pontuação de confiança, e é aí que as boas implantações se separam das más. Confiança alta envia uma resposta. Confiança baixa escreve uma nota interna para uma pessoa, em vez disso. Na eesel, esse comportamento é algo que você configura em linguagem simples, não um limiar que você ajusta numericamente, e a documentação do agente de helpdesk deixa o fallback claro: se não sabe, ele diz, ou escala.
Ele age, ou entrega. Agir significa escrever em um sistema: marcar o ticket, atualizar um campo, consultar um pedido, emitir um reembolso, fechar a conversa. Entregar significa uma transferência real com o contexto anexado. Mais sobre isso abaixo, porque é a parte em que todo mundo investe de menos.
As correções voltam ao sistema. Seu atendente reescreve o rascunho, ou diz ao sistema que ele foi muito formal, e isso fica registrado como uma mudança de instrução em vez de evaporar. Sem esse ciclo, você fica reensinando a mesma lição toda semana.

O que ele deveria tratar, e o que não deveria
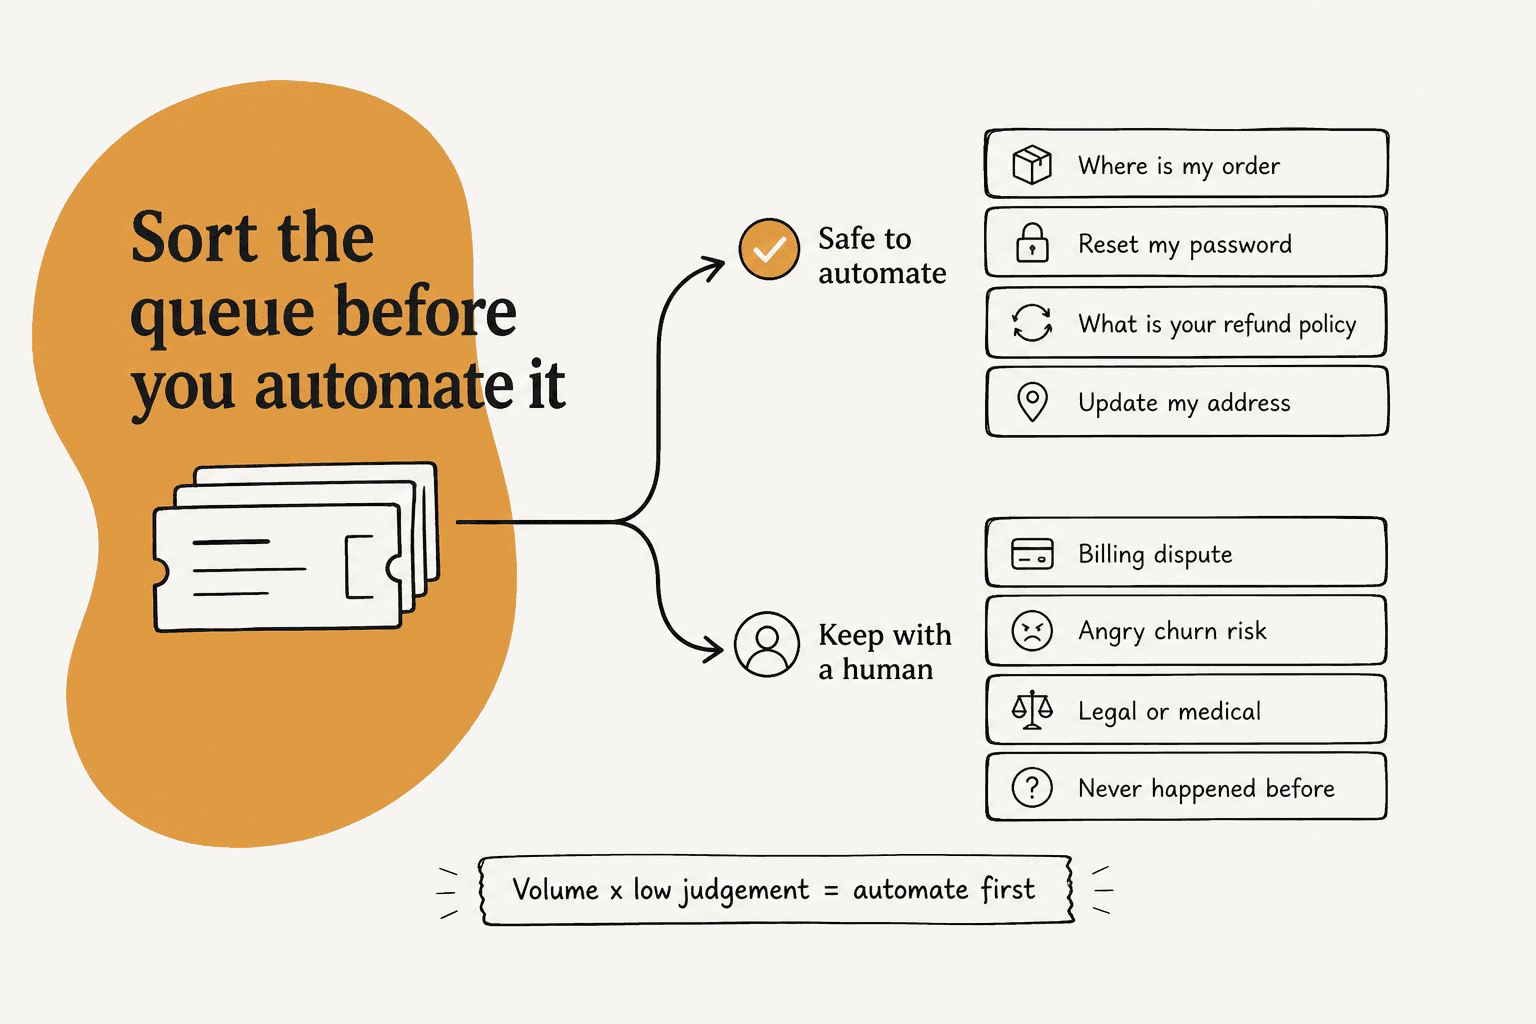
A regra de escopo à qual eu sempre volto é volume vezes baixo julgamento. Volume alto por si só não basta, porque mil disputas de cobrança idênticas continuam sendo mil disputas de cobrança. Baixo julgamento por si só também não basta, porque não vale a pena automatizar uma pergunta que você recebe duas vezes por mês.
Automatizar primeiro: status de pedido e WISMO. Redefinições de senha. Perguntas de política com uma resposta documentada. Mudanças de endereço e de assinatura. Triagem de tickets e roteamento. Tradução. Eles compartilham uma propriedade: a resposta certa já existe por escrito em algum lugar, e enviar a errada custa um e-mail de acompanhamento, não dinheiro.
Spam também pertence a essa lista, e é subestimado. Em um teste real ao qual voltarei mais adiante, 22% da fila de entrada era lixo, e capturar tudo isso antes de uma pessoa ler uma única palavra foi uma vitória do primeiro dia, sem nenhum risco voltado ao cliente.
Deixar para uma pessoa: qualquer coisa em que errar seja caro ou difícil de reverter.
- Exceções de política. O dia 35 de uma janela de devolução de 30 dias é uma questão de julgamento, não uma consulta. A IA deveria sinalizar e escalar isso, não decidir.
- Dinheiro acima de um teto que você define. Escreva o número. O agente pode emitir um crédito de até X $; acima disso, uma pessoa assina. Quase ninguém publica essa regra, e toda implantação real tem uma.
- Conversas regulamentadas. Aconselhamento médico, jurídico, financeiro. Compliance não é um selo em uma página de preços, é uma restrição sobre o que o agente tem permissão para dizer.
- Clientes já irritados. Uma boa entrega na primeira mensagem vence uma ótima resposta na quarta.
- Qualquer coisa que nunca tenha acontecido antes. Se não há precedente no seu histórico de tickets e nada nos seus documentos, o retrieval não retorna nada, e é exatamente sob essa condição que os modelos começam a inventar.
Esse último ponto merece atenção, porque eu vi em tempo real como isso deu errado no nosso próprio produto. Quando o retrieval volta vazio, um modelo que não foi instruído a parar preenche a lacuna com dados de treinamento. Tivemos clientes pagantes, incluindo um fornecedor dinamarquês de energia solar, cujo bot inventou afirmações sobre produtos e as enviou para pessoas reais, porque a base de conhecimento não tinha correspondência e ninguém tinha dito a ele para recusar. A solução nunca foi um modelo melhor. Foi um limiar rígido e um fallback de recusar responder.
Existe uma versão mais simples do mesmo teste que eu colocaria em um quadro branco antes de qualquer implantação: essa ação pode ser desfeita com um clique? Se não, uma pessoa aprova. Isso cobre reembolsos, cancelamentos, exclusões de conta, e qualquer coisa que envie um e-mail que um cliente vá tirar print.
A afirmação mais afiada sobre isso que já ouvi veio de uma líder de CX de uma marca de suplementos DTC que lida com cerca de 7.000 tickets do Gorgias por mês contra 30.000 pedidos:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Provavelmente perdemos aquele negócio por isso, que é exatamente por que eu continuo citando. "Leave them alone" é um requisito de produto mais difícil do que "responder a tudo", e é o que os compradores realmente se importam.
Os benefícios que se sustentam, e os limites que ninguém imprime
A lista honesta de benefícios é mais curta que a do marketing, mas cada item nela é verificável.
Cobertura fora do seu horário. Essa é a vitória menos contestável. Uma fila que antes ficava parada a noite toda agora recebe o primeiro contato às 3 da manhã, e a cobertura fora do horário costuma ser o que uma equipe pequena sente primeiro.
Alcance de idiomas sem traduzir sua central de ajuda. Um ticket em português recebe uma resposta em português a partir de documentação em inglês. Um cliente eesel, a plataforma de comparação de empréstimos Smava, opera um agente do Zendesk totalmente automatizado que trata mais de 100.000 tickets em alemão por mês, um número publicado na página do agente de helpdesk. O suporte multilíngue antes era um problema de quadro de funcionários e agora, na maior parte, não é mais.
Velocidade no nível chato. O tempo de primeira resposta cai muito nos tipos de ticket que você delimitou, porque não há mais fila na frente deles.
Consistência. Todo atendente responde a pergunta sobre a política de reembolso da mesma maneira, o que não é glamouroso, mas é o que seu líder de QA quer há três anos.
Agora os limites, dito com clareza, porque prefiro que você os encontre aqui do que em produção.
Ele é só tão bom quanto seu conhecimento escrito, e o seu provavelmente está no formato errado. Um gerente de suporte em um serviço de rastreamento de ônibus nos contou que toda a base de conhecimento deles era escrita para administradores, enquanto todo ticket vinha de passageiros. O retrieval funcionava perfeitamente e as respostas continuavam confusas. O conteúdo desatualizado da central de ajuda é a outra metade do mesmo problema: a política mudou em março, o artigo não, e a IA cita com confiança em agosto uma política morta.
Uma taxa de desvio alta pode esconder uma implantação que está falhando. Se os tickets estão fechando e os contatos repetidos estão subindo, você está desviando, não resolvendo. Acompanhe os dois juntos, ou o painel vai mentir para você.
O excesso de escalada é um modo de falha real e parece segurança. Um agente que entrega tudo para uma pessoa não quebra nada, não irrita ninguém, e silenciosamente nunca entrega um retorno.
O tom é um problema separado da precisão. Isso nos surpreendeu com números reais, e é o núcleo do exemplo calculado abaixo.
Os clientes podem odiar mesmo quando você constrói bem. Esse é o limite que ninguém coloca em uma página de preços, e a versão mais honesta disso que já li veio de alguém que liderou o projeto:
"This is so true. I led the implementation of an AI customer service agent and even though management thinks it's a great success the metrics tell a totally different story. Our customers hated it. I haven't seen anything in tech that is hated more. Before you think we did a bad job with our solution, I can tell you we went with some of the best and did our own intensive testing and worked on latencies etc., I actually thought the final version was pretty good but our customers just hated it."

A razão pela qual esse comentário é difícil de descartar é a defesa preventiva no meio dele. Minha leitura é que a lacuna está quase sempre no posicionamento: uma IA que é uma ferramenta que o cliente pode contornar está bem, e uma IA que é um portão que ele precisa vencer não está.
Ele não remove o trabalho operacional, ele o desloca. Alguém é dono da base de conhecimento, revisa as escaladas, e lê o relatório semanal. Em 24 contas eesel que deram churn, nosso cofundador Amogh Sarda encontrou o mesmo fio condutor: "zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier." Implantações não rodam sozinhas, de nenhum dos lados.
Onde as equipes realmente usam isso
Cinco padrões cobrem a maior parte do que vejo em filas reais.
Status de pedido e envio. A pergunta de maior volume e menor julgamento no e-commerce, e a que mais precisa de uma chamada de ferramenta em tempo real em vez de uma busca em documento, porque a resposta vive no Shopify, não na sua central de ajuda. Vale a pena ler sobre automatizar o rastreamento de pedidos antes de delimitar isso.
Devoluções e reembolsos, com um teto. A IA pode lidar com reembolsos dentro de uma política documentada. Defina o limite em dólares, coloque tudo acima disso atrás de uma aprovação, e você terá coberto o volume sem entregar o cofre. A mecânica de automatizar reembolsos tem mais a ver com o desenho da aprovação do que com a IA.
Triagem de nível 1. Mesmo quando a IA nunca responde a um cliente, classificar, etiquetar, priorizar e rotear é uma vitória real. A deflexão de nível 1 é a manchete, mas o roteamento de tickets é o mais silencioso, aquele que os atendentes notam primeiro.
Assistência ao atendente, no helpdesk que já usam. O padrão copiloto: o rascunho está esperando quando o atendente abre o ticket. Zero novos hábitos, o que explica por que a adoção é alta e o risco é quase nulo.
Suporte interno de TI e de funcionários. O lugar mais seguro para começar, porque seu público é composto de colegas, não de clientes. O chefe de TI da InDebted colocou a eesel como primeira respondente na fila do Jira Service Management e a descreveu como se comportando "just like an agent would". Eles estão em 15% de deflexão enquanto visam 55%, e esse número me agrada mais do que os chamativos, porque mostra honestamente como é o terceiro mês.
Se você está na mesma pilha, IA para Jira Service Management cobre a configuração, e o mesmo padrão se estende além da TI para o helpdesk de RH e o suporte a funcionários em geral.
Profundidade técnica também não está automaticamente fora de escopo, o que me surpreendeu. Uma das deflexões mais fortes que já vi nos nossos próprios logs foi um técnico de campo em um fornecedor de automação industrial relatando uma falha de hardware com códigos de erro e sintomas de rede. O agente rodou seis buscas em manuais em PDF, leu dois deles por completo, e rascunhou um conjunto estruturado de testes de isolamento. Profundidade não é a barreira. Se a resposta está escrita em algum lugar, essa é a barreira.
Desenhando a escalada, a parte que todo mundo pula
Aqui está minha opinião real depois de anos com isso: o desenho da escalada é o produto. Responder já é o básico agora. O que separa uma implantação que sua equipe defende de uma que ela rejeita é o que acontece nos 20% das conversas que a IA não deveria concluir.
A confirmação externa mais clara disso que já vi veio de um operador de contact center descrevendo o que realmente aconteceu com os números dele depois do lançamento:
"AHT question nobody wants to answer lol. shipped a billing/tracking bot, decent containment, but AHT on escalated calls went up. agents had to read the transcript, figure out what the bot already tried, re-ask half of it anyway. fixed by forcing a structured handoff summary instead of raw transcript dump (saved more time than the automation itself). CSAT fine on deflected stuff, tanked on anything that bounced back after a failed bot attempt"

Leia essa última frase duas vezes. O CSAT estava bem nas conversas que o bot concluía, e despencava nas que voltavam quicando. A automação estava funcionando. A entrega era o defeito do produto, e corrigi-la economizou mais tempo do que a própria automação.
Três falhas que já vi acontecer, todas piores do que uma resposta errada.
A entrega que só anuncia a si mesma. O bot diz ao cliente que vai transferi-lo para uma pessoa, e depois não faz isso. Uma empresa de hospedagem holandesa no Zendesk enfrentou isso repetidamente, junto com nome e e-mail do cliente que não eram transferidos na passagem, e acabou construindo algo próprio. A frase do Amogh sobre essa classe de bug ficou comigo: "If hard-fail it's silent-failure class (worst class for trust)." Um erro visível é recuperável. Uma conversa que silenciosamente não foi para lugar nenhum não é.
A escalada para o vazio. Uma implantação escalava por e-mail, e o e-mail de escalada era fechado automaticamente por uma regra que ninguém lembrava de ter escrito. Nenhum humano jamais viu. O painel mostrava que as escaladas estavam disparando corretamente.
A IA que se faz passar por uma pessoa. Mesma implantação: o agente tinha pego o nome de um atendente humano no histórico de tickets e começou a assinar com o nome dela. Os clientes pensavam que tinham chegado a uma pessoa. Dê um nome ao seu bot, e faça com que ele diga o que é.
Então, concretamente, o que um bom desenho de escalada especifica antes de ir ao ar:
- Os gatilhos. O pedido explícito por uma pessoa. A mesma pergunta feita duas vezes. Uma leitura de sentimento além de uma linha que você define. Uma intenção na sua lista de bloqueio. Uma conta de alto valor nomeada. Mais aquele que quase ninguém escreve: as condições de não escalar, em que você decidiu que a IA deveria continuar em vez de desistir.
- A carga. O histórico completo da conversa, um resumo claro do que a IA tentou e por que parou, a leitura de sentimento, e cada registro que ela recuperou. Uma transcrição sozinha faz a pessoa reler tudo, o que é o oposto de ajudar. As boas práticas de entrega vão mais a fundo aqui.
- A rota. Qual fila, qual prioridade, e se a leitura de sentimento da IA pode fazê-la subir. A gestão de escaladas é tanto um problema de roteamento quanto um problema conversacional.
- O que é dito ao cliente. Você está citando um tempo de espera? A transcrição continua visível? Acertar o desenho da conversa de entrega é barato, e a diferença se sente imediatamente.
- O que acontece quando não há ninguém ali. Noites, fins de semana, uma fila a 200%. Essa é a falha de escalada real mais comum e a menos documentada. A resposta geralmente é um padrão de espera que define uma expectativa real, não uma promessa falsa.
Esse último ponto tem uma versão melhor do que "desculpar-se e esperar". Uma fintech com a qual trabalhamos, com 7.000 a 8.000 tickets escalados por mês enquanto espera parceiros de pagamento terceirizados, usa a IA para manter os tickets escalados aquecidos com atualizações de status honestas. Não precisa de base de conhecimento, só de instruções. Escalar não precisa significar que a conversa para.
Nem toda entrega é complicada, também. Aqui está uma dos nossos próprios logs, no chat do site de uma ferramenta de SEO: o cliente perguntou como excluir palavras-chave de um projeto, recebeu uma resposta, perguntou como excluir motores de busca, recebeu outra, e então perguntou "Posso falar com uma pessoa?" e foi transferido imediatamente. Duas perguntas resolvidas por conta própria, uma saída limpa. É assim que um sistema que funciona parece de fora, e é completamente normal, que é o ponto.
Se você está especificamente no Zendesk, regras de escalada do Zendesk cobre o lado nativo disso, e entrega humana no chat cobre a versão de canal em tempo real, em que os segundos realmente importam.
Como implantar, semana a semana
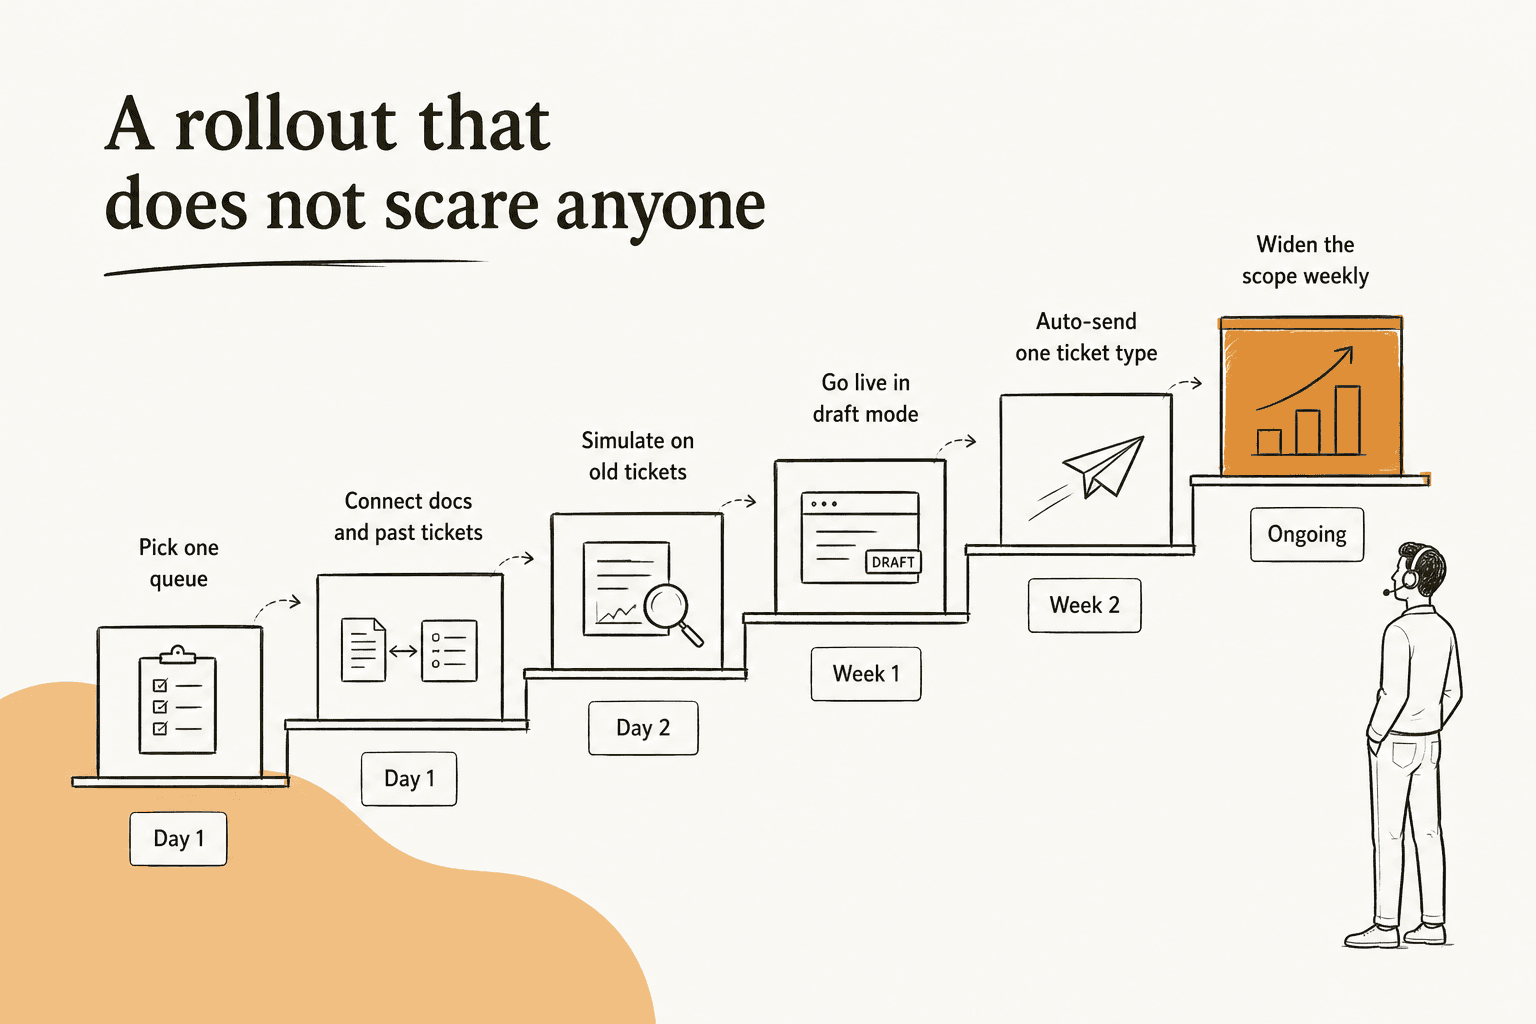
Conectar um helpdesk e conseguir uma primeira resposta leva cerca de meia hora. Chegar a uma implantação em que sua equipe confia leva de duas a quatro semanas, e a parte lenta nunca é o software.
Dia 1: escolha uma fila, não o helpdesk inteiro. Um canal, um tipo de ticket, um idioma. A falha que mais vejo é equipes apontando a IA para tudo no dia um, obtendo resultados medianos em todo lugar, e concluindo que a categoria não funciona.
Dia 1: conecte o conhecimento, incluindo tickets passados. Documentos, central de ajuda, macros, e seu histórico de tickets resolvidos. Esse último é o que os compradores pedem antes de qualquer outra coisa, e a nota do Amogh sobre isso é direta: "past ticket training strikes again. Classic. People really, really, really want to train on past tickets." Também é de onde vem um tom realista, porque sua central de ajuda é escrita com voz de política e seus tickets com voz humana. Você também não precisa de uma base de conhecimento perfeita para começar. Uma equipe do Reino Unido no Zendesk conseguiu 56 tarefas resolvidas a partir de nove macros sincronizadas, e continuou usando 38 dias depois que o teste expirou.
Dia 2: simule contra tickets que você já respondeu. Essa é a etapa que quase nenhuma página de fornecedor descreve, e a que eu me recusaria a pular. Reproduza um lote de tickets passados, deixe o agente rascunhar o que ele teria dito, e avalie esses rascunhos contra o que sua equipe realmente enviou. A simulação da eesel roda em modo sandbox e informa a cobertura por tema, então você obtém "política de reembolso 28%, erros de login SSO 35%" em vez de um único número de precisão sem sentido. Então você preenche a lacuna específica e roda de novo.
Defina um critério de aprovação antes de olhar os resultados, ou você vai racionalizar o que obtiver. O meu é: em uma amostra de pelo menos 100 tickets reais, erros factuais abaixo de 5% nas intenções que você delimitou, e nenhum erro nas categorias que você isolou.
Semana 1: vá ao ar em modo rascunho. Tickets reais, clientes reais, e toda resposta ainda sai por meio de uma pessoa. Você mede a diferença entre o que a IA rascunhou e o que seu atendente enviou, e essa diferença é o diagnóstico mais útil que você vai conseguir. Isso também significa que seu pior resultado possível na semana um é um rascunho desperdiçado.
Semana 2: envie automaticamente exatamente um tipo de ticket. O mais estreito, mais documentado, mais reversível que você tiver. Status de pedido é a escolha habitual. Observe por uma semana, com uma pessoa lendo cada conversa.
Semana 3 em diante: amplie por escopo, nunca por porcentagem. Adicione uma intenção por vez, e mantenha os números de deflexão de tickets ao lado dos números de contato repetido. Qualquer coisa que toque em dinheiro ou no estado da conta fica atrás de uma aprovação por muito mais tempo do que parece necessário.
Se você quer a mesma sequência de alguém que não está vendendo nada para você, isto se aproxima da versão que eu escreveria:
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."
A revisão das conversas reabertas é o detalhe que eu roubaria dali. Seu documento de escopo diz o que a IA deveria tratar. O registro de reaberturas diz a você o que ela de fato consegue tratar.
Duas coisas que vão realmente quebrar seu cronograma, e nenhuma delas está no roadmap de fornecedor nenhum. A primeira é a limpeza da base de conhecimento, que são horas reais de trabalho humano real. A segunda são as credenciais de integração, porque a pessoa com acesso de administrador no seu helpdesk está de férias. Reserve orçamento para as duas.
E existe um modo de falha além de tudo isso que vemos mais do que qualquer problema técnico, e não tem nada a ver com qualidade de resposta. Alguns testes ficam totalmente configurados, a integração conecta, os documentos sincronizam, e então ninguém conecta um gatilho, então nenhuma tarefa nunca dispara. Outros fazem tudo certo e ainda assim estagnam: observamos uma coorte em que nove em dez testes ativados tinham conversas funcionando com 96% de pontuação de qualidade, e exatamente um deles converteu. Em nenhum dos casos a IA era o problema. Configuração não é implantação, e implantação não é adoção. Alguém precisa ligar e ser o dono.
Nosso guia de implementação completo tem a versão mais longa dessa sequência, e implementar suporte com IA cobre o lado de gestão de mudança que deixei de fora aqui.
A aritmética mês a mês, com seus números
A maioria dos modelos de custo salta direto para uma taxa de desvio já madura, por isso o primeiro mês parece uma decepção. Coloque seu próprio volume, e a forma da rampa fica evidente.
A unidade cobrada é a outra metade disso, e é a palavra indefinida mais cara da categoria. Custos por assento, por pessoa. Custos por resolução, só quando algo se conclui. Custos por ticket, por cada conversa que a IA toca. Isso produz faturas radicalmente diferentes com o mesmo volume, então a pergunta a fazer a um fornecedor não é "quanto", mas qual evento incrementa o contador. A resposta da eesel, na sua página de preços, é 1 crédito por ticket ou chat atendido (planos a partir de 299 $/mês por 500 créditos), não importa quantas mensagens vão e voltam, o que é deliberadamente a unidade na qual as equipes de suporte já pensam. Nosso detalhamento do custo por resolução faz a comparação corretamente, e custo do suporte com IA coloca os modelos lado a lado.
O que medir, e as três palavras que os fornecedores confundem

Três métricas são usadas de forma intercambiável em quase toda página de fornecedor, e elas medem coisas diferentes. A razão de isso importar não é pedantismo, é que uma delas pode parecer ótima enquanto seus clientes estão passando por algo pior. O líder de suporte da PostHog colocou essa discrepância melhor do que eu conseguiria:
"Most companies don't realize the frustration they're creating. They look at the numbers, see fewer tickets coming in, and read it as a good sign: customers must be doing fine. Companies call it "deflection." Customers call it being ignored."
Vale notar que a PostHog vende análise de produto, não IA de suporte, e aquele post argumenta contra colocar IA na frente de uma fila de suporte, de forma geral. Eu não concordo totalmente, mas a distinção que eles traçam entre IA como ferramenta e IA como portão é a certa, e um número de desvio não consegue te dizer qual dos dois você construiu.
| Métrica | Numerador | Denominador | O que ela esconde |
|---|---|---|---|
| Taxa de desvio | Contatos que nunca chegaram a uma pessoa | Todos os contatos | Se o problema foi resolvido |
| Taxa de resolução | Problemas realmente resolvidos sem uma pessoa | Conversas em que a IA se engajou | Nada, se você também medir o contato repetido |
| Taxa de contenção | Conversas que ficaram no canal | Conversas que entraram nele | Se o cliente desistiu |
Qualquer porcentagem dessa família não significa nada sem o denominador, e os fornecedores citam o enquadramento que dá o maior número. A pergunta que resgata isso toda vez: porcentagem de quê, de quantos, em qual período?
O que eu realmente observaria toda semana:
- Taxa de resolução junto com taxa de contato repetido. Nenhuma delas sozinha diz nada. Juntas, dizem tudo. Nosso guia para melhorar a taxa de resolução é a continuação assim que os números forem honestos.
- Taxa de escalada e os motivos por trás dela. Uma escalada saudável não é uma falha. Uma escalada que disparou porque o retrieval não encontrou nada é um ticket para a base de conhecimento, não um problema da IA.
- Taxa de lacuna de conhecimento: as perguntas que o agente marcou como sem resposta. Esse é o número mais acionável de todo o conjunto, porque é uma lista de tarefas.
- CSAT dividido em três: em conversas resolvidas por IA, em escaladas, e misturado. São três números diferentes, e o misturado é o menos útil.
- Custo por ticket, incluindo suas próprias horas. O preço do software é a parte fácil. Medir corretamente o ROI do suporte com IA significa contar também a limpeza da base de conhecimento e o tempo de revisão.
Para a lista mais completa, nosso artigo sobre métricas de suporte vai mais a fundo do que posso ir aqui. Se você quiser o lado da qualidade da escalada especificamente, taxa de contenção é a próxima leitura.
Um fluxo de trabalho real, do começo ao fim
Aqui está o teste ao qual eu continuo apontando as pessoas, porque o resultado não foi o que ninguém esperava.
Uma joalheria online alemã, com cerca de 1.000 tickets por mês no Zendesk com Shopify por trás, não simplesmente ligou algo e ficou esperando. Eles rodaram o agente de verdade contra sua caixa de entrada em tempo real: 284 chats mais uma validação cruzada de 100 tickets, de modo que cada número veio de tickets que a própria equipe já tinha tratado.
A caixa de entrada se dividia aproximadamente em 38% de suporte direto ao consumidor, 22% de spam, e 21% de B2B interno. A triagem chegou a 93% de precisão, e a detecção de spam a 100% sem falsos positivos, o que, em uma caixa de entrada em que quase um quarto do volume é lixo, é uma vitória real do primeiro dia antes mesmo de existir uma única resposta voltada ao cliente.
A qualidade dos rascunhos foi mais forte exatamente onde vive uma política bem documentada: 96,4% de rascunhos úteis em reclamações de garantia, 93,8% em devoluções e reembolsos, 100% em consultas de produto e status de reembolso.
E então veio o número que fez todo mundo parar. Apenas 12% desses rascunhos foram enviados como estavam.
O instinto é ler isso como um problema de precisão. Não era. Quando detalhamos os motivos pelos quais os atendentes reescreviam os rascunhos, cerca de 65% das edições eram puramente de extensão e tom, porque os atendentes comprimiam rascunhos de 8 a 15 frases em respostas de 1 a 3 frases. Cerca de 20% precisavam de dados aos quais a IA não estava conectada, sistemas de ERP e logística. Só cerca de 5% das edições foram feitas porque a IA errou os fatos. Avaliada separadamente contra toda a amostra, em vez de contra as edições, a taxa de erro factual saiu em 7%.
Essa distinção é a coisa mais útil que aprendi rodando essas implantações. "A IA está errada" e "a IA não soa como a gente" são problemas diferentes com soluções diferentes, e só um deles se resolve com melhor conhecimento. A recomendação daquele teste foi concreta: treinar com 200 respostas recentes de atendentes, e a adoção tal como está deveria subir de 12% para algo entre 30 e 40%.

Para contraste, dois números publicados no outro extremo da rampa. A Gridwise resolveu 73% das solicitações de nível 1 no primeiro mês depois de um teste de sete dias, o que a eesel publica na sua página de produto. A Global Pay relatou até 80% de economia de tempo ao encontrar respostas na sua documentação. Ambos são reais, ambos são publicados, e nenhum deles é o que o seu primeiro mês vai parecer. O teste da joalheria, esse sim.
Teste a eesel para suporte ao cliente com IA
Se algo do que foi dito acima parece a sua fila, essa é a forma do problema para o qual a eesel foi construída. Ela se conecta ao helpdesk que você já opera em vez de substituí-lo, em Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot e Jira Service Management. Ela lê seus documentos e seus tickets resolvidos, e começa em modo rascunho, de modo que nada chega a um cliente sem que uma pessoa tenha visto antes.
A parte para a qual eu realmente empurraria você é a simulação. Antes de decidir se algo disso funciona para sua equipe, rode o agente sobre seus próprios tickets passados e leia o que ele teria dito ao lado do que sua equipe realmente enviou. Essa comparação responde a pergunta que uma demo não consegue responder. Depois que você for ao ar, é um preço mensal fixo (a partir de 299 $/mês por 500 créditos) sem taxa de plataforma ou custo por assento, e os primeiros 100 créditos são gratuitos, o que é mais simulação do que a maioria das equipes precisa para tomar a decisão.

Teste a eesel, ou se preferir ver contra seus próprios tickets com alguém guiando você, a página do agente de helpdesk com IA é o lugar para começar.
Perguntas frequentes
O que é suporte ao cliente com IA?
Suporte ao cliente com IA é um software que lê uma mensagem recebida de um cliente, encontra a resposta na sua própria documentação e histórico de tickets, e então responde ou entrega a conversa para uma pessoa. A distinção útil é entre um chatbot baseado em regras roteirizado, que segue uma árvore de decisão, e um agente de suporte com IA, que raciocina sobre seu conteúdo e pode executar ações no seu helpdesk.
O que o suporte ao cliente com IA nunca deveria tratar?
Qualquer coisa em que errar seja caro ou difícil de desfazer: exceções de política, disputas de cobrança, aconselhamento jurídico, médico e financeiro, e qualquer ticket de um cliente que já está irritado. Uma boa regra é o teste da irreversibilidade. Se a ação não pode ser desfeita com um clique, uma pessoa aprova. Nossas notas sobre guardrails explicam como esses limites são codificados. Sobre o que acontece quando faltam, leia como prevenir alucinações.
Quanto custa o suporte ao cliente com IA?
Depende totalmente da unidade cobrada, o número que decide sua fatura. Preços por assento cobram por agente, preços por resolução cobram só quando a IA fecha algo, e preços por ticket cobram por cada conversa que a IA toca. A página de preços da eesel fixa um preço mensal único por créditos (a partir de 299 $/mês por 500 créditos, 1 crédito por ticket ou chat), sem taxa de plataforma e sem cobrança por assento. Nosso detalhamento do custo por resolução percorre a conta.
Quanto tempo leva para implantar suporte ao cliente com IA?
Conectar um helpdesk e fazer um primeiro agente responder leva cerca de 30 minutos. Chegar a uma implantação em que você confia leva de duas a quatro semanas, e o que mais estica esse prazo é quase sempre a base de conhecimento, não o software. Nosso guia de implementação cobre a sequência, e conteúdo desatualizado da central de ajuda cobre a auditoria que você faz primeiro.
Como medir se o suporte ao cliente com IA está funcionando?
Observe três números juntos, nunca um só: a taxa de desvio junto com a taxa de resolução e a taxa de contato repetido. Uma taxa de desvio subindo junto com uma taxa de contato repetido subindo significa que os tickets estão sendo fechados, não resolvidos. Nosso guia de métricas de suporte lista o restante dos valores que vale a pena acompanhar toda semana.
O suporte ao cliente com IA pode funcionar com meu helpdesk atual?
Sim, e adicionar essa camada por cima costuma ser a escolha mais segura em vez de substituir o helpdesk. A eesel se conecta a Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot e Jira Service Management, então sua fila, suas macros e seus relatórios ficam onde estão. A lista completa está na página de integrações. Para ver como isso fica na prática em uma pilha específica, veja IA para Zendesk.
O suporte com IA vai substituir os atendentes de suporte?
Em filas reais, o que de fato acontece é que o nível repetitivo desaparece e o trabalho humano fica mais difícil e mais valioso. Os tickets que chegam a uma pessoa são os ambíguos. Nossa comparação de custo de agente de IA versus humano e nossas notas sobre desvio de nível 1 cobrem as duas onde fica a linha.