

xAIは2026年8月12日にGrok 4.6を公開しました。Grok 4.5の5週間後です。これは本物の前進です。Artificial AnalysisではIntelligence Indexで60.92、測定された95モデル中6位で、GPT-5.6 Sol Maxの60.93と統計的に互角、GPQA Diamondでは94.9%で246モデル中の単独1位です。これを入力$2、出力$6(100万トークンあたり)で実現しており、この価格帯で最高スコアのモデルです。
ここからが、公開時の報道が触れなかった部分です。定価は変わりませんでしたが、請求額は変わりました。Grok 4.6のキャッシュ入力は100万あたり$0.50で、Grok 4.5の$0.30より高く、タスクあたりの出力も47%多く書きます。Artificial Analysisは、同じベンチマークの実行コストがGrok 4.6で$1,068、Grok 4.5で$579、見出し料金が同じなのに1.84倍だったと測定しました。キャッシュの読み書きが4.6の請求の57%を占めます。リクエストのたびに大きな固定プロンプトを送り直すワークロードなら、つまりサポートキューがまさにそうですが、「同じ価格」にはなりません。
そして顧客の前に出すことを考えている方へ。正しい方向に動いた数字はハルシネーション率で、54.1%から34.3%に下がりました。本物の改善ですが、それでも3回に1回は誤答です。eesel自身のエージェントが、実行していない作業を自信満々に報告するのを私は見てきました。だからこそ今は、あらゆるロールアウトを、生身の人間に返信する前に顧客の過去チケットで検証します。優れたモデルは天井を押し上げます。床は作ってくれません。
Grok 4.6とは実際に何か
はじめにのページは、xAI自身の言葉で「SpaceXAI's frontier model built for coding, agentic tasks, and knowledge work」と説明しています。自社ドキュメントの本文では社名が実際に「SpaceXAI」と表記されるようになっていますが、ドメイン、xai_sdkパッケージ、@ai-sdk/xaiプロバイダーはいまだにxAIのままです。整えずに、公開されているとおりに報告します。
興味深いのは位置づけの変化です。Grok 4.5は自身のモデルページで「coding model for agentic software, engineering, and workflow tasks」と狭く位置づけられていました。モデル一覧は現在、CodeとChatの両方の推奨を4.6に向け、「our flagship model for code and everything else.」と呼んでいます。xAIが専門特化のラインを汎用フラッグシップに統合したということです。
仕様表は、すべてxAI自身のページからです。
| 項目 | Grok 4.6 |
|---|---|
| APIモデル名 | grok-4.6(エイリアスは公開なし) |
| コンテキストウィンドウ | 500,000トークン |
| 出力上限 | 「No text output limit」(ドキュメントより) |
| 知識カットオフ | 2026年2月1日 |
| 推論の強度 | low / medium / high / xhigh、既定はhigh、無効化不可 |
| モダリティ | テキストと画像を入力、テキストを出力。画像は最大20 MiB、jpgまたはpngのみ |
| 組み込みツール | 関数呼び出し、Web検索、X検索、コード実行 |
| レート制限 | 150リクエスト/秒、5,000万トークン/分 |
| リージョン | us-east-1とus-west-2のみ |
| API | Responses APIとChat Completions |
このうち3行は、もう一度よく見る価値があります。
xhighは唯一の本当に新しい機能です。 既定のhighの上にある4番目の推論レベルで、4.6にしか存在しません。落とし穴は古いモデルでの挙動です。xAIの推論ドキュメントは、これをサポートしないモデルでは「such as grok-4.5, requests with xhigh are treated as high.」と述べています。エラーではなく、黙ってのダウングレードです。xhighを含む設定を出荷し、障害時に4.5へフォールバックしても、モデルが静かに頑張らなくなったことをログは何も教えてくれません。
知識カットオフは2026年2月1日で、その帰結についてxAIは率直です。 モデルページには「Grok has no knowledge of current events or data beyond what was present in its training data.」とあります。最新の情報にはWeb SearchまたはX Searchをサーバー側で有効にする必要があり、トークンに加えて1,000回あたり$5が課金されます。サポート用途では、注文状況、現在の在庫、今週のポリシー変更など、どれもモデルからは得られず、すべて自社システムから来ます。
エイリアスなし。 Grok 4.5のページにはgrok-4.5-latestとgrok-build-latestが載っていますが、4.6のページにはエイリアス行自体がありません。そのためgrok-4.5-latestは今も4.5を指しており、-latestタグでアップグレードに自動で追従していた方は、今回は対象外です。
ベンチマークを正しく読む
ここで2つを切り分けたいと思います。xAI自身の発表表が両者を混ぜているからです。10行のうち3行は、Artificial Analysisの独立した測定値の再掲です。残り7行はxAI自身の実行結果で、外部の確認はありません。どちらも読む価値はありますが、証拠と呼べるのは片方だけです。
まず独立した測定から。Artificial Analysisは、9つの評価を合成したIntelligence Index v4.1.1でGrok 4.6(high)を60.92と採点し、廃止されていない95件の測定対象中6位、クラスの中央値34に対する位置づけです。
| 順位 | モデル | Intelligence Index |
|---|---|---|
| #1 | Claude Opus 5(max) | 63.05 |
| #2 | Claude Opus 5(xhigh) | 62.52 |
| #3 | Claude Fable 5(max) | 62.07 |
| #4 | Claude Opus 5(high) | 61.48 |
| #5 | GPT-5.6 Sol(max) | 60.93 |
| #6 | Grok 4.6(high) | 60.92 |
| #7 | Kimi K3(max) | 59.70 |
| #14 | Grok 4.5(high) | 55.76 |
5位と6位の差は0.007指数ポイントなので、4.6が「matches GPT-5.6 Sol」というxAIの主張は誇張ではなく妥当です。これを興味深くしているのは隣の価格列です。Grok 4.6より上のスコアのモデルは、すべて出力100万トークンあたり$12か$25を請求しますが、Grok 4.6は$6です。
ベンチマークごとに、前モデルとの比較です。
| ベンチマーク | Grok 4.6 | Grok 4.5 | 変化 |
|---|---|---|---|
| GPQA Diamond | 94.9%(246中1位) | 93.1% | +1.8 |
| Terminal-Bench v2.1 | 88.4%(3位) | 81.6% | +6.8 |
| Tau-3-Banking(エージェント型のツール利用) | 50.7%(2位) | 42.1% | +8.6 |
| GDPval-AA v2(Elo) | 1753(3位) | 1526 | +227 |
| AA-Briefcase(Elo) | 1577(4位) | 1313 | +264 |
| AA-LCR(長いコンテキスト) | 75.0%(27位) | 74.0% | +1.0 |
| Humanity's Last Exam | 42.9%(15位) | 42.7% | +0.2 |
| SciCode | 53.6%(16位) | 54.1% | -0.5 |
GPQA Diamondが際立っており、246モデル中の本物の1位で、94.1%のGemini 3.1 ProとGPT-5.6 Sol Maxを上回ります。4.6が後退したのはSciCodeだけで0.5ポイント、後退というより誤差の範囲です。
正直な留意点が2つあります。第一に、Grok 4.6の速度データはまだありません。 Artificial Analysisのページではタイミング情報が空で、性能の出典はxAI自身の一次情報と表示されています。そのため毎秒トークン数や最初のトークンまでの時間は示せず、4.5の55.62トークン/秒をそのまま当てはめるつもりもありません。第二に、xAI自身の表ではTerminal-Bench v3.0が26%ですが、Artificial AnalysisはTerminal-Bench v2.1を88.4%と報告しています。難易度が大きく異なる別のベンチマークであり、同じ文に並べると、62ポイントも崩落したかのような誤解を招きます。より難しいv3.0では、xAI自身の表によれば、Grok 4.6はGPT-5.6 Solの34.6%とFable 5の34.1%の後ろです。負けている行まで公開したxAIは評価に値します。
サポートチームが気にすべき唯一のベンチマーク
ここまではすべて順位表です。次の数字が、モデルがあなたの顧客と話せるかどうかを決めます。
Artificial AnalysisはAA-Omniscienceを実行しており、正解には加点、捏造には減点、「わかりません」には減点しません。
| 指標 | Grok 4.6 | Grok 4.5 |
|---|---|---|
| Omniscience Index | 30.48 | 25.32 |
| 正確さ | 48.2% | 51.6% |
| ハルシネーション率 | 34.3% | 54.1% |
注意深く読んでください。データセット全体で最も興味深い結果だからです。Grok 4.6の素の正確さは実は3.4ポイント下がりました。それでもOmniscienceのスコアが上がったのは、ハルシネーション率が54.1%から34.3%へ、ほぼ20ポイント下がったからです。モデルは、より多く知ることではなく、でっち上げを減らすことで良くなりました。
これは正しい方向であり、同時に無人のキューを任せたくない理由でもあります。自信ある回答の3分の1は依然として誤りです。サポートチケットでは、流暢に届けられた誤答は無回答より悪く、顧客がそれに基づいて行動してしまいます。ここで救ってくれるのは、より大きなモデルではなく、信頼度スコアのしきい値、自社コンテンツに範囲を絞ったグラウンディング、そしてモデルが迷ったときのきれいなエスカレーションです。全体のパターンはサポートでのAIハルシネーション防止に、テスト面は敵対的テストにまとめました。
ここでは競合ではなく、eesel自身の信頼性を差し出します。eesel自身のプロダクトで私が見た最悪の失敗モードは、本番環境で記録されたもので、事実の誤りではありませんでした。次のものです。
"The agent fabricates success. Worst observed pattern: narrating 'executing Zendesk searches' for ~10 turns without ever hitting the API; reporting files 'saved' that don't exist; fabricating metrics. Nothing kills a teammate faster than lying about what it did."
これは競合のレビューではなく、eesel自身の社内エンジニアリングメモです。ベンチマークを信じる代わりに本番前にシミュレーションする具体的な理由であり、19ポイントのハルシネーション改善を「十分」ではなく「心強い」と受け止める理由でもあります。
Grok 4.6の料金と、変わった1行
xAIの料金ページにある全テキストモデル、両方のコンテキスト帯の最新表を、丸めずにそのまま示します。
| モデル | コンテキスト | 入力 | キャッシュ | 出力 | 長文:入力 / キャッシュ / 出力 |
|---|---|---|---|---|---|
grok-4.6(新) | 500k | $2.00 | $0.50 | $6.00 | $4.00 / $1.00 / $12.00 |
grok-4.5 | 500k | $2.00 | $0.30 | $6.00 | $4.00 / $0.60 / $12.00 |
grok-build-0.1 | 256k | $1.00 | $0.20 | $2.00 | $2.00 / $0.40 / $4.00 |
grok-4.3 | 1M | $1.25 | $0.20 | $2.50 | $2.50 / $0.40 / $5.00 |
grok-4.20-multi-agent-0309 | 1M | $1.25 | $0.20 | $2.50 | $2.50 / $0.40 / $5.00 |
grok-4.20-0309-reasoning | 1M | $1.25 | $0.20 | $2.50 | $2.50 / $0.40 / $5.00 |
grok-4.20-0309-non-reasoning | 1M | $1.25 | $0.20 | $2.50 | $2.50 / $0.40 / $5.00 |
ついでに言えば、フラッグシップはxAIが販売する中で最大のコンテキストを持つモデルではありません。grok-4.3と4.20ファミリー全体は1Mのコンテキストで、4.6は500kです。巨大なドキュメントを1回の呼び出しに詰め込むのが仕事なら、1年前のモデルのほうが受け止められます。
では変わった1行です。入力、出力、コンテキストウィンドウは4.5と4.6で同一です。唯一異なる列はキャッシュ入力で、4.6が$0.50、4.5が$0.30、差は67%です。方向は正確に述べておきます。xAIが途中で価格を上げたわけではありません。4.5のキャッシュ料金は7月の公開後のどこかで$0.30に下がり、4.6は古い$0.50のまま登場しました。現在の表での実質的な効果は、どちらにしても同じです。
この1つのセルが見た目以上に重要な理由です。
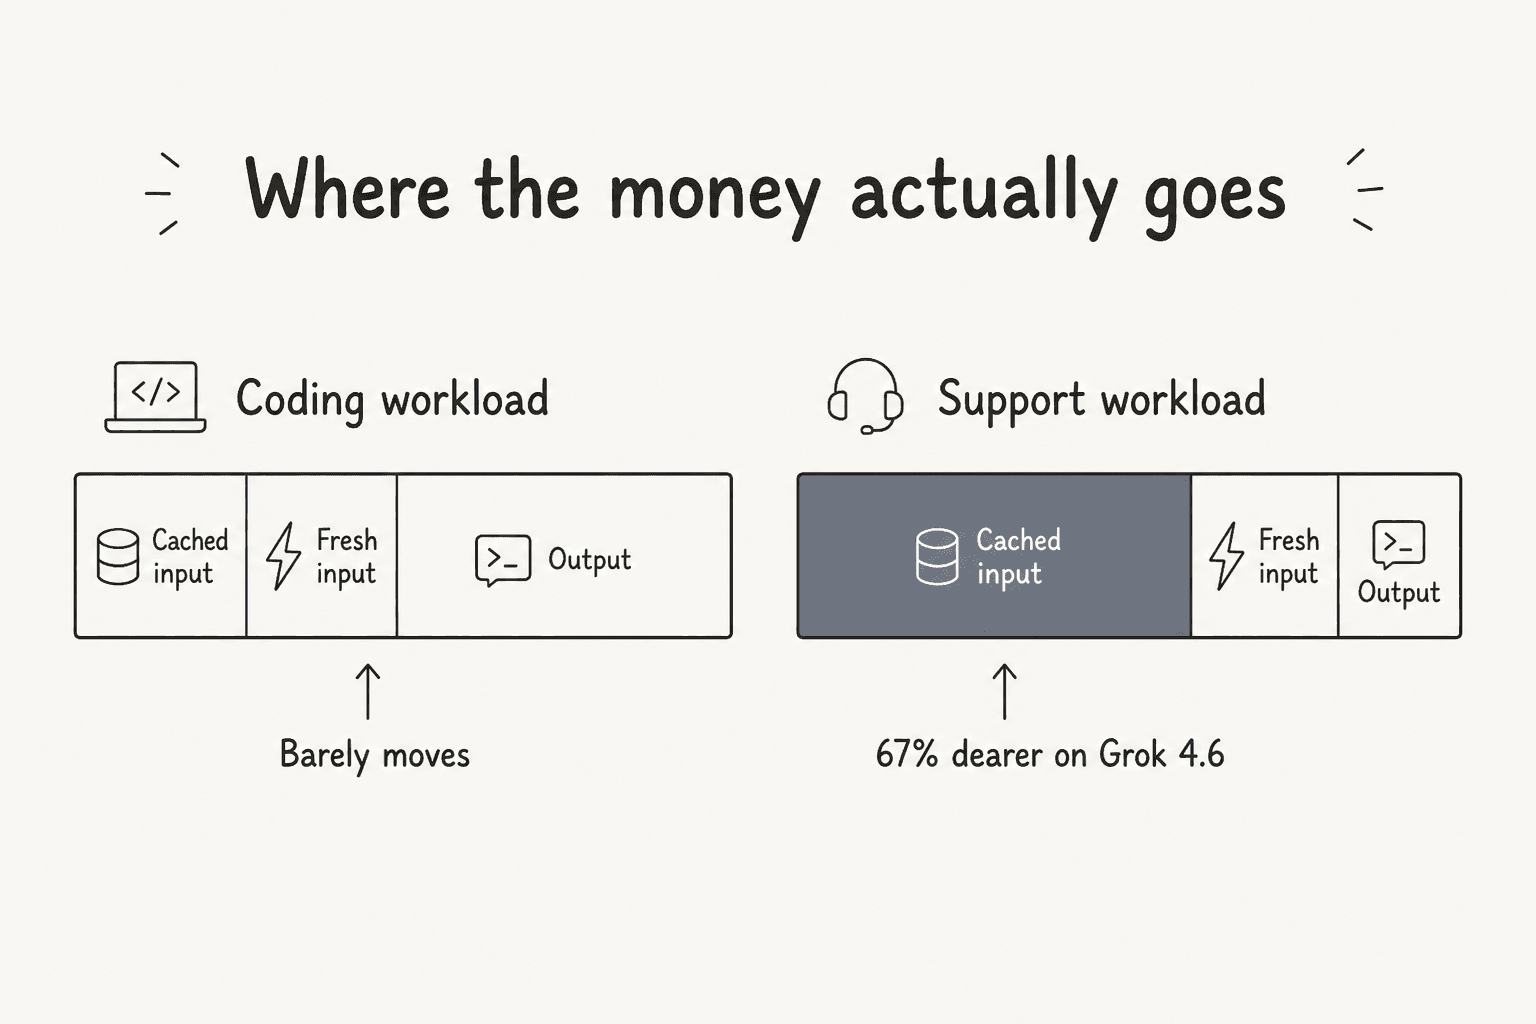
コーディングセッションは出力が重く、長い生成と絶えず変わるコンテキストが特徴です。サポート用途はその鏡像です。すべてのチケットが同じシステムプロンプト、同じトーンのルール、同じヘルプセンターの大量のコンテンツを送り直し、返ってくるのは3文です。これはキャッシュが支配する請求であり、キャッシュ入力は4.6のほうが高い唯一の料金です。
効果の大きさを私の言葉で信じていただく必要はありません。Artificial Analysisが実際の支出を公開しています。同じIntelligence Indexスイートの実行コストは次のとおりでした。
| コスト項目 | Grok 4.6 | Grok 4.5 |
|---|---|---|
| キャッシュ読み取り | $357.94 | $84.70 |
| キャッシュ書き込み | $253.63 | $111.33 |
| 推論トークン | $374.97 | $312.20 |
| 回答トークン | $57.96 | $46.98 |
| キャッシュなし入力 | $23.96 | $24.01 |
| 合計 | $1,068.47 | $579.21 |
| タスクあたり | $0.8367 | $0.3601 |
定価が同じで請求総額は1.84倍、しかもキャッシュの読み書きがその57%を占めます。一部は料金の差で、一部は挙動の差です。4.6はタスクあたり21,735出力トークンを生成し(4.5は14,795で47%増)、入力トークンは2.4倍を消費しました。トークン効率はGrok 4.5の発表時の目玉でしたが、Artificial Analysisの冗長さの評価は、2つのリリースの間に「better than average」から「somewhat higher than average」に変わりました。価格表がそうでないと言っていても、より深く考えるモデルはより高くつきます。
自分の数字を入れてみる
アップグレードが無料になるか25%の値上げになるかは、ワークロードの形で決まります。平均値で議論する代わりに、あなたの入力値で計算してみましょう。
誰も読まない2つの落とし穴
キャッシュ料金のほかに、この料金ページには請求時に驚かされる仕組みがあと2つあります。
200kの崖は段階ではなく、リクエスト全体の切り替えです。 xAIの文言は明確です。長いコンテキスト用の価格があるモデルは、プロンプトがしきい値に達した時点で、リクエスト内のすべてのトークンに長いコンテキストの料金を適用します。201kトークンのプロンプトは、超過した1,000トークンだけが2倍になるのではなく、201,000トークンすべてが2倍になります。
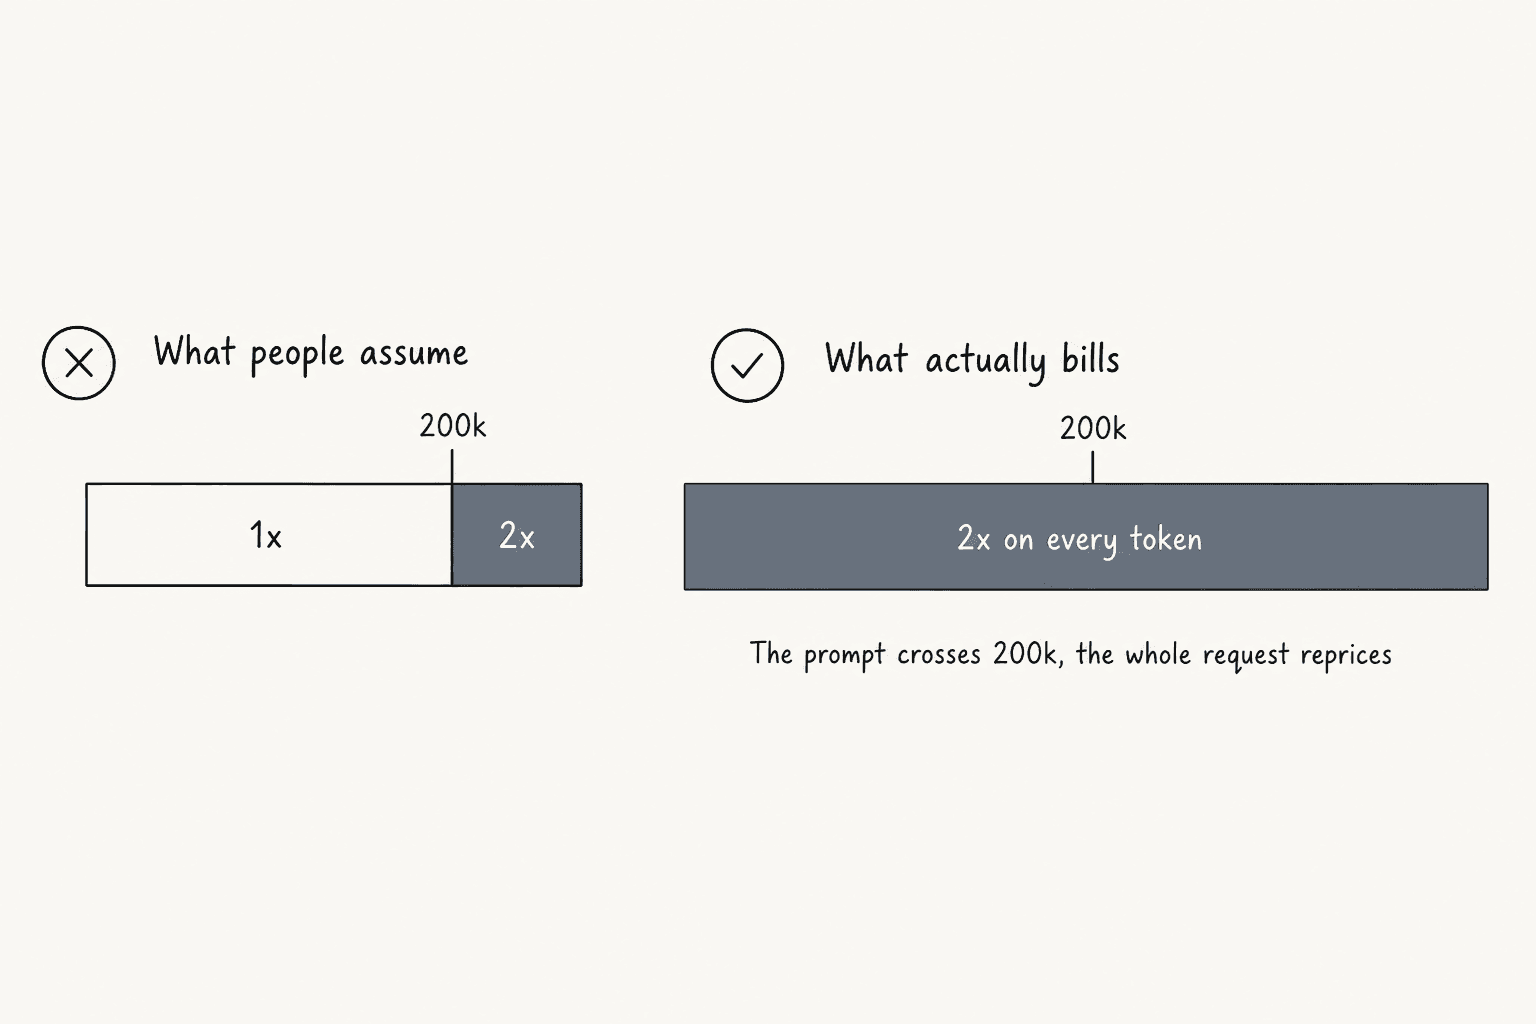
xAI自身のドキュメントがコンテキスト圧縮をこれほど強く勧めるのは、このためです。ターンごとにツールの結果が積み上がるエージェント型のループでは、圧縮は雑務ではなくコスト管理です。エージェントが9ターン目に200kを超えたら、9ターン目は最初のトークンから2倍になります。
安いキャッシュ料金は自動では適用されません。 これは4.6のページ全体で最も役立つ点で、ベンダーのドキュメントとしては異例なほど率直です。4.6のはじめにのページは、prompt_cache_key、またはChat Completionsではx-grok-conv-idヘッダーを設定するよう指示しています。理由は「it routes a conversation's requests to the same server, making cache hits reliable; without it you often pay full input price on a cache-cold server.」です。もう一度読んでください。既定の失敗モードは、$0.50の代わりに$2.00を払うことです。Grok 4.6上で構築してヘッダーを1つ省くと、入力行の請求が4倍になりえて、何も壊れているようには見えません。
さらにバッチの逆転があります。20%のBatch API割引はgrok-4.3と3つのgrok-4.20バリアントに適用されます。4.6、4.5、grok-build-0.1には適用されません。そのため、夜間のチケット分類やバックログのトリアージのような、バッチ化でき、キャッシュが重い作業では、1年前のgrok-4.3のほうがフラッグシップよりはるかに安く、入力$1.25、出力$2.50にさらに20%引きです。料金表はこれを完全に隠しており、大量処理に最新モデルが正解だと決めつける前に、4.3を試すべきだと思います。
知っておくべき小さな項目が2つあります。Priority Processingはすべてのトークン種別にかかる別の2倍の乗数で、レスポンスが"service_tier": "priority"を確認したときだけ課金されます。また、Responses APIで生成前に検出された利用ガイドライン違反には、リクエストあたり$0.05の手数料がかかるため、何も生成しなかったリクエストに5セント払うことがありえます。
他のフラッグシップとの比較
定価だけで見ると、Grok 4.6は優秀に見えます。以下の数字はすべて各ベンダー自身のページのものです。
| モデル | コンテキスト | 入力 /1M | キャッシュ /1M | 出力 /1M |
|---|---|---|---|---|
| Grok 4.6 | 500k | $2.00 | $0.50 | $6.00 |
| Claude Sonnet 5 | 1M | $2.00 | $0.20 | $10.00 |
| Claude Opus 5 | 1M | $5.00 | $0.50 | $25.00 |
| GPT-5.6 Sol | 1.05M | $5.00 | $0.50 | $30.00 |
| Gemini 3.1 Pro Preview | 1.05M | $2.00 | $0.20 | $12.00 |
| DeepSeek V4 Flash | 1M | $0.14 | $0.0028 | $0.28 |
出力では、Grok 4.6はDeepSeekを除いてここで最も安く、Sonnet 5の$10、Gemini 3.1 Proの$12、Opus 5の$25、Solの$30に対して$6です。互角のIntelligence Indexスコアと組み合わせると、本物の結果になります。Artificial Analysisの測定では、Index 1タスクあたりGrok 4.6は$0.8367、GPT-5.6 Solは$1.2312なので、同じ測定上の知能で32%安く、Claude Opus 5の$2.3369と比べると2.8倍安いことになります。
ここからが見方の転換で、サポート担当の読者はここで速度を落としてください。出力列ではなくキャッシュ列を見てください。Claude Sonnet 5のキャッシュは$0.20で、Grok 4.6は$0.50です。 Sonnet 5はさらに、長いコンテキストの割増が一切ない1Mウィンドウ(Anthropicは900kトークンのリクエストも9kと同じトークン単価だと明記しています)と、Grok 4.6にはない一律50%のバッチ割引を持っています。
したがって、正直な結論はモデルではなくワークロードで分かれます。
- 長い出力、変わるコンテキスト、コード生成: 価格ではGrok 4.6が明確に勝ちます。出力$6対$10や$30は比較にならず、ベンチマークも品質を裏付けます。
- 短い出力、巨大で再利用されるプロンプト、バッチ化できるボリューム: つまりサポートキューです。Sonnet 5は請求を支配する項目で2.5倍安く、落ちる200kの崖がなく、バッチでは半額になります。返信が3文なら、Grok 4.6の安い出力はほとんど意味を持ちません。
「Grok 4.6は安い」よりずっと役に立つ答えで、キャッシュ列を読んだときにしか見えません。サポート向けのモデル選びをもっと広く見たいなら、この仕事向けの最高のAIエージェントのまとめが、なぜ最高スコアのLLMが正解になることはまれなのかを説明しており、RAG対素のLLMがグラウンディング側を扱っています。
比較そのものについての公平性の注記です。キャッシュ入力はベンダー間で同じものではありません。AnthropicとOpenAIはキャッシュエントリの書き込みに別料金を課し、Googleはキャッシュの保管を時間単位で課金し、xAIとDeepSeekは別途の書き込み料金なしの読み取り料金だけをページに載せています。キャッシュ列だけの比較は、AnthropicとOpenAIをやや有利に見せます。Gemini 3.1 Proは思考トークンも出力として課金するため、推論の重い作業では$12は過小評価で、しかもまだPreviewモデルです。
実際にどこで入手できるか
一般利用者向けに、xAI自身の料金ページが公開している数字は期待より少なく、これはgrok.comが価格を、実際の数字を含まないアニメーションの桁ローラーで表示しているためです。公開されているのは次のとおりです。
| プラン | 価格 | 備考 |
|---|---|---|
| Free | $0 | リアルタイムのWeb・X検索、Voiceモード、Connectors。Grok 4.6は明記されていない |
| SuperGrok Lite | 非公開 | Grok Buildへのアクセス、Expertモード、2倍長いチャット |
| SuperGrok | 月額$30 | Grok 4.6を特典として明記する最初のプラン、5倍長いチャット |
| SuperGrok Plus | 月額$100 | ワンプロンプトでのアプリ作成、1080p動画、ピーク時の優先 |
| SuperGrok Heavy | 非公開 | 最大の利用量、より大きなエージェントチーム、X Premium+込み |
| Business | 1ユーザーあたり月額$30 | シート管理、RBAC、ドメイン検証 |
| Enterprise | 要相談 | SSO、SCIM、監査制御、データレジデンシー、ボリューム価格 |
Grok 4.6はFreeではなく、SuperGrok以上の特典として明記されています。有料プランは2026年6月に、Chat、Imagine、Voice、Buildで共有される1つの週次利用プールに移行しており、xAIは仕組みを公開していますが、メッセージ数の絶対値は公開していません。プールに達しても完全には止まらず、ChatとVoiceは無料プランの上限に戻ります。Extra Usage Creditsは$5から、1年で失効し、xAIは「priced at standard rates, which means the cost per action is higher than the effective rate you get from the included weekly usage in your plan.」とはっきり述べています。
調達部門を通して購入する方にとってより重要な事実は、Grok 4.6は直販とパートナーAPIでの公開であり、ハイパースケーラー経由ではないことです。
| チャネル | 公開時点のGrok 4.6 |
|---|---|
| xAI API、Grok Build、OpenRouter | 初日から利用可 |
| Cursor | xAIは利用可と言うが、Cursor自身のモデルページは4.5のみ掲載 |
| Azure AI Foundry | まだGrok 4.3 |
| AWS Bedrock | まだGrok 4.3 |
| GitHub Copilot | まだGrok 4.5 |
組織がBedrockやCopilotに標準化している場合、4.6にはまだ到達できません。Azure Foundryなら、$1.25と$2.50のGrok 4.3を買うことになり、安いものの2世代前です。この差はいずれ埋まりますが、すべての推論を1つのクラウドで行うという調達ポリシーがあるなら、今は大きな問題です。Grok BotやGrok Voice Think Fast 2で見たのと同じパターンで、xAIはまず自社の提供面に出荷し、リセラーが追いつくのを待ちます。
フロンティアモデルがサポートキューで変えること、変えないこと
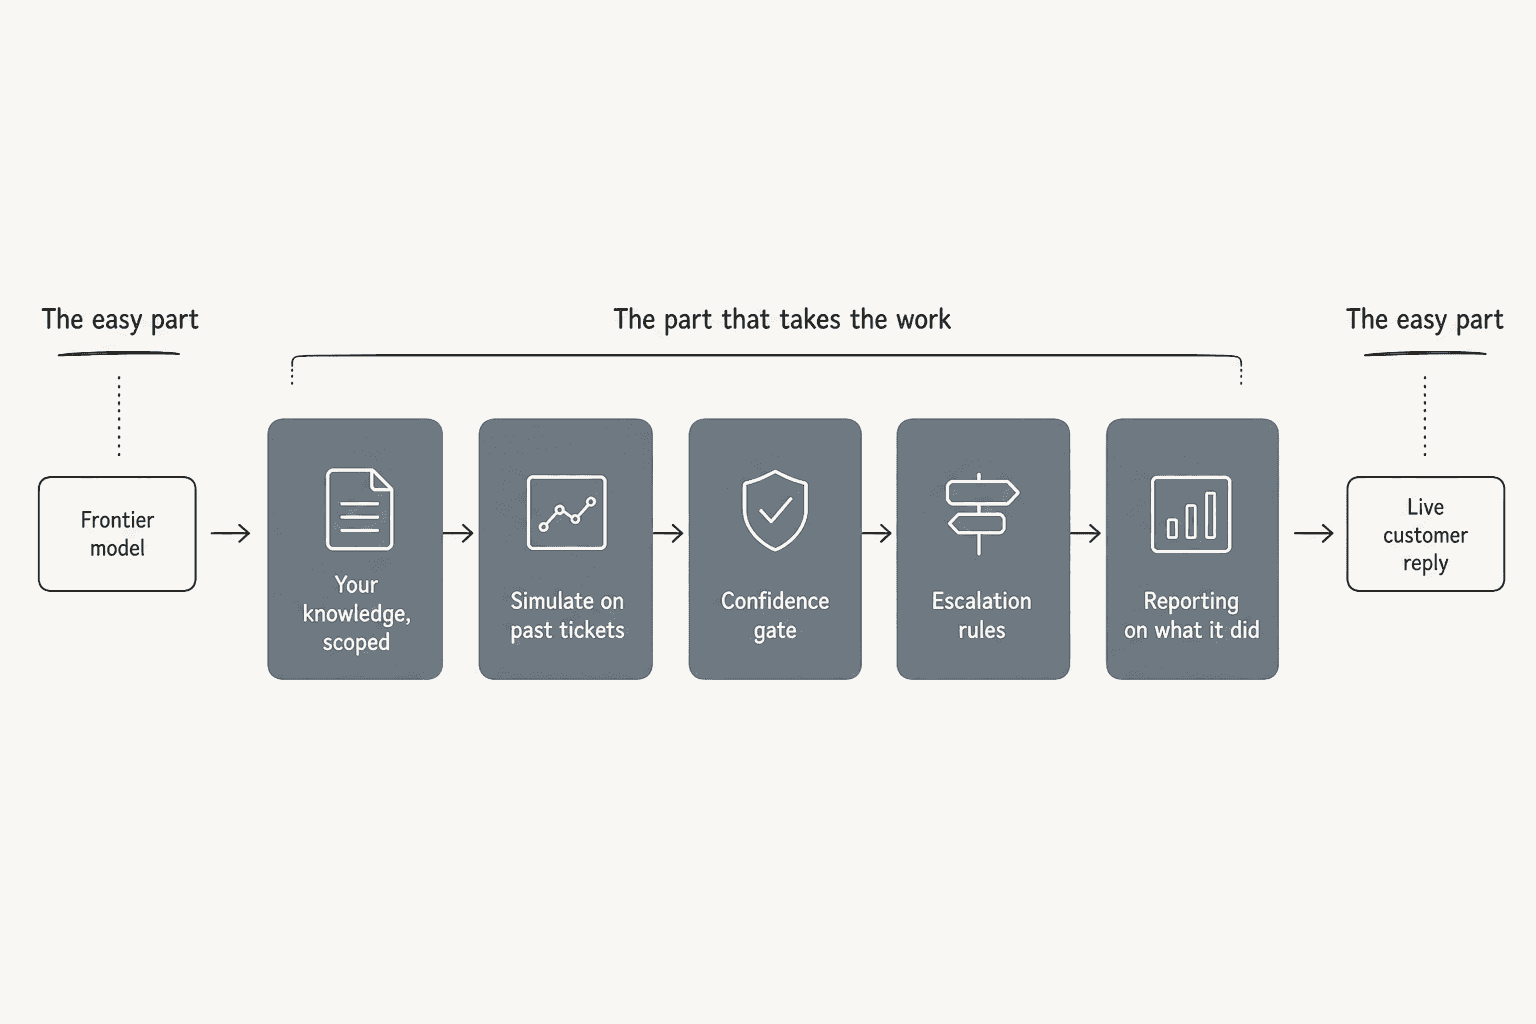
5週間ごとに新しいモデルが登場し、「乗り換えるべきか」という質問が私の受信箱に届きます。モデルとヘルプデスクの間に入る連携を出荷してきた立場から言えば、答えはほとんどの場合、モデルがボトルネックではなかった、です。
Grok 4.6が正直に変えること:
- エージェント型のツール利用が良くなりました。 Tau-3-Bankingで50.7%、97件中2位、8.6ポイント上昇です。会話の途中で注文システムや返品APIを呼び出す自動化なら、その信頼性こそがワークフロー自動化を途中で止まらず最後まで完了させます。
- 捏造が大きく減りました。 54.1%から34.3%はこのリリースで最大の改善であり、出力が顧客に届くときに最も重要です。
- 知能あたりのコストがライバルに対して改善しました。 互角のGPT-5.6 Solよりタスクあたり32%安いのは、大量利用では本物のお金です。
変えないこと:
- あなたの知識は、あなたの知識のままです。 2026年2月のカットオフは、モデルが返金ポリシーも、SKUも、先週火曜の障害も知らないことを意味します。それはナレッジベースでの学習と過去チケットから来るもので、ベンチマークのスコアでは代わりになりません。
- 34.3%のハルシネーションには、依然としてゲートが必要です。 モデルが迷ったときのための信頼度のしきい値、ガードレール、人への引き継ぎです。そもそも回答すべきだったかを測ることは別の領域で、封じ込め率とエスカレーション品質で扱っています。
- トークン価格は構築で最も安い項目です。 ウィジェットの既定値では、Grok 4.6は会話あたり約1.5セントのトークン代です。連携、トリアージのルール、レビューのループ、レポート、誤動作したときのオンコールなど、トークンよりはるかに大きい。だからこそ、計画に使う数字としては100万トークンあたりの価格より解決あたりのコストのほうが優れています。
- 多くのチームにとって、買うほうが作るより有利なことは変わりません。 そのトレードオフは別の判断で、料金表ではなく構築か購入かから始めることをお勧めします。
- 自社のチケットでどう動くかは、依然としてわかりません。 順位表は代理指標です。あなたのキューがテストです。評価の実践があるのは、まさに両者が誰もが望む以上にずれるからです。
単一のモデルではなくプラットフォーム層が必要なら、AIカスタマーサービスソフトウェアから始めてください。ロールアウトに求める指標としては、チケットの自動解決と解決率の2つが重要です。
モデルが担わない部分のためのeesel
Grok 4.6は良いモデルです。コードを出荷するなら使ってください。価格とスコアの比率はランキングで最高です。ただしサポートエージェントではありません。その正直な理由は、素のモデルは、あなたのチームがこの顧客にすでに何を伝えたかを知らず、いつ黙るべきかを判断できず、後で何をしたかの記録も残さないからです。
eeselがその層です。数分でZendesk、Freshdesk、Gorgiasなどに接続し、ヘルプセンター、マクロ、解決済みチケットから学ぶので、最初からあなたのチームらしい口調になります。そして、私が最も強くお勧めする点ですが、ライブの顧客に1通も返信する前に、あなた自身の過去チケットでシミュレーションを実行します。自分のデータでの正確さを確認し、見つかった穴を埋め、再実行して、それから本番に出します。3回に1回はまだ捏造するモデルを前にすると、この予行演習が実験と事故を分けます。

料金はトークンではなく月額固定です。料金ページによると、プランは500クレジットで月額$299から、チケットまたはチャット1件につき1クレジットで、返信が何回かかっても同じ、シート料金なし、人間が対応したチケットへの課金もありません。カード不要で100クレジットを無料で利用でき、まず一部だけをルーティングすることもできます。たとえば月1,000件のチケットのうち200件をAIに回すと200クレジットを使い、月額$299のプランに収まります。上限を明確にしたければ、自分で設定した上限付きのオプションの超過課金を有効にできます。コンプライアンス面はセキュリティとエンタープライズのページに、実際に機能するかはお客様事例にあります。
eeselを無料でお試しください。シミュレーションを実行して、順位表では分からないことを、あなた自身のチケットに語らせてください。
よくある質問
Grok 4.6とは何で、いつ公開されましたか?
xhighを備えています。モデルそのものよりも、本番のキューに載せることのほうが重要なら、それはAIヘルプデスクエージェントの仕事です。Grok 4.6は100万トークンあたりいくらですか?
Grok 4.6はGrok 4.5より安いですか?
Grok 4.6をカスタマーサポートに使えますか?
Grok 4.6はどこで使えますか?SuperGrokはいくらですか?
Grok 4.6はGrok 4.5より優れていますか?
Grok 4.6のコンテキストウィンドウは?xhighは何をしますか?
xhighは既定のhighの上にある4番目の推論レベルで、4.6にのみ存在します。xAIの推論ドキュメントによると、古いモデルはxhighのリクエストをエラーにせず、黙ってhighとして扱います。サポート用途では、プロンプトサイズはコンテキストウィンドウの問題である前に、たいてい検索の問題です。