

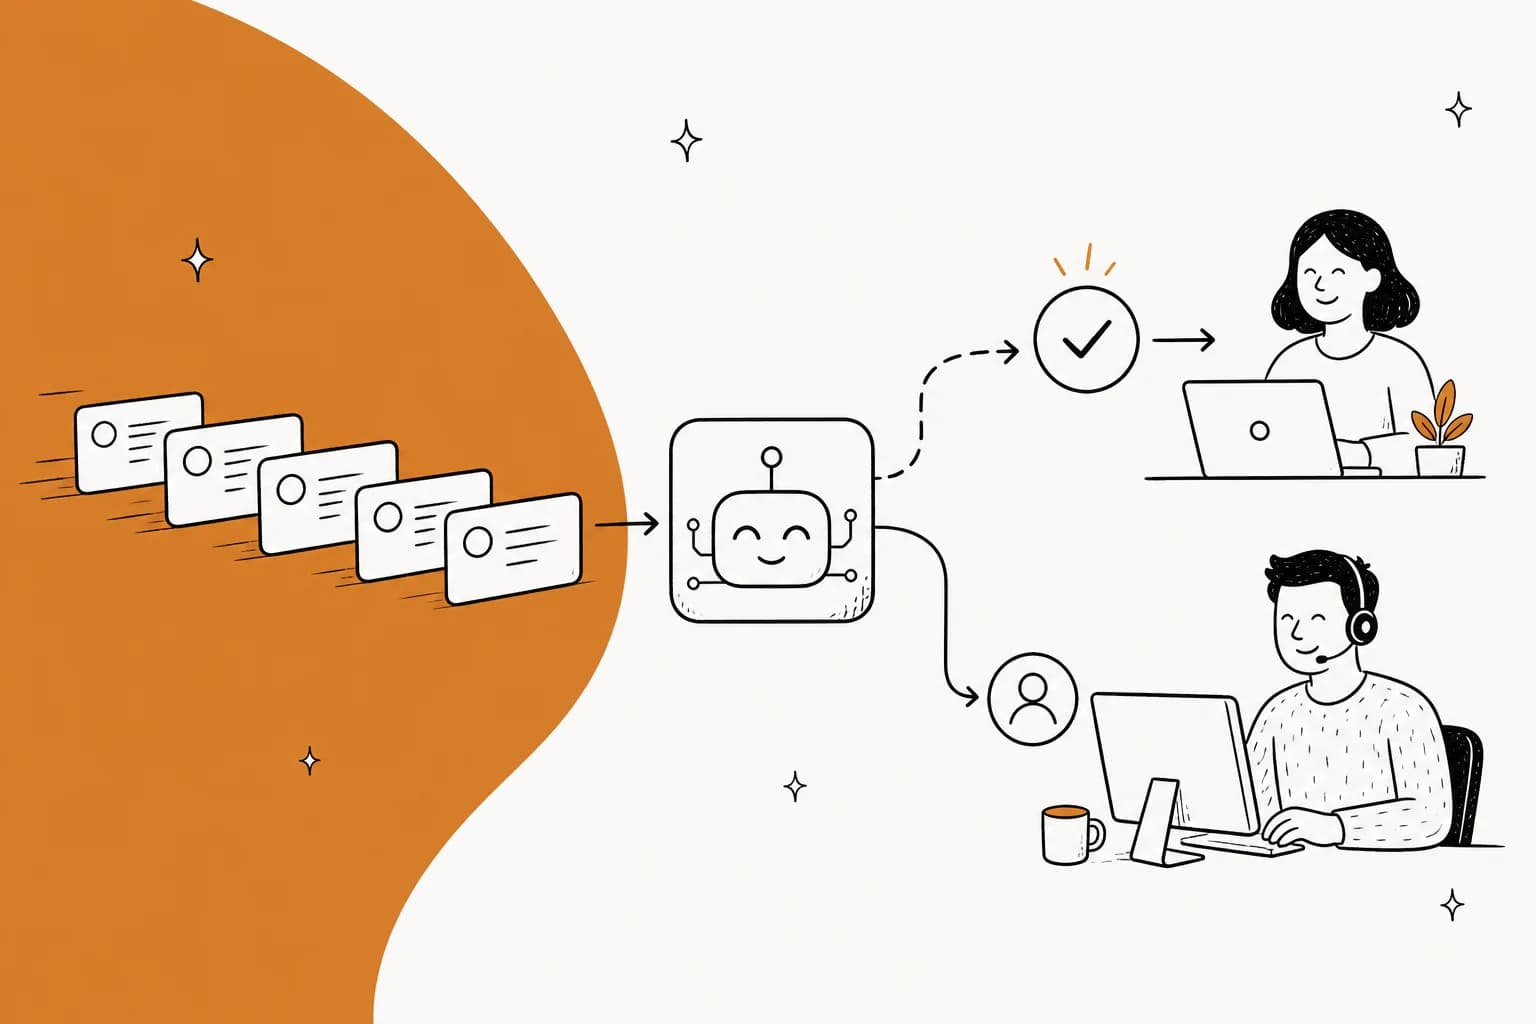
El soporte al cliente con IA es software que lee un mensaje entrante, busca la respuesta en tus propios documentos y tickets pasados, y luego responde o entrega la conversación a una persona. Lo interesante no es responder. Es la entrega. La mayoría de los despliegues que decepcionan hicieron bien la búsqueda y mal la escalada.
La regla de alcance que se sostiene en colas reales: automatiza los tickets de alto volumen y bajo criterio, y deja fuera todo aquello donde equivocarse sea costoso o difícil de revertir. Donde los equipos se queman es en el medio, y la solución es un umbral de confianza que deje a la IA declinar en lugar de adivinar.
Un despliegue realista toma de dos a cuatro semanas, no dos días, y la parte lenta es tu base de conocimiento, no el software. Empieza en modo borrador, donde una persona sigue pulsando enviar, deja que se envíe automáticamente exactamente un tipo de ticket, y luego amplía. Llevo años construyendo IA de soporte en eesel, y el patrón es constante: el primer mes ya vale la pena solo por la velocidad al redactar, mucho antes de que nada se resuelva solo.
Si eesel es la herramienta que pruebas, un agente de codificación con IA puede encargarse de la primera configuración. En cuanto apruebas el acceso, conecta tu helpdesk, añade los documentos de los que la IA debe responder, y arranca en modo borrador, de modo que una persona sigue pulsando enviar. Eso te da la velocidad de redacción desde la primera semana mientras decides qué tipo de ticket enviar automáticamente primero. Consulta la guía de configuración con un agente de codificación.
Qué es realmente el soporte al cliente con IA
Quitando el marketing, son cuatro pasos. Llega un mensaje. El sistema busca en tu centro de ayuda, tus tickets pasados y cualquier otra cosa que hayas conectado. Decide si conoce la respuesta lo bastante bien como para enviar una. Luego responde, redacta algo para que lo revise una persona, o escala.
Eso es todo. Todo lo demás, cada "agéntico" y "autónomo" e "inteligente", es una afirmación sobre lo bien que se ejecuta cada uno de esos cuatro pasos.
Los términos se confunden constantemente, así que aquí está la separación que sobrevive a una demo. Tres preguntas te dicen qué categoría tienes delante: quién lee la salida, si puede escribir en un sistema de registro, y si decide razonando o siguiendo un guion.
| Quién lee la salida | Puede cambiar tus sistemas | Cómo decide | |
|---|---|---|---|
| Chatbot basado en reglas | El cliente | No | Un árbol de decisiones que tú dibujaste |
| Agente de IA | El cliente | Sí, si lo permites | Razona sobre tu contenido |
| Copiloto | Tu agente | Solo cuando un humano envía | Razona, el humano aprueba |
Un chatbot basado en reglas se rompe en el momento en que un cliente formula algo como lo formularía una persona real. Un agente de soporte con IA razona sobre tu contenido y puede actuar. Un copiloto redacta y deja que tu agente pulse enviar. La diferencia entre agentes de IA y chatbots no está en el modelo de debajo, está en si a esa cosa se le permite terminar un trabajo.
Otra frase que vale la pena desmontar, porque aparece en casi cada página de proveedor: "entrenado con tus datos". Eso cubre tres mecanismos completamente distintos.
- El fine-tuning hornea tu contenido dentro de los pesos del modelo. Lento de actualizar, y tus datos ya salieron del edificio.
- El retrieval indexa tus documentos y los cita en el momento de responder. Esto es lo que significa RAG, y es lo que casi todo el mundo hace en realidad. Edita un artículo, y la siguiente reindexación lo recoge.
- Las llamadas a herramientas en vivo consultan tu API de pedidos en el momento. El único de los tres que puede responder "dónde está mi paquete", porque la respuesta no existía cuando se construyó el índice.
Pregunta a un proveedor cuál de los tres usa. Cambia la rapidez con que se propaga un cambio de política, cuánto de tus datos sale de tus sistemas, y si la cosa puede responder preguntas específicas de una cuenta siquiera. Vale la pena entender el equilibrio entre RAG y fine-tuning para centros de ayuda antes de sentarte en una demo, y si quieres la capa de debajo, búsqueda vectorial para soporte cubre la mecánica del retrieval.
Cómo funciona, ticket a ticket
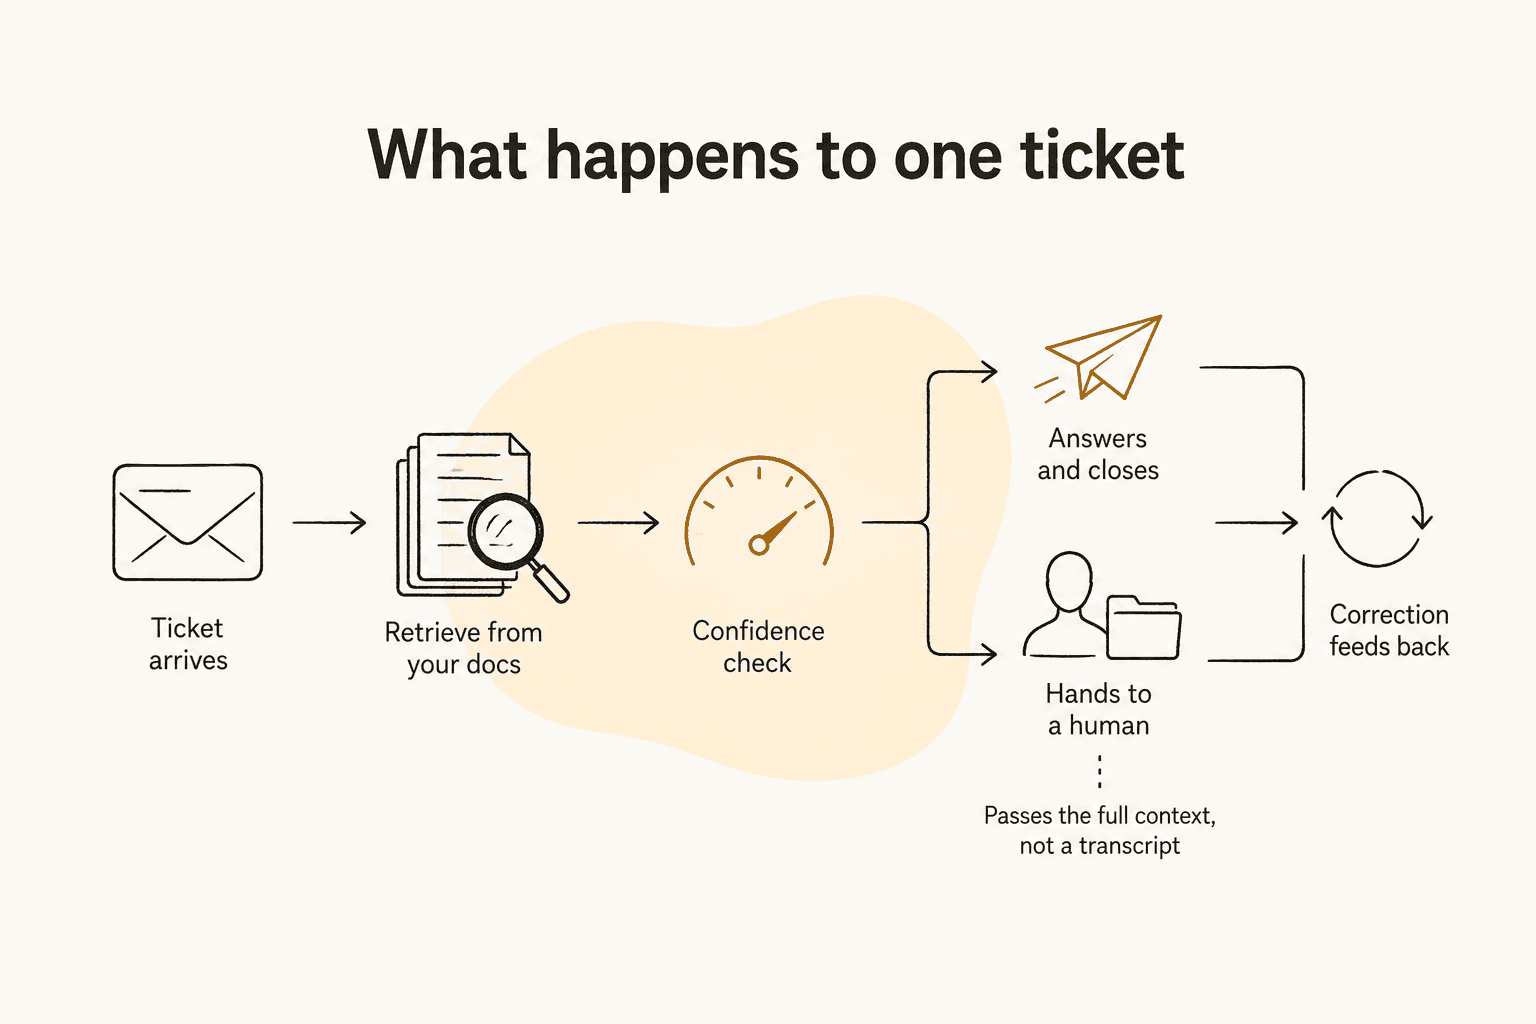
Sigue un ticket y el mecanismo deja de ser misterioso.
Lee el ticket y averigua qué se está pidiendo. No es coincidencia de palabras clave. Clasificación de intención más extracción de entidades más una lectura del sentimiento, de modo que "esta es la tercera vez que pregunto por el pedido 44182 y se me está acabando la paciencia" se resuelve en una pregunta de estado de pedido, un número de pedido, y un cliente enfadado. Esa última señal importa más de lo que se espera, y el análisis de sentimiento suele ser lo que decide si la IA responde siquiera.
Busca en todo lo que has conectado, a la vez. Artículos del centro de ayuda, tickets pasados resueltos, macros, una wiki interna, PDFs subidos. Los buenos sistemas agrupan esto en lugar de aislarlo por integración, de modo que una respuesta puede apoyarse a la vez en tus documentos públicos y en tu runbook interno. Grounding es el término para atar la respuesta al texto recuperado en lugar de a la memoria del modelo, y es la palanca individual más grande para la precisión.
Comprueba si debería hablar. Este es el paso de la puntuación de confianza, y es donde los buenos despliegues se separan de los malos. La confianza alta envía una respuesta. La confianza baja escribe una nota interna para una persona en su lugar. En eesel, ese comportamiento es algo que configuras en lenguaje sencillo en lugar de un umbral que ajustas numéricamente, y la documentación del agente de helpdesk deja claro el fallback: si no lo sabe, lo dice, o escala.
Actúa, o entrega. Actuar significa escribir en un sistema: etiquetar el ticket, actualizar un campo, consultar un pedido, emitir un reembolso, cerrar la conversación. Entregar significa una transferencia real con el contexto adjunto. Más sobre esto abajo, porque es la parte en la que todo el mundo invierte de menos.
Las correcciones vuelven al sistema. Tu agente reescribe el borrador, o le dice al sistema que fue demasiado formal, y eso queda como un cambio de instrucción en lugar de evaporarse. Sin este bucle, le estás reenseñando la misma lección cada semana.

Qué debería gestionar, y qué no
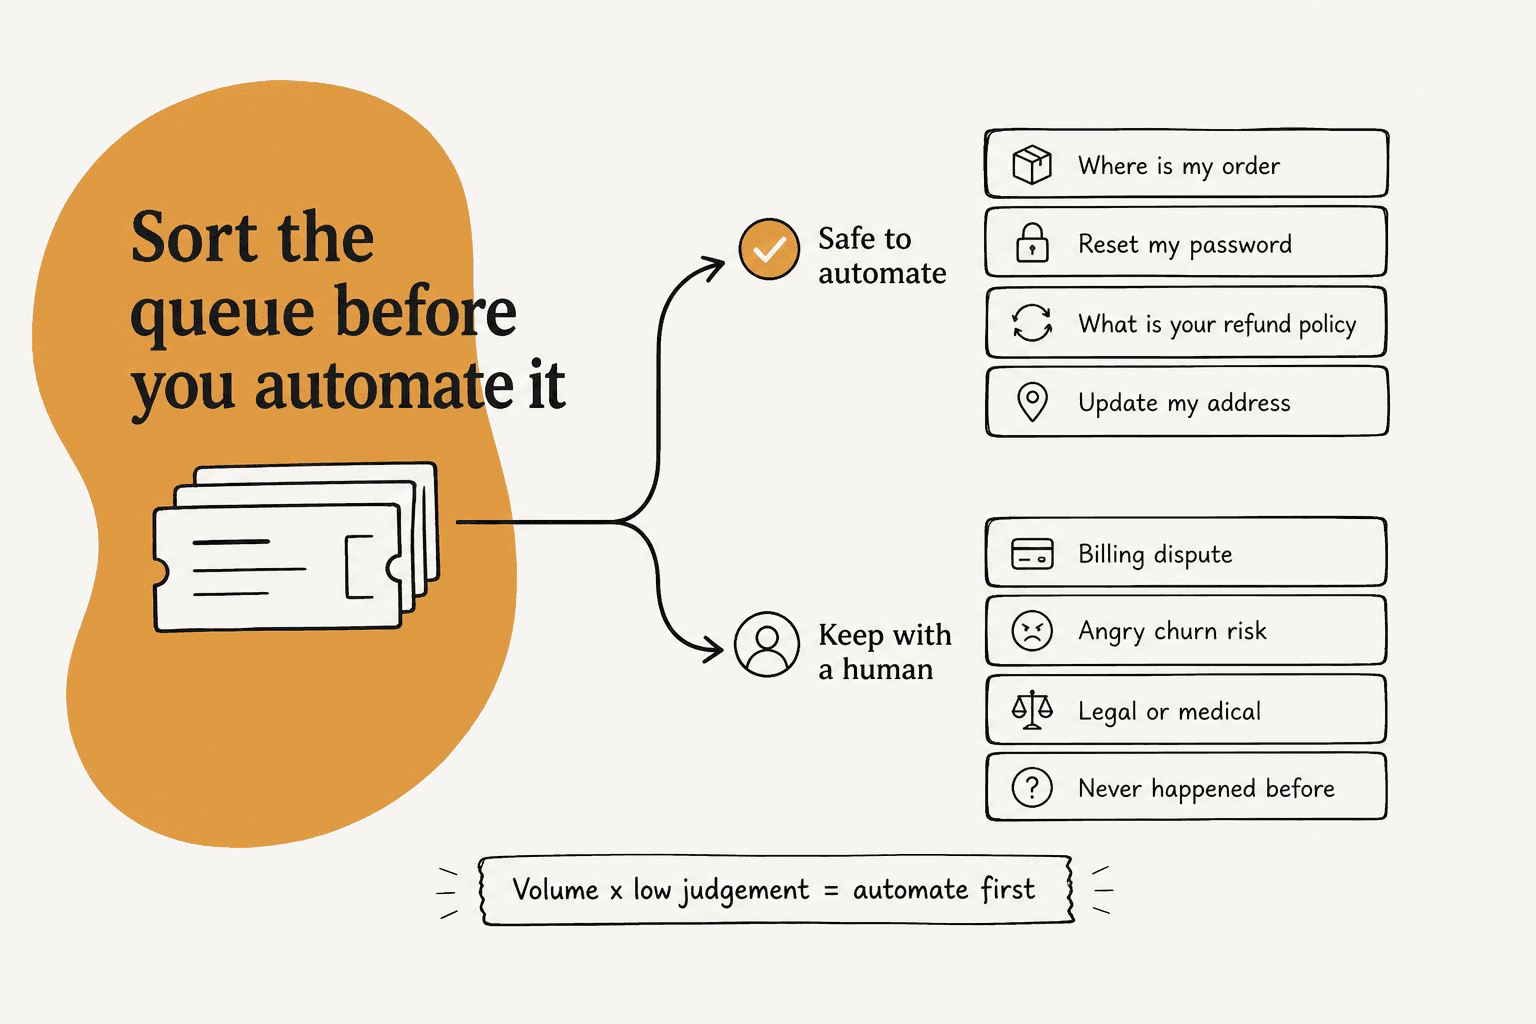
La regla de alcance a la que vuelvo siempre es volumen por bajo criterio. El volumen alto solo no basta, porque mil disputas de facturación idénticas siguen siendo mil disputas de facturación. El bajo criterio solo tampoco basta, porque no vale la pena automatizar una pregunta que recibes dos veces al mes.
Automatizar primero: estado de pedido y WISMO. Restablecimientos de contraseña. Preguntas de política con una respuesta documentada. Cambios de dirección y de suscripción. Triaje de tickets y enrutamiento. Traducción. Estos comparten una propiedad: la respuesta correcta ya existe por escrito en algún lugar, y enviar la incorrecta cuesta un correo de seguimiento, no dinero.
El spam también pertenece a esta lista, y está subestimado. En una prueba real a la que volveré más adelante, el 22 % de la cola entrante era basura, y detectarlo todo antes de que una persona leyera una sola palabra fue una victoria del primer día sin ningún riesgo de cara al cliente.
Dejar que lo vea una persona: cualquier cosa donde equivocarse sea costoso o difícil de revertir.
- Excepciones de política. El día 35 de una ventana de devolución de 30 días es una cuestión de criterio, no una consulta. La IA debería marcarlo y escalarlo, no decidirlo.
- Dinero por encima de un techo que tú fijes. Escribe el número. El agente puede emitir un crédito de hasta X $; por encima, firma una persona. Casi nadie publica esta regla, y todo despliegue real tiene una.
- Conversaciones reguladas. Asesoría médica, legal, financiera. El cumplimiento no es una insignia en una página de precios, es una restricción sobre lo que el agente puede decir.
- Clientes ya enfadados. Una buena entrega en el primer mensaje vence a una gran respuesta en el cuarto.
- Cualquier cosa que no haya pasado nunca antes. Si no hay precedente en tu historial de tickets y nada en tus documentos, el retrieval no devuelve nada, y es exactamente bajo esa condición cuando los modelos empiezan a inventar.
Ese último punto merece detenerse, porque he visto cómo salía mal en nuestro propio producto. Cuando el retrieval vuelve vacío, un modelo al que no se le ha dicho que se detenga llena el hueco con datos de entrenamiento. Tuvimos clientes de pago, incluido un proveedor danés de energía solar, cuyo bot inventó afirmaciones de producto y las envió a personas reales, porque la base de conocimiento no tenía ninguna coincidencia y nadie le había dicho que declinara. La solución nunca fue un mejor modelo. Fue un umbral duro y un fallback de declinar responder.
Hay una versión más simple de la misma prueba que pondría en una pizarra antes de cualquier despliegue: ¿se puede revertir esta acción con un clic? Si no, la aprueba una persona. Eso cubre reembolsos, cancelaciones, eliminación de cuentas, y cualquier cosa que envíe un correo que un cliente vaya a capturar en pantalla.
La afirmación más contundente sobre esto que he escuchado vino de una responsable de CX en una marca DTC de suplementos que gestiona unos 7.000 tickets de Gorgias al mes frente a 30.000 pedidos:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Probablemente perdimos ese trato por eso, que es exactamente por lo que lo sigo citando. "Leave them alone" es un requisito de producto más difícil que "responder a todo", y es el que a los compradores realmente les importa.
Los beneficios que se sostienen, y los límites que nadie imprime
La lista honesta de beneficios es más corta que la del marketing, pero cada elemento de ella se puede verificar.
Cobertura fuera de tu horario. Esta es la victoria menos discutible. Una cola que antes se quedaba dormida toda la noche ahora recibe el primer contacto a las 3 de la madrugada, y la cobertura fuera de horario suele ser lo que un equipo pequeño siente primero.
Alcance de idiomas sin traducir tu centro de ayuda. Un ticket en español recibe una respuesta en español a partir de documentación en inglés. Un cliente de eesel, la plataforma de comparación de préstamos Smava, opera un agente de Zendesk totalmente automatizado que gestiona más de 100.000 tickets en alemán al mes, una cifra publicada en la página del agente de helpdesk. El soporte multilingüe antes era un problema de plantilla y ahora en su mayoría ya no lo es.
Velocidad en el nivel aburrido. El tiempo de primera respuesta cae mucho en los tipos de ticket que has acotado, porque ya no hay cola delante de ellos.
Consistencia. Cada agente responde la pregunta sobre la política de reembolsos de la misma manera, lo cual no es glamuroso, pero es lo que tu responsable de calidad ha querido durante tres años.
Ahora los límites, dichos con claridad, porque prefiero que los encuentres aquí a que los encuentres en producción.
Solo es tan buena como tu conocimiento escrito, y el tuyo probablemente tiene la forma equivocada. Un gerente de soporte en un servicio de seguimiento de autobuses nos contó que toda su base de conocimiento estaba escrita para administradores, mientras que cada ticket venía de pasajeros. El retrieval funcionaba perfectamente y las respuestas seguían siendo confusas. El contenido desactualizado del centro de ayuda es la otra mitad del mismo problema: la política cambió en marzo, el artículo no, y la IA cita con confianza en agosto una política muerta.
Una tasa de desvío alta puede ocultar un despliegue que está fallando. Si los tickets se cierran y los contactos repetidos están subiendo, estás desviando, no resolviendo. Síguelos juntos o el panel te va a mentir.
La sobreescalada es un fallo real y parece seguridad. Un agente que lo pasa todo a una persona no rompe nada, no molesta a nadie, y en silencio nunca entrega un retorno.
El tono es un problema separado de la precisión. Esto nos sorprendió con cifras reales, y es el núcleo del ejemplo calculado más abajo.
Los clientes pueden odiarlo incluso cuando lo construyes bien. Este es el límite que nadie pone en una página de precios, y la versión más honesta que he leído de esto vino de alguien que dirigió el proyecto:
"This is so true. I led the implementation of an AI customer service agent and even though management thinks it's a great success the metrics tell a totally different story. Our customers hated it. I haven't seen anything in tech that is hated more. Before you think we did a bad job with our solution, I can tell you we went with some of the best and did our own intensive testing and worked on latencies etc., I actually thought the final version was pretty good but our customers just hated it."

La razón por la que ese comentario es difícil de descartar es la defensa preventiva en su mitad. Mi lectura es que la brecha casi siempre está en el posicionamiento: una IA que es una herramienta que el cliente puede esquivar está bien, y una IA que es una puerta que tiene que vencer no lo está.
No elimina el trabajo de operaciones, lo desplaza. Alguien es dueño de la base de conocimiento, revisa las escaladas, y lee el informe semanal. En 24 cuentas de eesel que se dieron de baja, nuestro cofundador Amogh Sarda encontró el mismo hilo: "zero proactive outreach for 6+ months. No 30/60/90 day check-ins on any tier." Los despliegues no funcionan solos, en ningún lado.
Dónde los equipos la usan realmente
Cinco patrones cubren la mayor parte de lo que veo en colas reales.
Estado de pedido y envío. La pregunta de mayor volumen y menor criterio en el comercio electrónico, y la que más necesita una llamada a una herramienta en vivo en lugar de una búsqueda en un documento, porque la respuesta vive en Shopify, no en tu centro de ayuda. Vale la pena leer sobre automatizar el seguimiento de pedidos antes de acotarlo.
Devoluciones y reembolsos, con un techo. La IA puede gestionar reembolsos dentro de una política documentada. Fija el límite en dólares, pon todo lo que esté por encima detrás de una aprobación, y habrás cubierto el volumen sin entregar la caja. La mecánica de automatizar reembolsos tiene más que ver con el diseño de la aprobación que con la IA.
Triaje de nivel 1. Incluso cuando la IA nunca le responde a un cliente, clasificar, etiquetar, priorizar y enrutar es una victoria real. El desvío de nivel 1 es el titular, pero el enrutamiento de tickets es el más silencioso, el que los agentes notan primero.
Asistencia al agente, en el helpdesk que ya usan. El patrón copiloto: el borrador está esperando cuando el agente abre el ticket. Cero hábitos nuevos, por lo que la adopción es alta y el riesgo es casi nulo.
Soporte interno de TI y de empleados. El lugar más seguro para empezar, porque tu audiencia son colegas, no clientes. El responsable de TI de InDebted puso a eesel como primer respondedor en su cola de Jira Service Management y lo describió como que se comportaba "just like an agent would". Están en un 15 % de desvío mientras apuntan al 55 %, y esa cifra me gusta más que las llamativas, porque es lo que honestamente se ve en el mes tres.
Si estás en el mismo stack, IA para Jira Service Management cubre la configuración, y el mismo patrón se extiende más allá de TI hacia el helpdesk de RR. HH. y el soporte a empleados en general.
La profundidad técnica tampoco está automáticamente fuera de alcance, lo cual me sorprendió. Uno de los desvíos más fuertes que he visto en nuestros propios registros fue un técnico de campo en un proveedor de automatización industrial que reportaba un fallo de hardware con códigos de error y síntomas de red. El agente ejecutó seis búsquedas en manuales en PDF, leyó dos por completo, y redactó un conjunto estructurado de pruebas de aislamiento. La profundidad no es la barrera. Si la respuesta está escrita en algún lugar es la barrera.
Diseñar la escalada, la parte que todos se saltan
Esta es mi opinión real tras años con esto: el diseño de la escalada es el producto. Responder ya es lo mínimo. Lo que separa un despliegue que tu equipo defiende de uno que resiente es lo que pasa en el 20 % de las conversaciones que la IA no debería terminar.
La confirmación externa más clara de esto que he visto vino de un operador de contact center describiendo lo que realmente pasó con sus números tras el lanzamiento:
"AHT question nobody wants to answer lol. shipped a billing/tracking bot, decent containment, but AHT on escalated calls went up. agents had to read the transcript, figure out what the bot already tried, re-ask half of it anyway. fixed by forcing a structured handoff summary instead of raw transcript dump (saved more time than the automation itself). CSAT fine on deflected stuff, tanked on anything that bounced back after a failed bot attempt"

Lee dos veces esa última cláusula. El CSAT estaba bien en las conversaciones que el bot terminaba, y se desplomaba en las que rebotaban de vuelta. La automatización funcionaba. La entrega era el defecto de producto, y arreglarla ahorró más tiempo que la propia automatización.
Tres fallos que he visto ocurrir, todos peores que una respuesta equivocada.
La entrega que solo se anuncia a sí misma. El bot le dice al cliente que lo está transfiriendo a una persona, y luego no lo hace. Una empresa de hosting holandesa en Zendesk se topó con esto repetidamente, junto con el nombre y el correo del cliente que no se transferían en el traspaso, y terminó construyendo algo propio. La frase de Amogh sobre esta clase de bug se me ha quedado: "If hard-fail it's silent-failure class (worst class for trust)." Un error visible es recuperable. Una conversación que se fue en silencio a ningún lado no lo es.
La escalada hacia el vacío. Un despliegue escalaba por correo electrónico, y el correo de escalada era cerrado automáticamente por una regla que nadie recordaba haber escrito. Ningún humano lo vio nunca. El panel mostraba que las escaladas se disparaban correctamente.
La IA que se hace pasar por una persona. Mismo despliegue: el agente había recogido el nombre de un agente humano del historial de tickets y empezó a firmar con su nombre. Los clientes pensaban que habían llegado a una persona. Dale un nombre a tu bot, y haz que diga lo que es.
Entonces, en concreto, lo que un buen diseño de escalada especifica antes del lanzamiento:
- Los disparadores. La petición explícita de hablar con una persona. La misma pregunta hecha dos veces. Una lectura de sentimiento por debajo de una línea que tú fijes. Una intención en tu lista de bloqueo. Una cuenta de alto valor nombrada. Más el que casi nadie escribe: las condiciones de no escalar, donde has decidido que la IA debería seguir en lugar de rendirse.
- La carga. El historial completo de la conversación, un resumen claro de lo que la IA intentó y por qué se detuvo, la lectura de sentimiento, y cada registro que recuperó. Una transcripción sola hace que la persona lo relea todo, que es lo contrario de ayudar. Las buenas prácticas de entrega profundizan más aquí.
- La ruta. Qué cola, qué prioridad, y si la lectura de sentimiento de la IA puede hacerla subir. La gestión de escaladas es tanto un problema de enrutamiento como uno conversacional.
- Qué se le dice al cliente. ¿Estás citando un tiempo de espera? ¿Sigue visible la transcripción? Acertar con el diseño de la conversación de entrega es barato, y la diferencia se siente de inmediato.
- Qué pasa cuando no hay nadie. Noches, fines de semana, una cola al 200 %. Este es el fallo de escalada más común en el mundo real y el menos documentado. La respuesta suele ser un patrón de espera que fija una expectativa real, no una promesa falsa.
Ese último punto tiene una versión mejor que "disculparse y esperar". Una fintech con la que trabajamos, con entre 7.000 y 8.000 tickets escalados al mes mientras espera a socios de pago externos, usa la IA para mantener calientes los tickets escalados con actualizaciones de estado honestas. No se necesita base de conocimiento, solo instrucciones. Escalar no tiene por qué significar que la conversación se detiene.
No toda entrega es complicada, tampoco. Aquí hay una de nuestros propios registros, en el chat del sitio web de una herramienta de SEO: el cliente preguntó cómo borrar palabras clave de un proyecto, obtuvo una respuesta, preguntó cómo borrar motores de búsqueda, obtuvo otra, y luego preguntó "¿Puedo hablar con una persona?" y fue transferido de inmediato. Dos preguntas resueltas por sí mismas, una salida limpia. Así es como se ve desde fuera un sistema que funciona, y es completamente normal, que es justo el punto.
Si estás específicamente en Zendesk, reglas de escalada de Zendesk cubre el lado nativo de esto, y entrega humana en el chat cubre la versión de canal en vivo, donde los segundos sí importan.
Cómo implementarlo, semana a semana
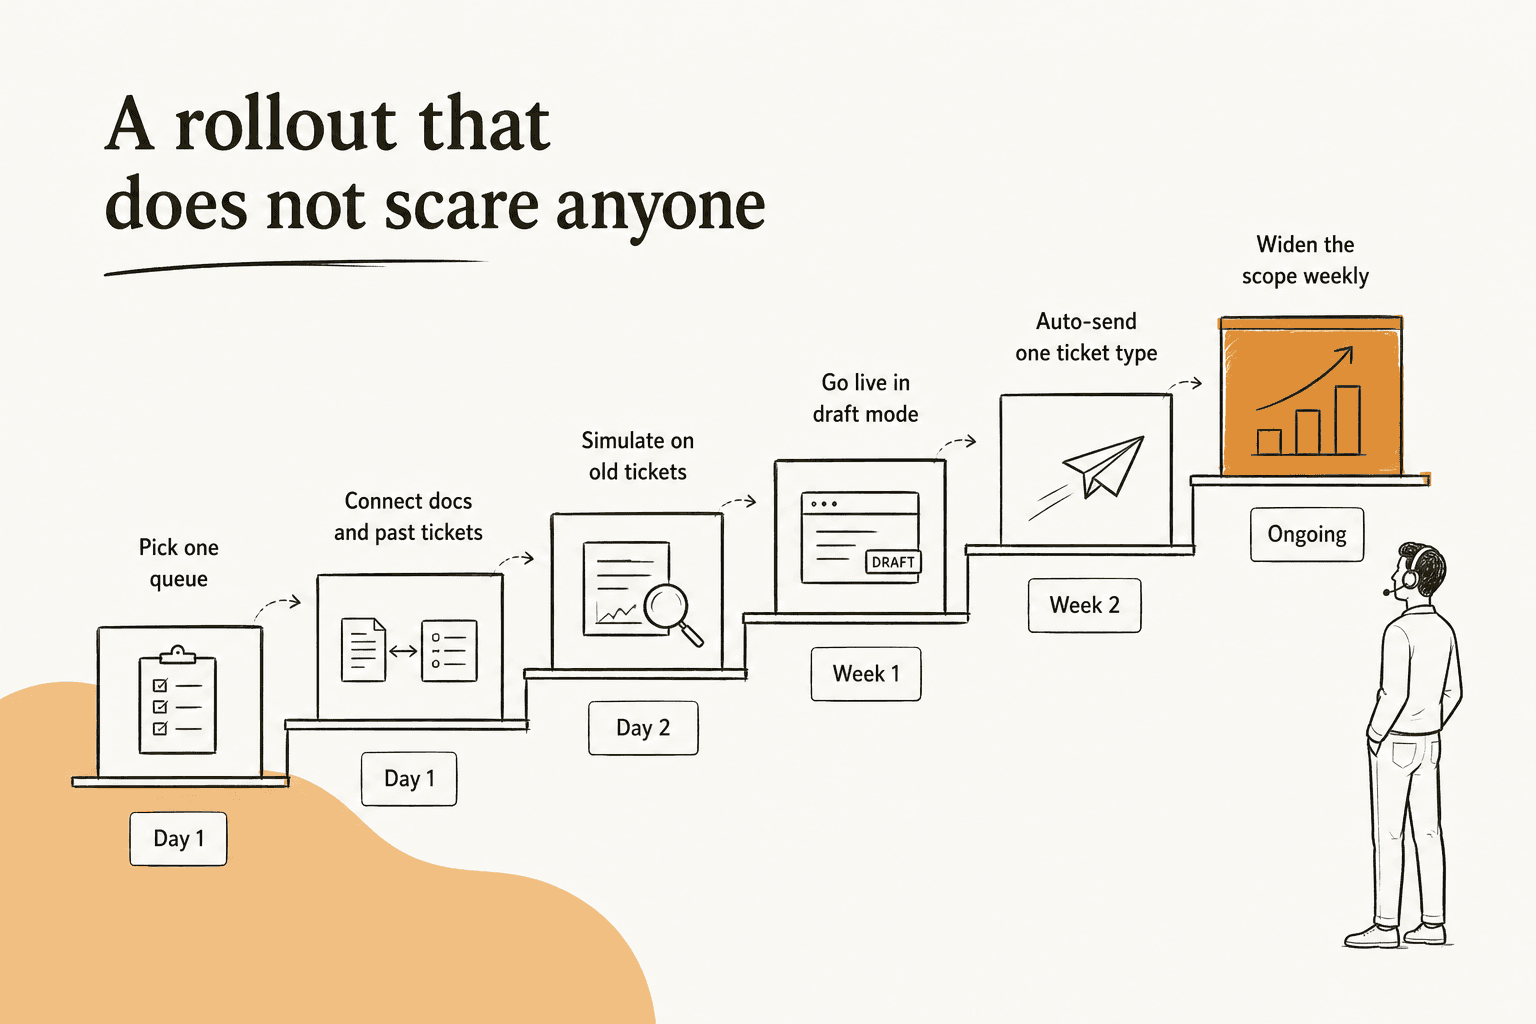
Conectar un helpdesk y conseguir una primera respuesta toma alrededor de media hora. Llegar a un despliegue en el que tu equipo confíe toma de dos a cuatro semanas, y la parte lenta nunca es el software.
Día 1: elige una cola, no todo el helpdesk. Un canal, un tipo de ticket, un idioma. El fallo que más veo es que los equipos apuntan la IA a todo el día uno, obtienen resultados mediocres en todas partes, y concluyen que la categoría no funciona.
Día 1: conecta el conocimiento, incluidos los tickets pasados. Documentos, centro de ayuda, macros, y tu historial de tickets resueltos. Esto último es lo que los compradores piden antes que nada, y la nota de Amogh sobre esto es directa: "past ticket training strikes again. Classic. People really, really, really want to train on past tickets." También es de donde sale un tono realista, porque tu centro de ayuda está escrito con voz de política y tus tickets con voz humana. Tampoco necesitas una base de conocimiento perfecta para empezar. Un equipo del Reino Unido en Zendesk consiguió 56 tareas resueltas a partir de nueve macros sincronizadas, y seguía usándolo 38 días después de que expirara su prueba.
Día 2: simula contra tickets que ya has respondido. Este es el paso que casi ninguna página de proveedor describe, y el que me negaría a saltarme. Reproduce un lote de tickets pasados, deja que el agente redacte lo que habría dicho, y califica esos borradores frente a lo que tu equipo realmente envió. La simulación de eesel se ejecuta en modo sandbox e informa la cobertura por tema, así que obtienes "política de reembolsos 28 %, errores de inicio de sesión SSO 35 %" en lugar de una única cifra de precisión sin sentido. Luego rellenas la brecha concreta y lo vuelves a ejecutar.
Fija un umbral de aprobación antes de mirar los resultados, o racionalizarás lo que obtengas. El mío es: en una muestra de al menos 100 tickets reales, errores factuales por debajo del 5 % en las intenciones que has acotado, y ningún error en las categorías que has cercado.
Semana 1: sal en vivo en modo borrador. Tickets reales, clientes reales, y cada respuesta sigue saliendo a través de una persona. Mides la diferencia entre lo que la IA redactó y lo que tu agente envió, y esa diferencia es el diagnóstico más útil que vas a conseguir jamás. También significa que tu peor resultado posible en la semana uno es un borrador desperdiciado.
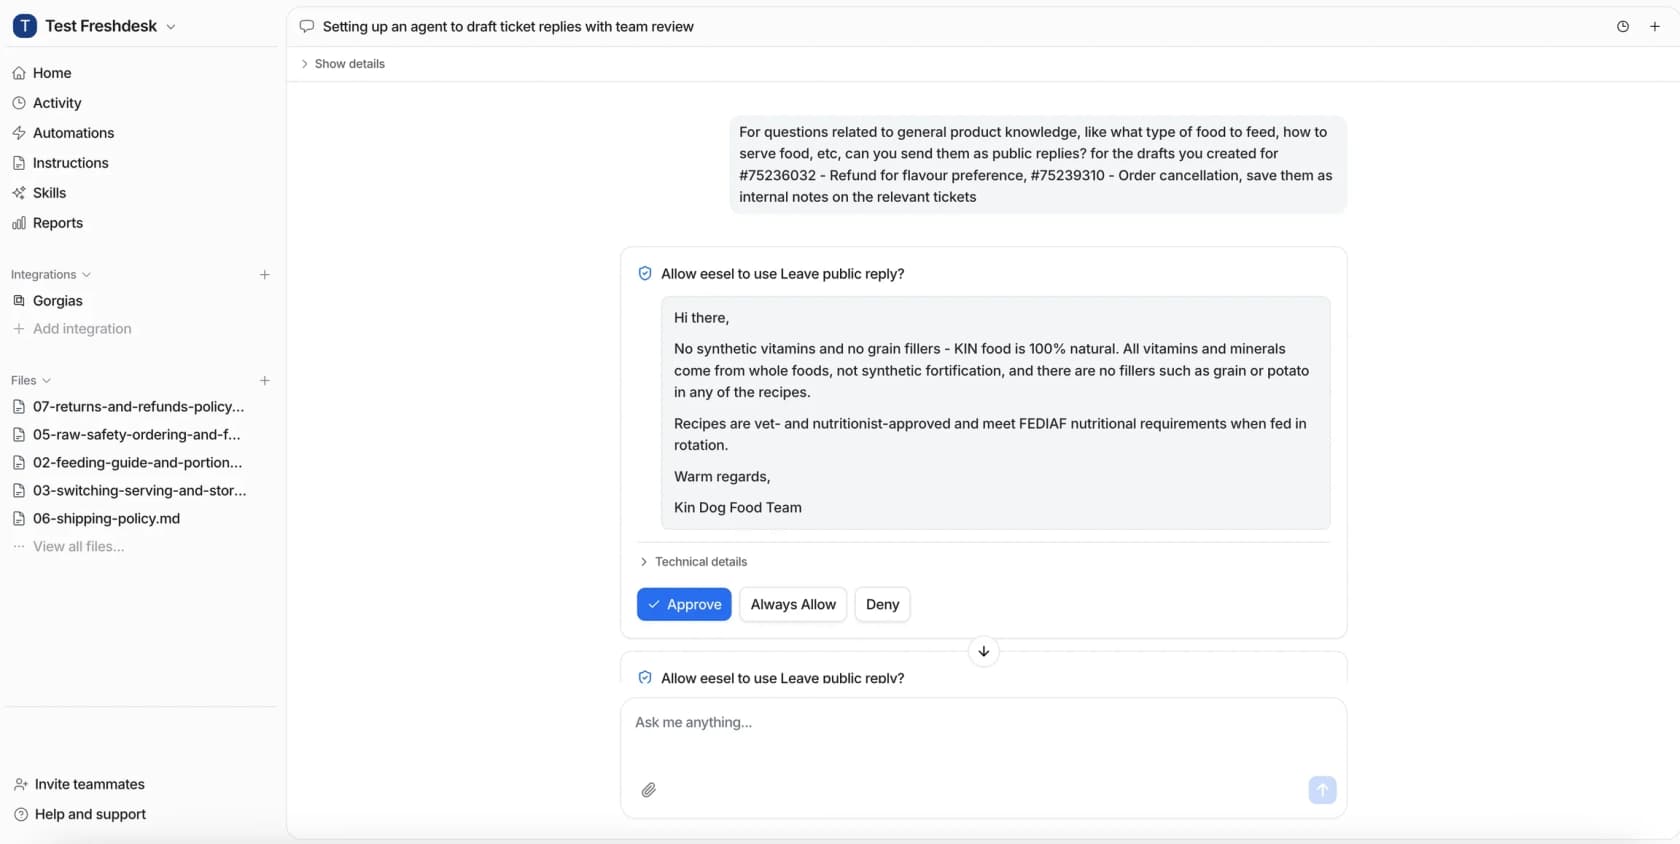
Semana 2: envía automáticamente exactamente un tipo de ticket. El más estrecho, el más documentado, el más reversible que tengas. El estado de pedido es la elección habitual. Vigílalo durante una semana con una persona leyendo cada conversación.
Semana 3 en adelante: amplía por alcance, nunca por porcentaje. Añade una intención a la vez, y mantén las cifras de desvío de tickets junto a las cifras de contacto repetido. Cualquier cosa que toque dinero o el estado de la cuenta se queda detrás de una aprobación mucho más tiempo del que parece necesario.
Si quieres la misma secuencia de alguien que no te está vendiendo nada, esto se acerca a la versión que yo escribiría:
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."
La revisión de conversaciones reabiertas es el detalle que robaría de ahí. Tu documento de alcance dice qué debería gestionar la IA. El registro de reaperturas te dice qué puede gestionar en realidad.
Dos cosas que de verdad van a romper tu cronograma, y ninguna está en la hoja de ruta de ningún proveedor. La primera es la limpieza de la base de conocimiento, que son horas reales de trabajo humano real. La segunda son las credenciales de integración, porque la persona con acceso de administrador en tu helpdesk está de vacaciones. Presupuesta para ambas.
Y hay un modo de fallo más allá de todo esto que vemos más que cualquier fallo técnico, y no tiene nada que ver con la calidad de la respuesta. Algunas pruebas quedan completamente configuradas, la integración se conecta, los documentos se sincronizan, y luego nadie conecta un disparador, así que nunca se dispara ninguna tarea. Otras lo hacen todo bien y aun así se estancan: observamos una cohorte en la que nueve de diez pruebas activadas tenían conversaciones funcionando con una puntuación de calidad del 96 %, y exactamente una de ellas convirtió. En ningún caso el problema era la IA. La configuración no es el despliegue, y el despliegue no es la adopción. Alguien tiene que encenderlo y ser el dueño.
Nuestra guía de implementación completa tiene la versión más larga de esta secuencia, y implementar soporte con IA cubre el lado de gestión del cambio que me he saltado aquí.
La aritmética mes a mes, con tus números
La mayoría de los modelos de coste saltan directamente a una tasa de desvío ya madura, por eso el primer mes se siente como una decepción. Pon tu propio volumen, y la forma de la rampa se vuelve evidente.
La unidad facturable es la otra mitad de esto, y es la palabra indefinida más cara de la categoría. Los cargos por asiento, por persona. Los cargos por resolución, solo cuando algo se cierra. Los cargos por ticket, por cada conversación que la IA toca. Eso produce facturas muy distintas con el mismo volumen, así que la pregunta que hay que hacerle a un proveedor no es "cuánto", sino qué evento incrementa el contador. La respuesta de eesel, en su página de precios, es 1 crédito por ticket o chat gestionado (planes desde 299 $/mes por 500 créditos), sin importar cuántos mensajes vayan y vengan, que es deliberadamente la unidad en la que los equipos de soporte ya piensan. Nuestro análisis de coste por resolución hace bien la comparación, y coste del soporte con IA pone los modelos lado a lado.
Qué medir, y las tres palabras que los proveedores confunden

Tres métricas se usan indistintamente en casi cada página de proveedor, y miden cosas distintas. La razón por la que importa no es pedantería, es que una de ellas puede verse estupenda mientras tus clientes lo están pasando peor. El responsable de soporte de PostHog lo expresó mejor de lo que yo podría:
"Most companies don't realize the frustration they're creating. They look at the numbers, see fewer tickets coming in, and read it as a good sign: customers must be doing fine. Companies call it "deflection." Customers call it being ignored."
Vale la pena notar que PostHog vende analítica de producto, no IA de soporte, y ese post argumenta en contra de poner IA frente a una cola de soporte, en general. No estoy del todo de acuerdo, pero la distinción que marcan entre la IA como herramienta y la IA como puerta es la correcta, y una cifra de desvío no te puede decir cuál de las dos construiste.
| Métrica | Numerador | Denominador | Qué oculta |
|---|---|---|---|
| Tasa de desvío | Contactos que nunca llegaron a una persona | Todos los contactos | Si el problema se resolvió |
| Tasa de resolución | Problemas realmente resueltos sin una persona | Conversaciones en las que la IA se involucró | Nada, si también mides el contacto repetido |
| Tasa de contención | Conversaciones que se quedaron en el canal | Conversaciones que entraron en él | Si el cliente se rindió |
Cualquier porcentaje de esta familia no significa nada sin su denominador, y los proveedores citan el encuadre que les da el número más grande. La pregunta que lo recupera siempre: ¿porcentaje de qué, de cuántos, en qué periodo?
Lo que de verdad vigilaría cada semana:
- Tasa de resolución junto con tasa de contacto repetido. Ninguna por sí sola te dice nada. Juntas te lo dicen todo. Nuestra guía para mejorar la tasa de resolución es la continuación una vez que los números son honestos.
- Tasa de escalada y los motivos detrás de ella. Una escalada sana no es un fallo. Una escalada que se disparó porque el retrieval no encontró nada es un ticket para la base de conocimiento, no un problema de la IA.
- Tasa de brecha de conocimiento: las preguntas que el agente marcó como irrespondibles. Es la cifra más útil de todo el conjunto, porque es una lista de tareas.
- CSAT dividido en tres: en conversaciones resueltas por IA, en escaladas, y mezclado. Son tres cifras distintas, y la mezclada es la menos útil.
- Coste por ticket, incluidas tus propias horas. El precio del software es la parte fácil. Medir bien el ROI del soporte con IA significa contar también la limpieza de la base de conocimiento y el tiempo de revisión.
Para la lista más completa, nuestro artículo sobre métricas de soporte profundiza más de lo que puedo aquí. Si quieres el lado de la calidad de la escalada en concreto, tasa de contención es la siguiente lectura.
Un flujo de trabajo real, de principio a fin
Esta es la prueba a la que sigo señalando a la gente, porque el resultado no fue el que nadie esperaba.
Una joyería alemana online, con unos 1.000 tickets al mes en Zendesk con Shopify detrás, no se limitó a encenderlo todo y esperar. Hicieron correr al agente de verdad contra su bandeja de entrada en vivo: 284 chats más una validación cruzada de 100 tickets, de modo que cada cifra provenía de tickets que su propio equipo ya había gestionado.
La bandeja se dividía aproximadamente en un 38 % de soporte directo al consumidor, 22 % de spam, y 21 % de B2B interno. El triaje llegó al 93 % de precisión, y la detección de spam al 100 % sin falsos positivos, lo cual, en una bandeja donde casi un cuarto del volumen es basura, es una victoria real del primer día antes de que exista siquiera una sola respuesta de cara al cliente.
La calidad de los borradores fue más fuerte justo donde vive una política bien documentada: 96,4 % de borradores útiles en reclamaciones de garantía, 93,8 % en devoluciones y reembolsos, 100 % en consultas de producto y estado de reembolso.
Y luego vino la cifra que hizo que todos se detuvieran. Solo el 12 % de esos borradores se enviaron tal cual.
El instinto es leer eso como un problema de precisión. No lo era. Cuando desglosamos los motivos por los que los agentes reescribían los borradores, alrededor del 65 % de las ediciones fueron pura extensión y tono, porque los agentes comprimían borradores de 8 a 15 frases en respuestas de 1 a 3 frases. Alrededor del 20 % necesitaba datos a los que la IA no estaba conectada, sistemas de ERP y logística. Solo alrededor del 5 % de las ediciones se hicieron porque la IA se equivocó en los hechos. Evaluada por separado contra toda la muestra, en lugar de contra las ediciones, la tasa de error factual salió en un 7 %.
Esa distinción es lo más útil que he aprendido al ejecutar estos despliegues. "La IA se equivoca" y "la IA no suena como nosotros" son problemas distintos con soluciones distintas, y solo uno de ellos se resuelve con mejor conocimiento. La recomendación de esa prueba fue concreta: entrenar con 200 respuestas recientes de agentes, y la adopción tal cual debería pasar del 12 % a entre el 30 y el 40 %.

Como contraste, dos cifras publicadas en el otro extremo de la rampa. Gridwise resolvió el 73 % de las solicitudes de nivel 1 en el primer mes tras una prueba de siete días, que eesel publica en su página de producto. Global Pay reportó hasta un 80 % de ahorro de tiempo al encontrar respuestas en su documentación. Ambas son reales, ambas están publicadas, y ninguna es lo que se verá tu primer mes. La prueba de la joyería sí lo es.
Prueba eesel para el soporte al cliente con IA
Si algo de lo anterior suena como tu cola, esa es la forma del problema para el que se construyó eesel. Se conecta al helpdesk que ya operas en lugar de sustituirlo, en Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot y Jira Service Management. Lee tus documentos y tus tickets resueltos, y arranca en modo borrador, de modo que nada llega a un cliente sin que una persona lo haya visto antes.
La parte hacia la que de verdad te empujaría es la simulación. Antes de decidir si algo de esto funciona para tu equipo, ejecuta el agente sobre tus propios tickets pasados y lee lo que habría dicho junto a lo que tu equipo realmente envió. Esa comparación responde la pregunta que una demo no puede responder. Una vez que sales en vivo, es un precio mensual fijo (desde 299 $/mes por 500 créditos) sin cuota de plataforma ni cargo por asiento, y los primeros 100 créditos son gratis, que es más simulación de la que la mayoría de los equipos necesita para tomar la decisión.

Prueba eesel, o si prefieres verlo contra tus propios tickets con alguien que te guíe, la página del agente de helpdesk con IA es el lugar por donde empezar.
Preguntas frecuentes
¿Qué es el soporte al cliente con IA?
El soporte al cliente con IA es software que lee un mensaje entrante de un cliente, busca la respuesta en tu propia documentación e historial de tickets, y luego responde o entrega la conversación a una persona. La distinción útil es la que hay entre un chatbot basado en reglas con guion, que sigue un árbol de decisiones, y un agente de soporte con IA, que razona sobre tu contenido y puede ejecutar acciones en tu helpdesk.
¿Qué no debería gestionar nunca el soporte al cliente con IA?
Cualquier cosa donde equivocarse sea costoso o difícil de revertir: excepciones de política, disputas de facturación, asesoría legal, médica y financiera, y cualquier ticket de un cliente que ya está molesto. Una buena regla es la prueba de irreversibilidad. Si la acción no se puede revertir con un clic, la aprueba una persona. Nuestras notas sobre guardrails explican cómo se codifican esos límites. Sobre lo que pasa cuando faltan, lee cómo prevenir alucinaciones.
¿Cuánto cuesta el soporte al cliente con IA?
Depende por completo de la unidad facturable, que es el número que decide tu factura. Los precios por asiento cobran por agentes, los precios por resolución cobran solo cuando la IA cierra algo, y los precios por ticket cobran por cada conversación que la IA toca. La página de precios de eesel fija un precio mensual único por créditos (desde 299 $/mes por 500 créditos, 1 crédito por ticket o chat), sin cuota de plataforma ni cargo por asiento. Nuestro desglose de coste por resolución recorre la aritmética.
¿Cuánto tarda en implementarse el soporte al cliente con IA?
Conectar un helpdesk y conseguir que un primer agente responda tarda unos 30 minutos. Llegar a un despliegue en el que confíes tarda de dos a cuatro semanas, y lo que más lo alarga es casi siempre la base de conocimiento, no el software. Nuestra guía de implementación cubre la secuencia, y contenido desactualizado del centro de ayuda cubre la auditoría que haces primero.
¿Cómo se mide si el soporte al cliente con IA está funcionando?
Observa tres números juntos, nunca uno solo: la tasa de desvío junto con la tasa de resolución y la tasa de contacto repetido. Una tasa de desvío que sube junto con una tasa de contacto repetido que también sube significa que los tickets se están cerrando, no resolviendo. Nuestra guía de métricas de soporte lista el resto de los valores que vale la pena vigilar cada semana.
¿Puede el soporte al cliente con IA funcionar con mi helpdesk actual?
Sí, y añadirlo encima suele ser la opción más segura frente a sustituir el helpdesk. eesel se conecta con Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot y Jira Service Management, así que tu cola, tus macros y tus informes se quedan donde están. La lista completa está en la página de integraciones. Para ver cómo se ve eso en la práctica sobre un stack concreto, consulta IA para Zendesk.
¿Va a reemplazar el soporte con IA a los agentes de soporte?
En colas reales, lo que ocurre en realidad es que el nivel repetitivo desaparece y el trabajo humano se vuelve más difícil y más valioso. Los tickets que llegan a una persona son los ambiguos. Nuestra comparación de coste de agentes de IA frente a humanos y nuestras notas sobre desvío de nivel 1 cubren ambas dónde cae la línea.