

Gladly sí tiene control de calidad con IA, pero apunta a la propia IA de Gladly, no a una scorecard para tu gente. Los quality checks filtran cada respuesta de Gladly AI antes de enviarla y entregan el chat a una persona si falla alguno, y Signals puntúa sesiones de IA de chat, SMS y correo según hasta cinco criterios que tú escribes. Las conversaciones de agentes humanos se puntúan en herramientas de partners como MaestroQA o Calabrio, y la documentación de Gladly no nombra ningún plan o precio para nada de esto. eesel no tiene una conexión integrada con Gladly, así que yo lo usaría como revisor a través de la API REST de Gladly (no lo he probado de principio a fin), o como la opción si usas Zendesk, Freshdesk o Gorgias.
Con la CLI de eesel, un agente de IA para programar puede subir tu rúbrica de QA y tus páginas de políticas, luego hacer preguntas de prueba y revisar las respuestas antes de que nada salga a producción. Una persona sigue teniendo que aprobar cualquier conexión a un helpdesk.
¿Tiene Gladly control de calidad con IA?
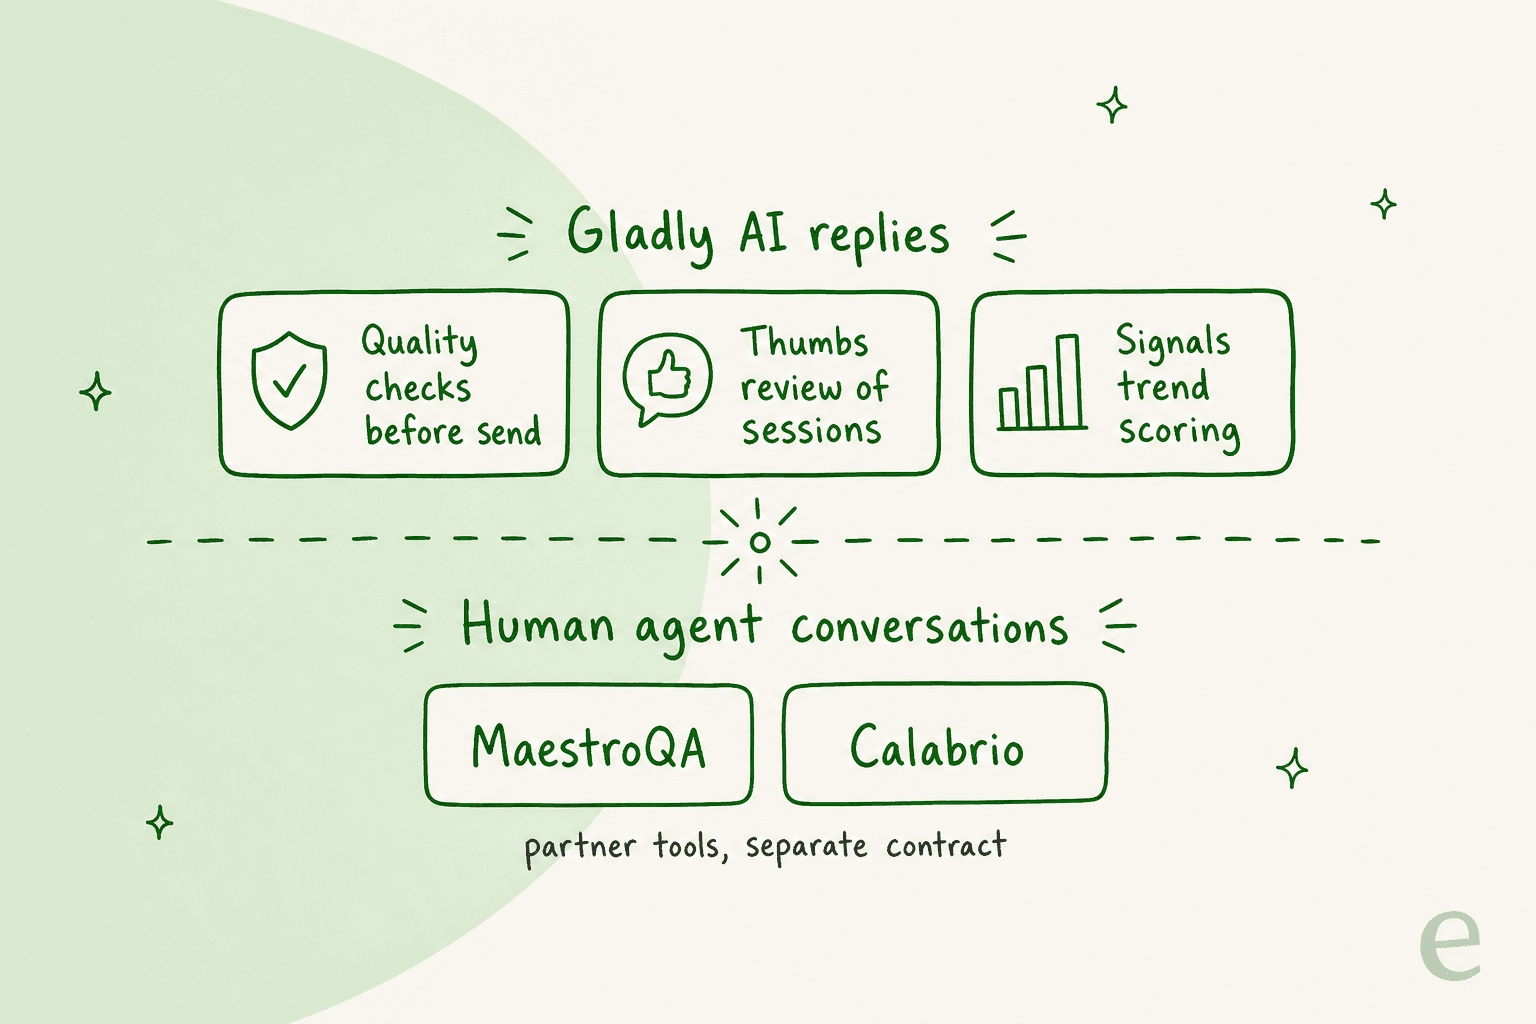
Sí, en tres capas, y lo que hay que notar es a quién mira cada capa. Yo trabajo en la cola de soporte en eesel, así que leo una herramienta de QA preguntando quién se puntúa y quién no. En Gladly, las capas nativas miran a la IA. Las personas están en un carril separado que Gladly entrega a partners, y ese es el hueco del que trata este artículo.
| Capa | Qué hace | Quién la ve | Límite |
|---|---|---|---|
| Quality checks | Prueba cada respuesta de IA antes de enviarla | La configuran Admins y Team Managers | Revisa la respuesta, no da una puntuación |
| Review and Inspect | Valoración con pulgar y notas, más una vista paso a paso de por qué respondió la IA | Admins y Team Managers, no los agentes | Sin datos antes del 24 de febrero de 2026 |
| Signals | La IA puntúa sesiones según tus criterios y agrega tendencias | Admins, Team Managers, roles personalizados con View Gladly AI | Solo sesiones de IA de chat, SMS y correo |
| QA de partner | Evaluadores puntúan conversaciones y hacen coaching a agentes | Los propios usuarios del partner | Proveedor y contrato separados |
La página de QA de Gladly describe el lado humano como "sync seamlessly with your QA tool", lo que dice que la scorecard vive fuera de Gladly. Si quieres la idea general primero, mi guía sobre IA para QA de soporte cubre lo que revisa un programa completo.
¿Qué detectan los quality checks de Gladly?
Detectan problemas de respuesta antes de que el cliente los vea, lo cual es un trabajo distinto a puntuar. Según el resumen de Gladly (actualizado el 21 de febrero de 2026), un cliente envía un mensaje, Gladly genera una respuesta, y la respuesta pasa por checks automatizados. Si aprueba, se envía. Si falla, Gladly la entrega a un agente en lugar de enviarla.
Los checks se dividen en tres categorías de cara al cliente:
| Categoría | Qué marca | Ejemplo de fallo de la documentación de Gladly |
|---|---|---|
| Missing Action | Afirmaciones sobre acciones que Gladly no ejecutó o no puede ejecutar | "Your order has been cancelled" cuando no se ejecutó ninguna cancelación |
| Missing Information | No hay suficiente información para responder | "Reach out to our customer service team" dentro de una conversación que ya es de servicio al cliente |
| Unverified Information | Fechas, políticas, correos, teléfonos o URLs que no están en el contexto | "Our return policy is 90 days" cuando la política real son 30 |
Por debajo, Gladly mezcla checks de LLM (Implied Mutation, Unfulfilled Action, Transfer Claim, Contact Us, Hallucination) con checks de código (Invalid Phrase, alucinación de correo y teléfono). Hallucination es el que yo vigilaría: divide la respuesta en frases y pregunta si cada afirmación de hecho está respaldada por resultados de acciones, resultados de búsqueda o contenido del Guide. Auto-Correction es un ajuste por defecto que elimina frases no respaldadas hasta un umbral configurado, corrige la gramática, repara URLs y vuelve a comprobar antes de entregar.
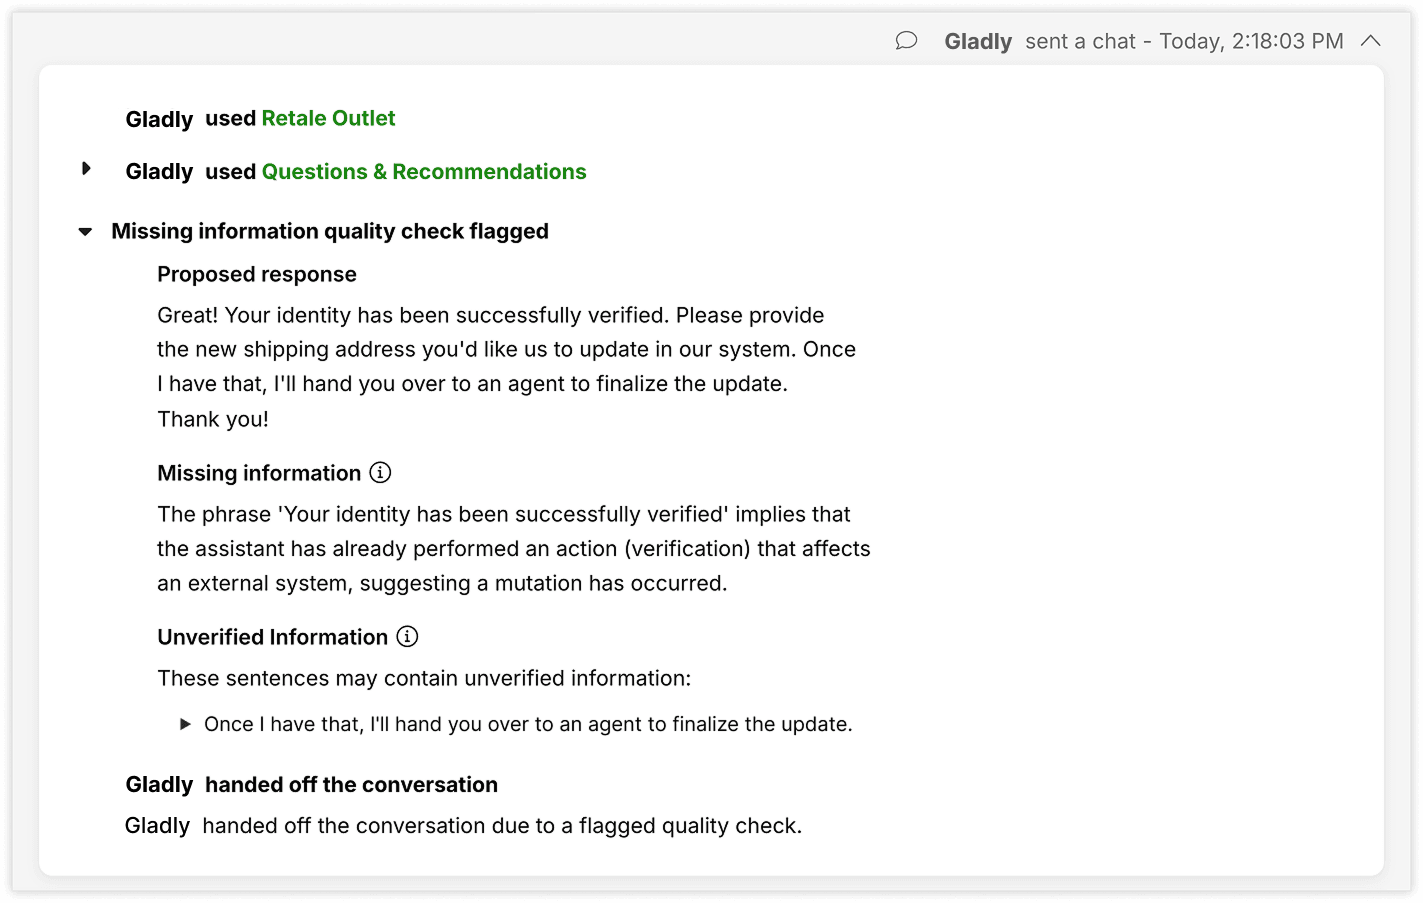
Esto se puede ajustar por Guide. Un Admin o Team Manager puede activar o desactivar checks individuales para un Guide, y el punto de partida recomendado por Gladly es concreto: para un Guide que responde desde fuentes de conocimiento, mantener Hallucination activo y desactivar Implied Mutation e Invalid Phrase, porque "may flag valid instructions and cause unnecessary handoffs". Eso te dice que el coste de un check estricto es una entrega, así que un ajuste ruidoso se traduce en trabajo extra para tus agentes. Lee mis notas sobre mejores prácticas de handoff si eso te importa.
¿Cómo revisas conversaciones de Gladly AI?
Las abres una a una, o extraes los informes agregados. En Review and Inspect (actualizado el 7 de noviembre de 2026), abres una sesión de IA, das un pulgar arriba o abajo con una nota, y haces clic en cualquier respuesta de IA para ver el Guide que siguió, las fuentes que consultó, los pasos que dio y el resultado de su quality check.
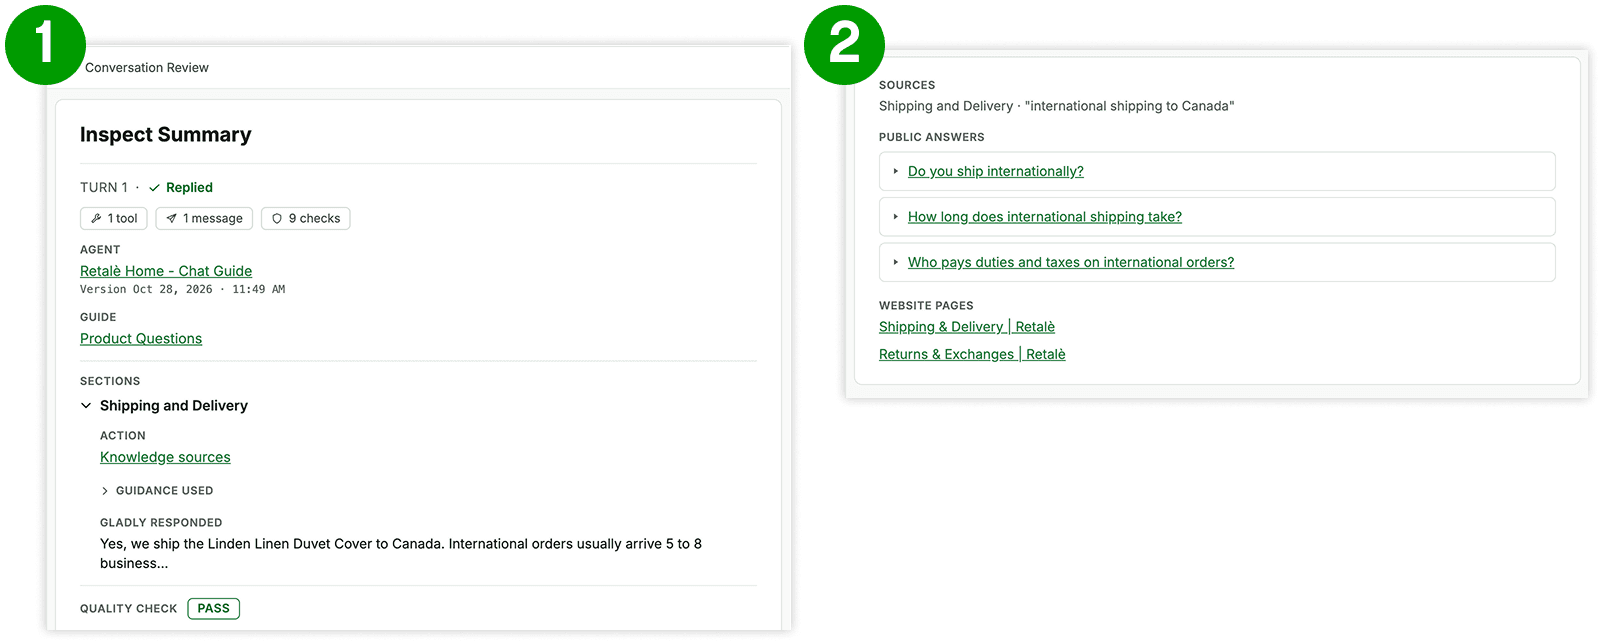
Cuatro detalles dan forma a cómo llevarías esto como rutina de QA:
- Es para managers. Review and Inspect son visibles para Admins y Team Managers, no para agentes, e Inspect no está disponible para conversaciones anteriores al 24 de febrero de 2026.
- Las valoraciones son un diario. Gladly dice que la página de Reviews "is an internal tool for your team, it is not sent to or acted on by Gladly". Las valoraciones no reentrenan nada por sí solas.
- Puedes exportarlas. El Feedback Report da una fila por review con el comentario, el ID de sesión y el enlace a la conversación, como CSV.
- Hay un panel de resultados. Improvement Opportunities sigue las tasas de respuesta, resolución, handoff y recontacto a 24 horas, y clasifica motivos de handoff como QC Failure, Transfer Detector y Hallucinated Argument.
Gladly también tiene un Simulator para probar antes de lanzar. Escribes un escenario con criterios de éxito de sí o no, y cada criterio debe aprobar para que la prueba apruebe. Está en Early Access, así que contactas con el soporte de Gladly para saber más. Para el método general, mira pruebas de simulación de soporte con IA.
¿Qué puede puntuar Gladly Signals?
Signals es lo más parecido que tiene Gladly a puntuación automatizada, y es útil con límites claros. Según la documentación de Gladly (actualizada el 20 de noviembre de 2026), "uses AI to evaluate AI-handled Sessions against criteria you define", y luego agrega los resultados en tendencias. Construyes un Signal con uno a cinco criterios, cada uno con dos a cinco labels (hasta 30 caracteres cada uno), y opcionalmente marcas un label como Goal o Risk.
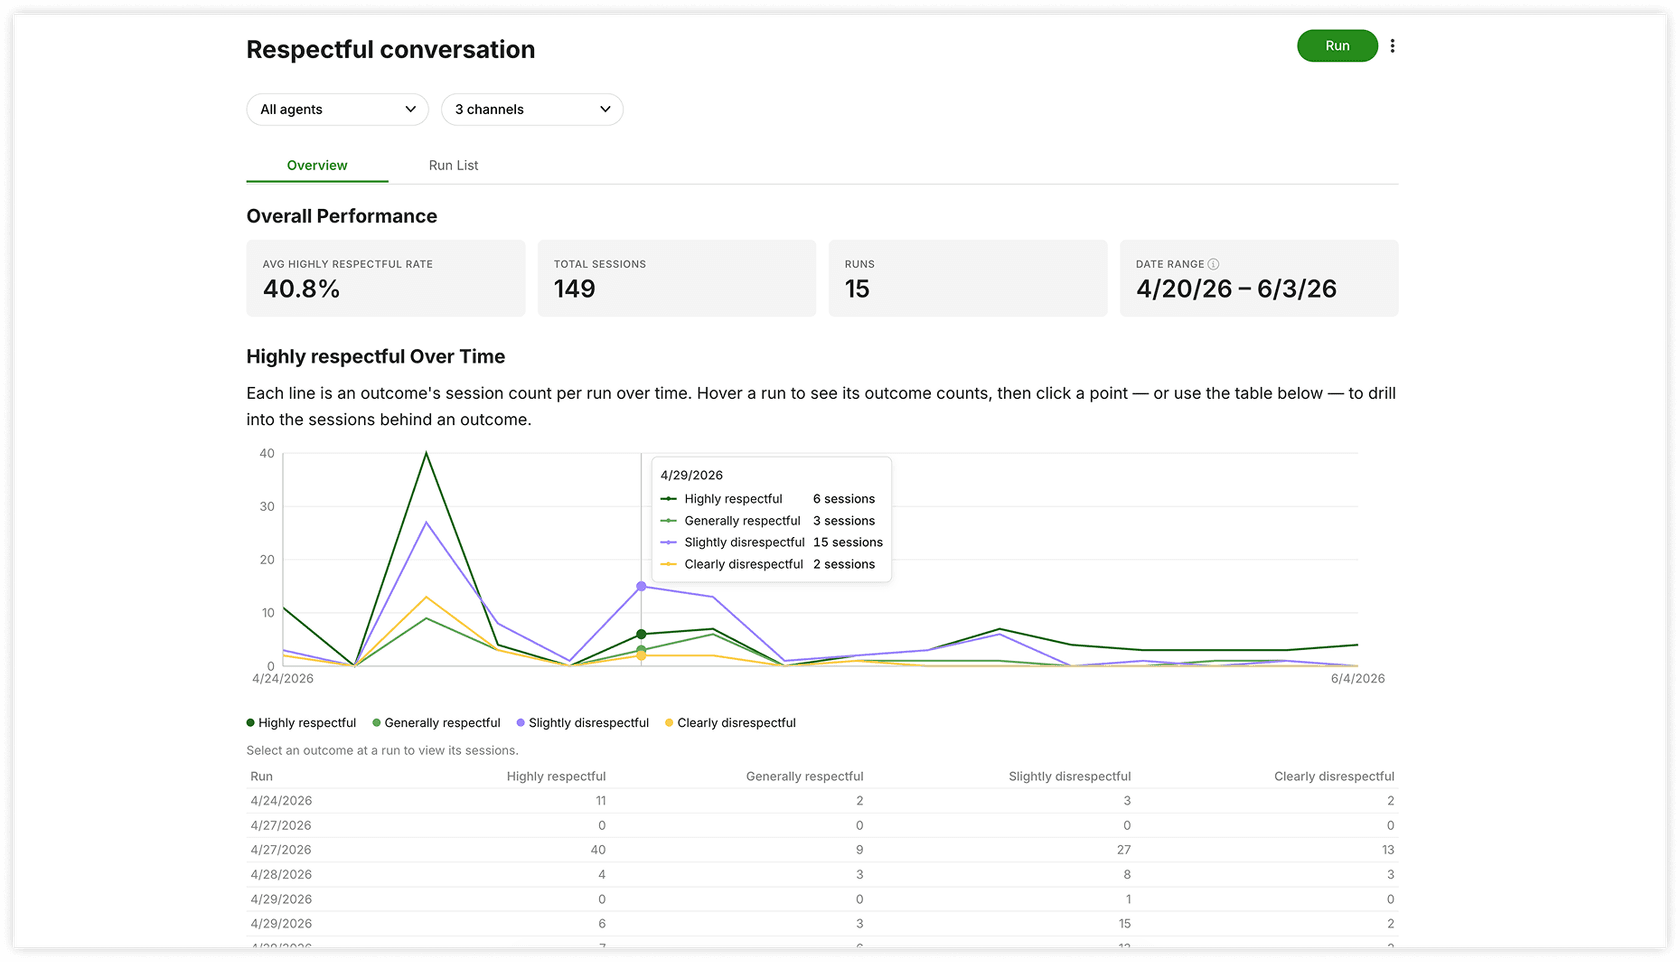
Tú eliges cómo funciona:
- Muestreo. La tasa es del 5%, 20% (la opción por defecto), 50% o 100%, con 100, 1.000 o 10.000 sesiones por ejecución.
- Programación. Puntual, o continua a diario o semanal. No hay opción mensual, y Gladly dice que Signals se ejecuta a demanda o programado, no en vivo.
- Revisión. Cada sesión evaluada lleva el label de la IA, su razonamiento y una cita de apoyo. Tú apruebas o marcas cada una, y una tarjeta de tasa de acuerdo muestra con qué frecuencia tu revisión coincidió con la de la IA.
El consejo de Gladly es la parte que yo copiaría. Prefiere menos labels, ya que "Binary (Yes/No) or a short list of named categories" produce resultados más consistentes que una lista más larga, y nunca uses una escala del 1 al 5. Empieza con menos de 50 sesiones antes de escalar. Gladly mantiene sus propios criterios integrados en una barra de ">90% accuracy" y dice que deberías fijar la tuya.
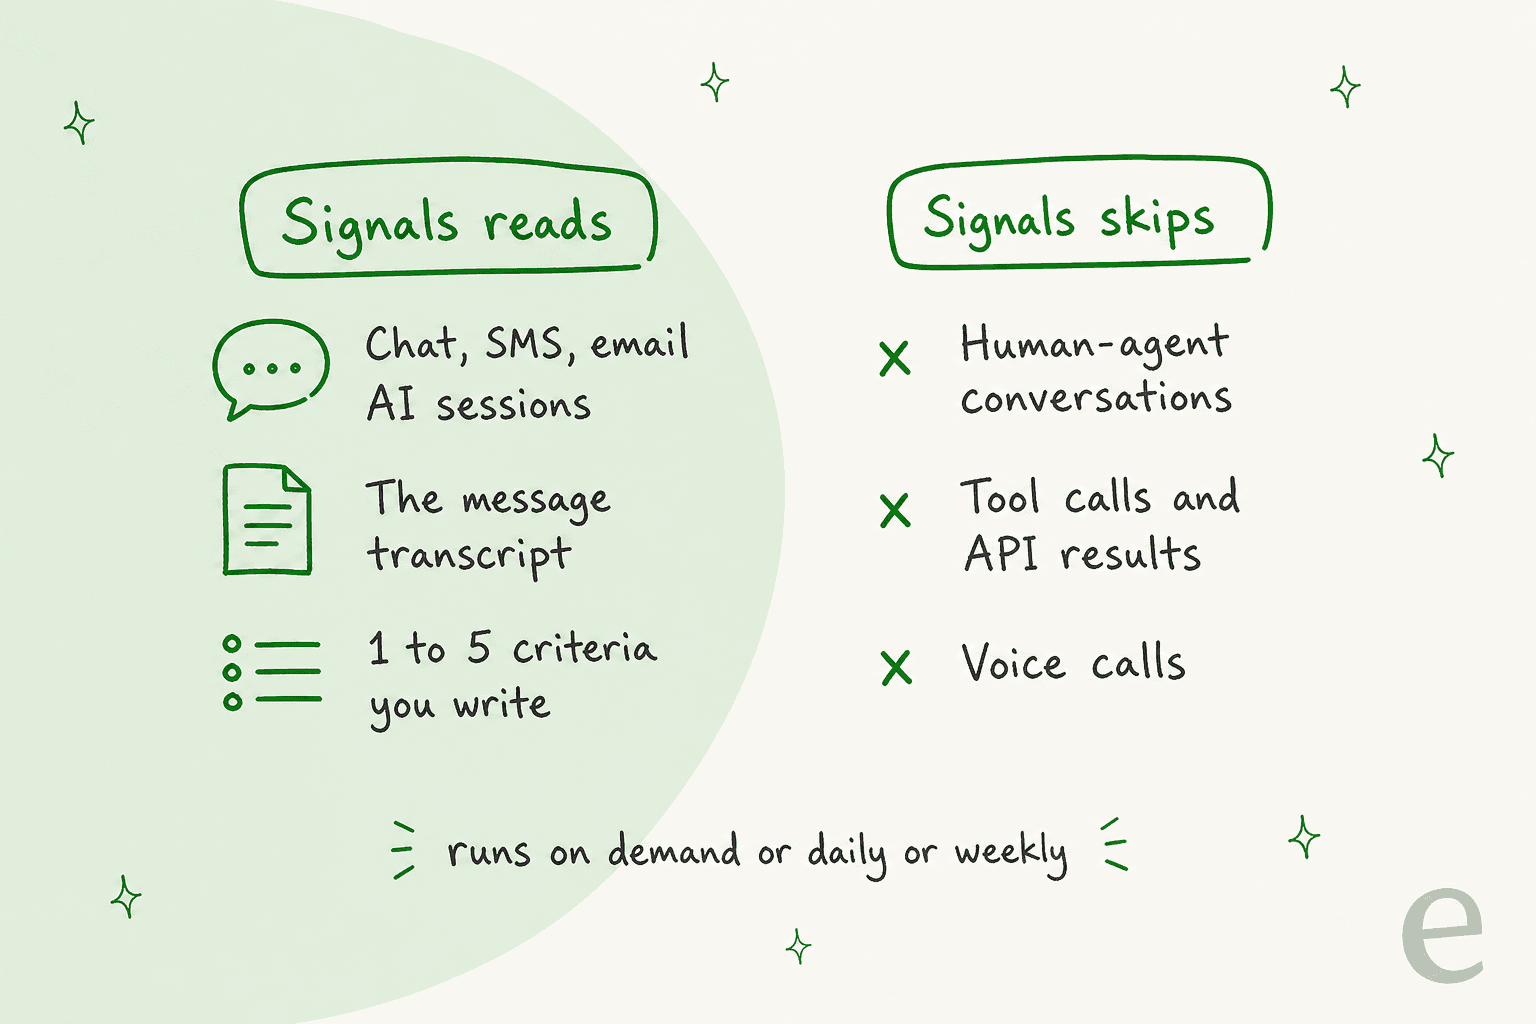
Dos límites importan más para una responsable de QA. Primero, las buenas prácticas de Signals dicen que "only reads the Conversation transcript", así que no puede ver llamadas a herramientas ni respuestas de API, y "conversations led by human Agents aren't included yet". El propio ejemplo de Gladly: no puedes preguntar si la IA realizó con éxito una cancelación, solo si le dijo al cliente que el pedido estaba cancelado. Segundo, es una herramienta de tendencias. Gladly dice que "not a replacement for human review".
¿Quién puntúa a los agentes humanos en Gladly?
Un partner lo hace. La lista de integraciones de Gladly incluye MaestroQA y Calabrio, ambos construidos y mantenidos por el partner, no por Gladly.
- MaestroQA se define como una plataforma para entender "support quality beyond CSAT", donde los evaluadores ven correos y escuchan llamadas. Según el kit de integración de Gladly, hace peticiones de solo lectura, así que "no data comes to Gladly from MaestroQA". Trae todas las conversaciones y luego usa reglas para acotar cuáles ven los evaluadores. Los canales son correo, voz y todos los canales de mensajería, y la configuración necesita un token de API de un usuario dedicado de Gladly.
- Calabrio te permite llevar los datos de rendimiento por agente de Gladly a programas de coaching y QA, con Calabrio Professional Services a cargo de la implementación.
Si te quedas dentro de Gladly, también hay una vía manual. Admins, Team Managers y usuarios Agent Plus pueden escuchar, hacer coaching o unirse a llamadas en vivo, y las grabaciones están disponibles para prácticas de QA. Una QA Analyst en Capterra describe esa vía así:
"It's great that the call is always recorded and that we can stop the recording when we need it. It helps us to keep track of every call very easy. Not only that, but it has the option to listen other call to monitoring in case is needed."

La profundidad de reporting es donde algunos revisores quieren más. Otro revisor de Capterra escribe:
"While this platform performs flawlessly at organizing customer communications and straightening out all chat content, its built-in data reporting function is far from sufficient to meet our marketing team’s needs."
Ese revisor habla de análisis de marketing, no de QA, así que no lo estiraría demasiado. Sí coincide con el patrón: el reporting de Gladly es amplio, y su puntuación de sentimiento y calidad de conversaciones humanas vive en otro lugar. Mis notas sobre análisis de sentimiento con IA de Gladly cubren la otra mitad.
¿Qué herramienta de Gladly cubre qué check?
Usa esto para ordenar tus propias preguntas de QA. Toca una para ver qué la cubre.
Toca cada check para ver qué herramienta de Gladly, si alguna, lo cubre.
¿Qué plan de Gladly incluye QA, y cuánto cuesta?
No pude confirmar ninguna de las dos cosas en las propias páginas de Gladly. La documentación describe los quality checks, el registro de Reviews y Signals sin nombrar un plan, aunque Signals dice estar disponible "for any organization using Gladly AI". El Simulator está en Early Access por solicitud. Gladly no publica precios de plataforma en su página de precios, así que el número sale de una llamada de ventas. Mi guía de precios de Gladly cubre lo poco que es público.
Pregunta a tu equipo de cuenta cuatro cosas antes de planificar nada de esto:
- ¿Está Signals en mi contrato, y cómo se facturan sus ejecuciones si subo la tasa de muestreo hacia el 100%?
- ¿Están los quality checks activos por defecto en cada Guide, y puedo ver la tasa de handoff que causan?
- ¿Qué herramienta de QA de partner usan otros clientes de Gladly en mis canales, y qué añade ese contrato?
- ¿Cuándo leerá Signals conversaciones llevadas por agentes humanos?
MaestroQA y Calabrio ponen precio a sus propios productos, y no he puesto precio a ninguno de los dos, así que no voy a adivinar un número.
¿Cómo cubres los huecos del QA de Gladly?
Empieza con lo que Gladly ya hace bien, y luego añade un carril para agentes humanos. Esta es la rutina que yo llevaría, unos 30 minutos para configurarla:
- Mantén activos los quality checks por defecto. Desactiva solo los que Gladly mismo dice que hay que quitar en un Guide basado solo en conocimiento, y vigila tu tasa de handoff después.
- Escribe tres Signals binarios. Elige preguntas de sí o no ligadas a tus políticas, ejecuta cada una sobre menos de 50 sesiones y luego amplía. Empieza con "le dijo al cliente que una acción estaba hecha" y "dio una fecha o una política".
- Revisa cada sesión marcada o con puntuación baja. Usa la tasa de acuerdo para encontrar criterios que necesiten ajustarse. Mi rutina de revisión de conversaciones de IA muestra qué buscar.
- Pon una scorecard sobre las conversaciones humanas. Usa una herramienta de partner, o un equipo calibrado de revisores. Calibración de QA de soporte y criterios de scorecard de QA te ayudan a empezar.
- Devuelve los fallos. La nota de un revisor solo sirve si alguien edita el Guide o la política. Ejemplos de feedback de QA mantienen las notas concretas.
Añade CSAT como segunda señal de dónde mirar primero, y un registro de escalado para las conversaciones que de todas formas necesitaron a una persona.
¿Dónde encaja eesel con el QA de Gladly?
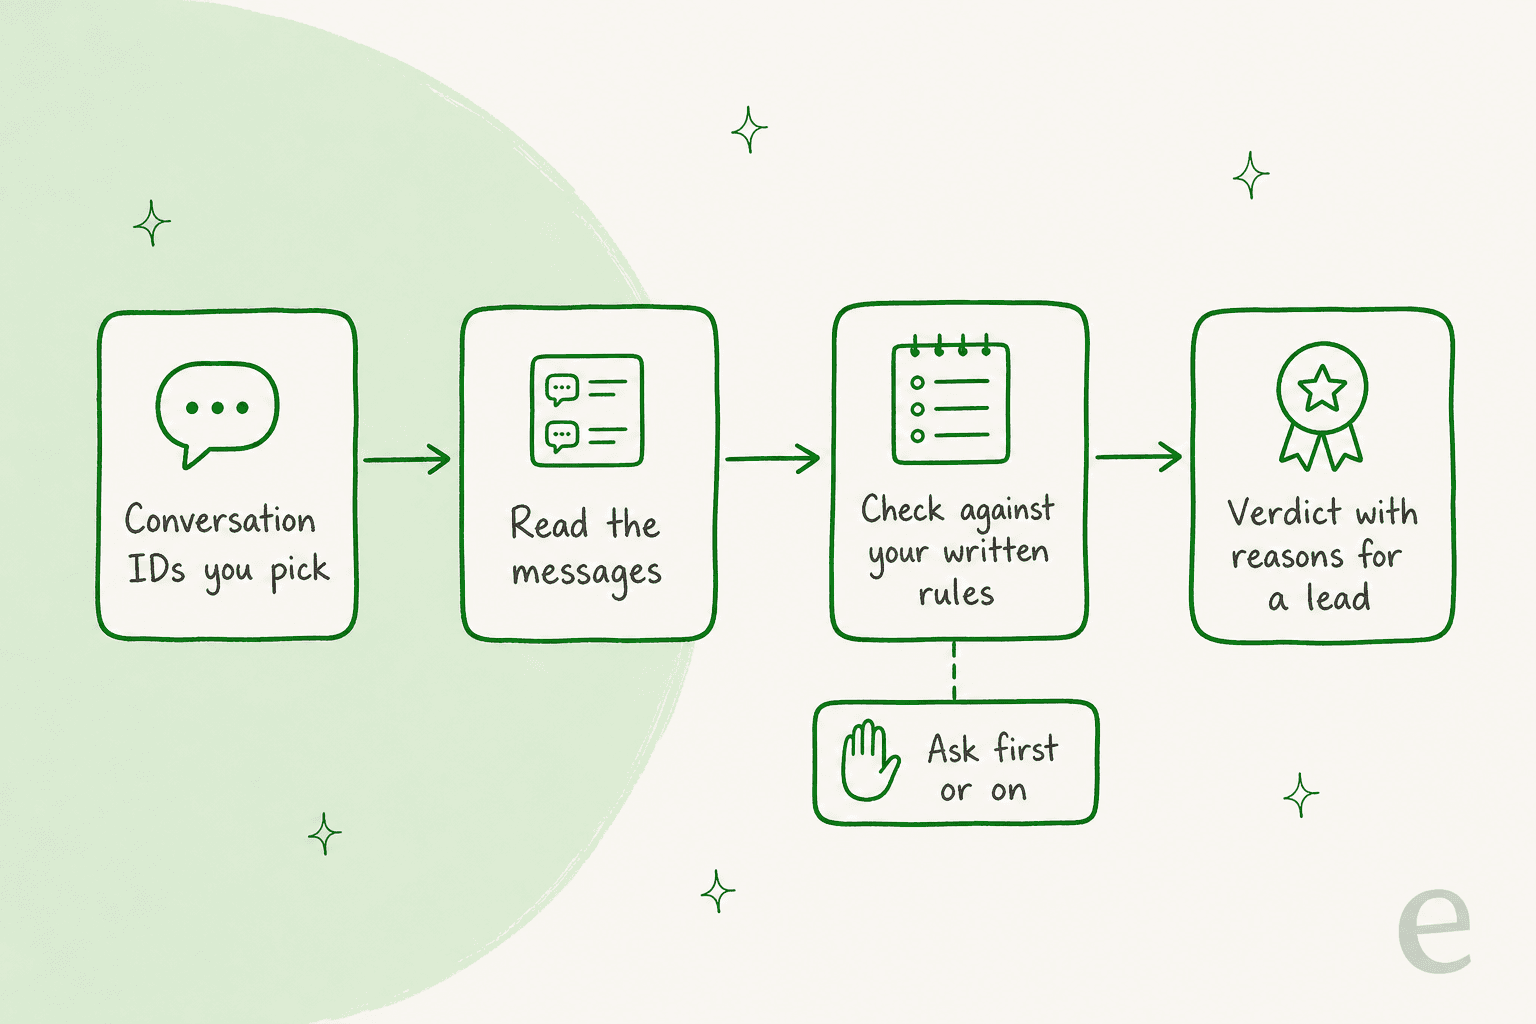
eesel no tiene una conexión integrada con Gladly, así que esto es lo que puedo y no puedo decir. eesel es una plataforma de compañeros de equipo con IA, y el que importa aquí es el compañero de equipo de helpdesk con IA. Para QA, lo pienso como un revisor que lee las conversaciones que le entregas y las comprueba contra reglas que escribes en palabras sencillas.
Gladly tiene una API REST, y eesel tiene una página de Tus APIs donde autorizas un dominio y añades una cabecera de autenticación. Se admite autenticación básica, las credenciales se quedan en los ajustes y la IA nunca las ve. La propia documentación de Gladly dice que un usuario de API crea un token de API, que se muestra una sola vez y está ligado a un usuario y un entorno, y que MaestroQA lee conversaciones a través de los endpoints /conversations y /conversation-items. Así que traer una conversación para revisarla parece posible. No he probado eesel contra la API de Gladly, trátalo entonces como una vía a confirmar en una demo, no como una función ya entregada.
Si eso funciona, le darías IDs de conversación y leería los mensajes, los comprobaría contra tu política y tu base de conocimiento, e informaría de los motivos a un responsable. En acciones y aprobaciones de eesel, cada acción puede ejecutarse sola, preguntar antes o quedarse apagada, lo que mantiene a un humano en el bucle.
La misma forma ya funciona para clientes de eesel. Cactus Club Cafe lleva dos agentes en Zendesk. Tixie lee el ticket completo, abre la política de emergencia y la matriz de enrutamiento antes de nada más, y sigue el runbook correspondiente sin pasos improvisados. Unas 790 de sus respuestas en un mes fueron borradores para que el equipo las enviara, frente a 51 enviadas directamente. Un segundo agente audita el extracto financiero diario, comprueba cada tienda y el total, y resuelve el ticket como equilibrado o lo deja abierto con el desajuste nombrado. Una revisión de QA también es una comprobación contra reglas escritas.
Para los demás helpdesks, mira mis guías de Dixa, Freshchat, Gorgias, Kustomer y Zoho Desk.
¿Es suficiente el QA de Gladly?
Para la IA, sí, y los quality checks antes de enviar son la parte que valoro más. Detienen una respuesta con una fecha no respaldada o una acción prometida que nunca se ejecutó, y explican por qué. Para las personas, no: necesitas un partner o un revisor humano, y deberías preguntar cuándo cubrirá Signals las conversaciones llevadas por agentes.
Mi opinión: si usas Gladly AI, mantén activos los quality checks, usa Signals para las tendencias que puedas nombrar en una pregunta de sí o no, y puntúa a tus humanos en MaestroQA o Calabrio. Recuerda qué significa un check aprobado. Significa que la respuesta estaba respaldada por el contexto, no que la política fuera correcta. Para revisiones más profundas entre herramientas, mira mi resumen de IA para QA de soporte y mis notas sobre observabilidad del agente de soporte con IA y permisos. Para el resto de la IA de Gladly, lee resúmenes con IA de Gladly, respuestas borrador, enrutamiento, traducción y deflection. ¿Estás valorando un cambio? Mira las mejores alternativas a Gladly, la mejor IA para Gladly y Kustomer vs Gladly.
Prueba eesel como tu revisor de políticas
Si el check que te falta es "¿esto estuvo bien según nuestra política?", eesel es el revisor que yo probaría después de las propias herramientas de Gladly. Lee las conversaciones que le entregas, las comprueba contra las reglas que escribes y tu centro de ayuda, y te dice por qué aprobaron o no. Si usas Zendesk, Freshdesk o Gorgias, se conecta directamente. Si usas Gladly, pregunta primero por la vía de la API. Empieza con diez conversaciones que tu equipo ya haya puntuado, y comprueba si eesel coincide. La guía de QA de call center cubre la voz.

Prueba eesel gratis, o reserva una demo para preguntar cómo revisaría tus conversaciones de Gladly.