

El control de calidad con IA de Front es Smart QA: en el plan Enterprise (105 $ por puesto al mes, facturado anualmente), la IA de Front puntúa cada conversación resuelta o archivada en las bandejas compartidas que elijas según una scorecard que creas con 15 criterios predeterminados y tus propios criterios personalizados. Las puntuaciones aparecen en un panel lateral y en un informe de Smart QA, y un admin puede anular cualquiera de ellas. Hace más que comprobar el tono, con dos salvedades. Sus criterios solo leen los mensajes de la conversación, así que Front dice que las etiquetas, las marcas de tiempo y el enrutamiento no se pueden puntuar, y pasó a un modelo más estricto el 20 de noviembre de 2026, así que los promedios bajan desde esa fecha sin que tu equipo haya empeorado. Para comprobar lo que Smart QA no puede (la etiqueta correcta, la bandeja correcta, la política en tu centro de ayuda), un responsable puede leer una muestra semanal, o un teammate de IA como eesel puede revisar cada conversación archivada según reglas que escribes y dejar sus razones en un comentario interno. Un agente de código como Claude Code puede configurar esa revisión mediante el CLI de eesel, aunque alguien autorizado a aprobar apps en Front sigue teniendo que aprobar la conexión.
¿Front tiene control de calidad con IA?
Sí. Front lo llama Smart QA, y el argumento de su página de producto es que "alguien tiene que revisar cada ticket", pero no tienes que ser tú. Yo construyo las integraciones de eesel, así que leo una función como esta por lo que realmente lee y escribe, no por lo que dice la página de producto.
Smart QA no es la única señal de control de calidad de Front. Esto es lo que obtiene un responsable de soporte, según la propia documentación de Front y su página de precios:
| Función de Front | Plan | Qué le dice a un responsable de QA | Qué no le dice |
|---|---|---|---|
| Smart QA | Enterprise | Cómo puntuó cada teammate y cada agente de IA según tus criterios, con razones y fragmentos citados | Nada sobre etiquetas, marcas de tiempo o enrutamiento |
| Smart CSAT | Enterprise | Cuán satisfecho estuvo probablemente el cliente, a partir del sentimiento, el esfuerzo y la resolución | Qué parte fue mérito del agente |
| Simulaciones de Compass | Con un agente de Autopilot | Si el agente de IA cumple tus criterios en conversaciones reales pasadas antes de salir en vivo | Cómo se desempeñan los teammates humanos |
| AI Topics | Todos los planes | Por qué escriben los clientes | Si recibieron una buena respuesta |
¿Cómo funciona Front Smart QA?
La IA de Front lee cada conversación en cuanto se resuelve o archiva, puntúa a cada teammate que respondió según los criterios de tu scorecard, y escribe una razón breve para cada puntuación. La configuración tiene dos partes:
- Una scorecard. En la configuración de la empresa, abre Front AI, luego la pestaña Smart QA, y haz clic en Create scorecard. Marca los criterios predeterminados que quieras, añade otros personalizados, y edita cómo se puntúa cualquiera de ellos. Puedes mantener varias scorecards.
- Una regla. En Rules and macros de un workspace, crea una regla a partir de la plantilla Review conversations with Smart QA. Pregunta qué tipos de conversación, qué bandejas compartidas, qué respuestas de teammates, cuánto esperar después de que una conversación se archive o resuelva, y qué scorecard usar.
Los 15 criterios predeterminados se agrupan en tres categorías. Communication incluye Brevity, Empathy, Friendliness, Grammar and spelling, Greeting offered, Information gathering, Personalization, Professionalism, Readability y Tone. Solution incluye Comprehension y Solution offered. Proactivity incluye Adaptability, Demo offered y Upsell. Algunos solo se aplican cuando surge el momento (Upsell, cuando "surgió una oportunidad clara de upsell/cross-sell"); si no, el criterio marca N/A y no cuenta.
Cada criterio se puntúa en una escala de 1 a 5 o de forma binaria con aprobado y reprobado. Las escalas se convierten en porcentajes (un 1 es 0%, un 4 es 75%), y el informe calcula el promedio, así que un teammate con un 1 y un 4 en Tone muestra 38%.
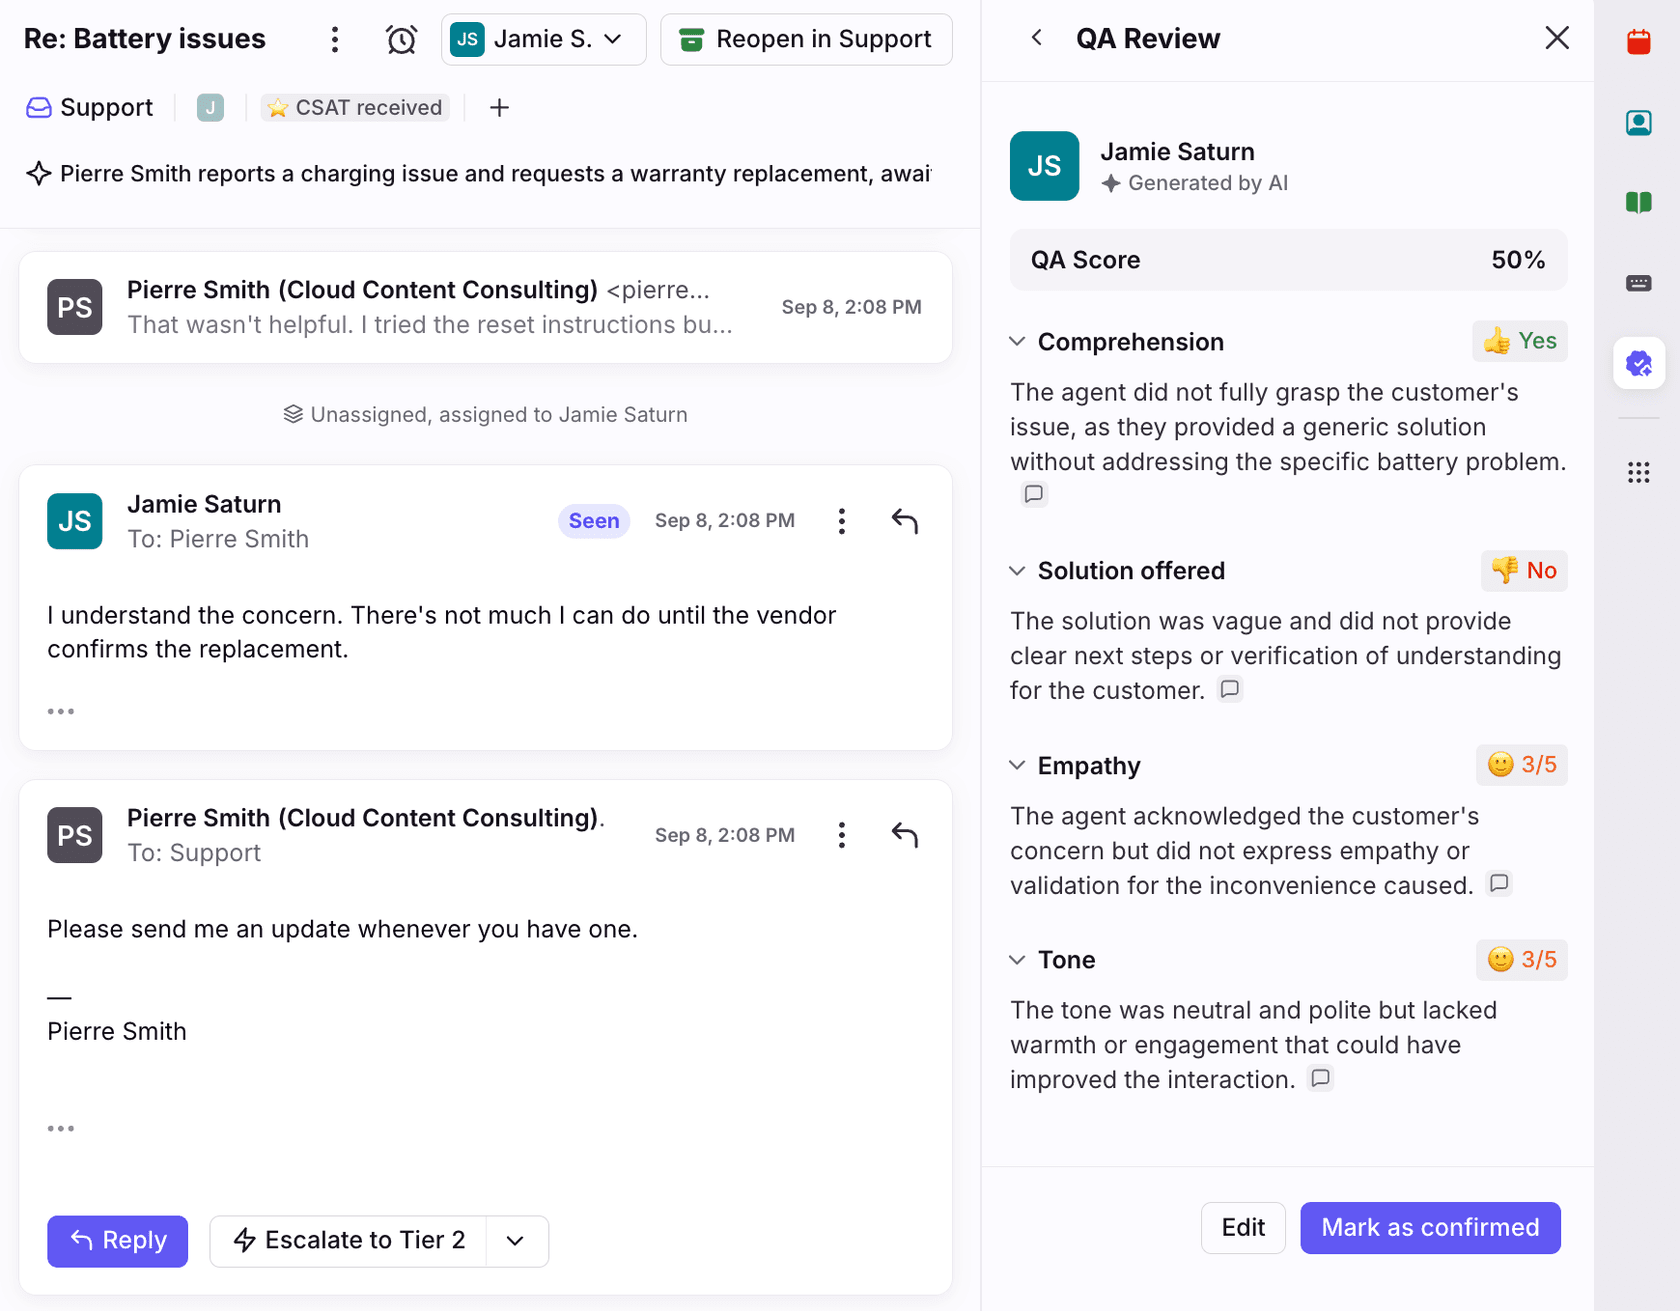
Los resultados aparecen en dos lugares, junto a Smart CSAT si lo usas. El panel Smart QA and CSAT en la barra lateral de la conversación muestra la revisión, y en las conversaciones puntuadas después del 6 de septiembre de 2026 cada razón cita hasta tres fragmentos a los que puedes saltar haciendo clic. El informe Smart QA en Analytics promedia cada criterio por teammate, ordena las conversaciones por puntuación y exporta a un archivo.
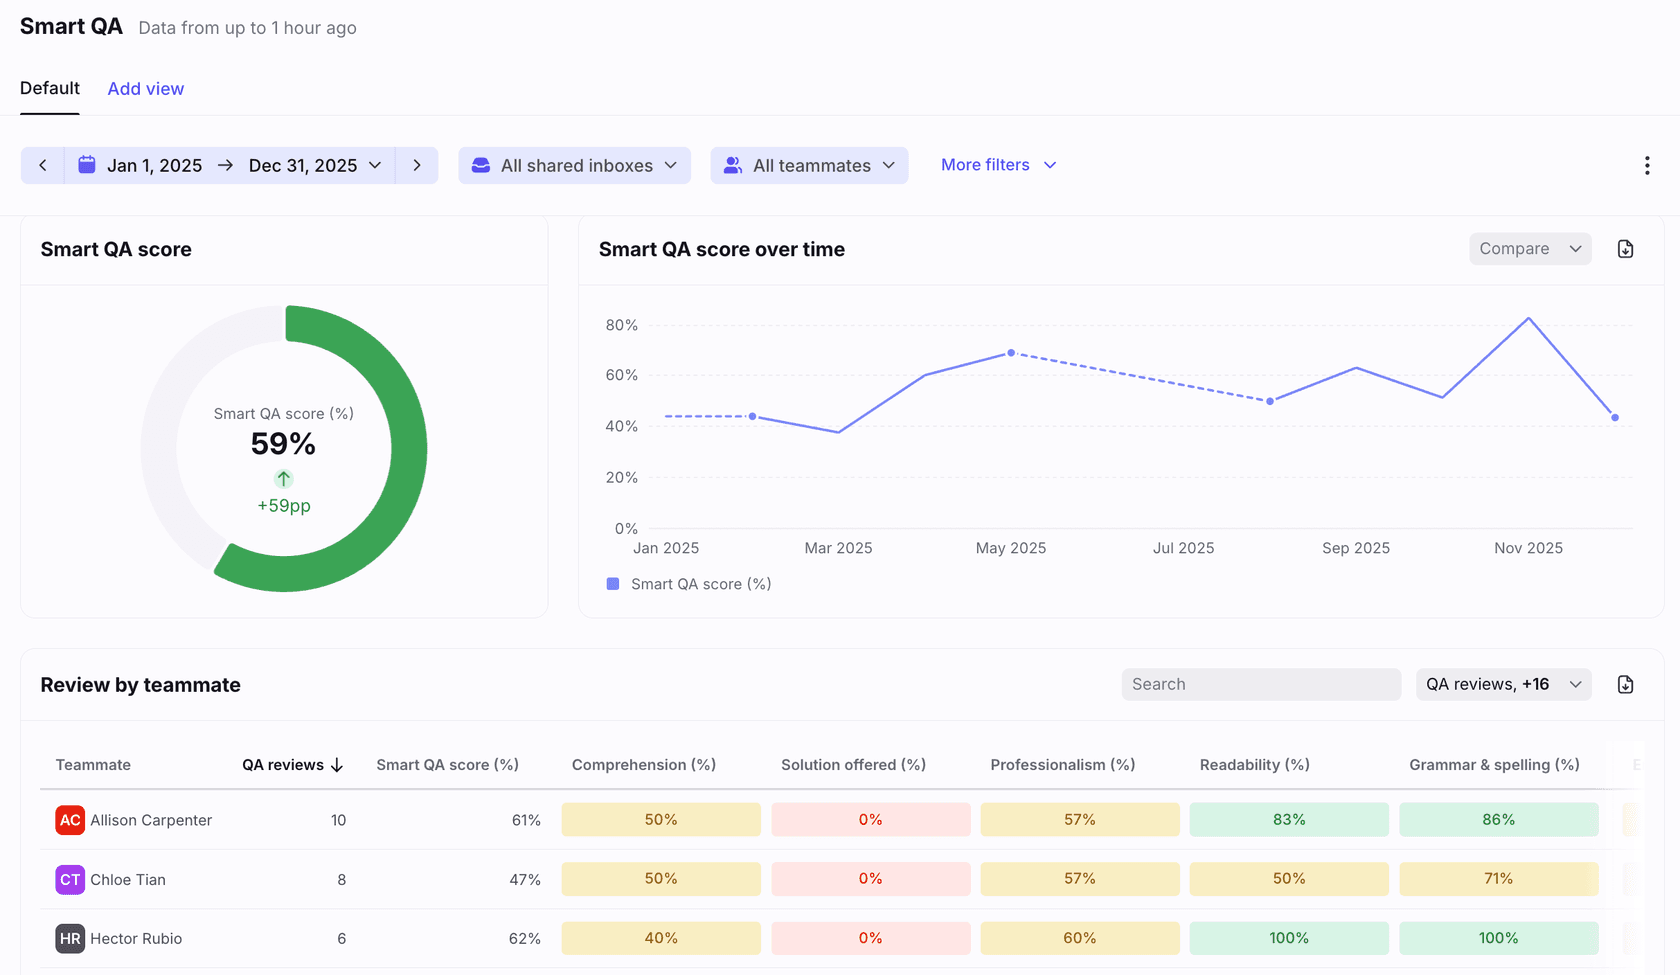
Las reglas que conviene conocer antes de confiar en los números:
- Los admins pueden anular. Edita una puntuación desde el panel o el informe, añade un comentario, y haz clic en Save & mark as reviewed. El nombre del admin reemplaza "Generated by AI", y el informe se actualiza en una hora.
- Los agentes solo ven las suyas. Los admins con permisos de analítica ven todo. Front también te pide que avises a los agentes cuando se les aplica Smart QA a sus conversaciones.
- Los agentes de IA también se puntúan. Se evalúa a todo teammate que responde antes de que la conversación se resuelva o archive, "tanto teammates humanos como agentes de IA". evaluación de agentes de IA explica cómo probar un agente antes de que salga en vivo.
- Front dice que no te fíes solo de esto. Su artículo te pide "confiar en tu propia evaluación y análisis, o en los de expertos, para decisiones importantes".
¿Por qué bajaron las puntuaciones de Front Smart QA en noviembre de 2026?
Porque Front cambió el modelo. El 20 de noviembre de 2026 Smart QA pasó a un modelo mejorado que, según Front, puntúa más parecido a revisores humanos expertos. La parte que notará un responsable: "Antes de la actualización, unas dos terceras partes de las puntuaciones eran 5. Ahora, alrededor de 1 de cada 4 conversaciones puntúa 5." Front te dice que esperes promedios más bajos y que trates la fecha de la actualización como una nueva base.
Así que si la puntuación de Smart QA de tu equipo bajó esta semana, no abras todavía un plan de coaching. Compara las semanas posteriores al 20 de noviembre entre sí, y si informas de la QA hacia arriba, marca el corte en el gráfico. Yo lo tomaría como buena noticia: una escala en la que dos tercios de las conversaciones obtienen la nota máxima no puede distinguir a tu mejor agente de uno medio.
¿Cómo funcionan los criterios personalizados en Front Smart QA?
Describes la comprobación con palabras sencillas y Front la convierte en una escala. Bajo el interruptor Criteria en la pestaña Smart QA, haz clic en Create criteria, dale un nombre y una descripción, y la documentación de Front sugiere decir "qué evalúa el criterio, qué no evalúa". Generate escribe a partir de eso una escala de 1 a 5 o de aprobado y reprobado, que puedes editar, y Applicability define si se aplica a cada conversación o solo a las que describas. Un validador marca "Too vague" o "Not a condition", aunque aun así te deja guardar.
El propio ejemplo de Front es un criterio llamado Solution accuracy:
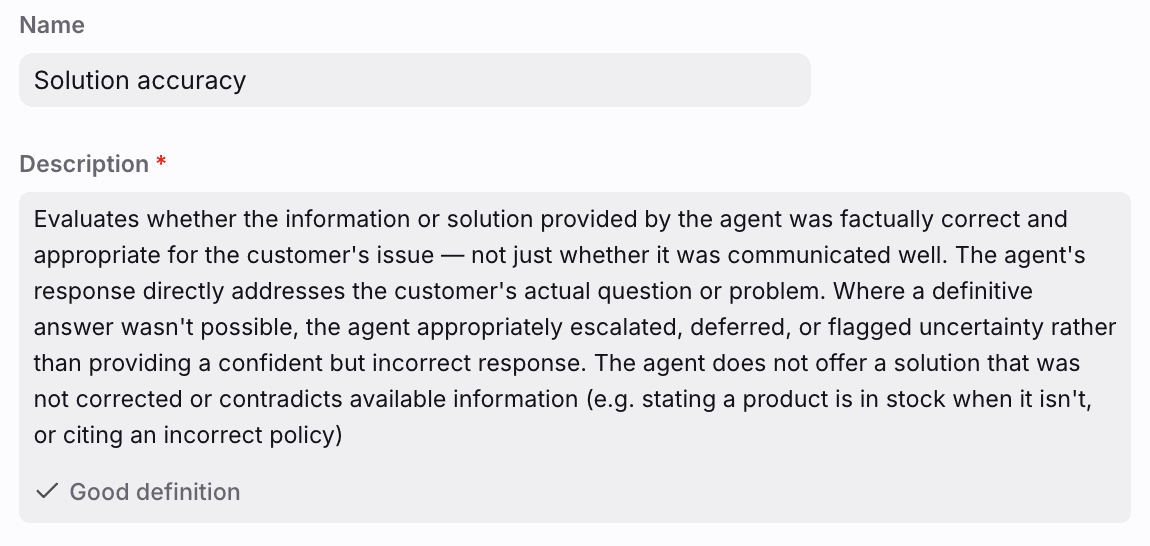
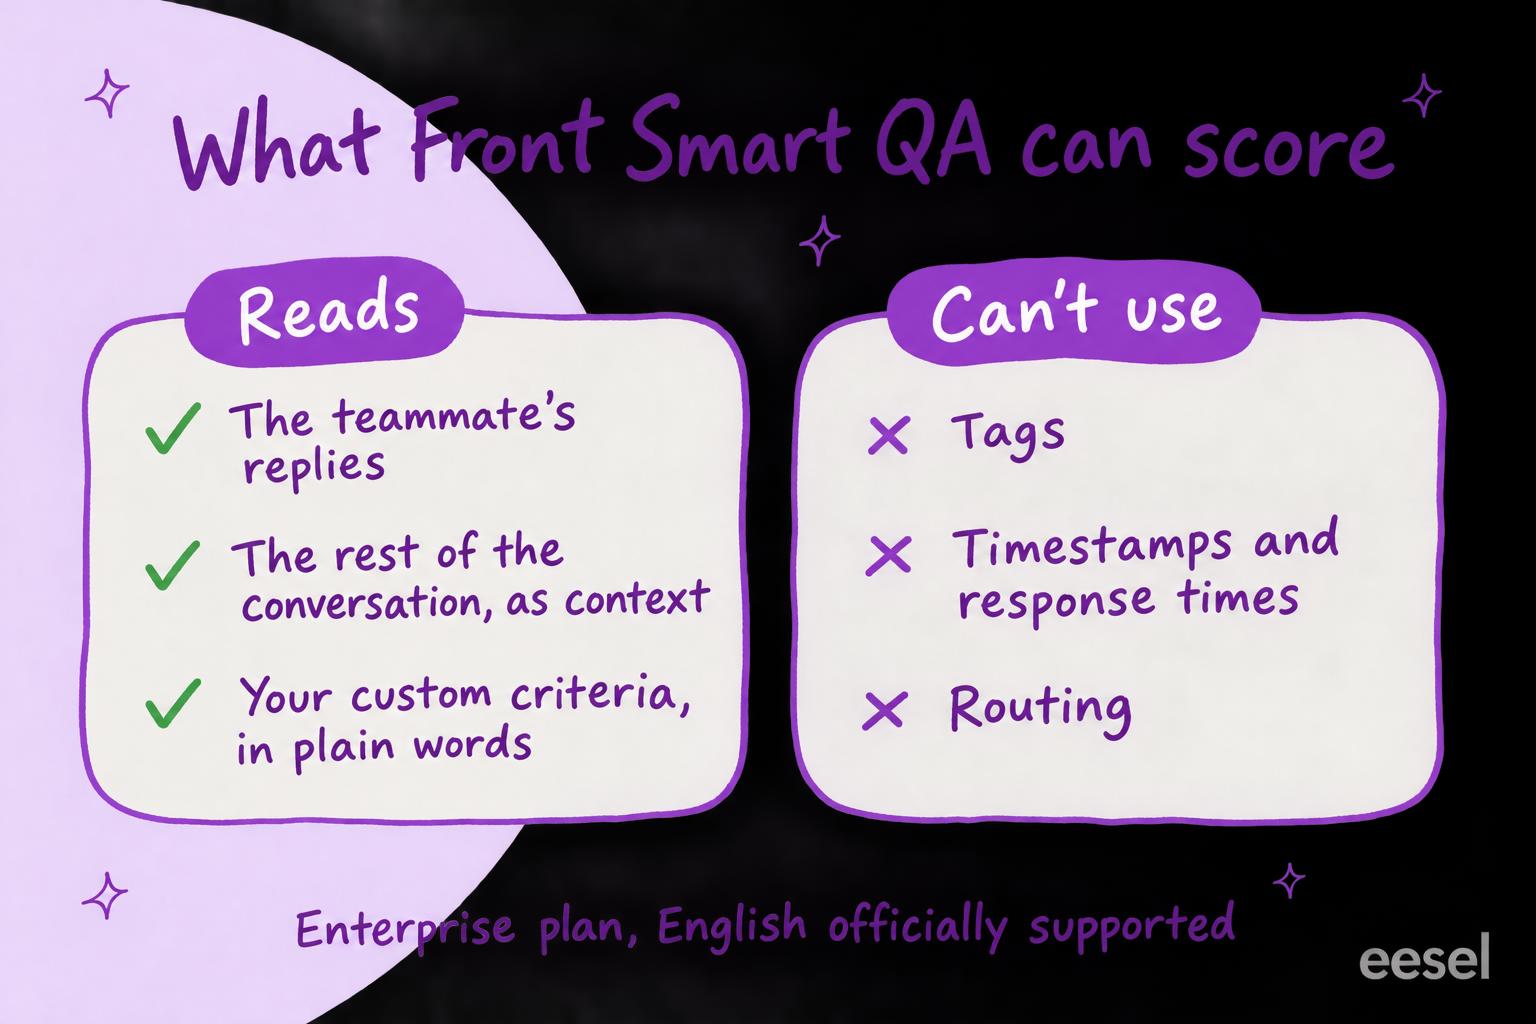
Ese es el criterio que la mayoría de los equipos quieren primero, y también muestra el límite. La descripción pregunta si la respuesta contradice "información disponible (por ejemplo, decir que un producto está en stock cuando no lo está, o citar una política incorrecta)". El artículo de Front dice qué evalúa un criterio: las respuestas del teammate revisado, con "todos los demás mensajes de la conversación como contexto". No incluye tu centro de ayuda, tus niveles de stock ni tus documentos de políticas como entradas. Así que una comprobación de políticas funciona cuando la regla está en el propio criterio ("los reembolsos después de 30 días necesitan la aprobación de un responsable") o en la conversación, y yo la probaría en algunas conversaciones cuya respuesta ya conozcas antes de confiar en ella.
¿Qué no puede ver Front Smart QA?
El registro alrededor de la conversación. El artículo de Front es explícito: "Conversation metadata such as tags, time between responses, and other information is not able to be used in the evaluation." Así que ningún criterio puede comprobar que una solicitud de reembolso recibió la etiqueta Refund, que una pregunta de facturación se movió a la bandeja Billing, o que una respuesta salió dentro de tu SLA. Si tu reporting se basa en etiquetas, una etiqueta equivocada es un fallo de QA que Smart QA no detectará. Las reglas de estado de ticket y las reglas de asignación de Front hay que comprobarlas de otra manera.
Los demás límites, del mismo artículo:
- Solo bandejas compartidas. Las bandejas personales no se revisan a menos que un admin las refleje en una compartida con una regla.
- Resueltas o archivadas, con una respuesta. Una conversación necesita al menos un mensaje entrante y uno saliente.
- No retroactivo. Una regla puntúa las conversaciones archivadas o resueltas después de haberse creado, así que el trimestre pasado queda sin puntuar.
- Inglés. "Only English is officially supported at this time"; otros idiomas pueden dar "unexpected results". control de calidad multilingüe explica las opciones.
- Las exclusiones se fijan en la regla. Se acota por bandeja, tipo de conversación y teammate; todo lo demás es una anulación manual posterior.
¿Cuánto cuesta la QA con IA de Front?
Smart QA viene con Enterprise. El centro de ayuda de Front dice que está "included with the latest Enterprise plan at no additional cost", y la página de precios lista "AI Copilot, QA, and CSAT included" bajo Enterprise. La palabra "latest" importa si tienes un contrato Enterprise antiguo: pregúntale a Front si el tuyo lo incluye. Precios comprobados el 21 de noviembre de 2026, facturados anualmente:
| Plan | Por puesto al mes | Límite de puestos | Qué añade para QA |
|---|---|---|---|
| Starter | 25 $ | Hasta 10 | Analítica básica, AI Topics |
| Professional | 65 $ | Hasta 50 | Analítica avanzada; Copilot es un complemento de 20 $ por puesto |
| Enterprise | 105 $ | Sin límite indicado | Smart QA, Smart CSAT y Copilot incluidos, informes personalizados |
Para un equipo de 10, Professional cuesta 650 $ al mes y Enterprise 1.050 $, así que Smart QA llega con un salto de 400 $ al mes. Si de todos modos comprarías Copilot (200 $ al mes para 10 puestos en Professional), la diferencia es de 200 $, que además te da Smart CSAT, enrutamiento y etiquetado con IA, y reglas ilimitadas. Para probarlo primero, la plantilla de regla tiene un botón Start free trial que inicia 30 días de Enterprise. El desglose de precios de Front de eesel tiene el resto, incluido el cargo de Autopilot.
¿Qué necesita un programa de QA que Smart QA te deja a ti?
La mayoría de los programas de QA comprueban tres cosas que Smart QA no puede alcanzar del todo: si la respuesta coincidió con una política que vive en un documento, si la conversación se etiquetó y enrutó como esperan tus informes, y cómo fue en conversaciones en otro idioma o en una bandeja personal. Elige qué quieres comprobar y mira qué lo cubre:
Elige qué comprobar para ver qué lo cubre en Front, y qué lo cubre si nada lo hace.
Hay dos formas de cubrir el resto.
Puntuar una muestra a mano
La vía más barata no necesita nada nuevo, y es donde empiezan la mayoría de las guías de QA de soporte con IA. Cada semana, un responsable filtra las conversaciones archivadas de la semana anterior en una bandeja, lee diez o veinte (las puntuaciones de Smart QA más bajas primero, si las tienes), y comprueba cada una según una rúbrica breve en una hoja de cálculo: respuesta correcta según la política, etiqueta correcta, bandeja correcta. Acuerda primero qué significa cada puntuación para que dos revisores puntúen la misma conversación igual: la calibración de QA ayuda, y también estos ejemplos de feedback de QA.
El límite es el obvio: una persona lee una muestra, y los resultados viven fuera de Front.
Que un teammate de IA revise según tus reglas
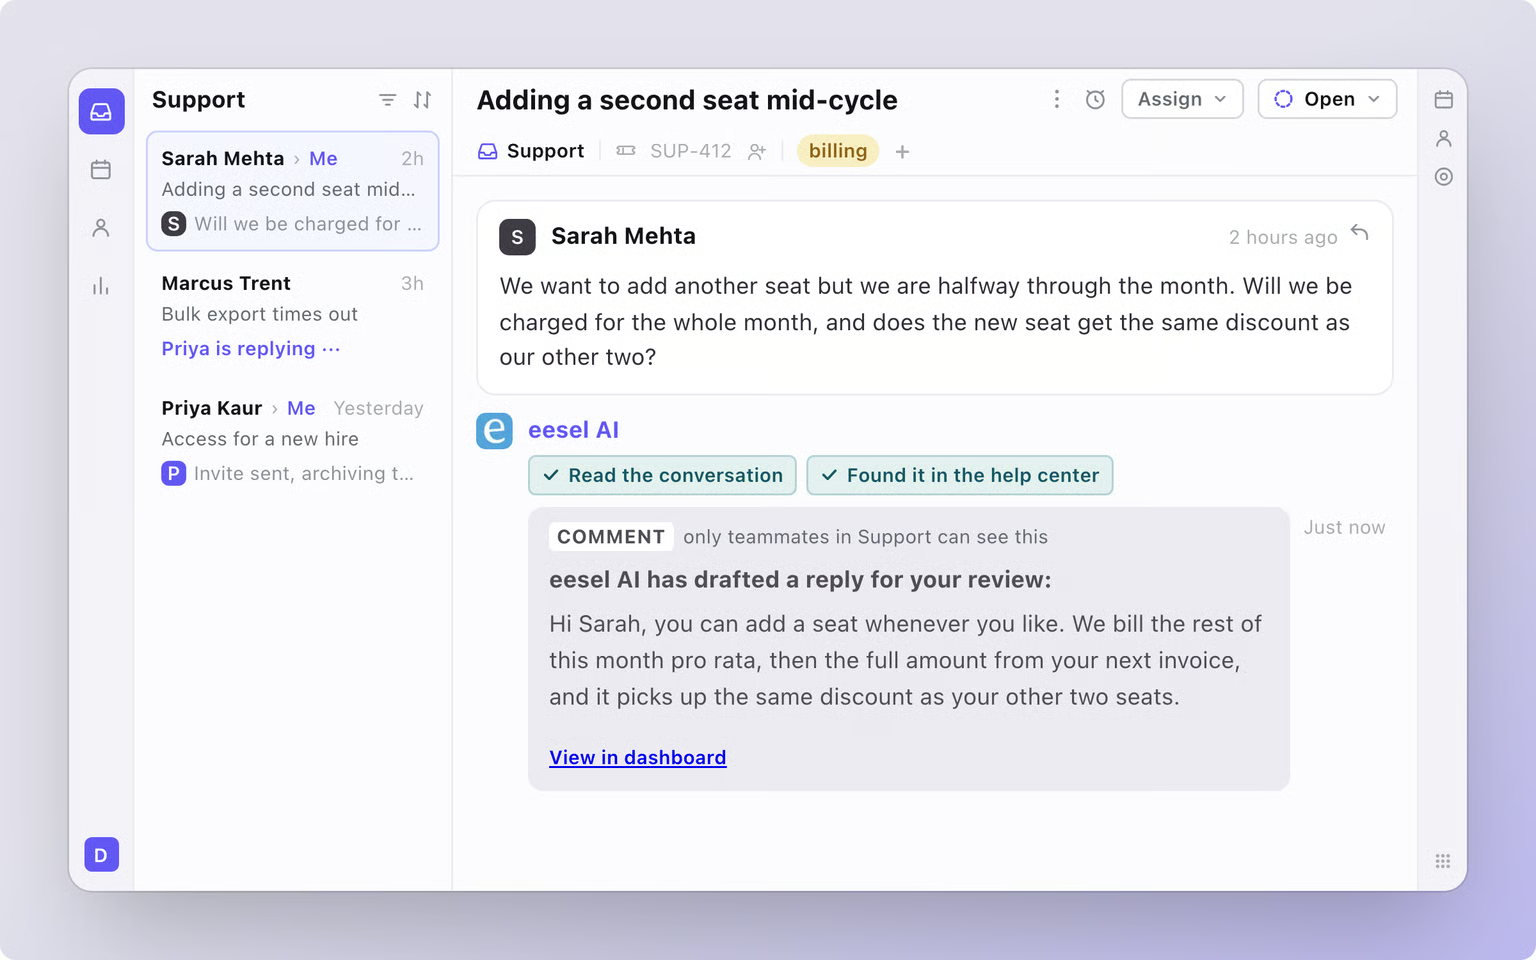
La segunda vía es un agente de IA que hace la revisión por su cuenta y deja el resultado en Front. Esto es lo que yo haría con eesel. La integración de Front de eesel puede iniciar una ejecución cuando se archiva una conversación, y la ejecución ya tiene las etiquetas, el responsable asignado, los campos personalizados, la bandeja y el hilo de la conversación, comentarios internos incluidos (en una conversación muy larga, la página más reciente de mensajes). Aprende de tu centro de ayuda de Front con antelación, así que una política que has publicado es algo que ya ha leído.
Configura una automatización en ese disparador y, para cada conversación archivada:
- Lee el hilo con sus etiquetas y su bandeja.
- Lo comprueba según las reglas que escribiste con palabras sencillas ("los reembolsos después de 30 días necesitan la aprobación de un responsable", "las preguntas de facturación reciben la etiqueta Billing", "nunca prometer una fecha de envío").
- Deja su veredicto y sus razones como un comentario interno en la conversación.
- Añade una etiqueta que hayas creado en Front, como qa-review, a las que un responsable debería leer, para que una vista o un filtro de analítica las encuentre.
Tú escribes las reglas, así que el etiquetado, el enrutamiento y la política son solo más líneas, que cambian cada vez que cambian tus políticas. Una cosa que hay que saber primero: eesel solo añade etiquetas que ya existen en Front, una a la vez, así que alguien debe crear la etiqueta de revisión antes de empezar. El mismo agente de eesel también puede triajar el correo nuevo y redactar respuestas como comentarios internos, si quieres que lo haga.
Comprobaciones diarias como esta ya se ejecutan para los clientes de eesel. Cactus Club Cafe ejecuta un segundo agente de eesel en su helpdesk de Zendesk que audita cada mañana la extracción financiera diaria: comprueba cada tienda y resuelve el ticket como equilibrado, o lo deja abierto nombrando el desajuste. Entre el 8 de agosto y el 8 de septiembre de 2026 se ejecutó unas 60 veces. Una revisión de QA tiene la misma forma: una comprobación contra reglas escritas, con el resultado dejado en la conversación.
¿Es suficiente Front Smart QA?
Hay que reconocer lo que corresponde: Smart QA cubre mucho. Criterios personalizados con palabras sencillas, una opción de aprobado y reprobado, fragmentos citados, anulaciones manuales que alimentan el informe, y agentes de IA puntuados en la misma tarjeta que las personas. El propio ejemplo de Front, Solution accuracy, muestra que sabe lo que los equipos quieren de la QA más allá del tono.
Mi opinión: en Enterprise, actívalo, empieza con cinco o seis criterios (Solution offered, Comprehension, Tone, y un criterio personalizado que escriba por completo tu política más incumplida), y usa las puntuaciones más bajas como tu lista de lectura. Reajusta la base desde el 20 de noviembre. No lo trates como el programa completo: un agente puede puntuar bien en todos los criterios mientras etiqueta mal la conversación, y Smart QA nunca lo sabrá. Si estás en Professional, Enterprise es un salto de 400 $ al mes para 10 puestos en el que la QA es solo una de varias cosas que añade, y un revisor que comprueba tus reglas y tus etiquetas en cada conversación cubre más de lo que una scorecard busca. eesel tiene el mismo desglose para Help Scout y puntuación de QA de HubSpot, y su resumen de herramientas de QA de soporte también cubre los puntuadores dedicados.
Prueba eesel junto a Front
Conserva Smart QA para lo que hace bien. Lo que eesel puede hacer depende de quién pregunte, y tú eliges qué acciones se ejecutan por sí solas, cuáles preguntan antes y cuáles se mantienen desactivadas; para una ejecución de revisión, deja que los comentarios y las etiquetas se ejecuten por sí solos y mantén las respuestas desactivadas. Deja que lea tus conversaciones archivadas de Front según el resto de tu rúbrica (tus políticas publicadas, tus etiquetas y bandejas), escrita con palabras sencillas y cambiada cada vez que cambian tus políticas. Deja sus razones en un comentario interno y etiqueta las conversaciones que un responsable debería leer.
Prueba eesel en tu bandeja de Front, empezando por las conversaciones archivadas de ayer.