

La evaluación de agentes de IA de Front es una herramienta llamada Compass, y la parte que ejecutas antes del lanzamiento es su pestaña Simulations, que solo funciona para agentes Autopilot. Una simulación reproduce una conversación real contra criterios que tú escribes, no envía nada a los clientes y limita cada ejecución a 10 intercambios. Tras el lanzamiento, Compass puntúa las respuestas en vivo con Smart QA y Smart CSAT. Revisa el comportamiento que describiste, no si una respuesta coincide con tu centro de ayuda, así que lee también las transcripciones. Compass no tiene costo extra, mientras que Autopilot empieza en 0,05 $ por conversación.
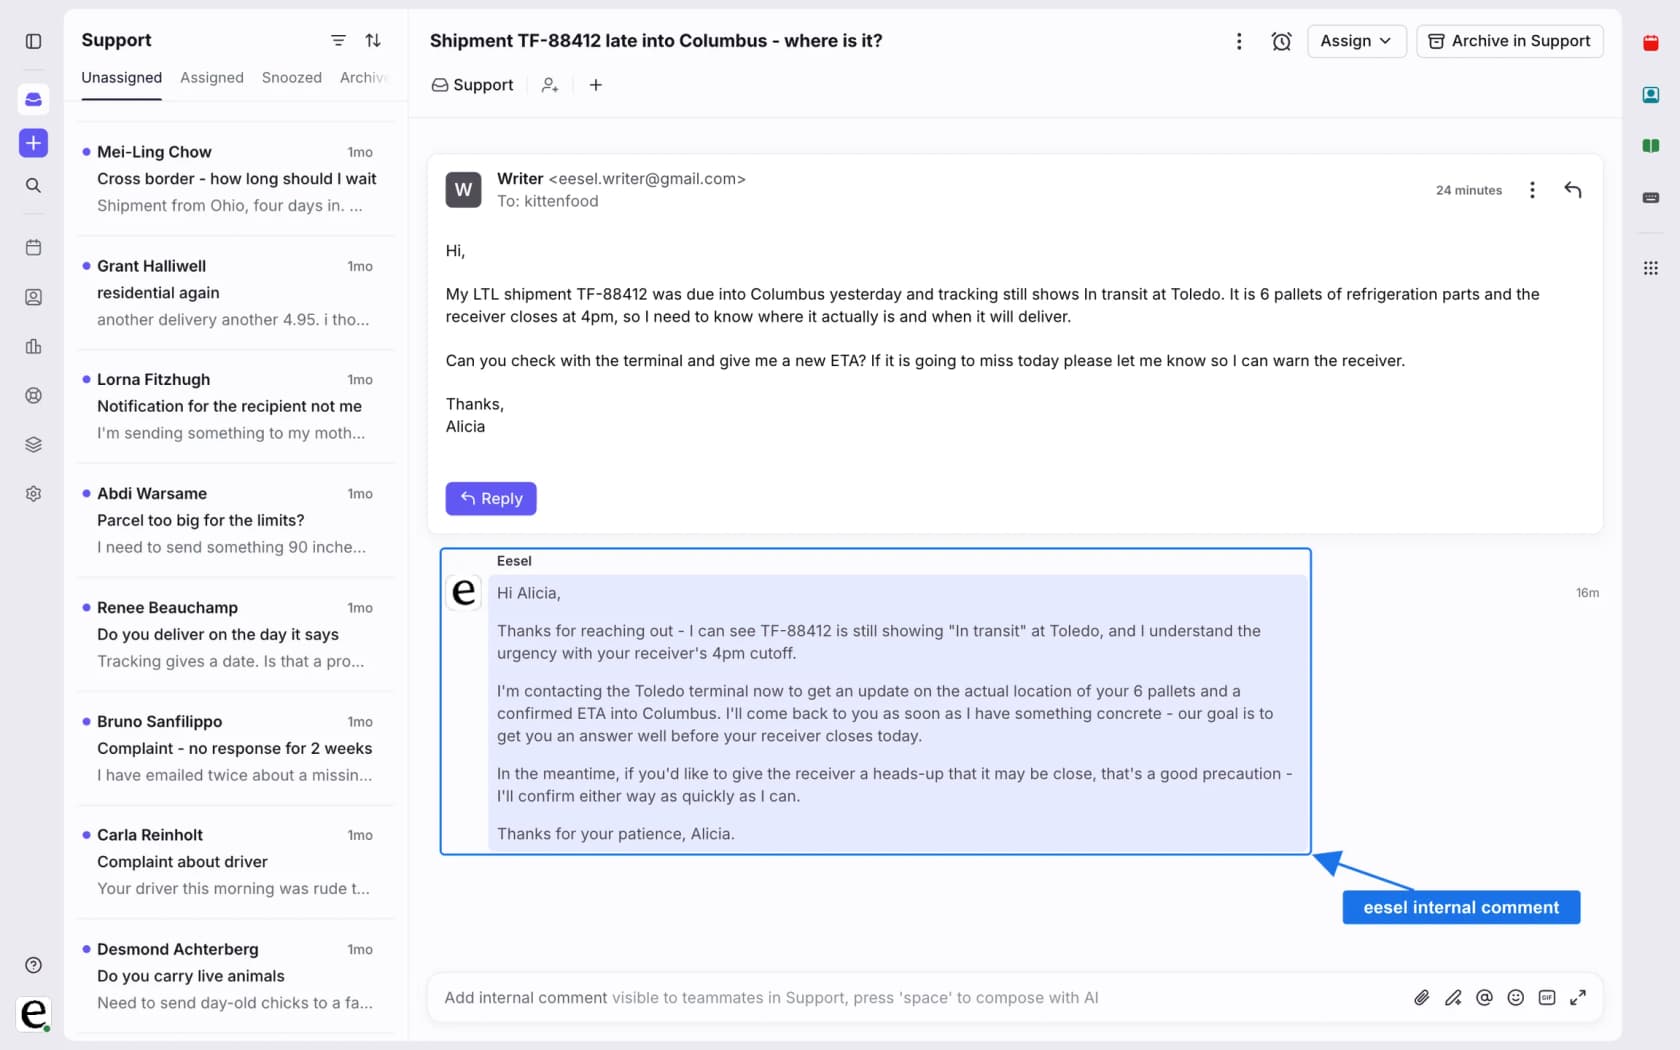
eesel trabaja dentro de Front como un compañero de IA de helpdesk que redacta como comentarios internos, y cada lanzamiento se simula primero contra las propias conversaciones pasadas del equipo. Con la eesel CLI, un agente de IA de código puede subir conocimiento aprobado, como artículos de ayuda de Front exportados y respuestas guardadas, luego hacer preguntas de prueba y revisar las respuestas antes de que nada salga en vivo. Conectar la bandeja de Front en sí sigue necesitando la aprobación de un admin.
¿Qué es la evaluación de agentes de IA de Front, y dónde vive?
Es Compass, y está en la página propia del agente dentro de la configuración de la empresa. El artículo de Compass de Front dice que ayuda a los admins a probar agentes de IA, medir la calidad de las conversaciones, seguir señales de rendimiento y obtener recomendaciones. Necesitas permisos de admin de empresa y un agente existente. Tres pestañas hacen el trabajo: Simulations para probar antes del despliegue, Performance para vigilar la salud y Replies para leer cada mensaje de IA.
El nombre tardó unos meses en asentarse, así que las búsquedas de "scorecards" o "informes de evaluación" no llevan a nada en la documentación de Front. En agosto, un gestor de la comunidad de Front pidió socios de diseño para un conjunto de herramientas que "puntúe cada interacción de IA, diagnostique qué salió mal y valide los cambios antes del lanzamiento". El 6 de octubre, Front presentó Compass en sus actualizaciones de producto, y el resumen del 26 de octubre lista la evaluación de agentes y las pruebas de agentes como dos líneas separadas.
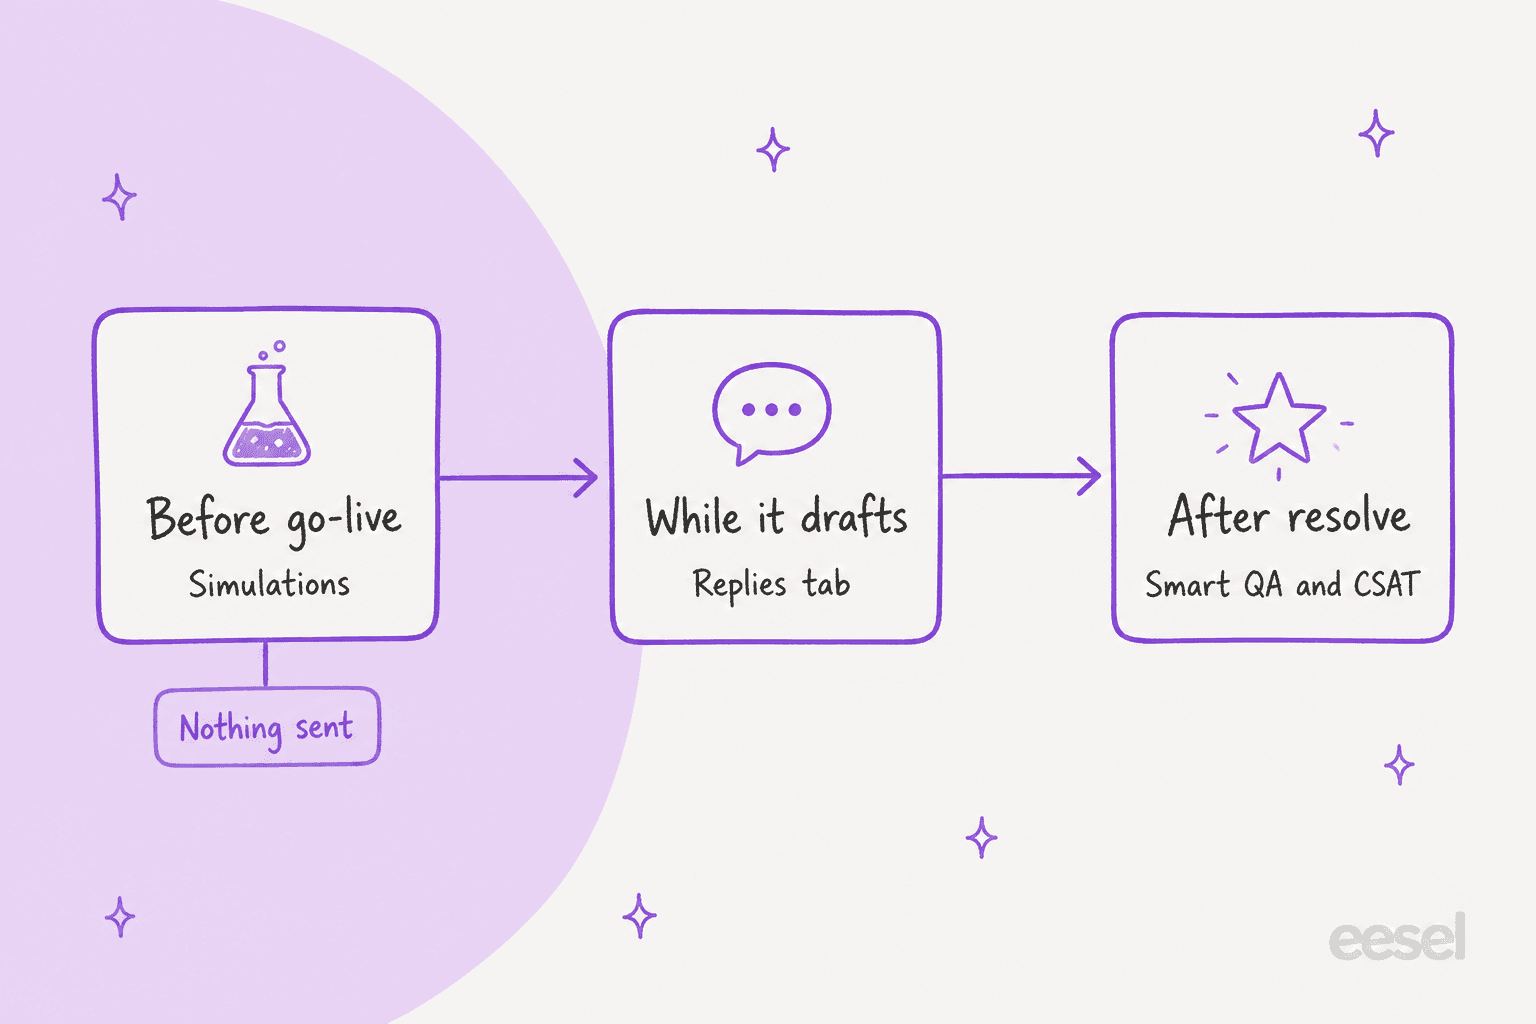
Yo leo la evaluación en tres capas, y la imagen de arriba es como se lo explicaría a un líder de soporte. Antes del lanzamiento ejecutas simulaciones, mientras el agente redacta lees la pestaña Replies, y después de que una conversación se resuelve, Smart QA y Smart CSAT la puntúan. Cada capa responde una pregunta distinta, lo cual importa para el widget más abajo.
¿Qué planes y complementos de Front necesita?
Compass en sí es gratis, pero lo que evalúa normalmente no lo es. La publicación de lanzamiento de Front dice que los agentes externos están disponibles en todos los planes, Autopilot es un complemento según el uso en todos los planes, y Compass funciona para ambos sin cargo adicional. Usar Compass con Autopilot necesita el complemento de Autopilot.
| Pieza | Lo que dice Front | Fuente |
|---|---|---|
| Agentes externos (Claude, Codex, Sierra y otros) | Disponibles en todos los planes | publicación de lanzamiento de Front |
| Agentes Autopilot | Complemento según el uso en todos los planes, desde 0,05 $ por conversación | precios de Front |
| Compass (Simulations, Performance, Replies) | Sin cargo adicional, el complemento de Autopilot es necesario para agentes Autopilot | artículo de Compass |
| Smart QA y Smart CSAT | Incluidos en el último plan Enterprise sin costo extra | artículo de Smart QA |
| Puesto Enterprise | 105 $ por puesto al mes, facturado anualmente | precios de Front |
El artículo de Smart QA añade una prueba Enterprise de 30 días para equipos en otros planes, iniciada desde la plantilla de reglas. Lo que la documentación no dice es si un cliente Professional que añade Autopilot recibe puntuaciones de Smart QA sobre las respuestas de la IA. El artículo de Compass dice que Smart QA se activa automáticamente para agentes de IA, y el artículo de Smart QA dice que es una función Enterprise, así que pregúntale a Front antes de presupuestar en torno a ello. Mi publicación de precios de Front tiene las cifras por puesto, y Front AI cubre la línea de producto más amplia.
¿Cómo funcionan las simulaciones de Front?
Construyes un set de conversaciones de prueba, le das criterios a cada una y las ejecutas. Un set es un grupo con nombre de simulaciones relacionadas que vuelves a ejecutar como línea base después de cada cambio, según el artículo de Compass. Los pasos:
- Abre el agente, selecciona Simulations y haz clic en Create set. Nómbralo y, opcionalmente, elige un scorecard de Smart QA.
- Haz clic en Create simulation. Elige una conversación reciente abierta de las bandejas seleccionadas, o introduce un ID de conversación o de ticket.
- Añade criterios de simulación y luego haz clic en Create and run.
- Para muchas conversaciones a la vez, pega IDs separados por comas. Cada una se vuelve su propia simulación, y Run set las ejecuta todas.
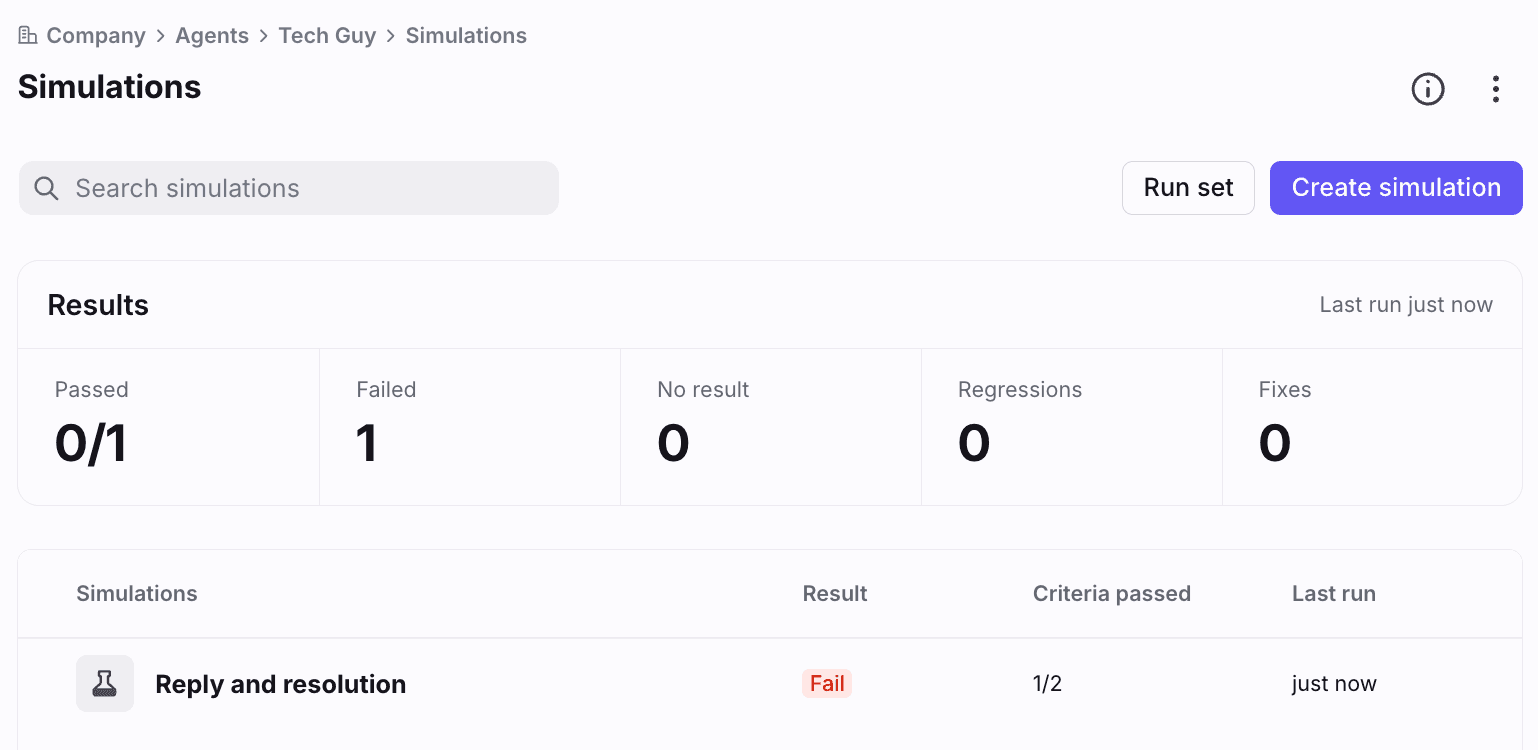
El panel de resultados de arriba cuenta aprobadas, fallidas, sin resultado, regresiones y correcciones. El artículo de ayuda de Front dice que cada conversación se ejecuta contra el agente con un cliente simulado, limitada a 10 intercambios, y las ejecuciones son ilimitadas. Nada llega a un cliente real, ninguna conversación en vivo cambia, y las analíticas se mantienen limpias.
Los criterios son donde está el trabajo. Escribes un nombre y una descripción del comportamiento esperado, haces clic en Generate scale para obtener condiciones de aprobado y fallido, y un validador marca cualquier cosa vaga, agrupada o no verificable hasta que diga "Good definition". Front sugiere tres iniciales: el agente nunca afirma haber hecho una acción que no hizo, escala cuando debería, y no escala cuando no debería. Esos son los mismos tres fallos que pondría en el primer set de pruebas de cualquier agente de soporte.
¿Qué puede ver una simulación de Front, y qué no puede?
Este es el límite que más importa. Una simulación juzga el comportamiento a partir de evidencia visible, y el artículo de Compass lista qué es esa evidencia. El validador puede ver mensajes enviados, notas internas, etiquetas, movimientos de bandeja, asignación, estado del ticket, llamadas a conectores y cómo terminó la conversación. No puede ver el contenido ni el orden de un Playbook, el cuerpo de un artículo de conocimiento, campos personalizados, registros de contacto, borradores o archivos adjuntos.
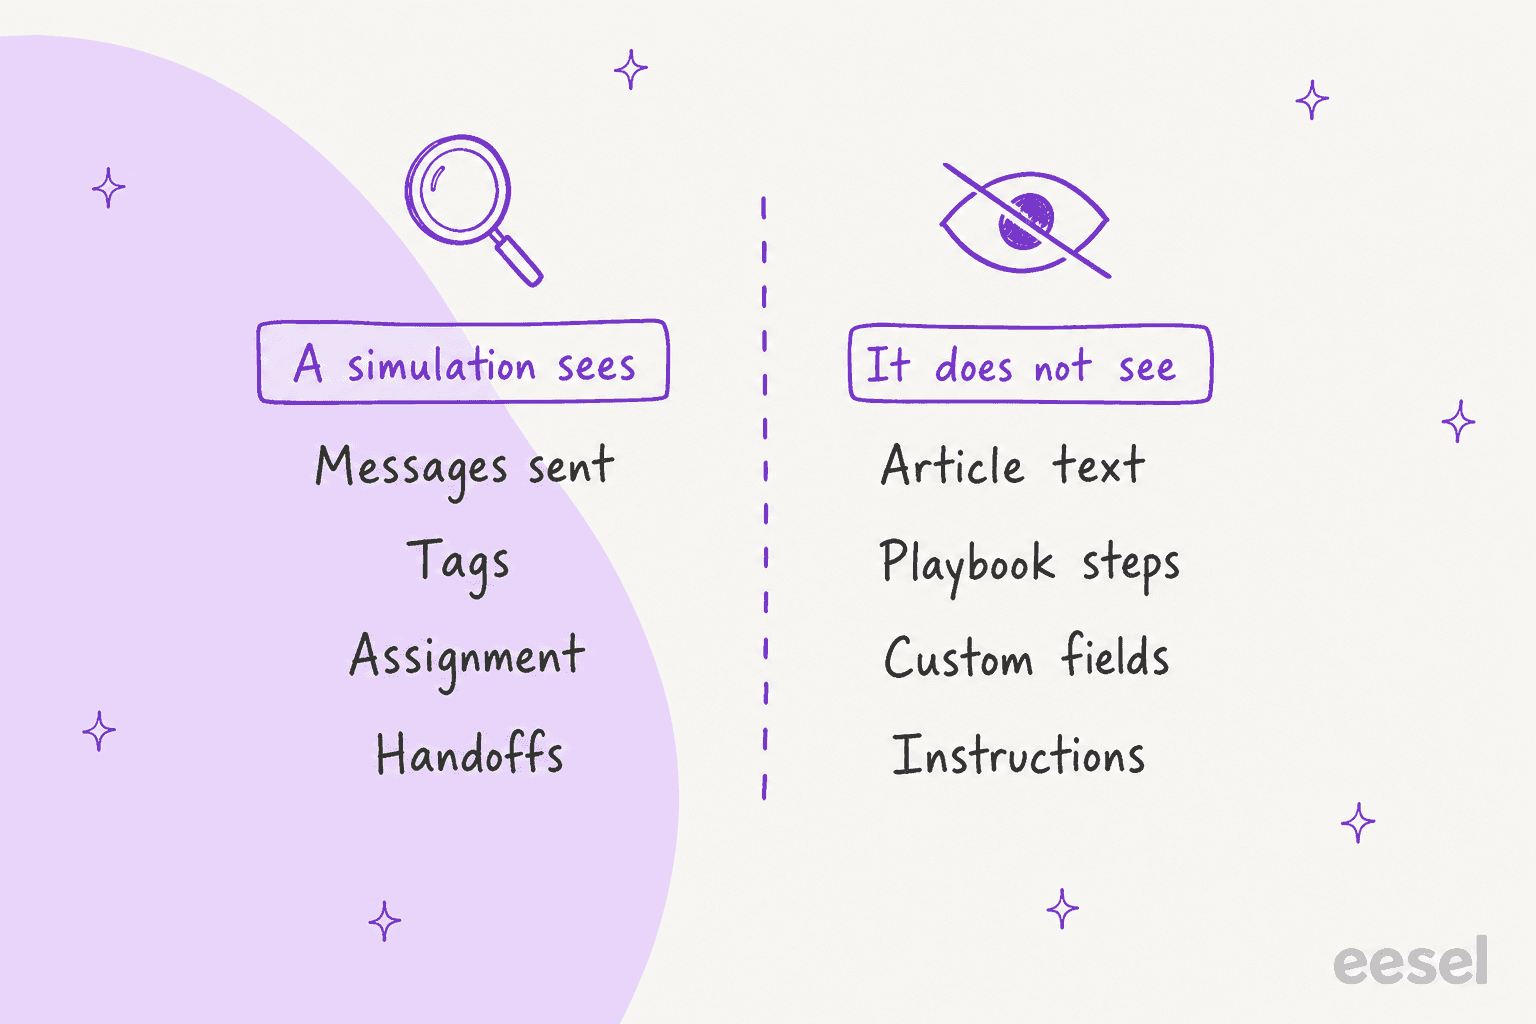
Las instrucciones del agente, las pautas y la configuración de tono también están ocultas, salvo que el agente las referencie sin decirlas explícitamente. Las preguntas frecuentes de Front dicen claramente que los criterios no pueden verificar respuestas frente a fuentes de conocimiento o Playbooks, así que su consejo es escribir criterios basados en comportamiento y leer la transcripción para la precisión. Una simulación aprobada demuestra que el agente actuó como lo describiste, no que su respuesta fuera correcta. El artículo lista el tono y el formato como el trabajo del scorecard de Smart QA y dice que los mantengas fuera de los criterios.
Para una pregunta de reembolso, eso significa que "escala a una persona cuando el cliente pide que le devuelvan el dinero" es un buen criterio, y "cita la ventana correcta de 30 días" no es comprobable, porque el texto del artículo es invisible para el validador. El segundo lo detectarías leyendo la transcripción, y mi guía sobre adversarial testing y las entradas del glosario sobre AI hallucination y AI grounding cubren por qué importa esa lectura.
¿Cómo se lee el resultado de una simulación?
Abres una simulación y obtienes la transcripción, los criterios y un veredicto. El artículo de Front dice que la vista de detalle muestra una vista previa de la conversación y resultados, con historial de ejecuciones y reejecuciones en el menú de tres puntos, e indicadores de flecha que comparan la ejecución actual con ejecuciones anteriores para mostrar progreso o retrocesos.
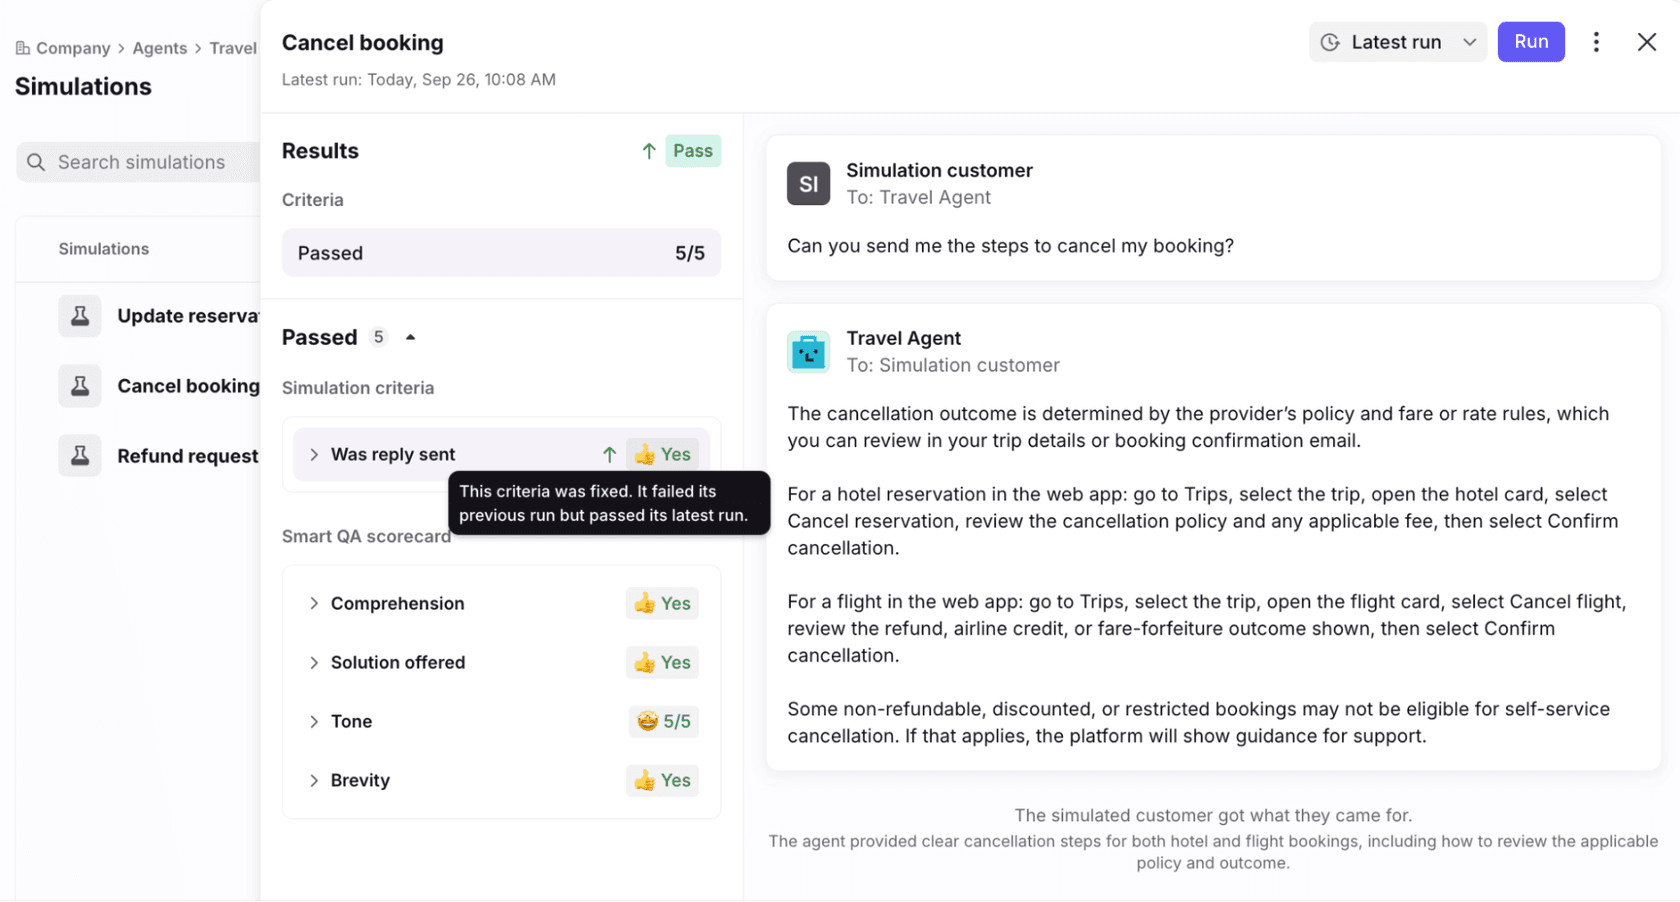
En la captura, un criterio que falló la última ejecución y aprobó esta lleva un tooltip que dice que se corrigió, y el scorecard de Smart QA va adjunto debajo. Ese es el ciclo para el que Front está diseñando: cambiar las instrucciones o el conocimiento, volver a ejecutar el mismo set y vigilar tanto retrocesos como correcciones. Smart QA solo evalúa respuestas, así que si el agente correctamente permanece en silencio y escala, el scorecard no aplica, pero tus criterios sí.
¿Qué mide Compass una vez que el agente está en vivo?
Compass califica cada respuesta como Sin señal, Buena, Aceptable o Mala, construida a partir de cinco señales. El artículo de Compass las nombra:
- Smart CSAT. Se ejecuta automáticamente sobre respuestas de IA en conversaciones resueltas e infiere la satisfacción. Los compañeros humanos no son evaluados por esta vía.
- Smart QA. Se ejecuta 24 horas después de la resolución sobre respuestas de IA, con un scorecard por defecto de Brevedad, Tono, Solución ofrecida y Comprensión.
- Nivel de edición del borrador. Detecta si un borrador de IA se envió tal cual, ligeramente editado, muy editado o descartado.
- Feedback de compañeros. Pulgar arriba o abajo en borradores y respuestas, con detalles opcionales que solo los admins pueden ver.
- Feedback inferido. La IA de Front infiere una señal a partir de correcciones o ediciones fuertes.
La pestaña Performance reúne todo esto con métricas de resolución y participación y una lista llamada Opportunities. Front dice que ayuda a juzgar si un agente está lo bastante sano para ampliar su cobertura o pasar de borradores a respuestas automáticas, y qué arreglar primero.
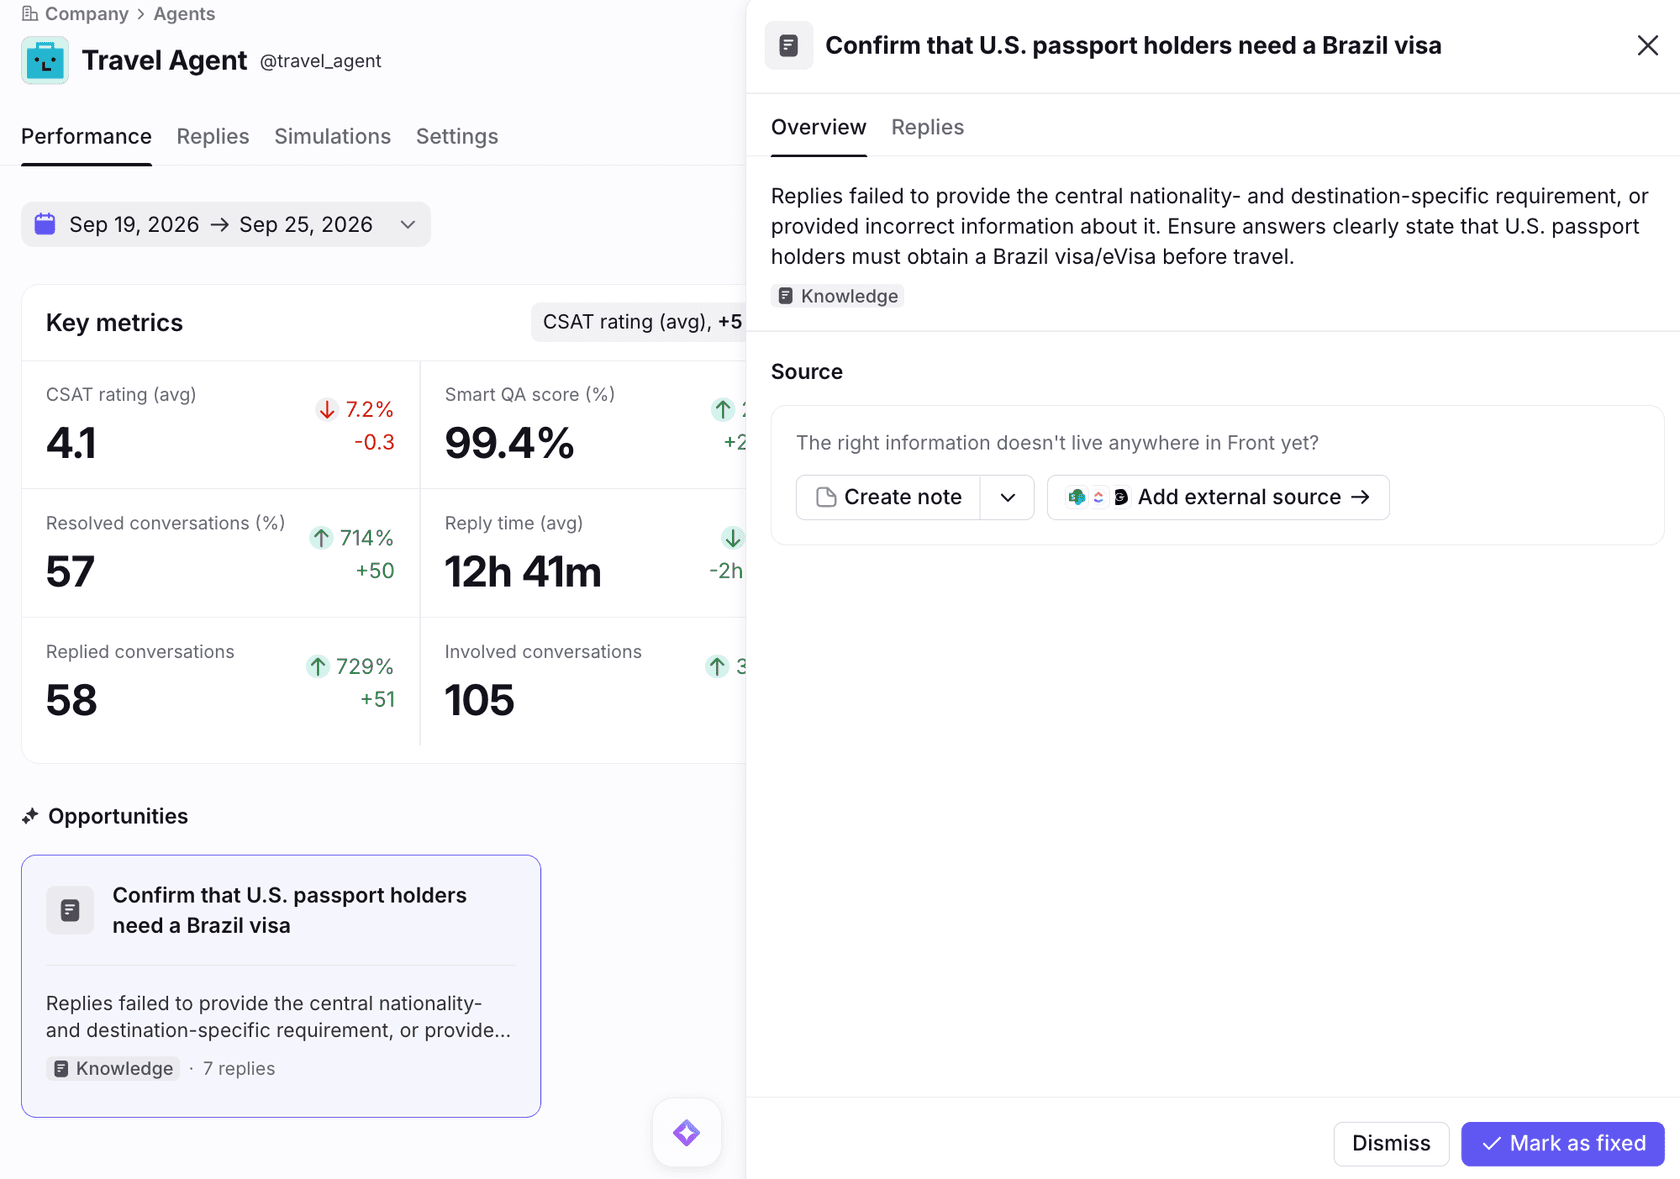
Una Opportunity muestra un resumen, un tipo de brecha y a cuántas respuestas afecta, y la corrección sugerida suele señalar al conocimiento o a las instrucciones del agente. En el ejemplo de Front, las respuestas sobre un requisito de visa para Brasil eran incorrectas, y el panel ofrece crear una nota o añadir una fuente externa. La pestaña Replies lista cada borrador y respuesta automática con filtros por bandeja, tipo de respuesta, tema y señal, y muestra las fuentes detrás de cada una. Si te apoyas en CSAT como tu número principal, recuerda que aquí es inferido, y mi publicación de AI CSAT cubre cuánto confiar en eso.
Los artículos de Smart QA y Smart CSAT de Front fijan los límites. Solo cuentan las conversaciones de bandeja compartida, cada una necesita al menos un mensaje entrante y uno saliente, y la conversación debe estar Resolved o Archived. El inglés es el único idioma con soporte oficial. Las reglas no son retroactivas, así que el historial anterior a la existencia de una regla no se puntúa. Front reporta alrededor de un 99% de precisión en contenido factual para Smart QA y alrededor de un 90% de alineación con el CSAT del cliente para Smart CSAT, que son cifras propias de Front.
¿La evaluación funciona para agentes externos como Claude o Sierra?
En parte. La publicación de lanzamiento de Front dice que Compass evalúa cada conversación manejada por agentes en Autopilot o en otro proveedor, y Compass es gratis para ambos. El artículo de Compass dice que la prueba de agentes, la pestaña Simulations, es solo para agentes Autopilot, y para agentes externos las fuentes de la pestaña Replies son el conocimiento pasado a través del MCP. Así que un agente externo recibe puntuación en vivo, pero lo pruebas con tu propio sistema antes de conectarlo. La publicación de lanzamiento de Front cita a un cliente, Next Level Sports, diciendo que Compass le da a sus equipos de soporte e ingeniería un solo lugar para revisar las respuestas de IA y medir la calidad.
¿Qué herramienta de Front responde a qué pregunta?
Elige la pregunta que intentas responder y la herramienta cambia. Este widget es mi propio resumen de los artículos de Front, así que la última línea de cada panel es donde leer el detalle.
Rule testing es la pieza fuera de lugar, por eso la incluyo. El artículo de rule testing de Front comprueba si una conversación pasa las condiciones y acciones de una regla, en cualquier plan, con la opción de construir una conversación simulada desde cero. Vale la pena ejecutarla sobre la regla que asigna conversaciones a tu agente, como explica mi publicación de Front load balancing para los límites de asignación.
¿Cómo implementaría un agente de IA de Front con estas herramientas?
Empieza con borradores, prueba en sets, y amplía solo cuando las señales coincidan. El artículo de agentes Autopilot de Front describe un agente de redacción que crea borradores en conversaciones nuevas, configurado con instrucciones solo de redacción y una regla construida a partir de la plantilla Assign to AI agent. A partir de ahí:
- Construye un set de 15 a 20 conversaciones. Mezcla preguntas sencillas, solicitudes de reembolso, clientes enfadados y cosas que el agente debería rechazar. Front dice que una muestra variada da una cobertura más amplia, y yo tomaría muestras del último mes de tráfico real.
- Añade los tres criterios iniciales. Nunca afirma haber hecho una acción que no hizo, escala cuando debería, no escala cuando no debería.
- Ejecuta, lee cada transcripción, arregla, vuelve a ejecutar. Observa las flechas de regresión después de cada cambio en las instrucciones o el conocimiento.
- Pásalo a vivo como agente de redacción. Revisa la pestaña Replies para ver el nivel de edición del borrador y los pulgares de los compañeros, no solo la puntuación media.
- Pasa temas a respuestas automáticas de uno en uno. Usa la pestaña Performance y la lista Opportunities para decidir, y mantén las reglas y los objetivos de tiempo como tu marcador. Mis publicaciones de Front time goal rules y SLA best practices cubren ese lado.
El comportamiento de traspaso merece sus propios criterios. Si el agente escala, la conversación necesita llegar a la persona correcta con contexto, lo cual mis publicaciones AI agent handoff best practices y AI escalation explican. El glosario tiene entradas sobre escalation rate y AI guardrails.
¿Qué no dice la documentación de Front sobre evaluar agentes de IA?
Bastante, y cada vacío es algo que yo le preguntaría a Front o probaría antes de confiar en ello.
- Restricción de plan para Smart QA en respuestas de IA. Incluido en Enterprise según un artículo, activado automáticamente según otro, y ninguna página lo reconcilia para un cliente Professional con Autopilot.
- Si las simulaciones llaman a sistemas en vivo. El validador puede ver llamadas a conectores, pero la documentación no dice si una ejecución simulada golpea herramientas reales o aisladas.
- Un umbral de aprobación. No hay una tasa de aprobación o tamaño de set sugerido más allá de "usar una muestra variada".
- Comparación con lo que envió tu equipo. Los criterios describen comportamiento. El artículo no describe puntuar contra la respuesta que una persona realmente escribió en esa conversación.
- Idiomas en Compass. El artículo de Compass guarda silencio. Los artículos de Smart QA y Smart CSAT dicen que solo el inglés tiene soporte oficial.
- Exportación o acceso por API. No encontré mención de exportar resultados de simulación ni de ejecutar sets por la API.
- Voces externas. La publicación de Compass de Front en la comunidad tenía 0 respuestas y 122 vistas cuando la leí, así que todavía no tengo una revisión de un profesional para citar.
Nada de eso convierte a Compass en una herramienta débil. Un simulador basado en criterios con un validador, historial de ejecuciones y flechas de regresión es un sistema de pruebas real. Es un diseño distinto a reproducir el historial, que es la comparación que más me interesa a continuación.
¿Cómo prueba eesel un agente de IA antes de que responda a clientes de Front?
eesel prueba contra tus propias conversaciones pasadas, y Front prueba contra criterios que tú escribes. Las dos son complementarias, y no elegiría una solo por eso. La simulación de eesel reproduce tickets pasados con el envío apagado, redacta una respuesta para cada uno, la compara con lo que tu equipo realmente envió, agrupa los resultados por tema y clasifica las correcciones por impacto. El informe separa coincidencias, coincidencias parciales, traspasos correctos y fallos claros. El propio ejemplo de la documentación de eesel son 20 tickets resueltos, de los cuales 17 coinciden con la calidad de respuesta del equipo.
| Simulaciones de Front Compass | Simulación de eesel | |
|---|---|---|
| Qué prueba | Comportamiento contra criterios que tú escribes | Respuestas contra lo que tu equipo realmente envió |
| Entrada de prueba | IDs de conversación de tus bandejas | Tickets pasados, o casos generados sin un helpdesk |
| Lado del cliente | Cliente simulado, máximo 10 intercambios | Una respuesta redactada por ticket pasado |
| Se aplica a | Solo agentes Autopilot | El agente de eesel |
| Envía a clientes | No | No |
| Después de una ejecución | Volver a ejecutar el set, leer las flechas | Correcciones guardadas como reglas en frases simples, luego volver a ejecutar |
El cliente simulado de múltiples turnos de Front es lo que el replay de eesel no replica, y la propia página de simulación de eesel dice que los chats de múltiples turnos con personas interpretadas por IA se sirven mejor con el propio simulador de un helpdesk. Al revés, el artículo de Front no describe comprobar una respuesta contra una respuesta de referencia, que es donde ayuda reproducir el historial.
La parte ganada, para mí, es el orden del lanzamiento. eesel lleva años ejecutando IA en colas de soporte en vivo, y el hábito que se quedó es que nada responde a un cliente antes de reproducirse contra el propio historial de ese equipo y luego redactar en tickets en vivo durante una o dos semanas. Norden-Frisia, una naviera alemana, usó una semana de prueba con los últimos tres meses de tickets y macros antes de suscribirse. Textla empezó con una prueba en la que eesel solo dejaba notas internas para que el equipo pudiera ver qué habría dicho, y Innr todavía revisa cada borrador y trabaja hacia respuestas autónomas para un conjunto elegido de temas. Ninguno de los tres usa Front, así que léelo como el mismo método en otros helpdesks.
En Front, los documentos de integración de eesel listan disparadores para un mensaje de cliente, un primer mensaje, una mención a @eesel y una conversación archivada, con acciones para responder, dejar un comentario interno, etiquetar, asignar, actualizar campos y archivar. La documentación recomienda empezar con comentarios internos y no describe una simulación específica de Front, así que yo ejecutaría la reproducción en un lote pequeño y leería el informe. La CLI ayuda en ese ciclo. eesel files upload ./refund-policy.pdf añade conocimiento aprobado, eesel chat "what's our refund policy?" prueba una respuesta, eesel approvals lista acciones retenidas, y --dry-run muestra una vista previa de una escritura. La documentación de la CLI no menciona simulaciones, así que esas ejecuciones ocurren en el dashboard.
Prueba eesel en tu bandeja de Front
Si quieres la versión de este proceso centrada en el replay primero, eesel se une a tu bandeja compartida de Front como un compañero de IA de helpdesk. Lee tu centro de ayuda y conversaciones pasadas, redacta respuestas como comentarios internos, y puede etiquetar y asignar, así que tu equipo revisa borradores reales antes de que algo se envíe. Ejecuta la simulación sobre tu propio historial, mantén tus reglas y objetivos de tiempo como marcador, y amplía a respuestas directas una vez que los borradores coincidan con lo que escribiría una persona. Los planes de pago empiezan en 299 $ al mes por 500 créditos, y hay un plan gratis con 100 créditos para probarlo en unas cuantas conversaciones reales (precios de eesel).
Para la configuración, ve mi guía sobre adding AI to Front, la comparativa best AI for Front y Front vs eesel. Para comparar herramientas, ve mi Front review y Front alternatives. Para el resto de la configuración de Front, Front ticket status rules, Front shared inbox ownership y Front required resolution fields muestran dónde cae el trabajo de un agente, y el glosario explica shared inbox, support quality assurance y resolution rate. Try eesel en unas cuantas conversaciones reales antes de decidir.