

Cinco tickets revisados por agente al mes dan una puntuación de calidad que puede desviarse unos 31 puntos, así que la solución no es una hoja de cálculo mejor, sino puntuar todos los tickets con IA y tratar el resultado como una señal que revisa una persona. Zendesk, Gorgias, Front, HubSpot y Freshdesk ofrecen cada uno alguna versión de esto, y cubren porciones muy distintas de un ticket (Gorgias puntúa 3 criterios con IA, HubSpot puntúa 3, Zendesk te deja escribir los tuyos).
Lo que la mayoría de las guías pasa por alto: cuando un agente de IA se lleva los tickets repetitivos, los que quedan para tus humanos son más difíciles, así que sube el tiempo de gestión, baja el volumen por agente y una scorecard diseñada antes de la IA penalizará a tus mejores personas. En Question Beauty, eesel cerró por sí solo unos 280 de 990 tickets de Gorgias en un mes y asignó unos 250 a una persona con una nota, de modo que la cola humana es un trabajo distinto del que se pensó al fijar los objetivos antiguos. Te explico las cuentas del tamaño de muestra, la scorecard reponderada desde la que yo empezaría y cómo mantener justas las puntuaciones de la IA.
¿Cuántas revisiones necesita realmente la puntuación de un agente?
Muchas más que cinco. Una puntuación basada en cinco tickets revisados es sobre todo suerte, y las cuentas son las estándar para cualquier tasa de aprobación.
Imagina un agente que de verdad aprueba un criterio el 85 % de las veces. Con 5 revisiones al mes, el margen de error al 95 % es de unos 31 puntos: el panel podría mostrar 55 % o 100 % para la misma persona en el mismo mes. Con 20 revisiones es de unos 16 puntos, con 100 de unos 7 y con 500 (todos los tickets) de unos 3. Es aritmética mía con la aproximación normal, con una corrección por población finita en el widget de abajo.
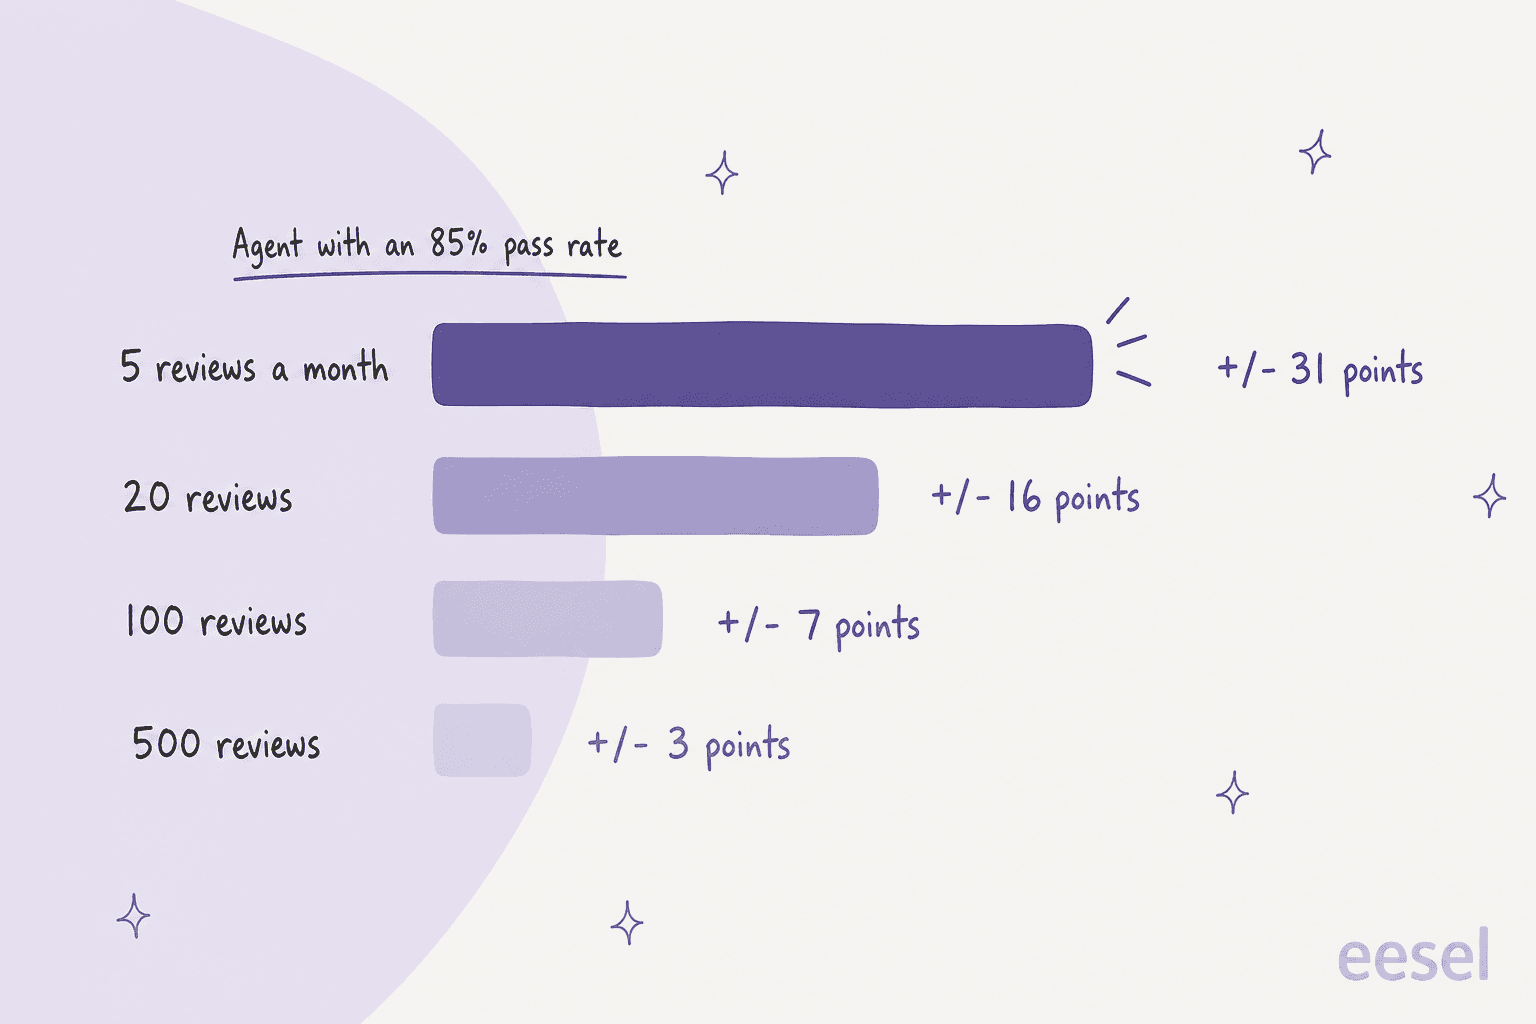
Se complica más al comparar personas. Para distinguir con confianza a un agente del 85 % de uno del 75 % necesitas unos 120 tickets puntuados de cada uno. Un líder de equipo que revisa 5-10 tickets a la semana de los unos 500 que un agente gestiona al mes nunca llega ahí. Leo Gasperin describió justo eso en su antiguo equipo, y un comentarista le puso nombre:
"sampling creates confidence, but not clarity."

Prueba con tus propios números. El widget de abajo usa tu volumen de tickets y tu número de revisiones.
Escribe tu propio volumen de tickets y número de revisiones para ver lo amplio que es el rango. La última tarjeta indica las revisiones necesarias para distinguir a dos agentes separados por 10 puntos.
Ya traté el argumento más amplio para abandonar el muestreo en aseguramiento de calidad en call centers, y la versión práctica en QA de soporte con IA. La versión corta aquí: la puntuación con IA vale la pena solo por el denominador.
¿Qué debería medir la scorecard de rendimiento de un agente?
Cuatro cosas, ninguna de las cuales es la velocidad por sí sola: calidad, resultado, opinión del cliente y eficiencia por tipo de ticket. El consejo habitual es una puntuación ponderada (por ejemplo, calidad 40, productividad 25, experiencia del cliente 25, fiabilidad 10), y esa estructura está bien. Los equipos se equivocan en los pesos.
| Categoría | Medida de ejemplo | Qué te dice | La trampa |
|---|---|---|---|
| Calidad | Empatía, precisión y resolución puntuadas por IA | ¿La respuesta cumplió su función? | Un criterio que la IA no puede juzgar (Gorgias deja la precisión y la voz de marca en manos de humanos) |
| Resultado | Tasa de reapertura, resolución en el primer contacto | ¿Se quedó resuelto? | Agentes que cierran rápido y reabren después |
| Opinión del cliente | CSAT | ¿El cliente sintió que lo ayudaron? | Pocas respuestas de encuesta por agente, o sea el mismo problema de ruido |
| Eficiencia | Tiempo medio de gestión por tipo de ticket | ¿Está bien organizado el trabajo? | Un único número combinado para tickets fáciles y difíciles |
Para la lista completa de métricas, mis artículos sobre KPIs de atención al cliente y productividad de los agentes de call center profundizan más. Si estás escribiendo criterios de revisión desde cero, ejemplos de feedback de QA te da redacciones que hacen coaching en lugar de poner notas.
¿Qué cambia cuando un agente de IA se queda con los tickets fáciles?
Tu cola humana se vuelve más difícil, y cada número por agente que fijaste antes de la IA ahora mide un trabajo distinto. La IA responde las preguntas sobre el estado de un pedido y los "cómo hago...", así que a una persona le llegan la decisión de un reembolso, el cliente enfadado y lo que el bot no supo resolver.
Un agente de call center en Reddit lo describió después de que un agente de voz con IA se colocara delante de los teléfonos:
"At this point, it's handling a lot of "routine" calls. Which means the calls that come through to us humans are more complicated, or people who are upset about the AI messing something up."

Los números respaldan la sensación. En Question Beauty, eesel gestionó unos 990 tickets de Gorgias en un mes (del 8 de agosto al 8 de septiembre de 2026), envió unas 960 respuestas, cerró unos 280 tickets por sí solo y asignó unos 250 a una persona con una nota interna. Los reembolsos, las quejas y las solicitudes mayoristas siempre van a un humano. Los agentes de ese equipo no son más lentos que antes; simplemente ya no ven nunca el "dónde está mi pedido". El tiempo de gestión por ticket sube y los tickets por agente bajan, y ninguna de las dos cosas es un problema de rendimiento.
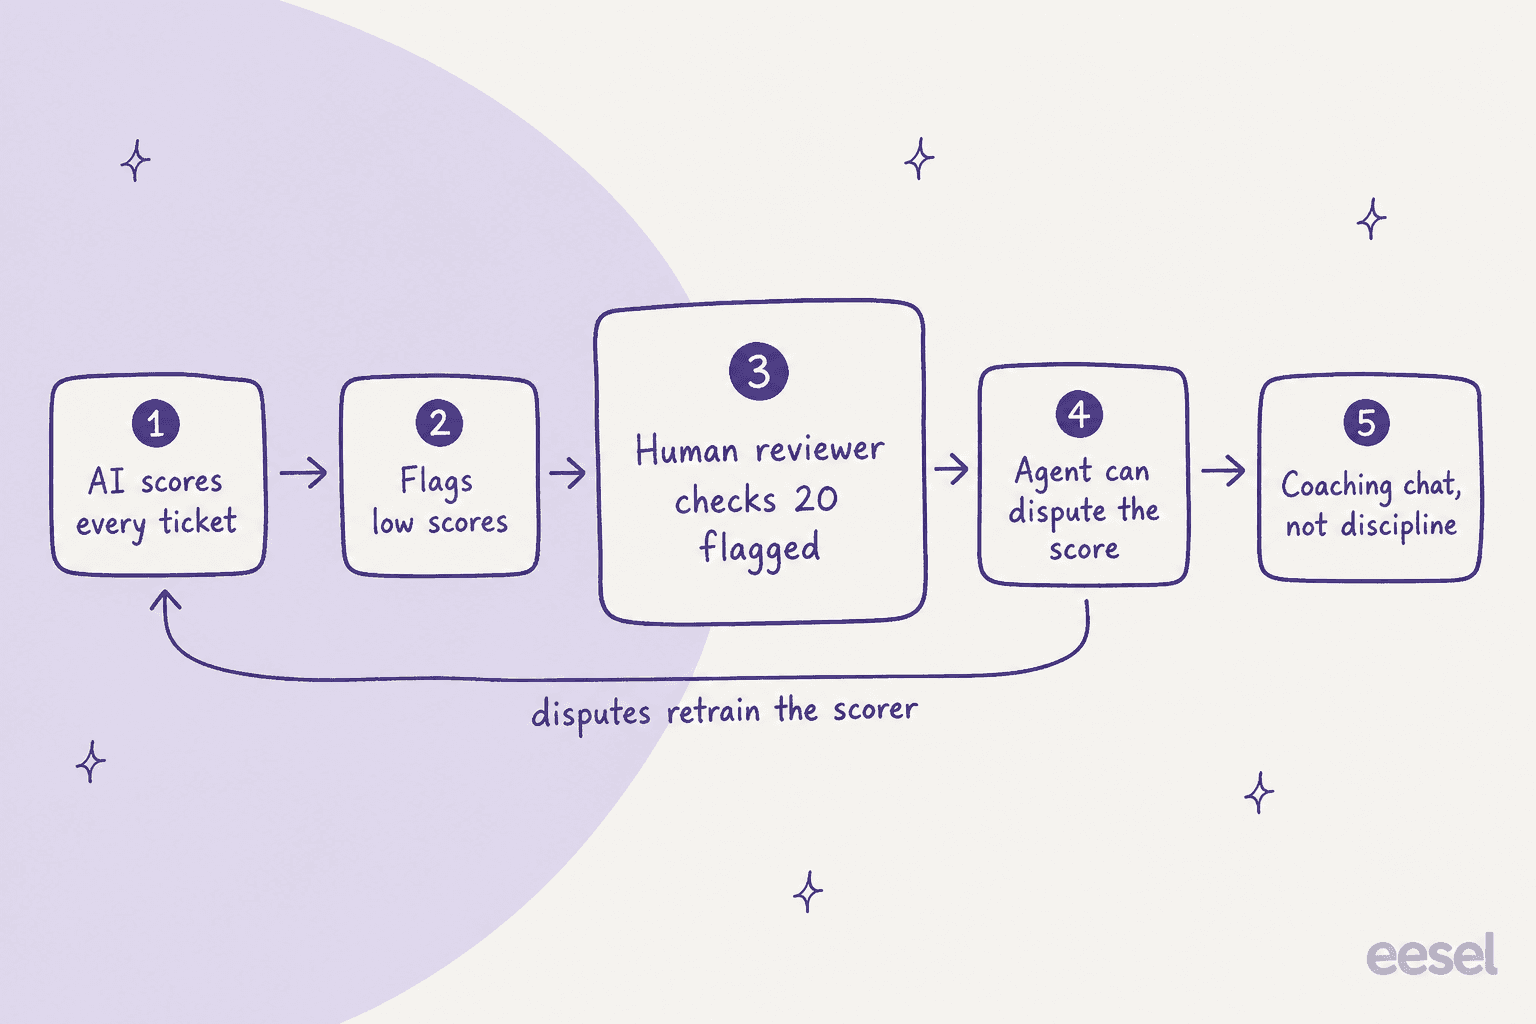
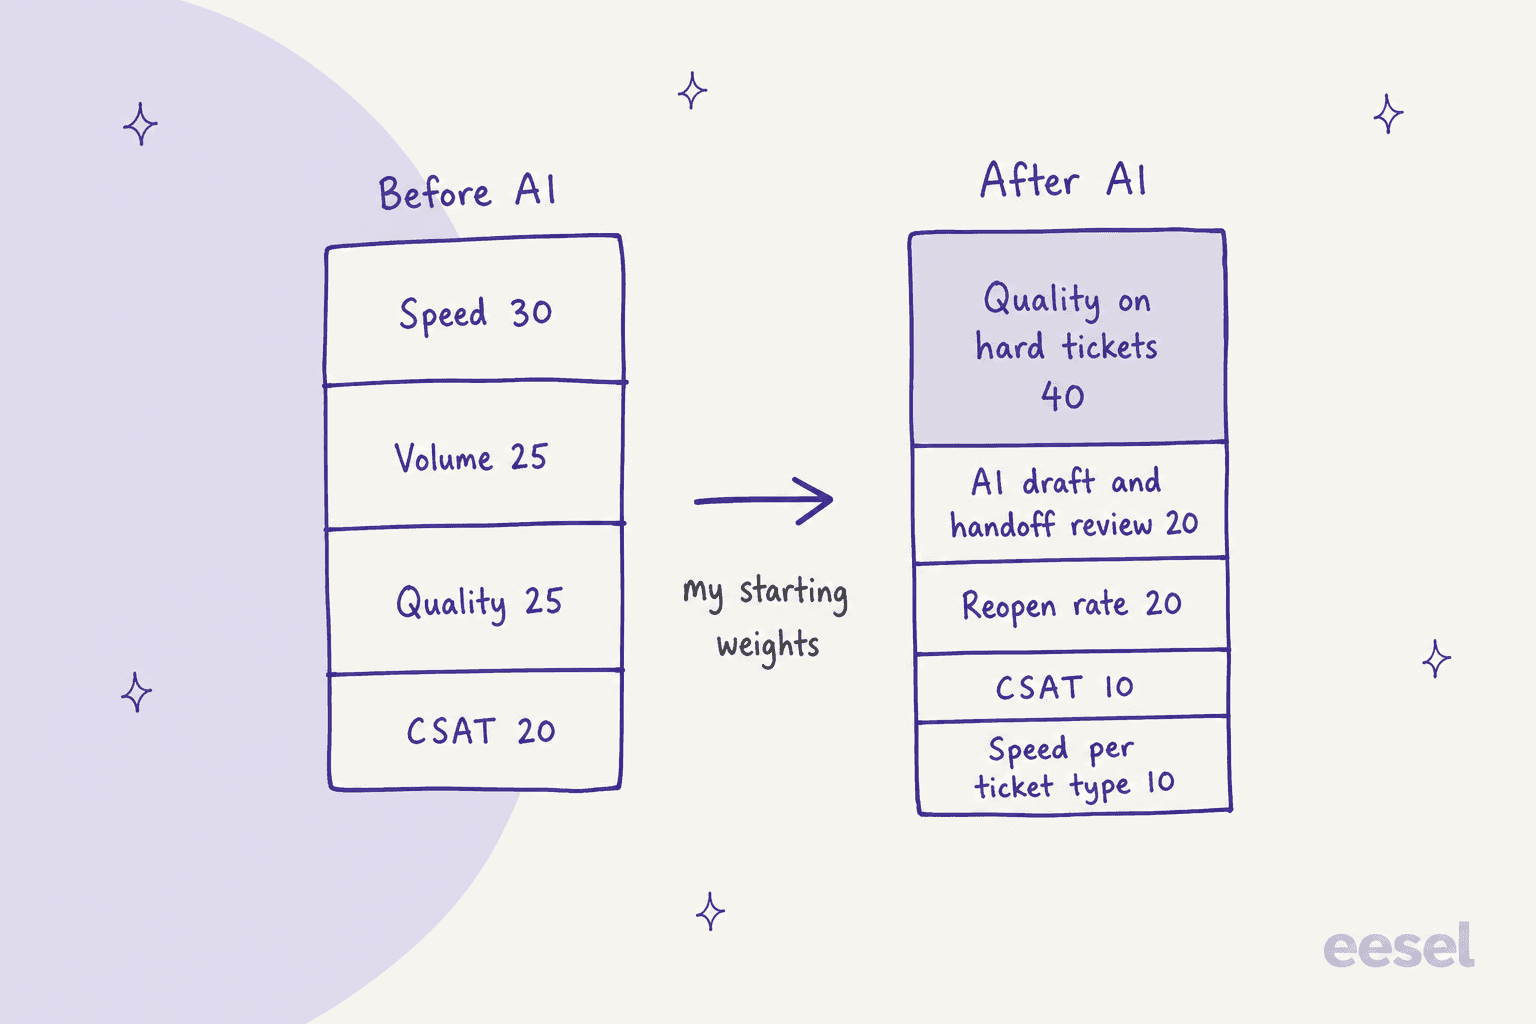
Esta es la reponderación desde la que yo empezaría. Son mis pesos de partida, no una referencia del sector, así que muévelos después de tu primera ronda de calibración. Qué cambia:
- Elimina los objetivos de volumen individuales. Los tickets cerrados por agente bajan por diseño cuando la IA desvía los fáciles. Haz seguimiento del total de horas de agentes en la cola, como explico en IA para reducir el tiempo de gestión.
- Mide la velocidad por tipo de ticket. Un ticket de reembolso y un restablecimiento de contraseña nunca deberían compartir una referencia. Gorgias ya calcula el tiempo de gestión del ticket solo en los tickets que trabajó una persona y deja fuera los tickets resueltos por su AI Agent. Copia esa regla en cualquier helpdesk.
- Añade una línea para el trabajo con la IA. Los agentes ahora aprueban, editan o rechazan borradores y reciben traspasos. En smava, eesel preparó unos 15.300 borradores de respuesta en un mes en un Zendesk compartido, y un agente aprueba un borrador o escribe @eesel en una nota para pedir una macro distinta. Revisar bien eso es una habilidad: una puntuación por "detectó un borrador erróneo" y por "dejó una nota de traspaso útil" tiene sitio en la tarjeta.
- Revisa el traspaso, no solo la respuesta. Si la IA traspasa con el pedido ya comprobado, eso es calidad del traspaso, y afecta a los números del agente más que su velocidad al teclear.
Un comentarista de Reddit con casi 30 años en soporte explicó con claridad el coste de ignorar esto:
"Except now imagine an eight-hour shift where practically EVERY conversation you receive is an escalation, an angry customer, an unusual problem or something the AI already couldn't solve."
Eso es también una cuestión de coaching y de turnos, y trato el lado del personal en IA para la dotación de personal de soporte y el lado de los turnos en IA para el relevo de turnos.
¿Qué herramientas de helpdesk puntúan la calidad de los agentes con IA?
Cinco helpdesks ofrecen algo nativo, y se diferencian más de lo que sugiere el marketing. Leí la documentación y la página de precios de cada proveedor, así que la tabla de abajo usa solo sus palabras y sus precios.
| Helpdesk | Qué puntúa | Cuánto del ticket juzga la IA | Precio indicado |
|---|---|---|---|
| Zendesk QA | Cada interacción, de humanos y de agentes de IA; categorías integradas como Empathy o Solution, más tus propias categorías basadas en prompts | Lo que escribas en la scorecard | Complemento de QA en todos los planes Suite, precio no indicado; el Workforce Engagement Bundle cuesta $50 por agente al mes facturado anualmente |
| Gorgias Auto QA | Tickets cerrados, puntuados 12 horas después del cierre | 3 criterios (resolución completa, comunicación, idioma); otros 4 (precisión, eficiencia, cumplimiento interno, voz de marca) son solo manuales | Activado por defecto con una suscripción a AI Agent, que cuesta $1.50 por interacción automatizada por encima del límite del plan |
| Front Smart QA | Cada ticket frente a scorecards personalizables, más Smart CSAT | Los criterios que definas | Indicado como incluido en Enterprise, $105 por puesto al mes facturado anualmente |
| HubSpot QA score | Tickets cerrados del help desk, de 1 a 5 | 3 criterios (tono, claridad, empatía); beta | Service Hub Enterprise, $150 por puesto al mes |
| Freshdesk Quality Coach | Conversaciones resueltas, que se muestran a los agentes en su bandeja, más un informe de Quality Score para administradores | 6 parámetros (apertura y cierre, puntualidad, calidad de la respuesta, sentimiento, gramática, muletillas) | Se activa en los ajustes de Freddy Copilot; Freddy AI Copilot cuesta $29 por agente al mes en Pro y Enterprise |
Algunas cosas que noté al leerlos uno al lado del otro:
- Zendesk es el más flexible y el menos transparente en precio. Tú escribes los criterios, y Spotlight señala riesgos de abandono y bucles atascados. Su AI Agent QA también compara lado a lado las puntuaciones de bots y de humanos. El coste es una conversación con ventas. Explico la configuración en criterios de scorecard de Zendesk QA y Zendesk QA para agentes de IA.
- Gorgias es el más honesto sobre sus límites. Su documentación dice claramente que la precisión y la voz de marca solo se pueden puntuar manualmente, que los criterios personalizados no están disponibles por ahora y que se omiten los tickets de menos de 250 caracteres, los tickets sociales y las llamadas telefónicas. Es útil: sabes qué mitad de tu scorecard sigue necesitando a un humano. Consulta precios de Gorgias AI Agent para el lado del coste.
- Front incluye QA junto con inferencia de CSAT, así que obtienes en un mismo lugar una vista de calidad y una vista de satisfacción inferida por IA. Precios de Front tiene el detalle de los planes.
- El de HubSpot es el más cauteloso. Está en beta y solo en Enterprise; si merece la pena por el precio del puesto es una pregunta que trato en HubSpot Service Hub AI.
- El de Freshdesk es el más antiguo, y el artículo de ayuda es de 2024, así que compruébalo con tu plan antes de construir un proceso sobre él. Los planes están en precios de Freshdesk.
Si no usas ninguno de estos o quieres una visión independiente del proveedor, herramientas de aseguramiento de calidad para atención al cliente compara las plataformas de QA independientes.
¿Cómo mantener justas con los agentes las puntuaciones de la IA?
Trata cada puntuación como una señal que elige los tickets que una persona debe leer, nunca como un veredicto. Los propios proveedores lo dicen: el artículo de ayuda de HubSpot advierte de que sus puntuaciones de QA pueden ser inexactas y que no deben ser la única base para decisiones de coaching, rendimiento, remuneración, disciplina u otras decisiones sobre una persona.
El ciclo que yo seguiría:
- Puntúa cada ticket con IA. Es la solución del denominador de la primera sección.
- Lee tú mismo los señalados. Veinte tickets señalados por equipo a la semana valen más que cinco aleatorios por agente, porque lees donde está la señal.
- Calibra. Haz que dos personas puntúen los mismos 20 tickets y compáralos con la IA. Donde discrepen, corrige la redacción del criterio, no a las personas. Un hilo de G2 pregunta justo cómo mantienen los equipos la calibración humana junto con la puntuación con IA, y la respuesta habitual es que la IA es la primera pasada y las sesiones humanas se mantienen.
- Deja que los agentes disputen. Gorgias permite a un revisor editar cualquier parte de una puntuación y usa esas ediciones para afinar el modelo. Incluso donde tu herramienta no lo haga, un agente que puede decir "esta puntuación es incorrecta, y este es el motivo" hace el sistema más preciso y más fiable.
- Nunca tomes medidas disciplinarias solo por el sentimiento. Las puntuaciones de sentimiento y tono castigan a quienes atienden a los clientes más enfadados, que, tras el desvío de la IA, son todos.
Mi artículo sobre análisis de sentimiento con IA para soporte explica por qué el sentimiento es un mal juez de un agente individual. La justicia es también la razón por la que probaría un evaluador antes de confiar en él, igual que simularías un agente de IA.
¿Cómo convertir las puntuaciones en coaching?
Elige un comportamiento por agente al mes, muéstrale dos tickets y acordad un cambio. Las puntuaciones encuentran los tickets; la conversación hace el trabajo.
Un plan de 30 días, en el orden en que lo haría:
- Semana 1, fija el denominador. Activa el QA con IA de tu helpdesk y deja que puntúe cada ticket cerrado. Todavía no mires clasificaciones por agente.
- Semana 2, calibra. Haz la comprobación de 20 tickets de arriba y reescribe cualquier criterio que humanos e IA lean de forma distinta.
- Semana 3, reajusta los pesos. Pasa a la scorecard posterior a la IA: sin objetivo de volumen individual, velocidad por tipo de ticket, una línea para la revisión de borradores y los traspasos.
- Semana 4, empieza las reuniones individuales. Un punto fuerte y un hábito por agente, con los dos tickets como evidencia. Coaching de agentes con IA y software de coaching para atención al cliente cubren las herramientas, y coaching de agentes de IA para soporte cubre el coaching de la propia IA.
Para las nuevas incorporaciones el mismo ciclo funciona más rápido, ya que los borradores de la IA sirven de ejemplos resueltos: consulta incorporación de agentes de atención al cliente.
¿Cómo encaja eesel en el rendimiento de los agentes?
eesel no puntúa a tus agentes humanos. Cambia en qué trabajan. eesel es un compañero de IA para helpdesks que vive en tu helpdesk actual, responde o redacta los tickets repetitivos y pasa el resto a una persona con una nota, de modo que la puntuación que construyas para tu equipo refleje el trabajo que queda. eesel lleva años ejecutando IA en colas de soporte reales, y cada despliegue se simula primero con tickets históricos, lo que te da la vista de antes y después de la cola humana que necesita una scorecard justa.
Tres historias de clientes publicadas muestran el patrón en distintos helpdesks:
- Gorgias: Question Beauty hizo que eesel enviara unas 960 respuestas y cerrara unos 280 de 990 tickets en un mes; unos 250 fueron a una persona con la consulta del pedido ya adjunta.
- Zendesk: smava gestiona unos 27.000 tickets al mes en un solo Zendesk entre dos marcas. eesel categorizó unos 14.600 de ellos y preparó unos 15.300 borradores, y las personas aprueban o redirigen cada borrador.
- Freshdesk: en SamCart eesel responde en los tickets solo mientras no hay ningún agente asignado, y que un compañero tome el ticket pone fin a la parte del agente, lo que es una línea clara para decidir de quién son los tickets que van en la scorecard de cada uno.

Para juzgar la propia IA, usa la scorecard de pilotos de soporte con IA, la guía de tasa de resolución de la IA y contención y calidad de las escalaciones. Para el lado del coste, coste de un agente de IA frente a uno humano tiene la comparación.
Prueba eesel para los tickets en los que tu equipo no debería ser puntuado
Si tus agentes están siendo puntuados por restablecimientos de contraseña y preguntas sobre el estado de pedidos, entrégaselos primero a eesel y reajusta la scorecard en torno a lo que queda. Se conecta con Zendesk, Freshdesk, Gorgias, HubSpot y Front, y aprende de tu centro de ayuda y de tus tickets pasados.
Los precios de eesel son planes de créditos fijos: un ticket o un chat cuesta 1 crédito sin importar cuánto dure, el plan gratuito incluye 100 créditos para probar todas las funciones y los planes de pago empiezan en $299 al mes por 500 créditos. Prueba eesel con tus propios tickets y comprueba cuánto de tu cola es del tipo fácil.