

Por qué el QA de soporte multilingüe falla en silencio
La mayoría de los programas de QA de soporte se construyen en inglés y luego se estiran. La ficha de evaluación se copia, el grupo de revisores sigue igual y alguien activa un botón de traducir para que los revisores angloparlantes puedan "leer" la cola en alemán. Las puntuaciones salen bien. Ese es el problema.
He visto cómo esto sale mal desde dentro. eesel lleva años ejecutando IA en helpdesks en vivo en alemán, neerlandés, francés, español, rumano y más, y el peor fallo multilingüe que he visto enviar a eesel no fue una mala traducción. A principios de 2026, borradores de respuesta en alemán y neerlandés salieron con marcadores sin resolver como {{ticket.requester.first_name}} y [Employee Name], en helpdesks belgas, alemanes y neerlandeses. Un corrector de gramática habría puntuado bien esos borradores. Un hablante nativo que leyera la respuesta una vez lo habría notado en dos segundos.
Ese es el patrón. Los errores que importan en un segundo idioma casi nunca son errores ortográficos.
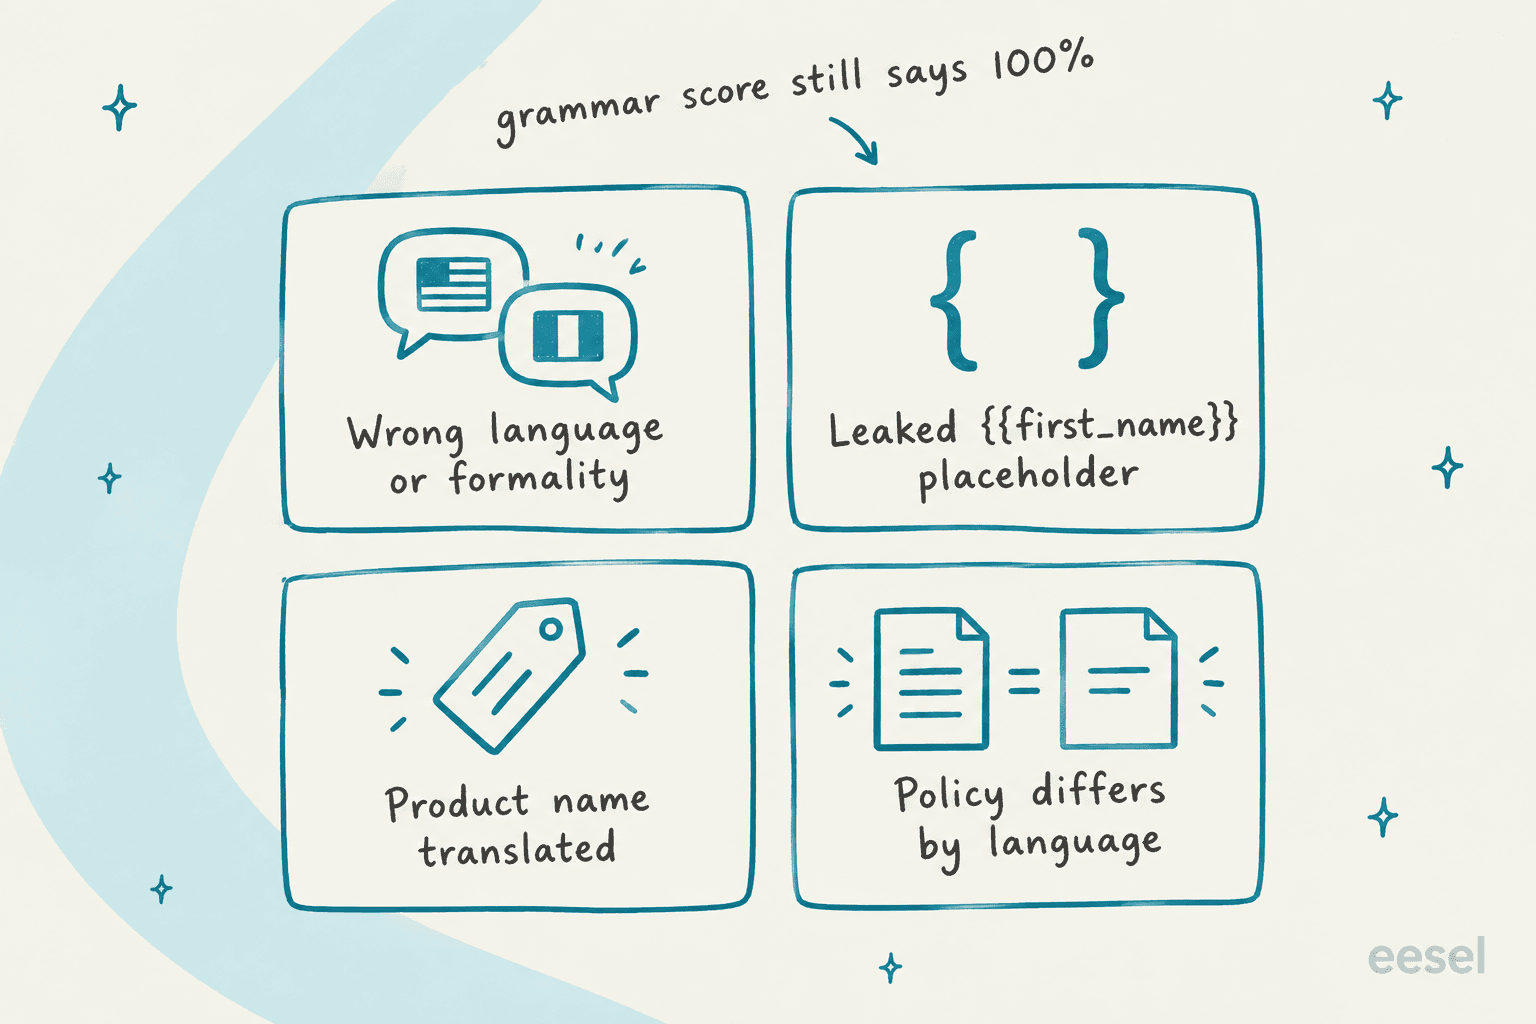
Esto es lo que se cuela cuando el QA en otros idiomas es solo QA en inglés con un botón de traducir:
- Registro y formalidad. Alemán du frente a Sie, francés tu frente a vous, los niveles de cortesía del japonés. La traducción automática los aplana, así que un revisor que lee la versión en inglés nunca ve que el agente trató a un cliente B2B de 60 años como a un adolescente.
- Filtraciones de mecánica. Marcadores, fragmentos en inglés olvidados en una macro, una despedida en inglés en una respuesta en español. Se leen como "aquí nadie habla mi idioma".
- Terminología. El nombre de tu producto traducido a un sustantivo común, o tres palabras distintas para la misma función en una sola respuesta. Escribí una guía entera sobre glosarios de traducción para soporte porque hoy ningún helpdesk incluye un glosario a nivel de ticket.
- Deriva de políticas. La macro en inglés dice devoluciones a 30 días, la macro en francés se tradujo hace dos años y sigue diciendo 14. Cada respuesta es gramaticalmente perfecta y una de ellas es incorrecta.
Qué puntuar en una respuesta que no está en inglés
Mantén una sola ficha para todos los idiomas. Dividirla en una "ficha en alemán" y una "ficha en inglés" es la forma de que las puntuaciones dejen de ser comparables. Lo que cambia por idioma es quién puede calificar cada línea y cómo son los ejemplos.
Divido las categorías con una pregunta: ¿esto sobrevive a la traducción? Si un revisor que lee una traducción automática puede calificarlo con fiabilidad, cualquier revisor formado puede puntuarlo. Si la señal vive en la redacción original, solo debería puntuarlo alguien que lea el idioma.
| Línea de la ficha | Qué comprueba | ¿Se puede calificar con seguridad desde una traducción? |
|---|---|---|
| Solución y precisión | Respuesta correcta, política correcta, siguiente paso correcto | Sí, si la traducción es fiel |
| Proceso | Etiquetado, enlazado y escalado correctamente | Sí |
| Comprensión | Si el agente entendió la pregunta real | En su mayoría |
| Coincidencia de idioma | Respondió en el idioma del cliente, sin fragmentos en inglés | En parte (necesita la vista original) |
| Ortografía y gramática | Mecánica en el idioma original | No |
| Formalidad y tono | Sie vs. du, nivel de cortesía, calidez | No |
| Terminología | Nombres de producto sin tocar, términos aprobados usados | No |
| Marcadores y filtraciones | Sin tokens {{ }}, sin notas internas, sin despedida en el idioma equivocado | Sí, pero solo en el original |
Las cuatro filas con "No" son donde deben ir tus horas de revisión nativa. Todo lo demás pueden calificarlo tus revisores actuales con una traducción, lo que mantiene el programa asequible. Para la rúbrica general detrás de esas filas, mi guía de calidad del idioma en atención al cliente desglosa gramática, claridad y tono, y la guía del tono en el servicio al cliente explica cómo escribir reglas de tono contra las que se pueda calificar de verdad.
Una regla más para la ficha: haz que "la política difiere de la fuente en inglés" sea un error crítico. MQM, el marco que usan los equipos profesionales de traducción para puntuar la calidad, trata un solo error crítico como suspenso automático sin importar lo bueno que sea el resto (MQM values and scores). El QA de soporte debería tomarlo prestado. Una política de reembolso errónea y bellamente escrita sigue siendo una política de reembolso errónea.
Toma prestados los tipos de error que ya usan los traductores
No tienes que inventar categorías. MQM clasifica los errores de traducción en siete grupos: terminología, precisión, convenciones lingüísticas, estilo, convenciones locales, adecuación a la audiencia, y diseño y marcado (MQM error typology). Sus penalizaciones por defecto son 0 para neutro, 1 para leve, 5 para grave y 25 para crítico (MQM values and scores). ISO 5060:2024 es el estándar formal basado en el mismo enfoque de tipo de error más penalización.
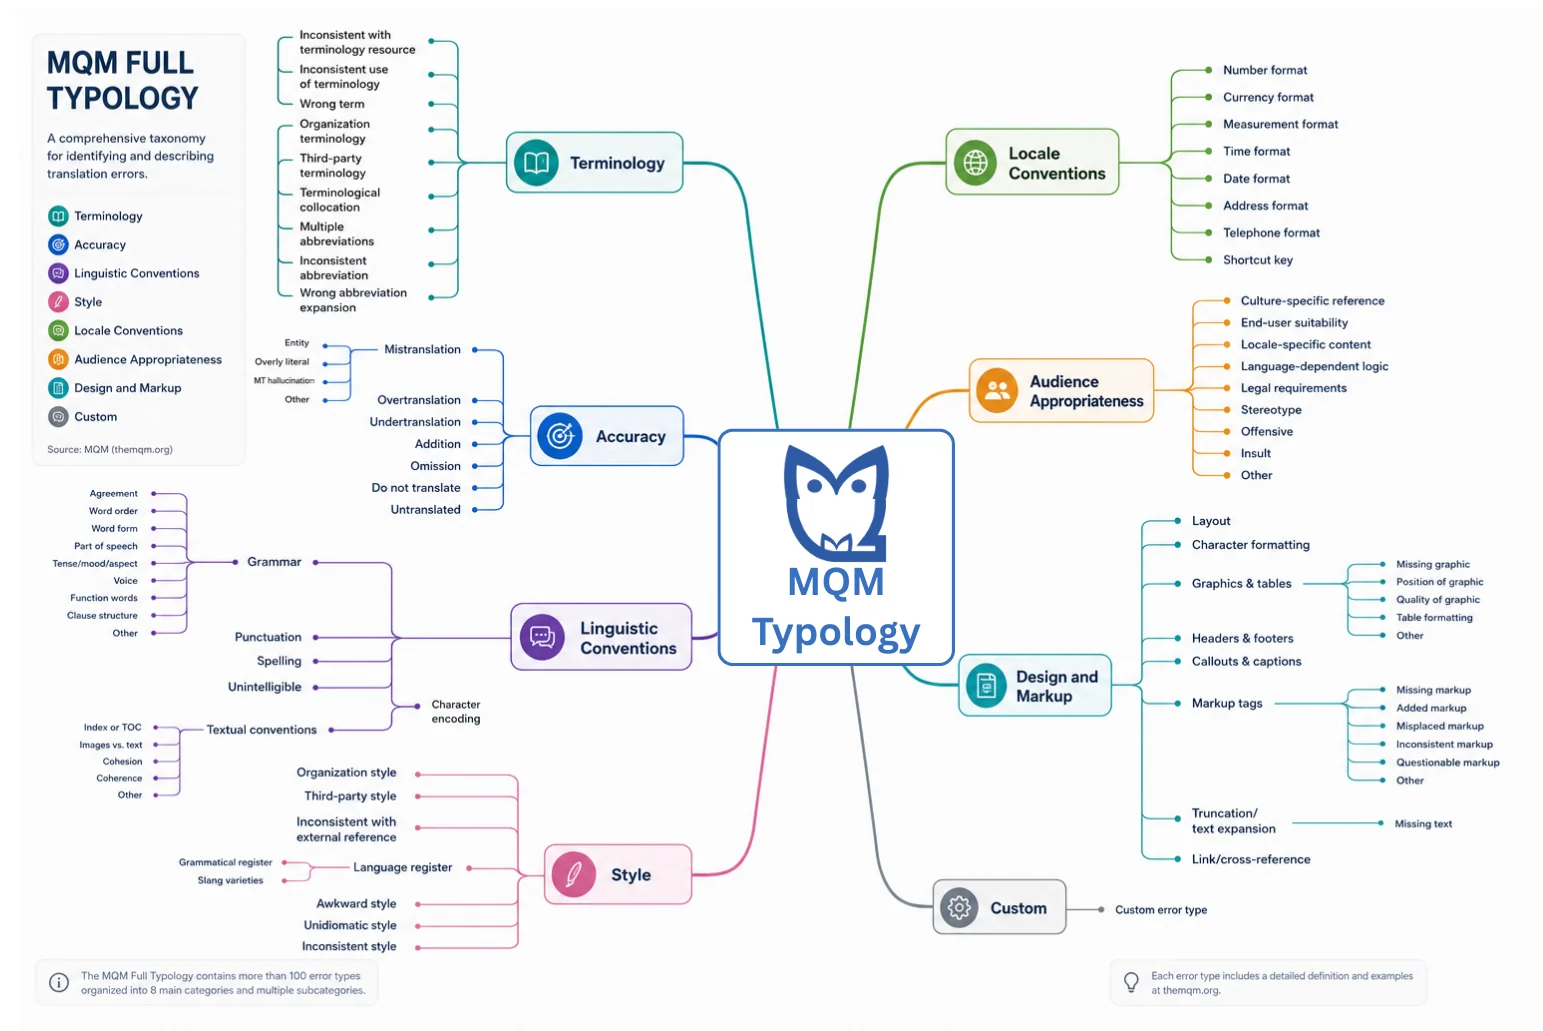
Dos ramas encajan bien con el trabajo de soporte. "Convenciones locales" cubre los formatos de fecha, moneda, números y direcciones, justo donde un agente formado en EE. UU. escribe 10/05 a un cliente alemán que lo lee como 10 de mayo. "Diseño y marcado" cubre el marcado ausente o roto, la familia a la que pertenece la filtración de marcadores. No ejecutaría la puntuación MQM completa en tickets de soporte (está pensada para documentos traducidos y cuenta errores por cada 1.000 palabras), pero usar sus nombres de categoría como etiquetas de error hace que tus datos de QA sean mucho más accionables.
Cómo muestrear tickets cuando un idioma es el 84 % del volumen
El muestreo aleatorio es justo entre tickets e injusto entre idiomas. Si el inglés es el 84 % de tu volumen, el alemán el 12 % y el neerlandés el 4 %, una muestra aleatoria de 50 revisiones a la semana deja 42 en inglés, 6 en alemán y 2 en neerlandés. Dos revisiones no pueden decirte si tu agente de neerlandés tiene un hábito o tuvo un mal martes. Los equipos de teléfono tienen el mismo problema, por eso los programas de QA de call center suelen estratificar también las muestras.
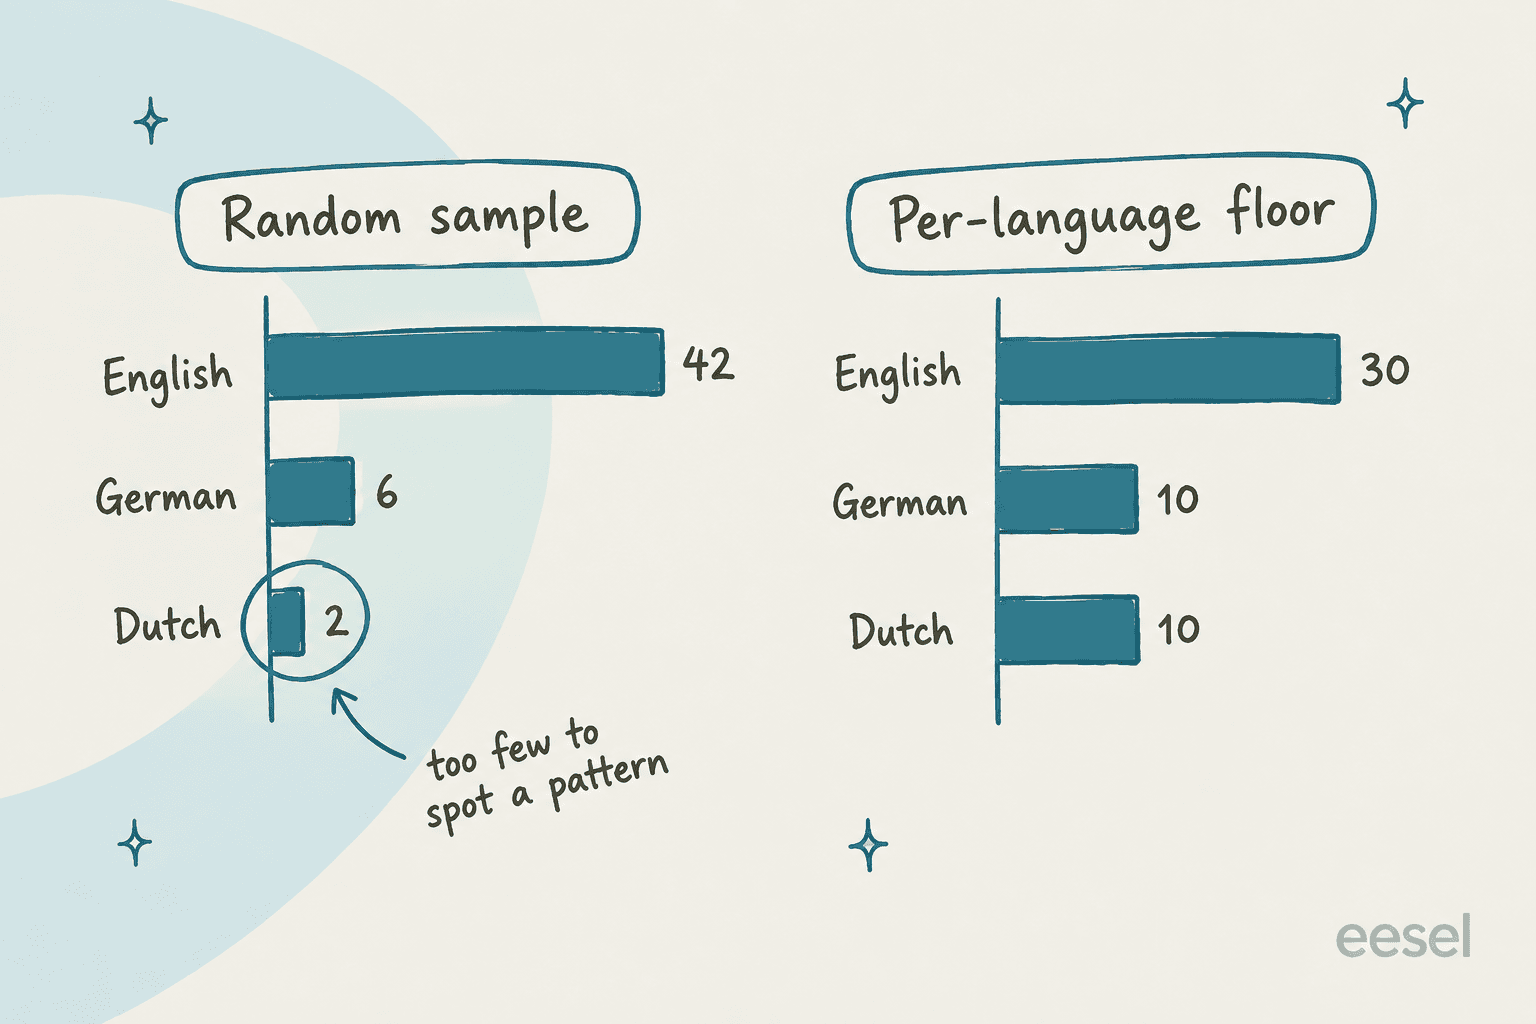
La solución es un mínimo: cada idioma recibe al menos N revisiones por semana, y lo que quede del presupuesto va a los idiomas grandes en proporción al volumen. Con un mínimo de 10, las mismas 50 revisiones pasan a ser 30 en inglés, 10 en alemán y 10 en neerlandés. El inglés sigue recibiendo la mayor atención. El neerlandés por fin recibe lo suficiente para ver un patrón.
Pon aquí tus propias cifras:
Un mínimo de alrededor de 10 por idioma y semana es la cifra más pequeña con la que confiaría en una tendencia. Si tu presupuesto no cubre eso para cada idioma, revisa los idiomas pequeños cada dos semanas con 20 en lugar de cada semana con 5. Menos lotes, pero más grandes, superan al goteo.
Dos filtros hacen la muestra más inteligente, no solo más grande:
- Sobremuestrea a los agentes nuevos y los idiomas nuevos. El primer mes de un mercado nuevo o de una contratación nueva es cuando los errores son más baratos de corregir. Mi guía de incorporación de agentes explica cómo adelantar la revisión para los recién llegados.
- Sobremuestrea el CSAT bajo en idiomas pequeños. Un cliente neerlandés enfadado es 1 de cada 25 tickets en neerlandés, no 1 de cada 625 en total. Sácalos siempre. Las herramientas de CSAT con IA pueden detectarlos automáticamente.
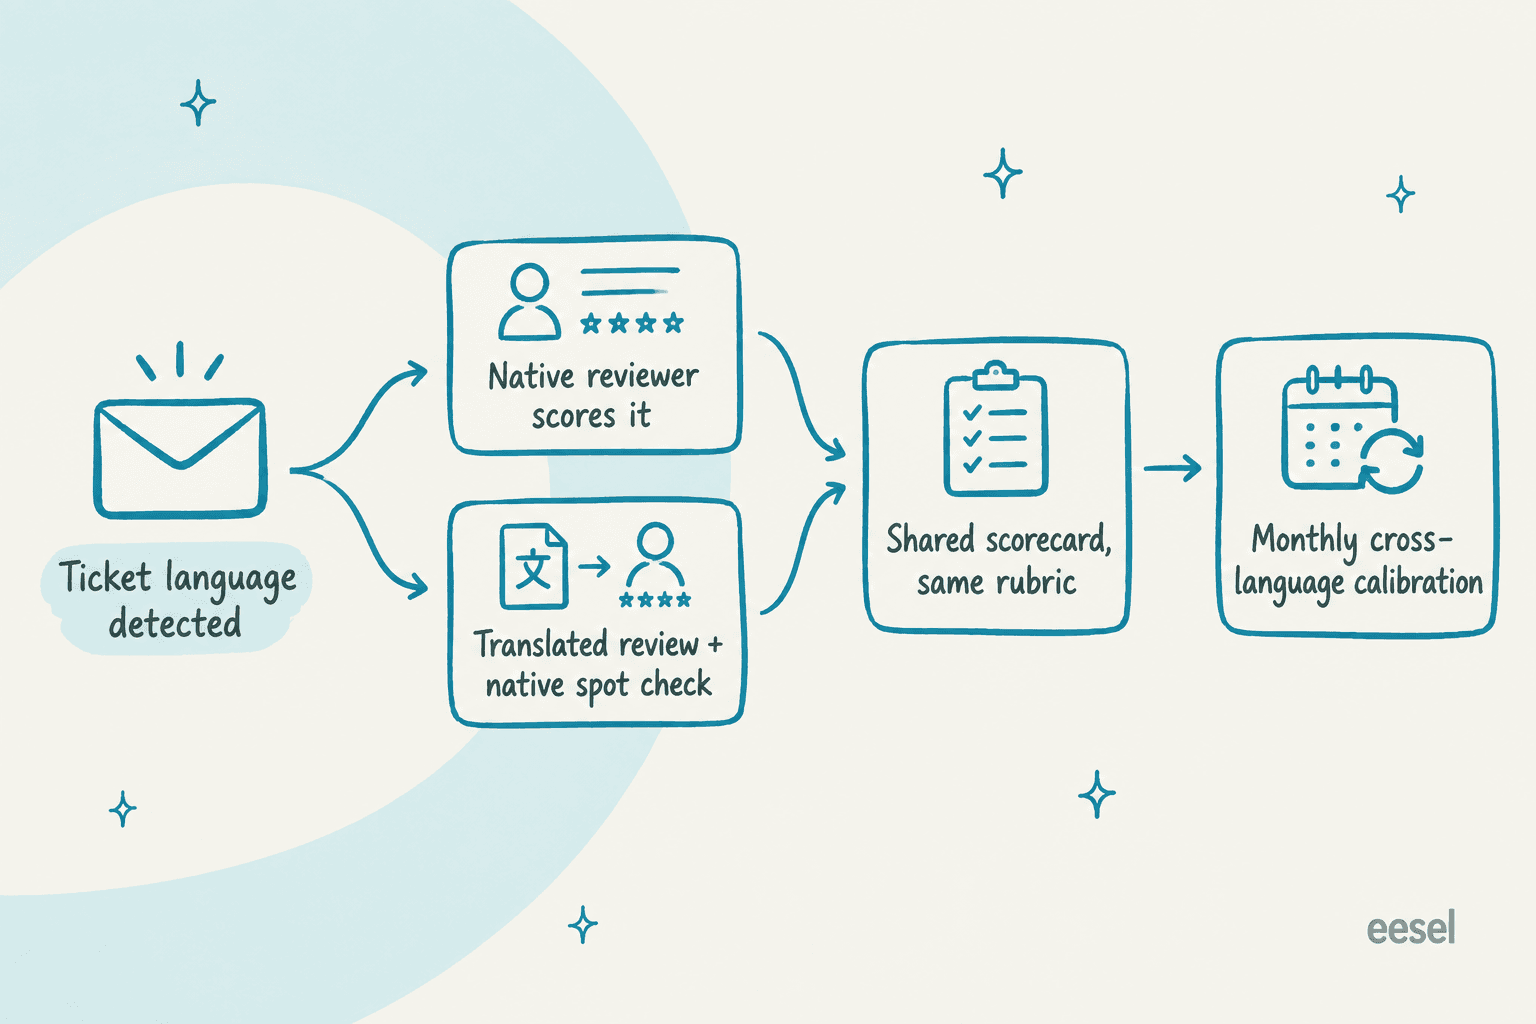
Quién revisa qué: revisores nativos frente a revisión traducida
Hay tres formas de dotar de personal al QA en otros idiomas, y la mayoría de los equipos acaban usando las tres.
1. Revisores nativos en cada idioma. El estándar de oro y el más caro. Normalmente un agente sénior del equipo de ese idioma, con unas horas a la semana de tiempo de revisión. En los equipos offshore, suele ser el líder del equipo en esa sede. Son responsables de las cuatro filas con "No" de la ficha.
2. Revisión traducida por tu equipo central de QA. Tus revisores actuales califican solución, proceso y comprensión mediante una traducción dentro de la herramienta. Barato, y mantiene un mismo par de ojos sobre la precisión en todos los mercados. Los equipos con soporte follow-the-sun son los que más se apoyan en esto.
3. Muestreos nativos sobre revisiones traducidas. Una vez al mes, un hablante nativo vuelve a calificar un puñado de conversaciones que el equipo central ya puntuó mediante traducción. Si las puntuaciones se separan, la revisión traducida se está dejando algo y mueves más volumen a la opción 1. También es donde encuentras lagunas de conocimiento que solo existen en un idioma.
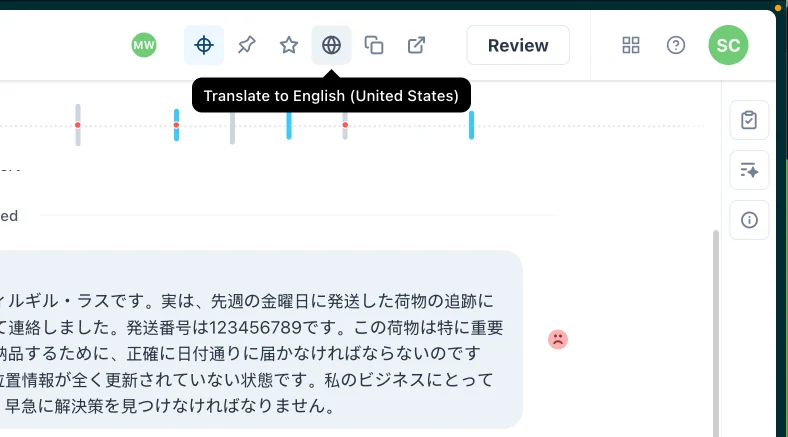
El enrutamiento es la parte que las herramientas ya manejan bien. En Zendesk QA, los revisores pueden traducir una conversación al idioma de su perfil haciendo clic en un icono de globo y volver al original (Using the Conversations view). Eso cubre 29 idiomas principales, y el árabe, el hebreo y el ucraniano no están en la lista de QA aunque la traducción en vivo de Support los cubre (Zendesk language support by product).
Para el enrutamiento, Zendesk QA tiene un filtro de conversación Language (AI) con condiciones "es" / "no es" (conversation filter types), y los grupos pueden organizar a los revisores "según características como el idioma" para usarlos en las asignaciones (groups in Zendesk QA). No encontré un único interruptor de "muestrear N por idioma". El mínimo lo construyes creando una asignación por idioma con una condición Language (AI) y una cantidad fija.
Un detalle del lado de Zendesk Support: el campo Language de la clasificación inteligente se lee del asunto y del primer comentario público y "no se actualiza con cada respuesta del usuario final" (intelligent triage). Un cliente que empieza en inglés y cambia a alemán sigue siendo un ticket "en inglés". Usar los valores de clasificación en flujos de trabajo también requiere el complemento Copilot (triage workflows). Más sobre esa configuración en mi guía de clasificación inteligente de Zendesk.
Esto es lo que pasa sin ello. Un responsable de QA de un call center lo dijo sin rodeos en Reddit:
"I was responsible for QA on a team taking Spanish calls. Don't speak a word myself. Yea, plenty of 100's were given."

Puntuaciones perfectas de un revisor que no puede leer la conversación no son datos de calidad. Son un punto ciego con un número.
Qué puede y qué no puede puntuar el QA automatizado en otros idiomas
El QA automatizado cierra la brecha de cobertura, pero su lista de idiomas es más corta de lo que la mayoría de los equipos supone. Esta es la cobertura de AutoQA de Zendesk QA, que requiere el complemento QA o Workforce Engagement (autoscoring categories):
| Categoría de AutoQA | Idiomas con la opción LLM activada | Con ella desactivada |
|---|---|---|
| Ortografía y gramática | 9 variantes: inglés (EE. UU., Reino Unido), alemán, francés, polaco, español, portugués (BR, PT), neerlandés | Las mismas 9 |
| Legibilidad | Inglés, español | Inglés, español |
| Saludo, cierre | Todos | 8 idiomas |
| Tono, empatía, comprensión, solución ofrecida | Todos | No disponible |
Lee otra vez esa primera fila. Un agente en italiano, japonés o sueco no recibe ninguna puntuación automática de ortografía y gramática, ni siquiera con la opción LLM activada. Si la mitad de tu equipo escribe en esos idiomas, tu panel de "100 % de cobertura" los está evaluando en todo salvo en lo primero que nota un cliente nativo.
Los ajustes por idioma también importan. Las excepciones de ortografía (hasta 300) y los saludos aprobados (hasta 200) se etiquetan cada uno con un idioma, y "los saludos no se traducen" (customizing AutoQA). El propio ejemplo de Zendesk: aprueba "Bom dia" para todos los idiomas y un agente que escriba "Buenos días" en una conversación en español recibe un voto negativo.
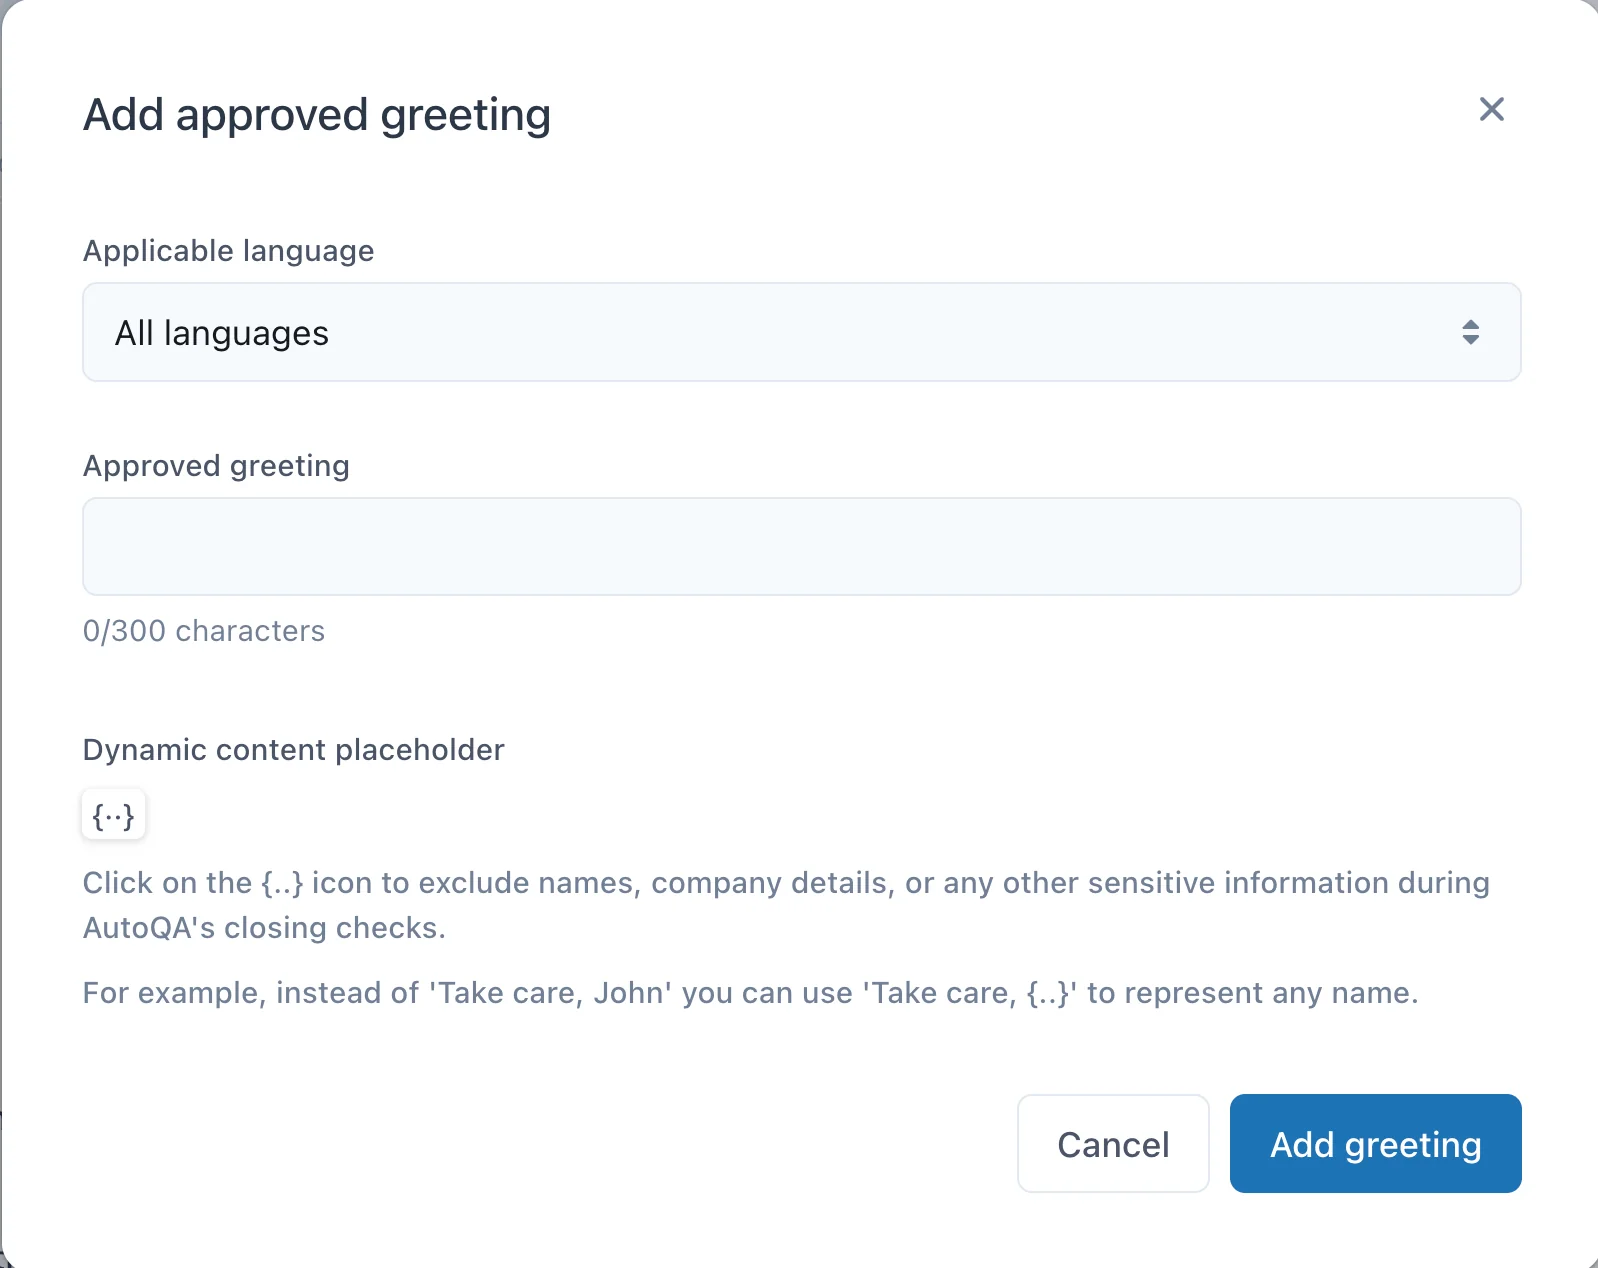
Así que configura saludos y cierres por idioma desde el primer día, o tus puntuaciones automáticas castigarán justo a los agentes que están haciendo bien lo localizado. Zendesk también dice que sus evaluaciones automáticas son "solo orientativas" y no deben guiar por sí solas decisiones de rendimiento (Zendesk QA account settings), que es la postura correcta para cualquier idioma en el que la autopuntuación tenga huecos.
Otras plataformas de QA documentan menos. evaluagent te permite escribir líneas de QA con IA generativa en tu propio idioma y detecta automáticamente el idioma hablado en las llamadas. Rippit (el nuevo nombre de MaestroQA) puntúa el 100 % de las conversaciones con agentes en lenguaje natural (Rippit announcement), pero no encontré funciones documentadas de traducción ni de filtro por idioma. Si la cobertura de idiomas te importa, pide la lista por escrito antes de comprar.
Las herramientas de QA con IA que he comparado varían mucho aquí, y mi resumen de herramientas de QA cubre el campo más amplio.
Qué da tu helpdesk a los revisores de serie
La herramienta de QA es solo la mitad. Los revisores suelen trabajar dentro del helpdesk, y lo que pueden ver ahí depende de la función de traducción que usen tus agentes.
| Helpdesk | Detección de idioma | Traducción que puede ver un revisor | Plan o límite |
|---|---|---|---|
| Zendesk | Campo Language de clasificación, ~150 idiomas, solo el primer mensaje | Traducción de conversaciones en todos los canales salvo voz; las traducciones de chats entrantes no se guardan y se vuelven a ejecutar al recargar | Traducción de tickets en Team+; la clasificación en flujos de trabajo requiere Copilot |
| Freshdesk | Detectado por ticket, los agentes pueden cambiarlo | Live Translate con "See original", 43 idiomas | Pro/Enterprise, 100 tickets traducidos por licencia de Copilot al mes |
| Gorgias | Hasta 54 idiomas, solo el cuerpo del mensaje | Traducción entrante y saliente, pasa el cursor para ver el original | Todos los planes de helpdesk |
| Front | Detectado automáticamente en entrantes y salientes | La traducción sigue visible para todos los compañeros del hilo | Starter+, 1.500 solicitudes por compañero al día |
| Help Scout | No documentado para entrantes | AI Assist traduce solo el texto saliente | Plus/Pro, o planes por contacto |
Dos líneas de esa tabla causan verdaderos dolores de cabeza de QA. Las traducciones de chats entrantes de Zendesk "se ejecutan de nuevo cada vez que se actualiza o se recarga un ticket, por lo que los resultados de la traducción pueden variar" (Zendesk), así que el inglés que lee un revisor puede no ser el inglés que vio el agente. Y Freshdesk vuelve a contar un ticket cuando lo traduce otro agente (Freshdesk), así que un revisor de QA que abre la traducción puede consumir el tope mensual de los agentes. En Freshdesk, haz que los revisores usen la traducción de la herramienta de QA, no la de los agentes.
Para profundizar por herramienta, consulta las opciones nativas de traducción de Zendesk, Front AI Translate y Freddy AI Copilot.
Si usas una capa de traducción, lee su informe de calidad
Los equipos con Unbabel o Language I/O ya tienen una segunda señal de QA y a menudo la ignoran. Unbabel ejecuta una estimación de calidad en cada traducción, prediciendo la puntuación MQM que daría un revisor humano. Sus informes clasifican las traducciones en cinco bandas, de Best (98 y más) a Weak (menos de 60), y un par de idiomas incumple su umbral cuando más del 10 % cae en rojo (Unbabel quality reporting).
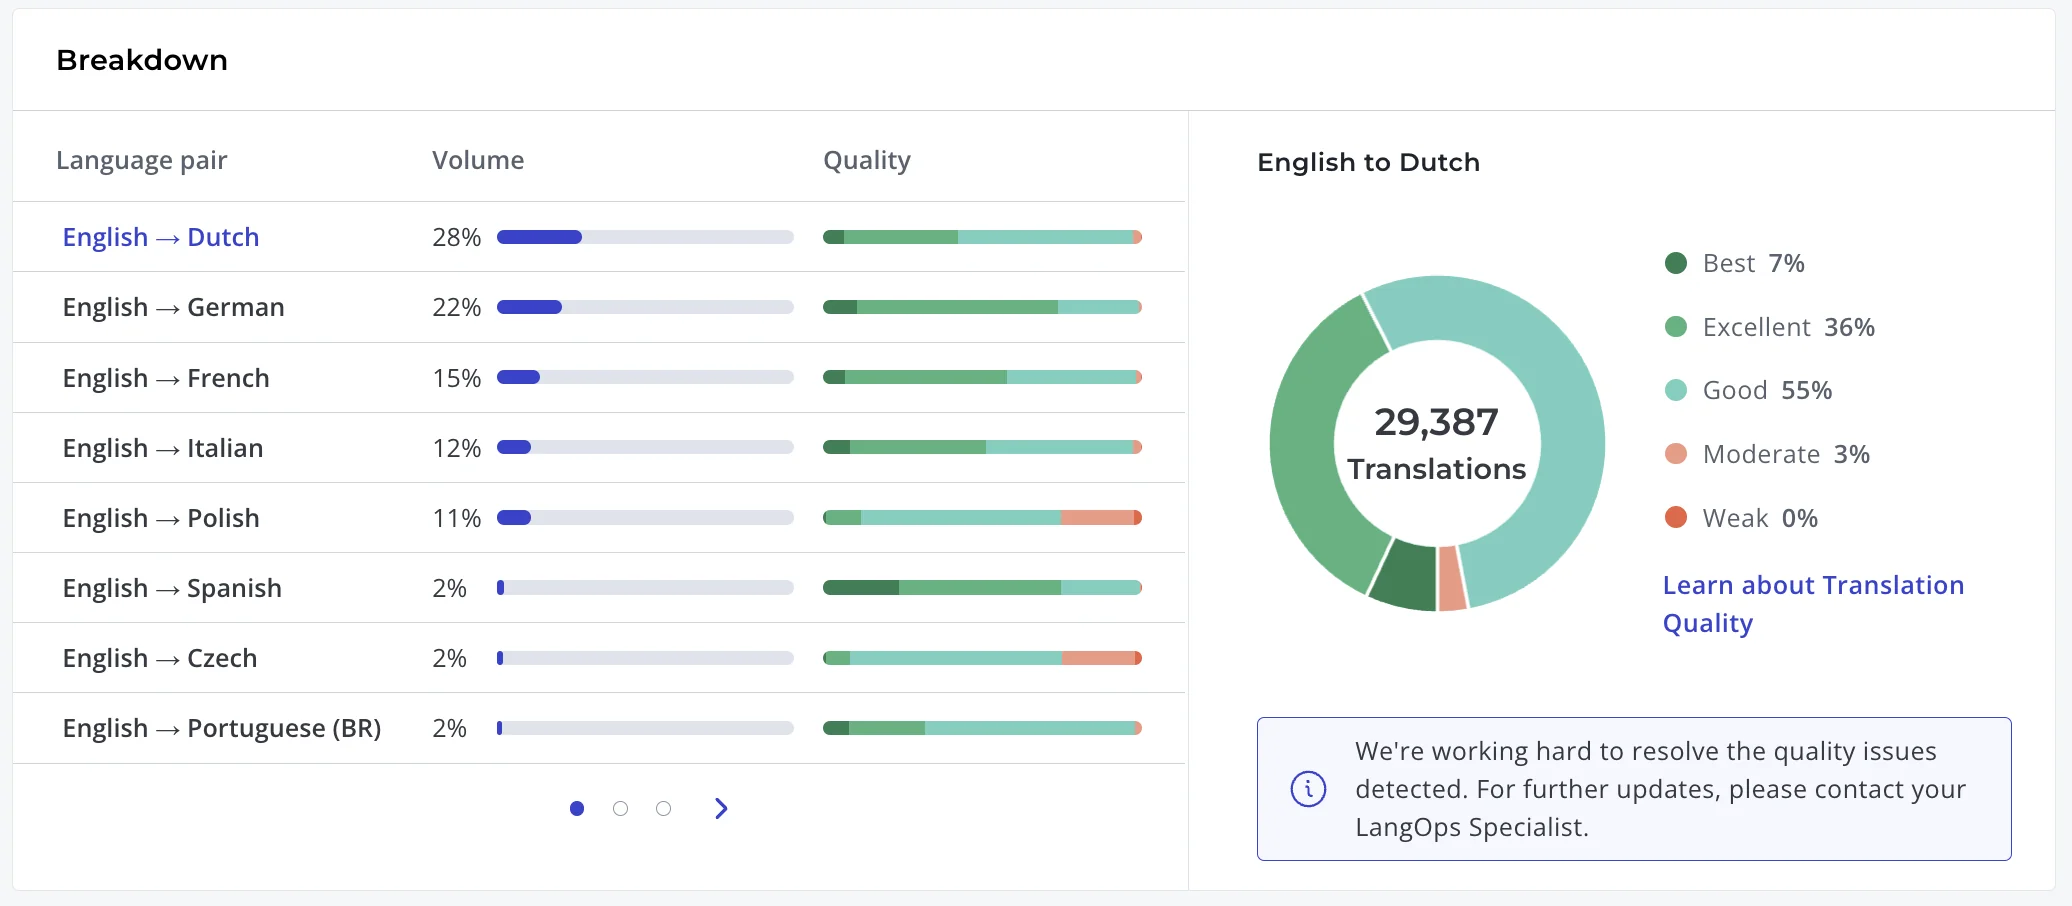
Esa vista por par es útil para el muestreo. Si inglés a polaco tiene claramente más traducciones Moderate que inglés a alemán, pon más de tus horas de revisión nativa en polaco el mes siguiente. Language I/O describe una supervisión de calidad en tiempo real frente a resultados pasados y reglas de glosario, y permite a los agentes marcar y regenerar una mala traducción, aunque no publica una escala de puntuación.
Lo que estos informes no pueden decirte: si la respuesta original era correcta. Una traducción perfecta de una respuesta errónea puntúa Best. La calidad de la traducción y la calidad del soporte son dos comprobaciones distintas, y necesitas ambas.
Cómo calibrar entre equipos de distintos idiomas
La calibración es donde los programas de QA multilingüe se mantienen unidos o se parten en islas. El objetivo es simple: un "4 sobre 5" de tu revisor de español tiene que significar lo mismo que un "4" de tu revisor de inglés.
Lo que funciona, según mi experiencia:
- Elige de 5 a 8 conversaciones al mes, al menos una por idioma. Usa una mezcla: una respuesta limpia, una con un error de política, una con un problema de tono.
- Todos puntúan las mismas conversaciones de forma independiente, mediante traducción si hace falta. Los revisores nativos también puntúan las filas solo de idioma de su idioma.
- Compara las puntuaciones línea por línea, no los totales. Un total coincidente puede ocultar a un revisor estricto con el tono y laxo con la precisión.
- Anota cada desacuerdo resuelto como un ejemplo en la rúbrica y lleva los problemas repetidos al coaching. "Usar du con un cliente B2B = fallo de tono, ver ticket 4821" vale más que un párrafo de definición.
- Sigue la dispersión por idioma a lo largo del tiempo. Si las puntuaciones de un equipo de idioma siguen desviándose, ese equipo necesita su propia sesión.
La puntuación de precisión de Zendesk QA es un buen modelo aquí: mide el acuerdo entre AutoQA y los revisores humanos, y Zendesk considera alto cualquier acuerdo superior al 75 % (AutoQA dashboard). Aplica la misma idea entre tus revisores humanos. Para dar el feedback resultante a los agentes, mis guías de ejemplos de feedback de QA y de feedback a agentes de soporte cubren la redacción.
El fallo contrario es igual de común: calificar una conversación que no está en inglés contra la redacción en inglés. Un agente bilingüe lo describió exactamente así:
"I got QA-ed that my Spanish questions were not close enough to the English script, deducted 7 points."
No había un guion en español. Las sesiones de calibración son donde se detecta ese tipo de regla y se reescribe como "coincide con la intención del guion, en español natural".
QA de respuestas de IA en otros idiomas
Si un agente de IA redacta o envía respuestas en otros idiomas, todo lo anterior sigue valiendo, más una regla: prueba cada idioma antes del lanzamiento, no solo el inglés.
La IA es muy buena en soporte multilingüe. En una prueba de eesel, una marca alemana de joyería con unos 1.000 tickets al mes en Zendesk y Shopify vio cómo su agente manejaba alemán, inglés, francés, neerlandés, español, polaco, croata y turco sin que nadie configurara un solo idioma. Esa es la ventaja. La desventaja es que cada idioma se convierte en una superficie en vivo de la que eres responsable, incluidos los que nadie de tu equipo lee.
La otra cara aparece cuando nadie revisa la salida en otros idiomas. Un administrador de Zendesk describió su antiguo bot de respuestas multilingüe:
"the translations were often times wrong and our customers got mixed languages during their chat with the bot, ID customers will sometimes get Portuguese, IN customers would sometimes get Indonesian, and so on and so forth."
Lo que comprobaría por idioma antes de activar el piloto automático:
- Las respuestas salen de tu conocimiento, no de conocimiento general. El mismo artículo del centro de ayuda debería producir la misma política en francés que en inglés. Si tu base de conocimiento multilingüe tiene huecos, la IA los hereda.
- La formalidad encaja con tu marca en cada mercado. Escríbelo como una regla ("usa Sie con todos los clientes alemanes") en lugar de esperar que ocurra.
- Los nombres de producto no se traducen. Una lista de no traducir pertenece a tus instrucciones. Mi guía del glosario de traducción muestra cómo.
- Sin marcadores, sin fragmentos en inglés, sin despedidas en el idioma equivocado. Esta es la que comprobaría primero, por las razones que di al principio.
Luego ejecútalo contra el historial. La simulación de eesel reproduce tickets pasados reales, puntúa cada respuesta y sugiere correcciones (eesel skills). Filtra esa ejecución a tus tickets en alemán y neerlandés y tendrás una lectura por idioma antes de que un solo cliente vea un borrador. Zendesk QA también puntúa automáticamente a los agentes de IA de Zendesk y te permite marcar otros bots para revisión (AI agents in Zendesk QA), lo que cubre el lado posterior al lanzamiento. Mi guía de Zendesk QA para agentes de IA profundiza más.
Errores comunes en el QA de soporte multilingüe
- Revisar solo mediante traducción. Detecta respuestas erróneas y pasa por alto todo lo que un cliente nativo percibe primero.
- Un revisor de inglés que "es dueño" de todos los idiomas pequeños. Bien para la precisión, ciego para el tono. Da a cada idioma un revisor nativo de muestreo, aunque sea a tiempo parcial.
- Copiar los saludos en inglés a todos los idiomas. Tus puntuaciones automáticas castigarán entonces a los agentes que localizan bien.
- Fiarse del campo de idioma detectado. A menudo se establece solo a partir del primer mensaje. Los tickets con idiomas mezclados acaban en el grupo equivocado.
- Tratar la calidad de la traducción como calidad del soporte. Una traducción impecable de la política equivocada sigue fallando al cliente.
- No versionar las macros entre idiomas. La deriva de políticas empieza el día en que alguien actualiza la macro en inglés y olvida las otras cinco. Un SOP de soporte con un responsable por idioma lo evita.
Prueba eesel para el soporte multilingüe
Si llevas el soporte en tres o cuatro idiomas, la carga de QA crece con cada mercado que añades. Por eso puse a eesel en mi lista de las mejores IA para soporte multilingüe.
El compañero de IA para helpdesk de eesel se conecta con Zendesk, Freshdesk y el resto de tu stack, responde en el idioma del cliente sin que tengas que traducir tu centro de ayuda, y acepta reglas en lenguaje natural como "usa Sie con los clientes alemanes" o "nunca traduzcas los nombres de nuestros productos". Antes de salir en vivo, reproduces tus propios tickets pasados en cada idioma y ves dónde se habría equivocado.

La mayoría de los equipos empiezan con borradores como notas internas, para que tus revisores nativos vean cada respuesta en otro idioma antes que un cliente, y pasan al envío automático por idioma cuando las puntuaciones se mantienen. Los planes empiezan en 299 $ al mes por 500 créditos, con prueba gratuita (eesel pricing). Prueba eesel primero en una cola de un solo idioma y mira cómo puntúa.