

¿Qué es el análisis de errores en atención al cliente?
El análisis de errores en atención al cliente es una revisión repetible de respuestas de soporte incorrectas o débiles, en la que cada fallo recibe una etiqueta de causa raíz, se cuentan las etiquetas y se corrige en su origen la causa más común. Funciona igual si la respuesta vino de un agente, de una macro o de un agente de IA.
El término viene del aprendizaje automático, donde es el paso que la gente se salta. Un comentarista de Hacker News lo dijo sin rodeos hace más de una década:
"3) Do error analysis/run diagnostics. Go to 1. It is the last step I find inexperienced people usually lacking. You need to examine your errors and find commonalities among them."

Esa es toda la idea. Una respuesta incorrecta es una anécdota. Cuarenta respuestas incorrectas clasificadas en grupos son una lista de tareas.
Es fácil confundirlo con el QA de soporte, así que así los separo:
| QA de soporte | Análisis de errores | |
|---|---|---|
| Pregunta que responde | ¿Qué tan buena fue la respuesta de este agente? | ¿Por qué fallan las respuestas y dónde? |
| Unidad de revisión | Un agente, una hoja de evaluación | Un fallo, una causa raíz |
| Muestra | Tickets aleatorios o asignados | Tickets que ya salieron mal (reaperturas, CSAT malo, escalaciones, borradores rechazados) |
| Resultado | Una puntuación y notas de coaching | Una lista ordenada de causas, cada una con un responsable |
| Quién lo corrige | El agente | Quien es dueño de la causa: el redactor de la base de conocimiento, el responsable de la política, el administrador de la IA, el equipo de producto |
El QA sigue importando. El análisis de errores es lo que haces con los fallos que encuentra el QA para que dejen de repetirse. Yo construyo agentes de IA en eesel, y la hora más útil de cualquier despliegue es aquella en la que alguien lee 50 tickets fallidos y anota por qué falló cada uno.
Por qué la mayoría de los errores de soporte no son culpa del agente
Cuando un cliente recibe una respuesta incorrecta, el instinto es buscar quién la envió. Pero si lees lo que dicen los agentes sobre sus propios errores, enseguida aparece un patrón: el agente trabajaba con información incorrecta.
"Yes..and they're always outdated never load.. and if you have questions the supervisor will always refer you back there and give you a bad review saying you must not have checked it."

Los cambios de política son el caso clásico. La actualización llega en un correo o en un canal de chat, y el artículo de la base de conocimiento no cambia:
"Emails get buried so fast man I swear I will find a important update like 3 days later after already giving wrong info to 10 customers. The knowledge base is good when they actually update it but half the time someone forgot to change the article"
Una respuesta incorrecta, diez clientes. Hacer coaching a ese agente no arregla nada, porque el siguiente agente leerá el mismo artículo obsoleto. En otro hilo, un agente describió cómo pedía ayuda por una pregunta sobre un descuento: el supervisor dijo 30 $ al mes, un compañero dijo que no había descuento, otro dijo la mitad, y un coach necesitó diez minutos para confirmar que era la mitad. Tres personas, tres respuestas. Eso es una fuente de verdad ausente, no un agente descuidado. Mi guía de gestión de cambios de política explica cómo frenar esto en el origen.
Los agentes de IA fallan igual, solo que más rápido. Cuando el bot de soporte de Cursor dijo a los usuarios que un cierre de sesión era una nueva política de "un dispositivo", Hacker News lo trató como una historia de alucinación de la IA. El cofundador de Cursor explicó la causa raíz real en el hilo:
"For context, this user's complaint was the result of a race condition that appears on very slow internet connections. The race leads to a bunch of unneeded sessions being created which crowds out the real sessions. We've rolled out a fix."
El bot no tenía ningún documento que explicara el error, así que explicó el síntoma con algo plausible. La respuesta incorrecta fue el último eslabón de una cadena que empezó con un error de producto que nadie había documentado. Si solo "arreglas la IA", pasas por alto la parte que realmente falló. Mi artículo sobre alucinaciones de la IA en soporte profundiza en ese patrón.
Y a veces el "error" ni siquiera es un error. Este es el desglose de esa prueba de comercio electrónico, donde los agentes podían enviar un borrador de eesel tal cual o reescribirlo. Solo el 12 % de los borradores salió sin cambios en 284 chats, lo que suena terrible hasta que ves el porqué:
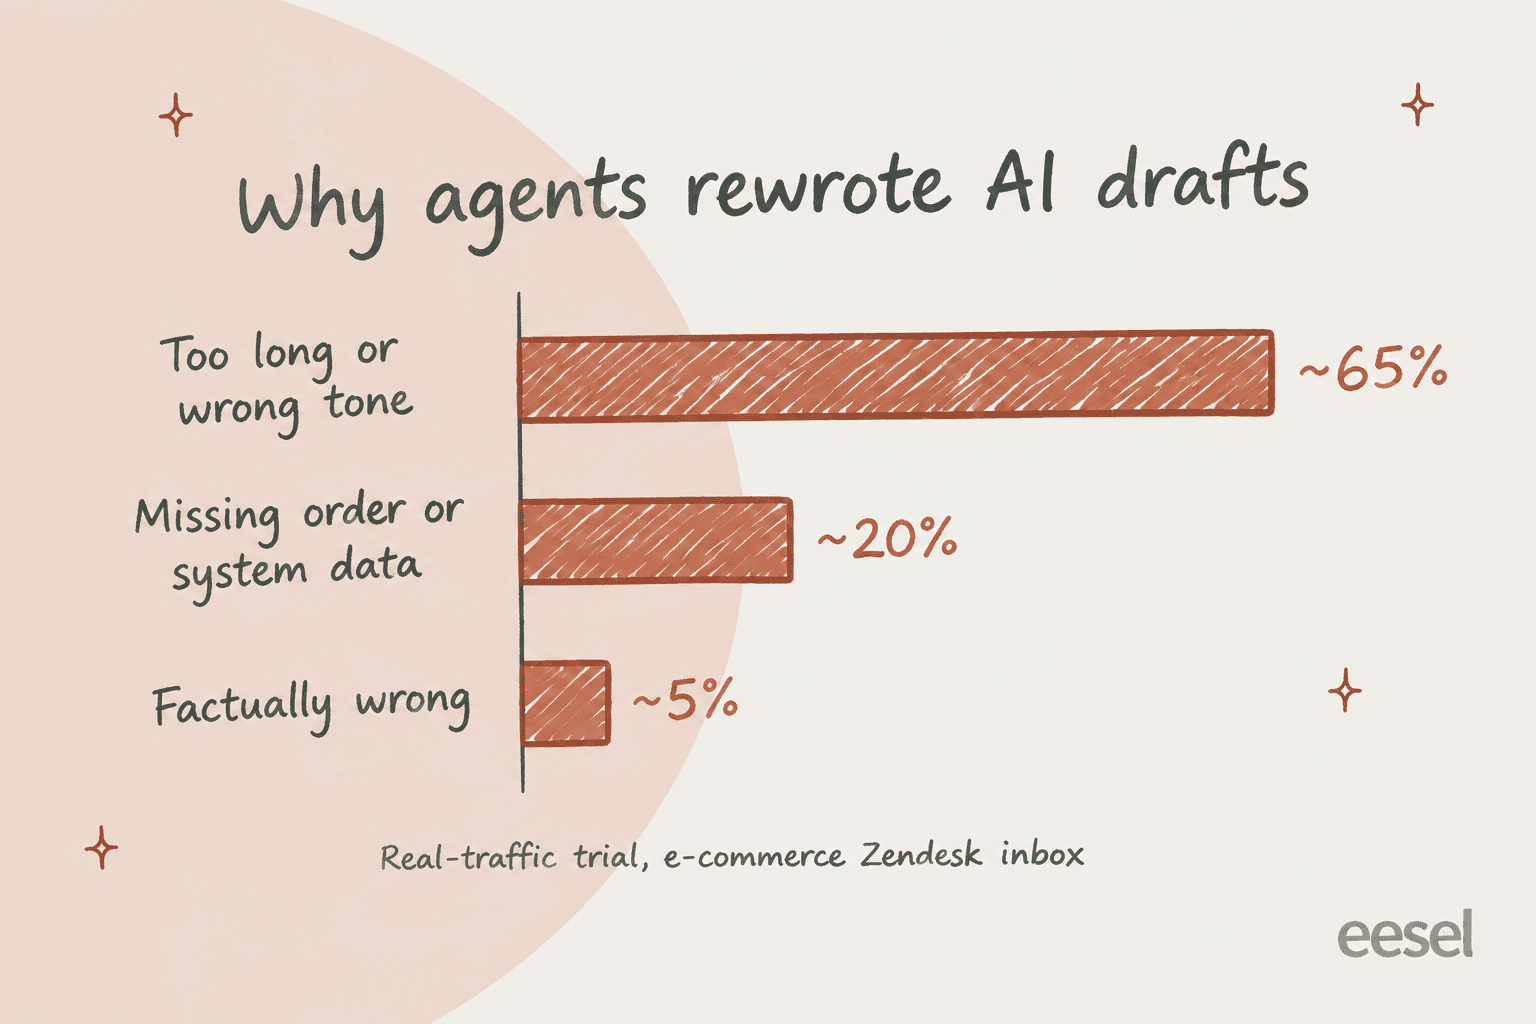
Los agentes solían convertir borradores de 8 a 15 frases en respuestas de 1 a 3 frases. La mayoría de las reescrituras eran un problema de estilo, que se resuelve entrenando con las respuestas enviadas del propio equipo y con una voz de marca para la IA clara. Alrededor de una quinta parte necesitaba datos de sistemas que aún no estaban conectados. El "problema de precisión" era sobre todo un problema de longitud y de acceso a datos. Para eso sirve exactamente el análisis de errores: evita que pases un mes reescribiendo artículos de ayuda cuando la solución real es "mantenlo en tres frases" y "conecta el sistema de pedidos".
Los seis lugares donde falla una respuesta de soporte
Toda respuesta incorrecta tiene un primer fallo. El truco es detenerse en el primero, porque todo lo que viene después es una consecuencia. Si la IA tomó el artículo equivocado, da igual que la respuesta además fuera demasiado larga.
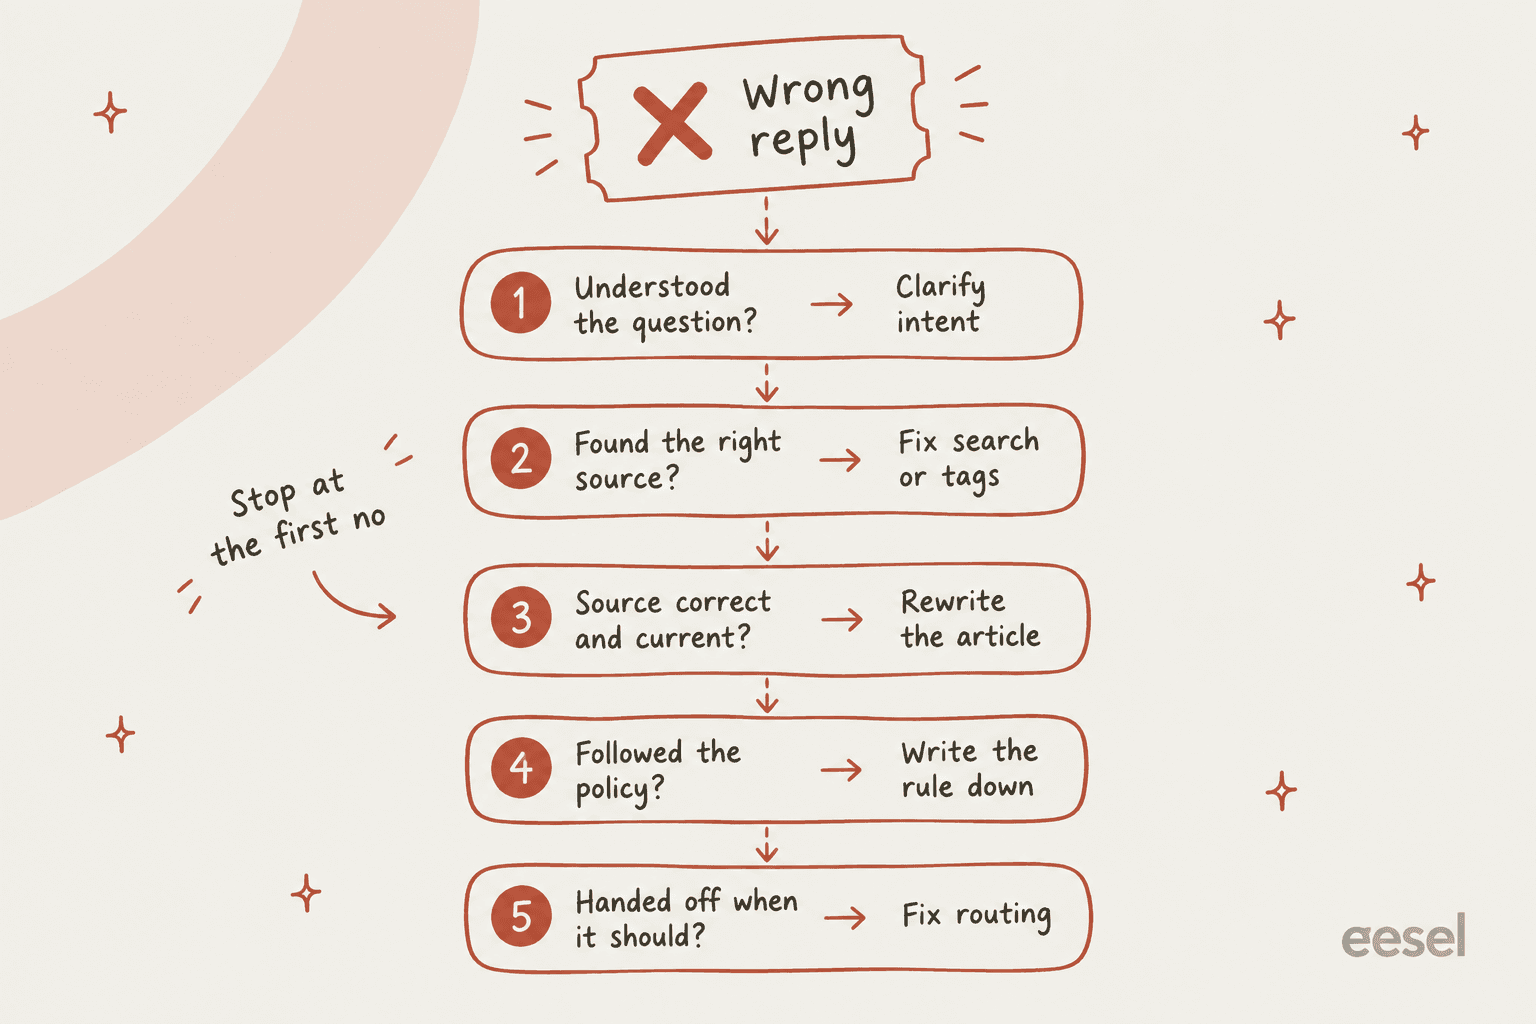
Uso seis grupos: los cinco puntos de control de arriba más un sexto para respuestas que son correctas pero no calan. Elige un grupo para ver cómo es, cómo detectarlo y quién lo corrige.
Fíjate en que solo el primer grupo trata de cómo se leyó la pregunta. Los grupos dos a cinco son sobre conocimiento, reglas y enrutamiento, cosas que un responsable de soporte puede cambiar una vez y arreglar para todos. Por eso el análisis de errores da resultados más rápido que hacer coaching a personas: la corrección de un artículo puede frenar el mismo error en todos los agentes y en la IA a la vez.
Cómo hacer un análisis de errores en atención al cliente en 7 pasos
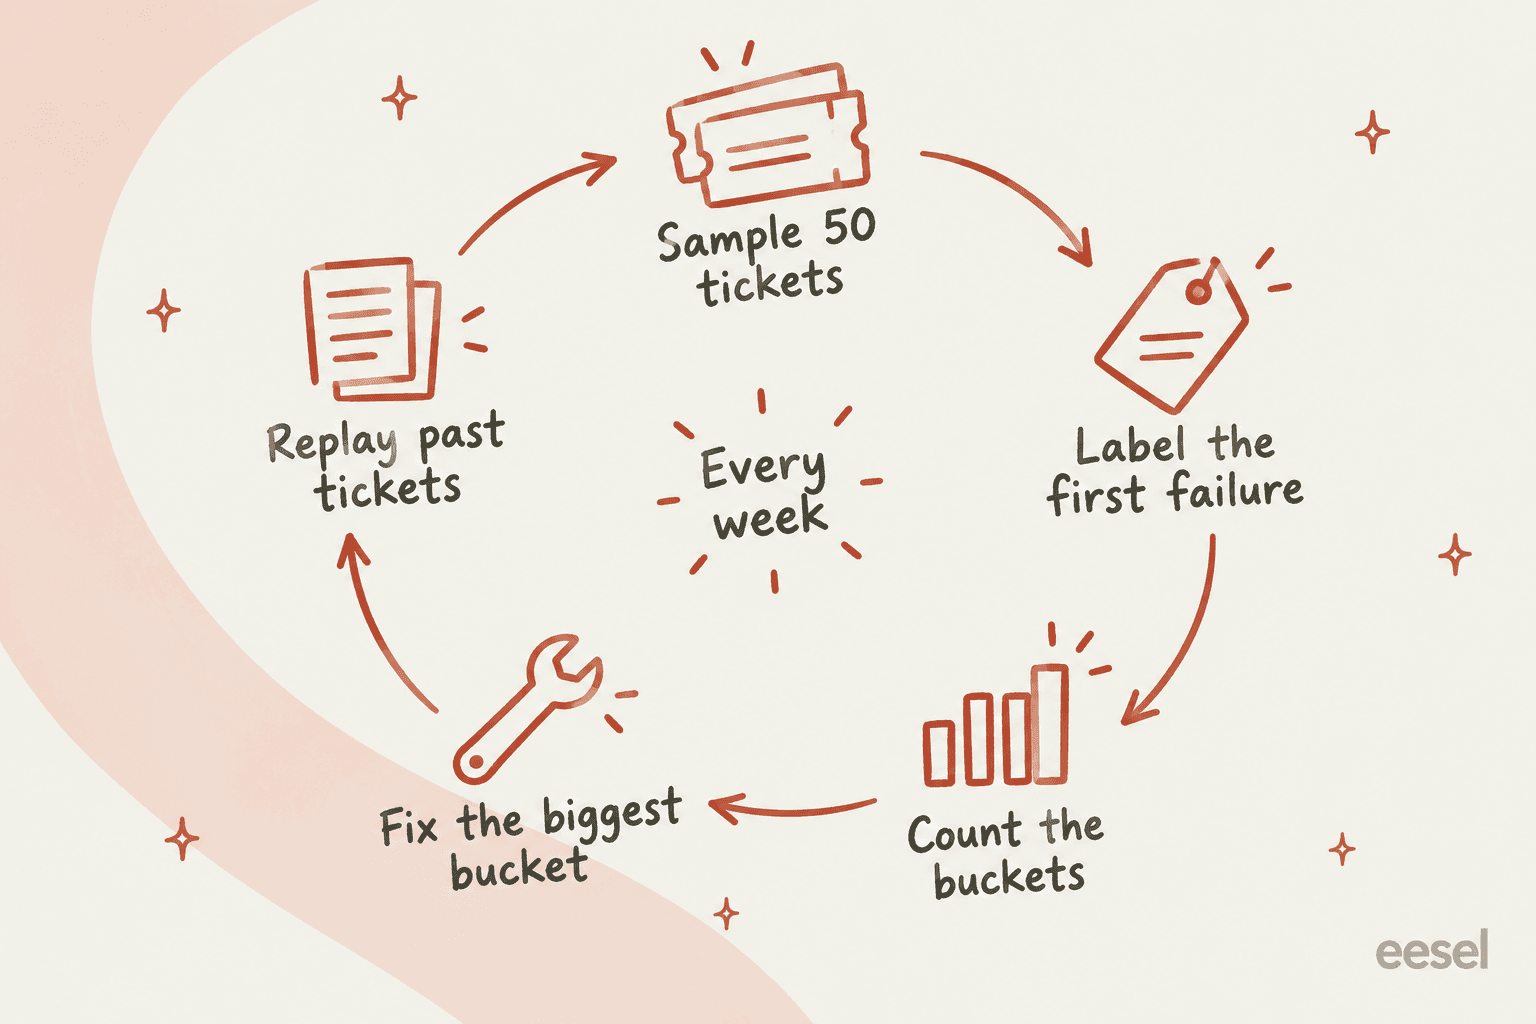
Puedes hacer tu primera pasada en unas dos horas. Después, es un hábito semanal de 30 minutos.
- Extrae los fallos, no una muestra aleatoria. Tickets reabiertos, CSAT malo, escalaciones desde la IA, tickets en los que un agente rechazó o reescribió un borrador de IA y contactos repetidos en pocos días. Zendesk Explore tiene métricas de Reopens y One-touch tickets para esto, y mi guía sobre la métrica de tickets reabiertos muestra cómo filtrarlos.
- Toma 50. Menos, y una semana rara lo distorsiona todo. Más, y nadie termina. Si tu volumen es bajo, toma todo lo del último mes.
- Lee cada uno y etiqueta el primer fallo. Usa los seis grupos de arriba. Una etiqueta por ticket. Si no puedes decidir en 30 segundos, etiquétalo "poco claro" y sigue.
- Cuenta los grupos. Este es el paso que cambia opiniones. "La IA es mala" se convierte en "14 de 50 eran el mismo artículo obsoleto de devoluciones".
- Corrige el grupo más grande en su origen. Reescribe el artículo, escribe la regla en tus SOP de soporte, cambia el enrutamiento. Da a cada corrección un responsable y una fecha.
- Vuelve a ejecutar tickets pasados para comprobar la corrección. Pasa el mismo tipo de pregunta por tu agente o tu IA y mira si cambió la respuesta. No esperes sin más a los tickets de la semana que viene.
- Repite cada semana y sigue la mezcla de grupos. Un programa sano ve encoger el grupo principal y que otro nuevo ocupe su lugar.
El primer paso es donde la mayoría de los equipos fallan sin darse cuenta, porque la métrica obvia miente. Un ticket que la IA "resolvió" puede seguir siendo un fallo:
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
La propia documentación de HubSpot dice lo mismo: las deflexiones "do not always indicate resolution", ya que un cliente puede simplemente irse (base de conocimiento de HubSpot). Así que cruza las conversaciones del bot con los tickets de seguimiento del mismo cliente antes de fiarte de cualquier tasa de resolución. Mi artículo sobre cómo medir la deflexión con IA cubre ese cruce.
Para el paso cuatro, al principio basta un simple recuento. Un responsable de TI en Reddit describió justo esto: contar cuántos tickets se vinculan a la misma causa y unir los puntos, sin obligar al equipo a pasar por unos "5 porqués" completos cada vez. Cuando los grupos sean estables, pásalos a tu helpdesk como etiquetas o causas raíz de QA para que el recuento se haga solo. Mi guía de análisis de tickets de soporte tiene una plantilla para la hoja de recuento.
Cómo analizar los errores de un agente de soporte con IA
El análisis de errores en un agente de IA es más fácil que en personas en un aspecto importante: la IA puede mostrar su trabajo. Puedes ver qué buscó, qué encontró y por qué eligió su respuesta. Eso nunca lo conseguirías de un agente humano al final de un turno largo.
El problema es que de verdad hay que leerlo. Un comentarista de Hacker News que construye agentes defendió hacerlo a mano, incluso cuando tienes puntuación automática:
"there's still a huge benefit in looking at traces yourself and labeling them. It's time-consuming, yes, but you'll learn a lot about the ways an agent fails in your particular domain, it gives you more reliable golden datasets, you have a mechanism to evaluate your judges, etc."
Al leer trazas de IA, los seis grupos siguen aplicando, pero la evidencia se ve distinta:
- Pregunta malinterpretada: la intención o el caso de uso que declara la IA no coincide con la pregunta del cliente.
- Fuente equivocada: la lista de fuentes muestra un artículo cercano pero incorrecto.
- Fuente mala o ausente: la IA citó el artículo correcto y el artículo es incorrecto, o no encontró nada y respondió igualmente. Esa segunda es la versión peligrosa. Cuando la recuperación devuelve vacío, un modelo puede rellenar el hueco con conocimiento general. En una configuración de eesel para un equipo de telemática de vehículos en Zendesk, el bot confirmó el soporte de modelos de coche que no estaban en la base de datos del producto, porque el centro de ayuda decía "soportamos todos los modelos".
- Política no seguida: la regla existe en la cabeza de tu equipo pero no en las instrucciones de la IA.
- Debió traspasarse: la conversación tocó un tema de tu lista de traspasos, o debió estar en ella, y siguió adelante. Mi guía de traspaso de la IA cubre qué debe ir en esa lista.
Una advertencia por experiencia: no saltes directamente a cambiar de modelo. Simon Willison preguntó en HN lo correcto: si cambias de modelo sin evaluaciones, "how will you tell if the model switch actually helped?" Y a menudo el modelo ni siquiera es el problema. Otro comentarista señaló que los equipos que culpaban al LLM descubrieron que la verdadera causa eran "upstream calls to services that produce data". En términos de soporte: la consulta del pedido no devolvió nada, así que la IA adivinó. Ese es el grupo del 20 % de la prueba anterior.
Si tu IA redacta borradores para los agentes en lugar de responder directamente, cada borrador rechazado o reescrito es un dato gratuito para el análisis de errores. Trata la edición como una etiqueta. Mi guía sobre cómo entrenar a un agente de soporte con IA cubre cómo devolver esas ediciones al sistema.
Qué muestra cada helpdesk cuando una respuesta falla
Todos los helpdesks principales ofrecen ya alguna forma de ver por qué su IA respondió como lo hizo. Difieren mucho en lo que muestran y en si puedes probar una corrección contra tickets pasados.
| Helpdesk | Dónde ves el "porqué" | ¿Fuentes mostradas por respuesta? | Códigos de motivo integrados | ¿Probar una corrección contra el historial? | Requisito | Fuente |
|---|---|---|---|---|---|---|
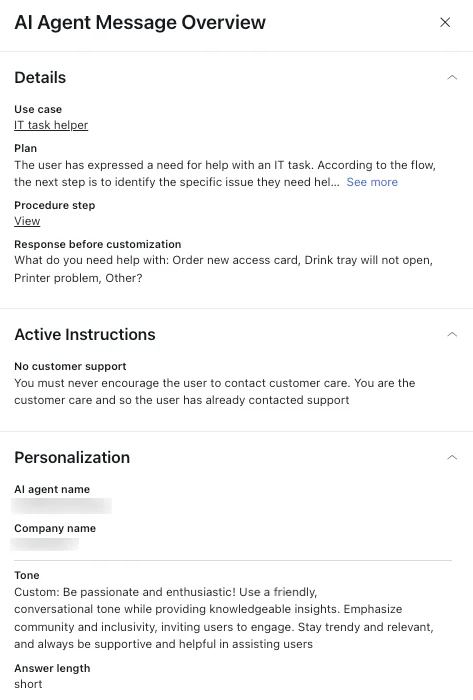
| Zendesk | Registros de conversación: por mensaje Plan, Response before customization, instrucciones activas | Por conversación (Resources used), no por artículo en respuestas de conocimiento simples | Resoluciones personalizadas incl. Unresolved, Escalation failed; causas raíz de QA con niveles | No documentado en bloque | Registros en todos los planes Suite; QA requiere el complemento QA o WEM | Documentación de Zendesk |
| Freshdesk | AI Agent Studio Analyze: pestaña Improve, Knowledge usage, Ticket logs | Answer Source en pruebas; recuentos por fuente de respuestas y comentarios | Tipos de Improve: New content, Edit content | Pestaña Test: hasta 100 consultas escritas o generadas | Growth, Pro, Enterprise | Documentación de Freshdesk |
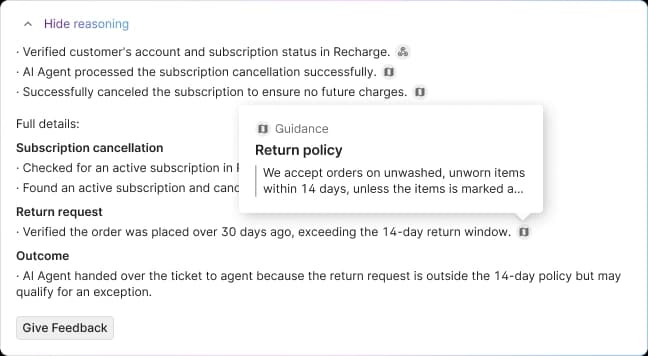
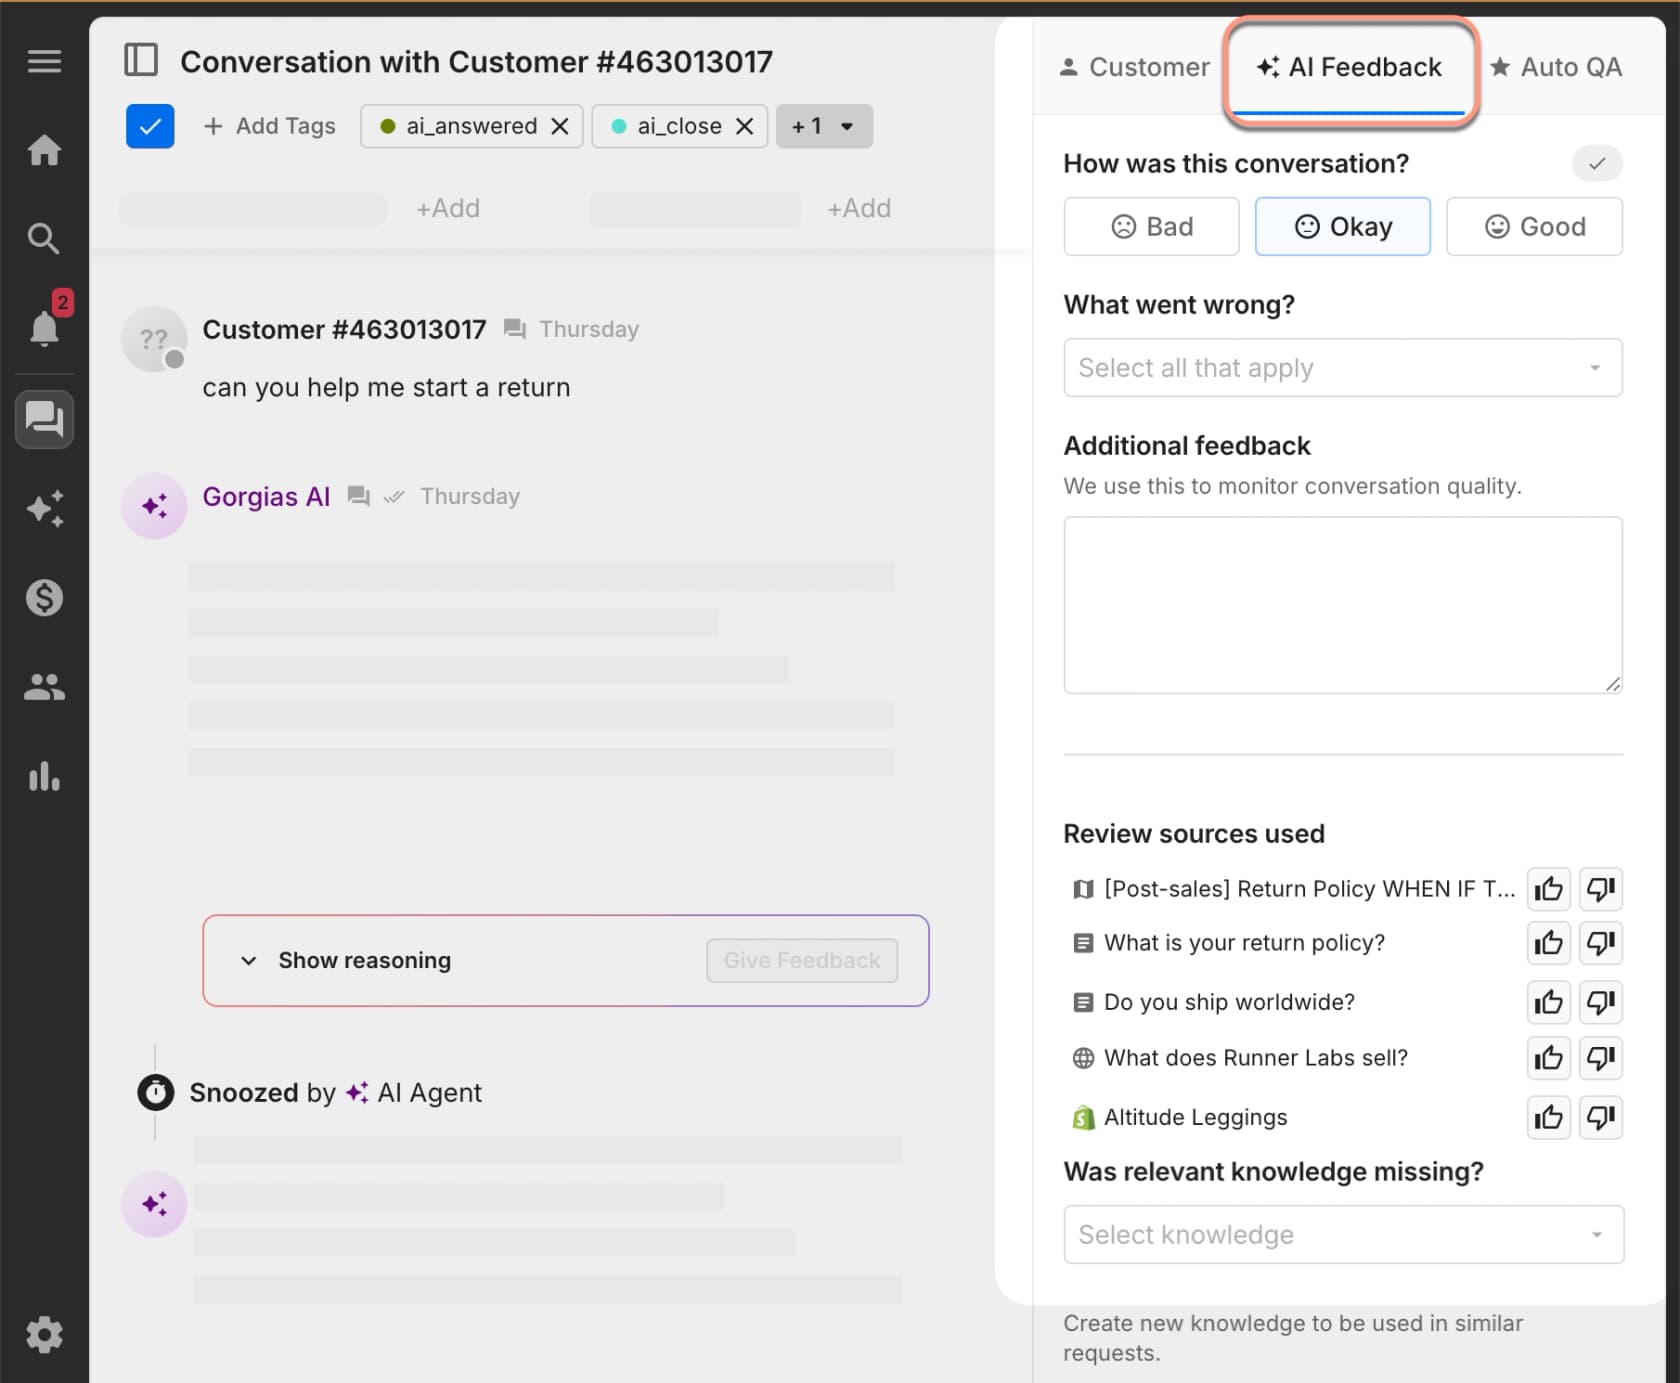
| Gorgias | Show reasoning bajo cada mensaje de la IA; pestaña AI Feedback | Sí, con pulgar arriba o abajo por fuente | Desplegable "What went wrong"; 3 motivos de traspaso; Opportunities: Fill knowledge gap, Resolve conflict | Un ticket existente cada vez | El feedback requiere Lead o Admin | Documentación de Gorgias |
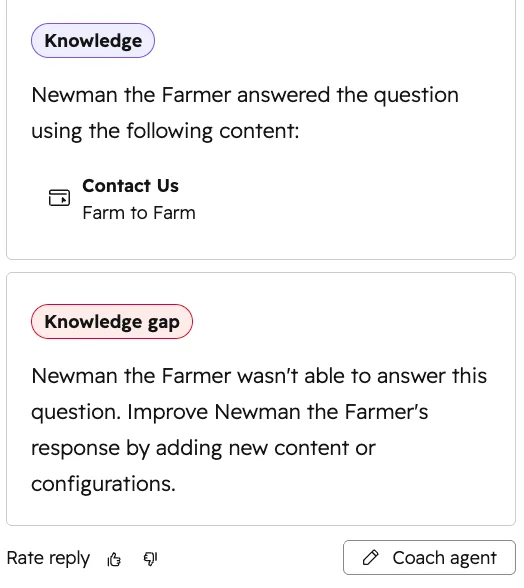
| HubSpot | Coaching opportunities; agent insights en Help Desk | Sí, fuentes de conocimiento citadas por respuesta | Reason: Knowledge, Handoff, Experience, Action, Other | No documentado | Pro o Enterprise más HubSpot Credits | Documentación de HubSpot |
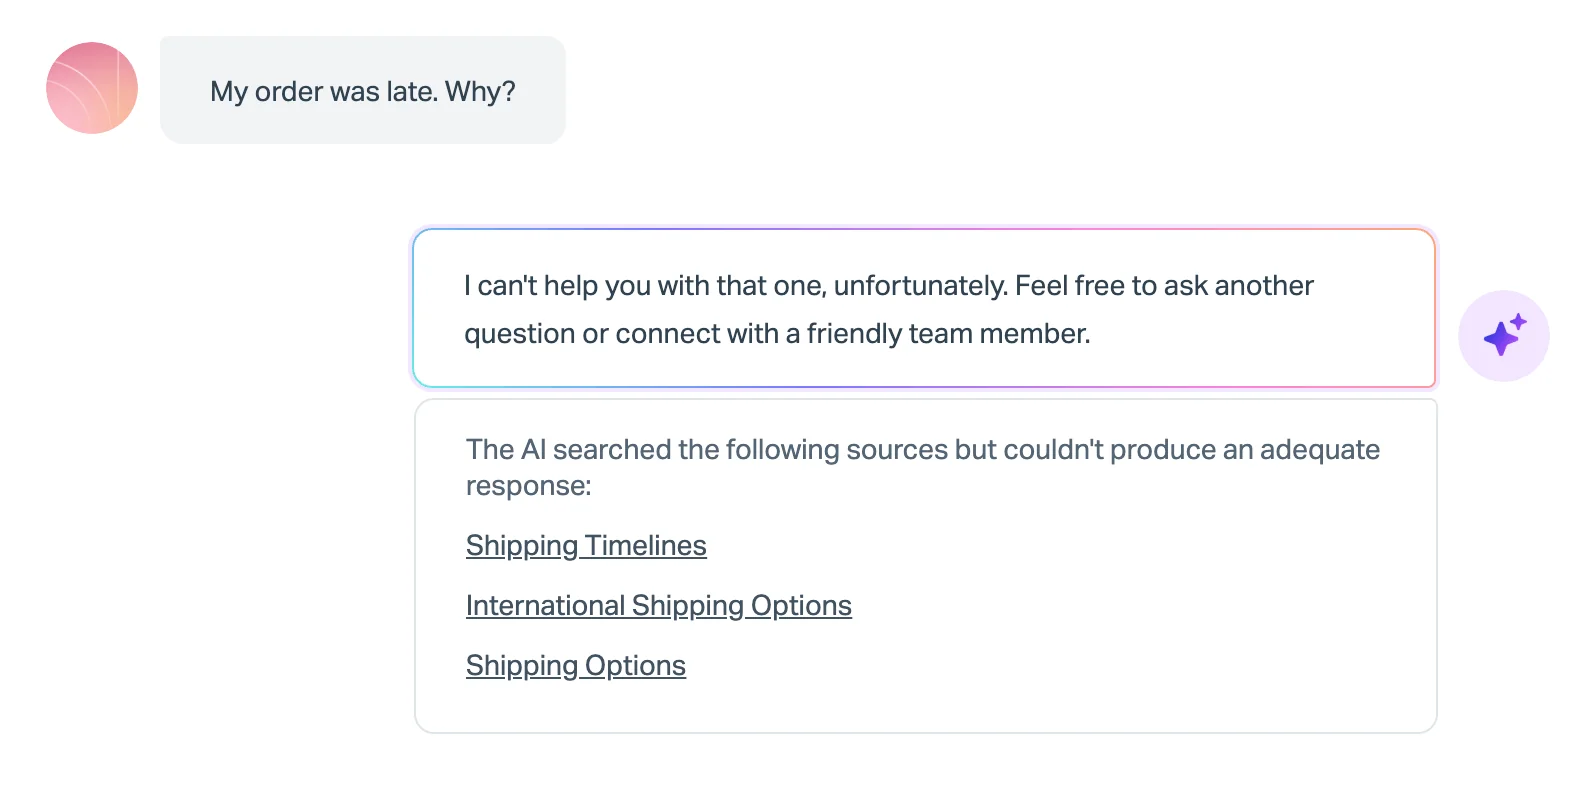
| Help Scout | Pestaña Beacon Sessions, Improvements | Solo cuando la IA falla o pide aclaración (Attempted Sources) | Contact helped, Contact not helped, Human escalation | No documentado | Todos los planes de pago, $0.75 por resolución de IA | Documentación de Help Scout |
| Front | Centro de respuestas de IA (AI replies hub) | Sí, con el extracto exacto de cada fuente | No documentado para traspasos de IA | Una conversación existente cada vez | Complemento Copilot o Autopilot; Smart QA $20/seat/month | Documentación de Front |
Todas las funciones y requisitos se comprobaron en la documentación de cada proveedor en octubre de 2026.
La vista a nivel de mensaje de Zendesk es la más detallada para sus procedimientos generativos. El campo Plan muestra el razonamiento de la IA, y Response before customization muestra el texto antes de aplicar tu personalidad e instrucciones, lo que te dice si una mala respuesta vino del razonamiento o de tus ajustes de tono:
Gorgias hace legible el razonamiento para cualquier rol, lo que importa más de lo que parece. Cuando los agentes pueden ver por qué la IA traspasó o respondió, pueden informar de la causa en lugar de solo "el bot se equivocó":
HubSpot etiqueta cada respuesta de la IA con lo que usó, o la marca como una laguna de conocimiento. Esa etiqueta es básicamente el grupo tres, ya hecho por ti:
Help Scout solo muestra fuentes cuando la IA falla, pero para el análisis de errores ese es el momento en que las necesitas. Una respuesta que buscó en tres artículos de envíos y aun así no pudo responder "mi pedido llegó tarde, ¿por qué?" apunta a un artículo ausente, no a un mal modelo:
La tabla Knowledge usage de Freshdesk es la mejor vista integrada para el grupo dos. Cuenta cuántas veces se usó cada fuente en respuestas del bot, junto a los comentarios positivos y negativos. La propia pauta de Freshdesk es que una fuente citada con frecuencia y con una proporción alta de negativos frente a positivos es tu principal objetivo de revisión de contenido:
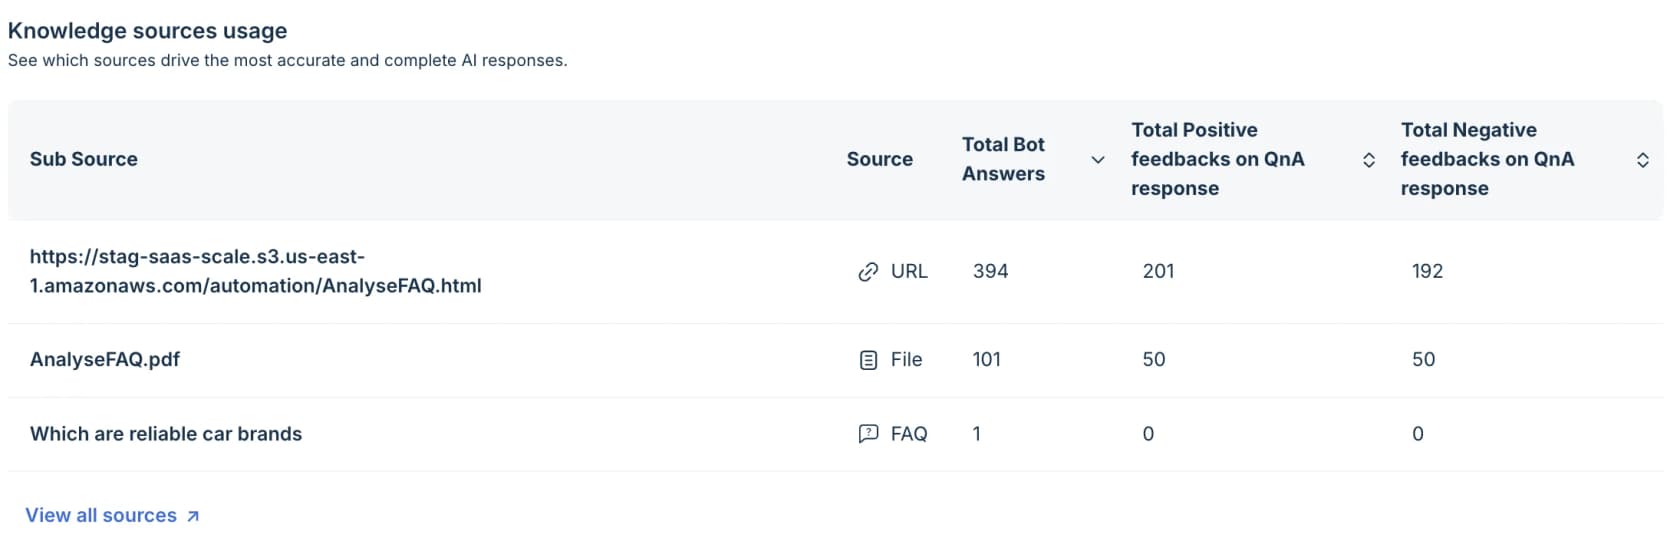
Dos cosas que debes saber antes de apoyarte en cualquiera de estas. Primero, el Root Cause Analysis de Freshdesk, a pesar del nombre, explica los picos de volumen de tickets con un mapa de árbol, no respuestas incorrectas individuales, y es solo para Enterprise. Segundo, la columna de "probar una corrección" es el punto débil en todos. Gorgias y Front te permiten volver a ejecutar un ticket existente cada vez, y Freshdesk prueba preguntas escritas o generadas. Eso sirve para comprobaciones puntuales, pero no te dirá si la corrección de la semana pasada movió la tasa de errores en 50 tickets reales.
Dónde registrar las causas raíz para poder contarlas
Leer trazas encuentra la causa. Contar requiere que la causa se guarde en algún sitio sobre el que puedas informar. Estos son los mejores lugares integrados que he encontrado.
Causas raíz de Zendesk QA. Los revisores pueden añadir una causa raíz opcional al puntuar una categoría, elegida de una lista que defines, organizada en niveles y subniveles, y reportada en paneles. Está pensada para valoraciones negativas, que es justo la muestra del análisis de errores. Requiere el complemento QA o WEM. Mi resumen de Zendesk QA y la guía de criterios de scorecard cubren la configuración.
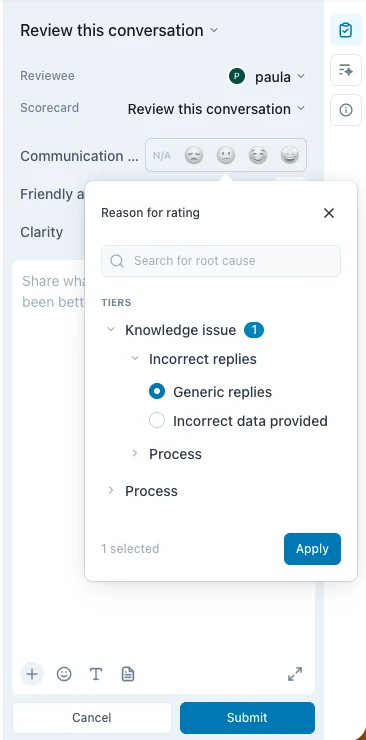
Yo configuraría niveles que coincidan con los seis grupos, con subniveles para tus casos más comunes ("Fuente mala o ausente > Devoluciones", "Fuente mala o ausente > Envíos"). Zendesk QA también puntúa agentes de IA en scorecards y tiene un panel BotQA para tasas de escalación y repetición del bot, aunque solo admite bots instalados desde el Zendesk Marketplace.
Coaching opportunities de HubSpot. Cada una lleva un Reason (Knowledge, Handoff, Experience, Action, Other) y un Type, que incluye Knowledge gap, Knowledge conflict y "Flagged by Help Desk rep". Es el conjunto más completo de códigos de motivo integrados que he encontrado, y encaja bien con los grupos tres y cinco.
AI Feedback de Gorgias. Ante una valoración Bad u Okay, los leads eligen de una lista "What went wrong", dan pulgar arriba o abajo a fuentes individuales y pueden señalar el conocimiento que debió usarse:
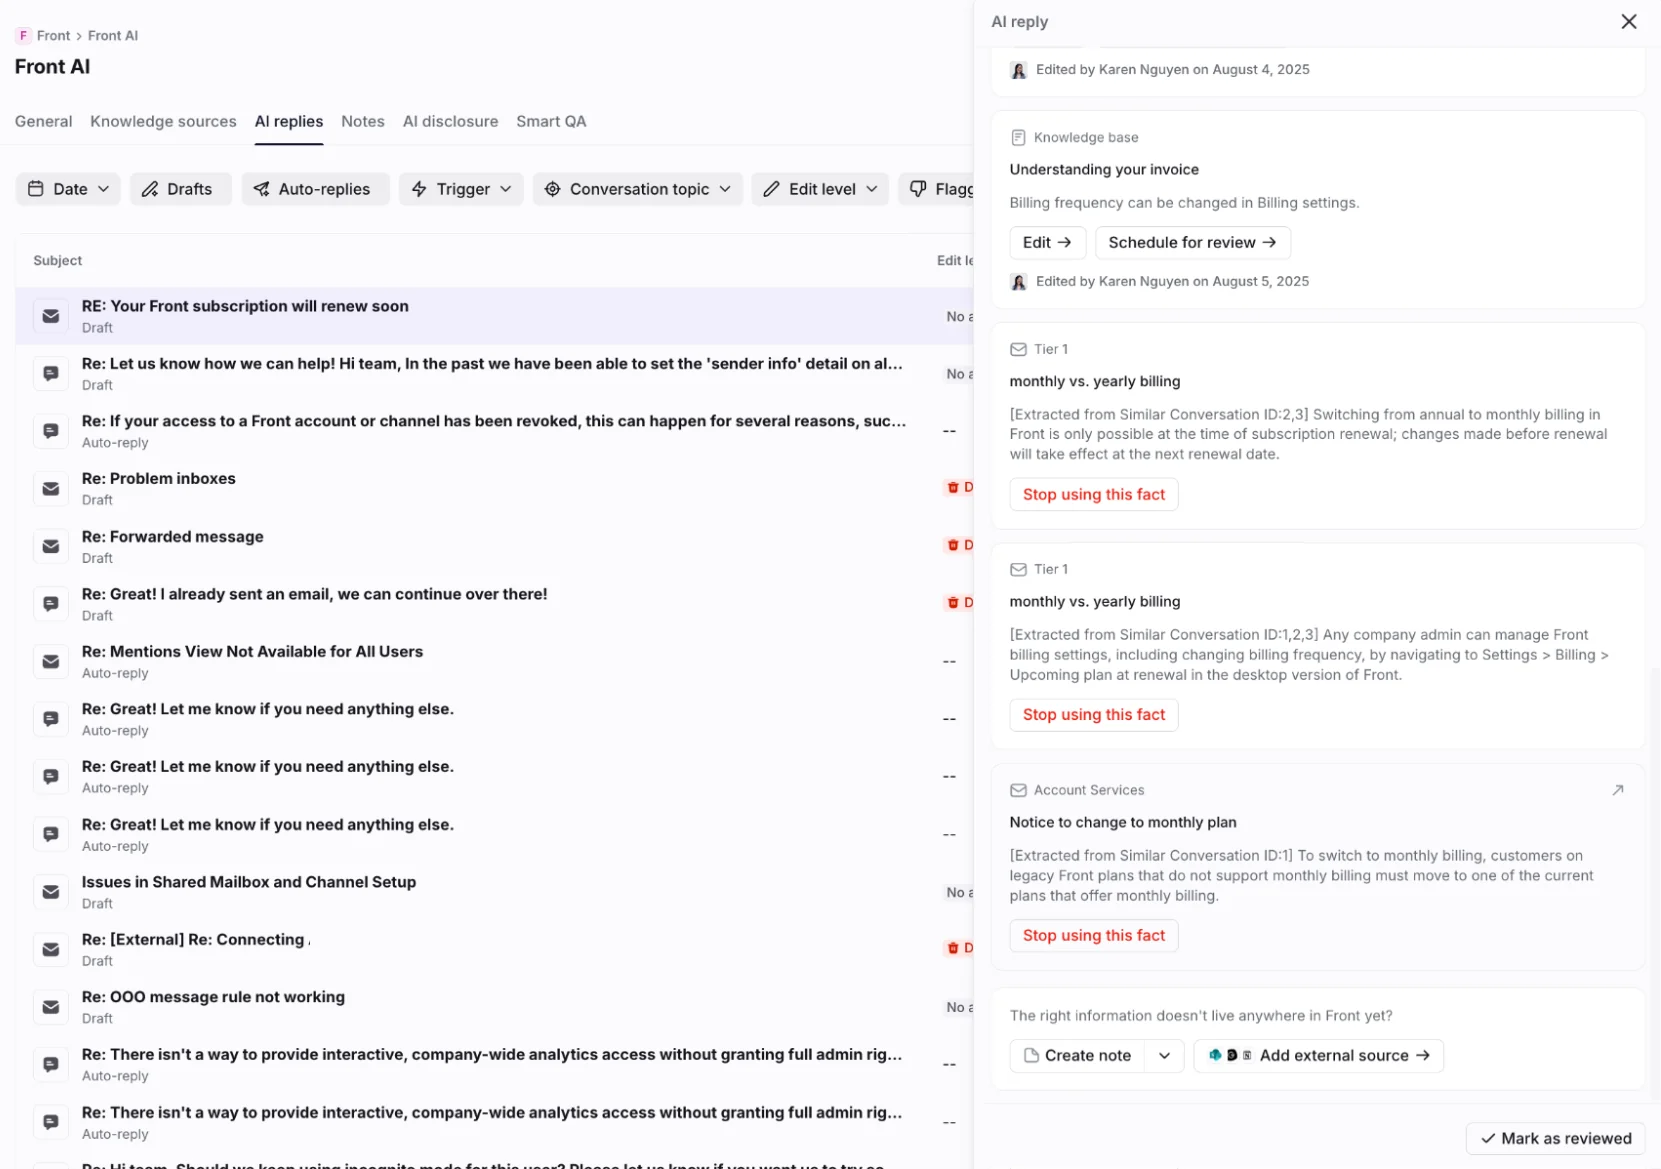
Centro de respuestas de IA de Front. No es un código de motivo, pero es el camino de corrección más rápido que he visto: cada fuente detrás de una respuesta, con el extracto exacto, y acciones en línea Edit, "Stop using this fact" y Create note.
Si tu helpdesk no tiene nada de esto, una etiqueta de ticket por grupo funciona bien. Mantén la lista corta. Seis etiquetas se usan; treinta se ignoran. Mi guía de etiquetado de soporte con IA muestra cómo aplicarlas sin añadir clics a los agentes.
Corrige el sistema, no a la persona
El análisis de errores solo funciona si la gente te cuenta los errores. Eso se acaba en cuanto se convierte en una forma de pillar a la gente. Los agentes tienen claro cómo se siente eso:
"Hold hands up it was something I missed (or didn't consider) but the complaint feedback was otherwise good so it stung to get a fail rather than a learning and fix it"
A veces la propia métrica es la causa raíz. Un agente describió que lo penalizaban por esperas de más de tres minutos, cuando confirmar la respuesta correcta lleva tres minutos o más:
"If I put them on hold that long, some get annoyed or escalate. Either way, I'm doomed: penalized if you placed the caller on hold for more than 3 mins or returned back to the caller and tell them you needed more time."
Si un objetivo empuja a la gente a responder antes de comprobar, las respuestas incorrectas son el resultado previsible. Pon "el KPI" en tu lista de grupos cuando aparezca. Mi artículo sobre KPI de servicio al cliente cubre cuáles resultan contraproducentes.
Nada de esto significa que nadie rinda cuentas. La distinción que me gusta viene de un hilo sobre revisiones sin culpa: las personas "still held to account for their decisions and actions but are not blamed for their results." Un agente que se saltó el artículo debe enterarse. Un agente que siguió un artículo incorrecto debe recibir un agradecimiento por encontrarlo.
Cómo es un buen ciclo en la práctica, según un agente cuyo equipo lo hace bien:
"But where I work if an agent finds inaccurate information, requests information, or has figured something out that isn't in KB all we have to do is send a message to our supervisor and they pass it along to our head of sales, and the next day KB is updated."
Actualizaciones de la base de conocimiento al día siguiente. Ese es el objetivo. Combínalo con una auditoría de la base de conocimiento periódica y un análisis de lagunas de conocimiento, y usa sesiones de feedback a agentes para los errores que realmente son individuales.
Lo mismo vale para una IA. Un comentarista de HN dijo, sobre el error de un representante humano, que quería "better training/docs so it doesn't happen again", no que despidieran a nadie. Trata a la IA igual y canaliza los errores humanos repetidos hacia el coaching en lugar de amonestaciones.
Cómo gestiona eesel el análisis de errores
Yo construyo agentes de IA en eesel, así que seré concreto sobre lo que hace y lo que no hace el nuestro aquí.
Muestra su trabajo en cada ticket. Cada ejecución en la página Activity de eesel muestra dónde ocurrió, qué la desencadenó, qué fuentes buscó, qué hizo, su razonamiento paso a paso y si encontró una laguna de conocimiento. En Zendesk, cada borrador nombra sus fuentes. Así que etiquetar una respuesta incorrecta requiere un clic en la ejecución, no adivinar.

Las correcciones se convierten en reglas. Cuando una respuesta es incorrecta, le dices qué estaba mal, en el ticket o en el chat, y escribe la corrección en sus propias instrucciones, o edita la regla existente si ya hay una que lo cubre. Un administrador de Zendesk le enseñó una corrección del grupo de políticas en dos líneas: "I have a rule in CS where we do not address a cancel or refund request when there is an issue attached to it." Después, en el siguiente borrador: "This is incorrect. You have not provided troubleshooting steps yet." Esa regla se aplica ahora a todos los tickets futuros, no solo a ese.
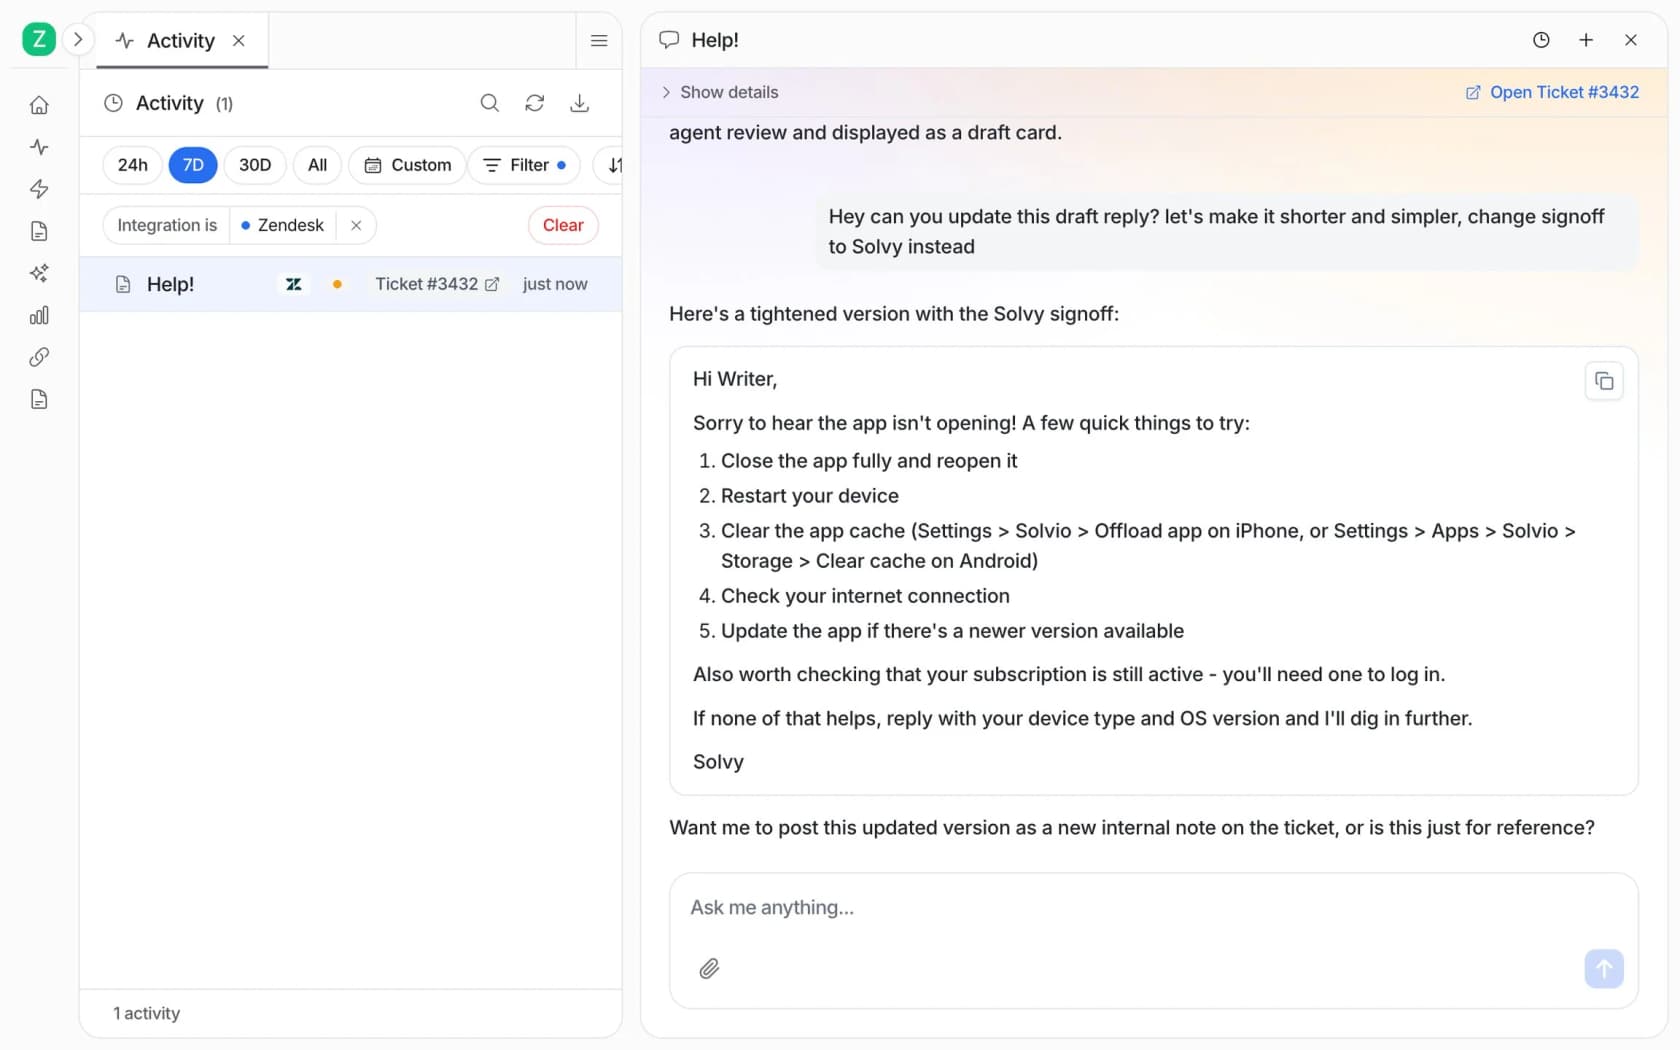
Encuentra el patrón por ti. La skill "Analyze and improve replies" examina lo que tu equipo rechazó o editó, encuentra el patrón y sugiere correcciones. Esos son los pasos tres a cinco del método anterior, ejecutados sobre tus propios datos.
Reproduce tickets pasados reales. La skill de simulación ejecuta tu agente contra tickets reales ya resueltos, compara cada respuesta con lo que tu equipo envió realmente, la puntúa por tema de ticket y sugiere cambios en las instrucciones. En el ejemplo de la documentación con 20 tickets, 17 igualaron la calidad de respuesta del equipo, y el informe encontró que la brecha real no era la redacción sino las acciones de los agentes, como revisar un registro o escalar a ingeniería:
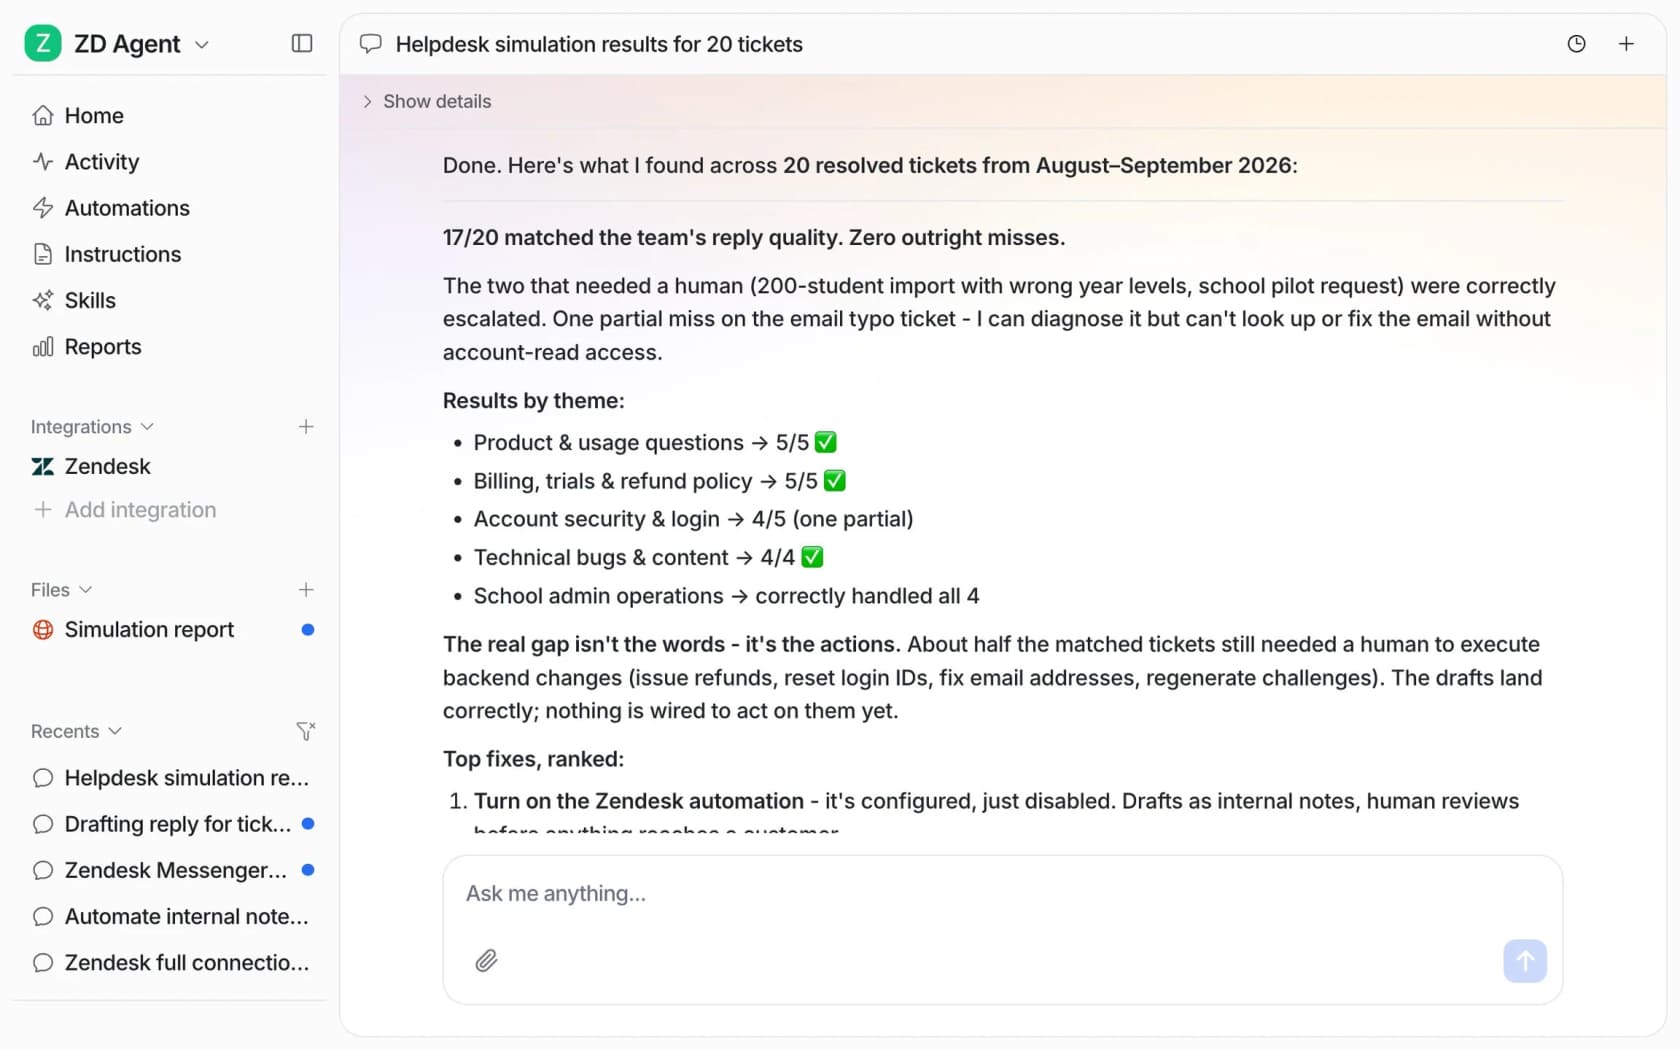
Ese es el paso que nunca me saltaría. Es la única forma que conozco de comprobar que una corrección funcionó en decenas de tickets reales antes de que los clientes la vean. Y si tu equipo trabaja desde una terminal o con scripts, la CLI de eesel te permite corregir al agente e imprimir sus reglas actuales desde la línea de comandos, de modo que un agente de código también pueda hacer la revisión semanal.
Lo que no es: un sustituto de una hoja de QA para tus agentes humanos. Su CSAT de IA es la valoración que una IA da a las respuestas, no feedback de clientes, y yo mantendría en marcha tu programa de QA humano en paralelo. Mi resumen de herramientas de QA de soporte cubre ese lado.
Haz tu análisis de errores con eesel
Si tu IA o tu equipo sigue cometiendo los mismos errores, el compañero de IA para helpdesk de eesel te da el rastro de errores en un solo lugar. Se une a tu cola existente de Zendesk, Freshdesk, Gorgias o Help Scout, registra qué leyó y por qué en cada ticket, convierte tus correcciones en reglas permanentes y reproduce tickets pasados reales para que veas funcionar una corrección antes de que se active. Empieza con borradores como notas internas, ejecuta una simulación con los tickets del mes pasado y tendrás tu primer recuento de grupos al final del día. Se puede probar gratis con 100 créditos, y los planes de pago empiezan en $299 al mes en la página de precios de eesel.