

Qué es una base de conocimiento por cliente y quién la necesita
Una base de conocimiento por cliente es contenido de ayuda acotado a una empresa cliente o a una audiencia. El cliente ve sus artículos más los compartidos. Todos los demás ven solo los compartidos.
Cuatro tipos de equipos acaban necesitándola:
- Agencias y equipos de soporte externalizados que atienden varias marcas desde un mismo helpdesk. La política de reembolsos del cliente A no puede aparecer en el chat del cliente B.
- MSP que documentan la red, los proveedores y los runbooks de cada cliente, lo que es toda una categoría de software por sí sola (más sobre Hudu e IT Glue abajo).
- Equipos de SaaS B2B cuyos clientes enterprise tienen configuraciones personalizadas, SSO propio o SLA específicos por contrato.
- Empresas multimarca, que cubrí en mi guía de soporte al cliente multimarca.
Así describió un administrador de Zendesk la forma del problema, y es la versión más clara que he encontrado:
"Can anyone advise on configuration for guide where I have 100 unique sites that need a help center? 2/3 of the content needs to be available for all end users but 1/3 of content is site-specific and needs to be invisible to users outside of that specific site. Multi brand? Orgs/tags? Labels?"

Fíjate en la proporción. Dos tercios compartidos, un tercio específico del cliente. Esa proporción decide casi todo lo demás en este artículo, desde cómo estructuras tu gestión de la base de conocimiento hasta cómo configuras la IA.
Soy Alicia y construyo los agentes de IA en eesel, así que dedico mucho tiempo al lado de la recuperación: qué se le permite leer a una IA cuando un cliente del cliente A hace una pregunta. Ahí pasaré la segunda mitad de este artículo, porque es donde el contenido específico de un cliente deja de serlo sin que nadie se dé cuenta.
Los tres niveles de separación
Todos los helpdesk ofrecen alguna mezcla de los mismos tres niveles, los llamen marcas, portales, espacios de trabajo o sitios de Docs. Elige el más bajo que cumpla el objetivo, porque cada escalón suma mantenimiento.
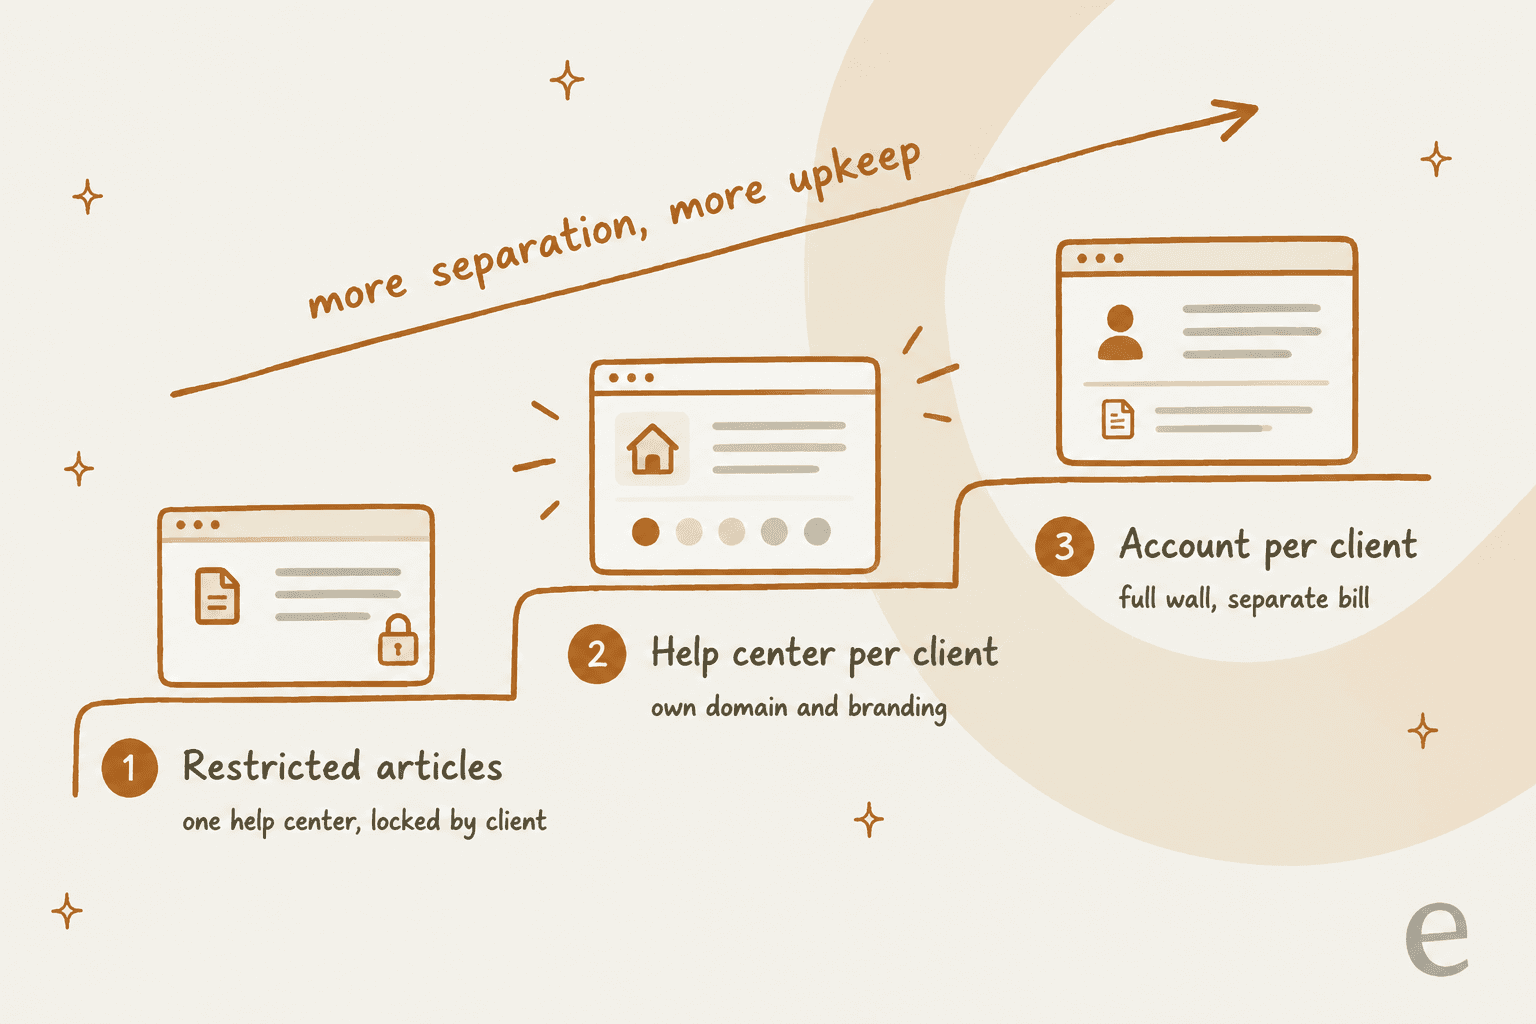
Nivel 1: artículos restringidos en un solo centro de ayuda. Los clientes inician sesión, y los usuarios de cada cliente ven sus artículos más los compartidos. Una biblioteca de artículos, una URL. Es la opción por defecto correcta para la mayoría de los equipos, y es a lo que apuntaban las respuestas en r/Zendesk:
"User Segments all the way. Cool part though if you have User data coming from say Azure. You can premap info. Or domains as well. Then user segments check that data and allow access to articles pertaining to their content. Little bit of maintenance but it's the best way"
El problema es el inicio de sesión. La restricción solo funciona cuando el helpdesk sabe quién está leyendo, así que los visitantes anónimos solo ven contenido público.
Nivel 2: un centro de ayuda por cliente. Cada cliente tiene su propio dominio, logotipo y conjunto de artículos. Es lo que suelen querer los clientes que revenden tu servicio o le ponen su propia marca, y es la configuración que recorre mi guía de configuración multimarca de Zendesk. Aun así, no es privado de forma automática. El documento de Zendesk sobre los centros de ayuda de marca dice: "you cannot restrict users to a specific help center. All of your help centers are accessible to all of your end users." Un centro de ayuda aparte es una decisión de marca, no de privacidad. Si el contenido es confidencial, sigues necesitando inicio de sesión más restricción.
Nivel 3: una cuenta por cliente. Helpdesk aparte, factura aparte, administradores aparte. El documento de Workspaces de Freshdesk dice que una facturación o titularidad legal separadas pueden requerir cuentas separadas. Es el muro completo, y también el que más trabajo da: cada artículo compartido se mantiene N veces.
No copies cada artículo por cliente
El error más común que veo es tratar "específico del cliente" como "copiar toda la biblioteca por cliente". Con la proporción de dos tercios compartidos de antes, eso significa que la mayoría de tus ediciones son la misma corrección pegada doce veces, y las copias se desincronizan en cuanto alguien olvida una.
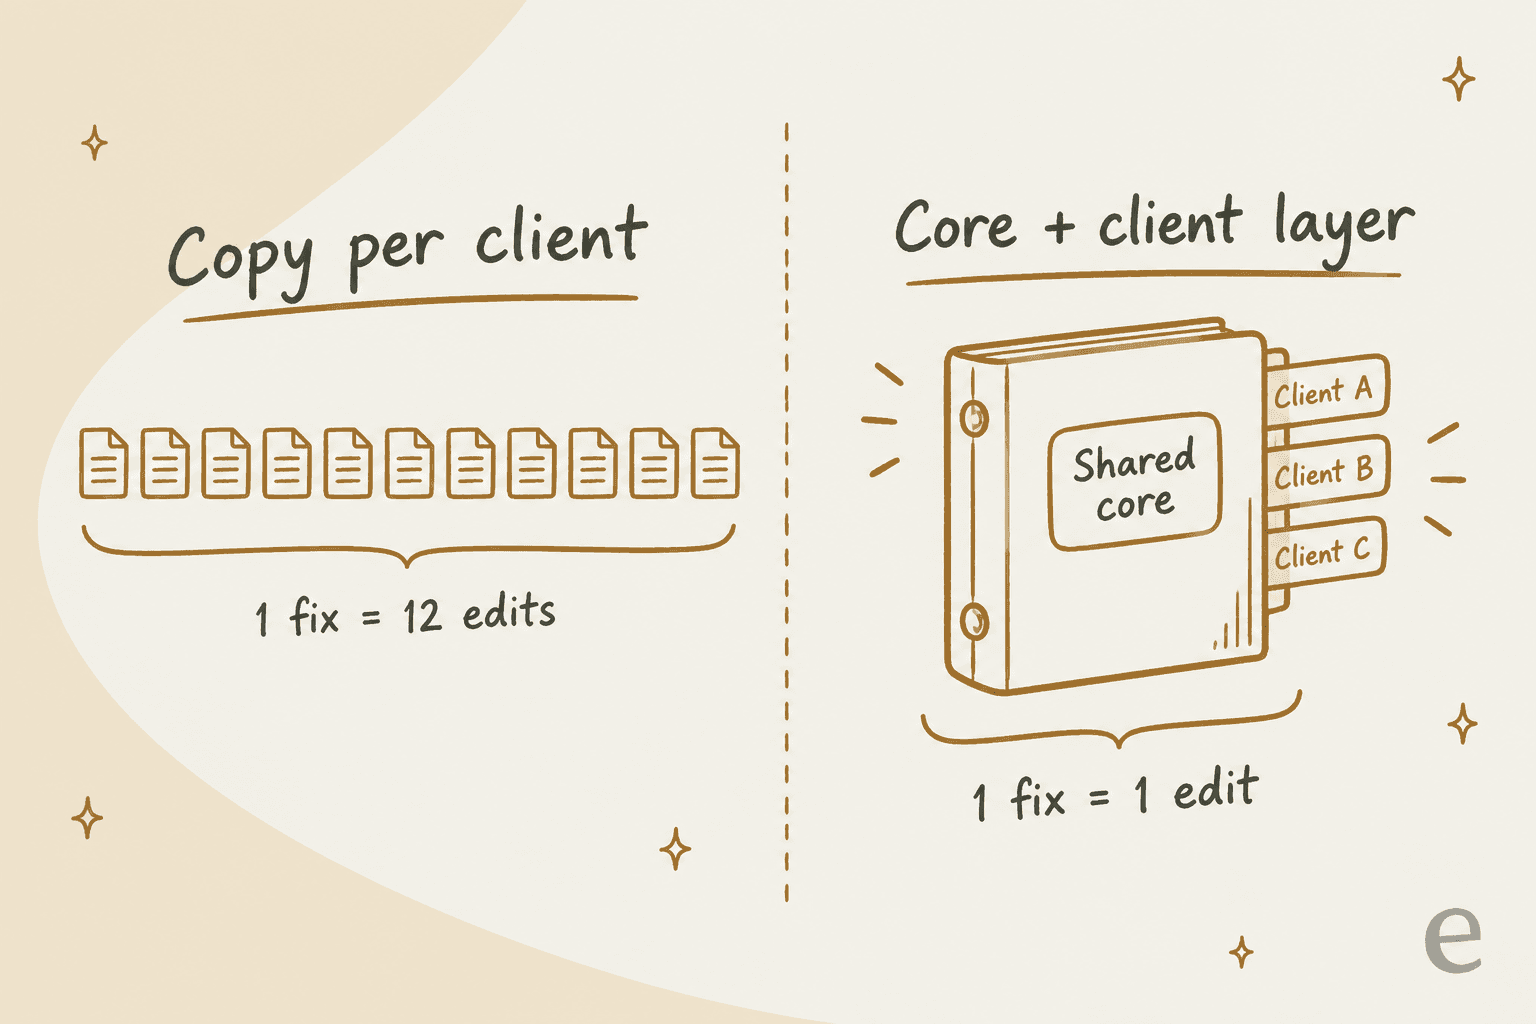
El patrón que aguanta es un núcleo compartido más una capa fina por cliente:
- Núcleo compartido: cómo funciona el producto, políticas estándar, resolución de problemas. Se escribe una vez.
- Capa del cliente: solo lo que difiere. Configuración personalizada, términos del contrato, contactos con nombre, rutas de escalado específicas del cliente, excepciones a la política estándar.
La misma división funciona para las bases de conocimiento internas, donde la capa del cliente son notas solo para agentes que tus clientes nunca ven.
Las herramientas de documentación para MSP están construidas exactamente así. Hudu lo llama bibliotecas de base de conocimiento duales: artículos centrales "for information that pertains to multiple clients" y artículos de cliente que "pertain only to that space." Zendesk tiene dos funciones que hacen el mismo trabajo dentro de una cuenta. La multiubicación de artículos coloca un artículo en hasta 10 secciones entre marcas, y cada ubicación conserva sus propios permisos de visualización.
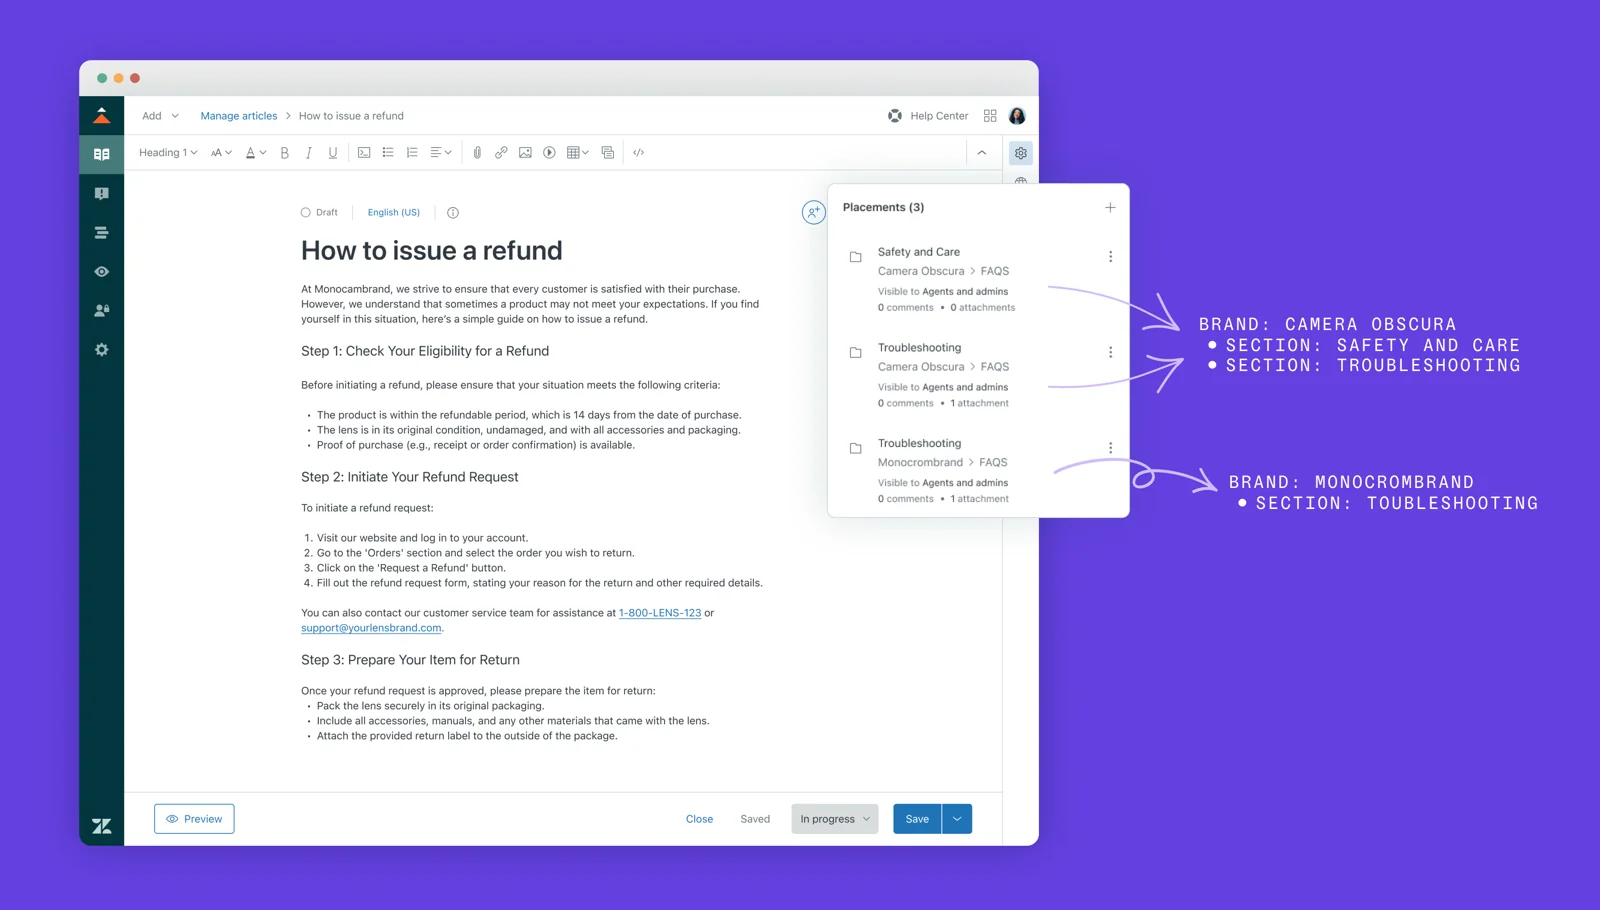
Los bloques de contenido van un nivel más pequeño: un párrafo o tabla reutilizable que se actualiza en todos los sitios donde se inserta. Eso sí, son solo para Enterprise, así que la mayoría de los equipos recurrirá a la multiubicación y a una convención de nombres clara.
Una nota honesta sobre IT Glue: no tiene biblioteca compartida nativa. Su propio documento de permisos sugiere crear una organización "named something like 'Common Documents'" para el contenido compartido. Funciona, pero es una convención que tienes que imponer, no una estructura que te da la herramienta.
Cómo gestiona cada helpdesk los artículos por cliente
Esto es lo que restringe cada herramienta, a qué nivel y en qué plan. Los precios son por agente o usuario al mes con facturación anual, tomados de la página de precios de cada proveedor a octubre de 2026.
| Helpdesk | Unidad más pequeña que se puede restringir | Mecanismo por cliente | Plan para restricción por cliente | Centro de ayuda aparte por cliente |
|---|---|---|---|---|
| Zendesk | Artículo | Segmentos de usuarios por organización, etiqueta o usuario concreto | Suite Professional $115 (segmentos personalizados); varios segmentos por artículo requieren Enterprise | 5 en Professional, 300 en Enterprise |
| Freshdesk | Carpeta | Carpeta visible para empresas seleccionadas, segmentos de contactos o segmentos de empresas | Indicado en todos los planes en los documentos de carpetas de Freshdesk | Pro $55 (hasta 5 portales), Enterprise $89 (ilimitados) |
| HubSpot Service Hub | Artículo o base de conocimiento completa | Grupos de acceso (estáticos o basados en filtros) | Professional: 2 grupos de acceso; Enterprise: 100 | Solo Enterprise (hasta 100 bases de conocimiento) |
| Help Scout | Sitio de Docs completo | Un sitio de Docs restringido por cliente | Plus $45 o Pro $75, más código propio | Sitios: Plus 3, Pro 5, extra $20/mes |
| Zoho Desk | Categoría, sección o artículo | Grupos de usuarios del centro de ayuda (hasta 200 por centro de ayuda) | No en Free; base de conocimiento desde Standard $14 | Enterprise $40 (centro de ayuda multimarca) |
| Front | Centro de ayuda completo | Un centro de ayuda con acceso controlado por inicio de sesión por cliente | Professional $65 | Professional y superiores |
Un par de cosas de esa tabla merecen más que una celda.
Zendesk: los segmentos de usuarios hacen el trabajo real
Los segmentos de usuarios de Zendesk son la opción más flexible de las que hay aquí. Un segmento puede filtrar por hasta 50 organizaciones, 50 etiquetas en cada grupo de etiquetas y 50 usuarios concretos, y tienes hasta 200 segmentos por cuenta, compartidos entre marcas. Si pones a los usuarios de cada cliente en una organización, tienes un segmento de cliente uno a uno.
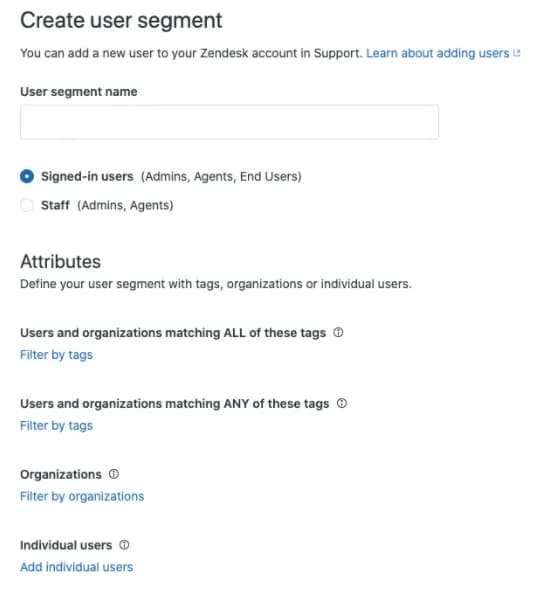
Dos detalles de plan importan. Suite Team solo puede elegir "todos" o "usuarios con sesión iniciada", así que no hay segmentos de cliente ni artículos solo para agentes. Y la restricción es por artículo, no por sección, así que bloqueas una sección entera de un cliente con actualizaciones masivas. Mi guía para restringir artículos por segmento lo recorre, y el artículo sobre los centros de ayuda multimarca cubre el Nivel 2.
Freshdesk: por carpeta, y por empresa de serie
Freshdesk fija la visibilidad en la carpeta, no en el artículo. Las opciones incluyen Todos los usuarios, Usuarios con sesión iniciada, Todos los agentes, Bot y Empresas concretas, además de segmentos de contactos y de empresas. El documento del widget de Freshdesk nombra directamente el caso del cliente: mostrar artículos "about a company to just contacts from that company".
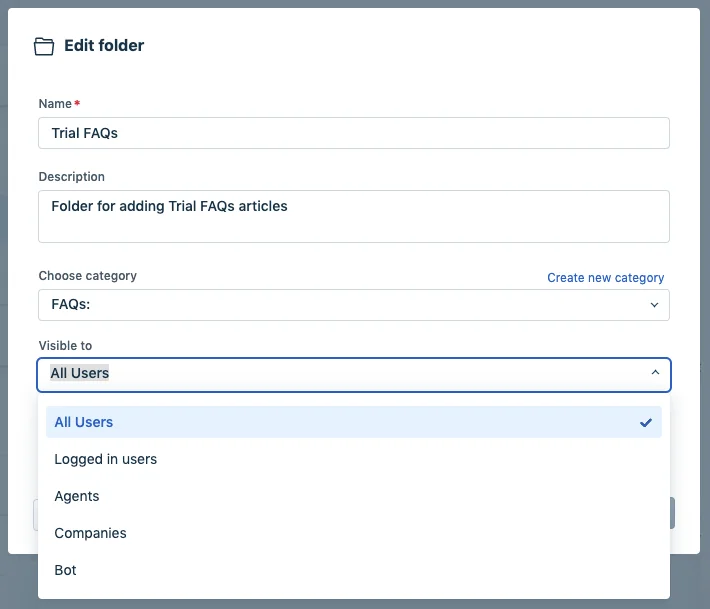
Eso hace de Freshdesk una de las formas más baratas de hacer el Nivel 1 (mi desglose de los precios de Freshdesk tiene la tabla de planes). La forma para la que hay que planificar: una carpeta por cliente, ya que la visibilidad no puede variar artículo por artículo dentro de una carpeta.
HubSpot: bien en Enterprise, justo en Professional
HubSpot restringe artículos sueltos o una base de conocimiento entera mediante grupos de acceso. Professional permite 2 grupos de acceso y 1 base de conocimiento. Alcanza para "público más socios más un nivel VIP", no para diez clientes. Enterprise permite 100 grupos y hasta 100 bases de conocimiento, y el contenido privado de HubSpot solo funciona en un dominio personalizado conectado. Más sobre la IA de HubSpot abajo, porque ahí es donde se pone interesante. Mi recopilación sobre la base de conocimiento de HubSpot tiene el resto, y el artículo sobre la IA de la base de conocimiento de Service Hub cubre el lado de la IA.
Help Scout, Zoho Desk y Front
Help Scout restringe sitios de Docs enteros, no colecciones. Los Docs restringidos requieren Plus o Pro y "custom code development by your own team" para emitir el token del visitante. Existen colecciones privadas, pero "privado" significa tus propios usuarios de Help Scout, no un cliente. Help Scout también señala que Docs no está cubierto por sus compromisos de RGPD ni de HIPAA, así que mantén fuera los datos de cuentas de clientes.
Zoho Desk es el más granular de estos tres. Las categorías pueden ajustarse a Ninguno, Grupos, Público, Agentes o IP personalizada, y los grupos de usuarios del centro de ayuda se describen como ligados a "a specific account". Los límites son 200 grupos por centro de ayuda y 2,000 usuarios por grupo. Si planeas entrenar a Zia con ello, lee primero la sección de IA de abajo.
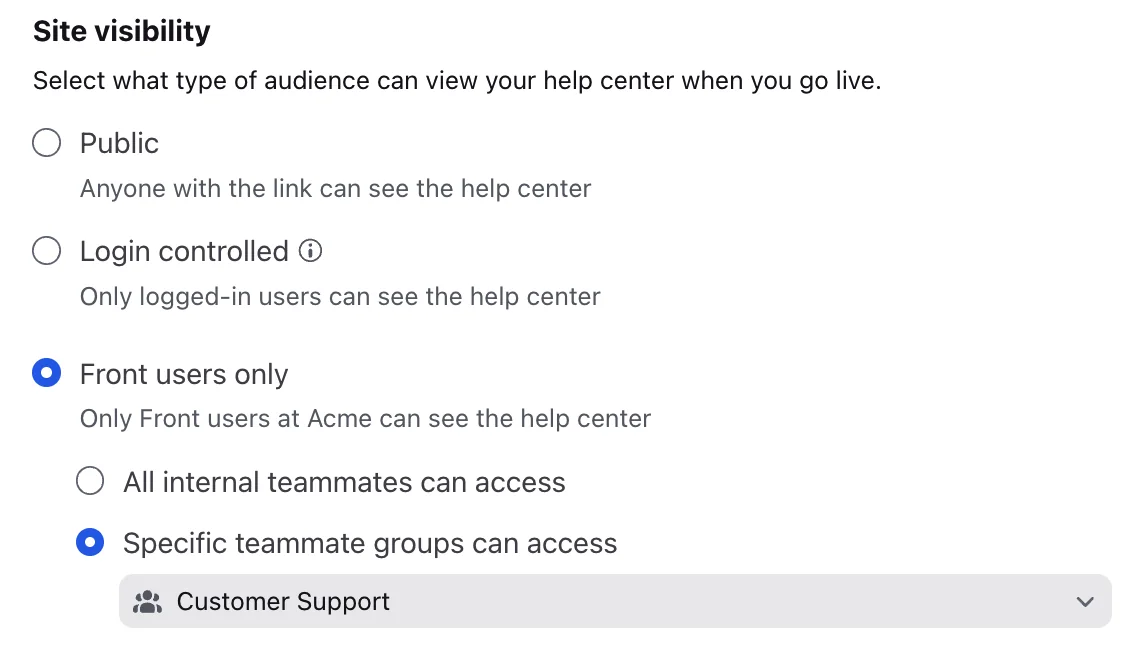
Front restringe a nivel de centro de ayuda: Público, Acceso controlado por inicio de sesión (mediante tu propio proveedor de identidad) o Solo usuarios de Front. Sus categorías privadas solo ocultan el contenido de la navegación, y cualquiera con el enlace directo puede abrirlas, así que no son un muro para clientes. Mi reseña de Front AI cubre lo que lee su IA.
Dónde se filtra el contenido por cliente: la IA
Este es el cambio en el que insisto. Los equipos pasan semanas ajustando bien los permisos del centro de ayuda y luego activan un agente de IA que lee la base de conocimiento con otro conjunto de reglas. El modelo de permisos que ven tus clientes no siempre es el que sigue tu IA.
| Función de IA | ¿Usa artículos restringidos por cliente? | Qué significa para ti |
|---|---|---|
| Agentes de IA de Zendesk (configuración actual) | Sí, y respeta los permisos de visualización para usuarios con sesión iniciada | La mensajería necesita inicio de sesión JWT con un ID externo que coincida; las respuestas restringidas no se pueden probar en el widget de prueba |
| Agentes de IA de Zendesk comprados antes del 10 de marzo de 2026 | Los artículos eran "public or private to everyone" | La migración va del 1 de julio a finales de 2026 |
| Freshdesk Freddy AI Agent | No. "Private or restricted articles are excluded" | Las carpetas de clientes no son una fuente; tendrías que hacerlas públicas |
| Freshdesk Freddy Copilot (lado del agente) | Sí, limitado al acceso del propio agente | Bueno para agentes, no para respuestas de cara al cliente |
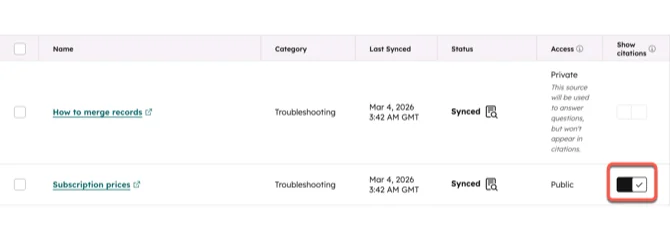
| Agente de atención al cliente de HubSpot | Sí, sin citas | HubSpot avisa de que el contenido privado "may still appear in responses" |
| Help Scout AI Answers | Se pueden activar colecciones privadas en los ajustes de Beacon | Yo lo acotaría por cliente con un agente de IA por Beacon |
| Zoho Desk Answer Bot | Zoho dice solo "published and public resources" | Un comentario de usuario en la misma página informa de artículos solo para agentes que aparecen; pruébalo |
Dos filas merecen una mirada más de cerca.
Freshdesk es estricto en la dirección segura. El documento de conocimiento del AI Agent dice "only articles visible to All users are used for AI learning." Así que el bot no puede filtrar la carpeta del cliente A al cliente B, pero tampoco puede responder al cliente A desde la carpeta del cliente A. La solución alternativa de Freshdesk, la búsqueda filtrada, acota la recuperación por propiedades del contacto o de la conversación, pero solo puede filtrar contenido del que la IA tuvo permiso para aprender en primer lugar.
HubSpot va en la dirección contraria. El documento de fuentes del agente de atención al cliente dice que las fuentes privadas "will not be cited, but their content may still appear in responses", y te indica que no incluyas datos confidenciales o privados de clientes. No encontré ninguna forma documentada de limitar una fuente privada a su grupo de acceso en el momento de responder.
El mismo problema aparece entre regiones, no solo entre clientes. Un administrador de Zendesk lo dijo bien:
"The problem: Zendesk AI pulls knowledge from the Help Centers linked to the same brand, regardless of language or region. So if a Brazilian customer asks something, the AI might base its answer on all related contents, even in articles just created for US."
Primero acota, luego busca
La solución es la misma a la que llegan quienes construyen la suya: decidir de quién es el contenido en juego antes de que se ejecute la búsqueda, no después. Un desarrollador de n8n que ejecuta un flujo de IA para diez clientes lo describió así:
"Once I've filtered the clientid the model won't make a mistake because if it gets the clientid gonna search for everything related to the client id, even the chat history is connected trough clientid so it seems pretty solid."
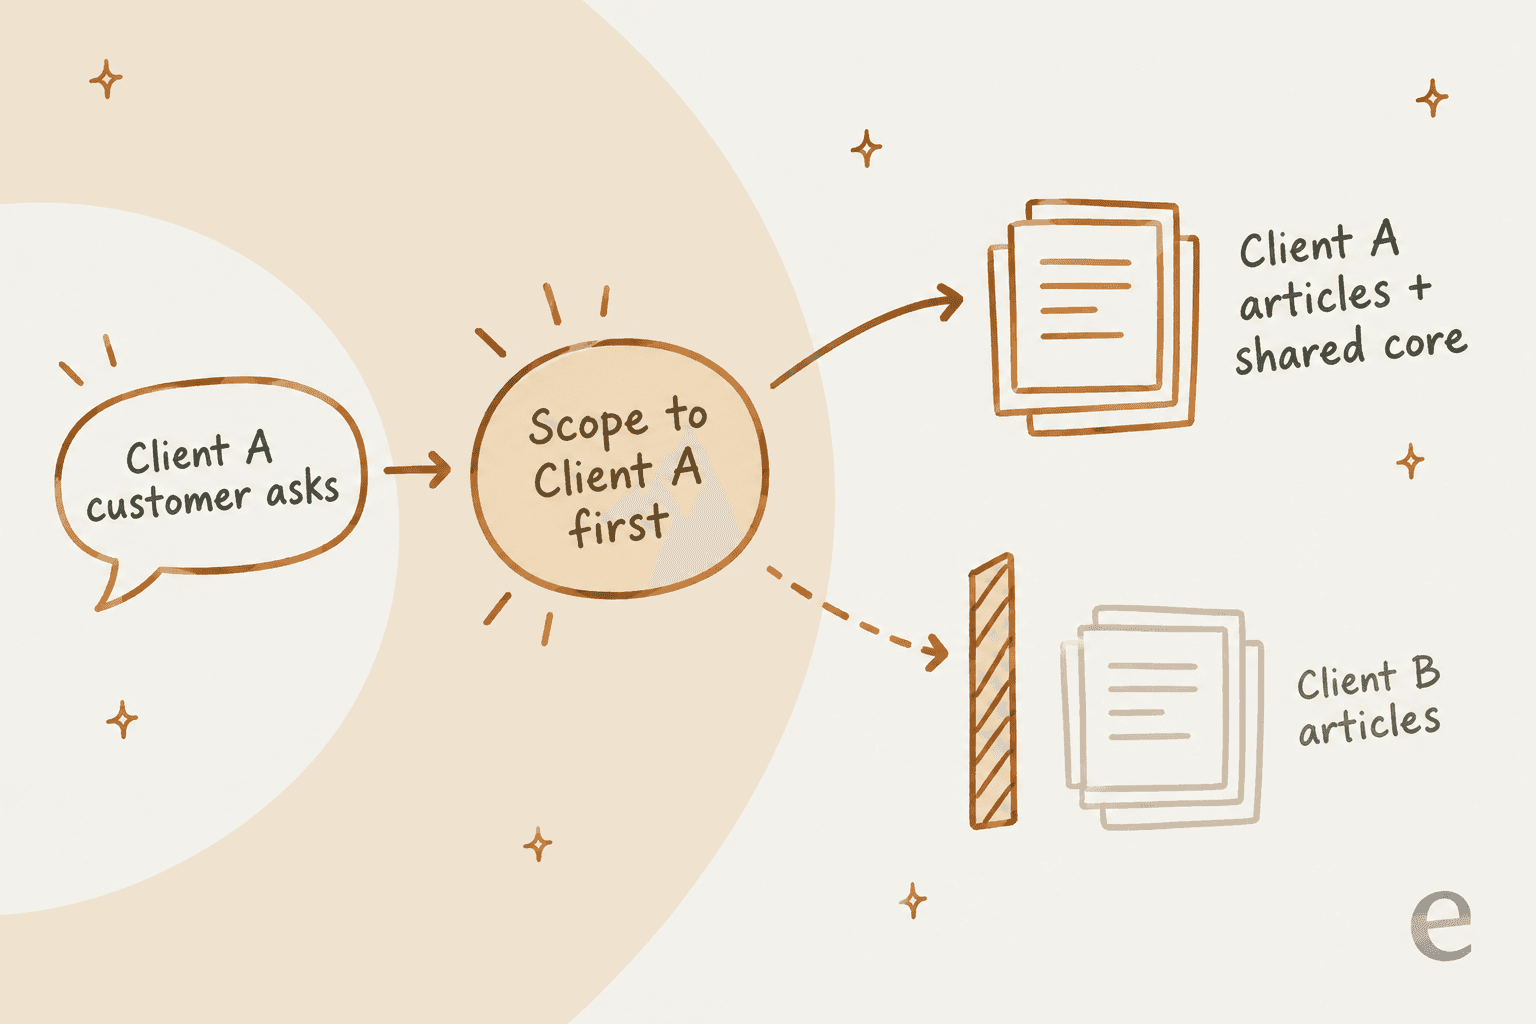
En un helpdesk, la forma más sencilla de acotar primero es un agente de IA por cliente, conectado solo a las fuentes de ese cliente. Instrucciones como "usa solo los artículos del cliente A" no son un muro. Si el contenido está en el índice del agente, asume que puede salir. Eso es cierto tanto si la IA usa recuperación como un modelo ajustado, como explico en RAG vs. fine-tuning.
Aquí también importan los tickets pasados. El historial de tickets es el conocimiento específico de cliente más rico que tienes, porque recoge todos los casos límite que los artículos nunca cubrieron. También es la fuente más fácil de mezclar, porque un helpdesk suele guardar los tickets de todos los clientes. Un copiloto de helpdesk del lado del agente es un lugar de menor riesgo para empezar, ya que una persona lee cada borrador antes de enviarlo.
Lo que aprendí construyendo esto en eesel
A principios de este año, un equipo belga de tecnología de reparto (neerlandés e inglés, 1,625 documentos, la prueba más activa de su cohorte) quería dos agentes de IA sobre un mismo Zendesk. Uno respondería a usuarios anónimos con artículos públicos, el otro a usuarios con sesión iniciada con los públicos más un subconjunto de artículos restringidos. La importación de eesel podía filtrar por categoría, pero no elegir un subconjunto restringido artículo por artículo, así que se atascaron. Más o menos en esas fechas vi cómo otros equipos multimarca se daban de baja porque configurar cada marca era demasiado engorroso para hacerlo solos.
De ahí salieron dos lecciones. Primero, pon el contenido específico de cada cliente en su propia categoría o sección desde el primer día, porque casi todas las herramientas, la IA incluida, acotan con más fiabilidad por contenedor que por artículo individual. Segundo, conectar por marca tiene que ser lo predeterminado, no un ajuste avanzado. Hoy en eesel, cada marca de Zendesk se conecta por separado e importa solo los tickets y artículos del centro de ayuda de esa marca, y cada marca puede ir a un agente distinto. Una empresa multimarca de bienestar ejecuta 5 agentes de IA específicos por marca de esta forma, cada uno entrenado con los tickets de su propia marca.
Cómo configurar bases de conocimiento por cliente en 6 pasos
Esto funciona en cualquiera de las herramientas anteriores. El orden importa más que la herramienta.
- Clasifica tus artículos en compartidos y específicos del cliente. Haz una auditoría de la base de conocimiento rápida y etiqueta cada artículo. Espera algo cercano a la proporción de dos tercios compartidos, y anota cualquier laguna de conocimiento mientras estás en ello. Si la capa de un cliente es mayor que el núcleo compartido, quizá ese cliente necesite el Nivel 2 o 3.
- Da a cada cliente un contenedor que tu helpdesk entienda. Una organización de Zendesk, una empresa de Freshdesk, un grupo de acceso de HubSpot, un grupo de usuarios de Zoho. Asigna usuarios automáticamente por dominio de correo o datos de SSO donde puedas, para que los usuarios nuevos del cliente no caigan en el grupo equivocado.
- Pon los artículos del cliente en una categoría o carpeta solo para el cliente. No mezclados en secciones compartidas. Este es el paso que hace manejables más adelante la IA y los cambios masivos de permisos.
- Decide qué compartir por referencia, no por copia. Usa multiubicación, bloques de contenido o categorías de portal que se asocien a varios portales. Copia solo cuando la versión del cliente realmente difiera.
- Activa el inicio de sesión y luego prueba como cada cliente. Inicia sesión como un usuario real del cliente A y del cliente B y busca el contenido del otro. Los documentos de Zendesk sobre la restricción por inicio de sesión y los segmentos dicen que el filtro de organización se ignora para los agentes con sesión iniciada y que los administradores de conocimiento se saltan todas las restricciones, así que probar como tú mismo no demuestra nada.
- Acota la IA por cliente y pruébala con el historial de ese cliente. Un agente por cliente o marca, conectado solo a las fuentes de ese cliente. Ejecútalo contra los tickets pasados de ese cliente antes de que responda a nadie en vivo.
Tras el lanzamiento, pon la capa del cliente en un ciclo de revisión. Los artículos por cliente caducan más rápido que los compartidos, porque dependen de un contrato o de un contacto que puede haber cambiado. Vincula su revisión a tu proceso de cambio de políticas, de modo que una actualización de contrato dispare una actualización del artículo. Mi artículo sobre el contenido desactualizado del centro de ayuda cubre cómo detectarlo.
MSP: Hudu e IT Glue ya funcionan así
Si eres un MSP, tu base de conocimiento por cliente probablemente no está en tu helpdesk. Está en una herramienta de documentación, donde la separación por cliente es todo el diseño.
| Hudu | IT Glue | |
|---|---|---|
| Contenedor por cliente | Espacio de empresa | Organización |
| Biblioteca compartida | Base de conocimiento central nativa | Una organización compartida "Common Documents" |
| Precio | $27/usuario/mes anual, sin mínimo | $29 / $38 / $44 por usuario/mes, mínimo de 5 usuarios, plazo de 36 meses |
| Portal del cliente | Usuarios de portal gratuitos | Complemento MyGlue, $407/mes |
| IA | Asistente Hudini y MCP, incluidos | Cooper Copilot, listado en todos los niveles |
Fuentes: precios de Hudu y precios de IT Glue.
Una fecha a vigilar: la versión 2.47 de Hudu empieza a desplegarse el 12 de octubre de 2026 y sustituye los portales de cliente por un rol de usuario de portal. La propia advertencia de Hudu es que los usuarios de portal heredarán "everything their groups can see", mientras que el portal antiguo solo mostraba los registros marcados para él. Si compartes documentos de clientes mediante el portal de Hudu, revisa los permisos de tus grupos antes de esa fecha.
El problema de encontrar la información tampoco desaparece con una herramienta dedicada:
"It can be really difficult to find client specific information unless you know exactly how to search for it. There is sometimes lost time spent there."

Mi guía del sistema de tickets para MSP cubre el lado de ticketing del mismo stack.
Prueba eesel para bases de conocimiento por cliente
Si atiendes a varios clientes o marcas en Zendesk, Freshdesk, Gorgias o Zoho Desk, eesel da a cada cliente su propio compañero de IA para el helpdesk, la misma configuración que describo en soporte con IA para agencias. Se une a la cola existente, se conecta por marca de Zendesk o por cuenta de helpdesk, y aprende solo del centro de ayuda, las macros y los tickets pasados de ese cliente. Cada fuente es un interruptor, así que puedes desactivar un historial de tickets del que el agente no debería aprender, y "uninstall from agent" quita una conexión del agente de un cliente sin tocar los demás.

Antes de que un agente salga en vivo para un cliente, la habilidad de simulación reproduce los tickets pasados reales de ese cliente y compara sus respuestas con lo que envió tu equipo. Las acciones también van por agente, así que permitir reembolsos para el cliente A no cambia lo que puede hacer el agente del cliente B.
Los precios incluyen agentes y puestos ilimitados en todos los planes, empezando gratis con 100 créditos y luego desde $299 al mes por 500 créditos, donde un ticket es 1 crédito. Como la facturación está a nivel de espacio de trabajo, una agencia con seis clientes pequeños compra un plan de créditos para el total de sus tickets en vez de seis suscripciones. Si prefieres automatizar un agente por cliente con scripts, la CLI de eesel puede ejecutar eesel agents create para crear un agente nuevo y apuntar a cualquiera de ellos con --agent, desde una terminal o desde un agente de programación como Claude Code.

Lo que eesel no es: una plataforma de IA de marca blanca ni un programa de reventa, y sus roles de usuario son de todo el espacio de trabajo, no por cliente. Si tus clientes necesitan sus propios inicios de sesión para gestionar su propio agente, hoy es una carencia. Si necesitas que la IA de cada cliente se mantenga en su carril, prueba eesel gratis.