

En resumen
La única evaluación comparativa de agentes de soporte con IA que merece servir de base para tomar decisiones es evaluar a tu agente y a tu equipo con los mismos tickets y una única definición de "resuelto". Las tasas de resolución de los proveedores no se pueden comparar entre sí: Zendesk, Gorgias, HubSpot, Freshdesk, Salesforce y Help Scout usan criterios distintos, así que el mismo cliente que deja de responder cuenta como un éxito en una herramienta y como un resultado incierto en otra. Las pruebas públicas como tau-bench clasifican modelos, no tu configuración. La simulación de eesel hace exactamente esto: vuelve a procesar tus tickets resueltos, compara las respuestas con lo que tu equipo envió realmente y puntúa cada tema antes de que nada llegue a un cliente.
¿Qué significa realmente "evaluar comparativamente un agente de soporte con IA"?
Desarrollo agentes de IA en eesel, y la pregunta que más escucho después de una implementación es alguna variante de "¿un 60 % está bien?". La respuesta honesta es que depende de qué 60 % estemos hablando. Cuando alguien dice "evaluación comparativa", normalmente se refiere a una de tres cosas distintas, y confundirlas es lo que lleva a los equipos a quedarse con una cifra que no les sirve para tomar decisiones.
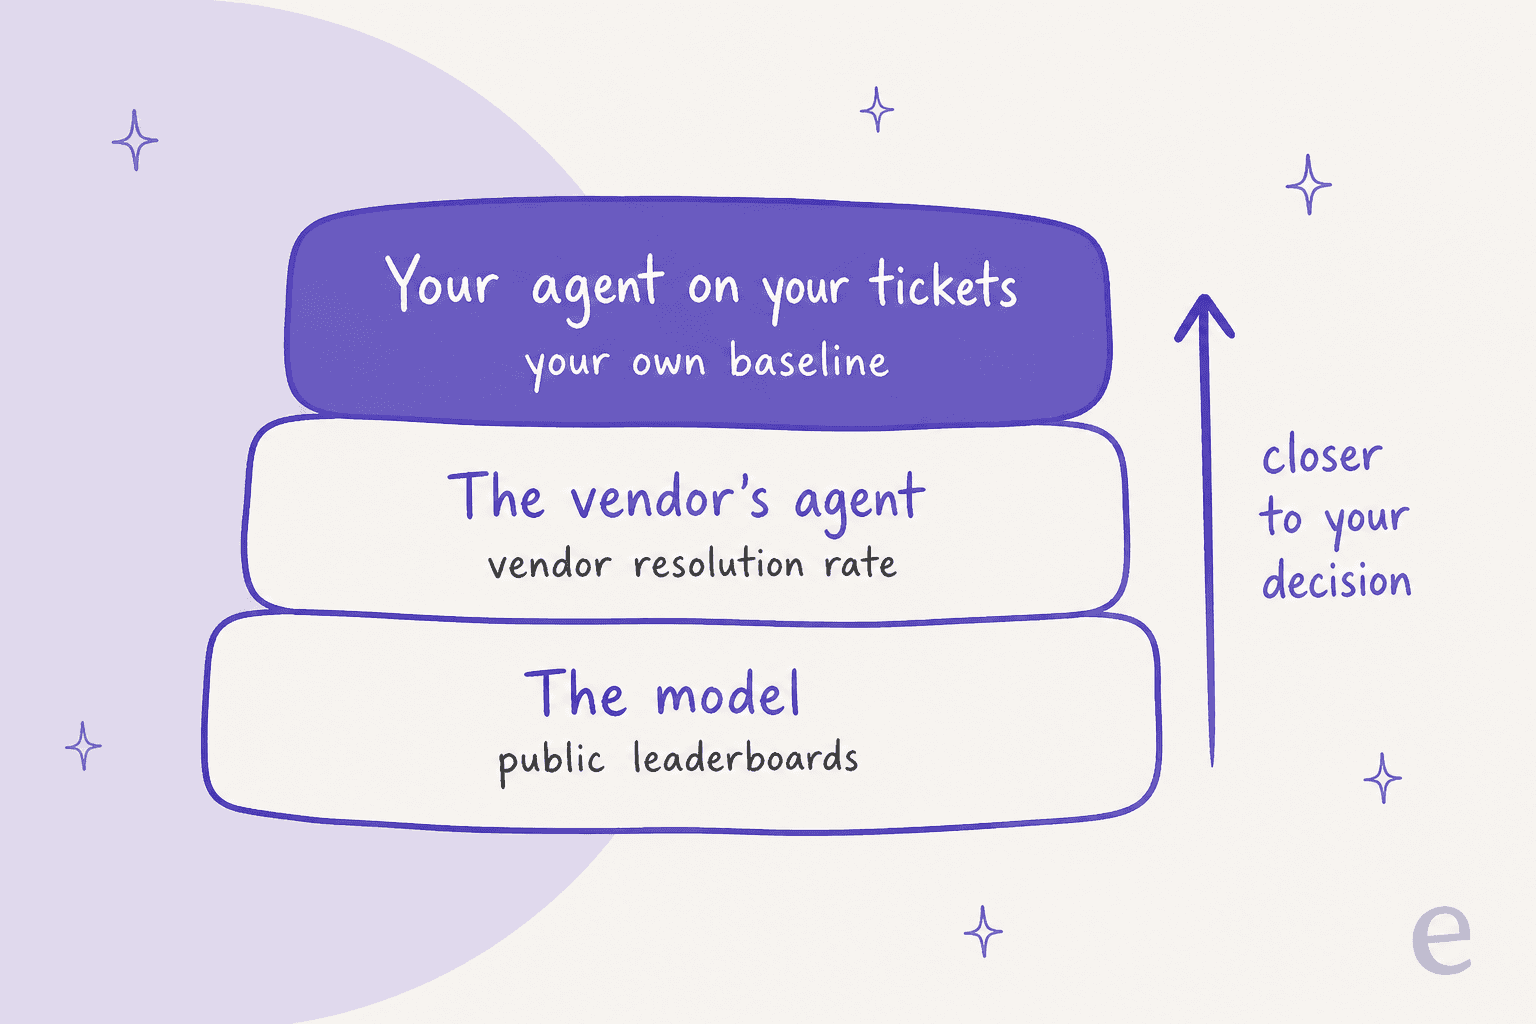
- El modelo. Las clasificaciones públicas como tau-bench prueban el modelo de lenguaje grande subyacente con tareas de soporte simuladas. Son útiles para elegir un modelo, pero no dicen nada sobre tu base de conocimientos.
- El agente del proveedor. La tasa de resolución que te muestra tu plataforma de soporte, o el promedio que un proveedor publica en su página de inicio. Cada proveedor la define según sus propios criterios de facturación.
- Tu agente con tus tickets. Tu configuración, tu documentación y tus políticas, evaluadas frente a cómo tu propio equipo gestionó las mismas preguntas. Esta es la que te indica si debes ampliar lo que gestiona la IA.
Cada nivel te acerca más a la decisión que realmente tienes que tomar. El resto de este artículo recorre los tres, porque el error que veo con más frecuencia es que un equipo cita el segundo nivel como si fuera el tercero.
¿Por qué no puedes comparar las tasas de resolución de los proveedores?
Porque cada proveedor contabiliza una resolución con un criterio diferente, y la mayoría factura según ese mismo criterio. Esta semana revisé la documentación de ayuda de cada proveedor, y no hay dos que coincidan en lo que significa "resuelto".
| Proveedor | Qué cuenta como resuelto | Plazo | ¿Se factura por ello? | Precio por unidad |
|---|---|---|---|---|
| Zendesk | La IA respondió, el cliente no pidió nada más y un LLM confirma que la solicitud se resolvió satisfactoriamente. No supera la comprobación = "Contained", no se factura | 72h para correo electrónico, 2h por defecto para mensajería (hasta 72h), contadas desde el primer mensaje | Sí | $1.50 con compromiso, $2.00 por uso |
| Gorgias | Gestionado por completo mediante IA o automatización, sin necesidad de intervención humana en 72 horas | 72h | Sí, más la tarifa del ticket | $1.50 por exceso de uso en la página de precios |
| HubSpot | El agente respondió con una fuente de contenido o una acción y no hubo derivación iniciada por el visitante, o un cliente potencial se marcó como calificado, parcialmente calificado o no calificado | 72h después del último mensaje del visitante | Sí | $0.50 (50 créditos) |
| Freshdesk Freddy | Informes: cerrado sin intervención humana. La facturación es por sesión, independientemente del resultado | 24h para chat, 72h para correo electrónico por sesión | No, se factura por sesión | $49 por 100 sesiones |
| Salesforce Agentforce | "Deflected" cuando un LLM puntúa la sesión con un 4 o un 5, lo que significa "mostly or fully resolved" | Tiempo de espera por abandono de 2h | No, se factura por conversación | $2 por conversación |
| Help Scout | La IA respondió y el cliente no pidió más ayuda después | No documentado | Sí | $0.75 |
Hay tres diferencias que importan más que las demás.
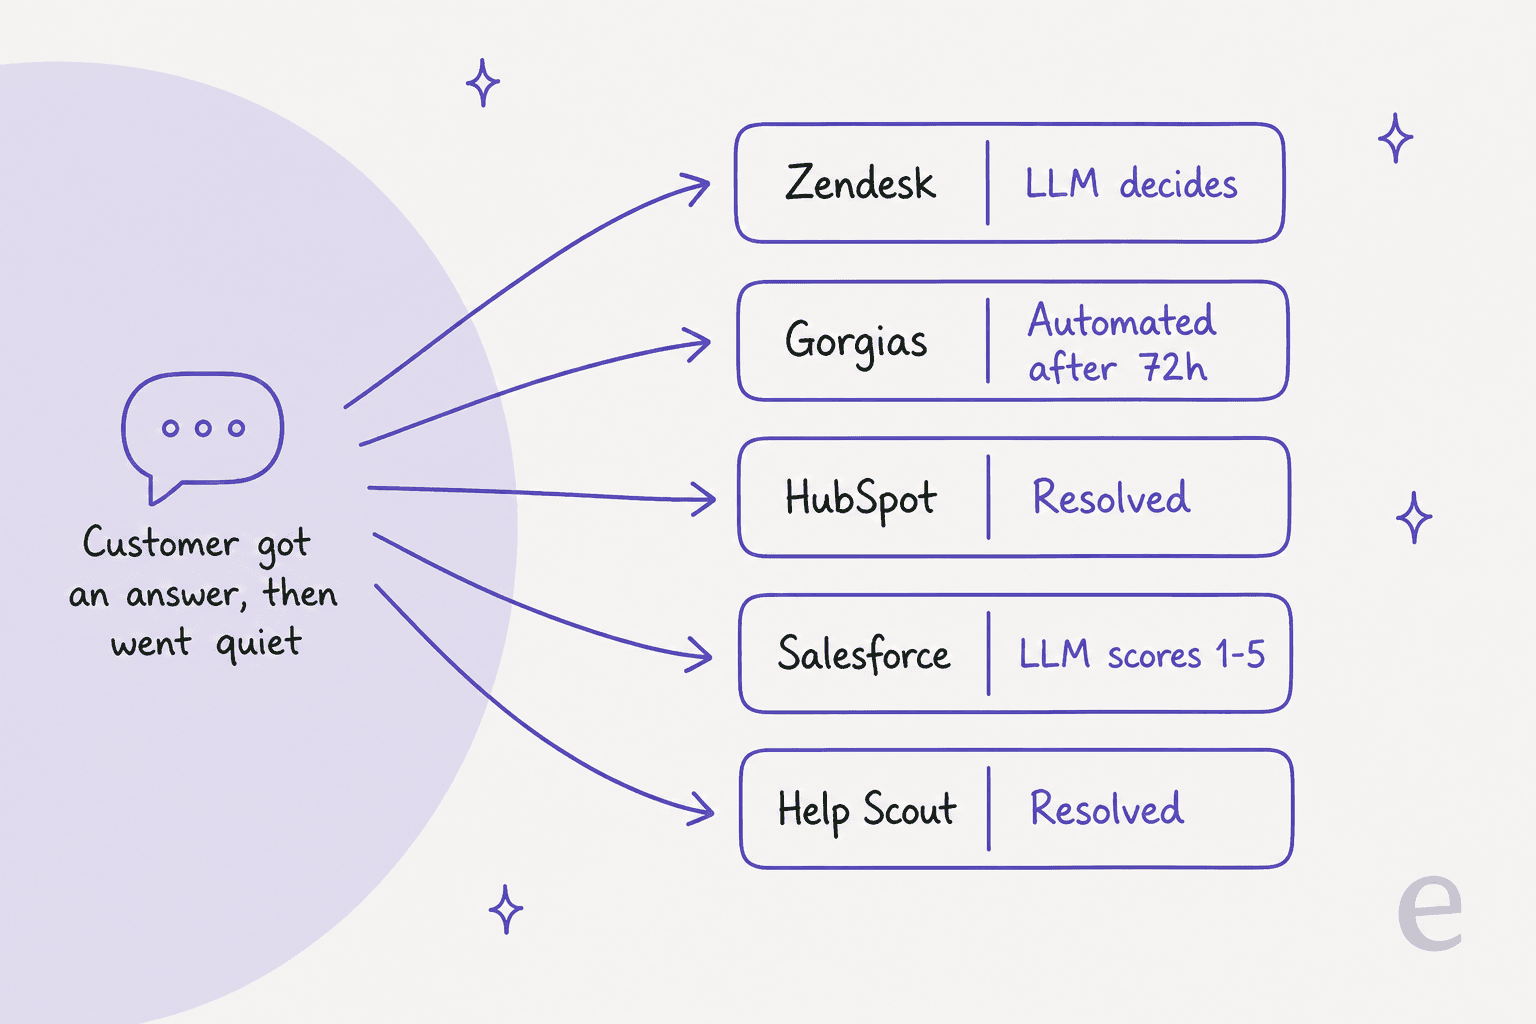
Quién decide si funcionó. Zendesk y Salesforce usan un LLM como juez de la transcripción. Gorgias, HubSpot y Help Scout contabilizan la ausencia de una persona: nadie pidió hablar con alguien, así que cuenta. Son preguntas distintas. "¿El cliente consiguió lo que necesitaba?" y "¿el cliente se rindió sin decir nada?" parecen idénticas en una métrica que solo comprueba si hay silencio.
Qué impide contabilizar una resolución. La propia documentación de HubSpot dice que solo las derivaciones iniciadas por el visitante cuentan en contra, y que los eventos posteriores, como "messages from a live agent, a transfer request, or negative feedback, will not change the resolution status". Un flujo de trabajo que deriva un ticket a una persona después de que el agente haya respondido no anula la resolución.
Cuál es el denominador. Gorgias informa de dos cifras que suenan parecidas: una tasa de éxito sobre los tickets que gestionó la IA y una tasa de automatización sobre toda tu carga de trabajo facturable. Mismo mes, mismos tickets, dos porcentajes muy distintos.
Así se ve esto en una conversación corriente: el agente responde y el cliente no vuelve a escribir.
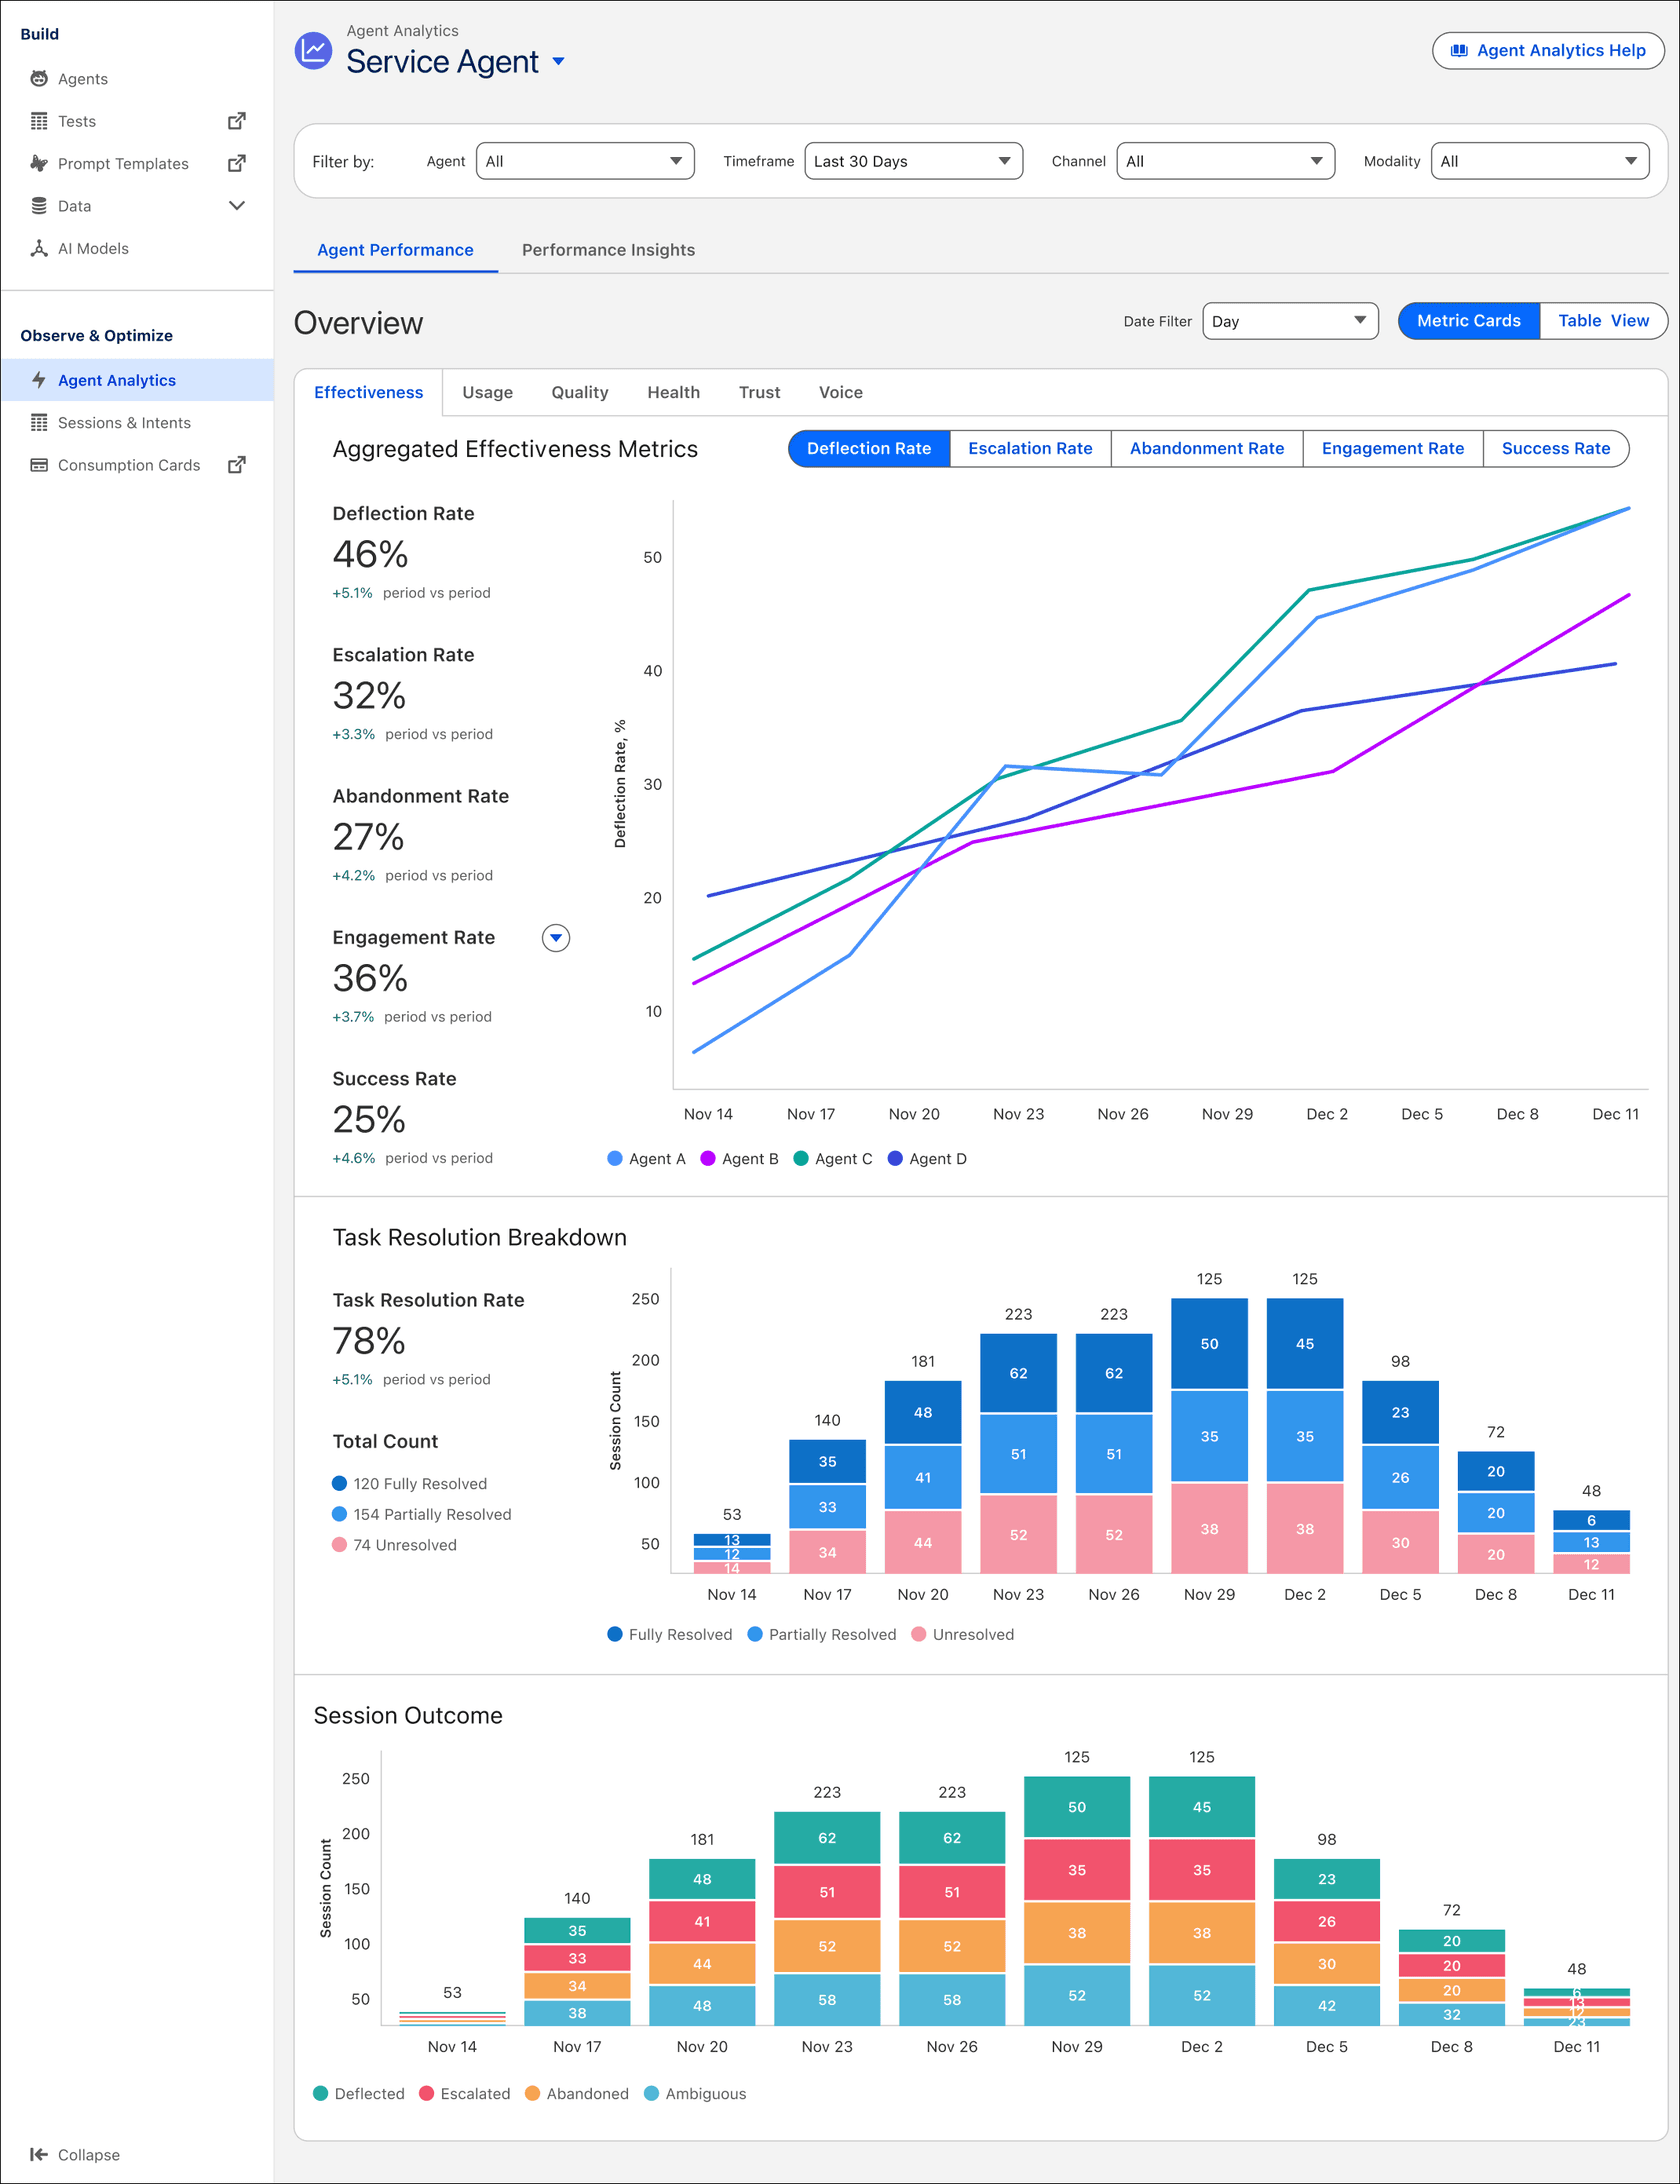
Incluso dentro de un mismo producto, la cifra cambia según la métrica que elijas. El panel de ejemplo de Agent Analytics de Salesforce muestra el mismo conjunto de sesiones con una tasa de desvío del 46 %, una tasa de éxito del 25 % y una tasa de resolución de tareas del 78 %.
Nada de esto significa que los proveedores sean deshonestos. Cada definición está documentada, y el propio blog de Zendesk advierte que "different tools may classify 'resolved' in different ways". Solo significa que una afirmación en una página de inicio, como el 65 % de las conversaciones de HubSpot entre 8.000+ clientes, es una cifra basada en la definición de HubSpot. No es un estándar que puedas exigir a tu agente de Zendesk o Gorgias.
Para profundizar en las definiciones, empieza por mi artículo sobre la tasa de desvío frente a la tasa de resolución. Los usuarios de Zendesk pueden ir más allá con las métricas de los agentes de IA de Zendesk, y la parte de precios está en costo por resolución.
"For comparing vendors, the only fair test I know is to run them on the same slice of your own traffic and score it with your own definition. Their published numbers mostly just tell you which definition they chose."

¿Qué te dicen las pruebas comparativas públicas como tau-bench?
Te dicen qué modelos gestionan bien las tareas de soporte y, algo más útil, con qué frecuencia completan correctamente la misma tarea dos veces. tau-bench, de Sierra, pone un modelo frente a un cliente simulado con herramientas reales y un documento de políticas y, después, según el artículo de tau-bench, compara "the database state at the end of a conversation" con el estado correcto. No evalúa lo agradable que sonó la respuesta. Evalúa si el reembolso se procesó realmente y si debía haberse procesado.
La idea que merece la pena tomar prestada para tu propia evaluación es pass^k. Los autores del artículo la definen como "the chance that all k i.i.d. task trials are successful": ejecuta la misma tarea k veces con un cliente que la formule de forma distinta cada vez, y cuéntala solo si todas las ejecuciones tienen éxito. En el artículo original, el mejor agente completó más del 60 % de las tareas de comercio minorista una vez, pero menos del 25 % cuando tenía que completar la misma tarea ocho veces.
La clasificación actual cuenta la misma historia. Extraje todos los resultados enviados del repositorio público de resultados de Sierra:
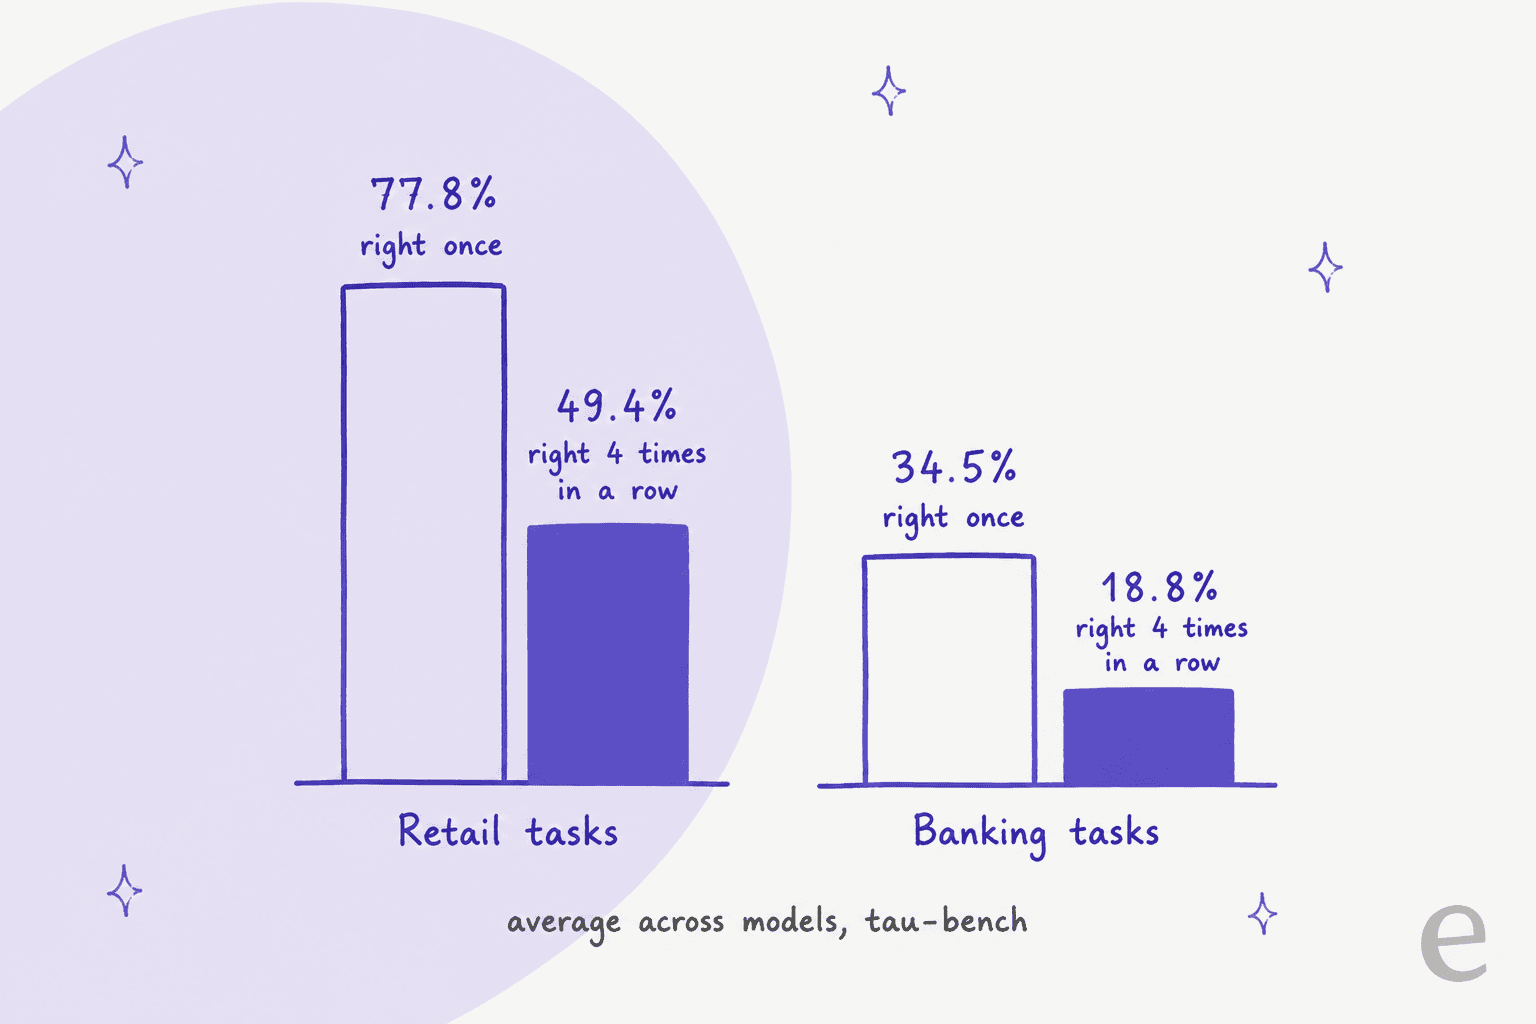
La banca es la prueba más difícil porque la respuesta está en 698 documentos de políticas en lugar de en una herramienta, y las tareas necesitan una media de 18.6 documentos y 9.5 llamadas a herramientas, según la descripción de tau-Knowledge. Esa es la situación de la mayoría de los equipos de soporte reales: la respuesta está en algún lugar de tu documentación. El mejor modelo de texto en esa prueba, Qwen 3.8 Max, obtiene 55.2 en una ejecución y 35.1 en cuatro ejecuciones.
Si quieres una visión más amplia, Fireworks publica un índice de atención al cliente que mantiene cinco pruebas comparativas en paralelo en lugar de combinarlas en una sola puntuación:
| Prueba comparativa (responsable) | Qué evalúa | Puntuación | Líder (noviembre de 2026) |
|---|---|---|---|
| τ³-Banking (Sierra) | Solicitudes bancarias sujetas a políticas, con herramientas y un usuario simulado | Recompensa media por intento | Gemini 4 Argon 58.25%, Claude Opus 5.5 56.01% |
| Cresta-Bench (Cresta) | 181 llamadas simuladas entre 4 agentes de centro de contacto | pass^3, "a case counts only when all three runs pass" | Claude Opus 5.5 82.57%, Claude Haiku 5.5 en último lugar con 20.05% |
| DuetBench-Diagnosis (Decagon) | Reproducción de conversaciones reales de diagnóstico, evaluador a ciegas | Clasificación Elo | Claude Opus 5 1034.9 |
| τ³-Voice (Sierra) | Agentes de voz de dúplex completo | Pass@1 | Pine Voice 1.0 87.33% |
| vCX (Retell AI) | Agentes de voz que siguen instrucciones y llaman a herramientas | Puntuación | GPT-6.1 Sol 93.4% |
Dos advertencias antes de que te apoyes en todo esto. Primero, Sierra ejecutó por sí misma 27 de los 29 resultados de texto enviados a tau-bench, así que se trata del entorno de pruebas de un solo laboratorio, no de una competición independiente. Segundo, y más importante, ninguna de estas pruebas sabe nada sobre tu política de devoluciones, tus macros o los tres artículos de ayuda que se contradicen entre sí. Una clasificación de modelos no es una clasificación de agentes de soporte listos para usar. Úsalas para preseleccionar un modelo y después prueba tu configuración. Profundizo en la elección del modelo en mi repaso de modelos para soporte.
¿Cómo comparas tu agente de IA con tu equipo humano?
Evalúas a ambos con los mismos tipos de tickets, los mismos criterios y dentro del mismo plazo. La trampa está en el promedio bruto: la IA recibe restablecimientos de contraseñas y consultas sobre el estado de pedidos, tu equipo recibe las disputas por reembolsos de clientes enfadados, y la IA acaba pareciendo más rápida y mejor porque sus tickets eran más fáciles.
Este es el método que yo usaría, y es el que recomendaría a cualquier equipo que esté empezando.
- Elige una definición de resuelto y déjala por escrito. Mi criterio por defecto: el problema del cliente quedó solucionado, nada contradijo las políticas y el cliente no volvió a contactar por el mismo problema en un plazo de 7 días. Es más estricto que todas las filas de la tabla de proveedores anterior, y así debe ser.
- Primero divide tus tickets por tema. Reembolsos, estado de pedidos, instrucciones de uso, facturación, errores. Evalúa por tema, nunca con una sola cifra combinada. Un 90 % en preguntas sobre cómo hacer algo y un 40 % en reembolsos dan un promedio que no significa nada.
- Vuelve a procesar tickets resueltos antes de consultar datos en vivo. Toma tickets que tu equipo ya haya cerrado, haz que el agente los responda sin enviar nada y compara cada respuesta con lo que tu equipo escribió realmente. La respuesta de tu equipo es la referencia. Aquí es donde detectas los peores fallos, sin poner en juego la confianza de tus clientes. Mi guía de pruebas de simulación cubre la evaluación y los tamaños de muestra.
- Evalúa manualmente una muestra a ciegas. Mezcla respuestas de la IA y respuestas humanas sobre los mismos temas, oculta cuál es cuál y puntúalas con los mismos criterios: correcta, parcialmente correcta, incorrecta, debería haberse derivado. Una ficha de evaluación de calidad funciona bien aquí.
- Después compara las cifras en vivo, por tema y durante el mismo plazo. Tasa de reapertura, CSAT, tiempo de resolución y costo por ticket resuelto, IA frente a humanos, tema por tema.
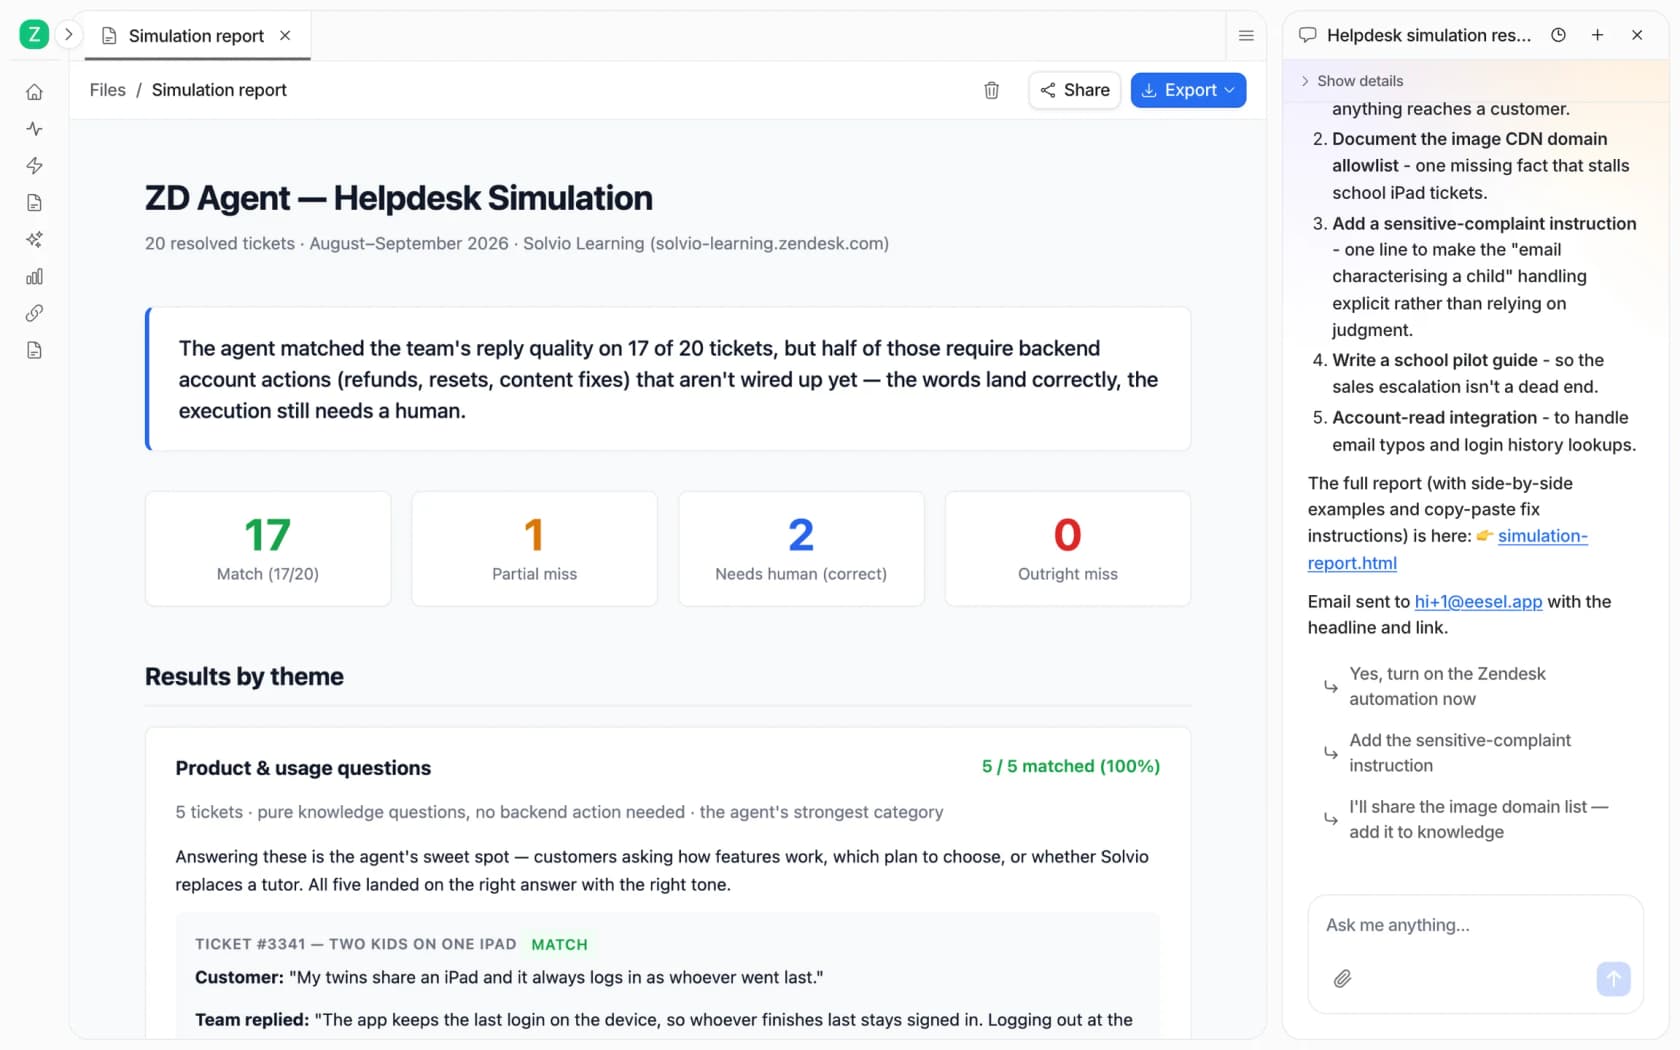
El paso 4 importa más de lo que parece. En una prueba con tráfico real que eesel realizó para una tienda alemana de joyería en línea que usaba Zendesk y Shopify, el mismo agente obtuvo un 93% de precisión en la clasificación inicial, tuvo una tasa de errores factuales del 7% y, aun así, solo el 12% de sus borradores se enviaron tal cual. Tres cifras verdaderas de una misma prueba que cuentan tres historias distintas. Cuando analicé las reescrituras, aproximadamente el 65 % consistía en que el equipo acortaba el borrador o cambiaba su tono, lo cual es un problema de estilo, no de exactitud. Si hubiera evaluado solo el porcentaje "enviado tal cual", habría considerado un fracaso a un agente que acertaba la mayoría de las veces.
Otra muestra me enseñó una segunda lección: prueba con tickets reales, no con las preguntas que harías en una demostración. En una muestra de 434 chats que eesel revisó, los chats de IA obtuvieron un 86 % de valoraciones positivas en general, pero un 79 % en los chats procedentes de tickets reales de soporte. Tus propias preguntas siempre son más fáciles que las de tus clientes.
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Responsable de experiencia del cliente de una marca de suplementos de venta directa al consumidor que usa Gorgias y Shopify, en una llamada comercial con eesel
Esa cita es la razón práctica para evaluar por tema. No puedes auditarlo todo, así que la verdadera función de la evaluación comparativa es decirte de qué temas puede hacerse cargo la IA y cuáles debe derivar.
¿Qué cifras deben aparecer en tu ficha de evaluación comparativa de IA?
Menos de las que te muestra tu panel. Yo me quedaría con cinco, todas medidas por tema y calculadas a partir de tus propios datos, no del campo de resolución del proveedor.
| Métrica | Cómo calcularla | Por qué está en la lista |
|---|---|---|
| Tasa de participación | Tickets en los que intervino la IA ÷ todos los tickets | Te indica qué parte de la cola llega siquiera a ver la IA |
| Tasa de contención | Tickets de IA sin respuesta humana ÷ tickets de IA | Aproximadamente lo que la mayoría de los proveedores llama resolución. Útil, pero generosa |
| Tasa de resolución verificada | Tickets contenidos que no se reabrieron en 7 días y superaron el control de calidad ÷ tickets de IA | La versión honesta de la cifra anterior |
| Tasa de automatización de principio a fin | Resoluciones verificadas ÷ todos los tickets | La que le importa al área de finanzas |
| Resolución en el primer contacto y CSAT, más el costo por resolución verificada, IA frente a humanos | La misma fórmula para ambos, los mismos temas, el mismo plazo | La comparación directa real |
La diferencia entre contención y resolución verificada es la cifra individual más útil que calcularás. Si es pequeña, la cifra del proveedor se aproxima lo suficiente como para confiar en ella. Si es grande, el agente está cerrando tickets que no están realmente cerrados. Una persona que gestionaba estas operaciones en Reddit lo aprendió por las malas:
"i track cost per resolution with a 48 hour window for reopens, automation rate alone is basically useless we had a period where our "automation rate" looked incredible but half those customers were just giving up and calling in later, the dashboard was lying to us"
Introduce tus propios datos del mes para ver la diferencia:
Con las cifras predeterminadas, los mismos 6.000 tickets de IA se interpretan como un 70 % de contención y un 52 % de resolución verificada, y solo el 31 % de toda la cola está realmente automatizado. Las tres cifras son honestas. Solo una de ellas es la que deberías presentar a tu jefe. Para un conjunto más amplio de métricas, mi guía de métricas de atención al cliente con IA profundiza en el tema. El artículo sobre KPI de atención al cliente cubre los objetivos para personas, y el de referencias de costo por ticket cubre la parte humana de la comparación de costos.
¿Cómo es un buen resultado en la práctica?
Un buen resultado es una proporción de temas de los que la IA se hace cargo por completo, que crece de forma deliberada, no un gran porcentaje desde el primer día. Las historias de clientes de eesel lo muestran con más claridad que cualquier promedio, porque informan del reparto del trabajo en lugar de dar una sola tasa.
- ClutchLoop, una marca de accesorios para teléfonos que usa Gorgias y Shopify, tuvo unas
180respuestas enviadas directamente a clientes en un mes, "about seven in ten conversations, no person needed". - Question Beauty, una marca de cosméticos que usa Gorgias, registró unos
280tickets cerrados por eesel y unos250asignados a una persona, de un total de990gestionados. - SE Ranking, que usa Zendesk, tuvo
2,100chats en vivo respondidos primero por eesel de un total de4,650conversaciones. Ahora está probando respuestas directas por correo electrónico con tickets de prueba seleccionados por su línea de asunto, con cada hilo etiquetado como abierto, resuelto, escalado o en manos de una persona, y un hilo solo cuenta como resuelto "once the customer says it worked". Es un criterio más estricto que el de cualquier proveedor de la tabla anterior. - Cactus Club Cafe gestiona el soporte interno de TI en Zendesk y eligió el enfoque opuesto:
790borradores de respuesta para el equipo técnico "against 51 sent directly". Para sus tickets, mantener a una persona en el proceso es el objetivo de referencia adecuado.
"In the first month, eesel is resolving 73% of our tier 1 requests. eesel offers easy Zendesk implementation and setup. Our team implemented and achieved results quickly during our 7-day trial."

Fíjate en el alcance de esa reseña: solicitudes de nivel 1, no todos los tickets. Así es exactamente como debería citarse una evaluación comparativa. Si alguien te da una tasa de resolución sin decir qué tickets cubre y cómo se decidió qué era "resuelto", todavía no tienes una referencia comparativa. Para ver cómo mejorar la cifra una vez que la hayas medido, consulta mi guía para mejorar la tasa de resolución.
¿Cuáles son los errores más comunes al evaluar comparativamente la IA?
La mayoría surge de medir lo fácil porque el panel ya lo muestra.
- Evaluar solo preguntas que se pueden responder. Si tu conjunto de pruebas solo contiene preguntas cubiertas por tu documentación, pasarás por alto el peor fallo: que el agente invente una respuesta cuando la base de conocimientos no contiene nada. Añade preguntas que sepas que no puedes responder y comprueba que, en su lugar, derive el caso. Mi artículo sobre alucinaciones de la IA en soporte trata este tema.
- Contar cierres en lugar de aciertos. Una respuesta incorrecta que suena correcta también puede cerrarse como resuelta.
"The hardest ones are wrong answers that sound right. Nothing errors, the customer doesn't push back, and the ticket can close as resolved. If a refund window changes and the agent is still working from the old policy text, the resolution rate won't flag it, because that metric only counts closures."
- Confiar en una sola ejecución. tau-bench mostró que las puntuaciones caían aproximadamente entre un tercio y la mitad cuando la misma tarea tenía que completarse correctamente cuatro veces. Vuelve a ejecutar tu conjunto de pruebas después de cada cambio en las instrucciones o la documentación y busca respuestas que cambien.
- Usar muy pocos tickets por tema. Un 85 % sobre 20 tickets supone un intervalo del 64 % al 95 %. Es una primera impresión, no un veredicto.
- Dejar fuera las entradas complicadas. Los clientes pegan mal los números de pedido, escriben en dos idiomas y, de vez en cuando, intentan convencer al bot de que les dé un descuento. Las pruebas adversarias deben formar parte del conjunto.
- Comparar con el promedio de un proveedor. El promedio de un proveedor procede de su propia combinación de clientes y de su propia definición. Tu referencia es tu equipo.
Si todavía estás eligiendo una herramienta, mi lista de verificación para evaluar proveedores incorpora este tipo de prueba con tickets al proceso de compra. Mi plantilla de solicitud de propuestas también lo hace, para que todos los proveedores se evalúen con los mismos tickets.
Evalúa comparativamente tu agente de IA con eesel
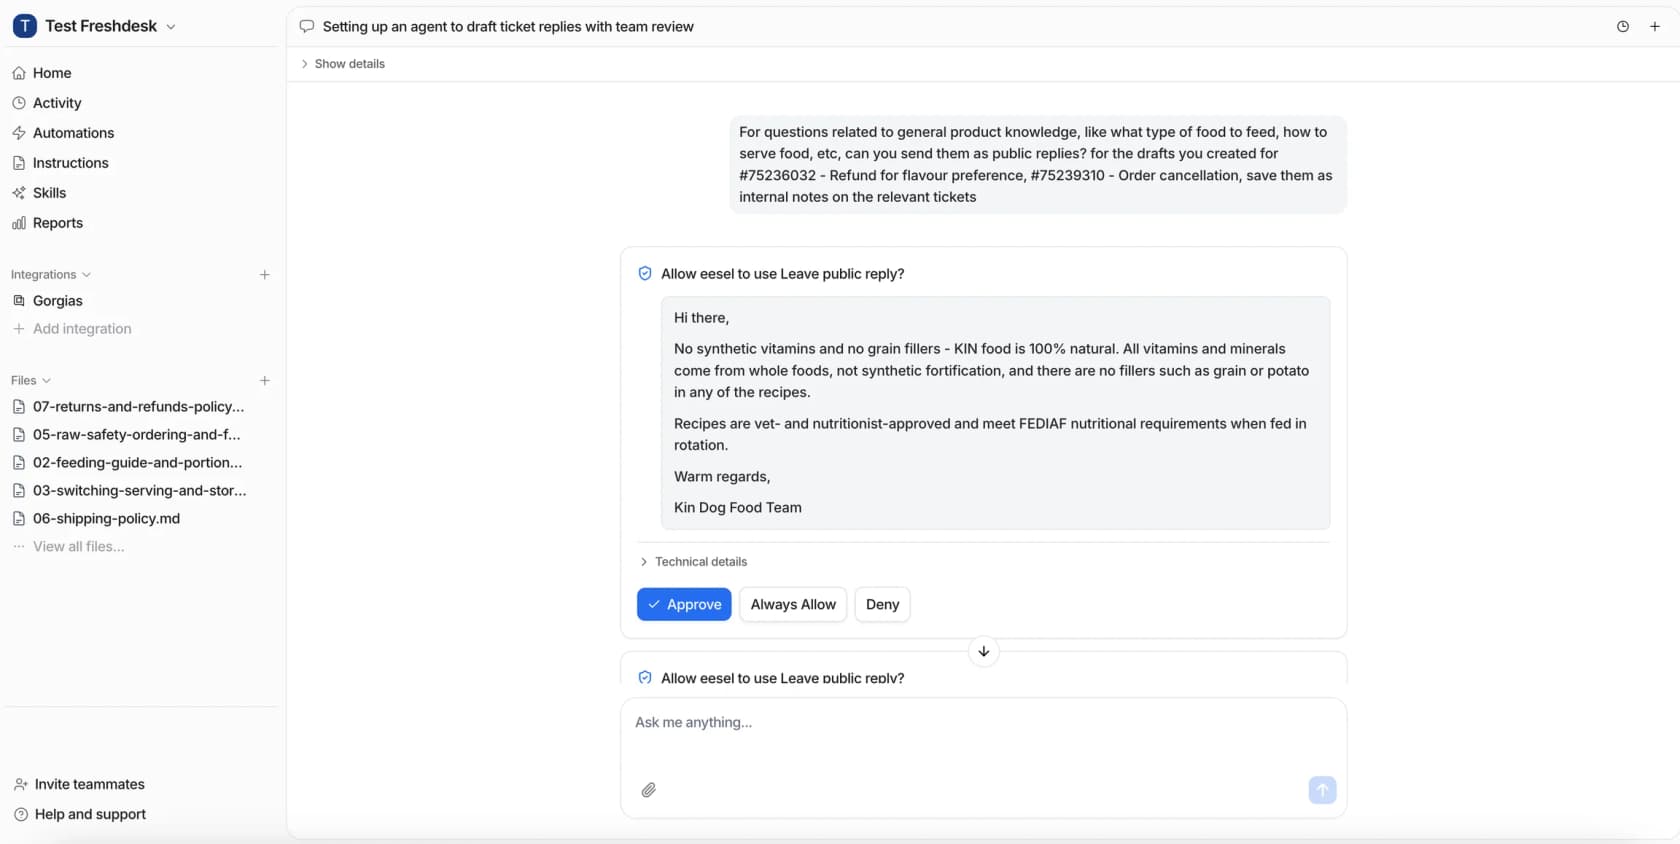
eesel es un compañero de equipo de soporte con IA que se incorpora a tu cola existente, ya sea en Zendesk o en otra plataforma de soporte, y la evaluación comparativa forma parte de su puesta en marcha. Según la documentación de eesel, su simulación "replays your real past tickets and compares its answers to what your team sent", después puntúa los resultados por tema y sugiere correcciones en las instrucciones.
La implementación sigue los mismos pasos que el método anterior: empieza con borradores, deja que responda a los temas fáciles y activa más cuando las puntuaciones lo justifiquen. Funciona igual en las colas de Freshdesk, y la integración con Gorgias sigue el mismo proceso de implementación.
Si quieres tu propia referencia comparativa en lugar del promedio de un proveedor, ejecuta una simulación con los tickets resueltos del mes pasado y comprueba, tema por tema, dónde la IA está al nivel de tu equipo. Los planes de pago empiezan en 299 $ por 500 créditos, y cada ticket o chat consume un crédito. Prueba eesel primero con tus propios tickets.