

¿Qué es la calibración de QA en soporte?
Zendesk lo explica con claridad en su guía de configuración de la calibración: la calibración es "the practice of having all your reviewers rate the same batch of conversations and compare their scores and comments." Esa es toda la idea. Las mismas conversaciones, la misma scorecard de QA, personas distintas, y luego una conversación sobre por qué los números no coinciden. Si aún no has creado la scorecard, empieza por la creación de scorecards en Zendesk QA y vuelve.
Trabajo la cola de soporte de eesel todos los días, y la razón por la que esto importa es que las puntuaciones de QA no se quedan dentro de la herramienta de QA. Acaban en las reuniones 1:1, en los planes de coaching, a veces en los bonus. Si un revisor da a una respuesta un 4 sobre 5 en tono y otro le da un 2 a esa misma respuesta, la puntuación del agente depende de en qué cola le tocó caer. Los agentes lo notan rápido, y cuando deciden que el QA es una lotería, el feedback deja de calar.
"You could have five QA agents listen to the same call and get five different results. Which isn't fair to the agent as that score could be used to determine if they'll be fired."

La calibración es la solución. No es una sesión de formación para agentes, y en la mayoría de las herramientas los agentes nunca la ven. La guía de configuración de Zendesk dice "Agents do not see any conversation-related information in calibration", y las puntuaciones de calibración "don't affect the existing Internal Quality Score (IQS)." Es un control de los evaluadores, hecho por los evaluadores.
Por qué las puntuaciones de QA se separan
Los revisores no discrepan al azar. Discrepan en las categorías donde la rúbrica deja margen al criterio: tono, empatía, "¿tenía la respuesta la longitud adecuada?", "¿hizo el agente un esfuerzo extra?". El proceso y la precisión suelen coincidir, porque una política de reembolsos se cumple o no se cumple. El tono es donde dos personas cuidadosas leen la misma frase y acaban a dos puntos de distancia.
La otra fuente de desviación es qué significa "aprobar" en primer lugar. Aquí va un ejemplo real del propio trabajo de eesel. Analicé una prueba con tráfico real en una bandeja de Zendesk de un e-commerce, donde 284 respuestas redactadas por IA se evaluaron de tres formas distintas.
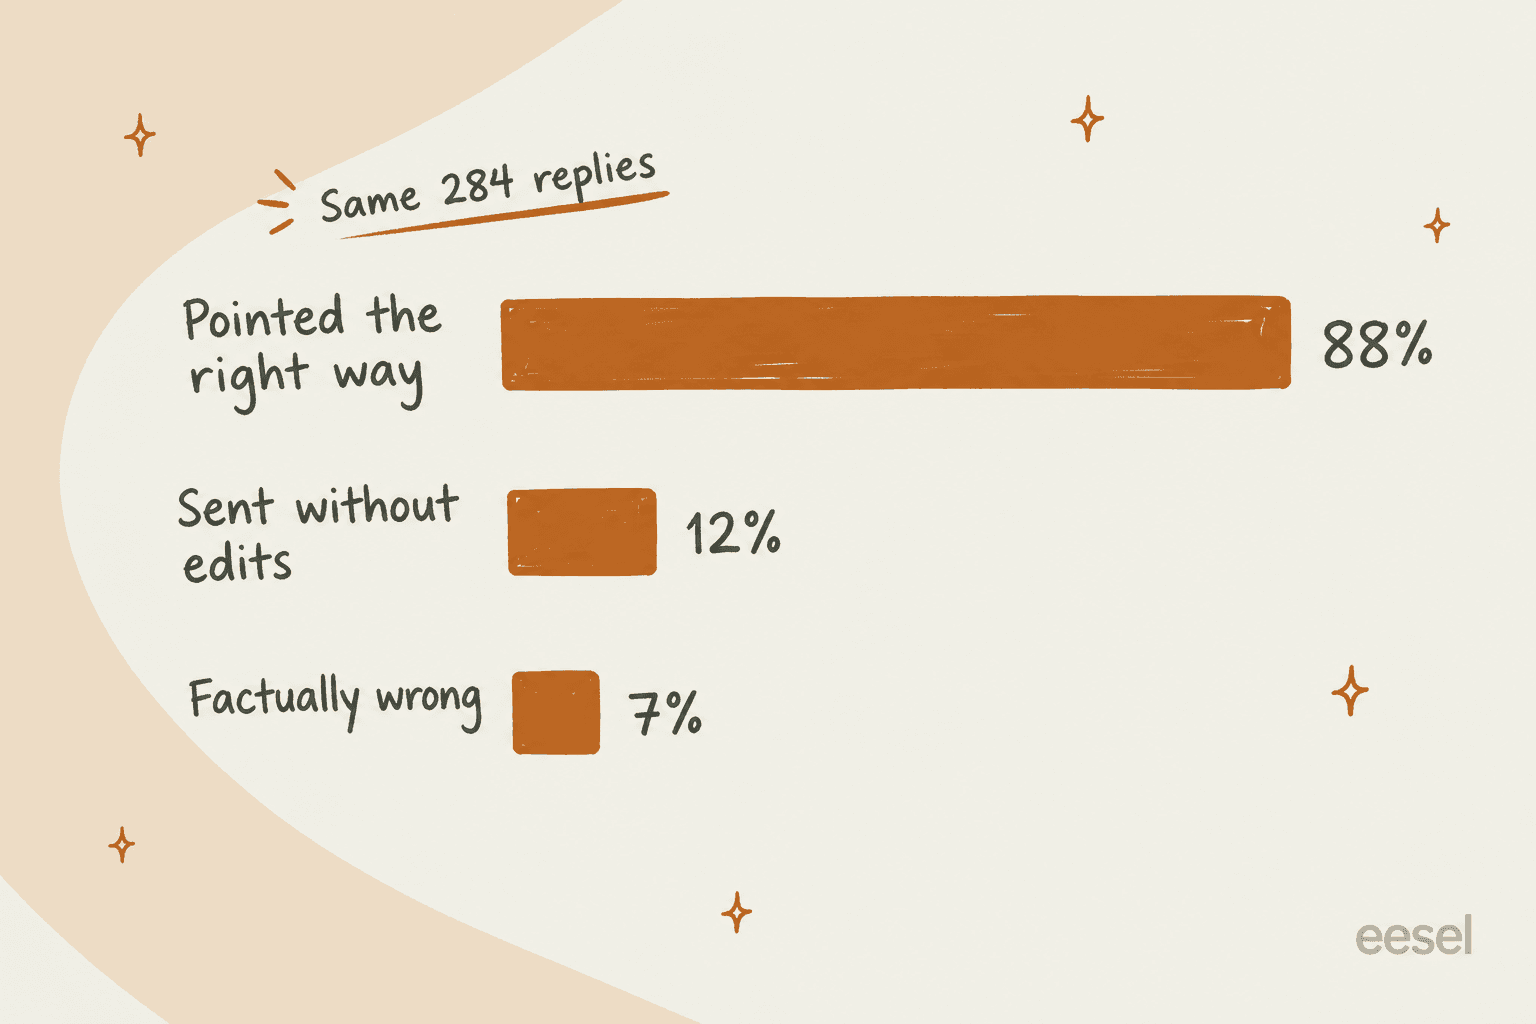
Las mismas respuestas, tres veredictos: el 88 % apuntaba en la dirección correcta, solo el 12 % se envió sin ediciones y el 7 % era incorrecto en los hechos. Ninguna de esas cifras es errónea. Simplemente responden a preguntas distintas. Un revisor que evalúa "¿enviaría esto tal cual?" y otro que evalúa "¿es correcta la respuesta?" puntuarán la misma cola a kilómetros de distancia, y ambos creerán que están siendo justos. Cuando investigué por qué los agentes reescribían los borradores, alrededor del 65 % de las reescrituras eran por longitud y tono, alrededor del 20 % necesitaban datos del pedido que el borrador no podía ver y alrededor del 5 % era porque el borrador era incorrecto en los hechos. La longitud y el tono son justo las categorías en las que los revisores humanos también se dividen. (Desglosé ese tipo de análisis de reescrituras en mi guía de análisis de errores.)
Por eso la calibración empieza por el listón, no por la puntuación. Si tu scorecard no dice qué diferencia a un 3 de un 4 en tono, ninguna discusión logrará que los revisores se pongan de acuerdo por mucho tiempo.
Cómo hacer una sesión de calibración de QA
Esta es la sesión que haría yo, en cinco pasos. Lleva aproximadamente una hora al mes, más de 10 a 15 minutos de puntuación por revisor de antemano.
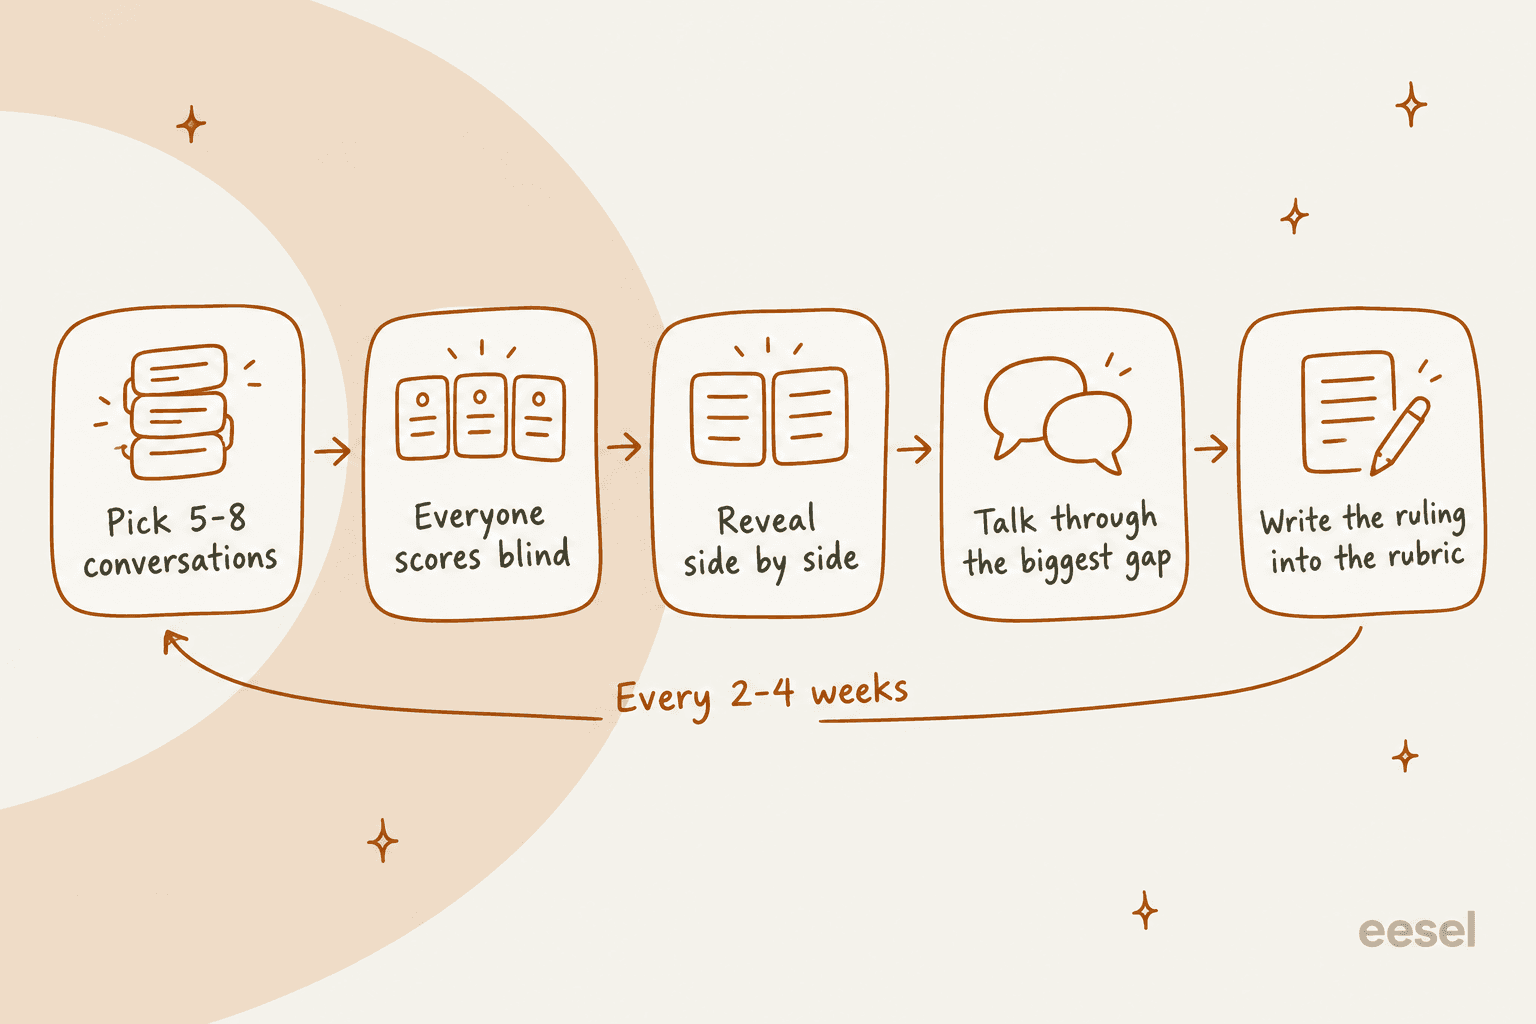
1. Elige de 5 a 8 conversaciones que provoquen discusión
La guía de calibración de Zendesk sugiere empezar con unas cinco conversaciones. Yo subiría a ocho cuando el equipo ya esté acostumbrado. Más que eso y la discusión se hace con prisas.
La selección importa más que la cantidad. Los tickets fáciles no te enseñan nada, porque todos los puntúan igual. El consejo sobre calibración de MaestroQA es elegir tickets con puntuaciones de QA bajas, temas complicados o un proceso o producto que haya cambiado recientemente. evaluagent añade un punto razonable en su explicación de la calibración: mantén el conjunto equilibrado, no solo interacciones malas, o la sesión se convierte en una revisión de culpas.
Mi mezcla: una conversación que toque una política que acaba de cambiar, una donde el cliente estaba molesto desde el primer mensaje, un hilo largo con muchas respuestas, una que fue bien pero dejó una sensación "rara", y una que un agente disputó hace poco. Si das soporte en más de un idioma, añade también una conversación que no esté en inglés; mi guía de QA de soporte multilingüe explica cómo calibrar entre equipos de distintos idiomas.
2. Todos puntúan a ciegas
Este es el paso que los equipos se saltan, y es el que hace que funcione el resto. Si los revisores pueden ver las puntuaciones de los demás, o puntúan juntos en la sala, la primera persona segura de sí misma fija el número y todos se desplazan hacia él. El webinar sobre calibración de evaluagent describe la versión en papel de este problema: la gente "can change their scores on their paper, and they can be swayed to another person's point of view before they get an opportunity to speak."
En Zendesk QA, a ciegas o abierto es un ajuste del espacio de trabajo que eliges por rol. Se puede configurar que los revisores vean solo sus propias revisiones, o que vean las de sus compañeros únicamente después de enviar las suyas. Los responsables y gerentes tienen la misma opción de "después de enviar", o "siempre".
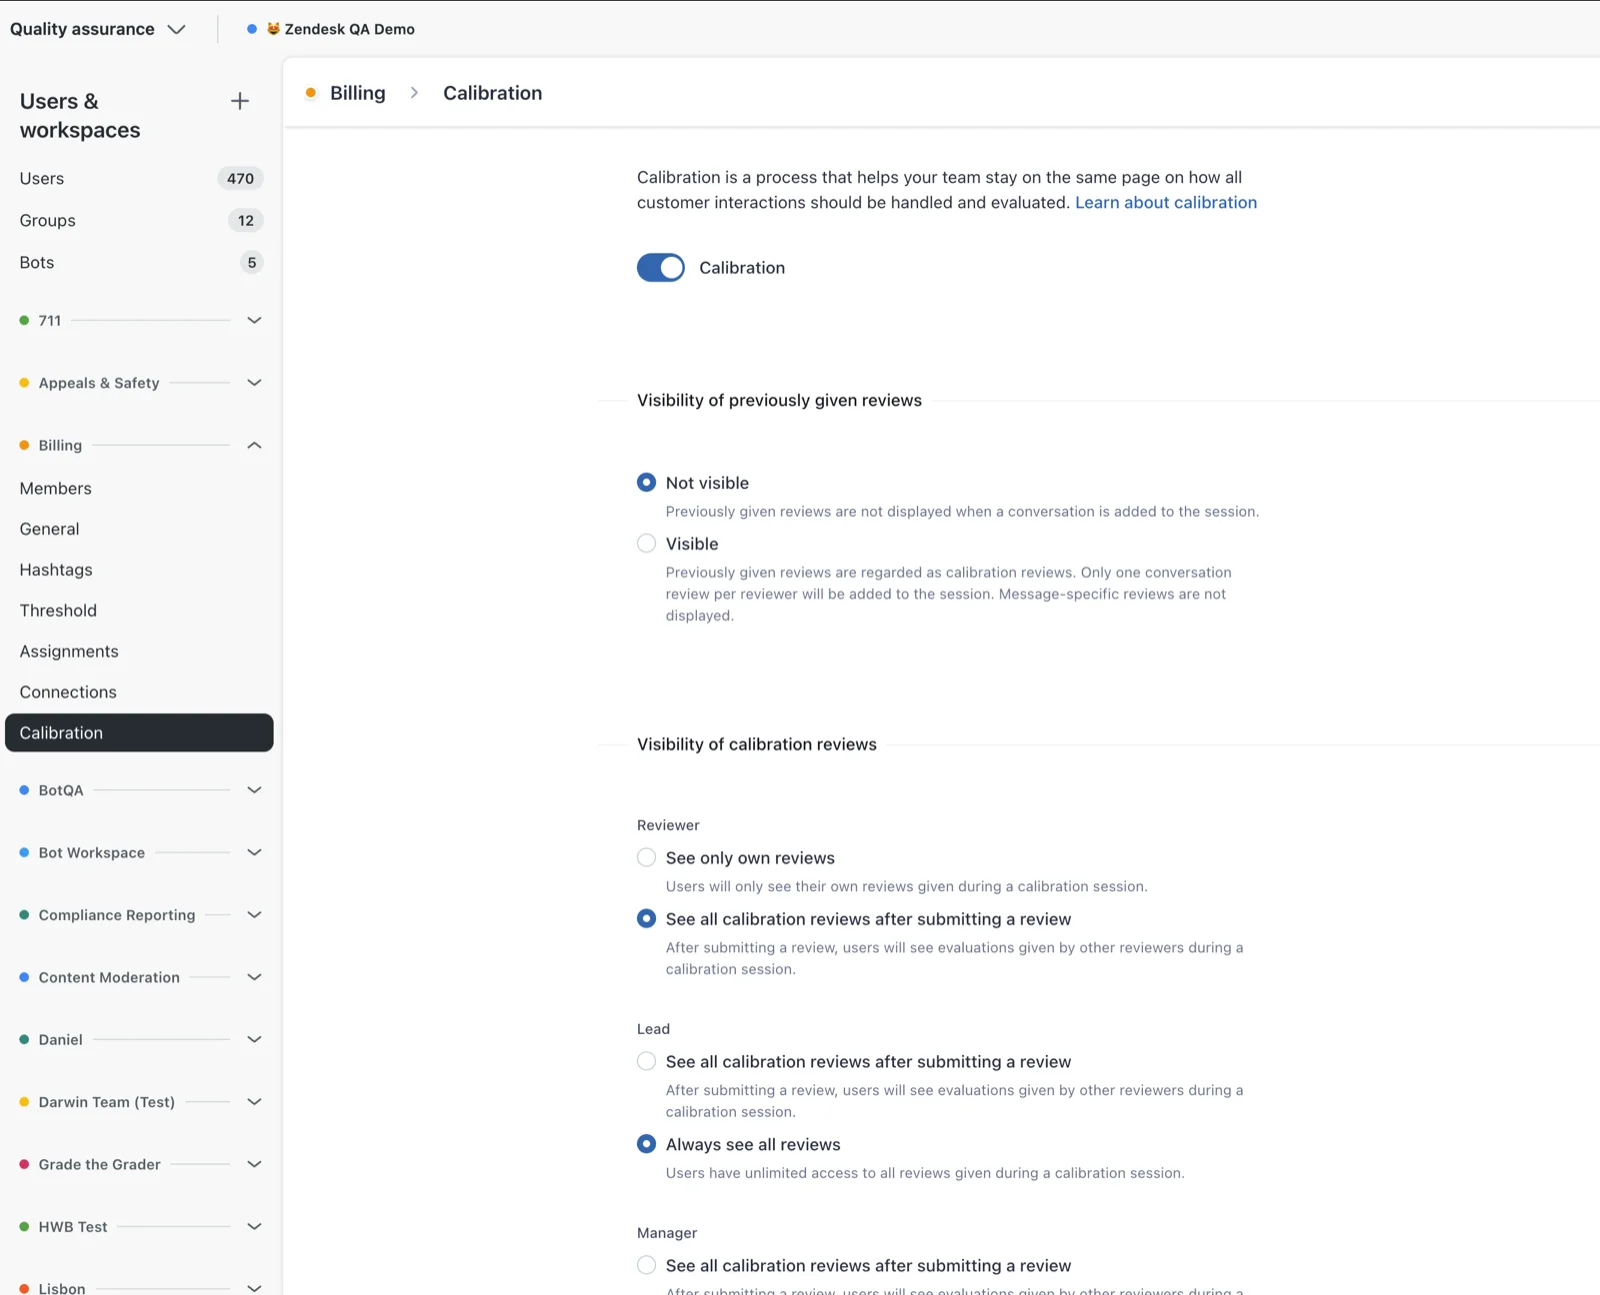
Un detalle práctico: Zendesk QA no envía notificaciones de calibración. Según la documentación de Zendesk, "it's up to the workspace manager or lead to inform reviewers about the calibration session and its due date." Pon la fecha límite en el canal del equipo, o la mitad de los revisores puntuará 10 minutos antes de la reunión.
3. Revela las puntuaciones lado a lado, frente a una referencia
Cuando todos hayan puntuado, pon las puntuaciones en una cuadrícula: los revisores en un lado, las categorías de la scorecard arriba. Buscas dos cosas, a las que vuelvo en la siguiente sección: categorías con mucha dispersión y revisores que se desvían en todo.
También necesitas una referencia, es decir, una puntuación "correcta" acordada con la que comparar. Zendesk QA permite que un gerente marque una revisión como Baseline review, lo que, según Zendesk, "makes it easier to compare scores against it." El panel de calibración muestra entonces la puntuación de cada revisor junto a la puntuación de referencia.
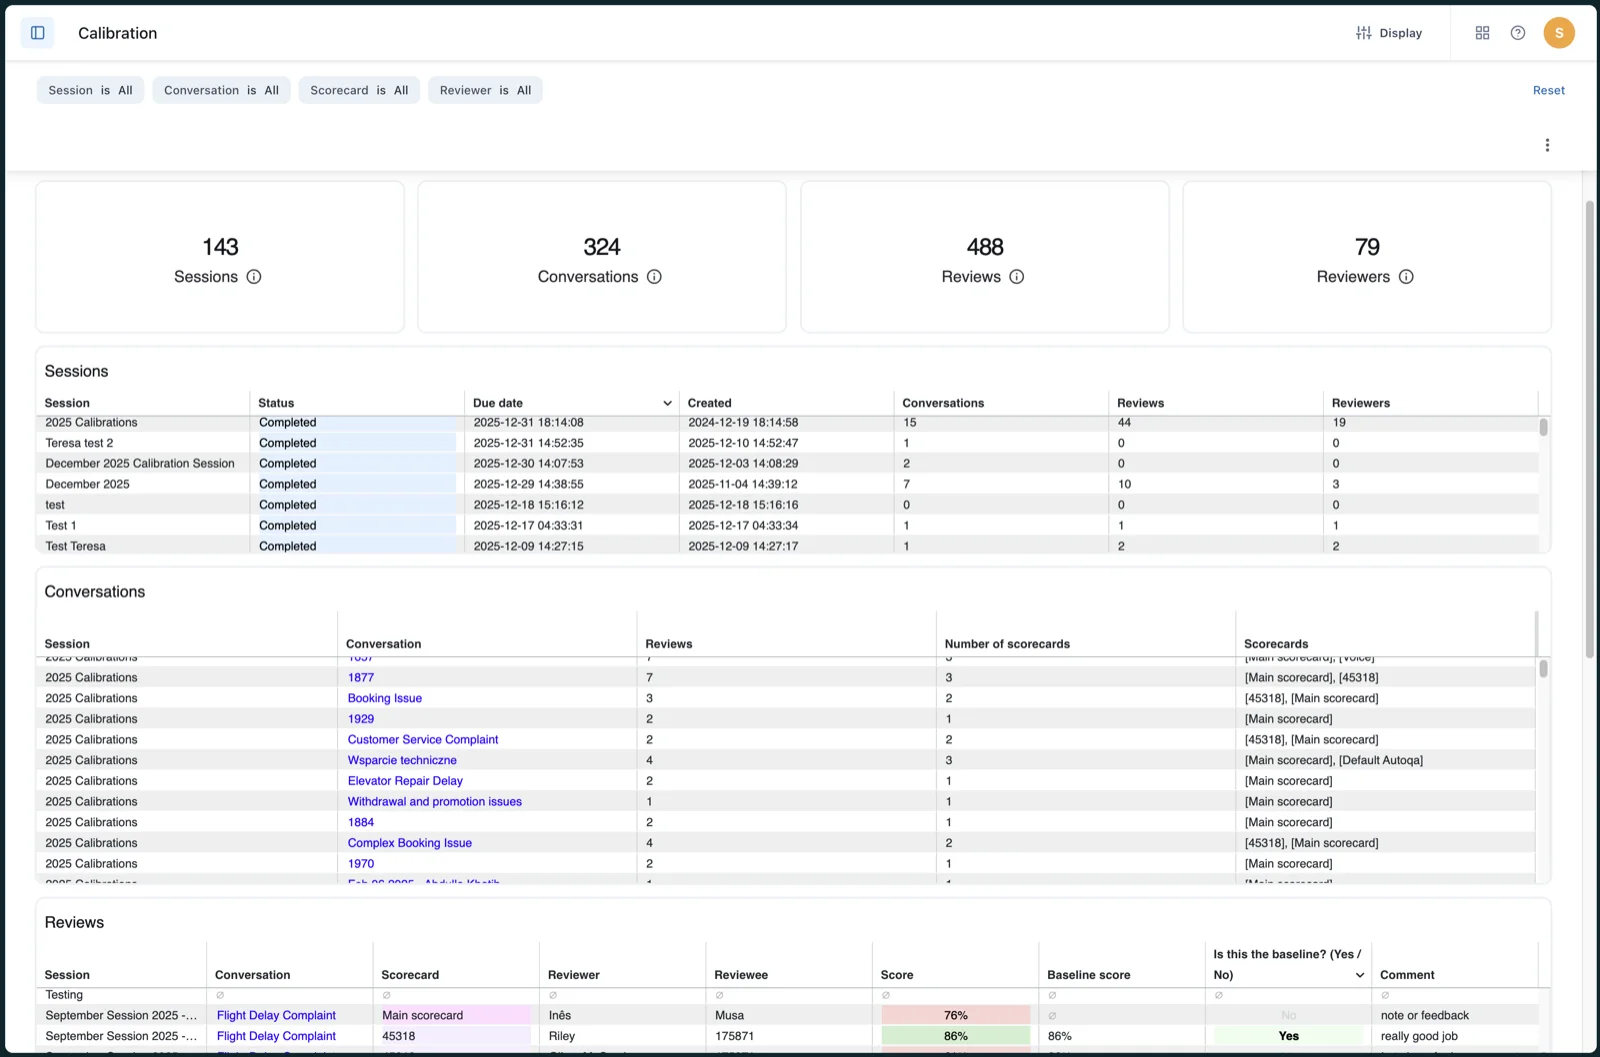
MaestroQA hace lo mismo con un calibrador final designado. Su guía de alineación de equipos llama a esa persona "your source of truth to measure alignment against", y cada evaluador recibe una puntuación de alineación frente a ella.
4. Habla de la mayor diferencia, no de todas
Con 5 conversaciones y 6 categorías tienes 30 lugares donde discrepar. No vas a poder con todos en una hora, y no deberías intentarlo. Ordena por dispersión y dedica la reunión a las dos o tres diferencias más amplias.
El objetivo es una decisión, no un consenso. Un directivo de Stitch Fix citado en la página de calibraciones de MaestroQA lo expresó bien: "We've normalized the expectation that we're driving toward commitment, not consensus." evaluagent dice lo mismo desde el otro lado: "It's not a democracy, if you like, where majority rules." Si tres revisores dicen 4 y uno dice 2, la respuesta no es automáticamente 4. Decide la persona que mejor conoce la política, y todos se comprometen con esa decisión.
5. Escribe la decisión en la rúbrica
Aquí es donde la mayoría de las sesiones de calibración fracasan en silencio. El equipo se pone de acuerdo, todos asienten, y tres semanas después reaparece el mismo desacuerdo porque no se anotó nada.
Cada diferencia resuelta debe convertirse en una línea de la guía de tu scorecard, con la conversación como ejemplo práctico. "Tono: una respuesta que se disculpa dos veces por el mismo problema puntúa 3, no 4. Ejemplo: ticket #48213." Ese es el artefacto que acorta la siguiente sesión. También alimenta tus SOP de soporte y los ejemplos que usas en el onboarding de nuevos agentes, ya que un recién llegado necesita las mismas decisiones que tus revisores acaban de acordar. Las buenas decisiones se leen como buenos ejemplos de feedback de QA: específicas, ligadas a una línea de la conversación y breves.
Un responsable de QA en r/callcentres describió la versión estricta de esto:
"Calibrations by quality need to be strictly enforced and maintained. My last team I ran was quality and every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
¿Problema de la rúbrica o del revisor?
Esta es la parte de la calibración que creo que la mayoría de las guías omite, y es la más útil. Cuando las puntuaciones no coinciden, el patrón del desacuerdo te dice qué arreglar.
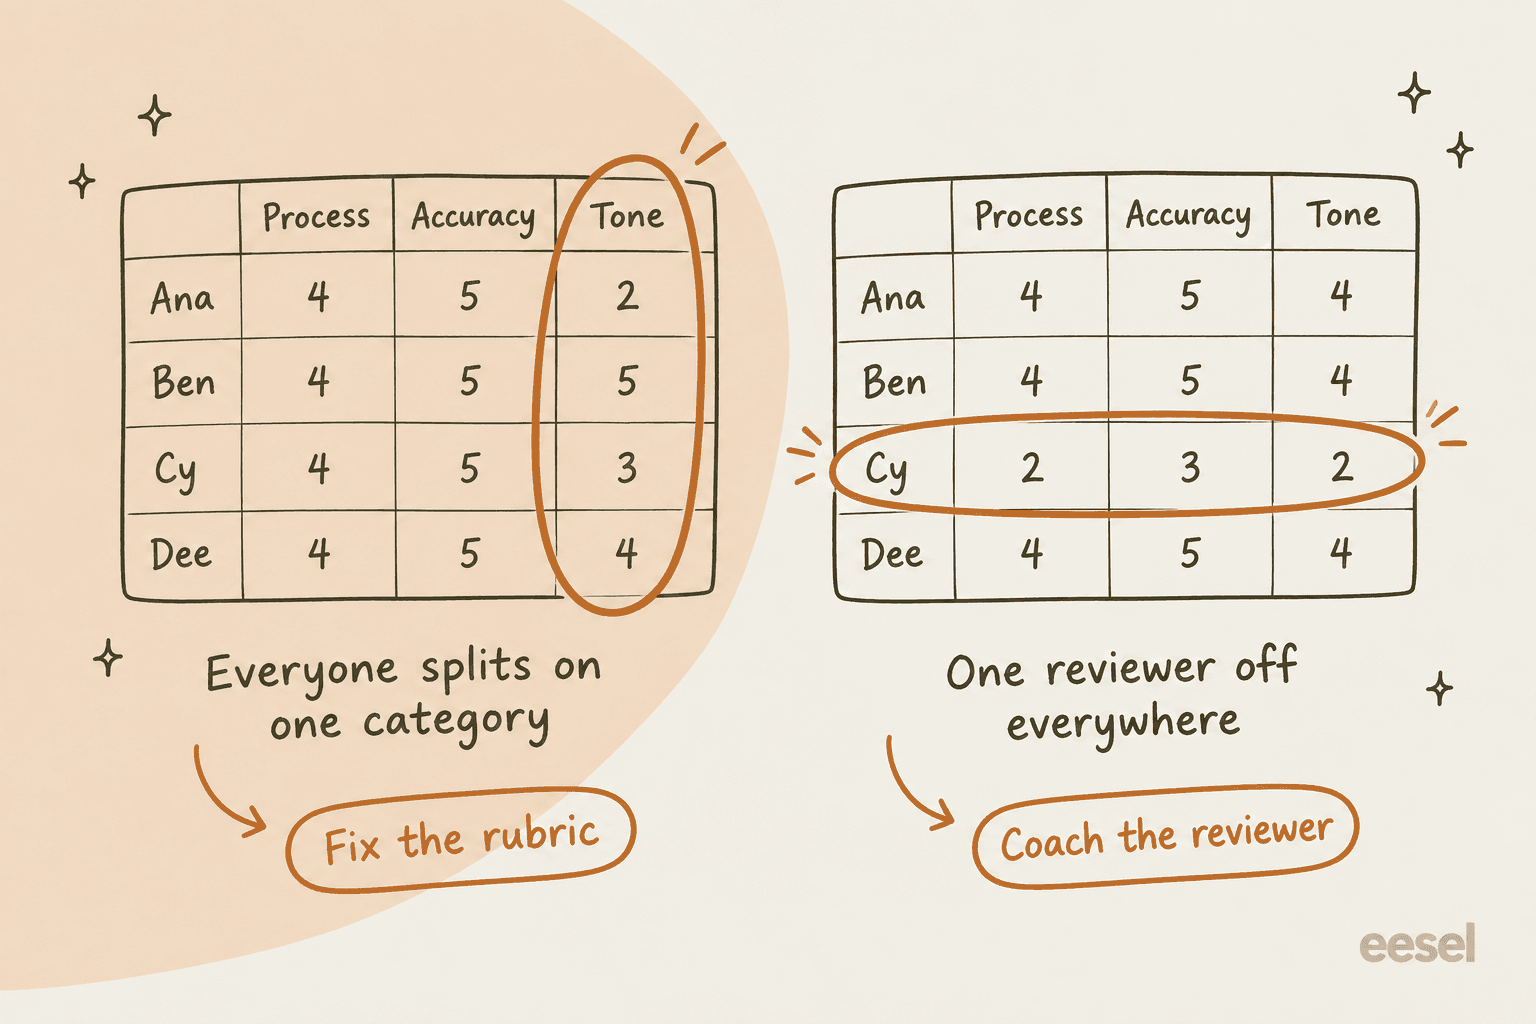
Todos se dividen en una categoría. Si el proceso y la precisión coinciden pero el tono va de 2 a 5 entre cuatro revisores, nadie está "equivocado". El criterio está abierto a interpretación, así que arregla la rúbrica. Reescribe la guía de tono con ejemplos concretos (mi guía de tono en atención al cliente tiene una plantilla) y vuelve a puntuar la misma conversación en la siguiente sesión para comprobar que la diferencia se cerró.
Un revisor se desvía en todo. Si una persona puntúa dos puntos por debajo del resto en todas las categorías, la rúbrica está bien. Ese revisor la está leyendo de otra manera, así que haz coaching al revisor. Siéntate con él, igual que harías para hacer coaching a un agente, repasa una conversación categoría por categoría y haz que puntúe otra por su cuenta.
Todo el equipo se aleja de la referencia en la misma dirección. Todos ponen 4 y el responsable puso 2. Normalmente significa que el responsable sabe algo que el equipo no, como un cambio de política que nunca llegó a la base de conocimiento. Es un problema de comunicación, no de puntuación.
Pruébalo con tus propios números. Introduce las puntuaciones de cada revisor para una conversación y el verificador te dice cuál de estos casos tienes delante.
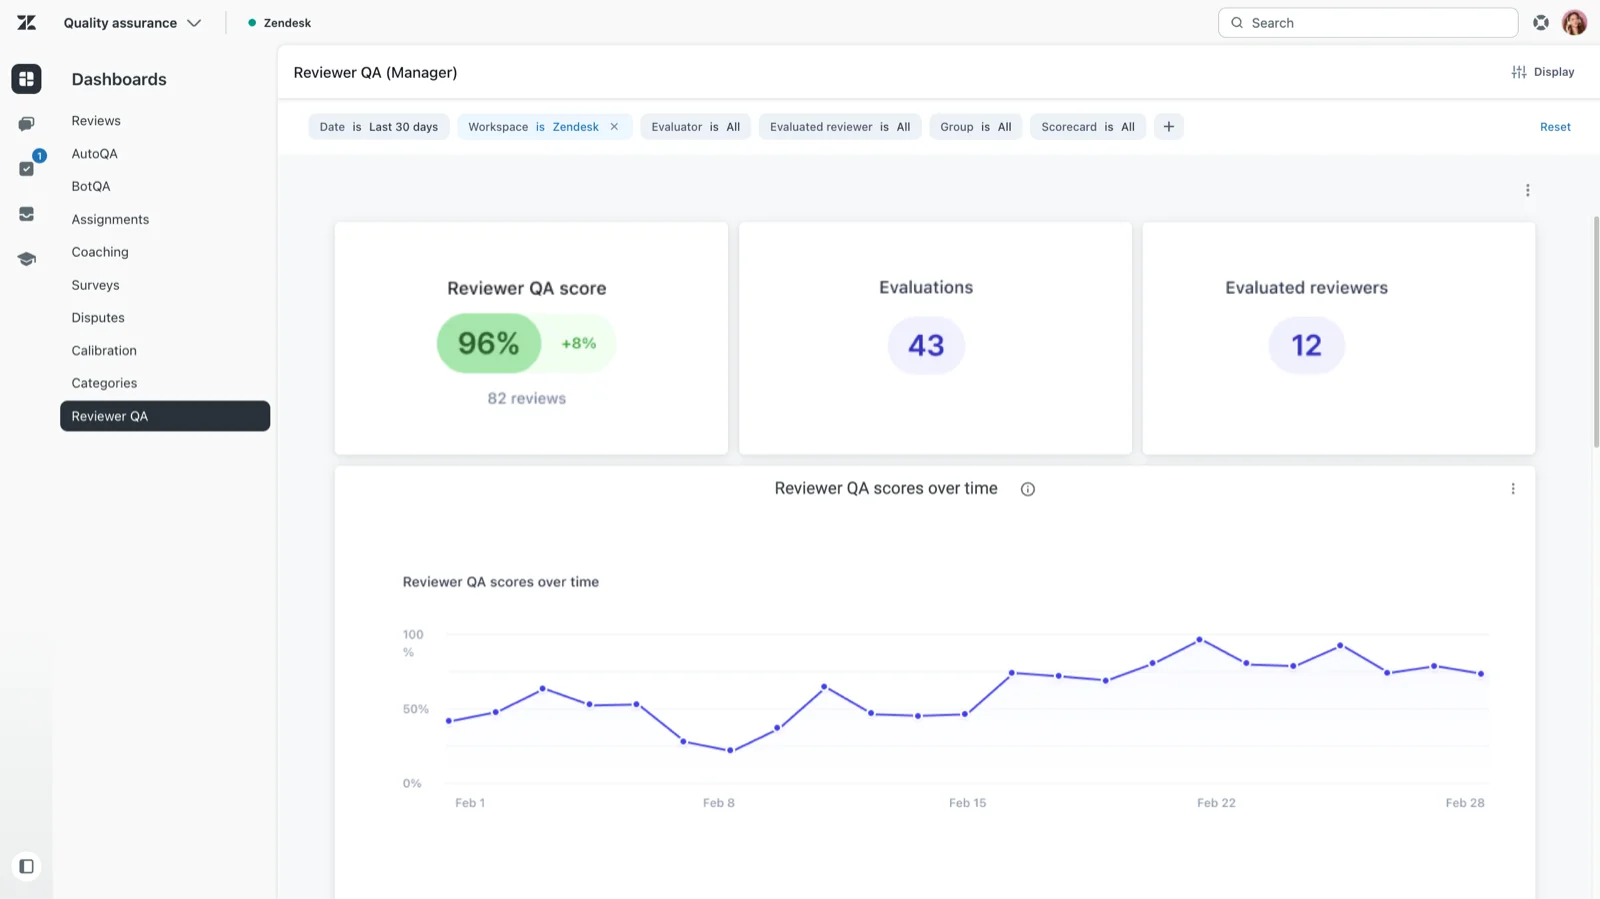
Zendesk QA también sigue el lado del revisor a lo largo del tiempo con un panel aparte de Reviewer QA. Funciona con asignaciones aleatorias en las que alguien evalúa las propias revisiones de los revisores, y la documentación del panel de Zendesk dice que sirve para "track reviewer accuracy, evaluation history, and coaching trends." Los revisores evaluados ven sus propias puntuaciones pero no pueden ver quién los evaluó.
¿Qué cuenta como "calibrado"?
Ningún proveedor de QA que revisé publica una nota de aprobado fija. Esto es lo que usan, en cambio, quienes se dedican a esto.
| Fuente | Objetivo de calibración | Frente a qué se mide |
|---|---|---|
| Guía de calibración de Zendesk | Diferencia "usually falls around 5 percent" | Referencia fijada durante la sesión |
| u/mattemer en r/callcentres | Dentro del 3 %, algunos elementos al 100 % | Puntuación acordada por el grupo |
| MaestroQA | Puntuación de alineación por evaluador, sin umbral fijo | Puntuación del calibrador final |
| Scorebuddy | % de respuestas coincidentes, más Avg Variation | La puntuación original que se vuelve a puntuar |
| Zendesk QA AutoQA | Más del 75 % de precisión es "alta concordancia" | Puntuaciones de revisores humanos |
Mi opinión: busca que cada revisor esté a unos 5 puntos de la referencia en la puntuación total, y que no haya ninguna categoría en la que los revisores estén a 2 o más puntos en una escala de 5. Luego añade la regla de la cita de r/callcentres de arriba: algunos elementos tienen que ser 100 %. Una verificación de identidad omitida o un importe de reembolso incorrecto no es cuestión de gustos. Márcalos como elementos críticos o de fallo automático en la scorecard (mi guía de criterios de scorecard muestra cómo hacerlo en Zendesk QA) para que nunca se "calibren" hasta una puntuación parcial.
Vigila también el total. Dos revisores pueden llegar al mismo 80 % global y discrepar en tres categorías de fondo, uno alto donde el otro es bajo. Compara siempre por categoría, no solo la puntuación global.
¿Con qué frecuencia deberías calibrar?
La respuesta honesta es "más a menudo de lo que lo haces ahora". Esto es lo que sugieren proveedores y profesionales:
- Programa de QA nuevo o scorecard nueva: la guía de MaestroQA dice que ve equipos calibrar "as frequently as once a week", pasar a mensual cuando la alineación es alta y volver a subir cuando se lanza una rúbrica nueva.
- Régimen estable: la guía de Zendesk dice que las sesiones mensuales sirven para la mayoría de los equipos, y "the more reviewers you have, the more often you should calibrate."
- Equipos de QA grandes: un antiguo responsable de QA en r/callcentres hacía "a weekly calibration call so that everyone was on the same page" junto con 5 auditorías por agente al mes.
Un analista de QA en solitario en r/talesfromcallcenters describió la otra cara, en la que el evaluado es el propio revisor:
"I was the lone QA agent for a call center of 55-70 people. We had a calibration session each week which involved the call center manager, the management staff, and myself. They chose ten calls that I had evaluated to listen to and score... I was held to a 95% accuracy rating which compared to the average of their call scores."
Yo añadiría un disparador que no está en ningún calendario: calibra después de cualquier cosa que cambie lo que significa "correcto". Un cambio de precios, una nueva política de devoluciones, una nueva vía de escalado. Ahí es cuando los revisores se desvían más rápido, porque algunos conocen el cambio y otros no. También conviene hacer una sesión cuando se une un revisor nuevo, igual que acortarías el tiempo de adaptación de un agente con ejemplos prácticos, antes de que sus puntuaciones cuenten para los KPI de soporte de nadie.
Funciones de calibración de QA comparadas
La mayoría de las herramientas de QA dedicadas tienen algún tipo de función de calibración. Se diferencian en si la puntuación es a ciegas, frente a qué se mide la "respuesta correcta" y qué ves después.
| Herramienta | Función | Puntuación a ciegas | Se mide frente a | ¿Lo ven los agentes? |
|---|---|---|---|---|
| Zendesk QA | Sesiones de calibración, Reviewer QA | Configurable por rol | Revisión de referencia fijada por un gerente | No |
| MaestroQA (ahora Rippit) | Team Calibration, Grade-the-Grader | Sí, los evaluadores solo ven su propia puntuación y la final | Calibrador final, puntuación de alineación | No documentado |
| Scorebuddy | Listas de calibración | No documentado | Puntuación original que se vuelve a puntuar | Interruptor opcional por lista |
| evaluagent | Sesiones de calibración, Check-the-Checker | Sí, "blind evaluate" | "Calibrated outcome" acordado | No documentado |
| Playvox (NICE) | Calibración | No documentado | "Expert opinions" | No documentado |
| Level AI | Calibración | No documentado | Referencia del auditor | No documentado |
Algunos detalles que conviene saber antes de elegir:
Zendesk QA necesita el complemento de QA o de Workforce Engagement Management. Cada plan Suite indica que Quality Assurance "Requires QA add-on", y el Workforce Engagement Bundle figura a 50 $ por agente al mes, facturado anualmente. La calibración no está reservada a un nivel superior además de eso. Un límite que conviene conocer: el panel de calibración lista conversaciones y sus revisiones, y un comentario de un cliente en el artículo de configuración señala que los datos "can only be downloaded conversation by conversation." Si quieres la tendencia de un revisor a lo largo de muchas sesiones, planea pasarla a una hoja de cálculo o apóyate en el panel Reviewer QA.
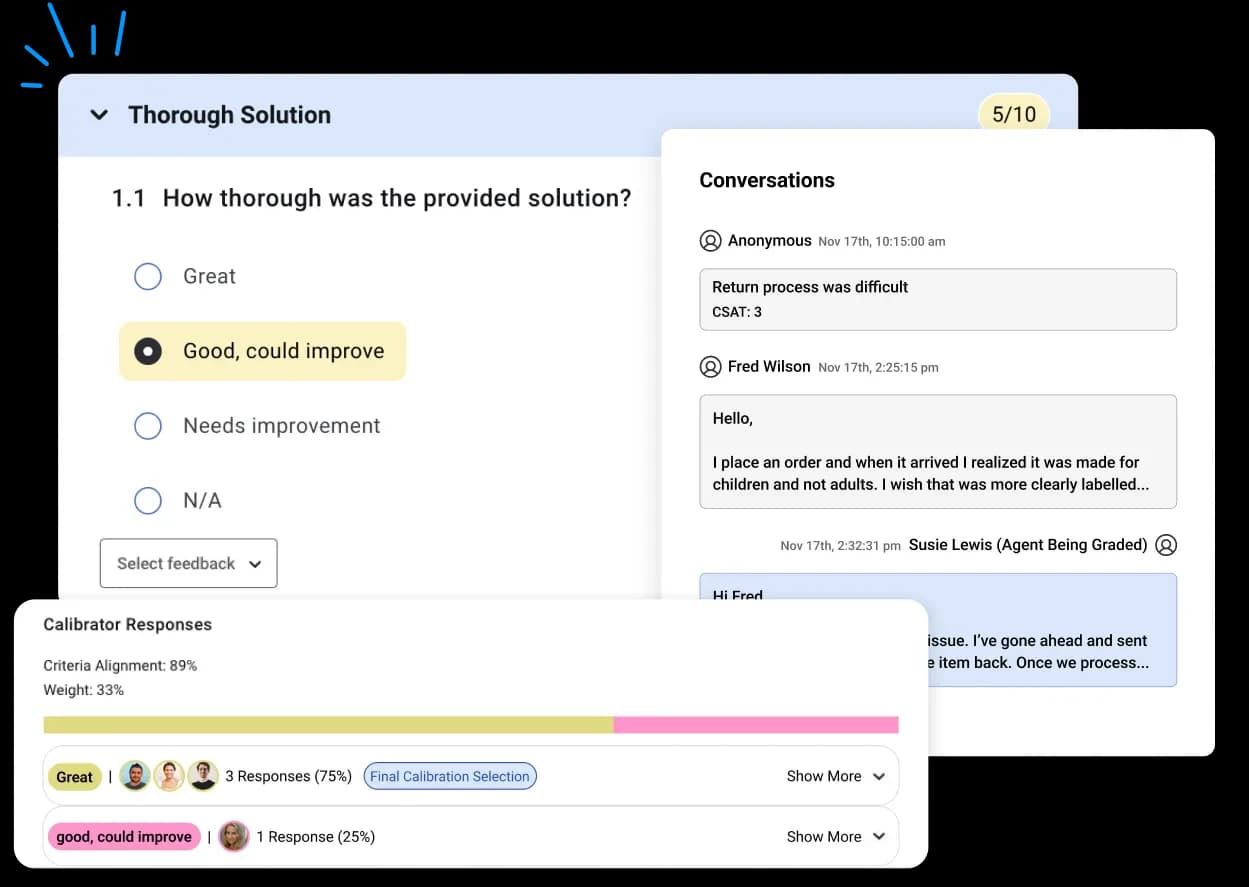
MaestroQA, ahora rebautizado como Rippit, separa dos tareas: la calibración de equipo en directo y Grade-the-Grader, donde un evaluador de referencia vuelve a evaluar a ciegas tickets que otra persona ya puntuó. Su vista de calibración muestra cómo respondió cada calibrador a cada pregunta, con un porcentaje de "Criteria Alignment".
Scorebuddy construye la calibración a partir de resultados ya puntuados: los añades a una lista de calibración y la asignas a usuarios, incluidos usuarios externos, lo cual es útil si externalizas parte de tu soporte a un socio BPO. Su glosario define Avg Variation como "the average of all differences between a set of Calibration's numerical scores, and the numerical scores of the original Scores." El módulo de calibración está en su plan de entrada Foundation, aunque los precios son "Request a price."
Si haces el QA dentro de tu helpdesk, comprueba qué cubre realmente. Tengo una lista más larga de herramientas de QA con IA por si estás comparando. Gorgias ofrece Auto QA, que puntúa conversaciones automáticamente, pero no encontré en su documentación un flujo de calibración para revisores humanos. Lo mismo con Freshdesk y Front en la documentación que consulté. Si tu helpdesk no lo tiene, una hoja de cálculo compartida con la cuadrícula del paso 3 cumple perfectamente para un equipo de tres a cinco revisores.
Calibrar evaluadores de IA y agentes de IA
Cada vez más equipos dejan que la IA puntúe el 100 % de las conversaciones, con humanos revisando una muestra. Eso no elimina la calibración. Añade un revisor más que calibrar, y es el que revisa más tickets.
Zendesk QA lo mide directamente. Su panel de AutoQA tiene una Accuracy score que "measures the consistency and level of agreement between ratings generated by AutoQA and those provided by human reviewers", y por encima del 75 % cuenta como alta concordancia. También registra las Modified AutoQA conversations, donde un humano cambió la puntuación de la IA en al menos una categoría. Esa lista es tu agenda de calibración para la IA, y es la forma más rápida de hacer QA de soporte con IA sin confiar ciegamente en ella: si los humanos siguen corrigiendo la misma categoría, el evaluador de IA y tu rúbrica no coinciden, y uno de los dos necesita arreglo. Las puntuaciones de AutoQA tampoco entran en el IQS del agente, así que la IA no puede mover en silencio la puntuación de un agente por sí sola.
Los agentes lo notan cuando nadie lo hace:
"My company uses AI to score calls, too. You can have a great call, but if it doesn't pick up on certain keywords you get a lousy score for it"
Trata al evaluador de IA como a un revisor nuevo que se une al equipo. Incluye algunas conversaciones puntuadas por AutoQA en tu sesión de calibración, puntúalas a ciegas junto a él y mira dónde queda. Mi guía de QA de soporte con IA cubre el resto de esa configuración, y ¿puede la IA hacer QA de soporte? es sincero sobre dónde todavía se queda corta.
La misma lógica se aplica cuando el agente es una IA. Si un agente de IA responde tickets, tus revisores deben acordar cómo evaluar sus respuestas antes de empezar, o tendrás el problema del 88 % frente al 12 % de antes, la misma diferencia que ves cuando los equipos discuten sobre la tasa de resolución de la IA: un revisor marca una respuesta como aprobada porque la respuesta es correcta, otro la marca como suspensa porque es tres párrafos demasiado larga. Acordad primero el listón y luego evaluad. Una voz de marca escrita para la IA hace mucho más fácil calibrar la categoría de tono. Mi artículo sobre agentes de IA en Zendesk QA explica cómo puntuar conversaciones de bots.
Errores comunes en la calibración de QA
- Puntuar juntos en la sala. Pierdes lo único que viniste a medir, el desacuerdo original. Puntúa siempre primero a ciegas.
- Calibrar solo tickets fáciles. Si cada sesión termina en acuerdo, estás eligiendo las conversaciones equivocadas.
- Tratar el promedio como la respuesta. Que tres personas digan 4 no hace que 4 sea lo correcto. Alguien es responsable de la decisión.
- Sin seguimiento por escrito. Si la decisión no llega a la guía de la scorecard, tendrás la misma discusión el mes que viene.
- Comparar solo puntuaciones totales. Dos revisores pueden dar ambos 80 % y discrepar en la mitad de las categorías.
- No calibrar nunca al evaluador de IA. Revisa más tickets que nadie más en el equipo. Necesita un asiento en la sesión.
- Hacerlo sin las disputas de los agentes. Las revisiones disputadas son material de calibración gratuito. El panel de disputas de Zendesk QA incluso tiene una tabla "Disputed reviewers" que "shows which reviewers may need additional help with consistency and accuracy." Recurre a ella al elegir conversaciones, y mira mi artículo sobre el feedback a agentes en Zendesk QA para ver cómo vuelven las disputas a los agentes.
Prueba eesel para tener respuestas de IA en las que tu equipo de QA pueda confiar
Si vas a incorporar IA a tu cola de soporte, la pregunta de la calibración aparece desde el primer día: ¿cómo evaluarán tus revisores lo que escribe? El compañero de IA para helpdesk de eesel se une a tu cola existente de Zendesk, Freshdesk, Gorgias o Help Scout y deja que tu equipo lo resuelva antes de salir en vivo. Reproduce tickets pasados reales para que los revisores puntúen sus respuestas frente a lo que tus agentes enviaron de verdad, empieza como borradores en notas internas, y cada ejecución muestra las fuentes y el razonamiento detrás de la respuesta. Cuando un revisor lo corrige, la corrección se convierte en una instrucción permanente, de modo que la misma decisión se aplica a todos los tickets futuros. Se puede probar gratis con 100 créditos, y los planes de pago empiezan en 299 $ al mes en la página de precios de eesel.
