

Las pruebas de simulación de soporte con IA consisten en reproducir tickets que tu equipo ya resolvió a través del agente de IA, con el envío desactivado, y calificar cada respuesta antes de que ningún cliente vea una. El resultado vale lo que valgan tres cosas: cuántos tickets reprodujiste por tema, contra qué calificaste y si la prueba pudo tocar sistemas reales. Un 85 % de coincidencia con 20 tickets puede estar en realidad en cualquier punto entre 64 % y 95 %, así que léelo por tema y trata las ejecuciones pequeñas como un primer vistazo, no como un veredicto.
De los helpdesks que revisé, solo el agente de correo de Freshdesk y eesel reproducen tus propios tickets resueltos. El simulador de Zendesk usa escenarios ficticios, HubSpot genera preguntas a partir de temas de conversaciones pasadas, Salesforce genera o carga casos de prueba, y Gorgias prueba una conversación a la vez.
La ejecución más útil que he visto, una verificación cruzada de 100 tickets en una bandeja real de ecommerce, salió 88 % correcta en dirección, pero solo el 12 % de los borradores habría salido sin editar y el 7 % tenía un error factual. Misma ejecución, tres puntuaciones honestas. Por eso empiezo cada despliegue con una simulación y después un periodo de borradores en tickets reales. eesel hace ambas cosas, y Norden-Frisia se registró a los pocos días de una semana de prueba con sus propios tickets pasados.
¿Qué son las pruebas de simulación de soporte con IA?
Las pruebas de simulación de soporte con IA son un ensayo de un agente de IA con mensajes realistas de clientes, donde cada respuesta se registra y se puntúa en lugar de enviarse. Responden una pregunta antes del lanzamiento: si este agente hubiera atendido tu cola el mes pasado, ¿con cuántas de sus respuestas habrías estado conforme para enviarlas?
Hay tres maneras de alimentar una simulación, y detectan cosas distintas.
| Tipo de simulación | De dónde vienen los mensajes de prueba | Qué detecta | Qué se le escapa |
|---|---|---|---|
| Reproducción de tickets pasados | Tickets resueltos de tu propio helpdesk, con las palabras de tus clientes | Formulación real, mezcla real de temas, huecos en tu base de conocimiento | Problemas nuevos que aún no has visto, insistencia en varios mensajes |
| Escenarios generados | Una IA escribe mensajes de clientes a partir de tus documentos, temas o un prompt | Cobertura de temas con poco historial, casos límite que describes | Cómo redactan realmente los clientes, el peso real de cada tema |
| Conjuntos de prueba escritos a mano | Preguntas que tú o tu equipo escriben a mano | Riesgos conocidos: reembolsos, asuntos legales, prompt injection | Todo lo que a nadie se le ocurrió anotar |
Yo empezaría siempre por la reproducción, porque es la única construida con lo que los clientes realmente envían. Las pruebas generadas y escritas a mano rellenan los huecos que deja la reproducción, sobre todo en los temas de riesgo que no aparecen con la frecuencia suficiente para salir en una muestra. Mi guía anterior de pruebas de agentes de soporte con IA reúne las tres en un plan de lanzamiento de cuatro etapas, y la lista de verificación previa al lanzamiento cubre traspasos, acciones y el interruptor de apagado. Este artículo profundiza en la simulación en sí: cómo hacer una y cómo leer la puntuación que te da.
¿Por qué una buena puntuación de simulación puede engañarte?
Construyo las integraciones que traen el historial de tickets a eesel, así que paso mucho tiempo mirando qué lee realmente una reproducción. La lección que sigo reaprendiendo es que "85 % aprobado" no significa nada hasta que sabes qué significó "aprobado".
La verificación cruzada de 100 tickets del TL;DR es el ejemplo más claro que tengo. Fue una prueba en una bandeja real de ecommerce con unos 1.000 tickets al mes. La clasificación fue 93 % precisa y la detección de spam, 100 %. Los borradores apuntaban en la dirección correcta el 88 % de las veces. Pero solo el 12 % se habría enviado exactamente como estaba escrito, y el 7 % contenía un error factual. De las reescrituras, cerca del 65 % eran de longitud y tono, que se arreglan aprendiendo de las respuestas enviadas del propio equipo, y solo cerca del 5 % eran el agente equivocándose en los hechos. Si te hubieras quedado en "88 %", habrías lanzado con una tasa de error del 7 % que nunca viste, el tipo de alucinación de IA silenciosa que los clientes encuentran antes que tú.
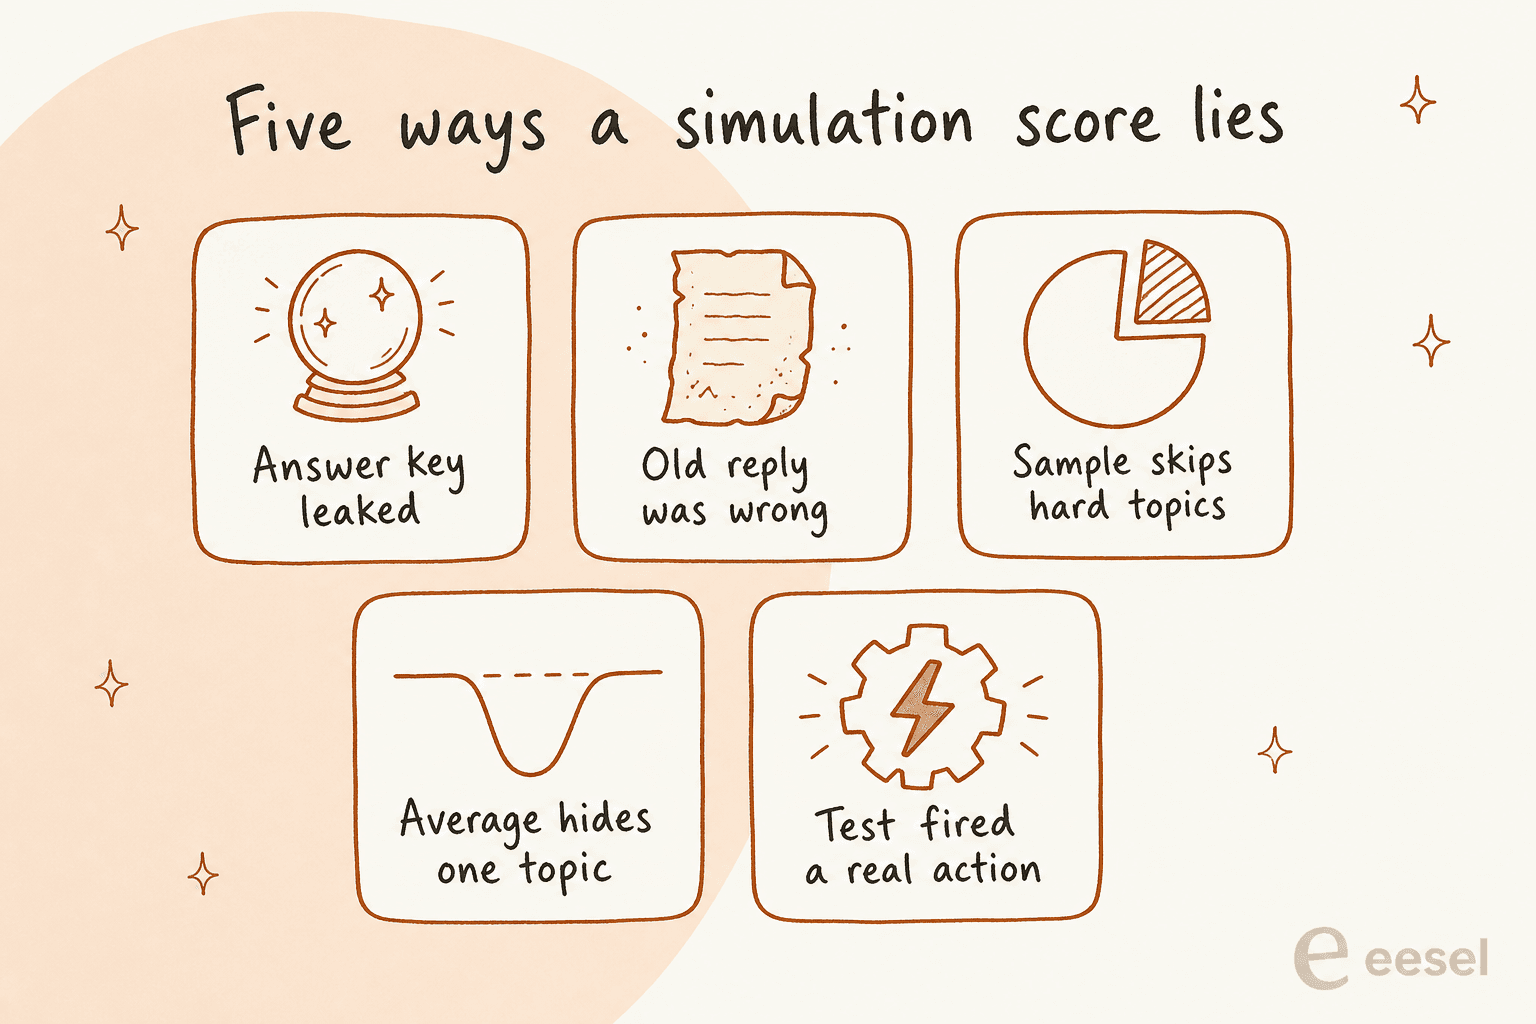
Estas son las cinco maneras en que he visto a una puntuación de simulación alejarse de lo que es el día del lanzamiento:
- La clave de respuestas se filtró. Si el agente puede leer el mismo ticket con el que se le prueba, o una macro escrita después de resolver ese ticket, se está calificando a sí mismo con las respuestas en la mano. Elige tickets de los que el agente no haya aprendido, o desactiva esa fuente de tickets para la prueba.
- La respuesta antigua era errónea. Coincidir con lo que envió tu equipo es un buen punto de partida, pero algunas de esas respuestas usaban una política que has cambiado desde entonces, y otras eran simples errores. Califica contra la política de hoy y trata una "discrepancia" en un ticket obsoleto como un acierto.
- La muestra omite los temas difíciles. Veinte tickets recientes de una quincena tranquila pueden no incluir ninguna disputa de reembolso. Llena la muestra por tema y añade casos escritos a mano para los raros y de riesgo.
- El promedio oculta un tema. Un 90 % global puede esconder un tema que falla siempre. Un comentarista de Reddit lo dijo bien: "A clean average can still hide one common path that fails every time" (u/Bitter_Big4525).
- La prueba disparó una acción real. Una respuesta que nunca se envía es segura. Un reembolso, una cancelación o una actualización del CRM disparados durante una prueba no lo son. Más sobre esto en el paso 3 más abajo.
"the biggest failure i've seen was an agent that kept pulling data from the wrong user's account because the session token wasn't being passed correctly to the api call, the text responses looked perfect so nobody caught it until a customer complained about seeing someone else's balance"

Esa última es la razón por la que una simulación tiene que mirar lo que hizo el agente, no solo lo que dijo.
¿Cuántos tickets necesita una simulación de soporte con IA?
Para un primer vistazo, 20 tickets bastan. Para decidir el lanzamiento de un tema, quieres más bien 100 tickets de ese tema, porque las ejecuciones pequeñas dan una puntuación con un margen de error muy amplio.
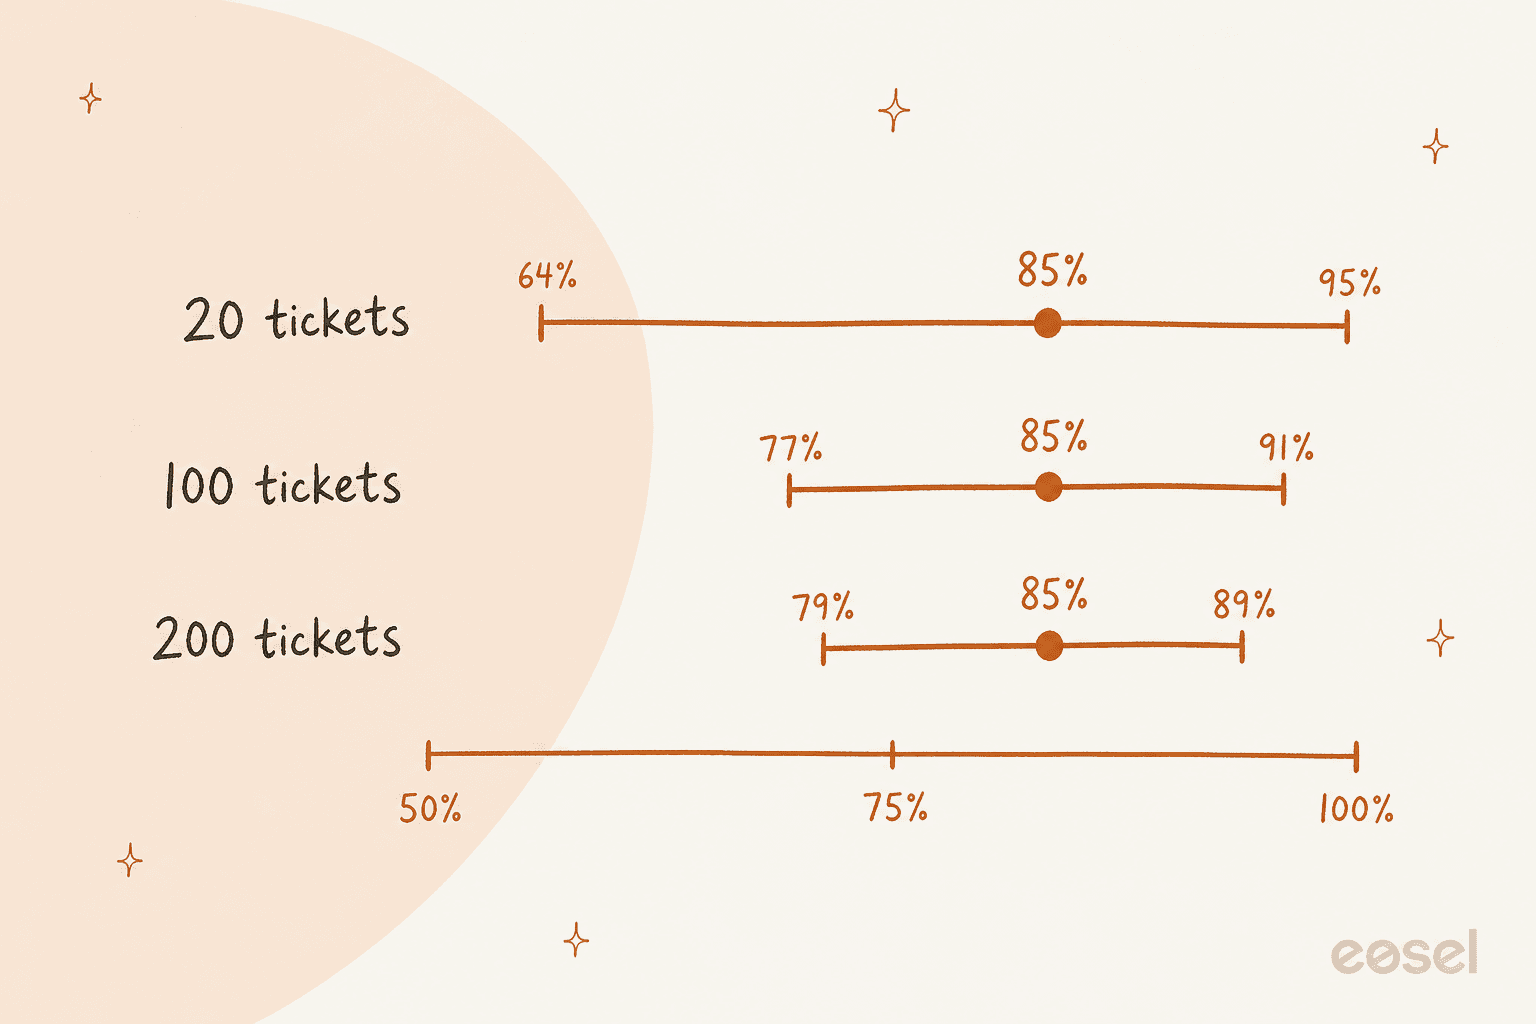
Aquí tienes la misma puntuación del 85 % con tres tamaños de muestra, usando un rango de confianza estándar del 95 % (el intervalo de Wilson, si quieres comprobar mis cuentas):
| Tickets reproducidos | Aprobados | Puntuación | La tasa real probablemente está entre |
|---|---|---|---|
| 20 | 17 | 85 % | 64 % y 95 % |
| 50 | 42 | 84 % | 72 % y 92 % |
| 100 | 85 | 85 % | 77 % y 91 % |
| 200 | 170 | 85 % | 79 % y 89 % |
| 20 | 20 | 100 % | 84 % y 100 % |
Destacan dos cosas. Una ejecución de 17 de 20 no puede decirte si tienes un agente del 65 % o del 95 %. Y un 20 de 20 perfecto solo te dice que la tasa real de fallos probablemente está por debajo de un 16 % aproximadamente. Es una gran señal para una primera ejecución, y no basta para pasar un tema a piloto automático total.
El arreglo es barato: ejecuta la simulación por tema y sigue añadiendo tickets a los temas que quieres automatizar hasta que el extremo bajo del rango supere tu umbral. Pon aquí tus propios números:
Si un tema recibe solo un puñado de tickets al mes, no tendrás historial suficiente para demostrarlo en un sentido ni en otro. Es un tema para borradores o un traspaso a una persona, no para piloto automático, por buena que parezca la ejecución pequeña.
¿Cómo se ejecuta una simulación de soporte con IA en la que puedas confiar?
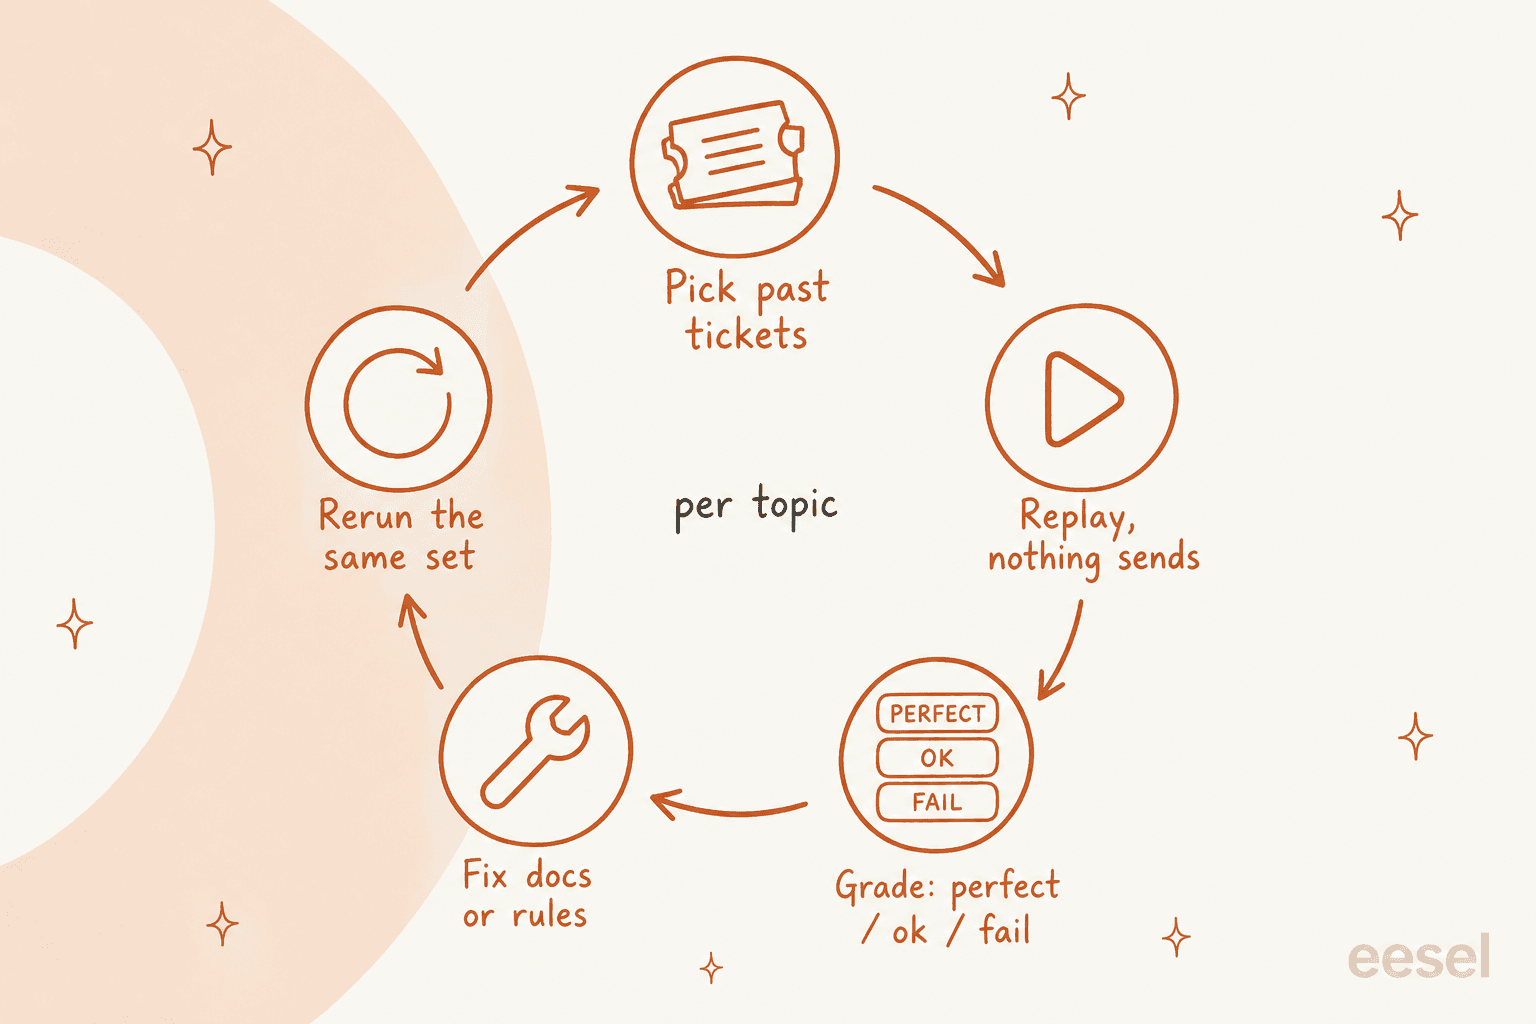
Seis pasos, en este orden. Funcionan igual si usas el probador integrado de tu helpdesk, una hoja de cálculo o un agente de IA para helpdesk dedicado. Todo el ciclo lleva una tarde la primera vez y minutos en cada repetición posterior.
Paso 1: elige los tickets por tema
Extrae tickets resueltos de los últimos dos o tres meses, para que reflejen tus productos y políticas actuales. Agrúpalos por tema (las etiquetas de tu helpdesk o los campos de ticket suelen bastar) y toma de cada tema una parte cercana a la frecuencia con la que llega. Luego añade un pequeño conjunto escrito a mano para los casos raros y de alto riesgo: un reembolso fuera del plazo, un cliente que pide hablar con un responsable, un mensaje que intenta anular las reglas del agente, una pregunta que tus documentos no responden en absoluto.
Esto último importa más de lo que parece. Algunos de los peores fallos tempranos que he visto en el historial de clientes de eesel fueron bots que inventaban respuestas cuando la base de conocimiento no tenía nada relevante. Un conjunto de pruebas sin preguntas sin respuesta no puede detectarlo, y es el núcleo de prevenir las alucinaciones en soporte.
"The one that worried me most was refund amounts. I ran AI models through support emails with a written refund policy, and 7 of them promised the wrong amount on the same email. The reply reads polite and confident, so nobody catches it until the customer quotes it back. On the easy emails they all looked great. It only showed up on hard emails I wrote and held back."
Paso 2: congela lo que sabe el agente y busca filtraciones
Apunta al agente al mismo centro de ayuda, macros e instrucciones que usará el primer día, y nada más. Cada respuesta debería estar fundamentada en una fuente que puedas señalar, para que el calificador pueda comprobar de dónde salió. Después comprueba que el ticket que reproduces, y cualquier cosa escrita para responderlo, no esté en el conocimiento del agente. Si el agente aprende de tickets pasados, elige tickets de los que no haya aprendido o excluye esa fuente en la ejecución de prueba.
Paso 3: desactiva toda acción que escriba
Desactiva el envío y luego revisa las acciones. Los proveedores dejan claro que esto no es automático:
- Gorgias advierte que cuando su agente usa una acción en una conversación de prueba, "it can affect real customer and order data (like cancelling an order)", y sugiere un perfil de cliente ficticio (documentación de Gorgias).
- Salesforce dice "Testing agents can modify CRM data" y te indica que ejecutes el Testing Center solo en un sandbox.
- El panel de pruebas de HubSpot ahora muestra "any records that were created or updated" durante una prueba (documentación de HubSpot).
Mi regla: en una simulación, el agente puede leer todo lo que leerá en producción y no escribir nada. Si quieres probar una acción de reembolso, pruébala por separado contra un pedido ficticio y califícala con acciones bajo aprobación cuando salga en vivo.
Paso 4: califica en tres niveles, más una categoría "nunca"
Una nota de aprobado/suspenso tira a la basura la información más útil. Yo califico cada respuesta como una de estas:
- Perfecta: la enviarías tal cual.
- Aceptable: respuesta correcta, necesita una edición ligera de longitud o tono.
- Fallo: incorrecta, incompleta, o debió traspasarse y no lo hizo.
Después mantengo una categoría aparte "nunca" para los fallos que bloquean el lanzamiento sin importar el promedio: una política inventada, un reembolso prometido que la política no permite, datos de otro cliente, un traspaso omitido en un ticket legal o de seguridad. Un comentarista de Reddit describió sus categorías como "annoying", "bad" y "burn it down", y el nivel burn-it-down "has to be zero or we don't ship" (u/Evening_Event4634).
Dejar que un calificador de IA haga la primera pasada está bien, y la mayoría de las herramientas ya lo hacen. Salesforce usa un "LLM judge" que compara cada respuesta con una respuesta esperada, y aun así dice que sus puntuaciones de calidad "are not absolute measures of success or failure" (Salesforce). Yo hago que una persona lea cada fallo, cada candidato a "nunca" y una porción aleatoria de los aciertos, lo que mantiene a un humano en el circuito donde el calificador es más débil. Las buenas prácticas de evaluación de OpenAI dicen lo mismo sobre contrastar un calificador de modelo con personas. Es el mismo hábito que una sesión de calibración de QA, solo que dirigido al agente.
Paso 5: lee los resultados por tema y decide por tema
Aquí la ejecución se convierte en un plan de despliegue. Para cada tema, toma una de tres decisiones:
| Cómo se ve el resultado del tema | Qué haría yo |
|---|---|
| El extremo bajo del rango supera tu umbral, cero fallos "nunca" | Candidato a responder solo, tras una semana de borradores en tickets reales |
| Mayormente perfecto o aceptable, algunos fallos que entiendes | Borradores para que una persona envíe, arreglar la causa, repetir |
| Muchos fallos, o cualquier fallo "nunca" | Traspasar a una persona, arreglar primero los documentos o reglas |
Lanzar por tema, no todo a la vez, es como lo hacen la mayoría de los clientes de eesel. Rúngne mantiene una lista de temas que decide qué recibe una respuesta directa y qué recibe un borrador, y mover un tema de una a otra es editar la lista. smava marca unos 1.100 de sus 27.000 tickets mensuales como aptos para respuesta automática, con borradores para el resto.
Paso 6: arregla y repite los mismos tickets
Cuando un tema falla, el arreglo suele ser un artículo de ayuda que falta o es vago, una instrucción demasiado laxa o una regla de traspaso que no se activa. Haz el cambio, repite exactamente el mismo conjunto y compara. Mantén en el conjunto los tickets que ya pasaron, porque un arreglo para un tema puede romper otro sin avisar. Repite siempre que cambies el modelo, las instrucciones, el umbral de confianza o una parte grande de la base de conocimiento. Saltarse la repetición tras un "cambio pequeño" es uno de los errores de implementación que más veo.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
¿Qué helpdesks permiten simular un agente de IA con tickets pasados?
La mayoría de los agentes de IA ya incluyen algún tipo de ejecutor de pruebas, pero entienden cosas muy distintas por "simulación". Si estás eligiendo una herramienta, vale la pena añadir esto a tu lista de evaluación de proveedores. Revisé el centro de ayuda de cada proveedor el 30 de octubre de 2026:
| Herramienta | ¿Reproduce tus tickets pasados reales? | Entrada de prueba | Límite por ejecución | Cómo se puntúan las respuestas | ¿Pueden las pruebas tocar datos reales? | Repeticiones guardadas |
|---|---|---|---|---|---|---|
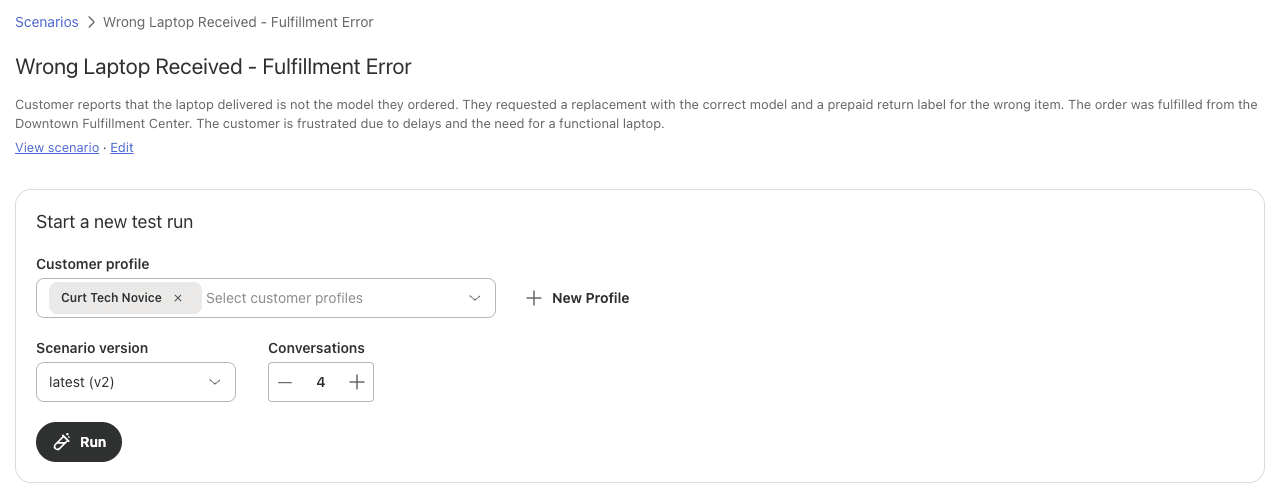
| Simulador de conversaciones de Zendesk (acceso anticipado) | No, solo datos ficticios | Perfiles de cliente y escenarios que escribes o que genera la IA | No indicado | Estado por conversación, estimación de resolución | No indicado; el widget de prueba omite las acciones del CRM | Escenarios con versiones, historial de ejecuciones |
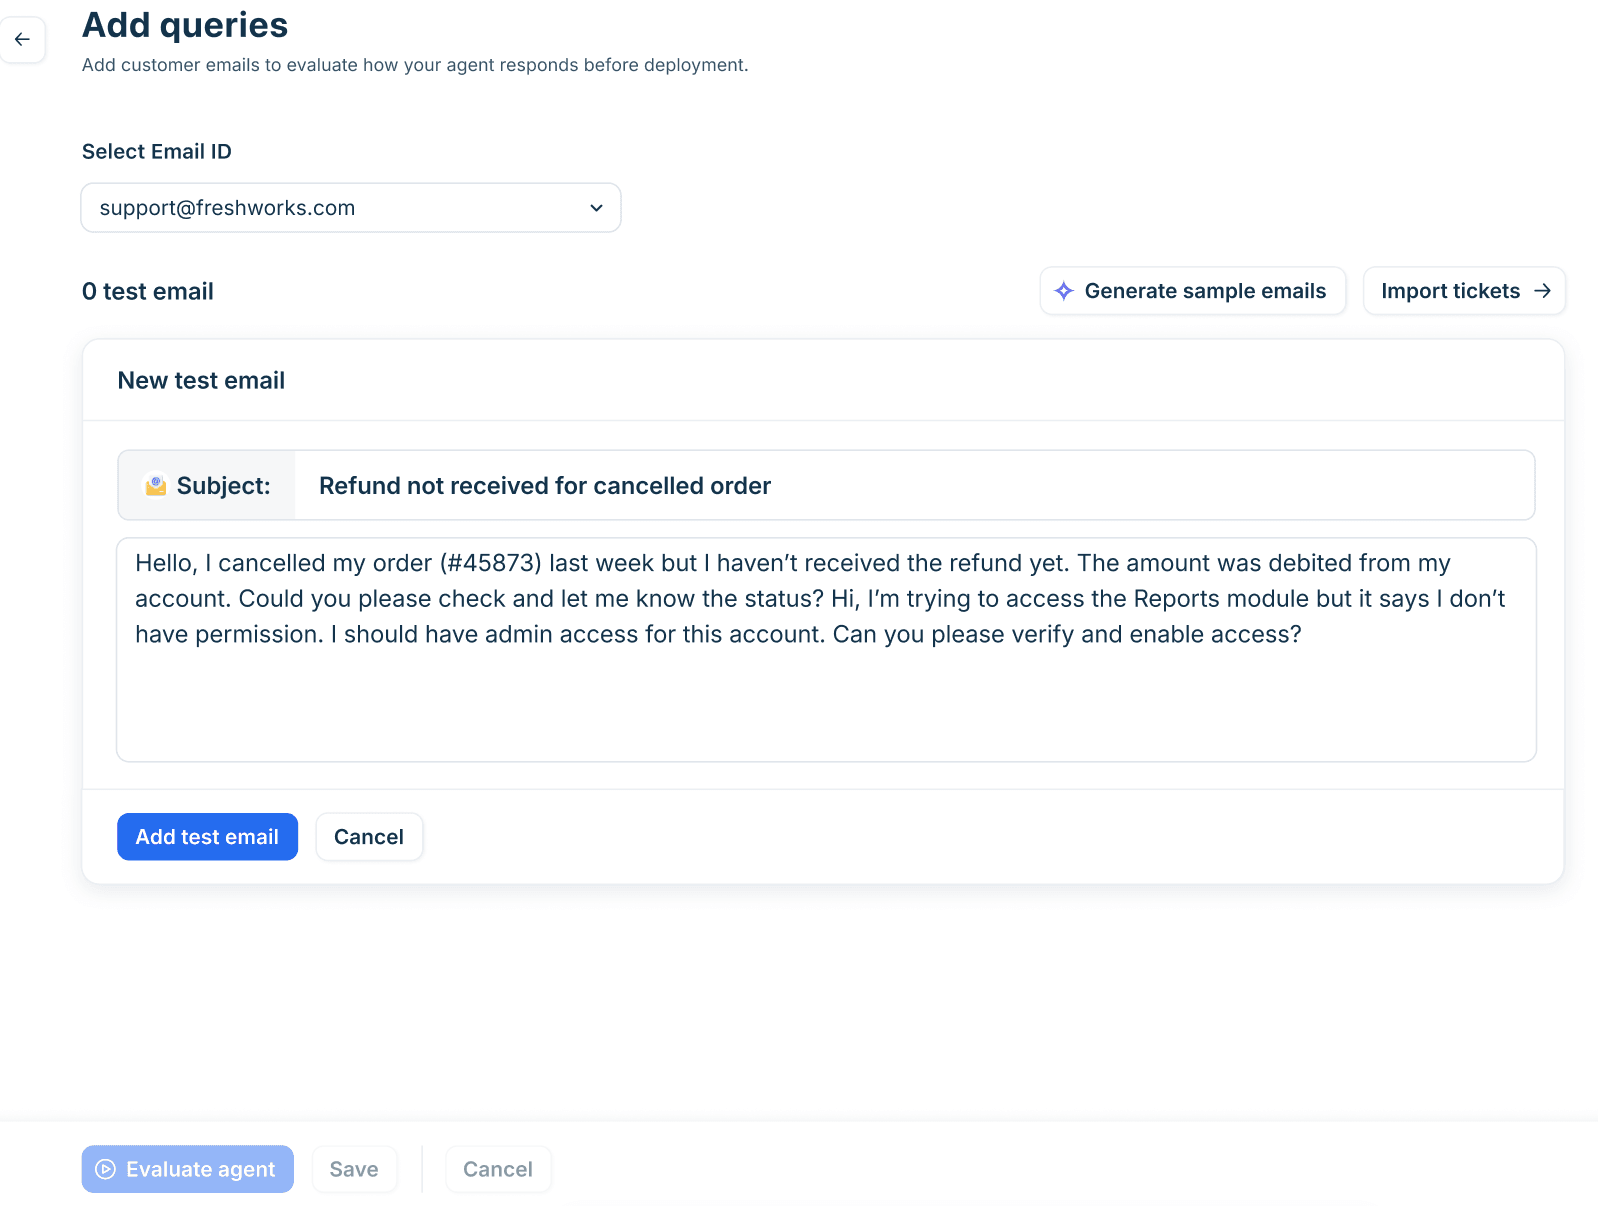
| Agente de IA de correo de Freshdesk | Sí, tickets resueltos | Tickets importados, correos escritos o generados | 50 | Answered, Unanswered o Error, más tu valoración | Los flujos de trabajo se activan; no indicado si en vivo | Sí |
| Agente de IA de chat de Freshdesk | No | Preguntas escritas o generadas | 100 | Answered o Unanswered, más tu valoración | No indicado | Sí |
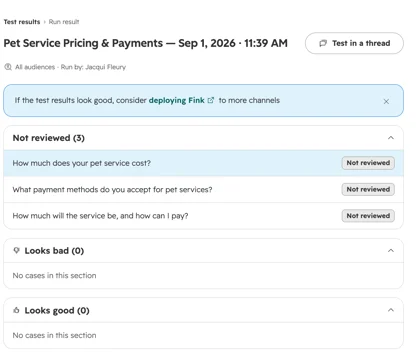
| Agente de cliente de HubSpot | No, genera preguntas a partir de temas de conversaciones pasadas | Preguntas generadas o escritas | 8 conjuntos de prueba | Marcas Looks good o Looks bad | Se pueden crear o actualizar registros | Sí |
| Gorgias AI Agent | Un ticket existente a la vez | Mensaje escrito o un ticket pasado | 1 conversación | Sin puntuación; lees su razonamiento | Sí, si las acciones están activadas | No |
| Testing Center de Salesforce Agentforce | No | Generado a partir de temas, acciones o conocimiento, o carga de CSV | 100 generados, 1.000 por CSV | Juez de IA contra una respuesta esperada, puntuaciones de calidad de 0 a 5 | Sí, se aconseja sandbox | Sí |
| Atlassian Customer Service Management | No indicado | Un conjunto de datos de preguntas | No indicado | Resuelto o no, revisado por una persona | No indicado | Sí |
| eesel | Sí, tickets resueltos | Tickets pasados, o casos generados sin helpdesk | Ejecución de ejemplo en la documentación: 20 tickets | Comparado con lo que envió tu equipo, agrupado por tema | No, "It sends nothing to customers" | Sí, puede ejecutarse según un horario |
Algunas cosas que conviene saber de cada uno.
Zendesk. El simulador de conversaciones está en un programa de acceso anticipado y solo funciona con un agente de IA de mensajería. Escribes un escenario (contexto, problema inicial, resultado esperado, valores simulados) y eliges un perfil de cliente, y la IA hace de cliente. Zendesk dice que está "designed for testing with fictional data", así que es fuerte para chats de varios mensajes y débil para "cómo habría manejado el mes pasado". Probar en él no consume resoluciones automatizadas, lo que importa con el precio por resolución de Zendesk. Tras el lanzamiento, los registros de conversaciones y Zendesk QA toman el relevo de la calificación.
Freshdesk. El paso Evaluate del agente de correo es lo más parecido a una reproducción real que hay integrado: puedes "Import tickets to use solved historical tickets", hasta "50 queries per evaluation run" (Freshdesk). El propio umbral de Freshdesk es "at least 20 representative queries before deploying", que, según la tabla de arriba, yo trataría como un mínimo. La puntuación indica si el agente respondió, no si la respuesta coincidió con la que envió tu agente, así que sigues leyendo cada una. Está en Freshdesk Omni Growth, Pro y Enterprise, y hay un sandbox si quieres una copia totalmente separada.
HubSpot. Las pruebas por lotes pueden "generate them from existing customer conversations", lo que significa que escribe preguntas comunes por tema, y un tema necesita "5 or more conversations on a similar topic" para aparecer. La calificación es manual, respuesta por respuesta, y los conjuntos de prueba se guardan para repeticiones. Las pruebas no consumen HubSpot Credits.
Gorgias. El Playground puede volver a ejecutar "an existing ticket", que Gorgias recomienda para "re-simulating a conversation where AI Agent did not initially respond as expected" (Gorgias). Es ideal para comprobar un arreglo en un ticket, pero no hay ejecución por lotes, así que no puedes obtener una puntuación sobre 100 tickets. Gorgias se apoya en cambio en la revisión en vivo: su guía de salida a producción te pide revisar "at least 10 tickets" en la primera semana.
Salesforce y Atlassian. El Testing Center de Agentforce tiene la puntuación más detallada del grupo: comprueba que se eligieron el tema y la acción correctos, más un juez de IA y evaluadores de calidad opcionales, en las ediciones Enterprise, Performance, Unlimited y Developer con una licencia adicional de agente (ver precios de Agentforce). Sin embargo, no reproduce casos pasados; generas pruebas o subes un CSV. Las evaluaciones de Atlassian son más simples: un conjunto de datos de preguntas, cada una marcada como resuelta o no, con una repetición tras cada arreglo.
Si usas Zendesk, Gorgias o HubSpot y quieres una reproducción de tus tickets realmente resueltos, es un hueco que tendrás que cubrir fuera del helpdesk, ya sea con una hoja de cálculo y mucho copiar y pegar, o con una herramienta que lea tu historial de tickets directamente.
¿Qué no puede decirte una simulación?
Una simulación te dice cómo maneja el agente el primer mensaje de un ticket cuyo tipo ya ha visto. No puede decirte del todo cuatro cosas:
- Cómo insisten los clientes. Una reproducción tiene un mensaje del cliente y una respuesta. Los clientes reales responden "eso está mal", vuelven a preguntar o se enfadan. Las pruebas guiadas de varios mensajes ayudan; los borradores en vivo ayudan más.
- Qué hay de nuevo esta semana. Un lanzamiento de producto, una caída o un cambio de política crean tickets que tu historial no tiene.
- Cómo se sienten los clientes. Un comentarista de Hacker News que lideró un despliegue de soporte con IA dijo que "did our own intensive testing" y aun así descubrió que "our customers just hated it" (victor106). El tono, la rapidez y la opción de llegar a una persona importan tanto como la precisión.
- Si tus documentos siguen siendo ciertos. Una simulación es una instantánea. Si una página de políticas cambia el mes que viene, la puntuación queda obsoleta. Programa una repetición.
"Shipped a customer service agent for a mid-size e-commerce client last year, manual testing looked clean across every flow we ran. First week in production, users started interrupting mid-response to rephrase their question, agent would drop the original context entirely and answer the new phrasing with confident, wrong information. Support tickets spiked, client was fielding churn risk conversations by day ten. We caught exactly zero of that in manual testing because we were too polite during QA."
Por eso trato la simulación como la puerta a los borradores, no al piloto automático. El siguiente paso son una o dos semanas en las que el agente redacta borradores en tickets reales y una persona los envía. Innr está justo en esa etapa en Freshdesk: hoy cada respuesta es un borrador, y el equipo va pasando temas elegidos a respuestas autónomas de uno en uno. SE Ranking está probando respuestas directas por correo en tickets de prueba elegidos por línea de asunto antes de ampliarlo. Vigila la tasa de resolución y la tasa de reapertura por tema durante ese periodo (no la deflexión, que cuenta tickets que nunca llegaron a ti), y úsalas para decidir qué pasa a ser autónomo. Mi artículo sobre el cronograma de implementación muestra cuánto suele durar esa etapa.
Cómo ejecuta eesel una simulación con tus tickets pasados
Voy a ser específico sobre cómo funciona esto en eesel, ya que es la parte del producto sobre la que veo más preguntas.
Lo pides en el chat. Con un helpdesk conectado, la simulación de helpdesk de eesel "replays your past tickets and scores its answers against what your team actually sent" (documentación de eesel). Sin uno, escribe casos de prueba realistas en su lugar. La ejecución redacta una respuesta para cada ticket, la compara con la respuesta de tu equipo, agrupa los resultados por tema y enumera arreglos ordenados por impacto. En la ejecución de ejemplo de la documentación, 17 de 20 tickets resueltos coincidieron con la calidad de respuesta del equipo, con un desglose por tema debajo. Tómalo como un ejemplo del informe, no como un pronóstico para tu cola.
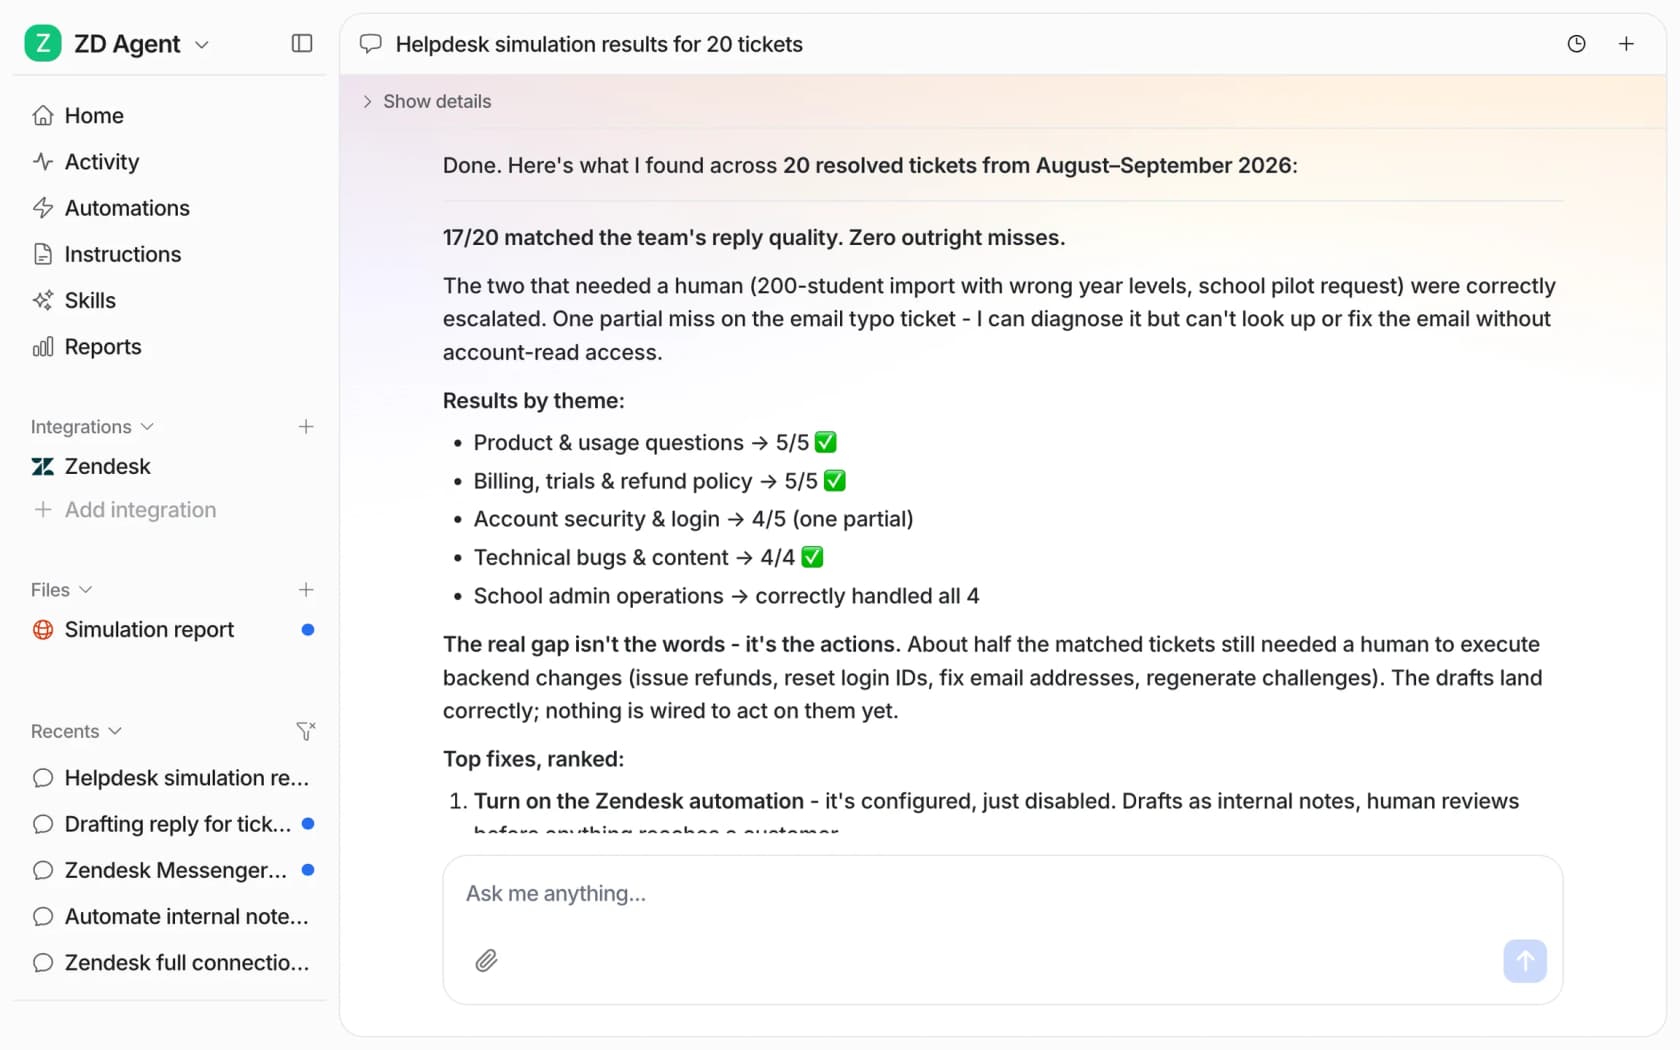
El informe completo se abre junto al chat, ticket por ticket: qué preguntó el cliente, qué respondió tu equipo y cómo se comparó la respuesta del agente. Los dos informes de simulación de ejemplo de la documentación de Skills terminan igual: "It sends nothing to customers". Eso cubre el paso 3.
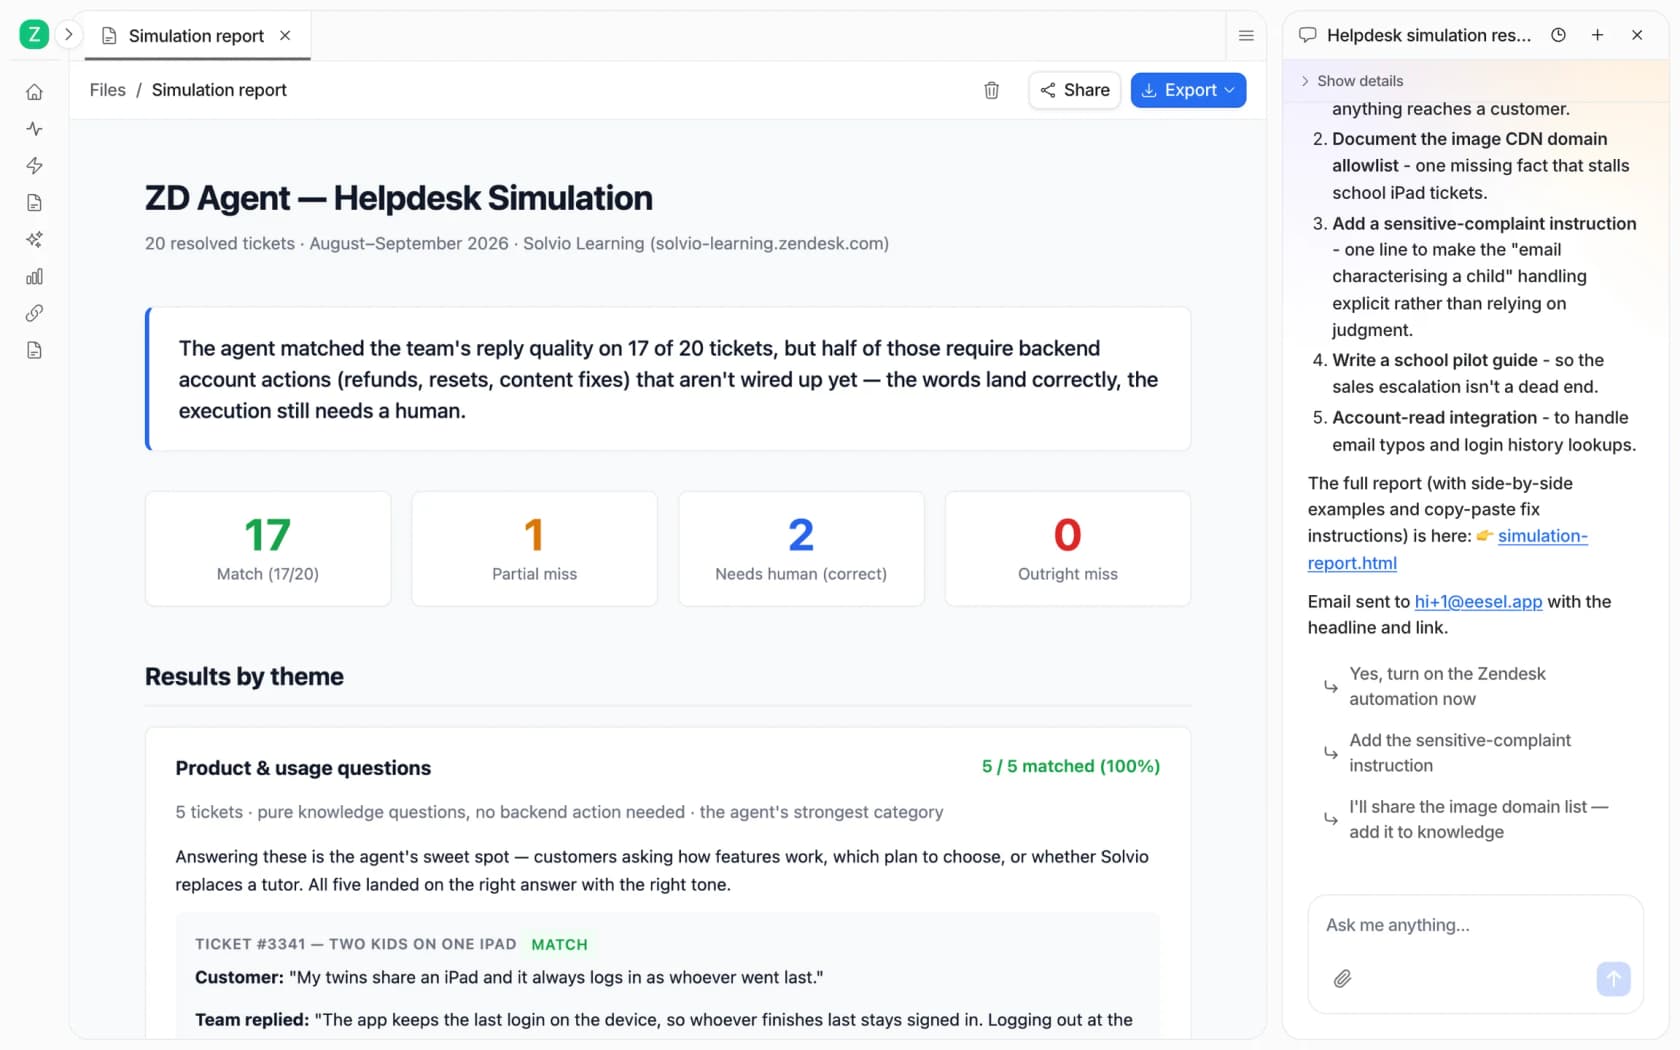
Fíjate en que el informe no se queda en "coincide". Separa los fallos parciales y los tickets que correctamente necesitaban a una persona, que es la calificación en tres niveles del paso 4 incorporada. Cuando corriges al agente en el chat, escribe la corrección en sus propias instrucciones como una regla en una frase sencilla, de modo que la siguiente repetición pruebe el arreglo. También puedes asociar la simulación a una automatización para que se ejecute según un horario, lo que resuelve el paso 6 sin que nadie tenga que acordarse.
Tras la simulación, cada respuesta empieza como borrador o nota interna, y pasas temas a "responder solo" cuando estés listo. Todo lo que cuesta dinero queda tras una aprobación. Si prefieres trabajar desde una terminal, la CLI de eesel te permite probar el mismo agente con eesel chat "what's our refund policy?", ver qué está esperando con eesel approvals y previsualizar cualquier escritura con --dry-run antes de que se ejecute. Agentes de programación como Claude Code o Cursor pueden manejar esos mismos comandos.
Dónde eesel no es la opción adecuada: si necesitas simulaciones de chat de varios mensajes con personajes de cliente interpretados por IA dentro de Zendesk, su propio simulador está hecho para eso. La simulación de eesel trata de cómo habría respondido el agente a tu historial real.
Simula tu agente de IA con tus propios tickets en eesel
Si estás a punto de activar un agente de IA y quieres una puntuación de tu propia cola primero, eesel se conecta a Zendesk, Freshdesk, Gorgias y HubSpot en pocos minutos, reproduce tickets que tu equipo ya resolvió y te dice tema por tema dónde está listo y dónde tus documentos tienen huecos, sin enviar nada. Norden-Frisia hizo su semana de prueba con tres meses de tickets y macros pasados y se registró a los pocos días. El plan gratuito incluye 100 créditos para probar todas las funciones, y los planes de pago empiezan en 299 $/mes por 500 créditos.
Prueba eesel y ejecuta tu primera simulación esta misma tarde.