

Ja, Re:amaze lenkt Tickets in Ebenen ab: FAQ-Artikel, die Kunden lesen, bevor sie schreiben, Cues und Chatbots, ein KI-Agent (noch mit Beta-Label), der im Chat, per E-Mail und SMS antwortet, und der KI-Pre-Filter, der sensible Themen an Menschen weiterleitet. Nur der KI-Agent wird abgerechnet: 5, 10 oder 20 Lösungen pro Sitz bei Basic, Pro und Plus, danach 0,85 $ pro Stück. Der Haken: Schaltet man den KI-Agent ein, stoppen die klassischen Hello-, Order- und FAQ-Bots, und er antwortet aus Ihrer FAQ, Ihren Vorlagen und Ihren Shop-Daten, nicht aus den bisherigen Antworten Ihres Teams.
Wenn E-Mail der Punkt ist, an dem Deflection stockt, lernt eesel aus Ihren Re:amaze-Unterhaltungen und prüft die Warteschlange alle zehn Minuten. Mit der eesel-CLI kann ein Coding-Agent freigegebenes Wissen hochladen und vor dem Go-Live Testfragen ausführen, auch wenn eine Person das API-Token weiterhin selbst kopiert.
Kann Re:amaze Tickets mit KI ablenken?
Das kann es, über fünf getrennte Bausteine, und ich würde sie nicht als ein einziges Feature behandeln. Ich arbeite an eesels Helpdesk-Integrationen, und wenn ich die "KI"-Seite eines Helpdesks lese, achte ich auf zwei Dinge: Was das Modell liest, und welche Unterhaltungen als erledigt gezählt werden. Re:amazes Antworten unterscheiden sich je Ebene, hier sind sie nebeneinander.
| Ebene | Was sie tut | Wo sie ablenkt | Abgerechnet? |
|---|---|---|---|
| FAQ-Artikel | Öffentliche, interne und Entwurfsartikel, einbettbar auf der Website, in der App und im Chat | Bevor eine Unterhaltung entsteht | Nein |
| Cues und klassische Chatbots | Proaktive Nachrichten und Skript-Bots (Hello Bot, Order Bot, FAQ Bot, eigene Bots) | Meist im Chat | Nein |
| KI-Agent (Beta) | Antwortet Kunden in Chat, E-Mail und SMS aus FAQ, Vorlagen, eigenem Kontext und Shop-Daten | Innerhalb einer Unterhaltung | Pro Lösung, über Ihr Kontingent hinaus |
| KI-Pre-Filter | Liest neue Unterhaltungen, vergibt einen Tag und eine Aktion | Hält Themen von der KI fern oder archiviert Rauschen | Braucht den aktiven KI-Agent |
| Gelernte Antworten | Macht eskalierte, abgeschlossene Unterhaltungen zu Antwortvorschlägen | Verbessert den KI-Agent über die Zeit | Nein |
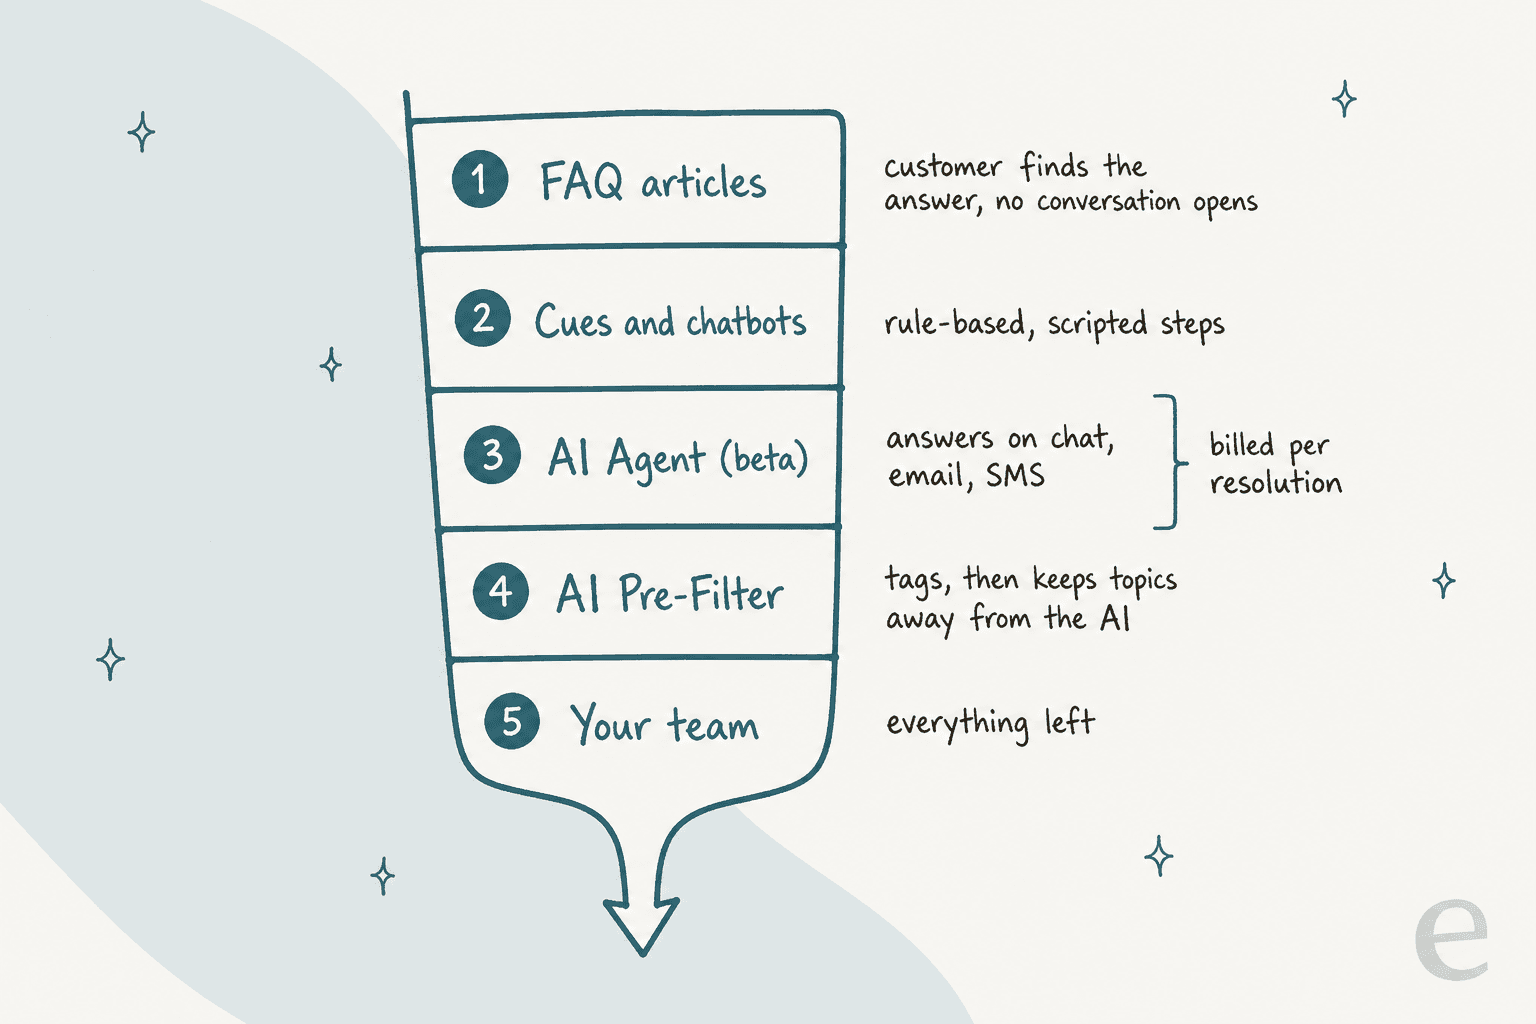
Die Re:amaze-KI-Seite sagt, diese Tools würden von OpenAIs GPT-Modellen angetrieben und trägt ein Beta-Label. Das Meiste im Folgenden stammt aus Re:amazes eigenem Help Center, und ich habe jede Zahl am 22. November 2026 dagegen geprüft.
Wie lenkt die FAQ-Ebene ab, bevor ein Ticket entsteht?
Kunden lesen einen Artikel und schreiben nie, was die sauberste Art von Ticket-Deflection ist, weil nichts abgerechnet wird und niemand wartet. Re:amazes FAQ ist in jedem Plan enthalten, mit öffentlichen, internen und nicht gelisteten Artikeln, Stichwortsuche und Einbettung auf Ihrer Website, in Ihrer App und in Re:amaze Chat.
Das geht über Selbstbedienung hinaus, weil der KI-Agent dieselben Artikel liest. Re:amazes eigener Hinweis sagt, der KI-Agent sei nur so gut wie der Inhalt dahinter, sodass eine veraltete Rückgaberichtlinie selbstbewusst wiederholt wird. Ein Capterra-Rezensent mochte, wie beides zusammenpasst:
"I loved how easy it was to setup and how the knowledge base integrated into the chat widget."

Ein anderer nannte die Schwachstelle, nämlich das Verfassen:
"Their knowledge base editor doesn't support uploading photos to an article. If you want to add an image to an article, you have to point to an external URL."
Wenn Ihre FAQ dünn ist, beheben Sie das, bevor Sie irgendetwas einschalten. Kunden-Selbstbedienung lohnt sich nur, wenn die Antworten existieren, und ein lesbares Help Center ist eine gute Checkliste.
Was passiert mit Cues und Chatbots, wenn der KI-Agent aktiv ist?
Sie halten meist an, und das ist das Detail, das ich kennen würde, bevor ich den Schalter umlege. Re:amazes Setup-Leitfaden sagt, dass die klassischen Chatbots (Hello Bot, Order Bot, Shopping Bot, AI FAQ Bot und FAQ Bot) nicht laufen, solange der KI-Agent aktiviert ist. Cue Bots und Workflow Bots arbeiten weiter, sodass Ihre Workflow-Automatisierung überlebt.
Der Abrechnungsleitfaden fügt einen Fallback hinzu: Ist die Nutzungsüberschreitung unter Settings > AI Settings deaktiviert, können die klassischen Chatbots kostenlos weiterlaufen, sobald Ihr enthaltenes Kontingent aufgebraucht ist. Die Wahl ist also real. Lassen Sie den kostenlosen Order Bot "Wo ist meine Bestellung" beantworten und zahlen Sie nichts, oder übergeben Sie dieselbe Frage an den KI-Agent, der mehr Formulierungen versteht und gemessen wird.
Die Chatbots-Seite beschreibt, was die klassischen Bots tun: Der Order Bot prüft den Bestellstatus für Shopify, BigCommerce und WooCommerce, der FAQ Bot antwortet aus FAQ-Inhalten, wenn eine Frage passt, und eigene Bots werden in einem visuellen Editor gebaut und an eine Cue oder einen Workflow angehängt. Für die ausführliche Tour siehe Re:amaze-Automatisierung, die Workflows und Bots abdeckt.
Wie lenkt der KI-Agent ab, und was liest er?
Er beantwortet Kundennachrichten eigenständig, in Chat, E-Mail und SMS, und eskaliert, wenn er nicht weiterkommt. Laut Setup-Leitfaden greift er auf fünf Quellen zurück:
- FAQ-Artikel aus Ihrer Wissensdatenbank.
- Antwortvorlagen, die Ihr Team bereits geschrieben hat.
- Eigener KI-Kontext: Persönlichkeit, Antwortrichtlinien und externe URLs, die Sie unter AI > Manage Bots > Custom AI Context hinzufügen.
- Shopify-Produkte und -Bestellungen, falls Sie Shopify nutzen.
- WooCommerce-Produkte und -Bestellungen, falls Sie WooCommerce nutzen.
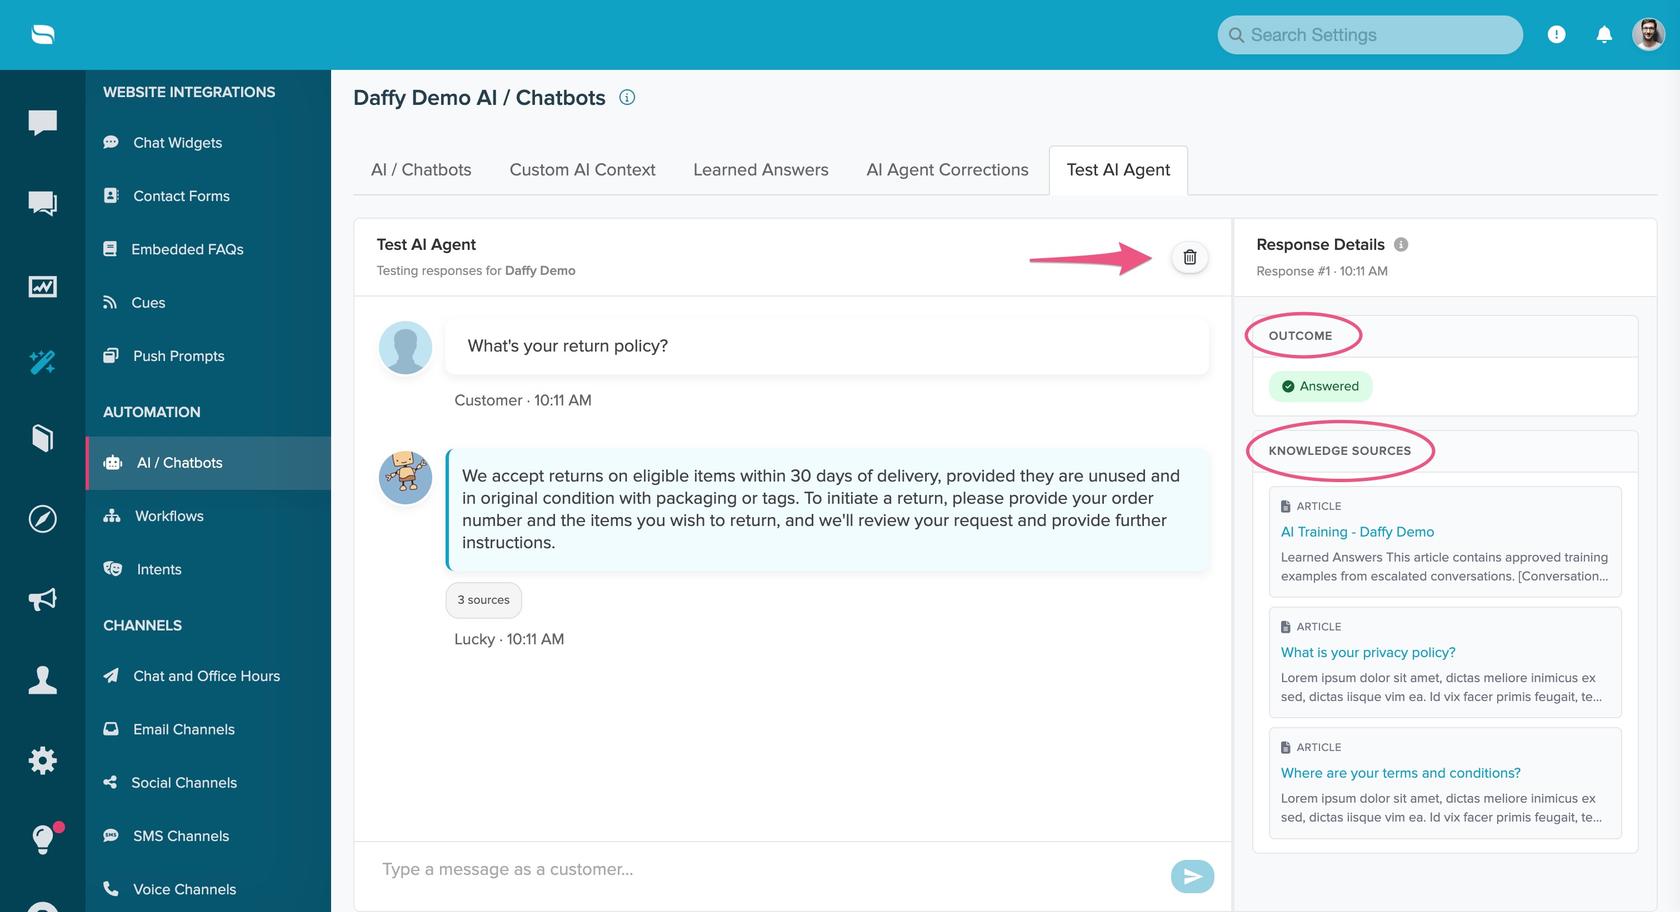
Zwei Funktionen machen ihn vertrauenswürdiger als die meisten. Erstens zeigt jede KI-Antwort eine Quellenzahl, und beim Aufklappen sieht man, welcher Artikel, welches Produkt oder welche Vorlage verwendet wurde, sodass sich eine schlechte Antwort bis zur verursachenden Seite zurückverfolgen lässt. Zweitens lässt der Test AI Agent-Tab Sie mit ihm chatten, bevor Kunden es tun, mit den Ergebnissen Beantwortet, Eskaliert, Gelöst oder Fehlgeschlagen. Die Grenze: Das Testtool hat keine echte Shop-Verbindung, kann also keinen echten Bestellstatus nachschlagen.
Ist eine Antwort falsch, speichert die Schaltfläche Improve Response eine Korrektur, aber nur bei Antworten, bei denen die KI einen FAQ-Artikel verwendet hat, und Re:amaze speichert bis zu 100 Korrekturen. Hat die KI ohne Artikel geantwortet, rät der Leitfaden, einen zu schreiben. Das ist eine solide Gewohnheit gegen eine KI-Halluzination und für deren Vermeidung im Support, und sie hält zudem die FAQ als Ihre einzige Quelle der Wahrheit.
Ein Rezensent auf G2 beschrieb den Reiz des FAQ-gestützten Ansatzes:
"They recently added AI features that pull information from FAQ's, those are very helpful"

Was tut der KI-Pre-Filter für Deflection?
Er entscheidet, welche Unterhaltungen der KI-Agent nie berührt, und er markiert alles, was er liest, eine Form von Auto-Triage. Ein Pre-Filter hat drei Teile: einen Prompt mit bis zu 500 Zeichen, einen Tag und eine von vier Aktionen (nur taggen, taggen und als erledigt markieren, taggen und als Spam markieren, taggen und archivieren). Re:amaze liefert fünf Standardwerte: Marketing, Käufe, Updates, Social und Spam.
Lesen Sie die Regeln genau, denn sie prägen Ihr Setup. Laut Leitfaden wird jede Unterhaltung, die zu einem Pre-Filter passt, nicht vom KI-Agent bearbeitet, unabhängig von der verwendeten Aktion, und Pre-Filter haben Vorrang vor Workflows. Der vorgeschlagene Einsatz des Leitfadens ist Routing: Abrechnungsfragen, Kündigungen und VIP-Kunden gehen zuerst an eine Person. Und der Pre-Filter selbst braucht einen aktivierten KI-Agent mit verbleibenden Lösungen oder aktivierter Überschreitung.
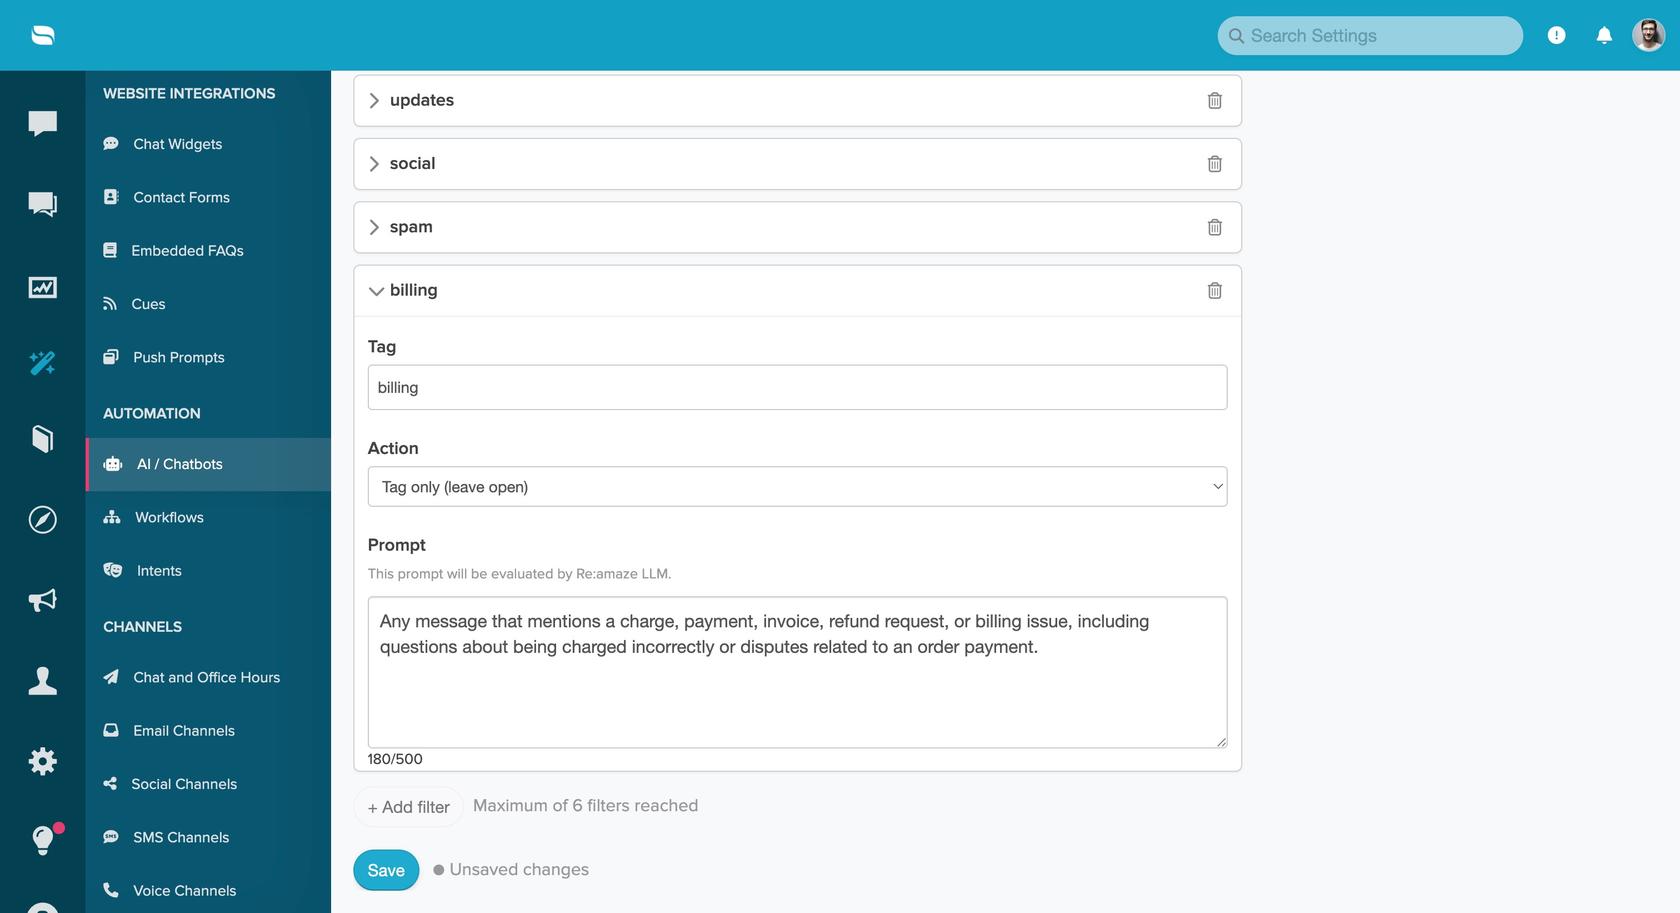
Dieser Screenshot zeigt einen eigenen Abrechnungsfilter, und die Seite nennt ein Maximum von 6 Filtern. Diese Ebene gefällt mir aus einem Grund, den man nicht erwartet: Gute Deflection hängt teilweise davon ab, was man sich zu automatisieren weigert. Für einen tieferen Blick auf das Taggen von Unterhaltungen siehe Re:amazes Ticket-Tagging und -Routing.
Verbessern gelernte Antworten die Deflection?
Langsam, und nur für den KI-Agent. Wenn der KI-Agent eine Unterhaltung eskaliert und eine Person sie als Done markiert, erstellt Re:amaze einen Antwortvorschlag. Sie speichern, bearbeiten oder löschen jeden einzeln, Vorschläge laufen nach 14 Tagen ab, und der Leitfaden sagt, Sie können bis zu 50 Antworten speichern.
Sie lernt nur aus Eskalationen, und nichts wird hinzugefügt, bis eine Person es genehmigt. Für einen Shop mit ein paar hundert wiederkehrenden Fragen sind 50 gespeicherte Antworten schnell voll, behandeln Sie gelernte Antworten also als den Ort für Ausnahmen von der Richtlinie und halten Sie allgemeine Antworten in der FAQ. Dieselbe Grenze ist der Grund, warum ich Re:amaze-KI-Antwortentwürfe separat behandelt habe: Entwürfe auf Agentenseite haben andere Eingaben als der KI-Agent.
Was kostet Re:amaze-KI-Deflection?
Zuerst die Sitze, dann die Lösungen. Die Preise unten stammen aus Re:amazes Preisseite und dem Abrechnungsleitfaden, geprüft am 22. November 2026.
| Plan | Monatspreis | Jahrespreis (pro Monat) | Enthaltene KI-Agent-Lösungen | Zusätzliche Lösungen |
|---|---|---|---|---|
| Starter | 59 $ pauschal, unbegrenzte Teammitglieder, 500 beantwortete Unterhaltungen im Monat | Nicht gelistet | Nicht gelistet | Nicht gelistet |
| Basic | 29 $ pro Teammitglied | 26,10 $ | 5 pro Sitz | 0,85 $ pro Stück |
| Pro | 49 $ pro Teammitglied | 44,10 $ | 10 pro Sitz | 0,85 $ pro Stück |
| Plus | 69 $ pro Teammitglied | 62,10 $ | 20 pro Sitz | 0,85 $ pro Stück |
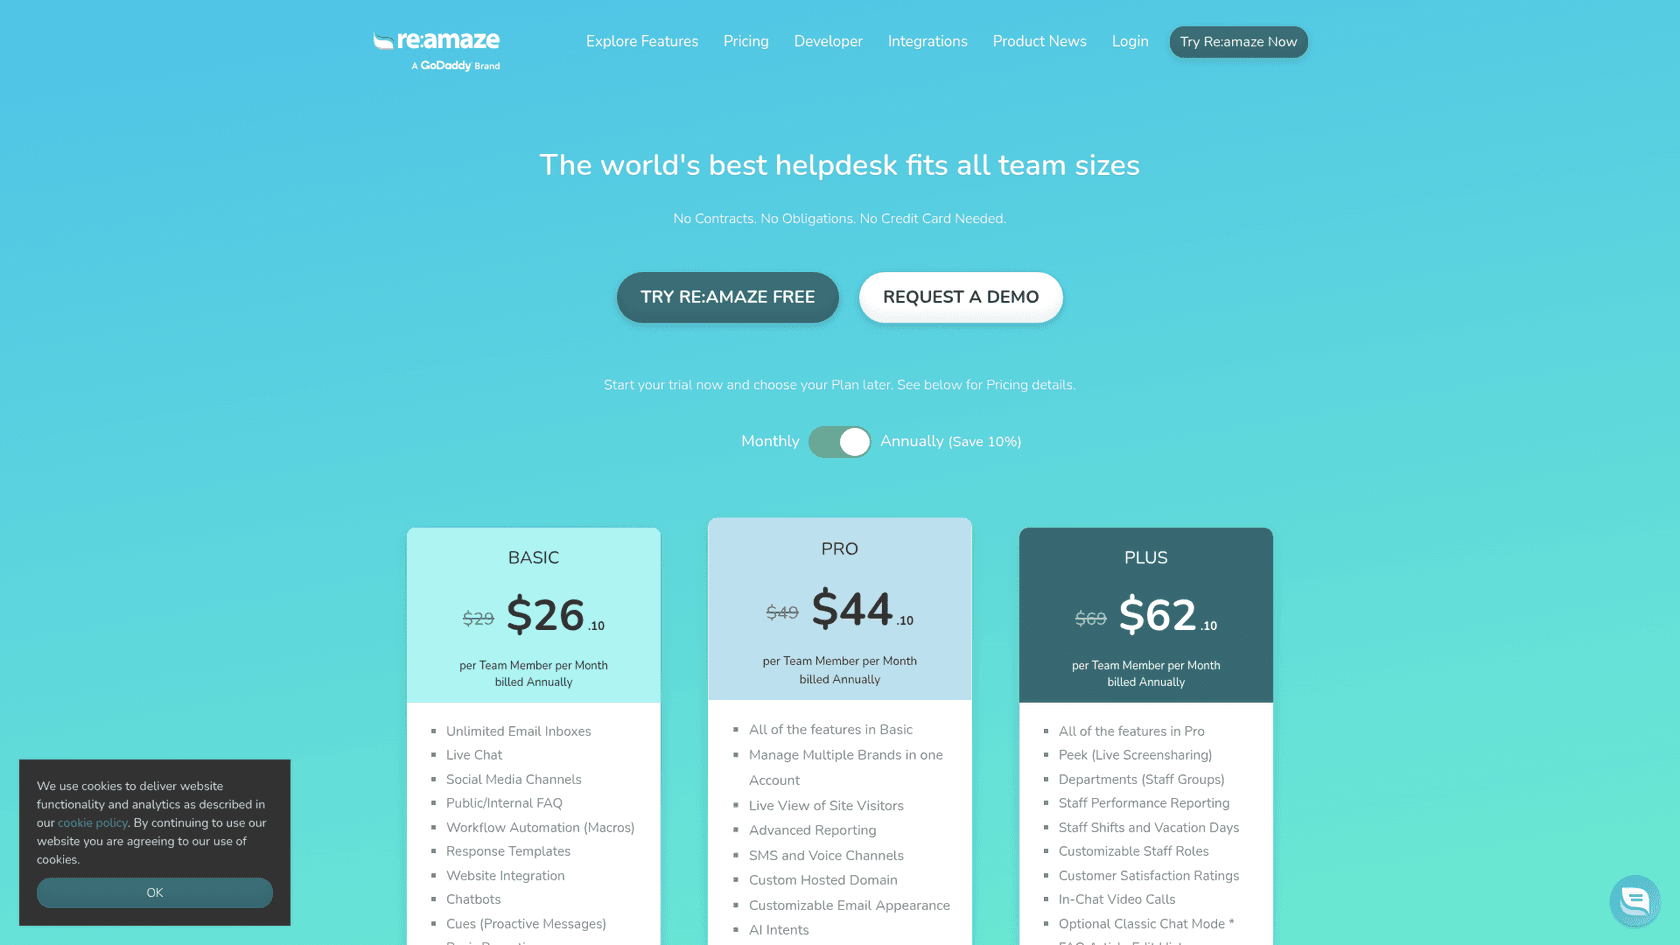
Der Leitfaden sagt, Volumenpläne hätten kein sitzbasiertes Kontingent und rechnen jede Lösung pauschal mit 0,85 $ ab. Hier sind drei Szenarien, die ich durchgerechnet habe. Die Lösungszahlen sind meine Annahmen, keine Re:amaze-Zahlen.
| Team | Sitzkosten (Monatsabrechnung) | Enthalten | Angenommene Lösungen | Überschreitung | Gesamt |
|---|---|---|---|---|---|
| 2 Sitze auf Basic | 58 $ | 10 | 100 | 90 x 0,85 $ = 76,50 $ | 134,50 $ |
| 3 Sitze auf Pro | 147 $ | 30 | 200 | 170 x 0,85 $ = 144,50 $ | 291,50 $ |
| 5 Sitze auf Plus | 345 $ | 100 | 400 | 300 x 0,85 $ = 255,00 $ | 600,00 $ |
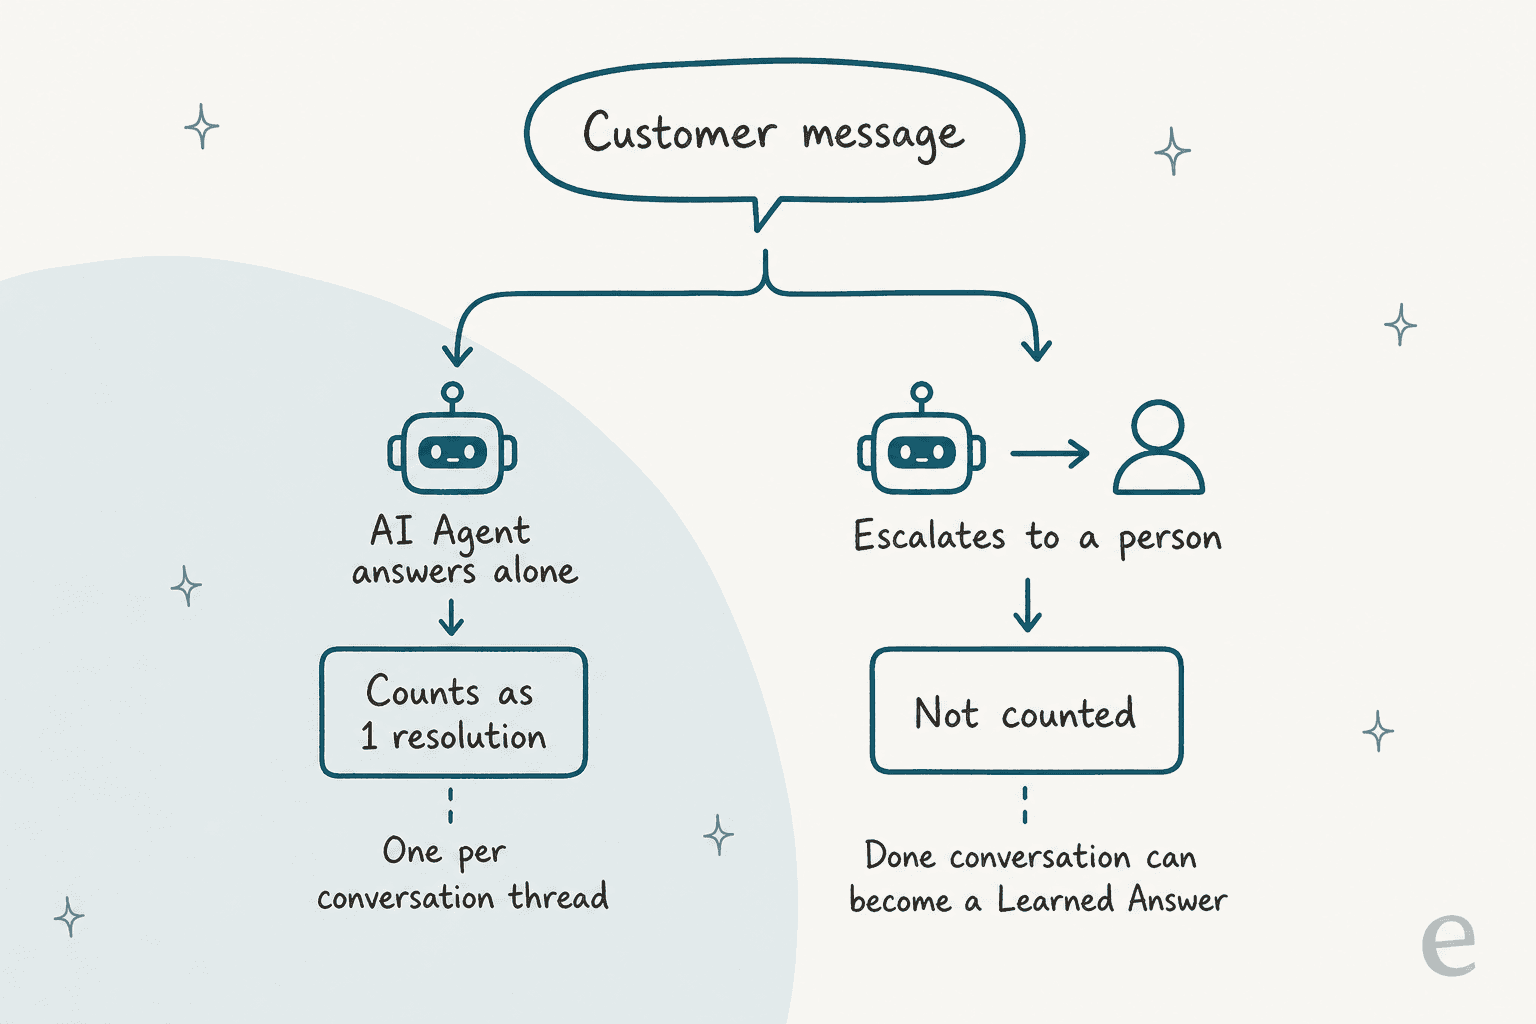
Das Sitzkontingent deckt nur einen kleinen Teil eines geschäftigen Shops ab, sodass die Überschreitung schnell zum Hauptkostenfaktor der KI wird. Der Zähler läuft nur bei Unterhaltungen, die der KI-Agent abschließt, sodass eine eskalierte Unterhaltung kostenlos ist, was eine gute FAQ belohnt. Für das breitere Preisbild siehe was Re:amaze kostet und die Re:amaze-Rezension.
Wie richten Sie Re:amaze-KI-Deflection in etwa einer Stunde ein?
Das meiste davon ist Schreiben, nicht Klicken. Hier ist die Reihenfolge, die ich verwenden würde.
- Zuerst die FAQ reparieren (20 Minuten). Eine Frage pro Artikel, die Frage als Titel, die Antwort in der ersten Zeile. Veröffentlichen Sie nichts Veraltetes mehr, denn die KI wird es selbstbewusst wiederholen.
- Eigenen KI-Kontext ausfüllen (10 Minuten). Setzen Sie unter AI > Manage Bots > Custom AI Context eine Persönlichkeit und kurze Richtlinien, und fügen Sie externe URLs für Richtlinien hinzu, die außerhalb von Re:amaze liegen.
- Pre-Filter für das hinzufügen, was eine Person beantworten sollte (10 Minuten). Abrechnung, Kündigungen und VIP-Kunden sind die üblichen ersten drei.
- Testen (15 Minuten). Nutzen Sie den Test AI Agent-Tab mit Ihren zehn häufigsten Fragen und notieren Sie, welche eskalieren oder den falschen Artikel zitieren.
- Für einen Kanal einschalten. Gehen Sie zu AI > Manage Bots > AI/Chatbots, aktivieren Sie Re:amaze AI Agent und wählen Sie einen einzelnen E-Mail- oder SMS-Kanal, und denken Sie daran, dass die klassischen Bots dann stoppen.
- Zwei Wochen täglich überprüfen. Prüfen Sie Quellenzahlen bei Antworten, speichern Sie Korrekturen und genehmigen Sie gelernte Antworten, die zu Ihrer Richtlinie passen.
Nutzen Sie auch Shopify, hat eesel eine Shopify-Integration, und KI für Shopify-Support zeigt, was bestellungsbewusste KI kann, und das Re:amaze-KI-Setup meiner Kollegin ist die längere Anleitung.
Wie misst man Deflection ehrlich?
Zählen Sie die Unterhaltungen, die nie passiert sind, nicht nur die, die ein Bot abgeschlossen hat. Re:amazes Chatbot-Bericht (Reports > Chatbot Reports) gibt Ihnen vier Zahlen: ausgelöste Mengen, Beteiligungsrate, Lösungsrate und Eskalationsrate. Die beschreiben Unterhaltungen, die bereits existieren. FAQ-Besuche, die ohne Nachricht endeten, sind nicht darunter.
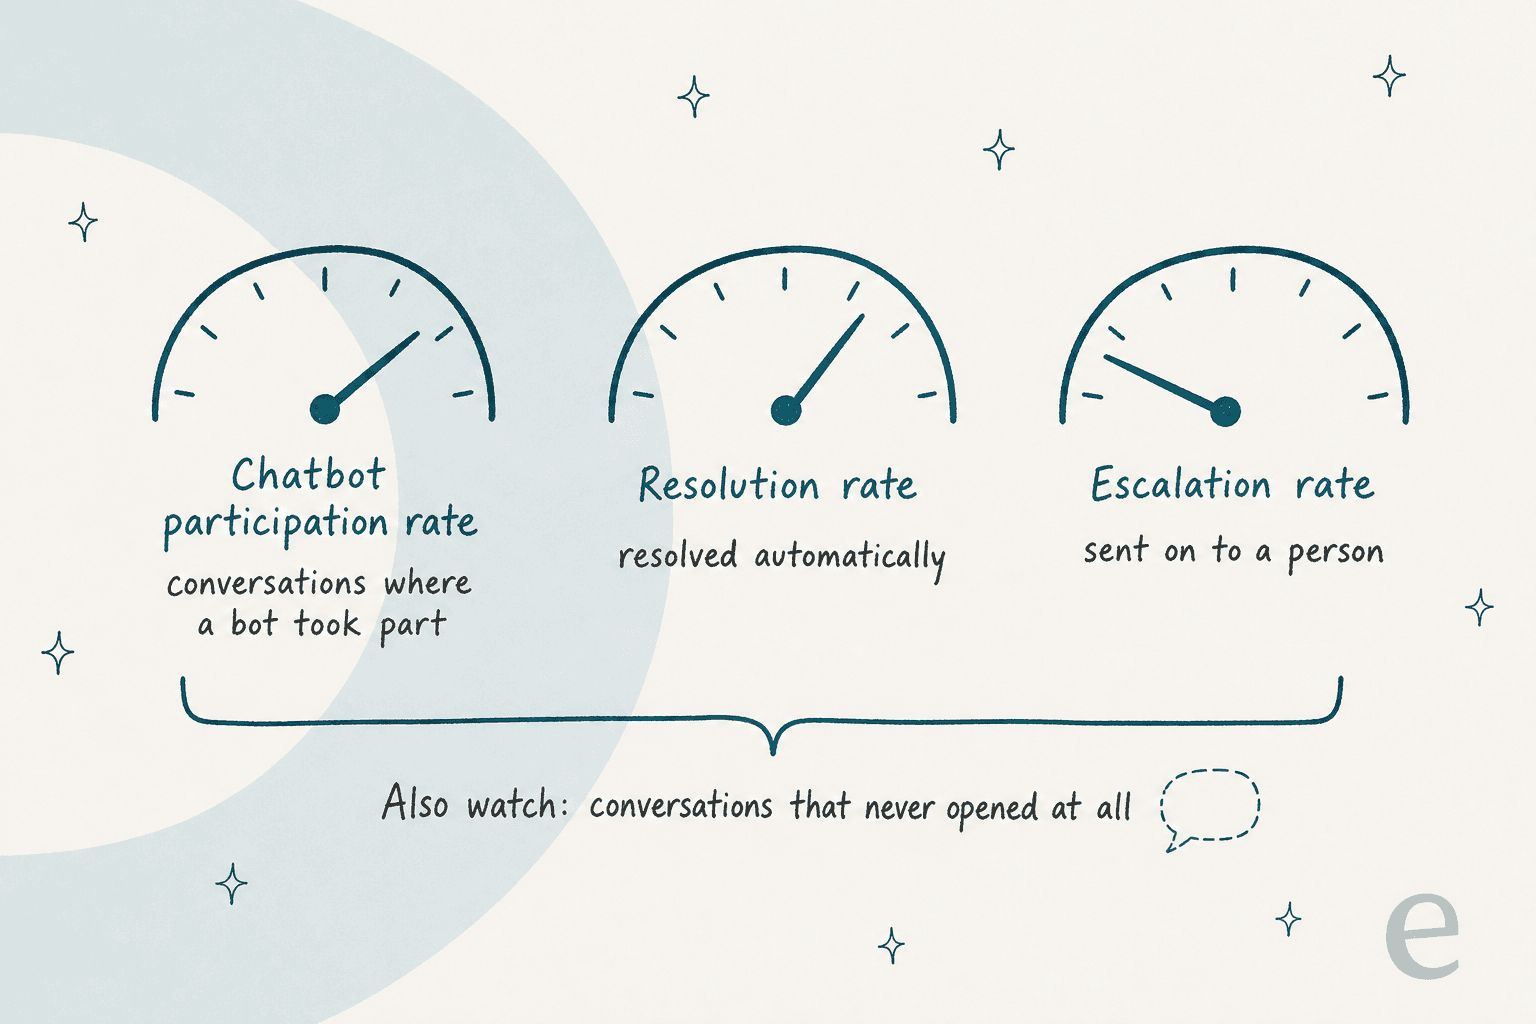
Mein Ansatz, der eine Methode von mir ist und kein Re:amaze-Feature:
- Die Lösungsrate sagt Ihnen, wie oft der KI-Agent beendet, was er beginnt. Lesen Sie sie neben der Eskalationsrate, denn eine hohe Lösungsrate bei einer engen Auswahl leichter Fragen sagt wenig aus. KI-Lösungsrate und Containment- und Eskalationsqualität erklären den Unterschied.
- Unterhaltungen pro 1.000 Bestellungen kommt der echten Deflection am nächsten. Schreiben Sie die Zahl des letzten Monats vor dem Start auf und vergleichen Sie nach vier Wochen.
- Wiedereröffnete und wiederholte Unterhaltungen zeigen Antworten, die richtig klangen und es nicht waren. Wiederkehrende Support-Tickets behandelt, wie man sie liest.
Eine Lösung in Re:amaze bedeutet "kein Mensch hat geantwortet", was nicht dasselbe ist wie "der Kunde hat die richtige Antwort bekommen". Prüfen Sie im ersten Monat wöchentlich zwanzig gelöste Unterhaltungen stichprobenartig.
Wo endet Re:amazes Deflection?
Sie endet dort, wo die Gewohnheiten Ihres eigenen Teams mehr zählen als Ihre geschriebene FAQ. Hier sind die Grenzen, die ich einplanen würde, jede aus Re:amazes Dokumentation.
- Die Quellen sind Ihre Inhalte. FAQ, Vorlagen, eigener Kontext und Shop-Daten. Frühere Ticket-Historie ist nicht als Eingabe aufgeführt, und gelernte Antworten kommen nur aus Eskalationen.
- Das Lernen ist begrenzt und manuell. 50 gespeicherte Antworten, 100 Korrekturen, 14-tägiger Ablauf bei Vorschlägen.
- Der KI-Agent und die klassischen Bots laufen nicht zusammen. Sie wählen einen für den Chat.
- Pre-Filter hängen vom KI-Agent ab. Sie brauchen ihn aktiv, mit verbleibenden Lösungen oder aktivierter Überschreitung.
- Es trägt das Label Beta. Die KI-Seite und die Preisseite zeigen beide das Label, erwarten Sie also, dass sich der Funktionsumfang weiter ändert.
Die meisten Helpdesks haben mit ihrer eingebauten KI ähnliche Grenzen. Help Scouts Deflection-Stack zieht die Linien an anderen Stellen, und eingebaute Helpdesk-KI gegen eine zusätzliche Ebene ist der allgemeine Kompromiss. Wenn Sie einen Wechsel abwägen, geben Re:amaze-KI-Alternativen und lohnt sich Re:amaze den breiteren Blick.
Wie fügt eesel Deflection auf Re:amaze hinzu?
eesel ist ein KI-Teammitglied, das sich Ihrem Helpdesk anschließt, und bei Re:amaze füllt es die Lücke, die die eingebauten Tools lassen: Antworten, die darauf beruhen, wie Ihr Team bereits antwortet. Laut eesels Re:amaze-Dokumentation liest es Ihre bisherigen Unterhaltungen, Antwortvorlagen und Help-Center-Artikel, und es kann die neuesten 40 Nachrichten eines Strangs lesen. Es kann eine interne Notiz für eine Person hinterlassen oder eine Antwort senden, die Kunden sehen. Vor dem Senden liest es den Strang erneut und stoppt, wenn jemand schon geantwortet hat, und markiert die Unterhaltung dann mit eesel-handled.
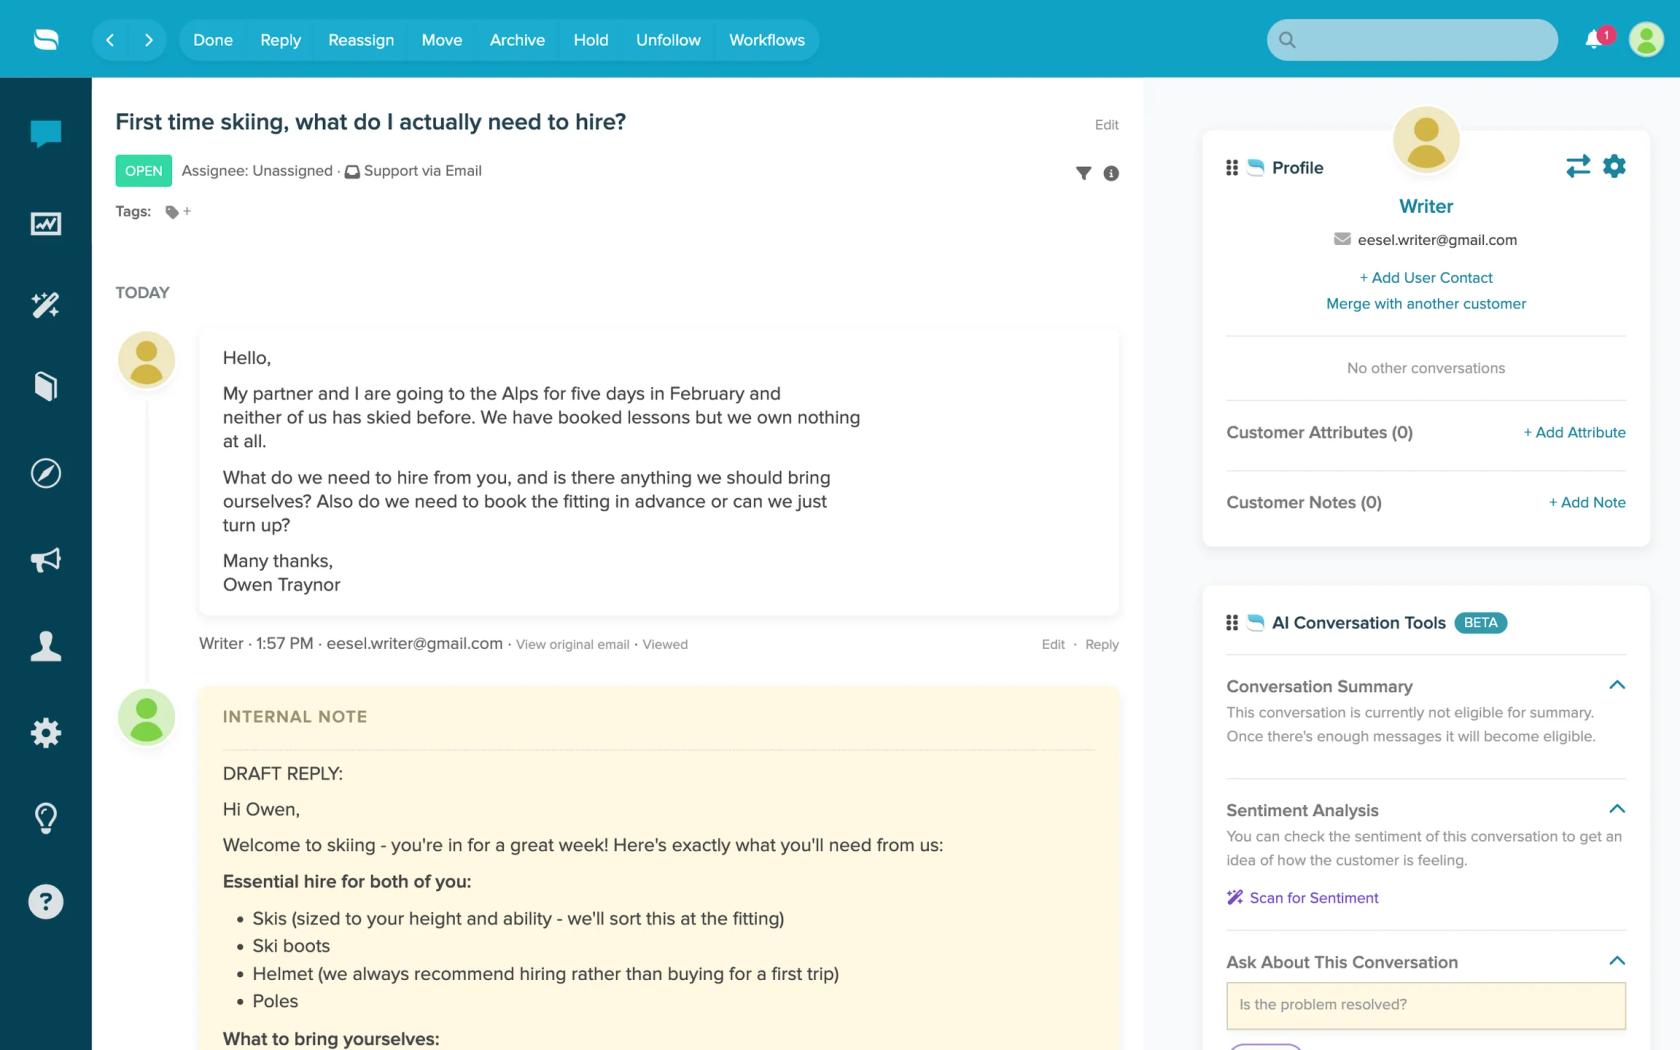
Seien Sie klar über die Grenzen. Re:amaze hat in eesel keine Event-Trigger, es läuft also nach einem Zeitplan, so oft wie alle zehn Minuten, was besser zu E-Mail passt als zu Live-Chat. Es liest keine Anhänge oder benutzerdefinierten Felder. Antworten schließt die Unterhaltung nicht, es sei denn, Sie fordern diese Statusänderung an. Deshalb würde ich Re:amazes eigenen KI-Agent für sofortigen Chat behalten und eesel die E-Mail-Warteschlange geben.
Wie Deflection in einem E-Commerce-Posteingang aussieht, zeigt Question Beauty, das eesel auf Gorgias und Shopify betreibt. In einem Monat (8. August bis 8. September 2026) bearbeitete eesel rund 990 Tickets, sandte rund 960 Antworten direkt an Kunden statt als Entwürfe, sah rund 290 Shopify-Bestellungen nach, bevor es Lieferfragen beantwortete, und schloss rund 280 Tickets ohne eine Person. Rückerstattungen, Beschwerden und alles, was eine Entscheidung braucht, gehen mit einer Notiz an ein Teammitglied. Dieses Setup läuft auf Gorgias, das bei neuen Nachrichten auslöst, Re:amazes Zeitplan wäre also langsamer, aber das Muster aus Antworten, Bestellung prüfen und Übergeben bleibt erhalten. STIL Classics wählt den vorsichtigen Weg: eesel entwirft interne Notizen, die eine Person prüft und sendet. Beide passen zum Human-in-the-Loop-Ansatz, den ich für den ersten Monat verwenden würde. Breitere Ideen finden sich in Support-Tickets mit KI reduzieren und FAQ-Deflection-Tools.
Testen Sie eesel auf Ihrer Re:amaze-Warteschlange
Nutzen Sie Re:amazes FAQ, Order Bot oder KI-Agent für die sofortigen Antworten, die sie gut bewältigen, und lassen Sie eesel die E-Mail-Unterhaltungen übernehmen, bei denen die bisherigen Antworten Ihres Teams mehr zählen als ein FAQ-Artikel. Verbinden Sie Re:amaze per API-Token, starten Sie mit Entwürfen als interne Notizen bei Unterhaltungen ohne Antwort, und wechseln Sie zum Senden, sobald Sie den Antworten vertrauen.
Eine Unterhaltung kostet 1 Credit, egal wie lange sie läuft. Der kostenlose Test gibt Ihnen 100 Credits über 7 Tage ohne Kreditkarte, und Pläne starten bei 299 $ im Monat für 500 Credits, laut eesel-Preisen. Testen Sie eesel in Ihrer Re:amaze-Warteschlange, oder lesen Sie zuerst die Übersicht beste KI für E-Commerce-Support.