

Was ist Support-QA-Kalibrierung?
Zendesk bringt es in seiner Anleitung zur Kalibrierung auf den Punkt: Kalibrierung ist „the practice of having all your reviewers rate the same batch of conversations and compare their scores and comments.“ Das ist die ganze Idee. Dieselben Gespräche, dieselbe QA-Scorecard, verschiedene Personen, und dann ein Gespräch darüber, warum die Zahlen nicht übereinstimmen. Wenn du die Scorecard noch nicht gebaut hast, fang mit der Erstellung einer Zendesk-QA-Scorecard an und komm danach zurück.
Ich bearbeite jeden Tag die Support-Warteschlange von eesel, und das Thema ist wichtig, weil QA-Scores nicht im QA-Tool bleiben. Sie landen in 1:1-Gesprächen, in Coaching-Plänen, manchmal in Boni. Wenn ein Reviewer einer Antwort beim Ton 4 von 5 gibt und ein anderer derselben Antwort 2, hängt der Score des Agenten davon ab, in wessen Warteschlange er gelandet ist. Agenten merken das schnell, und sobald sie QA für ein Glücksspiel halten, kommt Feedback nicht mehr an.
"You could have five QA agents listen to the same call and get five different results. Which isn't fair to the agent as that score could be used to determine if they'll be fired."

Kalibrierung ist die Lösung dafür. Sie ist kein Training für Agenten, und in den meisten Tools sehen Agenten sie nie. In Zendesks Anleitung steht "Agents do not see any conversation-related information in calibration", und Kalibrierungs-Scores "don't affect the existing Internal Quality Score (IQS)." Es ist eine Kontrolle der Bewerter, durchgeführt von den Bewertern.
Warum QA-Scores auseinanderdriften
Reviewer widersprechen sich nicht zufällig. Sie sind sich bei den Kategorien uneinig, in denen die Rubrik Raum für Urteilsvermögen lässt: Ton, Empathie, „hatte die Antwort die richtige Länge“, „hat der Agent mehr getan als nötig“. Prozess und Genauigkeit stimmen meist überein, denn eine Erstattungsrichtlinie wurde entweder befolgt oder nicht. Beim Ton lesen zwei sorgfältige Menschen denselben Satz und landen zwei Punkte auseinander.
Die andere Ursache für Drift ist, was „bestanden“ überhaupt bedeutet. Hier ein echtes Beispiel aus der eigenen Arbeit von eesel. Ich habe mir einen Test mit echtem Traffic in einem E-Commerce-Zendesk-Posteingang angesehen, bei dem 284 von der KI entworfene Antworten auf drei verschiedene Arten bewertet wurden.
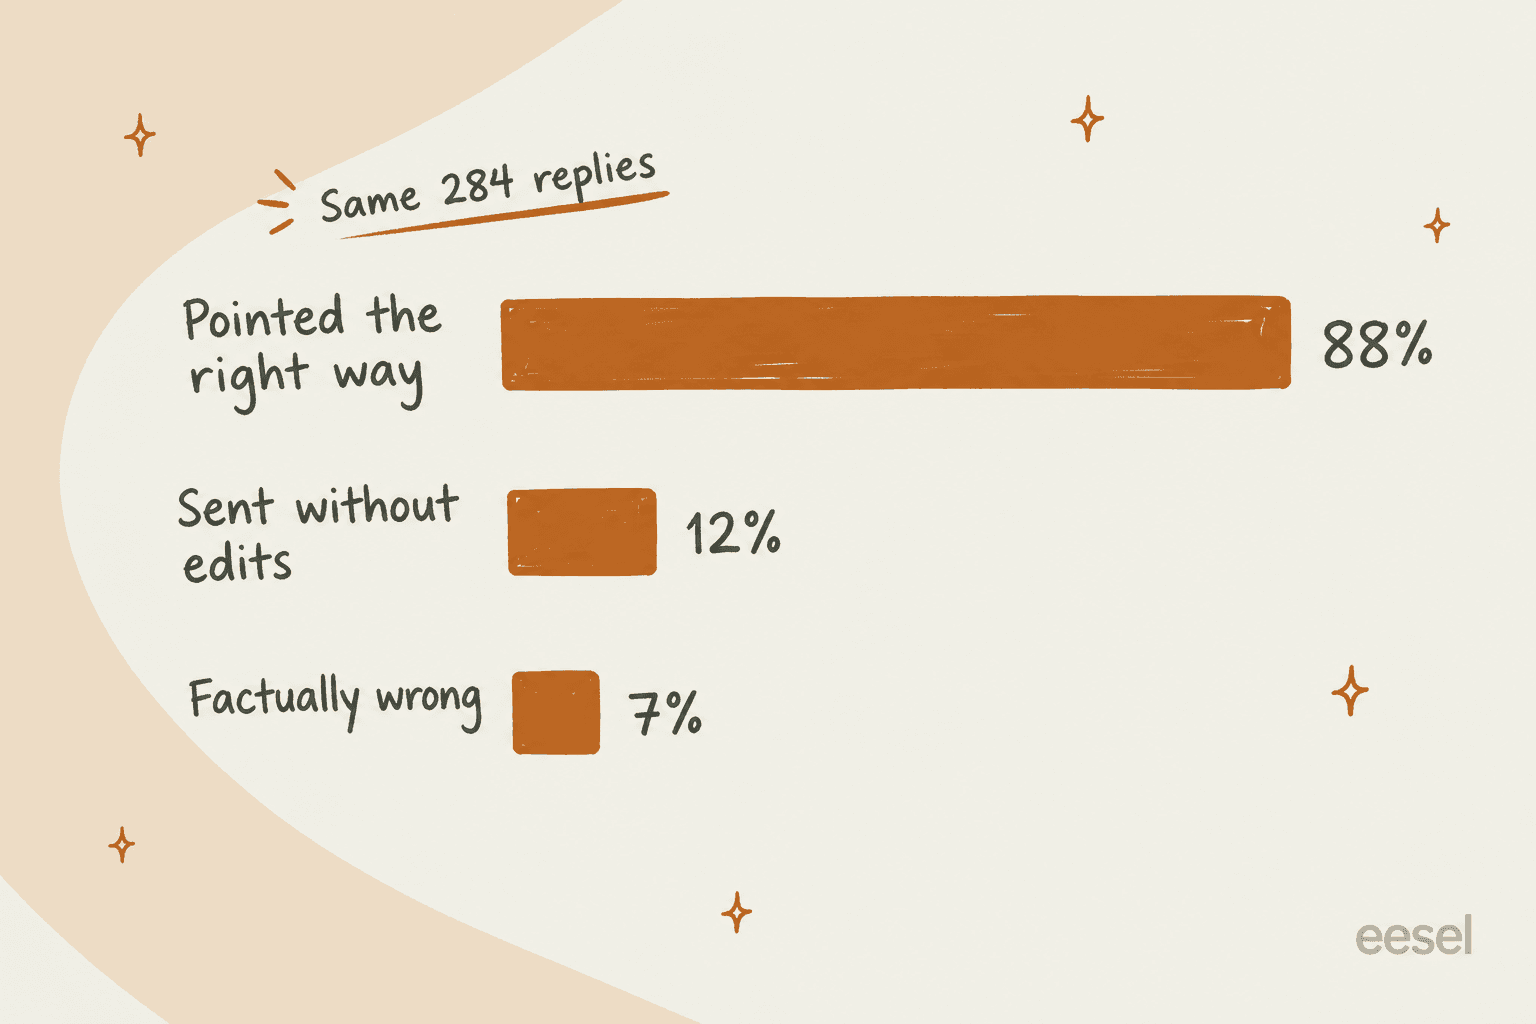
Dieselben Antworten, drei Urteile: 88 % zeigten in die richtige Richtung, nur 12 % wurden ohne Änderungen gesendet, und 7 % waren sachlich falsch. Keine dieser Zahlen ist falsch. Sie beantworten nur unterschiedliche Fragen. Ein Reviewer, der fragt „würde ich das so senden?“, und einer, der fragt „ist die Antwort richtig?“, bewerten dieselbe Warteschlange meilenweit auseinander, und beide halten sich für fair. Als ich untersuchte, warum Agenten die Entwürfe umschrieben, ging es bei etwa 65 % der Umschreibungen um Länge und Ton, bei etwa 20 % fehlten Bestelldaten, die der Entwurf nicht sehen konnte, und bei etwa 5 % war der Entwurf sachlich falsch. Länge und Ton sind genau die Kategorien, bei denen auch menschliche Reviewer auseinanderliegen. (Diese Art von Umschreibungsanalyse habe ich in meinem Leitfaden zur Fehleranalyse aufgeschlüsselt.)
Deshalb beginnt Kalibrierung mit der Messlatte, nicht mit dem Score. Wenn deine Scorecard nicht sagt, wie sich eine 3 von einer 4 beim Ton unterscheidet, bringt keine noch so lange Diskussion Reviewer dauerhaft auf eine Linie.
So führst du eine QA-Kalibrierungs-Session durch
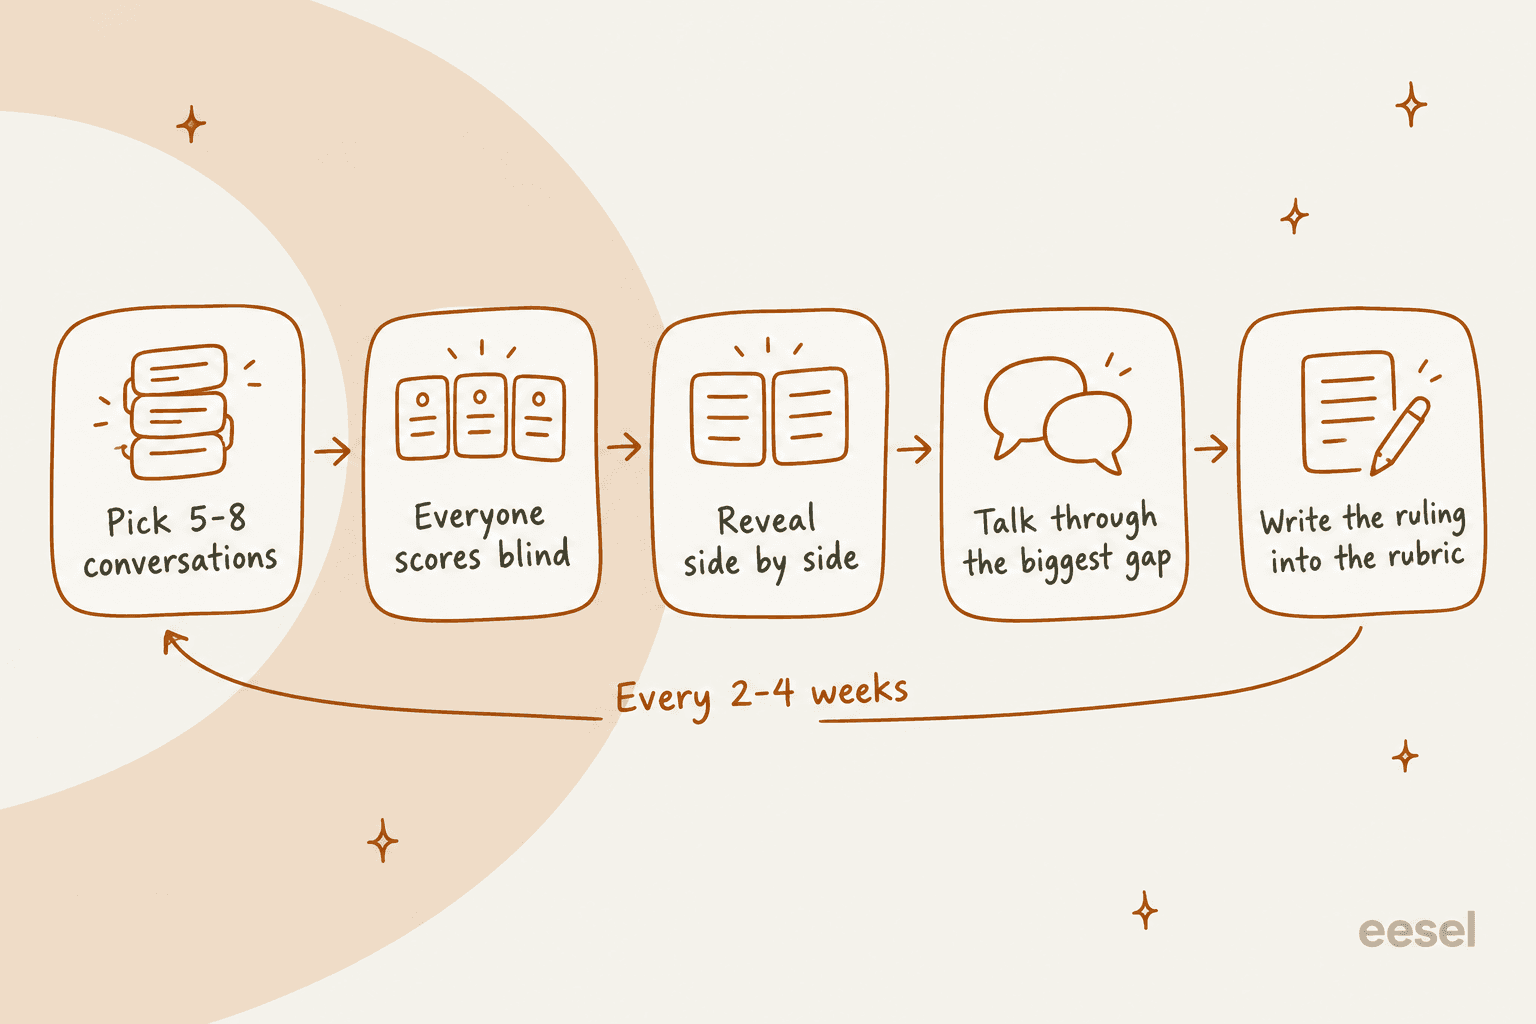
So würde ich die Session in fünf Schritten durchführen. Sie dauert etwa eine Stunde pro Monat, plus 10 bis 15 Minuten Bewertung pro Reviewer vorab.
1. Wähle 5 bis 8 Gespräche, die Streit auslösen
Zendesks Kalibrierungsleitfaden empfiehlt, mit etwa fünf Gesprächen zu beginnen. Ich würde auf acht gehen, sobald das Team daran gewöhnt ist. Mehr als das, und die Diskussion wird gehetzt.
Die Auswahl ist wichtiger als die Anzahl. Einfache Tickets lehren dich nichts, weil alle sie gleich bewerten. Der Kalibrierungsrat von MaestroQA lautet, Tickets mit niedrigen QA-Scores, kniffligen Themen oder einem kürzlich geänderten Prozess oder Produkt zu ziehen. evaluagent ergänzt in seiner Erklärung zur Kalibrierung einen fairen Punkt: Halte das Set ausgewogen und nimm nicht nur schlechte Interaktionen, sonst wird die Session zur Schuldzuweisung.
Meine Mischung: ein Gespräch zu einer gerade geänderten Richtlinie, eines, bei dem der Kunde von der ersten Nachricht an verärgert war, ein langer Thread mit vielen Antworten, eines, das gut lief, sich aber „komisch“ anfühlte, und eines, das ein Agent kürzlich angefochten hat. Wenn du mehr als eine Sprache unterstützt, nimm auch ein nicht englisches Gespräch dazu; mein Leitfaden zur mehrsprachigen Support-QA erklärt, wie du über Sprachteams hinweg kalibrierst.
2. Alle bewerten blind
Diesen Schritt überspringen Teams, und er macht den Rest erst wirksam. Wenn Reviewer die Scores der anderen sehen oder gemeinsam im Raum bewerten, setzt die erste selbstsichere Person die Zahl, und alle driften dorthin. Das Kalibrierungs-Webinar von evaluagent beschreibt die Papierversion dieses Problems: Leute "can change their scores on their paper, and they can be swayed to another person's point of view before they get an opportunity to speak."
In Zendesk QA ist blind oder offen eine Workspace-Einstellung, die du pro Rolle wählst. Reviewer können so eingestellt werden, dass sie nur ihre eigenen Reviews sehen oder die Reviews der Kollegen erst nach dem Absenden der eigenen. Leads und Manager haben dieselbe Option „nach dem Absenden“ oder „immer“.
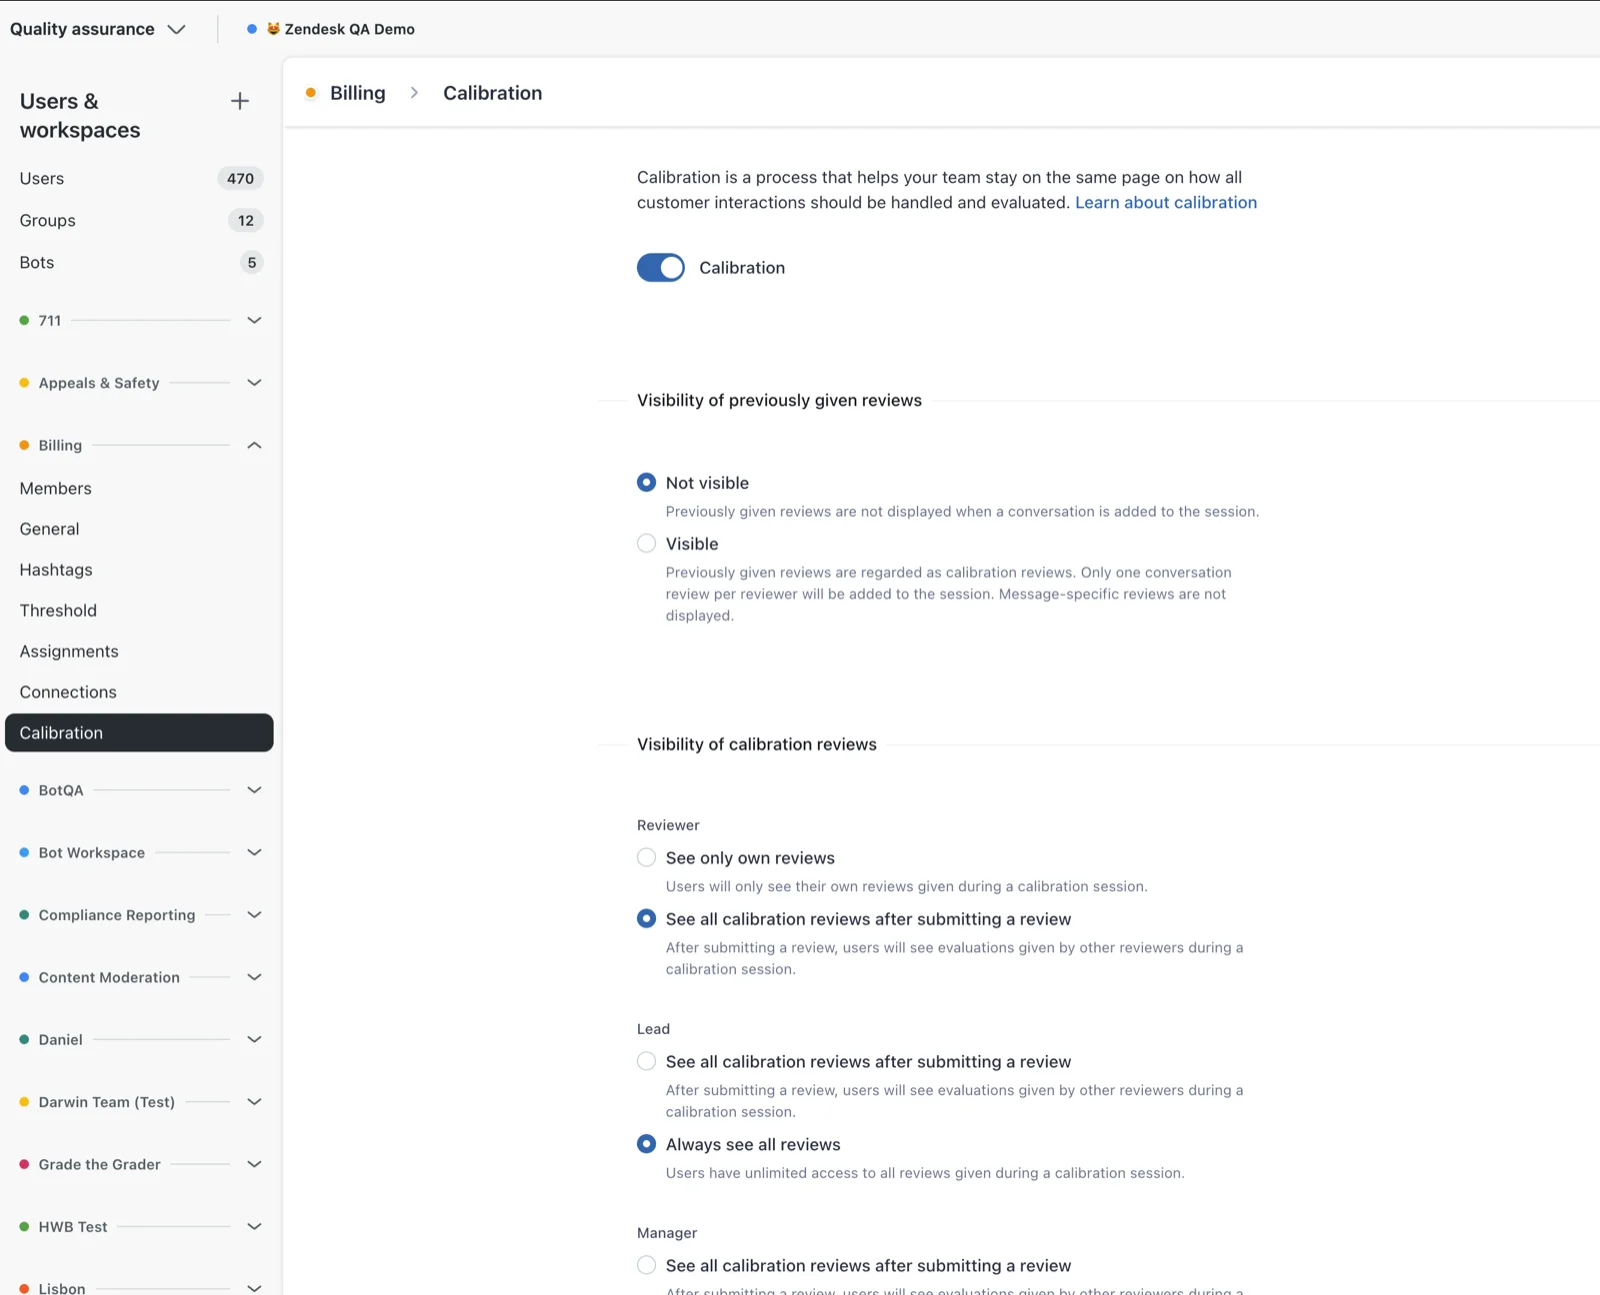
Ein praktischer Stolperstein: Zendesk QA sendet keine Benachrichtigungen zur Kalibrierung. Laut Zendesks Dokumentation gilt: "it's up to the workspace manager or lead to inform reviewers about the calibration session and its due date." Schreib die Frist in den Team-Channel, sonst bewertet die Hälfte der Reviewer 10 Minuten vor dem Meeting.
3. Scores nebeneinander aufdecken, gegen eine Baseline
Sobald alle bewertet haben, bring die Scores in ein Raster: Reviewer an der Seite, Scorecard-Kategorien oben. Du suchst nach zwei Dingen, auf die ich im nächsten Abschnitt zurückkomme: Kategorien mit großer Streuung und Reviewer, die überall danebenliegen.
Du brauchst außerdem eine Baseline, also einen vereinbarten „richtigen“ Score zum Vergleich. In Zendesk QA kann ein Manager ein Review als Baseline review markieren, was laut Zendesk "makes it easier to compare scores against it." Das Kalibrierungs-Dashboard zeigt dann den Score jedes Reviewers neben dem Baseline-Score.
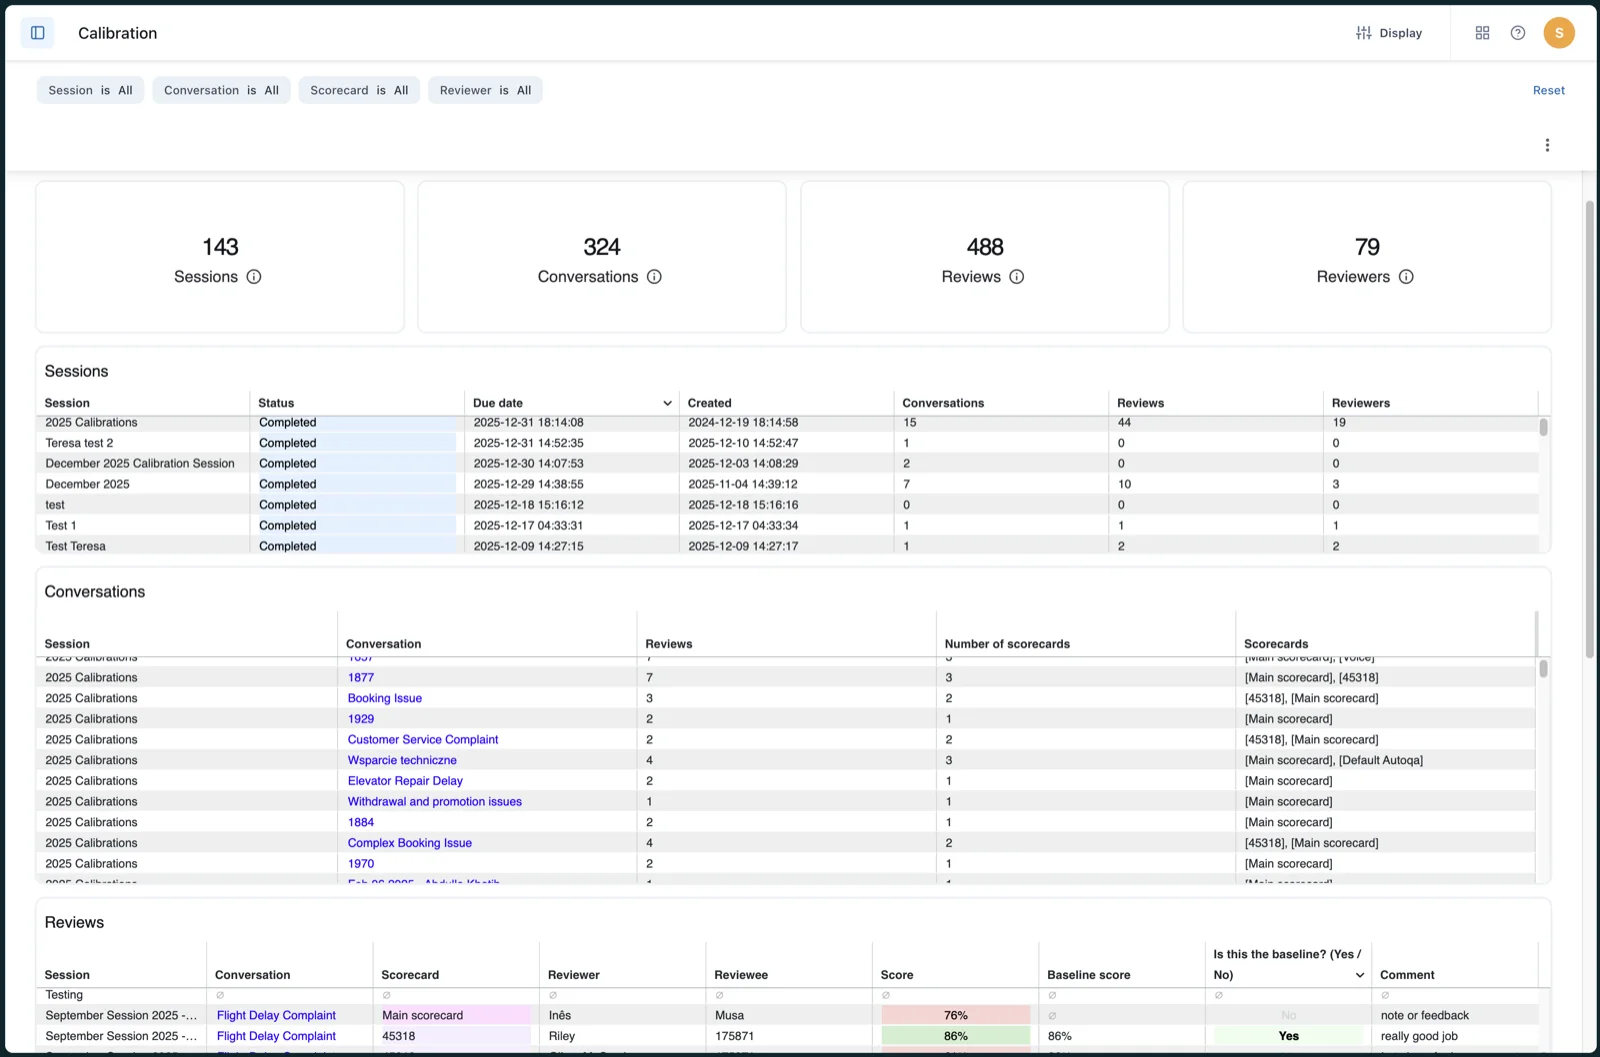
MaestroQA macht dasselbe mit einem festgelegten finalen Kalibrierer. Der Leitfaden zur Team-Abstimmung nennt diese Person "your source of truth to measure alignment against", und jeder Bewerter bekommt einen Abstimmungs-Score im Vergleich zu ihr.
4. Besprich die größte Abweichung, nicht jede
Bei 5 Gesprächen und 6 Kategorien hast du 30 Stellen für Uneinigkeit. Die schaffst du in einer Stunde nicht, und du solltest es nicht versuchen. Sortiere nach Streuung und verwende das Meeting auf die zwei oder drei größten Abweichungen.
Das Ziel ist eine Entscheidung, kein Konsens. Eine Führungskraft von Stitch Fix, zitiert auf MaestroQAs Kalibrierungsseite, formulierte es gut: "We've normalized the expectation that we're driving toward commitment, not consensus." evaluagent sagt dasselbe von der anderen Seite: "It's not a democracy, if you like, where majority rules." Wenn drei Reviewer 4 sagen und einer 2, ist die Antwort nicht automatisch 4. Wer die Richtlinie am besten kennt, entscheidet, und alle tragen die Entscheidung mit.
5. Schreib die Entscheidung in die Rubrik
Hier scheitern die meisten Kalibrierungs-Sessions leise. Das Team einigt sich, alle nicken, und drei Wochen später taucht dieselbe Meinungsverschiedenheit wieder auf, weil nichts aufgeschrieben wurde.
Jede geklärte Abweichung sollte zu einer Zeile in deinen Scorecard-Hinweisen werden, mit dem Gespräch als Praxisbeispiel. „Ton: Eine Antwort, die sich zweimal für dasselbe Problem entschuldigt, bekommt 3, nicht 4. Beispiel: Ticket #48213.“ Das ist das Artefakt, das die nächste Session kürzer macht. Es speist auch deine Support-SOPs und die Beispiele, die du beim Onboarding neuer Agenten nutzt, denn neue Mitarbeitende brauchen dieselben Entscheidungen, die deine Reviewer gerade getroffen haben. Gute Entscheidungen lesen sich wie gute QA-Feedback-Beispiele: konkret, an eine Zeile im Gespräch gebunden und kurz.
Ein QA-Lead auf r/callcentres beschrieb die strenge Version davon:
"Calibrations by quality need to be strictly enforced and maintained. My last team I ran was quality and every month we'd pick a random call, all score separately, then get together and decide the correct score for each quality point. Whatever we all decided on, we had to be within 3% of that score (and certain elements had to be 100% on point)."
Rubrik-Problem oder Reviewer-Problem?
Das ist der Teil der Kalibrierung, den die meisten Leitfäden überspringen, und er ist der nützlichste. Wenn Scores nicht zusammenpassen, verrät dir das Muster der Abweichung, was du beheben musst.
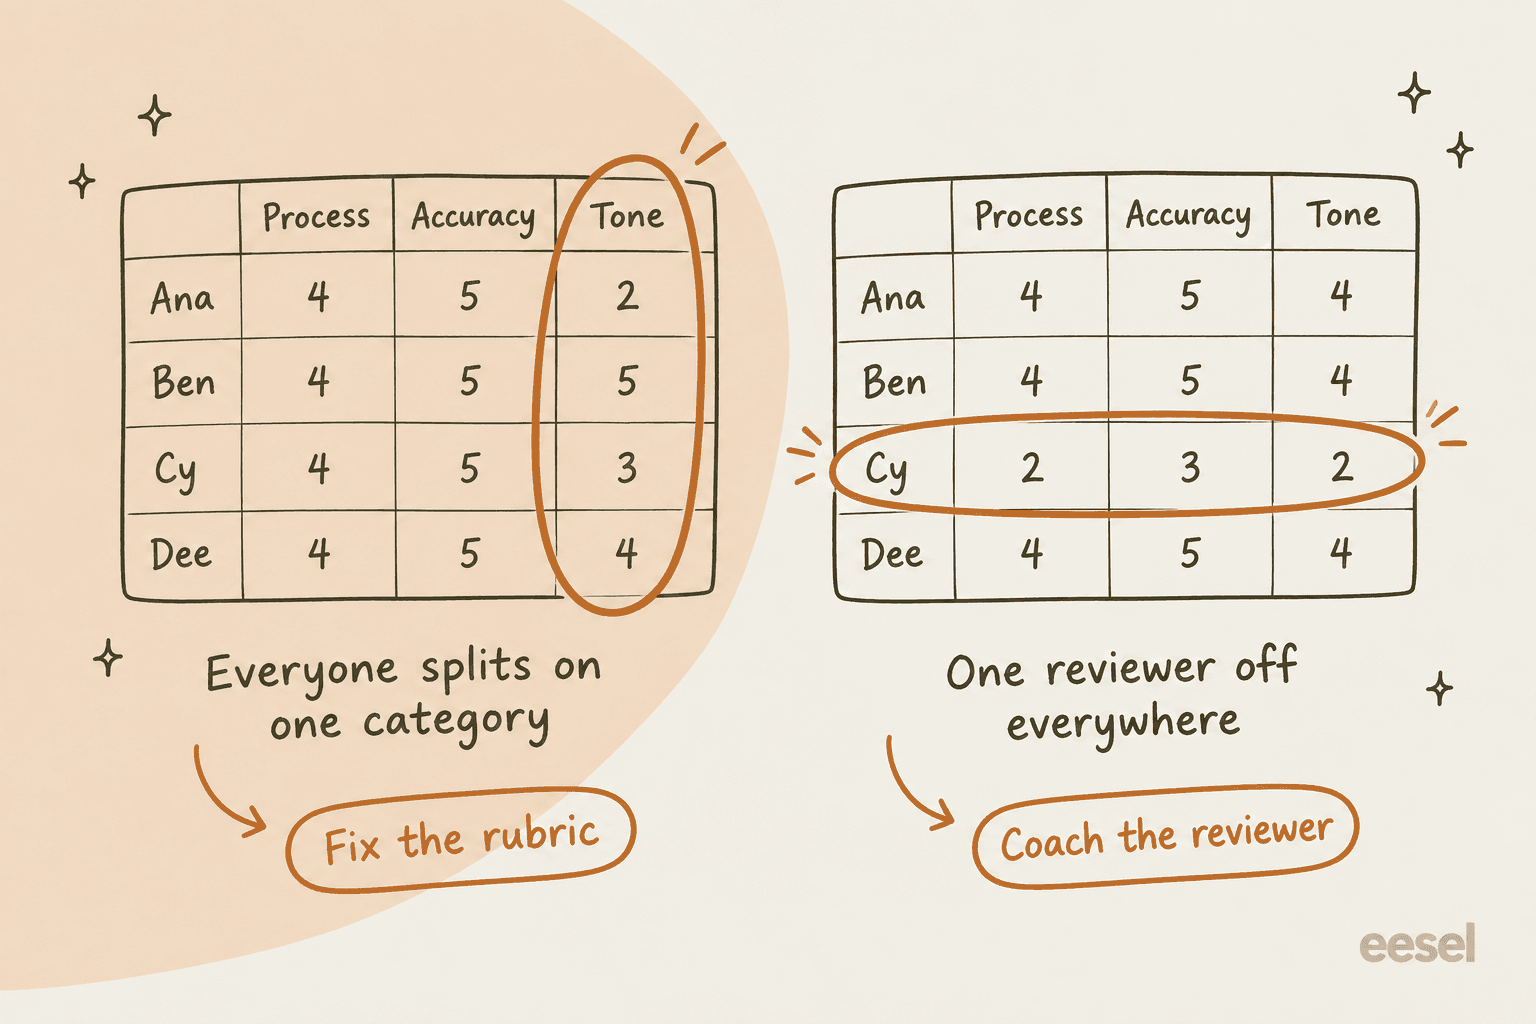
Alle streuen bei einer Kategorie. Wenn Prozess und Genauigkeit übereinstimmen, der Ton bei vier Reviewern aber von 2 bis 5 reicht, liegt niemand „falsch“. Das Kriterium lässt Interpretationsspielraum, also korrigiere die Rubrik. Schreib die Ton-Hinweise mit konkreten Beispielen um (mein Leitfaden zum Ton im Kundenservice enthält eine Vorlage) und bewerte dasselbe Gespräch in der nächsten Session erneut, um zu prüfen, ob sich die Lücke geschlossen hat.
Ein Reviewer liegt überall daneben. Wenn eine Person in jeder Kategorie zwei Punkte niedriger bewertet als alle anderen, ist die Rubrik in Ordnung. Dieser Reviewer liest sie anders, also coache den Reviewer. Setz dich mit ihm zusammen, so wie du einen Agenten coachen würdest, geh ein Gespräch Kategorie für Kategorie durch und lass ihn ein weiteres allein bewerten.
Das ganze Team liegt in dieselbe Richtung neben der Baseline. Alle geben 4er, und die Führungskraft gab 2er. Das heißt meist, dass die Führungskraft etwas weiß, was das Team nicht weiß, etwa eine Richtlinienänderung, die es nie in die Wissensdatenbank geschafft hat. Das ist ein Kommunikationsproblem, kein Bewertungsproblem.
Probier es mit deinen eigenen Zahlen aus. Trag die Scores jedes Reviewers für ein Gespräch ein, und der Checker sagt dir, welcher Fall vorliegt.
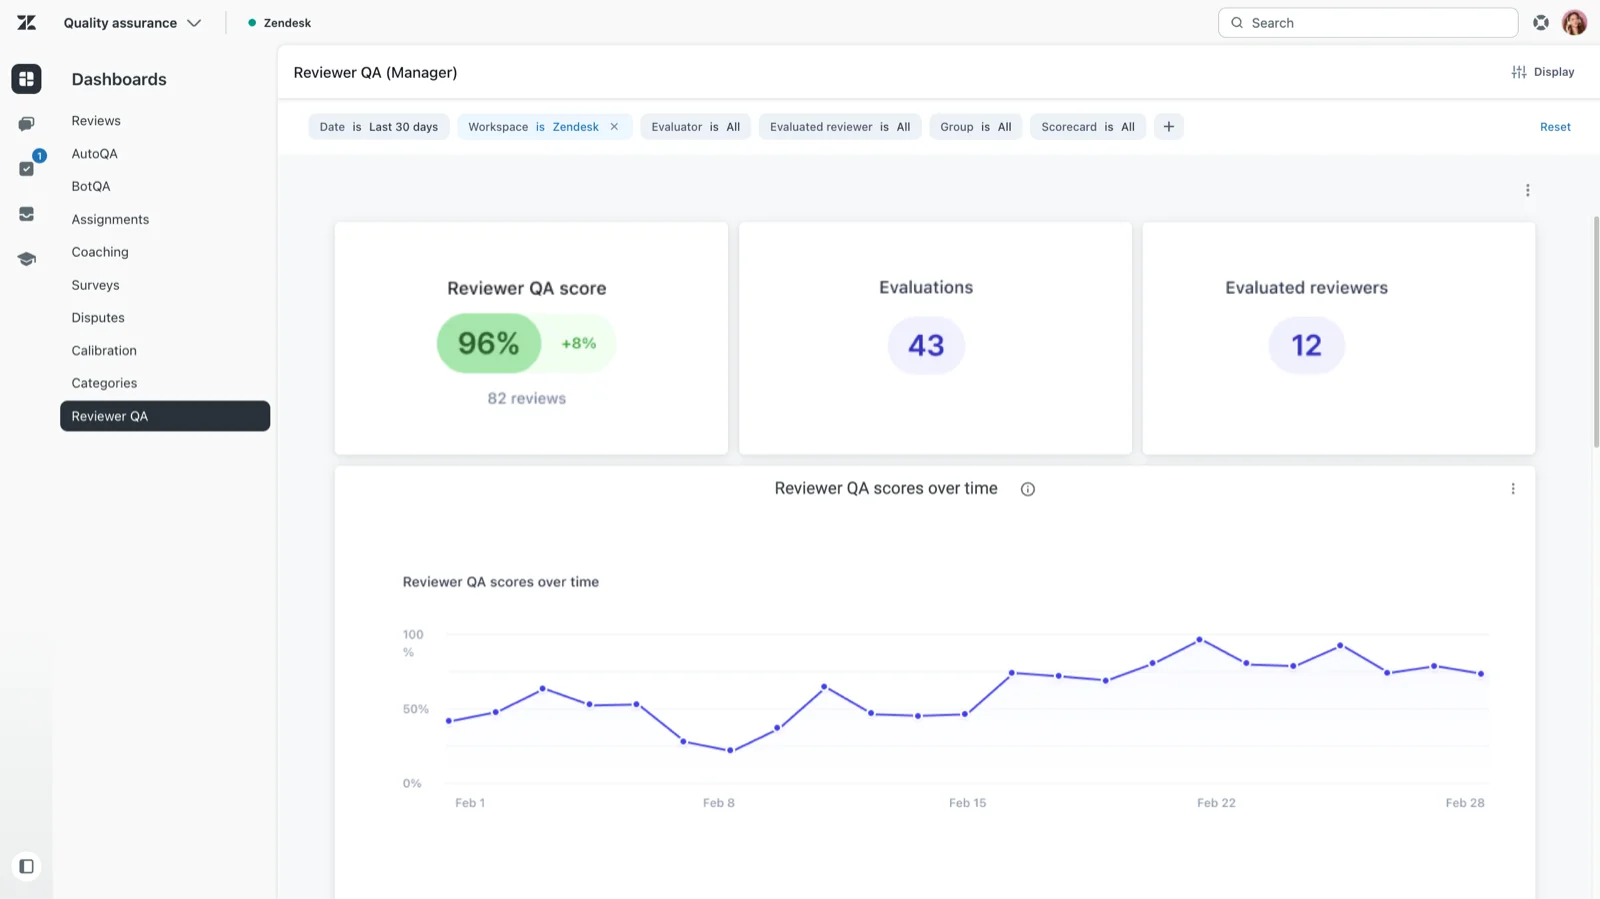
Zendesk QA verfolgt die Reviewer-Seite außerdem über die Zeit mit einem eigenen Reviewer-QA-Dashboard. Es arbeitet mit zufälligen Zuweisungen, bei denen jemand die Reviews der Reviewer selbst bewertet, und laut Zendesks Dashboard-Dokumentation dient es dazu, "track reviewer accuracy, evaluation history, and coaching trends." Bewertete Reviewer sehen ihre eigenen Scores, aber nicht, wer sie bewertet hat.
Was gilt als „kalibriert“?
Kein QA-Anbieter, den ich geprüft habe, veröffentlicht eine feste Bestehensgrenze. Das verwenden stattdessen die Leute, die das beruflich machen.
| Quelle | Kalibrierungsziel | Woran gemessen wird |
|---|---|---|
| Zendesks Kalibrierungsleitfaden | Abweichung "usually falls around 5 percent" | In der Session festgelegte Baseline |
| u/mattemer auf r/callcentres | Innerhalb von 3 %, manche Elemente 100 % | Von der Gruppe vereinbarter Score |
| MaestroQA | Abstimmungs-Score pro Bewerter, keine feste Schwelle | Score des finalen Kalibrierers |
| Scorebuddy | % übereinstimmender Antworten, plus Avg Variation | Der ursprüngliche Score, der neu bewertet wird |
| Zendesk QA AutoQA | Über 75 % Genauigkeit gilt als „hohe Übereinstimmung“ | Scores menschlicher Reviewer |
Meine Einschätzung: Strebe an, dass jeder Reviewer beim Gesamtscore etwa 5 Punkte von der Baseline entfernt oder näher liegt, und dass es keine Kategorie gibt, in der Reviewer auf einer 5-Punkte-Skala 2 oder mehr Punkte auseinanderliegen. Ergänze dann die Regel aus dem r/callcentres-Zitat oben: Manche Punkte müssen 100 % sein. Eine verpasste Identitätsprüfung oder ein falscher Erstattungsbetrag ist keine Geschmackssache. Markiere sie in der Scorecard als kritische oder Auto-Fail-Punkte (mein Leitfaden zu Scorecard-Kriterien zeigt, wie das in Zendesk QA geht), damit sie nie zu einem Teil-Score „kalibriert“ werden.
Achte auch auf die Gesamtzahl. Zwei Reviewer können beide bei 80 % insgesamt landen und sich dabei in drei Kategorien uneinig sein, einer hoch, wo der andere niedrig liegt. Vergleiche immer pro Kategorie, nicht nur den Gesamtscore.
Wie oft solltest du kalibrieren?
Die ehrliche Antwort lautet „öfter, als du es jetzt tust“. Das empfehlen Anbieter und Praktiker:
- Neues QA-Programm oder neue Scorecard: Laut MaestroQAs Leitfaden kalibrieren Teams "as frequently as once a week", wechseln zu monatlich, sobald die Abstimmung hoch ist, und erhöhen wieder, wenn eine neue Rubrik startet.
- Normalbetrieb: Laut Zendesks Leitfaden passen monatliche Sessions für die meisten Teams, und "the more reviewers you have, the more often you should calibrate."
- Große QA-Teams: Ein ehemaliger QA-Manager auf r/callcentres hielt "a weekly calibration call so that everyone was on the same page" neben 5 Audits pro Mitarbeiter und Monat.
Ein einzelner QA-Analyst auf r/talesfromcallcenters beschrieb die Kehrseite, bei der der Reviewer selbst bewertet wird:
"I was the lone QA agent for a call center of 55-70 people. We had a calibration session each week which involved the call center manager, the management staff, and myself. They chose ten calls that I had evaluated to listen to and score... I was held to a 95% accuracy rating which compared to the average of their call scores."
Ich würde einen Auslöser ergänzen, der in keinem Kalender steht: Kalibriere nach allem, was verändert, was „richtig“ bedeutet. Eine Preisänderung, eine neue Retourenrichtlinie, ein neuer Eskalationsweg. Dann driften Reviewer am schnellsten, weil manche von der Änderung wissen und andere nicht. Auch wenn ein neuer Reviewer dazukommt, lohnt sich eine Session, so wie du die Einarbeitungszeit eines Agenten mit Praxisbeispielen verkürzen würdest, bevor seine Scores in irgendjemandes Support-KPIs einfließen.
QA-Kalibrierungsfunktionen im Vergleich
Die meisten spezialisierten QA-Tools haben irgendeine Kalibrierungsfunktion. Sie unterscheiden sich darin, ob blind bewertet wird, woran die „richtige Antwort“ gemessen wird und was du danach siehst.
| Tool | Funktion | Blind-Bewertung | Gemessen an | Sehen Agenten es? |
|---|---|---|---|---|
| Zendesk QA | Kalibrierungs-Sessions, Reviewer QA | Pro Rolle konfigurierbar | Von einem Manager festgelegtes Baseline-Review | Nein |
| MaestroQA (jetzt Rippit) | Team Calibration, Grade-the-Grader | Ja, Bewerter sehen nur ihren eigenen Score und den finalen | Finaler Kalibrierer, Abstimmungs-Score | Nicht dokumentiert |
| Scorebuddy | Kalibrierungslisten | Nicht dokumentiert | Ursprünglicher Score, der neu bewertet wird | Optionaler Schalter pro Liste |
| evaluagent | Kalibrierungs-Sessions, Check-the-Checker | Ja, "blind evaluate" | Vereinbartes "calibrated outcome" | Nicht dokumentiert |
| Playvox (NICE) | Kalibrierung | Nicht dokumentiert | "Expert opinions" | Nicht dokumentiert |
| Level AI | Kalibrierung | Nicht dokumentiert | Auditor-Benchmark | Nicht dokumentiert |
Ein paar Details, die du vor der Auswahl kennen solltest:
Zendesk QA braucht das Add-on für QA oder Workforce Engagement Management. Bei jedem Suite-Plan steht bei Quality Assurance "Requires QA add-on", und das Workforce Engagement Bundle kostet 50 $ pro Agent und Monat, jährlich abgerechnet. Die Kalibrierung ist darüber hinaus nicht an einen höheren Tarif gebunden. Eine Einschränkung: Das Kalibrierungs-Dashboard listet Gespräche und deren Reviews auf, und ein Kundenkommentar zum Einrichtungsartikel merkt an, die Daten ließen sich "can only be downloaded conversation by conversation." Wenn du den Verlauf eines Reviewers über viele Sessions willst, plane, ihn in eine Tabelle zu ziehen, oder nutze das Reviewer-QA-Dashboard.
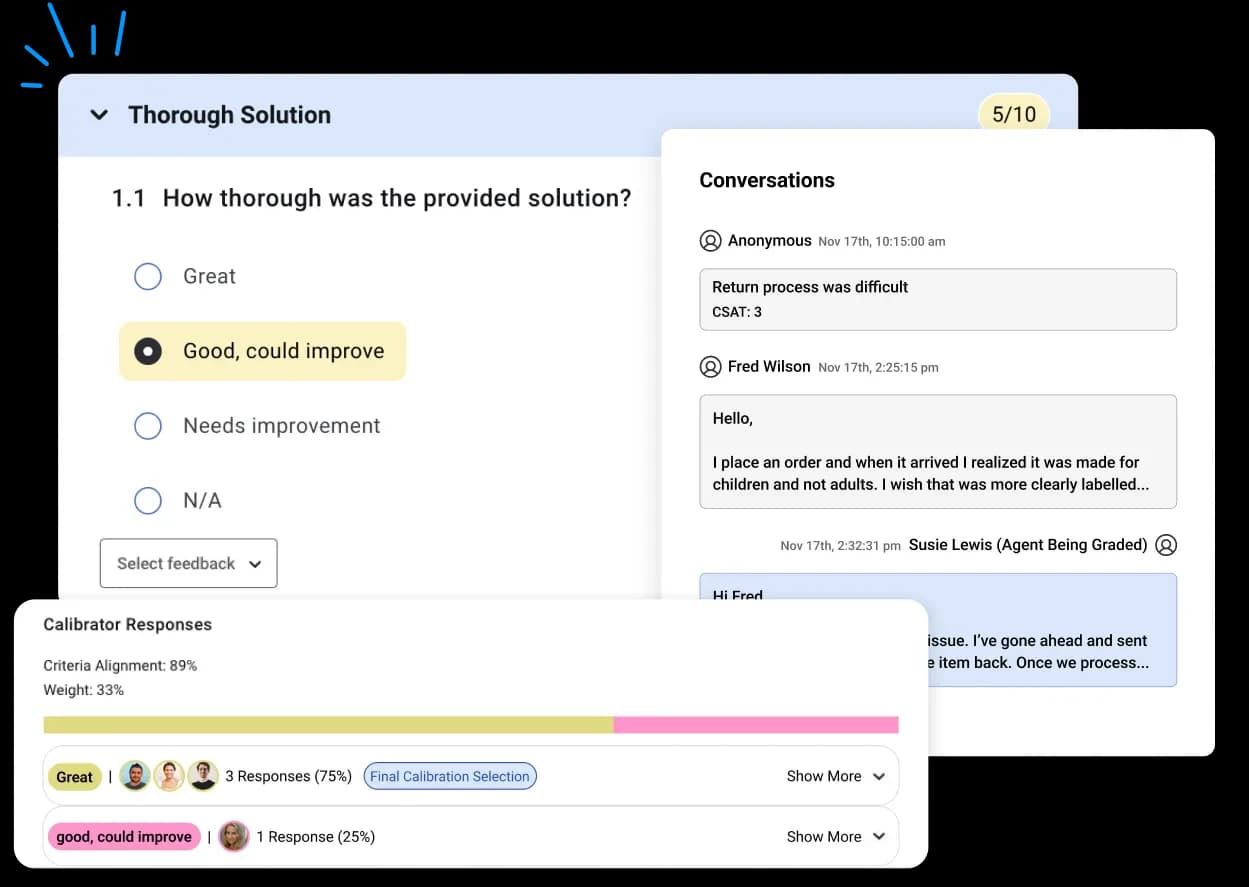
MaestroQA, jetzt unter dem Namen Rippit, trennt zwei Aufgaben: Live-Team-Kalibrierung und Grade-the-Grader, bei dem ein Benchmark-Bewerter Tickets blind neu bewertet, die jemand anderes schon bewertet hat. Die Kalibrierungsansicht zeigt, wie jeder Kalibrierer jede Frage beantwortet hat, mit einem Prozentwert "Criteria Alignment".
Scorebuddy baut die Kalibrierung aus vorhandenen bewerteten Ergebnissen auf: Du fügst sie einer Kalibrierungsliste hinzu und weist sie Nutzern zu, auch externen, was praktisch ist, wenn du einen Teil deines Supports auslagerst an einen BPO-Partner. Das Glossar definiert Avg Variation als "the average of all differences between a set of Calibration's numerical scores, and the numerical scores of the original Scores." Das Kalibrierungsmodul steckt im Einstiegsplan Foundation, die Preise gibt es aber nur über "Request a price."
Wenn du QA direkt im Helpdesk betreibst, prüfe, was sie tatsächlich abdeckt. Ich führe eine längere Liste von KI-QA-Tools, falls du dich umschaust. Gorgias bietet Auto QA, das Gespräche automatisch bewertet, aber in seiner Dokumentation habe ich keinen Kalibrierungs-Workflow für menschliche Reviewer gefunden. Dasselbe gilt für Freshdesk und Front in der von mir durchsuchten Dokumentation. Wenn dein Helpdesk das nicht hat, erledigt eine gemeinsame Tabelle mit dem Raster aus Schritt 3 den Job für ein Team aus drei bis fünf Reviewern problemlos.
KI-Bewerter und KI-Agenten kalibrieren
Immer mehr Teams lassen KI 100 % der Gespräche bewerten, wobei Menschen eine Stichprobe prüfen. Das macht Kalibrierung nicht überflüssig. Es kommt ein weiterer Reviewer dazu, der kalibriert werden muss, und zwar der, der die meisten Tickets prüft.
Zendesk QA misst das direkt. Das AutoQA-Dashboard hat einen Accuracy score, der "measures the consistency and level of agreement between ratings generated by AutoQA and those provided by human reviewers", wobei über 75 % als hohe Übereinstimmung zählen. Es erfasst außerdem Modified AutoQA conversations, bei denen ein Mensch den Score der KI in mindestens einer Kategorie geändert hat. Diese Liste ist deine Kalibrierungs-Agenda für die KI, und sie ist der schnellste Weg, Support-QA mit KI zu betreiben, ohne ihr blind zu vertrauen: Wenn Menschen immer wieder dieselbe Kategorie überstimmen, sind sich KI-Bewerter und deine Rubrik uneins, und eines von beiden muss korrigiert werden. AutoQA-Scores bleiben außerdem außerhalb des IQS des Agenten, sodass die KI den Score eines Agenten nicht heimlich allein verschieben kann.
Agenten merken es, wenn es niemand tut:
"My company uses AI to score calls, too. You can have a great call, but if it doesn't pick up on certain keywords you get a lousy score for it"
Behandle den KI-Bewerter wie einen neuen Reviewer im Team. Nimm ein paar von AutoQA bewertete Gespräche in deine Kalibrierungs-Session auf, bewerte sie blind parallel und sieh, wo er landet. Mein Leitfaden zu KI-Support-QA behandelt den Rest dieses Setups, und kann KI Support-QA ist ehrlich darüber, wo sie noch zu kurz greift.
Dieselbe Logik gilt, wenn der Agent eine KI ist. Wenn ein KI-Agent Tickets beantwortet, müssen sich deine Reviewer vorher einigen, wie sie seine Antworten bewerten, sonst bekommst du das Problem 88 % gegen 12 % von vorhin, dieselbe Lücke, die entsteht, wenn Teams über die KI-Lösungsquote streiten: Ein Reviewer wertet eine Antwort als bestanden, weil sie inhaltlich stimmt, ein anderer als durchgefallen, weil sie drei Absätze zu lang ist. Einigt euch zuerst auf die Messlatte, dann bewertet. Eine schriftlich festgehaltene Markenstimme für die KI macht die Ton-Kategorie viel leichter kalibrierbar. Mein Beitrag über KI-Agenten in Zendesk QA zeigt, wie du Bot-Gespräche bewertest.
Häufige Fehler bei der QA-Kalibrierung
- Gemeinsam im Raum bewerten. Du verlierst das Einzige, was du messen wolltest, die ursprüngliche Uneinigkeit. Bewerte immer zuerst blind.
- Nur einfache Tickets kalibrieren. Wenn jede Session in Einigkeit endet, wählst du die falschen Gespräche aus.
- Den Durchschnitt für die Antwort halten. Dass drei Personen 4 sagen, macht 4 nicht richtig. Jemand verantwortet die Entscheidung.
- Keine schriftliche Nachbereitung. Wenn die Entscheidung nicht in die Scorecard-Hinweise gelangt, führst du nächsten Monat dieselbe Diskussion.
- Nur Gesamtscores vergleichen. Zwei Reviewer können beide 80 % vergeben und sich bei der Hälfte der Kategorien uneinig sein.
- Den KI-Bewerter nie kalibrieren. Er prüft mehr Tickets als jeder andere im Team. Er braucht einen Platz in der Session.
- Ohne die Einsprüche der Agenten arbeiten. Angefochtene Reviews sind kostenloses Kalibrierungsmaterial. Das Disputes-Dashboard von Zendesk QA hat sogar eine Tabelle "Disputed reviewers", die "shows which reviewers may need additional help with consistency and accuracy." Nutze sie bei der Auswahl der Gespräche, und in meinem Beitrag zum Zendesk-QA-Agent-Feedback siehst du, wie Einsprüche zu den Agenten zurückfließen.
Probier eesel für KI-Antworten, denen dein QA-Team vertrauen kann
Wenn du KI in deine Support-Warteschlange bringst, stellt sich die Kalibrierungsfrage am ersten Tag: Wie bewerten deine Reviewer, was sie schreibt? Der KI-Helpdesk-Teammate von eesel schließt sich deiner bestehenden Zendesk-, Freshdesk-, Gorgias- oder Help-Scout-Warteschlange an und lässt dein Team das klären, bevor er live geht. Er spielt echte vergangene Tickets nach, damit Reviewer seine Antworten mit dem vergleichen können, was deine Agenten tatsächlich gesendet haben, er startet als Entwurf in internen Notizen, und jeder Durchlauf zeigt die Quellen und die Begründung hinter der Antwort. Wenn ein Reviewer ihn korrigiert, wird die Korrektur zu einer dauerhaften Anweisung, sodass dieselbe Entscheidung für jedes künftige Ticket gilt. Du kannst es mit 100 Credits kostenlos testen, und kostenpflichtige Pläne beginnen bei 299 $ im Monat auf der eesel-Preisseite.
