

Warum QA im mehrsprachigen Support unbemerkt scheitert
Die meisten Support-QA-Programme sind auf Englisch gebaut und werden dann gedehnt. Die Scorecard wird kopiert, der Prüferpool bleibt gleich, und jemand aktiviert eine Übersetzen-Schaltfläche, damit die englischsprachigen Prüfer die deutsche Queue „lesen“ können. Die Scores sehen gut aus. Das ist das Problem.
Ich habe gesehen, wie das von innen schiefgeht. eesel betreibt seit Jahren KI in Live-Helpdesks auf Deutsch, Niederländisch, Französisch, Spanisch, Rumänisch und mehr, und der schlimmste mehrsprachige Fehler, den eesel ausgeliefert hat, war keine schlechte Übersetzung. Anfang 2026 gingen deutsche und niederländische Entwurfsantworten mit rohen Platzhaltern wie {{ticket.requester.first_name}} und [Employee Name] raus, in belgischen, deutschen und niederländischen Helpdesks. Ein Grammatikprüfer hätte diese Entwürfe gut bewertet. Ein Muttersprachler, der die Antwort einmal liest, hätte es in zwei Sekunden bemerkt.
Das ist das Muster. Die Fehler, die in einer Zweitsprache zählen, sind meist keine Rechtschreibfehler.
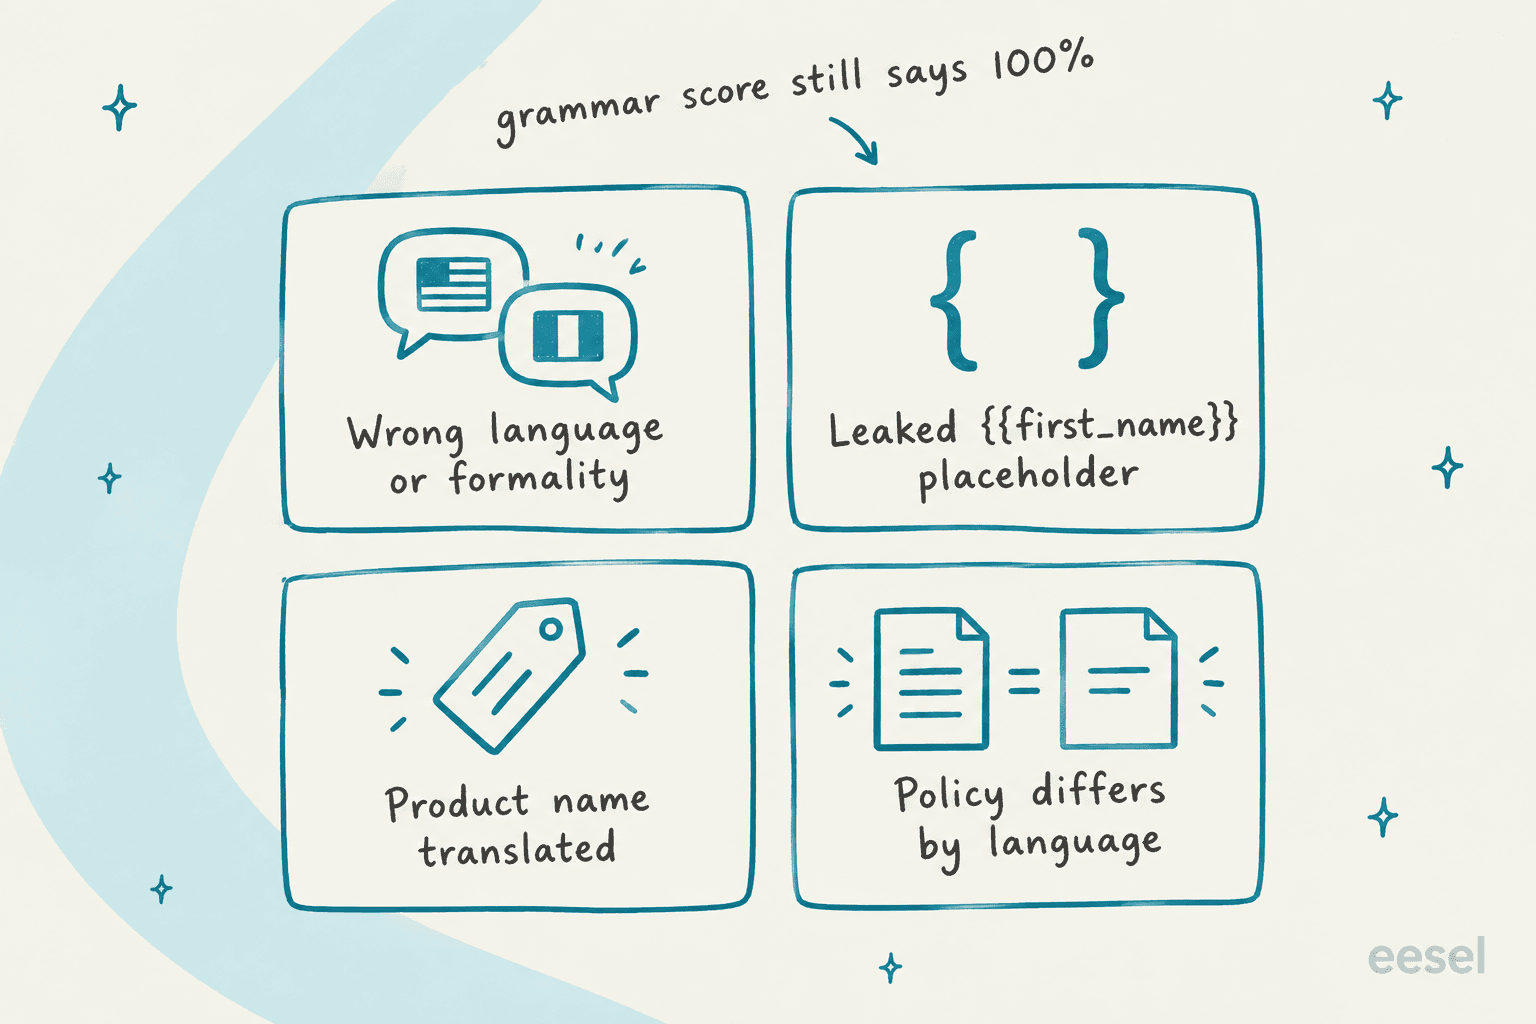
Das rutscht durch, wenn nicht englische QA nur englische QA mit einer Übersetzen-Schaltfläche ist:
- Register und Anredeform. Deutsch du gegenüber Sie, Französisch tu gegenüber vous, japanische Höflichkeitsstufen. Maschinelle Übersetzung glättet das, sodass ein Prüfer, der die englische Version liest, nie sieht, dass der Agent einen 60-jährigen B2B-Kunden wie einen Teenager angesprochen hat.
- Mechanik-Lecks. Platzhalter, englische Fragmente in einem Makro, ein englischer Gruß unter einer spanischen Antwort. Das wirkt wie „hier spricht niemand meine Sprache“.
- Terminologie. Dein Produktname, übersetzt in ein Alltagswort, oder drei verschiedene Wörter für dieselbe Funktion in einer Antwort. Ich habe einen ganzen Leitfaden zu Support-Übersetzungsglossaren geschrieben, weil heute kein Helpdesk ein Glossar auf Ticketebene mitliefert.
- Richtlinien-Drift. Das englische Makro sagt 30 Tage Rückgabe, das französische Makro wurde vor zwei Jahren übersetzt und sagt immer noch 14. Jede Antwort ist grammatikalisch perfekt, und eine davon ist falsch.
Was du in einer nicht englischen Antwort bewertest
Nutze eine Scorecard für alle Sprachen. Eine „deutsche Scorecard“ und eine „englische Scorecard“ zu trennen, ist der Weg, auf dem Scores nicht mehr vergleichbar werden. Was sich pro Sprache ändert, ist, wer jede Zeile bewerten kann und wie die Beispiele aussehen.
Ich teile die Kategorien nach einer Frage: Übersteht das die Übersetzung? Wenn ein Prüfer, der eine maschinelle Übersetzung liest, es zuverlässig bewerten kann, kann es jeder geschulte Prüfer bewerten. Wenn das Signal im Originalwortlaut steckt, sollte nur jemand bewerten, der die Sprache liest.
| Scorecard-Zeile | Was sie prüft | Aus einer Übersetzung sicher bewertbar? |
|---|---|---|
| Lösung und Genauigkeit | Richtige Antwort, richtige Richtlinie, richtiger nächster Schritt | Ja, wenn die Übersetzung treu ist |
| Prozess | Korrekt getaggt, verlinkt, eskaliert | Ja |
| Verständnis | Hat der Agent die eigentliche Frage verstanden | Meistens |
| Sprachübereinstimmung | In der Sprache des Kunden geantwortet, keine englischen Fragmente | Teilweise (braucht die Originalansicht) |
| Rechtschreibung und Grammatik | Mechanik in der Originalsprache | Nein |
| Anredeform und Ton | Sie vs. du, Höflichkeitsstufe, Wärme | Nein |
| Terminologie | Produktnamen unverändert, freigegebene Begriffe verwendet | Nein |
| Platzhalter und Lecks | Keine {{ }}-Tokens, keine internen Notizen, kein Gruß in der falschen Sprache | Ja, aber nur im Original |
Die vier „Nein“-Zeilen sind der Ort, an den deine Stunden für muttersprachliche Prüfung gehören. Alles andere können deine vorhandenen Prüfer mit einer Übersetzung bewerten, was das Programm bezahlbar hält. Für das allgemeine Raster hinter diesen Zeilen schlüsselt mein Leitfaden zur Sprachqualität im Kundensupport Grammatik, Klarheit und Ton auf, und der Leitfaden zum Ton im Kundenservice zeigt, wie du Tonregeln schreibst, an denen sich wirklich bewerten lässt.
Eine weitere Regel für die Scorecard: Mach „Richtlinie weicht von der englischen Quelle ab“ zu einem kritischen Fehler. MQM, das Framework, mit dem professionelle Übersetzungsteams Qualität bewerten, behandelt einen einzigen kritischen Fehler als automatisches Nichtbestehen, egal wie gut der Rest ist (MQM values and scores). Support-QA sollte das übernehmen. Eine schön geschriebene falsche Erstattungsrichtlinie bleibt eine falsche Erstattungsrichtlinie.
Übernimm die Fehlertypen, die Übersetzer schon nutzen
Du musst keine Kategorien erfinden. MQM sortiert Übersetzungsfehler in sieben Gruppen: Terminologie, Genauigkeit, sprachliche Konventionen, Stil, lokale Konventionen, Zielgruppenangemessenheit sowie Design und Markup (MQM error typology). Die Standardstrafen sind 0 für neutral, 1 für gering, 5 für schwer und 25 für kritisch (MQM values and scores). ISO 5060:2024 ist der formale Standard, der auf demselben Ansatz aus Fehlertyp und Strafpunkten beruht.
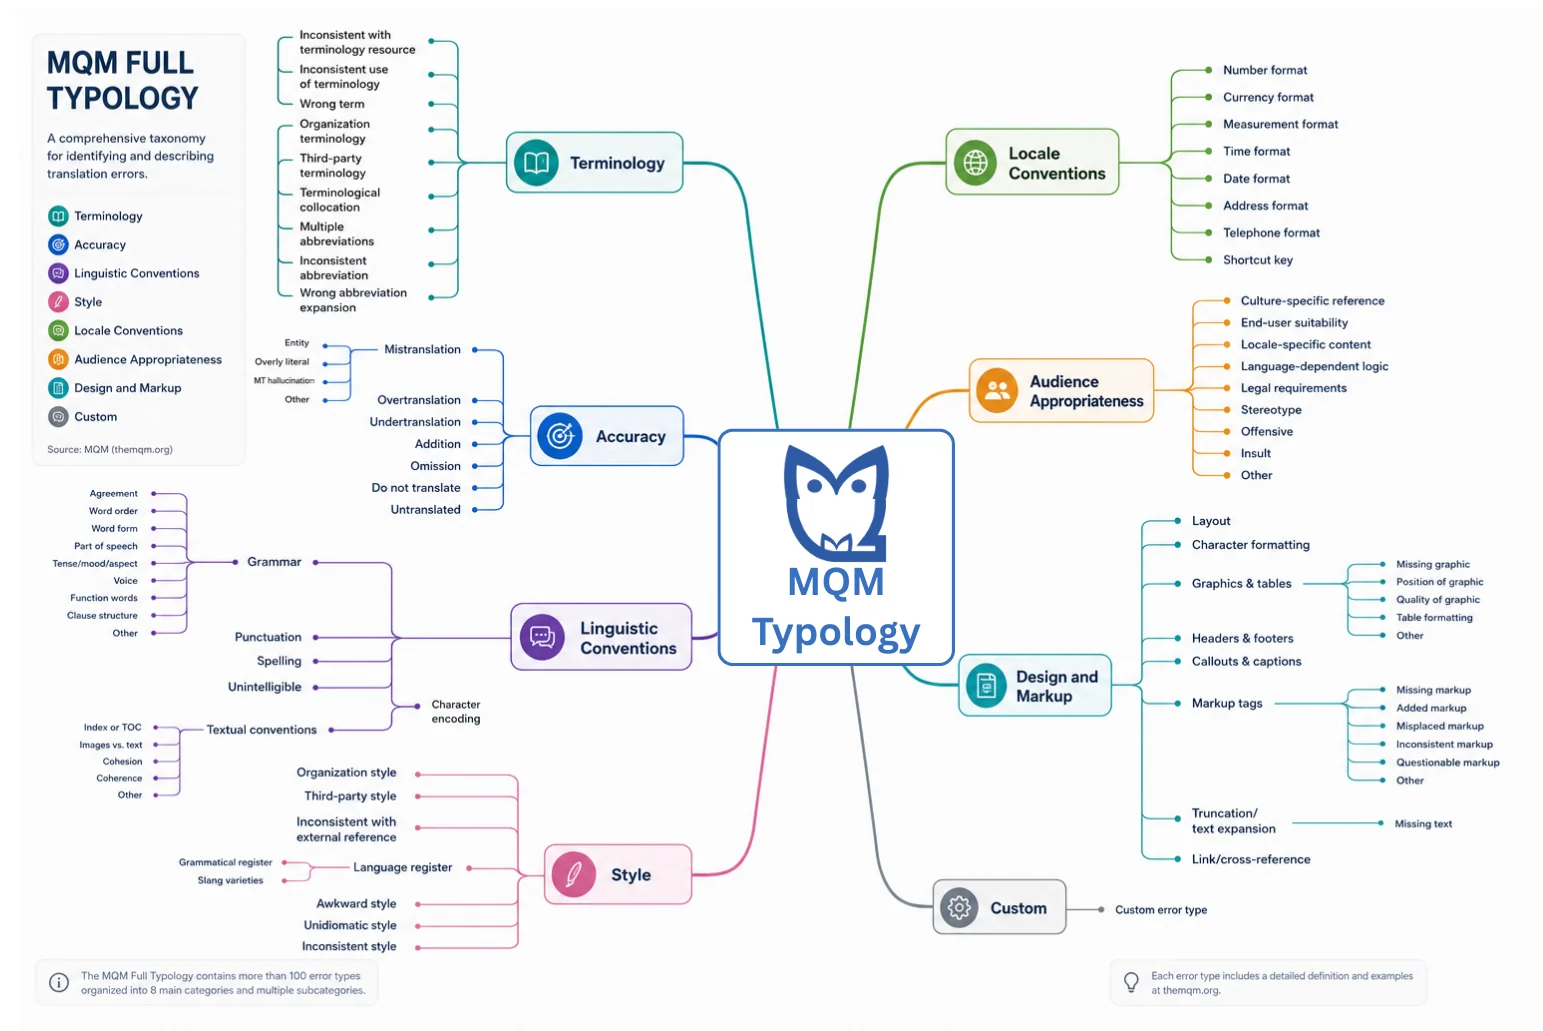
Zwei Zweige passen gut auf die Support-Arbeit. „Lokale Konventionen“ umfasst Datums-, Währungs-, Zahlen- und Adressformate, genau dort, wo ein in den USA geschulter Agent 10/05 an einen deutschen Kunden schreibt, der es als 10. Mai liest. „Design und Markup“ umfasst fehlendes oder kaputtes Markup, zu dieser Familie gehört das Platzhalter-Leck. Ich würde kein volles MQM-Scoring auf Support-Tickets anwenden (es ist für übersetzte Dokumente gebaut und zählt Fehler pro 1.000 Wörter), aber seine Kategorienamen als Fehler-Tags zu nutzen, macht deine QA-Daten deutlich besser verwertbar.
So samplst du Tickets, wenn eine Sprache 84 % des Volumens ausmacht
Zufallsstichproben sind fair über Tickets und unfair über Sprachen. Wenn Englisch 84 % deines Volumens ist, Deutsch 12 % und Niederländisch 4 %, landen bei zufälligen 50 Reviews pro Woche 42 auf Englisch, 6 auf Deutsch und 2 auf Niederländisch. Zwei Reviews können dir nicht sagen, ob dein niederländischer Agent eine Angewohnheit hat oder einen schlechten Dienstag. Telefonteams haben dasselbe Problem, weshalb Call-Center-QA-Programme meist ebenfalls geschichtet samplen.
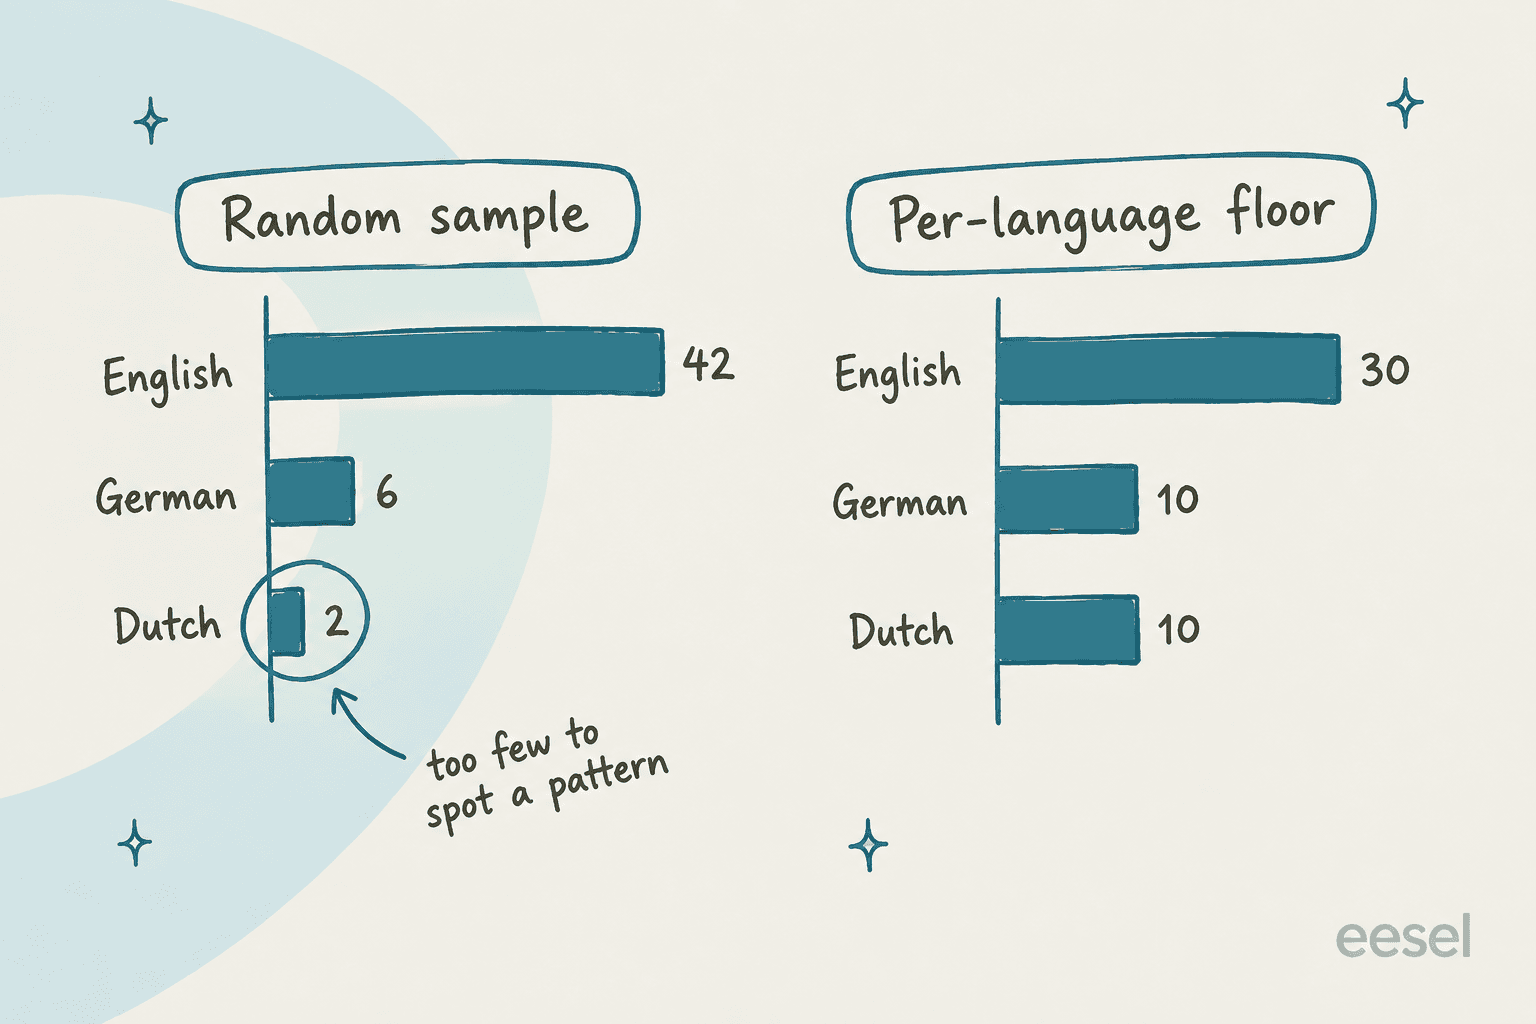
Die Lösung ist eine Untergrenze: Jede Sprache bekommt mindestens N Reviews pro Woche, und was vom Budget übrig bleibt, geht im Verhältnis zum Volumen an die großen Sprachen. Mit einer Untergrenze von 10 werden aus denselben 50 Reviews 30 englische, 10 deutsche und 10 niederländische. Englisch bekommt weiterhin die meiste Aufmerksamkeit. Niederländisch bekommt endlich genug, um ein Muster zu sehen.
Setze hier deine eigenen Zahlen ein:
Eine Untergrenze von etwa 10 pro Sprache und Woche ist die kleinste Zahl, bei der ich einem Trend vertrauen würde. Wenn dein Budget das nicht für jede Sprache abdeckt, prüfe die kleinen Sprachen lieber alle zwei Wochen mit 20 statt jede Woche mit 5. Weniger, größere Batches schlagen ein Rinnsal.
Zwei Filter machen das Sample klüger, nicht nur größer:
- Neue Agenten und neue Sprachen übergewichten. Im ersten Monat eines neuen Marktes oder einer neuen Einstellung sind Fehler am günstigsten zu beheben. Mein Leitfaden zum Onboarding von Support-Agenten behandelt, wie du die Prüfung für Neueinsteiger vorziehst.
- Niedriges CSAT in kleinen Sprachen übergewichten. Ein verärgerter niederländischer Kunde ist 1 von 25 niederländischen Tickets, nicht 1 von 625 insgesamt. Zieh diese jedes Mal heraus. KI-CSAT-Tools können sie automatisch hervorheben.
Wer was prüft: Muttersprachler gegenüber Prüfung per Übersetzung
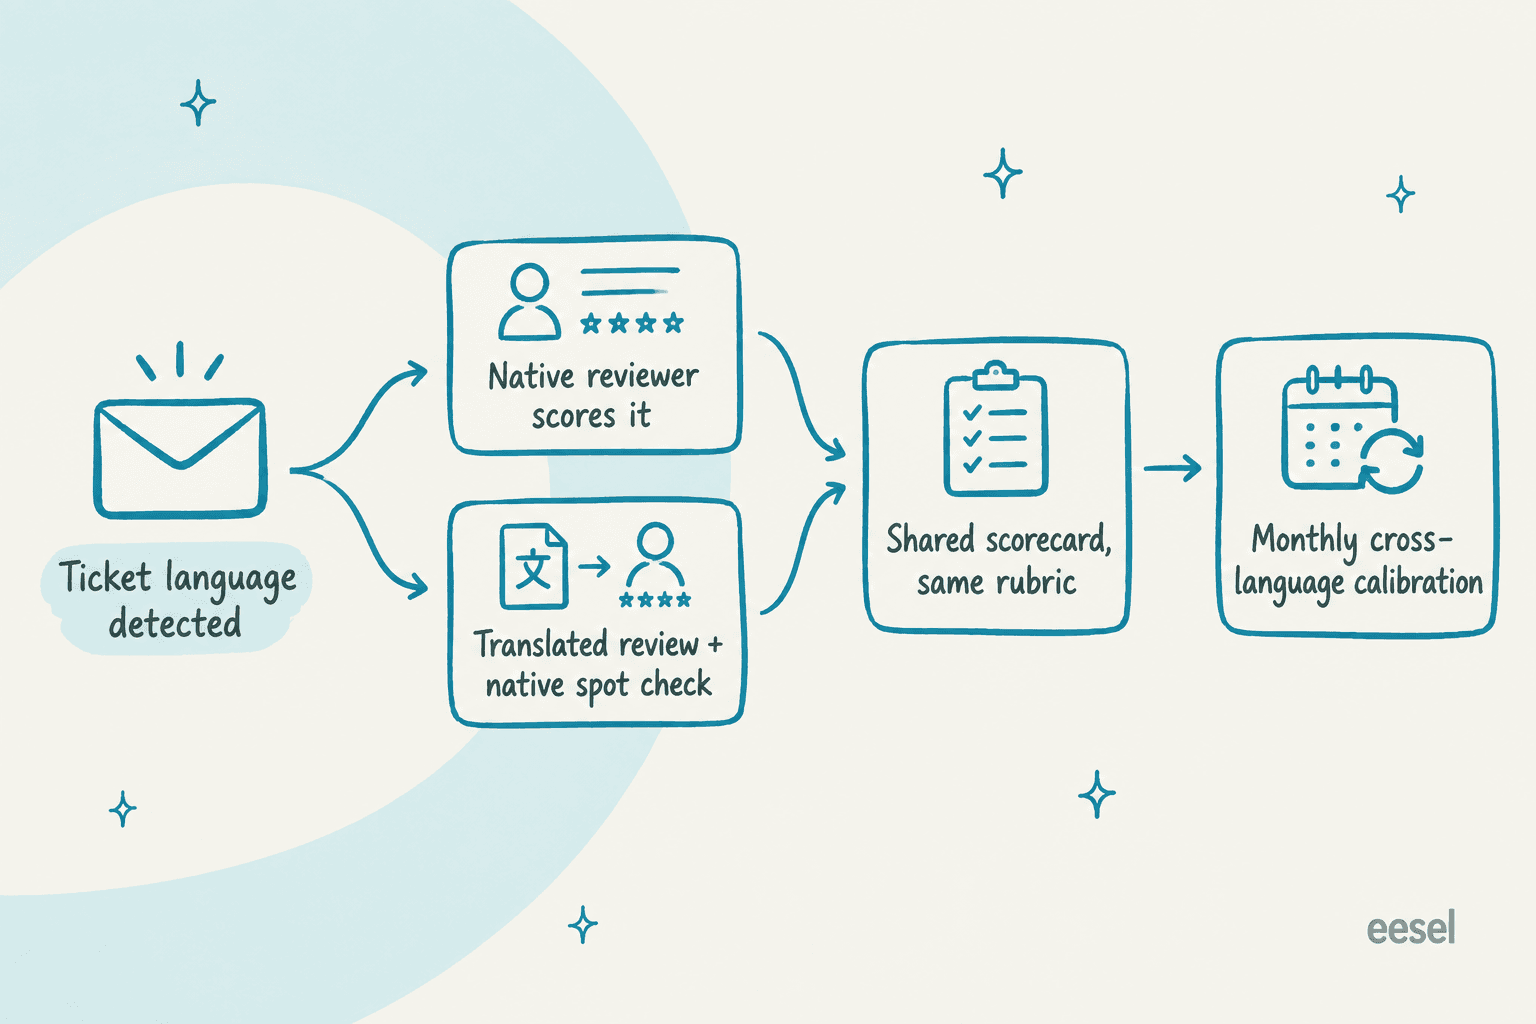
Es gibt drei Wege, nicht englische QA zu besetzen, und die meisten Teams nutzen am Ende alle drei.
1. Muttersprachliche Prüfer in jeder Sprache. Der Goldstandard und der teuerste. Meist ein erfahrener Agent im jeweiligen Sprachteam mit ein paar Stunden Prüfzeit pro Woche. Bei Offshore-Teams ist das oft die Teamleitung am jeweiligen Standort. Sie verantworten die vier „Nein“-Zeilen der Scorecard.
2. Prüfung per Übersetzung durch dein zentrales QA-Team. Deine vorhandenen Prüfer bewerten Lösung, Prozess und Verständnis über eine Übersetzung im Tool. Günstig, und es hält ein Augenpaar auf der Genauigkeit in jedem Markt. Teams mit Follow-the-Sun-Support setzen am stärksten darauf.
3. Muttersprachliche Stichproben auf übersetzte Reviews. Einmal im Monat bewertet ein Muttersprachler eine Handvoll Gespräche neu, die das Kernteam schon per Übersetzung bewertet hat. Wenn die Scores auseinanderlaufen, übersieht die Prüfung per Übersetzung etwas, und du verlagerst mehr Volumen auf Option 1. Hier findest du auch Wissenslücken, die nur in einer Sprache existieren.
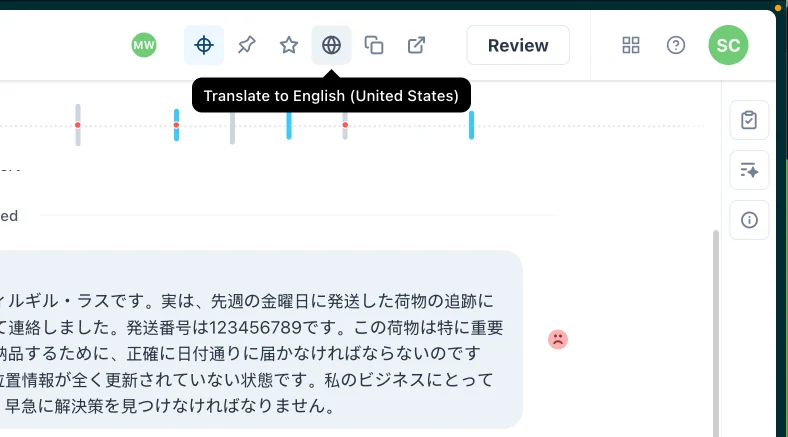
Das Routing ist der Teil, den Tools inzwischen gut beherrschen. In Zendesk QA können Prüfer ein Gespräch per Klick auf ein Globus-Symbol in ihre Profilsprache übersetzen und zum Original zurückschalten (Using the Conversations view). Das deckt 29 Hauptsprachen ab, und Arabisch, Hebräisch und Ukrainisch stehen nicht auf der QA-Liste, obwohl die Live-Übersetzung von Support sie abdeckt (Zendesk language support by product).
Fürs Routing hat Zendesk QA einen Gesprächsfilter Language (AI) mit den Bedingungen „ist“ / „ist nicht“ (conversation filter types), und Gruppen können Prüfer „nach Merkmalen wie der Sprache“ für Zuweisungen organisieren (groups in Zendesk QA). Einen einzelnen Schalter „N pro Sprache samplen“ habe ich nicht gefunden. Die Untergrenze baust du, indem du pro Sprache eine Zuweisung mit einer Language-(AI)-Bedingung und einer festen Anzahl anlegst.
Eine Falle auf der Zendesk-Support-Seite: Das Language-Feld der Intelligent Triage wird aus dem Betreff und dem ersten öffentlichen Kommentar gelesen und „wird nicht bei jeder Antwort des Endnutzers aktualisiert“ (intelligent triage). Ein Kunde, der auf Englisch beginnt und zu Deutsch wechselt, bleibt ein „englisches“ Ticket. Triage-Werte in Workflows zu nutzen, erfordert außerdem das Copilot-Add-on (triage workflows). Mehr zu diesem Setup in meinem Leitfaden zu Zendesk Intelligent Triage.
So sieht es aus, wenn es fehlt. Ein QA-Verantwortlicher im Call Center hat es auf Reddit offen gesagt:
"I was responsible for QA on a team taking Spanish calls. Don't speak a word myself. Yea, plenty of 100's were given."

Perfekte Scores von einem Prüfer, der das Gespräch nicht lesen kann, sind keine Qualitätsdaten. Sie sind ein blinder Fleck mit einer Zahl dran.
Was automatisierte QA in anderen Sprachen bewerten kann und was nicht
Automatisierte QA schließt die Abdeckungslücke, aber ihre Sprachliste ist kürzer, als die meisten Teams annehmen. Hier die AutoQA-Abdeckung von Zendesk QA, die das QA- oder Workforce-Engagement-Add-on voraussetzt (autoscoring categories):
| AutoQA-Kategorie | Sprachen mit aktivierter LLM-Option | Mit ausgeschalteter Option |
|---|---|---|
| Rechtschreibung und Grammatik | 9 Varianten: Englisch (US, UK), Deutsch, Französisch, Polnisch, Spanisch, Portugiesisch (BR, PT), Niederländisch | Dieselben 9 |
| Lesbarkeit | Englisch, Spanisch | Englisch, Spanisch |
| Begrüßung, Abschluss | Alle | 8 Sprachen |
| Ton, Empathie, Verständnis, angebotene Lösung | Alle | Nicht verfügbar |
Lies die erste Zeile noch einmal. Ein italienischer, japanischer oder schwedischer Agent bekommt überhaupt keinen automatischen Rechtschreib- und Grammatik-Score, auch nicht mit aktivierter LLM-Option. Wenn die Hälfte deines Teams in diesen Sprachen schreibt, bewertet dein Dashboard mit „100 % Abdeckung“ sie in allem außer dem, was ein muttersprachlicher Kunde als Erstes bemerkt.
Auch Einstellungen pro Sprache zählen. Rechtschreibausnahmen (bis zu 300) und freigegebene Begrüßungen (bis zu 200) werden jeweils einer Sprache zugeordnet, und „Begrüßungen werden nicht übersetzt“ (customizing AutoQA). Das eigene Beispiel von Zendesk: Gibst du „Bom dia“ für alle Sprachen frei, bekommt ein Agent, der in einem spanischen Gespräch „Buenos días“ schreibt, einen Downvote.
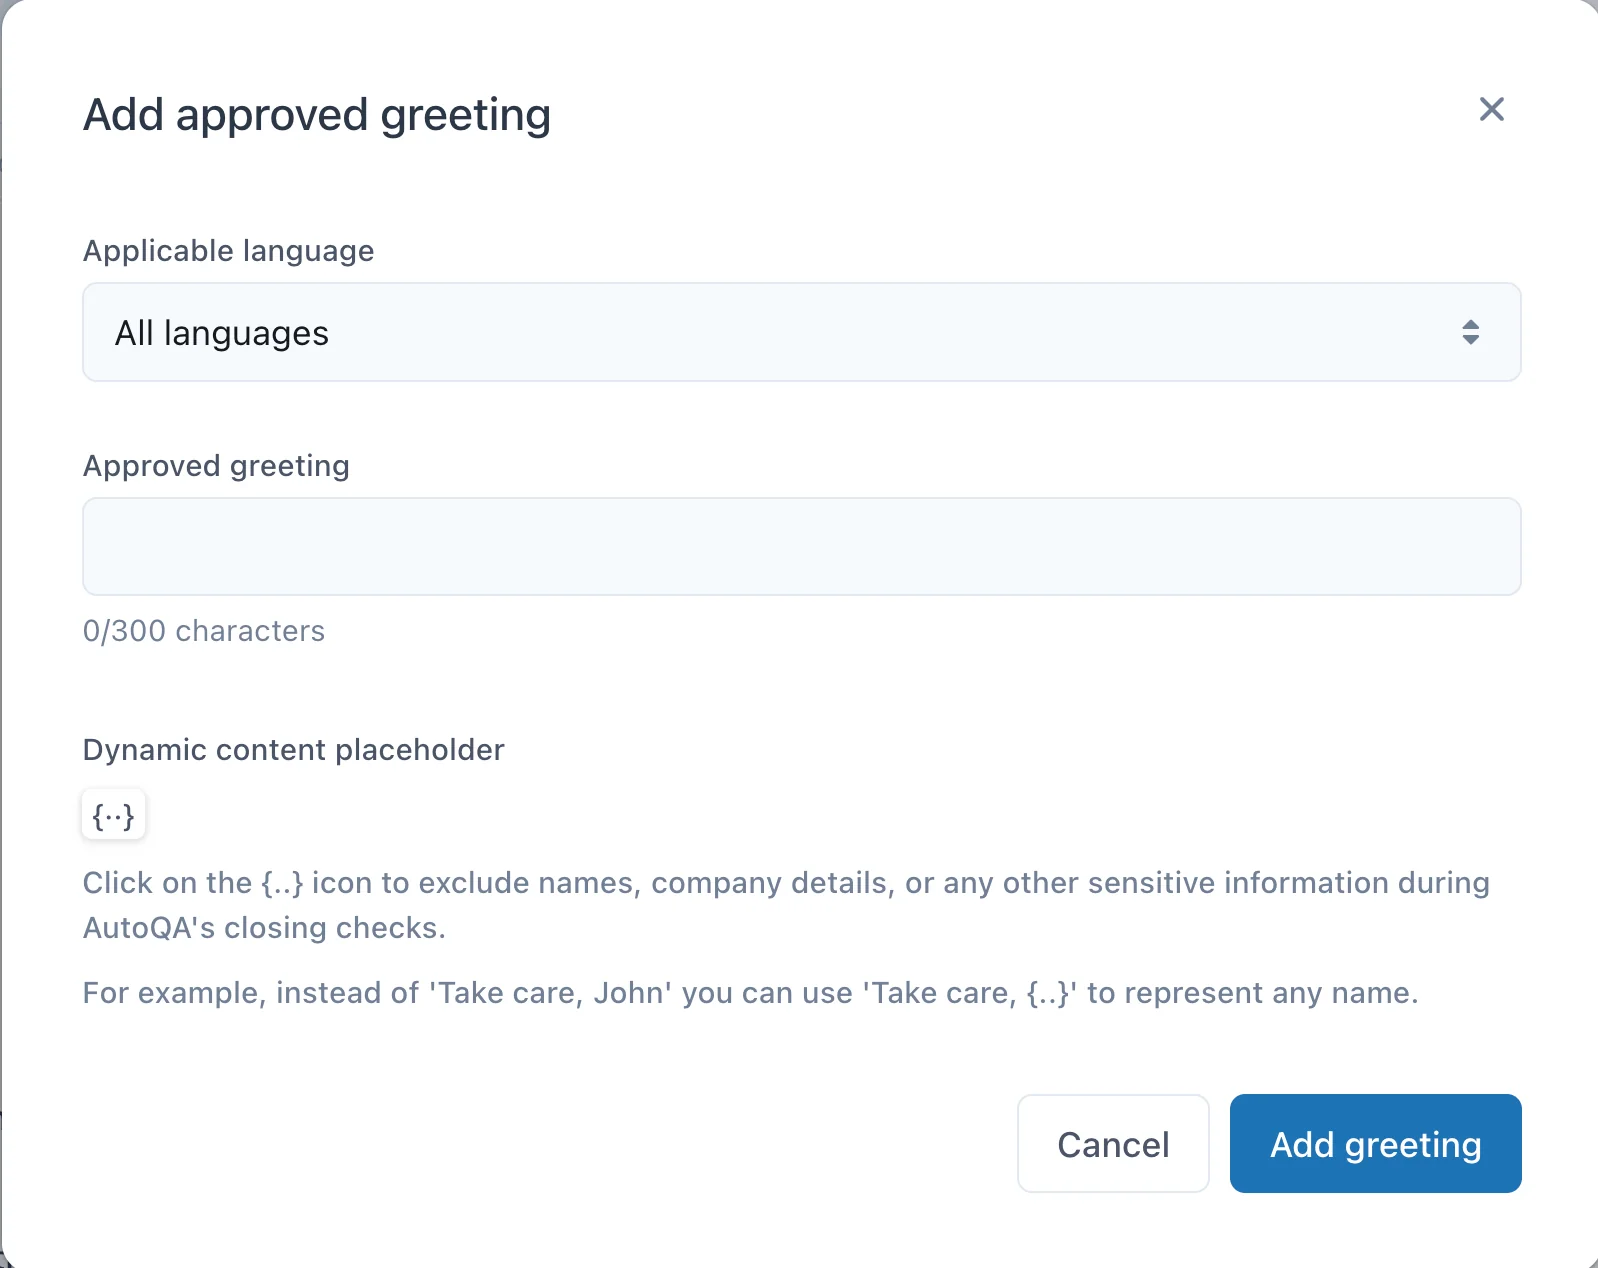
Lege also Begrüßungen und Abschlüsse am ersten Tag pro Sprache fest, sonst bestrafen deine automatischen Scores genau die Agenten, die das Lokalisierte richtig machen. Zendesk sagt außerdem, dass seine automatisierten Bewertungen „nur zur Orientierung“ dienen und Leistungsentscheidungen nicht allein bestimmen sollten (Zendesk QA account settings), was für jede Sprache mit Lücken im Auto-Score die richtige Haltung ist.
Andere QA-Plattformen dokumentieren weniger. evaluagent lässt dich generative KI-QA-Zeilen in deiner eigenen Sprache schreiben und erkennt die gesprochene Sprache bei Anrufen automatisch. Rippit (das umbenannte MaestroQA) bewertet 100 % der Gespräche mit Agenten in Alltagssprache (Rippit announcement), aber ich konnte keine dokumentierten Übersetzungs- oder Sprachfilter-Funktionen finden. Wenn dir Sprachabdeckung wichtig ist, lass dir die Liste schriftlich geben, bevor du kaufst.
Die KI-QA-Tools, die ich verglichen habe, unterscheiden sich hier stark, und meine Übersicht über QA-Tools deckt das weitere Feld ab.
Was dein Helpdesk Prüfern von Haus aus bietet
Das QA-Tool ist nur die halbe Miete. Prüfer arbeiten oft im Helpdesk, und was sie dort sehen können, hängt von der Übersetzungsfunktion ab, die deine Agenten nutzen.
| Helpdesk | Spracherkennung | Übersetzung, die ein Prüfer sehen kann | Tarif oder Limit |
|---|---|---|---|
| Zendesk | Triage-Language-Feld, ~150 Sprachen, nur erste Nachricht | Gesprächsübersetzung in allen Kanälen außer Voice; Übersetzungen eingehender Chats werden nicht gespeichert und beim Neuladen erneut ausgeführt | Ticketübersetzung ab Team+; Triage in Workflows braucht Copilot |
| Freshdesk | Pro Ticket erkannt, Agenten können überschreiben | Live Translate mit „See original“, 43 Sprachen | Pro/Enterprise, 100 übersetzte Tickets pro Copilot-Lizenz und Monat |
| Gorgias | Bis zu 54 Sprachen, nur Nachrichtentext | Übersetzung eingehend und ausgehend, Hover zeigt das Original | Alle Helpdesk-Tarife |
| Front | Automatisch erkannt bei eingehend und ausgehend | Übersetzung bleibt für alle Teammitglieder im Thread sichtbar | Ab Starter, 1.500 Anfragen pro Teammitglied und Tag |
| Help Scout | Für eingehend nicht dokumentiert | AI Assist übersetzt nur ausgehenden Text | Plus/Pro oder kontaktbasierte Tarife |
Zwei Zeilen in dieser Tabelle verursachen echte QA-Kopfschmerzen. Die Übersetzungen eingehender Chats in Zendesk „laufen bei jeder Aktualisierung oder jedem Neuladen eines Tickets erneut, sodass sich die Übersetzungsergebnisse unterscheiden können“ (Zendesk), das Englisch, das ein Prüfer liest, muss also nicht das Englisch sein, das der Agent gesehen hat. Und Freshdesk zählt ein Ticket erneut, wenn ein anderer Agent es übersetzt (Freshdesk), sodass ein QA-Prüfer, der die Übersetzung öffnet, am Monatskontingent der Agenten zehren kann. Lass Prüfer in Freshdesk die Übersetzung des QA-Tools nutzen, nicht die der Agenten.
Tiefere Einblicke pro Tool findest du bei Zendesks nativen Übersetzungsoptionen, Front AI Translate und Freddy AI Copilot.
Wenn du eine Übersetzungsschicht nutzt, lies ihren Qualitätsbericht
Teams mit Unbabel oder Language I/O haben schon ein zweites QA-Signal und ignorieren es oft. Unbabel führt für jede Übersetzung eine Qualitätsschätzung durch und sagt den MQM-Score voraus, den ein menschlicher Prüfer vergeben würde. Die Berichte sortieren Übersetzungen in fünf Bänder, von Best (98 und mehr) bis Weak (unter 60), und ein Sprachpaar verfehlt seine Schwelle, wenn mehr als 10 % im roten Bereich landen (Unbabel quality reporting).
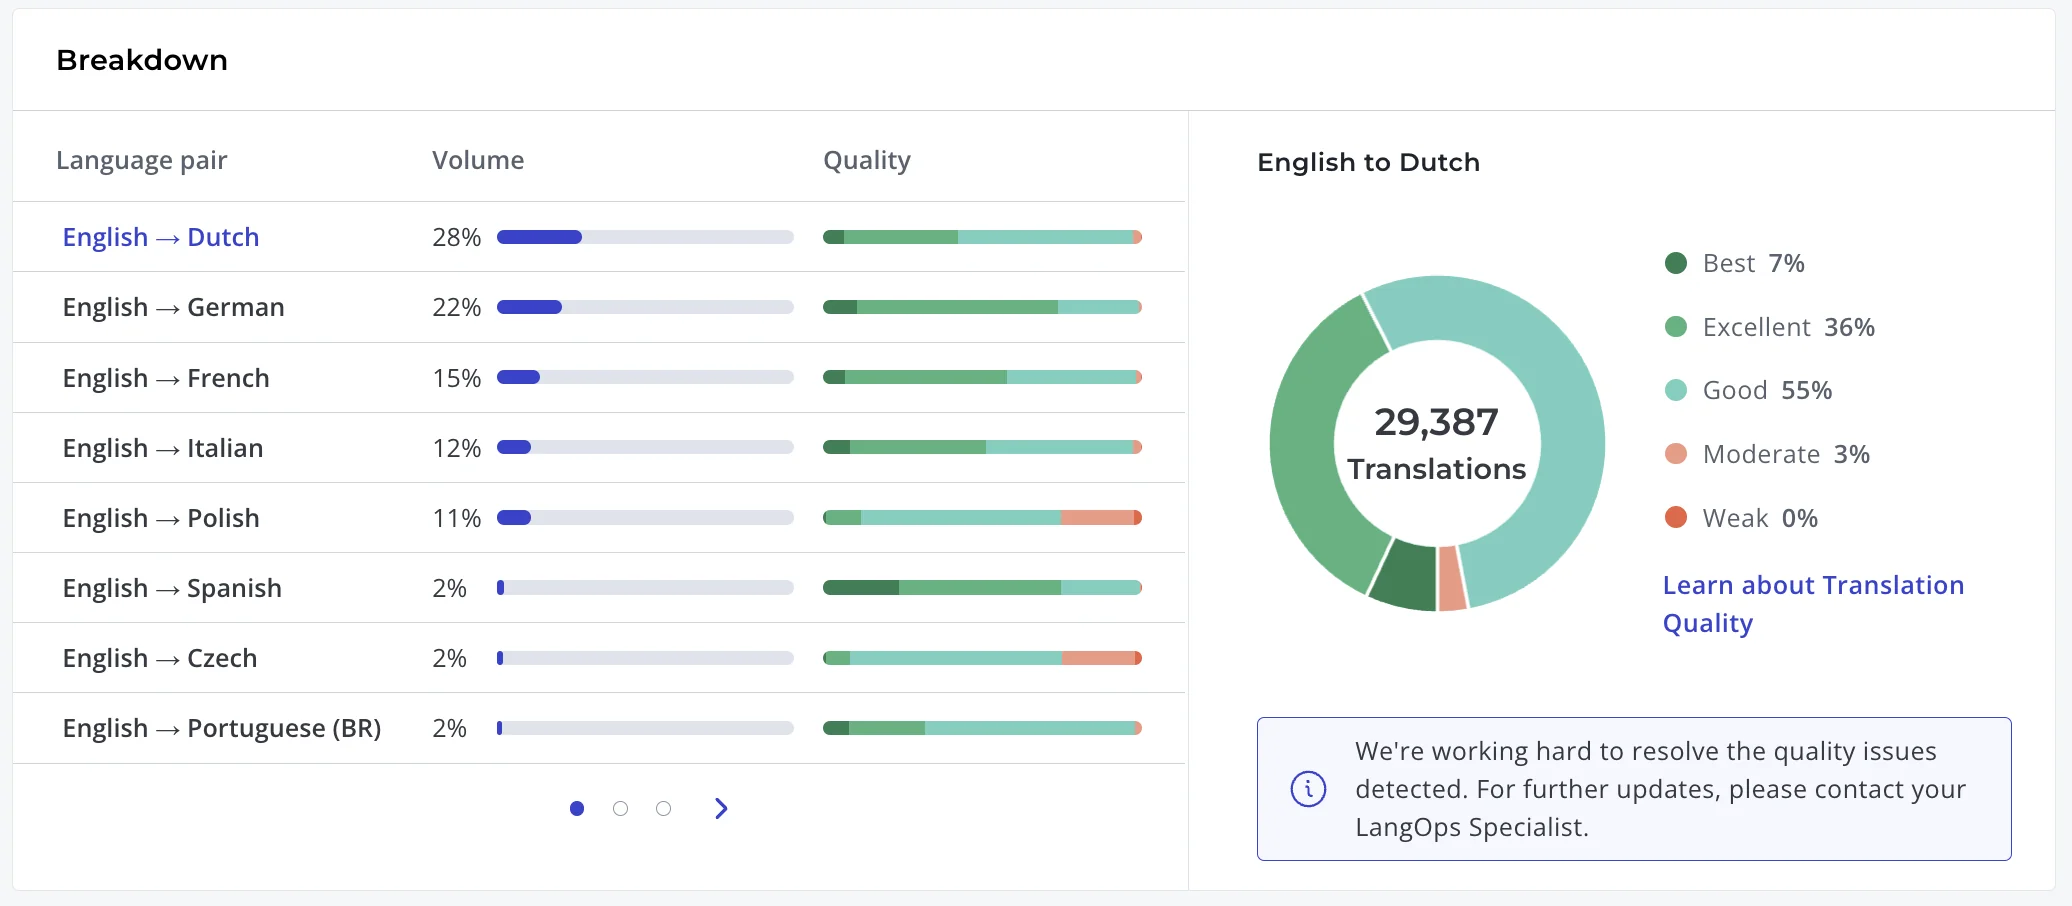
Diese Ansicht pro Sprachpaar ist fürs Sampling nützlich. Wenn Englisch–Polnisch deutlich mehr Moderate-Übersetzungen hat als Englisch–Deutsch, setze nächsten Monat mehr deiner muttersprachlichen Prüfstunden auf Polnisch. Language I/O beschreibt Echtzeit-Qualitätsüberwachung gegen frühere Ergebnisse und Glossarregeln und lässt Agenten eine schlechte Übersetzung markieren und neu erzeugen, veröffentlicht aber keine Bewertungsskala.
Was diese Berichte nicht sagen können: ob die Ausgangsantwort richtig war. Eine perfekte Übersetzung einer falschen Antwort wird mit Best bewertet. Übersetzungsqualität und Supportqualität sind zwei verschiedene Prüfungen, und du brauchst beide.
So kalibrierst du über Sprachteams hinweg
An der Kalibrierung entscheidet sich, ob mehrsprachige QA-Programme zusammenhalten oder in Inseln zerfallen. Das Ziel ist einfach: Eine „4 von 5“ deines spanischen Prüfers muss dasselbe bedeuten wie eine „4“ deines englischen Prüfers.
Was nach meiner Erfahrung funktioniert:
- Wähle jeden Monat 5 bis 8 Gespräche, mindestens eines pro Sprache. Nutze eine Mischung: eine saubere Antwort, eine mit Richtlinienfehler, eine mit Tonproblem.
- Alle bewerten dieselben Gespräche unabhängig voneinander, bei Bedarf per Übersetzung. Muttersprachliche Prüfer bewerten zusätzlich die rein sprachlichen Zeilen ihrer Sprache.
- Vergleiche Scores Zeile für Zeile, nicht die Summen. Eine übereinstimmende Summe kann einen Prüfer verbergen, der beim Ton streng und bei der Genauigkeit locker ist.
- Halte jede geklärte Abweichung als Beispiel im Raster fest und gib wiederkehrende Probleme ins Coaching. „Du bei einem B2B-Kunden = Ton-Fail, siehe Ticket 4821“ ist mehr wert als ein Absatz Definition.
- Verfolge die Streuung pro Sprache über die Zeit. Wenn die Scores eines Sprachteams immer weiter abdriften, braucht dieses Team eine eigene Session.
Der Genauigkeits-Score von Zendesk QA ist hier ein nützliches Vorbild: Er misst die Übereinstimmung zwischen AutoQA und menschlichen Prüfern, und Zendesk wertet alles über 75 % als hohe Übereinstimmung (AutoQA dashboard). Wende dieselbe Idee zwischen deinen menschlichen Prüfern an. Für das Feedback an Agenten behandeln meine Leitfäden zu QA-Feedback-Beispielen und Feedback für Support-Agenten die Formulierungen.
Der umgekehrte Fehler ist genauso häufig: ein nicht englisches Gespräch am englischen Wortlaut zu messen. Ein zweisprachiger Agent beschrieb genau das:
"I got QA-ed that my Spanish questions were not close enough to the English script, deducted 7 points."
Es gab kein spanisches Skript. In Kalibrierungsrunden fällt so eine Regel auf und wird umgeschrieben zu „entspricht der Absicht des Skripts, in natürlichem Spanisch“.
QA für KI-Antworten in anderen Sprachen
Wenn ein KI-Agent Antworten in anderen Sprachen entwirft oder sendet, gilt alles oben weiter, plus eine Regel: Teste vor dem Start jede Sprache, nicht nur Englisch.
KI ist sehr gut im mehrsprachigen Support. In einem eesel-Test sah eine deutsche Schmuckmarke mit etwa 1.000 Tickets im Monat auf Zendesk und Shopify zu, wie ihr Agent Deutsch, Englisch, Französisch, Niederländisch, Spanisch, Polnisch, Kroatisch und Türkisch bewältigte, ohne dass jemand eine einzige Sprache konfigurierte. Das ist die Chance. Die Kehrseite: Jede Sprache wird zu einer Live-Fläche, für die du verantwortlich bist, auch die, die niemand in deinem Team liest.
Die Kehrseite zeigt sich, wenn niemand die nicht englische Ausgabe prüft. Ein Zendesk-Admin beschrieb seinen alten mehrsprachigen Answer-Bot:
"the translations were often times wrong and our customers got mixed languages during their chat with the bot, ID customers will sometimes get Portuguese, IN customers would sometimes get Indonesian, and so on and so forth."
Das würde ich pro Sprache prüfen, bevor ich den Autopiloten einschalte:
- Antworten kommen aus deinem Wissen, nicht aus Allgemeinwissen. Derselbe Help-Center-Artikel sollte auf Französisch dieselbe Richtlinie ergeben wie auf Englisch. Wenn deine mehrsprachige Wissensdatenbank Lücken hat, erbt die KI sie.
- Die Anredeform passt pro Markt zu deiner Marke. Schreib es als Regel („nutze Sie bei allen deutschen Kunden“), statt zu hoffen.
- Produktnamen bleiben unübersetzt. Eine Do-not-translate-Liste gehört in deine Anweisungen. Mein Leitfaden zum Übersetzungsglossar zeigt, wie.
- Keine Platzhalter, keine englischen Fragmente, keine Grüße in der falschen Sprache. Das würde ich als Erstes prüfen, aus den Gründen, die ich oben genannt habe.
Dann lass es gegen die Historie laufen. Die Simulation von eesel spielt echte vergangene Tickets nach, bewertet jede Antwort und schlägt Korrekturen vor (eesel skills). Filtere diesen Lauf auf deine deutschen und niederländischen Tickets, und du bekommst pro Sprache eine Einschätzung, bevor ein einziger Kunde einen Entwurf sieht. Zendesk QA bewertet außerdem Zendesk-KI-Agenten automatisch und lässt dich andere Bots zur Prüfung markieren (AI agents in Zendesk QA), was die Zeit nach dem Start abdeckt. Mein Leitfaden zu Zendesk QA für KI-Agenten geht tiefer.
Häufige Fehler bei QA im mehrsprachigen Support
- Nur per Übersetzung prüfen. Das findet falsche Antworten und übersieht alles, worauf ein muttersprachlicher Kunde zuerst reagiert.
- Ein englischer Prüfer „besitzt“ alle kleinen Sprachen. Gut für Genauigkeit, blind für Ton. Gib jeder Sprache einen muttersprachlichen Stichprobenprüfer, auch in Teilzeit.
- Englische Begrüßungen in jede Sprache kopieren. Deine automatischen Scores bestrafen dann die Agenten, die richtig lokalisieren.
- Dem erkannten Sprachfeld vertrauen. Es wird oft nur aus der ersten Nachricht gesetzt. Tickets mit gemischten Sprachen landen im falschen Bucket.
- Übersetzungsqualität mit Supportqualität verwechseln. Eine makellose Übersetzung der falschen Richtlinie lässt den Kunden trotzdem im Stich.
- Makros nicht sprachübergreifend versionieren. Richtlinien-Drift beginnt an dem Tag, an dem jemand das englische Makro aktualisiert und die anderen fünf vergisst. Eine Support-SOP mit einem Verantwortlichen pro Sprache stoppt das.
eesel für mehrsprachigen Support ausprobieren
Wenn du Support in drei oder vier Sprachen betreibst, wächst der QA-Aufwand mit jedem Markt, den du hinzufügst. Deshalb habe ich eesel in meine Liste der besten KI für mehrsprachigen Support aufgenommen.
Der KI-Helpdesk-Teamkollege von eesel verbindet sich mit Zendesk, Freshdesk und dem Rest deines Stacks, antwortet in der Sprache des Kunden, ohne dass du dein Help Center übersetzen musst, und nimmt Regeln in Alltagssprache wie „nutze Sie bei deutschen Kunden“ oder „übersetze nie unsere Produktnamen“ entgegen. Bevor er live geht, spielst du deine eigenen vergangenen Tickets in jeder Sprache nach und siehst, wo er danebengelegen hätte.

Die meisten Teams starten mit Entwürfen als interne Notizen, sodass deine muttersprachlichen Prüfer jede nicht englische Antwort sehen, bevor ein Kunde es tut, und wechseln pro Sprache zum automatischen Senden, sobald die Scores stabil sind. Tarife beginnen bei 299 $ im Monat für 500 Credits, mit kostenloser Testphase (eesel pricing). Probiere eesel zuerst an einer Sprach-Queue aus und sieh, wie er abschneidet.