

Ein KI-Support-Simulationstest bedeutet: Du spielst Tickets, die dein Team bereits gelöst hat, mit abgeschaltetem Versand durch den KI-Agenten und bewertest jede Antwort, bevor ein Kunde eine sieht. Der Wert ist nur so gut wie drei Dinge: wie viele Tickets du pro Thema durchgespielt hast, woran du bewertet hast und ob der Test echte Systeme berühren konnte. Eine Übereinstimmung von 85 % bei 20 Tickets kann in Wahrheit irgendwo zwischen 64 % und 95 % liegen. Lies das Ergebnis also pro Thema und behandle kleine Durchläufe als ersten Blick, nicht als Urteil.
Von den Helpdesks, die ich geprüft habe, spielen nur der E-Mail-Agent von Freshdesk und eesel deine eigenen gelösten Tickets nach. Der Simulator von Zendesk arbeitet mit fiktiven Szenarien, HubSpot erzeugt Fragen aus Themen vergangener Gespräche, Salesforce erzeugt oder lädt Testfälle hoch, und Gorgias testet jeweils ein Gespräch.
Der nützlichste Durchlauf, den ich gesehen habe, ein Gegencheck mit 100 Tickets in einem echten Ecommerce-Posteingang, lag bei 88 % in der Richtung richtig, doch nur 12 % der Entwürfe wären unverändert rausgegangen und 7 % enthielten einen sachlichen Fehler. Derselbe Durchlauf, drei ehrliche Werte. Deshalb beginne ich jede Einführung mit einer Simulation und danach mit einer Phase von Entwürfen bei Live-Tickets. eesel macht beides, und Norden-Frisia hat sich nach einer Testwoche mit eigenen alten Tickets innerhalb weniger Tage angemeldet.
Was ist ein KI-Support-Simulationstest?
Ein KI-Support-Simulationstest ist ein Probelauf eines KI-Agenten mit realistischen Kundennachrichten, bei dem jede Antwort aufgezeichnet und bewertet statt gesendet wird. Er beantwortet vor dem Start eine Frage: Wenn dieser Agent im letzten Monat deine Warteschlange bearbeitet hätte, bei wie vielen Antworten hättest du sie gern abgeschickt?
Eine Simulation lässt sich auf drei Arten füttern, und sie fangen unterschiedliche Dinge ab.
| Art der Simulation | Woher die Testnachrichten kommen | Was sie findet | Was sie übersieht |
|---|---|---|---|
| Nachspielen vergangener Tickets | Gelöste Tickets aus deinem eigenen Helpdesk, in den Worten deiner Kunden | Echte Formulierungen, echte Themenverteilung, Lücken in deiner Wissensdatenbank | Neue Probleme, die du noch nicht kennst, Nachhaken über mehrere Nachrichten |
| Generierte Szenarien | Eine KI schreibt Kundennachrichten aus deinen Dokumenten, Themen oder einem Prompt | Abdeckung von Themen mit wenig Verlauf, Randfälle, die du beschreibst | Wie Kunden Dinge tatsächlich formulieren, der echte Anteil jedes Themas |
| Skriptbasierte Testsets | Fragen, die du oder dein Team von Hand schreibt | Bekannte Risiken: Erstattungen, Recht, Prompt Injection | Alles, woran niemand gedacht hat |
Ich würde immer mit dem Nachspielen beginnen, weil es als Einziges aus dem gebaut ist, was Kunden wirklich schicken. Generierte und skriptbasierte Tests füllen die Lücken, die das Nachspielen lässt, vor allem bei riskanten Themen, die zu selten vorkommen, um in einer Stichprobe aufzutauchen. Mein früherer Leitfaden zum Testen von KI-Support-Agenten fasst alle drei in einem Startplan mit vier Stufen zusammen, und die Checkliste vor dem Start behandelt Übergaben, Aktionen und den Ausschalter. Dieser Beitrag geht tiefer in die Simulation selbst: wie du eine durchführst und wie du ihr Ergebnis liest.
Warum kann ein gutes Simulationsergebnis trotzdem täuschen?
Ich baue die Integrationen, die den Ticketverlauf in eesel laden, und schaue deshalb oft darauf, was ein Nachspielen tatsächlich liest. Was ich immer wieder neu lerne: „85 % bestanden“ sagt nichts, solange du nicht weißt, was „bestanden“ bedeutete.
Der Gegencheck mit 100 Tickets aus dem TL;DR ist mein klarstes Beispiel. Es war ein Test in einem echten Ecommerce-Posteingang mit rund 1.000 Tickets im Monat. Die Triage war zu 93 % treffsicher, die Spam-Erkennung zu 100 %. Entwürfe zeigten in 88 % der Fälle in die richtige Richtung. Aber nur 12 % wären genau so versendet worden, und 7 % enthielten einen sachlichen Fehler. Von den Umformulierungen betrafen etwa 65 % Länge und Ton, behebbar durch Lernen aus den gesendeten Antworten des Teams, und nur etwa 5 % waren der Agent, der bei Fakten falsch lag. Hättest du bei „88 %“ aufgehört, wärst du mit einer Fehlerquote von 7 % gestartet, die du nie gesehen hast, die stille Art von KI-Halluzination, die Kunden vor dir finden.
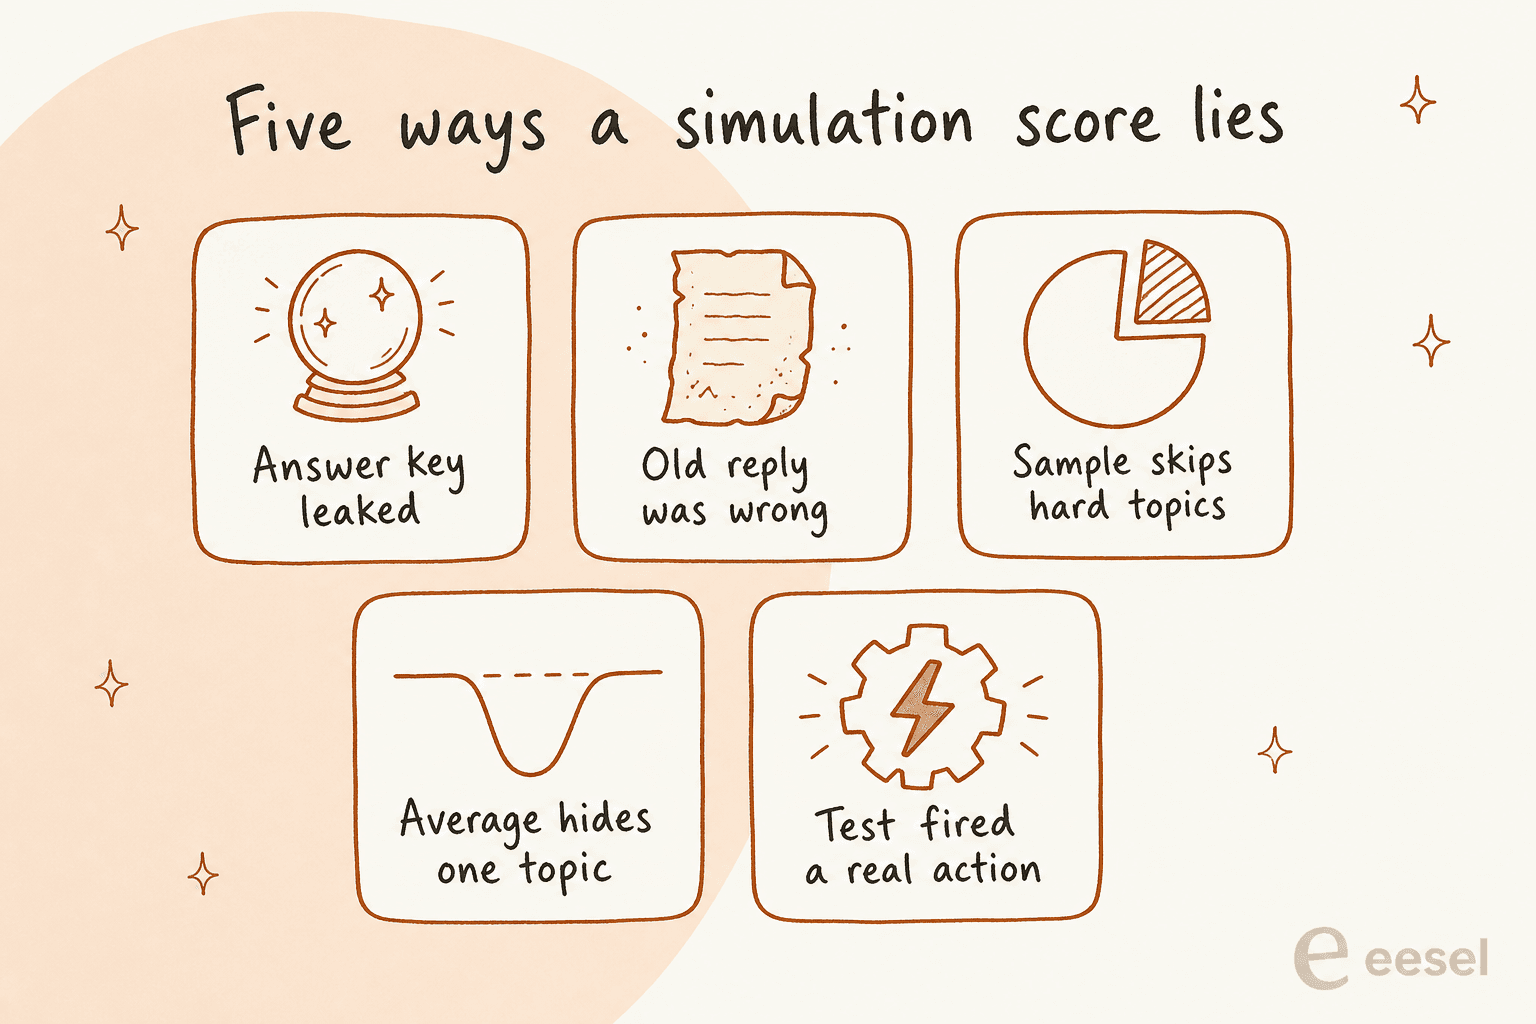
Das sind die fünf Wege, auf denen ich ein Simulationsergebnis von der Realität am Starttag habe abdriften sehen:
- Der Lösungsschlüssel ist durchgesickert. Wenn der Agent genau das Ticket lesen kann, an dem er getestet wird, oder ein Makro, das nach der Lösung dieses Tickets geschrieben wurde, bewertet er sich selbst mit den Antworten in der Hand. Wähle Tickets, aus denen der Agent nicht gelernt hat, oder schalte diese Ticketquelle für den Test ab.
- Die alte Antwort war falsch. Der Abgleich mit dem, was dein Team geschickt hat, ist ein guter Standard, aber manche dieser Antworten nutzten eine Richtlinie, die du inzwischen geändert hast, und manche waren schlicht Fehler. Bewerte nach der heutigen Richtlinie und zähle eine „Abweichung“ bei einem veralteten Ticket als bestanden.
- Die Stichprobe lässt die schwierigen Themen aus. Zwanzig aktuelle Tickets aus einer ruhigen Zeit enthalten vielleicht keinen einzigen Erstattungsstreit. Fülle die Stichprobe nach Themen und ergänze von Hand geschriebene Fälle für die seltenen, riskanten.
- Der Durchschnitt versteckt ein Thema. Ein Gesamtwert von 90 % kann auf einem Thema sitzen, das jedes Mal scheitert. Ein Reddit-Kommentator hat es gut gesagt: „A clean average can still hide one common path that fails every time“ (u/Bitter_Big4525).
- Der Test löste eine echte Aktion aus. Eine Antwort, die nie gesendet wird, ist sicher. Eine Erstattung, eine Kündigung oder ein CRM-Update, das während eines Tests ausgelöst wird, ist es nicht. Mehr dazu in Schritt 3 unten.
"the biggest failure i've seen was an agent that kept pulling data from the wrong user's account because the session token wasn't being passed correctly to the api call, the text responses looked perfect so nobody caught it until a customer complained about seeing someone else's balance"

Das letzte Beispiel ist der Grund, warum eine Simulation darauf schauen muss, was der Agent getan hat, nicht nur darauf, was er gesagt hat.
Wie viele Tickets braucht eine KI-Support-Simulation?
Für einen ersten Blick reichen 20 Tickets. Für eine Go-live-Entscheidung zu einem Thema brauchst du eher 100 Tickets zu diesem Thema, denn kleine Durchläufe liefern ein Ergebnis mit sehr großer Fehlerspanne.
Hier derselbe Wert von 85 % bei drei Stichprobengrößen, mit einem üblichen 95-%-Konfidenzbereich (dem Wilson-Intervall, falls du meine Rechnung prüfen willst):
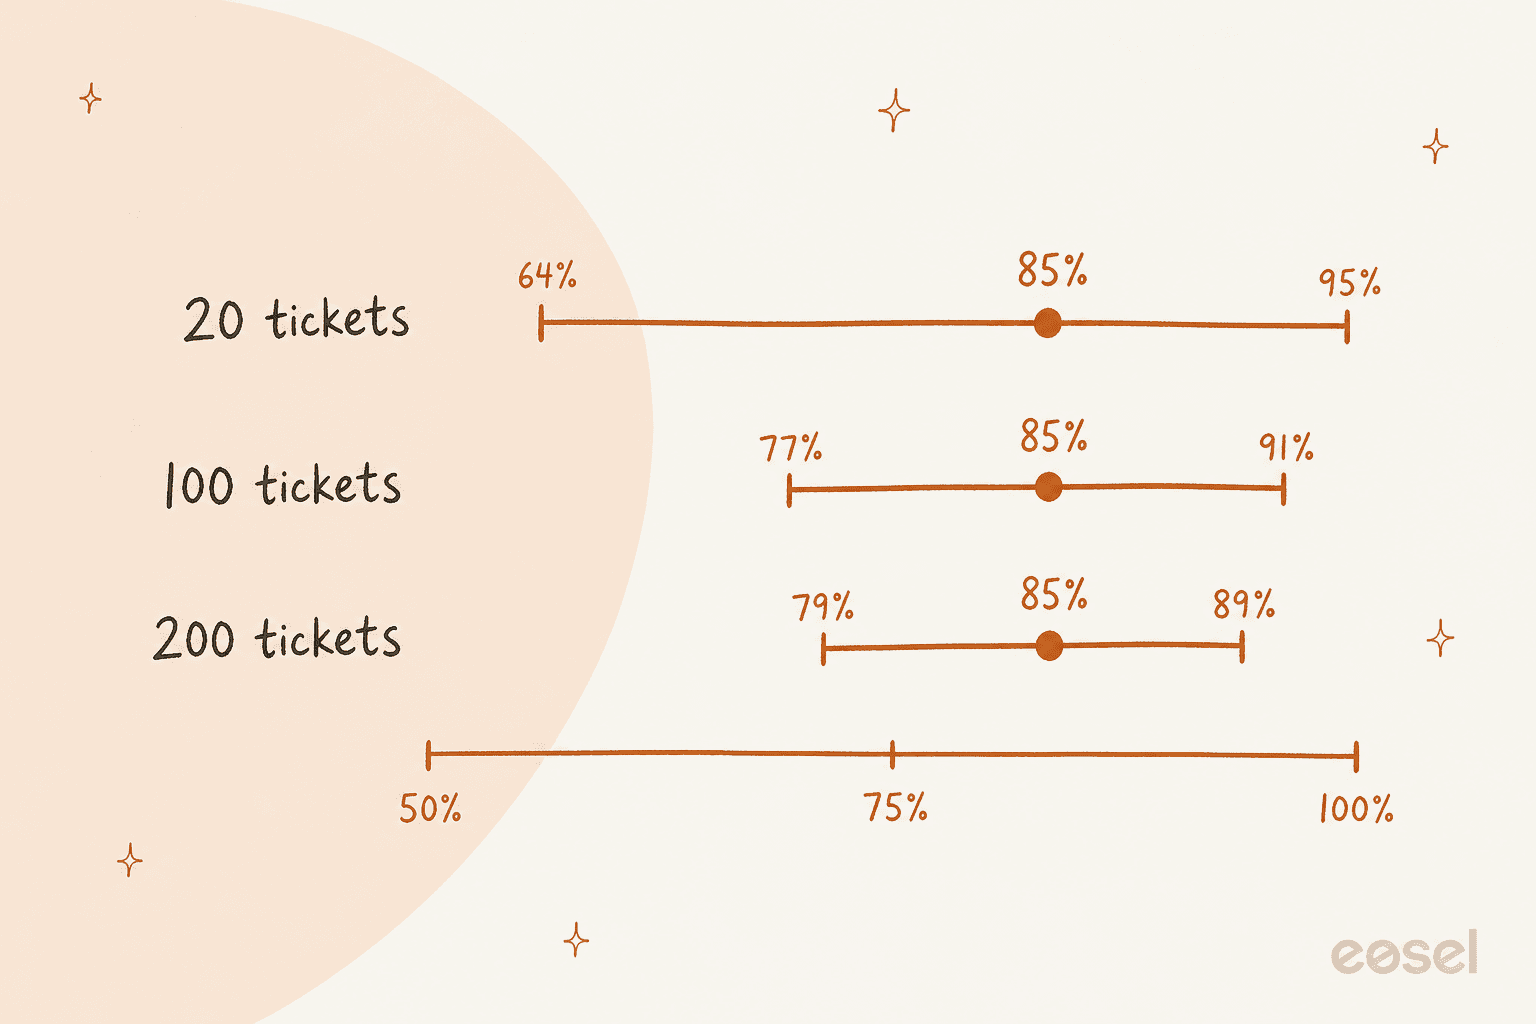
| Durchgespielte Tickets | Bestanden | Wert | Die echte Rate liegt wahrscheinlich zwischen |
|---|---|---|---|
| 20 | 17 | 85 % | 64 % und 95 % |
| 50 | 42 | 84 % | 72 % und 92 % |
| 100 | 85 | 85 % | 77 % und 91 % |
| 200 | 170 | 85 % | 79 % und 89 % |
| 20 | 20 | 100 % | 84 % und 100 % |
Zwei Dinge fallen auf. Ein Durchlauf mit 17 von 20 kann dir nicht sagen, ob du einen Agenten mit 65 % oder mit 95 % hast. Und selbst ein perfektes 20 von 20 sagt dir nur, dass die echte Fehlerrate wahrscheinlich unter etwa 16 % liegt. Das ist für einen ersten Durchlauf ein großartiges Zeichen, aber nicht genug, um ein Thema auf volle Automatik zu stellen.
Die Lösung ist günstig: Führe die Simulation pro Thema durch und füge den Themen, die du automatisieren willst, so lange Tickets hinzu, bis das untere Ende der Spanne deine Latte überspringt. Setze hier deine eigenen Zahlen ein:
Wenn ein Thema nur eine Handvoll Tickets im Monat bekommt, hast du nicht genug Verlauf, um es so oder so zu belegen. Das ist ein Thema für Entwürfe oder eine Übergabe an einen Menschen, nicht für Automatik, egal wie gut der kleine Durchlauf aussieht.
Wie führst du eine KI-Support-Simulation durch, der du vertrauen kannst?
Sechs Schritte, in dieser Reihenfolge. Sie funktionieren gleich, ob du den eingebauten Tester deines Helpdesks, eine Tabelle oder einen speziellen KI-Helpdesk-Agenten nutzt. Die ganze Schleife dauert beim ersten Mal einen Nachmittag und danach bei jeder Wiederholung nur Minuten.
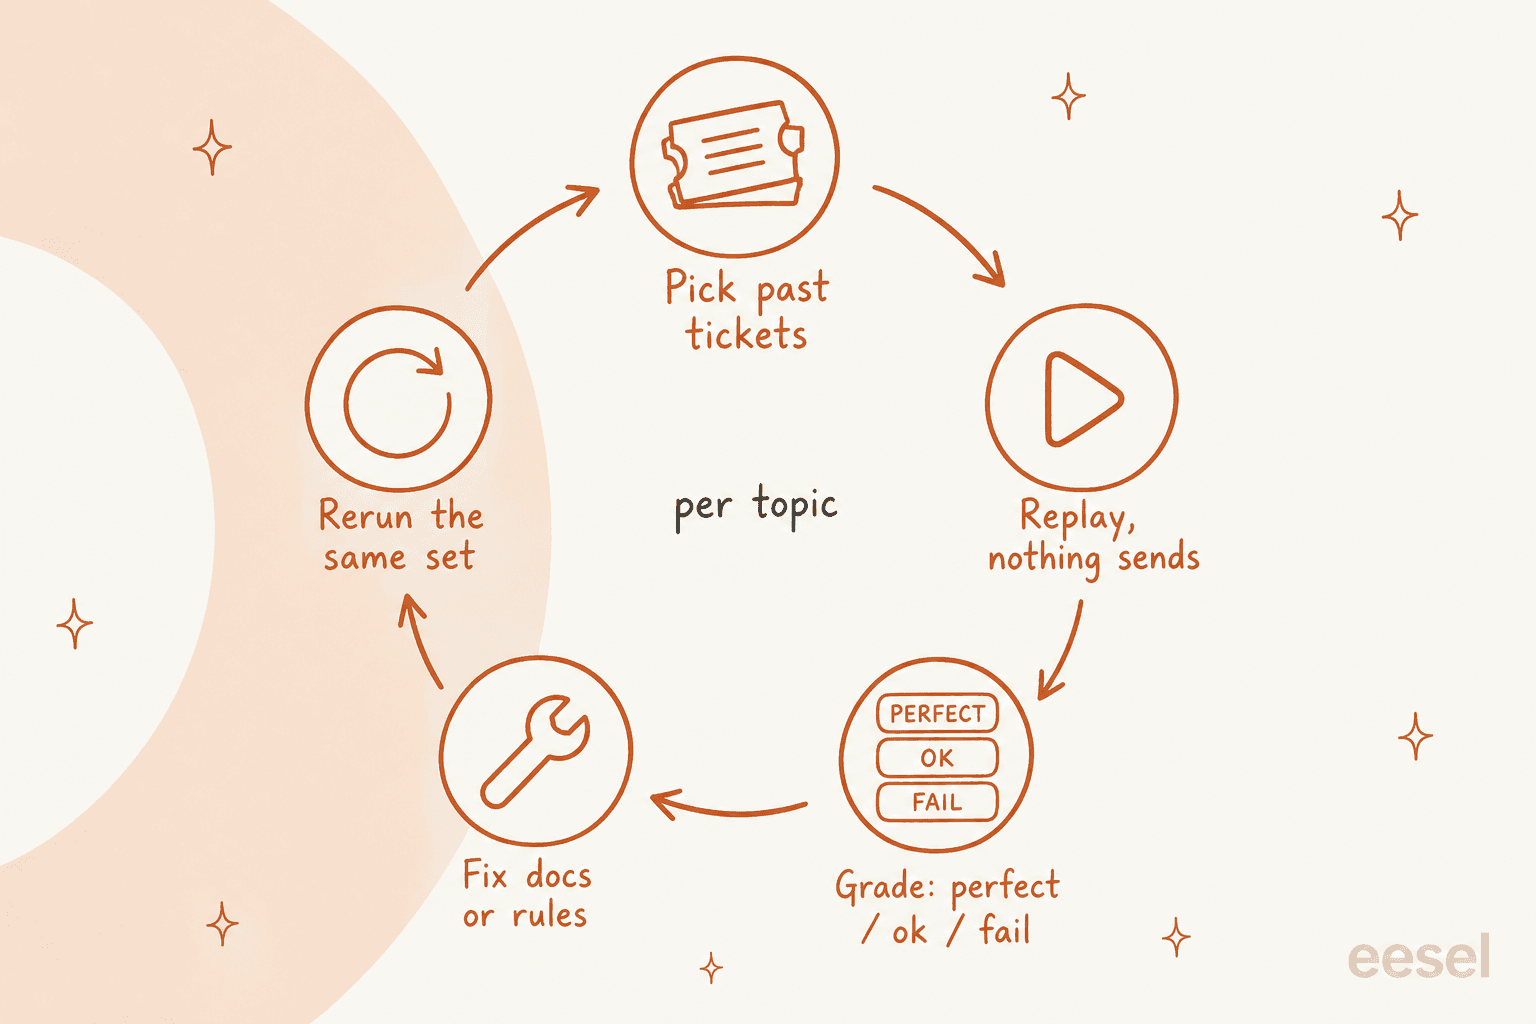
Schritt 1: Tickets nach Thema auswählen
Hole gelöste Tickets der letzten zwei bis drei Monate, damit sie deine aktuellen Produkte und Richtlinien widerspiegeln. Gruppiere sie nach Thema (die Tags oder Ticketfelder deines Helpdesks reichen meist) und nimm aus jedem Thema einen Anteil, der in etwa seiner Häufigkeit entspricht. Ergänze dann ein kleines, von Hand geschriebenes Set für die seltenen Fälle mit hohem Risiko: eine Erstattung außerhalb der Frist, ein Kunde, der nach einem Vorgesetzten fragt, eine Nachricht, die versucht, die Regeln des Agenten zu überschreiben, eine Frage, die deine Dokumente gar nicht beantworten.
Diese letzte Art ist wichtiger, als es aussieht. Einige der schlimmsten frühen Fehler, die ich in der Kundenhistorie von eesel gesehen habe, waren Bots, die Antworten erfanden, wenn die Wissensdatenbank nichts Passendes enthielt. Ein Testset ohne unbeantwortbare Fragen kann das nicht erkennen, und es ist der Kern der Vermeidung von Halluzinationen im Support.
"The one that worried me most was refund amounts. I ran AI models through support emails with a written refund policy, and 7 of them promised the wrong amount on the same email. The reply reads polite and confident, so nobody catches it until the customer quotes it back. On the easy emails they all looked great. It only showed up on hard emails I wrote and held back."
Schritt 2: Das Wissen des Agenten einfrieren und auf Lecks prüfen
Richte den Agenten auf dasselbe Help Center, dieselben Makros und dieselben Anweisungen, die er am ersten Tag nutzen wird, und auf nichts sonst. Jede Antwort sollte in einer Quelle verankert sein, auf die du zeigen kannst, damit die Bewertung prüfen kann, woher sie stammt. Prüfe dann, dass das nachgespielte Ticket und alles, was zu seiner Beantwortung geschrieben wurde, nicht im Wissen des Agenten liegt. Lernt der Agent aus vergangenen Tickets, wähle entweder Tickets, aus denen er nicht gelernt hat, oder schließe diese Quelle für den Testlauf aus.
Schritt 3: Jede schreibende Aktion abschalten
Schalte den Versand ab und prüfe dann die Aktionen. Die Anbieter sagen klar, dass das nicht automatisch geschieht:
- Gorgias warnt, dass eine Aktion des Agenten in einem Testgespräch "it can affect real customer and order data (like cancelling an order)" und schlägt ein fiktives Kundenprofil vor (Gorgias-Dokumentation).
- Salesforce sagt "Testing agents can modify CRM data" und rät, das Testing Center nur in einer Sandbox zu nutzen.
- Das Testfenster von HubSpot zeigt jetzt "any records that were created or updated" während eines Tests (HubSpot-Dokumentation).
Meine Regel: In einer Simulation darf der Agent alles lesen, was er auch in der Produktion liest, und nichts schreiben. Willst du eine Erstattungsaktion testen, teste sie getrennt gegen eine fiktive Bestellung und steuere sie mit Aktionen unter Freigabe, sobald sie live geht.
Schritt 4: Auf drei Stufen bewerten, plus ein „Niemals“-Topf
Eine Bestanden/Durchgefallen-Note wirft die nützlichste Information weg. Ich bewerte jede Antwort als eine von:
- Perfekt: Du würdest sie so senden.
- Akzeptabel: Richtige Antwort, braucht eine leichte Änderung bei Länge oder Ton.
- Fehler: Falsch, unvollständig oder hätte übergeben müssen und hat es nicht getan.
Dazu führe ich einen eigenen „Niemals“-Topf für die Fehler, die einen Start unabhängig vom Durchschnitt verhindern: eine erfundene Richtlinie, eine versprochene Erstattung, die die Richtlinie nicht erlaubt, Daten eines anderen Kunden, eine verpasste Übergabe bei einem rechtlichen oder sicherheitsrelevanten Ticket. Ein Reddit-Kommentator beschrieb seine Töpfe als „annoying“, „bad“ und „burn it down“, und die Stufe „burn it down“ "has to be zero or we don't ship" (u/Evening_Event4634).
Eine KI die erste Bewertung machen zu lassen ist in Ordnung, und die meisten Tools tun das inzwischen. Salesforce nutzt einen „LLM judge“, der jede Antwort mit einer erwarteten Antwort vergleicht, und selbst er sagt, seine Qualitätswerte "are not absolute measures of success or failure" (Salesforce). Ich lasse einen Menschen jeden Fehler, jeden „Niemals“-Kandidaten und eine zufällige Auswahl der bestandenen Antworten lesen, was einen Menschen im Prozess hält, wo die Bewertung am schwächsten ist. Die Best Practices für Evaluierung von OpenAI sagen dasselbe darüber, eine Modellbewertung gegen Menschen zu prüfen. Es ist dieselbe Gewohnheit wie eine QA-Kalibrierung, nur auf den Agenten gerichtet.
Schritt 5: Ergebnisse pro Thema lesen und pro Thema entscheiden
Hier wird aus dem Durchlauf ein Einführungsplan. Triff für jedes Thema eine von drei Entscheidungen:
| Wie das Ergebnis des Themas aussieht | Was ich tun würde |
|---|---|
| Das untere Ende der Spanne überspringt deine Latte, null „Niemals“-Fehler | Kandidat zum Alleinantworten, nach einer Woche Entwürfe bei Live-Tickets |
| Meist perfekt oder akzeptabel, ein paar Fehler, die du verstehst | Entwürfe, die ein Mensch sendet, Ursache beheben, erneut durchspielen |
| Viele Fehler oder irgendein „Niemals“-Fehler | An einen Menschen übergeben, zuerst Dokumente oder Regeln korrigieren |
Pro Thema statt auf einmal zu starten, machen die meisten Kunden von eesel so. Rúngne führt eine Themenliste, die entscheidet, was eine direkte Antwort und was einen Entwurf bekommt, und ein Thema umzuhängen ist eine Listenänderung. smava markiert etwa 1.100 seiner 27.000 monatlichen Tickets als geeignet für eine automatische Antwort, mit Entwürfen für den Rest.
Schritt 6: Korrigieren, dann dieselben Tickets erneut durchspielen
Wenn ein Thema scheitert, ist die Lösung meist ein fehlender oder vager Hilfeartikel, eine zu lockere Anweisung oder eine Übergaberegel, die nicht greift. Nimm die Änderung vor, spiele dann genau dasselbe Set erneut durch und vergleiche. Behalte die bereits bestandenen Tickets im Set, denn eine Korrektur für ein Thema kann ein anderes unbemerkt kaputt machen. Spiele erneut durch, sobald du das Modell, die Anweisungen, den Konfidenzschwellenwert oder einen großen Teil der Wissensdatenbank änderst. Den erneuten Durchlauf nach einer „kleinen Änderung“ zu überspringen, gehört zu den Einführungsfehlern, die ich am häufigsten sehe.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
Welche Helpdesks lassen dich einen KI-Agenten mit alten Tickets simulieren?
Die meisten KI-Agenten bringen heute irgendeinen Testlauf mit, aber sie meinen mit „Simulation“ sehr Unterschiedliches. Wenn du ein Tool auswählst, gehört das in deine Checkliste zur Anbieterbewertung. Ich habe am 30. Oktober 2026 das Help Center jedes Anbieters geprüft:
| Tool | Spielt deine echten alten Tickets nach? | Testeingabe | Limit pro Durchlauf | Wie Antworten bewertet werden | Können Tests echte Daten berühren? | Gespeicherte Wiederholungen |
|---|---|---|---|---|---|---|
| Zendesk Konversationssimulator (Early Access) | Nein, nur fiktive Daten | Kundenprofile und Szenarien, die du schreibst oder die die KI erzeugt | Nicht angegeben | Status pro Gespräch, geschätzte Lösung | Nicht angegeben; das Test-Widget überspringt CRM-Aktionen | Versionierte Szenarien, Durchlaufverlauf |
| Freshdesk E-Mail-KI-Agent | Ja, gelöste Tickets | Importierte Tickets, getippte oder generierte E-Mails | 50 | Answered, Unanswered oder Error, plus deine Bewertung | Workflows werden ausgelöst; nicht angegeben, ob live | Ja |
| Freshdesk Chat-KI-Agent | Nein | Getippte oder generierte Fragen | 100 | Answered oder Unanswered, plus deine Bewertung | Nicht angegeben | Ja |
| HubSpot Customer Agent | Nein, erzeugt Fragen aus Themen vergangener Gespräche | Generierte oder getippte Fragen | 8 Testsets | Du markierst Looks good oder Looks bad | Datensätze können angelegt oder aktualisiert werden | Ja |
| Gorgias AI Agent | Ein bestehendes Ticket nach dem anderen | Getippte Nachricht oder ein altes Ticket | 1 Gespräch | Kein Wert; du liest seine Begründung | Ja, wenn Aktionen an sind | Nein |
| Salesforce Agentforce Testing Center | Nein | Aus Themen, Aktionen oder Wissen generiert oder per CSV-Upload | 100 generiert, 1.000 pro CSV | KI-Bewertung gegen eine erwartete Antwort, Qualitätswerte von 0 bis 5 | Ja, Sandbox empfohlen | Ja |
| Atlassian Customer Service Management | Nicht angegeben | Ein Datensatz mit Fragen | Nicht angegeben | Gelöst oder nicht, von einem Menschen geprüft | Nicht angegeben | Ja |
| eesel | Ja, gelöste Tickets | Alte Tickets oder generierte Fälle ohne Helpdesk | Beispiellauf in der Doku: 20 Tickets | Verglichen mit dem, was dein Team gesendet hat, nach Themen gruppiert | Nein, "It sends nothing to customers" | Ja, kann nach Zeitplan laufen |
Ein paar Dinge zu jedem davon.
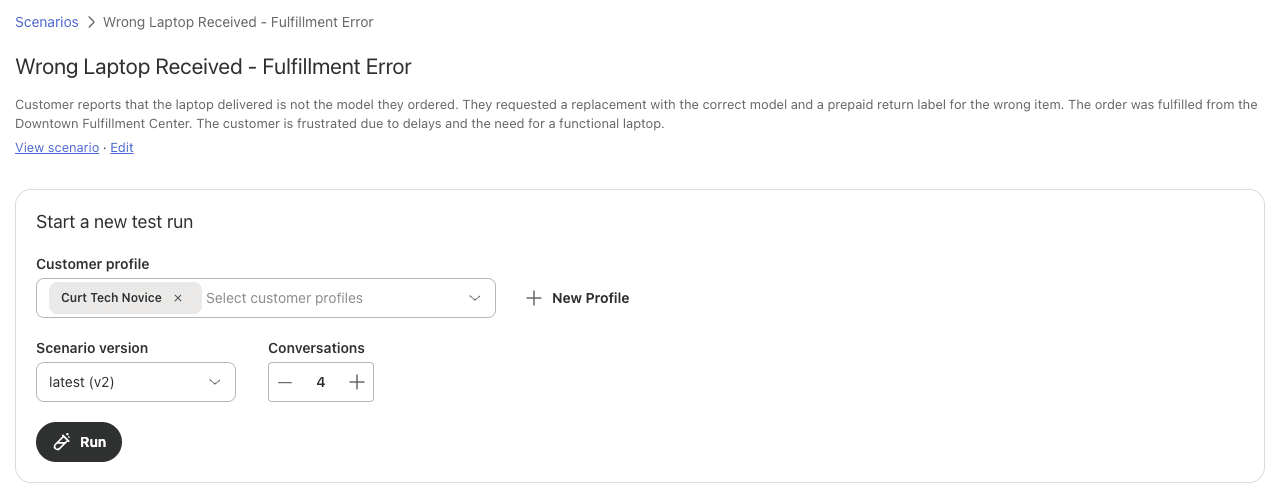
Zendesk. Der Konversationssimulator ist in einem Early-Access-Programm und funktioniert nur mit einem Messaging-KI-Agenten. Du schreibst ein Szenario (Hintergrund, Ausgangsproblem, erwartetes Ergebnis, Mock-Werte) und wählst ein Kundenprofil, und die KI spielt den Kunden. Zendesk sagt, er sei "designed for testing with fictional data", also stark für Chats über mehrere Nachrichten und schwach für „wie hätte er den letzten Monat gemeistert“. Tests darin verbrauchen keine automatisierten Lösungen, was bei der Preisgestaltung pro Lösung von Zendesk zählt. Nach dem Start übernehmen die Konversationsprotokolle und Zendesk QA das Bewerten.
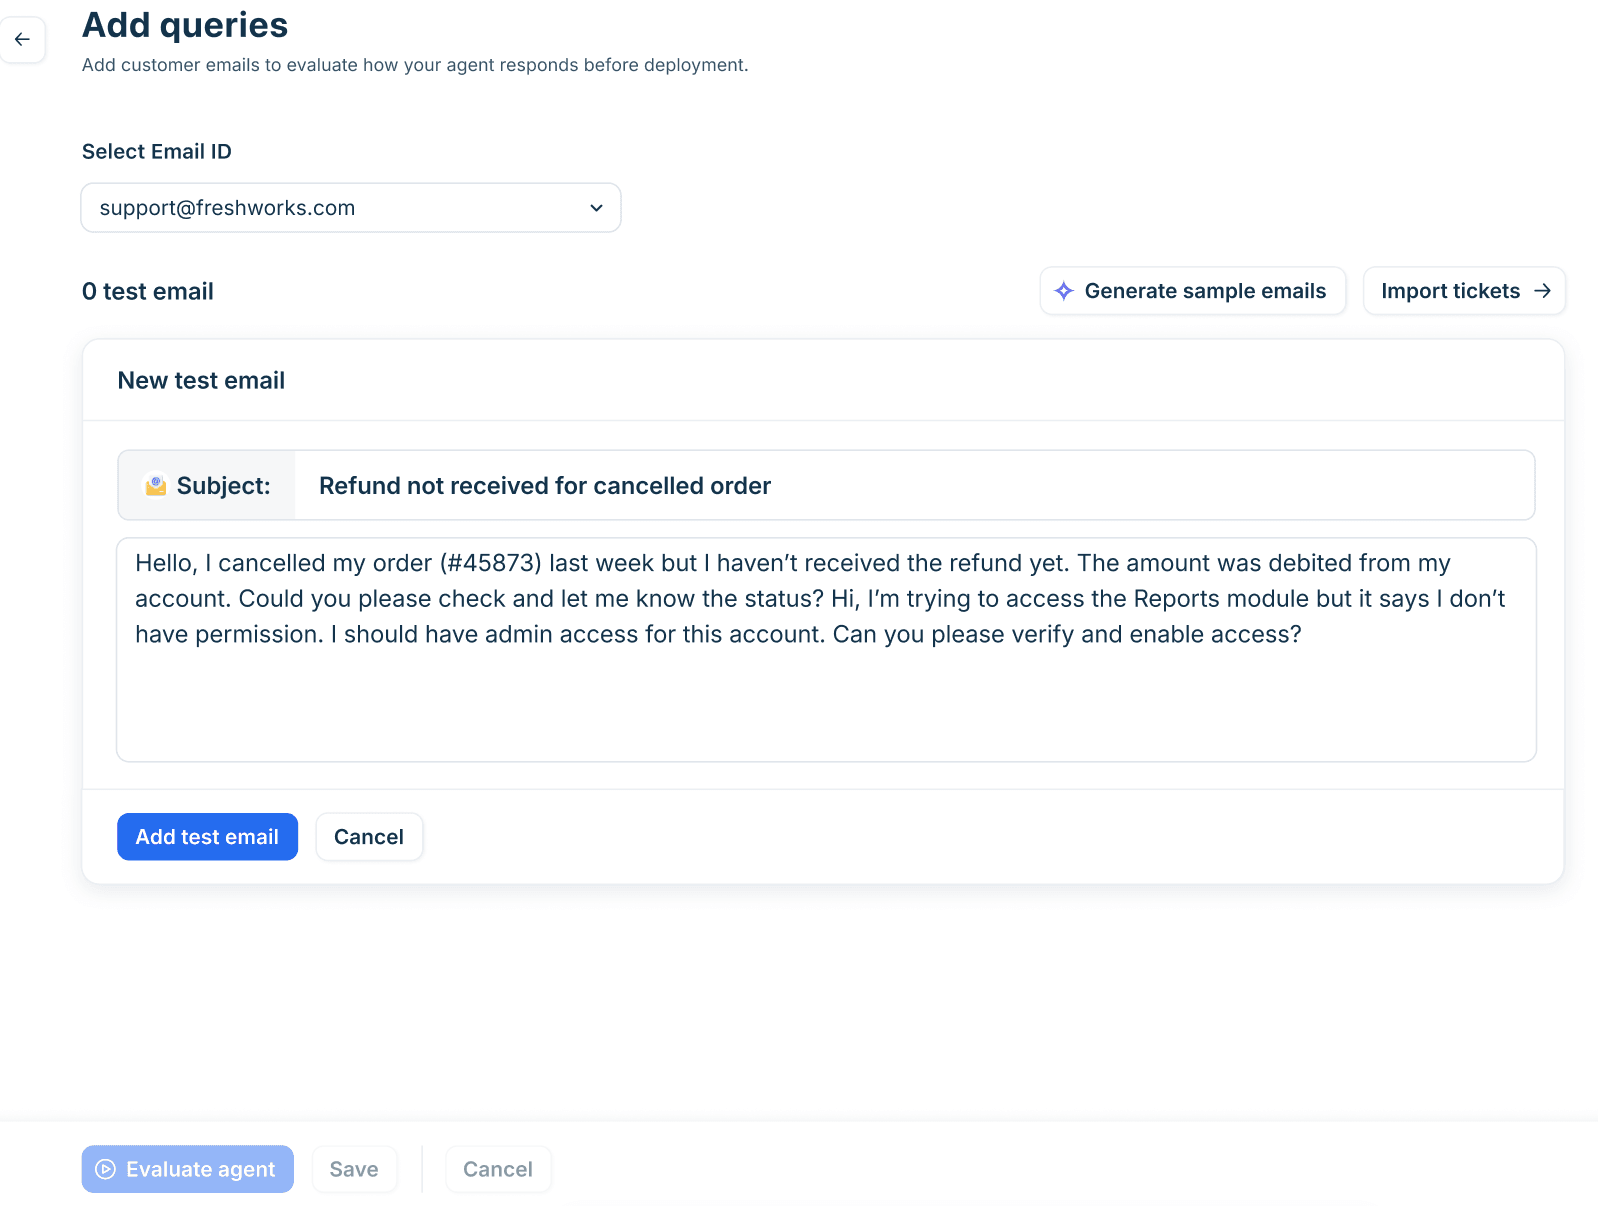
Freshdesk. Der Schritt Evaluate des E-Mail-Agenten ist das Nächste an einem echten Nachspielen, was eingebaut ist: Du kannst "Import tickets to use solved historical tickets", bis zu "50 queries per evaluation run" (Freshdesk). Freshdesks eigene Latte ist "at least 20 representative queries before deploying", was ich nach der Tabelle oben als Untergrenze behandeln würde. Der Wert besagt, ob der Agent geantwortet hat, nicht ob die Antwort mit dem übereinstimmte, was dein Mitarbeiter gesendet hat, also liest du trotzdem jede einzelne. Es gibt ihn in Freshdesk Omni Growth, Pro und Enterprise, und es gibt eine Sandbox, wenn du eine komplett getrennte Kopie willst.
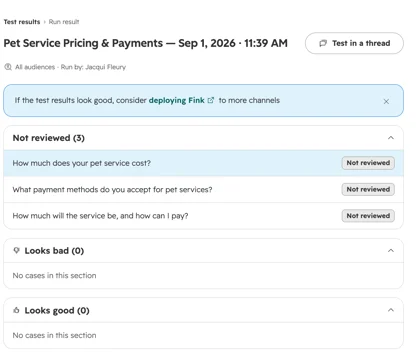
HubSpot. Das Batch-Testing kann sie "generate them from existing customer conversations", das heißt, es schreibt häufige Fragen pro Thema, und ein Thema braucht "5 or more conversations on a similar topic", um aufzutauchen. Die Bewertung erfolgt von Hand, Antwort für Antwort, und Testsets werden für Wiederholungen gespeichert. Tests verbrauchen keine HubSpot Credits.
Gorgias. Der Playground kann "an existing ticket" erneut durchlaufen lassen, was Gorgias empfiehlt für "re-simulating a conversation where AI Agent did not initially respond as expected" (Gorgias). Er ist gut, um eine Korrektur an einem Ticket zu prüfen, aber es gibt keinen Batch-Lauf, also bekommst du keinen Wert über 100 Tickets. Gorgias setzt stattdessen auf Live-Prüfung: Der Go-live-Leitfaden bittet dich, in der ersten Woche "at least 10 tickets" zu prüfen.
Salesforce und Atlassian. Das Agentforce Testing Center hat die detaillierteste Bewertung der Gruppe: Prüfungen, ob das richtige Thema und die richtige Aktion gewählt wurden, dazu eine KI-Bewertung und optionale Qualitätsbewerter, in den Editionen Enterprise, Performance, Unlimited und Developer mit einer Agent-Zusatzlizenz (siehe Agentforce-Preise). Es spielt aber keine vergangenen Fälle nach; du erzeugst Tests oder lädst eine CSV hoch. Die Evaluierungen von Atlassian sind einfacher: ein Datensatz mit Fragen, jede als gelöst oder nicht markiert, mit einem erneuten Durchlauf nach jeder Korrektur.
Wenn du Zendesk, Gorgias oder HubSpot nutzt und ein Nachspielen deiner tatsächlich gelösten Tickets willst, musst du diese Lücke außerhalb des Helpdesks füllen, entweder mit einer Tabelle und viel Copy-and-paste oder mit einem Tool, das deinen Ticketverlauf direkt liest.
Was kann eine Simulation dir nicht sagen?
Eine Simulation sagt dir, wie der Agent mit der ersten Nachricht eines Tickets umgeht, dessen Form er schon kennt. Vier Dinge kann sie nicht vollständig zeigen:
- Wie Kunden nachhaken. Ein Nachspielen hat eine Kundennachricht und eine Antwort. Echte Kunden antworten „das ist falsch“, fragen erneut oder werden wütend. Skriptbasierte Tests über mehrere Nachrichten helfen, Live-Entwürfe helfen mehr.
- Was diese Woche neu ist. Ein Produktstart, ein Ausfall oder eine Richtlinienänderung erzeugt Tickets, die dein Verlauf nicht hat.
- Wie Kunden es empfinden. Ein Hacker-News-Kommentator, der eine KI-Support-Einführung geleitet hat, sagte, sie hätten "did our own intensive testing" und trotzdem festgestellt, "our customers just hated it" (victor106). Ton, Tempo und die Möglichkeit, einen Menschen zu erreichen, zählen so viel wie Genauigkeit.
- Ob deine Dokumente wahr bleiben. Eine Simulation ist eine Momentaufnahme. Ändert sich nächsten Monat eine Richtlinienseite, ist der Wert veraltet. Plane einen erneuten Durchlauf ein.
"Shipped a customer service agent for a mid-size e-commerce client last year, manual testing looked clean across every flow we ran. First week in production, users started interrupting mid-response to rephrase their question, agent would drop the original context entirely and answer the new phrasing with confident, wrong information. Support tickets spiked, client was fielding churn risk conversations by day ten. We caught exactly zero of that in manual testing because we were too polite during QA."
Deshalb behandle ich die Simulation als Tor zu Entwürfen, nicht zur Automatik. Der nächste Schritt sind ein bis zwei Wochen, in denen der Agent bei Live-Tickets Entwürfe schreibt und ein Mensch sendet. Innr ist genau in dieser Phase auf Freshdesk: Jede Antwort ist heute ein Entwurf, und das Team stellt ausgewählte Themen einzeln auf autonome Antworten um. SE Ranking testet direkte E-Mail-Antworten bei Testtickets, die nach Betreffzeile ausgewählt sind, bevor es das ausweitet. Beobachte in dieser Phase die Lösungsquote und die Wiedereröffnungsquote pro Thema (nicht die Deflection, die Tickets zählt, die dich nie erreicht haben) und entscheide damit, was autonom wird. Mein Beitrag zum Einführungszeitplan zeigt, wie lange diese Phase üblicherweise dauert.
Wie eesel eine Simulation mit deinen alten Tickets durchführt
Ich werde konkret, wie das in eesel funktioniert, da es der Teil des Produkts ist, zu dem ich die meisten Fragen sehe.
Du bittest im Chat darum. Mit verbundenem Helpdesk "replays your past tickets and scores its answers against what your team actually sent", so die Helpdesk-Simulation von eesel (eesel-Dokumentation). Ohne Helpdesk schreibt eesel stattdessen realistische Testfälle. Der Lauf entwirft eine Antwort zu jedem Ticket, vergleicht sie mit der Antwort deines Teams, gruppiert die Ergebnisse nach Themen und listet Korrekturen nach Wirkung sortiert auf. Im Beispiellauf der Doku entsprachen 17 von 20 gelösten Tickets der Antwortqualität des Teams, mit einer Aufschlüsselung pro Thema darunter. Sieh das als Beispiel für den Bericht, nicht als Prognose für deine Warteschlange.
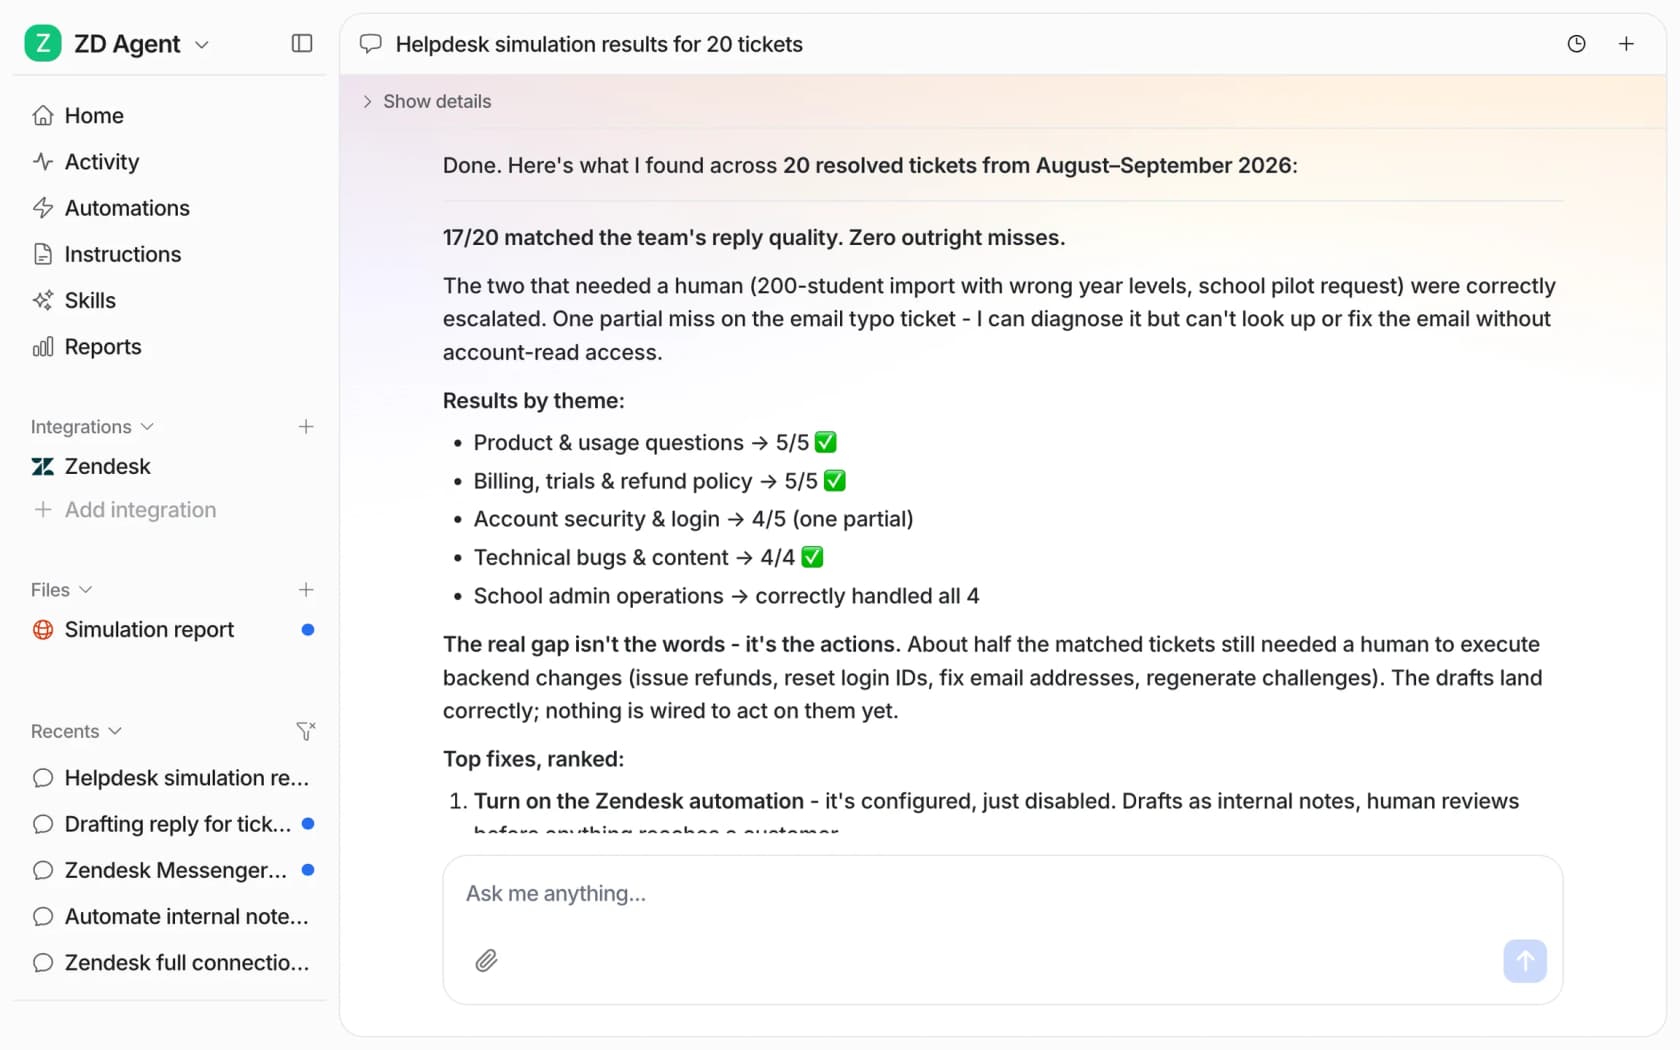
Der vollständige Bericht öffnet sich neben dem Chat, Ticket für Ticket: was der Kunde gefragt hat, was dein Team geantwortet hat und wie die Antwort des Agenten im Vergleich aussah. Beide Beispielberichte der Simulation in den Skills-Dokumenten enden gleich: "It sends nothing to customers". Das deckt Schritt 3 ab.
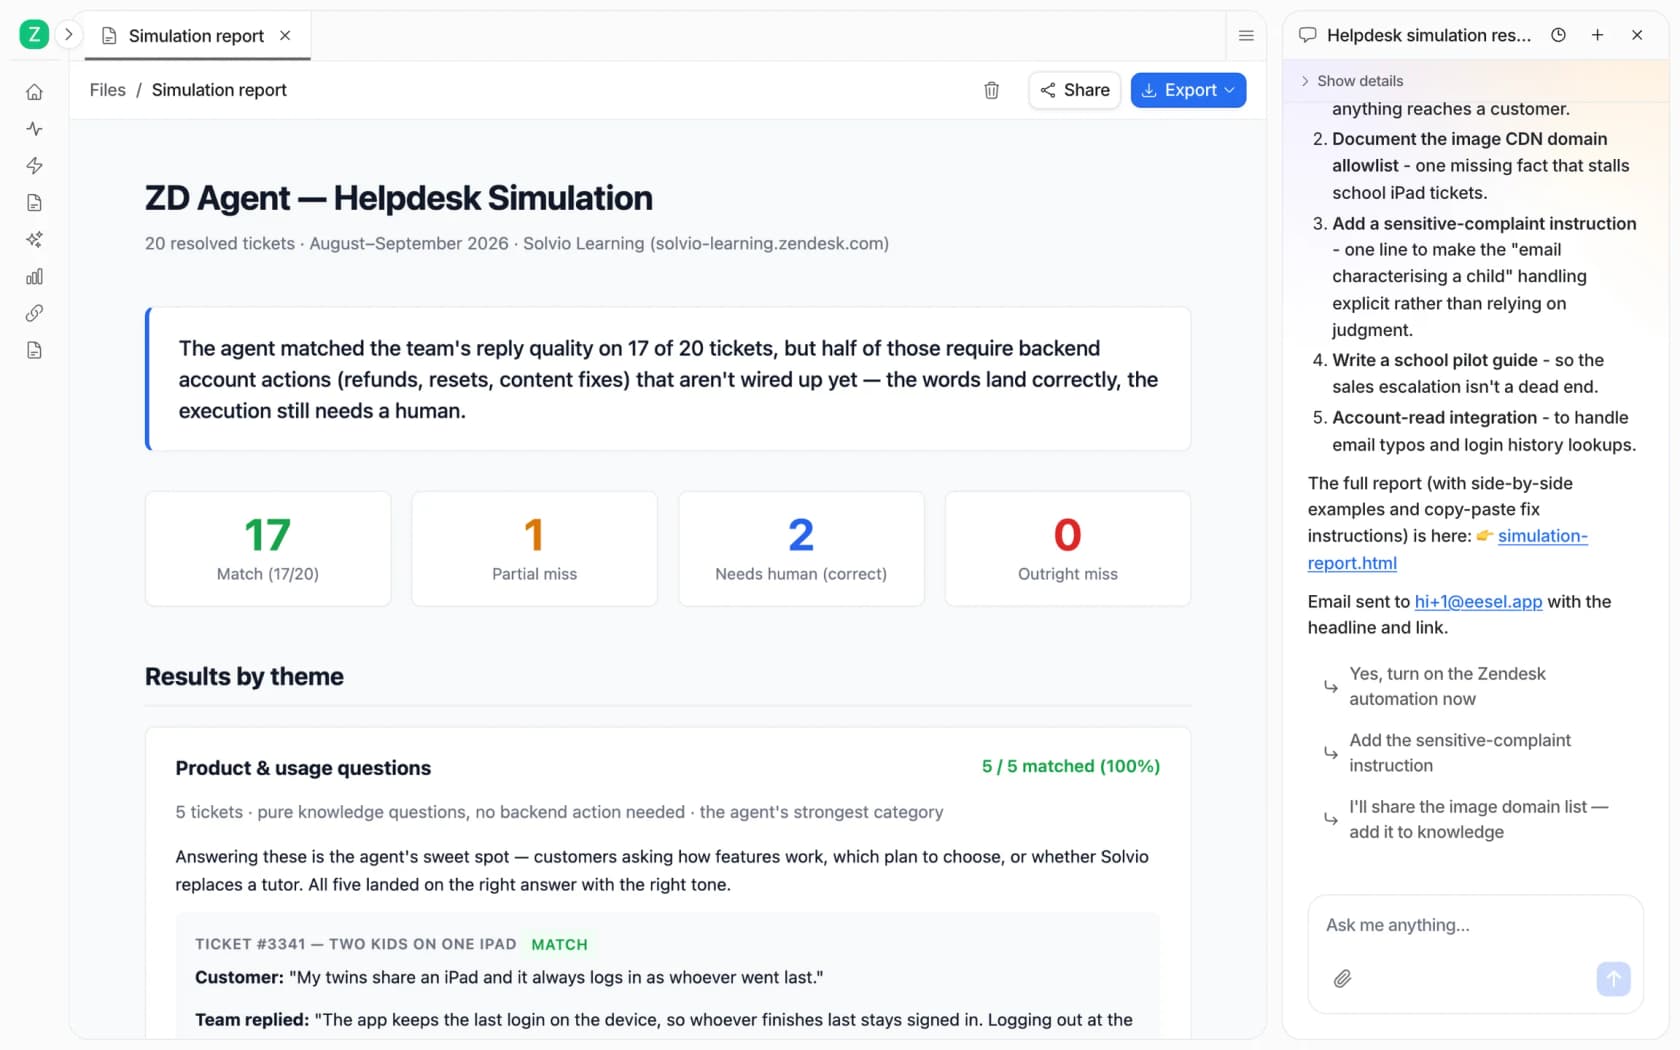
Beachte, dass der Bericht nicht bei „Treffer“ aufhört. Er trennt teilweise Fehlschläge und Tickets, die korrekt einen Menschen brauchten, also die Bewertung auf drei Stufen aus Schritt 4, direkt eingebaut. Wenn du den Agenten im Chat korrigierst, schreibt er die Korrektur als Regel in einem einfachen Satz in seine eigenen Anweisungen, sodass der nächste erneute Durchlauf die Korrektur testet. Du kannst die Simulation außerdem an eine Automation hängen, damit sie nach Zeitplan läuft, was Schritt 6 erledigt, ohne dass jemand daran denken muss.
Nach der Simulation beginnt jede Antwort als Entwurf oder interne Notiz, und du stellst Themen auf „antwortet allein“, wenn du bereit bist. Alles, was Geld kostet, bleibt hinter einer Freigabe. Wenn du lieber im Terminal arbeitest, lässt dich die eesel CLI denselben Agenten mit eesel chat "what's our refund policy?" testen, mit eesel approvals prüfen, was wartet, und jede Schreibaktion mit --dry-run vorab ansehen, bevor sie läuft. Coding-Agenten wie Claude Code oder Cursor können dieselben Befehle ausführen.
Wo eesel nicht die richtige Wahl ist: Wenn du Chat-Simulationen über mehrere Nachrichten mit von der KI gespielten Kundenpersonas in Zendesk brauchst, ist dessen eigener Simulator dafür gebaut. Die Simulation von eesel dreht sich darum, wie der Agent deinen echten Verlauf beantwortet hätte.
Simuliere deinen KI-Agenten mit eesel an deinen eigenen Tickets
Wenn du kurz davor bist, einen KI-Agenten einzuschalten, und vorher einen Wert aus deiner eigenen Warteschlange willst: eesel verbindet sich in wenigen Minuten mit Zendesk, Freshdesk, Gorgias und HubSpot, spielt Tickets nach, die dein Team schon gelöst hat, und sagt dir Thema für Thema, wo er bereit ist und wo deine Dokumente Lücken haben, ohne etwas zu senden. Norden-Frisia hat seine Testwoche mit drei Monaten alter Tickets und Makros durchgeführt und sich innerhalb weniger Tage angemeldet. Der Free-Tarif enthält 100 Credits, um jede Funktion auszuprobieren, und bezahlte Tarife beginnen bei 299 $/Monat für 500 Credits.
Probiere eesel aus und führe noch heute Nachmittag deine erste Simulation durch.