

Kurzfassung
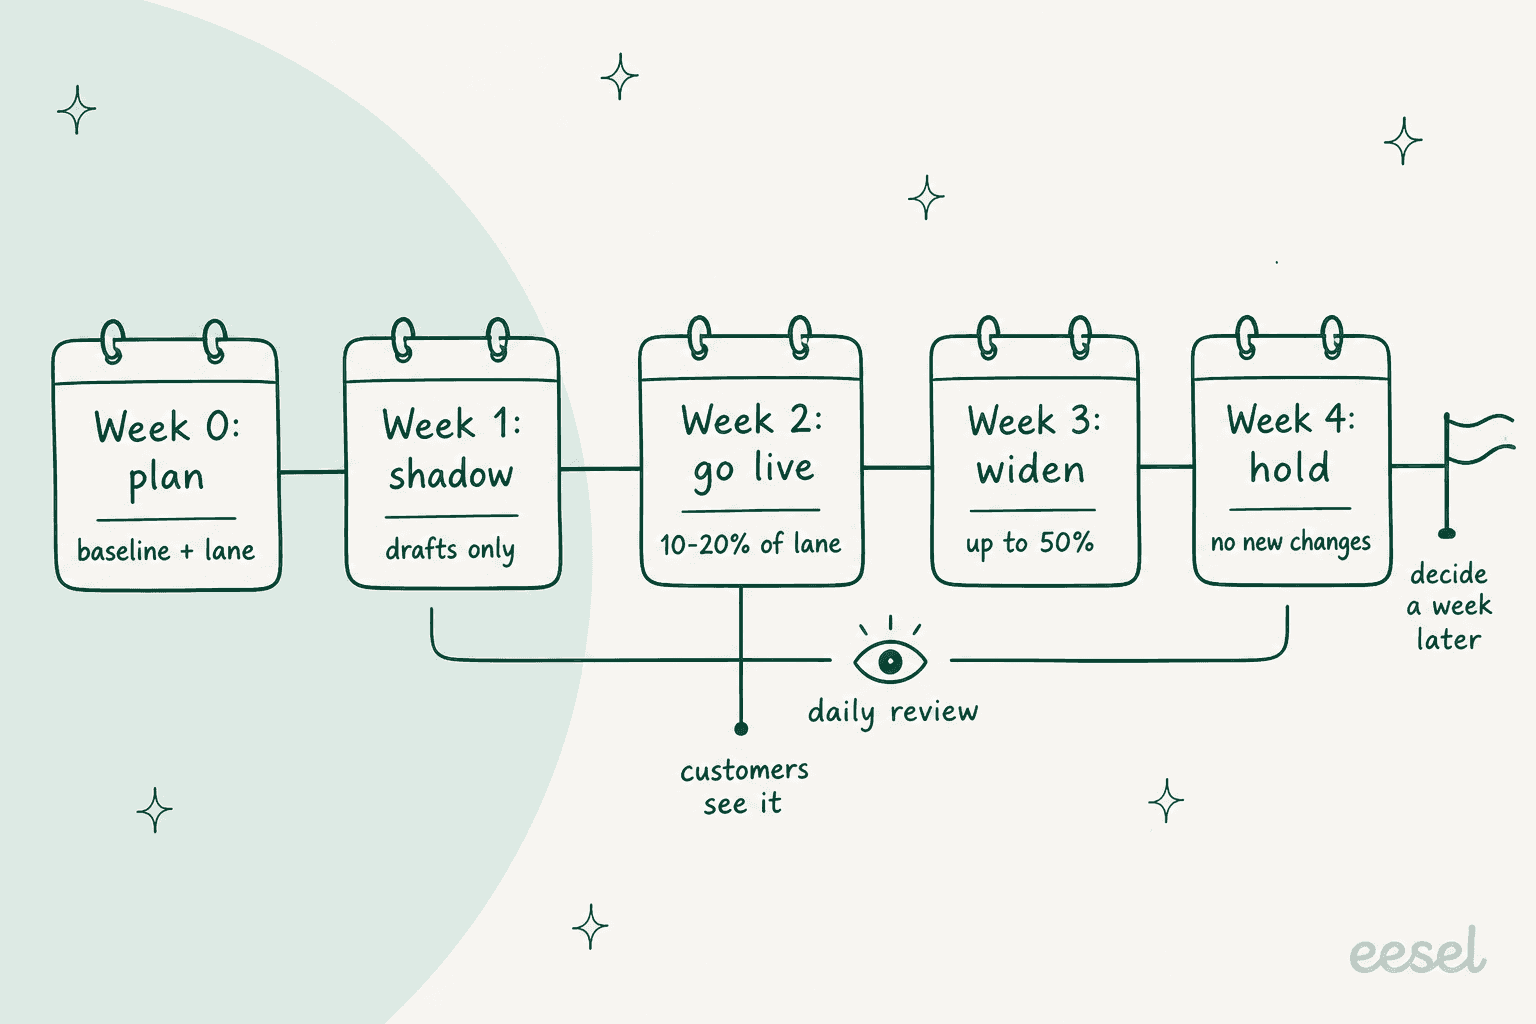
Planen Sie für einen KI-Support-Pilot vier Wochen und eine schmale Spur ein. Woche 0 ist die Planung: Wählen Sie zwei oder drei Ticket-Typen, die die KI direkt aus Ihren Dokumenten beantworten kann, halten Sie Ausgangswerte und Bestehensgrenzen schriftlich fest und richten Sie neben einer KI-Queue eine rein menschliche Kontroll-Queue für dieselben Tickets ein. Woche 1 ist der Shadow-Modus, in dem die KI nur Entwürfe schreibt und Ihr Team sie bewertet. In Woche 2 antwortet sie Kunden auf 10 bis 20 % der Spur. In Woche 3 weiten Sie auf etwa die Hälfte aus. In Woche 4 ändern Sie nichts und lassen die Zahlen sich setzen, dann entscheiden Sie eine Woche später: ausweiten, korrigieren und neu testen oder stoppen.
Der Teil, den Teams überspringen, ist die tägliche Prüfung. Fünfzehn Minuten am Tag, in denen Sie die KI-Tickets von gestern, jede ausgeführte Aktion und jede wiedereröffnete Unterhaltung lesen, entscheiden über den Erfolg des Piloten. Jeder Fehler lässt sich auf eine von vier Ursachen zurückführen (Wissenslücke, Anweisung, fehlende Daten oder Routing), und jede braucht eine andere Lösung. Erstattungen, Stornierungen und Kontoänderungen bleiben aus dem Pilot heraus oder hinter einer menschlichen Freigabe, bis die reine Antwort-Spur sauber läuft.
Wenn Sie einen Pilot wollen, der schon so funktioniert: eesel spielt Ihre vergangenen Tickets vor Tag eins nach und liefert einen Score, startet als Entwürfe in Zendesk, Freshdesk, Gorgias oder HubSpot und protokolliert jede Aktion für Ihre tägliche Prüfung. XAP begann mit einem einzigen Ausschnitt, nämlich Weiterleitungs-Tickets, die als interne Notizen vorformuliert wurden, und erweitert den Filter von dort aus. Der kostenlose Plan gibt Ihnen 100 Credits, um es an Ihrer eigenen Queue auszuprobieren.
Warum die meisten KI-Support-Piloten in Woche zwei scheitern
Ich betreue die Support-Queue von eesel und sehe Piloten deshalb von innen: die Setup-Fragen in Woche eins, dann die „Ist das normal?“-Nachrichten in Woche zwei. Die Piloten, die ins Stocken geraten, tun das selten, weil die KI schlecht ist. Meist liegt es daran, dass niemand die tägliche Durchsicht dessen verantwortet, was die KI getan hat, dass der Umfang wächst, bevor die erste Spur sauber ist, und dass dann drei Änderungen am selben Nachmittag live gehen, sodass niemand sagen kann, welche die Rückgabe-Antworten kaputt gemacht hat.
Hier ein echtes Beispiel. Ein dänisches Telematik-Team für Fahrzeuge auf Zendesk stellte fest, dass sein Bot Kunden „ja, wir unterstützen Ihr Automodell“ sagte, und zwar für Marken, die gar nicht in der Datenbank standen. Das Modell erfand das nicht aus dem Nichts. Ein Hilfeartikel sagte, das Produkt unterstütze alle Modelle, und die KI glaubte ihm. Die eigene Zusammenfassung des Teams zum Setup lautete „trial and error in the beginning“, was ehrlich ist und genau die Aufgabe eines Piloten beschreibt: die Sätze in Ihrer Wissensdatenbank zu finden, die auf eine Weise falsch sind, die ein menschlicher Mitarbeiter stillschweigend umgeht.
Deshalb würde ich einen Pilot als Betriebsprojekt planen, nicht als Softwaretest. Das Muster, das bei den meisten Teams funktioniert, mit denen ich spreche, ist das, wonach ohnehin gefragt wird: Die KI zuerst Antworten für Mitarbeitende entwerfen lassen und sie erst selbstständig Kunden antworten lassen, wenn die Entwürfe stimmen.
"The safest rollout I have seen is: let the agent draft, tag confidence plus reason, require approval for refunds or account changes, and review every reopened conversation for the first month. That review log is usually where the real automation boundary shows up."

Dieser Beitrag ist ein Ablaufplan für diese vier Wochen. Die Messseite (was auf die Scorecard kommt und wie man bewertet) finden Sie in der Scorecard für den KI-Support-Pilot. Die ausführlichere Testfolge vor dem Start steht unter Tests für KI-Support-Agenten.
Was vor Woche eins eingerichtet sein muss
Woche 0 sind ein paar Stunden Arbeit, verteilt auf einige Tage, und sie entscheidet, ob sich der Rest des Piloten überhaupt auswerten lässt. Fünf Dinge müssen stimmen, bevor die KI auch nur ein einziges Live-Ticket sieht.
- Eine verantwortliche Person, mit Namen. Sie macht die tägliche Prüfung, gibt Änderungen frei und kann eine Pause anordnen. In kleinen Teams ist das meist die Support-Leitung. Es sollte nicht dieselbe Person sein, die das Setup gebaut hat, aus demselben Grund, aus dem Zendesks eigener Testleitfaden empfiehlt: „select testers who aren't the same people who built your conversation flows.“
- Ausgangswerte. Die Zahlen des letzten Quartals für die Ticket-Typen im Umfang: Wochenvolumen, Zeit bis zur ersten Antwort, Quote wiedereröffneter bzw. erneuter Kontakte und auch, was ein von Menschen bearbeitetes Ticket Sie kostet. Der Leitfaden zu Kundenservice-KPIs zeigt, wie Sie sie ziehen.
- Schriftlich festgehaltene Bestehensgrenzen. Was am Ende gelten muss, damit Sie ausweiten. Ich würde die Schwellen und Ziele aus der Pilot-Scorecard übernehmen, statt neue zu erfinden, und sie dem Anbieter vor Tag eins schicken.
- Ein Routing-Plan. Welche Tickets in die KI-Queue gehen, welche identischen Tickets in einer rein menschlichen Kontroll-Queue bleiben und wie Sie beide taggen, damit Sie sie später herausziehen können. Mehr dazu weiter unten.
- Ein Pausenplan. Wer die KI abschalten kann, wo sich der Schalter in Ihrem Helpdesk befindet und was als Grund dafür gilt.
Sagen Sie Ihrem Support-Team dann, was passiert und was seine Aufgabe dabei ist. Mitarbeitende, die vom Pilot durch eine Kundenbeschwerde erfahren, behandeln die KI monatelang wie eine Bedrohung. Mitarbeitende, denen gesagt wird „Sie sind die Prüfer, und die KI übernimmt den Stapel mit den Bestellstatus-Anfragen“, werden Ihre beste Quelle für Fehlermeldungen. Eine Support-SOP für den Pilot (wer prüft, wann, wo man eine schlechte Antwort meldet) ist in zehn Minuten geschrieben und erspart viele Slack-Threads.
| Rolle im Pilot | Wer | Zeitaufwand |
|---|---|---|
| Pilot-Verantwortliche/r | Support-Leitung oder erfahrene/r Mitarbeiter/in, die/der das Setup nicht gebaut hat | 15 bis 20 Minuten pro Tag, plus wöchentlicher Bericht |
| Prüfer | 2 oder 3 Mitarbeitende, idealerweise auch eine neuere Person | 10 Minuten pro Tag und Person in Woche 1, danach weniger |
| Wissens-Pfleger | Wer Ihr Help Center verantwortet | Einige Korrekturen pro Woche, vor allem in Woche 1 und 2 |
| Eskalationskontakt | Jemand mit Befugnis für Erstattungen und Konten | Nur wenn eine Übergabe eine Entscheidung braucht |
Wie Sie die Tickets für einen KI-Support-Pilot auswählen
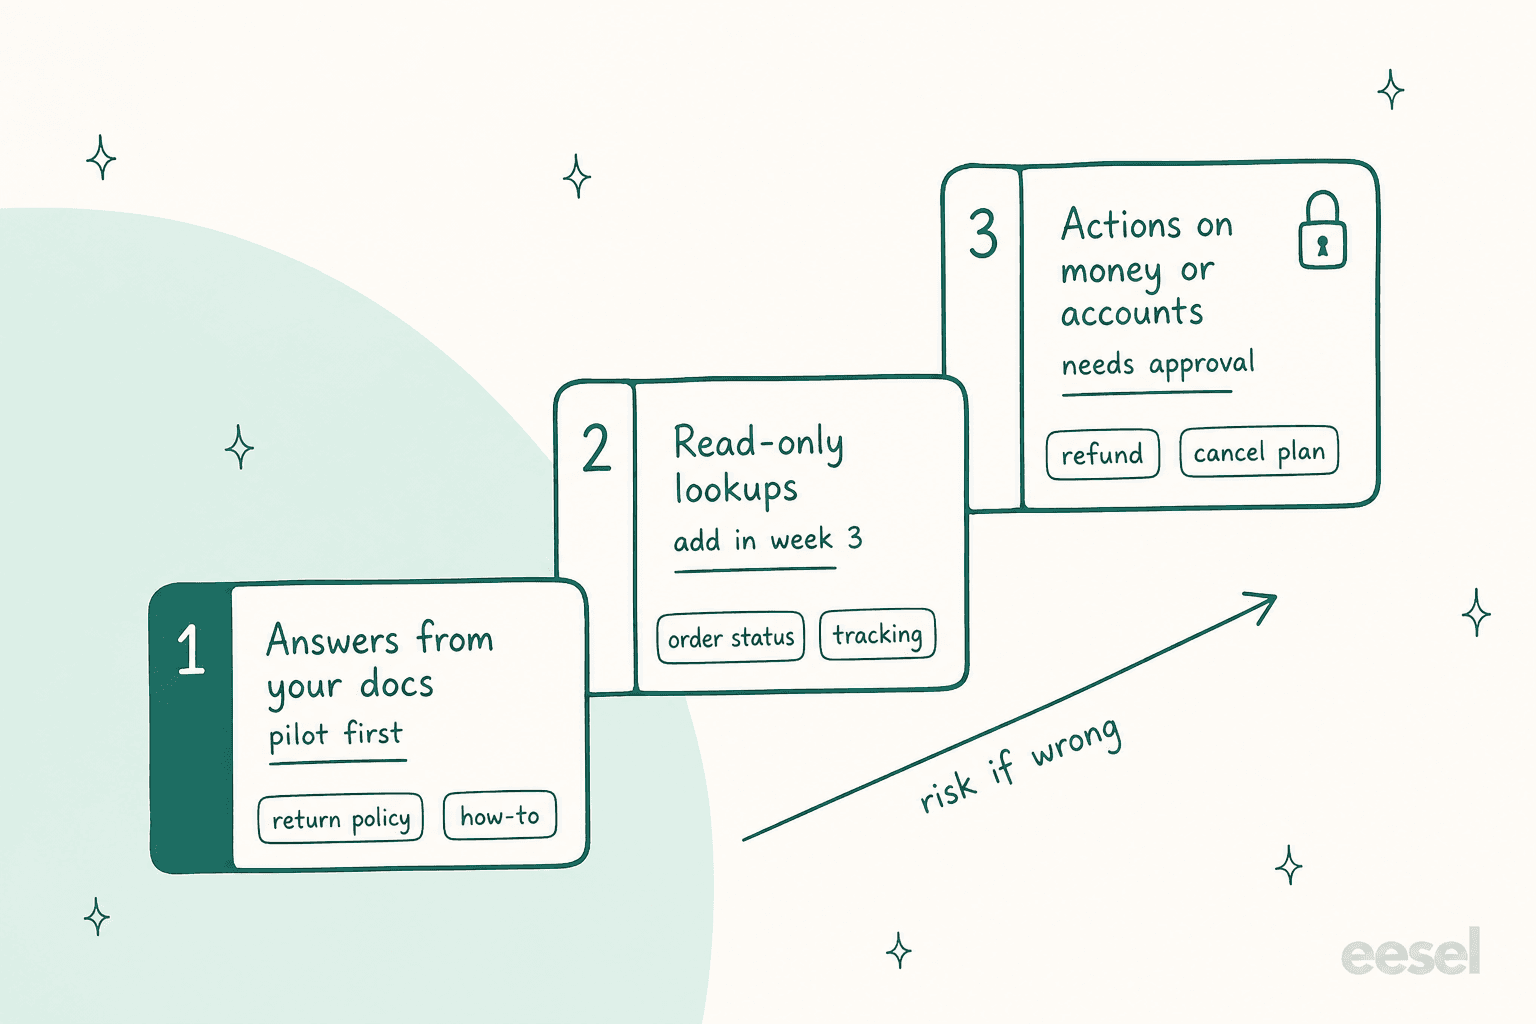
Die meisten Teams sortieren Pilotkandidaten nach Thema. Ich sortiere sie lieber danach, was die KI tun muss, um das Ticket zu schließen, denn dort sitzt das Risiko. Es gibt drei Arten:
- Antworten aus Ihren Dokumenten. Rückgaberichtlinie, Lieferzeiten, Anleitungsfragen. Liegt die KI hier falsch, bekommt ein Kunde einen falschen Satz, und die Lösung ist meist nur ein Artikel.
- Reine Leseabfragen. Bestellstatus, Sendungsverfolgung, Plandetails. Die KI liest ein System und meldet zurück, was sie gefunden hat. Falsch heißt hier, die falsche Bestellung oder den falschen Status zu lesen, was schlimmer ist, aber trotzdem nichts verändert.
- Aktionen mit Geld oder Konten. Erstattungen, Stornierungen, Adressänderungen, Kontobearbeitungen. Falsch heißt hier, dass bereits etwas passiert ist, das Sie nun rückgängig machen müssen.
Der Pilot startet mit der ersten Art und nimmt die zweite in Woche 3 dazu, wenn die tägliche Prüfung sauber ist; die dritte wartet bis nach dem Pilot, hinter einer Freigabe. Diese Aufteilung passt auch dazu, wie die Anbieter ihre eigenen Tests aufsetzen: Gorgias etwa lässt Aktionen in Testunterhaltungen standardmäßig ausgeschaltet, weil sie, wenn aktiviert, „can affect real customer and order data (like cancelling an order).“
Zwei weitere Filter gelten, bevor ein Ticket-Typ es schafft. Ihre Dokumente müssen ihn bereits beantworten (wenn nicht, ist das eine Aufgabe für die Analyse von Wissenslücken in Woche 0, kein Pilotergebnis). Und er braucht Volumen, denn eine Spur mit 15 Tickets pro Woche sagt Ihnen in einem Monat kaum etwas. Fragen zum Bestellstatus sind aus diesem Grund der übliche Favorit: hohes Volumen, eine Abfrage, geringes Risiko.
Ermessensentscheidungen (Beschwerden, Rückbuchungen, aufgebrachte Kunden) bleiben während des gesamten Piloten bei Menschen. Ein Praktiker hat die Messlatte gut formuliert:
"Splitting it by impact makes more sense to me. A slightly awkward response is one thing but anything involving pricing, refunds or account changes should have a much higher bar."
Eng ist in Ordnung. XAP, das Software für Studien- und Berufsvorbereitung entwickelt, startete sein eesel-Setup auf Freshdesk mit einem einzigen Ausschnitt: Tickets, in denen ein Student nach etwas fragt, das seine Hochschule oder eine staatliche Stelle regelt und das eine höfliche, korrekte Weiterleitung braucht. Ein Filter lässt nur diese Fälle (plus Passwort-Resets im Portal) durch, dann entwirft eesel die vollständige Antwort als interne Notiz aus der Textbaustein-Antwort des Teams, und eine Person sendet sie. In seiner Story heißt der Weiterleitungs-Agent „the first slice“, und der Filter wird erweitert, während das Team Weiterleitungsfälle für seine anderen Portale hinzufügt. Das ist eine gelungene Pilotspur: klein, beantwortbar und leicht zu prüfen.
Tragen Sie Ihre eigene Ticket-Mischung ein, um zu sehen, in welcher Spur jeder Typ landet und ob die Spur bis Ende von Woche 4 genug Volumen für ein Urteil hat.
Reicht die Spur nicht aus, nehmen Sie einen weiteren Antwort-Ticket-Typ dazu, bevor Sie den Kalender strecken. Ein längerer Pilot auf einer dünnen Spur gibt dem Umfang meist nur mehr Zeit zu wuchern.
Wie Sie KI-Queue und Kontroll-Queue in Ihrem Helpdesk trennen
Sie wollen dieselben Ticket-Typen auf demselben Kanal über dieselben Wochen auf zwei Arten bearbeiten: einen Teil durch die KI, einen Teil nur durch Menschen. Der Scorecard-Beitrag erklärt, warum die rein menschliche Kontroll-Queue für die Zahlen wichtig ist. Hier sehen Sie, wo die Steuerungen in jedem Helpdesk liegen, geprüft am 20. Oktober 2026 im Help Center des jeweiligen Anbieters.
| Helpdesk | KI-Spur eingrenzen mit | Kontroll-Queue halten durch | Pausieren durch |
|---|---|---|---|
| Zendesk | Kanäle pro KI-Agent; Trigger-Bedingungen eines E-Mail-Agenten | Ein zufälliges trafficSplit mit Kontrollgruppe, von Ihrem Account Manager aktiviert (A/B-Test), oder eine separate Support-Adresse | Kanal unter Manage channels abwählen |
| Freshdesk | Ticket-Quellen, „Deploy to internal teams“ oder eigene Regeln mit bis zu fünf Ebenen UND/ODER | Eine eigene Regel, die einen Teil der Spur ausschließt (ein Postfach, ein Kundenattribut) | Ein Limit unter Daily conversation limits oder den Agenten für diese Quelle deaktivieren |
| HubSpot | Ein Kanal pro Bereitstellung, Arbeitszeiten, Ein- und Ausschlusslisten bei E-Mail | Der Prozentwert Conversation coverage (der Rest geht an Menschen) | Die Zuweisung des Customer Agent ausschalten |
| Gorgias | AI Agent > Deploy pro Kanal, jeweils ein Skill | Einen Kanal oder Skill für die Spur ausgeschaltet lassen und vergleichen | Einen Skill ausschalten „without affecting others“ |
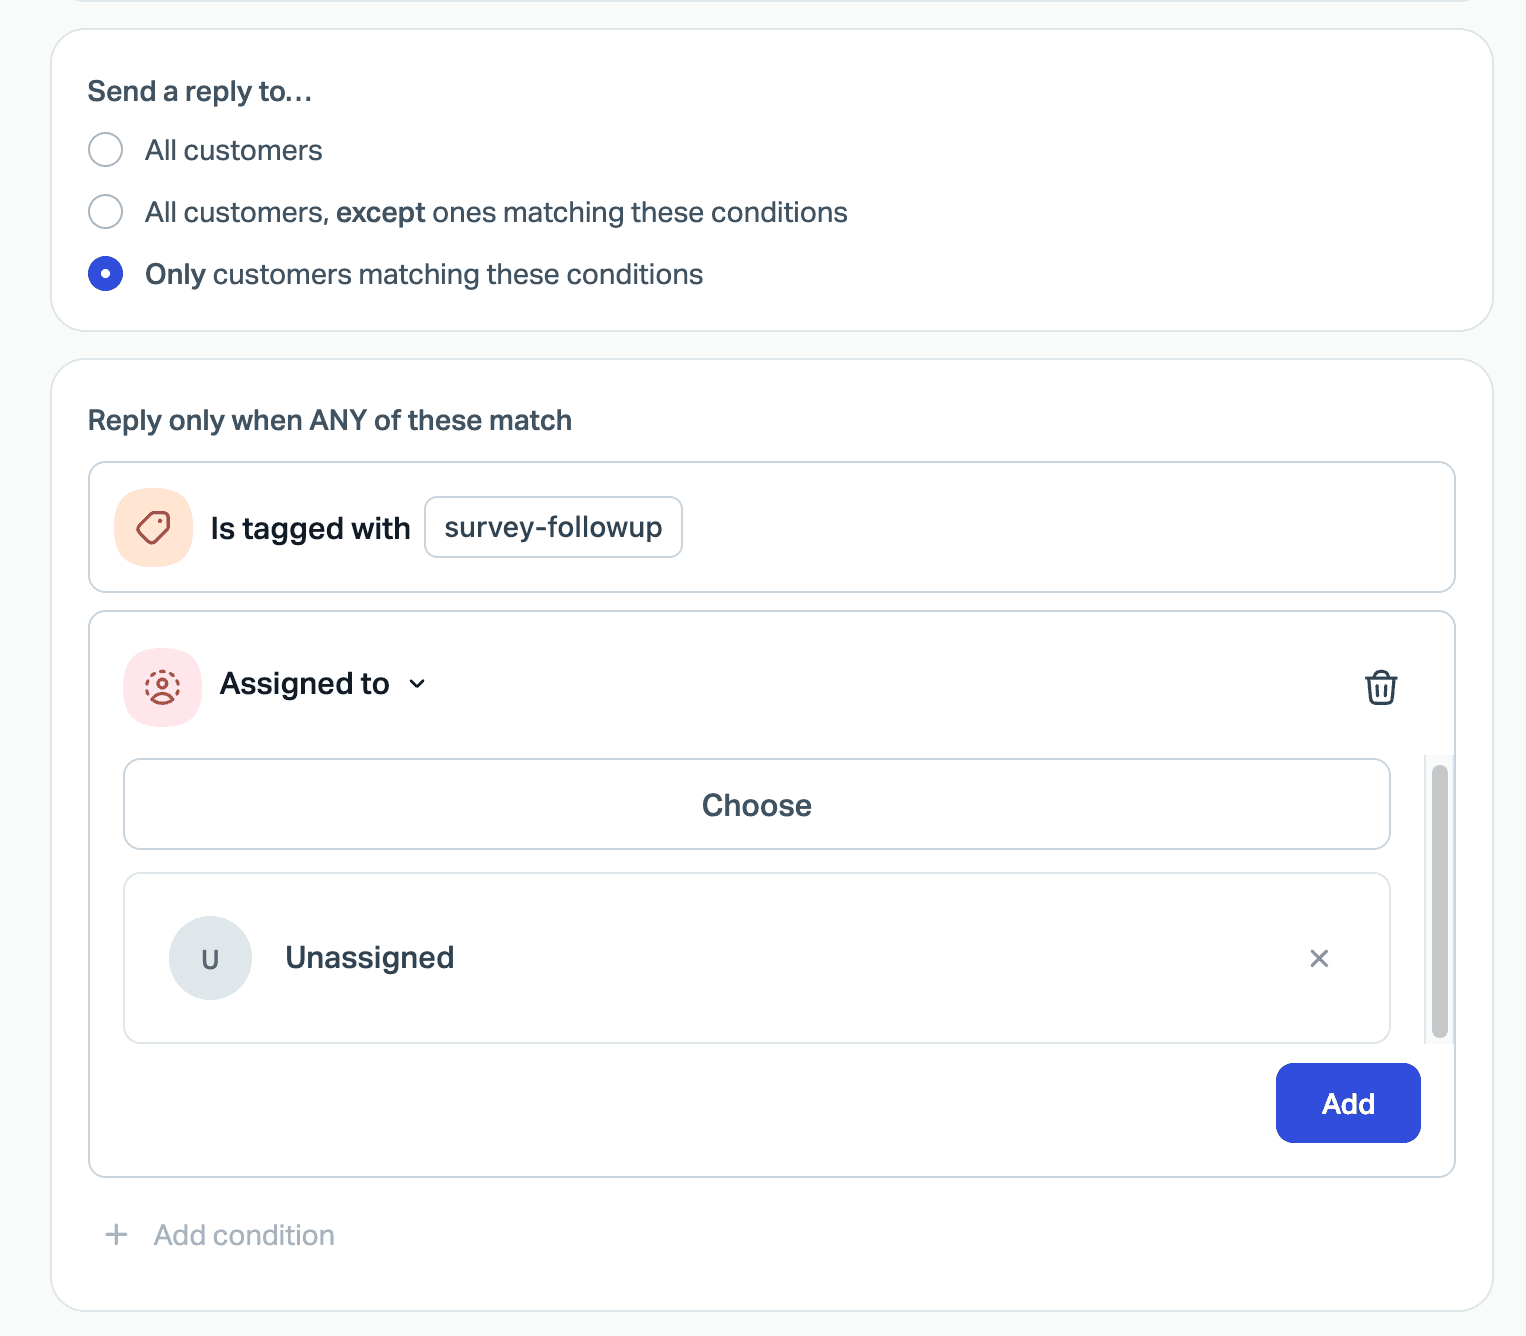
| Help Scout | Pro Beacon und Postfach; E-Mail lässt sich auf „Only customers matching these conditions“ begrenzen | Der Bereich „except ones matching these conditions“ im selben Postfach | Der Enable-Schalter pro Beacon oder Postfach |
Ein paar Details aus diesen Seiten, die für Ihr Setup einen Unterschied machen:
- Zendesk lässt pro Kanal nur einen KI-Agenten gleichzeitig laufen, und ein für Messaging gebauter Agent kann später nicht auf E-Mail umgestellt werden. Legen Sie zuerst den Kanal fest, bevor Sie bauen.
- Der Go-live von Freshdesk gilt nur nach vorn. Tickets, die vor der Bereitstellung eingingen, „are not retroactively answered“, sodass Tag eins des Piloten sauber beginnt.
- HubSpots eigener Rat passt zur Steigerung hier: mit „a single channel or limit it to a small percentage of conversations“ beginnen und dann Eskalationen und Wissenslücken prüfen, bevor Sie ausweiten. Bei einer Pause „it keeps existing chats but won't get new ones.“
- Gorgias bietet Inbox-Ansichten für Tickets, die die KI bearbeitet, die sie geschlossen hat und die sie übergeben hat, was im Grunde schon Ihre fertige Queue für die tägliche Prüfung ist.
Der Bedingungs-Editor von Help Scout zeigt gut, wie genau eine Spur werden kann: Die KI antwortet nur auf Tickets, die zu einem Tag oder einer Zuweisungsregel passen.
Egal welches Helpdesk: Taggen Sie beide Queues vom ersten Tag an (ai_pilot und ai_control funktionieren gut). Der Leitfaden zum KI-Support-Tagging sagt mehr zur Benennung. In Woche 4 wollen Sie beide Mengen in eine Tabelle ziehen, ohne vom Bericht des Anbieters abzuhängen.
Woche 1: Shadow-Modus, bevor ein Kunde etwas sieht
Shadow-Modus heißt: Die KI bearbeitet echte eingehende Tickets in Ihrer Spur, aber alles, was sie schreibt, ist ein Entwurf oder eine interne Notiz. Eine Person liest und bewertet es und sendet, bearbeitet oder verwirft es. Kunden sehen keinen Unterschied. Es birgt kein Kundenrisiko für Sie, und hier zeigen sich die meisten behebbaren Probleme.
Vor Beginn der Shadow-Woche würde ich die KI an Ihren vergangenen Tickets laufen lassen, damit Sie mit einem Score statt einer Vermutung starten. Die meisten Helpdesks bieten dafür inzwischen eine kostenlose Möglichkeit:
- Die E-Mail-AI-Agent-Auswertung von Freshdesk kann per Import tickets „to use solved historical tickets“ einlesen, bis zu 50 Anfragen pro Durchlauf, und Freshworks empfiehlt „at least 20 representative queries before deploying.“ Die Vorschau „does not affect live conversations or consume message limits.“
- Das Batch-Testing von HubSpot baut Testfragen aus Themen Ihrer Live-Unterhaltungen, und Vorschau oder Test verbrauchen keine HubSpot Credits.
- Die Testunterhaltungen von Gorgias „are free to use“ und können „an existing ticket“ nachspielen, jeweils eines.
- Zendesks Sandbox, Test-Widget und Konversationssimulator verbrauchen keine automatisierten Lösungen, ein in der Produktion getesteter E-Mail-Agent aber schon. Der Leitfaden zum Freshdesk-Sandbox-Setup behandelt das Gegenstück auf der Freshdesk-Seite.
Lassen Sie die Prüfer in der Shadow-Woche jeden Entwurf auf eine von drei Arten bewerten: unverändert senden, mit Änderungen senden oder falsch. Halten Sie zu jedem „falsch“ eine kurze Notiz fest. Bis Freitag haben Sie eine Liste, und diese Liste ist Ihr Korrekturplan für Woche 2. Mischen Sie auch bewusst unbequeme Tickets dazu, die aufdringliche Sorte „Sie liegen falsch, erstatten Sie mir das“; der Leitfaden zu Adversarial Testing hat ein Set zum Ausleihen.
Rechnen Sie zu Beginn mit vielen „mit Änderungen senden“ und lassen Sie sich davon nicht beunruhigen. Bei der Testphase eines Juweliers auf eesel betrafen die meisten Änderungen, die Mitarbeitende an Entwürfen vornahmen, Länge und Ton, also das, was sich verbessert, sobald die KI aus den gesendeten Antworten des Teams lernt. Änderungen, die einen sachlichen Fehler behoben, machten nur einen kleinen Anteil aus. Das ist ein ganz anderer Befund als „die KI liegt falsch“, und Sie sehen ihn nur, wenn Prüfer sagen, warum sie bearbeitet haben.
Der Ausgangstest für Woche 1 ist einfach: Der Stapel „falsch“ ist klein, und zu jedem Eintrag gibt es entweder eine Korrektur, die Sie vorgenommen haben, oder einen Grund, warum der Ticket-Typ die Spur verlassen sollte.
Woche 2 und 3: auf einem Ausschnitt live gehen, dann ausweiten
In Woche 2 beginnt die KI, Kunden zu antworten, aber nur auf einem Teil der Spur. Ich würde mit 10 bis 20 % starten. Das Coverage-Feld von HubSpot macht das direkt, bei anderen Helpdesks erreichen Sie es mit einer Regel für ein Kundenattribut oder ein Postfach. Der Rest der Spur bleibt bei Menschen und dient zugleich als Kontroll-Queue.
Drei Regeln für diese beiden Wochen:
- Erst nach einer sauberen Phase ausweiten. War die tägliche Prüfung drei oder vier Arbeitstage lang sauber, gehen Sie in Woche 3 von etwa 20 % auf etwa die Hälfte. War sie es nicht, bleiben Sie, wo Sie sind, und beheben zuerst die Probleme.
- Immer nur eine Sache ändern und das Datum festhalten. Eine ausgeweitete Spur und eine neue Anweisung am selben Tag bedeuten, dass Sie nicht sagen können, was die Zahlen bewegt hat. Swiftreg, das private Kfz-Kennzeichen in Großbritannien verkauft, führt seine eesel-Support-Anweisungen als nummerierte Releases, die nach eigenem Verfahren ausgerollt statt live bearbeitet werden. Das ist mehr Prozess, als die meisten Piloten brauchen, aber die Gewohnheit (jede Änderung hat eine Version und ein Datum) ist die richtige.
- Reine Leseabfragen vor Aktionen dazunehmen. War Woche 2 bei reinen Antwort-Tickets sauber, können in Woche 3 Bestellstatus und Sendungsverfolgung dazukommen. Aktionen bleiben aus.
Machen Sie den Weg „mit einer Person sprechen“ vom ersten Live-Tag an offensichtlich. Kunden, die feststecken und keinen Menschen finden, tauchen in den meisten Dashboards nicht als Fehler auf, sondern als abgebrochene Unterhaltungen oder verärgerte Tickets auf einem anderen Kanal. Die Checkliste zur Übergabe von KI-Agenten zeigt, was eine Übergabe enthalten sollte, damit Ihr Mitarbeiter nicht erneut fragen muss.
Zur Offenlegung: Ich würde Kunden sagen, dass sie mit einer KI sprechen. Swiftreg beendet jede öffentliche KI-Antwort mit einer Fußzeile, die besagt, dass der AI Support Assistant sie geschrieben hat und sie Fehler enthalten kann, und der Live-Chat von HubSpot zeigt „Powered by AI“ im Header, solange der Customer Agent zugewiesen ist. Das setzt Erwartungen und macht eine falsche Antwort leichter verzeihlich.
Die tägliche QA-Prüfung, die Ihren Pilot entscheidet
Das ist die Gewohnheit, die Piloten mit einer klaren Entscheidung von Piloten trennt, die in einem Streit enden. Fünfzehn Minuten, jeden Tag zur gleichen Zeit, von der Shadow-Woche bis zum Ende von Woche 4.
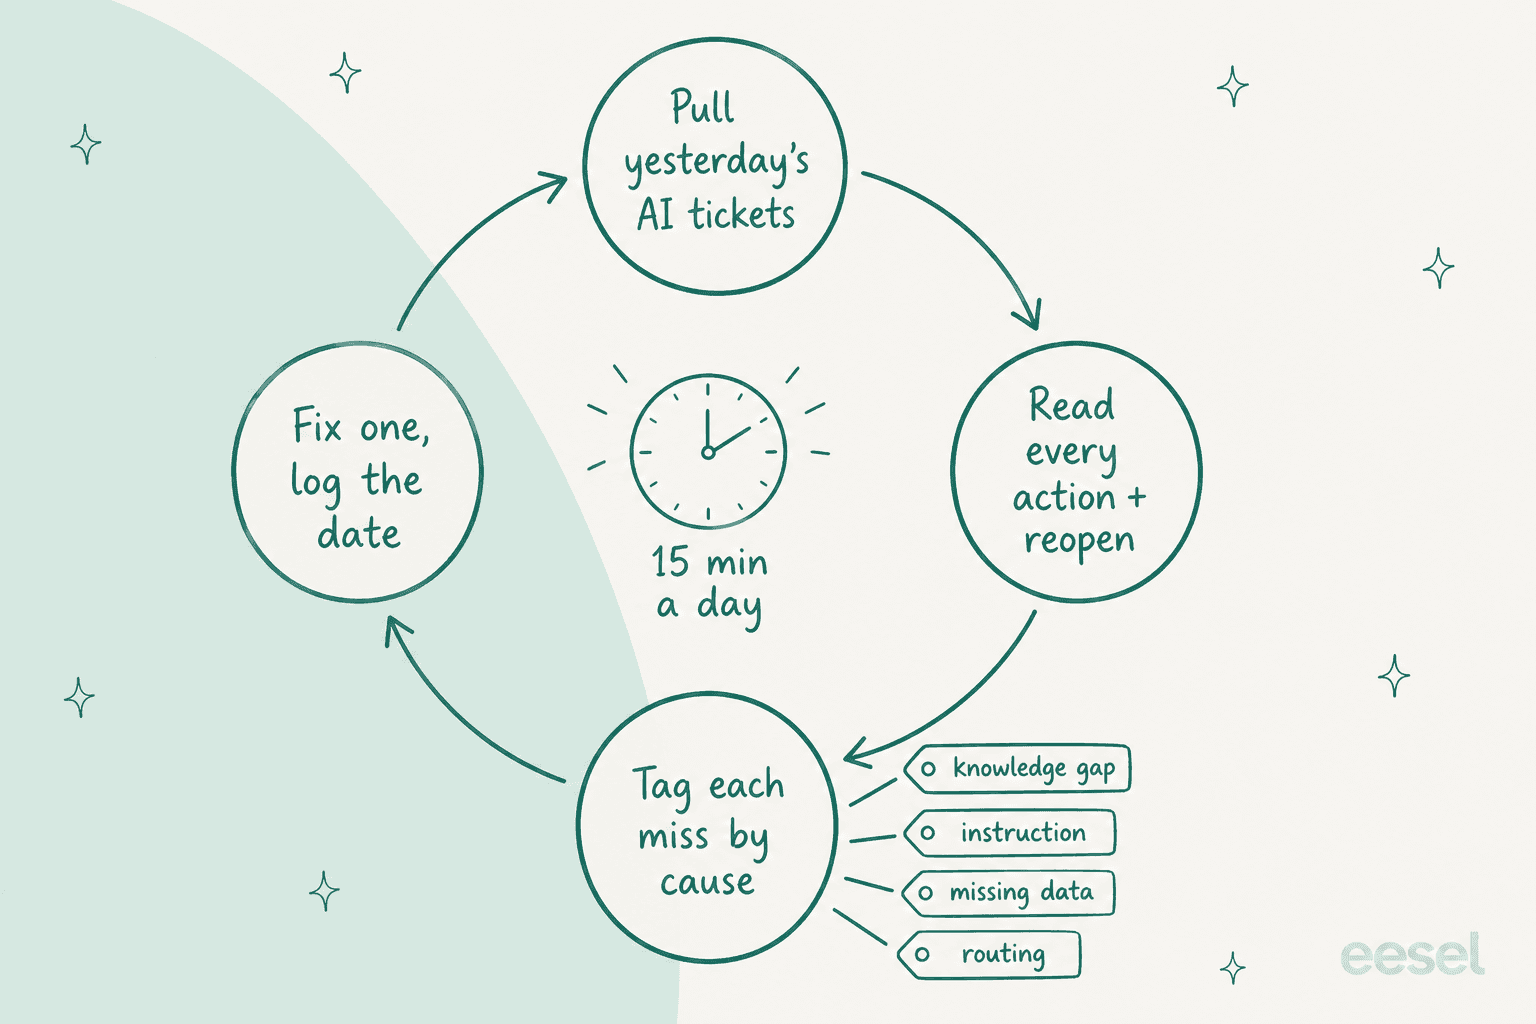
Was in diese fünfzehn Minuten gehört:
- Jede Aktion, die die KI ausgeführt hat, sofern welche eingeschaltet sind. Lesen Sie das Protokoll, nicht nur die Antwort. Eine Antwort kann perfekt klingen und trotzdem auf der falschen Bestellnummer beruhen.
- Jede wiedereröffnete oder erneut kontaktierte Unterhaltung aus der KI-Queue. Das sind die Fehler, die das Dashboard als Erfolge zählt.
- Jede Übergabe. Hat der Mensch genug erhalten, um ohne erneutes Nachfragen weiterzumachen?
- Eine Stichprobe aus dem Stapel „gelöst“, 10 bis 20 pro Tag. Gorgias empfiehlt, in der ersten Woche als Teil des Go-live „at least 10 tickets that AI Agent handled“ zu prüfen; dieses Tempo würde ich für den ganzen Pilot beibehalten.
Taggen Sie dann jeden Fehler nach seiner Ursache, denn jede Ursache hat eine andere Lösung und auch einen anderen Verantwortlichen:
| Ursache des Fehlers | Wie es aussieht | Die Lösung | Wer behebt es |
|---|---|---|---|
| Wissenslücke | Aus einem veralteten oder fehlenden Artikel geantwortet („we support all models“) | Artikel bearbeiten oder ergänzen; das Thema neu testen | Verantwortliche/r für das Help Center (Audit der Wissensdatenbank) |
| Anweisung | Richtige Fakten, falsches Verhalten: zu lang, falscher Ton, keine Übergabe | Eine Regel ergänzen oder schärfen | Pilot-Verantwortliche/r |
| Fehlende Daten | Brauchte eine Bestellung, ein Konto oder ein System, das sie nicht sehen kann | Die Quelle anbinden oder den Ticket-Typ aus der Spur nehmen | Wer die Integration verantwortet |
| Routing | Ein Ticket, das nicht in die Spur gehörte, ist dort gelandet | Filter oder Trigger enger fassen | Helpdesk-Admin |
Führen Sie ein gemeinsames Änderungsprotokoll mit drei Spalten: Datum und was sich geändert hat, dann warum. Zendesks Testleitfaden empfiehlt dasselbe für Tester, eine gemeinsame Datei, um zu „track whether a resolution has been implemented.“ Wenn sich in Woche 3 eine Zahl bewegt, sagt Ihnen das Protokoll, ob es der Artikel war, den Sie am Dienstag korrigiert haben, oder die Spur, die Sie am Mittwoch ausgeweitet haben. Sind sich zwei Prüfer uneins, ob eine Antwort „falsch“ war, klärt eine kurze QA-Kalibrierung den Bewertungsmaßstab, bevor die Uneinigkeit zu Rauschen in Ihren Ergebnissen wird.
Die Person, die diese Prüfung verantwortet, muss nicht technisch sein. Bei Norden-Frisia, einer deutschen Fährlinie zu den Nordseeinseln, betreibt Support-Leiterin Frauke Hagen das eesel-Setup allein: Sie prüft den Konversationsverlauf, fragt nach, wenn eine Antwort den FAQs widerspricht, und überträgt Korrekturen selbst vom Zendesk-Bot in den Chatbot. Ihre Testphase dauerte nur eine Woche, und das Training mit vergangenen Tickets gab den Ausschlag für das Abonnement.
"I think the key is testing the decision separately from the conversation. An agent can have a perfectly polite chat and still issue a refund it wasn't allowed to. If it has to state which policy and limit it applied before it takes any action, you can check that against the rule instead of reading through transcripts."
Wann man einen KI-Support-Pilot mittendrin pausiert
Legen Sie die Pausenregeln in Woche 0 fest, damit niemand an einem schlechten Dienstag darüber streiten muss. Ich würde die KI-Queue noch am selben Tag pausieren, wenn eines davon passiert:
- Eine falsche Aktion hat einen Kunden erreicht: eine Erstattung auf die falsche Bestellung, eine Änderung am falschen Konto.
- Die KI hat eine Richtlinie genannt, die es nicht gibt, oder etwas versprochen, das Ihr Team nicht liefern kann.
- Der Anteil der Kunden, die einen Menschen verlangen, springt im Vergleich zu den Vortagen.
- Eine Richtlinie hat sich geändert und das Wissen hinkt hinterher. Eine neue Rückgabefrist, neue Preise oder ein Ausfall. Pausieren Sie, bis die Artikel aktualisiert sind, und testen Sie das Thema dann neu. Der Leitfaden zum Management von Richtlinienänderungen hat dafür eine Checkliste.
Eine Pause ist günstig, wenn Sie wissen, wo der Schalter sitzt. Bei Zendesk geschieht sie durch Abwählen des Kanals, es gibt keine eigene Pause-Taste.
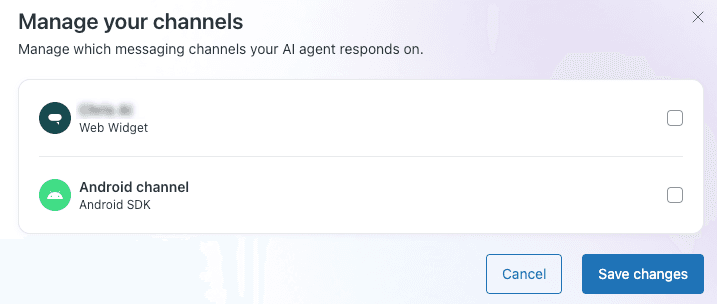
HubSpot lässt Sie „manually pause customer agent assignment by turning it off“, was es empfiehlt „when updating or reviewing content sources or making changes to the agent's configuration.“ Das Tageslimit von Freshdesk ist die sanftere Bremse: „Conversations continue to arrive but the AI stops replying once the limit is reached.“ Welche Sie auch nutzen: Eine Pause bedeutet keinen gescheiterten Pilot. Halten Sie sie mit Datum und Grund fest, führen Sie eine kurze Fehleranalyse zur Ursache durch und starten Sie die Uhr für diese Spur neu, sobald das behoben ist.
Woche 4 und danach: ausweiten, neu testen oder stoppen
Woche 4 ist eine Haltewoche. Keine neuen Ticket-Typen und keine Änderungen an der Abdeckung, auch keine neuen Anweisungen, außer etwas ist akut kaputt. Sie lassen die letzten Änderungen sich setzen, damit die letzte Woche ein stabiles Setup widerspiegelt. Setzen Sie den Entscheidungstermin dann eine Woche nach Pilotende an, denn die Auflösungsfenster der Anbieter und Ihre eigene Prüfung auf erneute Kontakte brauchen etwas Zeit, bis sie zu Ende gezählt haben (die Scorecard erklärt den Zeitablauf).
Die Entscheidung selbst ist eine von dreien, und jede bedeutet für den nächsten Monat etwas Konkretes:
| Entscheidung | Wann | Was Sie als Nächstes tun |
|---|---|---|
| Ausweiten | Schwellen gehalten und Ziele auf der Spur erreicht | Eine Stufe höher: den nächsten Antwort-Ticket-Typ, reine Leseabfragen oder einen weiteren Kanal hinzufügen. Eines nach dem anderen, mit derselben täglichen Prüfung |
| Korrigieren und neu testen | Sicher, aber unter dem Ziel | Die häufigsten Ursachen aus Ihrem Änderungsprotokoll abarbeiten, die Wiedergabe vergangener Tickets erneut laufen lassen, dann zwei weitere Wochen auf derselben Spur |
| Stoppen | Eine Schwelle wurde verfehlt, oder Kunden kamen häufiger zurück als in der Kontroll-Queue | Die bereinigten Artikel und die Ticket-Tags behalten, den Grund festhalten und entscheiden, ob ein anderes Tool oder eine schmalere Spur einen zweiten Pilot wert ist |
Beim „Ausweiten“ wollen die meisten Teams direkt zu Erstattungen springen. Ich würde Aktionen noch einen Zyklus zurückhalten und sie zuerst über Freigabe-Workflows laufen lassen: Die KI bereitet die Erstattung vor, eine Person gibt sie frei, und Sie zählen, wie oft die Person widerspricht. Liegt diese Zahl einige Wochen lang nahe null, können Routineaktionen von selbst laufen. Große Erstattungen, Rückbuchungen und alles über den Grenzen Ihrer Matrix für Erstattungsfreigaben bleibt bei Menschen.
Fehler, die ich bei KI-Piloten sehe
- Keine benannte verantwortliche Person. Die tägliche Prüfung wird zu „wer gerade Zeit hat“, und das ist bis Donnerstag niemand.
- Die schwersten Tickets pilotieren, um „es richtig zu testen“. Sie lernen, dass schwere Tickets schwer sind. Starten Sie dort, wo die KI gewinnen kann, und weiten Sie von da aus.
- Alle Kanäle auf einmal. Eine schlechte Woche auf Chat und E-Mail zusammen lässt sich auf keinen von beiden zurückführen.
- Drei Dinge an einem Tag ändern. Sie können nicht sagen, welches geholfen oder welches die Rückgaben kaputt gemacht hat.
- Die Kontroll-Queue weglassen, weil das Vorher-Nachher offensichtlich aussieht. Ticket-Mix und Saisonalität verändern sich ebenfalls.
- Das Dashboard des Anbieters lesen statt der Tickets. Das Dashboard sagt Ihnen, wie viele Unterhaltungen endeten, nicht ob sie richtig waren. Die längere Liste steht unter Fehler bei der Einführung von KI im Kundenservice.
Führen Sie Ihren KI-Support-Pilot mit eesel durch
eesel ist ein KI-Helpdesk-Teammitglied, das in Ihre bestehende Queue in Zendesk, Freshdesk, Gorgias, HubSpot und weiteren einsteigt und so gebaut ist, dass man es wie in diesem Beitrag beschrieben pilotieren kann:
- Score in Woche 0 aus Ihrer eigenen Historie. Der Simulation-Skill lässt Ihren Agenten gegen echte vergangene Tickets laufen und bewertet jede Antwort gegen das, was Ihr Team gesendet hat, und schlägt dann Änderungen an den Anweisungen vor. Es wird nichts an Kunden gesendet.
- Shadow-Modus als Standard. Es startet mit Entwürfen: Jede Antwort ist ein Entwurf oder eine interne Notiz, die eine Person sendet. Sie lassen es die einfachen Fälle von Anfang bis Ende beantworten, wenn Sie bereit sind, und können jederzeit alles wieder ausschalten.
- Aktionen hinter Freigabe. Jede Aktion ist Auto, Needs approval oder Disabled, und Freigaben laufen nie von selbst nach einem Timeout durch. Erstattungen können während des gesamten Piloten auf Needs approval bleiben.
- Eine tägliche Prüfung, die bereits angelegt ist. Die Seite Activity listet jedes bearbeitete Ticket, was gesucht wurde, jede Aktion und wer sie freigegeben hat, samt Begründung. Wenn Sie es im Chat neben einem Lauf korrigieren, wird die Korrektur zu einer Regel in den Anweisungen, sodass die Korrektur auch nächste Woche noch gilt.

Die Preise sind ein fester Monatsplan, bei dem ein Ticket oder ein Chat 1 Credit kostet: kostenlos für 100 Credits ohne Karte, danach ab $299/month für 500 Credits. Der kostenlose Plan reicht, um die Entwürfe an Ihren eigenen Tickets zu sehen, bevor Sie sich auf irgendetwas festlegen. Wenn Sie einen Pilot mit irgendeinem Anbieter starten wollen, lassen Sie zuerst die Simulation von eesel auf Ihrer Queue laufen und bringen Sie den Bericht in den Vergleich ein. eesel ausprobieren.