

Was macht ein Support-Team KI-first?
Ich baue bei eesel die Helpdesk-Integrationen und sehe bei fast jedem Rollout dasselbe Muster: Der technische Teil dauert Tage, der organisatorische Monate. Die KI kann die Queue am ersten Tag lesen. Was sie nicht entscheiden kann, ist, wer die Antwort verantwortet, wenn sie falsch ist.
Ein KI-first Team ist eines, in dem die KI bei der Arbeit, die sie gut beherrscht, die erste Antwort gibt und die Menschen um das herum organisiert sind, was die KI nicht allein kann: Ermessensentscheidungen, Systemkorrekturen und das Wissen, das die KI liest. Das ist ein anderes Organigramm als "Agenten plus Chatbot". Im März 2026 bat uns ein Support-Manager in seiner Nachricht um eine Anwendung, die "handle 60% of the incoming zendesk tickets and know when to pull a real person in for better analysis and resolution." Beide Hälften dieses Satzes sind die Aufgabe. Die meisten Teams besetzen die erste Hälfte und vergessen die zweite.
Unsere Demo-Gespräche haben mir das Einführungsmuster gezeigt, nach dem ich heute plane: Teams beginnen damit, dass die KI Antworten für Agenten vorformuliert, und wechseln zur vollen Automatisierung, sobald Vertrauen da ist. Ich habe den Rest dieses Leitfadens um diese Reihenfolge herum geschrieben, weil sie den Kontakt mit einer echten Queue übersteht.
Wer verantwortet was, wenn die KI zuerst antwortet?
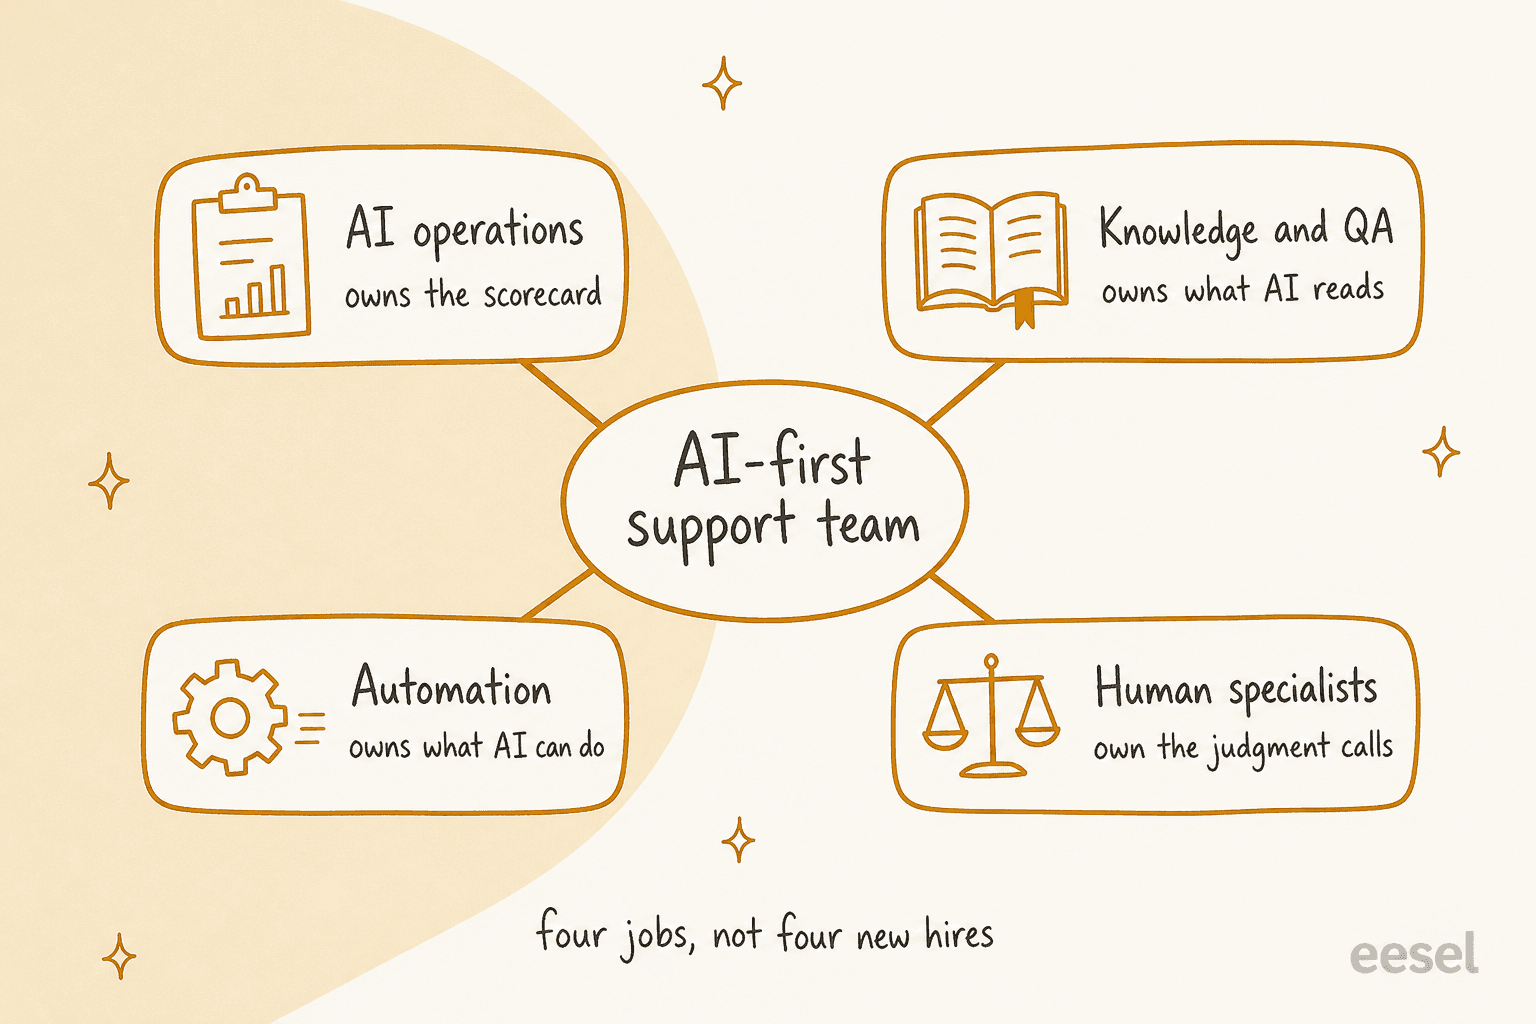
Vier Verantwortlichkeiten decken fast alles ab. Es sind Aufgaben, keine Stellen: In einem kleinen Team hält eine Person zwei davon, in einem großen bekommt jede eine kleine Gruppe.
| Aufgabe | Verantwortet | Eine Kennzahl, an der man sie misst | Wer sie meist übernimmt |
|---|---|---|---|
| KI-Betrieb | Die Scorecard, die Lanes und die Entscheidung, zu erweitern oder zurückzunehmen | Rate verifizierter Lösungen | Die Support-Leitung |
| Wissen und QA | Jeden Artikel, jedes Makro und jede Richtlinie, die die KI liest, plus die Prüfung ihrer Antworten | Antwortgenauigkeit in einer wöchentlichen Stichprobe | Ein erfahrener Agent |
| Automatisierung | Was die KI tun darf: Abfragen, Tags, Rückerstattungen, Berechtigungen, Audit-Logs | Erfolgreich abgeschlossene Aktionen | Eine technische Person, oft mit der Technik geteilt |
| Menschliche Spezialisten | Ermessensentscheidungen, verärgerte Kunden, Ausnahmen und die Korrekturen, die die KI nicht vornehmen kann | CSAT bei übergebenen Gesprächen | Deine bestehenden Agenten |
Die Wissensaufgabe wird von Teams am meisten unterschätzt. Ein IT-Dienstleister aus dem öffentlichen Sektor sagte uns, dass in dem Jahr zwei erfahrene Agenten gehen würden und er ihr Wissen in der KI festhalten wollte, bevor sie gehen. Das ist ein Problem der Wissensverantwortung, kein Tool-Problem, und der Leitfaden zur Bewahrung von Support-Wissen zeigt, wie man das macht, bevor die Leute gehen. Wenn deine Artikel veraltet sind, ist die KI im großen Maßstab selbstsicher falsch. Deshalb mache ich zuerst ein Audit der Wissensdatenbank und danach jeden Monat eine Wissenslücken-Analyse.
Die Automatisierungsaufgabe ist die leise. Alles, was die KI nachschlagen oder ändern kann, ist eine Berechtigung, die jemand erteilt hat. Beginne rein lesend (Bestellstatus, Tarifdetails) und füge Schreibaktionen wie Rückerstattungen erst hinzu, wenn Berechtigungen, Freigaben und ein Audit-Log existieren. Wenn du auch die Personalseite abwägst, behandelt ein Kundenservice-Team aufbauen die menschlichen Grundlagen, die dieser Leitfaden voraussetzt.
Welche Tickets soll die KI bearbeiten, und welche bleiben menschlich?
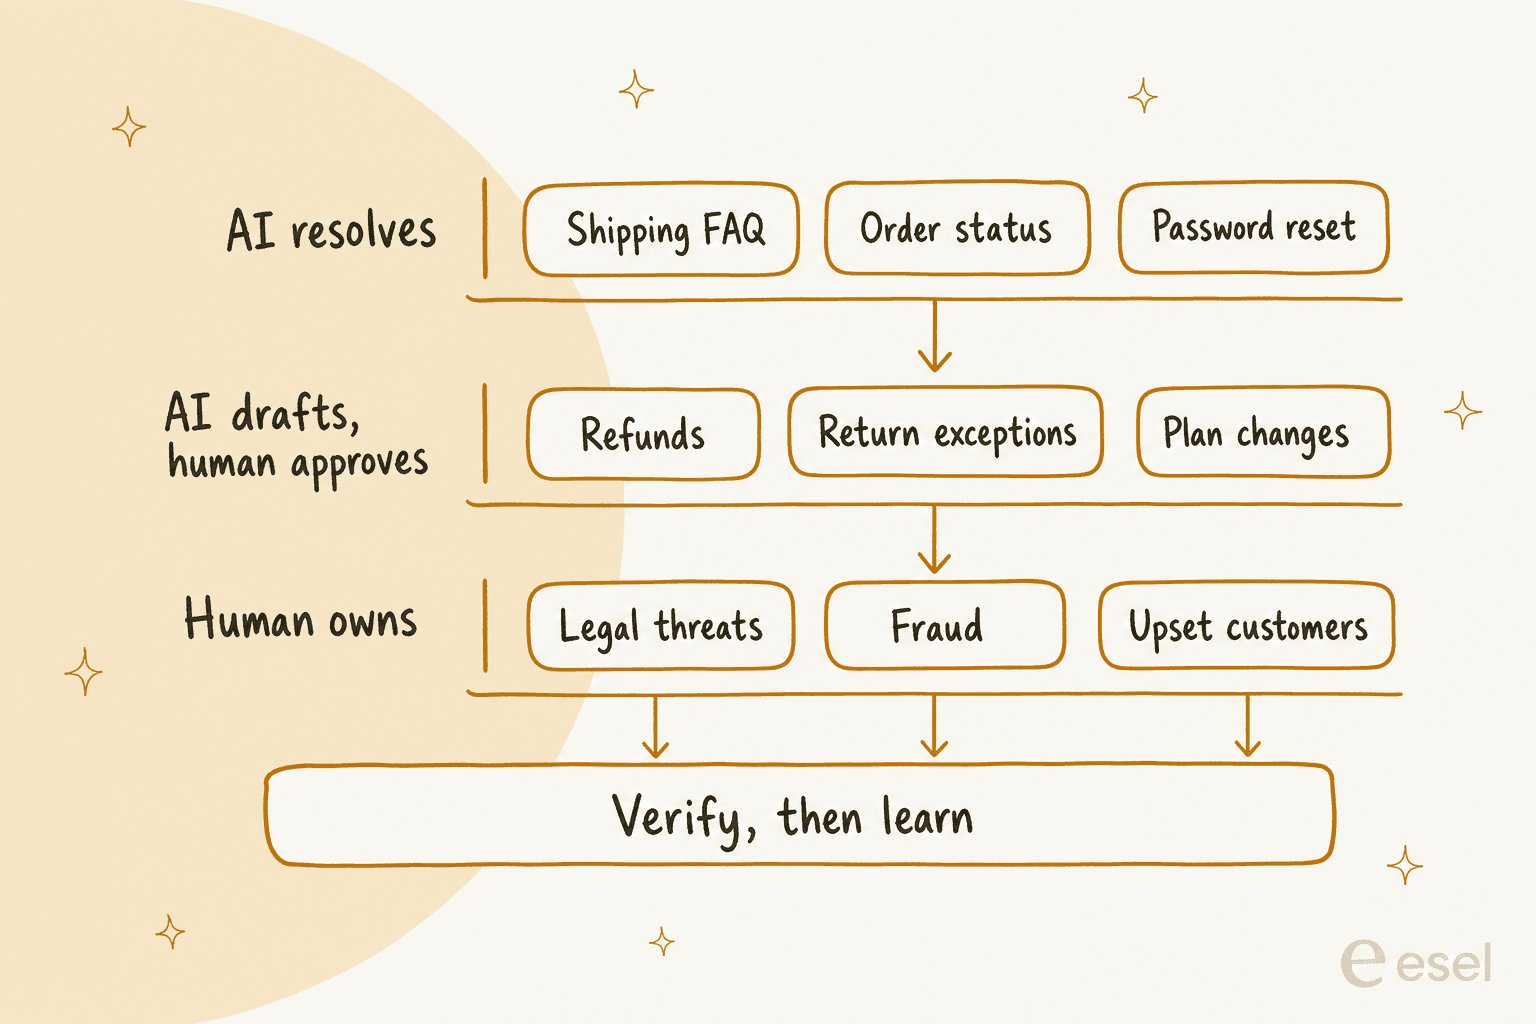
Sortiere nach Risiko, nicht nach Thema. Eine Rückerstattungsfrage und eine Versandfrage sind beide "Bestellprobleme", aber die eine bewegt Geld und die andere nicht.
| Tickettyp | Lane | Warum |
|---|---|---|
| Versand- und Richtlinien-FAQs | Die KI löst | Die Antwort steht schon in deinem Help Center |
| Sendungsverfolgung | Die KI löst | Rein lesende Abfrage, geringe Auswirkung |
| Fragen zu Passwort und Zugang | Die KI löst, bei fehlgeschlagener Prüfung Übergabe | Self-Service-Link, klare Rückfalloption |
| Rücksendungen innerhalb der Richtlinie | Die KI formuliert vor, eine Person gibt frei, später sendet die KI | Die Richtlinie ist klar, aber es geht um echtes Geld |
| Rückerstattungen | Die KI formuliert vor, eine Person gibt frei | Braucht einen benannten Freigeber und ein schriftliches Limit |
| Kundenbeschwerden | Eine Person verantwortet | Ton und Urteilsvermögen entscheiden über das Ergebnis |
| Zahlungsstreitigkeiten, Recht, Betrug | Eine Person verantwortet | Die Kosten einer falschen Antwort sind weit höher als die einer langsamen |
Das ist eine Ausgangsposition, kein Gesetz. Dein Rückerstattungslimit, deine VIP-Regeln und deine regulierten Themen werden Zeilen zwischen den Lanes verschieben. Entscheidend ist, dass jeder Tickettyp genau eine Lane und einen benannten Verantwortlichen hat, schriftlich festgehalten vor dem Start. Probiere den Sortierer unten aus, um zu sehen, wie die Regel für jeden Typ lautet.
*Wähle einen Tickettyp, um seine Lane, seinen Verantwortlichen und die Regel zu sehen, die ich vor dem Start schreiben würde.*Zwei Details machen die Lanes in der Software real. Erstens: Route mit Tags oder Feldern, die dein Helpdesk schon versteht, damit die Lane am Ticket sichtbar ist und nicht in einem Prompt versteckt; die Leitfäden zu Ticket-Triage und Ticket-Klassifizierung zeigen, wie. Zweitens: Gib der KI eine ausdrückliche Stoppbedingung für die Lane in menschlicher Hand. Der Glossareintrag zu KI-Guardrails ist eine brauchbare Checkliste dafür, was man schriftlich verbieten sollte.
Wie sieht eine echte Queue mit drei Lanes aus?
Rúngne, eine norwegische Marke für Kletterbekleidung, ist das klarste Beispiel, das ich dafür habe, wie sich Lanes in Agenten verwandeln. Sie betreibt Gorgias für E-Mail, Live-Chat und Social-Kommentare, und ihre Chief Operating Officer Jasmin Villasoto hat einen Alleskönner-Agenten innerhalb einer Woche in drei Agenten mit je einer Aufgabe aufgeteilt.
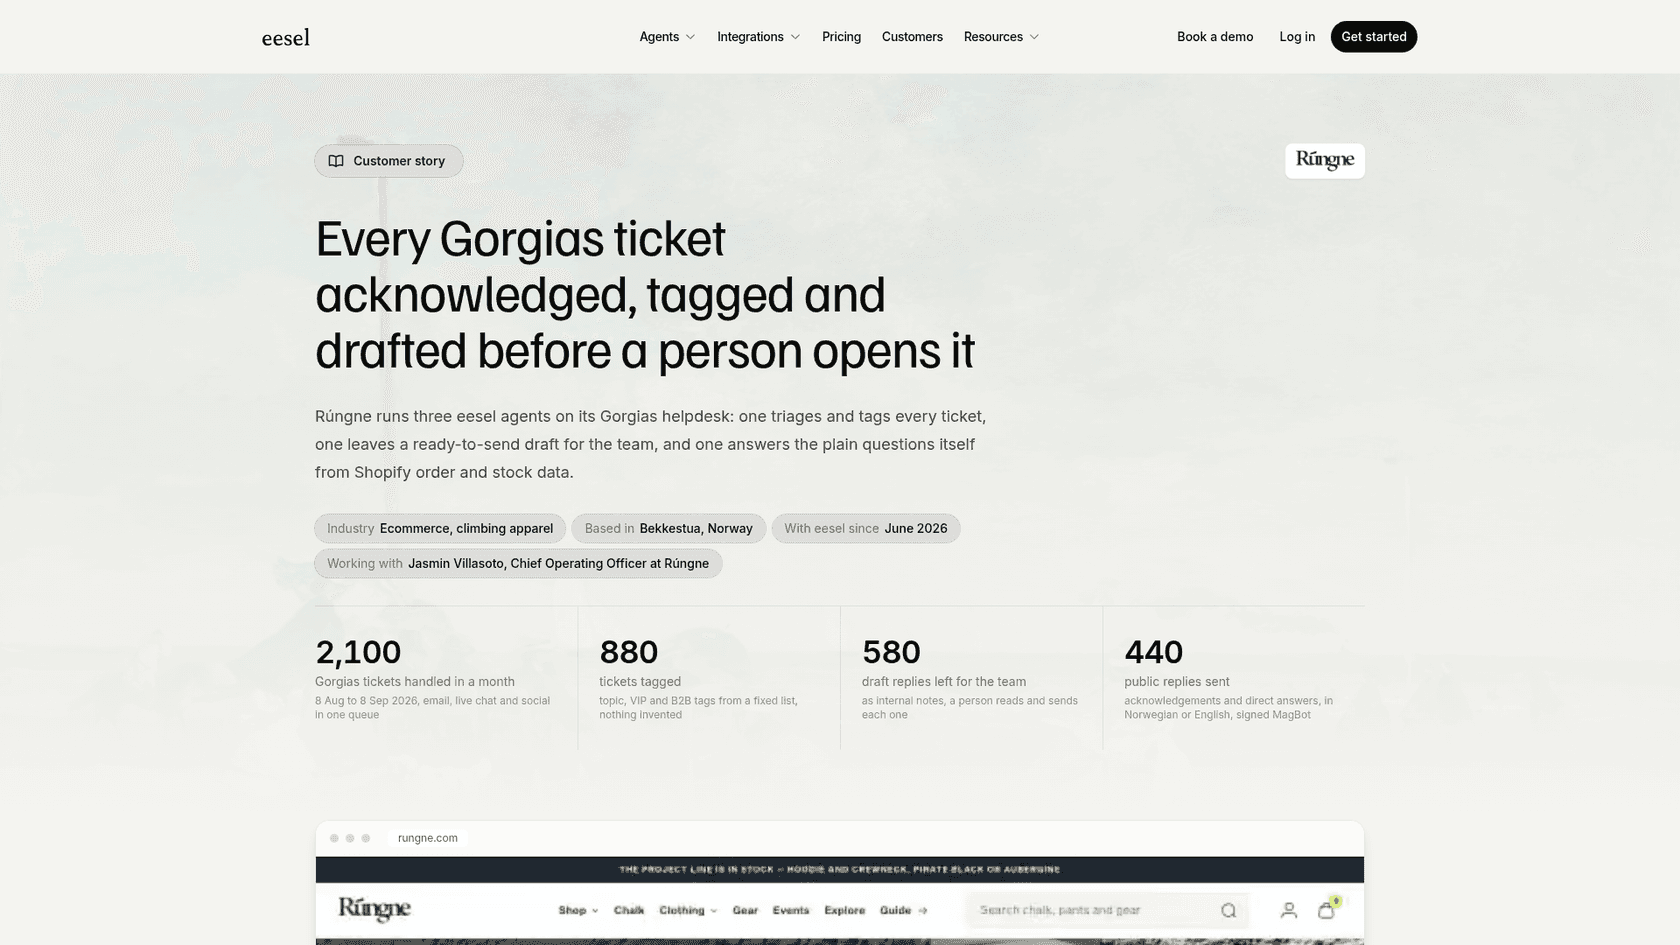
- Triage-Agent: bestätigt jedes Ticket, taggt es aus einer festen Liste und schließt Spam und Social-Rauschen. In diesem Monat hat er
880Tickets getaggt. - Entwurfs-Agent: liest den Verlauf, schlägt Bestellung und Bestand in Shopify nach und hinterlässt eine versandfertige interne Notiz. Er hat
580Entwürfe hinterlassen, und eine Person liest und sendet jeden davon. Wenn Geld im Spiel ist oder eine Tatsache nicht geprüft werden kann, schreibt er die Fakten und Optionen statt einer Antwort. - Helpdesk-Agent: antwortet öffentlich nur zu den Themen, die das Team gewählt hat (Richtlinien, Sendungsverfolgung, Bestand, Vorbestellungen). Er hat
440Antworten gesendet und taggt, schließt oder ändert nie ein Ticket.
Stornierungen, beschädigte Artikel, verlorene Pakete, Zollstreitigkeiten und alle, die nach einer Person fragen, gehen an das Team. Das ist Lane drei, und sie ist Absicht. Der Agent, der mit Kunden spricht, hat die engsten Berechtigungen, und der Agent mit dem meisten Kontext sendet nie etwas von allein.
smava, eine deutsche Vergleichsplattform für Kredite, zeigt die mittlere Lane im großen Maßstab. Zwei Marken teilen sich ein Zendesk mit rund 27,000 Tickets im Monat, und eesel hat 14,600 davon kategorisiert und 15,300 Antwortentwürfe aus 820 Makros und Artikeln vorbereitet. Jeder Entwurf landet mit Schaltflächen zum Freigeben und Ablehnen, Tickets mit Anhängen gehen mit einer Notiz an eine Person, und ein Ticket, dessen Kunde bereits einen Berater hat, kommt für eine automatische Antwort gar nicht erst in Frage. Das ist regulierte Finanzbranche, daher geht das Design davon aus, dass die Formulierung zählt.
SamCart zeigt die leiseste Form von Lane drei. Sein Freshdesk-Agent antwortet nur, solange keine Person zugewiesen ist, und wenn ein Verkäufer nach einem Menschen fragt, wird das Ticket für die Übergabe getaggt und der Agent hört auf. Wenn du deine eigene Version davon willst, zeigen die Freshdesk-Integration und KI für Freshdesk das Setup.
Wie sollte die KI ein Gespräch an eine Person übergeben?
Bei der Übergabe gewinnt oder verliert ein KI-first Team Vertrauen, denn der Kunde ist da schon einen Schritt verärgerter als am Anfang. Zwei Regeln decken das meiste ab: Die Person muss die ganze Geschichte sehen, und der Kunde darf nie gebeten werden, sie zu wiederholen.
Die Dokumentation von Zendesk definiert die Mechanik klar, daher lohnt sich die Lektüre auch, wenn du es nicht nutzt. Bei der Übergabe wird der KI-Agent als erster Antwortender entfernt und ein menschlicher Agent wird erster Antwortender; Agenten werden über deinen normalen Routing-Ablauf benachrichtigt, und der KI-Agent kann nicht mehr antworten. Die Rückgabe ist das Gegenteil und wird ausgelöst, wenn das Ticket von Gelöst auf Geschlossen wechselt.
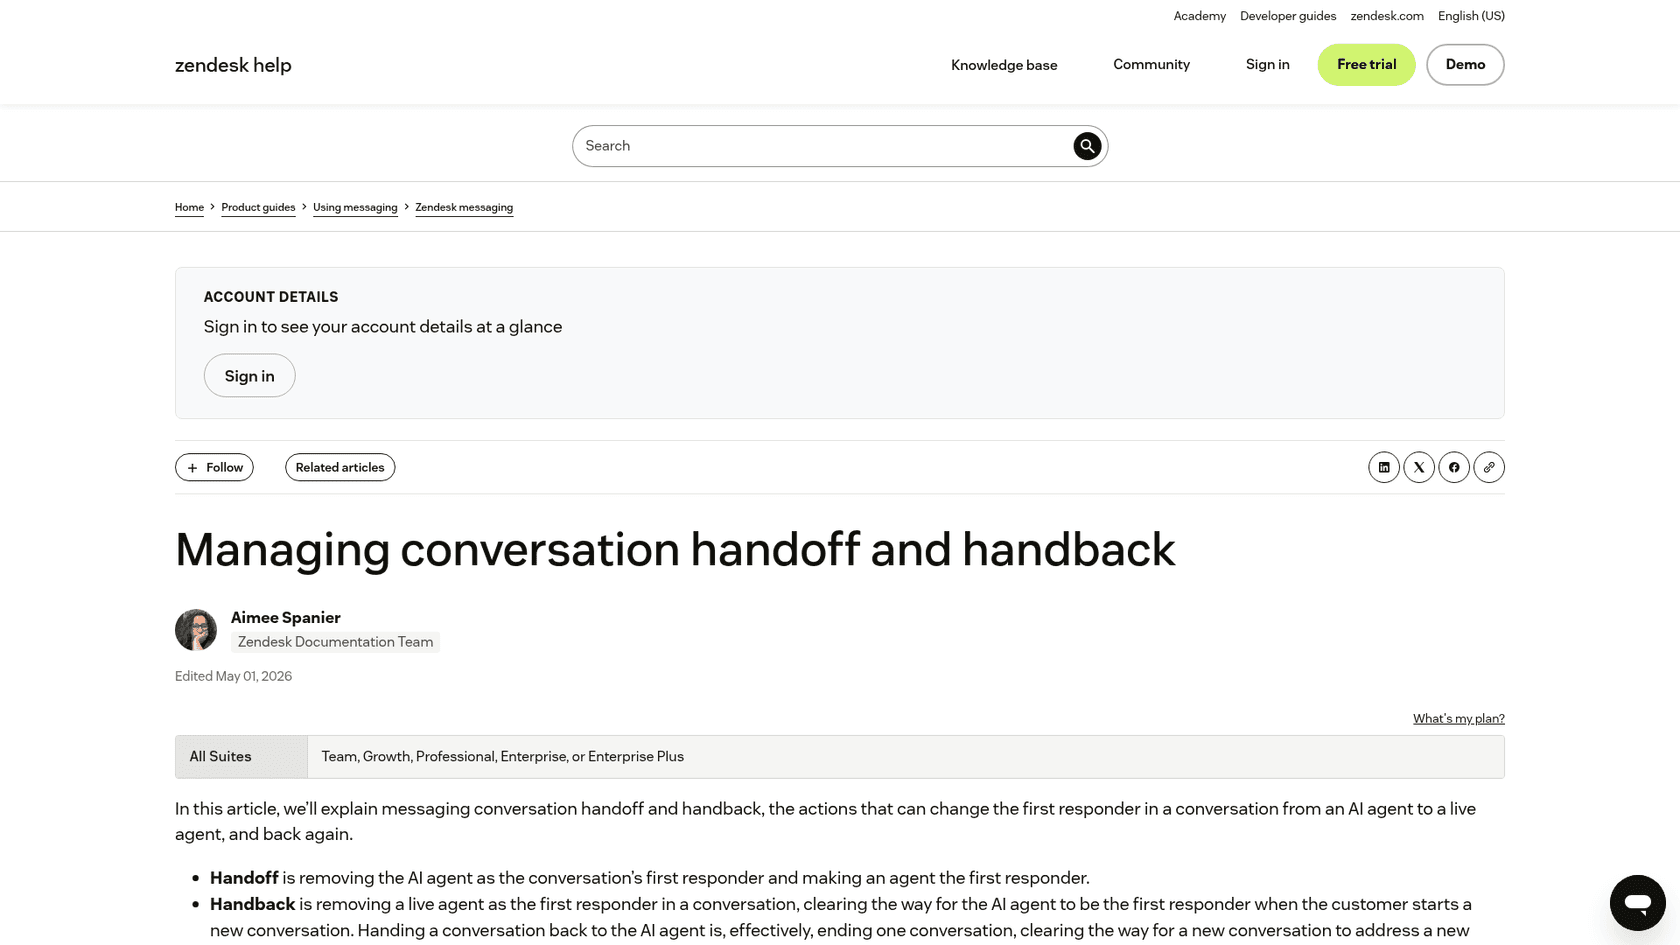
Das Detail, das die meisten Teams übersehen, ist der Zeitpunkt der Rückgabe. Standardmäßig schließt Zendesk ein gelöstes Ticket nach vier Tagen, und bis es geschlossen ist, findet ein zurückkehrender Kunde das alte Gespräch noch aktiv vor, mit dem Menschen als erstem Antwortenden. Im selben Artikel steht, dass du diese Automatisierung auf alles zwischen einer Stunde und 28 Tagen ändern kannst. Diese eine Einstellung entscheidet, ob die nächste, unabhängige Frage eines Kunden bei der KI oder im Posteingang einer Person landet, also muss jemand sie verantworten. In meinem Plan ist das die Automatisierungsaufgabe.
Für das Übergabepaket selbst verlange ich bei jedem übergebenen Ticket fünf Dinge:
- Die Frage des Kunden in einer Zeile, damit sich der Agent in fünf Sekunden orientieren kann.
- Was die KI schon versucht oder gesagt hat, einschließlich allem, was sie versprochen hat.
- Die Konto- oder Bestelldaten, die sie abgefragt hat.
- Warum sie übergeben hat (Kunde hat gefragt, Thema außerhalb des Umfangs, geringe Sicherheit, Richtlinienblock).
- Ein vorgeschlagener nächster Schritt, deutlich als Vorschlag gekennzeichnet.
Auch die Formulierung zählt. Die Hinweise zum Konversationsdesign von Zendesk selbst sagen, man solle nicht zu viel versprechen, und das Beispiel ersetzt "I'll help you solve this" durch "Let's try and solve this." Dieselbe Seite bevorzugt ein kurzes Angebot, den Kunden mit einer Person zu verbinden, wenn die Frage außerhalb des Umfangs liegt. Ein Hacker-News-Kommentator hat das Prinzip schlicht formuliert:
"There just needs to be a human available when there's any request that escalates past that simple case."

Wenn deine Übergaben die Schwachstelle sind, geht Best Practices für die Übergabe von KI-Agenten tiefer, und der Glossareintrag zur Eskalation definiert die Begriffe.
Was solltest du statt "bearbeitet" messen?
"Bearbeitet" ist die Kennzahl, die ein Dashboard gut aussehen lässt und Kunden das Gefühl gibt, ignoriert zu werden. Eine KI kann einen Chat "bearbeiten", indem sie etwas beantwortet, was der Kunde nicht gefragt hat. Ich nutze sechs Messgrößen, und die erste ist die, auf die es ankommt.
| Messgröße | Was sie dir sagt | Woher sie kommt |
|---|---|---|
| Rate verifizierter Lösungen | Das Problem des Kunden wurde wirklich gelöst, bestätigt durch ein Signal | Stichprobenprüfung plus keine Wiedereröffnung |
| Erneuter Kontakt innerhalb von 7 Tagen | Das "gelöste" Ticket kam nicht zurück | Helpdesk-Daten |
| Antwortgenauigkeit | Die KI hat nach deiner Richtlinie das Richtige gesagt | Wöchentliche QA-Stichprobe |
| CSAT gegenüber der Baseline | Kunden stehen nicht schlechter da als bei einer Person | Umfrage bei KI- und menschlichen Tickets gleichermaßen |
| Kritische Richtlinienverstöße | Null-Toleranz-Fälle: falsche Rückerstattung, Datenleck | QA und Audit-Log |
| Voll belastete Kosten pro Lösung | Tools plus Prüfzeit, geteilt durch verifizierte Lösungen | Finanzen plus Helpdesk |
Zwei externe Stimmen erklären, warum ich dabei so streng bin. Die erste ist ein Hacker-News-Kommentator zu Lösungsraten:
"But look deeper. It's not a 60% reduction in work because they're just tracking how many chats get escalated to a human."
Die zweite ist eine Warnung von jemandem, der es gemessen hat:
"When asking customers how well they were helped by the customer support system (via CSAT score), I've found industry-standard AI support agents will generally perform worse than a well-trained human support team."
Ich lese das nicht als Grund, KI zu meiden. Ich lese es als Grund, gegen eine Baseline zu vergleichen, die du vor dem Start gemessen hast, und eine Gruppe von Kunden aus dem Pilot herauszuhalten, damit du etwas zum Vergleichen hast. Die Scorecard für den KI-Support-Pilot setzt genau dafür Bestehensgrenzen, und CX-KI-Kennzahlen ordnet die Definitionen jedem Helpdesk zu. Für das Vokabular siehe Lösungsrate.
Wie sehen die ersten 90 Tage aus?
90 Tage reichen, um von null zu einem gemessenen Pilot und einer ersten Erweiterung zu kommen. Sie reichen nicht, um alles zu automatisieren, und der Plan funktioniert besser, wenn du das gleich zu Beginn sagst.
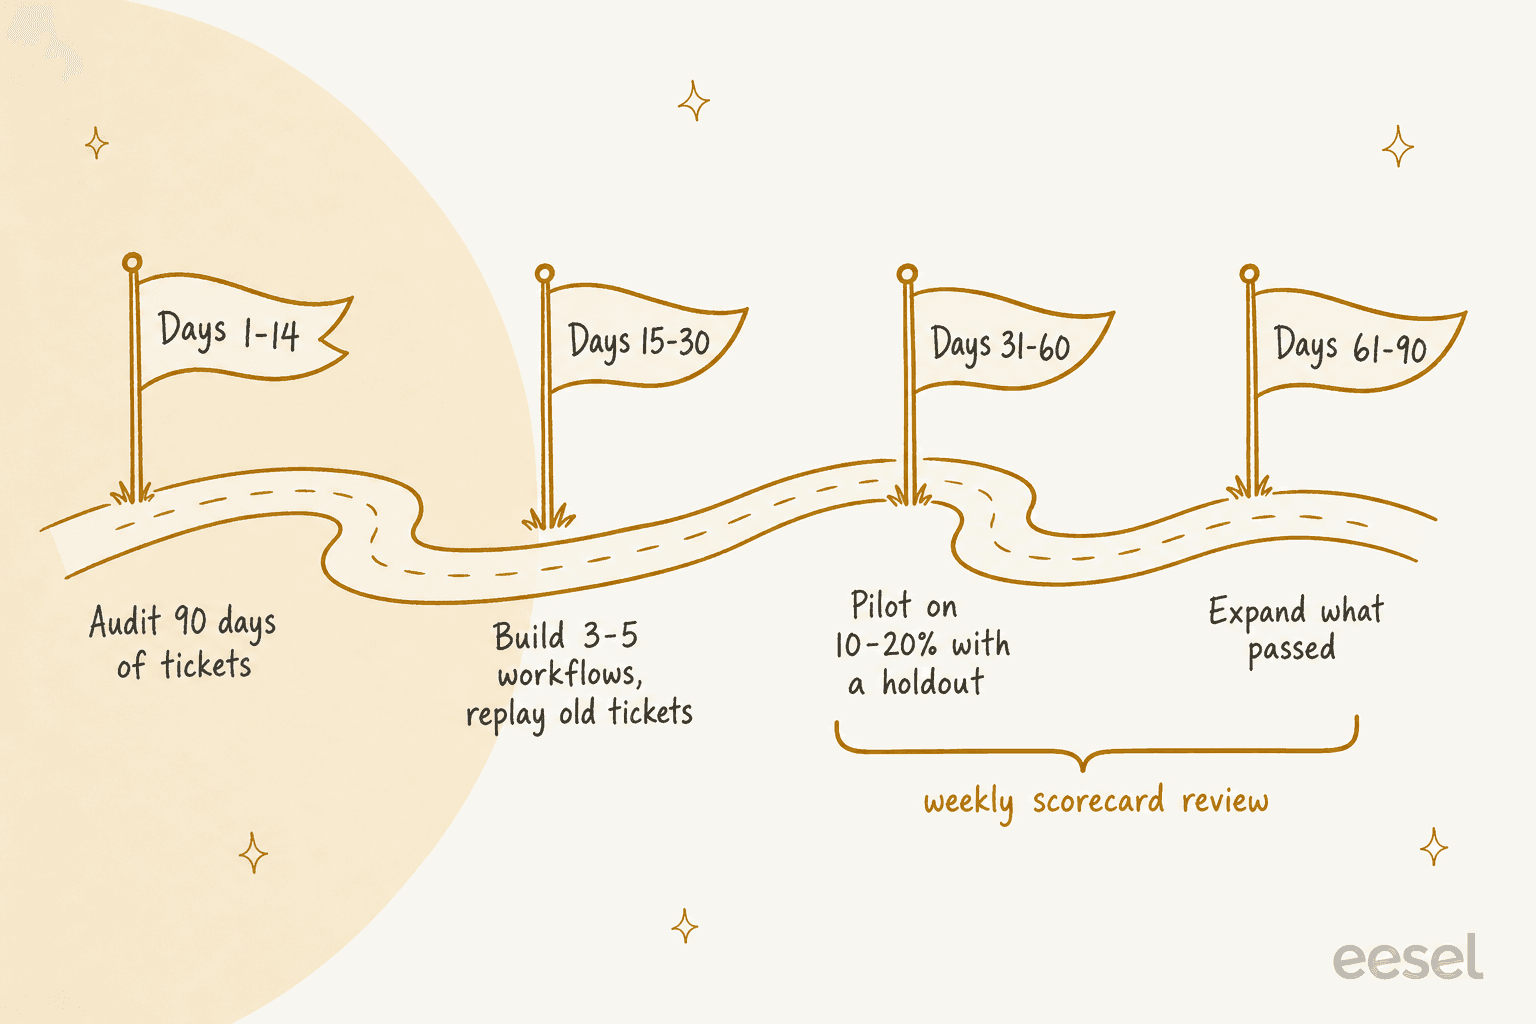
| Tage | Ziel | Was du tust | Abschlusstest |
|---|---|---|---|
| 1 bis 14 | Audit | 60 bis 90 Tage Tickets exportieren, Anliegen nach Volumen und Risiko ordnen, die vier Aufgaben vergeben, Baseline für CSAT und Kosten pro Lösung festlegen | Eine geordnete Liste von 3 bis 5 Kandidaten-Workflows |
| 15 bis 30 | Aufbau und Replay | 3 bis 5 Workflows in der risikoärmsten Lane aufbauen, dann alte Tickets dagegen durchspielen | Genauigkeit im Replay erreicht deine Bestehensgrenze |
| 31 bis 60 | Pilot | 10 bis 20 % eines Tickettyps an die KI leiten, eine Holdout-Gruppe behalten, täglich prüfen | Verifizierte Lösung und CSAT auf oder über der Baseline, null kritische Verstöße |
| 61 bis 90 | Ausbau | Jeweils einen Tickettyp oder Kanal hinzufügen, nur die, die bestanden haben | Scorecard hält, während das Volumen wächst |
Alte Tickets durchzuspielen ist der Schritt, den Leute überspringen, und es ist dein günstigstes Sicherheitsnetz. Der Leitfaden zum Test vor dem Start führt dich durch, und das Playbook zum KI-Support-Pilot gibt die Woche-für-Woche-Version der Tage 31 bis 60. Wähle deinen ersten Workflow mit Blick auf die Tier-1-Entlastung, denn im risikoärmsten Volumen liegt der erste Erfolg.
Eine Reihenfolgeregel halte ich strikt ein: Migriere dein Helpdesk und füge KI nicht im selben Quartal hinzu. Behalte das Helpdesk, das du hast, setze die KI obendrauf und bewerte die KI für sich. Wenn du später zu dem Schluss kommst, dass das Helpdesk das Problem ist, ist der Wechsel des KI-Support-Anbieters der schrittweise Plan, und KI-Schicht oder integrierte KI hilft dir zu entscheiden, ob eine Schicht oder ein integriertes Tool passt.
Welcher Wochenrhythmus hält das Ganze am Laufen?
Ein KI-first Team läuft nicht auf einem Launch, sondern auf einer Schleife. Die Regel, die ich durchsetze: Jeder Fehler wird zu einem Verbesserungsticket mit Verantwortlichem, und der Verantwortliche ist eine der vier Aufgaben.
| Takt | Wer | Was passiert |
|---|---|---|
| Täglich, 15 Minuten | KI-Betrieb und Spezialisten | Fehlgeschlagene oder wiedereröffnete KI-Tickets von gestern prüfen, Ursache taggen |
| Zweimal pro Woche | Wissen und QA | Die Artikel und Makros hinter den Fehlern korrigieren |
| Wöchentlich | KI-Betrieb mit dem Team | Scorecard-Review: verifizierte Lösung, erneuter Kontakt, CSAT, Verstöße |
| Monatlich | Support-Leitung mit Finanzen | Review von Besetzung und Lanes: was die Lane wechselt, was die KI nicht mehr tun sollte |
Für die QA-Seite hält der Leitfaden zur QA-Kalibrierung im Support die Prüfer konsistent, und Tools für die Qualitätssicherung im Kundensupport vergleicht, was es gibt. Zendesk testet außerdem KI-generierte Qualitätswerte, die gelöste und geschlossene Tickets bewerten, allerdings ist die Funktion in einem Early-Access-Programm und auf Professional-Tarife und höher beschränkt, also behandle sie als etwas zum Beobachten, nicht zum Verlassen.
Wenn du einen Governance-Rahmen für diese Schleife willst, ordnet das NIST AI Risk Management Framework die Arbeit am KI-Risiko in vier Funktionen: Govern, Map, Measure und Manage. Sein Profil für generative KI, veröffentlicht im Juli 2024, ergänzt Risiken, die für generierten Text spezifisch sind. Ich glaube nicht, dass ein Support-Team das Ganze lesen muss, aber die Form passt gut: Deine Lanes sind "Map", deine Scorecard ist "Measure", die wöchentliche Schleife ist "Manage" und die schriftlich festgehaltene Verantwortung ist "Govern".
Woran scheitern Teams?
Die meisten Fehler, die ich sehe, sind einer von vier, und alle sind Fehler der Verantwortung, nicht der Technik.
- Keine Lane für die schwierigen Tickets. Die KI darf alles versuchen, also versucht sie sich am Rückerstattungsstreit. Lösung: Die Lane in menschlicher Hand ist schriftlich festgelegt, und die KI hat eine ausdrückliche Stoppregel.
- Niemand verantwortet das Wissen. Die erste falsche Antwort wird "der KI" angelastet, und der Artikel dahinter bleibt veraltet. Siehe Fehler bei der Einführung von KI im Kundenservice für mehr vom gleichen Muster.
- Erfolg wird als Volumen gemessen. Die Entlastungszahl steigt, und niemand prüft, ob der Kunde zurückkam. Lösung: verifizierte Lösung und eine Holdout-Gruppe.
- Die besten Agenten bleiben an der repetitiven Arbeit hängen. Der eigentliche Gewinn ist, dass deine stärksten Leute aufhören, dieselben zehn Fragen zu beantworten, und anfangen, Systeme, Wissen und Kundenentscheidungen zu verantworten. Wenn deine SOPs in den Köpfen der Leute leben, beginne mit einer SOP für den Kundensupport und einem Durchgang zu KI für die Produktivität von Agenten.
Probiere eesel als KI-Helpdesk-Teammitglied in deiner Queue aus
Wenn du ein Teammitglied für die erste Lane dieses Plans willst, probiere eesel. Es steigt in die Queue ein, die du bereits in Zendesk, Freshdesk, Gorgias oder HubSpot betreibst, lernt aus deinem Help Center und früheren Tickets und zeigt jede Aktion als freigegeben, abgelehnt oder ausstehend an, damit eine Person die Kontrolle behält, während du Vertrauen aufbaust. Du kannst mit dem reinen Entwurfsmodus beginnen, alte Tickets durchspielen und die Lane erweitern, wenn die Scorecard es sagt.
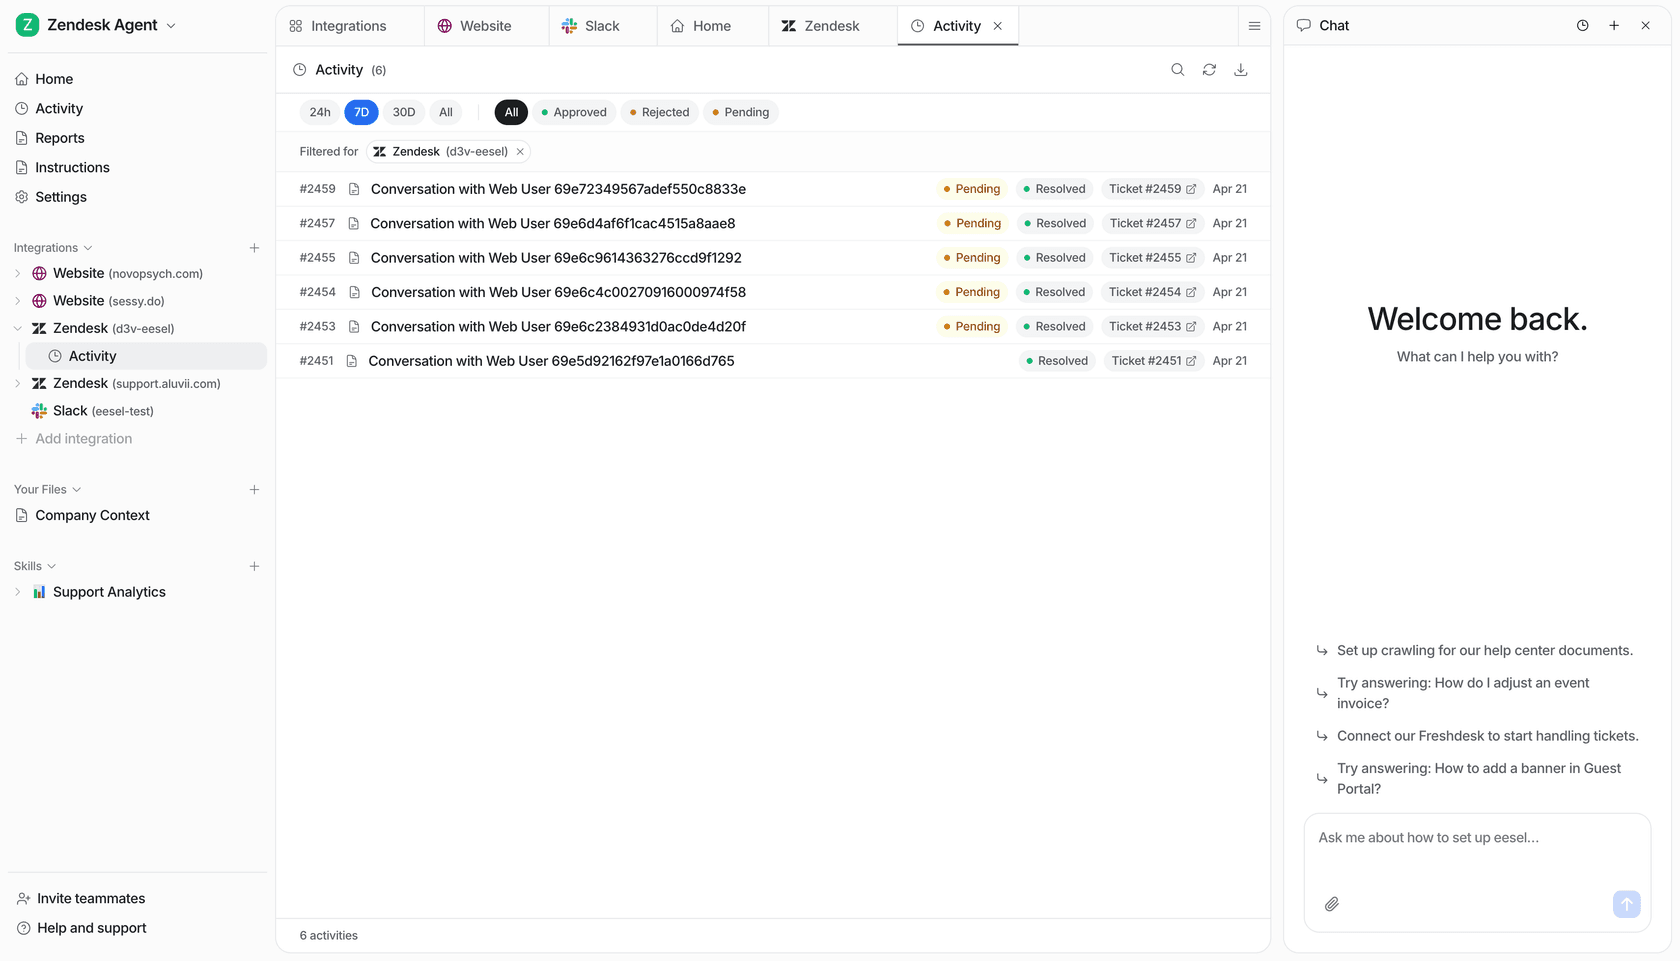
Der kostenlose Plan gibt dir 100 Credits ohne Karte, um es an echten Tickets zu testen, und der Teammate-Plan startet bei $299 im Monat für 500 Credits, wobei ein Ticket oder ein Chat einen Credit zählt. Für das größere Bild, wie das Teammitglied in deine Tools passt, ist der Leitfaden zum KI-Helpdesk-Agenten die nächste Lektüre.