

Kurzfassung
Wählen Sie einen KI-Agenten für den Kundenservice, indem Sie ihn an Ihren eigenen alten Tickets testen, nicht an der Demo des Anbieters. Jede Demo sieht gut aus. In Ihrer Warteschlange zeigen sich die Unterschiede. Die zwei Prüfungen, die die Tools am stärksten trennen, sind: wie Sie vor dem Start testen können und wofür Sie tatsächlich bezahlen.
Zur Abrechnung: „Lösung“ bedeutet fast bei jedem Anbieter etwas anderes. Zendesk berechnet jetzt nur KI-verifizierte Lösungen, Gorgias zählt alles ohne menschliche Antwort innerhalb von 72 Stunden, Freshdesk rechnet eine Sitzung ab, egal ob gelöst oder nicht, und Ada, Decagon und Sierra veröffentlichen gar keinen Preis. Abrechnung pro Lösung wirkt im Pilotprojekt am günstigsten und wird teurer, je besser der Agent wird.
Wenn Sie einen Agenten wollen, der sich in den Helpdesk einklinkt, den Sie bereits nutzen, und sich zuerst beweist: eesel spielt Hunderte Ihrer alten Tickets nach und bewertet jede Antwort anhand dessen, was Ihr Team tatsächlich gesendet hat. Abgerechnet wird ein Pauschaltarif pro bearbeitetem Ticket. Sie können es kostenlos mit 100 Credits testen.
Warum die Demo der schlechteste Ort ist, einen KI-Support-Agenten zu beurteilen
Ich arbeite bei eesel täglich in der Support-Warteschlange, und was ich beim Beobachten von Teams gelernt habe: Die Demo sagt fast nie voraus, was bei Ihren Tickets passiert. Die Demo läuft mit ordentlichen Fragen, die der Anbieter ausgewählt hat. In Ihrer Warteschlange gibt es die halb geschriebene E-Mail, den Kunden, der drei Dinge gleichzeitig fragt, und die Richtlinie, die sich letzten Dienstag geändert hat.
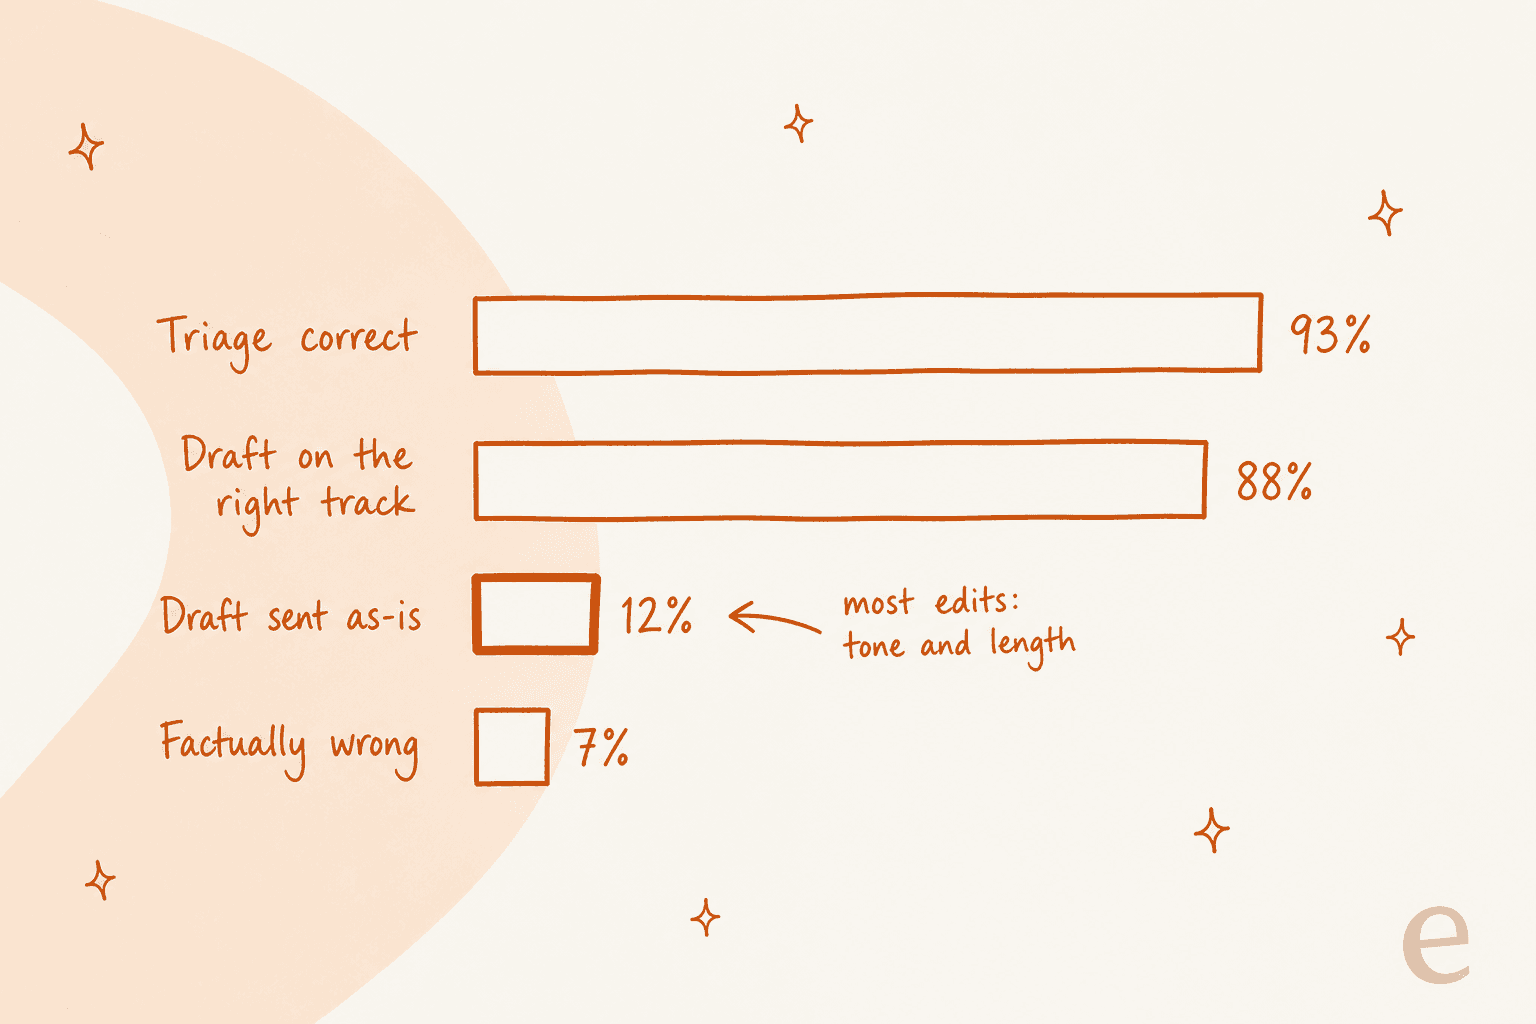
Ein reales Beispiel: Als eesel seinen Agenten in einem Schmuck-Onlineshop mit rund 1.000 Tickets im Monat testete, sahen die Kennzahlen großartig aus: 93 % Triage-Genauigkeit und 88 % der Entwürfe in die richtige Richtung. Doch Mitarbeitende sendeten nur 12 % der Entwürfe unverändert. Etwa 65 % ihrer Überarbeitungen betrafen Länge und Ton, nicht Fakten, und nur rund 5 % waren die KI, die schlicht falsch lag. Eine einzelne „Genauigkeit“ hätte all diese Erkenntnisse verdeckt.
Diese Lücke ist der Grund, warum KI-Support-Kennzahlen wichtiger sind als die Präsentation. Ein Praktiker mit zehn Jahren Erfahrung in Contact-Center-KI formulierte die ehrliche Ausgangslage deutlich:
„Das Problem ist, dass Anbieter den Unternehmen erzählen, sie könnten 80 bis 90 % (vielleicht sogar 100 %, wenn sie dabei ernst bleiben können) der Jobs ihrer Kundenservice-Mitarbeitenden mit KI wegrationalisieren, und das ist Unsinn.“

Als grobe Ausgangslage nannte derselbe Kommentator etwa 30 % der eingehenden Kontakte, die abgefangen werden. Ihre Zahl kann deutlich höher liegen, und viele Teams übertreffen das, aber das erfahren Sie nur durch einen Test an Ihrer Warteschlange. Die sieben Prüfungen unten folgen deshalb einer Idee: Jeder Anbieter muss es an Ihren Tickets beweisen, bevor Sie unterschreiben.
Schritt 1: Schreiben Sie vor jeder Demo ein Briefing in einem Absatz
Bevor Sie einen einzigen Termin buchen, halten Sie fest, was „gut“ für Sie heißt. Nicht „Support automatisieren“, sondern ein Ziel und eine Übergaberegel. Ein Support-Manager formulierte sein Briefing in einem Telefonat mit eesel in einem Satz: Er wollte etwas, das „60 % der eingehenden Zendesk-Tickets bearbeiten kann und weiß, wann es einen echten Menschen für eine bessere Analyse und Lösung hinzuziehen muss“.
Das ist ein großartiges Briefing, weil es beide Hälften enthält, die jede Bewertung braucht. Ein Abdeckungsziel sagt, was Sie messen. Eine Übergaberegel sagt, wie Scheitern aussieht. Ein weiterer CX-Leiter mit 7.000 Tickets im Monat sagte eesel, die zweite Hälfte sei wichtiger als die erste:
„Ich brauche eine KI, die nur die Tickets bearbeitet, bei denen sie sich sicher ist, und alle anderen in Ruhe lässt.“
Ihr Briefing sollte beantworten:
- Welche Themen soll der Agent übernehmen? Bestellstatus, Passwort-Zurücksetzungen und Abrechnungsfragen kommen meist zuerst. Ziehen Sie einen Monat an Tickets und markieren Sie die wiederkehrenden Fragen; mein Leitfaden zur Ticket-Triage zeigt, wie.
- Welche Kanäle: E-Mail, Chat, Social Media, Telefon?
- Was er tun darf, nicht nur sagen: Bestellungen nachschlagen, Erstattungen auslösen, Adressen ändern?
- Wann er aufhören muss und an einen Menschen übergibt, und was der Mensch erhalten soll.
- Was Sie pro Monat zahlen, im schlimmsten Fall, in Ihrer stärksten Saison.
Bringen Sie dieses Briefing in jede Demo und lassen Sie den Anbieter es zu Ihren Bedingungen beantworten. So driftet das Gespräch auch nicht zu Funktionen ab, die Sie nie nutzen werden.
Schritt 2: Entscheiden Sie, wo der Agent leben soll
Die erste Weggabelung: Kaufen Sie den KI-Agenten, den Ihr Helpdesk ohnehin verkauft, eine eigenständige Plattform oder eine Schicht, die sich in Ihren vorhandenen Helpdesk einklinkt? Diese Entscheidung setzt leise Ihre Obergrenze für alles andere: woraus der Agent lernt, wie Sie ihn testen und ob Sie wieder wechseln können.
| Option | Beispiele | Wo er lebt | Lernt aus alten Tickets? | Einrichtung |
|---|---|---|---|---|
| Im Helpdesk eingebaut | Zendesk AI agents, Gorgias AI Agent, Freddy AI | Nur in diesem Helpdesk | Nein, meist Hilfecenter und Dokumente | Self-Service, in der Helpdesk-Verwaltung |
| Eigenständige Enterprise-Plattform | Ada, Decagon, Sierra | Vor Ihrem Helpdesk, übergibt an ihn | Teilweise, alte Konversationen dienen als Testgrundlage oder Artikelentwürfe | Anbietergeführt, zuerst Demo |
| Schicht auf Ihrem vorhandenen Helpdesk | eesel | In Zendesk, Freshdesk, Gorgias, Front, HubSpot und mehr | Ja, bei voller Anbindung | Self-Service |
Eingebaute Agenten sind der Weg des geringsten Widerstands, und das ist eine echte Stärke. Wenn Sie in Gorgias arbeiten und über Shopify verkaufen, kann der Gorgias AI Agent Bestellungen stornieren, Lieferadressen ändern und erneut versenden, ohne zusätzliche Einrichtung. Der Preis dafür: Er funktioniert nur dort. Laut Gorgias-Dokumentation „kann er mit Shopify-Shops verwendet werden, die mit Gorgias verbunden sind“, und ein Capterra-Rezensent, der ihn mit 5/5 bewertete, merkte dennoch an, dass er „die volle Funktionalität nur für Shopify“ biete (Frank A., Capterra).
Eigenständige Plattformen wie bei Decagon vs. Sierra passen zu großen Teams, die ein Anbieterteam wollen, das mit ihnen baut. Sierras eigene Produktseite wirbt mit der Zusammenarbeit mit „einem Expertenteam für Agentenentwicklung“ und sagt „In Wochen einsatzbereit“ (Sierra). Das passt im Enterprise-Maßstab gut und ist viel Aufwand, wenn Sie drei Agenten und ein Zendesk-Konto haben.
Noch ein Datenpunkt, bevor Sie standardmäßig zur eingebauten Option greifen. Ein CX-Leiter einer US-Gesundheitsplattform kam zu eesel, nachdem er den eingebauten KI-Agenten von Zendesk ausprobiert und für zu teuer für den Nutzen befunden hatte. Das ist ein einzelnes Team, und viele andere sind zufrieden damit, aber deshalb würde ich den eingebauten Agenten denselben Tests unterziehen wie alle anderen, statt ihn als sichere Standardwahl zu behandeln. Meine Übersichten zu Zendesk-AI-Alternativen und Freddy-Alternativen gehen tiefer.
Schritt 3: Prüfen Sie, woraus er lernt
Ein KI-Agent ist nur so gut wie das, was er liest. Die meisten Agenten lernen aus Ihrem Hilfecenter, einem Website-Crawl und hochgeladenen Dateien. Deutlich weniger lernen aus dem, was tatsächlich abbildet, wie Ihr Team antwortet: Ihren gelösten Tickets.
Dieser Unterschied zeigt sich in der Dokumentation. Gorgias beantwortet die Frage direkt in seinen FAQ: „Nutzt der AI Agent meine Makros? Nein“ (Gorgias). Die Seite zu Wissensquellen von Zendesk nennt Hilfecenter und externe Quellen, aber keine alten Tickets (Zendesk). Freshdesks Freddy lernt aus „URLs, Dateien, Lösungsartikeln, eigenen Fragen und Antworten und externen Apps“ (Freshdesk), und gelöste Tickets tauchen nur als Testeingaben auf.
Warum das zählt: Erinnern Sie sich an den Test, bei dem 65 % der Änderungen Ton und Länge betrafen? Genau das behebt ein Agent, der die gesendeten Antworten Ihres Teams liest. eesel-Mitgründer Amogh hört das in fast jedem Verkaufsgespräch:
„Außerdem: Training mit alten Tickets schlägt wieder zu. Klassiker. Die Leute wollen wirklich, wirklich, wirklich mit alten Tickets trainieren.“
Was auch immer der Agent liest, die Inhalte müssen aktuell sein. Dieser Reddit-Kommentar ist die klarste Warnung, die ich kenne:
„Ich habe erlebt, wie ein Bot selbstbewusst falsche Antworten gab, weil die Wissensdatenbank seit 8 Monaten nicht aktualisiert war. Die Kunden bekamen nicht nur schlechte Antworten. Sie bekamen sie sofort.“

Fragen Sie jeden Anbieter zwei Dinge: Kann er unsere alten Tickets und Makros lesen, und kann er die internen Dokumente lesen, in denen unsere echten Richtlinien stehen (Confluence, Notion, Google Docs)? Prüfen Sie dann die Wissensdatenbank vor dem Test, nicht danach. Veraltete Artikel sind die häufigste Ursache für KI-Halluzinationen, die ich sehe.
Schritt 4: Testen Sie ihn an Ihren eigenen alten Tickets
Das ist die Prüfung, die die Tools am stärksten trennt, und die, die die meisten Käufer überspringen. Jeder Anbieter lässt Sie vor dem Livegang testen, aber „testen“ heißt drei sehr verschiedene Dinge.
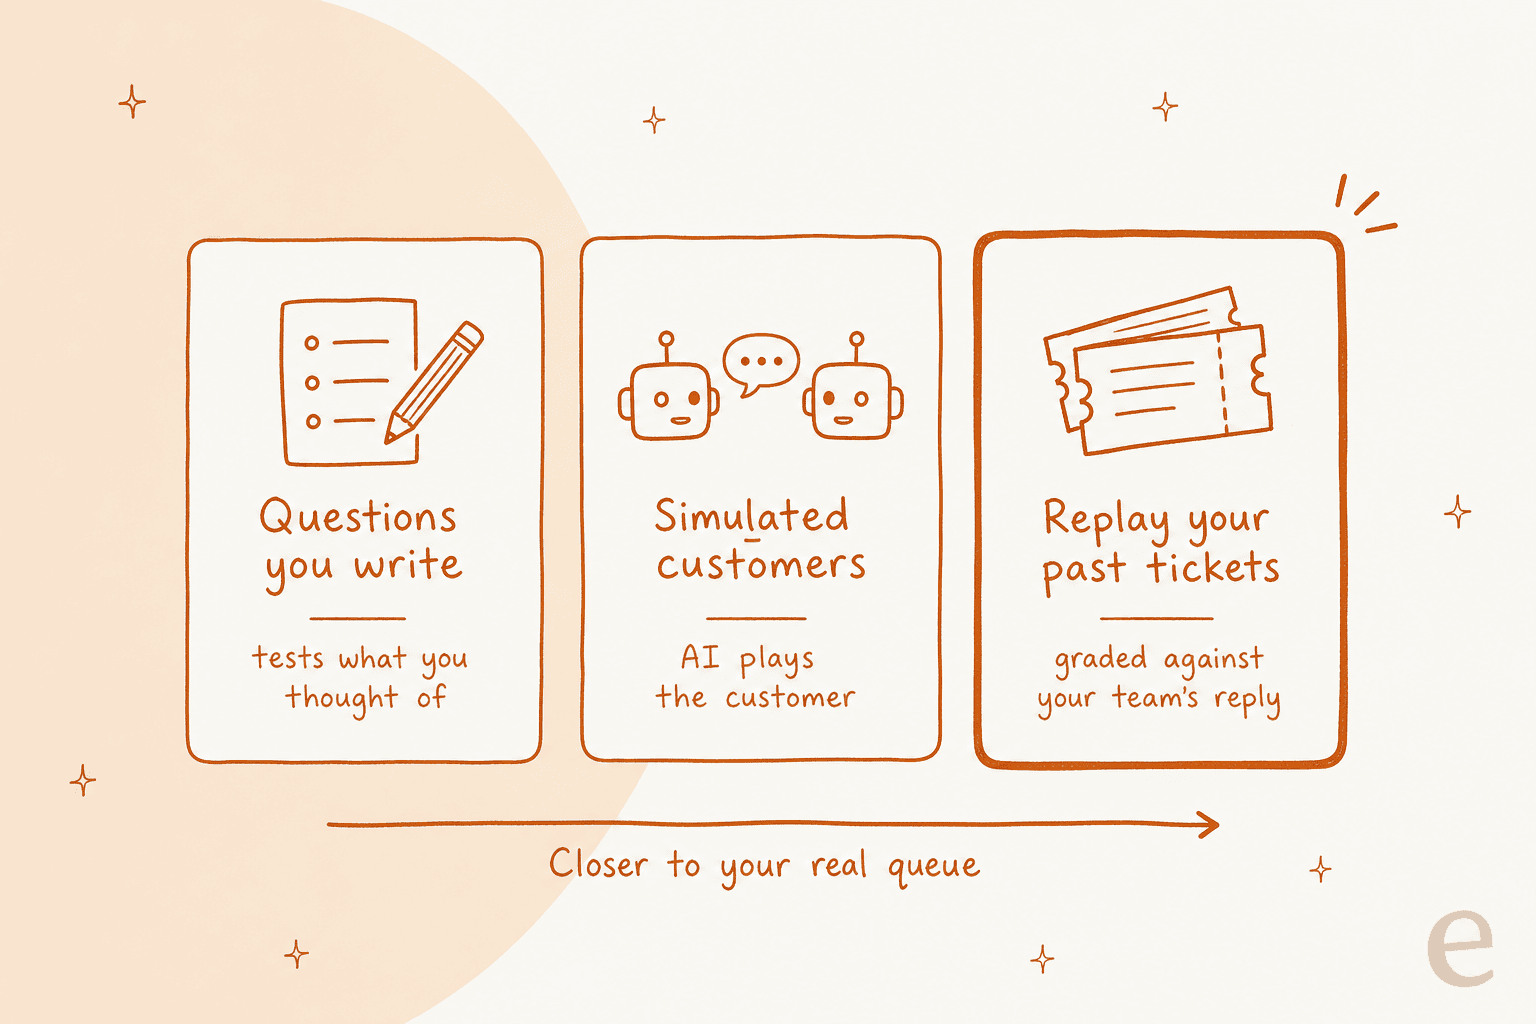
Das Problem selbst geschriebener Fragen: Sie testen nur, woran Sie gedacht haben. Das Problem simulierter Kunden: Eine KI erfindet den Kunden, der Test ist also nur so realistisch wie der Generator. Das Nachspielen Ihrer tatsächlichen Tickets ist die einzige Methode, bei der die „richtige Antwort“ etwas ist, das Ihr Team bereits gesendet hat.
So beschreiben die Dokumentationen der Anbieter das Testen:
| Anbieter | So testen Sie vor dem Start | Bewertet anhand von |
|---|---|---|
| Zendesk | Vorschau-Chat sowie ein Konversationssimulator (Early Access, nur Messaging), der von Ihnen geschriebene Szenarien mit fiktiven Daten durchspielt | Seiner eigenen Schätzung der Lösungsquote |
| Gorgias | Playground-Vorschau-Chat; ein bestehendes Ticket lässt sich jeweils einzeln erneut ausführen | Ihrer Einschätzung, pro Konversation |
| Freshdesk Freddy | Bis zu 100 geschriebene oder KI-generierte Anfragen pro Durchlauf im Chat; bei E-Mail den Import von bis zu 50 gelösten Tickets pro Durchlauf | Beantwortet, unbeantwortet oder Fehler |
| Ada | Geschriebene Testfälle, bis zu 3.000 Simulationen pro Tag | Bestanden oder durchgefallen pro Test |
| Decagon | KI-generierte Test-Kunden, die mit hochgeladenen Transkripten vorbereitet werden können | Bestanden oder durchgefallen pro Test |
| Sierra | KI-generierte Test-Nutzer, bewertet von einer zweiten KI | KI-Bewerter |
| eesel | Spielt Ihre gelösten Tickets in Stapeln nach | Was Ihr Team tatsächlich geantwortet hat |
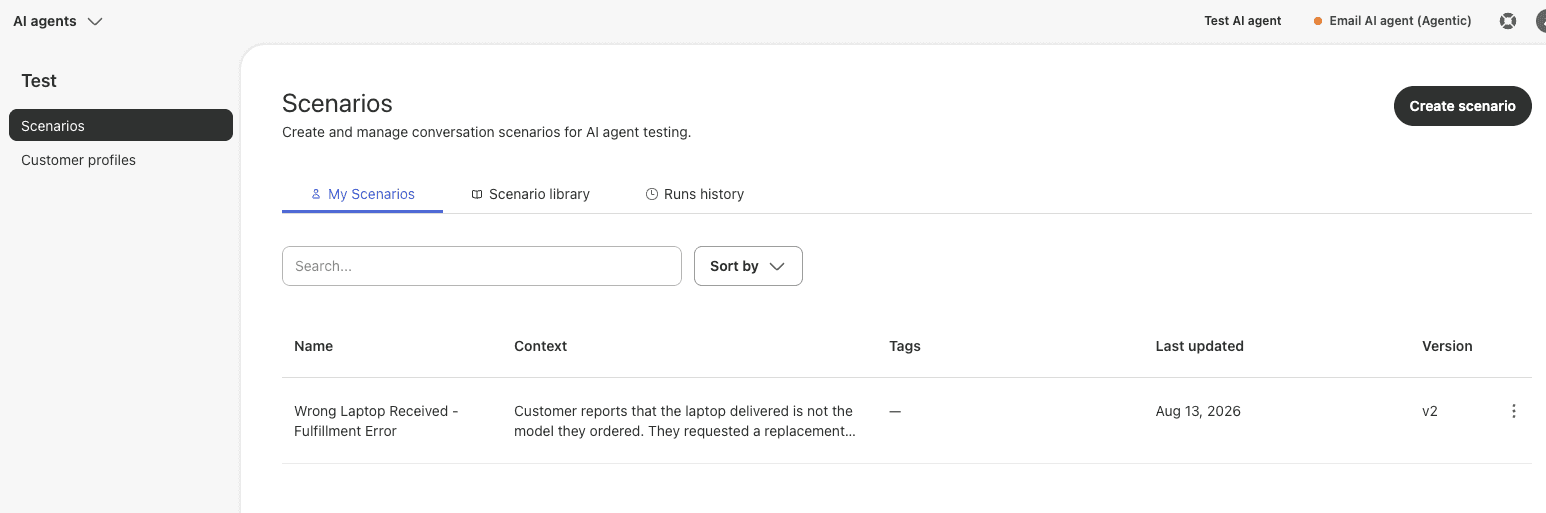
Zendesks Simulator ist ein gutes Beispiel für den Ansatz mit geschriebenen Szenarien. Der Hilfeartikel sagt, er „erzeugt realistische Konversationen auf Basis von Szenarien, die Sie erstellen“, und ergänzt, er sei „für Tests mit fiktiven Daten ausgelegt“ (Zendesk). Das ist nützlich für Regressionstests eines Ablaufs, aber die geschätzte Lösungsquote stammt aus Szenarien, die Sie sich ausgedacht haben.
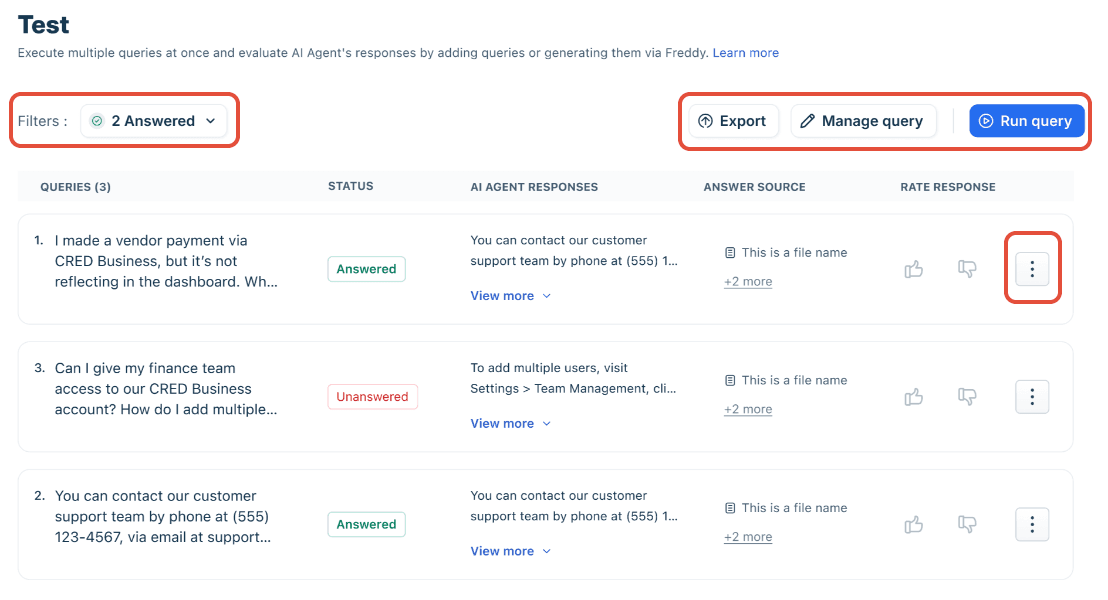
Freddys Massentest lässt sich schnell ausführen, und die Option des E-Mail-Agenten, gelöste Tickets zu importieren, bringt Sie näher an die Realität. Der Haken ist die Bewertung: Jede Anfrage kommt als „Answered“, „Unanswered“ oder „Error“ zurück (Freshdesk). Ein beantwortetes Ticket kann trotzdem falsch sein.
Noch eine Falle: Manche Tests führen echte Aktionen aus. Adas Dokumentation sagt, bei Simulationen würden „Aktionen nicht simuliert“ und „gegen Live-Systeme ausgeführt“ (Ada), und Gorgias warnt, eine Test-Aktion „kann echte Kunden- und Bestelldaten betreffen (zum Beispiel eine Bestellung stornieren)“ (Gorgias). Verwenden Sie ein Fake-Kundenprofil, bevor Sie Aktionen in einem Test aktivieren.
Wie ein Nachspielen alter Tickets aussieht
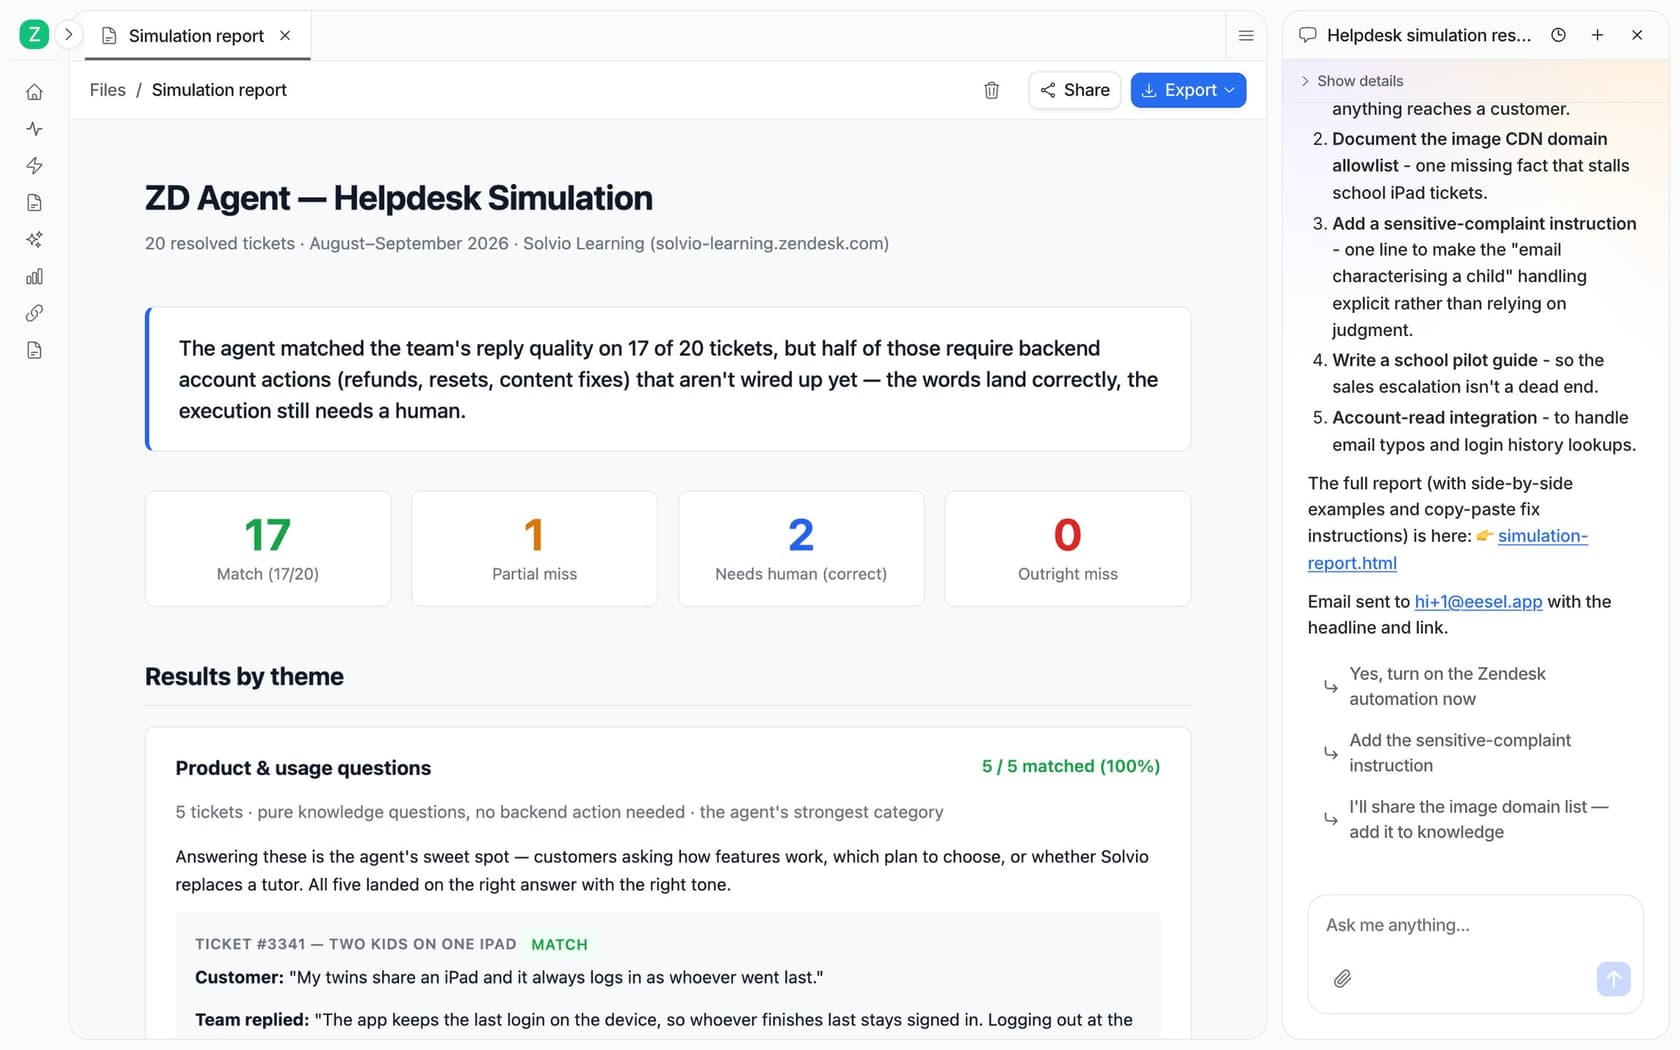
Diese Methode sollte aus meiner Sicht jeder Anbieter unterstützen. Deshalb hier, wie sie in eesel aussieht. Sie bitten den Agenten im Chat um eine Simulation, er holt Ihre gelösten Tickets und arbeitet sie in Stapeln ab. Danach sagt er Ihnen, wie viele Antworten mit dem übereinstimmten, was Ihr Team tatsächlich gesendet hat, Thema für Thema (eesel-Dokumentation).
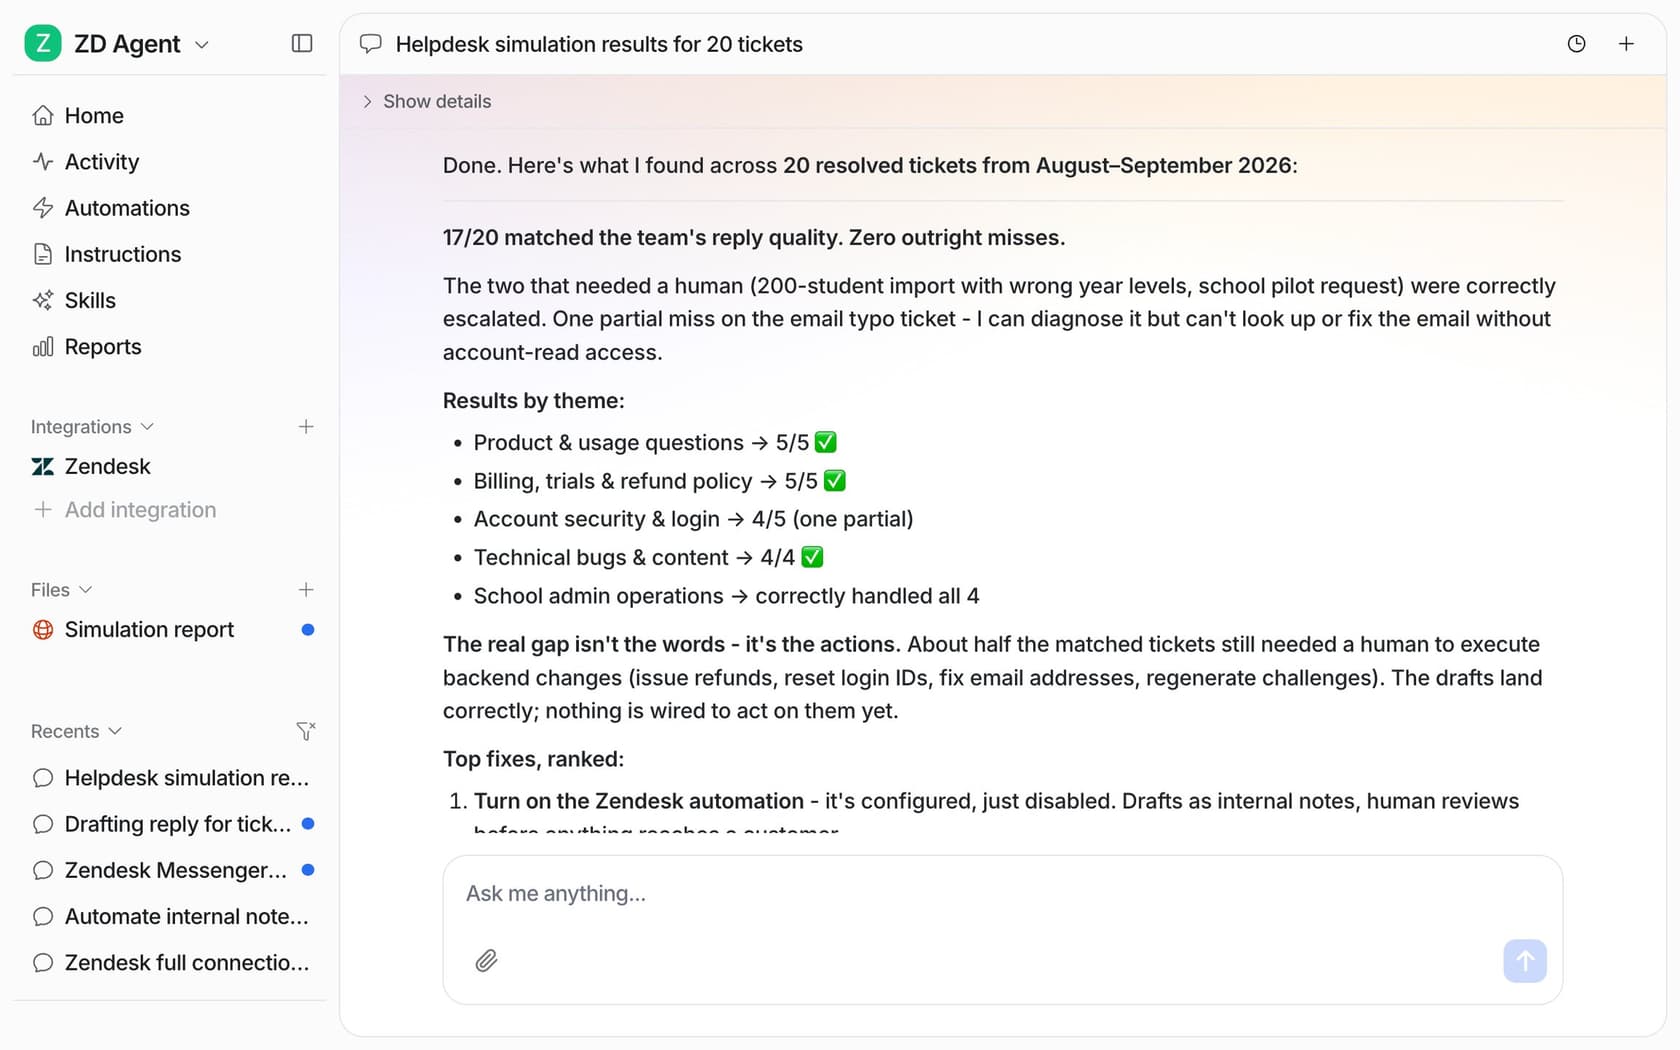
Im Beispiel der Dokumentation stimmten 17 von 20 Tickets überein. Der nützlichere Teil ist die Erkenntnis darunter: Die Entwürfe waren richtig, aber bei der Hälfte der übereinstimmenden Tickets musste dennoch ein Mensch eine Backend-Aktion ausführen, die noch niemand angebunden hatte. Diese Kaufeinsicht bekommen Sie aus keiner Demo.
Welches Tool Sie auch wählen: Bewerten Sie im Test mindestens vier Dinge: Triage-Genauigkeit, unverändert gesendete Entwürfe, sachliche Fehler und korrekte Eskalationen. Messen Sie auch die Antwortzeiten. Ein Käufer, mit dem eesel sprach, führte eine methodische Bewertung mit 67 Tests durch, fand die Antworten solide und sprang trotzdem ab, weil das Chat-Widget langsam war und ständig hängen blieb.
Schritt 5: Lesen Sie die Abrechnungseinheit, bevor Sie sich verlieben
Hier sehe ich am meisten Reue. Teams wählen den Agenten, der ihnen am besten gefiel, und merken erst auf der ersten Rechnung, was „Lösung“ bedeutet.
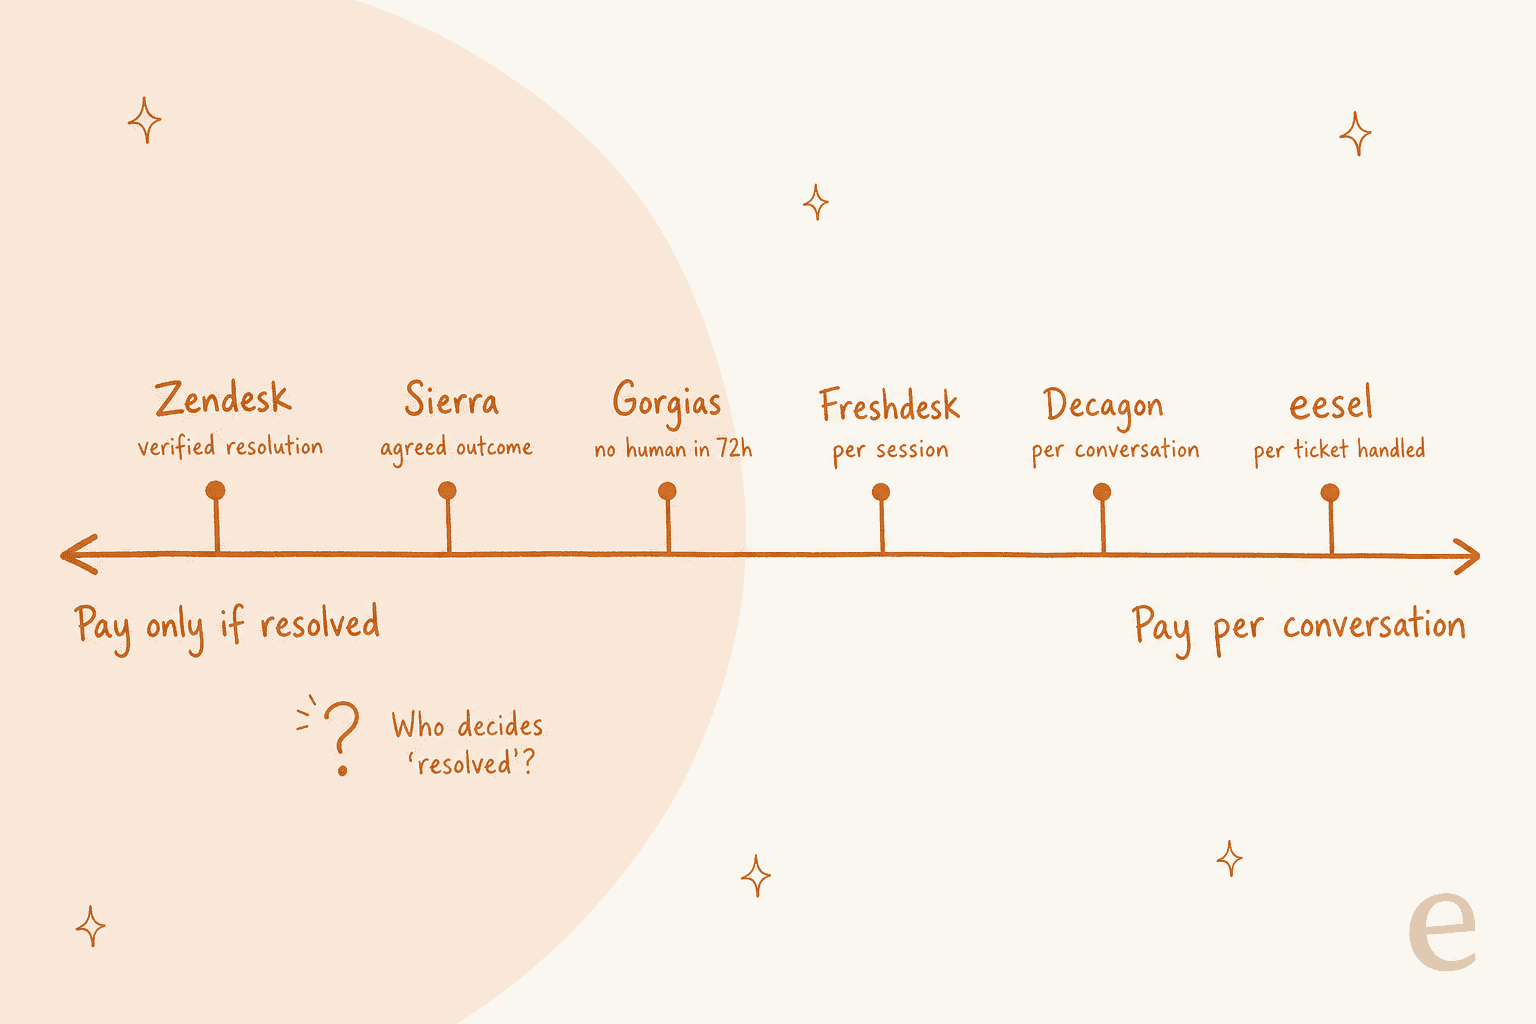
Hier steht, wofür jeder Anbieter tatsächlich abrechnet, mit seinen eigenen Worten:
| Anbieter | Abrechnungseinheit | Die Definition | Listenpreis | Berechnet, wenn nicht gelöst? |
|---|---|---|---|---|
| Zendesk | Verifizierte automatisierte Lösung | Ein LLM „wertet den Text der Konversation aus, um zu bestätigen, dass die Anfrage des Kunden zufriedenstellend gelöst wurde“ | 1,50 $ bei Commitment, 2,00 $ pay-as-you-go (Preise), nach einem Kontingent pro Agent | Nein |
| Gorgias | Automatisierte Interaktion, plus die Ticketgebühr | Der Kunde „benötigt innerhalb von 72 Stunden keine Beteiligung eines menschlichen Agenten“ | 0,85 bis 1,00 $ je nach Tarif | Ticketgebühr ja, Automatisierungsgebühr nein |
| Freshdesk | Sitzung | Chat: alles innerhalb von 24 Stunden. E-Mail: ein Fenster von 72 Stunden | 49 $ pro 100 Sitzungen, einmalig 500 kostenlos | Ja |
| Ada | Nicht veröffentlicht | Ada plädiert für Preise pro Konversation „unabhängig vom Ergebnis“ | Nur Demo | Unklar |
| Decagon | Pro Konversation (die meisten Kunden) oder pro Lösung | „Ein fester Satz für jede eingehende Konversation“ | Nur Demo | Ja, bei Preis pro Konversation |
| Sierra | Vereinbartes Ergebnis | „Ist die Konversation ungelöst, fällt in den meisten Fällen keine Gebühr an“ | Nur Demo | Meist nein |
| eesel | Bearbeitetes Ticket oder bearbeiteter Chat | „Ein Ticket oder Chat ist 1 Credit, egal wie lang“ | 299 $/Monat für 500, bis zu 1.749 $ für 5.000 | Ja, aber Spam und übersprungene Tickets zählen nicht |
Ehre, wem Ehre gebührt: Zendesk hat sein Modell am 18. Mai 2026 geändert. Bei den Lösungsstufen zählen „Assisted escalation“ und „Contained resolution“ nicht gegen Ihr Kontingent, und eine Lösung erreicht die Stufe „Verified“ erst nach einer LLM-Prüfung. Das greift die Kritik auf, die Zendesk-Nutzer äußerten, als die Abrechnung pro Lösung eingeführt wurde:
„Totaler Müll lol, Zeug, das früher kostenlos war, zählt jetzt als AR. Die meisten ARs sind abgebrochene Chats. Es gibt kein Verfahren, um das anzufechten.“
Dieser Kommentar stammt von 2024, und ältere Konten laufen womöglich noch nach dem früheren Schema, bis sie umgestellt werden. Prüfen Sie also, welches bei Ihnen gilt. Selbst Anbieter, die Preise pro Lösung verkaufen, räumen ein, dass die Definition schwammig ist. Decagons eigener Produktdirektor schrieb: „Man will nie in die Lage geraten, darüber zu streiten, was eine ‚Lösung‘ ist“ (Decagon).
Das größere Problem ist, wie jedes Modell skaliert. Probieren Sie den Rechner unten aus: Stellen Sie das Volumen auf Ihre Warteschlange und schieben Sie dann die Lösungsquote nach oben.
Bei 2.000 von der KI bearbeiteten Konversationen im Monat kippt das Bild, wenn der Agent besser wird:
| Lösungsquote | Zendesk (1,50 $/Lösung) | Gorgias (0,90 $/Interaktion) | Freshdesk (0,49 $/Sitzung) | eesel (2.000-Credit-Tarif) |
|---|---|---|---|---|
| 20 % (früher Pilot) | 600 $ | 360 $ | 980 $ | 849 $ |
| 50 % | 1.500 $ | 900 $ | 980 $ | 849 $ |
| 70 % (ausgereift) | 2.100 $ | 1.260 $ | 980 $ | 849 $ |
Das Modell pro Lösung ist genau dann am günstigsten, wenn der Agent am schlechtesten ist. Das ist kein Grund, diese Tools auszuschließen, denn Sie bezahlen auch für einen funktionierenden Agenten. Es ist ein Grund, Ihren Spitzenmonat vor der Unterschrift durchzurechnen und zu fragen, ob die Lösungszählung des Anbieters Spam und abgebrochene Chats einschließt. Mehr zur Rechnung finden Sie in meiner Aufschlüsselung der Kosten pro Lösung sowie in den Leitfäden zu Zendesk-AI-Preisen und Freddy-AI-Preisen.
Ein Gorgias-Rezensent auf G2 benannte das Problem der Hochsaison direkt:
„Wenn unser Bestellvolumen wächst und mehr Kundenanfragen kommen, steigen die Kosten schnell auf eine Weise, die schwer vorherzusehen und zu budgetieren ist. In Spitzenzeiten wie den Feiertagen, wenn das Support-Volumen hochschnellt, können die Kosten in kurzer Zeit erheblich steigen.“

Schritt 6: Prüfen Sie, was er tun kann und was ihn bremst
Fragen zu beantworten ist die halbe Arbeit. Die andere Hälfte ist Handeln: eine Bestellung nachschlagen, einen Artikel erstatten, ein Ticketfeld aktualisieren. Und zu jeder Aktion, die er ausführen kann, brauchen Sie eine passende Bremse.
Prüfen Sie bei den Aktionen für jeden Anbieter drei Dinge:
- Funktioniert es auf Ihrem System, direkt ab Werk? Die Shopify-Aktionen von Gorgias brauchen keine zusätzlichen Schritte, wenn Shopify bereits verbunden ist. Bei Zendesk bedeuten Bestellabfragen und Erstattungen, dass Sie eine API-Integration oder einen Aktionsablauf gegen Ihr eigenes System bauen (Zendesk).
- Ist es eingeschränkt? Ada begrenzt Sie standardmäßig auf „fünf aktive, kundenseitige API-Tools pro AI Agent“ und weist darauf hin, dass die Funktion „möglicherweise nicht im Abonnementpaket Ihrer Organisation enthalten ist“ (Ada).
- Wer baut es? Sierra sagt, komplexe Workflows und Integrationen „erfordern weiterhin Code“ (Sierra). Das ist in Ordnung, wenn Sie Entwickler übrig haben, und ein Hindernis, wenn nicht.
Der Test ist einfach: Lassen Sie ihn im Test die Aktion an einer Testbestellung ausführen und prüfen Sie das Ergebnis im Quellsystem, nicht nur die Antwort. Ein Entwickler auf Reddit beschrieb einen Agenten, dessen „Textantworten perfekt aussahen“, während er Daten aus dem Konto des falschen Nutzers zog (u/properwomanhood_292, Reddit).
Bei den Schutzmechanismen achten Sie auf drei Dinge. Erstens die Freigabe pro Aktion: Bei eesel können Sie jede Aktion so einstellen, dass sie eigenständig läuft, vorher fragt oder deaktiviert bleibt, und die Dokumentation empfiehlt, „Erstattungen, Stornierungen und alles, was Geld kostet, hinter eine Freigabe“ zu legen (eesel-Dokumentation). Zweitens die Steuerung auf Themenebene: Auf der KI-Abdeckungsseite von Gorgias können Sie jede Absicht auf „AI allowed“ oder „Handover“ setzen (Gorgias). Drittens eine Übergabe an Menschen, die Kontext weitergibt, keinen Transkript-Dump.
Das Letzte ist wichtiger, als es klingt:
„behoben, indem wir eine strukturierte Übergabezusammenfassung statt eines rohen Transkript-Dumps erzwungen haben (hat mehr Zeit gespart als die Automatisierung selbst). CSAT bei abgefangenen Anfragen in Ordnung, eingebrochen bei allem, was nach einem gescheiterten Bot-Versuch zurückkam“

Prüfen Sie außerdem die Eskalationsauslöser an Ihren eigenen Tickets. Eine Support-Leiterin auf Reddit sagte, ihre ersten Regeln, „eskalieren, wenn es um Abrechnung geht oder bestimmte Schlüsselwörter fallen“, hätten „etwa die Hälfte der Situationen, in denen tatsächlich ein Mensch nötig war“, verpasst (u/Salt-Question8632, Reddit). Mein Leitfaden zu Eskalationsauslösern behandelt die Muster, die funktionieren.
Schritt 7: Rollen Sie gestuft aus und wählen Sie ein Tool, das das zulässt
Die letzte Prüfung betrifft den Rollout, nicht das Produkt, sollte aber beeinflussen, welches Produkt Sie kaufen. Sie wollen ein Tool, das beaufsichtigt starten und sich Thema für Thema Autonomie verdienen kann.
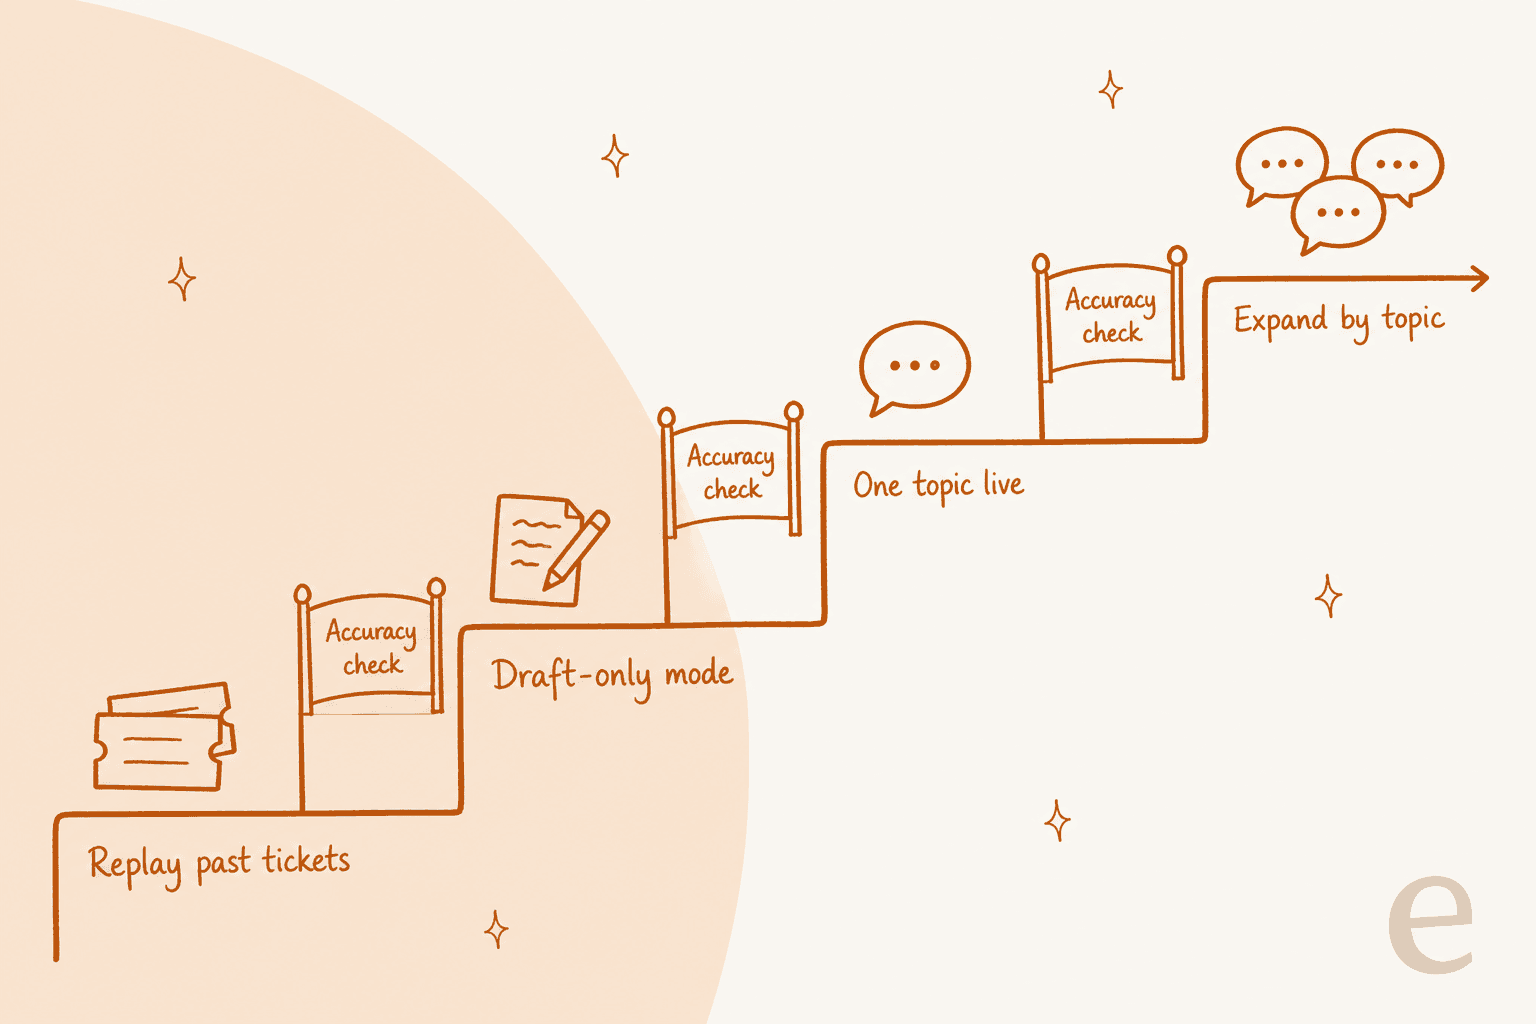
Amoghs Eindruck aus Verkaufsgesprächen: Erst Copilot, dann volle KI ist das Muster, das fast alle wollen: im Modus „Antwort entwerfen“ starten und auf Vollautomatik umschalten, sobald Sie vertrauen. Eine Support-Leiterin auf Reddit beschrieb dasselbe aus Betreibersicht:
„Der sicherste Rollout, den ich gesehen habe: Der Agent entwirft, markiert Konfidenz plus Begründung, Erstattungen oder Kontoänderungen brauchen eine Freigabe, und im ersten Monat wird jede wieder geöffnete Konversation geprüft. In diesem Prüfprotokoll zeigt sich meist die echte Automatisierungsgrenze.“
Fragen Sie also jeden Anbieter: Kann er Entwürfe als interne Notizen zur Freigabe durch Mitarbeitende ablegen? Kann ich ihn nur für ein Thema oder einen Kanal einschalten? Kann ich begrenzen, wie viele Antworten er pro Tag sendet? Freshdesks E-Mail-Agent hat genau diese Obergrenze, „nützlich für kontrollierte Rollouts“ (Freshdesk). Zuerst zu entwerfen gibt Ihrem Team zudem einen KI-Copilot, während Sie Belege sammeln, sodass sich der Test durch eingesparte Tipparbeit selbst bezahlt.
Die Fragen an jeden Anbieter
Nehmen Sie das in jede Demo mit. Kann ein Anbieter eine Frage nicht klar beantworten, ist das Ihre Antwort.
| Frage | Warum sie wichtig ist |
|---|---|
| Kann ich ihn vor dem Livegang an meinen eigenen alten Tickets testen? | Geschriebene Szenarien testen nur, woran Sie gedacht haben |
| Woran wird er in diesem Test bewertet? | „Beantwortet“ ist nicht dasselbe wie „korrekt“ |
| Lernt er aus unseren gelösten Tickets und Makros? | Dort stecken der Ton Ihres Teams und Ihre echten Richtlinien |
| Was genau zählt als abrechenbare Einheit? | „Lösung“ bedeutet fast bei jedem Anbieter etwas anderes |
| Wie sieht meine Rechnung in unserem stärksten Monat aus? | Kosten pro Lösung steigen, wenn der Agent besser wird |
| Zählt eine Lösung Spam oder abgebrochene Chats mit? | Bläht Rechnung und gemeldete Quote auf |
| Welche Aktionen funktionieren auf meinem System ohne Entwicklung? | Demo-Systeme sind nicht Ihr System |
| Kann er nur Entwürfe liefern, pro Thema, mit Freigaben bei Erstattungen? | Gestufter Rollout verhindert einen öffentlichen Fehler |
| Was erhält ein Mensch bei der Übergabe? | Eine schlechte Übergabe kostet mehr Agentenzeit, als sie spart |
| Funktioniert er in meinem aktuellen Helpdesk? | Den Helpdesk für einen KI-Agenten zu wechseln, ist ein großer versteckter Kostenpunkt |
Für eine fertige Auswahlliste, an der Sie diese Fragen testen können, sehen Sie sich meine Übersicht der KI-Support-Agenten und meine Liste der Support-Automatisierungstools an.
Fehler, die ich bei Teams sehe
- Urteil nach einer einzigen Zahl. Die Lösungsquote eines Anbieters oder Ihre eigene „Genauigkeit“ verdeckt die Geschichte. Verfolgen Sie Deflection-Rate, KI-CSAT und wieder geöffnete Tickets nebeneinander. Wie ein Hacker-News-Kommentator sagte, sieht die Führung vielleicht Kennzahlen, wonach der KI-Serviceagent 80 % der Fragen erfolgreich geholfen hat, „aber sie merken nicht, wie schädlich diese 20 % sind“ (cortesoft, Hacker News).
- Testen vor dem Preis. Ein Testnutzer, mit dem eesel arbeitete, sah großartige Ergebnisse in 12 Test-Chats und bat dann um Kündigung, als er die Abrechnungsseite sah. Rechnen Sie zuerst die Kosten durch, dann testen Sie.
- Den Bot selbstsicher über Dinge sprechen lassen, die er nicht kann. Ein G2-Rezensent bemerkte, Ada habe einmal „Aktionen angeboten, die sie gar nicht ausführen kann (zum Beispiel Bestellungen stornieren)“, fügte aber hinzu, dass Coaching das behoben habe (G2). Testen Sie die Grenze dessen, was er versprechen darf.
- Den Übergabetest überspringen. Abgefangene Tickets sehen im Dashboard gut aus; bei zurückgekehrten Tickets sinkt der CSAT.
- Einen neuen Helpdesk kaufen, um einen KI-Agenten zu bekommen. Wenn Sie nicht ohnehin wechseln wollten, ist die Migration nur für einen Agenten der teuerste Weg zur Automatisierung. Schauen Sie sich zuerst Optionen an, die in Ihrem bestehenden Zendesk-, Freshdesk- oder Gorgias-Setup funktionieren.
eesel für Ihren Helpdesk ausprobieren
Wenn Sie gerade einen KI-Agenten für den Kundenservice auswählen: Der KI-Helpdesk-Teamkollege von eesel wurde um die obigen Prüfungen herum gebaut. Er schließt sich dem Helpdesk an, den Sie bereits nutzen (Zendesk, Freshdesk, Gorgias, Front, HubSpot, Help Scout, Salesforce und mehr), lernt bei voller Anbindung aus Ihren alten Tickets und Makros und führt eine Simulation über Ihre gelösten Tickets aus. So sehen Sie, wo er zu Ihrem Team passt und wo nicht, bevor ein Kunde eine Antwort sieht. Er startet im Entwurfsmodus mit Erstattungen hinter einer Freigabe, und Sie erweitern seinen Umfang Thema für Thema.
Gridwise formulierte es nach dem Test so: „Im ersten Monat löst eesel 73 % unserer Tier-1-Anfragen.“ Die Preise sind ein Pauschaltarif pro bearbeitetem Ticket, ab 299 $/Monat für 500 Tickets, ohne Arbeitsplatzgebühren, und Spam zählt nicht. Der kostenlose Tarif gibt Ihnen 100 Credits, um zuerst echte Entwürfe an Ihren eigenen Tickets zu sehen.
eesel testen Sie kostenlos, oder buchen Sie eine Demo und bringen Sie Ihr Briefing mit.