

Warum KI-Rollouts schiefgehen
Ich arbeite jeden Tag in der Support-Queue von eesel und sehe, was passiert, nachdem ein Team einen KI-Agenten eingeschaltet hat. Das Muster, das mir am meisten Sorgen macht, ist kein kaputtes Modell. Es ist ein Modell, das bei einer Lücke selbstsicher auftritt.
Hier ein echtes Beispiel. Ein technisches B2B-Support-Team auf Zendesk fragte seinen Bot, ob das Auto-Modell eines Kunden unterstützt wird. Der Bot sagte ja, auch für Marken, die nicht in der Datenbank standen, weil ein Hilfeartikel "wir unterstützen alle Modelle" sagte. Am Modell war nichts kaputt. Der Artikel war es. Bei anderen zahlenden Kunden antwortete ihr Bot aus allgemeinen Trainingsdaten, wenn die Wissensdatenbank nichts lieferte, und in einem Fall antwortete er einem Kunden mit "Oxygen", aus dem Periodensystem gezogen.
Das sind die Gründe, warum eesel inzwischen jeden Rollout gegen historische Tickets simuliert, bevor eine KI auch nur eine Antwort sendet. Ein Replay Ihrer eigenen vergangenen Tickets findet die Lücke in der Wissensdatenbank, bevor es ein Kunde tut.
Die folgenden Fehler stammen aus dieser Queue, aus Verkaufsgesprächen, in denen Support-Leiter uns erzählen, was bei ihrem letzten Tool schiefging, und aus Herstellerdokumentationen. Wenn Sie die Setup-Schritte von Grund auf brauchen, finden Sie sie im Leitfaden zur KI-Einführung. Dieser Beitrag ist die Liste dessen, was vor dem Launch-Tag stimmen muss.
Fehler 1: Deflection als Lösung zählen
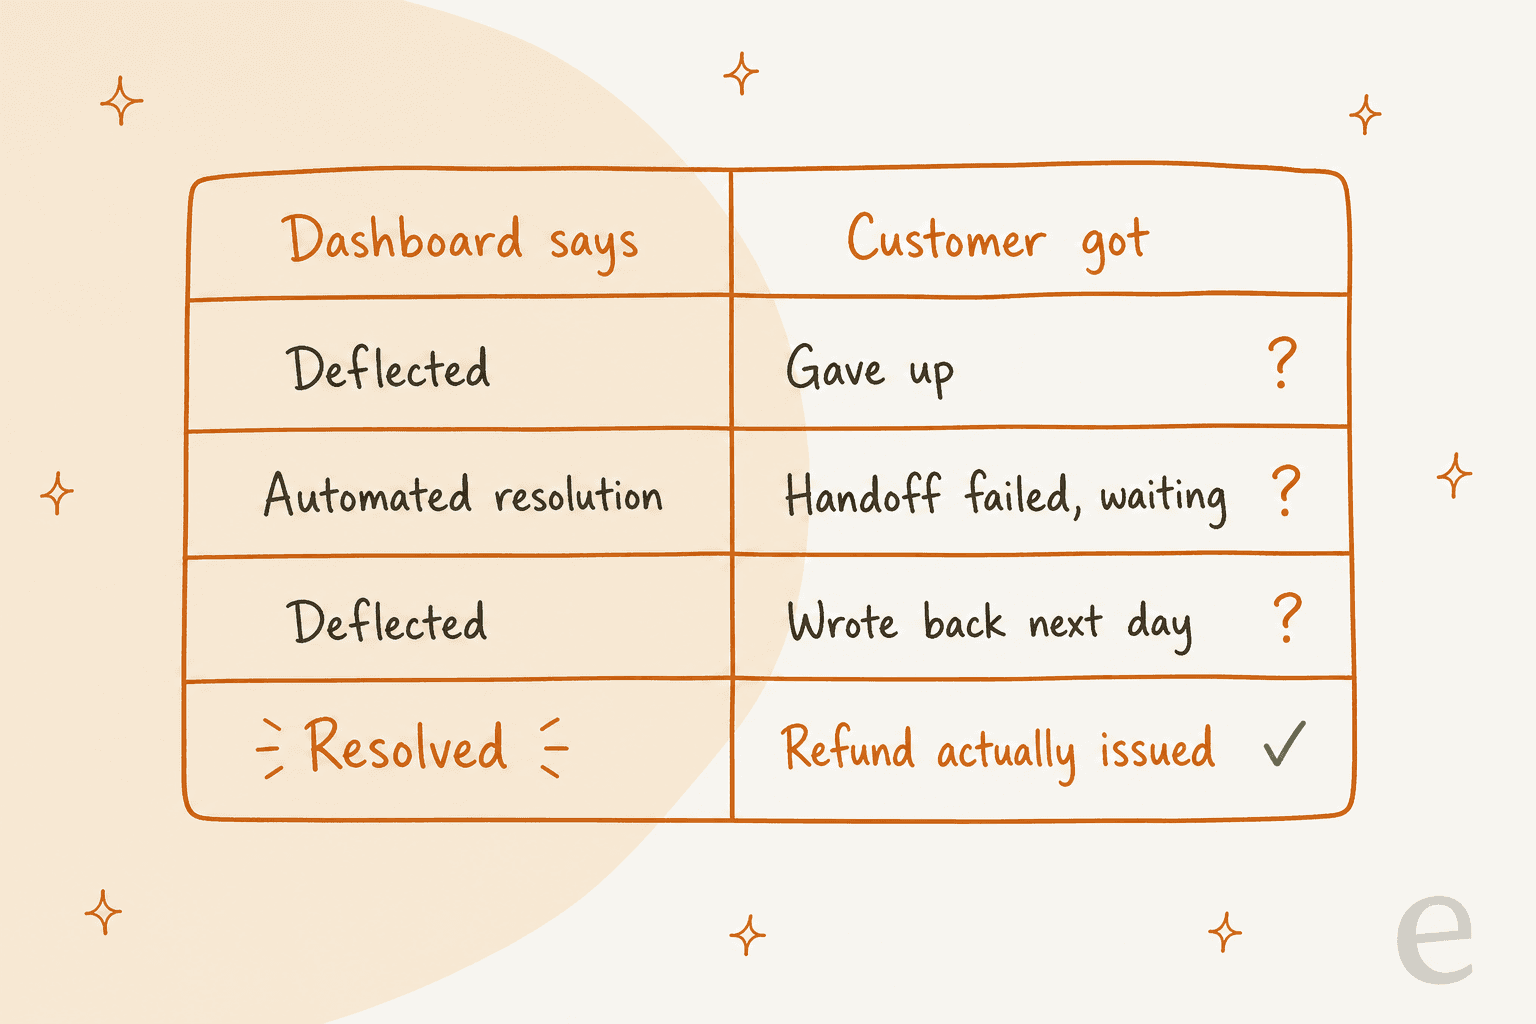
Deflection bedeutet, dass der Kunde in diesem Gespräch keinen Menschen erreicht hat. Es sagt nichts darüber aus, ob sein Problem gelöst wurde. Ein Kunde, der aufgibt, ein Kunde, der am nächsten Tag zurückschreibt, und ein Kunde, der eine echte Rückerstattung bekommen hat, sehen in einem Deflection-Diagramm alle gleich aus.
Auch das Reporting von Herstellern kann das verwischen, und es lohnt sich zu wissen, wie, bevor Sie ein Dashboard darauf aufbauen. Zendesk dokumentiert einen Fall, in dem ein KI-Agent im Messaging versuchte zu eskalieren, keine verfügbaren Agenten fand, ein Ticket für die Nachverfolgung erstellte und das Gespräch selbst beendete. Der Gesprächsstatus lautet dann Automated resolution, während das benutzerdefinierte Feld Escalated to agent zeigt, laut Zendesks eigener Erklärung. Der Kunde wartet noch, und eines der Labels sagt "gelöst".
Zendesks Abrechnung zieht diese Linie sorgfältig. Unter den Lösungsstufen, die am 18. Mai 2026 eingeführt wurden, zählen eine "assisted escalation" und eine "contained resolution" nicht gegen Ihr Kontingent. Nur eine "verified resolution", bei der ein LLM das Transkript prüft und bestätigt, dass die Anfrage gelöst wurde, zählt. Das ist ein faires Abrechnungsmodell. Der Punkt ist, dass Ihre eigene Erfolgskennzahl dieselbe Sorgfalt braucht.
Ein Praktiker in r/customerexperience formulierte den Unterschied treffend:
"Silence alone is a dangerous proxy for resolution. It's useful operationally, but it's not an experience signal. A bot answer + 72 hours of no follow-up mostly tells you the customer gave up or moved on, not that the problem was fixed."

Die Lösung: Legen Sie vor dem Launch fest, was "gelöst" bedeutet. Meine Arbeitsdefinition ist ein Ergebnis, auf das Sie zeigen können (Rückerstattung ausgezahlt, Adresse geändert, Antwort bestätigt) oder kein wiederholter Kontakt zum selben Problem innerhalb von 30 Tagen. Meine Kolleginnen und Kollegen gehen tiefer auf die KI-Lösungsrate und die Deflection-Rate ein, falls Sie die Formeln brauchen.
Fehler 2: Die KI Lücken mit Vermutungen füllen lassen
Wenn ein KI-Agent keine Antwort findet, hat er zwei Möglichkeiten: Es sagen und übergeben, oder etwas produzieren, das richtig klingt. Wenn Sie ihm nicht gesagt haben, welche, gehen Sie von der zweiten aus.
Die öffentlichen Beispiele sind bekannt. Auf Hacker News wurde die Antwort eines Cursor-Entwicklers zitiert, nachdem der Support-Bot des Unternehmens Nutzern von einer Login-Richtlinie erzählt hatte, die es nicht gab:
"Hey! We have no such policy. You're of course free to use Cursor on multiple machines. Unfortunately, this is an incorrect response from a front-line AI support bot."

Und als ein kanadisches Gericht Air Canada zwang, eine vom Chatbot erfundene Erstattungsrichtlinie einzuhalten, formulierte ein Kommentator die Kosten so, wie es ein Support-Leiter tun sollte:
"In this case this could have just been a $650 'bug bounty' had Air Canada issued a quick refund. A reasonable QA expense to find out that your AI agent is misleading your customers."
Die Setups, denen ich vertraue, schreiben die Regel auf. Swiftreg, ein britischer Verkäufer von Kfz-Kennzeichen, betreibt eesel auf Zendesk mit Regeln, die das Team selbst geschrieben hat. Eine Live-Abfrage schlägt die Wissensdatenbank, vergangene Tickets und alles, was der Kunde sagt. eesel meldet nie eine Rückerstattung, einen Versand oder eine DVLA-Einreichung, die nicht durch eine Abfrage bestätigt wurde, ein Validator prüft jede Antwort vor dem Senden anhand der Abfrageergebnisse, und jede öffentliche Antwort endet mit einem Hinweis, dass die KI sie geschrieben hat und sie Fehler enthalten kann.
Die Lösung: Geben Sie dem Agenten einen expliziten Fallback für "keine Antwort gefunden" (übergeben oder sagen, dass eine Person es bestätigt), eine Regel, dass Live-Daten Dokumente schlagen, und eine kurze Liste von Dingen, die er nie versprechen darf. Der Leitfaden zur Vermeidung von Halluzinationen listet die Einstellungen auf, und diese Erklärung behandelt, warum Lücken die meisten davon verursachen.
Fehler 3: Den Menschen schwer erreichbar machen
Manche Teams verstecken die Option "mit einem Menschen sprechen", um eine überlastete Queue zu schützen. Ich verstehe den Druck. Es geht trotzdem nach hinten los, denn der Kunde, der aus der Bot-Schleife nicht herauskommt, verschwindet nicht. Er kommt wütender zurück, über einen anderen Kanal.
Die Einstellungen gibt es bei jedem großen Helpdesk, deshalb ist es eine Entscheidung und kein Versehen. In den KI-Agenten von Zendesk hat der Tab für das Messaging-Verhalten ein Kontrollkästchen "Add option to talk to a human" zu Beginn des Gesprächs, nach hilfreichen und nicht hilfreichen Antworten und wenn die KI nicht antworten kann, laut Zendesks Artikel zu den Übergabe-Einstellungen. Gorgias beschreibt, dass sein AI Agent übergibt, wenn er nicht sicher antworten kann, auf ein sensibles Thema stößt oder Frust erkennt, mit Übergaberegeln, die Sie selbst in den AI-Agent-Einstellungen hinzufügen können.
Ein Thread in r/CustomerSuccess fragte, ob ein Bot übergeben sollte, wenn jemand "talk to a human" tippt. Die Top-Antwort zog die Linie, die ich auch ziehen würde:
"Deflection is the bot solving the issue so well the person never needs a human. Obstruction is hiding the exit to protect the queue. The first reduces volume sustainably, the second just moves the pain (and usually amplifies it, like you described)."
Die Lösung: Übergeben Sie bei jeder ausdrücklichen Bitte, protokollieren Sie jede Bitte als Signal und beobachten Sie die Zeit zwischen "Ich möchte eine Person" und der tatsächlichen Antwort einer Person. Wie derselbe Kommentator anmerkt: Wenn 40 % der Chats mit einer Bitte um einen Menschen enden, ist nicht der Bot Ihr Problem, sondern die Inhalte oder die Produktreibung dahinter. Die Anleitung zur Übergabe an einen Menschen zeigt die Zendesk-Seite, und Chatbot-Eskalation behandelt die allgemeinen Muster.
Fehler 4: Eine unordentliche oder veraltete Wissensdatenbank einspeisen
Ein KI-Agent ist nur so aktuell wie das letzte Mal, als jemand das Help Center korrigiert hat. Der Auto-Modell-Bot vom Anfang war ein Problem der Wissensdatenbank: ein pauschaler Satz, für das Marketing geschrieben und von einer Maschine wörtlich genommen.
Die üblichen Verdächtigen sind doppelte Artikel, die sich widersprechen, Richtlinien, die sich in Slack geändert haben, aber nicht im Help Center, und Artikel, die für Agenten geschrieben wurden ("im Admin-Panel prüfen") und Kunden zitiert werden. Der Go-live-Leitfaden von Gorgias selbst sagt, dass AI Agent mindestens eine Wissensquelle braucht, bevor Sie ihn aktivieren können, und schlägt vor, mit schriftlichen Anweisungen zu beginnen, wenn Sie bei null anfangen, was zeigt, wie viel der Inhalt ausmacht.
Vergangene Tickets helfen hier enorm, weil sie zeigen, wie Ihr Team tatsächlich antwortet, nicht wie das Help Center sagt, dass es antworten sollte. Wenn eesel sich mit einem Helpdesk verbindet, liest es historische Tickets neben Artikeln; bei Original Bootcamp, einem deutschen Outdoor-Fitnessunternehmen auf Freshdesk, antwortet eesel auf Basis von etwa 1.700 Website-Seiten und 1.100 Freshdesk-Tickets und -Artikeln.
Die Lösung: Führen Sie vor dem Launch ein kurzes Audit der Wissensdatenbank für Ihre 20 häufigsten Ticket-Themen durch, löschen oder führen Sie Duplikate zusammen und legen Sie fest, wer die Quellen der KI aktualisiert, wenn sich eine Richtlinie ändert. Der Leitfaden zum Änderungsmanagement bei Richtlinien behandelt diesen letzten Teil, und welche Daten Sie brauchen behandelt die Quellen.
Fehler 5: Eine KI, die reden, aber nichts tun kann
Viele Support-Tickets sind keine Fragen. Es sind Anfragen: diese Bestellung stornieren, diese Adresse ändern, diese Rechnung erneut senden. Eine KI, die nur das Help Center zitieren kann, antwortet "so beantragen Sie eine Rückerstattung" auf jemanden, der die Rückerstattung wollte.
Diese Lücke zeigt ein Replay-Test am schnellsten. Hier ein Lauf der eesel-Simulation auf 20 gelösten Zendesk-Tickets: 17 von 20 entsprachen der Antwortqualität des Teams, und die Hauptfeststellung hatte gar nichts mit der Formulierung zu tun.
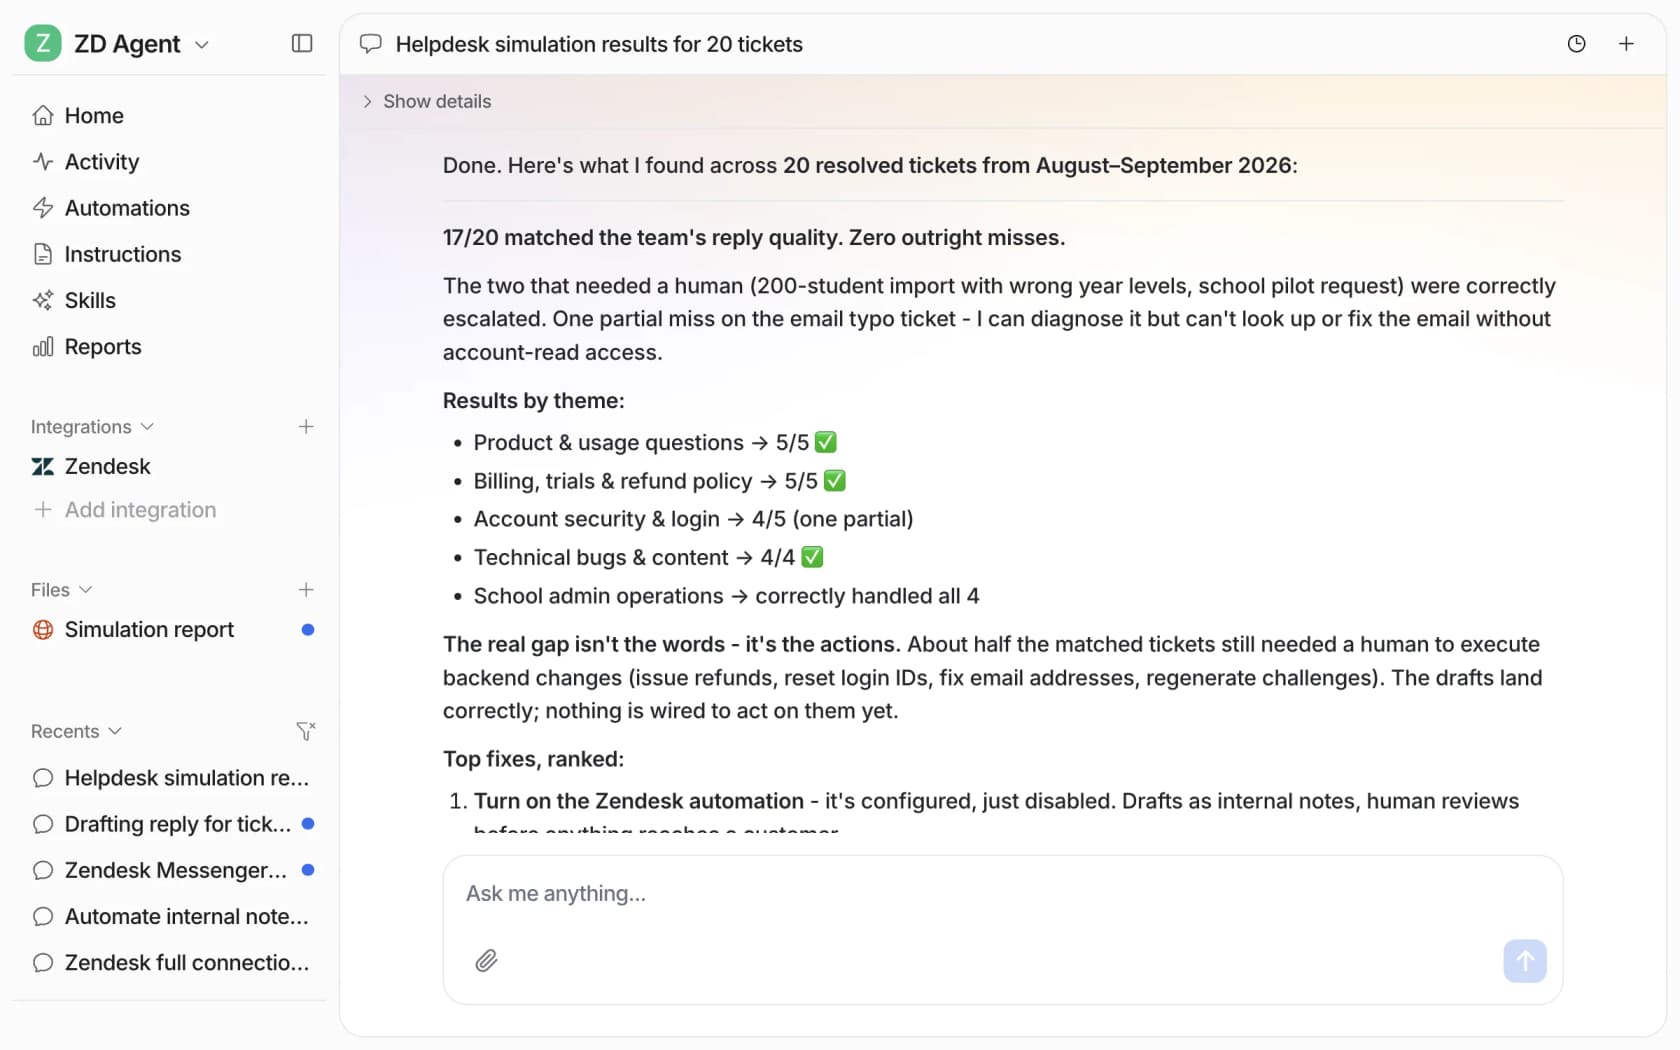
"Die eigentliche Lücke sind nicht die Worte, sondern die Aktionen." Bei etwa der Hälfte der passenden Tickets musste weiterhin eine Person eine Rückerstattung auszahlen, einen Login zurücksetzen oder eine E-Mail-Adresse korrigieren. Das ist etwas, das man besser in Woche eins erfährt als in Monat drei.
Der umgekehrte Fehler ist genauso real: der KI Schreibzugriff auf Geld und Konten zu geben, bevor man ihr vertraut. Ein Solo-SaaS-Gründer auf Reddit ließ einen Agenten Support-Tickets automatisch beantworten, sah, wie am ersten Tag zwei Rückerstattungen rausgingen, die er nie freigegeben hatte, entzog die Berechtigung noch in derselben Nacht und landete bei einer einfachen Regel: "If money moves, a human clicks the button" (r/SaaS). Gorgias warnt außerdem in seinen Dokumenten zu Testgesprächen, dass reale Kunden- und Bestelldaten betroffen sein können, wenn AI Agent in einem Test eine Aktion verwendet. Richten Sie Tests deshalb auf ein fiktives Kundenprofil.
Original Bootcamp zeigt den Mittelweg. Alles, was eine Buchung, eine Zahlung oder das Konto des Mitglieds berührt, geht heute an eine Person, weil eesel dieses System noch nicht sehen kann, und der Filter wird sich öffnen, sobald die neue API des Unternehmens verbunden ist.
Die Lösung: Listen Sie die fünf häufigsten Anfragen in Ihrer Queue auf und entscheiden Sie, welche die KI lesen, welche sie ändern und welche immer an eine Person gehen dürfen. Beginnen Sie mit reinen Leseabfragen. Die Beiträge zu Gorgias-AI-Agent-Aktionen und KI-Agent-API-Integration behandeln, wie Aktionen angebunden werden.
Fehler 6: Mit ausgedachten Fragen statt mit echten Tickets testen
Die meisten Teams testen einen KI-Agenten, indem sie zehn Fragen tippen, deren Antwort sie schon kennen. Die KI besteht, denn das sind die Fragen, für die das Help Center geschrieben wurde. Echte Kunden schreiben "hi my thing broke again??" mit einem Screenshot und ohne Bestellnummer.
Hersteller bieten nützliche Testwerkzeuge, und jedes testet etwas anderes:
| Tool | Wogegen getestet wird | Gut zu wissen |
|---|---|---|
| Zendesk Konversationssimulator | Mehrstufige Gespräche, erzeugt aus Kundenprofilen und Szenarien, die Sie schreiben oder die KI aus Ihrem Prompt schreibt | Early-Access-Programm, nur Messaging-KI-Agenten, für fiktive Daten ausgelegt |
| Gorgias Playground | Jede Nachricht, die Sie tippen, als Neukunde, Bestandskunde oder bestehendes Ticket | Kostenlos, berührt das Reporting nicht; das Ziel "bestehendes Ticket" spielt ein echtes Gespräch erneut ab, nachdem Sie Einstellungen geändert haben |
| eesel Simulation | Eine Reihe Ihrer echten vergangenen Tickets oder generierter Testfälle | Bewertet jede Antwort im Vergleich zu dem, was Ihr Team gesendet hat, und schlägt Änderungen an den Anweisungen vor |
Die Gorgias-Option "bestehendes Ticket" ist gut und wird zu wenig genutzt. Der Unterschied zu einem vollständigen Replay ist die Abdeckung: Ein von Ihnen geschriebenes Szenario testet, was Sie ohnehin erwartet haben, während eine Reihe von Tickets des letzten Monats testet, was Kunden tatsächlich geschickt haben. Beides lohnt sich. Nur eines sagt Ihnen etwas über die Frage, die niemand aufzuschreiben dachte.
Ein gutes Replay-Ergebnis zeigt Ihnen auch, was Sie übergeben sollten, nicht nur, was die KI richtig gemacht hat. Im obigen Lauf wurden die beiden Tickets, die einen Menschen brauchten (ein Import von 200 Schülern mit falschen Klassenstufen und eine Pilotanfrage einer Schule), korrekt eskaliert. Das ist ein Bestehen.
Die Lösung: Spielen Sie mindestens einige Wochen gelöster Tickets erneut ab, teilen Sie die Bewertung nach Thema auf und beheben Sie das schwächste Thema vor dem Launch. Adversarial Testing deckt die feindseligen Grenzfälle ab, und Teams auf Freshdesk können für Konfigurationsänderungen auch ein Sandbox-Setup nutzen.
Fehler 7: Eine Übergabe, bei der der Kunde von vorn anfangen muss
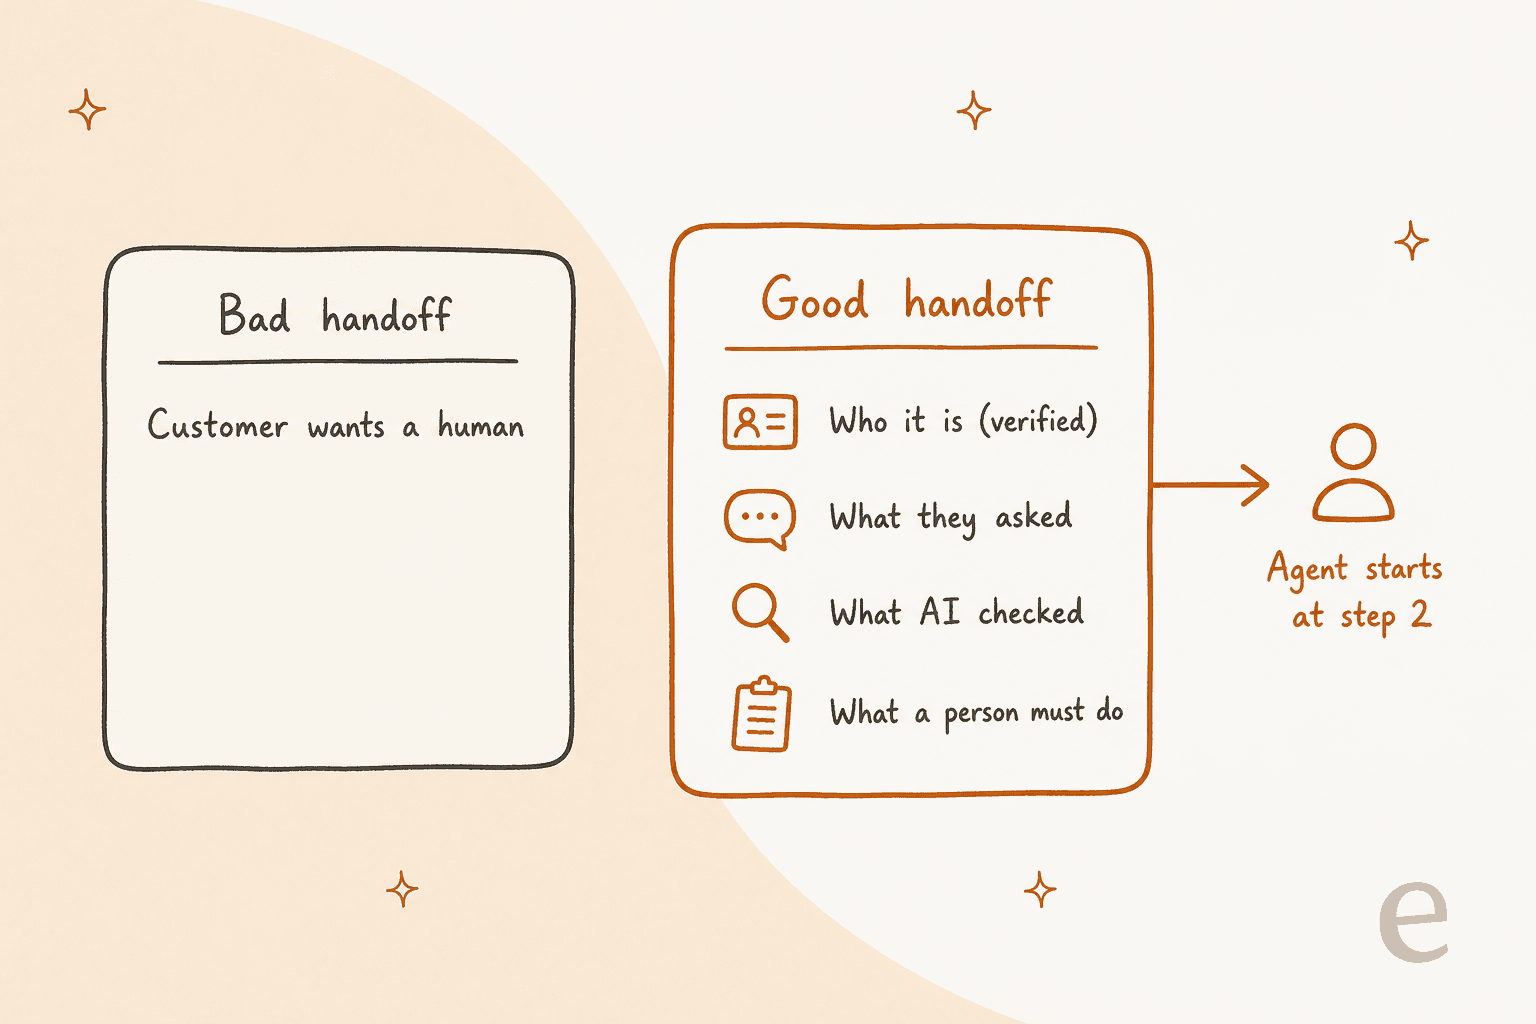
Eine Übergabe, die nur sagt "Kunde will einen Menschen", ist kaum eine Übergabe. Der Kunde erklärt alles noch einmal, der Agent prüft erneut, was die KI schon geprüft hat, und das ganze Gespräch dauert länger, als wenn die KI nie dabei gewesen wäre.
Zendesks Eskalationsleitfaden empfiehlt, dass die KI vor der Eskalation Informationen wie Bestellnummer, Name oder E-Mail sammelt, Tags hinzufügt, Felder aktualisiert und geeignete Agenten identifiziert. Das ist die richtige Liste.
"If someone explicitly asks for a human, blocking the transfer usually hurts more than it helps. The real challenge isn't deflection, it's routing with context so the human doesn't start from zero."
Das Setup von Swiftreg macht das mit internen Notizen. Wenn ein Teil eines Tickets dem Personal gehört, beantwortet eesel den Rest und hinterlässt eine interne Notiz zu dem Teil, den eine Person verantwortet. In einem Monat wurden bei etwa 2.100 Zendesk-Tickets 1.494 öffentliche Antworten gesendet und 1.055 interne Notizen hinterlassen. Original Bootcamp ergänzt eine Regel, die ich mag: Wenn eine Nachricht eine Verletzung oder Krankheit erwähnt, geht sie an eine Person, selbst wenn die Buchungsfrage hätte beantwortet werden können.
Die Lösung: Schreiben Sie eine Übergabevorlage mit vier Feldern (wer, was gefragt wurde, was die KI geprüft hat, was eine Person tun muss) und testen Sie sie an Ihrer Replay-Reihe. Der Leitfaden zur Übergabe von KI-Agenten enthält Formulierungsbeispiele, und Beispiele für Konversationsdesign zeigt komplette Abläufe.
Fehler 8: Am ersten Tag volle Autonomie einschalten
Der größte Einwand, den ich in Verkaufsgesprächen höre, ist nicht der Preis. Es ist die Kontrolle. Support-Leiter wurden meist schon einmal enttäuscht und wollen, dass die KI nur die Tickets übernimmt, die sie bewältigen kann. Ein CX-Leiter einer DTC-Nahrungsergänzungsmarke auf Gorgias mit etwa 7.000 Tickets im Monat sagte es so:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
CX-Leiter einer DTC-Nahrungsergänzungsmarke auf Gorgias + Shopify, Verkaufsgespräch mit eesel
Das ist das Argument für einen gestuften Rollout. Zuerst der Entwurfsmodus, in dem die KI schreibt und eine Person sendet, dann automatische Antworten zu einem engen Thema, dann zum nächsten.
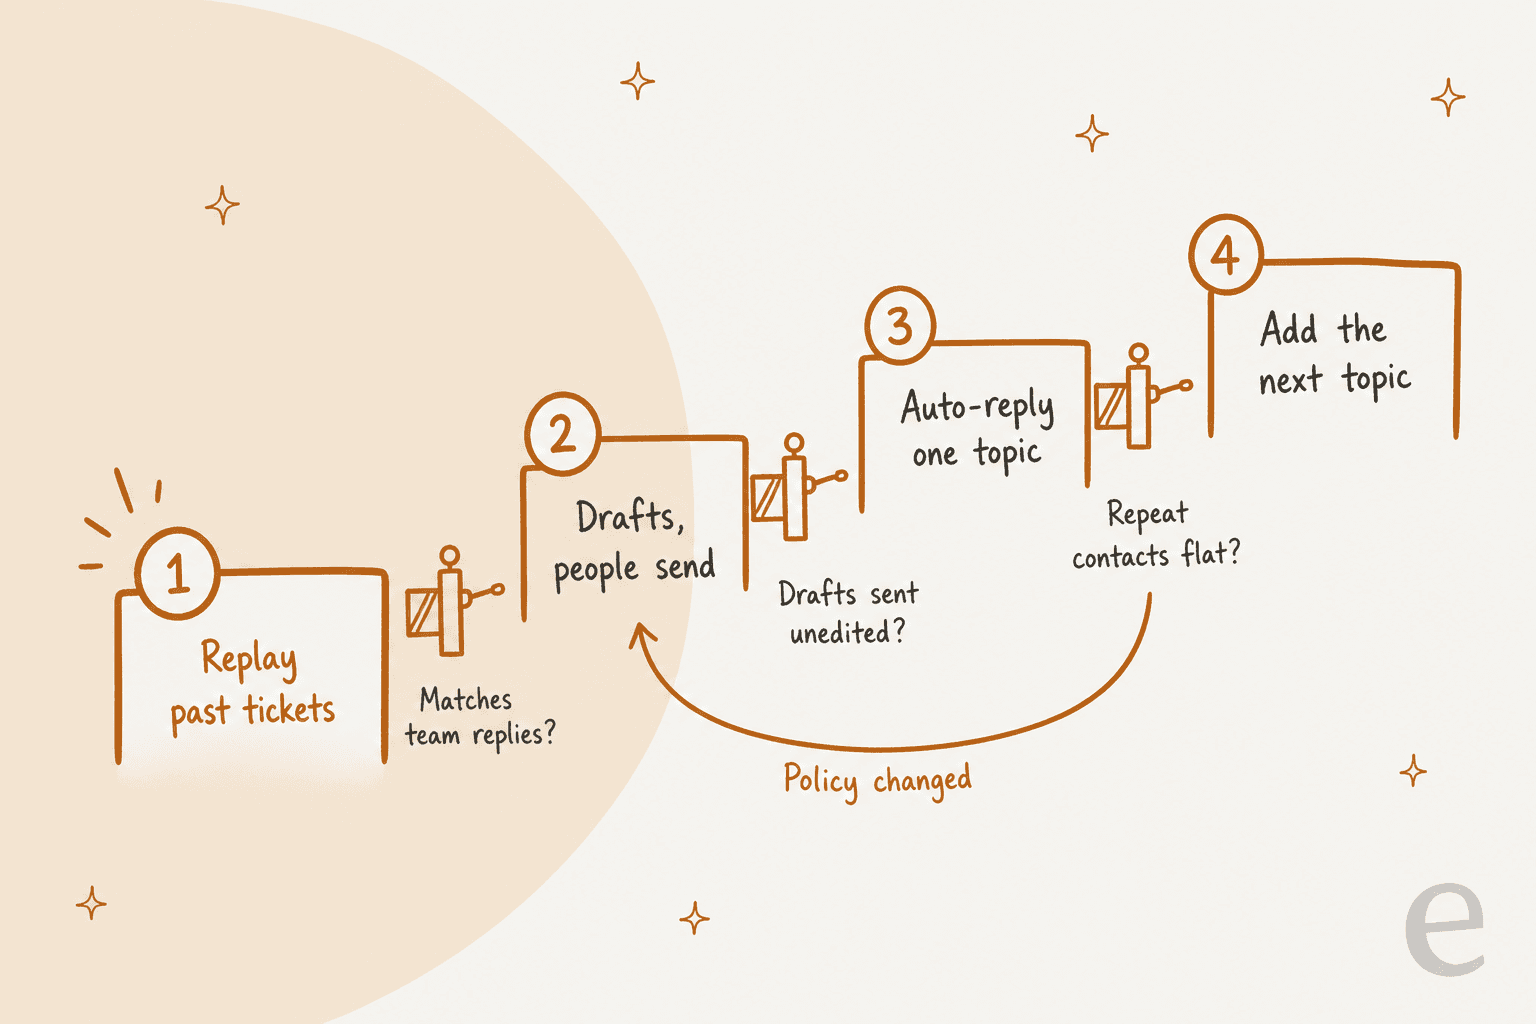
smava ist das klarste Beispiel, das ich nennen kann. Das Unternehmen betreibt eesel seit Dezember 2024 auf Zendesk, über zwei Marken und etwa 27.000 Tickets im Monat. Zwischen dem 8. August und dem 8. September 2026 lief der Entwurfs-Agent, dessen Ergebnis auf die Freigabe durch eine Person wartet, auf etwa 12.200 Tickets. Die Antwort-Agenten, die kundenfertige Antworten vorbereiten, übernehmen nur Tickets, bei denen dem Kunden kein Berater zugewiesen ist, etwa 1.100 davon. Die Regel, welche Tickets infrage kommen, ist ein einziges Feld, deshalb ist eine Erweiterung eine Textänderung und kein Projekt.
Die eigene Go-live-Checkliste von Gorgias weist im kleineren Maßstab in dieselbe Richtung: Prüfen Sie in der ersten Woche mindestens 10 von AI Agent bearbeitete Tickets und geben Sie Feedback zu denen, die danebenlagen.
Die Lösung: Lassen Sie zwei Wochen lang Entwürfe laufen und verfolgen Sie, wie oft Agenten einen Entwurf ohne Bearbeitung senden. Schalten Sie automatische Antworten nur für das Thema mit der höchsten Quote unveränderter Entwürfe ein. KI-Copilot für den Kundenservice erklärt den Entwurfsmodus, und Freshdesk-KI-Entwurfsantworten zeigt ihn auf Freshdesk.
Fehler 9: Den Launch für die Ziellinie halten
Ihre Rückgaberichtlinie wird sich ändern. Ein neues Produkt erscheint. Ein Paketdienst ändert seine Tracking-Seite. Jedes davon macht einen Teil der KI-Antworten über Nacht falsch, und niemand bemerkt es, bis sich die wiederholten Kontakte häufen.
Gorgias beschreibt die Verbesserung von AI Agent als Schleife aus Trainieren, Testen, Bereitstellen und Analysieren, jeweils für einen Gesprächstyp, mit dem Beispiel eines Retouren-Skills mit 30 % Übergaberate, die zum Ziel der nächsten Schleife wird. Swiftreg geht weiter: Die eesel-Anweisungen werden als nummerierte Releases geführt, und die nächste Version wird als Kandidaten-Build gekennzeichnet und über Swiftregs eigenes Verfahren ausgerollt, statt live bearbeitet zu werden.
Datenschutz gehört ebenfalls in diese laufende Arbeit, nicht nur in die Sicherheitsprüfung vor der Vertragsunterzeichnung. Zendesk weist darauf hin, dass sein Konversationssimulator für fiktive Daten ausgelegt ist, und bittet darum, in Testprofilen keine echten Namen und E-Mail-Adressen zu verwenden. Ihre eigenen Prüfungen sollten fragen, was die KI lesen kann, was sie in Tickets zurückschreibt und wer die Protokolle sehen kann. Der Beitrag zum Datenschutz beim Zendesk-KI-Agenten behandelt die Zendesk-Besonderheiten.
Die Lösung: Tragen Sie eine monatliche Überprüfung in den Kalender ein. Spielen Sie den Replay-Test mit den Tickets des letzten Monats erneut ab, lesen Sie jedes Ticket, das zum selben Problem zurückkam, und aktualisieren Sie die Wissensdatenbank, bevor Sie die Anweisungen der KI anfassen. Fehleranalyse im Kundensupport bietet eine Methode, um zu sortieren, was schiefging.
Ist Ihr KI-Agent startklar?
Haken Sie die Schranken ab, die Sie ehrlich mit Ja beantworten können. Jede offene zeigt die Korrektur, die Sie vor dem Launch vornehmen sollten.
Was Sie in den ersten 30 Tagen messen sollten
Sobald die KI live ist, würde ich diese Zahlen auf eine Seite bringen. Keine davon ist allein Deflection.
| Kennzahl | Was sie aufdeckt | Wie man sie liest |
|---|---|---|
| Lösung mit belegtem Ergebnis | Stilles Aufgeben, das als Erfolg gezählt wird | Rückerstattung ausgezahlt, Bestellung geändert oder Kunde hat bestätigt |
| Wiederholter Kontakt zum selben Problem (7 und 30 Tage) | Falsche oder unvollständige Antworten | Steigt bei einem Thema, deutet das auf einen veralteten Artikel oder eine fehlende Aktion hin |
| Übergaberate pro Thema | Themen, für die die KI noch nicht bereit ist | Hoch bei einem Thema ist das Nächste, was zu beheben ist, kein Versagen |
| Zeit von der Bitte um einen Menschen bis zur Antwort | Ein versteckter oder unterbesetzter Ausgang | Schlechte Werte hier kosten mehr Vertrauen als jede Bot-Antwort |
| Quote unveränderter Entwürfe | Ob ein Thema reif für automatische Antworten ist | Themen mit hoher Quote befördern, den Rest im Entwurfsmodus lassen |
| CSAT bei reinen KI- gegenüber menschlichen Gesprächen | Lücken bei Ton und Qualität | Beide vergleichen, nicht den gemischten Durchschnitt |
Ein Kommentator in r/CustomerSuccess nannte die Kennzahl, die ich in jedes Launch-Dashboard aufnehmen würde:
"The metric I'd watch is request-for-human to human-response time. If that number is bad, or people keep reopening on another channel after the bot, you're not deflecting demand, you're just hiding queue pain."
Es hilft auch zu wissen, wofür Ihr Anbieter abrechnet, denn die Abrechnungseinheit ist das, worauf Ihre Finanzabteilung zuerst schaut:
| Anbieter | Abrechnungseinheit für die KI | Veröffentlichter Preis |
|---|---|---|
| Zendesk | Automated resolution (nur Verified-Stufe, seit 18. Mai 2026) | $1.50 bei Commitment, $2.00 Pay-as-you-go, laut Zendesk-Preisen |
| Gorgias | Automated interaction, wenn AI Agent ohne Übergabe löst | $0.85 bis $1.00 je nach Tarif, laut Gorgias-Preisen |
| Freshdesk | Freddy-AI-Agent-Sitzung (eine E-Mail-Sitzung ist ein 72-Stunden-Fenster) | Die ersten 500 Sitzungen einmalig inklusive, danach $49 pro 100, laut Freshdesk-Preisen |
| eesel | Credit: ein Ticket oder ein Chat, egal wie viele Antworten oder Abfragen | Ab $299/Monat für 500 Credits, laut eesel-Preisen |
Der Leitfaden zu den Kennzahlen für KI im Kundenservice definiert jede Kennzahl genauer, KI-CSAT behandelt die Umfrageseite, und Kosten pro Lösung rechnet das Geld durch.
Ein 30-Tage-Rollout-Plan
So würde ich bei einer typischen E-Mail- und Chat-Queue vorgehen. Ein Helpdesk ist in Minuten verbunden; der größte Teil des Monats geht dafür drauf, Thema für Thema Vertrauen aufzubauen.
- Tage 1 bis 5: verbinden und aufräumen. Verbinden Sie Helpdesk und Wissensquellen, prüfen Sie Ihre 20 wichtigsten Themen und schreiben Sie die Fallback-Regel, die Liste der Dinge, die nie versprochen werden, und die Übergabevorlage.
- Tage 6 bis 8: Replay. Lassen Sie die KI gegen einige Wochen gelöster Tickets laufen. Beheben Sie das schwächste Thema und spielen Sie dann erneut ab.
- Tage 9 bis 22: Entwürfe. Die KI entwirft zu jedem geeigneten Ticket, Agenten geben frei, bearbeiten oder lehnen ab. Verfolgen Sie die Quote unveränderter Entwürfe pro Thema und was Agenten ändern.
- Tage 23 bis 30: ein Thema live. Schalten Sie automatische Antworten für das Thema mit der besten Quote unveränderter Entwürfe ein. Lassen Sie die Option für einen Menschen sichtbar und beobachten Sie wiederholte Kontakte täglich.
- Ab Tag 30: die Schleife. Fügen Sie ein Thema nach dem anderen hinzu, spielen Sie den Replay monatlich erneut ab und schicken Sie jedes Thema zurück in den Entwurfsmodus, wenn sich eine Richtlinie ändert.
Der Leitfaden zum Automatisieren des Supports mit KI geht auf jeden Schritt tiefer ein, und wenn Sie noch ein Tool auswählen, behandeln Auswahl eines KI-Agenten und Kaufkriterien für KI-Helpdesks die Kaufseite.
eesel ohne die Fehler einführen
eesel ist ein KI-Helpdesk-Teammitglied, das in die Queue einsteigt, die Sie bereits in Zendesk, Freshdesk oder Gorgias betreiben, und sein Rollout folgt der obigen Reihenfolge. Bevor es etwas sendet, spielt die Simulation-Funktion Ihre vergangenen Tickets erneut ab und bewertet jede Antwort im Vergleich zu dem, was Ihr Team tatsächlich gesendet hat. Dann entwirft es, Ihre Agenten geben frei, und automatische Antworten werden nur für die Themen eingeschaltet, die es sich verdient haben, nach Regeln, die Sie in einfacher Sprache schreiben.
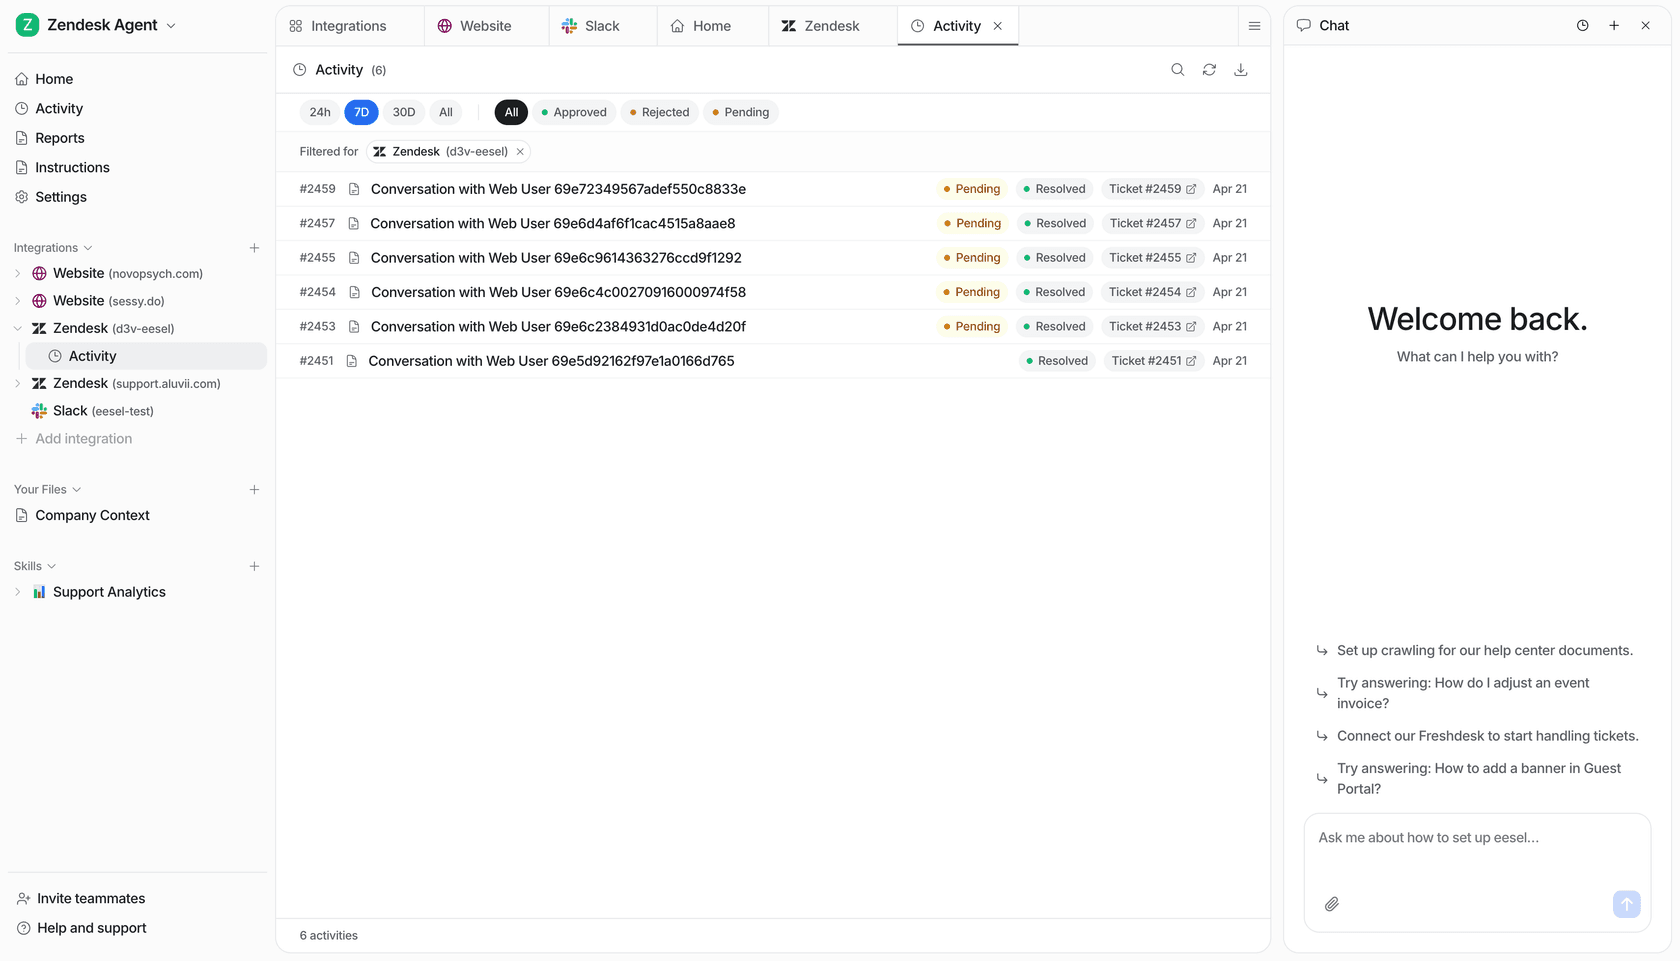
So betreibt smava etwa 27.000 Zendesk-Tickets im Monat, wobei Menschen die meisten Entwürfe freigeben, und so beantwortet Swiftreg Kennzeichen-Bestellungen ausschließlich aus Live-Abfragen. Sie erhalten 100 kostenlose Credits, um Ihren Helpdesk zu verbinden und echte Entwürfe zu Ihren eigenen Tickets zu sehen, bevor Sie etwas bezahlen. eesel testen und diese Woche den ersten Replay starten.