

Eine Checkliste zur Bewertung von KI-Support-Anbietern hat etwa 30 Prüfpunkte, aber nur 6 davon unterscheiden einen Anbieter tatsächlich vom anderen: wofür du zahlst und was als „gelöst" zählt, ob du ihn vor der Unterschrift an deinen eigenen alten Tickets testen kannst, ob er in deinem bestehenden Helpdesk funktioniert, ob du ihn stufenweise ausrollen kannst, ob du ihn ohne Verkaufsgespräch ausprobieren kannst und welche Sicherheitsnachweise der Anbieter heute vorliegen hat. Bei den anderen 24 sagt jeder Anbieter Ja.
Gewichte diese 6 mit je drei Punkten und den Rest mit einem, dann liefert die Scorecard unten einen Sieger statt eines Unentschiedens. Der größte einzelne Punkt ist der Test mit alten Tickets: Gib jedem Finalisten dieselben Tickets, die dein Team schon gelöst hat, und bewerte die Entwürfe im Vergleich zu dem, was dein Team gesendet hat. eesel führt diesen Test für dich durch, mit der Helpdesk-Simulation, an 20 kürzlich gelösten Tickets, ohne etwas an Kunden zu senden, direkt in dem Helpdesk, den du schon nutzt.
Warum enden die meisten KI-Anbieter-Checklisten im Unentschieden?
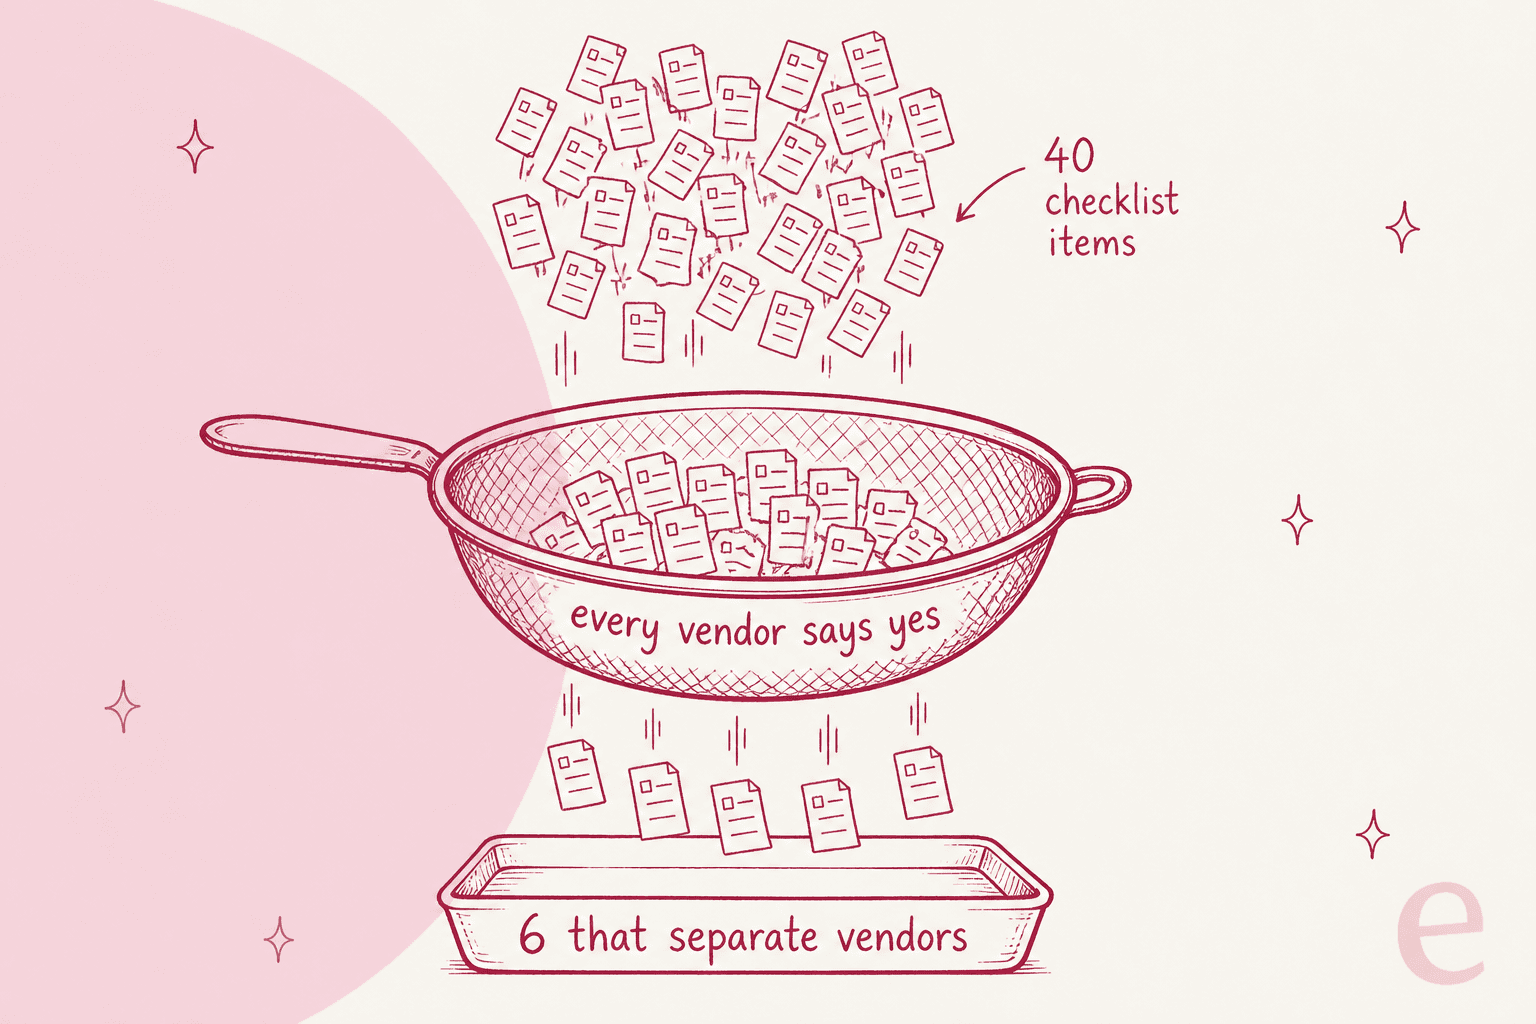
Die meisten KI-Anbieter-Checklisten enden im Unentschieden, und der Grund ist einfach: Sie stellen Fragen, auf die jeder Anbieter mit Ja antworten kann. „Lässt sich in deinen Helpdesk integrieren?" Ja. „Unterstützt mehrere Sprachen?" Ja. „Übergibt an einen Menschen?" Auch ja. Nach vierzig Jas entscheidest du am Ende nach der Demo, und die ist der einzige Teil des ganzen Prozesses, den der Anbieter vollständig kontrolliert.
Weil ich die Helpdesk-Integrationen von eesel selbst baue, ist die Zeile, der ich auf jeder Checkliste am wenigsten traue, „integriert sich mit Zendesk". Das kann alles Mögliche heißen, von „liest einmal dein Help Center" bis „liest jedes alte Ticket, schreibt in Ticketfelder und antwortet nicht mehr, sobald ein Mensch übernimmt", und beides bekommt denselben Haken.
Eine längere Checkliste behebt das nicht. Was hilft, ist eine gewichtete, bei der jeder Punkt einen Nachweis statt eines Jas verlangt und die wenigen Punkte, die Anbieter wirklich trennen, mehr zählen. Genau das baut der Rest dieses Beitrags.
Eines noch, bevor wir zu den Punkten kommen. In einem Verkaufsgespräch mit eesel hat ein Lead einer Nahrungsergänzungsmarke mit etwa 7.000 Gorgias-Tickets im Monat die eigentliche Sorge ziemlich klar benannt:
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist also die Messlatte für die Checkliste. Die Frage ist nicht „ist diese KI beeindruckend", sondern eher „kann ich ihr meine Queue anvertrauen, ohne jedes Ticket zu lesen".
Welche 6 Punkte trennen KI-Support-Anbieter?
Bei diesen Punkten geben die Anbieter wirklich unterschiedliche Antworten, und die Antwort verändert, was du zahlst oder wie viel Risiko du trägst. Jeden davon kannst du anhand öffentlicher Dokumente oder mit einem kurzen Test prüfen, nichts davon muss man einfach glauben.
1. Wofür zahlst du, und was zählt als „gelöst"?
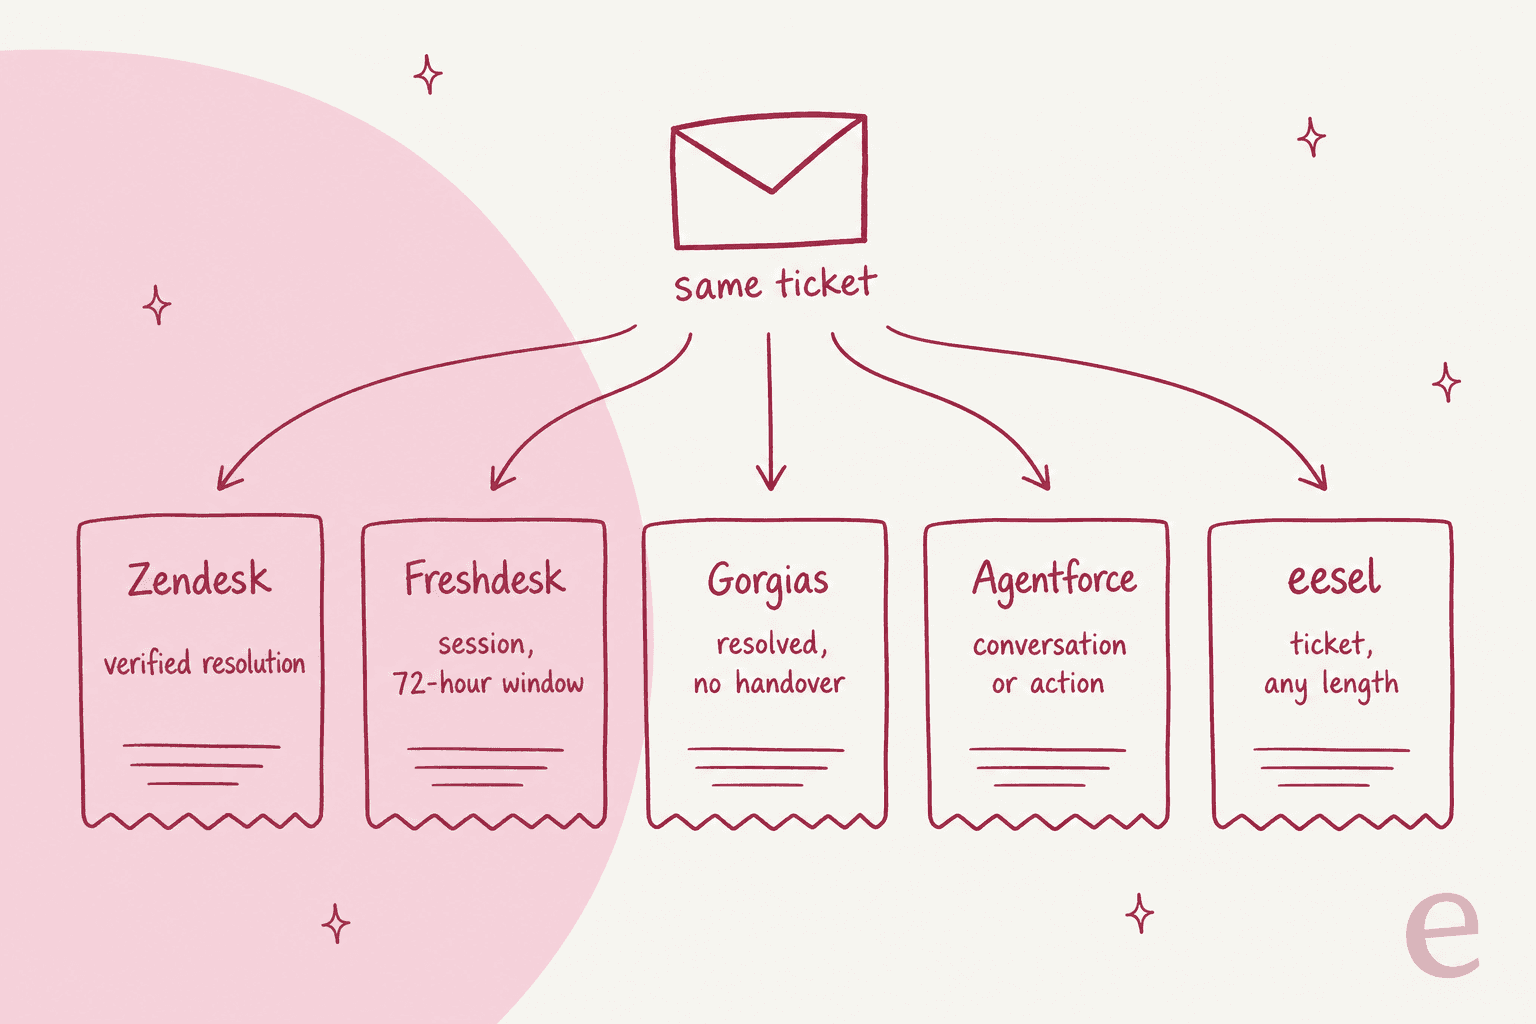
Von allen sechs bewegt dieser Punkt das meiste Geld. Dasselbe Ticket wird auf mindestens fünf verschiedene Arten abgerechnet, je nachdem, bei wem du kaufst:
| Anbieter | Was eine abrechenbare Einheit ist | Veröffentlichter Preis pro Einheit |
|---|---|---|
| Zendesk AI agents | Eine automatische Lösung, die eine "Verified Resolution"-Prüfung besteht, 72 Stunden später bei E-Mail und 2 Stunden später bei Messaging | 1,50 $ bei Commitment, 2,00 $ Pay as you go |
| Freshdesk Freddy AI Agent | Eine Sitzung; bei E-Mail ein 72-Stunden-Fenster ab der ersten E-Mail des Kunden | Die ersten 500 Sitzungen inklusive, danach 49 $ pro 100 Sitzungen |
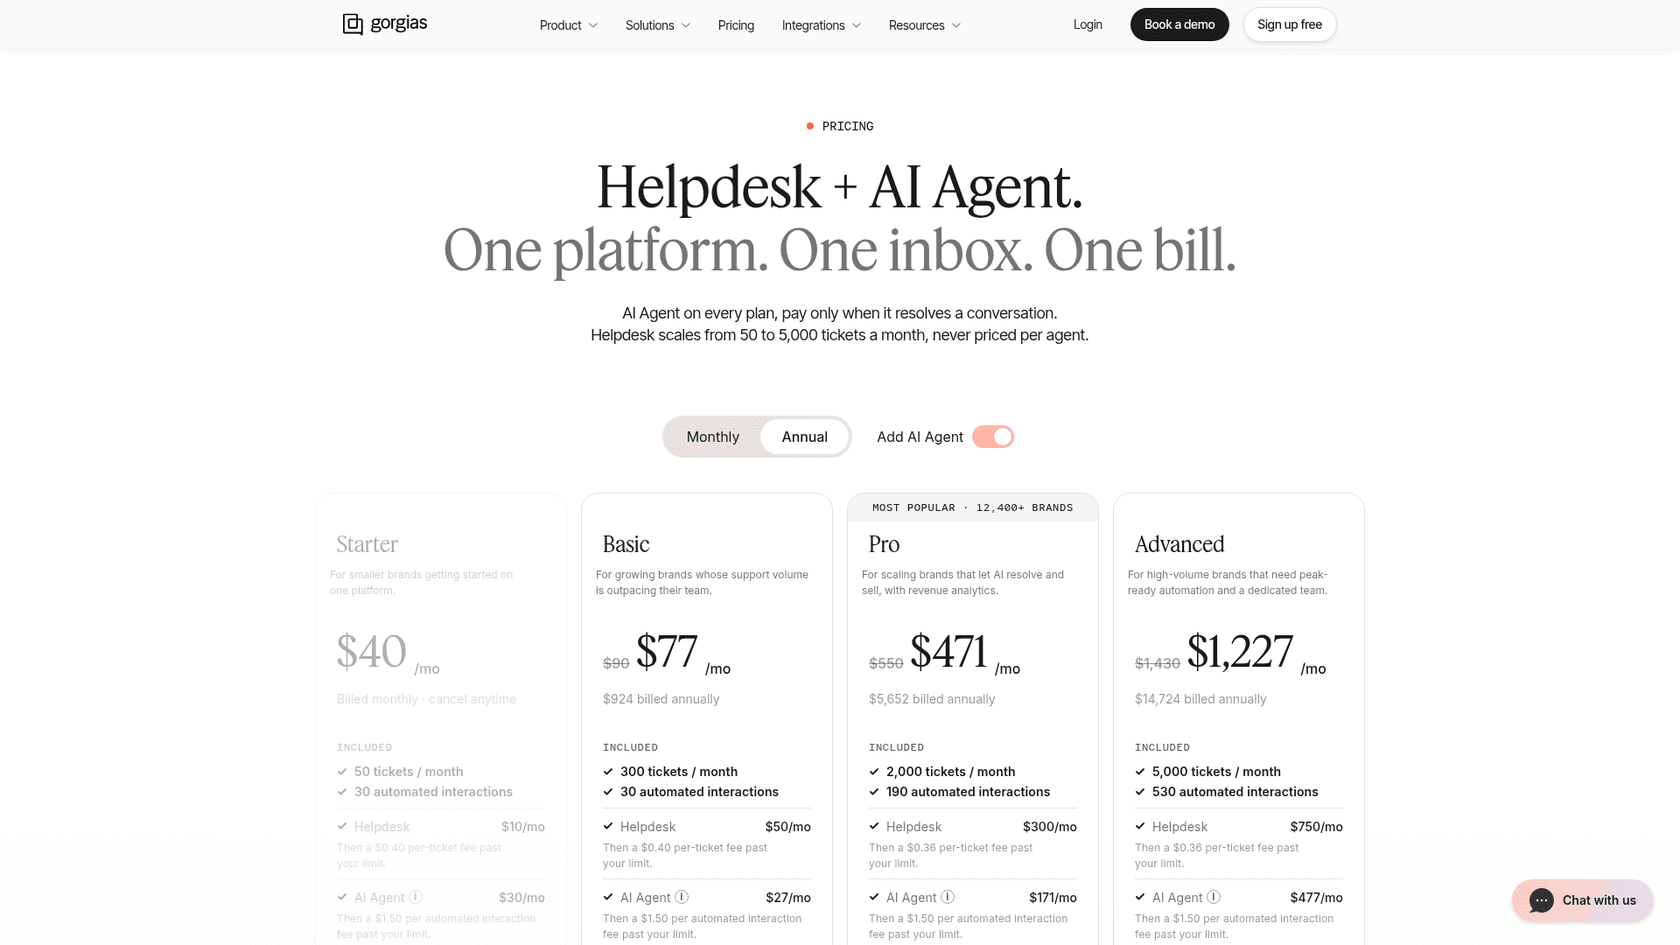
| Gorgias AI Agent | Eine automatisierte Interaktion, gezählt, wenn sie ohne Übergabe löst | Kontingent je Tarif, darüber hinaus je 1,50 $ |
| Salesforce Agentforce | Eine Konversation oder Flex Credits pro Aktion (eine Aktion kostet 20 Credits) | 2 $ pro Konversation oder 500 $ pro 100.000 Flex Credits |
| Ada | Nicht öffentlich angegeben | Nur auf Anfrage |
| Decagon | Pro Konversation oder pro Lösung; die meisten Kunden wählen pro Konversation | Nur auf Anfrage |
| Sierra | Ergebnisse, die pro Kunde vereinbart werden | Nur auf Anfrage |
| eesel | Ein Credit pro Ticket oder Chat, egal wie viele Antworten hin- und hergehen | 299 $ für 500 Credits bis 1.749 $ für 5.000; zusätzliche Credits 0,80 $ |
Zwei Dinge lohnt es sich aus dieser Tabelle herauszuziehen. Erstens: „Gelöst" ist eine Definition und keine Tatsache, und jeder Anbieter schreibt seine eigene Version. Von denen, die ich gelesen habe, ist die von Zendesk die strengste, da ein LLM die Konversation nach einer Wartezeit erneut prüft, bevor sie zählt. Zweitens: Ein Preis pro Lösung und ein Preis pro Ticket lassen sich erst vergleichen, wenn du einen Monat deines eigenen Volumens unter beiden durchrechnest. Meine Aufschlüsselung der Kosten pro Lösung rechnet das durch, und Deflection vs. Resolution erklärt, warum eine Deflection-Zahl keine Resolution-Zahl ist.
"Simply entering a flow that tells the customer we're outside business hours can already count as a resolution and incur a cost, even when no generative AI is actually involved. [...] After just 30 days, we had already consumed more than 40% of the automated resolutions included in our plan for the entire year."

Welchen Nachweis du verlangen solltest: einen schriftlichen Satz vom Anbieter, der die abrechenbare Einheit und die Bedingung für „gelöst" definiert, dazu ein Angebot für dein tatsächliches Monatsvolumen und eines für das Doppelte.
2. Kannst du ihn vor der Unterschrift an deinen eigenen alten Tickets testen?
Jede Demo läuft mit Tickets, die der Anbieter ausgewählt hat. Deine alten Tickets sind der einzige Testdatensatz, der deine Produkte, deine Richtlinien und deine merkwürdigen Sonderfälle enthält, und obendrein haben sie die richtige Antwort schon dabei, nämlich das, was dein Team gesendet hat.
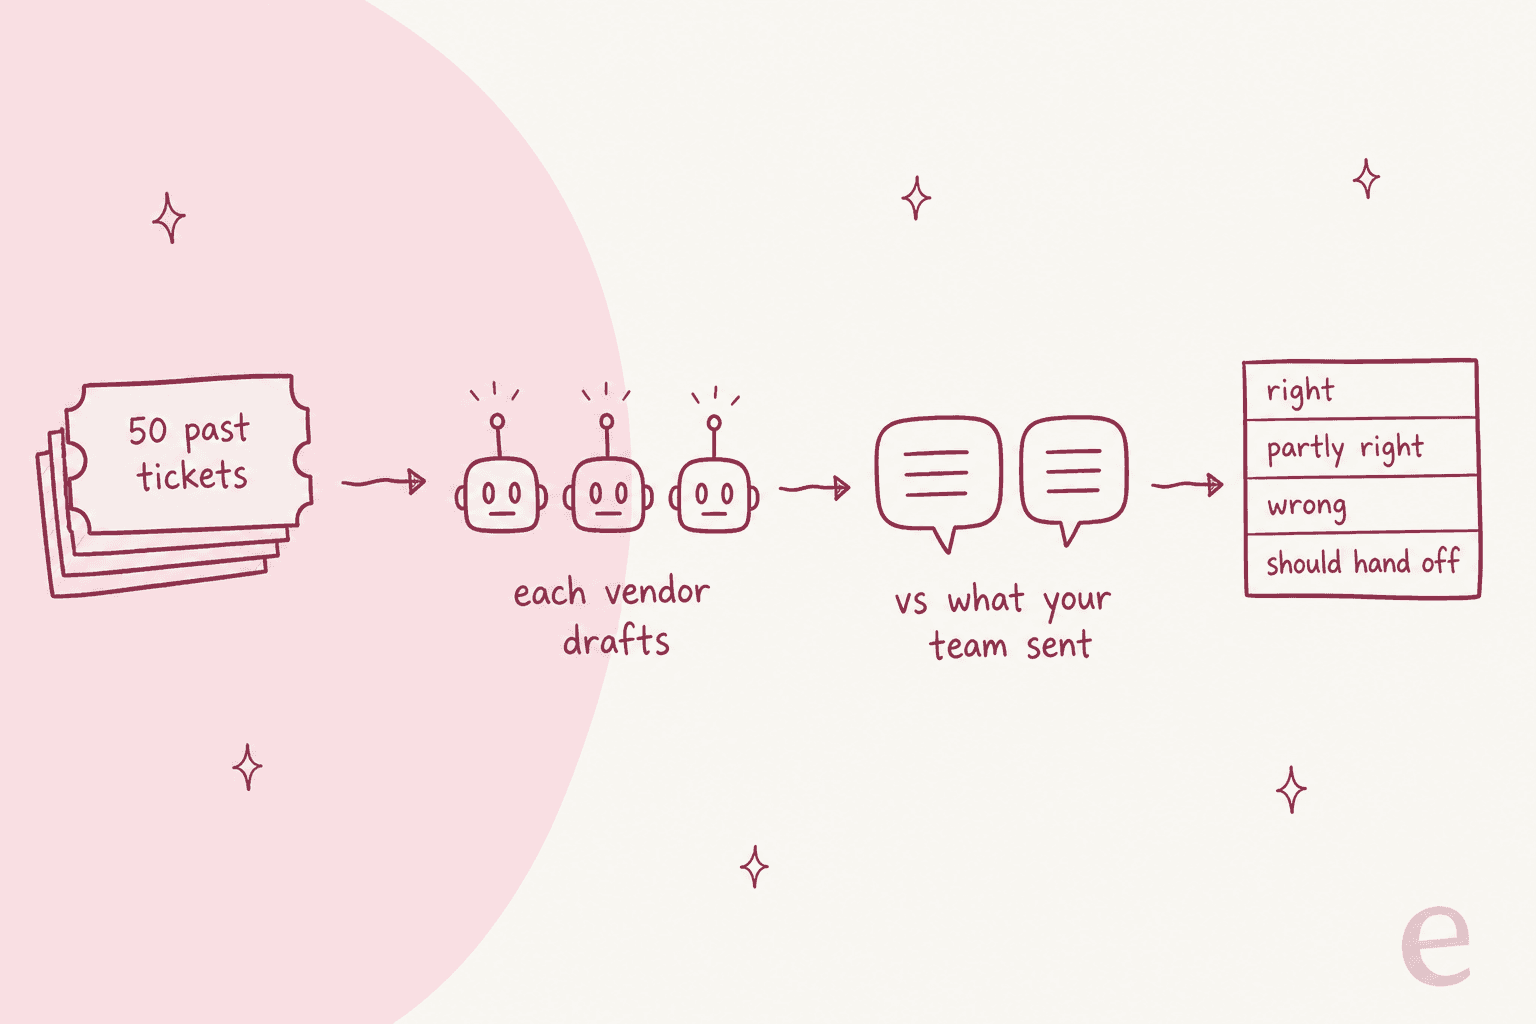
Den Test zu beschreiben ist einfach, und doch bieten ihn Anbieter erstaunlich selten an. Du nimmst 50 Tickets, die dein Team kürzlich gelöst hat, verteilt über deine Hauptthemen, und gibst dieselben 50 jedem Finalisten. Jeder entwirft eine Antwort, dann bewertest du jeden Entwurf im Vergleich zu dem, was dein Team tatsächlich gesendet hat.
Pro Ticket reichen vier Ergebnisse: richtig, teilweise richtig, falsch und hätte übergeben müssen. Das letzte ist wichtiger, als es aussieht. Ein Agent, der auf einem Ticket selbstsicher antwortet, das er hätte eskalieren müssen, ist schlechter als einer, der weniger Tickets beantwortet und den Rest sauber übergibt. Teile danach die Ergebnisse nach Thema auf, denn ein Gesamtwert von „82 % richtig" kann „40 % richtig bei Abrechnung" verbergen, und gerade bei der Abrechnung kosten Fehler dich am meisten.
"I haven't had a great experience with the AI support agent. It takes a pretty big effort to train it. Then, I find that most of the responses have an error that I have to apologize for after the handoff. It's probably fine for basic questions like order status [...]"
Wenn ich einen Punkt am höchsten gewichten müsste, wäre es dieser, und es ist auch der, um den eesel herum gebaut wurde. Der Skill Helpdesk-Simulation nimmt 20 Tickets, die dein Team kürzlich gelöst hat, und entwirft zu jedem eine eigene Antwort. Danach vergleicht er jeden Entwurf mit dem, was dein Team gesendet hat, gruppiert die Ergebnisse nach Thema und listet auf, was vor dem Livegang zu beheben ist, alles ohne etwas an Kunden zu senden.
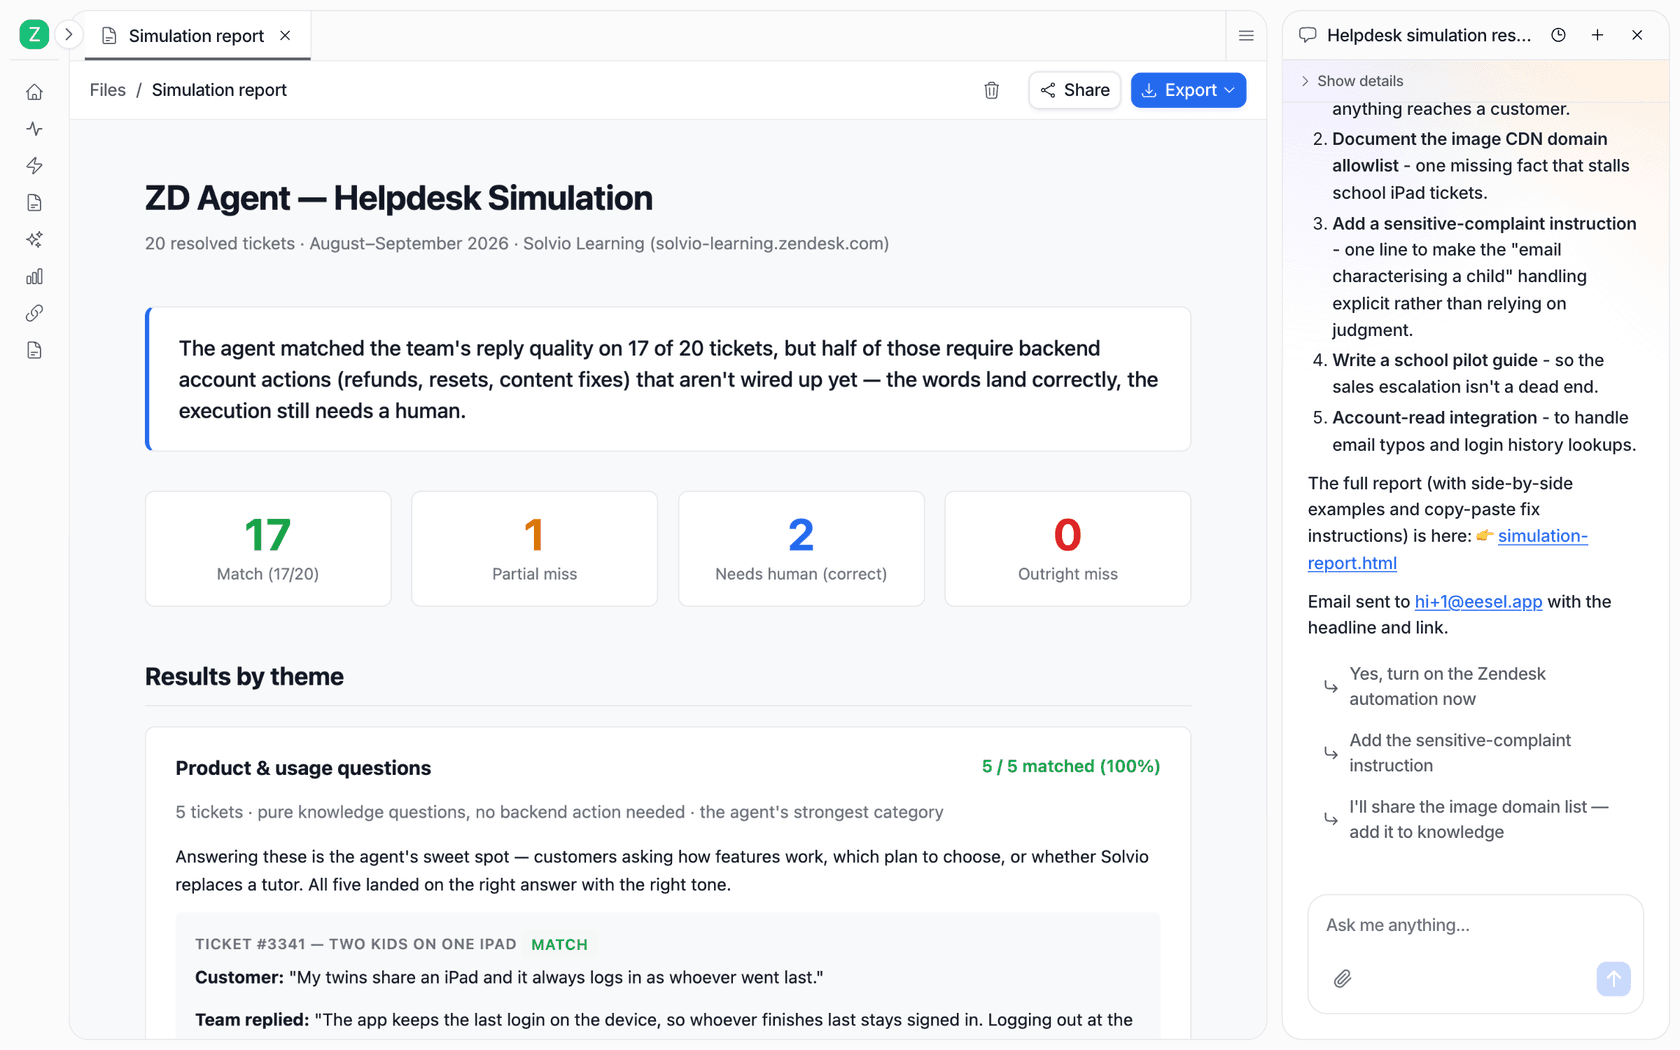
In diesem Bericht ist nicht die Zahl 17 von 20 der nützliche Teil. Es ist die Zeile darunter: Bei etwa der Hälfte der übereinstimmenden Tickets musste trotzdem ein Mensch etwas in einem Backend-System tun, mit dem der Agent nicht verbunden war. Eine Demo bringt so einen Befund nie zutage, und genau den willst du vor der Unterschrift kennen. Zur breiteren Methode siehe KI-Agent testen und Tests für KI-Support-Agenten.
Welchen Nachweis du verlangen solltest: ein bewerteter Durchlauf mit Tickets, die du lieferst, nicht mit solchen, die der Anbieter liefert. Wenn ein Anbieter das vor Vertragsabschluss nicht kann, ist es berechtigt, nach dem Grund zu fragen.
3. Funktioniert er in dem Helpdesk, den du schon hast?
Manche KI-Agenten sind ein Feature eines einzelnen Helpdesks, andere setzen auf den Helpdesk auf, den du gerade betreibst. Wenn die gewünschte KI nur in einem Helpdesk läuft, den du nicht nutzt, ist das eigentliche Projekt eine Helpdesk-Migration, und die Checkliste sollte das am ersten Tag aussprechen.
- Freddy AI Agent gehört zu den Freshdesk-Tarifen, und genauso sind Zendesk AI agents Teil von Zendesk.
- Gorgias AI Agent braucht einen angebundenen Shopify-Shop. Gorgias gibt außerdem an, dass er bei Shops mit BigCommerce, Magento oder WooCommerce nicht unterstützt wird.
- Agentforce läuft auf Salesforce, und seine Service-Preisgestaltung setzt voraus, dass du bereits Salesforce-Kunde bist.
- Die Plattformseite von Ada listet Anbindungen an Helpdesks wie Salesforce und Freshworks. Decagon und Sierra sind ebenfalls eigenständige Plattformen, daher lohnt es sich, bei beiden zu fragen, in welche Helpdesks sie nativ zurückschreiben.
- eesel arbeitet in dem Helpdesk, den du schon hast, unter anderem auf Zendesk, Freshdesk, Gorgias, Front und HubSpot. Ein typisches Beispiel für die Anbindung ist die Front-Integration.
„Funktioniert in" hat auch eine Tiefe, und hier kommt meine Voreingenommenheit als Integrationsbauer ins Spiel. Frage, was er liest (nur das Help Center oder auch alte Tickets und Makros) und was er schreibt (eine Antwort, eine interne Notiz, Tags, Ticketfelder), und dann auch, wie er sich verhält, wenn ein Mensch zuerst antwortet. ClutchLoop betreibt eesel auf Gorgias mit Shopify-Abfragen für Live-Preis und Bestand, und dort tritt der Agent zurück, sobald sich schon ein Mensch um das Ticket kümmert. Dieses letzte Verhalten siehst du in einer Demo nicht, in der Produktion ist es aber sehr deutlich.
Welchen Nachweis du verlangen solltest: eine schriftliche Liste, was der Agent in deinem Helpdesk liest und schreibt, und was er tut, wenn ein Teammitglied schon am Ticket ist.
4. Kannst du ihn stufenweise ausrollen?
Der sicherste Rollout geht zuerst mit Entwürfen, dann mit dem Senden bei den Themen, bei denen die Entwürfe richtig waren, und erst danach mit weiteren Themen. Ein Anbieter, der nur am ersten Tag komplett live gehen kann, verlangt von dir, den Schritt zu überspringen, der Fehler abfängt.
Worauf du hier achten solltest:
- Reiner Entwurfsmodus. Kann der Agent seine Antworten als interne Notizen hinterlassen, die ein Mensch versendet? smava arbeitet so auf Zendesk in großem Maßstab, mit 15.300 vorbereiteten Entwurfsantworten in einem Monat, und eesel sendet die kundenfertigen nie von allein.
- Themen- und Kanalgrenzen. Original Bootcamp hat einen Filter, sodass eesel nur die Freshdesk-Tickets beantwortet, die sich aus der Website und alten Tickets beantworten lassen. Alles, was eine Buchung betrifft, geht an einen Menschen.
- Freigabe bei Aktionen. Bei nicht umkehrbaren Aktionen wie dem Stornieren einer Bestellung schaltet Gorgias die Kundenbestätigung automatisch ein. Bei eesel lässt sich jede Aktion so einstellen, dass sie auf die Freigabe eines Menschen wartet.
- Ein Ausschalter. Wie schnell kannst du den Agenten pausieren, und wer in deinem Team kann das tun, ohne ein Support-Ticket beim Anbieter zu öffnen?
"the AI will immediately show you gaps and issues in your knowledge base and/or website (if you connect a crawler). You'd be amazed at how many outdated pages it will find and suddenly bring to light..... [...] Choose one annoying use case and automate that. Then go to the next."
Mehr zur Übergabe findest du unter Best Practices für die Übergabe bei KI-Agenten.
Welchen Nachweis du verlangen solltest: Entwurfsmodus und Themenlimit in einer Sandbox oder Testphase in Aktion sehen, dazu einen Freigabeschritt, nicht auf einer Folie.
5. Siehst du den Preis und kannst du es ohne Verkaufsgespräch ausprobieren?
Hier geht es weniger um das Produkt als darum, wie der Anbieter verkauft. Anbieter, die nur auf Anfrage verkaufen und demo-getrieben sind, haben keine schlechteren Produkte, aber die Bewertung dauert länger, und der Preis kommt, wenn du emotional schon investiert bist.
- Ada, Decagon und Sierra veröffentlichen keine Preise und bieten keine öffentliche Self-Service-Testphase (meine Aufschlüsselung zu den Decagon-Preisen zeigt, wie das in der Praxis aussieht). Die Demo-Seite von Ada beschreibt eine Expertenprüfung und eine individuelle Demo, gefolgt von einem Business Case mit deinen Zahlen.
- Agentforce nennt einen Einstieg mit 0 $ Salesforce Foundations, und seine Flex-Credits-Preisliste berechnet Help Agent Resolutions in einer Sandbox mit 0 Credits, was für einen Test hilfreich ist.
- Die ersten 500 Sitzungen des Freddy AI Agent sind in den Freshdesk-Tarifen enthalten.
- eesel hat einen kostenlosen Tarif mit 100 Credits ohne Karte, und alle Funktionen und Integrationen sind enthalten.
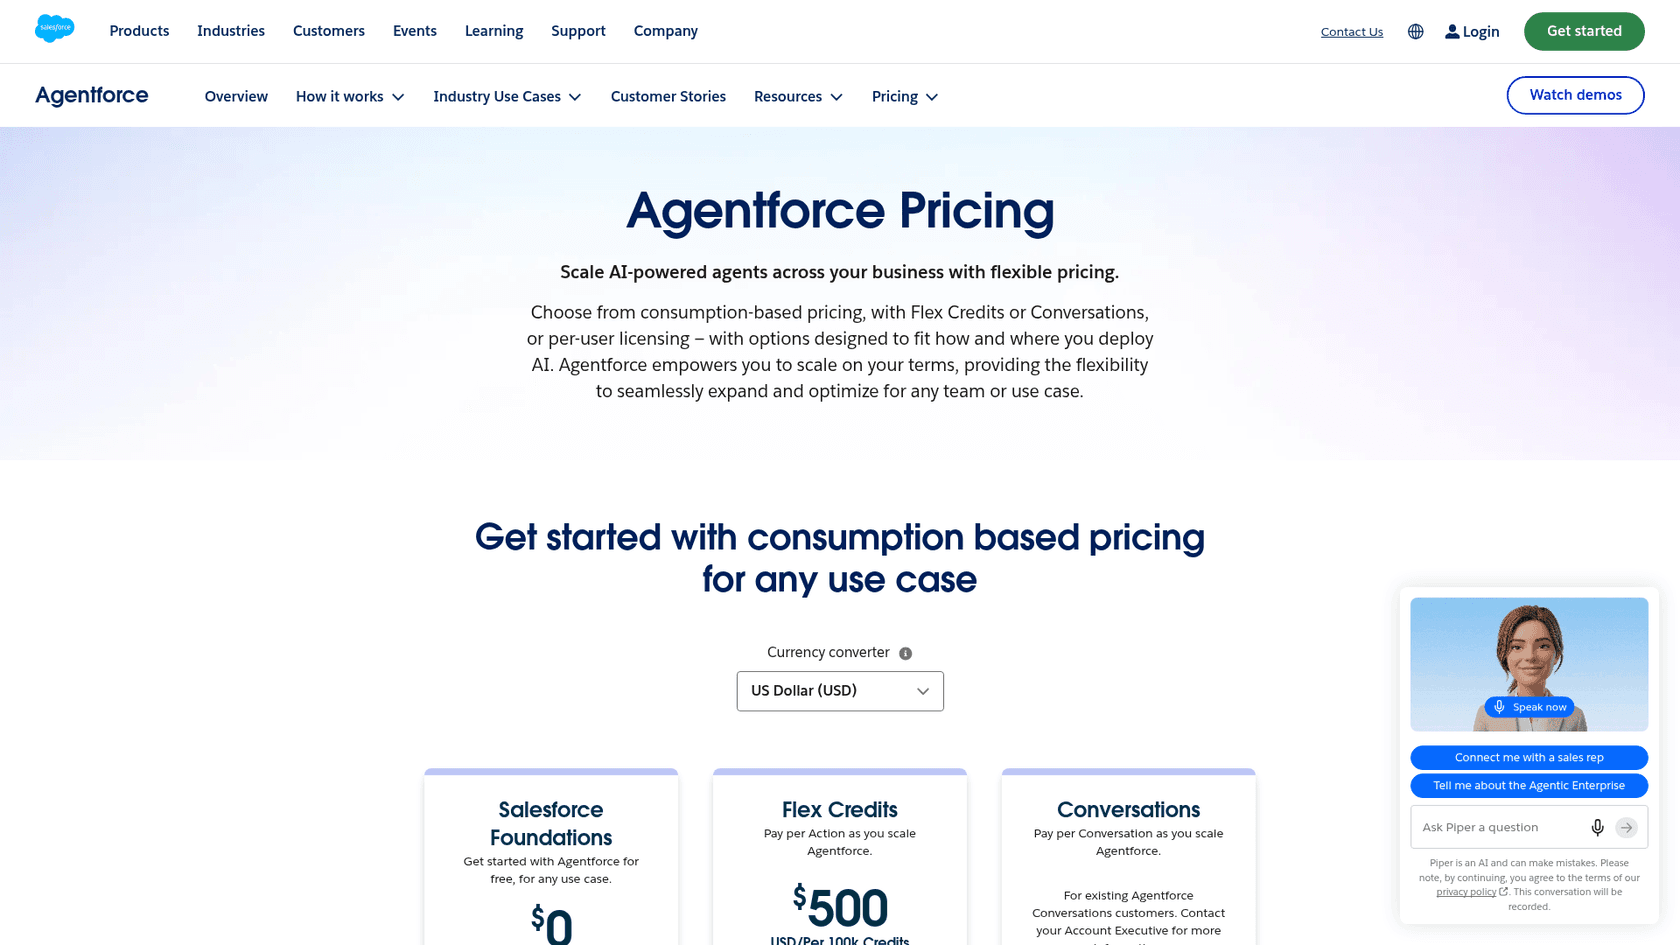
Für eine große, komplexe Queue mit einem Einkaufsteam dahinter kann ein vertriebsgetriebener Anbieter genau richtig sein. Aber wenn du ein Team aus 6 Personen bist und bis Monatsende entscheiden willst, spart dir ein Anbieter, den du selbst einschalten kannst, Wochen.
Welchen Nachweis du verlangen solltest: einen schriftlichen Preis für dein Volumen und eine Testphase in deinem eigenen Helpdesk, beides vor dem zweiten Termin.
6. Welche Sicherheitsnachweise hat der Anbieter heute?
Jeder Anbieter sagt „Sicherheit auf Enterprise-Niveau", der Unterschied zeigt sich also in den Dokumenten. Frage, was heute vorliegt, nicht was geplant ist, und verlange den Bericht statt des Siegels.
| Anbieter | Auf den eigenen Seiten genannte Sicherheitsnachweise | Trainiert Modelle mit deinen Daten? |
|---|---|---|
| Zendesk | SOC 2 Type II, ISO 27001/27017/27018/27701/42001, FedRAMP LI-SaaS, HIPAA BAA über Add-on | Nicht für generative KI; nutzt bereinigte Daten für eigene Klassifikationsmodelle |
| Ada | SOC 2 Type 2, SOC 3, HIPAA, DSGVO, PCI-Attestierung | Keine Datenspeicherung bei LLM-Partnern; Fine-Tuning mit de-identifizierten Daten |
| Decagon | SOC 2 Type II, ISO 27001:2022, HIPAA, DSGVO, PCI DSS 4.0.1 | Keine Datenspeicherung bei LLM-Anbietern |
| Sierra | SOC 2 Type II, ISO 27001, ISO 42001, HIPAA, PCI DSS, FedRAMP High | Auf den Trust-Seiten nicht angegeben |
| eesel | SOC 2 Type II Audit läuft (Beobachtungszeitraum 1. Okt. bis 31. Dez. 2026), DSGVO-AVV, HIPAA BAA im Enterprise-Tarif | Nein, trainiert oder fine-tunt nie |
Ich stelle die Zeile von eesel ganz offen dar. Der Beobachtungszeitraum für SOC 2 Type II hat am 1. Oktober 2026 begonnen, und der Bericht folgt nach dem Audit Anfang 2027. Wenn dein Sicherheitsteam heute einen fertigen SOC-2-Bericht verlangt, ist das ein echter Grund, eesel bei diesem Punkt vorerst niedriger zu gewichten, und ein fairer dazu. Wenn es einen AVV, ein BAA oder eine unterschriebene Antwort zum Modelltraining braucht, gibt es die heute schon.
Die vollständigen Sicherheitsfragen sind lang genug für eine eigene Liste, also habe ich eine geschrieben, die Sicherheits-Checkliste für KI-Anbieter. Für regulierte Fälle gibt es den Leitfaden zu SOC 2 und DSGVO und außerdem HIPAA-konforme KI.
Welchen Nachweis du verlangen solltest: den Bericht oder das Zertifikat selbst unter NDA und den AVV, dazu eine schriftliche Antwort zu Training und Aufbewahrung.
Die vollständige Checkliste zur Bewertung von KI-Support-Anbietern
Hier ist die ganze Scorecard mit 30 Prüfpunkten in sechs Bereichen. In jedem Bereich ist der erste Punkt (mit ★ markiert) einer der sechs oben und zählt 3 Punkte, die übrigen zählen 1. Hake nur ab, was ein Anbieter dir tatsächlich gezeigt hat, nicht was er versprochen hat, und bewerte einen Anbieter nach dem anderen, mit Zurücksetzen dazwischen.
Kurz zur Gewichtung. Gleiche Gewichte sind der Grund, warum die Tabelle mit 40 Punkten im Unentschieden endet: Vier Anbieter haken je 36 Kästchen ab, und du entscheidest wieder nach der Demo. Sobald du die sechs ★-Punkte verdreifachst, schlägt ein Anbieter, der die schwierigen Dinge nachweist, einen, der alle leichten abhakt, und genau dieses Ergebnis willst du.
Es ist auch in Ordnung, die Gewichte an deine Situation anzupassen. Für ein Gesundheits- oder Finanzteam sollte der Sicherheits-★ als Tor wirken (kein Nachweis, kein Deal) statt als drei Punkte. Eine Shopify-Marke auf Gorgias sollte den Helpdesk-★ stark gewichten, denn eine falsche Antwort bedeutet dort einen Plattformwechsel.
Wie schneiden die wichtigsten KI-Support-Anbieter bei den 6 Punkten ab?
Unten steht, wo die Anbieter, die in dieser Kategorie am häufigsten vorkommen, bei den sechs ★-Punkten landen, ausschließlich auf Grundlage dessen, was jeder Anbieter veröffentlicht. Wo ein Anbieter keine Antwort veröffentlicht, steht das in der Zelle, statt zu raten.
| Anbieter | Abrechnungseinheit | Öffentlicher Preis | Test an deinen alten Tickets | Läuft in deinem aktuellen Helpdesk | Ausprobieren ohne Verkaufsgespräch | Sicherheitsnachweis heute |
|---|---|---|---|---|---|---|
| Zendesk AI agents | Verifizierte automatische Lösung | 1,50 $ bis 2,00 $ pro Lösung | Nachfragen | Nur Zendesk | Nicht geprüft | SOC 2 Type II, ISO 27001, ISO 42001 |
| Freddy AI Agent | Sitzung (72 Stunden bei E-Mail) | 49 $ pro 100 nach 500 inklusive | Nachfragen | Nur Freshdesk | 500 Sitzungen in Tarifen enthalten | Nicht geprüft |
| Gorgias AI Agent | Ohne Übergabe gelöst | 1,50 $ über dem Tarifkontingent | Nachfragen | Gorgias mit Shopify | Tarife ab 40 $ im Monat | Nicht geprüft |
| Agentforce | Konversation oder Aktions-Credits | 2 $ pro Konversation | Sandbox: Lösungen 0 Credits | Salesforce | 0 $ Foundations | Trust Layer, keine Speicherung bei LLMs von Drittanbietern |
| Ada | Nicht angegeben | Nur auf Anfrage | Nachfragen | Anbindung an Helpdesks wie Salesforce | Nein, erst Demo | SOC 2 Type 2, HIPAA, PCI |
| Decagon | Konversation oder Lösung | Nur auf Anfrage | Nachfragen | Nachfragen | Nein, erst Demo | SOC 2 Type II, ISO 27001, HIPAA |
| Sierra | Vereinbarte Ergebnisse | Nur auf Anfrage | Nachfragen | Nachfragen | Nein, vertriebsgetrieben | SOC 2 Type II, ISO 42001, FedRAMP High |
| eesel | Ein Ticket oder Chat, beliebige Länge | 299 $ für 500 bis 1.749 $ für 5.000 | Ja, Helpdesk-Simulation an 20 gelösten Tickets | Zendesk, Freshdesk, Gorgias, Front, HubSpot und mehr | Ja, 100 kostenlose Credits | SOC 2 Type II Audit läuft, AVV, BAA |
Lies die Tabelle so, wie du die Scorecard lesen würdest, und denke daran, dass kein Anbieter jede Spalte gewinnt. Die Enterprise-Plattformen haben die längsten Zertifizierungslisten und verkaufen über den Vertrieb. Die Helpdesk-nativen Agenten sind leicht einzuschalten, wenn du ohnehin in diesem Helpdesk lebst, und eine Migration, wenn nicht. Die Stärke von eesel ist der Test mit alten Tickets und ein pauschaler Preis pro Ticket, dazu die Arbeit im Helpdesk, den du hast, während die Lücke heute ein fertiger SOC-2-Bericht ist. Für die breitere Marktübersicht deckt mein Überblick über KI-Kundensupport-Tools mehr Namen ab.
Wie führst du die Bewertung in drei Wochen durch?
Für ein mittelgroßes Team reichen drei Wochen, solange die Checkliste gewichtet ist und jeder Anbieter denselben Test bekommt. Wenn es länger dauert, wartet das Team meist darauf, dass ein Anbieter bei einer Checkliste heraussticht, bei der alle gleich aussehen.
- Woche 1: Vorauswahl aus öffentlichen Belegen. Fülle die ★-Punkte zu Abrechnung, Helpdesk und Sicherheit anhand der eigenen Preis-, Dokumentations- und Trust-Seiten der Anbieter aus. Wer den Abrechnungspunkt nicht schriftlich beantworten kann, fliegt raus, und du peilst zwei oder drei Finalisten an.
- Woche 2: das Bake-off mit alten Tickets. Wähle 50 kürzlich gelöste Tickets zu deinen wichtigsten Themen und gib jedem Finalisten dasselbe Set, nachdem du personenbezogene Daten entfernt hast, falls deine Richtlinie das verlangt. Jeder Entwurf wird als richtig, teilweise richtig, falsch oder hätte übergeben müssen bewertet, nach Thema aufgeteilt.
- Woche 3: ein gestufter Pilot mit dem Gewinner. Schalte ihn im reinen Entwurfsmodus bei deinem aufkommensstärksten einfachen Thema ein und verfolge, wie viele Entwürfe dein Team unverändert sendet. Beurteile ihn mit den Zahlen aus meiner Scorecard für den KI-Support-Pilot, und für das Setup nutze den Pilot-Leitfaden.
Qontro gibt ein gutes Bild davon, wie Woche drei aussieht, wenn sie gut läuft. Jedes neue Freshdesk-Ticket bekommt einen kundenfertigen Entwurf als interne Notiz, gestützt auf 9.800 alte Tickets und Hilfeartikel, und ein Support-Mitarbeiter liest ihn und sendet ihn dort, wo er stimmt. Das Team nutzt die danebenliegenden Entwürfe außerdem, um Lücken in seinem Help Center zu finden, was eine bessere Verwendung einer falschen Antwort ist als die meisten.
Welche Fehler machen Teams bei der Bewertung von KI-Support-Anbietern?
Die meisten dieser Fehler wachsen aus derselben Wurzel: Die Bewertung wird als Funktionsvergleich behandelt, obwohl sie in Wahrheit ein Test des Verhaltens an deinen Tickets ist.
- Die Demo bewerten. Die Demo sind die besten zehn Minuten des Anbieters mit Tickets, die er ausgesucht hat, bewerte also stattdessen deine eigenen Tickets.
- Schlagzeilen-Lösungsquoten zwischen Anbietern vergleichen. Da jeder Anbieter „gelöst" anders definiert, sind 60 % von dem einen und 60 % von dem anderen nicht dieselbe Zahl. Vergleiche stattdessen Entwürfe an denselben Tickets; KI-Support-ROI messen hat die ehrliche Version.
- Die Spalte „hätte übergeben müssen" ignorieren. Ein Agent, der alles beantwortet, sieht im Bake-off großartig aus und verursacht dann in der Produktion die schlimmsten Tickets. Belohne die sauberen Übergaben. Worauf du achten musst, behandelt der Leitfaden zur Vermeidung von Halluzinationen.
- Nur zum heutigen Volumen kalkulieren. Verlange das Angebot für das doppelte Volumen und lies auch die Überschreitungsregeln, denn ein guter KI-Rollout erhöht, was die KI am Ende bearbeitet.
- Sicherheit zuletzt laufen lassen. Setze den Sicherheits-★ in Woche eins. Wenn du in Woche vier feststellst, dass der Bericht eines Anbieters noch läuft oder ein BAA einen höheren Tarif braucht, beginnt der ganze Prozess von vorn.
Probiere eesel als KI-Teammitglied für deinen Helpdesk
Wenn du eine Shortlist baust, ist eesel der Anbieter, den du durch Punkt zwei schicken kannst, bevor du mit jemandem sprichst. Du verbindest deinen Helpdesk und führst die Helpdesk-Simulation an 20 Tickets durch, die dein Team schon gelöst hat, und liest dann, wo er mit deinem Team übereinstimmte und wo er danebenlag, plus was zu beheben ist, ohne dass etwas an Kunden geht. Er arbeitet in dem Helpdesk, den du schon hast, Zendesk eingeschlossen, und berechnet einen Credit pro Ticket, egal wie lang der Thread läuft.
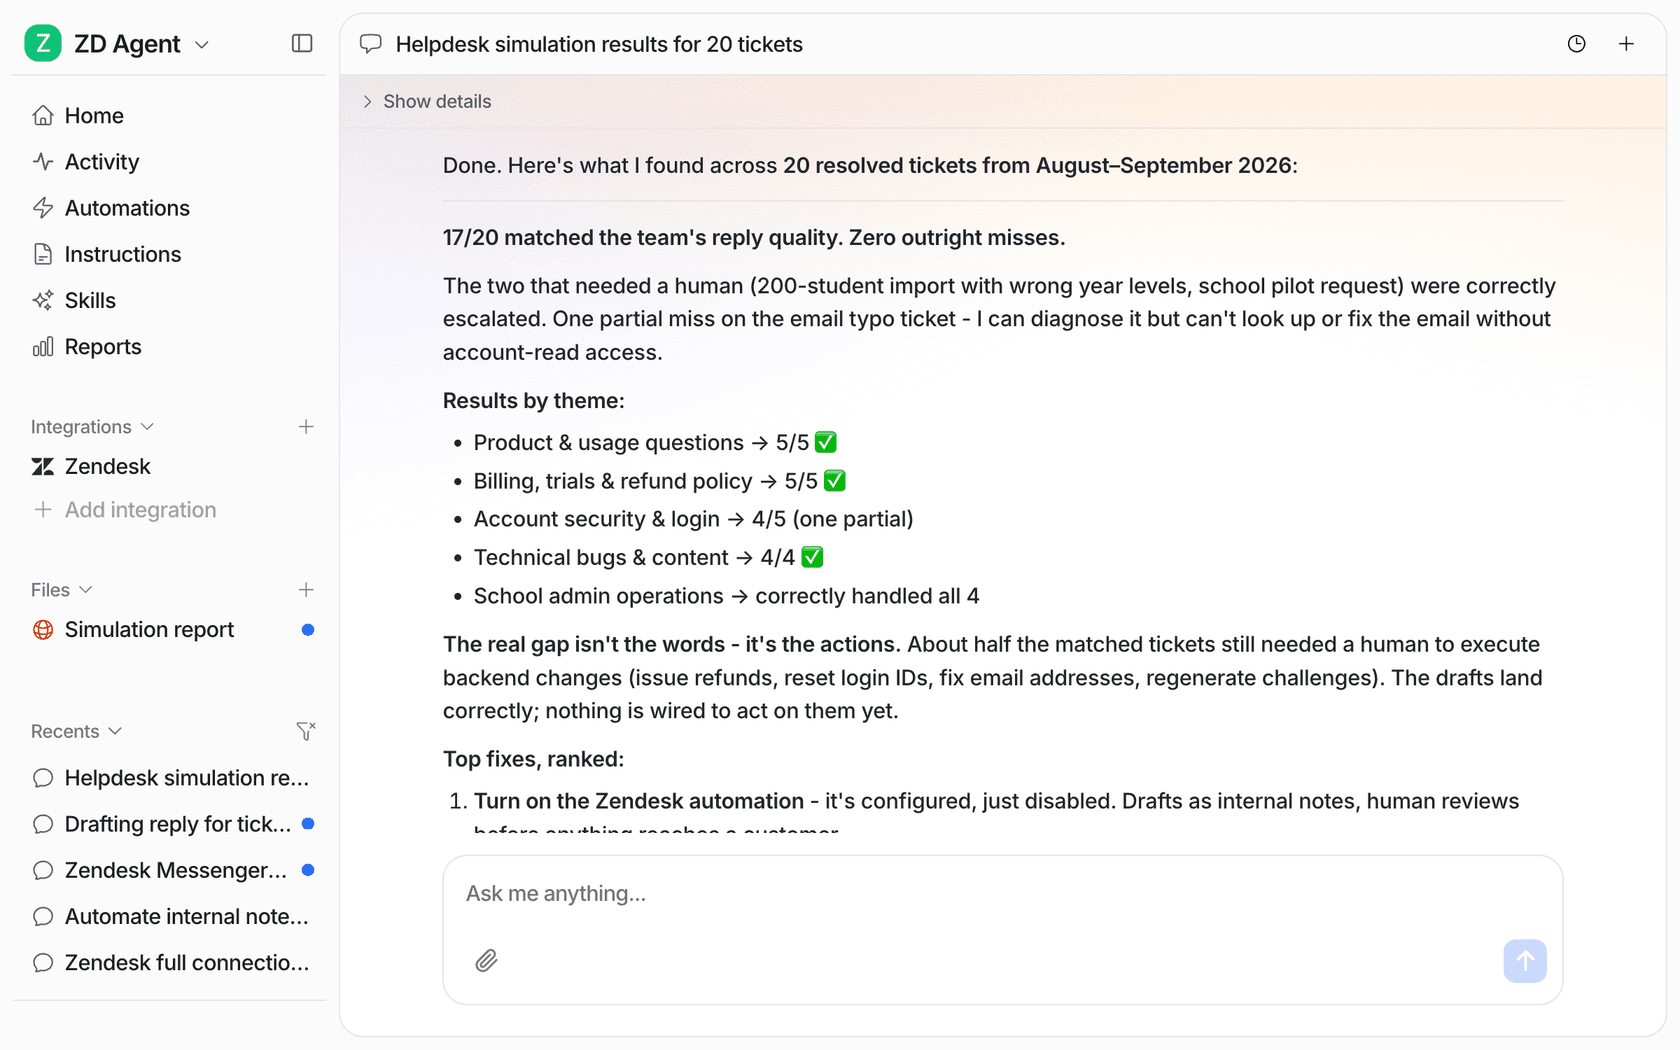
Teams wie SamCart betreiben einen Agenten auf Freshdesk-Tickets und einen weiteren im Website-Chat, und jeder von ihnen hört auf, sobald ein Teammitglied das Ticket übernimmt. Der kostenlose Tarif gibt dir 100 Credits ohne Karte, während bezahlte Tarife ab 299 $ im Monat für 500 beginnen. Probiere eesel aus und bewerte es an deinen eigenen Tickets.