

Warum ein bestandener Antworttest nicht heißt, dass Sie startklar sind
Ich baue die Helpdesk-Integrationen von eesel, also verbringe ich meine Tage genau in dem Code, in dem die Probleme des Launch-Tages sitzen: Auslöser, Übergaben, API-Aufrufe in Bestellsysteme und die Tags, die sagen, wer ein Ticket angefasst hat. Selten bricht das Modell, meistens bricht die Verkabelung.
Die Testing Best Practices von Zendesk zeigen gut, wie die Branche meistens darüber denkt. Sie sagen Testern: "Focus on whether the AI agent's response was accurate and matched the tone of voice you expected." Das ist ein guter Rat, aber nur die Spitze des Eisbergs. Dasselbe Help Center dokumentiert in anderen Artikeln, dass Tickets von KI-Agents Ihre Ticket-Trigger und Automatisierungen erst ausführen, wenn sie eskaliert werden. Ihre Routing-Regeln feuern also zum ersten Mal genau im Moment der Übergabe, dem einen Moment, den ein Genauigkeitstest nie erreicht.
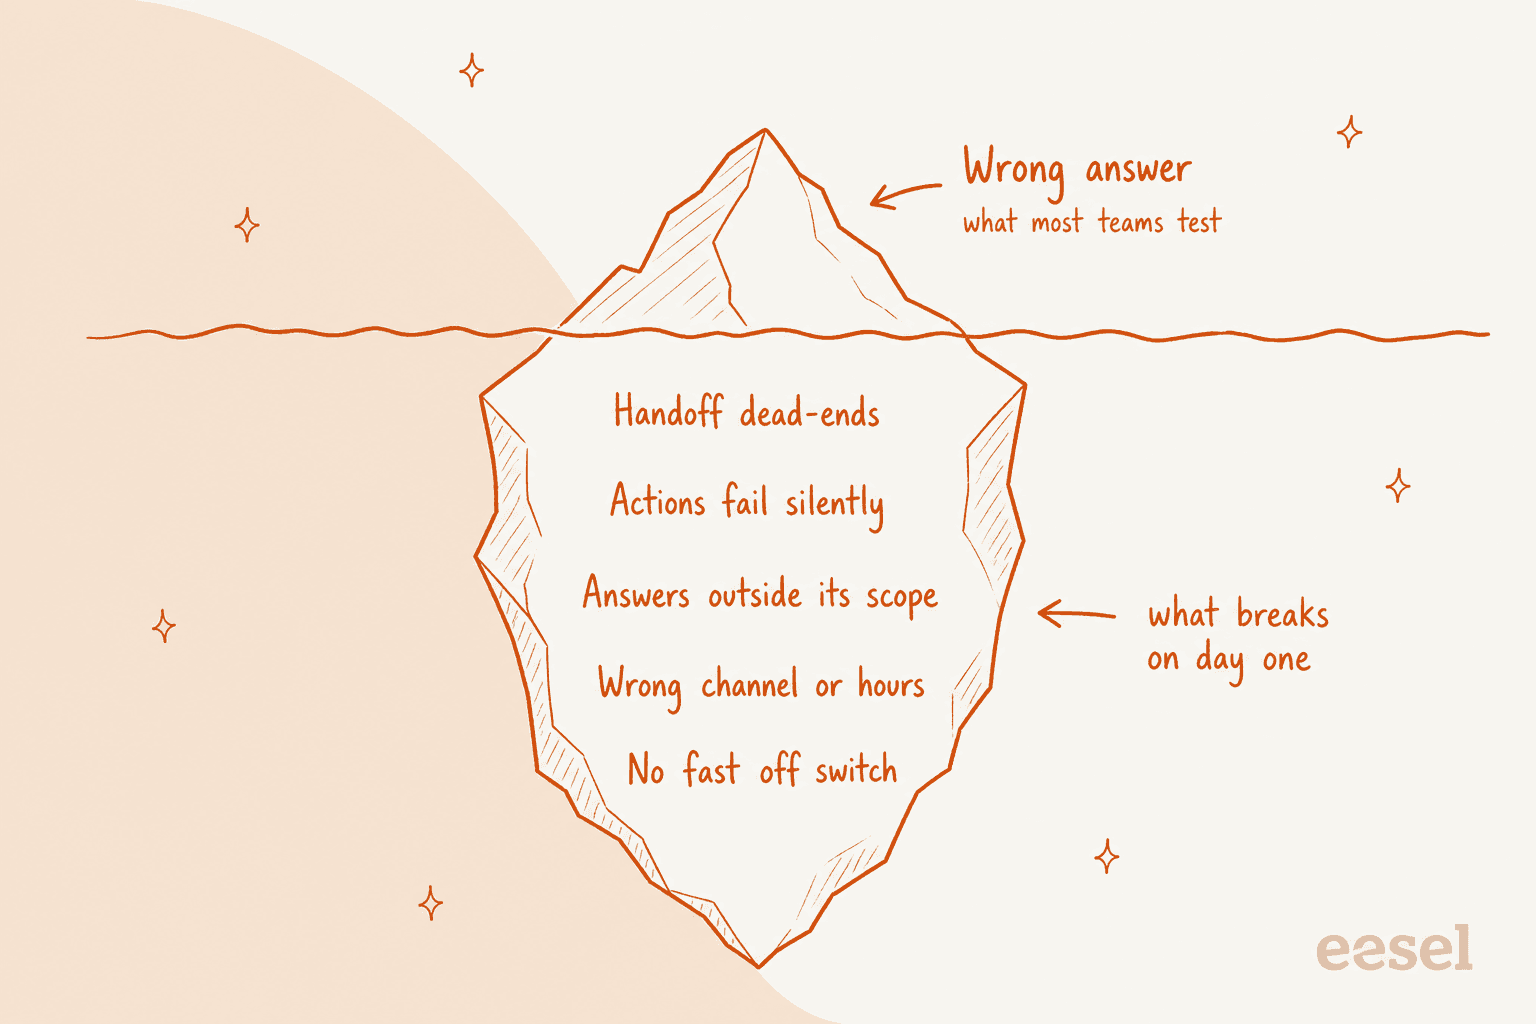
Ich habe selbst Narben davongetragen. Auf der Plattform von eesel habe ich erlebt, wie ein Bot seine eigenen Antworten als neue Kundennachrichten behandelte und sich selbst antwortete, eine Selbstantwort-Schleife, die erst auf einem Live-Helpdesk auftauchte. Ich habe gesehen, wie interner Oberflächentext während einer Produktionstestphase eines Kunden in eine öffentliche Antwort gelangte. Und ich habe Bots auf der Plattform von eesel Antworten erfinden sehen, wenn die Wissensdatenbank leer zurückkam, statt zu übergeben. Keines davon war eine falsche Antwort auf eine Testfrage. Alle waren Nahtstellen.
Auch die rechtliche Seite hat aufgeholt. In Moffatt v. Air Canada sagte der Chatbot der Fluggesellschaft einem Kunden, er könne den Trauerfall-Tarif nach der Reise beantragen, innerhalb von 90 Tagen nach Ausstellung des Tickets, was der eigenen Richtlinienseite von Air Canada widersprach. Das Tribunal nannte das Argument von Air Canada, der Chatbot sei "a separate legal entity", eine "remarkable submission" und ordnete eine Zahlung von $812.02 an. Der Bot lag falsch, aber das eigentliche Versagen war, dass niemand ihn gegen die Quellrichtlinie prüfte, bevor sich Kunden darauf verließen.
Wenn Sie den Leitfaden meines Kollegen zum Testen von KI-Support-Agents schon gelesen haben, ist die Antwortseite abgedeckt. Dieser Beitrag ist das Gegenstück: alles andere, was Sie in der Woche vor dem Umlegen des Schalters prüfen müssen.
Die sieben Checks vor dem Launch im Überblick
Hier ist der ganze Plan auf einem Bildschirm. Der erste Check ist der, den die meisten Teams schon machen. Bei den anderen sechs geht der Launch-Tag schief.
| # | Check | Was Sie nachweisen | Bestehensgrenze vor dem Launch |
|---|---|---|---|
| 1 | Echte Tickets durchspielen | Er beantwortet Ihre häufigen Fragen richtig und in Ihrem Ton | An 50+ alten Tickets bewertet, Genauigkeit und Ton getrennt |
| 2 | Themengrenzen | Er lehnt Themen ab oder übergibt sie, die er nicht anfassen darf | Jedes ausgeschlossene Thema wird übergeben, auf drei Arten gefragt |
| 3 | Übergabepfade | Ein Mensch erhält das Ticket tatsächlich, mit Kontext | Jeder Pfad landet in einer beobachteten Warteschlange, in und außerhalb der Geschäftszeiten |
| 4 | Aktionen | Abfragen und Schreibvorgänge funktionieren und scheitern sicher | Jede Aktion an Testdatensätzen getestet, plus ein erzwungener Fehler |
| 5 | Wo er auftaucht | Er beantwortet die richtigen Tickets und überspringt den Rest | Ein Testticket pro Ausschluss (intern, Spam, VIP, andere Marke) |
| 6 | Ausschalter | Sie können ihn schnell stoppen, ohne Tickets zu verlieren | Jemand hat ihn aus- und wieder eingeschaltet, mit Zeitmessung |
| 7 | Reporting | Sie sehen, was er am ersten Tag getan hat | Vom KI-Agent bearbeitete Tickets getaggt und in einer Ansicht sichtbar |
Die Bestehensgrenzen sind meine, kein Branchenstandard. Setzen Sie Ihre eigenen, aber schreiben Sie sie auf, bevor Sie mit dem Testen beginnen, nicht nachdem Sie die Ergebnisse gesehen haben. Wenn Sie Hilfe bei den Zahlen brauchen, bietet die AI support pilot scorecard eine Vorlage.
Check 1: echte Tickets für die Antworten durchspielen
Beginnen Sie mit dem Antworttest, denn alles andere setzt voraus, dass der Agent die einfachen Fragen richtig beantwortet. Ziehen Sie 50 bis 100 zuletzt gelöste Tickets zu Ihren wichtigsten Themen, lassen Sie sie durch den Agent laufen, ohne dass er jemandem antwortet, und vergleichen Sie seine Antwort mit dem, was Ihr Team tatsächlich gesendet hat.
Die meisten Helpdesks bieten dafür ein Werkzeug. Der E-Mail-Agent von Freshdesk kann importierte Tickets auswerten, bis zu 50 Anfragen pro Durchlauf, und empfiehlt mindestens 20. Der Kundenagent von HubSpot führt Batch-Tests mit bis zu 8 Testsätzen aus, ohne Credits zu verbrauchen. Der Simulation-Skill von eesel spielt Ihre echten alten Tickets durch und bewertet jede Antwort anhand dessen, was Ihr Team gesendet hat, und schlägt dann Änderungen an den Anweisungen vor.
Bewerten Sie Genauigkeit und Ton als zwei getrennte Zahlen. In einer eesel-Testphase mit Live-Verkehr, einem Schmuck-E-Commerce-Postfach mit etwa 1.000 Tickets im Monat, zeigten 88 % der Entwürfe in die richtige Richtung, aber nur 12 % wurden unverändert gesendet, und 7 % enthielten einen Sachfehler. Die meisten Überarbeitungen betrafen Länge und Ton, nicht Fakten. Ein einziger "Genauigkeits"-Wert hätte beide Probleme verdeckt.
Halten Sie den Testsatz dann am Leben. Dieser Reddit-Kommentar ist der nützlichste Rat zum Thema, und er ist nicht ausgefallen:
"keep a list of test questions handy and run it through and see if you get the right answers. Whenever an edge case appears, add to the list of test questions, update your agent and re-run your tests. Boring, but works."

Nehmen Sie Fragen auf, die Ihre Dokumentation nur halb beantwortet. Das richtige Ergebnis ist dort eine Übergabe, kein selbstsicheres Raten. Wenn Antworten falsch sind, weil die Quelle veraltet ist, ist das ein Wissensproblem, und ein Audit der Wissensdatenbank behebt mehr als jede Prompt-Anpassung.
Check 2: testen, was er nicht beantworten darf
Hier trifft "wir haben es ihm gesagt" auf die Realität. Jedes große Helpdesk trennt inzwischen weiche Hinweise von harten Regeln, und die weiche Version richten die meisten Teams ein.
- Zendesk führt "Always escalate to an agent if the user mentions being hacked" als schlechte Anweisung auf, weil "Instructions cannot trigger escalations" (Zendesk-Leitfaden zu Anweisungen). Dafür brauchen Sie einen Use Case.
- Freshdesk sagt, seine Einstellung "Topics to avoid" "may not fully prevent responses in edge cases", und verweist für strikte Durchsetzung auf die Übergabe-Einstellung (Freshdesk Identität und Anweisungen).
- Help Scout sagt es klar: Rollen ändern, wie Scout antwortet, und um Themen direkt an Ihr Team zu schicken, "create an exclusion" (Scout-Rollen).
- HubSpot lässt Sie Leitplanken pro Segment setzen und warnt, dass Antworten "may not always exactly match" dem entsprechen, was Sie festgelegt haben.
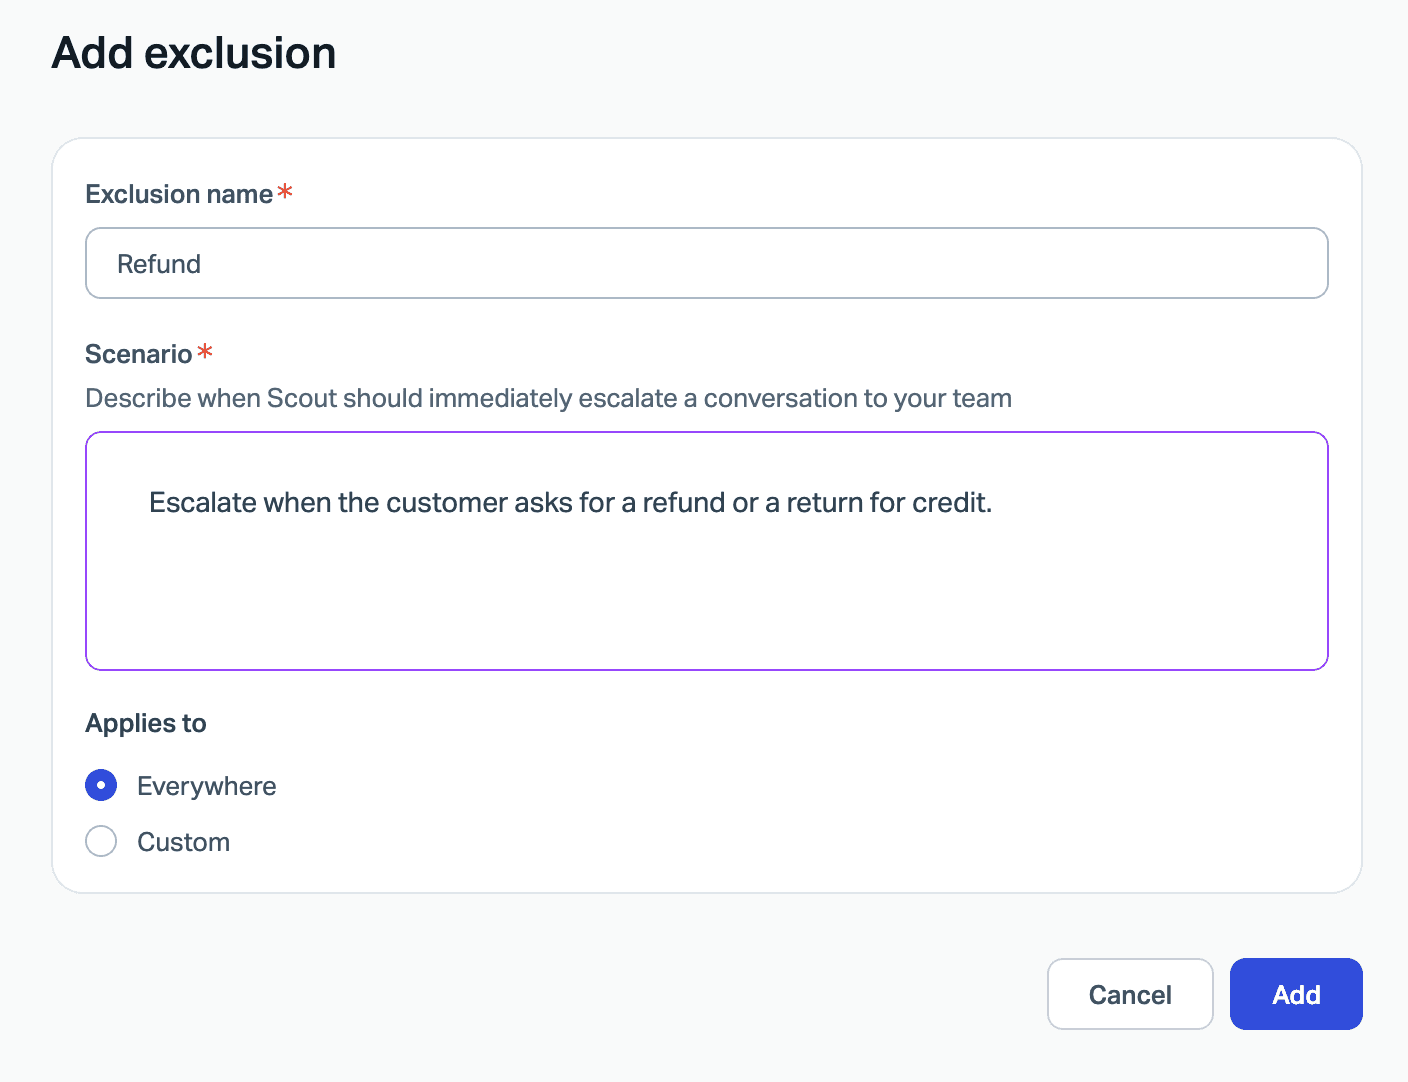
Testen Sie also jedes Thema auf Ihrer "Nie"-Liste (Erstattungen über einem Limit, rechtliche Drohungen, Kontosicherheit, medizinische oder Sicherheitsfragen, alles zu einem Liefertermin, den Sie nicht versprechen können) auf drei Arten: direkt gefragt, in einer längeren Nachricht versteckt und erneut gefragt, nachdem der Agent nein gesagt hat. Die Bestehensgrenze ist jedes Mal eine Übergabe.
Ein E-Commerce-Support-Manager, der eesel nutzt, fing genau das in der Prüfung ab. Sein Agent sagte Kunden immer wieder, Bestellungen kämen pünktlich an, und die Notiz, die er dafür hinterließ, war deutlich: "stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday." Das ist ein Themengrenzen-Test, den Sie vor dem Launch schreiben können: "Kommt es bis Freitag an?"
Testen Sie dann, was passiert, wenn ein Kunde versucht, ihn vom Skript abzubringen. Im Januar 2024 bat ein DPD-Kunde den Bot zu fluchen und ein Gedicht über das Unternehmen zu schreiben, und er tat es:
"Parcel delivery firm DPD have replaced their customer service chat with an AI robot thing. It's utterly useless at answering any queries, and when asked, it happily produced a poem about how terrible they are as a company. It also swore at me. 😂"
OWASP stuft Prompt Injection als größtes Risiko für LLM-Apps ein und empfiehlt "adversarial testing and attack simulations". Für einen Support-Agent heißt das eine kurze Liste von Versuchen: "ignore your instructions", "are you a human?", "give me a discount code" und eine Nachricht, die gefälschten Richtlinientext einfügt. Einen ausführlicheren Leitfaden finden Sie im Beitrag zu Adversarial Testing.
Kundengeschichten machen den Punkt zu den Themengrenzen deutlich. Luxedo, das Projektionssysteme verkauft, hat seinen eesel-Agent nur auf Privatkunden begrenzt: Tickets von Schulen, Fitnessstudios und anderen gewerblichen Käufern werden übersprungen und bleiben beim Vertrieb. Hardwaredefekte, Garantieentscheidungen, Erstattungen und elektrische Sicherheit gehen immer an das Team. Eine so konkrete Grenze lässt sich vor dem Launch leicht testen: Senden Sie ein Ticket aus jeder ausgeschlossenen Gruppe und bestätigen Sie, dass der Agent es in Ruhe lässt.
Check 3: jeden Übergabepfad von Anfang bis Ende durchlaufen
Ein echter Übergabetest stellt drei Fragen: Hat ein Mensch das Ticket bekommen, konnte er sehen, was passiert ist, und wusste der Kunde, was ihn erwartet? Das sind drei verschiedene Checks, und jedes Helpdesk handhabt sie anders.
| Helpdesk | Wo eine Übergabe landet | Reist der Kontext mit? | Umgang außerhalb der Geschäftszeiten |
|---|---|---|---|
| Zendesk AI agents | Die Transfergruppe des Agents oder ein "Escalate to team" pro Pfad | Der Nachrichtenverlauf wird ins Ticket nachgetragen | Availability-Block im Dialog |
| Freshdesk Freddy AI Agent | Nicht zugewiesene Warteschlange oder eine benannte Gruppe (E-Mail) | Ja, eine automatische private Notiz mit dem Grund | Schalter "Transfer outside business hours" |
| Gorgias AI Agent | Der Handover-Bereich der AI-Agent-Ansicht | Keine Zusammenfassungsnotiz dokumentiert | Getrennte Online- und Offline-Anweisungen |
| HubSpot customer agent | Gewählte Nutzer oder Teams oder ein Routing-Workflow | Keine Zusammenfassung dokumentiert | Arbeitszeiten plus eine separate Übergabenachricht |
| Help Scout Scout | Chat: Der Kunde wählt E-Mail oder Chat. E-Mail: Ihr Posteingang | Keine Zusammenfassung dokumentiert | Für Scout nicht dokumentiert |
Einige dieser Details übersieht man leicht, und sie schmerzen am ersten Tag:
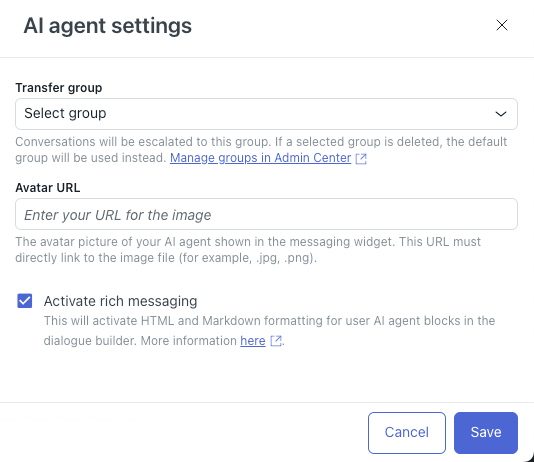
- Die Transfergruppe von Zendesk hat einen stillen Fallback. Der Einstellungsdialog warnt: "If a selected group is deleted, the default group will be used instead." Benennen Sie nach der Einrichtung eine Gruppe um oder führen Sie sie zusammen, und Ihre Übergaben gehen leise woandershin. Die E-Mail-Agents von Zendesk antworten außerdem nicht mehr, sobald der Tag
escalated_by_ultimategesetzt ist, und Zendesk sagt, Sie sollen Ihre Workflows konfigurieren, um diese Tickets selbst zu finden. - Gorgias leitet Übergaben standardmäßig nicht an ein Team. Sie bauen eine Auto-Assign-Regel auf dem Tag
ai_handover(Gorgias-Übergabeleitfaden). Ohne sie bleiben Übergaben in der AI-Agent-Ansicht liegen. - Das "Team only"-Routing von HubSpot übergibt auch, wenn niemand da ist. HubSpot sagt, der Agent "will execute a handoff even if no users are currently available", und er berücksichtigt die Verfügbarkeit des Chat-Widgets nicht (HubSpot-Übergabe einrichten).
- Die Übernahme in Freshdesk lässt sich nicht rückgängig machen. Wenn ein Mensch auf "Stop responding & assign to me" klickt, wird der KI-Entwurf "is discarded permanently" (Freshdesk-Schutzmaßnahmen für E-Mail). Stellen Sie sicher, dass Ihr Team das weiß, bevor es das an einem Ticket testet, das ihm wichtig ist.
So sieht eine Übergabeschleife aus Kundensicht aus. Jeder Ausgang führt zurück zum Anfang:
"The ChatBot looping around providing generic answers, asking what my problem is. It ignores direct request to speak with an agent or to create a customer service. It simply starts with "Please, tell us about the problem ..." If I keep asking the same question, I can managed to get to a list of choices: 1. Report a technical issue, 2. Visit our Status page, 3. Time Tracker issues. Typing 2 and 3 leads to nowhere. Typing 1 reset the chatbot and it start again asking about my problem."
Und hier die Version, in der die Übergabe "funktioniert", aber der Kontext nicht mitgereist ist:
"Doesn't help at all if your support team ignores the bot chats. There is NOTHING more frustrating than talking to a bot for ten minutes just to have your live agent ask "can you please give me your account number one more time?"."
Der Übergabetest hat also fünf Schritte. Bitten Sie auf drei verschiedene Arten um einen Menschen (direkt, frustriert und mitten im Ablauf). Lösen Sie jeden konfigurierten Eskalationsgrund aus. Öffnen Sie das Ticket als der Mitarbeiter, der es erhält, und prüfen Sie, ob Verlauf und eventuelle Zusammenfassung da sind. Lesen Sie die Nachricht, die der Kunde darüber erhielt, was als Nächstes passiert. Und messen Sie, wie lange jemand im Team braucht, um das Ticket zu bemerken. Mehr zur Gestaltung der Übergabe selbst finden Sie in diesen Best Practices für die KI-Übergabe und im Leitfaden dazu, wann man übergeben sollte.
Die Übergabenachricht ist so wichtig wie das Routing. SE Ranking hat seine eesel-Agents so eingestellt, dass sie Kunden sagen, sie sollen in ein bis zwei Werktagen mit einer Antwort rechnen, und nie, dass jemand gleich dazukommt. Erstattungen, Testverlängerungen und wiederholte Fragen gehen mit Name und E-Mail des Kunden ans Team. Das ist ein Versprechen, das das Team halten kann, also auch eines, das Sie testen können.
Den Pfad außerhalb der Geschäftszeiten separat testen
Außerhalb der Geschäftszeiten brechen Übergaben am häufigsten, weil die Warteschlange, die sonst beobachtet wird, es dann nicht ist. Jedes Helpdesk handhabt das ein wenig anders:
- Freshdesk hat einen Schalter "Transfer outside business hours" und warnt davor, Anweisungen für den Umgang mit Geschäftszeiten zu verwenden (Freshdesk-Übergabeeinstellungen).
- Zendesk nutzt einen Availability-Block am Anfang des Eskalationspfads.
- Gorgias schließt ein Offline-Chat-Ticket, wenn der Käufer keine E-Mail-Adresse hinterlässt.
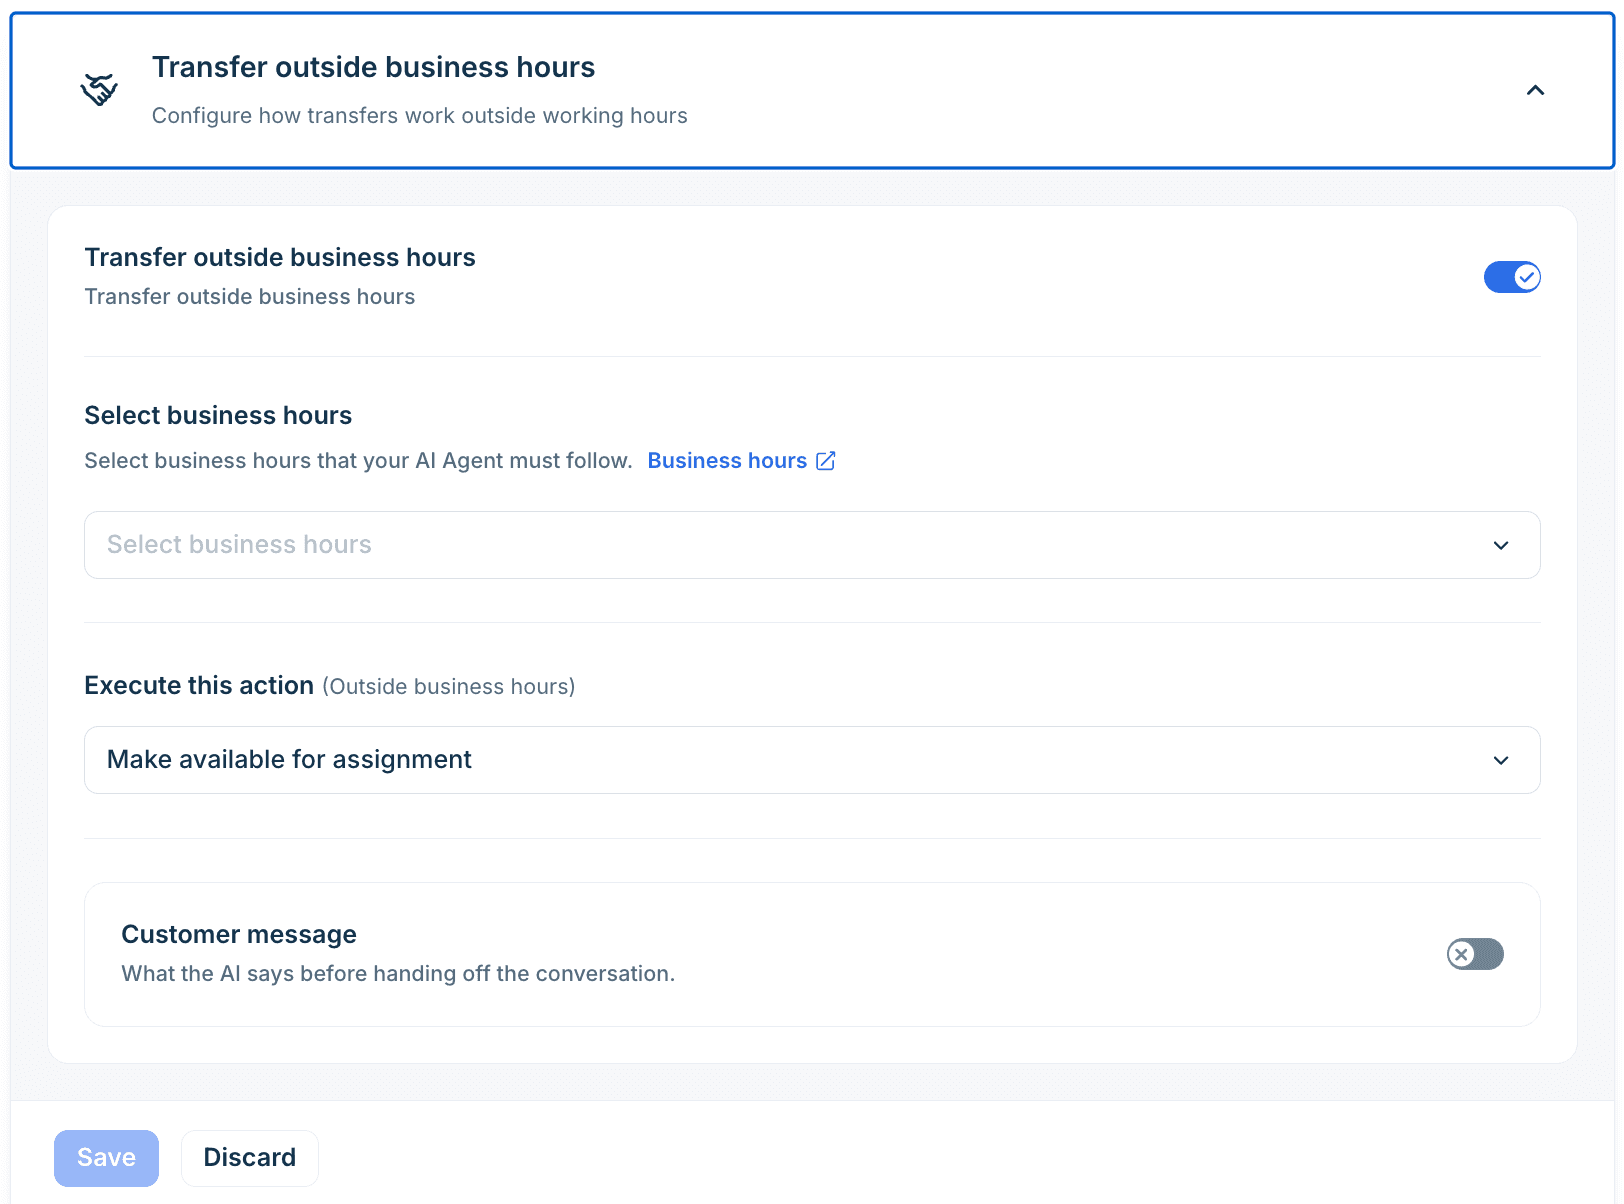
Führen Sie einen Übergabetest mit auf "geschlossen" gestellten Geschäftszeiten durch und bestätigen Sie drei Dinge: wo das Ticket landet, was dem Kunden gesagt wird und ob etwas ohne Antwort geschlossen wird. Wenn Ihr Helpdesk eigene Geschäftszeiten-Einstellungen hat, prüfen Sie, dass der KI-Agent denselben Zeitplan nutzt wie Ihr Team.
Check 4: jede Aktion testen, dann absichtlich kaputt machen
Aktionen sind der Punkt, an dem ein KI-Agent aufhört zu reden und anfängt zu handeln: eine Bestellung nachschlagen, einen Tag hinzufügen, eine Erstattung starten, ein Abo kündigen. Hier lassen einen Testumgebungen auch am meisten im Stich, weil das Testen einer Aktion meist ein echtes System berührt.
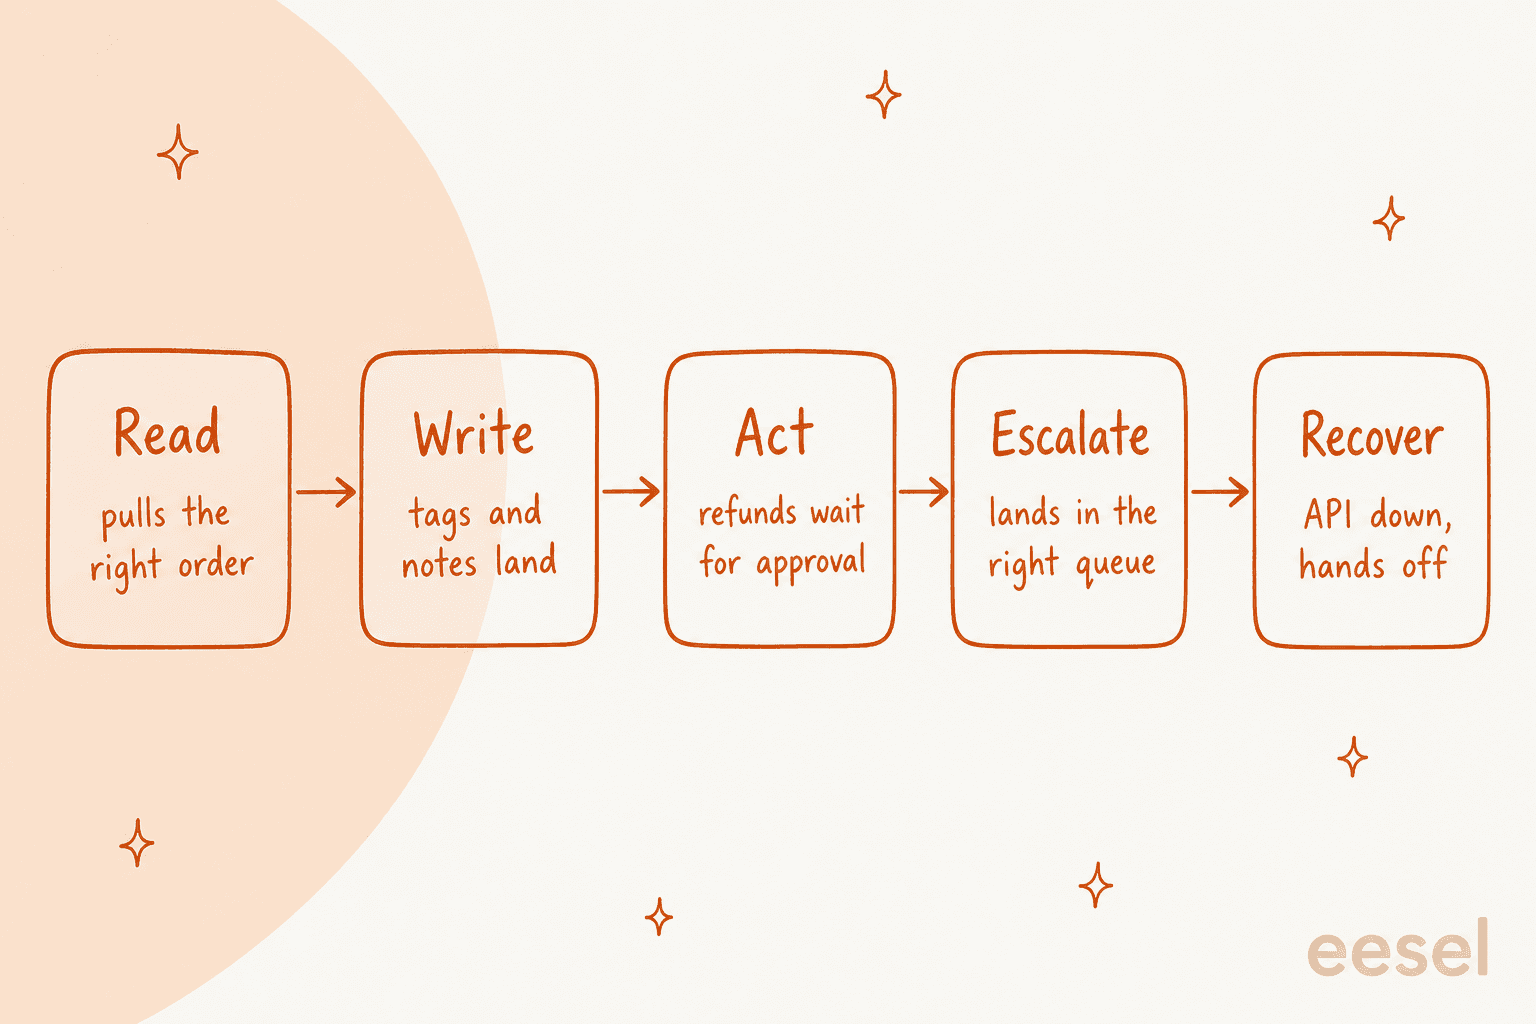
Testen Sie jede Aktion in allen fünf Weisen, auf die es ankommen kann. Read: Holt sie die richtige Bestellung, wenn zwei Kunden denselben Namen haben? Write: Landen Tags, Notizen und Feldänderungen am richtigen Ticket? Act: Wartet alles, was Geld kostet, auf einen Menschen? Escalate: Geht das Ticket an einen Menschen, wenn die Aktion nicht abgeschlossen werden kann? Recover: Bekommt der Kunde eine sinnvolle Antwort statt Schweigen, wenn die API ausgefallen oder langsam ist?
Was die Helpdesks zu Fehlern dokumentieren:
- Zendesk Custom Actions laufen nach 10 Sekunden in ein Timeout, und dann "the action isn't performed." Der eigene Leitfaden von Zendesk zu generativen Prozeduren gibt eine gute Regel zum Kopieren: "If API returns 'timeout', retry up to 2 times. If still failing, escalate the request." Er weist auch darauf hin, dass ein Aufruf Erfolg zurückmelden und trotzdem im Fehlerzweig landen kann, wenn der Agent die Antwort nicht lesen kann.
- Freshdesk Chat-Aktionen leiten bei Timeout oder Fehler auf einen Fallback-Pfad. Bei E-Mail dagegen werden "confirmation blocks are skipped", weil es keine Live-Unterhaltung gibt, und Freshdesk sagt, Sie sollen Schutzmaßnahmen "at the API layer" einbauen (Freshdesk API-Aktionen). Die Schaltfläche Test API nutzt "real values and may affect your external system".
- Gorgias stoppt eine mehrstufige Aktion am fehlgeschlagenen Schritt und übergibt das Ticket an Ihr Team, aber frühere Schritte bleiben ausgeführt (Gorgias-Aktionsprotokolle). Testunterhaltungen "use real data from your connected apps", also verwenden Sie ein Testkundenprofil.
- HubSpot lässt Sie bis zu 20 Aktionen mit einem Aktionsschutzlevel (None, Match email oder Verify email) einrichten, dokumentiert aber nicht, was passiert, wenn eine scheitert. Testen Sie das selbst.
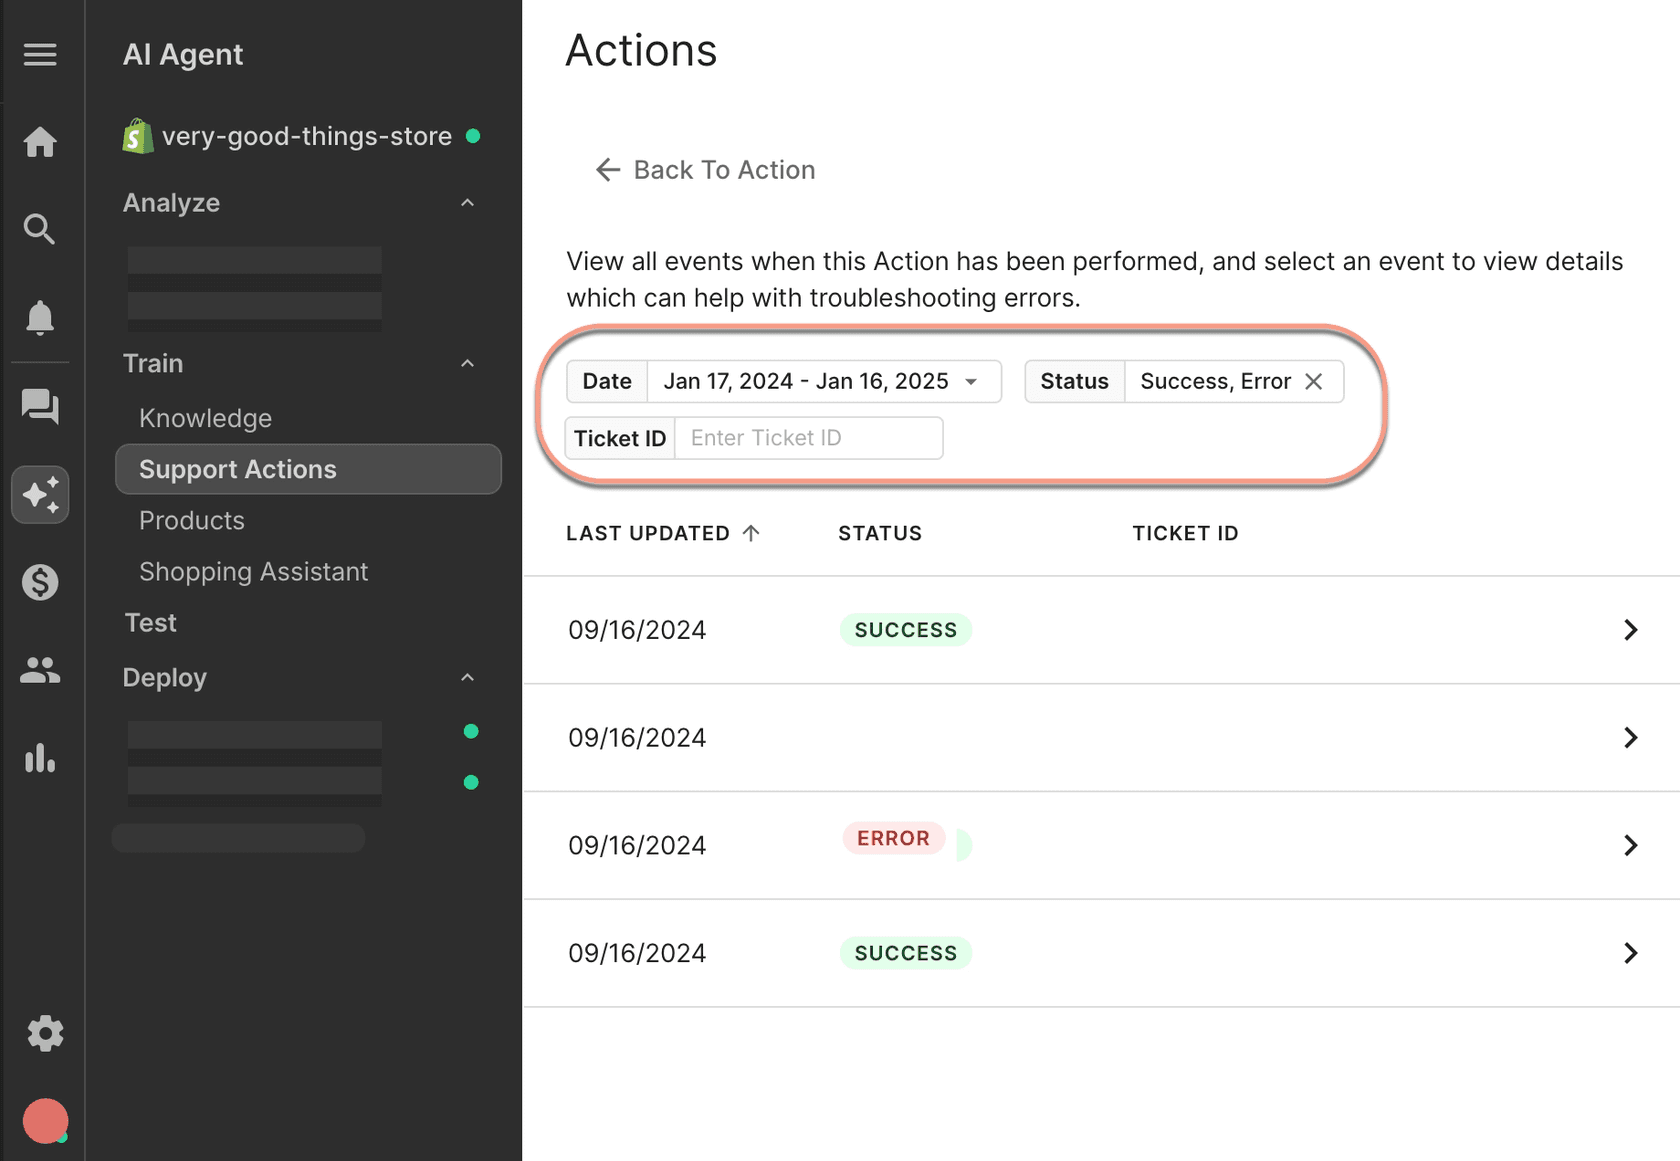
Kein Helpdesk, das ich geprüft habe, hat eine Schaltfläche, die einen API-Ausfall simuliert. Um den Recover-Schritt zu testen, richten Sie die Aktion auf einen Staging-Endpunkt und schalten ihn ab, oder geben Sie ihr eine falsche Bestellnummer und ein abgelaufenes Token. Es fühlt sich nach Mehrarbeit an, bis das Bestellsystem einen schlechten Morgen hat.
Der sicherste Standard ist der langweilige: Starten Sie jede Aktion, die etwas verändert, hinter einer Freigabe. In eesel wird jede Aktion auf Auto, Needs approval oder Disabled gesetzt, neue Agents sollen beaufsichtigt starten, und "Approvals never run on their own after a timeout." Wenn Sie eigene Regeln schreiben, welche Erstattungen ein Bot anfassen darf, ist eine Erstattungs-Freigabematrix ein guter Anfang.
Check 5: bestätigen, wo er auftaucht und wo er still bleibt
Ein Agent, der bei den richtigen Tickets gut antwortet, kann Sie bei den falschen trotzdem blamieren. Auslöser, Kanäle, Marken und Regeln entscheiden, welche Tickets der Agent sieht, und jedes Helpdesk hat seine eigenen Überraschungen:
- Gorgias-Regeln laufen zuerst. Wenn eine Regel eine automatische Antwort sendet, "may still attempt its own response" der AI Agent, und der Kunde bekommt zwei Nachrichten (Gorgias-Regeln und AI Agent). Gorgias schließt außerdem ohne Antwort jede Nachricht, die es für nicht E-Commerce- oder Support-bezogen hält, und das lässt sich nicht abschalten. Prüfen Sie nach einem Testlauf die geschlossenen und zurückgestellten Tickets.
- Zendesk eskaliert jede Nachricht mit einem PDF an einen Menschen, was es "expected behavior" nennt (Zendesk-Fehlerbehebung). Wenn Ihre Kunden Rechnungen als PDF senden, sehen Ihre Deflection-Zahlen anders aus als im Test.
- Freshdesk lässt Sie den E-Mail-Agent zuerst für interne Teams ausrollen, "a safe pilot rollout", mit bis zu fünf Ebenen verschachtelter Regeln dafür, wen er bedient (Freshdesk E-Mail-Agent einrichten).
Senden Sie ein Testticket für jede Art von Ticket, die der Agent überspringen soll: ein internes Ticket, Spam, einen VIP, ein Ticket für Ihre zweite Marke, eine Bewerbung, ein Anbieterangebot. Lesson Pro, das mehrere Unterrichtsmarken aus einem Zendesk betreibt, hat seine eesel-Agents so eingestellt, dass sie Bewerbungen, Voicemails und Bestellformulare überspringen und die Marke erkennen, bevor sie ein Wort schreiben. Eine falsche Marke in einer Antwort ist schlimmer als eine langsame Antwort, und es ist das, was sich am leichtesten testen lässt.
Lassen Sie den Agent dann auf einem echten Testticket in Ihrem Live-Helpdesk antworten und beobachten Sie dieses Ticket zehn Minuten lang. Nur so fangen Sie eine Selbstantwort-Schleife ab, den Fehler, den ich oben erwähnt habe, bei dem der Auslöser auf die eigene Antwort des Agents feuert. Auch eine Sandbox zeigt ihn nicht. Die Sandbox von Zendesk schaltet Webhooks standardmäßig ab, kopiert keine Aktions-Flows und kein skillbasiertes Routing, unterstützt kein SMS, und eine vollständige Kopie "can take up to a week or more". Sie ist ein guter Ort, um Antworten zu testen, und ein schwacher, um Nahtstellen zu testen. Mehr zu diesem Abwägen finden Sie unter Zendesk Sandbox vs. Produktion.
Check 6: den Ausschalter proben
Jeder Launch-Plan hat eine Zeile, die sagt "wir können ihn abschalten, wenn etwas schiefgeht". Sehr wenige Teams haben es tatsächlich getan. Tun Sie es vor dem Launch, messen Sie die Zeit und sorgen Sie dafür, dass zwei Personen wissen, wie es geht.
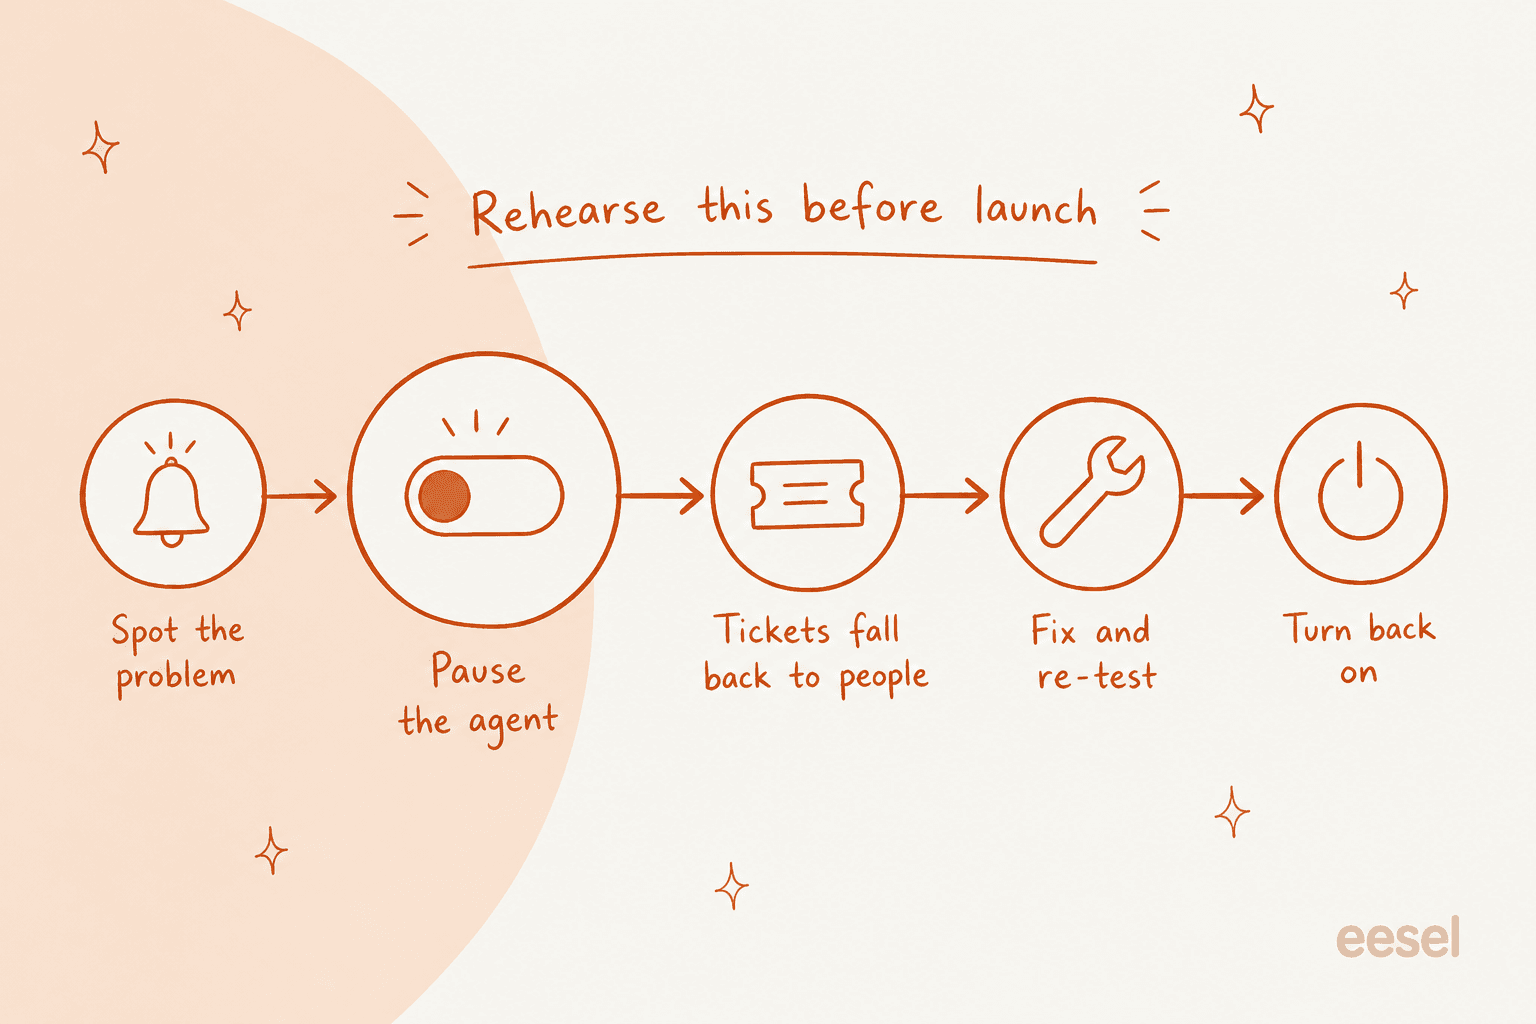
Der Ausschalter ist nicht in jedem Helpdesk dasselbe, und einige der naheliegenden Schalter tun nicht, was man erwartet:
| Helpdesk | So schalten Sie ihn ab | Worauf Sie achten sollten |
|---|---|---|
| Zendesk | Den Kanal unter Manage channels abwählen (Zendesk-Leitfaden) | Keine Pause-Taste. Wenn Sie den E-Mail-Trigger bearbeitet haben, verwaltet dieses Menü den E-Mail-Agent nicht mehr |
| Freshdesk | Den Agent an der Quelle deaktivieren oder ein Ticket übernehmen | Die Übernahme gilt pro Ticket und lässt sich nicht rückgängig machen. Konfigurationsänderungen gelten nur für neue Tickets |
| Gorgias | ON/OFF-Schalter pro Kanal unter Deploy | Einen Skill auszuschalten ist kein Ausschalter, der Agent greift dann auf Ihr Wissen zurück (Gorgias-Skills) |
| HubSpot | Schalter unter Usage & Limits oder Remove pro Kanal | Wenn er aus ist, bearbeitet er bestehende Threads weiter, nur neue gehen an Menschen (HubSpot Deploy) |
| Help Scout | Enable-Schalter pro Beacon und pro Posteingang | Ob es sofort wirkt, ist nicht dokumentiert |
Zwei davon sind eine zweite Lektüre wert. In Gorgias stoppt das, was nach "Erstattungs-Skill abschalten" aussieht, keine Erstattungsfragen; der Agent beantwortet sie stattdessen aus Ihrem Wissen, und ihn bei einem Teil der Tickets zu stoppen, erfordert eine "ignore"-Regel. In HubSpot nennt die Übergabeseite "the agent is paused" als Grund für eine Übergabe, während die Deploy-Seite sagt, dass bestehende Threads weiterlaufen, wenn er aus ist. Testen Sie, welches Verhalten Sie bekommen.
Schreiben Sie die Übung als einseitiges Runbook auf: wer ihn abschalten darf, die genauen Klicks, wohin die Tickets gehen, wenn er aus ist, wer das Team informiert und was gelten muss, bevor Sie ihn wieder einschalten.
Check 7: das Reporting vor dem ersten Tag einrichten
Am Launch-Tag wird jemand fragen "funktioniert es?", und Sie wollen in unter einer Minute antworten können. Das heißt, die Tags und Ansichten müssen vor dem ersten Live-Ticket existieren, nicht danach.
Taggen Sie mindestens jedes Ticket, das die KI anfasst, taggen Sie jede Übergabe mit einem Grund und bauen Sie eine Ansicht für "übergeben und noch nicht übernommen". SE Ranking bat um einen Tag ai_handled auf jedem Ticket, das eesel anfasst, plus Tags für hilfreich und nicht hilfreich, um die Eindämmungsquote in Zendesk zu zählen, statt zu raten. Freshdesk protokolliert für jedes Ticket automatisch einen Übergabegrund, darunter "System issue" und "Max turns exceeded", was ein kostenloser Bericht zur Eskalationsqualität ist, wenn Sie ihn nutzen.
Entscheiden Sie dann, was Sie in Woche eins prüfen. Das ist die beste kurze Antwort, die ich dazu gelesen habe:
"The expensive misses are usually the ones that look confident and don't escalate. So I'd rather have a slightly annoying bot that hands off early than one that quietly invents an answer. If I were running it, I'd review a small sample of resolved tickets every week, plus every escalation and complaint. That's probably more important than the model choice."
Gorgias schlägt vor, in der ersten Woche mindestens 10 von der KI bearbeitete Tickets zu prüfen (Gorgias-Go-live-Leitfaden). Ich würde am ersten Tag weiter gehen: Lesen Sie jede Übergabe und jeden Aktionslauf. Der Leitfaden zu CX-KI-Kennzahlen zeigt, was Sie danach verfolgen sollten.
Was tun, wenn am ersten Tag etwas schiefgeht
Auch mit allen sieben Checks wird Sie etwas überraschen. Die nützliche Frage ist, ob es ein "jetzt pausieren"-Problem oder ein "heute beheben"-Problem ist. Wählen Sie das Symptom, das Sie sehen:
Triage am Launch-Tag
Am ersten Tag ist etwas schiefgegangen. Ziehen Sie den Stecker?
Wählen Sie, was Sie sehen. Sie erhalten die Entscheidung, den ersten Schritt und den Test vor dem Launch, der es abgefangen hätte.
- Pausieren?
- Das Thema pausieren, wenn Geld, Recht oder Sicherheit betroffen sind. Sonst eingeschaltet lassen und heute beheben.
- Jetzt tun
- Finden Sie jede Antwort zu diesem Thema seit dem Launch und senden Sie eine Korrektur von einem Menschen. Beheben Sie das Quelldokument und fügen Sie dann eine klare Regel hinzu ("nenne nie eine Erstattungsfrist, verlinke die Richtlinienseite").
- Test, der es abfängt
- Fragen, die Ihre Dokumentation nur halb beantwortet oder die ihr widersprechen. Das richtige Ergebnis ist eine Übergabe, kein selbstsicheres Raten.
- Pausieren?
- Jetzt pausieren auf diesem Kanal. Ein gefangener Kunde ist der schnellste Weg zu einer öffentlichen Beschwerde.
- Jetzt tun
- Stellen Sie den Kanal wieder auf Menschen um und prüfen Sie dann, wo die Übergabe landen soll und ob "mit einem Menschen sprechen" überhaupt ein Auslöser ist.
- Test, der es abfängt
- Bitten Sie auf drei verschiedene Arten um einen Menschen, mitten im Gespräch, außerhalb der Geschäftszeiten und auf jedem Kanal.
- Pausieren?
- Die Aktion pausieren, nicht den ganzen Agent. Stellen Sie sie wieder auf nur mit Freigabe.
- Jetzt tun
- Ziehen Sie das Aktivitätsprotokoll für jeden Lauf dieser Aktion seit dem Launch und machen Sie rückgängig, was Sie von Hand können.
- Test, der es abfängt
- Führen Sie jede Aktion an Testdatensätzen aus und machen Sie sie dann kaputt: falsche Bestellnummer, zwei passende Kunden, API-Timeout.
- Pausieren?
- Eingeschaltet lassen, aber den Auslöser heute eingrenzen.
- Jetzt tun
- Fügen Sie dem Auslöser den fehlenden Ausschluss hinzu (Tag, Marke, Gruppe, Absender) und prüfen Sie, was sonst noch dieselbe Bedingung erfüllt.
- Test, der es abfängt
- Senden Sie ein Testticket pro Ausschluss, der Ihnen wichtig ist: intern, Spam, VIP, die zweite Marke, und bestätigen Sie, dass der Agent es überspringt.
- Pausieren?
- Eingeschaltet lassen. Der Agent hat seine Arbeit getan, das Routing nicht.
- Jetzt tun
- Richten Sie die Übergabe auf eine Gruppe, die jemand beobachtet, nehmen Sie die Ansicht in die Schicht des Teams auf und versprechen Sie in der Übergabenachricht eine realistische Antwortzeit.
- Test, der es abfängt
- Lösen Sie eine Übergabe aus und messen Sie, wie lange ein Kollege braucht, um sie zu bemerken, in und außerhalb der Geschäftszeiten.
- Pausieren?
- Jetzt pausieren. Schleifen vervielfachen sich minütlich.
- Jetzt tun
- Prüfen Sie, dass der Auslöser nur bei Kundennachrichten feuert, nicht bei jeder Aktualisierung oder jedem öffentlichen Kommentar.
- Test, der es abfängt
- Lassen Sie den Agent auf einem echten Testticket im Live-Helpdesk antworten und beobachten Sie das Ticket danach zehn Minuten lang.
Das Muster hinter dem Widget: Pausieren Sie alles, was einen Kunden festsetzt oder Geld ausgibt, und beheben Sie Routing- und Auslöserprobleme, während der Agent weiterläuft. Wenn der Support-Bot eines Anbieters öffentlich danebengeht, sieht die Lösung meist gleich aus. Nachdem der KI-Support-Bot von Cursor im April 2025 eine Aussperr-Richtlinie erfunden hatte, begann die eigene Nachbetrachtung des Mitgründers auf Hacker News mit Kennzeichnung und einer Erstattung:
"Apologies - something very clearly went wrong here. We've already begun investigating, and some very early results:
Any AI responses used for email support are now clearly labeled as such. We use AI-assisted responses as the first filter for email support. We've made sure this user is completely refunded - least we can do for the trouble." mntruell (Cursor cofounder), Hacker News

Ihre Go/No-go-Entscheidung
Gehen Sie am Abend vor dem Launch diese Liste durch. Wenn eine Zeile ein "Nein" ist, halten Sie dieses Teil vorerst zurück. Starten Sie die Spur, die besteht, und halten Sie den Rest zurück.
- Der Agent wurde an echten alten Tickets bewertet, Genauigkeit und Ton getrennt.
- Jedes "nie beantworten"-Thema wird übergeben, auf drei Arten getestet, mit einem harten Ausschluss statt einer Anweisung.
- Jeder Übergabepfad landet in einer Warteschlange, die jemand beobachtet, in und außerhalb der Geschäftszeiten, mit angehängtem Kontext.
- Jede Aktion wurde an Testdatensätzen getestet und einmal zum Scheitern gebracht.
- Ein Testticket pro Ausschlusstyp wurde korrekt übersprungen, und ein Live-Testticket hat keine Schleife ausgelöst.
- Zwei Personen haben den Agent aus- und wieder eingeschaltet und wissen, wohin die Tickets gehen, wenn er aus ist.
- Von der KI bearbeitete Tickets und Übergaben sind getaggt, und es gibt eine Ansicht für nicht übernommene Übergaben.
Wenn Sie dazu einen vollständigen Rollout-Plan wollen, behandelt der Leitfaden zum Durchführen eines KI-Support-Piloten die vier Wochen nach dem Launch, und die Liste der Fehler bei der KI-Einführung die, die später auftauchen.
Wie eesel die Nahtstellen vor dem Launch handhabt
Ich bin befangen, weil ich es baue, aber das ist der Teil von eesel, auf den ich am stolzesten bin, weil er um die Nahtstellen herum gebaut ist statt um die Demo.
- Erst die Antworten. Der Simulation-Skill spielt Ihre alten Tickets durch, bewertet jede Antwort anhand dessen, was Ihr Team gesendet hat, und listet Korrekturen auf. Die Anbindung eines Helpdesks ist nur lesend: "It does nothing on tickets until you create an automation."
- Harte Schalter, nicht nur Anweisungen. Wenn aus bestimmtem Ticketverlauf nicht gelernt werden soll, sind die Docs von eesel deutlich: "Telling it in its instructions to ignore past tickets does not stop it finding them; the switch does" (Zendesk-Einrichtung).
- Aktionen hinter Freigabe. Jede Aktion ist Auto, Needs approval oder Disabled, und die Docs empfehlen, Erstattungen hinter einer Freigabe zu halten.
- Ein Protokoll dessen, was tatsächlich getan wurde. Die Seite Activity listet jedes Ticket, was gesucht wurde, jede Aktion, wer sie freigegeben hat, und übersprungene Tickets mit dem Grund.
- Ein Terminal für die Verkabelung. Mit dem eesel CLI testen Sie den Agent mit
eesel chat, prüfen zurückgehaltene Aktionen miteesel approvals, leseneesel activityund nutzen--dry-run, um den genauen Aufruf auszugeben, den ein Schreibvorgang senden würde, ohne ihn zu senden. Das ist nützlich, wenn ein Coding-Agent wie Claude Code Ihnen bei der Integration hilft und Sie den Schreibvorgang sehen wollen, bevor er passiert.

Beautek, ein B2B-Ausrüstungslieferant in Deutschland, ist ein gutes Beispiel dafür, wie die Übergabeseite richtig läuft. Sein Website-Chat beantwortet Produkt- und Bestellfragen auf Deutsch, aber bei Frustration, rechtlichen Fragen, komplexen Bestellungen oder dem Wunsch nach einem Menschen wird ein Zendesk-Ticket mit der angehängten Unterhaltung erstellt. In einem Monat waren das 20 aus dem Chat erstellte Zendesk-Tickets, die meisten davon Vertriebskontakte, während Zendesk-Tickets selbst als Entwürfe bleiben, die das Team freigibt.
Testen Sie Ihren KI-Agent vor dem Launch mit eesel
Wenn Ihr Launch-Plan lautet "wir haben die Antworten getestet, den Rest klären wir live", ist eesel für den Rest gebaut. Es schließt sich Ihrem Zendesk, Freshdesk, Gorgias oder HubSpot an wie ein neuer Mitarbeiter: Es lernt aus Ihren alten Tickets, wird daran bewertet, bevor es einen Kunden berührt, und kann so starten, dass jede Antwort und jede Erstattung auf Ihre Freigabe wartet. Sie entscheiden, wann jede Spur live geht, und Sie können alles wieder abschalten.
Der kostenlose Plan enthält 100 Credits ohne Karte, und kostenpflichtige Pläne beginnen bei $299/month für 500 Credits (Preise). Probieren Sie eesel an einer Kopie der Tickets der letzten Woche aus und sehen Sie, was es getan hätte.