

Der einzige Benchmark für KI-Support-Agenten, aus dem Sie wirklich Entscheidungen ableiten können, ist ein Vergleich Ihres Agenten und Ihres Teams anhand derselben Tickets, mit einer einheitlichen Definition von „gelöst“. Die Lösungsquoten der Anbieter lassen sich nicht miteinander vergleichen: Zendesk, Gorgias, HubSpot, Freshdesk, Salesforce und Help Scout verwenden jeweils einen anderen Test. Derselbe schweigende Kunde zählt deshalb in einem Tool als Erfolg und in einem anderen als Vielleicht. Öffentliche Tests wie tau-bench bewerten Modelle, nicht Ihre Konfiguration. Die Simulation von eesel macht genau das: Sie spielt Ihre gelösten Tickets erneut durch, vergleicht die Antworten mit dem, was Ihr Team tatsächlich gesendet hat, und bewertet jedes Thema, bevor irgendetwas einen Kunden erreicht.
Was bedeutet es eigentlich, „einen KI-Support-Agenten zu benchmarken“?
Ich entwickle KI-Agenten bei eesel, und die häufigste Frage, die ich nach einer Einführung höre, ist eine Variante von „Sind 60 % gut?“. Die ehrliche Antwort lautet: Es kommt darauf an, welche 60 % gemeint sind. Wenn jemand „Benchmark“ sagt, meint er meist eines von drei verschiedenen Dingen. Wer sie vermischt, landet als Team schnell bei einer Zahl, aus der sich nichts ableiten lässt.
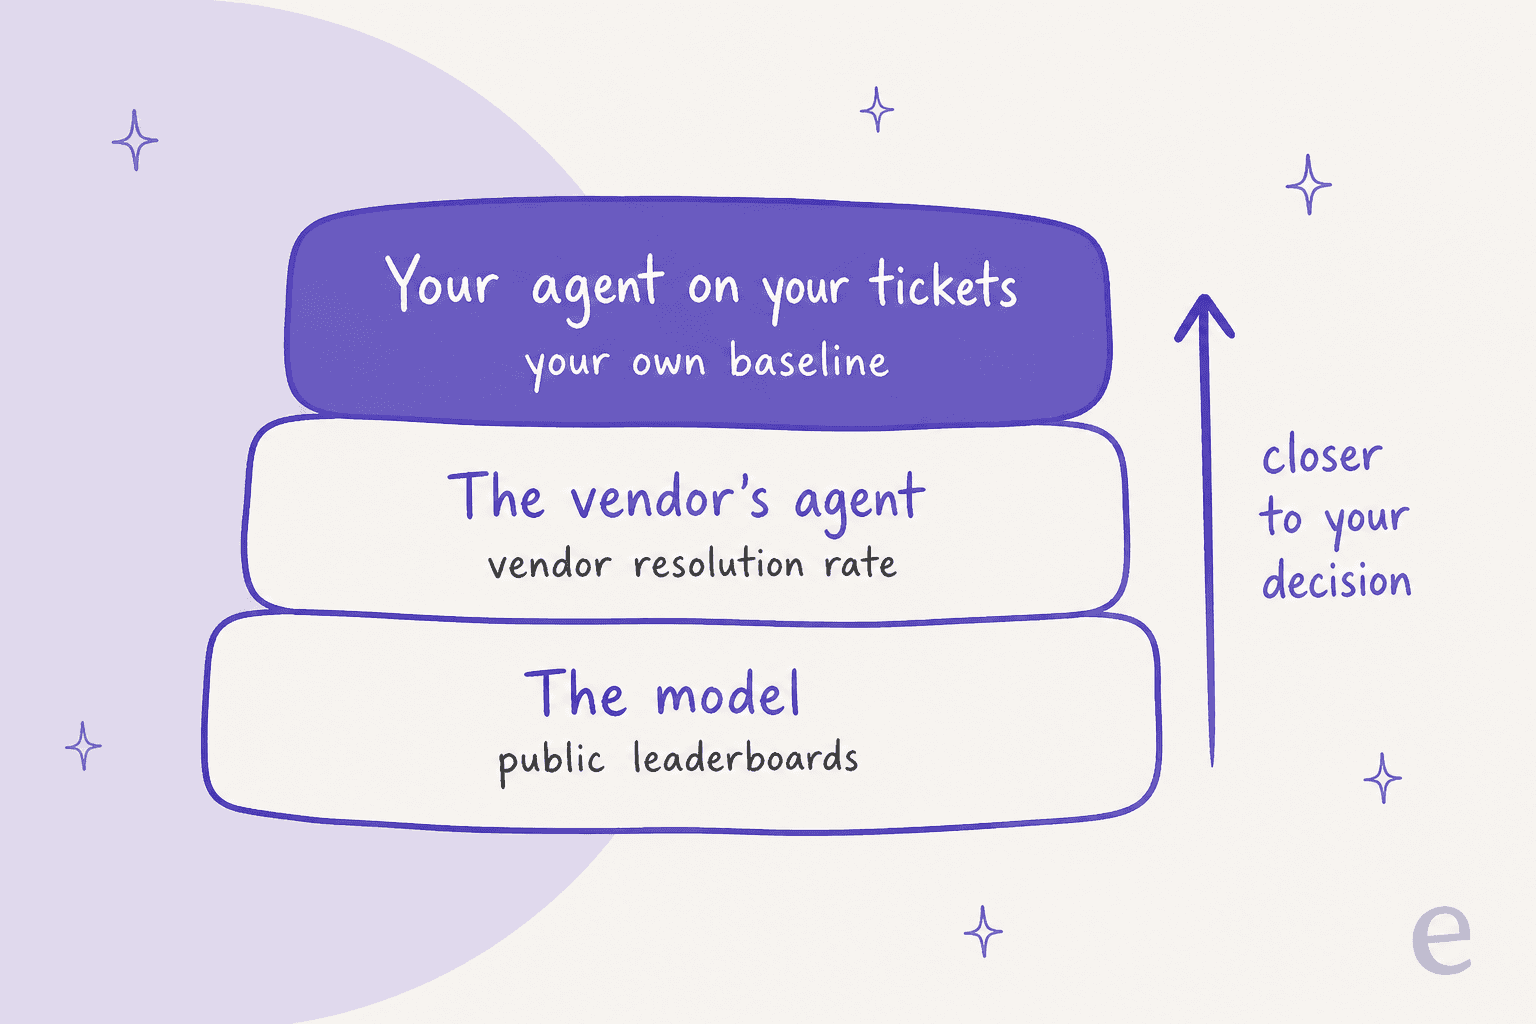
- Das Modell. Öffentliche Ranglisten wie tau-bench testen das zugrunde liegende große Sprachmodell anhand simulierter Support-Aufgaben. Nützlich für die Modellauswahl, aber ohne Aussage zu Ihrer Wissensdatenbank.
- Der Agent des Anbieters. Die Lösungsquote, die Ihr Helpdesk anzeigt, oder der Durchschnitt, den ein Anbieter auf seine Startseite stellt. Jede davon wird vom jeweiligen Anbieter für dessen Abrechnung definiert.
- Ihr Agent auf Ihren Tickets. Ihre Konfiguration, Ihre Dokumentation, Ihre Richtlinien, bewertet im Vergleich dazu, wie Ihr eigenes Team dieselben Fragen bearbeitet hat. Diese Ebene sagt Ihnen, ob Sie den Aufgabenbereich der KI erweitern sollten.
Jede Ebene liegt näher an der Entscheidung, die Sie tatsächlich treffen müssen. Im Rest dieses Beitrags gehe ich alle drei durch, denn der häufigste Fehler, den ich sehe, ist ein Team, das Zahlen der zweiten Ebene zitiert, als gehörten sie zur dritten.
Warum können Sie die Lösungsquoten der Anbieter nicht vergleichen?
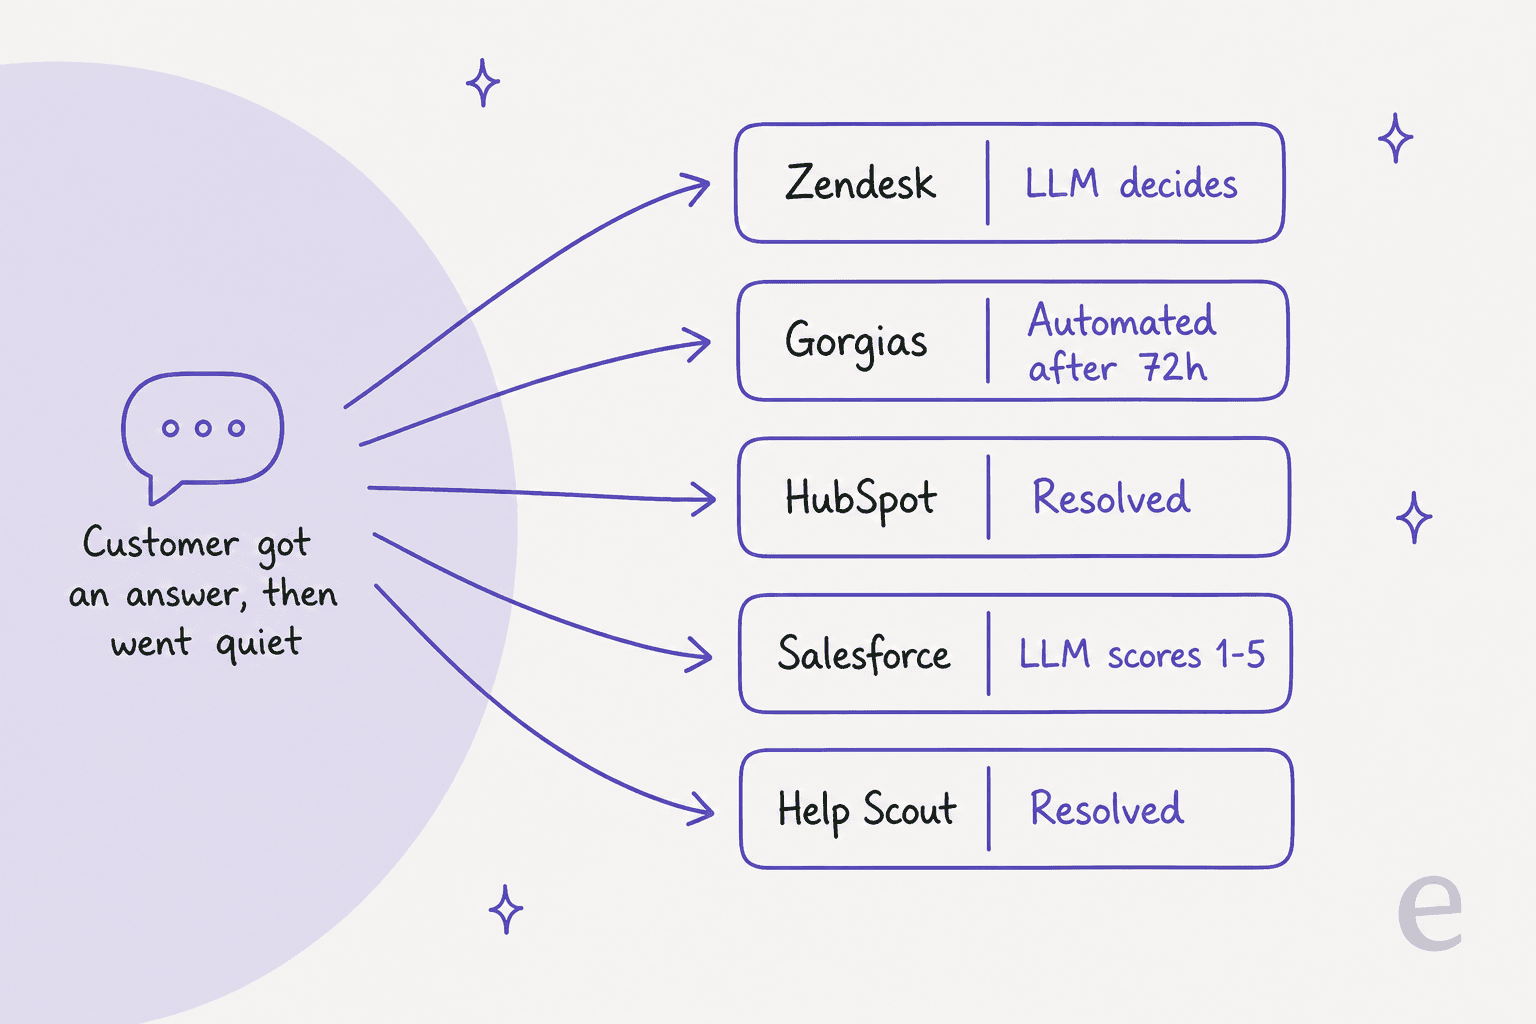
Weil jeder Anbieter eine Lösung anhand eines anderen Tests zählt und die meisten anhand desselben Tests abrechnen. Ich habe diese Woche die Hilfedokumentation jedes Anbieters durchgesehen, und keine zwei sind sich darüber einig, was „gelöst“ bedeutet.
| Anbieter | Was als gelöst zählt | Zeitfenster | Wird danach abgerechnet? | Preis pro Einheit |
|---|---|---|---|---|
| Zendesk | Die KI hat geantwortet, der Kunde hat nichts Weiteres angefragt, und ein LLM bestätigt, dass die Anfrage zufriedenstellend gelöst wurde. Prüfung nicht bestanden = "Contained", nicht abgerechnet | 72h für E-Mail, standardmäßig 2h für Messaging (bis zu 72h), ab der ersten Nachricht gezählt | Ja | $1.50 bei verbindlicher Abnahme, $2.00 bei nutzungsabhängiger Zahlung |
| Gorgias | Vollständig durch KI oder Automatisierung bearbeitet, innerhalb von 72 Stunden kein Mensch erforderlich | 72h | Ja, zuzüglich Ticketgebühr | $1.50 für Mehrverbrauch laut Preisseite |
| HubSpot | Der Agent hat mit einer Inhaltsquelle oder Aktion geantwortet und es gab keine vom Besucher eingeleitete Übergabe, oder ein Lead wurde als qualifiziert, teilweise qualifiziert oder nicht qualifiziert markiert | 72h nach der letzten Besuchernachricht | Ja | $0.50 (50 Credits) |
| Freshdesk Freddy | Berichterstattung: ohne menschliches Eingreifen geschlossen. Die Abrechnung erfolgt pro Sitzung, unabhängig vom Ergebnis | 24h Chat, 72h E-Mail pro Sitzung | Nein, Abrechnung pro Sitzung | $49 pro 100 Sitzungen |
| Salesforce Agentforce | "Deflected", wenn ein LLM die Sitzung mit 4 oder 5 bewertet, was "mostly or fully resolved" bedeutet | 2h Zeitlimit bis zum Abbruch | Nein, Abrechnung pro Konversation | $2 pro Konversation |
| Help Scout | Die KI hat geantwortet und der Kunde hat danach nicht um weitere Hilfe gebeten | Nicht dokumentiert | Ja | $0.75 |
Drei Unterschiede sind wichtiger als die übrigen.
Wer entscheidet, ob es funktioniert hat. Zendesk und Salesforce lassen ein LLM das Gesprächsprotokoll bewerten. Gorgias, HubSpot und Help Scout zählen die Abwesenheit eines Menschen: Niemand hat nach einer Person gefragt, also zählt es. Das sind unterschiedliche Fragen. „Hat der Kunde bekommen, was er brauchte?“ und „Hat der Kunde still aufgegeben?“ sehen in einer Kennzahl, die nur auf Schweigen prüft, identisch aus.
Was eine Lösung verhindert. Laut HubSpots eigener Dokumentation zählen nur vom Besucher eingeleitete Übergaben dagegen. Dort steht außerdem, dass spätere Ereignisse wie "messages from a live agent, a transfer request, or negative feedback, will not change the resolution status". Ein Workflow, der ein Ticket nach der Antwort des Agenten an eine Person weiterleitet, macht die Lösung nicht rückgängig.
Was der Nenner ist. Gorgias meldet zwei ähnlich klingende Zahlen: eine Erfolgsquote für die von der KI bearbeiteten Tickets und eine Automatisierungsquote für Ihr gesamtes abrechenbares Arbeitsaufkommen. Derselbe Monat, dieselben Tickets, zwei sehr unterschiedliche Prozentsätze.
So sieht das bei einer gewöhnlichen Konversation aus: Der Agent antwortet, und der Kunde schreibt nie zurück.
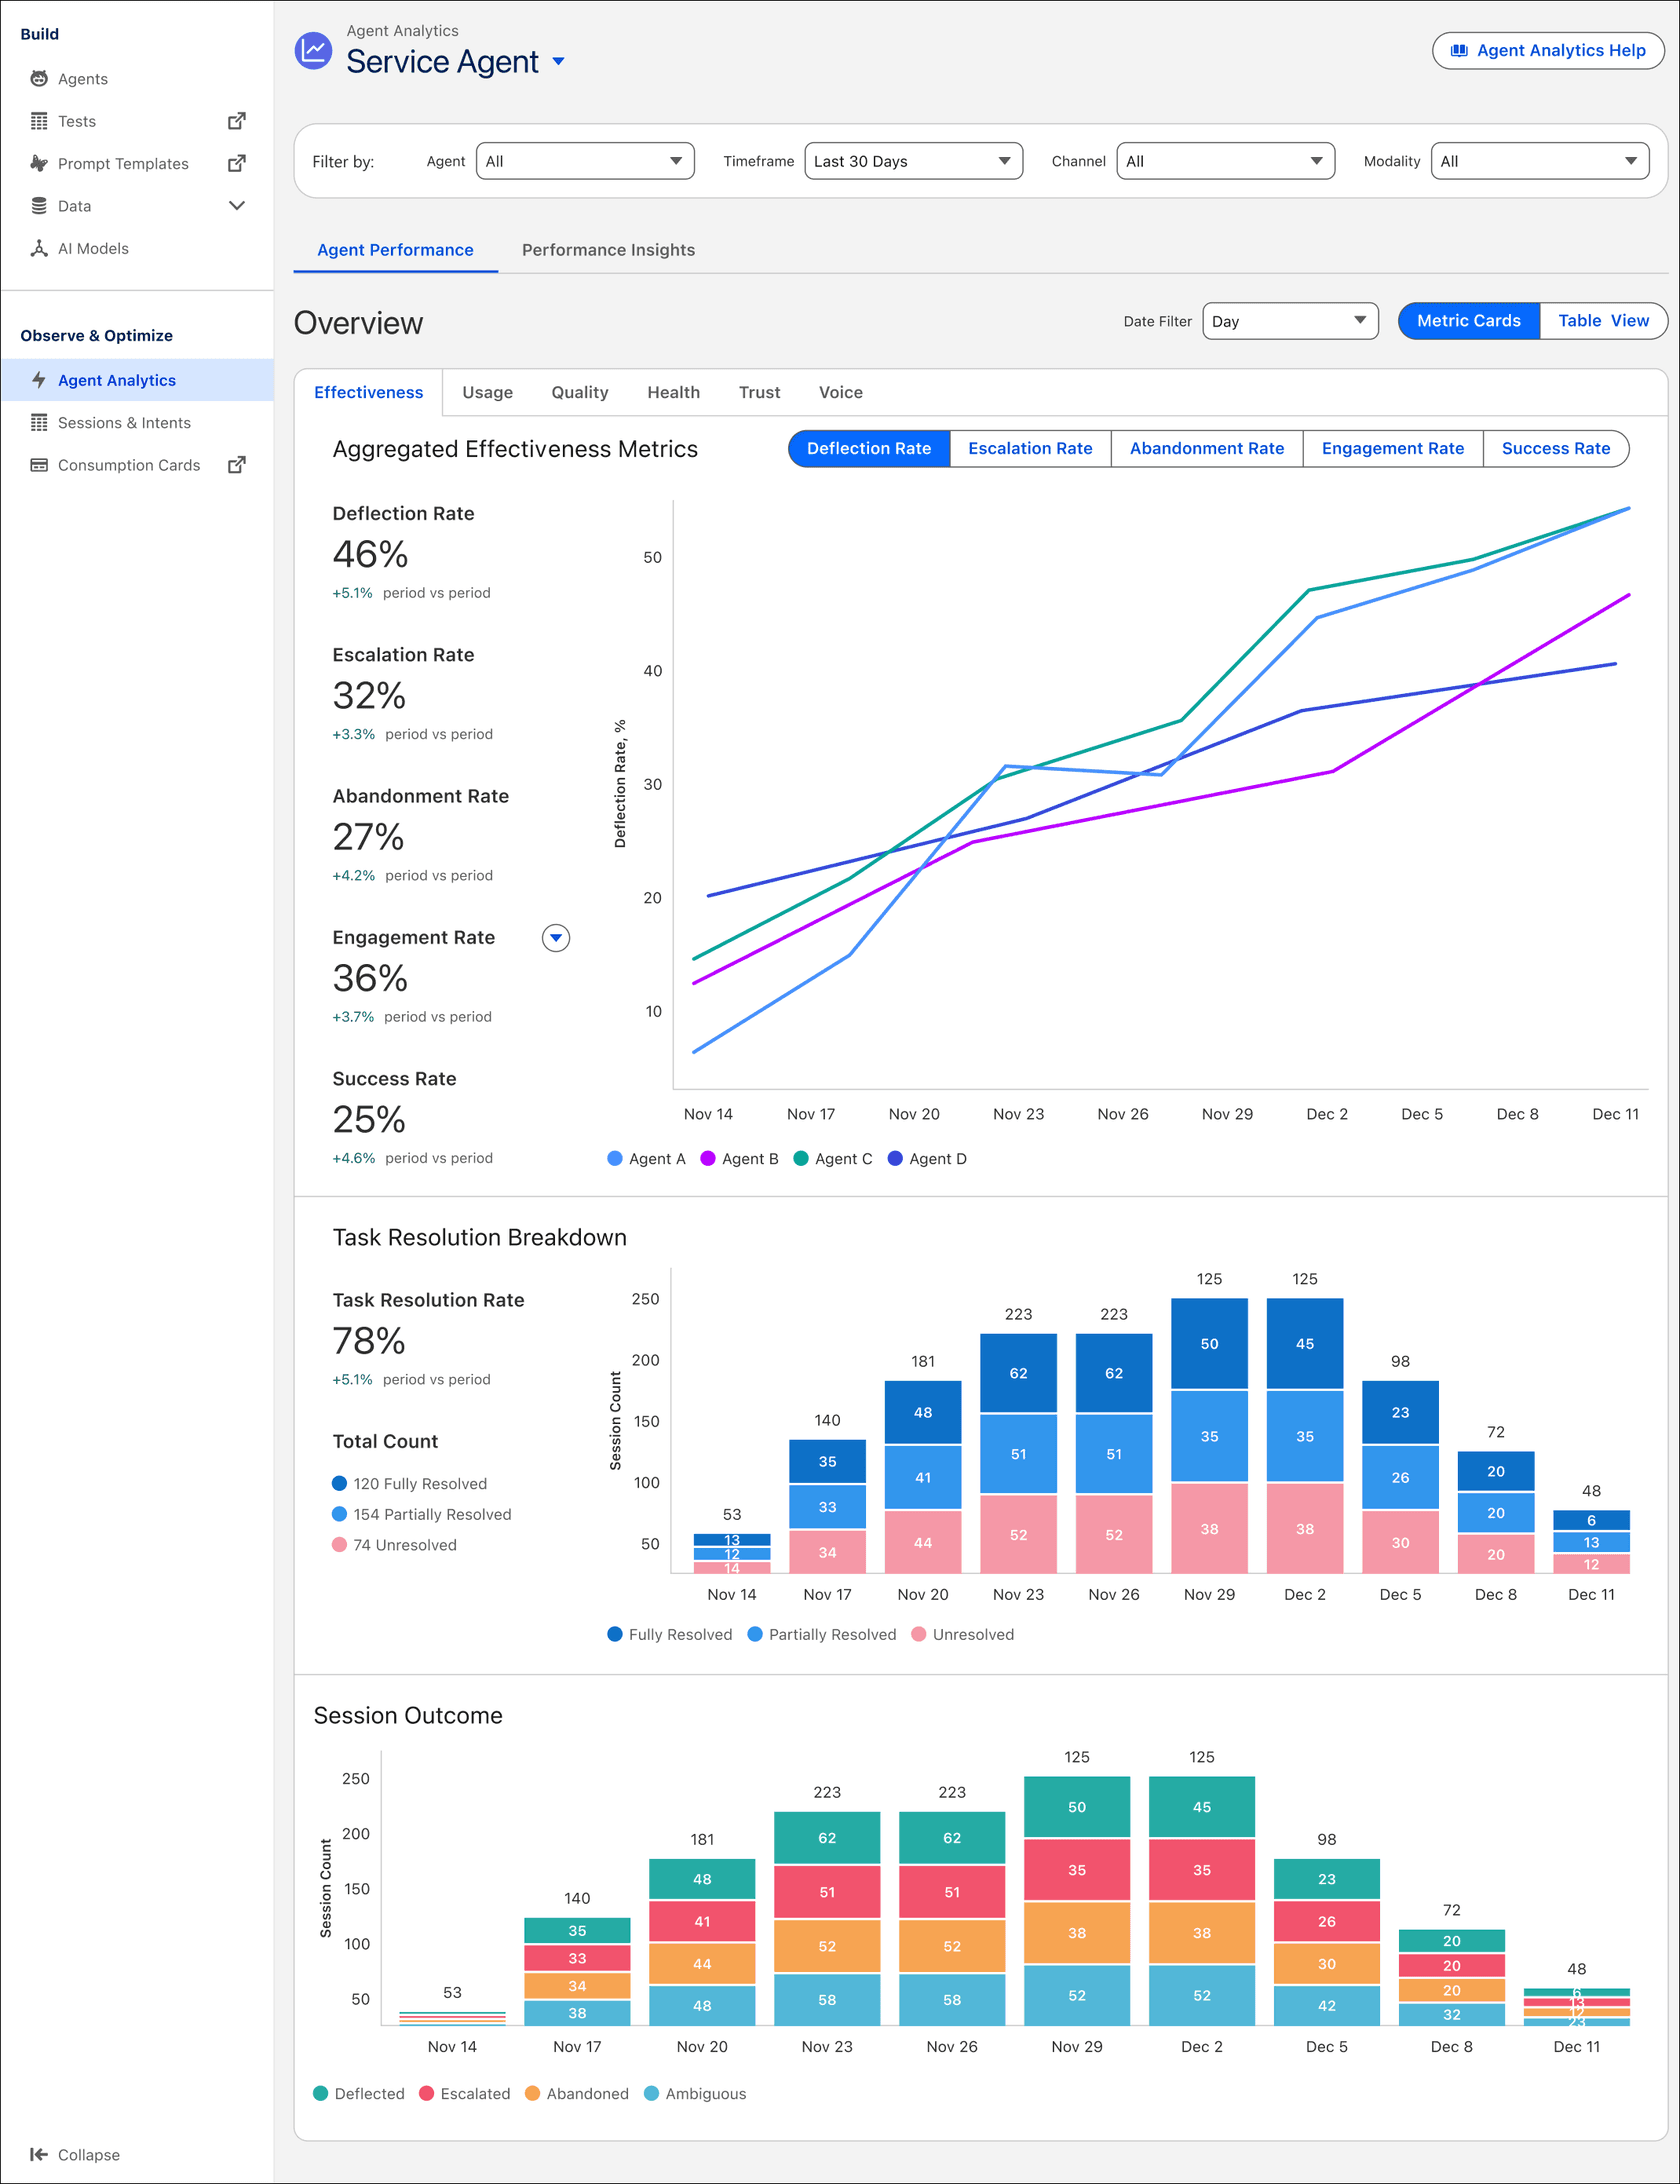
Selbst innerhalb eines Produkts verändert sich die Zahl mit der gewählten Kennzahl. Das eigene Beispiel-Dashboard von Salesforce für Agent Analytics zeigt für dieselben Sitzungen eine Abfangquote von 46 %, eine Erfolgsquote von 25 % und eine Aufgabenlösungsquote von 78 %.
Nichts davon macht die Anbieter unehrlich. Jede Definition ist dokumentiert, und Zendesk warnt im eigenen Blog, dass "different tools may classify 'resolved' in different ways". Es bedeutet nur, dass eine Aussage auf der Startseite wie HubSpots 65 % der Konversationen über 8.000+ Kunden hinweg eine Zahl nach HubSpot-Definition ist. Sie ist kein Maßstab, an dem Sie Ihren Zendesk- oder Gorgias-Agenten messen können.
Für ausführlichere Definitionen beginnen Sie mit meinem Beitrag über Abfangquote und Lösungsquote im Vergleich. Zendesk-Nutzer können mit den Kennzahlen für Zendesk-KI-Agenten tiefer einsteigen, und die Preisseite behandle ich unter Kosten pro Lösung.
"For comparing vendors, the only fair test I know is to run them on the same slice of your own traffic and score it with your own definition. Their published numbers mostly just tell you which definition they chose."

Was sagen Ihnen öffentliche Benchmarks wie tau-bench?
Sie sagen Ihnen, welche Modelle Support-ähnliche Aufgaben gut bewältigen, und noch hilfreicher: wie oft sie dieselbe Aufgabe zweimal richtig lösen. Sierras tau-bench stellt einem Modell einen simulierten Kunden, echte Tools und ein Richtliniendokument gegenüber und prüft dann laut tau-bench-Paper "the database state at the end of a conversation" gegen den korrekten Zustand. Es bewertet nicht, wie freundlich die Antwort klang. Es bewertet, ob die Erstattung tatsächlich durchgeführt wurde und ob sie hätte durchgeführt werden sollen.
Die Idee, die Sie für Ihren eigenen Benchmark übernehmen sollten, ist pass^k. Die Autoren des Papers definieren es als "the chance that all k i.i.d. task trials are successful": Führen Sie dieselbe Aufgabe k-mal mit einem Kunden aus, der sie jedes Mal anders formuliert, und zählen Sie sie nur, wenn jeder Durchlauf erfolgreich ist. Im ursprünglichen Paper löste der beste Agent über 60 % der Einzelhandelsaufgaben einmal erfolgreich, aber unter 25 %, wenn er dieselbe Aufgabe achtmal lösen musste.
Die aktuelle Rangliste erzählt dieselbe Geschichte. Ich habe alle Einreichungen aus Sierras öffentlichem Ergebnis-Bucket abgerufen:
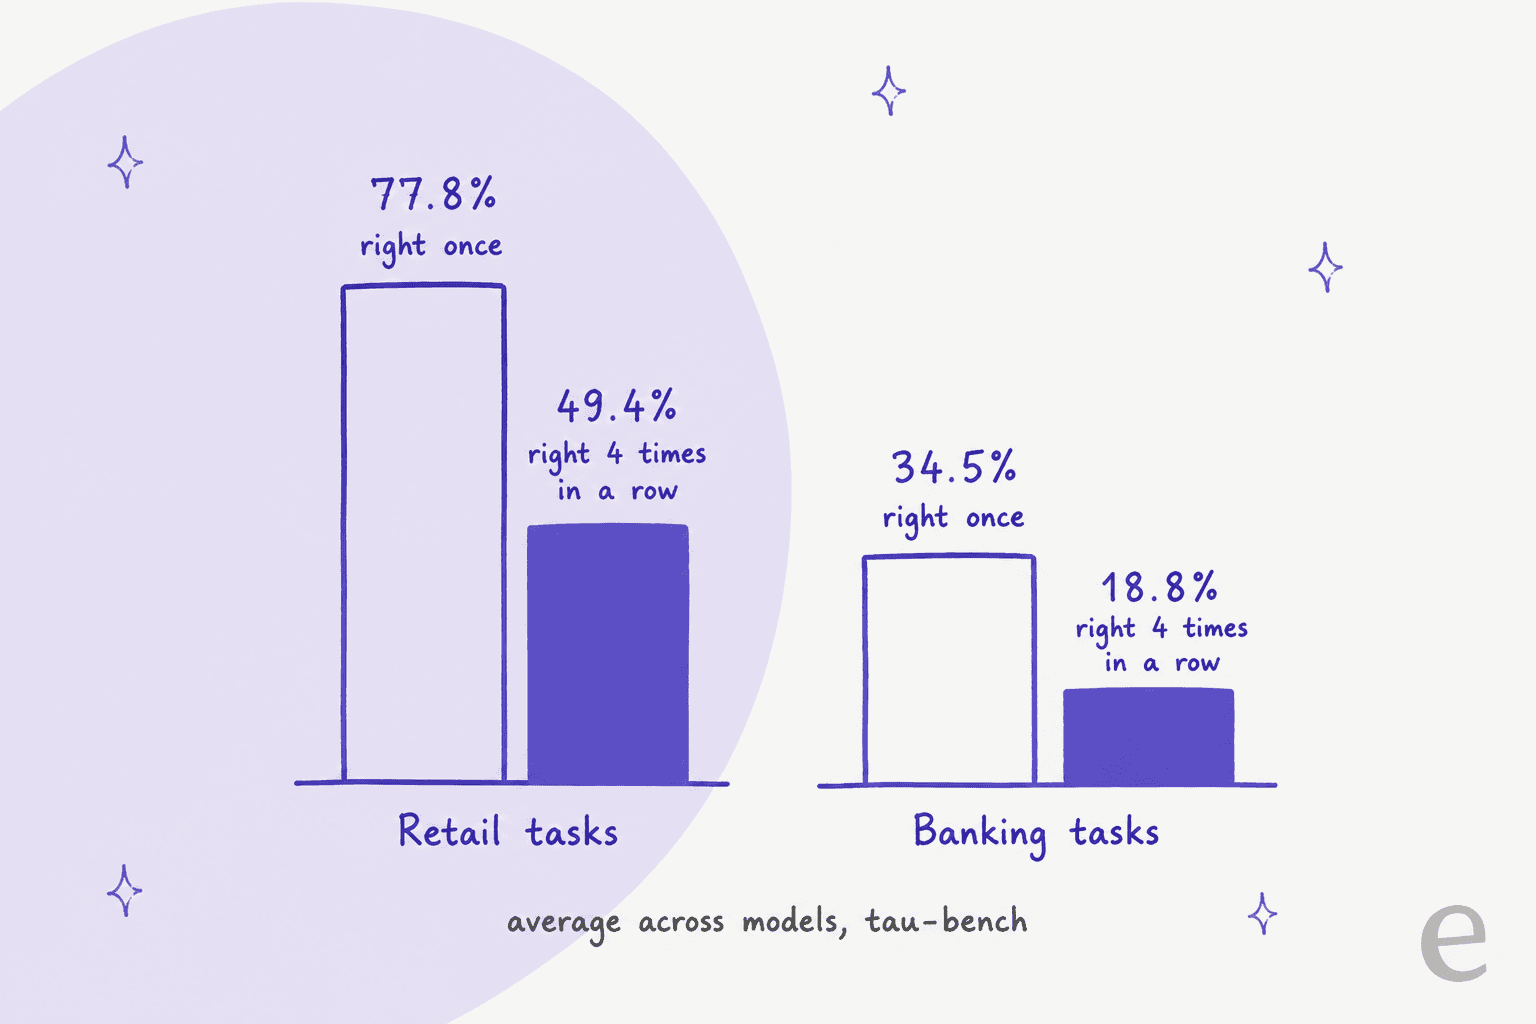
Banking ist der schwierigere Test, weil die Antwort in 698 Richtliniendokumenten statt in einem Tool steckt und die Aufgaben laut tau-Knowledge-Bericht durchschnittlich 18.6 Dokumente und 9.5 Tool-Aufrufe benötigen. So sieht es in den meisten echten Helpdesks aus: Die Antwort steht irgendwo in Ihrer Dokumentation. Das dort beste Textmodell, Qwen 3.8 Max, erreicht 55.2 bei einem Durchlauf und 35.1 über vier Durchläufe.
Wenn Sie einen breiteren Überblick möchten, veröffentlicht Fireworks einen Customer Support Index, der fünf Benchmarks nebeneinanderstellt, statt sie zu einer einzigen Bewertung zu vermischen:
| Benchmark (Verantwortlicher) | Was getestet wird | Bewertung | Führendes Modell (November 2026) |
|---|---|---|---|
| τ³-Banking (Sierra) | Richtliniengebundene Bankanfragen mit Tools und einem simulierten Nutzer | Durchschnittliche Belohnung pro Versuch | Gemini 4 Argon 58.25%, Claude Opus 5.5 56.01% |
| Cresta-Bench (Cresta) | 181 simulierte Anrufe über 4 Contact-Center-Agenten | pass^3, "a case counts only when all three runs pass" | Claude Opus 5.5 82.57%, Claude Haiku 5.5 als Letzter mit 20.05% |
| DuetBench-Diagnosis (Decagon) | Erneut durchgespielte echte Diagnosegespräche, verblindete Bewertung | Elo-Wertung | Claude Opus 5 1034.9 |
| τ³-Voice (Sierra) | Vollduplex-Sprachagenten | Pass@1 | Pine Voice 1.0 87.33% |
| vCX (Retell AI) | Sprachagenten, die Anweisungen befolgen und Tools aufrufen | Punktzahl | GPT-6.1 Sol 93.4% |
Zwei Einschränkungen, bevor Sie sich darauf stützen. Erstens wurden 27 der 29 Texteinreichungen auf tau-bench von Sierra selbst durchgeführt. Es handelt sich also um die Testumgebung eines einzelnen Labors, nicht um einen unabhängigen Wettbewerb. Zweitens, und wichtiger: Keiner dieser Tests weiß etwas über Ihre Rückgaberichtlinie, Ihre Makros oder die drei Hilfeartikel, die sich gegenseitig widersprechen. Eine Modellrangliste ist keine Rangliste fertiger Support-Agenten. Nutzen Sie diese Tests, um Modelle in die engere Wahl zu nehmen, und testen Sie dann Ihre Konfiguration. Auf die Modellauswahl gehe ich in meiner Übersicht zu Support-Modellen näher ein.
Wie benchmarken Sie Ihren KI-Agenten im Vergleich zu Ihrem menschlichen Team?
Sie bewerten beide anhand derselben Ticketarten, mit demselben Bewertungsraster und innerhalb desselben Zeitfensters. Die Falle ist der reine Durchschnitt: Die KI bekommt Passwortzurücksetzungen und Bestellstatusfragen, Ihr Team bekommt die verärgerten Kunden mit strittigen Erstattungen. Am Ende sieht die KI schneller und besser aus, weil ihre Tickets einfacher waren.
So würde ich vorgehen, und diese Methode würde ich jedem Team an die Hand geben, das gerade anfängt.
- Wählen Sie eine Definition von „gelöst“ und schreiben Sie sie auf. Mein Standard: Das Problem des Kunden wurde behoben, nichts widersprach den Richtlinien, und der Kunde meldete sich innerhalb von 7 Tagen nicht erneut wegen desselben Problems. Das ist strenger als jede Zeile in der Anbietertabelle oben, und so sollte es sein.
- Teilen Sie Ihre Tickets zuerst nach Themen auf. Erstattungen, Bestellstatus, Anleitungen, Abrechnung, Fehler. Benchmarken Sie pro Thema, niemals als eine vermischte Gesamtzahl. 90 % bei Anleitungsfragen und 40 % bei Erstattungen ergeben einen bedeutungslosen Durchschnitt.
- Spielen Sie gelöste Tickets erneut durch, bevor Sie sich Live-Daten ansehen. Nehmen Sie Tickets, die Ihr Team bereits geschlossen hat, lassen Sie den Agenten darauf antworten, ohne etwas zu versenden, und vergleichen Sie jede Antwort mit dem, was Ihr Team tatsächlich geschrieben hat. Die Antwort Ihres Teams ist der Ausgangswert. Hier fangen Sie die schlimmsten Fehler ab, ohne das Wohlwollen Ihrer Kunden zu strapazieren. Mein Leitfaden für Simulationstests behandelt Bewertung und Stichprobengrößen.
- Bewerten Sie eine verblindete Stichprobe von Hand. Mischen Sie KI-Antworten und menschliche Antworten zu denselben Themen, verbergen Sie, welche von wem stammen, und bewerten Sie sie mit einem einheitlichen Raster: richtig, teilweise richtig, falsch, hätte übergeben werden sollen. Eine QA-Scorecard eignet sich dafür gut.
- Vergleichen Sie anschließend Live-Zahlen pro Thema im selben Zeitfenster. Wiederöffnungsquote, CSAT, Zeit bis zur Lösung und Kosten pro gelöstem Ticket, KI im Vergleich zum Menschen, Thema für Thema.
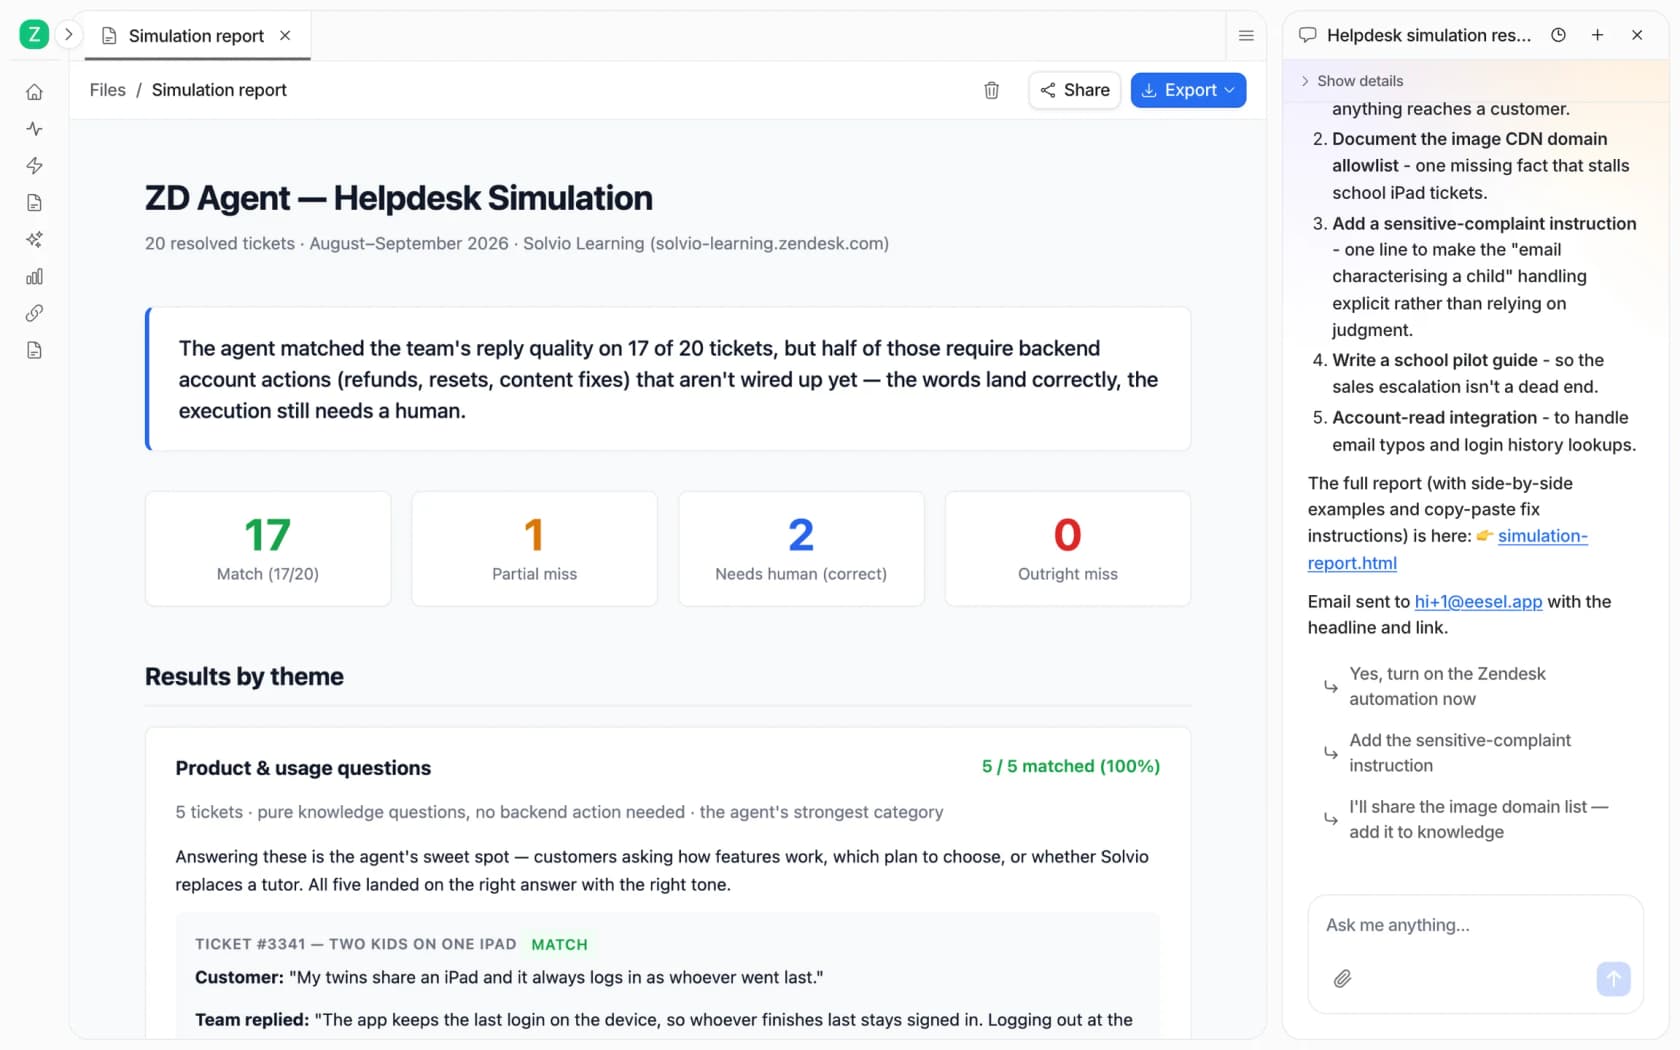
Schritt 4 ist wichtiger, als er aussieht. In einem Test mit echten Anfragen, den eesel für einen deutschen Online-Schmuckhändler auf Zendesk und Shopify durchführte, erreichte derselbe Agent 93% Triage-Genauigkeit, hatte eine sachliche Fehlerquote von 7%, und dennoch wurden nur 12% seiner Entwürfe unverändert versendet. Drei wahre Zahlen aus einem Test, die drei verschiedene Geschichten erzählen. Als ich mir die Überarbeitungen genauer ansah, bestanden etwa 65 % darin, dass das Team den Entwurf kürzte oder seinen Ton änderte. Das ist ein Stilproblem, kein Problem der Richtigkeit. Hätte ich nur anhand von „unverändert versendet“ gebenchmarkt, hätte ich einen überwiegend korrekten Agenten als Fehlschlag eingestuft.
Eine separate Stichprobe hat mir eine zweite Lektion erteilt: Testen Sie mit echten Tickets, nicht mit den Fragen, die Sie in einer Demo stellen würden. In einer von eesel geprüften Stichprobe von 434 Chats wurden KI-Chats insgesamt zu 86 % als gut bewertet, aber bei Chats aus echten Helpdesk-Tickets nur zu 79 %. Ihre eigenen Fragen sind immer einfacher als die Fragen Ihrer Kunden.
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eine CX-Führungskraft einer DTC-Marke für Nahrungsergänzungsmittel auf Gorgias und Shopify, in einem eesel-Vertriebsgespräch
Dieses Zitat ist der praktische Grund, nach Themen zu benchmarken. Sie können nicht alles prüfen. Die eigentliche Aufgabe des Benchmarks ist deshalb, Ihnen zu zeigen, welche Themen die KI eigenständig übernehmen kann und welche sie übergeben sollte.
Welche Zahlen gehören auf Ihre KI-Benchmark-Scorecard?
Weniger, als Ihr Dashboard Ihnen anzeigt. Ich würde fünf behalten, alle pro Thema gemessen und alle aus Ihren eigenen Daten berechnet statt aus dem Lösungsfeld des Anbieters.
| Kennzahl | Berechnung | Warum sie auf der Liste steht |
|---|---|---|
| Beteiligungsquote | Tickets, an denen die KI beteiligt war ÷ alle Tickets | Zeigt Ihnen, wie viel von der Warteschlange die KI überhaupt sieht |
| Containment-Quote | KI-Tickets ohne menschliche Antwort ÷ KI-Tickets | Ungefähr das, was die meisten Anbieter als Lösung bezeichnen. Nützlich, aber großzügig |
| Verifizierte Lösungsquote | Ohne menschliche Antwort bearbeitete Tickets, die innerhalb von 7 Tagen nicht zurückkamen und die QA bestanden haben ÷ KI-Tickets | Die ehrliche Version der Zahl darüber |
| Ende-zu-Ende-Automatisierungsquote | Verifizierte Lösungen ÷ alle Tickets | Die Zahl, die die Finanzabteilung interessiert |
| Erstkontaktlösung und CSAT sowie Kosten pro verifizierter Lösung, KI im Vergleich zum Menschen | Dieselbe Formel für beide, dieselben Themen, dasselbe Zeitfenster | Der tatsächliche direkte Vergleich |
Die Lücke zwischen Containment und verifizierter Lösung ist die nützlichste einzelne Zahl, die Sie berechnen werden. Ist sie klein, liegt die Anbieterzahl nahe genug an der Realität, um ihr zu vertrauen. Ist sie groß, schließt der Agent Tickets, die nicht wirklich erledigt sind. Ein Verantwortlicher auf Reddit musste das auf die harte Tour lernen:
"i track cost per resolution with a 48 hour window for reopens, automation rate alone is basically useless we had a period where our "automation rate" looked incredible but half those customers were just giving up and calling in later, the dashboard was lying to us"
Geben Sie hier Ihre eigenen Monatszahlen ein, um die Unterschiede zu sehen:
Mit den Standardwerten ergeben dieselben 6.000 KI-Tickets 70 % Containment und 52 % verifizierte Lösungen, und nur 31 % der gesamten Warteschlange sind tatsächlich automatisiert. Alle drei Zahlen sind ehrlich. Nur eine davon ist die Zahl, die Sie Ihrer Führungskraft vorlegen sollten. Für ein breiteres Kennzahlenset geht mein Leitfaden zu KI-Kundenservice-Kennzahlen weiter ins Detail. Der Beitrag zu Kundenservice-KPIs behandelt Zielwerte für Menschen, und Benchmarks für Kosten pro Ticket behandelt die menschliche Seite des Kostenvergleichs.
Wie sieht ein gutes Ergebnis in der Praxis aus?
Gut bedeutet: ein Anteil von Themen, den die KI vollständig übernimmt und der gezielt wächst, nicht eine große Prozentzahl am ersten Tag. Die Kundengeschichten von eesel zeigen das deutlicher, als es ein Durchschnitt je könnte, weil sie über die Aufteilung der Arbeit berichten statt über eine einzelne Quote.
- ClutchLoop, eine Marke für Smartphone-Zubehör auf Gorgias und Shopify, ließ in einem Monat etwa
180Antworten direkt an Kunden senden, "about seven in ten conversations, no person needed". - Question Beauty, eine Kosmetikmarke auf Gorgias, verzeichnete etwa
280von eesel geschlossene und etwa250einer Person zugewiesene Tickets bei insgesamt990bearbeiteten Tickets. - Bei SE Ranking auf Zendesk wurden von
4,650Konversationen2,100Live-Chats zuerst von eesel beantwortet. Das Unternehmen testet jetzt direkte E-Mail-Antworten auf Testtickets, die anhand der Betreffzeile ausgewählt wurden. Jeder Gesprächsverlauf wird als offen, gelöst, eskaliert oder bei einer Person markiert, und ein Verlauf zählt erst als gelöst, "once the customer says it worked". Das ist ein strengerer Test als bei jedem Anbieter in der Tabelle oben. - Cactus Club Cafe betreibt internen IT-Support auf Zendesk und hat den Regler in die entgegengesetzte Richtung gestellt:
790Antwortentwürfe für das Technikteam "against 51 sent directly". Für deren Tickets ist ein eingebundener Mensch das richtige Benchmark-Ziel.
"In the first month, eesel is resolving 73% of our tier 1 requests. eesel offers easy Zendesk implementation and setup. Our team implemented and achieved results quickly during our 7-day trial."

Beachten Sie den Geltungsbereich dieser Bewertung: Tier-1-Anfragen, nicht jedes Ticket. Genau so sollte ein Benchmark zitiert werden. Wenn Ihnen jemand eine Lösungsquote nennt, ohne zu sagen, welche Tickets sie umfasst und wie über „gelöst“ entschieden wurde, haben Sie noch keinen Benchmark. Wie Sie die Zahl nach der Messung verbessern können, erfahren Sie in meinem Leitfaden zur Verbesserung der Lösungsquote.
Was sind die häufigsten Fehler beim KI-Benchmarking?
Die meisten entstehen dadurch, dass man das leicht Messbare misst, weil das Dashboard es bereits anzeigt.
- Nur beantwortbare Fragen benchmarken. Wenn Ihr Testdatensatz nur Fragen enthält, die Ihre Dokumentation abdeckt, übersehen Sie den schlimmsten Fehler: Der Agent erfindet eine Antwort, wenn die Wissensdatenbank nichts hergibt. Fügen Sie Fragen hinzu, von denen Sie wissen, dass Sie sie nicht beantworten können, und prüfen Sie, ob er stattdessen übergibt. Mein Beitrag über KI-Halluzinationen im Support behandelt genau das.
- Abschlüsse statt Richtigkeit zählen. Auch eine falsche Antwort, die richtig klingt, wird als gelöst geschlossen.
"The hardest ones are wrong answers that sound right. Nothing errors, the customer doesn't push back, and the ticket can close as resolved. If a refund window changes and the agent is still working from the old policy text, the resolution rate won't flag it, because that metric only counts closures."
- Einem einzigen Durchlauf vertrauen. tau-bench zeigte, dass die Ergebnisse um etwa ein Drittel bis zur Hälfte fallen, wenn dieselbe Aufgabe viermal bestanden werden muss. Führen Sie Ihren Testdatensatz nach jeder Änderung an Anweisungen oder Dokumentation erneut aus und achten Sie auf Antworten, die sich ändern.
- Zu wenige Tickets pro Thema. 85 % bei 20 Tickets entsprechen einer Spanne von 64 % bis 95 %. Das ist ein erster Einblick, kein Urteil.
- Knifflige Eingaben auslassen. Kunden fügen Bestellnummern falsch ein, schreiben in zwei Sprachen und versuchen gelegentlich, den Bot zu einem Rabatt zu überreden. Adversariale Tests gehören in den Testdatensatz.
- Mit einem Anbieterdurchschnitt vergleichen. Der Durchschnitt eines Anbieters ergibt sich aus seinem eigenen Kundenmix und seiner eigenen Definition. Ihr Ausgangswert ist Ihr Team.
Wenn Sie noch ein Tool auswählen, integriert meine Checkliste zur Anbieterbewertung diese Art von Tickettest in den Kaufprozess. Dasselbe tut meine RFP-Vorlage, damit jeder Anbieter anhand derselben Tickets bewertet wird.
Benchmarken Sie Ihren KI-Agenten mit eesel
eesel ist ein KI-Teammitglied für den Helpdesk, das in Ihre bestehende Warteschlange einsteigt, ob in Zendesk oder einem anderen Helpdesk. Benchmarking gehört dabei von Anfang an dazu. Laut eesel-Dokumentation gilt für die Simulation: Sie "replays your real past tickets and compares its answers to what your team sent", bewertet anschließend die Ergebnisse nach Themen und schlägt Korrekturen an den Anweisungen vor.
Die Einführung folgt denselben Schritten wie die Methode oben: Beginnen Sie mit Entwürfen, lassen Sie eesel die einfachen Themen beantworten und schalten Sie weitere frei, sobald die Bewertungen es rechtfertigen. Das funktioniert genauso bei Warteschlangen in Freshdesk, und die Gorgias-Integration folgt demselben Einführungsablauf.
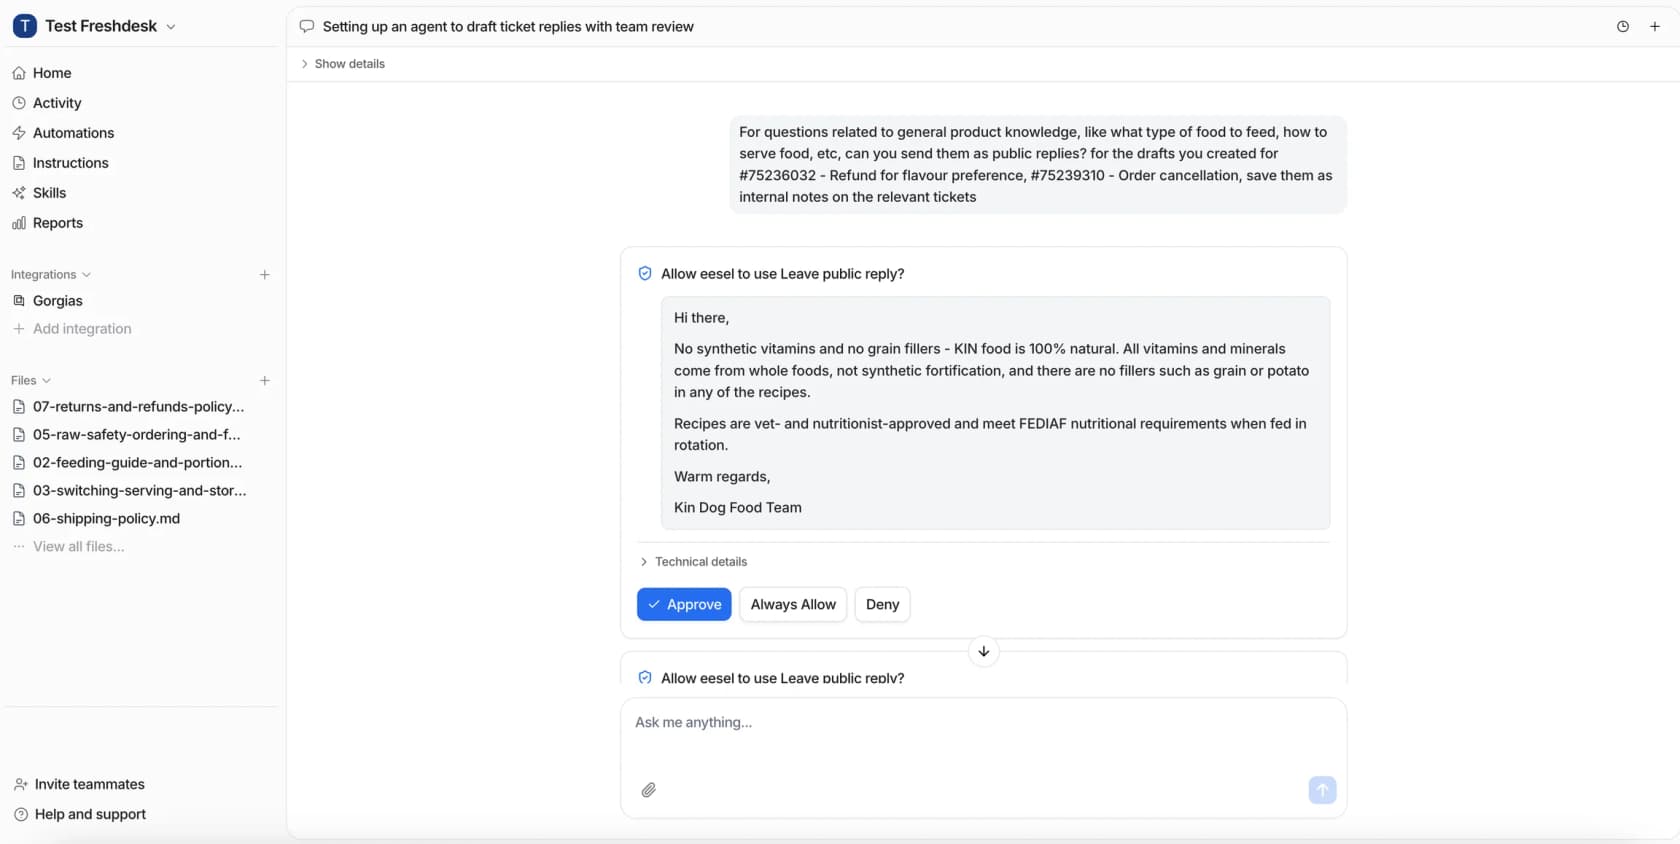
Wenn Sie Ihren eigenen Benchmark statt eines Anbieterdurchschnitts möchten, führen Sie eine Simulation mit den gelösten Tickets des letzten Monats durch und sehen Sie Thema für Thema, wo die KI mit Ihrem Team mithält. Kostenpflichtige Tarife beginnen bei 299 $ für 500 Credits, und ein Ticket oder Chat verbraucht einen Credit. Testen Sie eesel zuerst mit Ihren eigenen Tickets.