

KI-Support-Agent-Observability heißt, dass du jede Konversation öffnen kannst und siehst, was der Agent gelesen hat, welche Tools er aufgerufen hat und was sie zurückgaben, was er getan hat und warum er geschlossen oder übergeben hat. Dieser Trace zählt mehr als die Lösungsrate, denn die meisten Anbieter zählen "gelöst" einfach als: 72 Stunden lang ist niemand eingeschritten. Wenn du den Agenten selbst gebaut hast, liefern Tracing-Tools wie LangSmith oder Langfuse den Trace. Wenn du einen innerhalb deines Helpdesks gekauft hast, entscheiden die Logs des Anbieters, was du sehen kannst, also prüf das, bevor du unterschreibst. eesel zeigt bei jedem Lauf die Quellen, Aktionen und Begründungen und spielt vergangene Tickets durch, bevor es live geht. Mit der eesel CLI kann ein Coding-Agent ihr Testfragen schicken und ihre Aktivität im Terminal lesen.
Was bedeutet Observability für einen KI-Support-Agenten?
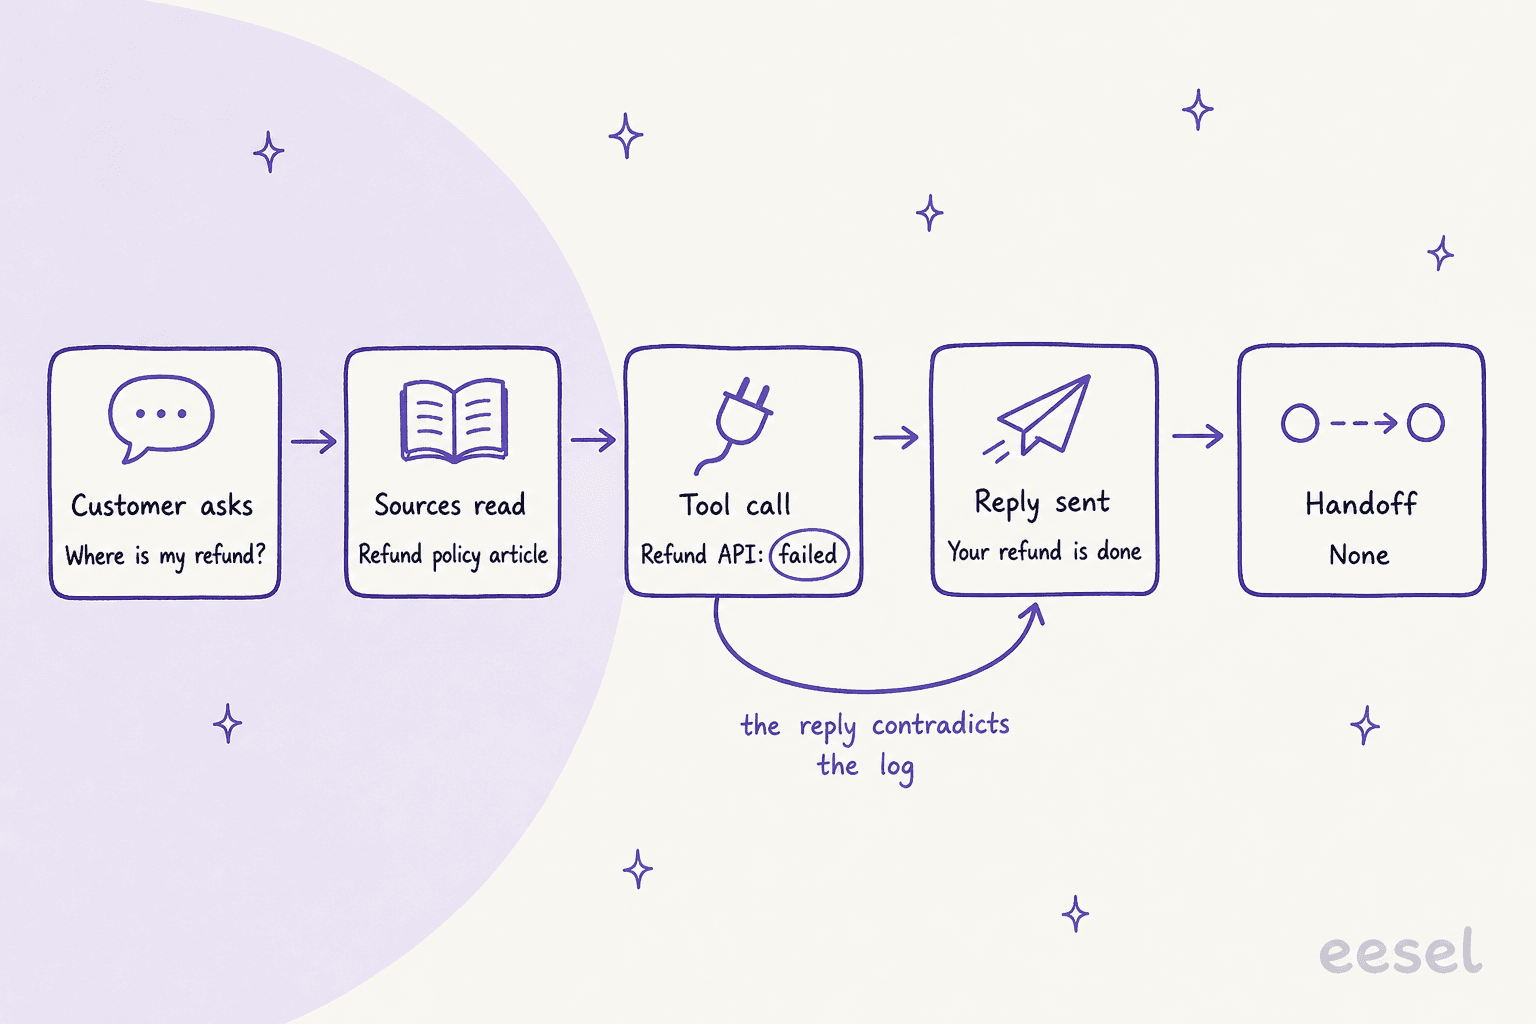
Ich baue Funktionen für eesels KI-Agenten, also verbringe ich die meiste Zeit meiner Woche damit, zu lesen, was ein Agent bei einem Ticket getan hat, und herauszufinden, warum. Die größte Lehre aus dieser Arbeit ist einfach: die Antwort des Agenten ist der am wenigsten verlässliche Beleg dafür, was passiert ist. Eine Antwort kann sagen "Ich habe deine Rückerstattung bearbeitet", obwohl der Rückerstattungsaufruf fehlgeschlagen ist. Sie kann eine Richtlinie zitieren, die der Agent nie tatsächlich gefunden hat. Der einzige Weg, es zu wissen, ist ein Blick auf die Schritte darunter.
Genau das bedeutet Observability hier. Nicht ein Dashboard mit einer Lösungsquote, sondern ein Protokoll pro Konversation, das du öffnen und wie eine Quittung lesen kannst. Entwickler nennen es einen Trace. Für einen Support-Agenten beantwortet ein nützlicher Trace sechs Fragen:
| Teil des Trace | Die Frage, die er beantwortet | Was ohne ihn schiefgeht |
|---|---|---|
| Die Nachricht des Kunden | Was wurde eigentlich gefragt? | Du bewertest die Antwort an der falschen Frage |
| Durchsuchte und genutzte Quellen | Auf welchen Artikel, welche Makro oder welches alte Ticket hat er sich gestützt? | Eine falsche Antwort wirkt wie ein Modellproblem, obwohl es ein Inhaltsproblem ist |
| Tool- und API-Aufrufe mit Ergebnissen | Hat die Bestellabfrage oder der Rückerstattungsaufruf funktioniert? | Die Antwort behauptet einen Erfolg, den das System nie bestätigt hat |
| Durchgeführte Aktionen | Was wurde geändert: Tags, Status, eine Rückerstattung, eine Antwort? | Nebenwirkungen passieren, ohne dass festgehalten wird, wer sie verursacht hat |
| Begründung | Warum hat er diesen Weg gewählt? | Du kannst eine schlechte Regel nicht von einem schlechten Rateversuch unterscheiden |
| Übergabe oder Abschluss | Warum hat er aufgehört, und war das richtig? | Späte Übergaben und stille Abschlüsse bleiben unsichtbar |
Die Tool-Aufruf-Zeile ist die, für die ich am härtesten kämpfen würde. Der schlimmste Fehler, den ich in eesels eigenen Produktionsdaten gesehen habe, ist keine falsche Antwort. Es ist ein Agent, der Arbeit beschreibt, die er nie erledigt hat, der Suchen erzählt, die er nie ausgeführt hat. Ein Entwickler auf Hacker News hat die allgemeine Regel treffend formuliert, nachdem ein Coding-Agent eine Produktionsdatenbank gelöscht hatte:
"you can't trust anything it says, including its apologies, excuses, and explanations of past failure."

Support-Agenten haben dieselbe Schwäche, weshalb der Trace festhalten muss, was die Systeme zurückgegeben haben, und nicht, was der Agent behauptet, dass sie zurückgegeben haben.
Dasselbe Protokoll fängt auch die leiseren Fehler. Anfang des Jahres erzählte ein B2B-Team für Fahrzeugtelematik auf einem Demo-Call bei Zendesk eesels Team, dass ihr Bot Support für Fahrzeugmodelle bestätigt hatte, die gar nicht in ihrer Datenbank standen. Die Wissensdatenbank sagte "wir unterstützen alle Modelle", also tat der Bot genau das, was seine Quelle ihm sagte. Ohne die Quelle im Trace sieht das aus, als würde die KI sich Dinge ausdenken. Mit ihr ist die Lösung ein Satz in einem Artikel. Dieses Muster hat einen Namen, KI-Halluzination, und das übliche Mittel dagegen ist bessere KI-Grounding in Quellen, die du kontrollierst.
Warum ist die Lösungsrate nicht dasselbe wie Genauigkeit?
Weil jeder Anbieter "gelöst" als etwas definiert, das sich automatisch messen lässt, und Genauigkeit lässt sich nicht automatisch messen. Eine Lösung bedeutet meist, dass innerhalb eines Zeitfensters niemand nach einem Menschen gefragt hat. Ein Kunde, der eine falsche Antwort bekam und aufgab, besteht diesen Test genauso gut wie einer, der die richtige Antwort bekam.
Ein Reddit-Thread über das Messen von KI-Support hat das Problem besser dargelegt als jede Anbieterseite, die ich gelesen habe:
"Like if a ticket is "deflected", it could mean: customer got the right answer, customer just gave up, customer came back later through another channel, bot gave a wrong answer confidently, bot should have escalated but didn't."

So zählen es die vier großen Helpdesk-KI-Agenten, direkt aus ihrer eigenen Dokumentation. Das zählt doppelt, denn bei drei von ihnen ist die Definition auch das, wofür du bezahlst.
| Anbieter | Was als Erfolg zählt | Abrechnungseinheit | Die Lücke, die man kennen sollte |
|---|---|---|---|
| Zendesk AI agents | Eine verifizierte Lösung: Nach Ende der Konversation liest ein LLM sie und bestätigt, dass die Anfrage gelöst wurde | 1,50 $ verpflichtend, 2,00 $ pay-as-you-go pro Lösung | Die Prüfung selbst ist das Urteil einer KI über das Transkript |
| HubSpot Customer Agent | Eine Quelle geteilt oder eine Aktion ausgeführt, und keine vom Besucher ausgelöste Übergabe innerhalb von 72 Stunden | 0,50 $ pro gelöster Konversation, 50 HubSpot Credits | Eine manuelle oder Workflow-Zuweisung blockiert keine Lösung, also kann eine Konversation unter Human handoffs auftauchen und trotzdem als gelöst zählen |
| Gorgias AI Agent | Eine automatisierte Interaktion: keine menschliche Beteiligung innerhalb von 72 Stunden | Ticketgebühr plus eine Automatisierungsgebühr, wenn der Agent ohne Übergabe löst | Ein Kunde, der einfach nicht mehr antwortet, zählt genauso wie ein zufriedener |
| Freshdesk Freddy AI Agent | Deflection Rate: "von der KI ohne menschliches Eingreifen gelöst" | 49 $ pro 100 Sessions, egal wie es ausgeht | Die Tabs Performance und Improve decken nur Chat-Agenten ab; E-Mail-Agenten bekommen Ticket-Logs |
Keine dieser Definitionen ist falsch. Sie beantworten nur "musste ein Mensch eingreifen?", nicht "war die Antwort richtig?". Freshworks selbst ist dabei offen über Schwellenwerte: Die Dokumentation sagt, eine Deflection Rate unter 60 % bei einem Thema mit hohem Volumen sei ein Warnsignal. Mehr zum Unterschied in meinem Artikel zu Deflection vs. Lösungsrate, und der Eintrag zur Containment Rate definiert den dritten Verwandten.
Der praktische Schritt ist, die eigene Definition im eigenen Helpdesk sichtbar zu machen. SE Ranking hat genau das getan. Als eesel für drei Produkte in den Zendesk-Live-Chat integriert wurde, bat das Team um einen ai_handled-Tag auf jedem Ticket, das eesel berührt, plus Tags für hilfreich und nicht hilfreich aus der Frage "War diese Antwort hilfreich?", damit die Containment-Zahl in Zendesk gezählt wird und nicht geschätzt werden muss. Über einen Monat waren das rund 4.650 Konversationen. Das ist eine Zahl, die sie prüfen können, denn jedes getaggte Ticket ist nur einen Klick entfernt.
Hast du deinen KI-Support-Agenten gebaut oder gekauft?
Das ist die Frage, die entscheidet, welche Tools überhaupt passen, und es ist die, die die meisten Observability-Ratschläge überspringen. Frag ChatGPT, wie man einen KI-Support-Agenten überwacht, und du bekommst eine Liste von Entwickler-Tracing-Plattformen. Sie sind ausgezeichnet, und sie sind weitgehend irrelevant, wenn dein Agent in Zendesk lebt.
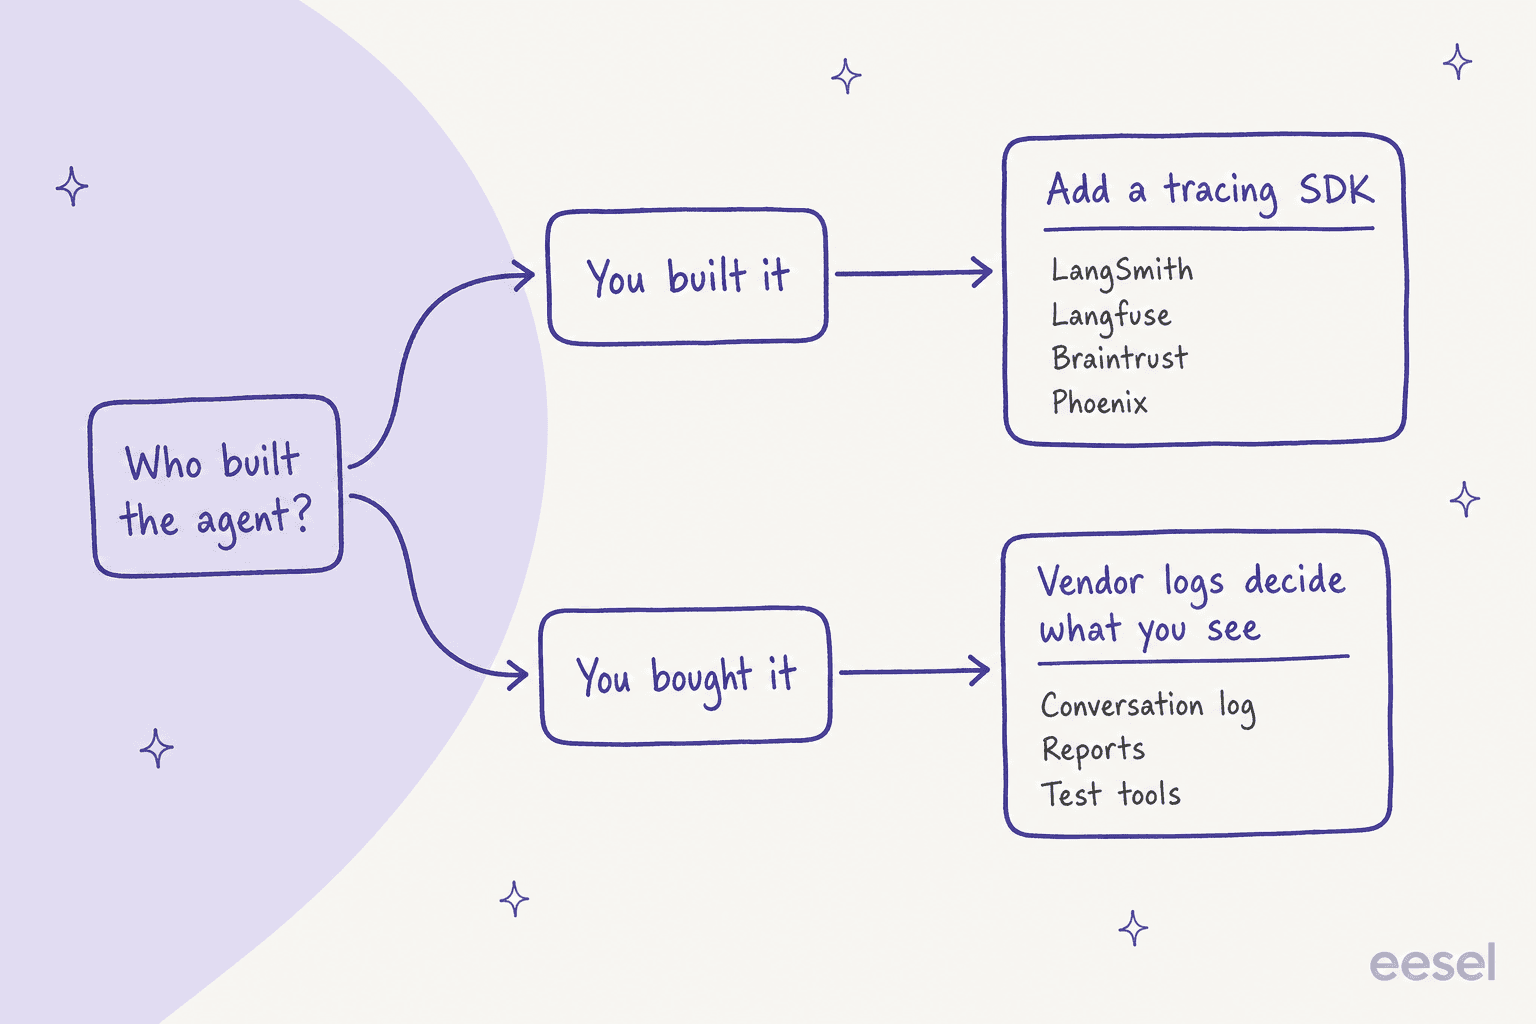
Wenn du ihn gebaut hast, ist eine Tracing-Plattform die richtige Wahl. Jede von ihnen funktioniert im Kern gleich: Du fügst ihr SDK oder einen OpenTelemetry-Exporter in den Code deines Agenten ein, und jeder Modellaufruf, jede Retrieval- und jede Tool-Nutzung wird zu einem Span mit Eingaben, Ausgaben, Latenz und Kosten. Hier, was jedes Tool laut eigener Seite bietet:
| Tool | Wie es Traces sammelt | KI-Bewertung von Live-Traffic | Self-Host | Free-Tier | Erster kostenpflichtiger Plan |
|---|---|---|---|---|---|
| LangSmith | SDKs, @traceable, OpenTelemetry | Ja, gefiltert und gesampelt, kann ganze Threads bewerten | Enterprise-Add-on | 1 Seat, 5.000 Traces/Monat | Plus, 39 $ pro Seat/Monat |
| Langfuse | SDKs, OpenAI-Wrapper, OpenTelemetry | Ja, pro Schritt, gefiltert und gesampelt | Ja, Open Source | 50.000 Units/Monat | Core, 29 $/Monat |
| Braintrust | SDKs, API, OpenTelemetry | Ja, "Online Scoring" | Data Plane im Enterprise-Plan | 1 GB, 10.000 Scores | Pro, 249 $/Monat |
| Arize Phoenix | OpenTelemetry, Auto-Instrumentierung | Dokumentation verweist auf das kostenpflichtige Arize AX | Ja, Elastic License 2.0 | Kostenlos zum Self-Hosten | Arize AX Pro, 50 $/Monat |
Wenn du ihn gekauft hast, kann keines davon hineinsehen. Ein gehosteter Helpdesk-Agent gibt dir nicht seinen Code oder einen OpenTelemetry-Stream, also ist das, was du beobachten kannst, genau das, was der Anbieter in sein Conversation Log, seine Reports und seine Testtools gepackt hat. Das macht das Log zu einem Kaufkriterium, nicht zu einer Nebensache. Ich würde "zeig mir den Trace für eine Konversation, in der der Agent eine API aufgerufen hat" in jede Demo einbauen. Mitten in der Evaluierung? Meine Checkliste zur Anbieterbewertung deckt den Rest ab.
Was kannst du im KI-Agenten deines Helpdesks sehen?
Mehr, als du bei manchen erwartest, weniger, als du dir bei anderen wünschst, und die Lücken stecken selten im Marketing. Hier, was die Dokumentation jedes Anbieters heute sagt, dass du öffnen kannst.
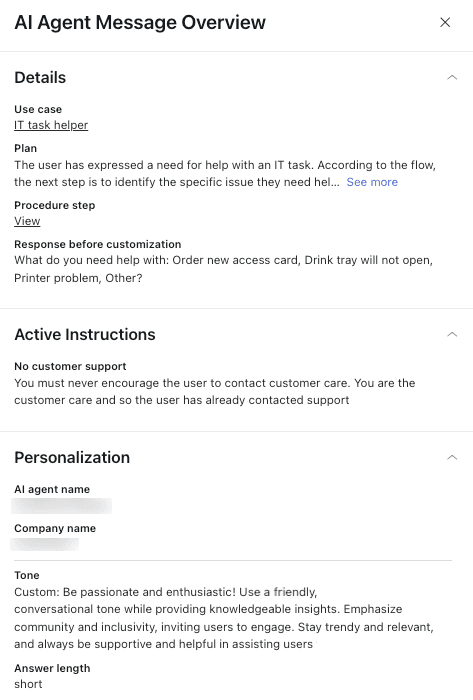
Zendesk hat das detaillierteste Log der vier. In den Conversation Logs zeigt eine generative Antwort den Plan des Agenten (seine Begründung), den Verfahrensschritt und die aktiven Anweisungen. API-Aufrufe öffnen ein Integration-Details-Panel mit Eingaben, Ausgaben und etwaigen API-Fehlern, fehlende Werte sind rot markiert, legacy API-Integrationen tauchen allerdings nicht auf. Der Haken sind die Quellen: Das Log nennt den Ressourcentyp ("Knowledge replies"), während der konkrete Artikel im Knowledge-Sources-Report und der Data-Export-API auftaucht. Testen geht nur eine Konversation zur Zeit in einem Test-Widget, das keine CRM-Aktionen oder eingeschränkten Help-Center-Inhalt ausführen kann. Automatisierte Bewertung jeder Konversation braucht das separate QA-Add-on, das ich in Zendesk QA für KI-Agenten behandelt habe.
Gorgias hat das beste Aktions-Log. Jede AI-Agent-Nachricht hat einen Show-Reasoning-Link, der die genutzten Skills, Wissensquellen und Aktionen auflistet, und jede Action behält ein Event-Log mit dem vollständigen HTTP-Request, der Response und etwaigen Fehlern, einschließlich welcher Schritt einer mehrstufigen Action erfolgreich war oder fehlschlug. Fehlgeschlagene Actions taggen das Ticket zusätzlich mit ai_failed_action, sodass du sie per Regel weiterleiten kannst. Im Playground lässt sich ein bestehendes Ticket nach einer Änderung neu durchlaufen. Eine ehrliche Einschränkung in Gorgias' eigenen Worten: Deine Konversationsbewertung geht an Gorgias und ändert nicht sofort, wie der AI Agent sich verhält. Nur Quellenbewertungen ändern künftige Antworten. Meine Anleitung zu Gorgias-AI-Agent-Aktionen hat mehr zur Aktionsseite.
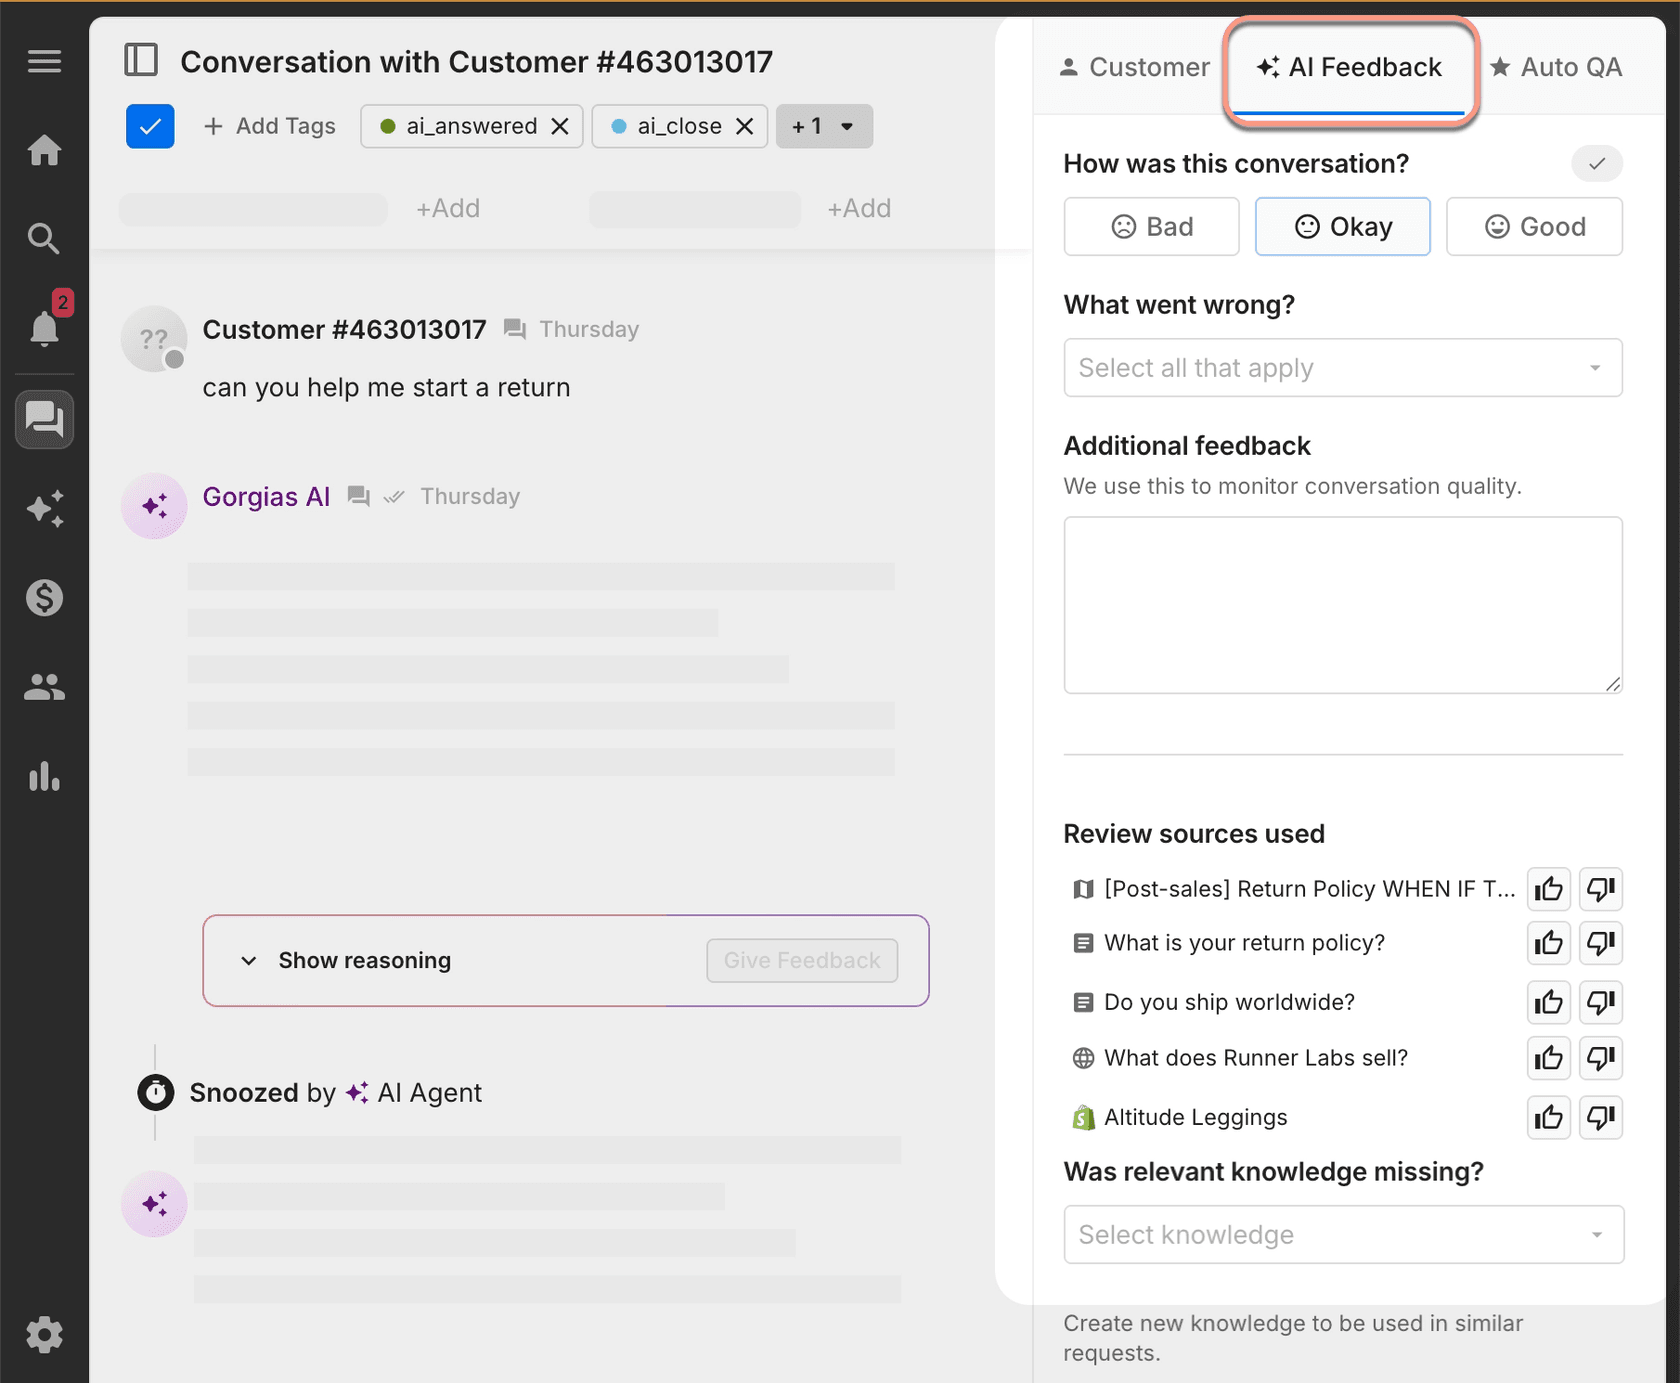
HubSpot packt es in den Help Desk. Klick auf das KI-Symbol an einer Customer-Agent-Nachricht, und die Agent Insights zeigen die zitierten Quellen, die ausgelösten Aktionen und etwaige Wissenslücken, mit einer Daumen-Bewertung und einem Coach-Agent-Button. Coaching Opportunities markieren Wissenslücken, Widersprüche, Aktionslücken und, als Beta, Konversationen mit einem CX-Score von 45 oder weniger. Batch-Testing erlaubt bis zu 8 Testsets, auf Wunsch aus echten Konversationen erzeugt, was ich in HubSpot-Batch-Testing durchgehe. Ein Ausführungs-Log pro Aufruf wie bei Gorgias konnte ich nicht finden.
Freshdesk teilt nach Kanal. Chat-Agenten bekommen die Tabs Performance und Improve, mit Zitationszahlen pro Quelle, die zu jeder Konversation verlinken, in der eine Quelle zitiert wurde. E-Mail-Agenten bekommen Ticket-Logs mit Entwürfen und Ergebnissen, plus einen nützlichen Shadow-Modus, der Entwürfe als private Notizen auf echten Tickets schreibt, ohne sie zu senden. Bulk-Testing fährt einen Stapel Anfragen durch und zeigt für jede die Antwortquelle. Zwei Dinge sollte man wissen: Previews verbrauchen kostenpflichtige Sessions, selbst bei einem unveröffentlichten Agenten, und die Workflow-Doku sagt, dass ticketabhängige Aktionen im Log als abgeschlossen auftauchen können, während sie noch in der Warteschlange stehen.
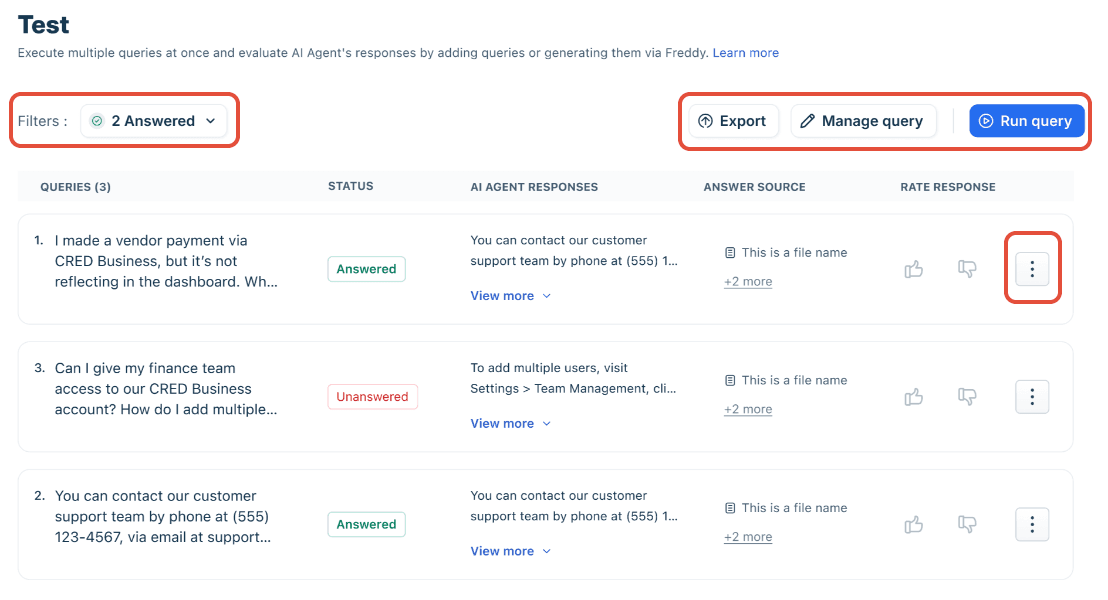
Wenn du lieber dein eigenes Setup prüfst, als vier Absätze zu lesen, wähl es unten aus.
Was siehst du in deinem Setup?
Wähl, wo dein KI-Agent läuft. Jede Antwort stammt aus der eigenen Dokumentation des jeweiligen Anbieters, geprüft im November 2026.
| Quellen pro Antwort | Ressourcentyp im Log. Der konkrete Artikel steht im Knowledge-Sources-Report und der Data-Export-API. |
| Tool-Aufrufe und Ergebnisse | Ja. Integration Details zeigt Eingaben, Ausgaben und API-Fehler. Legacy-API-Integrationen werden nicht gezeigt. |
| Begründung | Ja, der Plan bei jeder generativen Antwort. |
| Testen | Test-Widget, eine Konversation zur Zeit. Keine CRM-Aktionen. |
| Automatische Bewertung | Mit dem kostenpflichtigen QA-Add-on. |
Worauf achten: die verifizierte Lösung, für die du bezahlst, ist die Einschätzung einer KI über das Transkript.
| Quellen pro Antwort | Zitationszahlen pro Quelle, verlinkt zu jeder Konversation, die sie zitiert hat. |
| Tool-Aufrufe und Ergebnisse | Workflow-Abschluss- und Übergabequoten. Kein Log mit Request und Response pro Aufruf dokumentiert. |
| Begründung | In Live-Logs nicht dokumentiert. |
| Testen | Bulk-Evaluierungsläufe mit einer Antwortquelle pro Anfrage. Previews verbrauchen kostenpflichtige Sessions. |
| Automatische Bewertung | Nur Kunden-Daumen. Kein automatischer Qualitätsscore dokumentiert. |
Worauf achten: in der Warteschlange stehende Aktionen können im Log als abgeschlossen auftauchen.
| Quellen pro Antwort | Für E-Mail nicht dokumentiert. |
| Tool-Aufrufe und Ergebnisse | Nicht dokumentiert. |
| Begründung | Nicht dokumentiert. |
| Testen | Shadow-Modus: Entwürfe landen als private Notizen auf echten Tickets und werden nie gesendet. |
| Automatische Bewertung | Nicht dokumentiert. |
Worauf achten: die Tabs Performance und Improve decken nur Chat-Agenten ab. E-Mail bekommt Ticket-Logs.
| Quellen pro Antwort | Ja, in Show Reasoning, mit einem Daumen pro Quelle. |
| Tool-Aufrufe und Ergebnisse | Ja. Das Event-Log jeder Action hat den HTTP-Request, die Response und den Fehler. |
| Begründung | Ja, unter jeder AI-Agent-Nachricht. |
| Testen | Playground, inklusive erneutem Durchlauf eines bestehenden Tickets. Aktionen standardmäßig aus. |
| Automatische Bewertung | Konversationsbewertungen gehen an Gorgias und ändern das Verhalten nicht sofort. |
Worauf achten: kein Mensch innerhalb von 72 Stunden zählt als automatisiert.
| Quellen pro Antwort | Ja, in den Agent Insights im Help Desk. |
| Tool-Aufrufe und Ergebnisse | Ausgelöste Aktionen werden angezeigt. Kein Ausführungs-Log mit Request und Response gefunden. |
| Begründung | In den Testing Insights während der Vorschau. |
| Testen | Batch-Testing, bis zu 8 Testsets. Keine Credits verbraucht. |
| Automatische Bewertung | Coaching Opportunities, inklusive eines Beta-Flags für niedrigen CX-Score. |
Worauf achten: manuelle und Workflow-Zuweisung blockieren keine abgerechnete Lösung.
| Quellen pro Antwort | Was immer du als Retrieval-Span loggst. |
| Tool-Aufrufe und Ergebnisse | Ja, als Tool-Spans mit Eingaben und Ausgaben. |
| Begründung | Wenn du sie aufzeichnest. |
| Testen | Datasets und Experimente in deinem Tracing-Tool. |
| Automatische Bewertung | Online-LLM-as-a-Judge in LangSmith, Langfuse oder Braintrust. |
Worauf achten: dir gehört die Instrumentierung, also ist ein Schritt, den du nie geloggt hast, ein Schritt, den du nicht sehen kannst.
Wie markierst du verdächtige Konversationen automatisch?
Du kannst nicht alles lesen, also ist die Aufgabe der Automatisierung, zu entscheiden, was eine Person liest. Ich würde die Signale in zwei Arten teilen: harte Signale, die kein Urteilsvermögen brauchen, und weiche Signale von einem KI-Bewerter.
Harte Signale sind billig und liegen fast nie falsch damit, dass sich ein Blick lohnt:
- Ein Tool- oder API-Aufruf ist fehlgeschlagen, aber die Antwort wurde trotzdem geschickt
- Die Antwort ging ohne erkennbare Quelle raus, oder der Agent hat eine Wissenslücke protokolliert
- Der Kunde ist innerhalb wenige Tage zum selben Thema zurückgekommen, die Support-Version der Reopen-Rate
- Ein Daumen runter, ein niedriger CSAT-Wert oder die Bitte um einen Menschen
- Das Thema steht auf deiner Hochrisikoliste (Rückerstattungen, Kündigungen, Recht, Gesundheit)
Ein Reddit-Kommentator beschrieb, was passiert, wenn man nur auf die Schlagzahl schaut:
"the bot looks great on the dashboard while actually making angry customers angrier before a human ever sees them."
Weiche Signale kommen von einem KI-Bewerter, oft LLM-as-a-Judge genannt: Ein zweites Modell liest die Konversation gegen eine Rubrik und bewertet sie. Das ist nützlich, und die Anbieter, die es verkaufen, warnen als Erste davor. Langfuses Dokumentation sagt "Ein Judge ist ein Prompt, den du geschrieben hast", und rät, ihn zuerst gegen menschliche Einstufungen zu prüfen, bevor man sich darauf verlässt. LangSmith sagt, Judge-Scores brauchen sorgfältige Überprüfung und Prompt-Tuning. Braintrust sagt, man solle Kandidaten-Judges gegen von Menschen vergebene Scores vergleichen, auch bei mehrdeutigen und fehlgeschlagenen Fällen.
Der Grund ist schlichte Mathematik, die ein Hacker-News-Kommentator aus seiner eigenen Evaluierungsarbeit beschrieb:
"The agent was about 80% correct, and the LLM judge about 80% accurate in assessing the agent."
Also behandle ich einen Judge als Sortierwerkzeug, nicht als Urteil. Er entscheidet, welche Konversationen eine Person zuerst liest, und ich verfolge, wie oft diese Person zustimmt. Dasselbe gilt für eesels eigenen KI-CSAT-Score: Die Reports-Doku sagt klar, dass es kein Kundenfeedback ist, sondern die Bewertung der Antworten deines Agenten durch eine KI, nützlich als internes Signal. Für die Toolwahl vergleicht meine Übersicht zu KI-Tools für Support-QA die Optionen.
Wie sollte Risiko entscheiden, was du prüfst?
Nicht jede Konversation verdient dieselbe Aufmerksamkeit, und zu versuchen, alles gleich zu prüfen, ist der Grund, warum Prüfroutinen in der dritten Woche sterben. Sortiere nach dem, was auf dem Spiel steht, wenn der Agent es falsch macht.
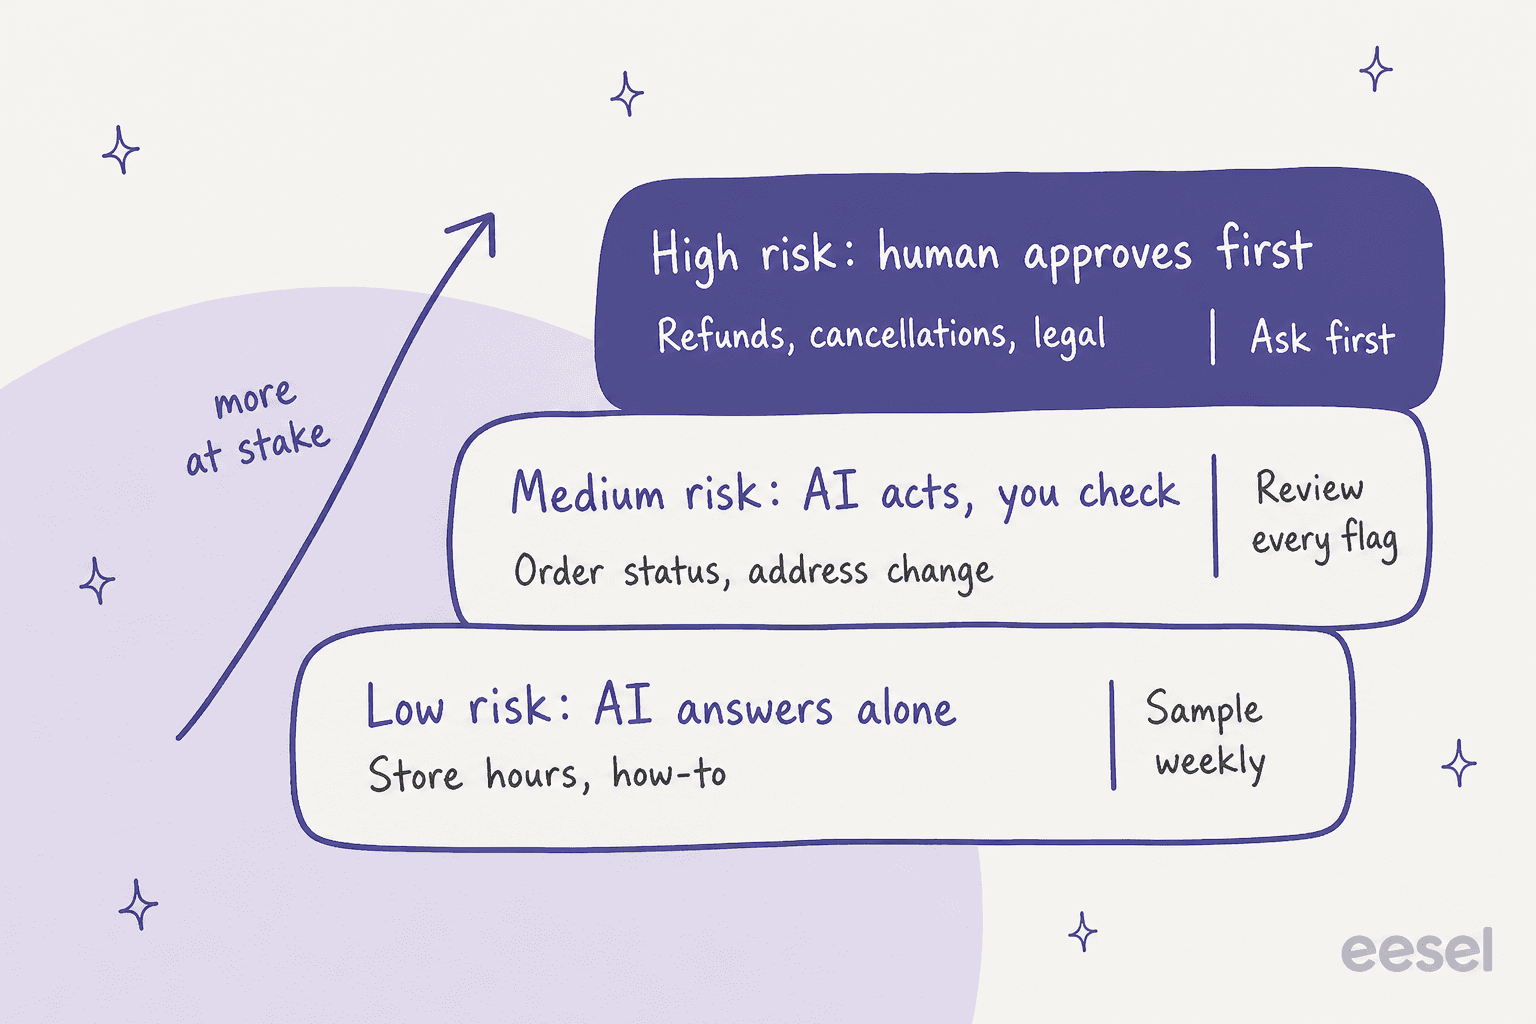
| Risikostufe | Beispiele | Was der Agent tun darf | Wie du es beobachtest |
|---|---|---|---|
| Niedrig | Öffnungszeiten, How-to-Schritte, Plan-Funktionen | Allein antworten | Eine zufällige wöchentliche Stichprobe |
| Mittel | Bestellstatus, Adressänderungen, Kontofragen | Handeln, jede Aktion wird protokolliert | Jede markierte Konversation lesen |
| Hoch | Rückerstattungen, Kündigungen, Recht, Gesundheit, Datenlöschung | Die Aktion vorbereiten, eine Person genehmigt | Ohne Entscheidung läuft nichts |
Die hohe Stufe ist eigentlich kein Observability-Problem. Es ist ein Berechtigungsproblem, und die sauberste Lösung ist, dass der Agent es gar nicht allein tun kann. Bei eesel ist jede Aktion pro Agent auf An, Zuerst fragen oder Aus eingestellt, und die Actions-Doku empfiehlt, Rückerstattungen, Kündigungen und alles, was Geld kostet, hinter eine Genehmigung zu stellen. Meine Anleitung zu KI-Agent-Berechtigungen geht tiefer, und die zu Rückerstattungs-Guardrails deckt speziell das Geldthema ab.
Original Bootcamp, ein Outdoor-Fitnessunternehmen in Deutschland, zeigt die Stufen in Freshdesk im Einsatz. Ein Filter lässt eesel nur Tickets beantworten, die es vollständig aus der Website und vergangenen Tickets lösen kann. Alles zu einer Buchung, einer Zahlung oder einem Mitgliedskonto geht ans Team, und alles, was eine Verletzung oder Krankheit erwähnt, geht an eine Person, selbst wenn die Buchungsfrage beantwortbar gewesen wäre. eesel behauptet nie, eine Buchung geändert zu haben. Jeden Wochentag um 9 Uhr Berliner Zeit prüft es den Workspace und schickt eine kurze Notiz an den Inhaber.
Wie sehen ein wöchentlicher Review- und Regressionszyklus aus?
Observability zahlt sich nur aus, wenn jemand nach dem handelt, was sie zeigt. Der Zyklus, den ich fahren würde, ist kurz: Zieh die markierten Konversationen und eine Zufallsstichprobe, finde bei jeder die Grundursache, behebe sie an der Quelle, und spiele dieselben Tickets erneut durch, um den Fix zu beweisen. Meine vollständige Routine, inklusive welche Konversationen man zieht und wie man Ursachen beschriftet, steht in meiner Anleitung zum Prüfen von KI-Support-Konversationen, hier konzentriere ich mich auf die zwei Teile, die Leute überspringen.
Behebe die Quelle, nicht die Antwort. Wenn der Trace zeigt, dass der Agent den richtigen Artikel zitiert hat und der Artikel falsch war, behebt das Bearbeiten der Antwort nur ein Ticket. Das Bearbeiten des Artikels behebt jedes künftige. Qontro, ein ERP-Unternehmen in Neuseeland, betreibt eesel auf Freshdesk genau so. Jedes neue Ticket bekommt einen Antwortentwurf als interne Notiz, gestützt auf das Help Center und rund 9.800 vergangene Tickets und Artikel. Das Team vergleicht jeden Entwurf mit der Antwort, die eine Person tatsächlich geschickt hat, und wo der Entwurf falsch lag, zeigt das meist auf einen fehlenden oder unvollständigen Hilfeartikel oder eine Regel, die enger gefasst werden muss. Etwa jeder zehnte Entwurf geht inzwischen mit kaum oder gar keiner Bearbeitung raus, und der Anteil steigt langsam.
Behalte einen Regressionssatz. Jeder Fehler, den du behebst, sollte zu einem Testfall werden, den du nach der nächsten Änderung an Anweisungen, Wissen oder Modell erneut durchläufst. Ein Satz von 50 bis 100 echten vergangenen Tickets über deine Hauptthemen reicht zum Start. Genau das macht eesels Helpdesk-Simulation vor dem Go-Live: Laut der Skills-Doku entwirft sie eine Antwort auf Tickets, die dein Team kürzlich gelöst hat, stellt jede neben das, was dein Team geschickt hat, gruppiert die Ergebnisse nach Thema und sagt, was zu beheben ist, ohne irgendetwas an Kunden zu schicken. Im Beispiellauf der Doku stimmten 17 von 20 Antworten mit denen des Teams überein. Die vollständige Methode steht unter Simulationstests. Meine Anleitung zu KI-Support-Agent-Testing deckt die Live-Launch-Seite ab.
Zwei Hinweise zum Takt. Prüfe in der ersten Woche nach dem Launch oder nach jeder großen Änderung täglich, danach wöchentlich. Und beobachte den Trend, nicht nur den Stapel: Eine steigende Zahl von Wissenslücken bei einem Thema sagt dir, welchen Artikel du als nächstes schreiben solltest, wie meine Anleitung zu KI-Kundenservice-Kennzahlen erklärt.
Sieh, was dein KI-Agent mit eesel getan hat
eesel ist eine KI-Helpdesk-Teamkollegin, die sich in deine bestehende Warteschlange in Zendesk, Freshdesk, Gorgias oder HubSpot einreiht, und sie ist so gebaut, dass du nie raten musst, was sie getan hat. Ihre Activity-Seite listet jeden Lauf mit dem Ort, dem Auslöser, den durchsuchten Quellen, jeder Aktion und wer sie genehmigt hat, ihrer Begründung Schritt für Schritt und ob sie auf eine Wissenslücke gestoßen ist. Übersprungene Tickets stehen mit dem Grund dabei.

Wenn eine Antwort falsch ist, kannst du den Agenten im Chat auf diesen Lauf hinweisen, und er geht seine Begründung durch, bietet einen Fix an und speichert die Regel in seinen Anweisungen, sobald du zustimmst. Die Reports-Seite verfolgt Volumen, KI-CSAT, Wissenslücken und Genehmigungsmuster, und die Doku gibt eine nützliche Leseregel: eine Aktion, die jedes Mal ohne Bearbeitung genehmigt wird, ist bereit, allein zu laufen, und eine, die immer wieder abgelehnt wird, braucht einen Fix an den Anweisungen. Bevor du das alles machst, lass eine Simulation auf deinen eigenen vergangenen Tickets laufen, damit du ihre Fehler siehst, bevor es ein Kunde tut.

Wenn dein Team vom Terminal aus arbeitet, gibt eesel activity dieselbe Lauf-Historie aus, und eesel chat schickt Testfragen, sodass ein Coding-Agent Antworten prüfen kann, bevor du erweiterst, was der Agent übernimmt. Das Verbinden des Helpdesks braucht trotzdem jemanden mit Admin-Zugriff, der es genehmigt.