

Was ist Fehleranalyse im Kundensupport?
Fehleranalyse im Kundensupport ist eine wiederholbare Prüfung falscher oder schwacher Support-Antworten: Jeder Fehler bekommt ein Ursachen-Label, die Labels werden gezählt, und die häufigste Ursache wird an der Quelle behoben. Sie funktioniert gleich, ob die Antwort von einem Mitarbeiter, einem Makro oder einem KI-Agenten kam.
Der Begriff stammt aus dem maschinellen Lernen, wo es der Schritt ist, den Leute überspringen. Ein Hacker-News-Kommentator brachte es vor mehr als zehn Jahren deutlich auf den Punkt:
"3) Do error analysis/run diagnostics. Go to 1. It is the last step I find inexperienced people usually lacking. You need to examine your errors and find commonalities among them."

Das ist die ganze Idee. Eine falsche Antwort ist eine Anekdote. Vierzig falsche Antworten, in Blöcke sortiert, sind eine To-do-Liste.
Man verwechselt sie leicht mit der Support-QA, deshalb hier, wie ich beide trenne:
| Support-QA | Fehleranalyse | |
|---|---|---|
| Frage, die sie beantwortet | Wie gut war die Antwort dieses Mitarbeiters? | Warum gehen Antworten schief, und wo? |
| Prüfeinheit | Ein Mitarbeiter, eine Bewertungskarte | Ein Fehler, eine Ursache |
| Stichprobe | Zufällige oder zugewiesene Tickets | Tickets, die bereits schiefgegangen sind (Wiedereröffnungen, schlechte CSAT, Eskalationen, abgelehnte Entwürfe) |
| Ergebnis | Eine Bewertung und Coaching-Notizen | Eine gerankte Liste von Ursachen, jede mit einem Verantwortlichen |
| Wer es behebt | Der Mitarbeiter | Wer die Ursache verantwortet: der KB-Autor, der Richtlinien-Verantwortliche, der KI-Admin, das Produktteam |
QA bleibt wichtig. Fehleranalyse ist das, was Sie mit den Fehlern tun, die die QA findet, damit sie sich nicht wiederholen. Ich baue bei eesel KI-Agenten, und die nützlichste Stunde bei jedem Rollout ist die, in der jemand 50 fehlgeschlagene Tickets liest und aufschreibt, warum jedes gescheitert ist.
Warum die meisten Support-Fehler nicht am Mitarbeiter liegen
Wenn ein Kunde eine falsche Antwort bekommt, ist der Instinkt, den Absender zu suchen. Aber liest man, was Mitarbeiter über ihre eigenen Fehler sagen, zeigt sich schnell ein Muster: Der Mitarbeiter hat mit schlechten Informationen gearbeitet.
"Yes..and they're always outdated never load.. and if you have questions the supervisor will always refer you back there and give you a bad review saying you must not have checked it."

Richtlinienänderungen sind der klassische Fall. Das Update landet in einer E-Mail oder einem Chat-Kanal, und der Artikel in der Wissensdatenbank ändert sich nicht:
"Emails get buried so fast man I swear I will find a important update like 3 days later after already giving wrong info to 10 customers. The knowledge base is good when they actually update it but half the time someone forgot to change the article"
Eine falsche Antwort, zehn Kunden. Den Mitarbeiter zu coachen behebt nichts, denn der nächste Mitarbeiter liest denselben veralteten Artikel. In einem anderen Thread beschrieb ein Mitarbeiter, wie er um Hilfe bat, bei einer Frage zu einem Rabatt: Der Vorgesetzte sagte 30 $ im Monat, ein Kollege sagte, es gebe keinen Rabatt, ein anderer sagte die Hälfte, und ein Coach brauchte zehn Minuten, um zu bestätigen, dass es die Hälfte ist. Drei Personen, drei Antworten. Das ist eine fehlende zentrale Wahrheitsquelle, kein nachlässiger Mitarbeiter. Mein Leitfaden zum Management von Richtlinienänderungen zeigt, wie Sie das an der Quelle stoppen.
KI-Agenten scheitern genauso, nur schneller. Als der Support-Bot von Cursor Nutzern erklärte, ein Logout sei eine neue „One-Device“-Richtlinie, behandelte Hacker News das als KI-Halluzinationsgeschichte. Cursors Mitgründer erklärte im Thread die eigentliche Ursache:
"For context, this user's complaint was the result of a race condition that appears on very slow internet connections. The race leads to a bunch of unneeded sessions being created which crowds out the real sessions. We've rolled out a fix."
Der Bot hatte kein Dokument, das den Fehler erklärte, also erklärte er das Symptom mit etwas Plausiblem. Die falsche Antwort war das letzte Glied einer Kette, die mit einem Produktfehler begann, den niemand dokumentiert hatte. Wenn Sie nur „die KI reparieren“, übersehen Sie den Teil, der wirklich kaputt war. Mein Beitrag zu KI-Halluzinationen im Support geht tiefer auf dieses Muster ein.
Und manchmal ist der „Fehler“ gar keiner. Hier die Aufschlüsselung aus dem E-Commerce-Test, in dem Mitarbeiter einen eesel-Entwurf unverändert senden oder umschreiben konnten. Nur 12 % der Entwürfe gingen bei 284 Chats unverändert raus, was schrecklich klingt, bis man sich ansieht, warum:
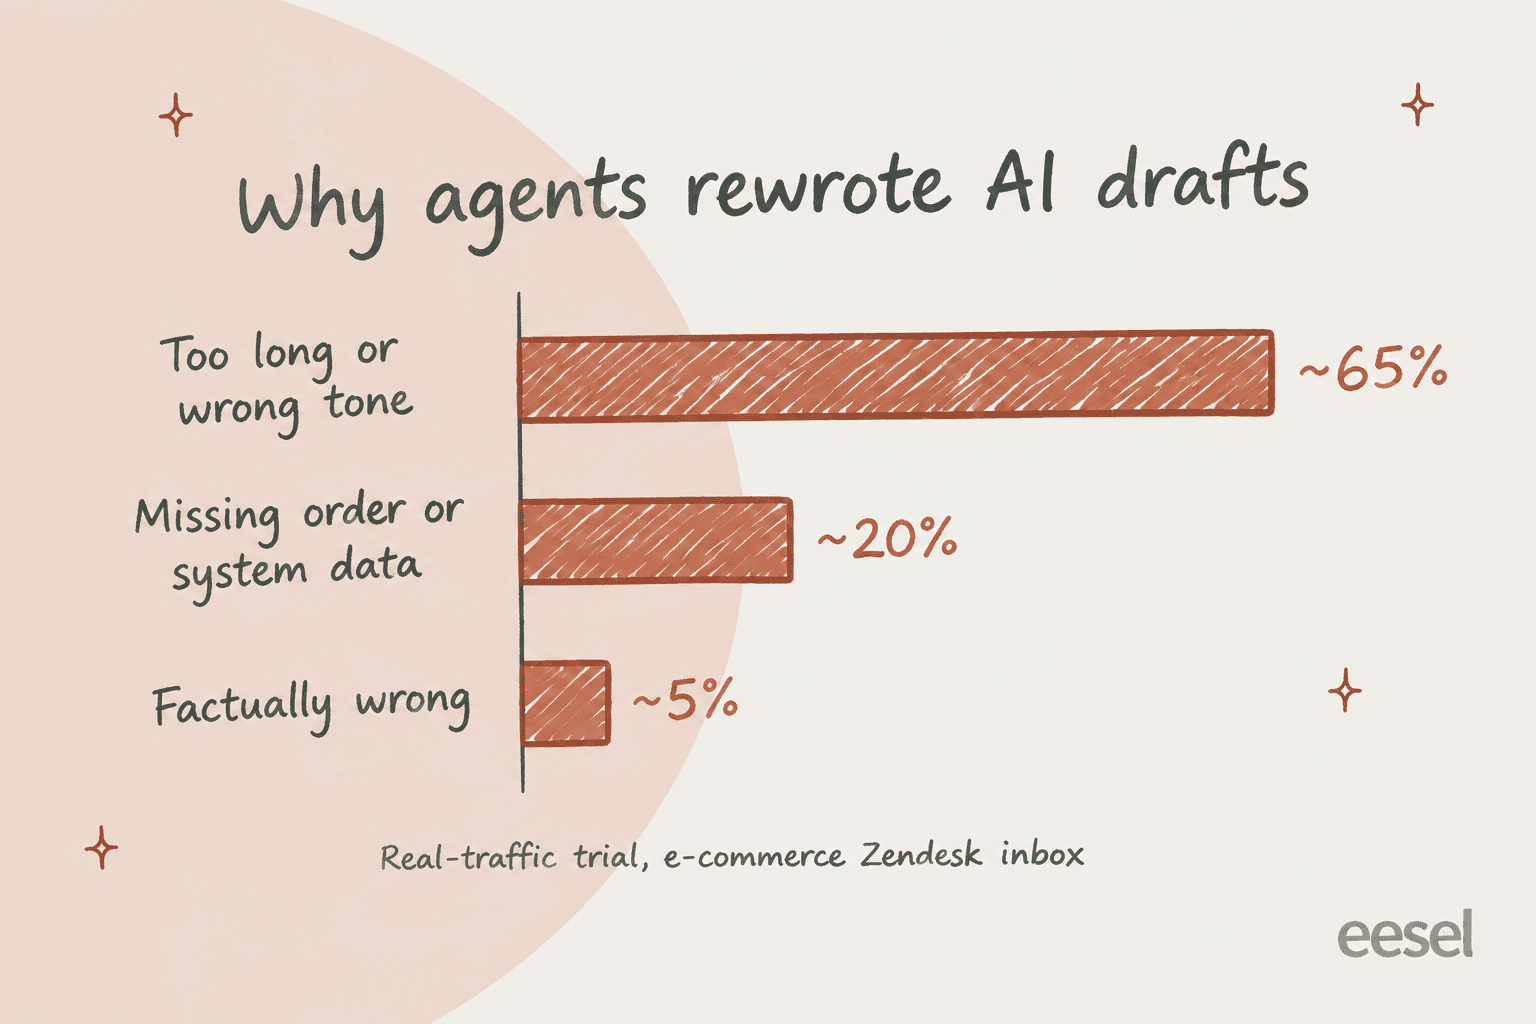
Mitarbeiter machten aus Entwürfen mit 8 bis 15 Sätzen typischerweise Antworten mit 1 bis 3 Sätzen. Die meisten Umschreibungen waren ein Stilproblem, lösbar durch Training mit den gesendeten Antworten des Teams und eine klare KI-Markenstimme. Etwa ein Fünftel brauchte Daten aus Systemen, die noch nicht angebunden waren. Das „Genauigkeitsproblem“ war größtenteils ein Längenproblem und ein Datenzugriffsproblem. Genau dafür ist die Fehleranalyse da: Sie verhindert, dass Sie einen Monat lang Hilfeartikel umschreiben, obwohl die echte Lösung „halte es auf drei Sätze“ und „binde das Bestellsystem an“ lautet.
Die sechs Stellen, an denen eine Support-Antwort danebengeht
Jede falsche Antwort hat einen ersten Fehler. Der Trick ist, beim ersten aufzuhören, denn alles danach ist eine Folge. Wenn die KI den falschen Artikel gezogen hat, spielt es keine Rolle, dass die Antwort auch zu lang war.
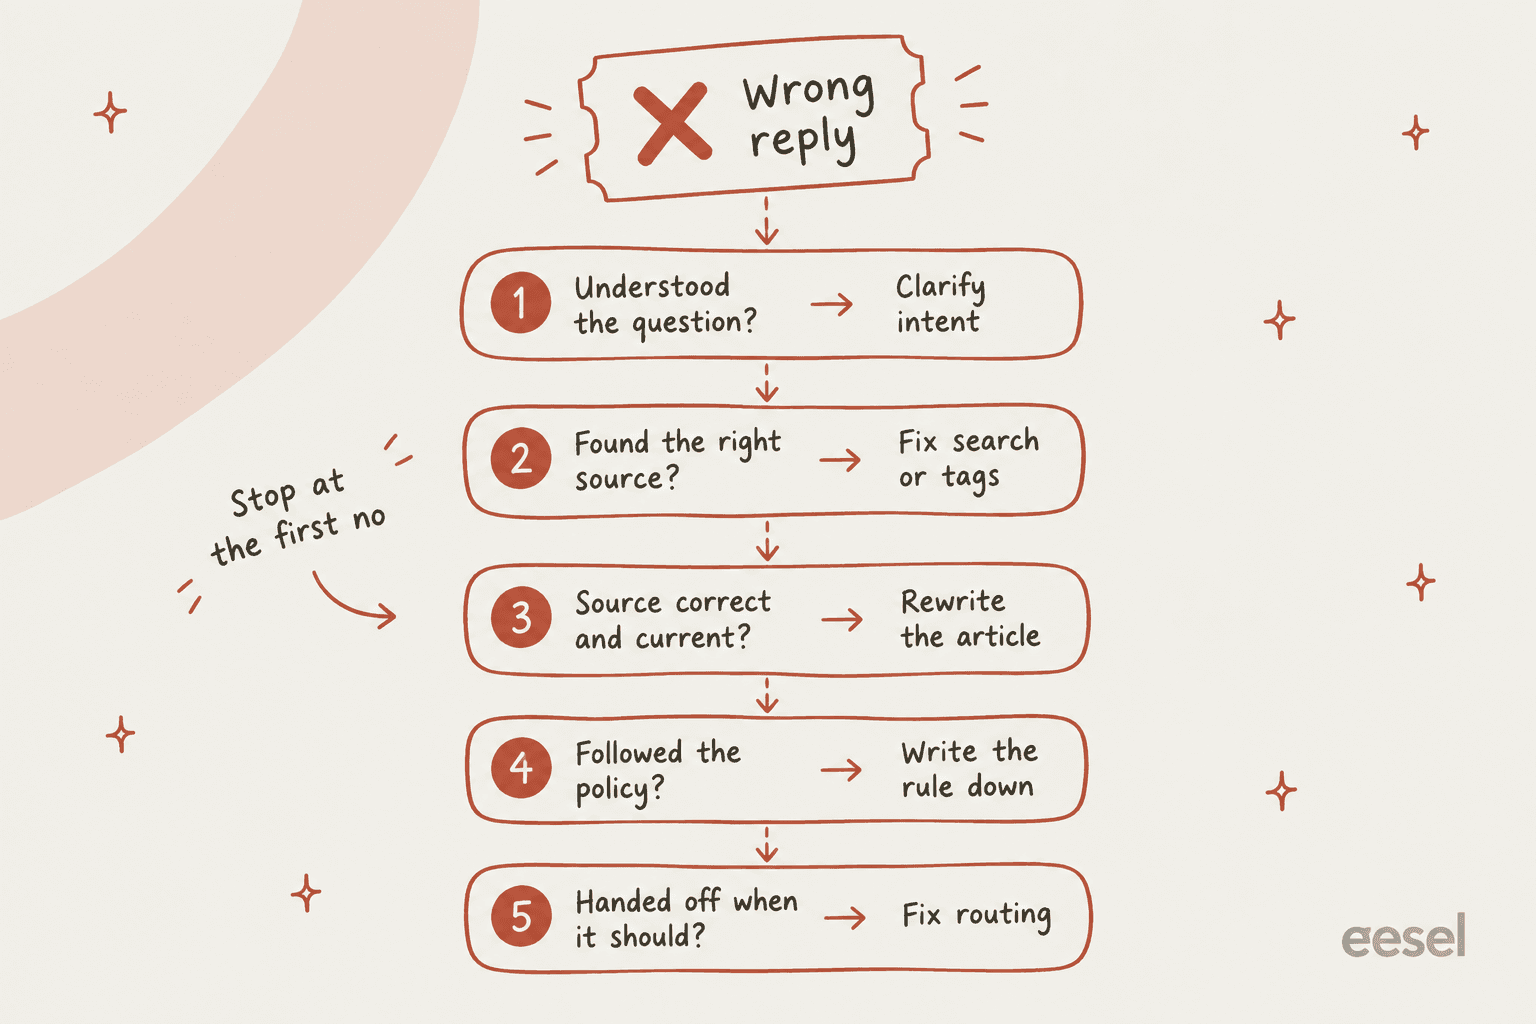
Ich nutze sechs Blöcke: die fünf Prüfpunkte oben plus einen sechsten für Antworten, die korrekt sind, aber nicht ankommen. Wählen Sie einen Block, um zu sehen, wie er aussieht, wie Sie ihn erkennen und wer ihn behebt.
Beachten Sie, dass nur der erste Block davon handelt, wie die Frage gelesen wurde. Die Blöcke zwei bis fünf betreffen Wissen, Regeln und Routing, also Dinge, die ein Support-Leiter einmal ändern und damit für alle beheben kann. Deshalb zahlt sich Fehleranalyse schneller aus als das Coaching einzelner Mitarbeiter: Eine Artikelkorrektur kann denselben Fehler bei allen Mitarbeitern und der KI gleichzeitig stoppen.
So führen Sie eine Fehleranalyse im Kundensupport in 7 Schritten durch
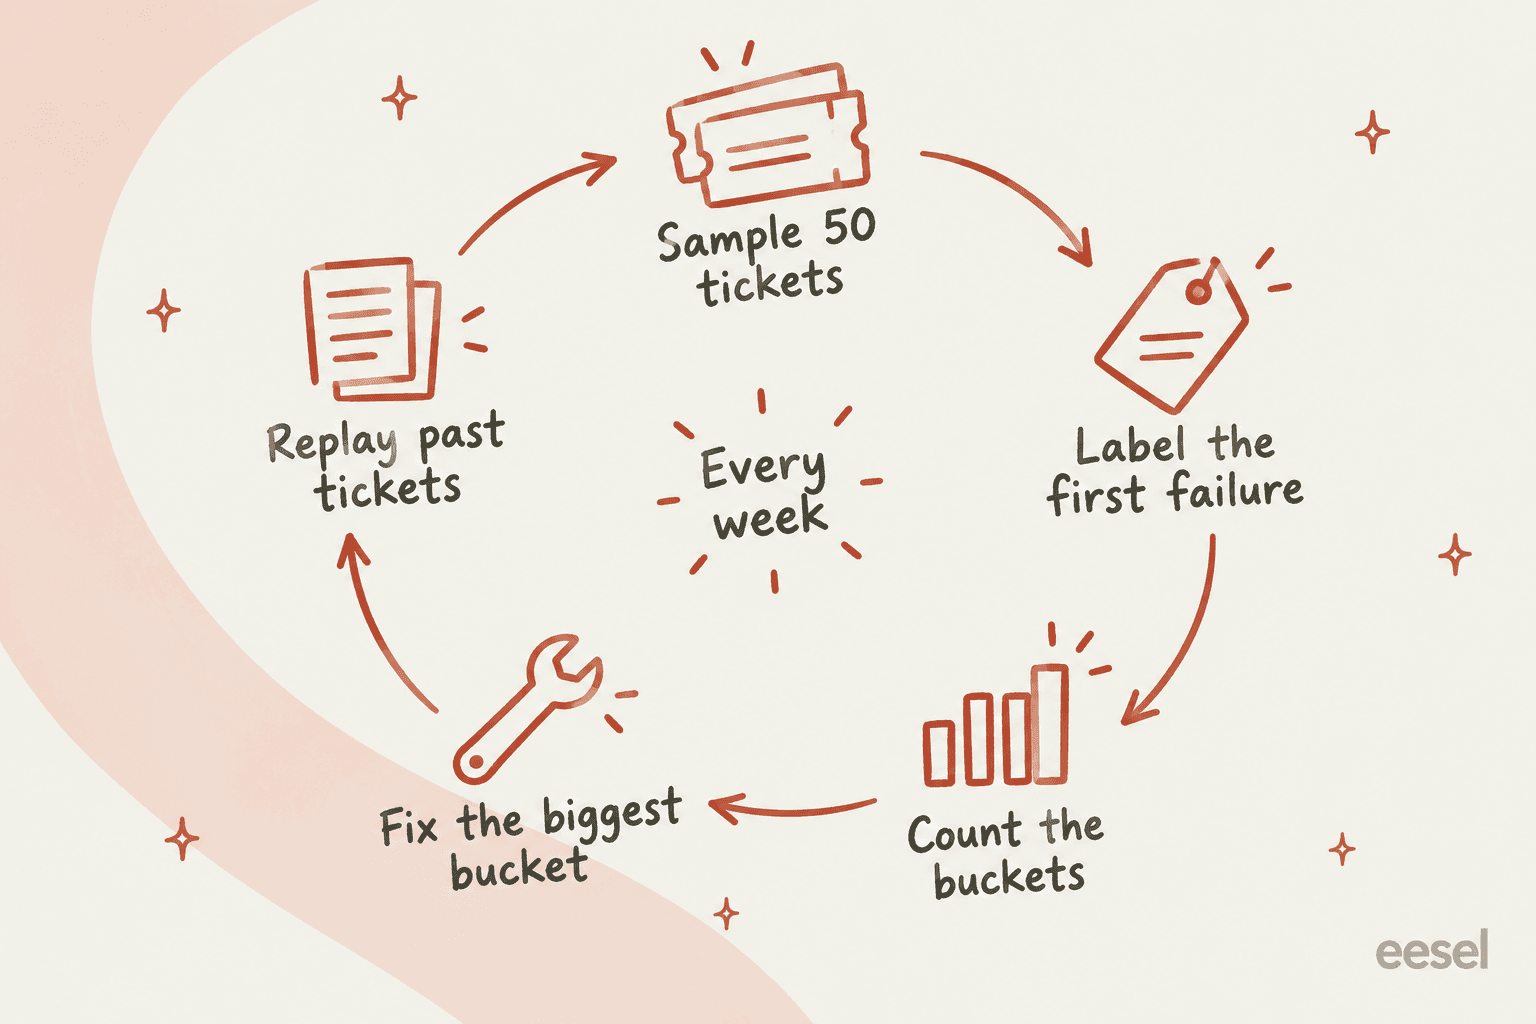
Den ersten Durchgang schaffen Sie in etwa zwei Stunden. Danach ist es eine wöchentliche Routine von 30 Minuten.
- Ziehen Sie die Fehlschläge, keine zufällige Stichprobe. Wiedereröffnete Tickets, schlechte CSAT, Eskalationen von der KI, Tickets, bei denen ein Mitarbeiter einen KI-Entwurf abgelehnt oder umgeschrieben hat, und wiederholte Kontakte innerhalb weniger Tage. Zendesk Explore hat dafür die Kennzahlen Reopens und One-touch tickets, und mein Leitfaden zur Kennzahl wiedereröffneter Tickets zeigt, wie Sie sie filtern.
- Nehmen Sie 50. Weniger, und eine seltsame Woche verzerrt alles. Mehr, und niemand wird fertig. Bei geringem Volumen nehmen Sie alles aus dem letzten Monat.
- Lesen Sie jedes und labeln Sie den ersten Fehler. Nutzen Sie die sechs Blöcke oben. Ein Label pro Ticket. Wenn Sie sich nicht in 30 Sekunden entscheiden können, labeln Sie es „unklar“ und gehen weiter.
- Zählen Sie die Blöcke. Dieser Schritt ändert Meinungen. Aus „Die KI ist schlecht“ wird „14 von 50 waren derselbe veraltete Retouren-Artikel“.
- Beheben Sie den größten Block an der Quelle. Schreiben Sie den Artikel um, schreiben Sie die Regel in Ihre Support-SOPs, ändern Sie das Routing. Geben Sie jeder Korrektur einen Verantwortlichen und ein Datum.
- Spielen Sie vergangene Tickets erneut durch, um die Korrektur zu prüfen. Geben Sie dieselbe Art Frage erneut an Ihren Agenten oder Ihre KI und sehen Sie, ob sich die Antwort geändert hat. Warten Sie nicht einfach auf die Tickets der nächsten Woche.
- Wiederholen Sie es wöchentlich und verfolgen Sie die Block-Verteilung. In einem gesunden Programm schrumpft der größte Block, und ein neuer nimmt seinen Platz ein.
Schritt eins ist der, an dem die meisten Teams stillschweigend scheitern, weil die naheliegende Kennzahl lügt. Ein Ticket, das die KI „gelöst“ hat, kann trotzdem ein Fehlschlag sein:
"Don't track deflection without tracking subsequent contact. A bot might "successfully" complete a chat, but if the user submits an email ticket 20 mins later – that bot was trash. You have to analyze repeat contact rates to get true transparency."
Auch HubSpots eigene Doku macht denselben Punkt: Deflections „do not always indicate resolution“, da ein Kunde einfach gehen kann (HubSpot knowledge base). Gleichen Sie also Bot-Gespräche mit Folgetickets desselben Kunden ab, bevor Sie einer Lösungsrate trauen. Mein Beitrag zum Messen von KI-Deflection behandelt den Abgleich.
Für Schritt vier genügt anfangs eine einfache Strichliste. Ein IT-Manager auf Reddit beschrieb genau das: zählen, wie viele Tickets auf dieselbe Ursache zurückgehen, und die Punkte verbinden, ohne das Team jedes Mal durch ein vollständiges „5 Whys“ zu schicken. Sind die Blöcke stabil, übertragen Sie sie in Ihren Helpdesk als Tags oder QA-Ursachen, damit das Zählen von selbst läuft. Mein Leitfaden zur Support-Ticket-Analyse enthält eine Vorlage für die Zähltabelle.
So analysieren Sie Fehler eines KI-Support-Agenten
Fehleranalyse bei einem KI-Agenten ist in einem wichtigen Punkt einfacher als bei Menschen: Die KI kann ihre Arbeit zeigen. Sie sehen, was sie gesucht hat, was sie fand und warum sie ihre Antwort gewählt hat. Das bekämen Sie von einem menschlichen Mitarbeiter am Ende einer langen Schicht nie.
Der Haken: Sie müssen es tatsächlich lesen. Ein Hacker-News-Kommentator, der Agenten baut, plädierte dafür, es von Hand zu tun, selbst wenn Sie automatisches Scoring haben:
"there's still a huge benefit in looking at traces yourself and labeling them. It's time-consuming, yes, but you'll learn a lot about the ways an agent fails in your particular domain, it gives you more reliable golden datasets, you have a mechanism to evaluate your judges, etc."
Beim Lesen von KI-Verläufen gelten weiter die sechs Blöcke, aber die Belege sehen anders aus:
- Frage falsch verstanden: Die genannte Absicht oder der Anwendungsfall der KI passt nicht zur Frage des Kunden.
- Falsche Quelle: Die Quellenliste zeigt einen Artikel, der nah dran, aber falsch ist.
- Schlechte oder fehlende Quelle: Die KI hat den richtigen Artikel zitiert und der Artikel ist falsch, oder sie fand nichts und antwortete trotzdem. Das zweite ist die gefährliche Variante. Wenn die Suche leer zurückkommt, kann ein Modell die Lücke mit allgemeinem Wissen füllen. In einem eesel-Setup für ein Fahrzeug-Telematik-Team auf Zendesk bestätigte der Bot die Unterstützung von Automodellen, die nicht in der Produktdatenbank standen, weil das Help Center „wir unterstützen alle Modelle“ sagte.
- Richtlinie nicht befolgt: Die Regel existiert in den Köpfen Ihres Teams, aber nicht in den Anweisungen der KI.
- Hätte übergeben müssen: Das Gespräch berührte ein Thema auf Ihrer Übergabeliste, oder hätte es tun sollen, und ging weiter. Mein Leitfaden zur KI-Übergabe behandelt, was auf diese Liste gehört.
Eine Warnung aus Erfahrung: Springen Sie nicht direkt zum Modellwechsel. Simon Willison stellte auf HN die richtige Frage: Wenn Sie das Modell ohne Evals wechseln, "how will you tell if the model switch actually helped?" Und oft ist das Modell gar nicht das Problem. Ein anderer Kommentator merkte an, dass Teams, die dem LLM die Schuld gaben, "upstream calls to services that produce data" als eigentliche Ursache fanden. Im Support-Kontext: Die Bestellabfrage lieferte nichts, also hat die KI geraten. Das ist der 20-%-Block aus dem Test oben.
Wenn Ihre KI Entwürfe für Mitarbeiter erstellt, statt direkt zu antworten, sind abgelehnte oder umgeschriebene Entwürfe kostenlose Daten für die Fehleranalyse. Behandeln Sie die Änderung als Label. Mein Leitfaden zum Trainieren eines KI-Support-Agenten behandelt, wie Sie diese Änderungen zurückspeisen.
Was jeder Helpdesk zeigt, wenn eine Antwort danebengeht
Jeder große Helpdesk bietet inzwischen eine Möglichkeit zu sehen, warum seine KI so geantwortet hat. Sie unterscheiden sich stark darin, was sie zeigen und ob Sie eine Korrektur an vergangenen Tickets testen können.
| Helpdesk | Wo Sie das „Warum“ sehen | Quellen pro Antwort angezeigt? | Eingebaute Ursachencodes | Korrektur an Historie testen? | Voraussetzung | Quelle |
|---|---|---|---|---|---|---|
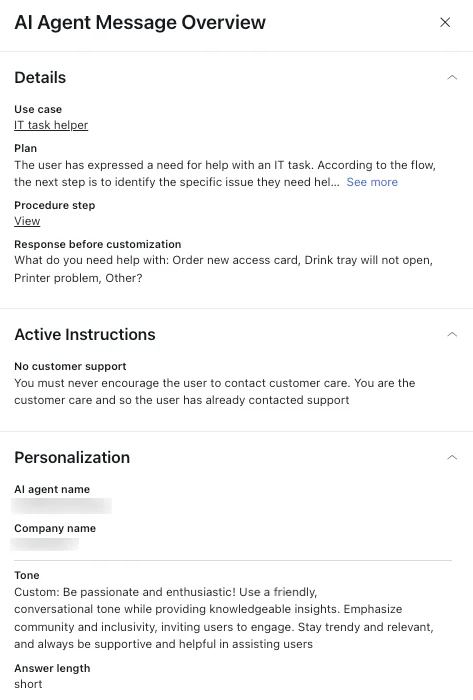
| Zendesk | Konversationsprotokolle: pro Nachricht Plan, Response before customization, aktive Anweisungen | Pro Konversation (Resources used), nicht pro Artikel bei einfachen Wissensantworten | Eigene Lösungen inkl. Unresolved, Escalation failed; QA-Ursachen mit Ebenen | Nicht als Massenfunktion dokumentiert | Protokolle in allen Suite-Tarifen; QA braucht das QA- oder WEM-Add-on | Zendesk-Doku |
| Freshdesk | AI Agent Studio Analyze: Tab Improve, Knowledge usage, Ticket logs | Answer Source in Tests; Zähler pro Quelle für Antworten und Feedback | Improve-Typen: New content, Edit content | Test-Tab: bis zu 100 getippte oder generierte Anfragen | Growth, Pro, Enterprise | Freshdesk-Doku |
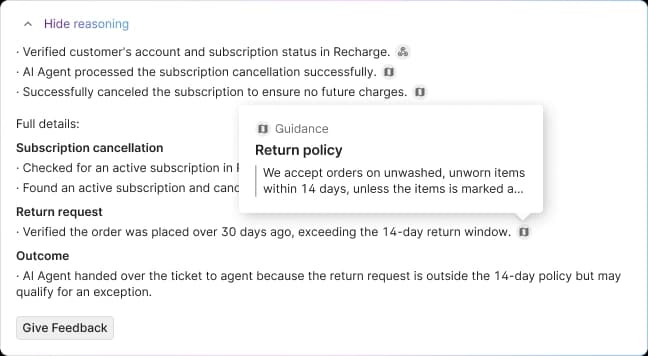
| Gorgias | Show reasoning unter jeder KI-Nachricht; Tab AI Feedback | Ja, mit Daumen hoch oder runter pro Quelle | Dropdown „What went wrong“; 3 Übergabegründe; Opportunities: Fill knowledge gap, Resolve conflict | Ein bestehendes Ticket nach dem anderen | Feedback erfordert Lead oder Admin | Gorgias-Doku |
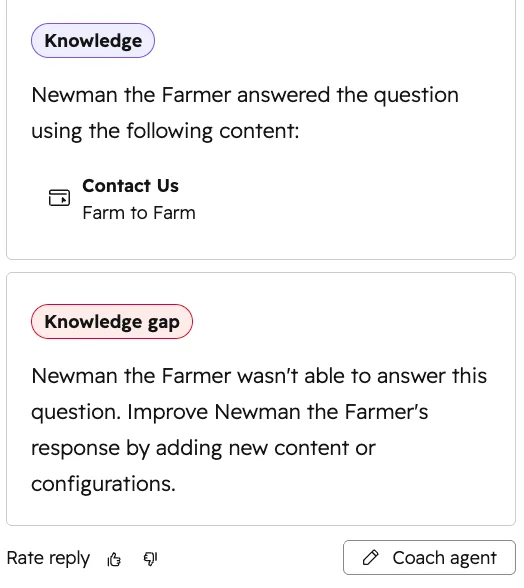
| HubSpot | Coaching opportunities; Agent-Insights im Help Desk | Ja, Wissensquellen pro Antwort zitiert | Reason: Knowledge, Handoff, Experience, Action, Other | Nicht dokumentiert | Pro oder Enterprise plus HubSpot Credits | HubSpot-Doku |
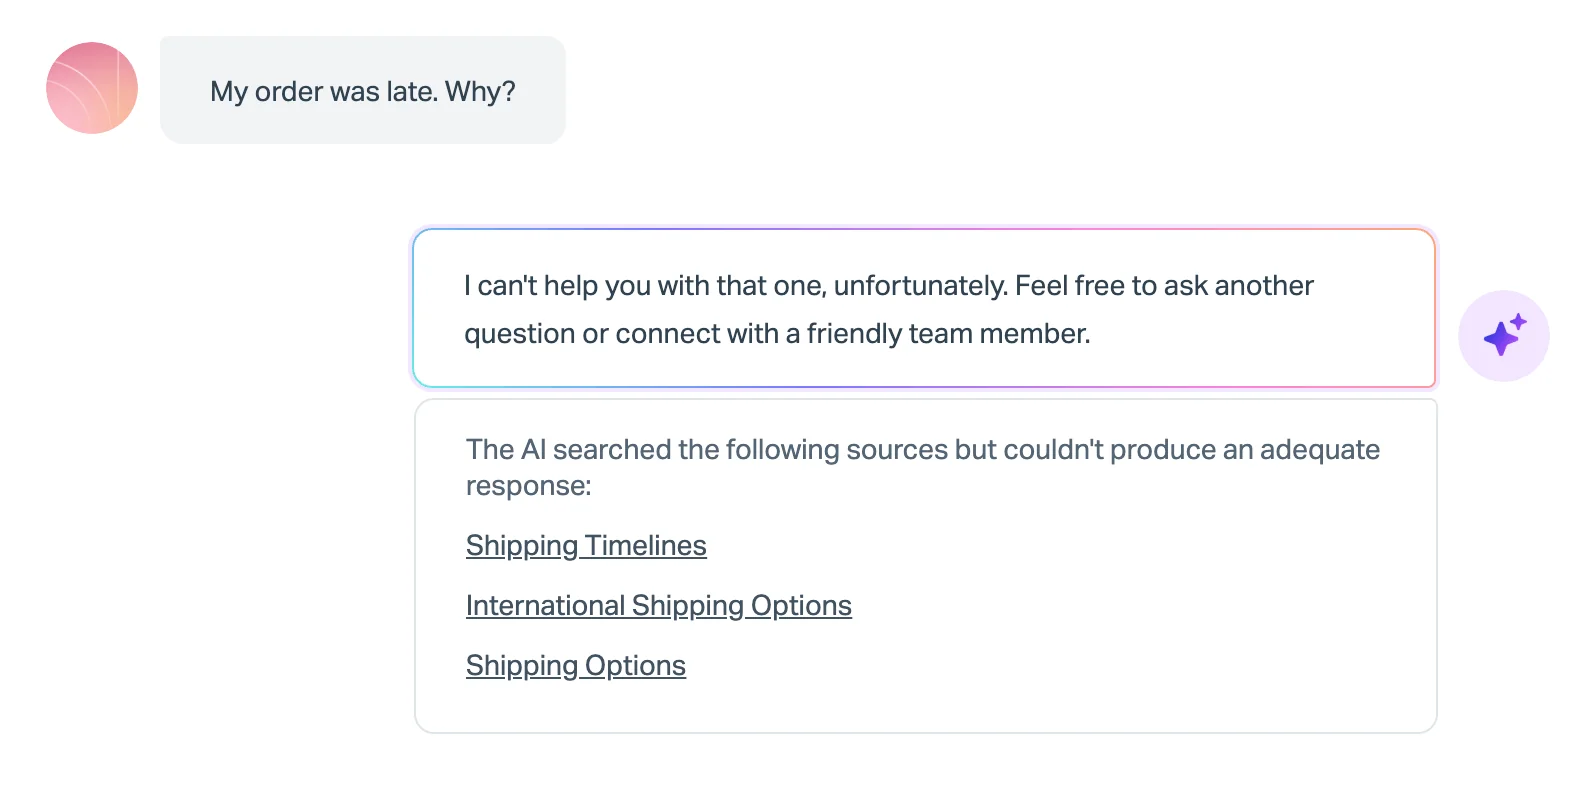
| Help Scout | Tab Beacon Sessions, Improvements | Nur wenn die KI scheitert oder nachfragt (Attempted Sources) | Contact helped, Contact not helped, Human escalation | Nicht dokumentiert | Alle kostenpflichtigen Tarife, $0.75 pro KI-Lösung | Help-Scout-Doku |
| Front | AI-Replies-Hub | Ja, mit dem genauen Auszug aus jeder Quelle | Für KI-Übergaben nicht dokumentiert | Eine bestehende Konversation nach der anderen | Copilot- oder Autopilot-Add-on; Smart QA $20/seat/month | Front-Doku |
Alle Funktionen und Voraussetzungen wurden im Oktober 2026 in der jeweiligen Herstellerdoku geprüft.
Zendesks Ansicht auf Nachrichtenebene ist für seine generativen Abläufe die detaillierteste. Das Feld Plan zeigt die Überlegung der KI, und Response before customization zeigt den Text, bevor Ihre Persona und Anweisungen angewendet wurden, woran Sie erkennen, ob eine schlechte Antwort aus der Überlegung oder aus Ihren Toneinstellungen kam:
Gorgias macht die Begründung für jede Rolle lesbar, was wichtiger ist, als es klingt. Wenn Mitarbeiter sehen können, warum die KI übergeben oder geantwortet hat, können sie die Ursache melden statt nur „der Bot lag falsch“:
HubSpot versieht jede KI-Antwort mit dem, was sie genutzt hat, oder markiert sie als Wissenslücke. Dieses Label ist im Grunde Block drei, schon für Sie erledigt:
Help Scout zeigt Quellen nur, wenn die KI scheitert, aber für die Fehleranalyse ist das genau der Moment, in dem Sie sie brauchen. Eine Antwort, die drei Versandartikel durchsucht hat und die Frage „Meine Bestellung kam zu spät, warum?“ trotzdem nicht beantworten konnte, deutet auf einen fehlenden Artikel hin, nicht auf ein schlechtes Modell:
Freshdesks Tabelle Knowledge usage ist die beste eingebaute Ansicht für Block zwei. Sie zählt, wie oft jede Quelle in Bot-Antworten genutzt wurde, neben positivem und negativem Feedback. Freshdesks eigene Empfehlung: Eine häufig zitierte Quelle mit hohem Verhältnis von negativem zu positivem Feedback ist Ihr wichtigstes Ziel für eine inhaltliche Überprüfung:
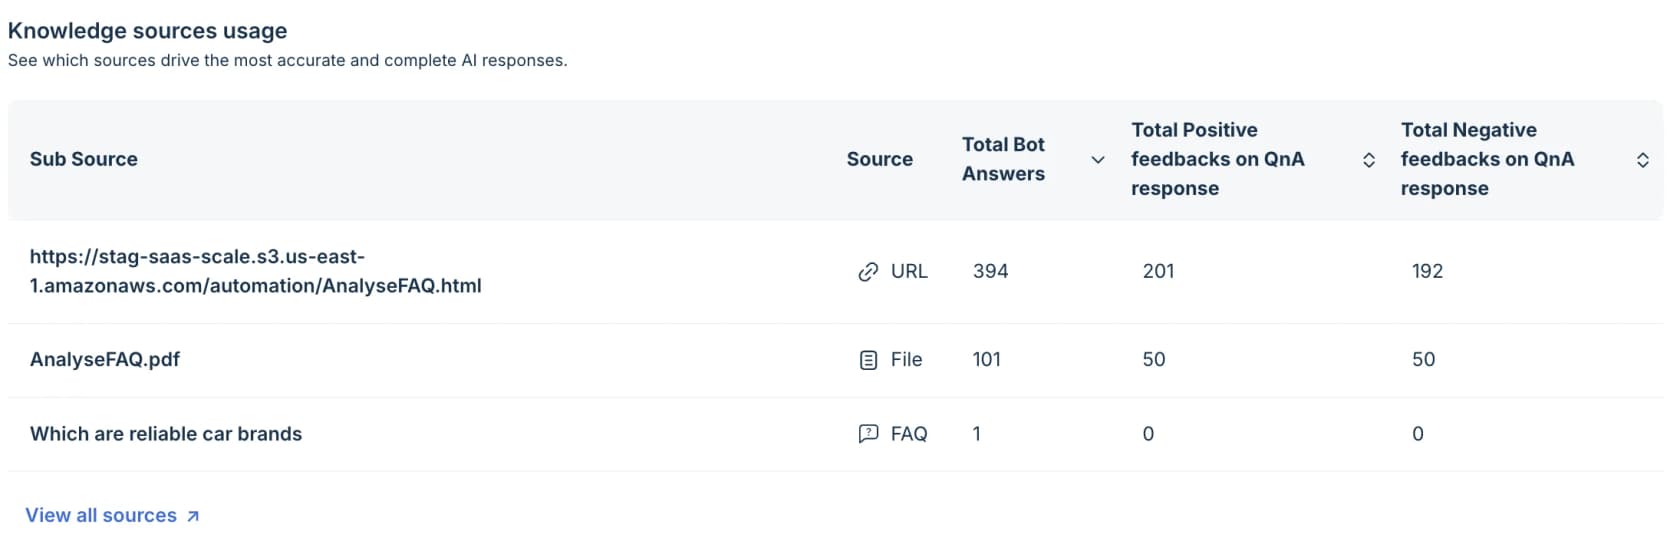
Zwei Dinge sollten Sie wissen, bevor Sie sich auf eines davon verlassen. Erstens erklärt Freshdesks Root Cause Analysis trotz des Namens mit einer Treemap Ticket-Spitzen, nicht einzelne falsche Antworten, und es ist nur für Enterprise. Zweitens ist die Spalte „Korrektur testen“ durchgehend die Schwachstelle. Gorgias und Front lassen Sie ein bestehendes Ticket nach dem anderen erneut durchlaufen, und Freshdesk testet getippte oder generierte Fragen. Das ist für Stichproben nützlich, sagt Ihnen aber nicht, ob die Korrektur der letzten Woche die Fehlerquote über 50 echte Tickets bewegt hat.
Wo Sie Ursachen erfassen, damit Sie sie zählen können
Das Lesen von Verläufen findet die Ursache. Zum Zählen muss die Ursache irgendwo gespeichert sein, worüber Sie berichten können. Das sind die besten eingebauten Orte, die ich gefunden habe.
Zendesk-QA-Ursachen. Prüfer können beim Bewerten einer Kategorie optional eine Ursache hinzufügen, gewählt aus einer von Ihnen definierten Liste, in Ebenen und Unterebenen organisiert und in Dashboards auswertbar. Sie ist für negative Bewertungen gedacht, genau die Stichprobe der Fehleranalyse. Dafür ist das QA- oder WEM-Add-on nötig. Meine Übersicht zu Zendesk QA und der Leitfaden zu Scorecard-Kriterien behandeln die Einrichtung.
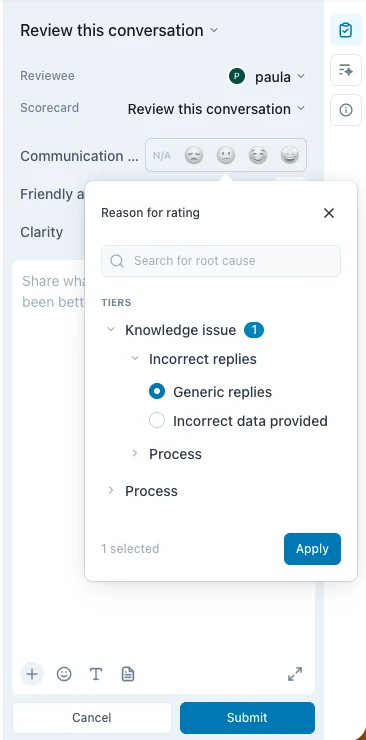
Ich würde Ebenen einrichten, die den sechs Blöcken entsprechen, mit Unterebenen für Ihre häufigsten Fälle („Schlechte oder fehlende Quelle > Retouren“, „Schlechte oder fehlende Quelle > Versand“). Zendesk QA bewertet auch KI-Agenten in Scorecards und hat ein BotQA-Dashboard für Eskalations- und Bot-Wiederholungsraten, unterstützt aber nur Bots, die aus dem Zendesk Marketplace installiert wurden.
HubSpot Coaching opportunities. Jede trägt einen Reason (Knowledge, Handoff, Experience, Action, Other) und einen Type, darunter Knowledge gap, Knowledge conflict und „Flagged by Help Desk rep“. Es ist der vollständigste Satz eingebauter Ursachencodes, den ich gefunden habe, und er passt gut auf die Blöcke drei und fünf.
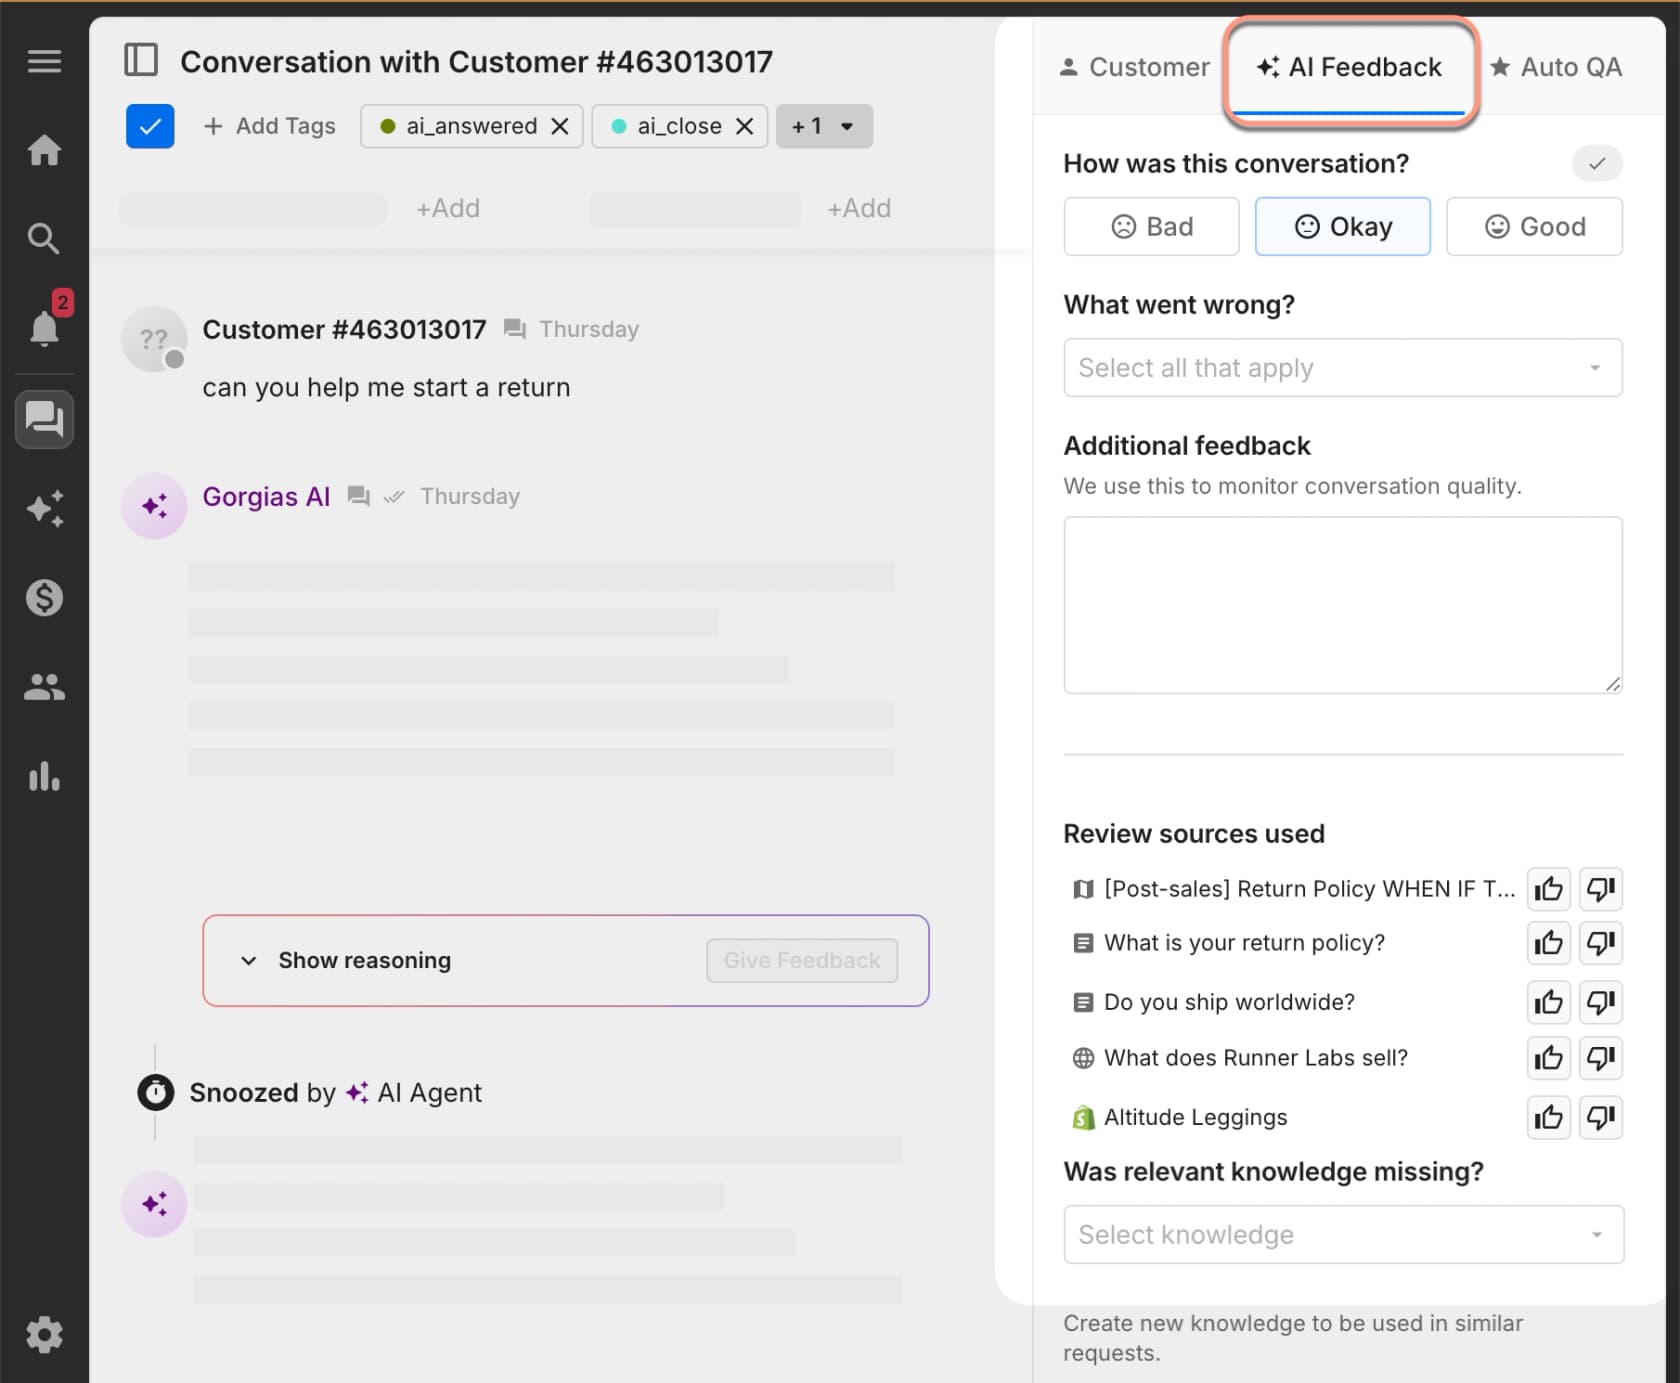
Gorgias AI Feedback. Bei einer Bewertung Bad oder Okay wählen Leads aus einer Liste „What went wrong“, geben einzelnen Quellen Daumen hoch oder runter und können auf das Wissen verweisen, das hätte genutzt werden sollen:
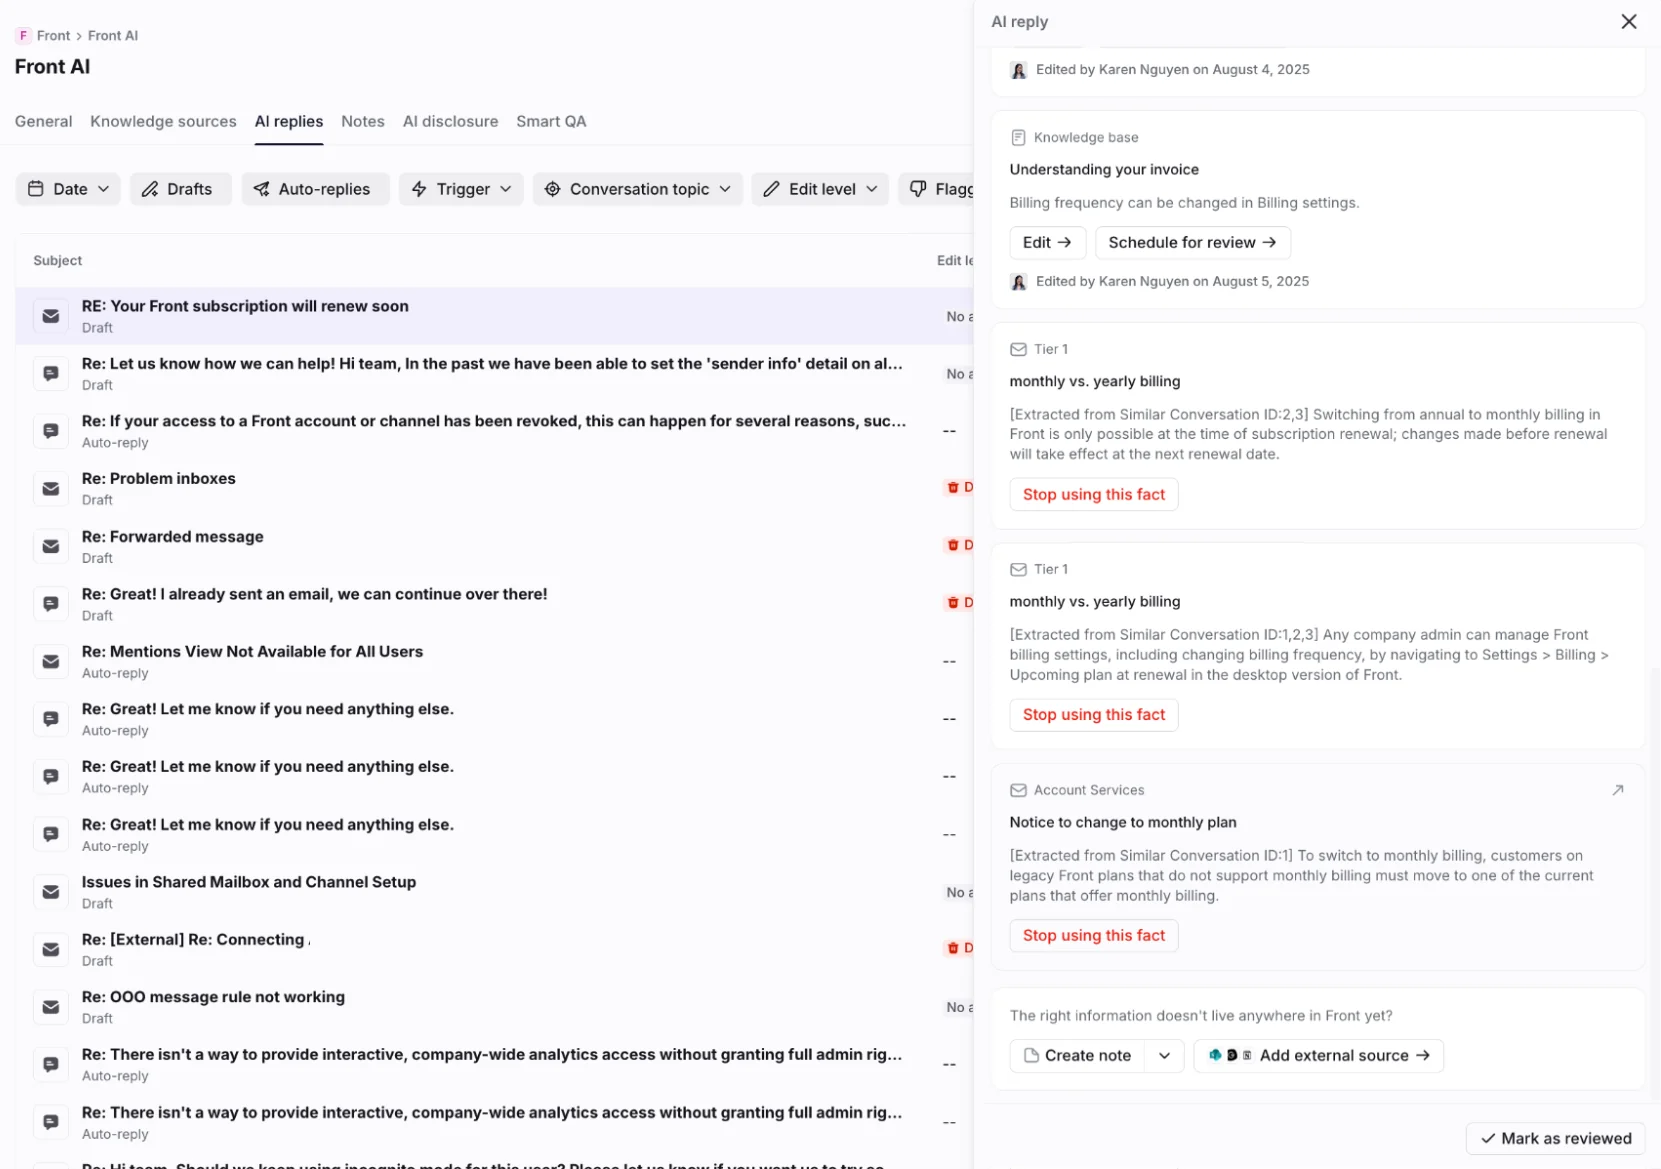
Fronts AI-Replies-Hub. Kein Ursachencode, aber der schnellste Korrekturweg, den ich gesehen habe: jede Quelle hinter einer Antwort, mit dem genauen Auszug, und direkte Aktionen Edit, „Stop using this fact“ und Create note.
Hat Ihr Helpdesk nichts davon, funktioniert ein Ticket-Tag pro Block gut. Halten Sie die Liste kurz. Sechs Tags werden genutzt, dreißig ignoriert. Mein Leitfaden zum KI-Support-Tagging zeigt, wie Sie sie anwenden, ohne Mitarbeitern zusätzliche Klicks aufzubürden.
Das System beheben, nicht die Person
Fehleranalyse funktioniert nur, wenn Menschen Ihnen von Fehlern erzählen. Das hört auf, sobald sie zum Mittel wird, Leute zu ertappen. Mitarbeiter sind klar darüber, wie sich das anfühlt:
"Hold hands up it was something I missed (or didn't consider) but the complaint feedback was otherwise good so it stung to get a fail rather than a learning and fix it"
Manchmal ist die Kennzahl selbst die Ursache. Ein Mitarbeiter beschrieb, dass er für Warteschleifen über drei Minuten bestraft wurde, obwohl die Bestätigung der richtigen Antwort drei Minuten oder mehr dauert:
"If I put them on hold that long, some get annoyed or escalate. Either way, I'm doomed: penalized if you placed the caller on hold for more than 3 mins or returned back to the caller and tell them you needed more time."
Wenn ein Ziel Menschen dazu drängt, zu antworten, bevor sie geprüft haben, sind falsche Antworten das vorhersehbare Ergebnis. Nehmen Sie „die KPI“ in Ihre Blockliste auf, wenn sie auftaucht. Mein Beitrag zu Kundenservice-KPIs behandelt, welche nach hinten losgehen.
Nichts davon heißt, dass niemand Verantwortung trägt. Die Unterscheidung, die ich mag, stammt aus einem Thread zu schuldfreien Reviews: Menschen werden "still held to account for their decisions and actions but are not blamed for their results." Ein Mitarbeiter, der den Artikel übersprungen hat, sollte das hören. Ein Mitarbeiter, der einem falschen Artikel gefolgt ist, sollte ein Dankeschön fürs Finden bekommen.
So sieht eine gute Schleife in der Praxis aus, von einem Mitarbeiter, dessen Team es richtig macht:
"But where I work if an agent finds inaccurate information, requests information, or has figured something out that isn't in KB all we have to do is send a message to our supervisor and they pass it along to our head of sales, and the next day KB is updated."
KB-Updates am nächsten Tag. Das ist das Ziel. Kombinieren Sie es mit einem regelmäßigen Audit der Wissensdatenbank und einer Wissenslückenanalyse und nutzen Sie Mitarbeiter-Feedback-Gespräche für die Fehler, die wirklich individuell sind.
Dasselbe gilt für eine KI. Ein HN-Kommentator sagte zum Fehler eines menschlichen Mitarbeiters, er wolle "better training/docs so it doesn't happen again", niemanden, der gefeuert wird. Behandeln Sie die KI genauso und leiten Sie wiederholte menschliche Fehler ins Coaching statt in Abmahnungen.
Wie eesel die Fehleranalyse handhabt
Ich baue bei eesel KI-Agenten, daher sage ich konkret, was unsere hier tut und was nicht.
Sie zeigt ihre Arbeit bei jedem Ticket. Jeder Lauf auf eesels Activity-Seite zeigt, wo er stattfand, was ihn ausgelöst hat, welche Quellen sie durchsucht hat, was sie getan hat, ihre Begründung Schritt für Schritt und ob sie auf eine Wissenslücke gestoßen ist. In Zendesk nennt jeder Entwurf seine Quellen. Eine falsche Antwort zu labeln dauert also einen Klick in den Lauf, kein Raten.

Korrekturen werden zu Regeln. Wenn eine Antwort falsch ist, sagen Sie ihr, was falsch war, im Ticket oder im Chat, und sie schreibt die Korrektur in ihre eigenen Anweisungen oder bearbeitet die bestehende Regel, falls eine schon passt. Ein Zendesk-Admin brachte ihr eine Korrektur für den Richtlinien-Block in zwei Zeilen bei: "I have a rule in CS where we do not address a cancel or refund request when there is an issue attached to it." Dann, beim nächsten Entwurf: "This is incorrect. You have not provided troubleshooting steps yet." Diese Regel gilt jetzt für jedes künftige Ticket, nicht nur für dieses.
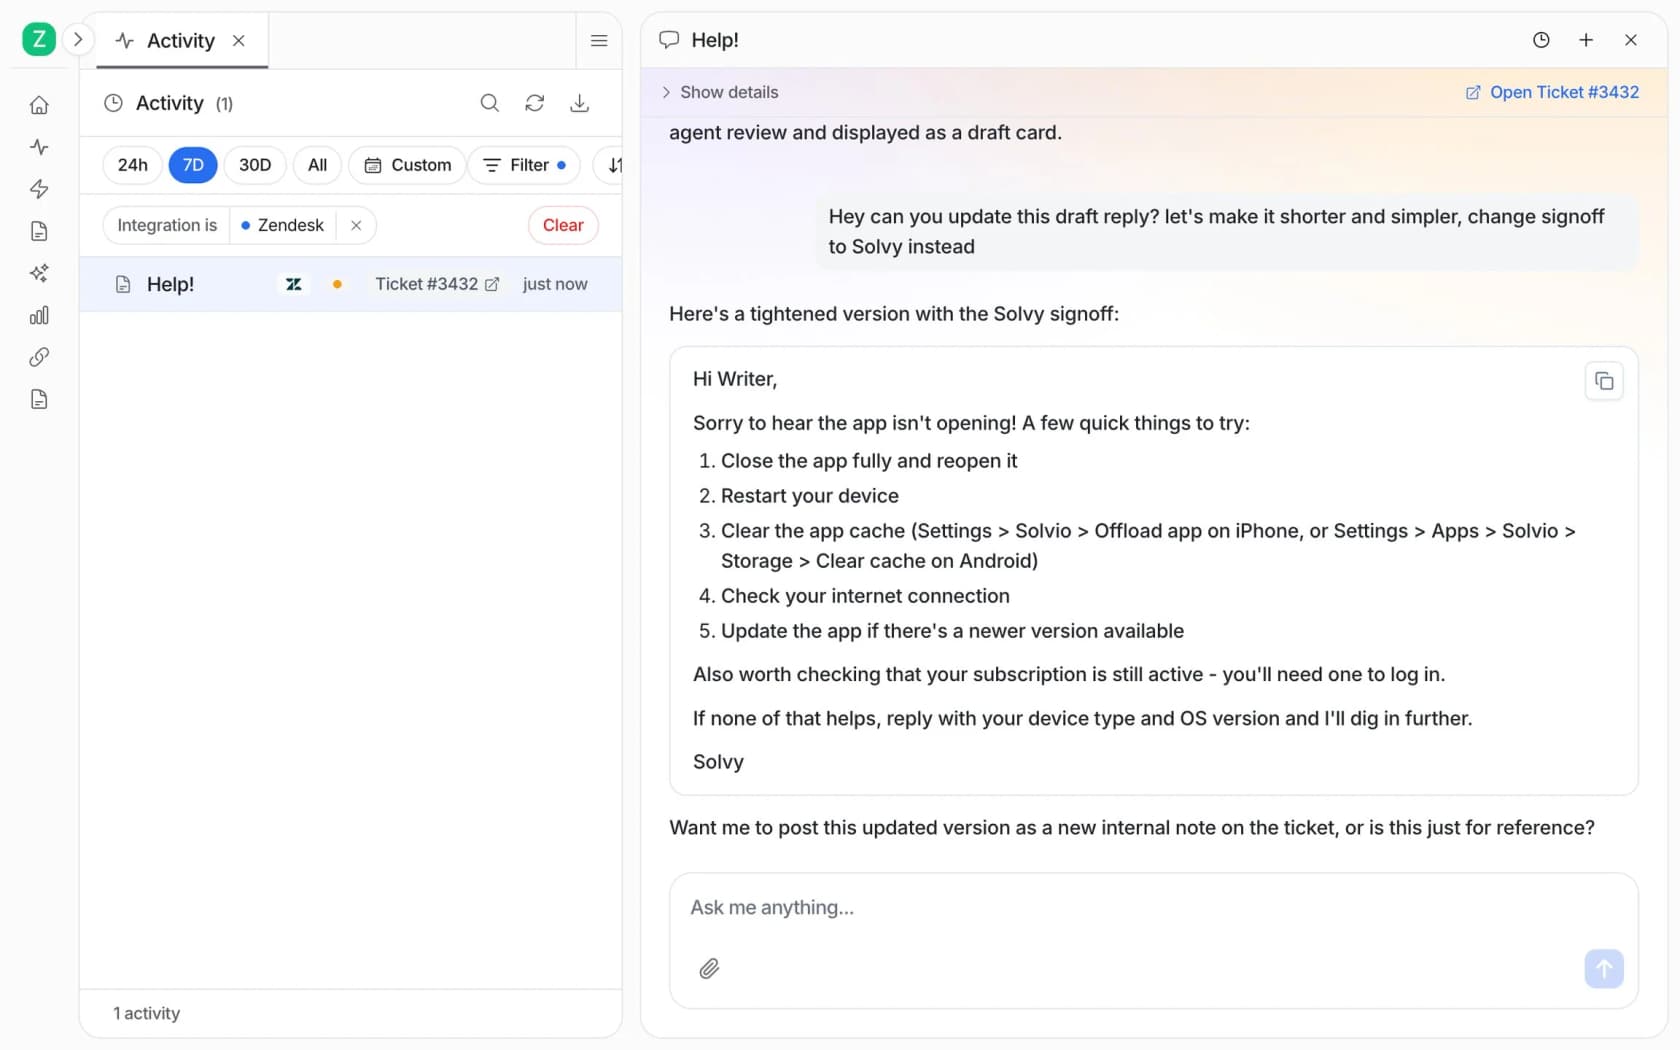
Sie findet das Muster für Sie. Der Skill „Analyze and improve replies“ betrachtet, was Ihr Team abgelehnt oder bearbeitet hat, findet das Muster und schlägt Korrekturen vor. Das sind die Schritte drei bis fünf der obigen Methode, auf Ihren eigenen Daten ausgeführt.
Sie spielt echte vergangene Tickets erneut durch. Der Simulations-Skill lässt Ihren Agenten gegen echte gelöste Tickets laufen, vergleicht jede Antwort mit dem, was Ihr Team tatsächlich gesendet hat, bewertet sie nach Ticket-Thema und schlägt Änderungen an den Anweisungen vor. Im Beispiellauf der Doku mit 20 Tickets erreichten 17 die Antwortqualität des Teams, und der Bericht fand, dass die eigentliche Lücke nicht der Wortlaut war, sondern die Aktionen der Mitarbeiter, etwa ein Protokoll prüfen oder an die Technik eskalieren:
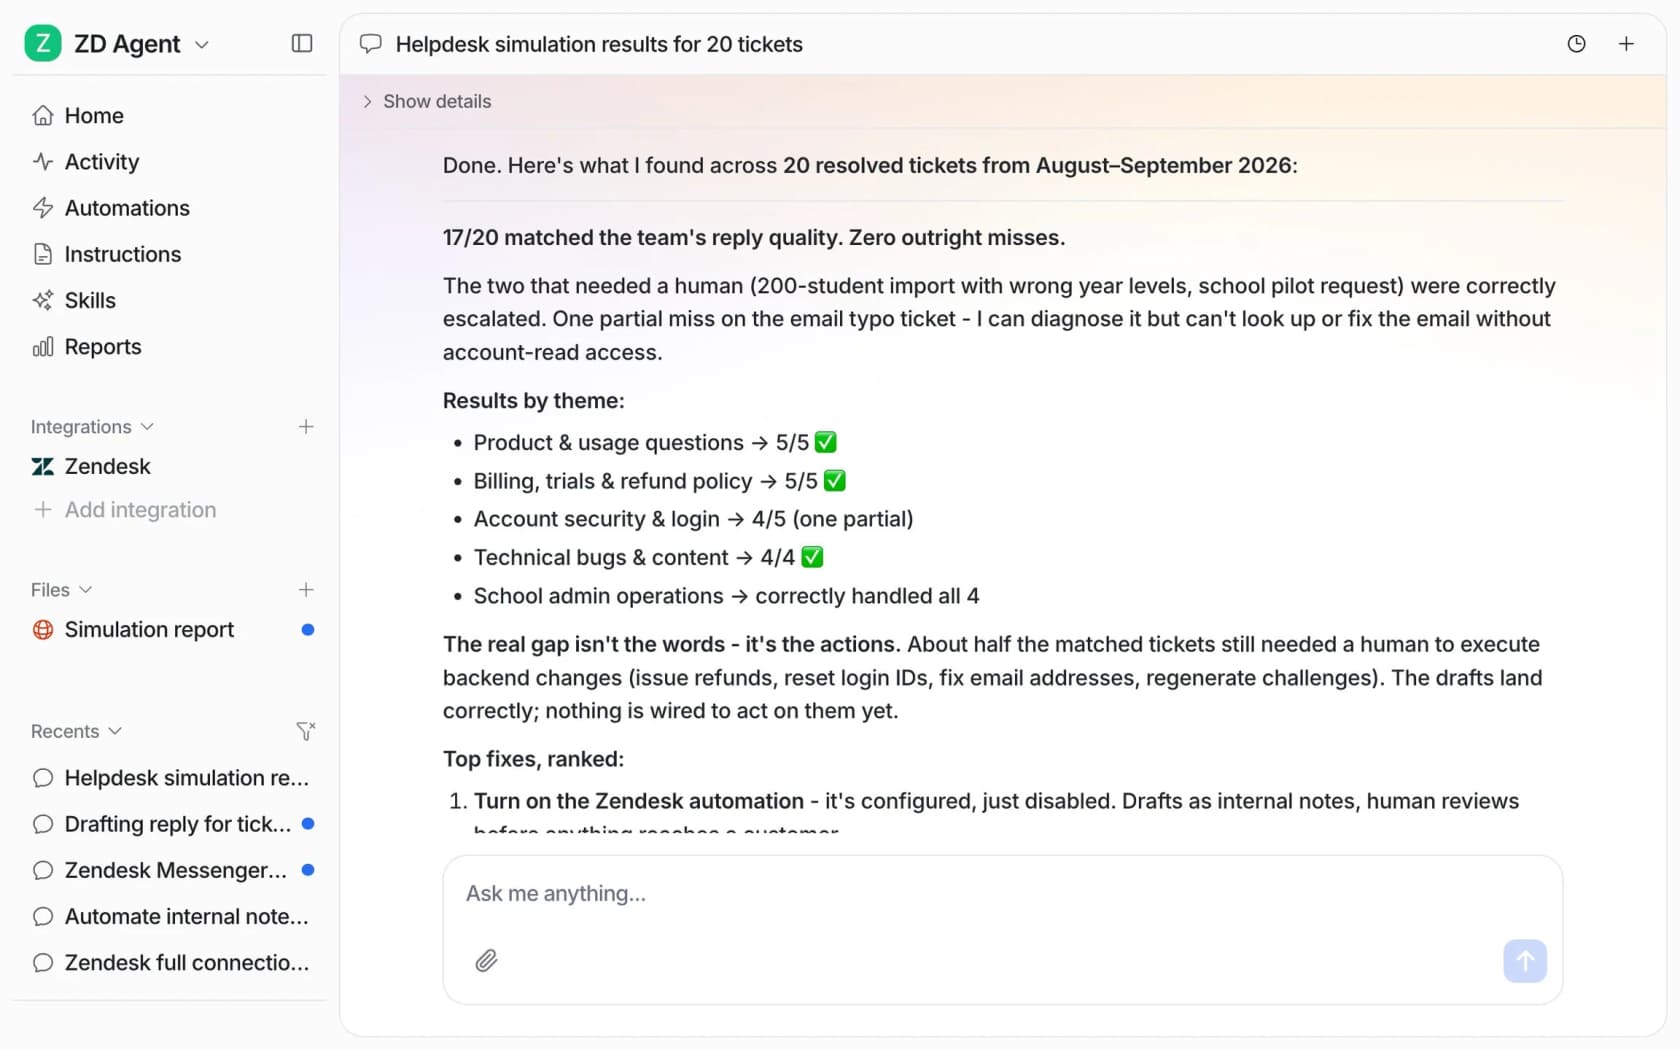
Diesen Schritt würde ich nie überspringen. Es ist der einzige Weg, den ich kenne, um an Dutzenden echter Tickets zu prüfen, dass eine Korrektur gewirkt hat, bevor Kunden sie sehen. Und wenn Ihr Team mit einem Terminal oder Skripten arbeitet, lässt Sie die eesel-CLI den Agenten korrigieren und seine aktuellen Regeln von der Kommandozeile ausgeben, sodass auch ein Coding-Agent den wöchentlichen Review durchführen kann.
Was sie nicht ist: ein Ersatz für eine QA-Scorecard Ihrer menschlichen Mitarbeiter. Ihre KI-CSAT ist die Bewertung der Antworten durch eine KI, kein Kundenfeedback, und ich würde Ihr menschliches QA-Programm parallel weiterlaufen lassen. Meine Übersicht zu Support-QA-Tools behandelt diese Seite.
Führen Sie Ihre Fehleranalyse mit eesel durch
Wenn Ihre KI oder Ihr Team immer wieder dieselben Fehler macht, gibt Ihnen der KI-Helpdesk-Teammate von eesel die Fehlerspur an einem Ort. Er schließt sich Ihrer bestehenden Zendesk-, Freshdesk-, Gorgias- oder Help-Scout-Warteschlange an, protokolliert bei jedem Ticket, was er gelesen hat und warum, macht aus Ihren Korrekturen dauerhafte Regeln und spielt echte vergangene Tickets erneut durch, damit Sie eine Korrektur wirken sehen, bevor sie live geht. Starten Sie ihn mit Entwürfen als interne Notizen, führen Sie eine Simulation mit den Tickets des letzten Monats durch, und Sie haben noch am selben Tag Ihre erste Block-Zählung. Es ist kostenlos mit 100 Credits testbar, und bezahlte Tarife beginnen bei $299 im Monat auf der eesel-Preisseite.