

Was Sprachqualität im Kundensupport wirklich bedeutet
Ich arbeite jeden Tag in der Support-Warteschlange von eesel, und die Antworten, die zu Beschwerden führen, enthalten fast nie einen Tippfehler. Es sind eher die, die vier Absätze lang sind, obwohl der Kunde eine Ja-Nein-Frage gestellt hat, oder die wie eine Rechtsbelehrung klingen, obwohl der Kunde offensichtlich verärgert war. Wenn ein Team sagt "unsere Sprachqualität lässt nach", frage ich deshalb zuerst, welche Ebene gemeint ist.
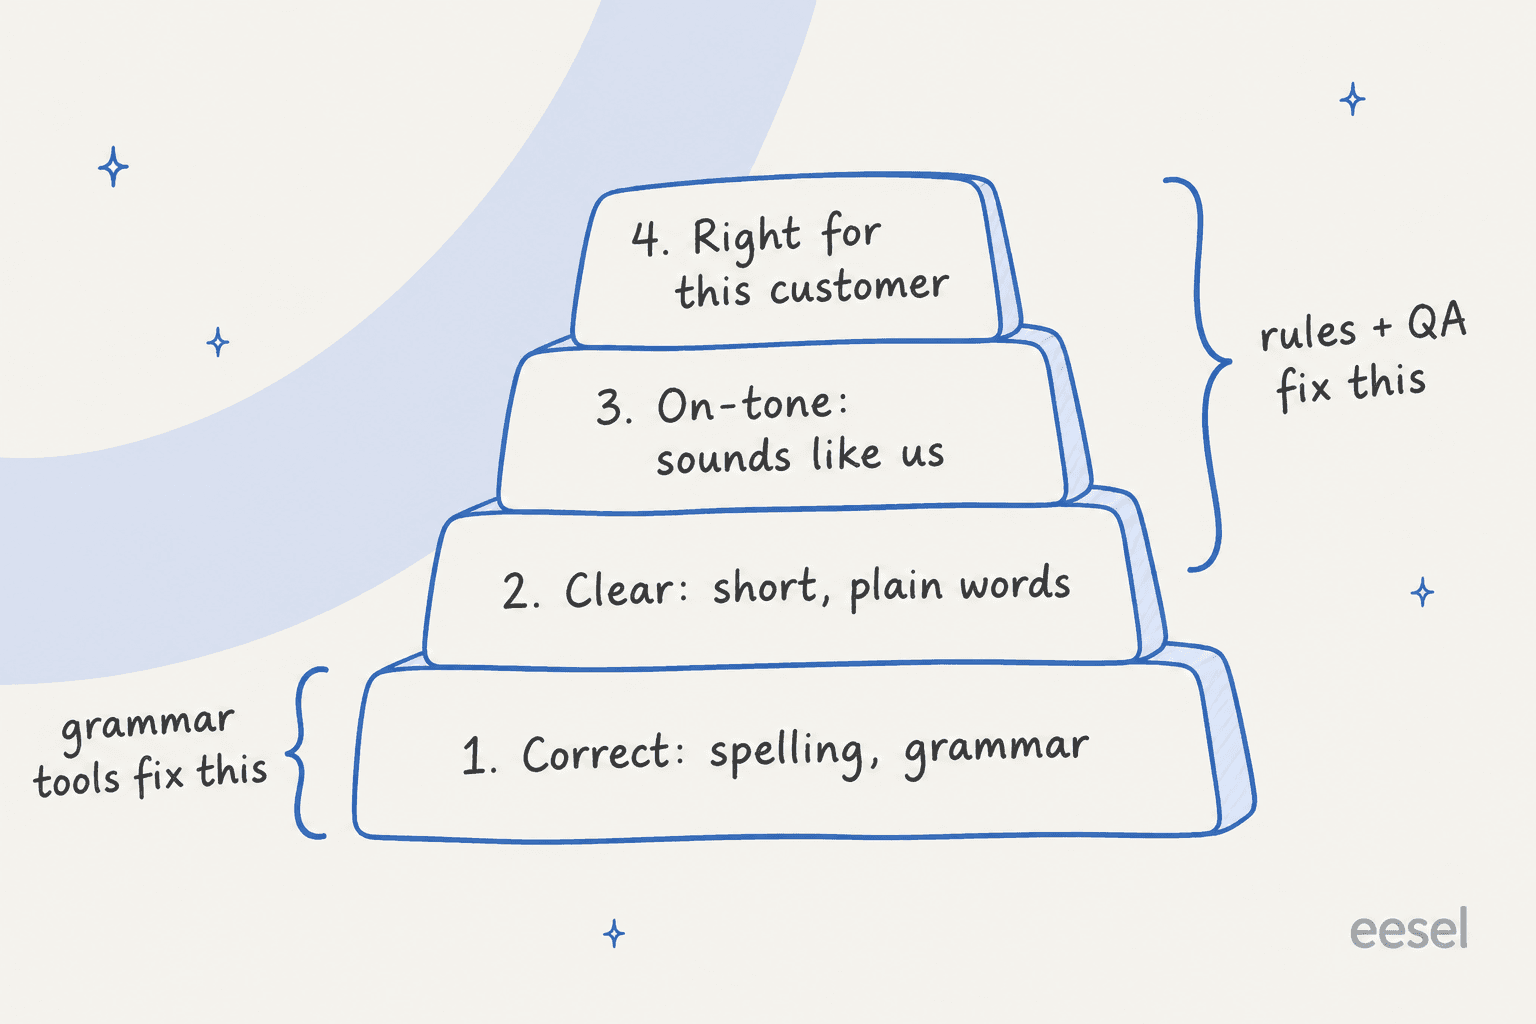
So teile ich es auf:
- Korrekt. Rechtschreibung, Grammatik, Zeichensetzung, Produktnamen so geschrieben, wie Sie sie schreiben. Software ist darin inzwischen sehr gut.
- Klar. Kurze Sätze, einfache Wörter, eine Bitte pro Nachricht, die Antwort vor der Erklärung. Software kann lange Sätze markieren, aber nicht erkennen, dass der Kunde zuerst Schritt 3 brauchte.
- Im passenden Ton. Klingt nach Ihrem Unternehmen, mit der richtigen Wärme. Eine Modemarke für Zwanzigjährige und ein Lohnabrechnungsanbieter sollten dieselbe Rückerstattungsantwort nicht gleich formulieren.
- Passend für diesen Kunden. Seine Sprache, seine Förmlichkeit, seine Stimmung, seine Geschichte mit Ihnen. Diese Ebene bemerkt ein verärgerter Stammkunde.
Der Vorteil dieser Aufteilung: Jede Ebene braucht eine andere Lösung, und die meisten Teams stecken zu viel in Ebene eins und zu wenig in die anderen drei. Wenn Sie bereits ein Übersetzungsglossar für den Support und eine mehrsprachige Einrichtung haben, ist Ebene vier sprachlich weitgehend abgedeckt; offen bleiben Förmlichkeit und Stimmung.
Warum es wichtiger ist, als es aussieht
Kunden lesen Sprachqualität als Hinweis auf Kompetenz. Ist die Antwort schlampig, nehmen sie an, dass es die Lösung auch sein wird. Das zeigt sich immer wieder in öffentlichen Diskussionen, und je größer die Marke, desto härter das Urteil.
"I was shocked by the middle school level English grammar coming from the company's official customer support. Who knew you could get so much wrong in seven sentences! Bad image for a luxury product."

Die überraschendere Variante: Tippfehler können eine echte Antwort gefälscht wirken lassen. Als ein Fan eine echte E-Mail des LEGO-Kundenservice postete, lautete die erste Reaktion im Thread, das könne nicht echt sein.
"Sorry, ain't no way that's legit. The typos, the casual secret-leaking…I'm desperate for more sets just like everyone else, but I highly doubt that actually came from LEGO."

Das ist ein Vertrauensproblem, kein Stilproblem. Kunden sind ohnehin misstrauisch gegenüber Phishing-Mails, und eine Support-Antwort voller Ausrutscher sieht genau wie die Betrugsmasche aus, die Ihr Sicherheitsteam Mitarbeitenden zu ignorieren beibringt.
Und es geht nicht nur um Fehler. Eine Antwort kann grammatikalisch perfekt sein und trotzdem schlecht ankommen, weil sie eine Standardantwort ist, die eingefügt wurde, ohne die Frage zu lesen:
"you'd email with a problem and get a reply that was obviously just someone copying and pasting big chunks of superficially relevant text from some database. So it can happen with people too."
Hier scheitern Ebene zwei und drei, während Ebene eins besteht.
So messen Sie Sprachqualität in Ihrer QA-Scorecard
Was Sie nur bemerken, wenn sich ein Kunde beschwert, können Sie nicht beheben. Der übliche Weg: Sprachkategorien in Ihre Support-QA-Scorecard aufnehmen und jede Woche eine Stichprobe von Tickets bewerten. Der neuere Weg: Software bewertet alle.
Was Zendesk QA automatisch bewertet
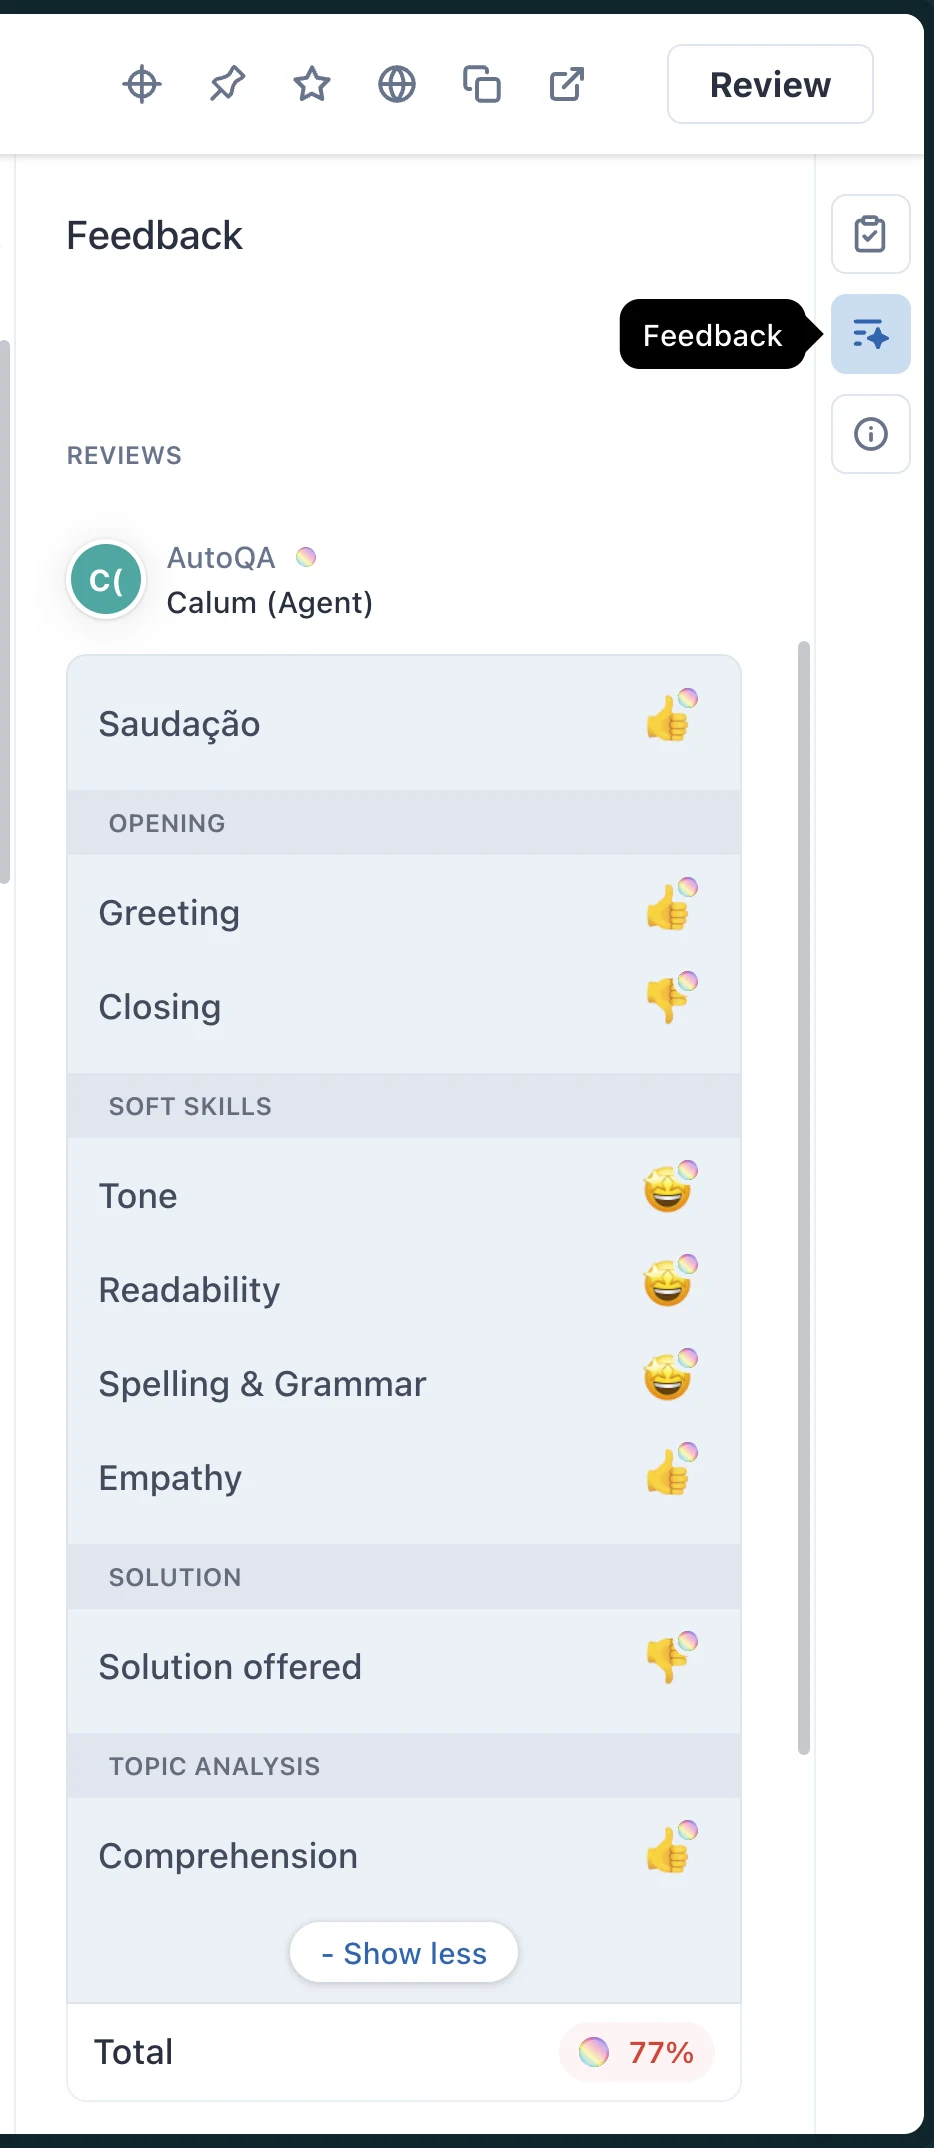
Zendesk QA (das Produkt, das früher Klaus hieß) ist das klarste Beispiel für automatische Sprachbewertung, das ich gefunden habe, weil jede Kategorie dokumentiert ist. Die Funktion AutoQA liefert acht Systemkategorien, die standardmäßig automatisch bewertet werden, über "100% of your ticket volume":
| AutoQA-Kategorie | Was geprüft wird | Bewertungsart | Sprachen |
|---|---|---|---|
| Rechtschreibung und Grammatik | Grammatikfehler, Tippfehler und Stilfehler, jeder Fehler wird markiert | Anpassbar | 9 Varianten: Englisch (US, UK), Deutsch, Französisch, Polnisch, Spanisch, Portugiesisch (Brasilien, Portugal), Niederländisch |
| Lesbarkeit | Wortkomplexität und Satzlänge | Feste 3-Punkte-Skala | Nur Englisch und Spanisch |
| Tonalität | Gewichtung positiver oder negativer Tonalität | Anpassbar | Alle, aber nur mit aktivierter LLM-Einstellung |
| Empathie | Ob der Agent auf das Anliegen des Kunden einfühlsam einging | Daumen hoch/runter | Alle, nur LLM |
| Verständnis | Ob der Agent das Problem verstanden hat | Daumen hoch/runter | Alle, nur LLM |
| Begrüßung | Ob der Agent den Kunden begrüßt hat | Daumen hoch/runter | Alle mit LLM; 8 Sprachen ohne |
| Abschluss | Ob der Agent angemessen abgeschlossen und weitere Hilfe angeboten hat | Daumen hoch/runter | Alle mit LLM; 8 Sprachen ohne |
| Angebotene Lösung | Ob der Agent eine Lösung vorgeschlagen hat | Daumen hoch/runter oder N/A | Alle, nur LLM |
Alle Zeilen stammen aus dem Artikel von Zendesk zu den Kategorien der automatischen Bewertung.
Einige Details sind wichtiger, als die Tabelle vermuten lässt:
- Die reinen Schreibprüfungen haben die schmalste Sprachabdeckung. Rechtschreibung und Grammatik deckt 9 Sprachvarianten ab, die Lesbarkeit nur Englisch und Spanisch. Wenn die Hälfte Ihrer Tickets auf Italienisch oder Japanisch kommt, bleiben diese beiden Kategorien für diese Hälfte stumm.
- Die Tonalitätsbewertung ändert sich am 6. Oktober 2026. Zendesk kündigte an, dass sich die Tonalitätsbewertung künftig "focus exclusively on concrete, professional conduct, such as whether a response is polite or impolite" konzentriert, mit neuen Labels für Wärme, Hilfsbereitschaft, Höflichkeit und Empathie. Zendesk warnt, Teams "might see an average decrease of 15% in their tone scores". Wenn Ihre Tonalitätskurve nächste Woche fällt, liegt das wahrscheinlich am Modell, nicht an Ihrem Team.
- Auch Bots werden bewertet. AutoQA prüft Rechtschreibung und Grammatik "in both agent and bot interactions", und laut der Zendesk-QA-Seite werden Tickets von KI-Agenten "without extra charge" analysiert. Das ist nützlich, wenn Sie KI-Agenten bewerten und dieselbe Scorecard wie für Menschen verwenden.
- Kurze Tickets werden übersprungen. Ein Ticket braucht eine Kundennachricht, eine Agentennachricht und mindestens 10 Wörter und wird erst bewertet, wenn es Gelöst oder Geschlossen ist.
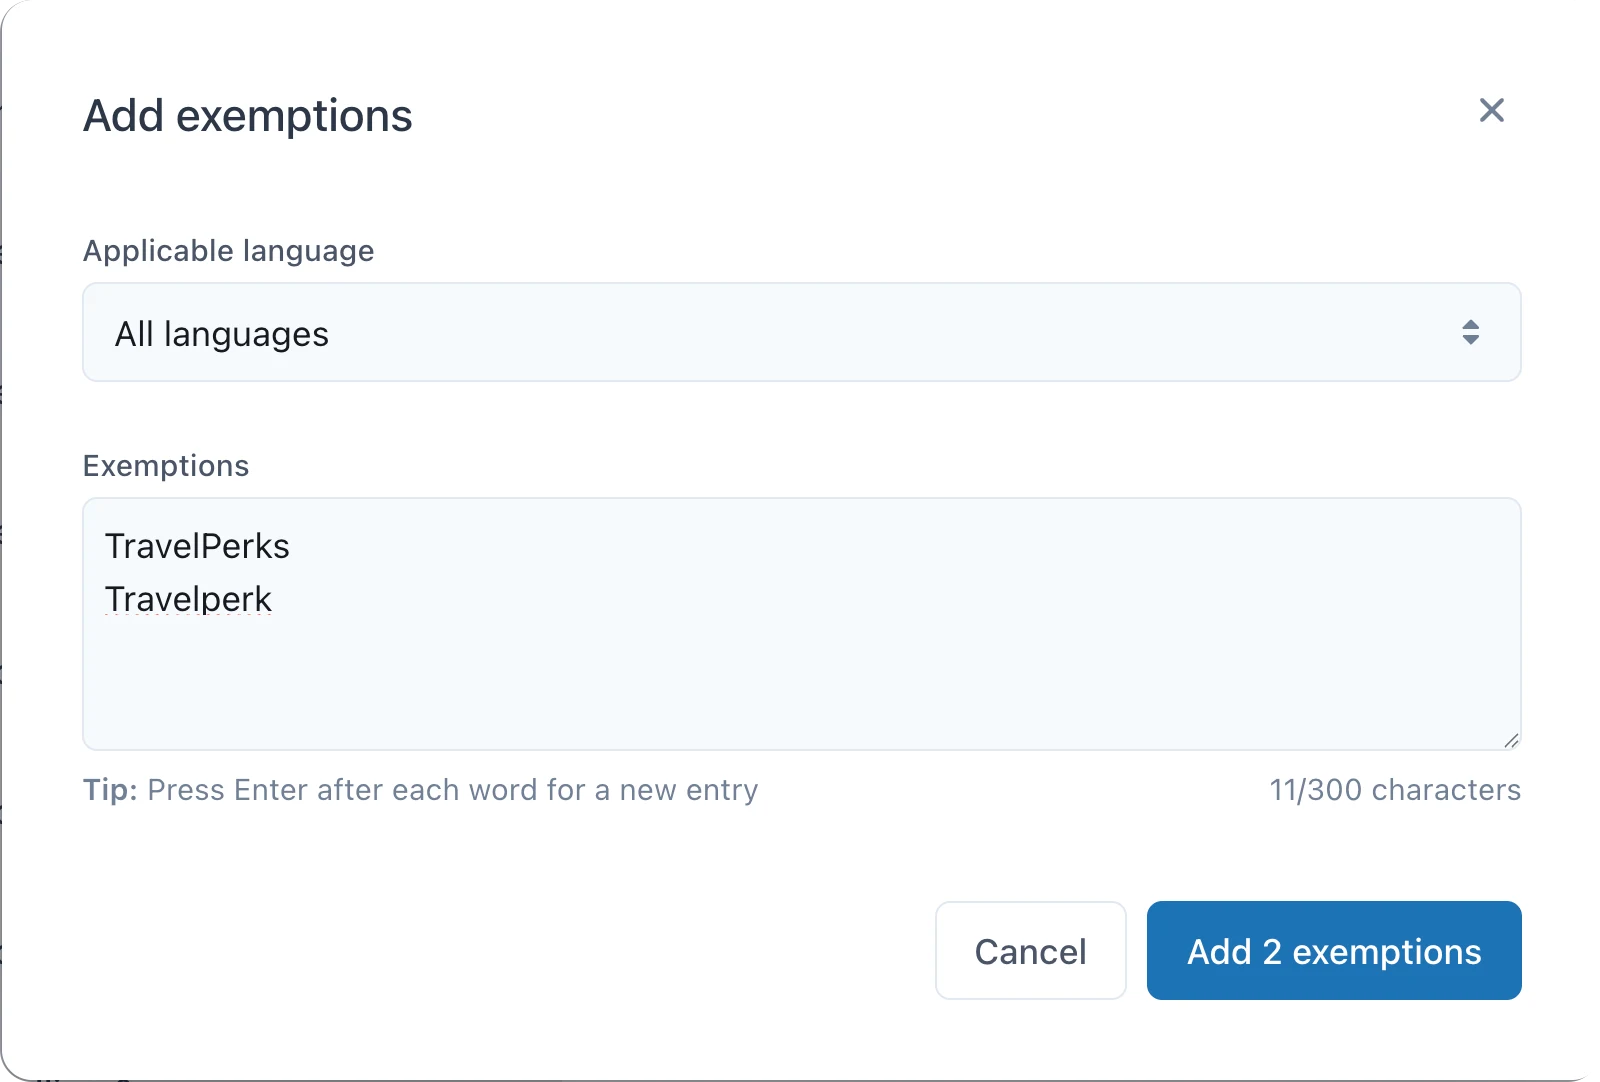
Sie können der Rechtschreibprüfung auch Ihr eigenes Vokabular beibringen. Admins können bis zu 300 Ausnahmen pro Sprache hinzufügen, dort gehören Produktnamen, SKUs und Markenschreibweisen hin, damit sie nicht mehr als Tippfehler zählen.
Der Haken, auf den ich jede Teamleitung hinweisen würde: Zendesk selbst sagt, automatische Bewertungen seien „nur zur Orientierung“ und sollten keine Leistungsentscheidungen steuern. Der automatische Wert (AQS) fließt erst in Ihren manuellen Qualitätswert (IQS) ein, wenn ein Mensch die Bewertung abschickt. Nutzen Sie ihn, um Muster zu finden, etwa den Agenten, der jede Woche dieselben drei Wörter falsch schreibt, und coachen Sie dann genau dazu.
Beim Preis braucht AutoQA das QA-Add-on oder das Workforce-Engagement-Add-on, und die Preisseite von Zendesk nennt keinen eigenständigen QA-Preis. Das gelistete Workforce Engagement Bundle kostet 50 $ pro Agent und Monat bei jährlicher Zahlung, zusätzlich zu Ihrem Zendesk-Tarif (Suite Team ab 55 $).
Was andere QA-Tools leisten
Andere QA-Plattformen lassen Sie meist eine Sprachprüfung selbst bauen, statt eine fertige mitzuliefern:
- Rippit (früher MaestroQA) hat sich als KI-zentrierte Plattform neu aufgestellt, die 100 % der Konversationen bewertet, mit QA-Agenten, die Sie selbst definieren. Die Metriken des alten AutoQA basieren auf LLM, Phrasenabgleich und Prozessen, Grammatik ist also eine eigene Metrik, die Sie schreiben. Die veröffentlichten Tarife sind Free (100 Agentenläufe), Starter für 185 $/Monat und Growth für 495 $/Monat.
- evaluagent bewertet qualitative Punkte über eigene Scorecard-Zeilen statt über einen eigenen Grammatikwert, ab 35 $ pro Nutzer und Monat.
Wenn Sie Zendesk nutzen, zeigt mein Leitfaden zu KI für Zendesk, was auf QA aufsetzt. Wenn Sie Plattformen vergleichen, gehen meine Übersichten zu KI für Support-QA und Qualitätssicherung im Callcenter tiefer.
So verbessern Sie die Sprachqualität, bevor die Antwort rausgeht
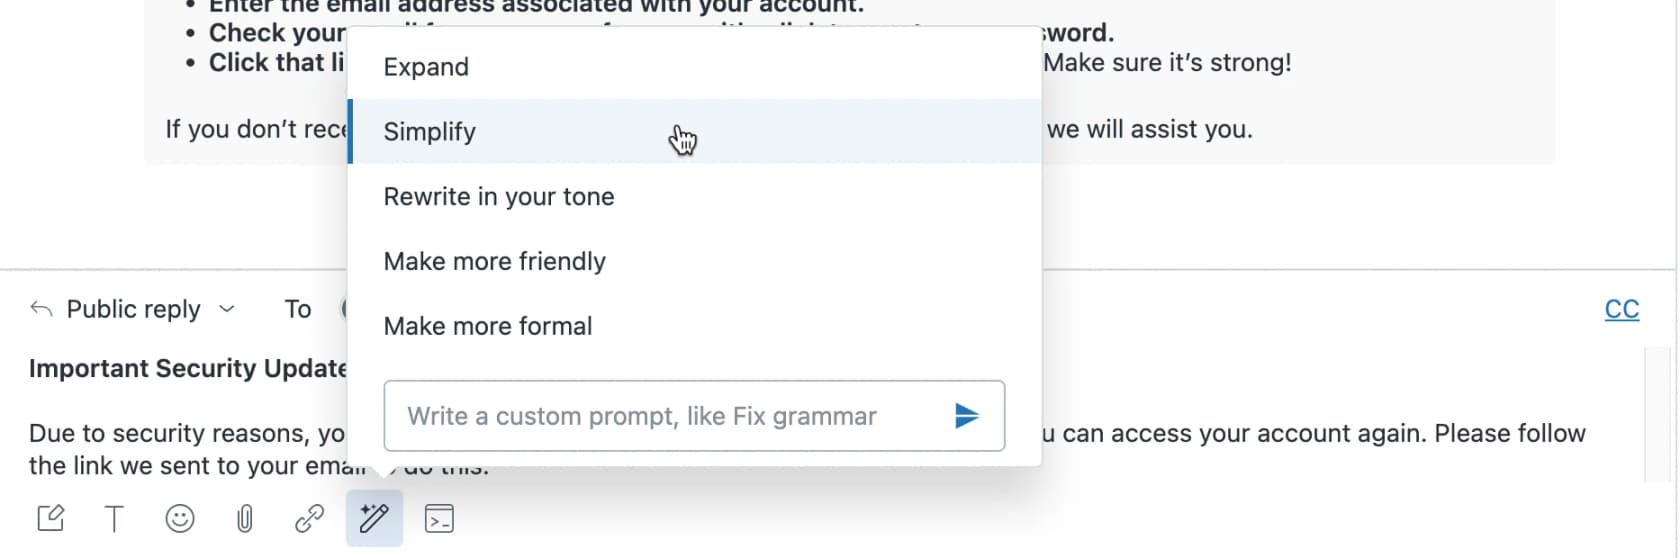
Nachträgliches Messen zeigt, wo die Probleme liegen. Vor dem Senden zu korrigieren verhindert, dass sie bei Kunden ankommen. Jeder große Helpdesk hat inzwischen irgendein KI-Schreibmenü im Editor, aber die Optionen unterscheiden sich stärker, als man erwartet. Nur einige haben eine benannte Grammatikkorrektur.
| Helpdesk | Funktion | Grammatikoption? | Optionen für Tonalität und Länge | Voraussetzung | Preis |
|---|---|---|---|---|---|
| Zendesk | Enhance writing | Keine benannte Option (nur eigener Prompt) | Expand, Simplify, Make more friendly, Make more formal, Rewrite in your tone | Professional+ bekommt 5 Nutzungen pro Agent und Monat, gemeinsam gezählt; unbegrenzt mit Copilot | Copilot 50 $/Agent/Monat, jährliche Zahlung |
| Freshdesk | Writing Assistant | In Rephrase enthalten ("clarity, grammar, and accuracy") | More formal, Less formal, Expand, Expand as email | Pro oder Enterprise plus Freddy AI Copilot | Add-on 29 $/Agent/Monat |
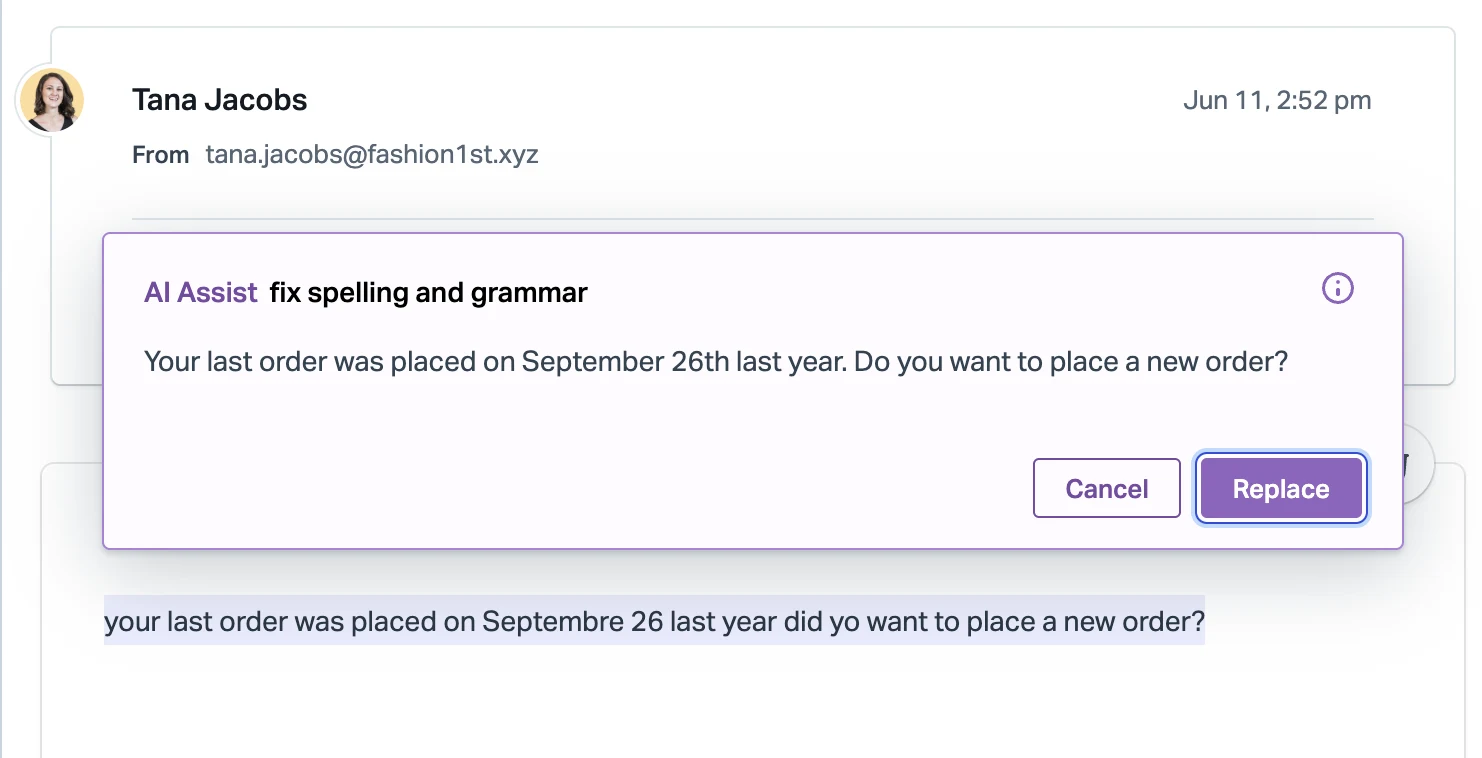
| Help Scout | AI Assist | Ja: Fix spelling and grammar | Longer, Shorter, Friendlier, More professional, Translate | Plus oder Pro (Tarife pro Nutzer) | Inklusive |
| Front | Compose | Ja: Rechtschreibung, Zeichensetzung, Grammatik | Tonalität, erweitern oder kürzen, übersetzen (18 Sprachen) | Ab Starter; eigene Prompts brauchen Copilot | Inklusive (200 Nutzungen/Tag); Copilot 20 $/Platz/Monat |
| HubSpot | KI-Assistent (Konversations-Posteingang) | Ja: Proofread | Change tone, Rewrite, Expand, Shorten | Alle Tarife, auch Free | Inklusive (1.000 Nutzungen/Tag) |
| Gorgias | Für Agentenentwürfe nichts dokumentiert | Nein | Nur Übersetzung | Alle Tarife | Inklusive |
Quellen: jeweiliges Hilfecenter des Anbieters, geprüft am 05.10.2026. Die kostenlose Schreibstufe von Zendesk ist auf 500 Nutzungen pro Konto und Monat begrenzt.
Zwei Dinge fallen auf. Erstens: Das Schreibmenü von Zendesk hat keinen Grammatik-Button; im Feld für eigene Prompts steht sogar der Vorschlag, selbst "Fix grammar" einzutippen, und die kostenlose Stufe ist nach 5 Nutzungen pro Agent und Monat aufgebraucht. Zweitens: Der Proofread von HubSpot ist in jedem Tarif enthalten, aber die eigene Dokumentation von HubSpot warnt, er "tends to produce inconsistent results in non-English languages". Meine Beiträge zu KI-Tonalitätsvorschlägen in HubSpot und Front AI Compose behandeln beide genauer.
Die Version von Help Scout, enthalten in den Tarifen Plus und Pro (Preise), ist die sauberste Ein-Klick-Korrektur, die ich in einem Editor gesehen habe:
Bei Freshdesk steckt der Writing Assistant hinter dem Add-on Freddy AI Copilot, das nur in Pro (55 $) und Enterprise (89 $) funktioniert. Meine Aufschlüsselung der Freddy-Copilot-Preise zeigt, was das pro Platz ergibt.
Eigenständige Grammatik-Tools für Support-Teams
Wenn die eingebaute Option Ihres Helpdesks dünn ist, deckt ein browserbasiertes Grammatik-Tool alle Helpdesks auf einmal ab. Diese drei würde ich mir ansehen:
| Tool | Preis | Stilregeln fürs Team | Helpdesk-Abdeckung | Sprachen | Gut zu wissen |
|---|---|---|---|---|---|
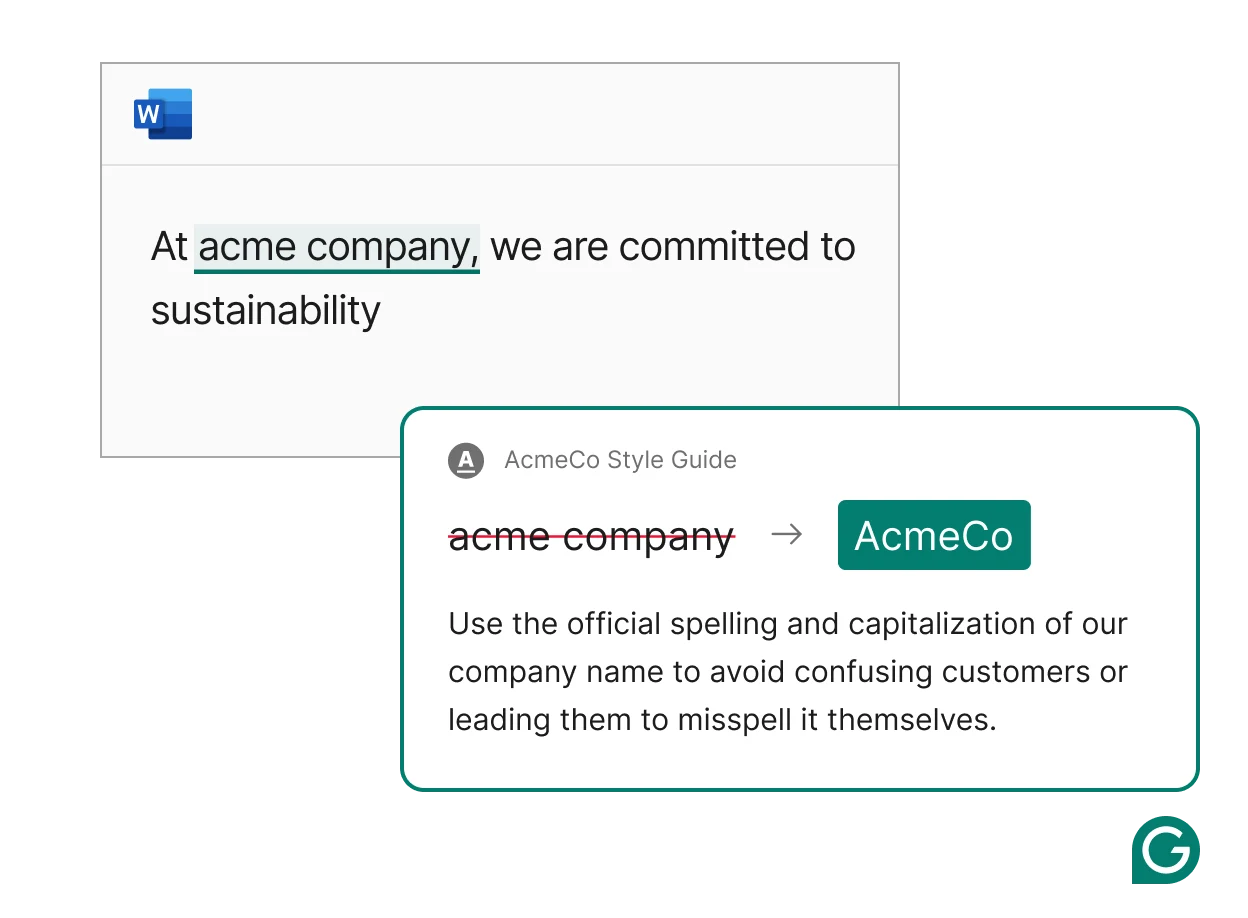
| Grammarly | Free; Pro 12 $/Mitglied/Monat jährlich (30 $ monatlich); Enterprise individuell | Pro: 1 Styleguide, 1 Markentonalität. Enterprise: unbegrenzt | Browser-Erweiterung; Zendesk, Gmail und Salesforce ausdrücklich genannt | 23 genannt | Feedback zur Markentonalität lässt sich auf die Website Ihres Helpdesks beschränken |
| Sapling | Free; Pro 25 $/Monat (12 $ jährlich); Enterprise ab 10 Plätzen für 15 $/Platz/Monat | Snippets, Team-Steuerung in Enterprise | 26 Support-Integrationen, u. a. Zendesk, Freshdesk, Gorgias, Help Scout | Mehrere (Spanisch, Französisch, Deutsch, Portugiesisch, Italienisch, Chinesisch, Japanisch genannt) | Self-Hosting, SOC 2 Type II, HIPAA mit BAA |
| LanguageTool | Teams 66,40 $/Nutzer/Jahr (20 % Aktionspreis am 05.10.2026) | Team-Styleguide und Team-Wörterbuch | Nur Browser-Add-on | 31 gelistet, am stärksten in etwa 7 | Günstigster Preis pro Platz für einen Team-Styleguide |
Grammarly ist aus gutem Grund der Standard: Seine Stilregeln erzwingen die Schreibweise Ihrer Produktnamen, und Markentonalitäten geben Agenten beim Tippen Feedback zur Tonalität. Die Grenze bei Pro ist je eine davon, ein Unternehmen mit zwei Marken braucht also Enterprise. Meine Liste der Grammarly-Alternativen deckt den Rest ab.
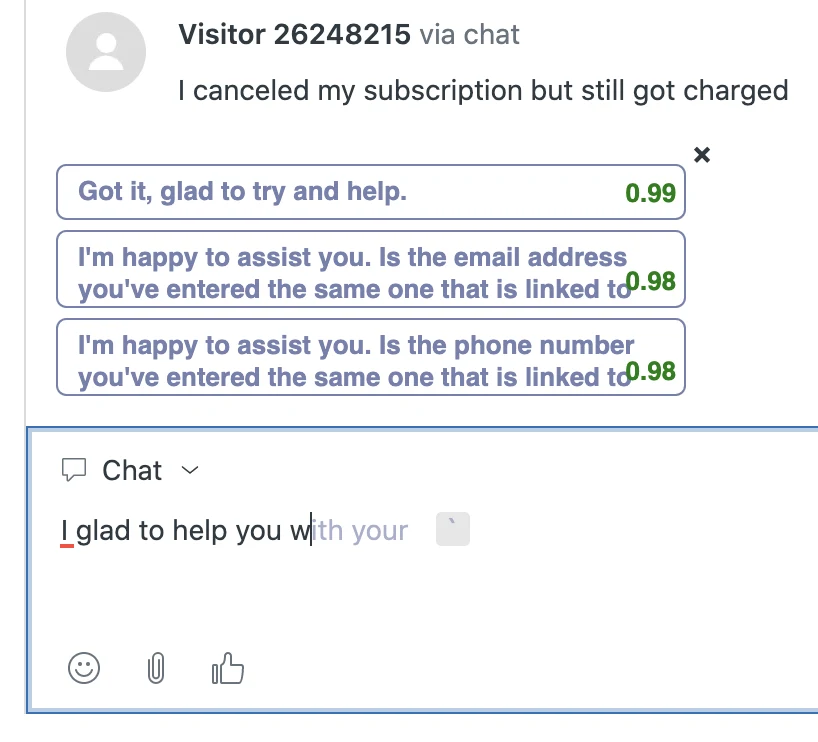
Sapling ist das Tool, das speziell für Support gebaut wurde. Es läuft in der Zendesk-Agentenansicht mit Grammatikprüfung plus Autovervollständigung und Antwortvorschlägen:
Alle drei korrigieren die Wörter. Keines weiß, ob die Antwort stimmt, ob sich die Rückerstattungsregel letzte Woche geändert hat oder ob dieser Kunde schon dreimal geschrieben hat. Das ist die Obergrenze der untersten Ebene.
Wo Fehler abgefangen werden: drei Kontrollpunkte
Fasst man Messen und Korrigieren zusammen, gibt es drei Stellen, an denen eine Antwort abgefangen werden kann, und ein gutes Setup nutzt alle drei für unterschiedliche Aufgaben.
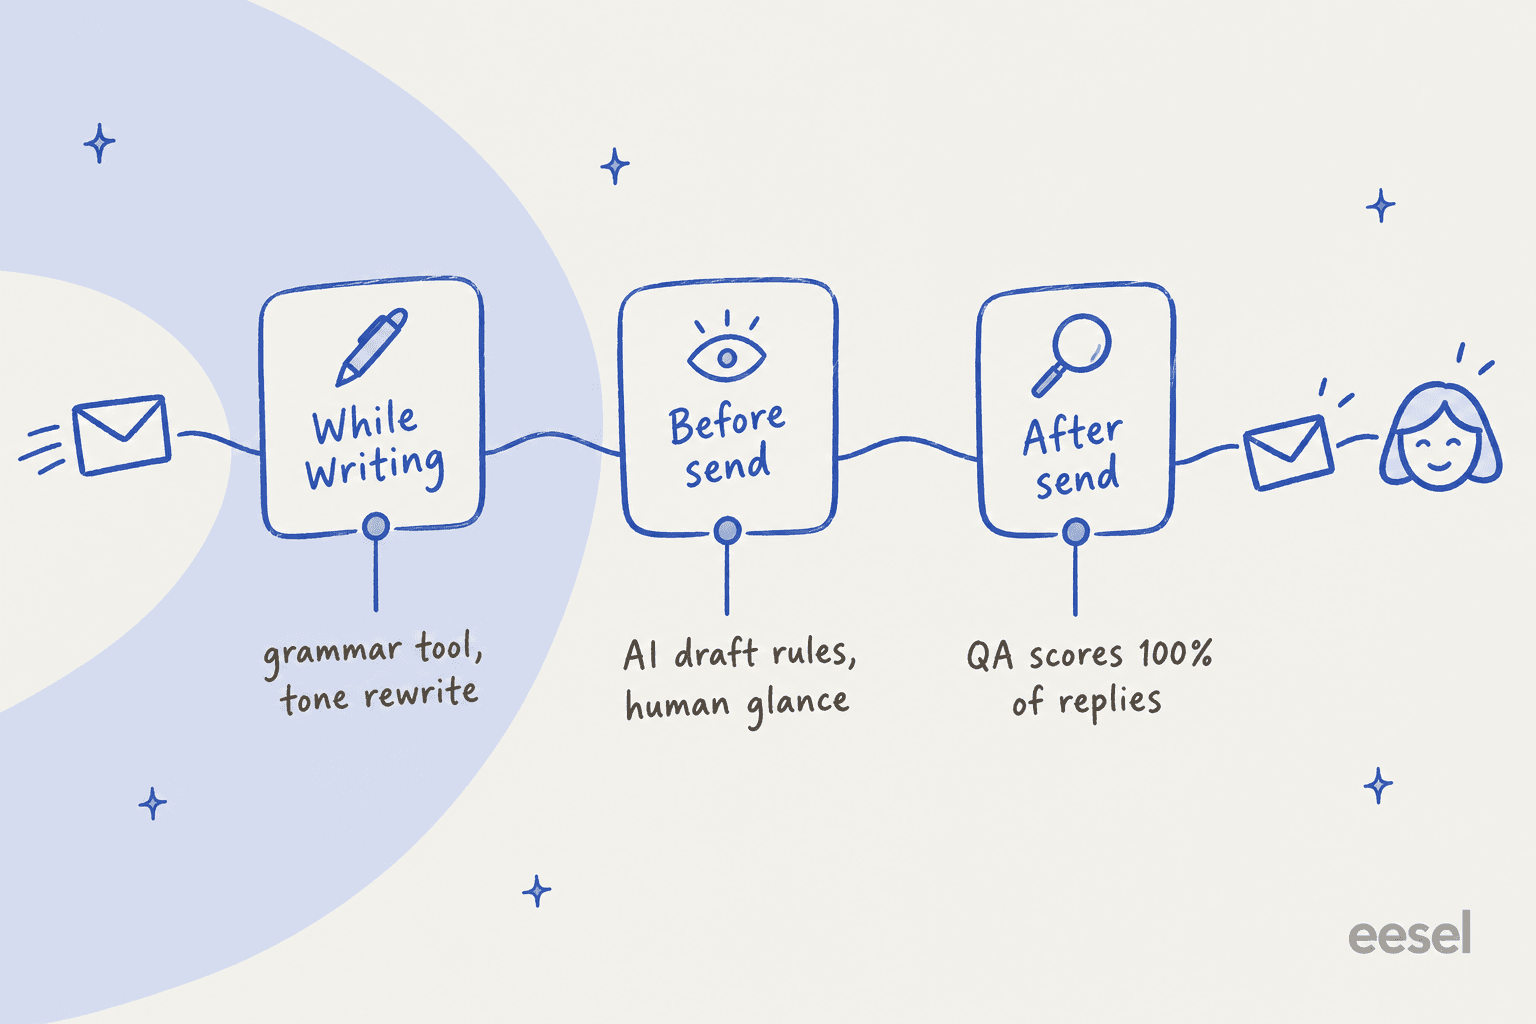
- Beim Schreiben: Ein Grammatik-Tool oder das KI-Menü im Editor kümmert sich um Ebene eins. Günstig, sofort, und nach einer Woche denken Agenten nicht mehr darüber nach.
- Vor dem Senden: Regeln für Tonalität und Länge, angewendet vom Agenten oder von der KI, die die Antwort entwirft. Hier wird der Großteil der Qualität gewonnen oder verloren.
- Nach dem Senden: QA-Bewertung findet die Muster, etwa den Agenten, der sich zu oft entschuldigt, oder das Makro, das alle verwirrt. Geben Sie das in Kontrollpunkt 2 zurück.
Die meisten Teams, mit denen ich spreche, haben nur Kontrollpunkt 1 und eine manuelle QA-Stichprobe von ein paar Tickets pro Agent und Woche. Die Lücke ist Kontrollpunkt 2.
Was KI-Entwürfe verändern
Das habe ich nicht erwartet, als eesel anfing, Agenten KI-Entwürfe vorzulegen. KI beendet das Problem mit Rechtschreibung und Grammatik im Wesentlichen. Das Problem der Sprachqualität beendet sie nicht. Sie verschiebt es in der Pyramide nach oben.
In einem echten Test lief eesel auf einem E-Commerce-Postfach mit etwa 1.000 Tickets im Monat in Zendesk, und ich habe ausgewertet, was die Agenten mit den Entwürfen machten. Die Entwürfe waren meistens inhaltlich richtig, und nur etwa 5 % der Umformulierungen gab es, weil eesel einen Fakt falsch hatte. Aber Agenten sendeten nur 12 % der Entwürfe unverändert. Das häufigste Muster war "kurz ansehen und umschreiben": Agenten machten aus Entwürfen mit 8 bis 15 Sätzen Antworten mit 1 bis 3 Sätzen, und etwa 65 % der Umformulierungen betrafen Länge und Tonalität.
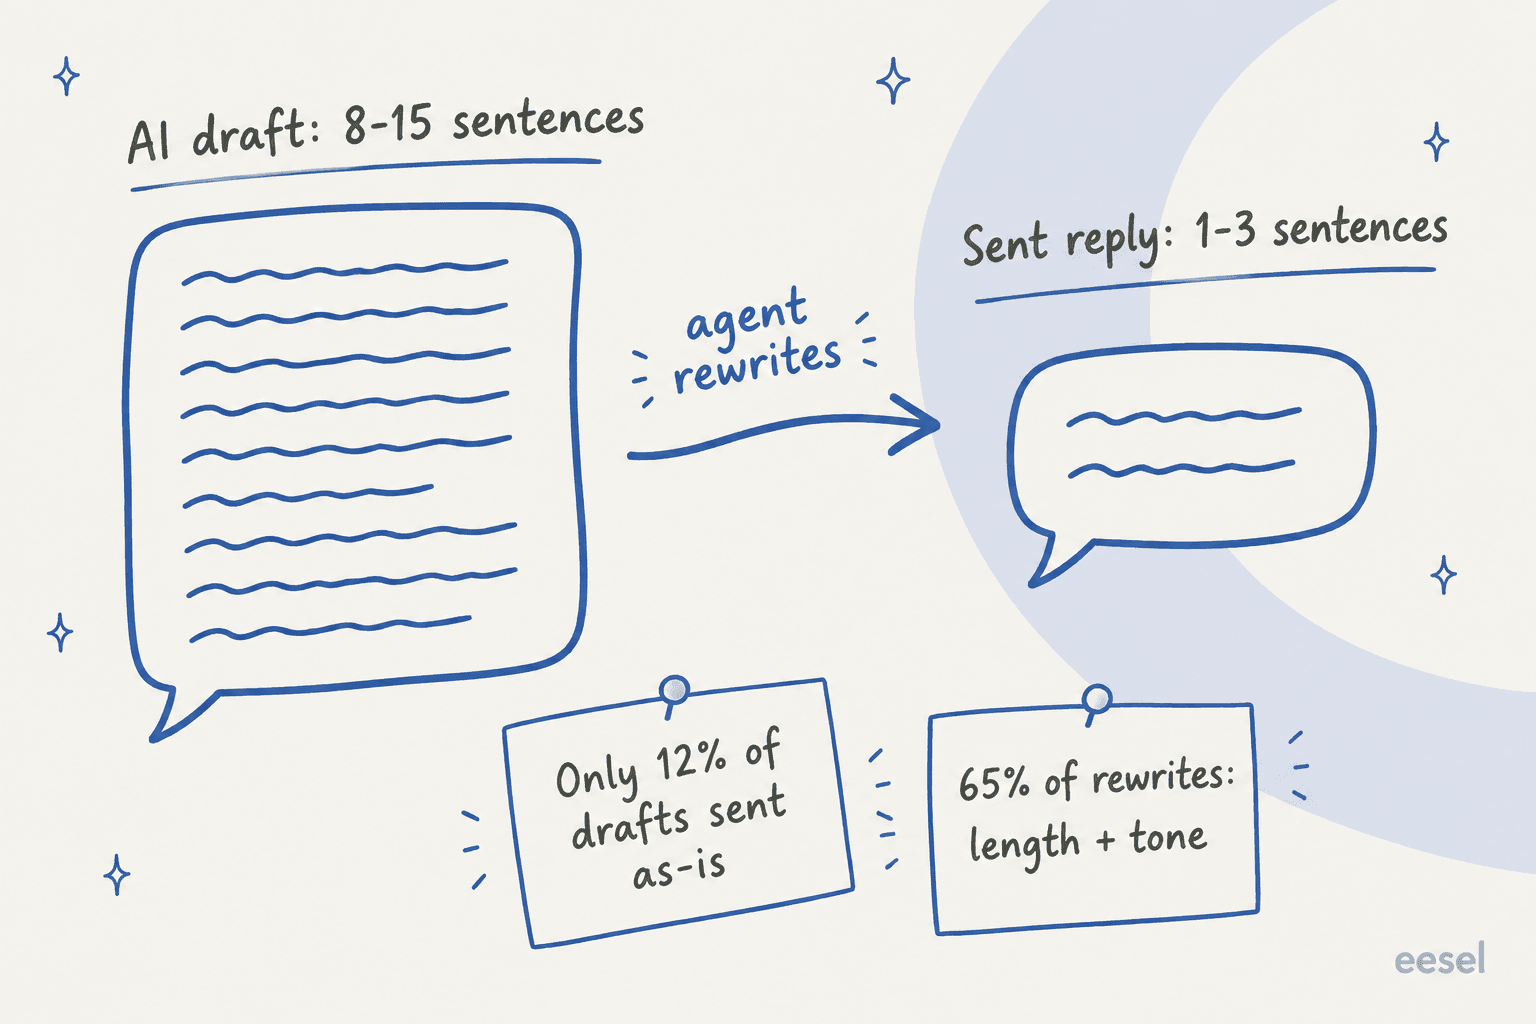
Die Lösung war kein Grammatik-Tool. Sie bestand darin, der KI beizubringen, wie dieses Team tatsächlich schreibt, anhand der bereits gesendeten Antworten. Die Analyse von eesel schätzte, dass ein Training mit etwa 200 aktuellen Agentenantworten die unveränderte Übernahme von 12 % auf 30 bis 40 % steigern könnte.
Wenn Sie KI-Entwürfe einführen, lautet die Frage zur Sprachqualität also nicht "schreibt sie korrekt?". Sondern "schreibt sie wie wir?". Ein HN-Kommentator hat denselben Punkt aus Kundensicht gemacht: Das Roboterhafte gab es lange vor der KI:
"The way support is setup nowadays humans are basically forced to be robots anyway, given a set of canned responses for each scenario and almost no latitude of their own. At least the robot responds instantly."
Wenn KI-Antworten roboterhaft klingen, liegt es meist daran, dass sie nur aus dem Help Center aufgesetzt wurden und nie eine echte Agentenantwort gesehen haben. Mein Leitfaden zur KI-Markenstimme geht die Einrichtung durch.
Sprachqualität bei Offshore-Teams und Teams ohne Englisch als Muttersprache
Hier wird es unbequem, deshalb sage ich es direkt: Ein großer Teil des Drucks auf die Sprachqualität kommt von Teams, die den Support an Offshore- oder Nearshore-Agenten verlagert haben und dann einen Rückgang der CSAT in schriftlichen Kanälen sahen. Fließendes schriftliches Englisch ist ein echter Einstellungsfaktor:
"I worked in Europe where it was not acceptable to address the customer in broken English. Easily $15 an hour."
Die Fehler, die am meisten schaden, sind keine Grammatikfehler. Es sind regionale Wendungen, die dort korrekt sind, wo der Agent lebt, und dort verwirren, wo der Kunde lebt:
"Consider for example phrases like "Kindly do the needful" or "out of station". Phrases they say daily that are completely foreign to American ears."
Und kleine Ausrutscher werden als Unhöflichkeit gelesen, selbst wenn der Inhalt stimmt. Das ist dem Agenten gegenüber unfair, aber der Kunde sieht nur die E-Mail.
Das würde ich bei einem Team ohne Muttersprache in dieser Reihenfolge tun:
- Eine einseitige Phrasenliste schreiben. Verbotene Formulierungen (mit Ersatz), freigegebene Begrüßungen und Grußformeln und wie man höflich Nein sagt. Das bringt mehr als jedes Grammatik-Tool.
- Ein Grammatik-Tool in den Editor einbauen und es zum Standard machen, nicht optional. Help Scout, Front und HubSpot haben bereits eines eingebaut; bei Zendesk oder Freshdesk ergänzen Sie Grammarly oder Sapling.
- Vorlagen für die schwierigen Nachrichten nutzen. Bei Ablehnungen von Rückerstattungen, Verzögerungen und Entschuldigungen geht die Tonalität schief. Bauen Sie dafür gute E-Mail-Vorlagen oder KI-Makros und lassen Sie Agenten sie anpassen.
- Auf Muster coachen, nicht auf Ausrutscher. QA-Tools wie Zendesk QA haben Dashboard-Karten für wiederholte Rechtschreib- und Grammatikfehler pro bewerteter Person. Ein Coaching-Gespräch zu einem wiederholten Fehler schlägt zwanzig Rotmarkierungen.
- Eine KI-Entwurfsebene erwägen. Sie gleicht die unteren zwei Ebenen für alle aus, und das Urteilsvermögen des Agenten fließt in die oberen zwei. Mein Vergleich der Kosten von KI und Offshore rechnet die Zahlen durch.
Ein einfaches Programm für Sprachqualität, Schritt für Schritt
Wenn Sie bei null anfangen, würde ich in dieser Reihenfolge vorgehen. Die Einrichtung dauert etwa zwei Wochen, danach läuft es von selbst.
- Vier Kategorien wählen. Rechtschreibung und Grammatik, Klarheit, Tonalität, Terminologie. Schreiben Sie für jede einen Satz, der "gut" definiert, mit einer echten Beispielantwort aus Ihrer Warteschlange.
- 30 aktuelle Tickets ziehen und von Hand bewerten. Das eigentliche Problem sehen Sie an einem Nachmittag. Meist sind es Länge oder Tonalität, nicht Tippfehler.
- Die unterste Ebene mit Tools beheben. Schalten Sie die Grammatikoption im Editor oder ein Grammatik-Tool für alle Agenten ein und tragen Sie Produktnamen in sein Wörterbuch oder die Ausnahmeliste ein.
- Die oberen Ebenen aufschreiben. Ein kurzer Tonalitäts-Leitfaden (zwei oder drei Adjektive plus Wörter, die Sie nie verwenden), eine Längenregel ("beantworten Sie die Frage in den ersten zwei Sätzen") und Beispiele für Empathie-Formulierungen, die nach Ihnen klingen. Legen Sie das in Ihrer Support-SOP ab.
- Laufend bewerten. Entweder automatische Bewertung jedes Tickets oder eine wöchentliche manuelle Stichprobe. Beobachten Sie Trends pro Agent und pro Makro.
- Den Kreis schließen. Jeder wiederholte Fehler wird zu einer Regel, einer Korrektur der Vorlage oder einem Coaching-Punkt. Neue Mitarbeitende bekommen die Regeln am ersten Tag; das passt gut zu Ihrem Onboarding von Agenten und zu Trainingsszenarien.
Häufige Fehler, die Sie vermeiden sollten
- Grammatik für die ganze Aufgabe halten. Eine grammatikalisch perfekte Antwort, die die Lösung im dritten Absatz vergräbt, ist eine schlechte Antwort.
- Tonalität bewerten, ohne sie zu definieren. "Sei freundlich" heißt für verschiedene Prüfer Verschiedenes. Kalibrieren Sie zuerst an fünf Beispieltickets.
- Automatische Werte für Leistungsbeurteilungen nutzen. Selbst Zendesk rät davon ab. Nutzen Sie sie, um Muster zu finden, und lassen Sie dann einen Menschen urteilen.
- Nicht-englische Warteschlangen ignorieren. Prüfen Sie, welche Sprachen Ihr QA-Tool tatsächlich bewertet. Die Lesbarkeit in Zendesk QA gibt es zum Beispiel nur für Englisch und Spanisch.
- KI ohne eigene Beispiele einführen. Ein KI-Copilot, der nur mit dem Help Center trainiert wurde, schreibt wie das Help Center. Lang, förmlich, vollständig. So schreibt Ihr bester Agent selten.
eesel für Sprachqualität im Support
Wenn Sie KI in Ihre Warteschlange bringen, lautet die Frage zur Sprachqualität, ob sie schreibt wie Ihr Team. Genau darauf ist der KI-Helpdesk-Teammate von eesel ausgelegt. Bei voller Anbindung liest er Ihr Help Center, Ihre Makros und vergangene Tickets, damit er weiß, wie Ihr Team antwortet, bevor er etwas entwirft.
Er arbeitet in Zendesk, Freshdesk, Help Scout, Gorgias und anderen Helpdesks und entwirft zunächst als interne Notizen, damit Ihre Agenten die Kontrolle behalten.

Regeln für Tonalität und Länge kommen in Anweisungen in einfacher Sprache ("antworte in zwei Sätzen, kein 'I apologize for any inconvenience'"), und wenn Sie einen Entwurf im Chat korrigieren, speichert er die Korrektur als Regel, damit sie auch nächste Woche gilt. Bevor etwas live geht, spielt der Simulations-Skill echte vergangene Tickets durch und bewertet jede Antwort. Ein Service-Desk-Leiter fasste das Ergebnis gut zusammen:
"It is getting us to the right articles really quickly and easily, as well as curating well-formed responses with consistent, on-brand tone, still keeping our own style and still keeping that human touch."
Eddie Stephens, Service Desk Lead, CartonCloud
Tarife beginnen bei 299 $ im Monat für 500 Credits, wobei ein Ticket einen Credit kostet, egal wie lange es dauert, und es gibt eine kostenlose Stufe zum Testen mit Ihren eigenen Tickets. Testen Sie eesel an einem Ausschnitt Ihrer Warteschlange und vergleichen Sie seine Entwürfe mit dem, was Ihr Team tatsächlich gesendet hat.