

Was eine kundenspezifische Wissensdatenbank ist und wer sie braucht
Eine kundenspezifische Wissensdatenbank ist Hilfeinhalt, der auf ein Kundenunternehmen oder eine Zielgruppe zugeschnitten ist. Der Kunde sieht seine Artikel plus die gemeinsamen. Alle anderen sehen nur die gemeinsamen.
Vier Arten von Teams brauchen sie am Ende:
- Agenturen und ausgelagerte Support-Teams, die den Support für mehrere Marken aus einem Helpdesk betreiben. Die Erstattungsrichtlinie von Kunde A darf nicht im Chat von Kunde B auftauchen.
- MSPs, die Netzwerk, Anbieter und Runbooks jedes Kunden dokumentieren, was eine eigene Softwarekategorie ist (mehr zu Hudu und IT Glue weiter unten).
- B2B-SaaS-Teams, deren Enterprise-Kunden individuelle Konfigurationen, SSO-Setups oder vertragsspezifische SLAs haben.
- Unternehmen mit mehreren Marken, die ich in meinem Leitfaden zum Multi-Brand-Kundensupport behandelt habe.
So hat ein Zendesk-Admin die Form des Problems beschrieben, und es ist die klarste Version, die ich gefunden habe:
"Can anyone advise on configuration for guide where I have 100 unique sites that need a help center? 2/3 of the content needs to be available for all end users but 1/3 of content is site-specific and needs to be invisible to users outside of that specific site. Multi brand? Orgs/tags? Labels?"

Beachten Sie das Verhältnis. Zwei Drittel gemeinsam, ein Drittel kundenspezifisch. Dieses Verhältnis entscheidet fast alles Weitere in diesem Beitrag, von der Struktur Ihres Wissensdatenbank-Managements bis zur Einrichtung der KI.
Ich bin Alicia und baue bei eesel die KI-Agenten, deshalb beschäftige ich mich viel mit der Abrufseite: was eine KI lesen darf, wenn ein Kunde von Client A eine Frage stellt. Dort verbringe ich die zweite Hälfte dieses Beitrags, denn dort hört kundenspezifischer Inhalt unbemerkt auf, kundenspezifisch zu sein.
Die drei Trennungsstufen
Jeder Helpdesk bietet eine Mischung derselben drei Stufen, egal ob er sie Marken, Portale, Workspaces oder Docs-Sites nennt. Wählen Sie die niedrigste, die den Zweck erfüllt, denn jede Stufe darüber erhöht den Pflegeaufwand.
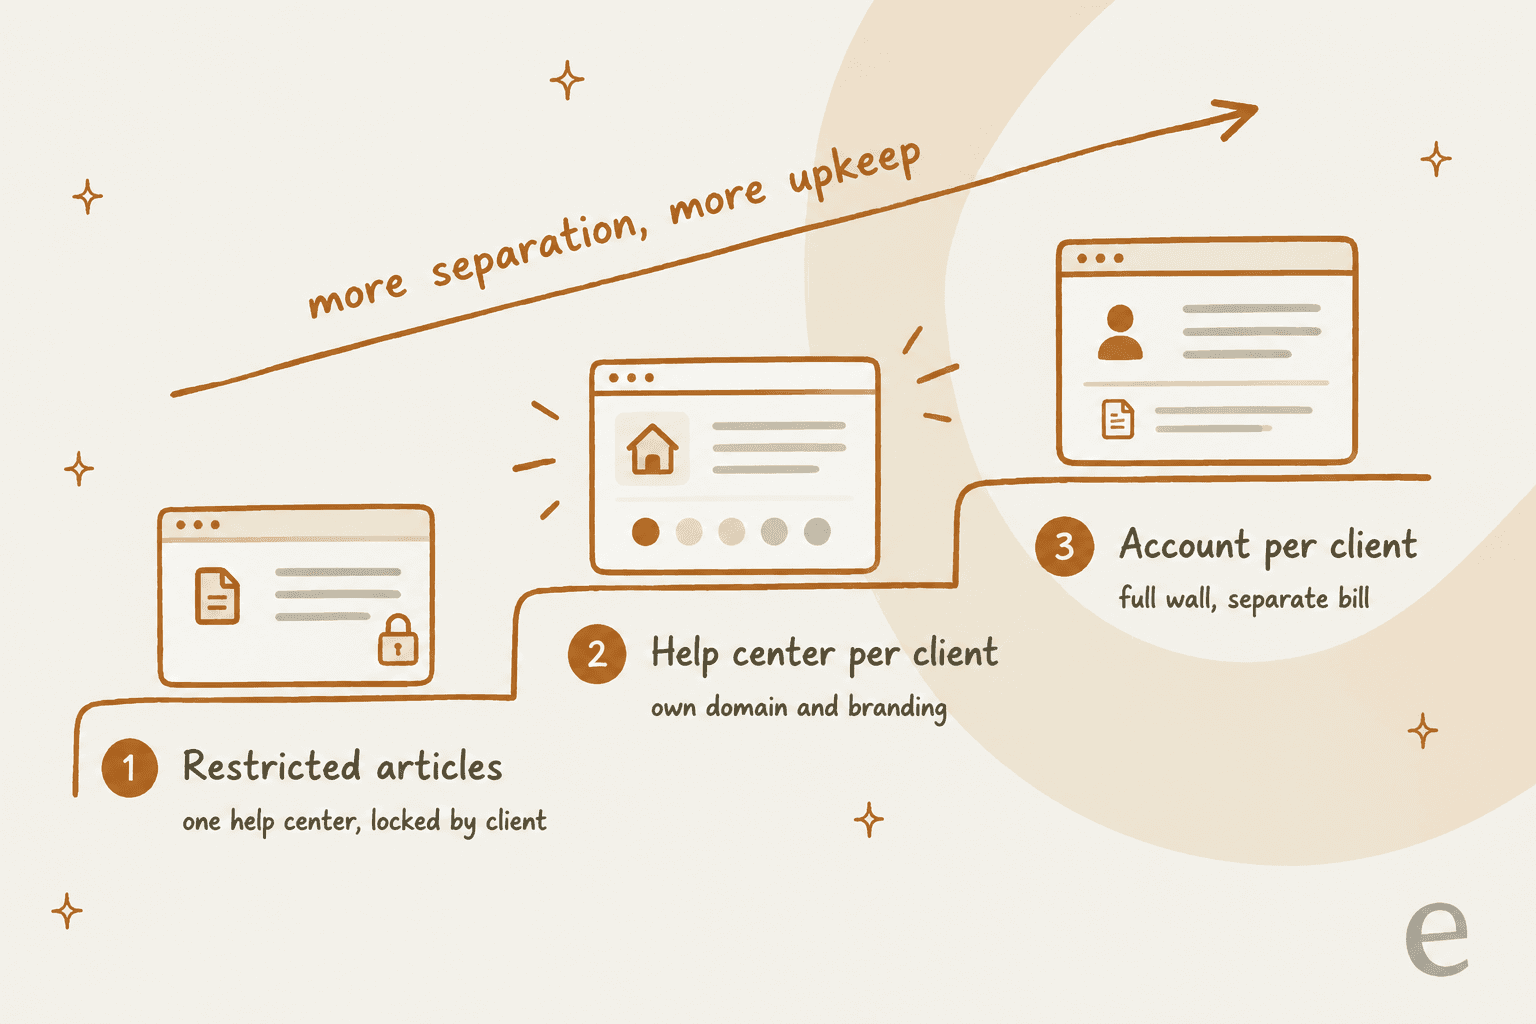
Stufe 1: eingeschränkte Artikel in einem Help Center. Kunden melden sich an, und die Nutzer jedes Kunden sehen ihre Artikel plus die gemeinsamen. Eine Artikelbibliothek, eine URL. Das ist für die meisten Teams der richtige Standard, und darauf verwiesen auch die Antworten auf r/Zendesk:
"User Segments all the way. Cool part though if you have User data coming from say Azure. You can premap info. Or domains as well. Then user segments check that data and allow access to articles pertaining to their content. Little bit of maintenance but it's the best way"
Der Haken ist die Anmeldung. Die Einschränkung funktioniert nur, wenn der Helpdesk weiß, wer liest, anonyme Besucher sehen also immer nur öffentliche Inhalte.
Stufe 2: ein Help Center pro Kunde. Jeder Kunde bekommt eine eigene Domain, ein eigenes Logo und einen eigenen Artikelsatz. Das wünschen sich meist Kunden, die Ihren Service weiterverkaufen oder mit eigener Marke auftreten, und es ist das Setup, das mein Leitfaden zum Zendesk-Multi-Brand-Setup durchgeht. Es ist aber nicht automatisch privat. Die Zendesk-Dokumentation zu Marken-Help-Centern sagt: "you cannot restrict users to a specific help center. All of your help centers are accessible to all of your end users." Ein separates Help Center ist eine Branding-Entscheidung, keine Datenschutzentscheidung. Bei vertraulichen Inhalten brauchen Sie weiterhin Anmeldung plus Einschränkung.
Stufe 3: ein Konto pro Kunde. Eigener Helpdesk, eigene Rechnung, eigene Admins. Die Workspaces-Dokumentation von Freshdesk sagt, dass getrennte Abrechnung oder rechtliche Eigentümerschaft separate Konten erfordern kann. Das ist die vollständige Mauer, aber auch der größte Aufwand: Jeder gemeinsame Artikel wird N-mal gepflegt.
Kopieren Sie nicht jeden Artikel pro Kunde
Der häufigste Fehler, den ich sehe, ist "kundenspezifisch" mit "die ganze Bibliothek pro Kunde kopieren" gleichzusetzen. Bei dem Verhältnis von zwei Dritteln gemeinsam von oben bedeutet das, dass die meisten Ihrer Änderungen dieselbe Korrektur zwölfmal eingefügt sind, und Kopien laufen auseinander, sobald jemand eine vergisst.
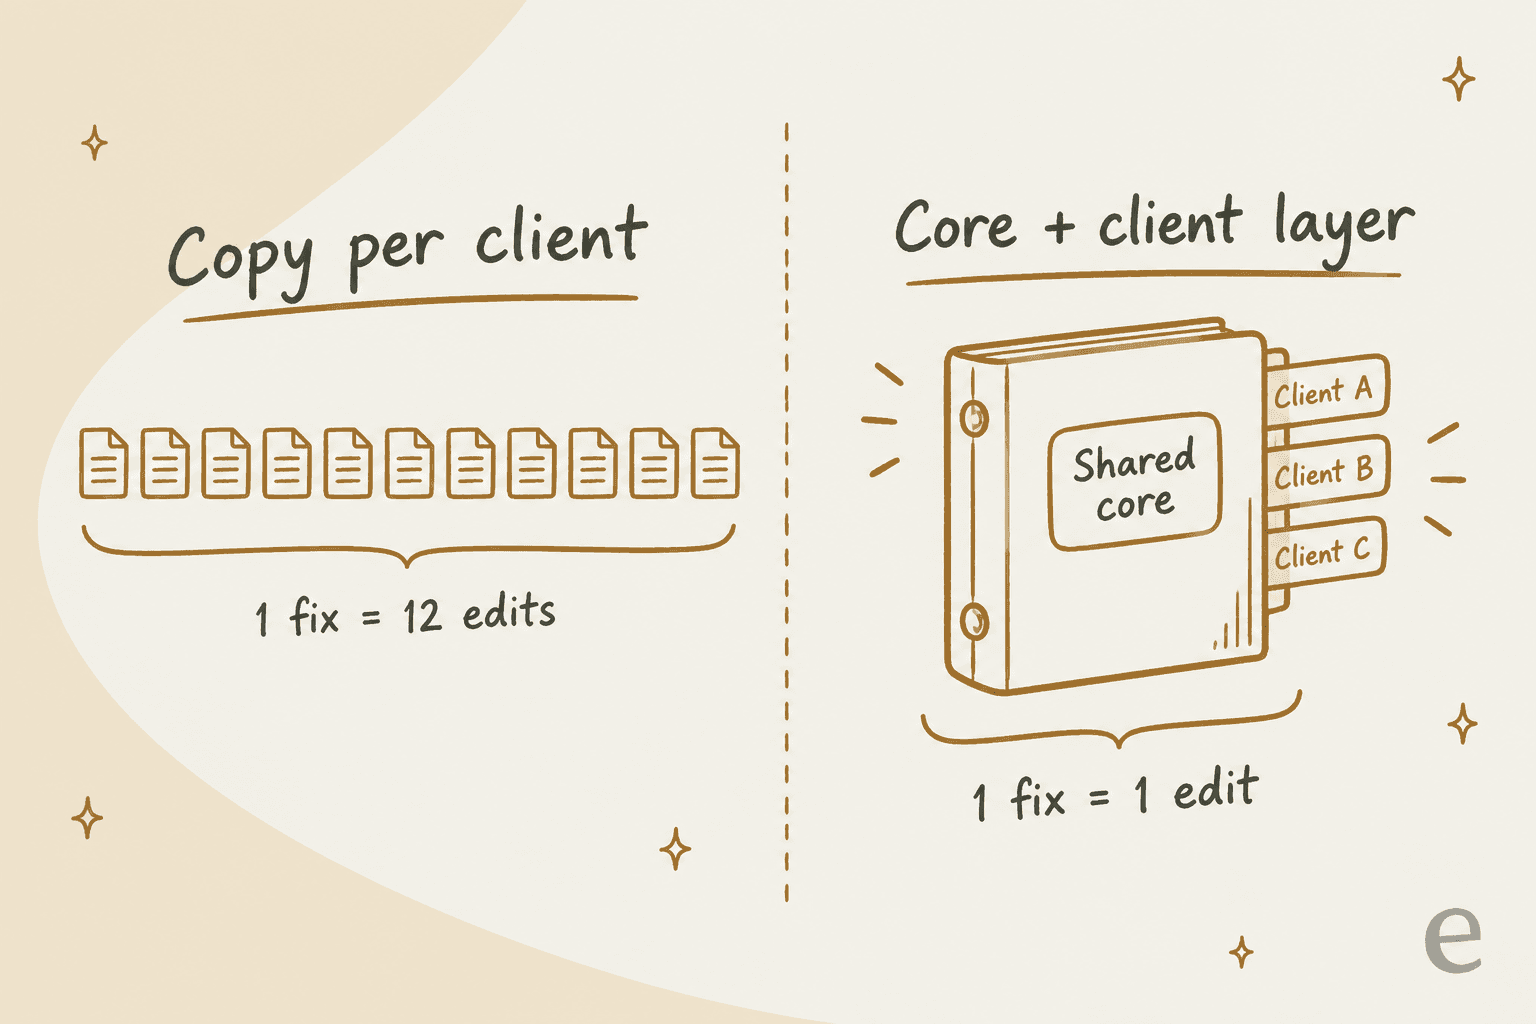
Das Muster, das trägt, ist ein gemeinsamer Kern plus eine dünne Kundenebene:
- Gemeinsamer Kern: wie das Produkt funktioniert, Standardrichtlinien, Fehlerbehebung. Einmal geschrieben.
- Kundenebene: nur das, was abweicht. Individuelle Konfiguration, Vertragsbedingungen, benannte Ansprechpartner, kundenspezifische Eskalationswege, Ausnahmen von der Standardrichtlinie.
Dieselbe Aufteilung funktioniert für interne Wissensdatenbanken, wo die Kundenebene aus reinen Agentennotizen besteht, die Ihre Kunden nie sehen.
Die MSP-Dokumentationstools sind genau so gebaut. Hudu nennt es duale Wissensdatenbank-Bibliotheken: zentrale Artikel "for information that pertains to multiple clients" und Kundenartikel, die "pertain only to that space." Zendesk hat zwei Funktionen, die innerhalb eines Kontos dasselbe leisten. Die Artikel-Mehrfachplatzierung legt einen Artikel in bis zu 10 Abschnitten über Marken hinweg ab, und jede Platzierung behält ihre eigenen Anzeigeberechtigungen.
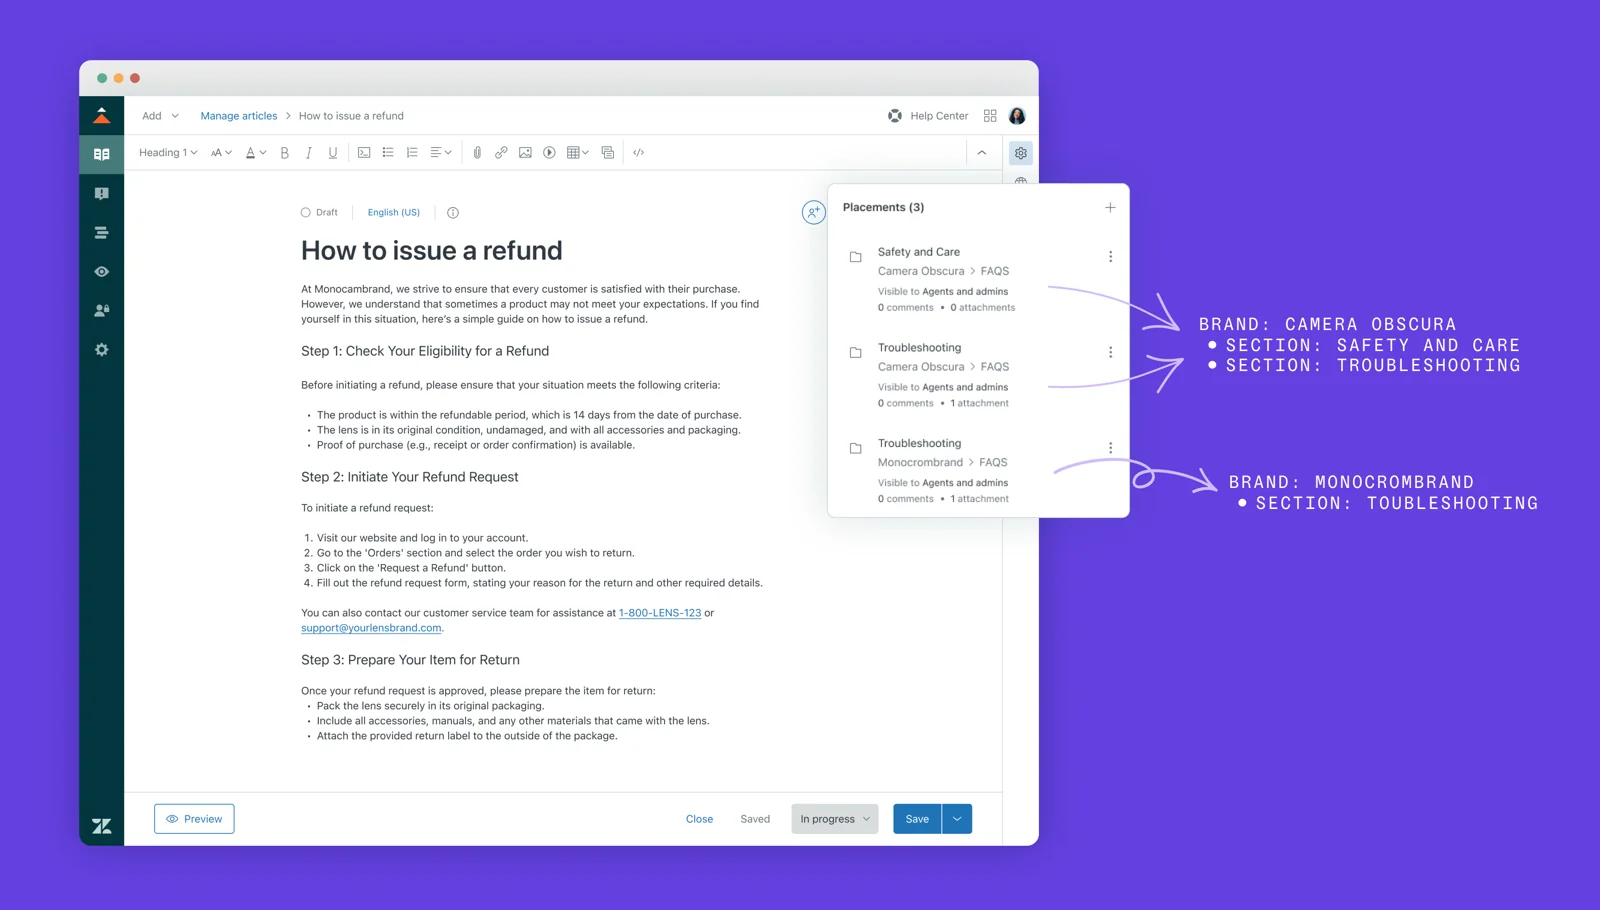
Inhaltsblöcke gehen eine Ebene kleiner: ein wiederverwendbarer Absatz oder eine Tabelle, die überall aktualisiert wird, wo sie eingefügt ist. Sie sind allerdings nur in Enterprise verfügbar, die meisten Teams setzen daher stattdessen auf Mehrfachplatzierung und eine klare Namenskonvention.
Ein ehrlicher Hinweis zu IT Glue: Es hat keine native gemeinsame Bibliothek. Die eigene Berechtigungsdokumentation schlägt vor, für gemeinsame Inhalte eine Organisation "named something like 'Common Documents'" anzulegen. Das funktioniert, ist aber eine Konvention, die Sie durchsetzen müssen, keine Struktur, die das Tool mitbringt.
Wie jeder Helpdesk kundenspezifische Artikel handhabt
Hier steht, was jedes Tool auf welcher Ebene und in welchem Tarif einschränkt. Preise gelten pro Agent oder Nutzer und Monat bei jährlicher Abrechnung, laut Preisseite des jeweiligen Anbieters, Stand Oktober 2026.
| Helpdesk | Kleinste einschränkbare Einheit | Mechanismus pro Kunde | Tarif für Einschränkung pro Kunde | Eigenes Help Center pro Kunde |
|---|---|---|---|---|
| Zendesk | Artikel | Nutzersegmente nach Organisation, Tag oder benanntem Nutzer | Suite Professional $115 (benutzerdefinierte Segmente); mehrere Segmente pro Artikel erfordern Enterprise | 5 bei Professional, 300 bei Enterprise |
| Freshdesk | Ordner | Ordner sichtbar für ausgewählte Unternehmen, Kontaktsegmente oder Unternehmenssegmente | In der Ordner-Dokumentation von Freshdesk für jeden Tarif aufgeführt | Pro $55 (bis zu 5 Portale), Enterprise $89 (unbegrenzt) |
| HubSpot Service Hub | Artikel oder gesamte Wissensdatenbank | Zugriffsgruppen (statisch oder filterbasiert) | Professional: 2 Zugriffsgruppen; Enterprise: 100 | Nur Enterprise (bis zu 100 Wissensdatenbanken) |
| Help Scout | Gesamte Docs-Site | Eine eingeschränkte Docs-Site pro Kunde | Plus $45 oder Pro $75, plus eigener Code | Sites: Plus 3, Pro 5, zusätzliche $20/Monat |
| Zoho Desk | Kategorie, Abschnitt oder Artikel | Help-Center-Nutzergruppen (bis zu 200 pro Help Center) | Nicht in Free; Wissensdatenbank ab Standard $14 | Enterprise $40 (Multi-Brand-Help-Center) |
| Front | Gesamtes Help Center | Ein anmeldegesteuertes Help Center pro Kunde | Professional $65 | Professional und höher |
Ein paar Dinge in dieser Tabelle verdienen mehr als eine Zelle.
Zendesk: Nutzersegmente leisten die eigentliche Arbeit
Die Nutzersegmente von Zendesk sind hier die flexibelste Option. Ein Segment kann nach bis zu 50 Organisationen, 50 Tags in jedem Tag-Bucket und 50 benannten Nutzern filtern, und Sie bekommen bis zu 200 Segmente pro Konto, geteilt über alle Marken. Legen Sie die Nutzer jedes Kunden in einer Organisation ab, und Sie haben ein Eins-zu-eins-Kundensegment.
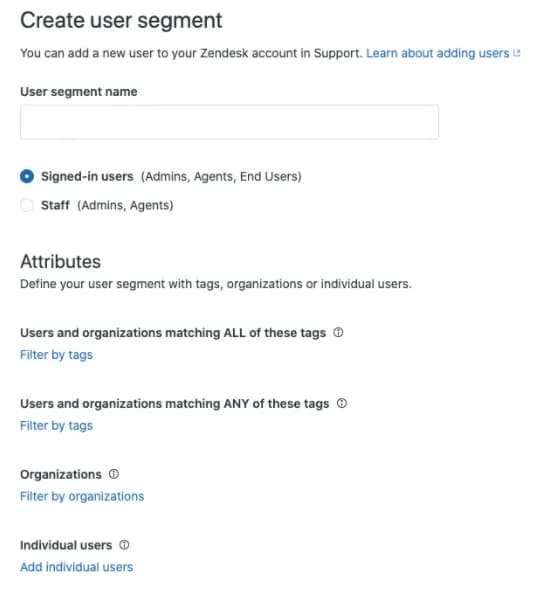
Zwei Tarifdetails sind wichtig. Suite Team kann nur "jeder" oder "angemeldete Nutzer" wählen, also keine Kundensegmente und keine reinen Agentenartikel. Und die Einschränkung gilt pro Artikel, nicht pro Abschnitt, Sie sperren also einen ganzen Kundenabschnitt per Massenaktualisierung. Mein Leitfaden zum Einschränken von Artikeln nach Segment führt Sie durch den Vorgang, und der Beitrag zu Multi-Brand-Help-Centern behandelt Stufe 2.
Freshdesk: pro Ordner und von Haus aus pro Unternehmen
Freshdesk legt die Sichtbarkeit am Ordner fest, nicht am Artikel. Die Optionen umfassen Alle Nutzer, Angemeldete Nutzer, Alle Agenten, Bot und bestimmte Unternehmen, dazu Kontakt- und Unternehmenssegmente. Die Widget-Dokumentation von Freshdesk nennt den Kundenfall direkt: Artikel "about a company to just contacts from that company" anzeigen.
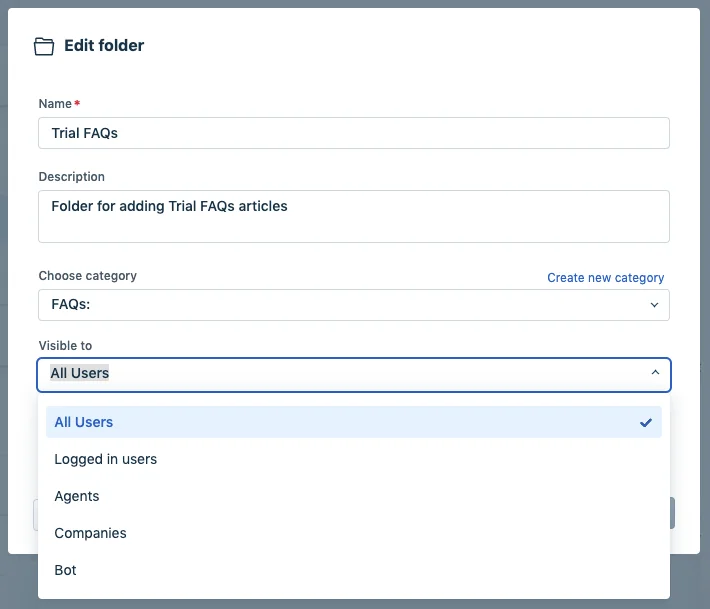
Damit ist Freshdesk einer der günstigsten Wege für Stufe 1 (meine Aufschlüsselung der Freshdesk-Preise enthält die Tariftabelle). Die Form, für die Sie planen sollten: ein Ordner pro Kunde, da die Sichtbarkeit innerhalb eines Ordners nicht von Artikel zu Artikel variieren kann.
HubSpot: gut in Enterprise, knapp in Professional
HubSpot schränkt einzelne Artikel oder eine ganze Wissensdatenbank über Zugriffsgruppen ein. Professional erlaubt 2 Zugriffsgruppen und 1 Wissensdatenbank. Das reicht für "öffentlich plus Partner plus eine VIP-Stufe", nicht für zehn Kunden. Enterprise erlaubt 100 Gruppen und bis zu 100 Wissensdatenbanken, und private HubSpot-Inhalte funktionieren nur auf einer verbundenen eigenen Domain. Mehr zur KI von HubSpot unten, denn dort wird es interessant. Meine Übersicht zur HubSpot-Wissensdatenbank enthält den Rest, und der Beitrag zur Service-Hub-Wissensdatenbank-KI behandelt die KI-Seite.
Help Scout, Zoho Desk und Front
Help Scout schränkt ganze Docs-Sites ein, keine Sammlungen. Eingeschränkte Docs erfordern Plus oder Pro und "custom code development by your own team", um das Besucher-Token auszustellen. Private Sammlungen gibt es, aber "privat" meint Ihre eigenen Help-Scout-Nutzer, nicht einen Kunden. Help Scout weist außerdem darauf hin, dass Docs nicht von den DSGVO- oder HIPAA-Zusagen abgedeckt ist, halten Sie Kundenkontodaten also daraus heraus.
Zoho Desk ist von diesen dreien am feinkörnigsten. Kategorien lassen sich auf Keine, Gruppen, Öffentlich, Agenten oder Eigene IP setzen, und Help-Center-Nutzergruppen sind an "a specific account" gebunden. Die Grenzen liegen bei 200 Gruppen pro Help Center und 2,000 Nutzern pro Gruppe. Wenn Sie vorhaben, Zia darauf zu trainieren, lesen Sie zuerst den KI-Abschnitt unten.
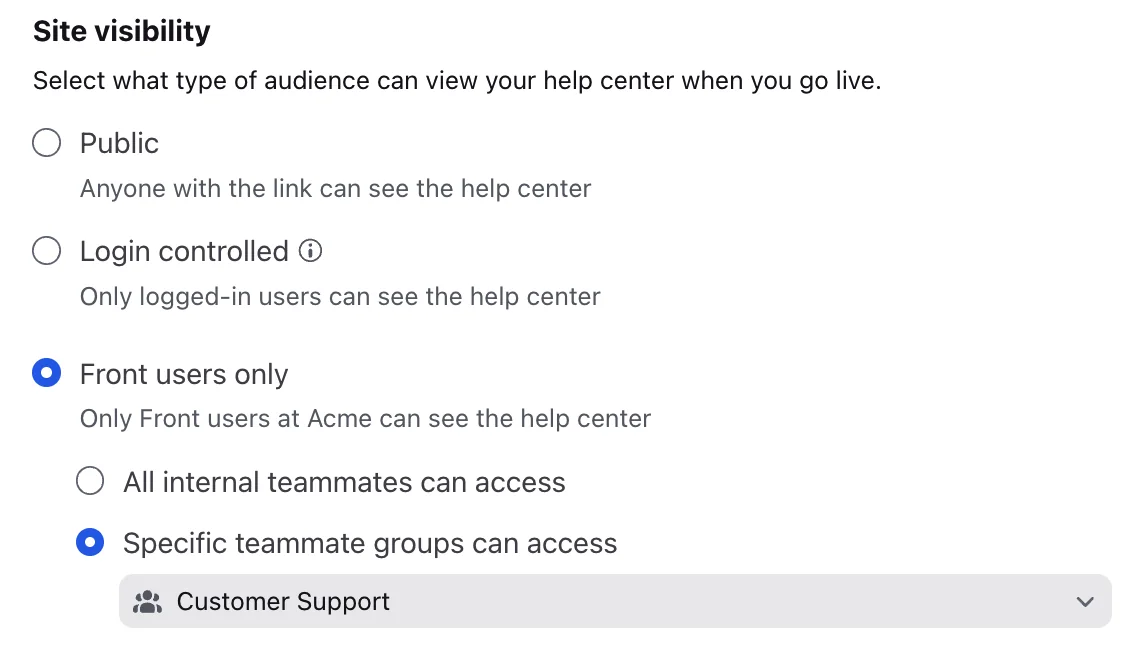
Front schränkt auf Help-Center-Ebene ein: Öffentlich, Anmeldegesteuert (über Ihren eigenen Identitätsanbieter) oder Nur Front-Nutzer. Die privaten Kategorien verstecken Inhalte nur in der Navigation, und jeder mit dem direkten Link kann sie öffnen, sie sind also keine Kundenmauer. Mein Test zu Front AI behandelt, was die KI liest.
Wo kundenspezifische Inhalte durchsickern: die KI
Hier ist die Verschiebung, auf die ich dränge. Teams verbringen Wochen damit, die Help-Center-Berechtigungen richtig zu setzen, und schalten dann einen KI-Agenten ein, der die Wissensdatenbank nach anderen Regeln liest. Das Berechtigungsmodell, das Ihre Kunden sehen, ist nicht immer das, dem Ihre KI folgt.
| KI-Funktion | Nutzt kundeneingeschränkte Artikel? | Was das für Sie bedeutet |
|---|---|---|
| Zendesk-KI-Agenten (aktuelles Setup) | Ja, und beachtet Anzeigeberechtigungen für angemeldete Nutzer | Messaging braucht JWT-Anmeldung mit passender externer ID; eingeschränkte Antworten lassen sich im Test-Widget nicht testen |
| Zendesk-KI-Agenten, gekauft vor dem 10. März 2026 | Artikel waren "public or private to everyone" | Die Migration läuft vom 1. Juli bis Ende 2026 |
| Freshdesk Freddy AI Agent | Nein. "Private or restricted articles are excluded" | Kundenordner sind keine Quelle; Sie müssten sie öffentlich machen |
| Freshdesk Freddy Copilot (agentenseitig) | Ja, begrenzt auf den eigenen Zugriff des Agenten | Gut für Agenten, nicht für kundenseitige Antworten |
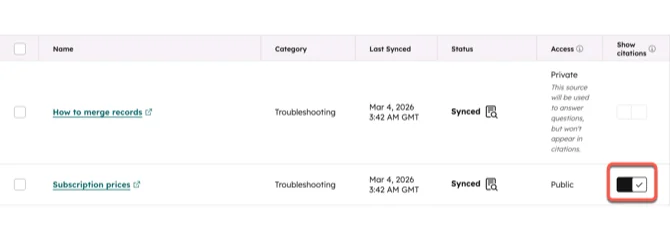
| HubSpot Customer Agent | Ja, ohne Quellenangaben | HubSpot warnt, dass private Inhalte "may still appear in responses" |
| Help Scout AI Answers | Private Sammlungen lassen sich in den Beacon-Einstellungen zuschalten | Ich würde pro Kunde mit einem KI-Agenten pro Beacon begrenzen |
| Zoho Desk Answer Bot | Zoho sagt, nur "published and public resources" | Ein Nutzerkommentar auf derselben Seite berichtet, dass reine Agentenartikel auftauchen; testen Sie es |
Zwei Zeilen verdienen einen genaueren Blick.
Freshdesk ist in der sicheren Richtung streng. Die Dokumentation zur Wissensbasis des AI Agent sagt: "only articles visible to All users are used for AI learning." Der Bot kann also den Ordner von Kunde A nicht an Kunde B durchreichen, kann Kunde A aber auch nicht aus dessen Ordner beantworten. Der Workaround von Freshdesk, die gefilterte Suche, grenzt den Abruf nach Kontakt- oder Konversationseigenschaften ein, kann aber nur Inhalte filtern, aus denen die KI überhaupt lernen durfte.
HubSpot geht in die andere Richtung. Die Dokumentation zu den Quellen des Customer Agent sagt, private Quellen "will not be cited, but their content may still appear in responses", und rät, keine vertraulichen oder privaten Kundendaten aufzunehmen. Ich habe keinen dokumentierten Weg gefunden, eine private Quelle bei der Antwort auf ihre Zugriffsgruppe zu begrenzen.
Dasselbe Problem tritt auch über Regionen hinweg auf, nicht nur bei Kunden. Ein Zendesk-Admin hat es gut formuliert:
"The problem: Zendesk AI pulls knowledge from the Help Centers linked to the same brand, regardless of language or region. So if a Brazilian customer asks something, the AI might base its answer on all related contents, even in articles just created for US."
Zuerst eingrenzen, dann suchen
Die Lösung ist dieselbe, zu der Entwickler greifen, die selbst bauen: Entscheiden Sie, wessen Inhalte im Spiel sind, bevor die Suche läuft, nicht danach. Ein n8n-Entwickler, der einen KI-Workflow für zehn Kunden betreibt, beschrieb es so:
"Once I've filtered the clientid the model won't make a mistake because if it gets the clientid gonna search for everything related to the client id, even the chat history is connected trough clientid so it seems pretty solid."
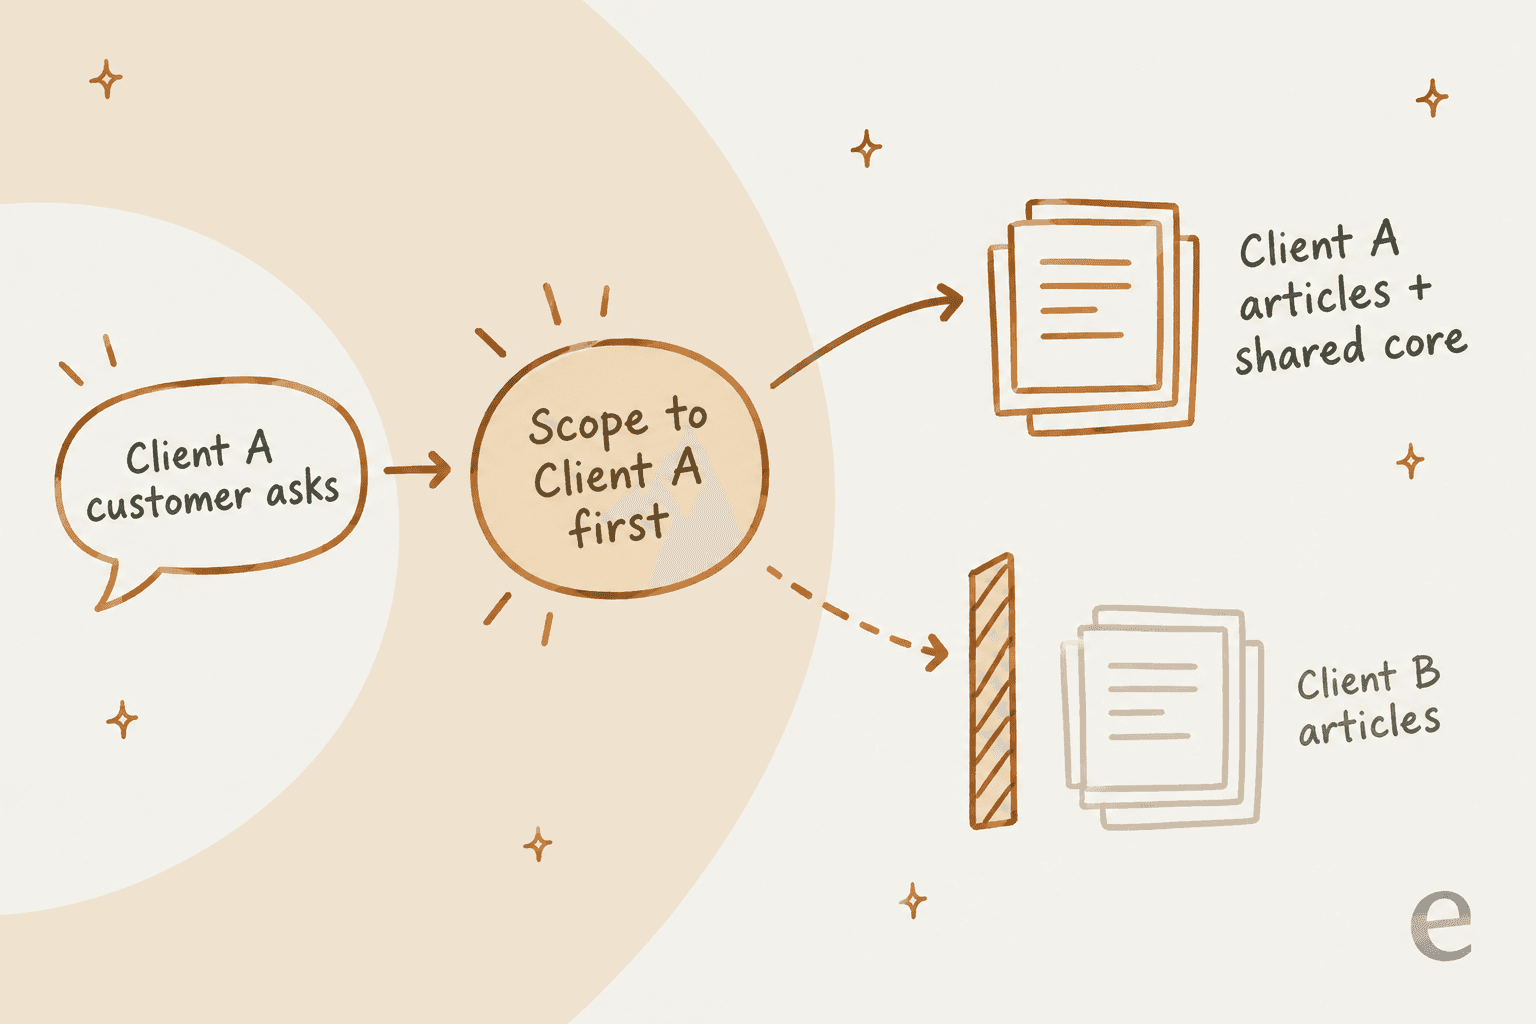
In einem Helpdesk ist der einfachste Weg, zuerst einzugrenzen, ein KI-Agent pro Kunde, nur mit den Quellen dieses Kunden verbunden. Anweisungen wie "nutze nur die Artikel von Kunde A" sind keine Mauer. Wenn der Inhalt im Index des Agenten liegt, gehen Sie davon aus, dass er herauskommen kann. Das gilt, egal ob die KI Retrieval oder ein feinabgestimmtes Modell nutzt, wie ich in RAG vs. Fine-Tuning erkläre.
Hier spielen auch vergangene Tickets eine Rolle. Der Ticketverlauf ist das reichhaltigste kundenspezifische Wissen, das Sie haben, denn er enthält jeden Randfall, den die Artikel nie abgedeckt haben. Er ist auch die Quelle, die sich am leichtesten vermischt, weil ein Helpdesk meist die Tickets aller Kunden enthält. Ein agentenseitiger Helpdesk-Copilot ist ein risikoärmerer Einstieg, da ein Mensch jeden Entwurf liest, bevor er rausgeht.
Was ich beim Bau bei eesel gelernt habe
Anfang dieses Jahres wollte ein belgisches Delivery-Tech-Team (Niederländisch und Englisch, 1,625 Dokumente, der aktivste Test seiner Kohorte) zwei KI-Agenten aus einem Zendesk. Einer sollte anonyme Nutzer aus öffentlichen Artikeln beantworten, der andere angemeldete Nutzer aus öffentlichen plus einem Teil der eingeschränkten Artikel. Der Import von eesel konnte nach Kategorie filtern, aber keine eingeschränkte Teilmenge Artikel für Artikel auswählen, also kamen sie nicht weiter. Etwa zur gleichen Zeit sah ich, wie andere Multi-Brand-Teams absprangen, weil das Setup pro Marke zu fummelig war, um es selbst zu machen.
Daraus gingen zwei Lehren hervor. Erstens: Legen Sie kundenspezifische Inhalte von Anfang an in eine eigene Kategorie oder einen eigenen Abschnitt, denn fast jedes Tool, KI eingeschlossen, grenzt zuverlässiger nach Container ein als nach einzelnem Artikel. Zweitens muss das Verbinden pro Marke der Standard sein, keine erweiterte Einstellung. In eesel verbindet sich heute jede Zendesk-Marke separat und importiert nur Tickets und Help-Center-Artikel dieser Marke, und jede Marke kann an einen anderen Agenten gehen. Ein Wellness-Unternehmen mit mehreren Marken betreibt auf diese Weise 5 markenspezifische KI-Agenten, jeder mit den Tickets seiner eigenen Marke trainiert.
Kundenspezifische Wissensdatenbanken in 6 Schritten einrichten
Das funktioniert in jedem der obigen Tools. Die Reihenfolge ist wichtiger als das Tool.
- Sortieren Sie Ihre Artikel in gemeinsam und kundenspezifisch. Führen Sie ein kurzes Audit der Wissensdatenbank durch und taggen Sie jeden Artikel. Rechnen Sie mit etwas nahe am Verhältnis von zwei Dritteln gemeinsam, und notieren Sie dabei Wissenslücken. Ist die Ebene eines Kunden größer als der gemeinsame Kern, braucht dieser Kunde vielleicht Stufe 2 oder 3.
- Geben Sie jedem Kunden einen Container, den Ihr Helpdesk versteht. Eine Zendesk-Organisation, ein Freshdesk-Unternehmen, eine HubSpot-Zugriffsgruppe, eine Zoho-Nutzergruppe. Ordnen Sie Nutzer wo möglich automatisch per E-Mail-Domain oder SSO-Daten zu, damit neue Kundennutzer nicht im falschen Bucket landen.
- Legen Sie Kundenartikel in eine reine Kundenkategorie oder einen Ordner. Nicht in gemeinsame Abschnitte gemischt. Dieser Schritt macht die KI und Massenänderungen an Berechtigungen später handhabbar.
- Entscheiden Sie, was per Verweis statt per Kopie geteilt wird. Nutzen Sie Mehrfachplatzierung, Inhaltsblöcke oder Portalkategorien, die an mehrere Portale angehängt werden. Kopieren Sie nur, wenn sich die Version des Kunden wirklich unterscheidet.
- Aktivieren Sie die Anmeldung und testen Sie dann als jeder Kunde. Melden Sie sich als echter Nutzer von Kunde A und Kunde B an und suchen Sie nach den Inhalten des jeweils anderen. Die Dokumentation zur Anmeldebeschränkung und zu Segmenten bei Zendesk sagt, dass der Organisationsfilter für angemeldete Agenten ignoriert wird und Knowledge-Admins jede Einschränkung umgehen, ein Test als Sie selbst beweist also nichts.
- Begrenzen Sie die KI pro Kunde und testen Sie sie am Verlauf dieses Kunden. Ein Agent pro Kunde oder Marke, nur mit den Quellen dieses Kunden verbunden. Lassen Sie ihn gegen die vergangenen Tickets dieses Kunden laufen, bevor er live jemanden beantwortet.
Nach dem Start sollten Sie die Kundenebene in einen Prüfrhythmus legen. Kundenspezifische Artikel veralten schneller als gemeinsame, weil sie von einem Vertrag oder einem Ansprechpartner abhängen, der sich geändert haben kann. Koppeln Sie ihre Prüfung an Ihren Prozess für Richtlinienänderungen, sodass eine Vertragsänderung eine Artikelaktualisierung auslöst. Mein Beitrag zu veralteten Help-Center-Inhalten zeigt, wie Sie das erkennen.
MSPs: Hudu und IT Glue funktionieren schon so
Wenn Sie ein MSP sind, liegt Ihre kundenspezifische Wissensdatenbank wahrscheinlich gar nicht in Ihrem Helpdesk. Sie liegt in einem Dokumentationstool, in dem die Trennung pro Kunde das gesamte Design ist.
| Hudu | IT Glue | |
|---|---|---|
| Container pro Kunde | Firmenbereich | Organisation |
| Gemeinsame Bibliothek | Native zentrale Wissensdatenbank | Eine gemeinsame Organisation "Common Documents" |
| Preis | $27/Nutzer/Monat jährlich, kein Minimum | $29 / $38 / $44 pro Nutzer/Monat, 5-Nutzer-Minimum, 36 Monate Laufzeit |
| Kundenportal | Kostenlose Portalnutzer | MyGlue-Add-on, $407/Monat |
| KI | Hudini-Assistent und MCP, inklusive | Cooper Copilot, in allen Stufen aufgeführt |
Quellen: Hudu-Preise und IT-Glue-Preise.
Ein Datum, das Sie im Blick behalten sollten: Hudus Version 2.47 wird ab dem 12. Oktober 2026 ausgerollt und ersetzt Kundenportale durch eine Portalnutzer-Rolle. Hudus eigene Warnung lautet, dass Portalnutzer "everything their groups can see" erben, während das alte Portal nur Datensätze zeigte, die dafür markiert waren. Wenn Sie Kundendokumente über das Hudu-Portal teilen, prüfen Sie Ihre Gruppenberechtigungen vor diesem Datum.
Das Auffindbarkeitsproblem verschwindet auch mit einem dedizierten Tool nicht:
"It can be really difficult to find client specific information unless you know exactly how to search for it. There is sometimes lost time spent there."

Mein Leitfaden zum MSP-Ticketsystem behandelt die Ticketing-Seite desselben Stacks.
eesel für kundenspezifische Wissensdatenbanken ausprobieren
Wenn Sie den Support für mehrere Kunden oder Marken auf Zendesk, Freshdesk, Gorgias oder Zoho Desk betreiben, gibt eesel jedem Kunden ein eigenes KI-Helpdesk-Teammitglied, dasselbe Setup, das ich in KI-Support für Agenturen beschreibe. Es tritt der bestehenden Warteschlange bei, verbindet sich pro Zendesk-Marke oder pro Helpdesk-Konto und lernt nur aus dem Help Center, den Makros und den vergangenen Tickets dieses Kunden. Jede Quelle ist ein Schalter, Sie können also einen Ticketverlauf abschalten, aus dem der Agent nicht lernen soll, und "uninstall from agent" entfernt eine Verbindung vom Agenten eines Kunden, ohne die anderen zu berühren.

Bevor ein Agent für einen Kunden live geht, spielt der Simulations-Skill die echten vergangenen Tickets dieses Kunden nach und vergleicht seine Antworten mit dem, was Ihr Team gesendet hat. Auch Aktionen gelten pro Agent, sodass das Erlauben von Erstattungen für Kunde A nicht ändert, was der Agent von Kunde B tun kann.
Die Preise enthalten in jedem Tarif unbegrenzte Agenten und Plätze, beginnend kostenlos mit 100 Credits, danach ab $299 im Monat für 500 Credits, wobei ein Ticket 1 Credit kostet. Da die Abrechnung auf Workspace-Ebene liegt, kauft eine Agentur mit sechs kleinen Kunden einen Credit-Tarif für ihre gesamten Tickets statt sechs Abonnements. Wenn Sie lieber einen Agenten pro Kunde per Skript anlegen, kann die eesel CLI mit eesel agents create einen neuen Agenten erstellen und mit --agent jeden davon ansprechen, aus einem Terminal oder von einem Coding-Agenten wie Claude Code aus.

Was eesel nicht ist: eine White-Label-KI-Plattform oder ein Reseller-Programm, und seine Nutzerrollen gelten für den gesamten Workspace statt pro Kunde. Wenn Ihre Kunden eigene Logins brauchen, um ihren eigenen Agenten zu verwalten, ist das heute eine Lücke. Wenn jede Kunden-KI in ihrer Spur bleiben soll, testen Sie eesel kostenlos.