

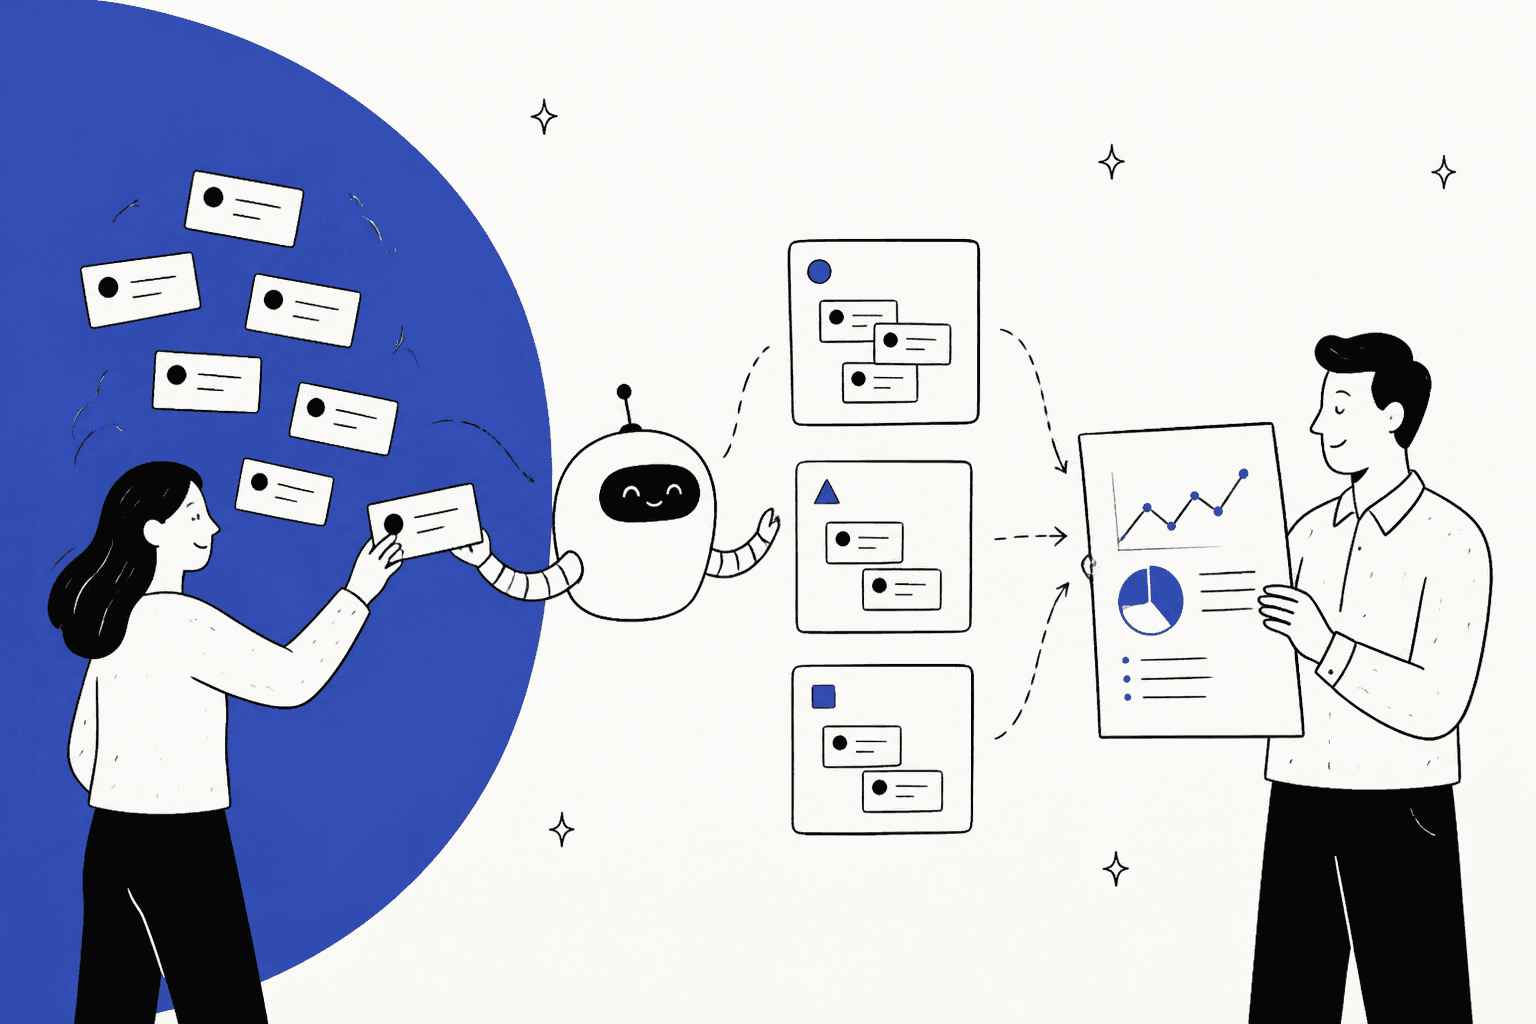
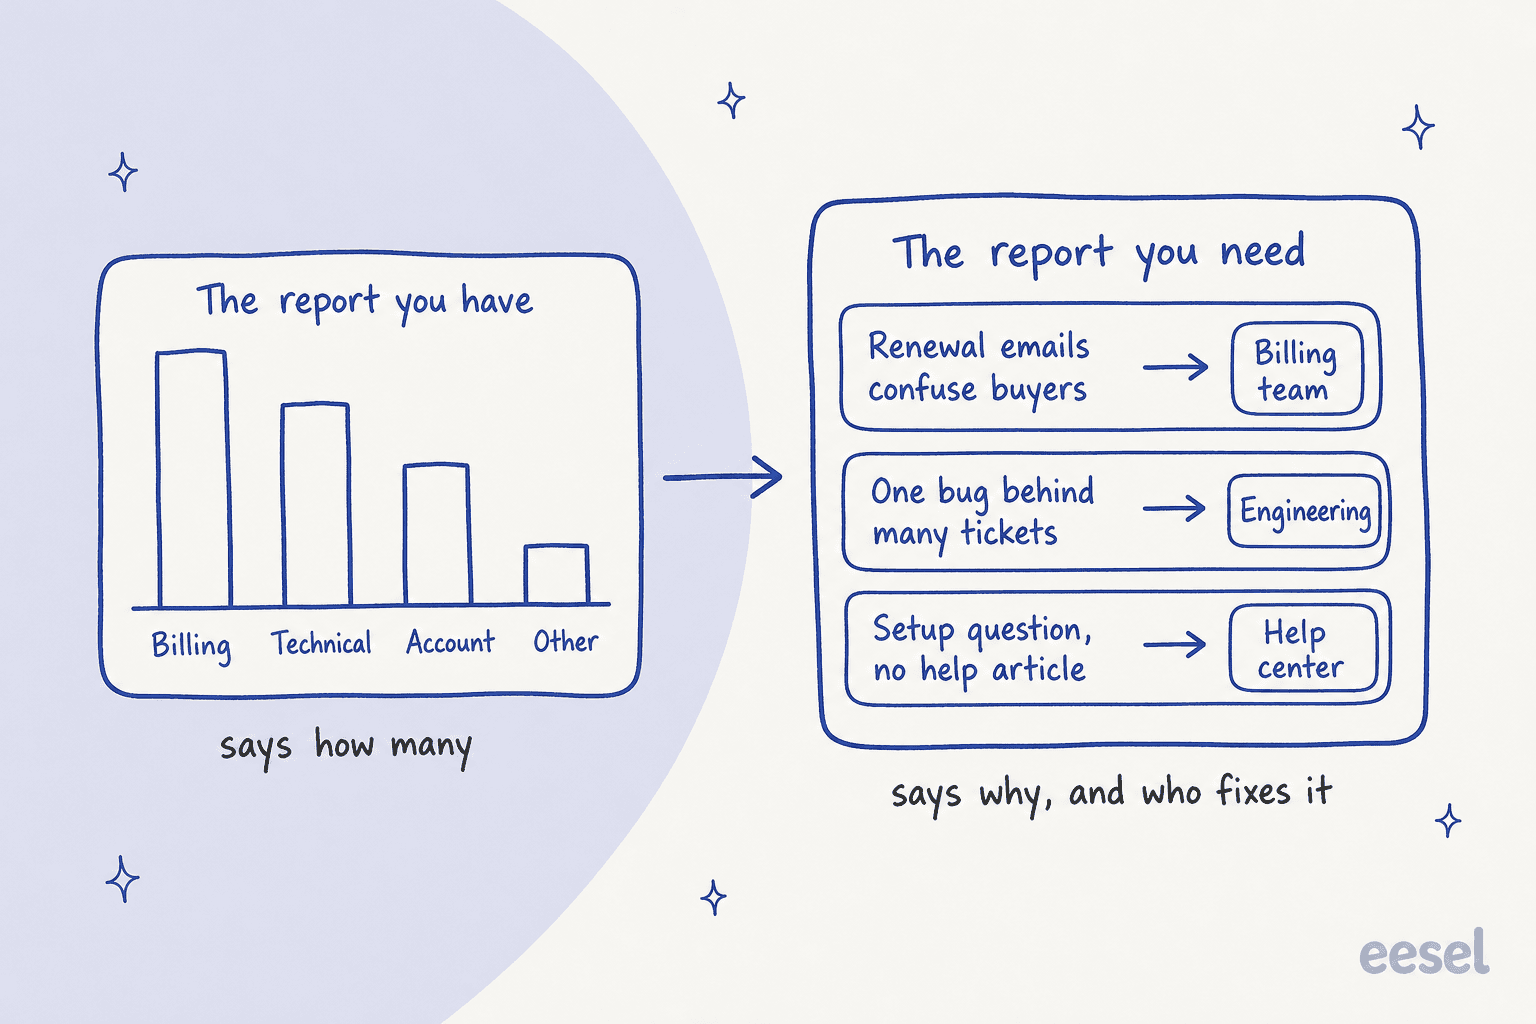
KI für Support-Reporting liest jedes Ticket, taggt es danach, warum der Kunde sich gemeldet hat, markiert Spitzen und fehlende Hilfeartikel und schreibt die Wochenzusammenfassung für Sie. Damit wandert Ihr Bericht von „wie viele Tickets" zu „warum sie eingingen und wer die Ursache beheben sollte", also genau dem Teil, den ein Tabellenexport nie verrät.
Die meisten Helpdesks bringen inzwischen einen Teil davon mit. Zendesk taggt Thema und Stimmung ab Suite Professional ($115 pro Agent und Monat), Gorgias erkennt Intent und Stimmung in jedem Helpdesk-Tarif, und die Spitzen- und Ursachenwarnungen von Freshdesk gibt es nur im Enterprise-Tarif ($89 pro Agent). Der Haken: KI-Tags sind nur so gut wie die Liste, die Sie ihnen geben, und die meisten eingebauten Berichte hören bei einem Diagramm auf. Jemand muss aus dem Diagramm noch eine Korrektur machen.
Ein KI-Teammate wie eesel schließt diese Lücke, weil er die Tickets ohnehin bearbeitet: Bei smava hat er in einem Monat rund 14,600 Zendesk-Tickets in eine feste Liste einsortiert, und er kann einen Wochenbericht mit den wichtigsten Themen, Wissenslücken und den ersten Korrekturen per E-Mail senden. Die Tarife beginnen bei $299 im Monat für 500 Credits.
Was macht KI beim Support-Reporting eigentlich?
Beim Support-Reporting übernimmt die KI fünf Aufgaben. Sie taggt jedes Ticket mit einem Kontaktgrund und liest die Stimmung des Kunden, sie bemerkt, wenn ein Thema ansteigt, sie zeigt auf Fragen, die Ihr Help Center nicht beantworten kann, und schreibt die Zahlen dann in verständlicher Sprache auf. Die erste Aufgabe trägt alle anderen. Wenn jedes Ticket einen verlässlichen Grund hat, fallen die übrigen vier recht leicht; sind die Gründe ein Durcheinander, ist darauf aufbauend kaum etwas vertrauenswürdig.
Ich arbeite jeden Tag in der Support-Warteschlange von eesel, und der Bericht, den ich am Montag will, ist kurz: worüber sich Leute gemeldet haben und was sich seit letzter Woche verändert hat, plus welche dieser Dinge jemand außerhalb des Supports beheben kann. Die reine Ticketzahl ist die am wenigsten nützliche Zeile auf dieser Seite.
So sieht jede Aufgabe in der Praxis aus:
| Aufgabe | Was die KI tut | Was Sie im Bericht erhalten |
|---|---|---|
| Kontaktgründe | Liest Betreff und Verlauf, wählt einen Grund aus Ihrer Liste | Volumen nach echtem Grund, nicht nach „Sonstiges" |
| Stimmung | Markiert jede Nachricht als positiv, neutral oder negativ | Welche Gründe Kunden am meisten verärgern |
| Spitzen | Vergleicht diese Woche mit den letzten Wochen pro Grund oder Gruppe | Eine Warnung vor dem Wochenmeeting, nicht danach |
| Wissenslücken | Vermerkt Fragen, die sie aus Ihren Dokumenten nicht beantworten konnte | Eine Liste von Hilfeartikeln, die geschrieben werden sollten |
| Schriftliche Zusammenfassung | Macht aus den Zahlen ein paar Sätze mit Beispielen | Ein Bericht, den auch Leute außerhalb des Supports lesen |
Zur technischen Seite der ersten Aufgabe geht mein Leitfaden zu KI-Support-Tagging tiefer, und KI-Stimmungsanalyse für den Support behandelt die zweite.
Warum erklären Ihre aktuellen Support-Berichte nicht, warum Tickets eingehen?
Ihre aktuellen Berichte können nicht erklären, warum Tickets eingehen, weil das Grundfeld von Hand ausgefüllt wird, am Ende eines Tickets, von müden Leuten. Jeder Agent taggt ein wenig anders, und die Hälfte der Tickets landet in einem Sammelbecken, was nicht hilft, wenn die Auswahlliste vor zwei Produkteinführungen entworfen wurde.
"We have been using ZD for a number of years but the system was never designed properly. Most tickets are not being tagged properly and we find it very difficult to see trends."

Dann kommt der Report Builder. Die nativen Dashboards sind gut bei Zahlen, erster Antwortzeit und SLA, aber deutlich schwächer darin, zu zeigen, was hinter einer Zahl steckt. Also exportieren Teams jede Woche in eine Tabelle oder ein BI-Tool, und genau in diesem Export verschwinden die Stunden.
"the native dashboards are fine for weekly pulse checks but anything deeper gets messy fast, I end up pulling everything into a BI tool anyway for proper trend analysis and sentiment tracking"
Das dritte Problem ist die Zuständigkeit. Selbst ein guter Bericht endet meist bei „Abrechnungstickets sind um 20 % gestiegen". Er sagt nicht, dass die Verlängerungs-E-Mail verwirrend ist, und er gibt das auch nicht an die Person weiter, der die Verlängerungs-E-Mail gehört. Dieser Schritt senkt die Tickets tatsächlich, und wenn ich ein Reporting-Setup von Grund auf entwerfen würde, würde ich alles um ihn herum aufbauen. Die Standardkennzahlen stehen in meinem Beitrag zu Kundenservice-KPIs; dieser Beitrag handelt von der Schicht darüber.
Welches KI-Reporting enthält Ihr Helpdesk bereits?
Die meisten großen Helpdesks liefern inzwischen KI-Themen-Tagging, doch der dafür nötige Tarif unterscheidet sich stark. Prüfen Sie vor jedem Kauf, wofür Sie bereits zahlen. Das sagen die Dokumentationen der Anbieter, Stand 29. Oktober 2026:
| Helpdesk | KI-Tagging nach Grund | Stimmung | Bericht in Alltagssprache anfordern | Spitzen- oder Anomaliewarnungen | Signal für Wissenslücken | Nötiger Tarif |
|---|---|---|---|---|---|---|
| Zendesk | Intelligent Triage: Thema, Entität, Sprache | Ja, im Triage-Dashboard | Schnellberichte | Über das Zendesk-QA-Add-on (Spotlight) | Zendesk-QA-Add-on | Suite Professional, $115/Agent/Monat jährlich |
| Freshdesk | Themen-Cluster für die Chats des KI-Agenten | In diesen Dokumenten nicht behandelt | Conversational Insights | Proactive Insights mit Ursachenanalyse | Improve-Tab für den KI-Agenten | Insights im Enterprise-Tarif, $89/Agent/Monat jährlich |
| Gorgias | Intent bei jeder Nachricht | Eine Stimmung pro Nachricht | Nicht gefunden | Nicht gefunden | Übergaben pro Artikel | Jeder Helpdesk-Tarif, ab $10/Monat |
| HubSpot | Themen (Beta) | CX-Score | Breeze erklärt einen bestehenden Bericht | Nicht gefunden | CX-Score markiert unklare Self-Service-Dokumente | Service Hub Professional, $90 bis $100/Platz/Monat |
| Help Scout | AI Topics (Beta), 8 bis 15 pro Posteingang | Nicht gefunden | Über den MCP-Server in Claude oder ChatGPT | Tägliche Prüfung legt neue Themen an | Nicht gefunden | Plus $45/Nutzer/Monat |
| Front | AI Topics, 85 % durchschnittliche Genauigkeit | Smart CSAT im Enterprise-Tarif | Nicht gefunden | Nicht gefunden | Nicht gefunden | Starter $25/Platz/Monat |
Einige Details sollten Sie kennen, bevor Sie sich auf eines davon verlassen.
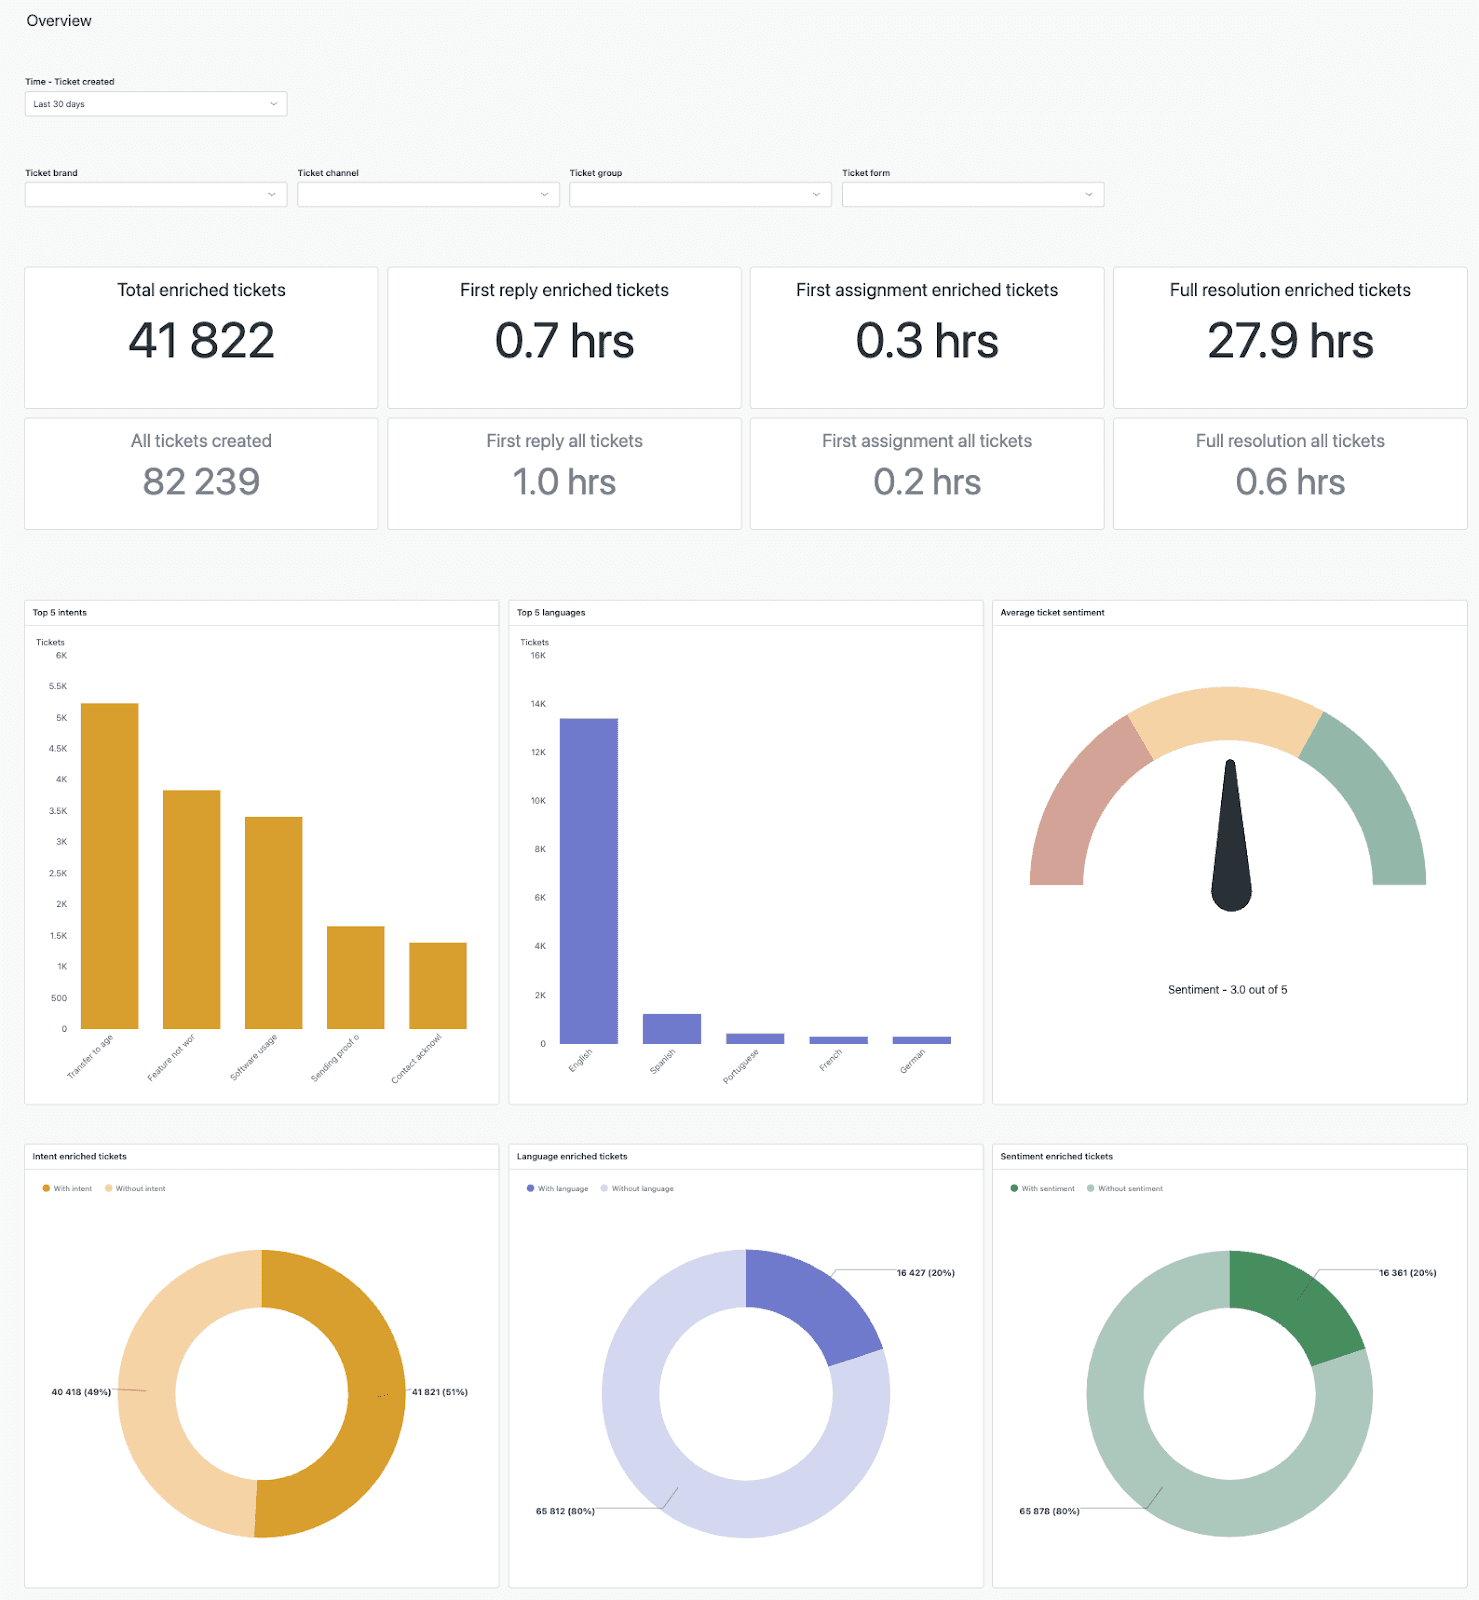
Zendesk hat Intelligent Triage im Juli 2026 ohne Aufpreis auf Professional-Tarife heruntergezogen. Ein Thema in einer Routing-Regel zu verwenden, erfordert jedoch weiterhin das Copilot-Add-on für $50 pro Agent. Das Triage-Dashboard hat die Tabs Overview, Topic, Entity, Language und Sentiment. Eine Eigenheit: Es behält den Wert, den die Triage zuerst vergeben hat, sodass das Dashboard auch nach einer späteren Korrektur des Themas durch einen Agenten noch das ursprüngliche zeigt. Bei Quick reports tippen Sie eine Frage, statt Kennzahlen auszuwählen, doch das ist auf den Tickets-Datensatz und Prompts mit 200 Zeichen beschränkt, ohne benutzerdefinierte Felder. Mehr in meinem Leitfaden zu Zendesk Intelligent Triage.
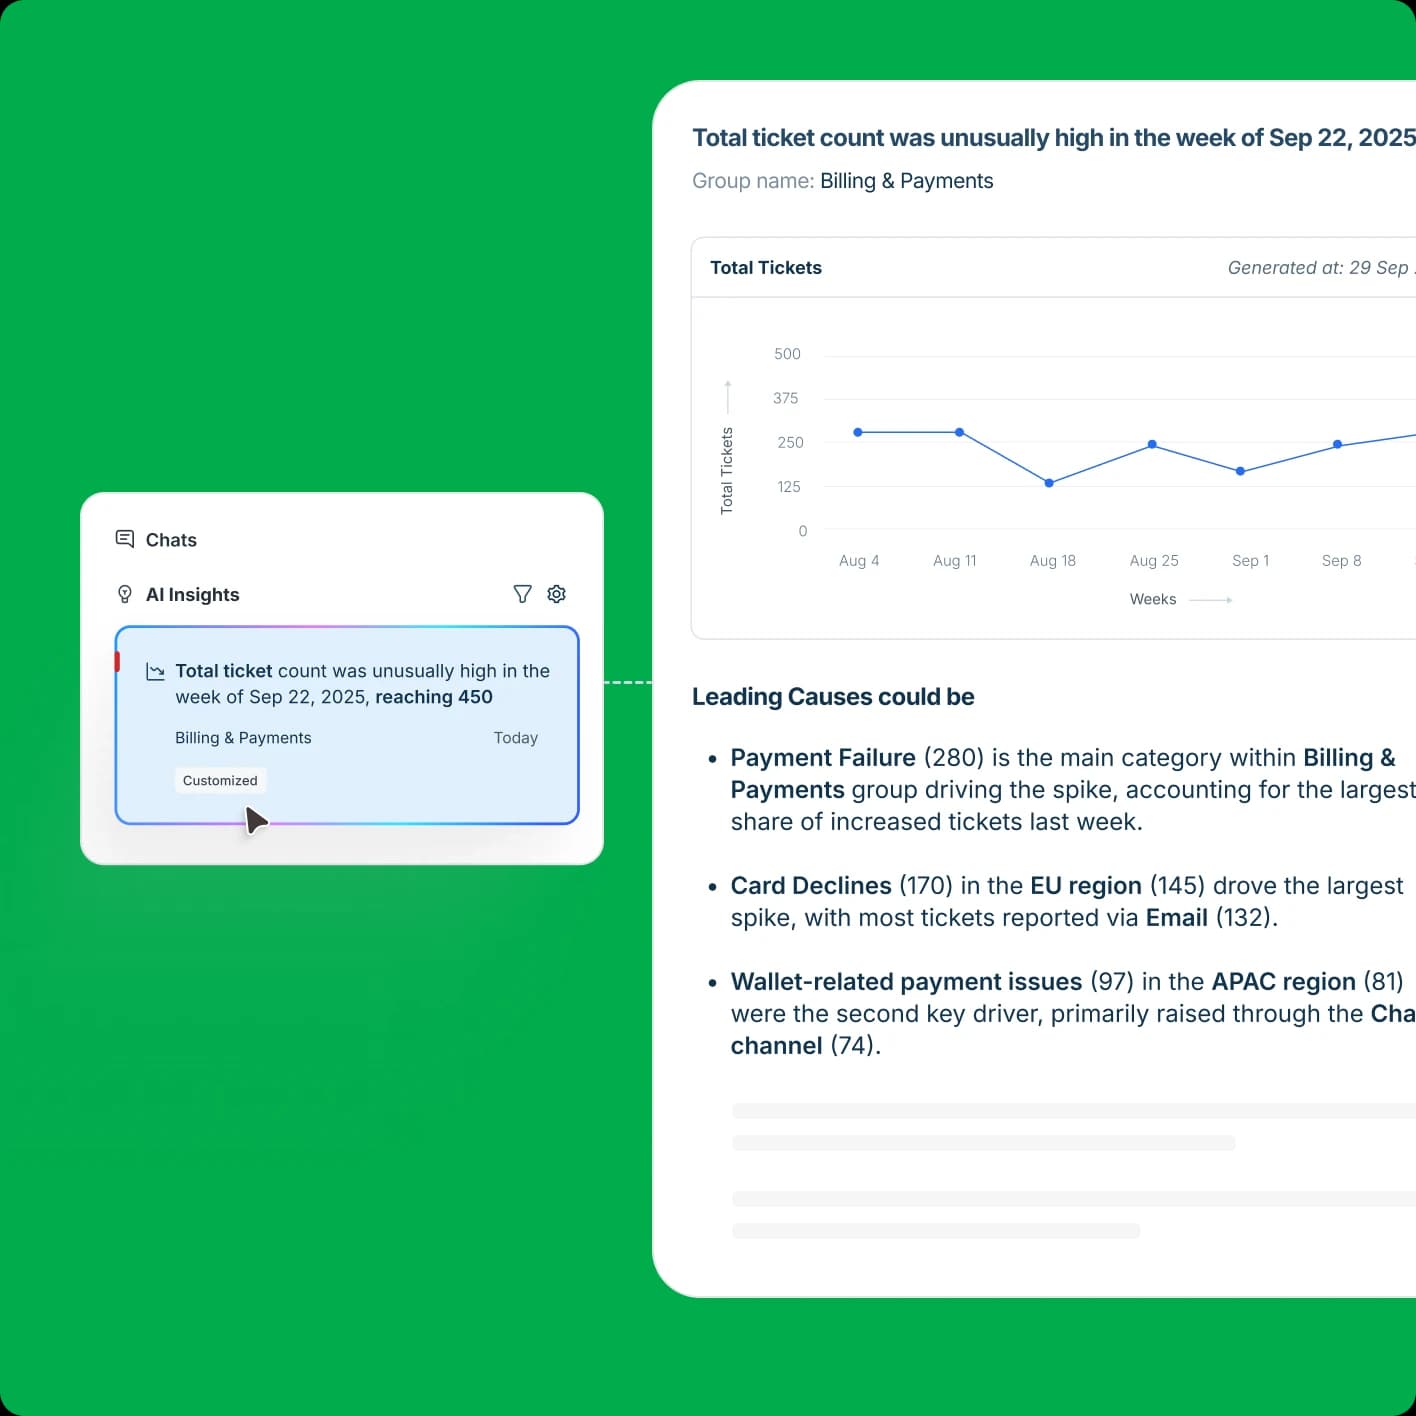
Freshdesk ist der einzige der sechs, der echte Spitzenerkennung mit Ursachenbaum dokumentiert. Proactive Insights meldet Ausreißer und Trendwechsel pro Agentengruppe, während Root Cause Analysis den „kritischen Pfad" hinter einer schlechten Woche durchgeht. Die eigene FAQ nennt die Grenzen: nur Englisch, wöchentliche Aktualisierung, mindestens 10 Tickets in 12 Wochen pro Gruppe und noch keine E-Mail- oder Slack-Warnungen. Die Einrichtung steht in meinem Beitrag zu Freddy AI Insights.
Gorgias erkennt Intent und Stimmung bei jeder eingehenden Nachricht aus einer festen Liste (Order/Damaged, Refund/Request usw.), und das in jedem Helpdesk-Tarif. Das nützlichste Reporting-Signal betrifft den AI Agent: Dort zeigt jeder Hilfeartikel seine Übergaben, und Gorgias sagt, „handovers are the clearest signal", dass ein Inhalt aktualisiert werden muss. Mehr dazu in meiner Anleitung zu Gorgias-Berichten.
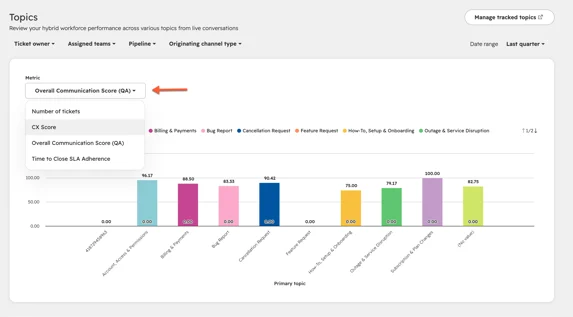
HubSpot Topics ist in Service Hub Professional und Enterprise in der Beta. Der Bericht stellt pro Thema Ticketzahl, CX-Score, QA-Score und SLA-Einhaltung nebeneinander, was näher an „was soll ich beheben" kommt als eine nackte Zahl.
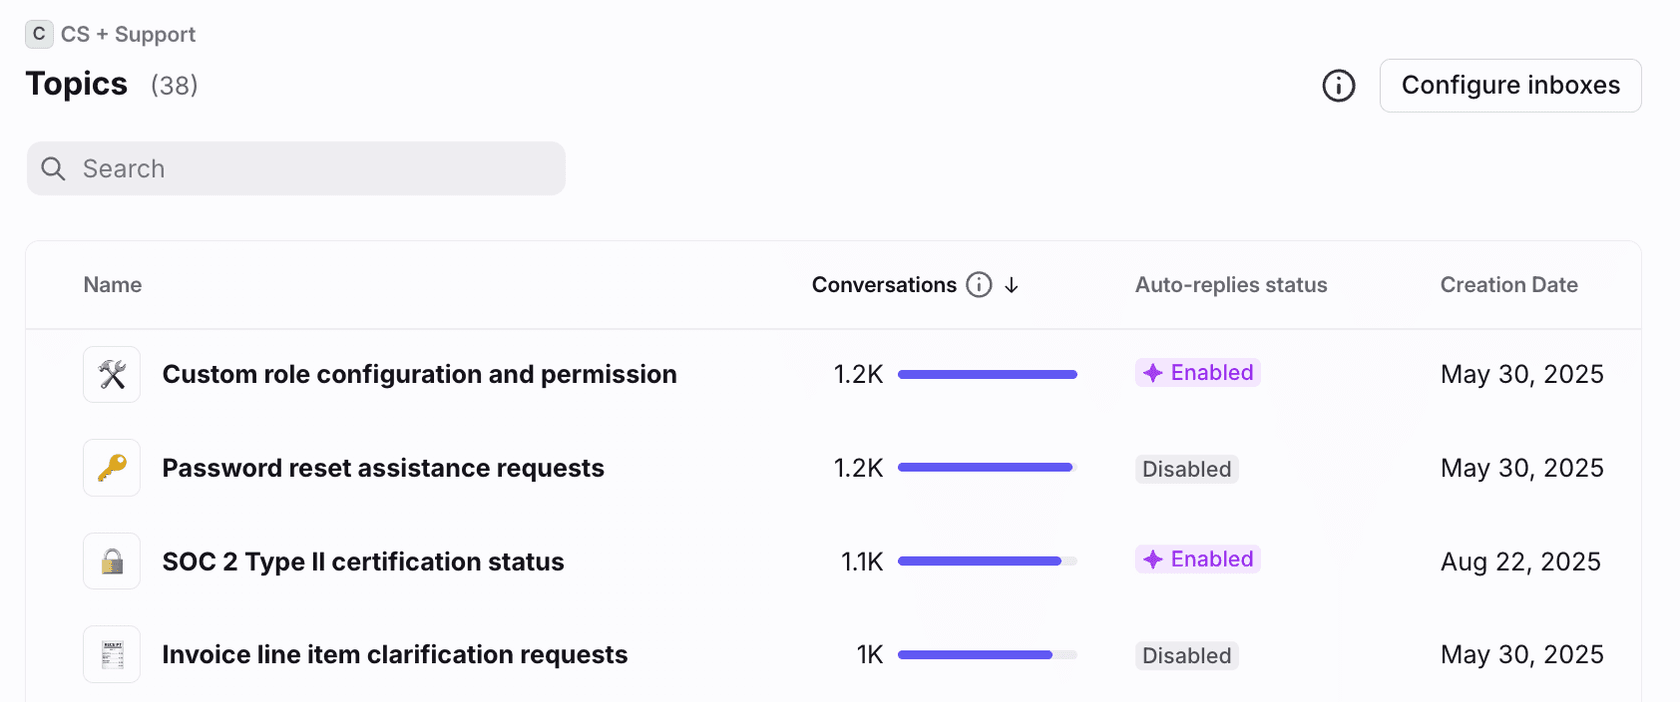
Help Scout AI Topics schlägt 8 bis 15 Themen pro Posteingang vor, und eine tägliche Prüfung kann ein neues Thema anlegen, wenn ein Trend auftaucht. Front Topics gruppiert Konversationen nach Kontaktgründen. Es ist für Posteingänge mit über 1.000 Konversationen im Monat gedacht und hat eine durchschnittliche Zuordnungsgenauigkeit von 85 %.
Wo bleiben eingebaute KI-Berichte zurück?
Eingebaute KI-Berichte bleiben an drei Stellen zurück: Die Tags driften, der Umfang ist eng, und der Bericht hört bei einem Diagramm auf. Das ist kein Grund, sie zu überspringen. Betrachten Sie es eher als Dinge, um die man herumplanen muss.
Tags driften und werden nur einmal gelesen. Mehrere dieser Tools klassifizieren nur anhand der ersten Nachricht. Ein Ticket, das als Versandfrage beginnt und zur Erstattung wird, behält das erste Label. Front veröffentlicht eine durchschnittliche Genauigkeit von 85 %, was ehrlich und nützlich ist, und es bedeutet auch, dass etwa jedes siebte Ticket im falschen Fach liegt.
"it only detects the parameters on the first ticket, so if a customer goes from angry to happy or vice versa, or has a new need/"intent" on the same ticket, nothing is updated. Intent is not always accurate, therefore is a little bit difficult to make rules according to it, and even language detection does not work from time to time"
Die besten Signale betreffen nur den Bot des Anbieters. Der Improve-Tab von Freshdesk, die Übergaben pro Artikel bei Gorgias und die Autopilot-Aufschlüsselungen von Front sind alle stark, beschreiben aber meist Konversationen, die der KI-Agent des Anbieters bearbeitet hat. Tickets, die Ihr menschliches Team beantwortet, fließen nicht in dieselbe Wissenslückenansicht ein.
Ein Diagramm ist keine Korrektur. Jedes der genannten Tools kann Ihnen zeigen, dass Abrechnungstickets gestiegen sind. Das mit der Verlängerungs-E-Mail zu verknüpfen und an den Abrechnungsverantwortlichen zu schicken, braucht einen Menschen oder einen Agenten, der nach Ihren Anweisungen arbeitet. Wenn die KI Ihnen den Export erspart, aber niemand handelt, verschieben sich die Stunden nur anderswohin.
"The ticket still needs tagging, the CRM still needs updating, the summary still needs writing, and half the time someone has to re categorise it anyway because the bot picked the wrong macro. So my team's hours did not really go down. They just shifted to cleanup work"
Gegen Drift hilft in der Praxis eine feste Gründeliste, aus der die KI wählt und nie etwas erfindet, dazu ein wöchentlicher Blick auf eine Stichprobe der Tags. Die Feinabstimmung habe ich in meinem Leitfaden zu falsch-positiven Tags bei Tickets beschrieben.
Wie machen Sie aus Ticketthemen Korrekturen?
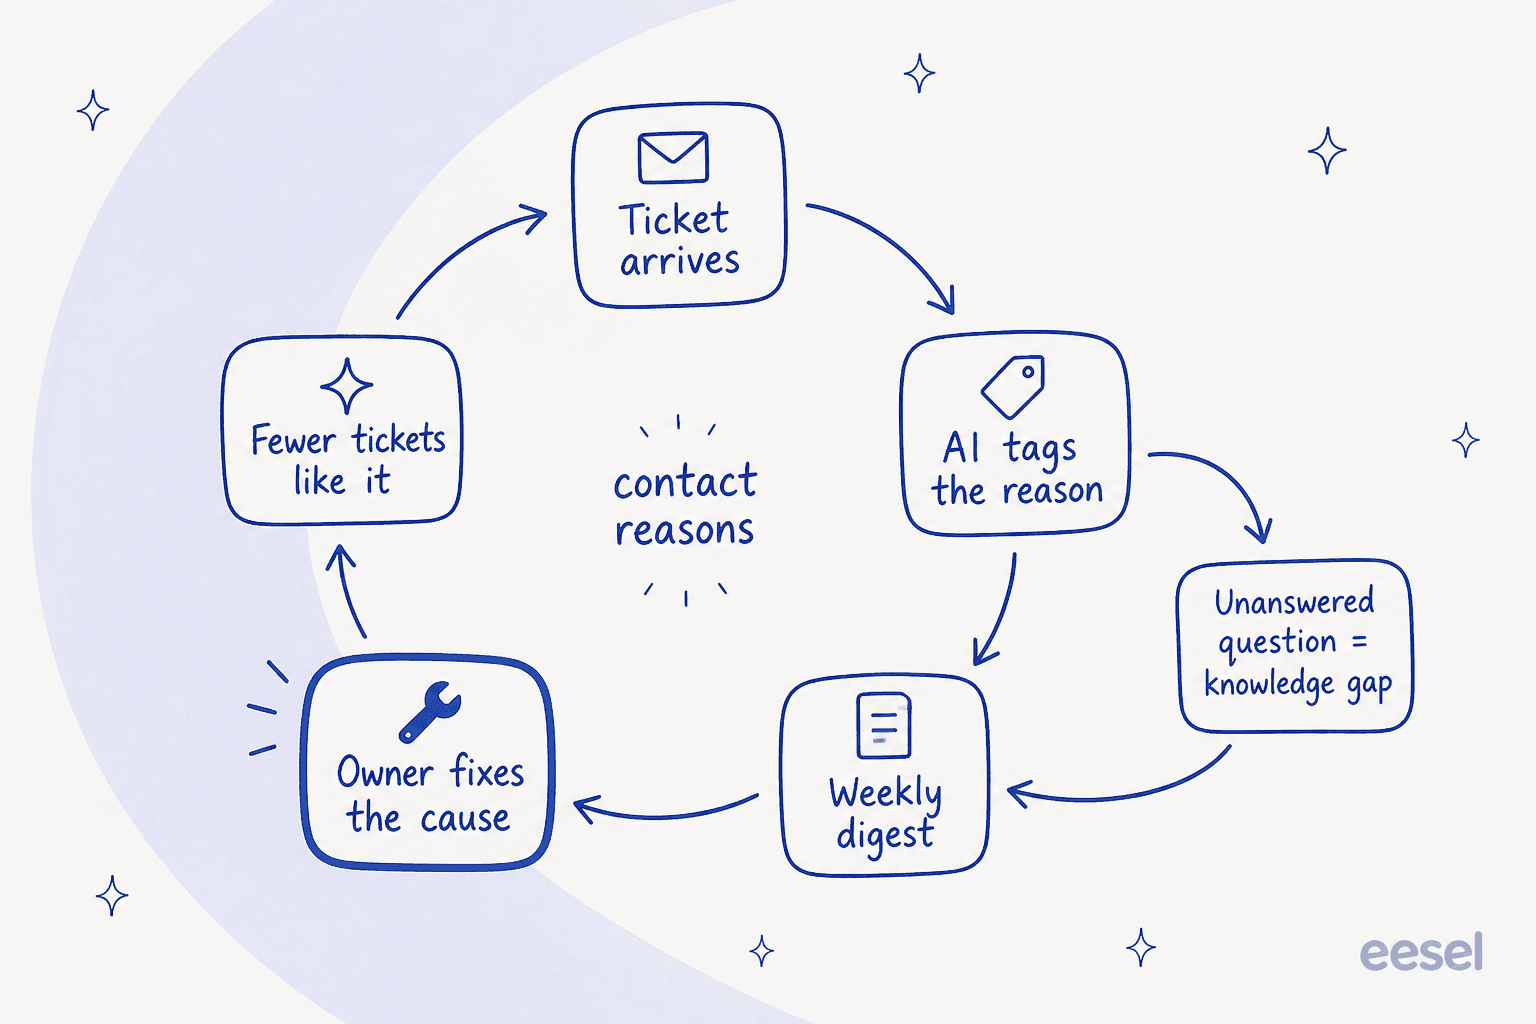
Sie machen aus Ticketthemen Korrekturen, indem Sie jedem Kontaktgrund einen Verantwortlichen außerhalb des Supports geben, plus einen wöchentlichen Termin, um ihn anzusehen. Die KI macht diese Schleife günstig. Sie taggt den Grund, wenn das Ticket eintrifft, vermerkt, was sie nicht beantworten konnte, schreibt den Digest und zeigt Ihnen in der Folgewoche, ob die Korrektur gewirkt hat.
Nicht jeder Grund verdient eine Korrektur. Ich finde die Aufteilung nützlich, wie oft ein Grund auftritt gegenüber dem, was er Ihr Team jeweils kostet, also vor allem Bearbeitungszeit plus wiederholte Kontakte:
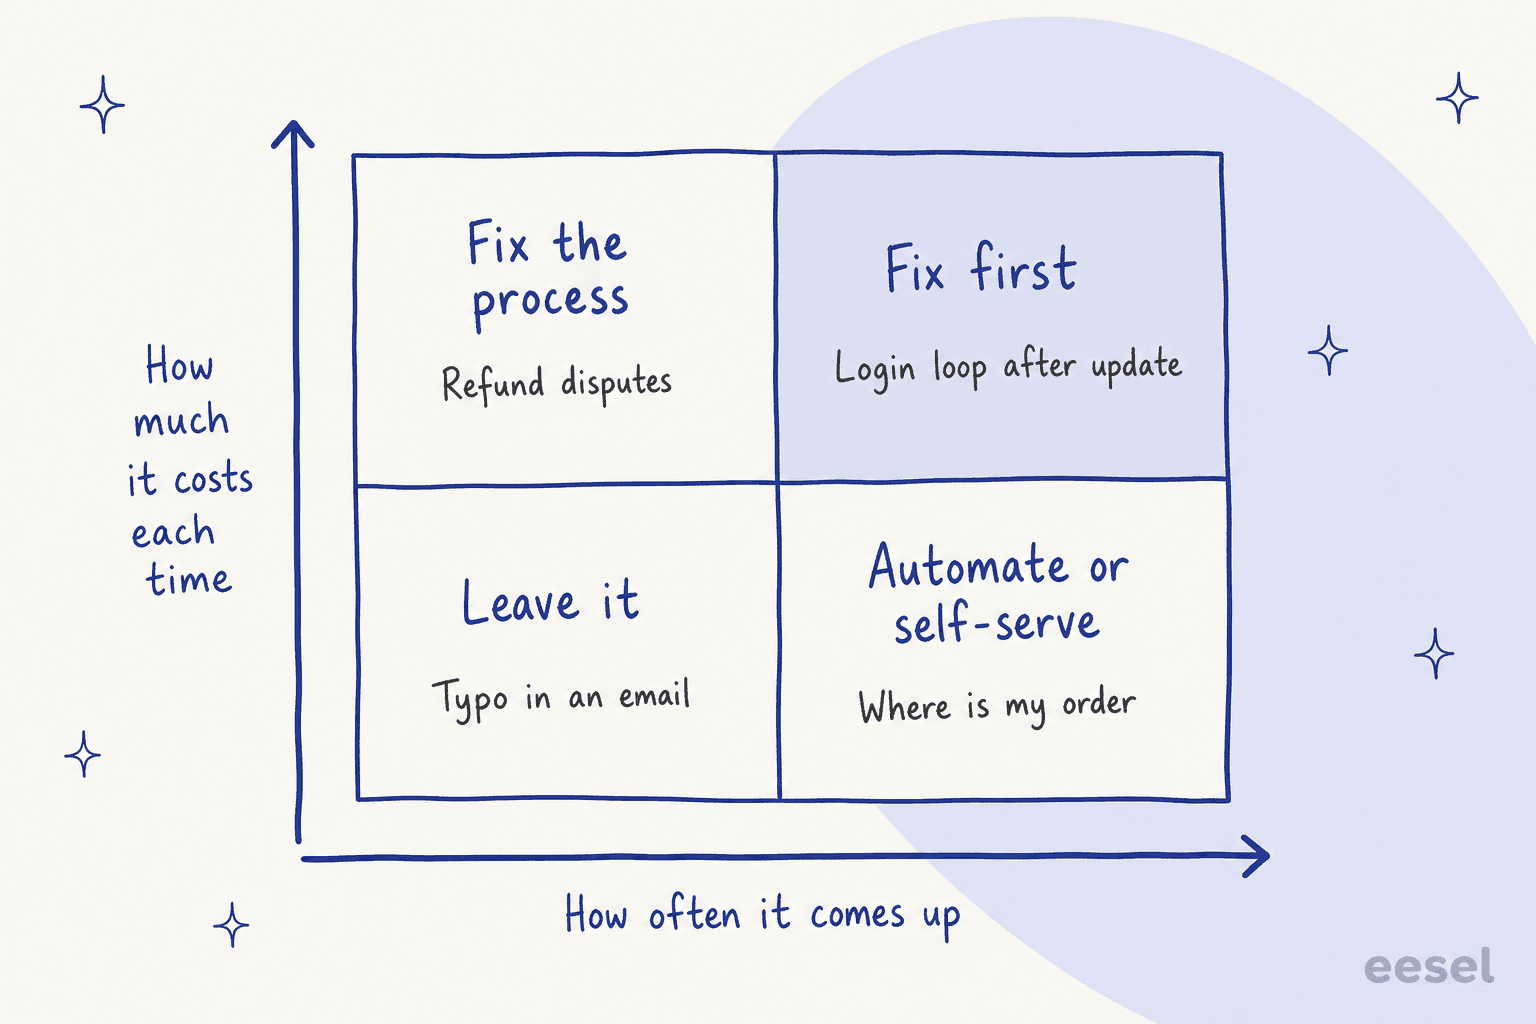
- Häufig und teuer: zuerst beheben. Eine Login-Schleife nach einem Update ist ein Bug, und die Entwicklung braucht eine wöchentliche Zählung mit Beispieltickets.
- Selten und teuer: den Prozess beheben. Erstattungsstreitigkeiten verlangen meist eine klarere Richtlinie statt mehr Agenten.
- Häufig und günstig: automatisieren oder Self-Service anbieten. „Wo ist meine Bestellung" ist der Klassiker, und ein KI-Agent mit Bestellabfrage kann ihn komplett beantworten. Was das für Ihre Durchschnittswerte bedeutet, steht in meinem Beitrag zu KI zur Senkung der Bearbeitungszeit.
- Selten und günstig: liegen lassen. Nicht jeder Tippfehler braucht ein Projekt.
Der Fehler, den ich am häufigsten sehe, ist die Rangfolge allein nach Volumen. Ein Grund mit weniger Tickets, aber langen, wiederholten Kontakten kann unbemerkt mehr Agentenstunden verschlingen als der größte Eimer.
Was kostet Sie jeder Kontaktgrund?
Jeder Kontaktgrund kostet seine Tickets mal die Minuten pro Ticket, plus die wiederholten Kontakte, die er verursacht, alles multipliziert mit dem Preis einer Agentenstunde. Tragen Sie unten Ihre eigenen Zahlen ein, und die Gründe werden nach Kosten statt nach Anzahl neu gereiht.
Mit den Beispielzahlen hat „Where is my order" die meisten Tickets, doch das Login-Problem kostet mehr, weil jedes 14 Minuten dauert und 30% dieser Kunden erneut schreiben. Ein Bericht, der nur zählt, verbirgt genau diese Umreihung. Ticketzahlen stammen aus Ihren Tag-Daten; die meisten Helpdesks melden auch Bearbeitungszeit und Wiedereröffnungen pro Tag, und mein Beitrag zu KI-Kundenservice-Kennzahlen zeigt, wo Sie sie finden.
Welche Kennzahlen gehören in einen KI-Support-Bericht?
Ein KI-Support-Bericht braucht sechs Kennzahlen pro Kontaktgrund, nicht zwanzig für die ganze Warteschlange. Diese sechs sagen Ihnen, was zu beheben ist und ob die Korrektur gewirkt hat:
| Kennzahl | Was sie Ihnen sagt | Wo KI hilft |
|---|---|---|
| Volumen pro Kontaktgrund, Woche auf Woche | Was wächst oder schrumpft | Einheitliche Tags bei jedem Ticket |
| Rate wiederholter Kontakte pro Grund | Welche Probleme nicht wirklich gelöst sind | Verknüpft Nachfragen mit demselben Grund |
| Bearbeitungszeit pro Grund | Welche Gründe Agentenstunden fressen | Zerlegt den gemischten Durchschnitt |
| Eskalations- oder Übergaberate pro Grund | Welche Gründe einen Menschen oder eine Richtlinie brauchen | Zeigt, wo die KI oder Tier 1 aufhört |
| Stimmung pro Grund | Welche Gründe Kunden am meisten verärgern | Erkennt den Ton ohne Umfragen |
| Wissenslücken pro Grund | Welche Hilfeartikel fehlen | Protokolliert Fragen, die die Dokumente nicht beantworten konnten |
Zwei weitere sollten Sie für die KI selbst im Blick behalten: wie oft Leute ihre Tags korrigieren und wie oft sie ihre Entwürfe oder Aktionen ablehnen. Steigt eines von beiden, korrigieren Sie die Gründeliste oder die Anweisungen, bevor Sie den Trends trauen. Warum die Erfolgszahl eines Bots dieselbe Vorsicht braucht, steht in meinem Beitrag zu Deflection vs. Resolution Rate, und KI-CSAT behandelt von KI bewertete Zufriedenheit.
Wie richten Sie KI-Support-Reporting in 30 Tagen ein?
Sie können KI-Support-Reporting in etwa 30 Tagen einrichten, wenn Sie zuerst die Gründeliste festlegen und den Bericht erst danach automatisieren. In dieser Reihenfolge:
- Woche 1: die Gründeliste schreiben. Ziehen Sie die Tickets der letzten 60 bis 90 Tage und entwerfen Sie 15 bis 25 Kontaktgründe in den Worten Ihrer Kunden, jeweils mit einer einzeiligen Definition und einem Verantwortlichen. Streichen Sie „Sonstiges" oder begrenzen Sie es zumindest.
- Woche 1: prüfen, was Sie schon haben. Nutzen Sie die Tabelle oben. Enthält Ihr Tarif bereits KI-Themen, schalten Sie sie ein und vergleichen Sie deren Themen mit Ihrer Liste.
- Woche 2: beim Eingang taggen. Lassen Sie die KI bei jedem neuen Ticket einen Grund aus der festen Liste wählen und jedes Mal eine Wissenslücke protokollieren, wenn sie aus Ihren Dokumenten nicht antworten kann. Prüfen Sie am Ende der Woche 50 Tags von Hand.
- Woche 3: den Digest planen. Ein Wochenbericht jeweils am selben Tag zur selben Zeit, mit Volumen und Veränderung pro Grund, den drei größten Lücken, drei Beispieltickets je Erkenntnis und einer empfohlenen Korrektur pro Verantwortlichem.
- Woche 4: die Schleife schließen. Im Meeting übernimmt jeder Verantwortliche eine Korrektur. Der nächste Digest zeigt dann, ob sich Volumen und wiederholte Kontakte für diesen Grund bewegt haben.
Wenn Sie heute Zendesk Explore nutzen, deckt Zendesks eigener Dienst für geplante Berichte den Versandschritt ab. Schwierig bleiben die Schritte 1 und 5.
Wie geht eesel mit Support-Reporting um?
eesel erledigt Support-Reporting direkt in der Warteschlange. Derselbe KI-Teammate, der Ihre Tickets beantwortet oder entwirft, taggt sie auch anhand Ihrer Liste, protokolliert, was er nicht beantworten konnte, und schreibt jeden Bericht, den Sie anfordern. Er schließt sich Zendesk, Freshdesk, Gorgias, HubSpot, Help Scout oder Front an, sodass es gar keinen Exportschritt gibt.
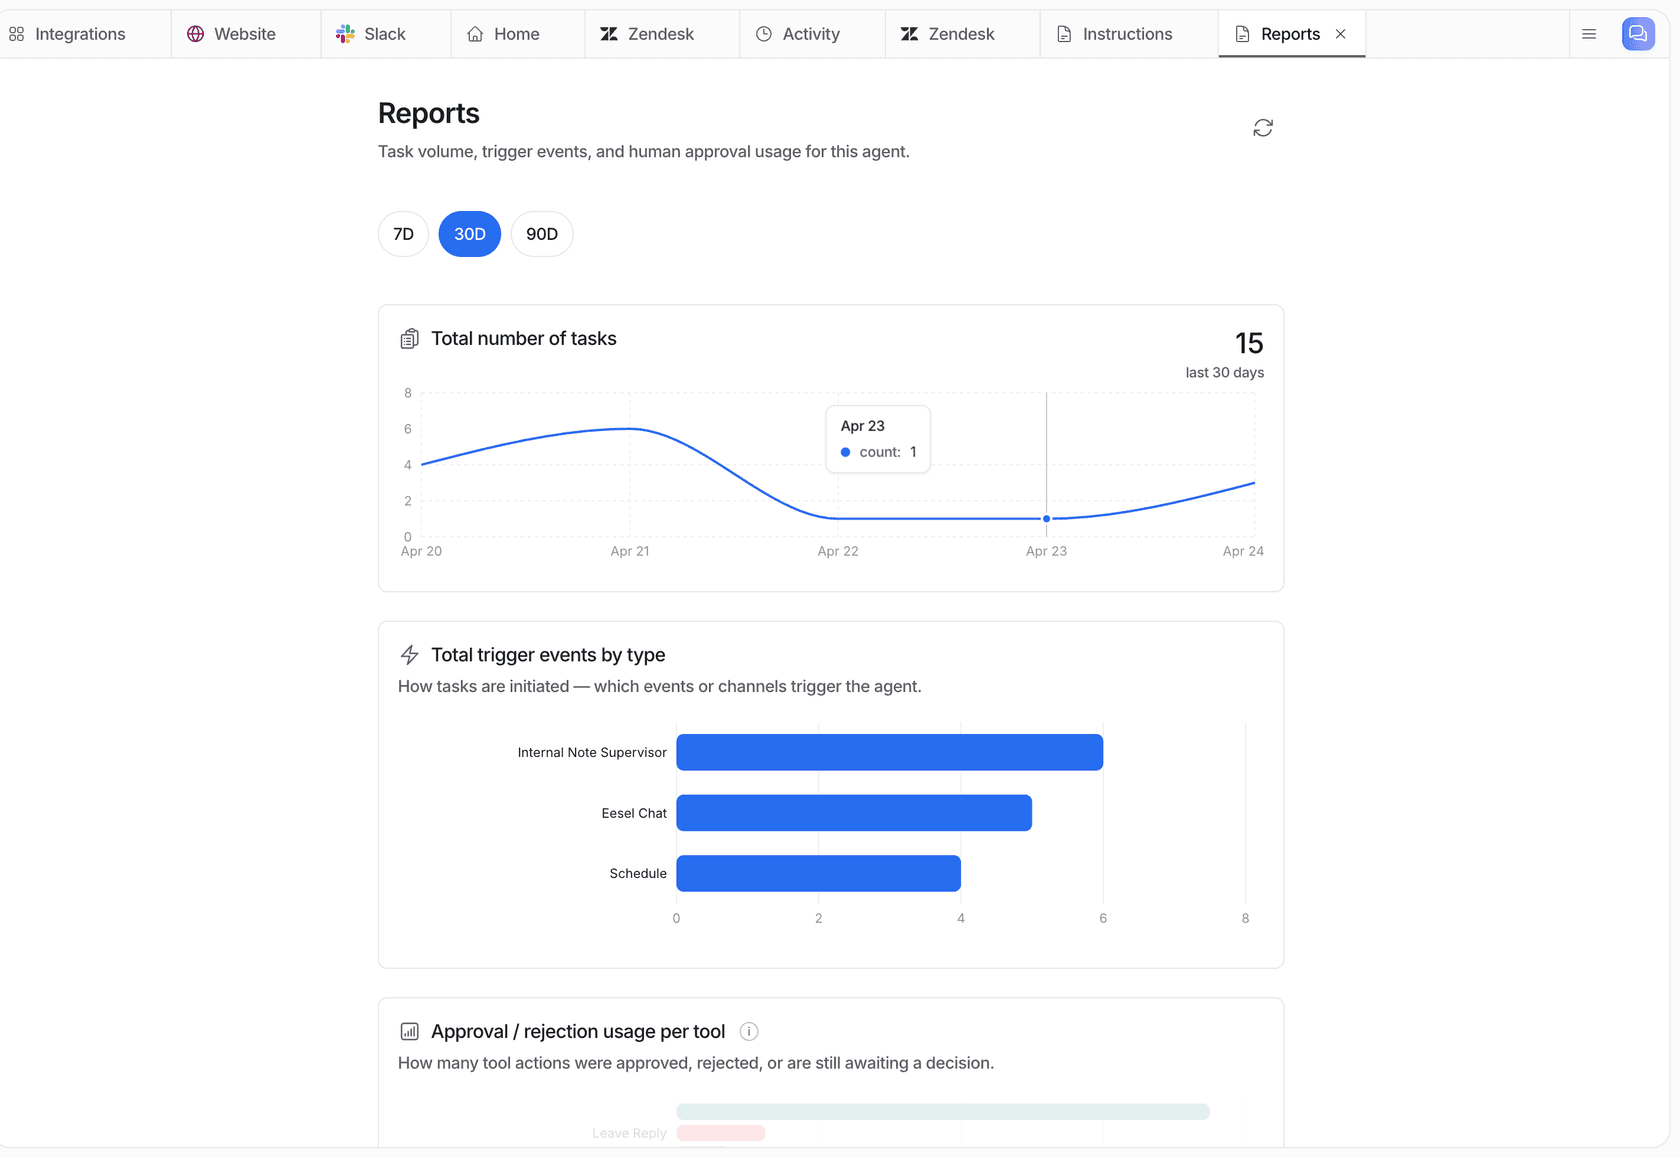
Die Reports-Seite zeigt Volumen, einen KI-Qualitätswert, Wissenslücken im Zeitverlauf und wie oft Ihr Team seine Aktionen genehmigt oder ablehnt, für 24 Stunden, 7, 30 oder 90 Tage oder einen eigenen Zeitraum. Ein ehrlicher Hinweis aus eesels eigener Dokumentation: Der Qualitätswert „is not customer feedback". Er ist die Bewertung der Antworten des Agenten durch eine KI, ich würde ihn also als internes Signal lesen.
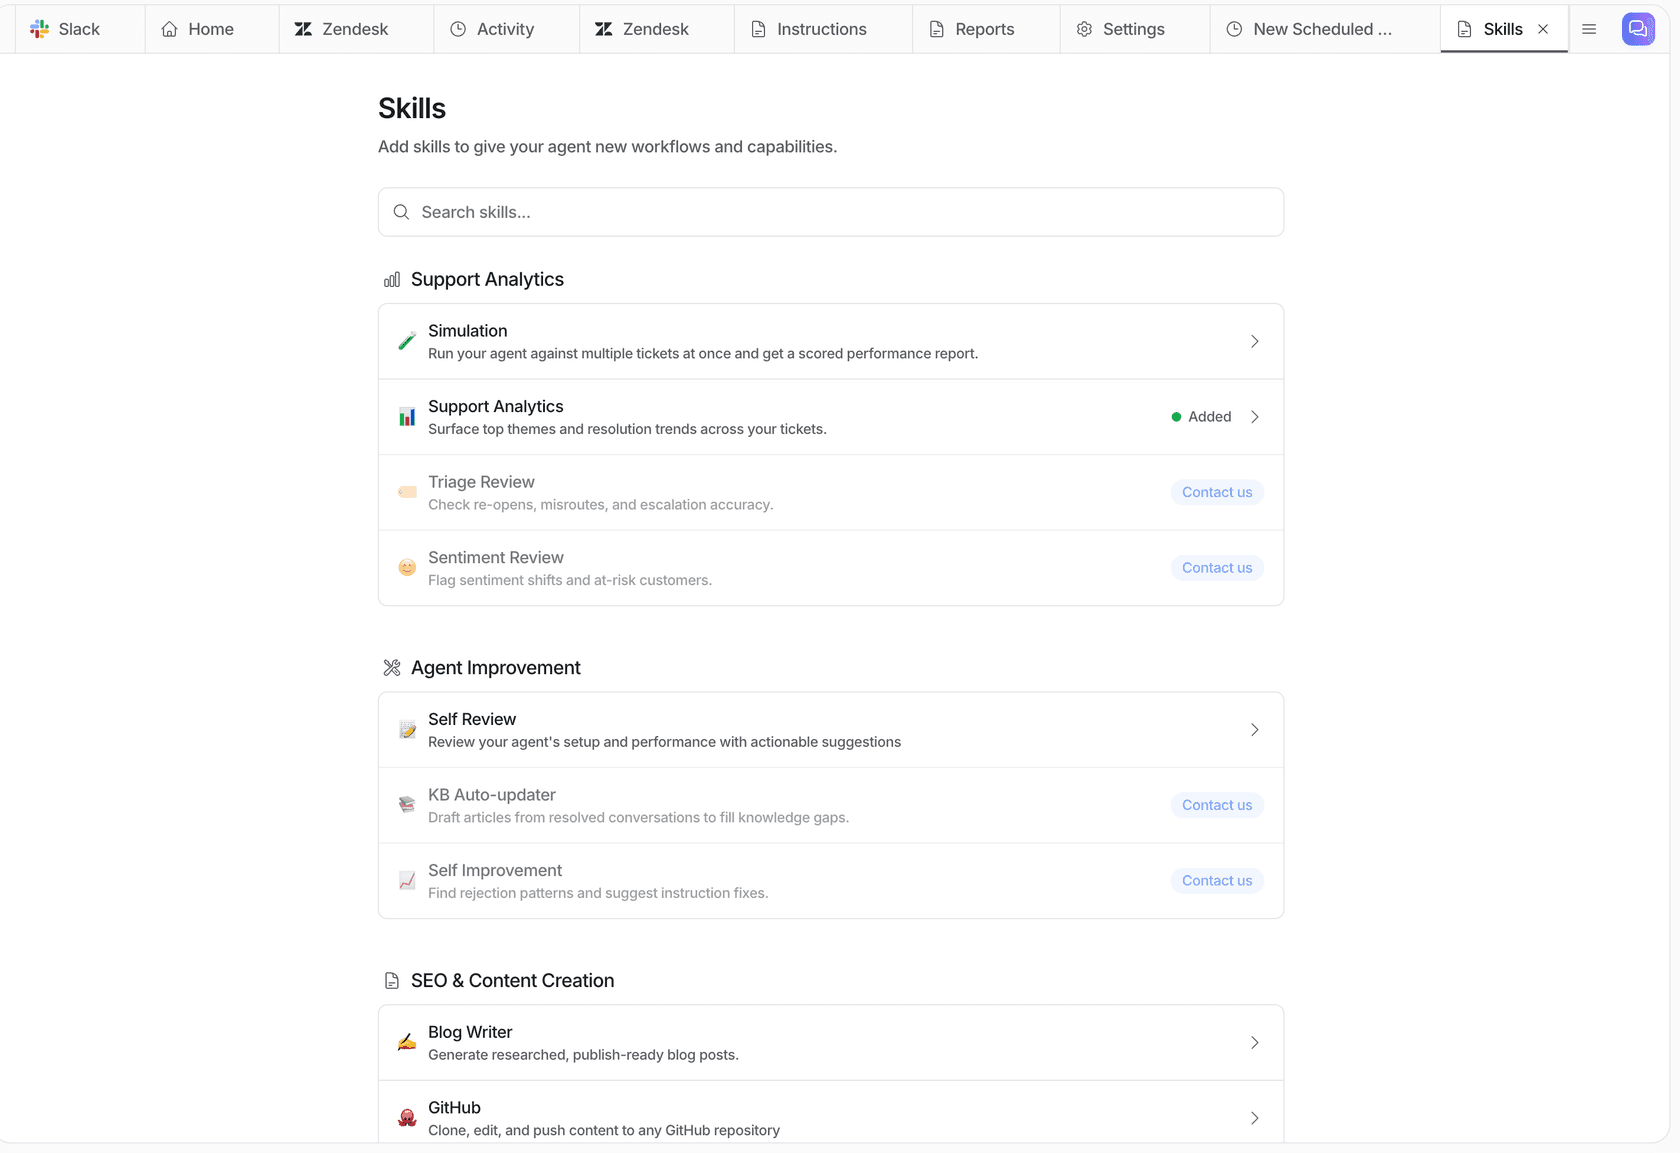
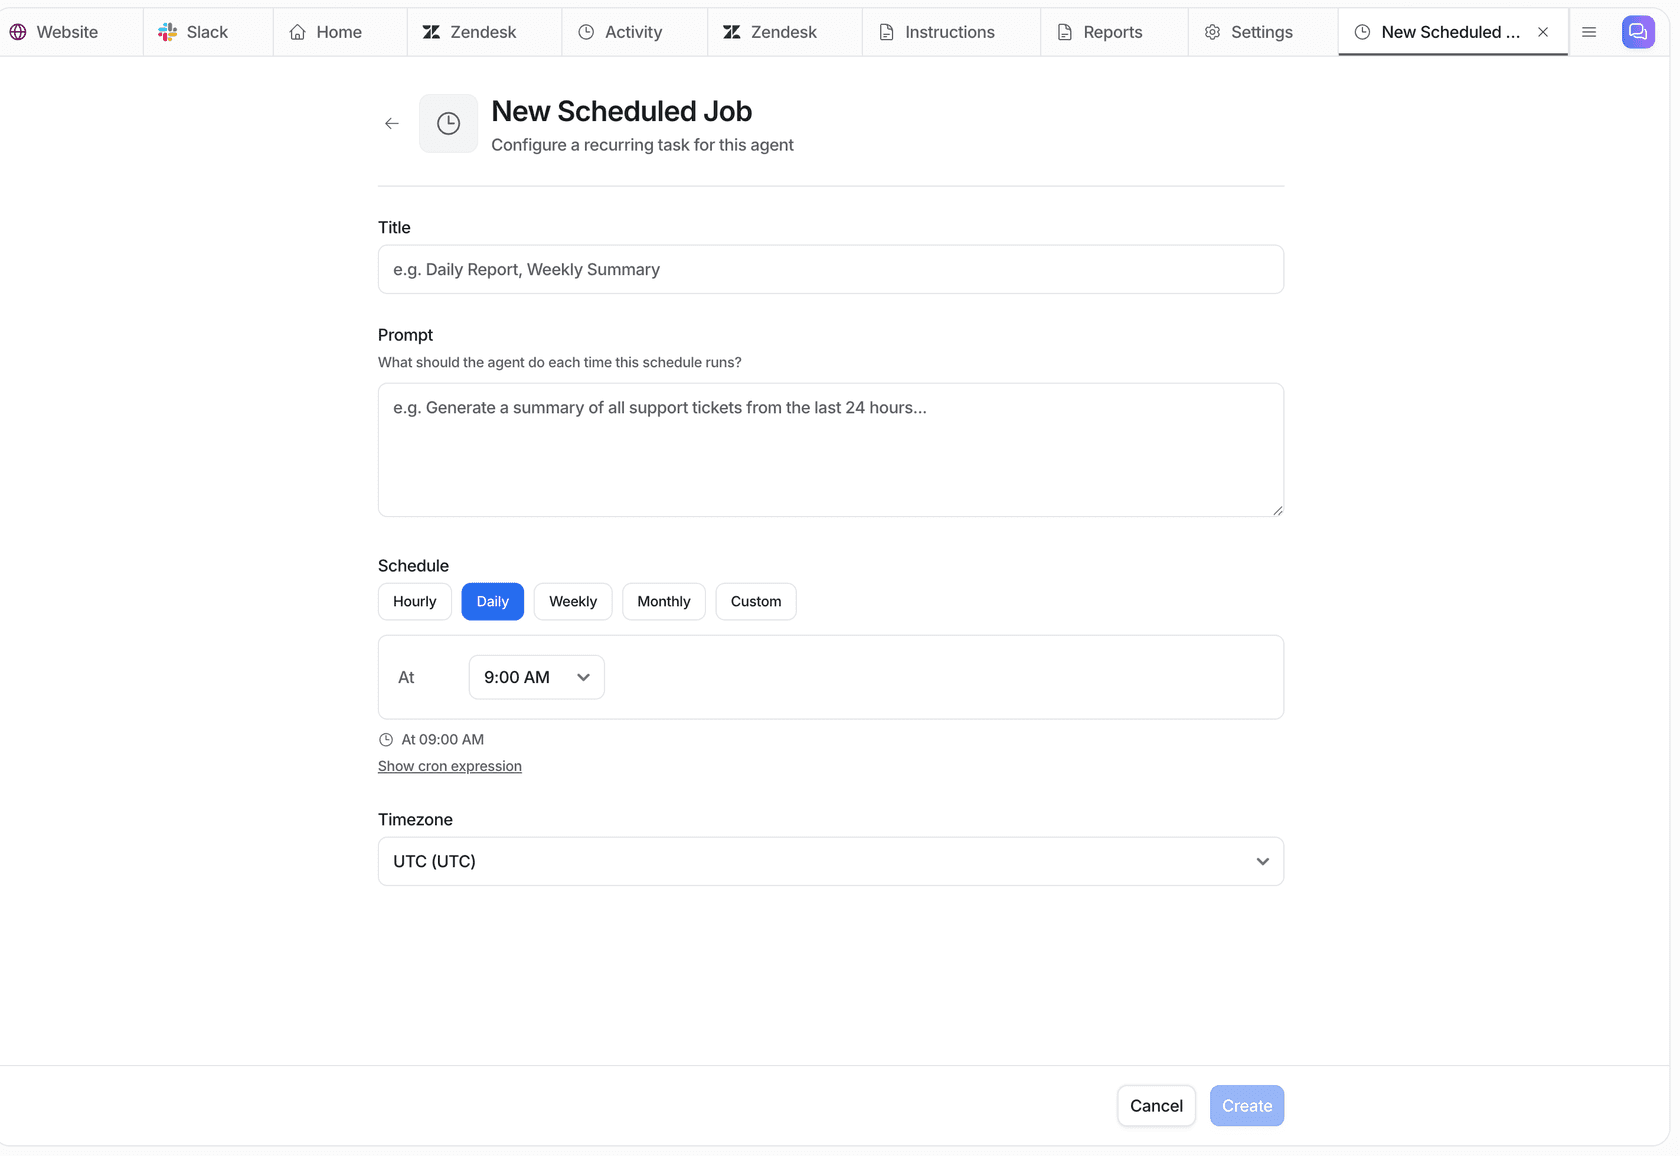
Für den schriftlichen Bericht fragen Sie einfach im Chat. Der Skill Analyze ticket trends findet wiederkehrende Themen samt Stimmung, Volumen und Lösungsweg. Das Beispiel Weekly support report in den Skills-Dokumenten deckt Volumen und Trend pro Thema ab, was die KI selbst bearbeitet und was sie übergeben hat, Wissenslücken und was zuerst zu beheben ist, und wird jeden Montag per E-Mail versendet. Es gibt auch einen Knowledge gaps report, der unbeantwortete Fragen der letzten 30 Tage nach Thema gruppiert und die drei wichtigsten fehlenden Seiten entwirft.
So sieht das bei echten Kunden aus:
- smava erhält rund
27,000Zendesk-Tickets im Monat über zwei Marken. Ein eesel-Agent taggt die Sprache und wählt für jedes Ticket eine einzelne Kategorie aus einer festen Liste, rund14,600kategorisiert in einem Monat, und schreibt sie in Zendesk-Felder, die ihre Berichte bereits nutzen. - Rúngne betreibt einen Triage-Agenten in Gorgias, der Thema, VIP und B2B aus einer festen Liste taggt, mit „nothing invented": rund
880Tickets in einem Monat getaggt. - Dokument 24 lässt eesel jedes neue Zendesk-Ticket nach Produkt taggen (Testament, Ehevertrag, Vorsorgevollmacht oder Firmengründung), was rund
430getaggte Tickets in einem Monat ergab. - Cape Coffee Beans führt fünf geplante Zendesk-Durchläufe aus, die meisten jeden Morgen, auf der Suche nach nicht zugewiesenen Tickets, wartenden Tickets ohne Wiedervorlagedatum und ohne Ergebnis geschlossenen Leads. Jeder endet in einer kurzen E-Mail an den Gründer, oder in keiner E-Mail, wenn es nichts zu berichten gibt. Ein wöchentlicher Inhaltslückenbericht, nach Produkt gruppiert, ist bereits geschrieben und kann jederzeit aktiviert werden.
- Ein Industrieautomatisierungsunternehmen schickt seinem Dokumentationsteam einen regelmäßigen Digest darüber, was der Chat gefragt wurde, welche Antworten schlecht bewertet wurden und wo das Wissen Lücken hatte. Diese Lücken landen direkt im Dokumentations-Backlog.
Einen Einwand höre ich von Käufern öfter: Berichte schauen zurück, Kunden brauchen aber jetzt die richtige Antwort. Das stimmt. Deshalb laufen Tagging und Routing auch beim Eingang, bei der ersten Nachricht des Kunden in Zendesk, und der Bericht ist nur die Wochenansicht derselben Daten.
Wenn Ihr Team im Terminal lebt, steuert die eesel CLI denselben Agenten. eesel activity listet auf, was er getan hat, das Neueste zuerst. eesel files holt gespeicherte Berichte, und eesel chat "analyze our ticket trends for last month" führt den Trends-Skill aus einem Skript aus. Jeder Befehl gibt JSON aus, sodass Claude Code, Cursor oder Codex die Zahlen in jedes Dashboard ziehen können, das Sie bereits führen.
Was kostet KI für Support-Reporting?
KI für Support-Reporting kostet nichts extra, wenn Ihr aktueller Helpdesk-Tarif KI-Themen bereits enthält. Wenn nicht, liegt der Preis irgendwo zwischen einem Tarif-Upgrade und einem separaten KI-Tool. Die gängigen Einstiegspunkte, den Preisseiten der Anbieter entnommen:
| Option | Was Sie zahlen | Was es abdeckt |
|---|---|---|
| Zendesk Suite Professional | $115/Agent/Monat jährlich, Copilot $50/Agent/Monat, um Themen in Regeln zu nutzen | Intelligent-Triage-Tags, Triage-Dashboard, Schnellberichte |
| Freshdesk Enterprise | $89/Agent/Monat jährlich | Proactive Insights, Ursachenanalyse, Conversational Insights |
| Gorgias | Helpdesk ab $10/Monat | Intent und Stimmung bei jeder Nachricht |
| HubSpot Service Hub Professional | $90 bis $100/Platz/Monat | Themen (Beta), CX-Score, Breeze-Berichtserkenntnisse |
| Help Scout Plus | $45/Nutzer/Monat | AI Topics (Beta) und Topics-Bericht |
| Front Starter | $25/Platz/Monat | AI Topics |
| eesel | Kostenlos mit 100 Credits, dann $299/Monat für 500 Credits bis $1,749/Monat für 5.000 | Tags, Triage, Antworten, Berichte und geplante Digests in Ihrem bestehenden Helpdesk |
Preise pro Platz wachsen mit dem Team, die von eesel wachsen mit den Tickets. Ein Ticket oder ein Chat ist ein Credit, und auch Berichte und geplante Läufe verbrauchen Credits, planen Sie also etwas über Ihrer monatlichen Ticketzahl ein. Wenn Sie Freshdesk Pro nutzen und Spitzenwarnungen wollen, wägen Sie das Upgrade auf Enterprise für alle Agenten gegen einen Teammate ab, der die vorhandenen Tickets taggt und auswertet. Die vollständigen Tarifübersichten stehen in meinen Beiträgen zu Zendesk-KI-Preisen und Freshdesk-Preisen.
eesel für Support-Reporting testen
Wenn Ihr Montagmorgen noch mit einem Tabellenexport beginnt, funktioniert eesel wie ein neuer Teammate, der alle Tickets der letzten Woche schon gelesen hat. Er schließt sich Ihrer Zendesk-, Freshdesk-, Gorgias- oder Help-Scout-Warteschlange an und taggt jedes Ticket anhand Ihrer eigenen Gründeliste. Er vermerkt jede Frage, die Ihr Help Center nicht beantworten konnte, und versendet dann einen Wochenbericht mit den Themen, den Lücken und dem, was zuerst zu beheben ist, während er die Tickets selbst entwirft oder beantwortet.
Das ist das Setup, das smava mit 27,000 Zendesk-Tickets im Monat betreibt. Eine Simulation an 20 Ihrer zuletzt gelösten Tickets zeigt, wie seine Antworten im Vergleich zu denen Ihres Teams aussehen, bevor irgendetwas live geht, und Sie starten mit 100 kostenlosen Credits, ohne Karte.
eesel testen an den Tickets der letzten Woche, oder lesen Sie zuerst meinen Überblick über KI-Ticket-Triage.