

Personalplanung im Support besteht aus fünf Schritten in einer Schleife: Volumen pro 30-Minuten-Intervall prognostizieren, mit der durchschnittlichen Bearbeitungszeit (AHT) multiplizieren, Erlang C für Live-Kanäle anwenden, Ausfallzeiten hinzurechnen und die Prognose dann mit dem tatsächlichen Verlauf abgleichen. Lassen Sie einen Schritt aus, und Sie erleben den Klassiker: ein auf den Tagesdurchschnitt besetztes Team, das montags um 10 Uhr untergeht.
Die Zahlen schwanken stärker, als die meisten Teams erwarten. Bei 60 Chats pro halbe Stunde und 6 Minuten Bearbeitungszeit verlangt Erlang C 15 Agenten in der Warteschlange, um 80 % innerhalb von 60 Sekunden zu beantworten, und 30 % Ausfallzeiten machen daraus 22 Personen im Dienstplan. E-Mail und Tickets funktionieren anders, weil sie warten können: Besetzen Sie sie nach dem SLA-Fenster, nicht mit Erlang C.
Von den Helpdesks, die ich geprüft habe, liefert nur Zendesk eine echte Prognose (das WFM-Add-on). Gorgias, Help Scout und HubSpot bieten Heatmaps und Exporte, die Prognose bauen Sie anderswo. Und ein KI-Agent verändert die Rechnung auf eine Weise, die die meisten Pläne übersehen: Er übernimmt die einfachen Tickets, sodass das Volumen sinkt, die Bearbeitungszeit für den Rest aber steigt. eesel betreibt seinen KI-Helpdesk-Teamkollegen seit 2023 in Live-Warteschlangen. Das klarste Beispiel, das ich habe, ist Norden-Frisia, eine deutsche Fährreederei, die in der Hochsaison mit 10,000 Interaktionen pro Monat plant und von Oktober bis März wieder herunterskaliert, statt für den Sommer einzustellen.
Warum werden Support-Teams immer wieder auf dem falschen Fuß erwischt?
Ich bin Riell und arbeite jeden Tag in der Support-Warteschlange von eesel. Die Frage hinter diesem Beitrag kommt meist so an: „Wir haben letztes Quartal zwei Leute eingestellt, warum stehen wir montags trotzdem unter Wasser?“ Die Antwort lautet fast nie allein Personalstärke. Es liegt daran, dass die Personalstärke gegen einen Tages- oder Wochendurchschnitt geplant wurde, und Kunden kommen nicht im Durchschnitt.
Ein Team, das 400 Tickets am Tag bekommt, bekommt nicht 50 pro Stunde über einen 8-Stunden-Tag. Es können 90 zwischen 9 und 10 Uhr sein, 20 nach dem Mittagessen und eine Spitze um 18 Uhr, wenn die Leute nach Hause kommen und nach ihrer Bestellung schauen. Wer auf 50 pro Stunde besetzt, ist die Hälfte des Tages überbesetzt und die andere Hälfte begraben. Diese Lücke versucht die Abdeckungsplanung zu schließen, und die Prognose ist die Mathematik darunter.
Contact Center haben das vor Jahrzehnten mit Workforce Management (WFM) gelöst. Das Vokabular wirkt etwas einschüchternd (Erlang C, Ausfallzeiten, Auslastung, Service Level), aber jeder Begriff beantwortet eine einfache Frage, und Sie können die ganze Methode in einer Tabelle durchrechnen. Neu ist, dass die meisten Support-Teams heute mit einem Helpdesk statt einer Telefonanlage arbeiten und ein wachsender Teil ihres Volumens zuerst an einen KI-Agenten geht. Beides verändert, wie Sie die alte Methode anwenden.
Wie funktioniert Personalplanung im Support?
Jedes WFM-Tool, das ich mir angesehen habe, von Zendesk WFM bis Assembled, folgt derselben Pipeline. Die Anbieter unterscheiden sich darin, welcher Algorithmus das Volumen prognostiziert und wie viel Sie anpassen können, aber die Form bleibt gleich.
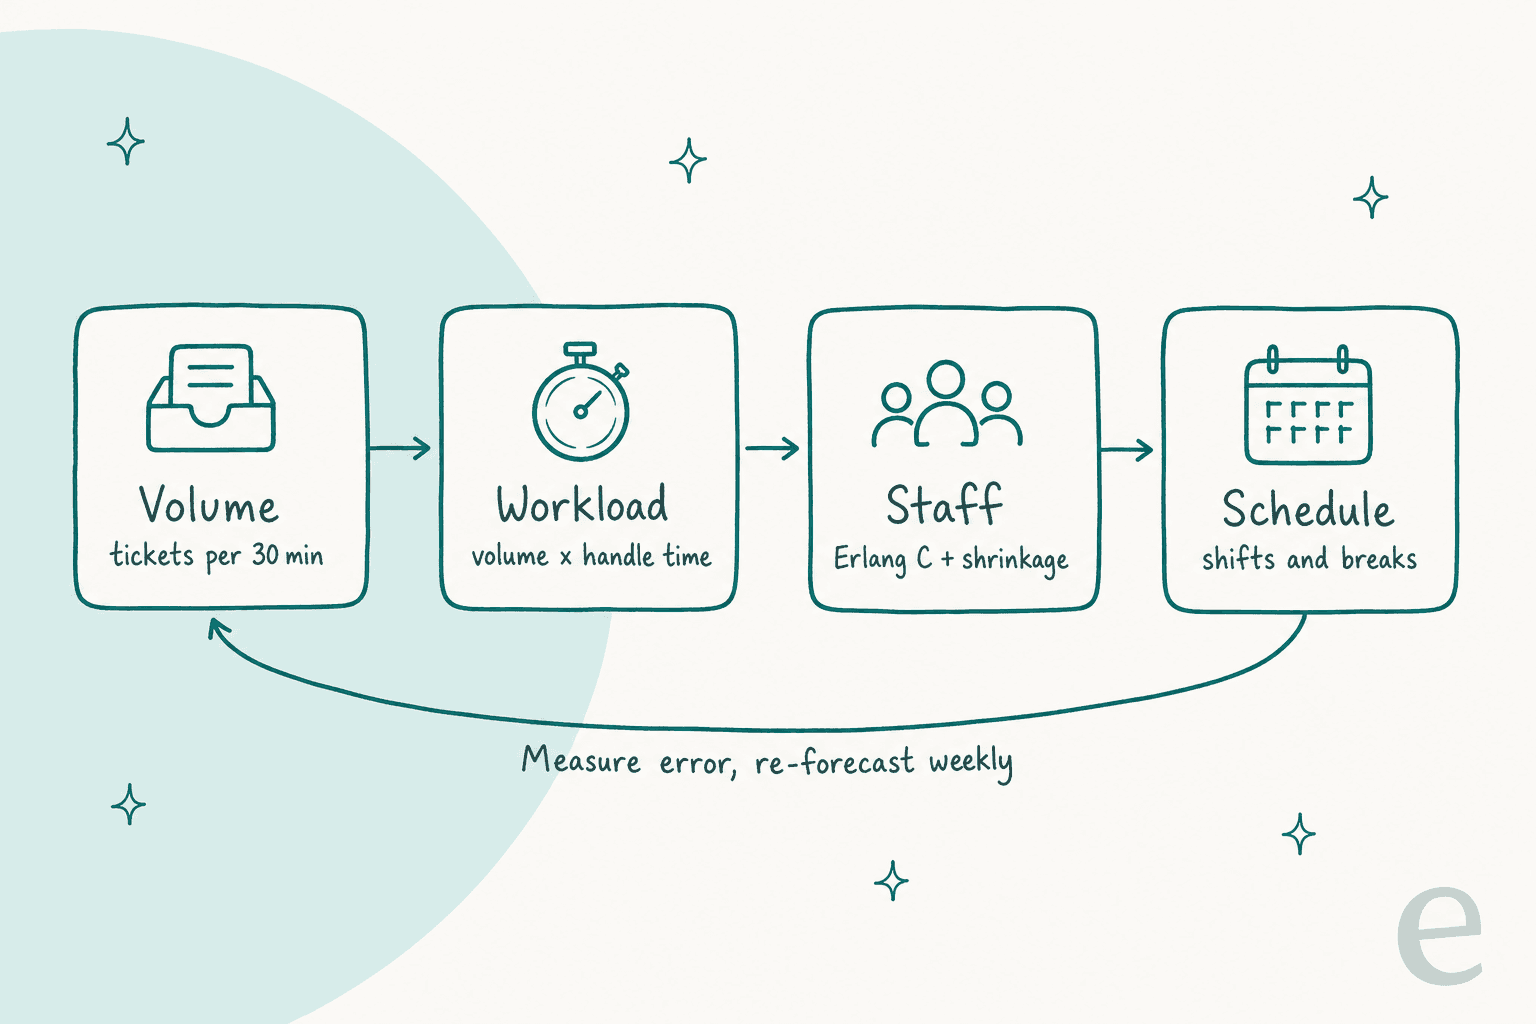
- Volumen: wie viele Kontakte in jedem 15- oder 30-Minuten-Intervall eintreffen, pro Kanal.
- Arbeitslast: Volumen multipliziert mit der durchschnittlichen Bearbeitungszeit, damit Sie wissen, wie viele Agentenminuten jedes Intervall braucht.
- Besetzung: wie viele Agenten nötig sind, um Ihr Service Level zu erreichen, mit Erlang C für Live-Kanäle, dann um Ausfallzeiten hochgerechnet.
- Dienstplan: Schichten und Pausen über dem Bedarf, sodass die Abdeckung der Kurve folgt.
- Messen: Prognose und Ist-Werte im Intervall vergleichen, die Eingaben korrigieren, wöchentlich wiederholen.
Der Rest dieses Beitrags geht jeden Schritt durch und betrachtet dann, was Ihr Helpdesk für Sie tun kann, wie Sie Spitzen planen und was sich ändert, sobald ein KI-Agent in der Warteschlange sitzt.
Wie prognostiziert man das Ticketvolumen nach Intervall?
Beginnen Sie mit dem Verlauf. Sie brauchen Kontakte pro Kanal, nach Datum und 15- oder 30-Minuten-Intervall geordnet, in Ihrer eigenen Zeitzone. Zendesk WFM erstellt mit weniger als einem Monat an Daten keine Prognose und zieht standardmäßig sechs Monate ein (Zendesk docs). Das ist auch für eine Tabelle eine sinnvolle Untergrenze.
Die Standardmethode ist der N-Wochen-Durchschnitt: Für den nächsten Dienstag 10:00-10:30 Uhr bilden Sie den Durchschnitt der letzten N Dienstage zwischen 10:00 und 10:30 Uhr. Die Dokumentation von Assembled nennt ihn den empfohlenen Standard, „generally very accurate for short term forecasting (~1 to 4 weeks)“, und schlägt 8 Wochen vor (Assembled forecast models). Der einfachste Algorithmus von Zendesk WFM ist dieselbe Idee: derselbe 15-Minuten-Slot, gemittelt über die letzten acht Wochen (Zendesk algorithms).
Der N-Wochen-Durchschnitt hat einen blinden Fleck: Er sieht keine Trends oder Saisons. Wächst das Volumen um 5 % im Monat, hinkt ein 8-Wochen-Durchschnitt immer hinterher. Hier kommen die ausgefeilteren Modelle ins Spiel. Assembled bietet eine Momentum-Variante, ein Saisonmodell, das eine 12-Monats-Wachstumslinie mit Mustern nach Kalenderwoche, Wochentag und 15-Minuten-Slot multipliziert, sowie die Prophet-Bibliothek von Meta. Zendesk ergänzt XGBoost, LightGBM und ein neuronales LSTM-Netz und wählt pro Workstream automatisch das beste aus. Beide Anbieter wollen ein Jahr oder mehr Verlauf, bevor sich die saisonalen und Machine-Learning-Modelle lohnen.
Drei Dinge verbessern eine Prognose stärker als ein besserer Algorithmus:
- Die Eingabe bereinigen. Zendesk WFM zählt Spam im Volumen mit und zählt ein Ticket jedes Mal erneut, wenn es in einen neuen Workstream wechselt (Zendesk best practices). MentorShow, eine französische Online-Lernplattform auf HubSpot, sagte eesel, sie bekämen je nach Zeitraum zwischen
5,000und13,000Tickets im Monat, und „a large share is not a question at all“: PayPal-Hinweise, automatische Antworten, Umfrageantworten, ein Mitglied, das „merci“ schreibt. Prognostizieren Sie die Arbeit, nicht das Rauschen. - Aus einem Treiber prognostizieren, wenn Sie einen haben. Eine DTC-Nahrungsergänzungsmarke, die in einem Sales-Call mit eesel sprach, hat rund
7,000Gorgias-Tickets bei30,000Bestellungen im Monat, ein Verhältnis von Tickets zu Bestellungen von 25-30 %, mit Hochsaison von November bis Mai. Wenn das Marketing eine Bestellprognose liefert, macht das Verhältnis daraus schneller eine Ticketprognose, als es jede Zeitreihe könnte. - Ausreißer markieren. Ein Ausfall oder ein viraler Beitrag bläht den Verlauf auf und vergiftet dann jeden Durchschnitt, der ihn enthält. Zendesk WFM lässt Sie Ausreißer ausschließen und manuelle Volumenanpassungen für bekannte Ereignisse hinzufügen; Assembled bietet dieselben Anpassungen und Ausreißer-Werkzeuge.
Eine Tabelle reicht dafür bei mittlerer Größe aus, wie eine WFM-Leiterin mit 35 Agenten beschreibt:
"I use salesforce reports to build Google sheets forecasts based on volume history. This allows me to analyze the historic volume for specific days of the week and days of the month. Using a rolling last 60 days report, I built several pivot tables breaking down volume by hourly intervals by days of the week. ... For context, we have 35 agents and handle around 400-600 contacts per day, 24/7"

Wenn Sie noch keinen sauberen Verlauf haben, beheben Sie das, bevor Sie ein WFM-Tool kaufen. Taggen Sie konsequent, trennen Sie Kanäle und stellen Sie sicher, dass das Ticket-Triage die Kontakte in die richtige Warteschlange legt, denn eine Prognose pro Warteschlange ist nur so gut wie das Routing, das sie füllt.
Wie macht man aus Volumen mit der Bearbeitungszeit eine Arbeitslast?
Die Arbeitslast ist das Volumen multipliziert mit der durchschnittlichen Bearbeitungszeit (AHT): die Minuten, die ein Agent für einen Kontakt aufwendet, einschließlich Nachbearbeitung. Sechzig Chats in einer halben Stunde zu je 6 Minuten sind 360 Agentenminuten Arbeit, oder die Zeit von 12 Agenten, wenn jeder von ihnen die vollen 30 Minuten nichts anderes als Chat macht. Contact Center nennen diese Zahl Verkehrsintensität, gemessen in Erlang: 60 × 6 ÷ 30 = 12 Erlangs.
Zwei Anpassungen sind in Support-Kanälen wichtig:
- Parallelität im Chat. Wenn Agenten zwei Chats gleichzeitig bearbeiten, halbiert sich die effektive Bearbeitungszeit pro Chat ungefähr. Aber Einstellung und Realität weichen voneinander ab. Ein WFM-Praktiker beziffert die reale Parallelität dort, wo Agenten zwei Chats annehmen können, auf „between 1.2 and 1.6“ und die Chat-AHT auf „maybe 130% of voice at least“ (Reddit thread). Nutzen Sie Ihren gemessenen Durchschnitt, nicht die Obergrenze.
- Die AHT variiert je nach Tickettyp. Ein Passwort-Reset dauert eine Minute, ein Rechnungsstreit zwanzig. Ein Durchschnitt über beide ist bei stabilem Mix in Ordnung und irreführend, wenn sich der Mix verschiebt, und genau das passiert, wenn ein KI-Agent hinzukommt (dazu unten mehr).
Ihr Helpdesk meldet meist etwas, das der AHT nahekommt, aber nicht immer dasselbe. Die Dauer-Metriken von Zendesk trennen zum Beispiel Metriken zu Geschäftszeiten von der Kalenderzeit, und die vollständige Lösungszeit ist keine Bearbeitungszeit. Wenn Sie keine echte Bearbeitungszeit bekommen, messen Sie eine Woche lang eine Stichprobe von Tickets von Hand. Das ist besser als zu raten.
Wie viele Agenten braucht man laut Erlang C?
Die Arbeitslast nennt das Minimum. Genau 12 Agenten für 12 Erlangs zu besetzen bedeutet 100 % Auslastung und eine ständig wachsende Warteschlange, weil Kontakte nicht in ordentlicher Reihe eintreffen. Erlang C ist die Formel, die bei zufälligen Ankünften die Frage beantwortet: „Wie viele Agenten brauche ich, damit X % der Kontakte innerhalb von Y Sekunden beantwortet werden?“ Zendesk WFM berechnet den benötigten Personalbedarf pro 15-Minuten-Intervall mit „a modified version of Erlang C“ (Zendesk docs), und Assembled nutzt Erlang C für seine synchronen Kanäle.
Die Eingaben sind die drei, die Sie schon haben, plus zwei Ziele:
- Service Level: der Anteil der Kontakte, der innerhalb einer Zielzeit beantwortet wird, etwa 80 % innerhalb von 60 Sekunden.
- Maximale Auslastung: der Anteil der angemeldeten Zeit, den Agenten mit Kontakten verbringen. Zendesk bietet sie als Einstellung an; eine Planung um 75-85 % ist üblich, denn 95 % Auslastung verschleißt Menschen schnell.
Hier das Beispiel mit 60 Chats im Durchlauf. Bei 12 Erlangs sagt Erlang C, dass 15 Agenten 80,6 % innerhalb von 60 Sekunden erreichen, bei einer durchschnittlichen Wartezeit von etwa 38 Sekunden und 80 % Auslastung. Mit 14 Agenten fällt das Service Level deutlich zu kurz. Dieser Sprung von 12 auf 15 sind die Kosten des Zufalls, und er schrumpft mit wachsendem Volumen: Große Warteschlangen laufen effizient, kleine nicht. Bei 6 Chats pro halbe Stunde (1,2 Erlangs) brauchen Sie für dasselbe Ziel 3 Agenten, bei 40 % Auslastung. Zendesk sagt das in der eigenen Dokumentation: Bei Workstreams mit geringem Volumen „Erlang C may give slightly higher staffing recommendations“ (Zendesk best practices).
Erlang C ist für Live-Warteschlangen, nicht für E-Mail
Erlang C setzt voraus, dass ein Kunde gerade in einer Warteschlange wartet. Chat und Telefon passen. E-Mail und Tickets nicht, denn der Kunde sitzt nicht da; er erwartet eine Antwort innerhalb von Stunden. Ein WFM-Praktiker beschrieb das Problem mit Ticket-Warteschlangen unverblümt:
"If you have very consistent handle times and a good way to capture it, you basically have a live queue and Erlang C works really well. Most of the time, that is pie in the sky because, for example, Zendesk tickets can take 30 seconds or 45 minutes…so how do you get a good handle time for those tickets?"
Besetzen Sie asynchronen Support stattdessen nach dem SLA-Fenster. Die Dokumentation von Assembled erklärt, warum: Der alte intervallbasierte Modus ging davon aus, dass Arbeit, die in einem 15-Minuten-Intervall eintrifft, in diesem Intervall abgearbeitet wird, was „significantly over-staffs async work“. Der neuere Modus verteilt die Arbeitslast über das Antwortziel, sodass 100 E-Mails, die um 9 Uhr eintreffen und ein 24-Stunden-SLA haben, nicht alle um 9 Uhr einen Agenten brauchen (Assembled async staffing). Zendesk WFM macht bei E-Mails, die außerhalb der Öffnungszeiten eintreffen, etwas Ähnliches: Es verteilt dieses Volumen über das Erstantwortfenster der nächsten offenen Periode neu.
In einer Tabelle ist die asynchrone Variante einfach: Summieren Sie die Arbeitslast des Tages in Agentenstunden, teilen Sie durch die produktiven Stunden pro Agent und prüfen Sie, dass der Rückstau nie über Ihre SLA-Richtlinien hinaus altert. Passiert das zu einer bestimmten Stunde, braucht diese Stunde mehr Leute.
Personalbedarf mit einem Erlang-C-Rechner berechnen
Der Rechner unten führt Erlang C für ein 30-Minuten-Intervall eines Live-Kanals aus und addiert dann die Ausfallzeiten. Wechseln Sie in den E-Mail-Modus für Warteschlangen, die warten können. Mit den KI-Feldern testen Sie, was passiert, wenn ein Agent einen Teil des Volumens übernimmt und die übrigen Tickets länger dauern.
Standardwerte: 60 Chats pro halbe Stunde, 6 Minuten AHT, 80 % beantwortet in 60 Sekunden, 30 % Ausfallzeiten und ein KI-Agent, der 40 % löst, mit 8 Minuten Bearbeitungszeit für den Rest.
Mit den Standardwerten braucht der Plan nur mit Menschen 15 Agenten in der Chat-Warteschlange und 22 im Dienstplan. Wenn die KI 40 % der Chats übernimmt und die übrigen Chats 8 Minuten dauern, sind es 13 in der Warteschlange und 19 im Dienstplan. Eine Lösungsrate von 40 % senkte den Dienstplan um etwa 14 %, nicht um 40 %. Das ist das nützlichste, was der Rechner zeigt, und der Grund, warum ich nie einen Einstellungsstopp auf der Deflection-Zahl eines KI-Anbieters aufbauen würde.
Wie viele Ausfallzeiten sollte man einplanen?
Erlang C sagt, wie viele Agenten in der Warteschlange sein müssen. Ausfallzeiten sind die Lücke zwischen dieser Zahl und der Zahl, die Sie im Dienstplan brauchen: Pausen, Meetings, Schulungen, Coachings, Krankheitstage, Urlaub und Zeit, in der man angemeldet, aber nicht verfügbar ist. Die Formel lautet scheduled = required ÷ (1 - shrinkage). Das eigene Beispiel von Zendesk: 100 produktive Agenten bei 40 % Ausfallzeiten bedeuten 167 im Dienstplan (Zendesk docs).
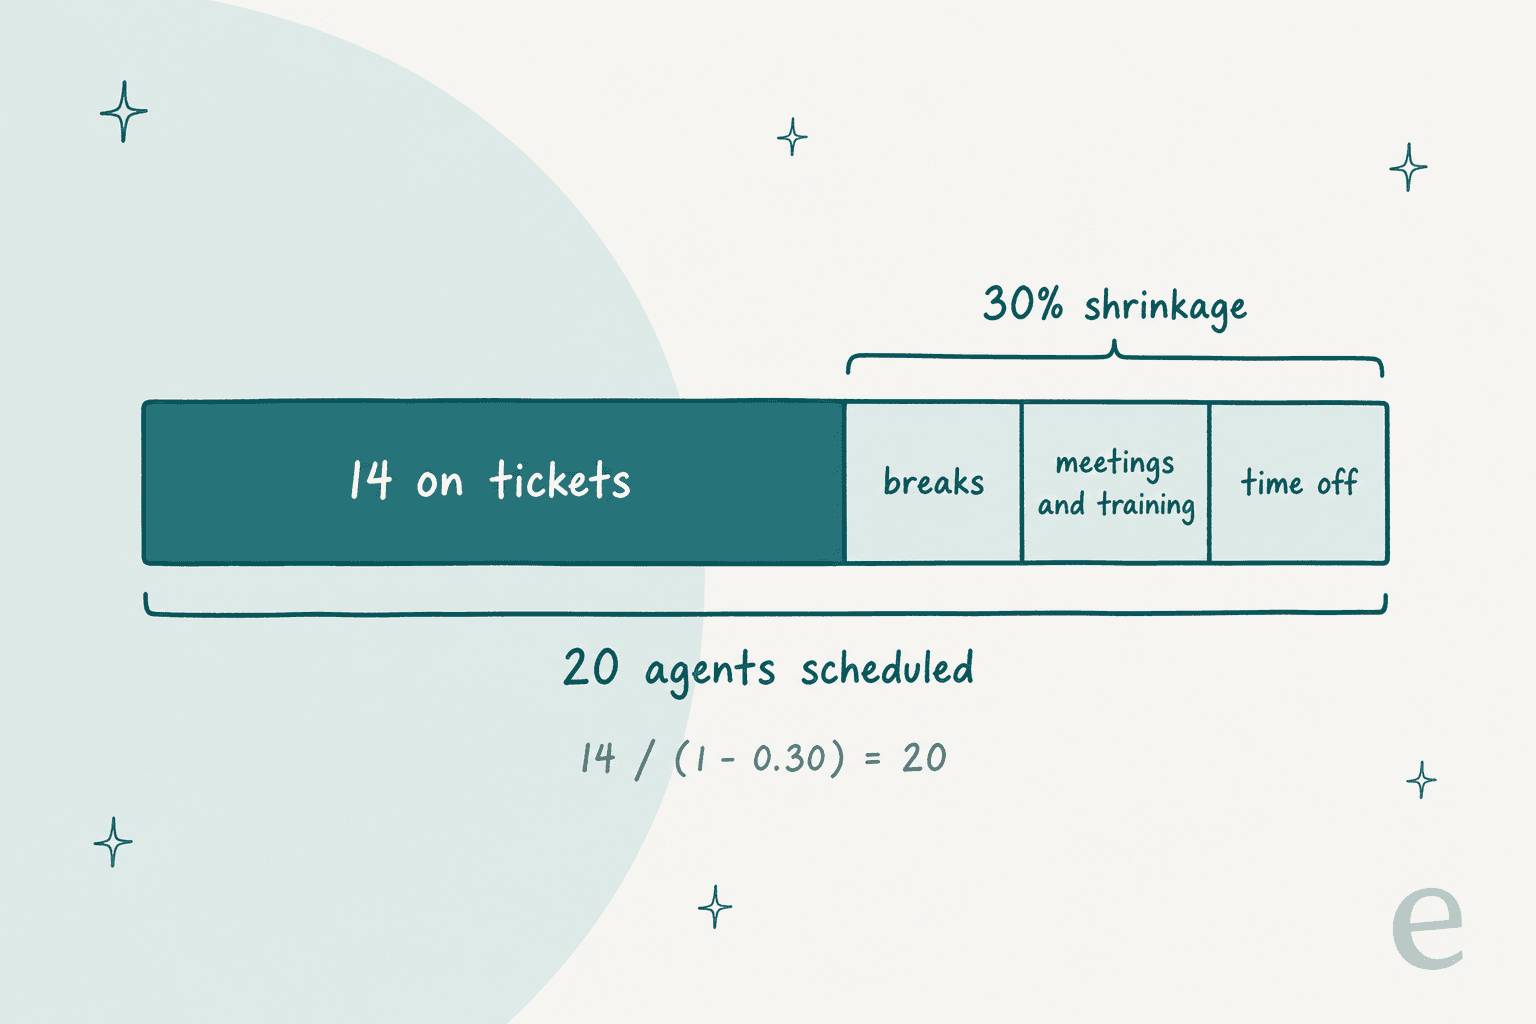
Die Zahl, die Teams verwenden, ist meist zu niedrig. Es kursieren zwei Definitionen, und ihre Vermischung ist eine häufige Quelle für Unterbesetzung:
- Enge Ausfallzeiten zählen nur geplante Zeit, die nicht geleistet wurde, grob
100% - adherence. Assembled nutzt diese Definition und plant Pausen, Urlaub und Meetings separat; die Dokumentation nennt 5-10 % für Voice, 10-15 % für Omnichannel und 15 %+ für komplexe Digital-first-Teams (Assembled staffing docs). - Volle Ausfallzeiten zählen alles, was einen bezahlten Agenten aus der Warteschlange nimmt. Das ist die Definition, die die meisten Tabellenprognosen brauchen, und sie ist viel größer:
"A 15% shrinkage rate seems low. Breaks alone account for approximately 6.25% on a standard 8-hour schedule. Most of our teams average shrinkage in the low 30% range once you factor in absenteeism, PTO, meetings, training, etc."
Ausfallzeiten schwanken auch. Ein anderer Praktiker in r/workforcemanagement merkt an, dass die Ausfallzeiten montags meist am höchsten sind und der Januar in seinem Team hoch ausfällt (thread). Auch neue Mitarbeitende zählen: Wer in den ersten Monaten ist, bearbeitet weniger und einfachere Kontakte, ein Team, das gerade fünf Leute eingestellt hat, hat also weniger Kapazität, als seine Personalstärke sagt. Wenn Sie vor einer Spitze einstellen, planen Sie die Einarbeitungszeit von Agenten und ein ordentliches saisonales Onboarding ein, statt einen Neuanfänger in Woche eins als vollen Agenten zu zählen.
Wie genau sollte eine Support-Prognose sein?
Genau genug, dass der darauf gebaute Dienstplan Ihr Service Level trifft. Das klingt wie eine Ausflucht, ist aber der richtige Test, denn eine Prognose, die bei der Wochensumme um 2 % danebenliegt, kann in den entscheidenden Stunden trotzdem falsch sein.
Die üblichen Maße sind der mittlere absolute Fehler (MAE) und der mittlere absolute prozentuale Fehler (MAPE). Der Bericht Forecast Management von Assembled kennzeichnet das Modell mit dem niedrigsten MAE als „most accurate“ und zeigt Über- und Unterschätzung getrennt an, da Sie vielleicht ein Modell bevorzugen, das selten zu niedrig prognostiziert (Assembled docs). Es warnt auch, dass MAPE bei einem tatsächlichen Volumen von null versagt, was in kleinen Intervallen oft vorkommt. Zendesk WFM hat eine Seite für Prognose gegen Ist-Werte im Early Access, um das aktive Szenario zu prüfen.
Was „gut“ bedeutet, hängt vom Horizont ab. Die Faustregel eines Praktikers:
"Unless you tie forecast accuracy to a specific business metric, you setup the forecasting team for failure. Also 3% intra-day (in)accuracy? Maybe annual 3%, 5% monthly, 10% weekly and 25%-40% daily."
Zwei Gewohnheiten fangen die meisten Probleme ab. Erstens: Prüfen Sie das Intervall, nicht nur die Summe: „Many wfm teams only look at the daily total to forecast as a kpi, which doesn't help if the call arrival pattern is wrong“ (Reddit). Zweitens: Nutzen Sie Ist-Werte als Eingaben. Wenn der Plan 2 gleichzeitige Chats und 15 % Ausfallzeiten annimmt und das Team 1,4 und 30 % liefert, verspricht die Prognose ein Service Level, das Sie nie erreichen. Beobachten Sie die erste Antwortzeit und das Alter des Rückstaus pro Intervall neben der Prognose; sie zeigen als Erste, dass die Eingaben abgedriftet sind.
Was prognostizieren Zendesk WFM und andere Helpdesks tatsächlich?
Hier unterscheiden sich Support-Teams am stärksten von Call Centern. Telefonsysteme liefern seit Jahrzehnten WFM. Helpdesks meist nicht. Das habe ich in der jeweiligen Anbieterdokumentation gefunden.
Zendesk WFM
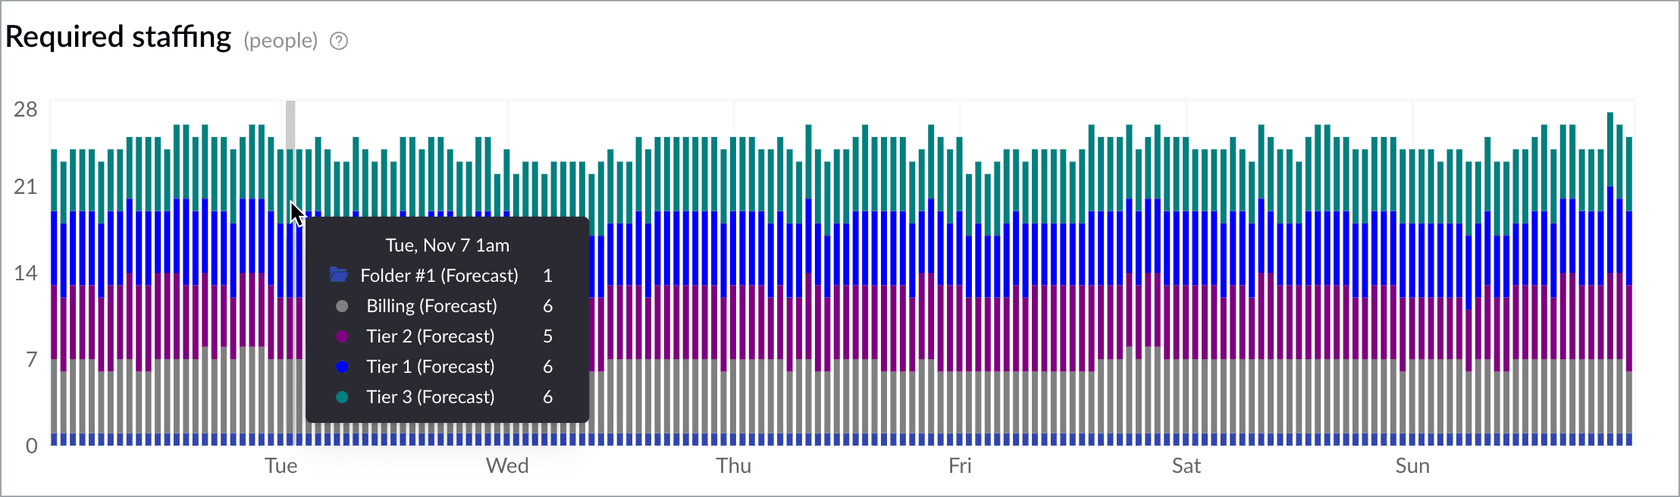
Zendesk ist hier der einzige Helpdesk mit nativer Prognose, und sie ist echt. Im WFM-Add-on bekommen Sie:
- Volumenprognosen bis zu einem Jahr im Voraus, in 15-Minuten-Intervallen, aus sechs Monaten migrierter Ticketdaten (auf Anfrage bis zu zwei Jahre).
- Algorithmuswahl pro Workstream: Acht-Wochen-Durchschnitt, Acht-Wochen-Durchschnitt mit Momentum, Prophet, XGBoost, LightGBM und ein neuronales LSTM-Netz. WFM testet alle und wählt den besten, und Sie können das überschreiben (Zendesk algorithms).
- Benötigtes Personal aus einem modifizierten Erlang C, mit Auslastung, Chat-Parallelität, AHT, SLA-Ziel, Ausfallzeiten und Mindestbesetzung (Standard 1 FTE) als Eingaben.
- Szenarien zum Durchspielen, ohne die aktive Prognose anzufassen, plus Volumenanpassungen und Ausreißerausschluss (Zendesk setup guide).
Die Grenzen, die man kennen sollte: WFM prognostiziert keine kombinierten Workstreams (der Workaround ist ein Ordner, der sie summiert), Spam zählt im Volumen, und keine der Prognose-Dokus erwähnt, KI-Agenten-Lösungen vom menschlichen Volumen zu trennen, sodass ein KI-Rollout über manuelle Anpassungen abgebildet wird. Beim Preis wird das Add-on für jeden Agenten des Kontos gekauft, und die Preisseite von Zendesk nennt das Workforce Engagement Bundle (WFM plus QA) mit $50 pro Agent und Monat bei jährlicher Zahlung (Zendesk pricing). Für das Gesamtbild der Basistarife siehe meine Aufschlüsselung der Zendesk-Preise.
Assembled
Assembled ist kein Helpdesk, sondern ein eigenständiges WFM-Tool, das sich in Zendesk, Salesforce, Gorgias und andere einklinkt. Es nutzt dieselbe Pipeline mit N-Wochen-, Momentum-, Saison- und Prophet-Modellen, standardmäßig 30-Minuten-Besetzungsintervallen, Erlang C für Live-Kanäle und einem SLA-Fenster-Modus für E-Mail. Die Preisseite listet WFM mit $25 (Core), $45 (Pro) und $75 (Enterprise) im Monat, und die Hilfedokumente ordnen Prognosemodelle, Genauigkeitsberichte und asynchrone SLA-Besetzung Pro und Enterprise zu (Assembled pricing). Das Marketing von Assembled sagt, die Besetzungspläne berücksichtigten die Kapazität von KI-Agenten neben Menschen, doch ich fand kein Hilfedokument, das den Mechanismus erklärt. Wenn Sie Optionen vergleichen, habe ich Assembled-Alternativen separat behandelt.
Gorgias
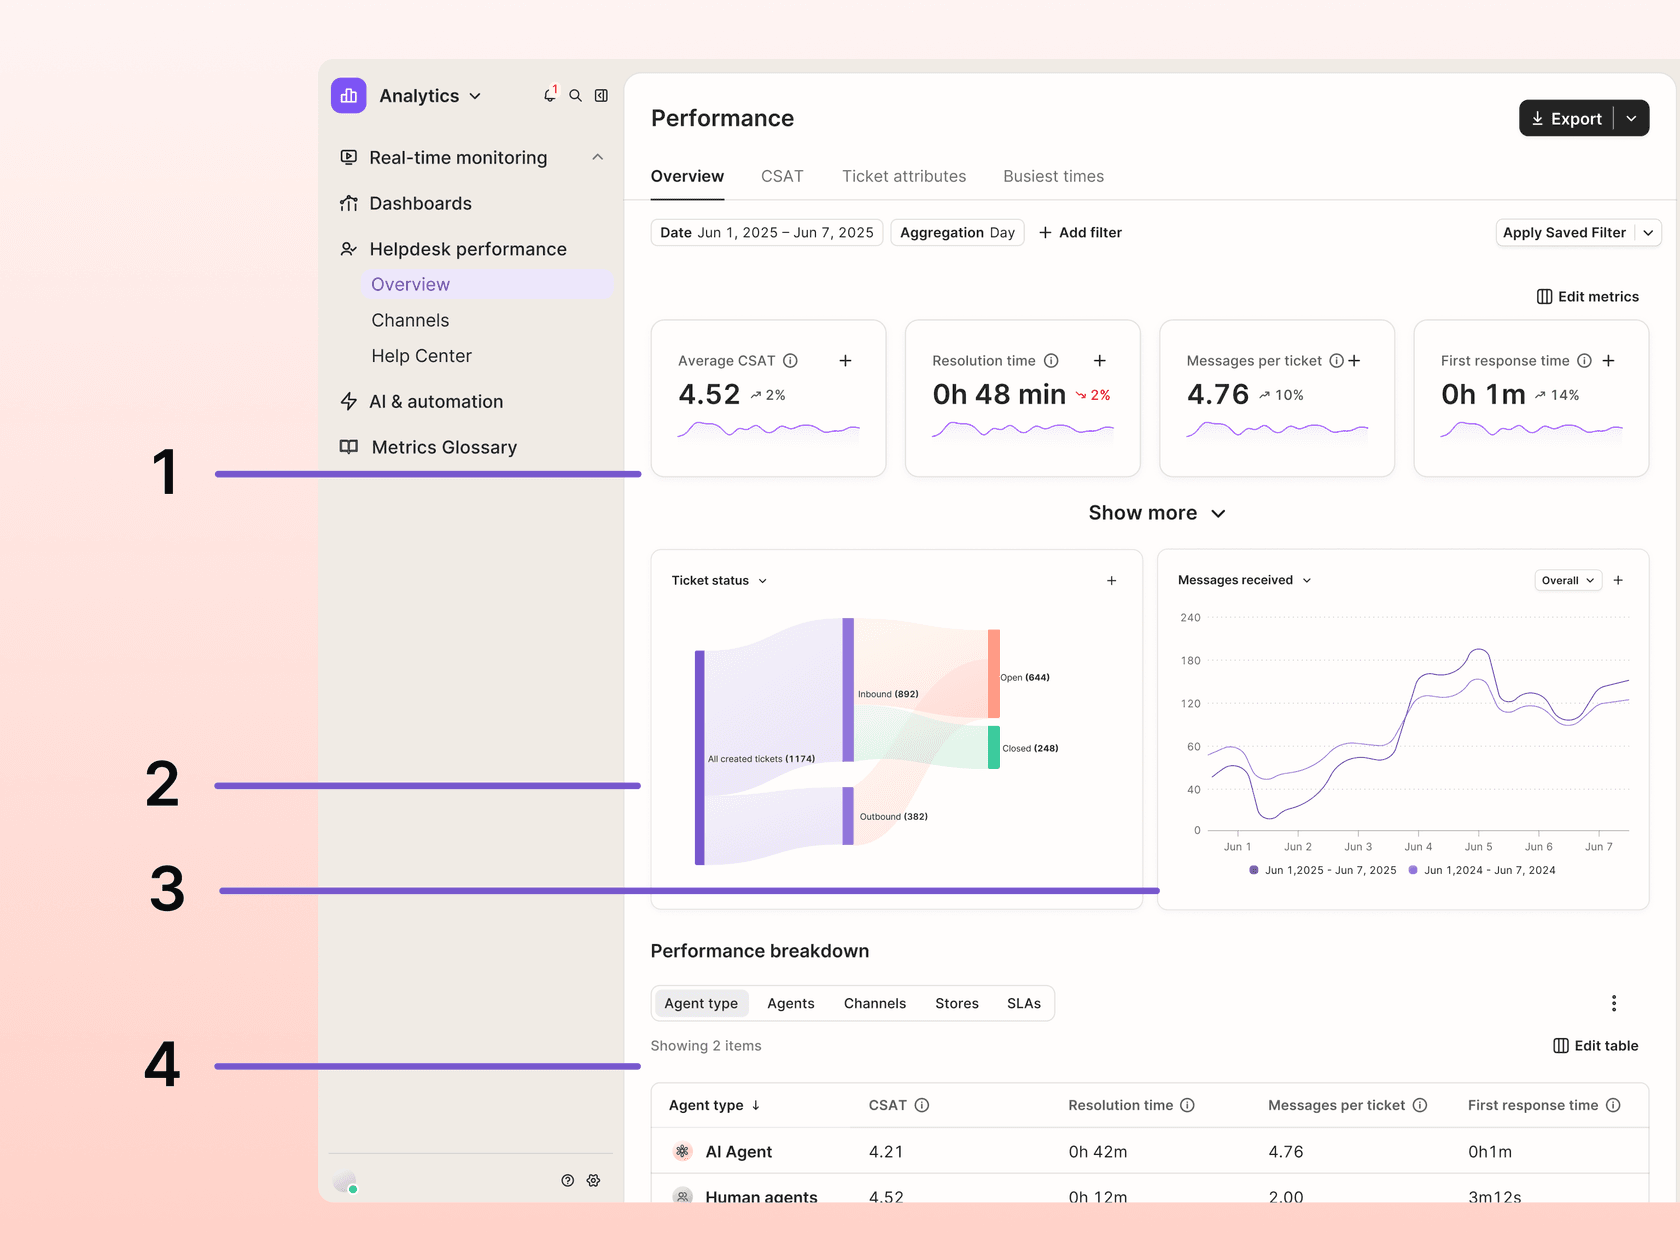
Gorgias hat keine Volumenprognose, aber seine Berichte liefern die meisten Eingaben. Der Tab Busiest times zeigt eine Metrik (erstellte Tickets, empfangene Nachrichten und andere) als Heatmap nach Stunde und Wochentag mit markierten Geschäftszeiten, und der eigene Tipp von Gorgias lautet: „A dark cell outside your business hours is demand arriving when nobody is scheduled“ (Gorgias docs). Trenddiagramme können das Vorjahr überlagern, um eine echte Veränderung von einem saisonalen Muster zu trennen, und jeder Bericht lässt sich bis zu 365 Tage pro Zeitraum als CSV exportieren. Wenn Sie den Gorgias AI Agent nutzen, liefert sein Bericht eine Automatisierungsrate, mit der Sie KI- und menschliches Volumen trennen können.
Help Scout
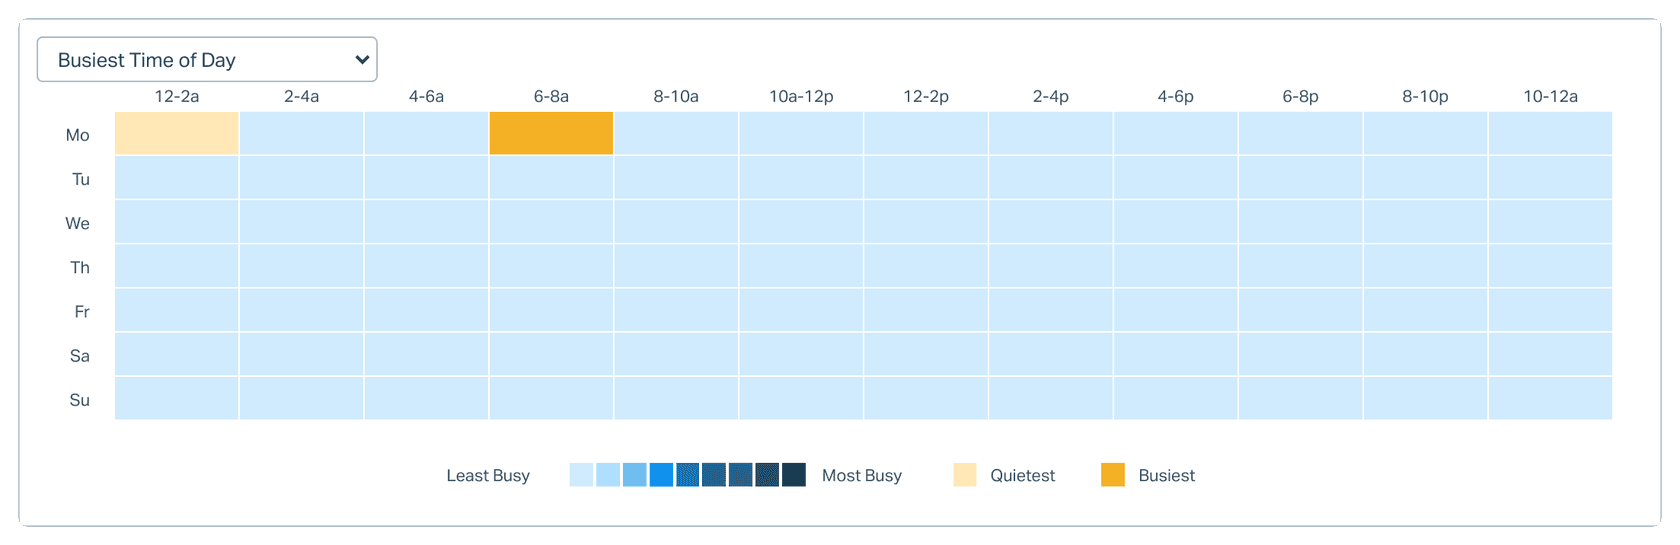
Die Berichte von Help Scout sind rein historisch, und die Doku sagt, dass Sie in der App keine eigenen Berichte bauen können. Der Bericht All Channels enthält eine Heatmap Busiest Time of Day, die Help Scout als „helpful for hiring“ beschreibt (Help Scout docs). Standardtarife berichten über zwei Jahre Verlauf; Plus und Pro über die Lebensdauer des Kontos. Der Export ist eine CSV- oder XLSX-Datei auf Konversationsebene, was Sie für eine Prognose wollen, mit einer Falle: XLSX-Zeitstempel sind in UTC, CSV nutzt die Zeitzone Ihres Unternehmens. Wer nach der falschen bündelt, verschiebt seine Spitzenstunde. Mehr zu Tarifgrenzen in meinem Beitrag zu den Help-Scout-Preisen.
HubSpot Service Hub
Das Prognosewerkzeug von HubSpot ist ein Umsatzwerkzeug auf Basis von Deal-Phasen, nicht von Tickets. Das Nächstliegende für den Support ist eine „predictive“ Trendlinien-Option in den Berichtseinstellungen der Service-Analytics-Suite, angewandt auf historische Diagramme (HubSpot docs). Die nützlichen Eingaben sind aber da: ein Support-Volumenbericht, ein Tageszeitbericht „to help inform team planning“ und Planungsberichte wie Maximum available rep, die zeigen, ob in den Spitzen Leute gearbeitet haben. Wenn Sie den Customer Agent von HubSpot nutzen, beachten Sie die Verzögerung von 72 Stunden, bevor antwortbasierte Lösungen gesetzt werden, sodass die Lösungsrate dieser Woche immer niedrig aussieht.
Im direkten Vergleich
| Native Volumenprognose | Intervalldetail | Besetzungsrechnung | KI-Aufteilung in Berichten | Export für eine Tabelle | |
|---|---|---|---|---|---|
| Zendesk (WFM-Add-on) | Ja, bis zu 1 Jahr | 15 Min. | Modifiziertes Erlang C, Ausfallzeiten, Auslastung, Parallelität | Nicht in den Prognose-Dokus | Ja, plus Importe |
| Assembled | Ja, 4 Modelle | 15-30 Min. | Erlang C (live), SLA-Fenster (async) | Nur Marketingaussagen | API oder CSV-Import |
| Gorgias | Nein | Stunden-Heatmap | Keine | Automatisierungsrate des AI Agent | CSV, 365 Tage pro Zeitraum |
| Help Scout | Nein | 2-Stunden-Heatmap | Keine | Nicht abgedeckt | CSV oder XLSX, Konversationsebene |
| HubSpot Service Hub | Nein (nur Trendlinie) | Bericht zur Tageszeit | Keine | Customer-Agent-Berichte | Nicht zusammengefasster Export |
Wenn Sie bei einem der letzten drei sind und Ihr Team weniger als 20 Agenten hat, reicht eine Tabelle mit der obigen Methode. Darüber hinaus, oder bei mehreren Kanälen und Schichten, zahlt sich ein WFM-Tool in Stunden aus, die Sie nicht mehr mit dem Neubau von Pivot-Tabellen verbringen. Für Teams, die ihren Helpdesk selbst abwägen, behandelt meine Übersicht der Helpdesks für hohes Ticketaufkommen auch die Berichtsseite.
Wie plant man für Spitzen und saisonale Hochs?
Eine auf Durchschnitten gebaute Prognose verfehlt die Spitze immer, systembedingt. Die Lösung ist, die Spitze als eigenes Szenario zu planen. Ich halte für jede Spitzenzeit drei Szenarien bereit: normal, +30 % und +60 % Volumen, jeweils mit eigener Besetzung und eigenem Dienstplan. Sie besetzen nicht für den schlimmsten Fall; Sie entscheiden vorab, was Sie tun, wenn Sie ihn kommen sehen (Überstunden, übergreifend geschulte Kollegen aus anderen Teams, ein Überlaufplan oder eine Pause bei nicht dringender Arbeit).
Bevor Sie eine Spitze besetzen, fragen Sie, warum sie entsteht:
"Why is it spiky? Do you send bills to customers all on the same day? Does your ad campaign run at a certain pattern? Identify "the why" in spikes and see if you can educate on the impacts to the call center."
Die meisten Spitzen haben einen Treiber, den jemand im Unternehmen schon kennt: ein Rechnungslauf, eine Promo-Mail, ein Produktlaunch, ein Versand-Stichtag. Bringen Sie diese Termine in den Support-Kalender und tragen Sie sie als manuelle Anpassungen ein. Für den Einzelhandel gehen meine Leitfäden zu Support-Spitzen an Feiertagen und KI für den Black Friday tiefer in den Ansturm von November bis Dezember.
Saisonale Unternehmen haben die härteste Version davon, denn für den Sommer einzustellen heißt, Leute durch den Winter mitzutragen. Norden-Frisia, die Fährreederei aus dem TL;DR, bekommt die meisten Passagierfragen zwischen Mai und September: Fahrpläne, Autos, Dachboxen, Fahrräder. Ein Team einzustellen und zu schulen, das mit der Saison wächst und schrumpft, war teuer und langsam, also stellte das Team vor seiner ersten Hochsaison seinen eesel-Tarif auf 10,000 Interaktionen im Monat um, mit der Vereinbarung, dass er von Oktober bis März wieder herunterskaliert wird. Das KI-Teammitglied beantwortet die wiederkehrenden Fragen aus den Zendesk-FAQs, und alles, was es nicht abschließen kann, wird zu einem Zendesk-Ticket für das menschliche Team. Das ist ebenso sehr eine Personalentscheidung wie eine Softwareentscheidung.
Rúngne, eine norwegische Kletterbekleidungsmarke auf Gorgias, zeigt die Wochen-zu-Wochen-Version. Zwischen dem 8. August und dem 8. September 2026 bearbeitete eesel für sie rund 2,100 Tickets, zwischen etwa 300 und 780 pro Woche. Ein Ausschlag dieser Größe innerhalb eines Monats entgeht einem durchschnittsbasierten Dienstplan genau, und deshalb sind Prüfungen im Tagesverlauf selbst mit einer ordentlichen Prognose wichtig. Teams, die mehrere Zeitzonen abdecken, können Spitzen auch mit Follow-the-Sun-Support glätten, indem sie die Warteschlange zwischen Regionen weiterreichen, statt eine Schicht zu dehnen.
Wie verändert ein KI-Agent die Personalprognose?
Hier haben die meisten Prognoseleitfäden den Anschluss noch nicht gefunden. Sobald ein KI-Agent einen Teil der Warteschlange beantwortet, liegt die alte Prognose in zwei Richtungen zugleich falsch.
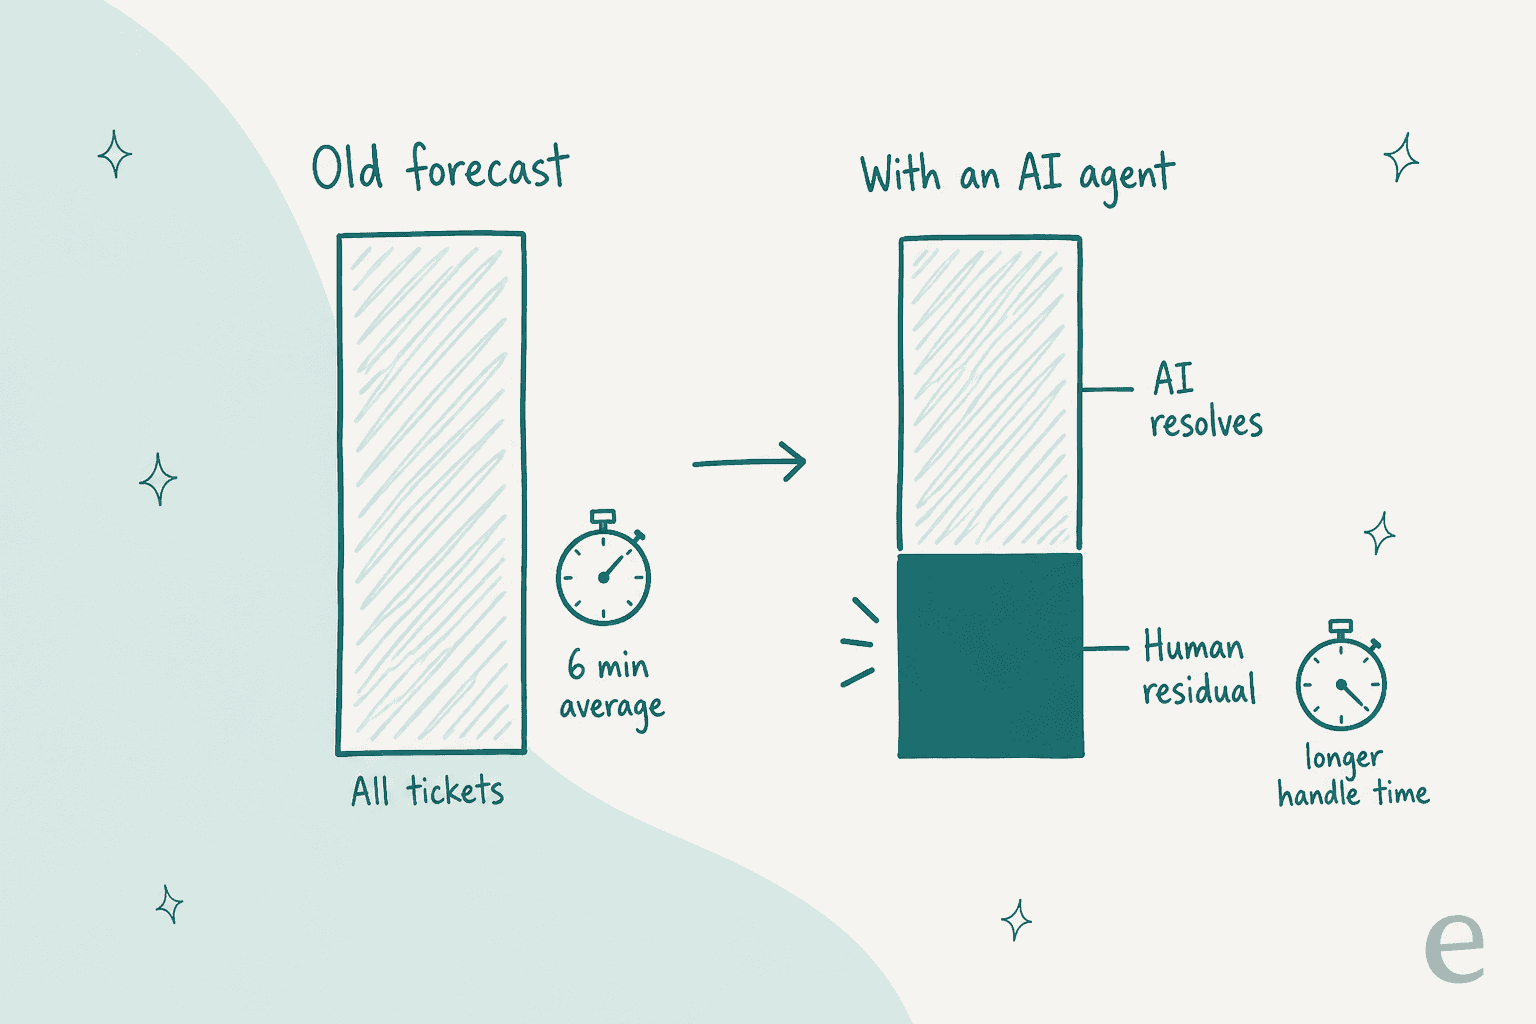
Das Volumen für Ihr Team sinkt, weil die KI die Fragen zu Bestellstatus, Passwort und Richtlinien löst. Aber das waren auch Ihre schnellsten Tickets, also steigt die Bearbeitungszeit für den Rest. Wenn Sie die Lösungsrate der KI vom Gesamtvolumen abziehen und die alte AHT behalten, besetzen Sie zu knapp. Der Rechner oben zeigt die Größe des Effekts: Eine Lösungsrate von 40 % mit einer Verschiebung der AHT von 6 auf 8 Minuten senkt den Dienstplan um etwa 14 %.
So würde ich mit einem KI-Agenten in der Warteschlange prognostizieren:
- Zwei Warteschlangen prognostizieren, nicht eine. Die gesamten Eingänge wie bisher, dann den menschlichen Restanteil als eigene Reihe, mit eigener AHT, gemessen an den Tickets, die die KI übergeben hat.
- Lösung nutzen, nicht Deflection. Eine Unterhaltung, die ohne Person endete, ist nicht immer ein gelöstes Problem; manche kommen einen Tag später über einen anderen Kanal zurück. Die Lücke zwischen Deflection- und Lösungsrate ist der Fehler in Ihrer Prognose.
- Nach jeder Änderung einige Wochen neu messen. Neue Themen für die KI, ein neuer Kanal, eine Richtlinienänderung: Jedes verschiebt den Restanteil. Der 8-Wochen-Durchschnitt von Assembled holt auf, aber langsam.
- Keinen Einstellungsstopp auf die Schlagzeile eines Anbieters stützen. Fahren Sie zuerst einen Support-Pilot mit Ihren eigenen Tickets und planen Sie nur mit dem Restanteil, den Sie gemessen haben.
Dafür braucht die KI auch einen klaren Umfang. Ein CX-Leiter einer DTC-Marke mit etwa 7.000 Tickets im Monat sagte dem Sales-Team von eesel, dass es den Sinn verfehle, jede KI-Antwort von Hand zu prüfen, und fügte hinzu:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das macht die Prognose auch stabil. Das Setup von Rúngne ist ein gutes Modell: Ein eesel-Agent triagiert und taggt jedes Ticket, einer legt Entwürfe für das Team ab, und ein dritter beantwortet nur die Themen, die das Team gewählt hat (Versand- und Rückgaberichtlinie, Wo ist meine Bestellung, Lagerbestand, Vorbestellungen). In diesem Monat lief der antwortende Agent bei etwa 280 von rund 2.100 Tickets, „around one ticket in seven“. Weil der Umfang eine feste Themenliste ist, ist der Restanteil vorhersehbar: Sie wissen, welche Tickettypen die menschliche Warteschlange verlassen haben, und können die neue AHT für den Rest messen. Praktiker im WFM kommen auf der Prognoseseite zum selben Ergebnis:
"I wouldn't trust an LLM to replace forecasting, Erlang/staffing calculations, shrinkage modelling or proper statistical analysis. Those should still be handled by the right models, tools and validated data. ... Basically: it would let AI explain the spreadsheet, not become the spreadsheet."
Dem stimme ich zu. Nutzen Sie KI, um Arbeit aus der Warteschlange zu nehmen und die Zahlen zu erklären, und lassen Sie die Prognose auf echten Daten laufen. Wenn Sie abwägen, ob KI Ihre Teamstruktur grundsätzlicher verändert, greifen meine Beiträge zum Aufbau eines KI-first-Support-Teams und zur Frage, ob KI Ihr Team ersetzen kann, diesen Faden auf. Für die Kostenseite vergleichen Sie die Kosten pro Lösung mit und ohne KI.
eesel ausprobieren
Wenn Ihre Prognose Ihnen immer wieder rät, für eine Spitze einzustellen, die Sie nur drei Monate haben, ist der KI-Helpdesk-Teamkollege von eesel der andere Hebel. Er schließt sich der Warteschlange an, die Sie ohnehin auf Zendesk, Gorgias, HubSpot oder Help Scout betreiben, lernt aus Ihren früheren Tickets und Ihrem Help Center und bearbeitet nur die Tickettypen, die Sie ihm geben, was den menschlichen Restanteil vorhersehbar genug macht, um damit zu planen.
Auch die Preisgestaltung passt zu einer saisonalen Prognose. Bei eesel-Preise ist ein Ticket oder ein Chat 1 Credit, die Tarife beginnen bei $299 im Monat für 500 Credits, und ein Upgrade gilt sofort, sodass Sie für die Spitze eine Größe hoch- und danach wieder herunterschalten, so wie es Norden-Frisia jeden Sommer tut. Sie können mit 100 kostenlosen Credits starten und sehen, wie viel Ihrer Warteschlange es übernehmen würde, bevor Sie eine einzige Schicht ändern.
