

Warum ein KI-Bereitschafts-Audit keine Inhaltsbereinigung ist
Ich baue bei eesel die KI-Agenten und lese Help Center deshalb so, wie der Agent es tut: als Haufen Text, der in Stücke geschnitten und nach Bedeutung durchsucht wird. Zendesk beschreibt den Ablauf in seiner Dokumentation klar. Wissensinhalte werden in Abschnitte (Chunks) zerlegt, jeder Chunk wird mit einem numerischen Vektor gespeichert, und die am besten passenden Chunks werden genutzt, um die Antwort zu schreiben. Das Modell liest dein Help Center nie so wie ein Mensch. Es liest die Chunks, die für diese eine Frage am höchsten bewertet wurden.
Das ändert, was „guter Inhalt" bedeutet. Ein Mensch überfliegt den veralteten Artikel, weil er weiß, dass es einen neueren gibt. Ein Retrieval-System hat dieses Urteilsvermögen nicht: Wenn beide passen, können beide verwendet werden. Das ist der Kern von Retrieval-Augmented Generation, und deshalb kann ein Help Center, das für Menschen gut funktioniert, trotzdem eine falsche KI-Antwort erzeugen.
Ich habe das bei echten Konten schiefgehen sehen. Ein technisches B2B-Support-Team erzählte mir, ihr Help Center sage „wir unterstützen alle Modelle", und ihr Bot hatte bereits Ja zu einer Marke gesagt, die nicht in ihrer Datenbank stand. Auch zahlende Kunden sahen Bots aus Allgemeinwissen antworten, wenn das Retrieval nichts Passendes fand. Beides sind Wissensprobleme, bevor sie Modellprobleme sind, und beides lässt sich vor dem Go-live günstiger finden. Dieser Beitrag behandelt den KI-Bereitschafts-Durchgang. Für die allgemeine Bereinigung aus Behalten, Zusammenführen oder Archivieren habe ich einen eigenen Leitfaden zum Support-Wissensdatenbank-Audit geschrieben.
Die vier Arten, wie eine Wissensdatenbank eine KI falsch antworten lässt
Jede falsche Antwort, die ich zurückverfolge, endet bei einer von vier Ursachen. Sie zu benennen macht das Audit schneller, denn jede hat einen anderen Test und eine andere Lösung.
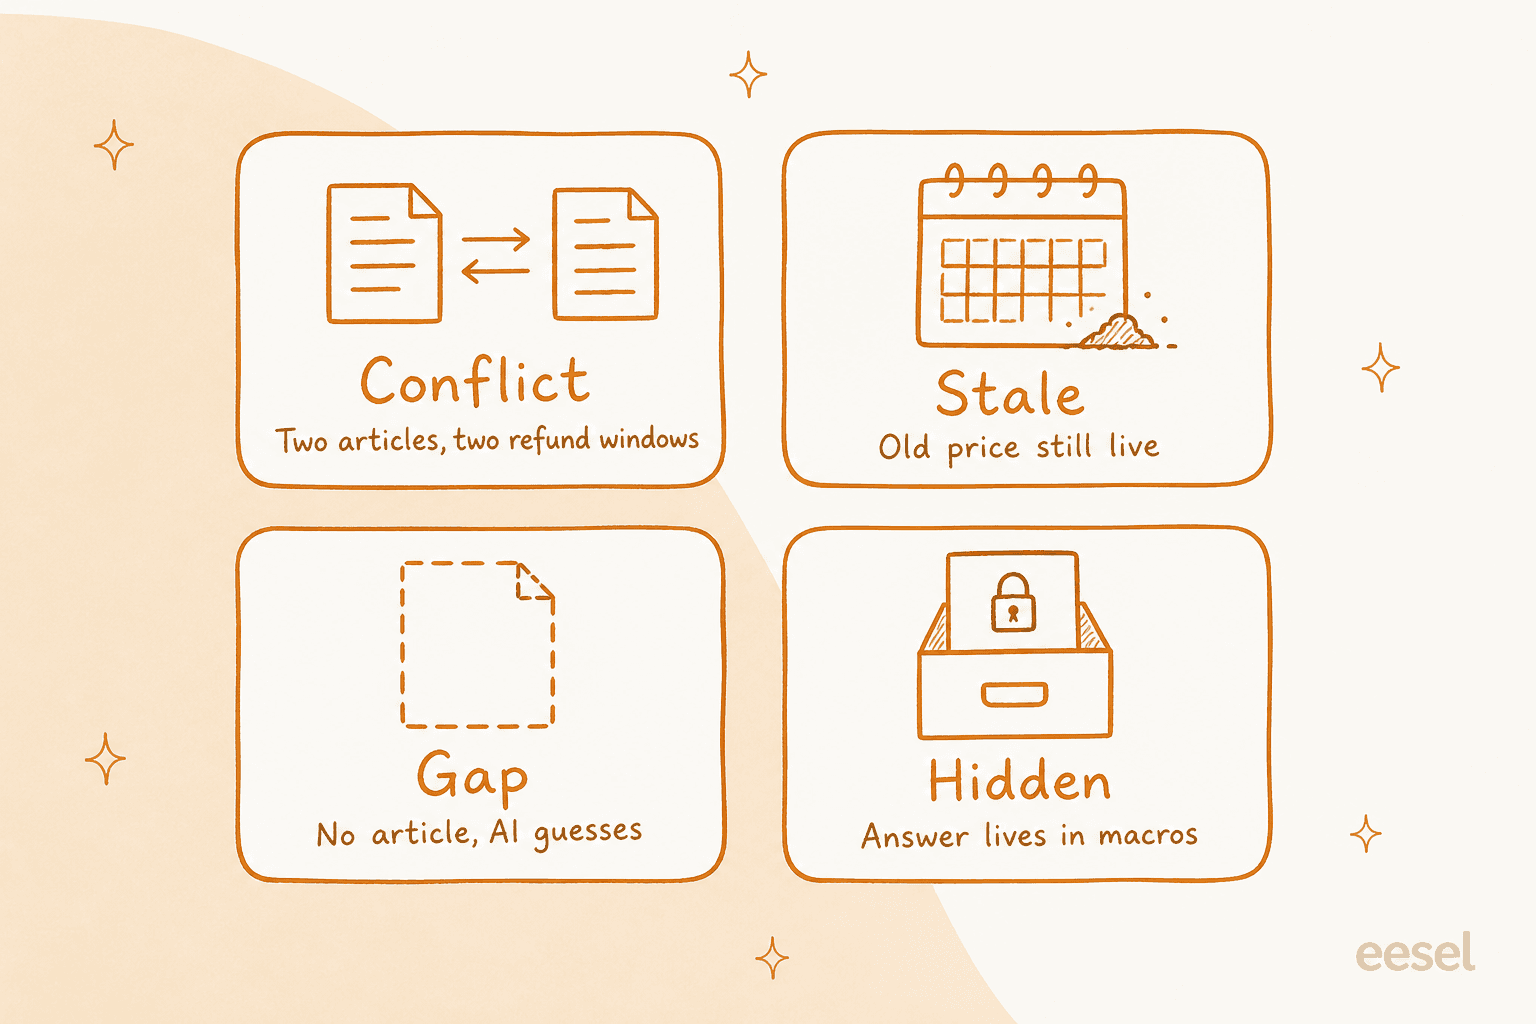
Die vier Fehler in der Reihenfolge, in der ich sie prüfe: zwei Artikel, die sich widersprechen, ein Fakt, der gealtert ist, ein Thema ohne Artikel und eine Antwort, die dort liegt, wo die KI sie nicht lesen kann.
Widerspruch. Zwei Artikel geben unterschiedliche Antworten. Gorgias nennt dafür ein Beispiel in der eigenen Dokumentation: Wenn ein Help-Center-Artikel eine Rückgabefrist von 30 Tagen angibt und ein Guidance-Eintrag 14, antwortet der Agent womöglich nicht jedes Mal gleich (Gorgias-Dokumentation). Die KI ist nicht verwirrt. Sie hat beide abgerufen, und nichts hat ihr gesagt, welcher gewinnt.
Veraltet. Der Artikel war einmal richtig. Preise, Tarifnamen, Versandschlusszeiten und Funktionsnamen altern am schnellsten, und eine veraltete Zeile wird mit voller Überzeugung wiederholt. Zendesks Regeln zur Artikelverifizierung gibt es dafür: bis zu 20 Regeln, die Artikel nach Zeitplan auf „nicht verifiziert" zurücksetzen, sodass ein Verantwortlicher sie erneut bestätigen muss.
Lücke. Kein Artikel deckt die Frage ab. Ein gut konfigurierter Agent übergibt. Ein schlecht konfigurierter füllt die Stille mit Allgemeinwissen. Gorgias merkt an, dass der Agent bei nicht abgedeckten Themen die Konversation oft an dein Team übergibt, was sicher ist, aber teuer, wenn das Thema hohes Volumen hat.
Versteckt. Dein Team kennt die Antwort, aber sie steckt in Makros, einem internen Wiki, einem Loom-Video oder im Kopf eines erfahrenen Agenten. Das habe ich von einer DTC-Marke gehört, die etwa die Hälfte ihres E-Mail-Volumens automatisieren wollte, während ihr Wissen in SOP-Tools, nicht transkribierten Videos und alten Makros lag. Eine KI kann nur aus dem antworten, was du verbindest, und der verbundene Teil war der dünnste.
Nutze das Widget unten für jeden Artikel, bei dem du unsicher bist. Es zeigt, wie der Fehler aussieht, wie du ihn findest und welche Regel ich vor dem Go-live anwende.
Welcher Fehler ist dieser Artikel?
Wähle den Fehlertyp, um zu sehen, wie du ihn findest und welche Go-live-Regel ich nutze.
Klicke auf jeden Fehlertyp, um zu sehen, wie er aussieht, wie du ihn findest und welche Regel ich vor dem Go-live prüfe.
In Risikoreihenfolge prüfen, nicht alphabetisch
Der übliche Fehler ist, das ganze Help Center gleichmäßig zu prüfen. Eine falsche Antwort zu den Öffnungszeiten und eine falsche Antwort zu Erstattungen kosten nicht dasselbe, deshalb ordne ich Themen nach zwei Dingen: wie viele Tickets sie erzeugen und was eine falsche Antwort kostet. Erstattungen, Rückgaben, Kündigungen und Zahlungen kommen in die oberste Stufe.
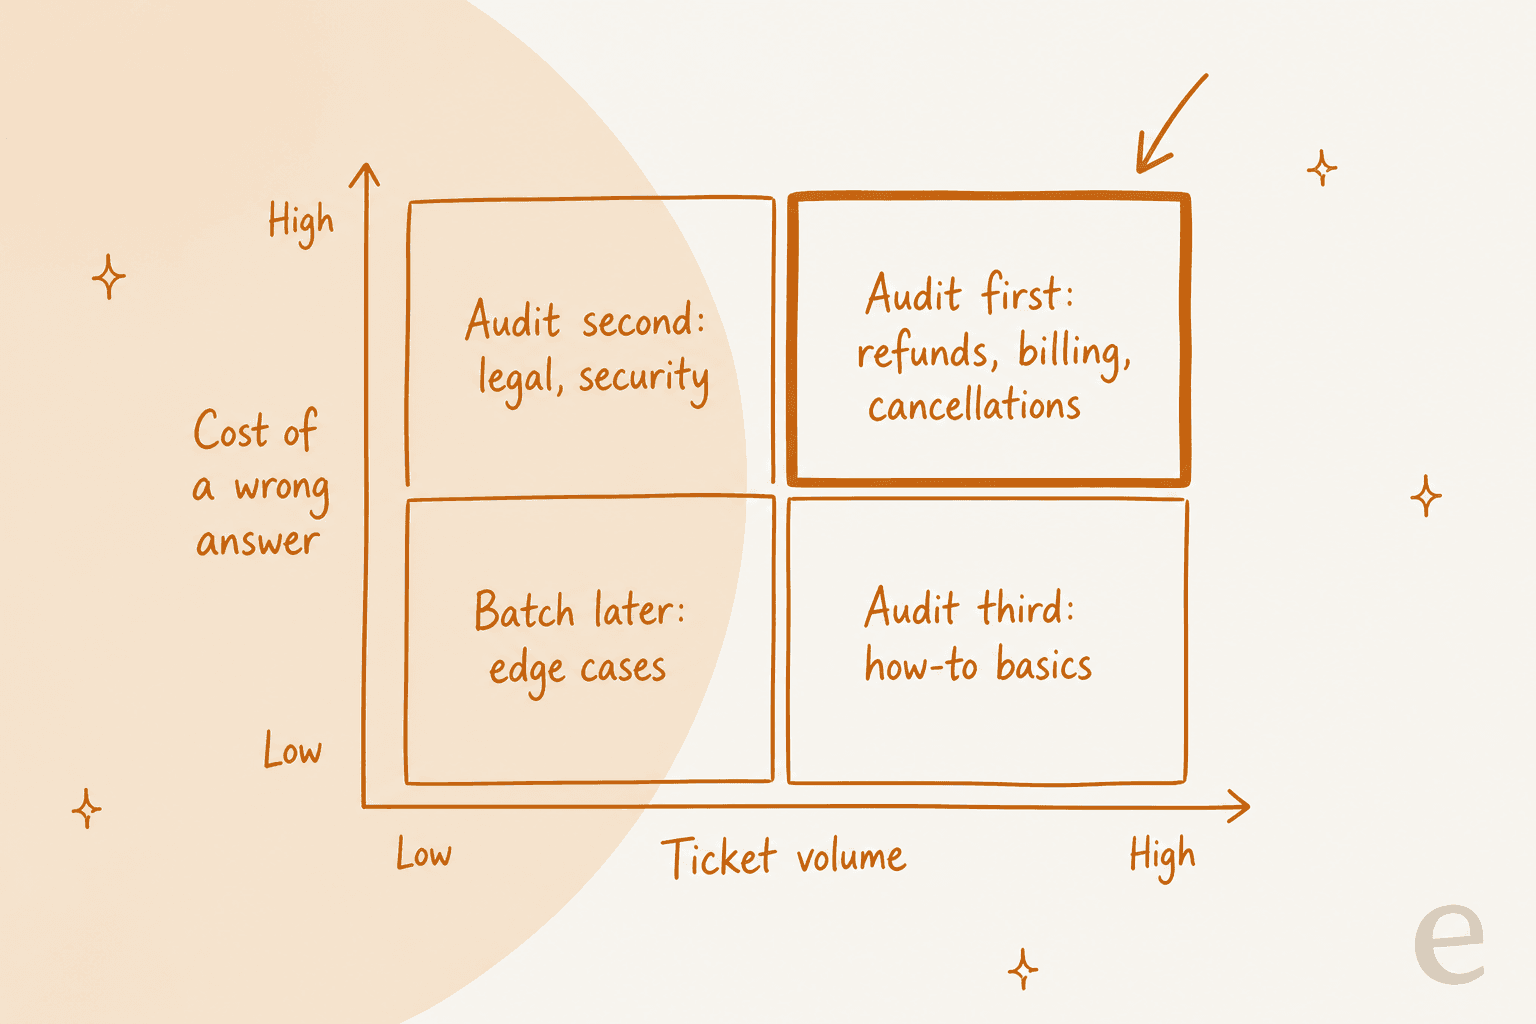
Prüfreihenfolge nach Kosten einer falschen Antwort und Ticketvolumen: Geldthemen zuerst, Recht und Sicherheit danach, Grundlagen-Anleitungen als Drittes, Randfälle später gebündelt.
| Stufe | Themen | Was ich prüfe | Typische Go-live-Hürde |
|---|---|---|---|
| 1: Geld | Erstattungen, Rückgaben, Kündigungen, Abrechnung, fehlgeschlagene Zahlungen | Widersprüche, veraltete Zahlen, Ausnahmen, wer genehmigen darf | Null falsche Antworten im Test |
| 2: Risiko | Rechtliche Bedingungen, Sicherheit, Datenschutz, Kontozugang | Formulierung vom richtigen Verantwortlichen freigegeben, klare Übergabe | Null falsche Antworten, bei Unsicherheit eskalieren |
| 3: Volumen | Versand, Abonnements, Grundlagen-Anleitungen, Fehlerbehebung | Richtigkeit, Vollständigkeit, einfache Sprache | Die meisten Antworten korrekt, der Rest eskaliert sauber |
| 4: Rest | Randfälle, seltene Produktfragen | Später bündeln, bis dahin Übergabe nutzen | Übergabe ist akzeptabel |
Für Stufe 1 lese ich die Erstattungsregeln außerdem so, wie ein Agent es täte. Wer darf eine Ausnahme genehmigen, ab welchem Betrag, und wie lautet die genaue Formulierung? Mein Beitrag zur Erstattungs-Genehmigungsmatrix legt das dar, und der Leitfaden KI für Erstattungsanfragen behandelt, was sich automatisieren lässt. Wenn eine Antwort der Stufe 1 eine Ermessensentscheidung braucht, stelle das Thema auf Übergabe statt Antwort. Rúngne macht genau das: Das Team wählt die Themen, die die KI direkt beantwortet, etwa Richtlinien und Sendungsverfolgung, und lässt Kündigungen, beschädigte Artikel und verlorene Pakete bei Menschen. Ein Thema zu verschieben ist eine Listenänderung, kein Projekt. Ihr Setup steht in der Rúngne-Geschichte.
Wie die KI jedes Helpdesks dein Wissen liest
Diesen Teil überspringen die meisten Audits. Bevor du einen Artikel korrigierst, musst du wissen, ob die KI ihn sehen kann und wie frisch ihre Kopie ist. Ich habe dafür die eigene Dokumentation jedes Anbieters gelesen (alle Seiten im September und Oktober 2026 bearbeitet oder aktualisiert), und die Unterschiede sind wichtig.
| Helpdesk-KI | Was sie liest | Wie frisch | Was zu prüfen ist |
|---|---|---|---|
| Zendesk AI agents | Zendesk-Help-Center, Web-Crawler, Wissensconnectors (bis zu 50 externe Quellen) | Help Center live durchsucht. Externe Quellen mit Stand der letzten Synchronisierung, meist alle 24 Stunden. Crawler aktualisiert alle 30 Minuten, Confluence alle 24 Stunden | Eingeschränkte Artikel erreichen nur authentifizierte Kunden. Zu viele Quellen können die Genauigkeit senken und die Latenz erhöhen |
| Freshdesk Freddy AI Agent | URLs, Dateien, öffentliche Lösungsartikel, eigene Q&As, Google-Drive- und SharePoint-Apps | Manuelle Neusynchronisierung, Zeitstempel der letzten Synchronisierung. SharePoint-Änderungen etwa alle 15 Minuten | Nur öffentliche Artikel. Geschützte URLs, private Artikel und Text in Bildern oder Tabellen werden übersprungen |
| Gorgias AI Agent | Guidance, Help-Center-Artikel, Shop-Website, öffentliche URLs, Dokumente | Neusynchronisierung von Website und URLs manuell, einmal alle 24 Stunden | Nur öffentliche Seiten. Eingebettete PDFs, Videos und Bilder werden nicht extrahiert. Entwürfe werden in Live-Antworten nicht genutzt |
| Help Scout Scout | Docs-Seite, Website-Seiten, PDFs, Word- und Excel-Dateien, Textquellen | Docs bleiben synchron. Websites brauchen manuelle Neusynchronisierung | Einzelne Seiten wählen, nicht ganze Websites. Google-Dateien müssen per Link freigegeben sein |
| HubSpot Customer Agent | HubSpot-Artikel und -Seiten, öffentliche URLs (bis zu 5.000 verwandte), Dateien | HubSpot-Artikel werden bei Bearbeitung neu synchronisiert. Andere Quellen wöchentlich | Private Quellen werden nicht zitiert, können Antworten aber trotzdem prägen |
Zendesk. Laut Zendesks Dokumentation wird ein verbundenes Help Center zum Zeitpunkt der Frage durchsucht, während externe Quellen den Stand der letzten Synchronisierung haben, meist alle 24 Stunden. Praktisch heißt das: Eine Änderung in einem externen Wiki ist erst nach einem Tag live, und der Web-Crawler läuft viel öfter als der Confluence-Connector. Eingeschränkte Help-Center-Artikel werden nur genutzt, wenn der Kunde authentifiziert ist, und die Dokumentation vermerkt, dass du Antworten mit eingeschränkten Inhalten im Test-Widget nicht testen kannst. Wenn deine besten Antworten hinter einem Login liegen, zeigt dir dein Launch-Test das nicht. Mehr in meiner Übersicht zu Zendesk AI.
Freshdesk. Der Freddy-Wissensleitfaden nennt Grenzen, die du lesen solltest, bevor du etwas verbindest: 10 URLs pro Agent, bis zu 3.000 Seiten pro Website, 200 Dateien pro Agent mit je 35 MB und Lösungsartikel nur, wenn sie für alle Nutzer sichtbar sind. Private oder eingeschränkte Artikel sind ausgeschlossen. Es gibt auch ein nützliches Audit-Werkzeug: Nach einer Konversation zeigt das Detailfeld, aus welchen Quellen der Agent abgerufen hat. Für Confluence empfiehlt Freshdesk ein eigenes Servicekonto, denn wenn der einrichtende Admin den Zugriff verliert, werden diese Artikel als gelöscht behandelt. Siehe Freddy-Wissensquellen und die eesel-Freshdesk-Integration.
Gorgias. Gorgias sagt, dass Guidance unter seinen Wissenstypen das meiste Gewicht hat, und damit ist Guidance der erste Ort, um nach Widersprüchen mit deinem Help Center zu suchen. Synchronisierungen von Shop-Website und URLs betreffen nur öffentliche Seiten, aktualisieren sich nicht automatisch und können einmal alle 24 Stunden erneut ausgeführt werden. Snippets, die von einer Website gezogen wurden, lassen sich nicht bearbeiten, aber deaktivieren, wenn sie veraltete Inhalte enthalten. Die Funktion Opportunities (Beta) zeigt Lücken und Widersprüche aus echten Konversationen, eine praktische Abkürzung. Mehr in der Analyse zu Gorgias AI Agent 2.0.
Help Scout. Scout, der Agent, der aus AI Answers hervorgegangen ist, bleibt mit deiner Docs-Seite jederzeit synchron, aber Website-Quellen brauchen eine manuelle Neusynchronisierung, wenn sich Preise oder ein Prozess ändern. Help Scout rät außerdem, ihn auf die einzelnen Seiten mit deinen besten Informationen zu richten statt auf eine ganze Website, und sagt, dass Bilder und Videos wichtige Schritte nicht allein tragen sollten. Details unter KI für Help Scout und der eesel-Help-Scout-Integration.
HubSpot. Der Customer Agent synchronisiert Wissensdatenbank-Artikel neu, wenn sie bearbeitet werden, und andere Quellen wöchentlich. Die Zeile, die du zweimal lesen solltest, betrifft private Inhalte: Private Quellen werden nicht zitiert, ihr Inhalt kann aber trotzdem in Antworten auftauchen. Damit ist „versteckt" ein subtileres Risiko, denn ein internes Dokument, das du als Referenz verbunden hast, kann seine Formulierungen trotzdem preisgeben. Siehe HubSpot AI agent für das größere Bild.
Abdeckung anhand echter Tickets prüfen
Artikel zu lesen sagt dir, ob sie richtig sind. Tickets sagen dir, ob es die richtigen Artikel sind. Ich ziehe die Tickets der letzten 90 Tage, gruppiere sie nach Thema und gebe jedem Thema eine von vier Markierungen.
- Abgedeckt. Ein Artikel existiert, ist aktuell und stimmt mit dem überein, was Agenten tatsächlich antworten.
- Teilweise. Ein Artikel existiert, beantwortet aber eine verwandte Frage oder lässt die Ausnahme aus, die Agenten immer erwähnen.
- Widersprüchlich. Zwei Quellen widersprechen sich, oder der Artikel widerspricht dem, was Agenten in der Praxis senden.
- Fehlend. Kein Artikel. Agenten antworten aus dem Gedächtnis oder mit einem Makro.
Die Agentenantwort ist hier der nützlichste Beleg. Wenn deine besten Agenten durchgängig einen Satz ergänzen, den der Artikel nicht hat, dann ist dieser Satz die Lücke. Eine Support-Managerin, mit der ich sprach, hatte ein Help Center, das ganz für Admins geschrieben war, während die Tickets von Endnutzern kamen. Kein Artikel-für-Artikel-Lesen entdeckt das. Der Vergleich mit Tickets schon.
Ordne die Ergebnisse nach Volumen. Themen der Stufe 1 mit der Markierung teilweise oder fehlend kommen oben auf die Korrekturliste. Zu den Methoden habe ich über das Zuordnen von Anfragen zu Lücken und den Ablauf der Zendesk-Wissenslückenanalyse geschrieben, und der breitere Rollout gehört in meinen Leitfaden zu Fehlern bei der Einführung.
Ein Testset bauen und Go-live-Regeln festlegen
Lege die Bestehensgrenze fest, bevor du den Test laufen lässt. Wenn du sie danach festlegst, sieht jedes Ergebnis akzeptabel aus.
Baue das Set aus echten Fragen. Nimm 50 bis 100 echte Kundennachrichten, gewichtet zu Stufe 1 und Stufe 2, und nimm einige dazu, die die KI nicht beantworten sollte: eine Erstattung außerhalb der Richtlinie, eine Rechtsfrage, eine Anfrage, die eine Kontoabfrage braucht. Schreibe zu jeder auf, wie eine korrekte Antwort oder eine korrekte Übergabe aussieht, und benenne den Quellartikel, aus dem sie stammen sollte.
Bewerte vier Dinge pro Antwort. Hat sie die richtige Quelle abgerufen? War die Antwort korrekt? War sie vollständig, einschließlich Ausnahmen? Hat sie eskaliert, wenn sie es sollte? Das Letzte wird am häufigsten übersprungen, und es hängt nach dem Go-live mit deiner Eskalationsrate und Containment-Rate zusammen.
Nutze die Testwerkzeuge des Anbieters im Rahmen ihrer Grenzen. Help Scout hat einen Test-Bereich, und Gorgias lässt dich Entwürfe vor der Veröffentlichung testen. Zendesks Test-Widget kann Antworten mit eingeschränkten Inhalten nicht testen.
Spiele alte Tickets erneut ab, wenn dein Tool es erlaubt. eesels Simulation-Funktion zieht alte Tickets, erzeugt KI-Antworten, vergleicht sie mit dem, was Menschen tatsächlich gesendet haben, bewertet die Übereinstimmung und erstellt einen Lückenbericht. Es ist das Nächste, was ich kenne, an einen Test mit deinen eigenen Daten, ohne dass ein Kunde eine falsche Antwort sieht. Mein Beitrag zum Testen von KI-Support-Agenten geht einen ausführlicheren Plan durch.
Go-live-Regeln, die ich empfehle. Das sind meine eigenen Hürden, kein Anbieterstandard, passe sie also an dein Risiko an:
- Themen der Stufen 1 und 2: null falsche Antworten im Testset, und jeder unsichere Fall wird übergeben.
- Stufe 3: mindestens neun von zehn Antworten korrekt, und jeder Fehler wird übergeben statt geraten.
- Keine offenen Widersprüche in Stufe 1, und jeder Artikel der Stufe 1 in den letzten 90 Tagen verifiziert.
- Jedes Thema mit hohem Volumen ist entweder abgedeckt oder auf Eskalation gestellt.
- Ein benannter Verantwortlicher für die wöchentliche Prüfung nach dem Launch.
Die wöchentliche Schleife nach dem Go-live
Ein Launch-Audit veraltet so schnell wie deine Richtlinien. Im ersten Monat lasse ich jede Woche dieselbe kurze Schleife laufen, danach halte ich sie monatlich und zusätzlich immer, wenn sich eine Richtlinie ändert.
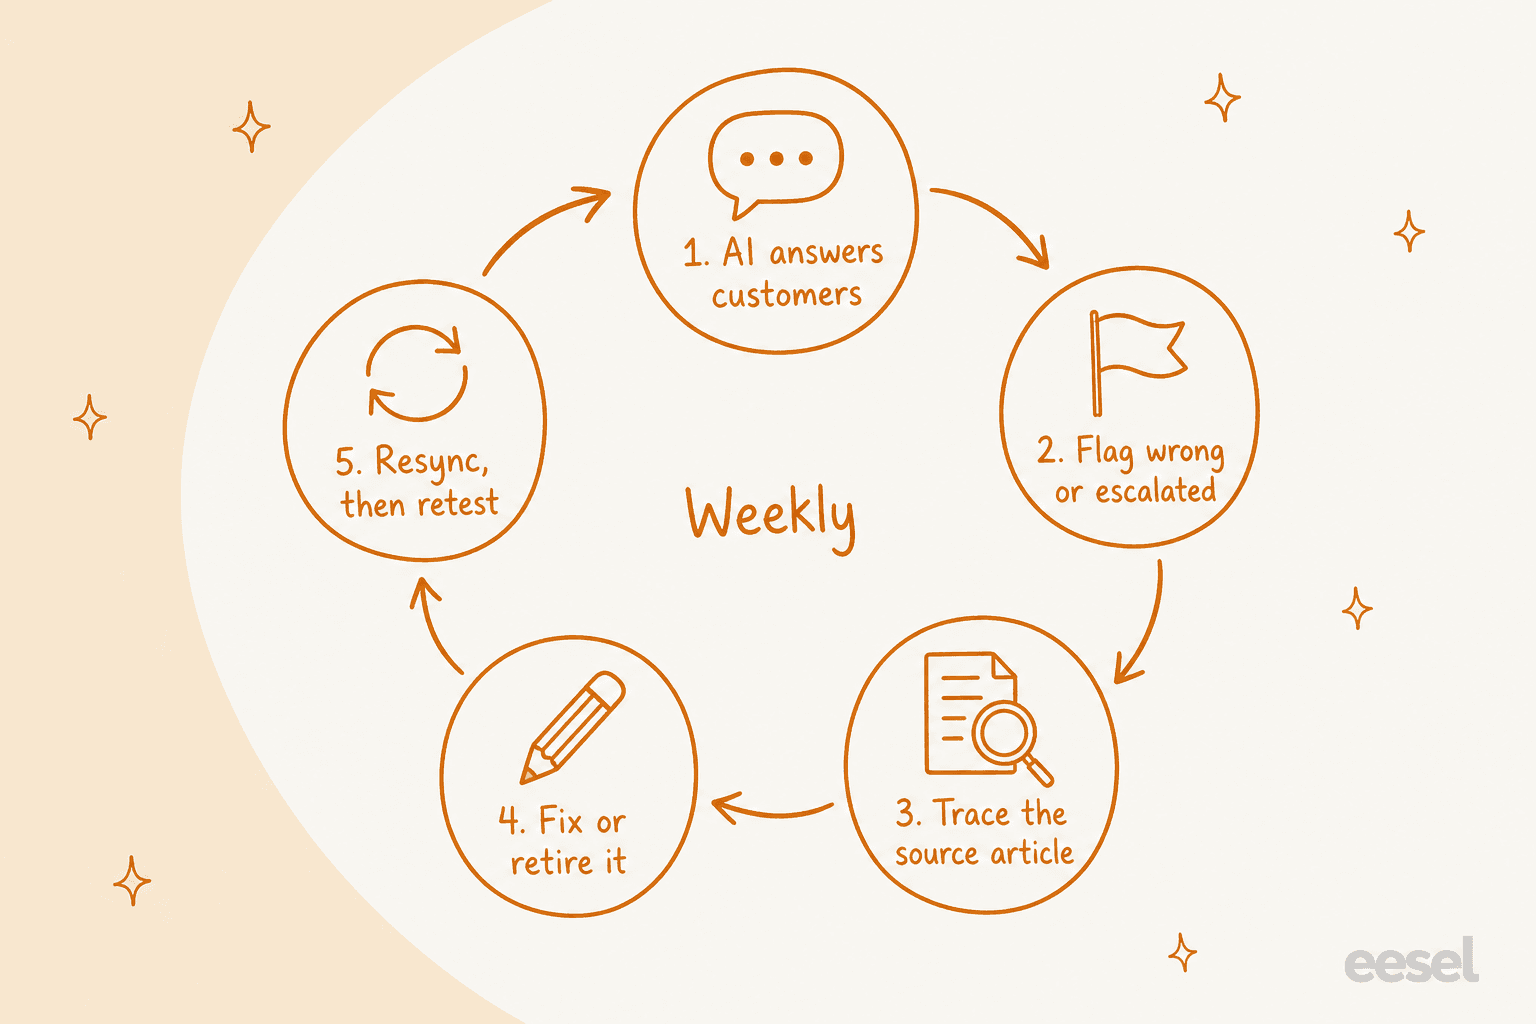
Die wöchentliche Schleife: lesen, was die KI falsch gemacht oder eskaliert hat, auf eine Quelle zurückführen, korrigieren, neu synchronisieren, dann erneut testen.
- Die falschen und eskalierten Konversationen ziehen. In Help Scout zeigt das Sortieren von Reports > Scout nach Lösung diejenigen, bei denen Kunden nicht geholfen wurde. In Freshdesk zeigen die Konversationsdetails, welche Quellen genutzt wurden.
- Jede auf eine Quelle zurückführen. War es ein Widerspruch, ein veralteter Fakt, eine Lücke oder eine versteckte Antwort? Nutze dieselben vier Labels, damit das Muster sichtbar wird.
- Die Quelle korrigieren oder streichen. Streichen schlägt Flicken, wenn sich zwei Artikel überlappen.
- Neu synchronisieren. Das ist der Schritt, den Leute vergessen. Eine Gorgias-Website-Quelle, eine Help-Scout-Website-Quelle und eine Freshdesk-URL brauchen alle eine manuelle Aktualisierung, bevor die KI die Änderung sieht.
- Erneut testen. Die Fragen erneut laufen lassen, die gescheitert sind, plus eine Handvoll aus Stufe 1.
Die Kennzahlen, die sich zu beobachten lohnen, stehen in meinem Leitfaden zu KI-Kundenservice-Kennzahlen.
Wie eesel das Audit in der Praxis handhabt
eesels KI-Helpdesk-Teammate lernt aus deinem Help Center, deinen vergangenen Tickets und Dokumenten wie Confluence und Google Docs und arbeitet dann in deinem bestehenden Helpdesk. Zwei namentlich genannte Kunden zeigen, wie das Audit in der Praxis aussieht.
- SamCart betreibt getrennte eesel-Agenten auf Freshdesk-E-Mail-Tickets und im Website-Chat, beide antworten aus rund 280 Help-Center-Artikeln. Den Agenten ist vorgegeben, nur öffentliche Artikel zu verlinken, sodass älteres internes Material eine Antwort speisen kann, ohne an einen Verkäufer geschickt zu werden. Wenn ein Artikel etwas beschreibt, das nicht mehr verfügbar ist, ergänzt das Team eine Korrektur, und der Agent bietet es nicht mehr an. Das ist die Lösung für Veraltetes, ohne den ganzen Artikel umzuschreiben.
- Rúngne betreibt drei Agenten auf Gorgias, nach Aufgabe getrennt. Einer sortiert und taggt, einer entwirft Antworten, die Menschen senden, und einer beantwortet einfache Richtlinien- und Sendungsverfolgungsfragen selbst. Kündigungen, Schäden und verlorene Pakete bleiben beim Team. Die Themenliste ist der Regler.
Das Muster ist dasselbe: entscheiden, welche Themen die KI beantworten darf, Geld und Ermessensentscheidungen bei Menschen lassen und Korrekturen zur Gewohnheit machen. Mein Beitrag zum Trainieren eines KI-Support-Agenten und der Leitfaden zur KI-Wissensdatenbank behandeln die Aufbauseite.
eesel ausprobieren
Das Audit entscheidet, ob dein Help Center bereit ist. Der Test entscheidet, ob es bereit genug ist. Wenn du diesen Test an deinen eigenen Tickets laufen lassen willst: eesels KI-Helpdesk-Teammate verbindet sich mit Zendesk, Freshdesk, Gorgias, Help Scout oder HubSpot, lernt aus deinem Help Center und vergangenen Tickets und kann an alten Konversationen erneut abgespielt werden, bevor er einem Kunden antwortet. Die Preise richten sich nach dem Tarif, und du kannst die Tarife ansehen und kostenlos starten.
eesel testen, kostenlos, oder eine Demo buchen, und ich zeige dir, wie es mit deinen eigenen Tickets umgeht.