

Warum „gelöst“ nicht „richtig“ bedeutet
Ich arbeite seit zwei Jahren bei eesel an der Suche, und nur wenige Support-Themen haben so viel Kaufabsicht wie dieses. Wer nach „how to train AI on past tickets“ sucht, tut das nicht aus Neugier. Er sitzt auf jahrelanger Helpdesk-Historie und hat gerade gemerkt, dass sie die detaillierteste Aufzeichnung davon ist, wie sein Team arbeitet. Das Training mit alten Tickets ist auch die Anfrage, die in den eigenen Sales-Gesprächen von eesel am konsequentesten auftaucht.
Der Haken: Der Status eines Tickets sagt Ihnen, dass das Gespräch endete. Er sagt nicht, dass der Kunde die richtige Antwort bekam, dass die zitierte Richtlinie noch gilt oder dass die Antwort wie der Mitarbeiter klang, den Sie klonen möchten. Viele „gelöste“ Tickets wurden durch eine Auto-Close-Regel geschlossen, eine Woche später wiedereröffnet oder von jemandem im ersten Monat beantwortet.
Die gute Nachricht: Die Historie bringt bei, worin KI von Haus aus meist am schwächsten ist, nämlich so zu klingen wie Ihr Team. In einem eesel-Test mit einer Schmuck-E-Commerce-Marke, die etwa 1.000 Tickets pro Monat auf Zendesk und Shopify bearbeitet, sendeten Mitarbeiter nur 12% der KI-Entwürfe unverändert. Als das Team nach den Gründen schaute, ging es bei rund zwei Dritteln der Überarbeitungen um Länge und Tonalität: lange Entwürfe wurden zu Antworten mit ein bis drei Sätzen. Nur etwa 5% korrigierten einen falschen Fakt. Genau diese Lücke schließt eine kuratierte Auswahl der von Ihrem Team gesendeten Antworten.
Die Aufgabe lautet also nicht „KI mit alten Tickets trainieren“. Sie lautet „der KI aus Ihren besten alten Tickets beibringen und den Rest draußen halten“. Das führt dieser Leitfaden in sechs Schritten durch. Wenn Sie noch klären, welche Daten Sie grundsätzlich brauchen, lesen Sie zuerst, welche Daten Sie brauchen, um KI zu trainieren, und kommen Sie dann zurück.
Was ein einzelnes altes Ticket einer KI beibringen kann
Bevor Sie etwas exportieren, hilft die Einsicht, dass ein Ticket mehrere verschiedene Dinge lehrt und jede Lektion an einen anderen Ort gehört.
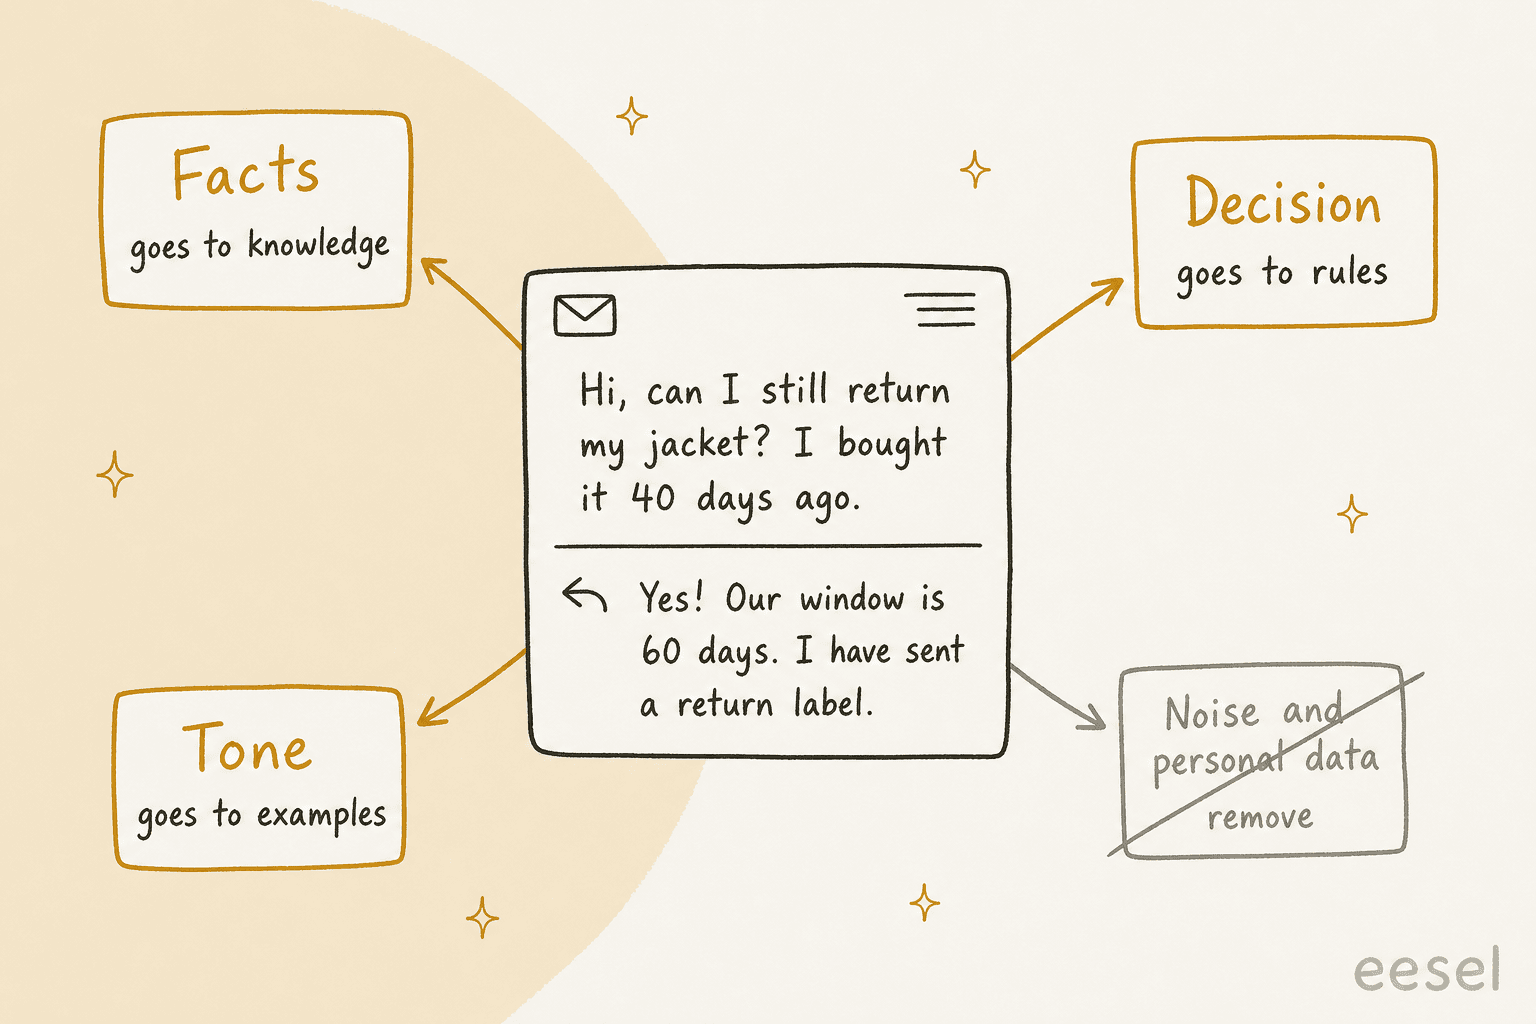
Nehmen wir eine einfache Rückgabeanfrage. Die Antwort des Mitarbeiters enthält:
- Einen Fakt: Die Rückgabefrist beträgt 60 Tage. Das gehört in Ihre Wissensdatenbank, wo es sich an einer Stelle aktualisieren lässt, wenn sich die Richtlinie ändert.
- Eine Entscheidung: Dieser Kunde hat Anspruch, also ein Etikett senden. Das ist eine Regel („innerhalb von 60 Tagen, ungetragen, Etikett senden; danach übergeben“), und Regeln sind schriftlich sicherer als aus Hunderten Beispielen abgeleitet.
- Tonalität: kurz, herzlich, ein Ausrufezeichen, keine Entschuldigung. Das lehren Beispielantworten.
- Rauschen: Name des Kunden, Anschrift, Bestellnummer, die Signatur des Mitarbeiters und eine interne Notiz. Nichts davon sollte die KI erreichen.
Wenn Sie das ganze Ticket in eine KI kippen, lernt sie alle vier auf einmal und kann sie nicht unterscheiden. So entsteht ein Bot, der in freundlichem Ton eine 30-Tage-Frist aus dem Jahr 2023 zitiert. Gorgias beschreibt das Risiko klar: "if a help center article says your return window is 30 days but a guidance says 14, AI Agent might not respond the same way every time" (Gorgias-Wissensdokumentation). Alte Tickets sind die größte Quelle genau solcher Konflikte.
Die drei Wege, alte Tickets zu nutzen
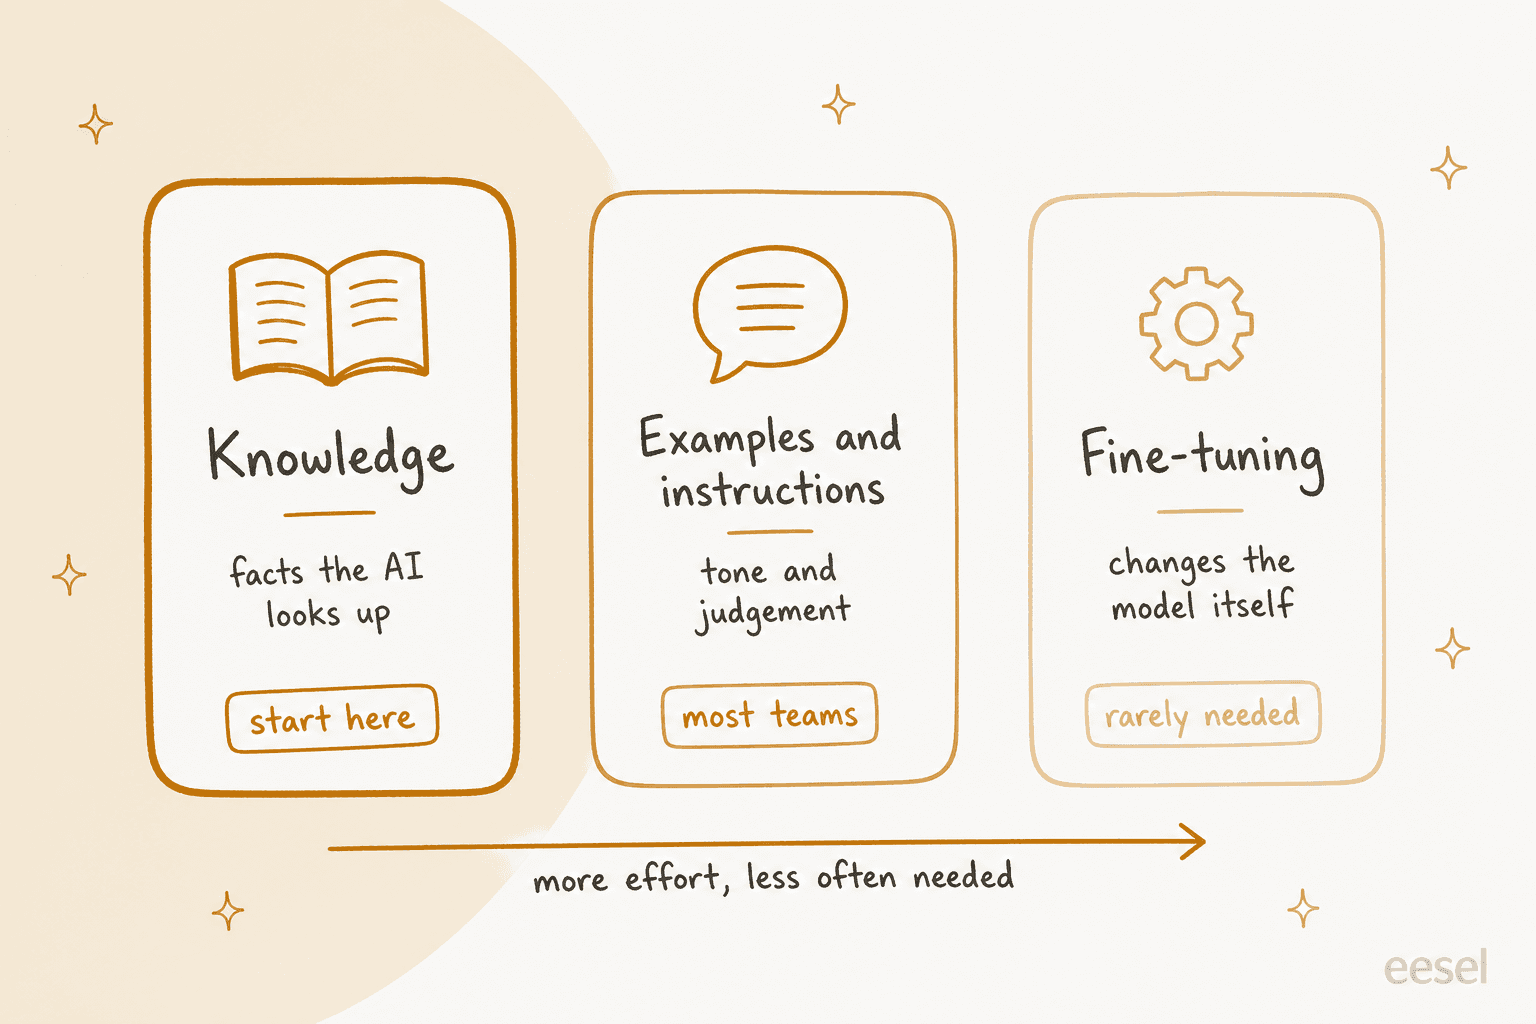
Es gibt drei Wege, die Ticket-Historie in KI-Verhalten zu verwandeln, und sie sind nicht gleich nützlich.
| Methode | Was sie beibringt | So funktioniert sie | Aufwand | Wann sie die richtige Wahl ist |
|---|---|---|---|---|
| Wissensextraktion und Retrieval | Fakten, Schritte, Richtlinien | Tickets nach Antworten durchsuchen, in Artikel oder Q&A verwandeln und die KI beim Antworten nachschlagen lassen (RAG) | Gering bis mittel | Immer. Hier kommt die Genauigkeit her |
| Beispiele und Anweisungen | Tonalität, Länge, Urteilsvermögen | Ein paar Dutzend Ihrer besten Antworten als Beispiele wählen, die Entscheidungen als Regeln aufschreiben | Gering | Fast immer. Hier kommt „klingt wie wir“ her |
| Fine-Tuning | Format und Stil im großen Maßstab | Die Gewichte eines Modells mit Tausenden Beispielgesprächen trainieren | Hoch | Selten: sehr hohes Volumen, eine enge Aufgabe und Evals, die belegen, dass Prompting es nicht schafft |
Beim Retrieval liegt die Genauigkeit. Die KI durchsucht Ihr Help Center, Ihre Makros und bereinigte Ticket-Antworten, wenn eine Frage eintrifft, und antwortet aus dem, was sie findet. Ändert sich eine Richtlinie, bearbeiten Sie einen Artikel, und die nächste Antwort stimmt. Die ausführliche Version dieses Arguments finden Sie unter RAG vs. Fine-Tuning.
Bei Beispielen und Anweisungen liegt die Tonalität. Freshdesks eigener Rat für seinen E-Mail-Agenten lautet "Include examples of ideal responses in your instructions. The agent learns from concrete examples faster than it does from abstract rules" (Freshdesk E-Mail-KI-Agent einrichten). Sie brauchen dafür keine 10.000 Tickets. Sie brauchen 20 bis 50 Antworten, auf die Ihre besten Mitarbeiter stolz wären.
Fine-Tuning ist das, wonach alle fragen und das fast niemand braucht. In der OpenAI-Dokumentation steht überwachtes Fine-Tuning als am besten geeignet für Klassifikation, Übersetzung, feste Ausgabeformate und "correcting instruction-following failures" (OpenAI Supervised Fine-Tuning). Ihre aktuelle Erstattungsrichtlinie zu lernen steht nicht auf dieser Liste, denn in Modellgewichte eingebackene Fakten veralten an dem Tag, an dem sich die Richtlinie ändert. Die Dokumentation sagt auch "The prompt engineering process may be all you need" (OpenAI Modelloptimierung).
Ein Entwickler auf Reddit hat es trotzdem versucht, und das Ergebnis ist das klarste Bild, das ich dazu gefunden habe, was Fine-Tuning auf rohen Tickets tatsächlich bewirkt:
"So I pulled about 8k past tickets which were mostly about shipping, returns, account issues and product information and anonymized the sensitive data then set up a training run. The good news was that it picked up the brand tone and mirrored our macros, but it also prioritized weird quirks too often. Our old agent would write 'hey there' for nearly every tricket so this model started spraying it everywhere."

Am Ende wechselte die Person zurück zu einem strikten System-Prompt und einer leichtgewichtigen Retrieval-Schicht. Das Modell lernte die Tonalität und auch die Angewohnheit eines einzelnen Mitarbeiters, denn ein Fine-Tune kann eine Marotte nicht von einer Richtlinie unterscheiden.
Und es gibt jetzt einen praktischen Grund, darauf zu verzichten. OpenAI fährt das Self-Service-Fine-Tuning herunter: Organisationen, die noch nie feinabgestimmt hatten, verloren am 7. Mai 2026 den Zugang, und aktive Kunden können nach dem 6. Januar 2027 keine neuen Jobs mehr anlegen (OpenAI-Deprecations). Wenn Sie bestehender Nutzer sind: Das Training eines gpt-4.1-mini-Modells kostet $5.00 pro Million Trainings-Tokens, und das feinabgestimmte Modell läuft dann mit $0.80 Input und $3.20 Output pro Million Tokens, dem Doppelten des Preises des Basismodells (OpenAI-Preise). Mehr zu diesem Weg finden Sie im Leitfaden zur OpenAI Fine-Tuning API.
Sie wissen nicht, was Ihr Problem braucht? Wählen Sie das Symptom, das Sie sehen.
Wählen Sie das Symptom, das Sie sehen, und erfahren Sie, welcher Teil Ihrer Ticket-Historie es behebt.
Was Ihr Helpdesk mit alten Tickets bereits tut
Prüfen Sie, bevor Sie etwas bauen, was Ihr Helpdesk von allein tut, denn die Antwort unterscheidet sich stärker, als das Marketing vermuten lässt. Ich habe das Help Center jedes Anbieters durchgesehen, damit Sie es nicht müssen.
| Helpdesk | Lernt aus alten Tickets? | Wie | Rückblick | KI-Preis (Anbieterseite) |
|---|---|---|---|---|
| Zendesk | Teilweise | Auto Assist nutzt ähnliche gelöste Tickets nur, wenn keine Prozedur und kein Artikel passt; Prozeduren und Help-Center-Entwürfe werden aus gelösten Tickets erzeugt, die Sie veröffentlichen | 90 Tage für erzeugte Entwürfe | Copilot $50/Agent/Monat bei jährlicher Zahlung; KI-Agent $1.50 pro automatisierter Lösung bei Zusage, $2.00 Pay-as-you-go |
| Freshdesk | Zum Testen, nicht zum Antworten | Alte Tickets sind keine aufgeführte Wissensquelle; gelöste Tickets lassen sich als Testset importieren | Standardmäßig 30 Tage per API | Freddy AI Agent: erste 500 Sessions inklusive, danach $49 pro 100 Sessions |
| Gorgias | Indirekt | „Opportunities“ (Beta) schlägt Wissenslücken und Konflikte aus Gesprächen vor, die die KI nicht lösen konnte; Sie bestätigen jeden Vorschlag | Berichte nutzen 28 Tage | $0.85 bis $1.00 pro automatisierter Interaktion |
| HubSpot | Ja | Erzeugt Q&A-Paare aus gelösten Tickets oder Posteingangs-Gesprächen; Sie akzeptieren, überspringen oder lehnen jedes ab | 90 Tage oder ein Ticket-Segment | 50 Credits pro Lösung, $0.50 bei Pay-as-you-go-Preisen |
Ein paar Details fielen auf.
Zendesk behandelt Tickets als letzten Ausweg. Auto Assist schlägt Antworten vor "based on procedures, help center articles, similar solved tickets", und die Reihenfolge zählt: "If there are no relevant procedures or help center articles available, then similar solved tickets are used" (About auto assist). Nur Tickets derselben Marke zählen. Zendesk entwirft außerdem pro Woche und Marke bis zu drei Prozeduren aus "Relevant solved tickets from the last 90 days", doch jede wartet darauf, dass ein Admin sie veröffentlicht (AI-generated procedures). Die Preise stehen auf Zendesks Preisseite.
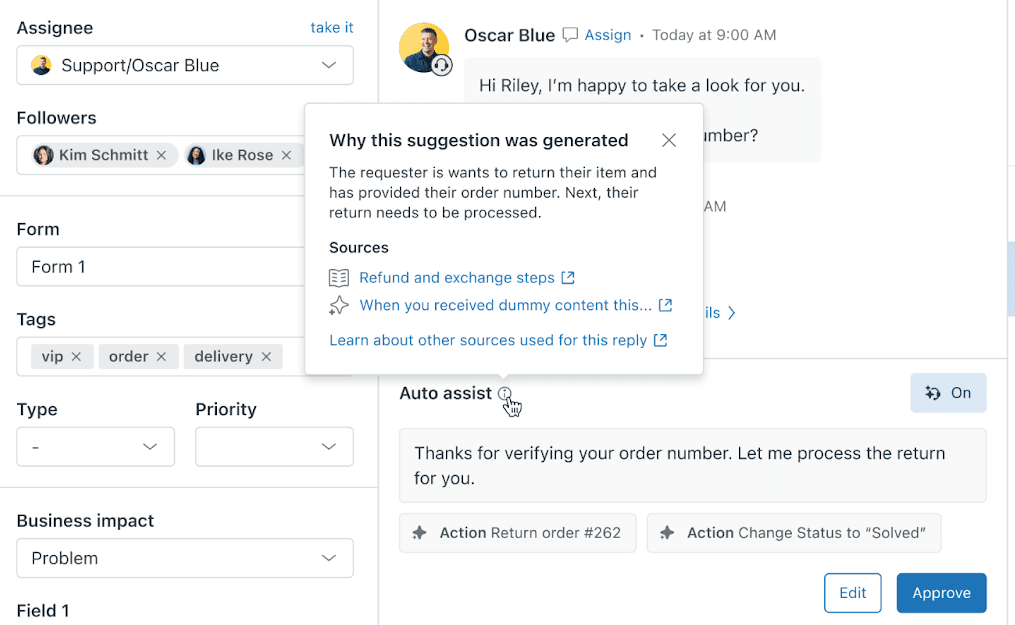
Zendesks Knowledge builder ist ebenfalls wissenswert, wenn Sie noch kein Help Center haben. Er liest die Tickets der letzten 90 Tage und schlägt bis zu 40 Artikel vor. Seine Ticket-Regeln sind ein gutes Vorbild für Ihren eigenen Filter: nur gelöst oder geschlossen, nur öffentliche, nicht leere Kommentare, und keine internen Notizen, kein Spam, keine Einzelfälle. Zendesk sagt selbst, dass er für ein gut gepflegtes Help Center "will likely not be helpful" sei.
Freshdesk hält Tickets aus dem Antwortpfad heraus. Es führt als Quellen des KI-Agenten "URLs, files, solution articles, custom Q&As, and external apps" auf (Freshdesk-Wissensdokumentation). Die Historie taucht beim Testen auf: Sie können gelöste historische Tickets in einen Evaluierungslauf importieren. Mehr dazu in Schritt 5. Die Preise stehen auf Freshdesks Preisseite.
HubSpot ist am direktesten. Es will "generate knowledge sources from your resolved tickets, inbox conversations, or uploaded files", gruppiert in Themen als FAQ-artige Paare, die Sie prüfen (HubSpot Knowledge Generator). Es ist in den Tarifen Professional und Enterprise enthalten.
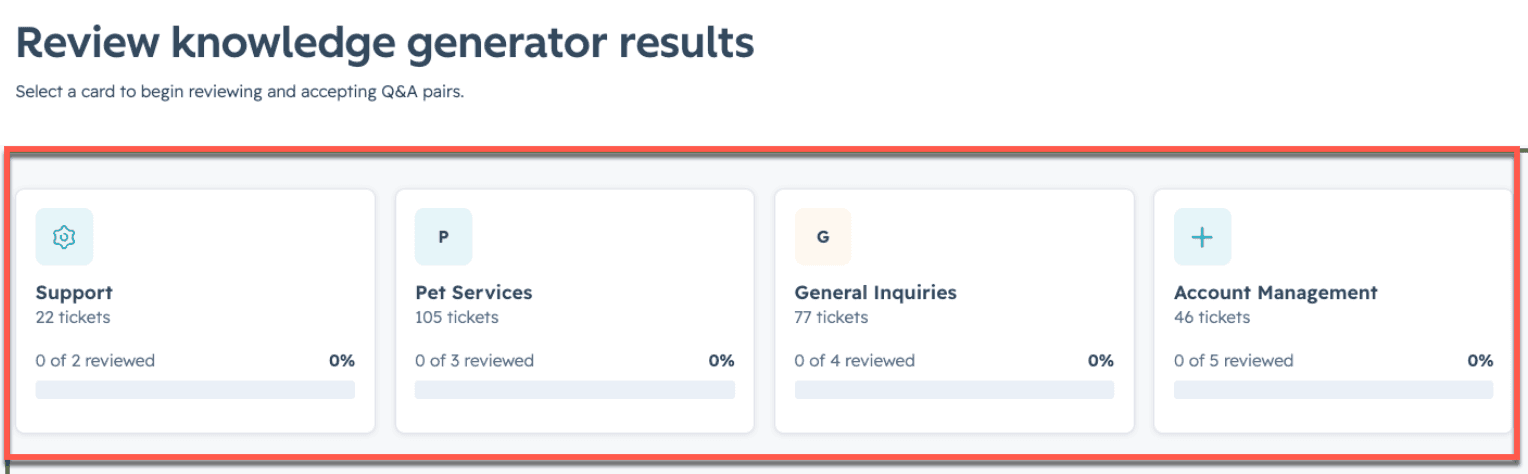
Das Muster fällt auf: Jeder Anbieter, der aus Tickets lernt, setzt einen menschlichen Freigabeschritt in die Mitte. Damit sagen die Anbieter Ihnen höflich, dass rohe Ticket-Historie nicht ungeprüft zum Lernen taugt.
Schritt 1: Tickets exportieren, mit angehängtem Gespräch
Die erste Überraschung für die meisten Teams: Der Standard-Ticket-Export enthält meist nicht das Gespräch. Sie bekommen Betreff, Status und Felder, aber nicht das Hin und Her, aus dem Sie eigentlich lernen wollen.
- Zendesk: Der empfohlene inkrementelle Export läuft über den Endpunkt
GET /api/v2/incremental/tickets/cursor.json, bis zu 1.000 Tickets pro Seite und 10 Anfragen pro Minute (30 mit dem High-Volume-Add-on), nur für Admins. Kommentare sind nicht enthalten. Holen Sie sie aus dem Ticket-Events-Stream mitinclude=comment_eventsoder pro Ticket vom Comments-Endpunkt, wopublic: falseeine interne Notiz markiert. Der Leitfaden zum Zendesk Incremental Export enthält die vollständige Anleitung. - Freshdesk: Der UI-Export "will NOT give you the entire conversation from the ticket or historical data" (Freshdesk-Exportdokumentation). Nutzen Sie einen Account-Export oder die API, die ohne
updated_sincenur die letzten 30 Tage liefert, und höchstens 30.000 Tickets pro Listenaufruf (Freshdesk API). - Gorgias: Der Ansichts-Export verarbeitet bis zu 1 Million Tickets, enthält aber keinen Nachrichtentext. "Export with message content" aus einem Analytics-Drilldown deckt nur die jüngsten 30 Tage ab, bis zu 100.000 Tickets, nur öffentliche Nachrichten (Gorgias-Exportdokumentation).
Exportieren Sie nur öffentliche Nachrichten. In internen Notizen schreiben Mitarbeiter Dinge wie „Kunde lügt, trotzdem erstatten, damit Ruhe ist“, und die soll die KI nicht lernen. Zendesks eigene Tools lassen interne Notizen aus demselben Grund weg.
Schritt 2: Tickets herausfiltern, die das Falsche beibringen würden
Dieser Schritt entscheidet über das Projekt. Sie wollen nicht möglichst viele Tickets behalten. Sie wollen die behalten, die Sie einem neuen Mitarbeiter gern als „so machen wir das“ zeigen würden.
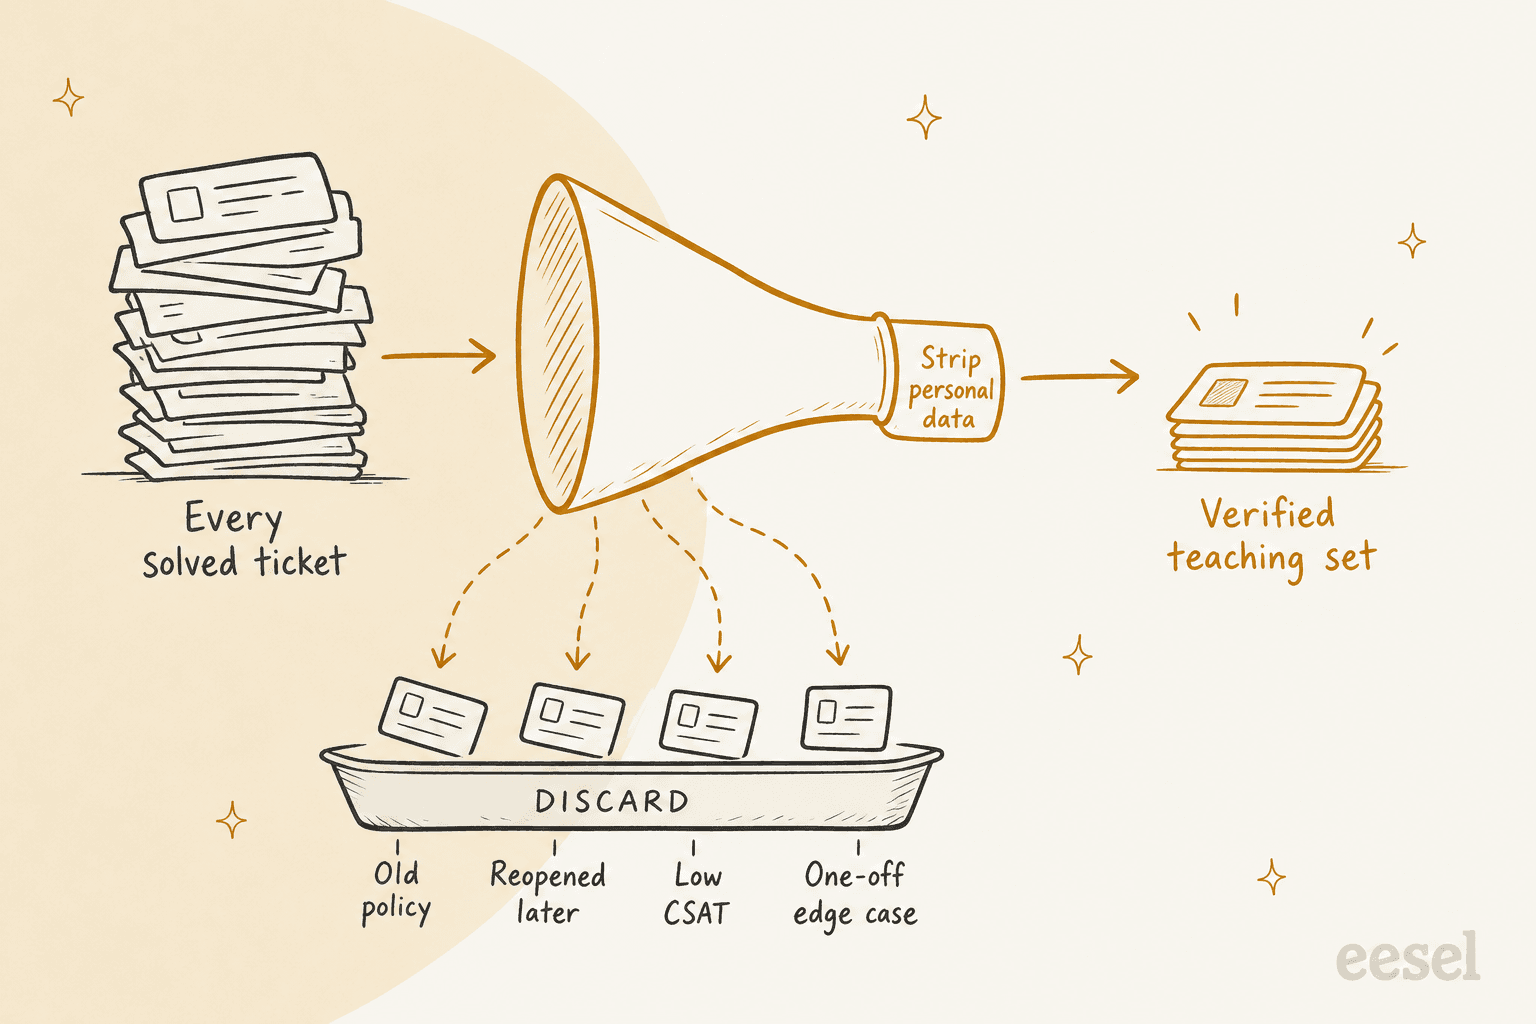
Lassen Sie diese weg:
- Tickets, die älter sind als Ihre letzte Richtlinienänderung. Wenn sich Ihre Rückgaberichtlinie im März geändert hat, bringt alles vor März die alte Regel bei. Fangen Sie im Zweifel mit den letzten drei bis sechs Monaten an. Zendesk und HubSpot nutzen für ihre eigenen Funktionen zum Lernen aus Tickets beide standardmäßig 90 Tage.
- Tickets, die wiedereröffnet, nach dem „Lösen“ eskaliert oder von einem zweiten Ticket zum selben Problem gefolgt wurden. Die erste Antwort hat nicht funktioniert.
- Tickets mit schlechter CSAT-Bewertung oder durchgefallener QA-Prüfung. Wenn Sie Support-QA betreiben, sind die von der QA freigegebenen Tickets Ihr Goldsatz.
- Automatisch geschlossene Tickets ohne Antwort eines Mitarbeiters, Spam und „Danke!“-Nachfragen.
- Einzelne Randfälle. Der maßgeschneiderte Deal, den Ihr Head of Support einmal für einen VIP gemacht hat, sollte nicht zur Standardantwort werden.
- Saisonspitzen, wenn sie die Mischung verzerren würden. Eine Blumenlieferdienst-Marke in einem eesel-Sales-Gespräch bat um 300 zufällige Tickets pro Monat über 10 Monate, ohne die Spitzen zu Valentinstag und Muttertag, damit ein Februar-Schub die anderen 10 Monate nicht übertönt.
OpenAIs Leitfaden zu Trainingsdaten sagt dasselbe von der anderen Seite: "a smaller amount of high-quality data is generally more effective than a larger amount of low-quality data" (OpenAI Fine-Tuning Best Practices). Er warnt auch, dass Ungleichgewicht Gewohnheiten beibringt. Wenn 60% der Beispielantworten "I cannot answer this" sagen, aber nur 5% es sollten, "you will likely get an overabundance of refusals." Ihre Ticket-Historie hat ihre eigene Version dieser Schieflage, meist in Richtung Ihres geschäftigsten Monats.
Ein Zendesk-Admin auf Reddit hat das Problem roher Historie gut beschrieben, und es ist der Grund, warum dieser Schritt existiert:
"I am not entirely sure this approach would be bullet-proof (especially for businesses that have struggled to offer consistent customer support across agents - yes, I've worked for one!). Also, training on tickets is only half the battle, it's integrating all the other "knowledge" sources that makes a difference."
Schritt 3: Personenbezogene Daten entfernen, bevor etwas indexiert wird
Support-Tickets sind voller Namen, E-Mail-Adressen, Anschriften, Bestellnummern und manchmal Kartennummern und Passwörtern, die Kunden in ihrer Frustration einfügen. Wenn die ins Wissen einer KI gelangen, ist das Risiko nicht nur Compliance. Es ist, dass die KI die Angaben eines Kunden in der Antwort an einen anderen wiederholt.
Die Anbieter sind dazu deutlich. HubSpots Dokumentation warnt, dass private Wissensquellen "will not be cited, but their content may still appear in responses", also "do not include personal, confidential, sensitive information, or private customer data" (HubSpot-Wissensquellen). Zendesks Add-on Advanced Data Privacy and Protection markiert Namen, E-Mail-Adressen, Anschriften, Kartennummern, Sozialversicherungsnummern, IP-Adressen und Telefonnummern in Kommentaren, mit einer Warnung, die man zweimal lesen sollte: "Ticket redaction cannot be reversed" (Zendesk-Schwärzung).
Die rechtliche Seite lässt sich einfach sagen, wie es ein Hacker-News-Kommentator tat:
"A support ticket or live chat with a customer is customer data. With things like GDPR you need to know exactly where customer data is stored and for how long."

Schwärzen Sie also nicht die Tickets in Ihrem Helpdesk, um einen Trainingssatz vorzubereiten. Schwärzen Sie die Kopie, mit der Sie trainieren. Ein paar Regeln, die ich befolgen würde:
- Maskieren, nicht löschen. Ersetzen Sie eine E-Mail-Adresse durch
[EMAIL], statt sie zu entfernen, damit das Beispiel natürlich liest und die KI „nach der Bestell-E-Mail fragen“ lernt, ohne jemandes tatsächliche Adresse zu lernen. - Halten Sie Bestellnummern aus Beispielen heraus, es sei denn, Sie bringen das Format bei. Die KI soll Bestellungen live nachschlagen, nicht auswendig lernen.
- Im Zweifel ablehnen. Wenn sich ein Ticket nicht bereinigen lässt, überspringen Sie es. Ein kleinerer Satz ist besser als ein Leck.
- Prüfen Sie den Schalter. Schwärzungs-Einstellungen sind oft standardmäßig aus. In eesel ist die Schwärzung alter Tickets zum Beispiel in kürzlich angelegten Workspaces aus, und die Dokumentation sagt, man solle "Check the toggle rather than assuming it's on" (eesel PII-Schwärzung).
Mehr zur Technik finden Sie unter PII in Support-Transkripten schwärzen und in der Übersicht zum Datenschutz bei Zendesk AI.
Schritt 4: Jedes Ticket in Fakten, Entscheidungen und Tonalität aufteilen
Nehmen Sie nun Ihren bereinigten Satz und leiten Sie jede Lektion an ihren Ort.
Fakten werden zu Wissen. Wenn dieselbe Frage in 15 Tickets dieselbe richtige Antwort bekommt und es dazu keinen Hilfeartikel gibt, ist das ein fehlender Artikel, kein Trainingsbeispiel. Schreiben Sie ihn einmal, in Ihrem Help Center oder einem internen Dokument, und lassen Sie die KI ihn abrufen. Das macht auch Ihr menschliches Team schneller, denn Antworten, die im Kopf einer Person lebten, stehen am Ende schriftlich da. Eine Analyse von Wissenslücken ist die systematische Version dieses Schritts.
Entscheidungen werden zu Regeln. Erstattung über einem Limit, ein Garantiefall, eine rechtliche Drohung, ein verärgerter VIP: Das sind Ermessensentscheidungen, und eine KI, die sie aus Beispielen gelernt hat, wird uneinheitlich sein, weil Ihre Mitarbeiter es auch waren. OpenAIs Dokumentation nennt dafür eine Zahl: Wenn sich Menschen nur in 70% der Fälle einig sind, "the model would likely not be able to do better than this" (OpenAI Fine-Tuning Best Practices). Schreiben Sie die Regel auf, einschließlich des Eskalationspfads, und testen Sie sie. Auch Zendesks Design spiegelt das: Auto Assist schlägt Aktionen nur vor, "if they're defined in your procedures", nie aus ähnlichen Tickets.
Tonalität wird zu Beispielen. Wählen Sie 20 bis 50 Antworten Ihrer besten Mitarbeiter zu Ihren wichtigsten Themen: eine kurze Antwort auf „Wo ist meine Bestellung“, eine sorgfältige Abrechnungsantwort, ein freundliches Nein. Beschriften Sie jede mit dem, was sie gut macht („zwei Sätze, keine Entschuldigung, Link zur Sendungsverfolgung“). Das reicht, um Länge und Stimme zu verschieben, und dort steckt der meiste Bearbeitungsaufwand. Die Leitfäden zur KI-Markenstimme und zum Support-Ton erklären, wie Sie die Regeln schreiben, die neben den Beispielen stehen.
OroSoft, das Software für die Edelmetallbranche herstellt, zeigt, wie das in der Praxis aussieht. Sein eesel-Agent auf Freshdesk lernt aus rund 6,100 alten Tickets, jede Nacht neu synchronisiert, soll aber gelöste und geschlossene Tickets bevorzugen, aktuelle gewichten und das Help Center als maßgebliche Quelle für Richtlinien behandeln, bei Widerspruch der neueren Quelle folgend. Passt ein altes Ticket, übernimmt der Entwurf dessen Struktur, Tonalität und Länge, sodass eine kurze Antwort, die schon einmal funktionierte, kurz bleibt. Und er kopiert nie Kundennamen oder Angaben aus alten Tickets.
Tickets nach Wissen zu durchsuchen muss auch nicht ausgefallen sein. Ein Hacker-News-Kommentator beschrieb so, wie er ein Modell auf seine Historie ansetzte:
"read this historical dump of 15k support tickets and break them into categories that make sense, then propose help docs that i could write to handle the most frequent queries in each category"
Das ist der richtige Instinkt: Das Ergebnis sind Hilfedokumente, die ein Mensch schreibt und freigibt, nicht ein Modell, das 15.000 Tickets auswendig gelernt hat.
Schritt 5: Aktuelle Tickets zurückhalten und nachspielen
Das ist der Testfehler, den ich am häufigsten sehe: Teams testen die KI mit denselben Tickets, aus denen sie gelernt hat, bekommen eine großartige Punktzahl und gehen live. Natürlich schnitt sie gut ab. Sie hatte die Antworten gesehen.
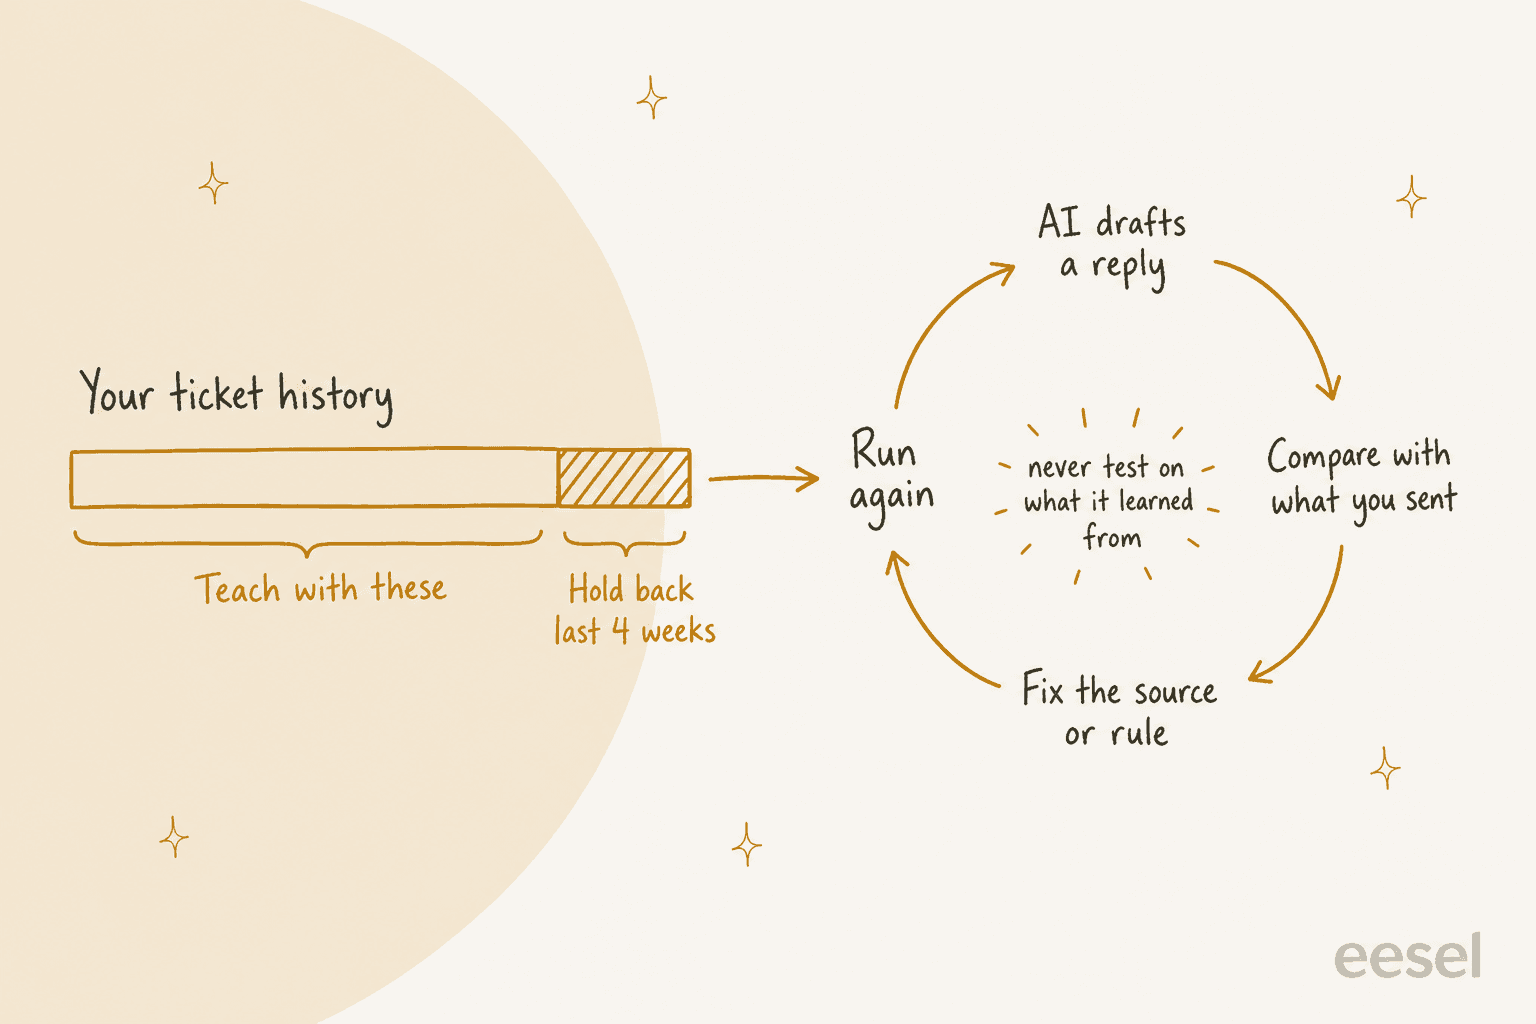
OpenAIs Dokumentation sagt es unverblümt: "Good evals first!", und empfiehlt ein Holdout-Set, das "acts as a control group" (OpenAI Supervised Fine-Tuning). Dasselbe gilt, wenn Sie gar nicht feinabstimmen. Eine einfache Version:
- Halten Sie die jüngsten drei bis vier Wochen gelöster Tickets aus dem Import zurück. Sie sind am repräsentativsten für die heutigen Fragen, und die KI hat sie nicht gesehen.
- Spielen Sie 50 bis 100 davon nach. Lassen Sie die KI auf jede Kundennachricht eine Antwort entwerfen, ohne etwas zu senden.
- Vergleichen Sie jeden Entwurf mit dem, was Ihr Team tatsächlich gesendet hat, und bewerten Sie Korrektheit und Tonalität getrennt. Ein Entwurf kann sachlich richtig sein und trotzdem komplett neu geschrieben werden müssen.
- Führen Sie jeden Fehler auf eine Ursache zurück: ein fehlender Artikel (Wissen korrigieren), eine falsche Entscheidung (Regel korrigieren) oder die falsche Stimme (Beispiele korrigieren). Dann führen Sie es erneut aus.
Die meisten Helpdesks bieten ein Werkzeug für das Nachspielen. Freshdesks E-Mail-Agent lässt Sie mit "Import tickets to use solved historical tickets" ein Testset anlegen, bis zu 50 Abfragen pro Lauf, und empfiehlt vor dem Einsatz mindestens 20 repräsentative Abfragen (Freshdesk E-Mail-KI-Agent einrichten). HubSpots Batch-Test verbraucht keine Credits. eesels Simulation-Skill entwirft eine Antwort auf 20 Tickets, die Ihr Team kürzlich gelöst hat, vergleicht jede mit dem, was Ihr Team gesendet hat, und gruppiert die Ergebnisse nach Themen mit Korrekturen, ohne etwas an Kunden zu senden.
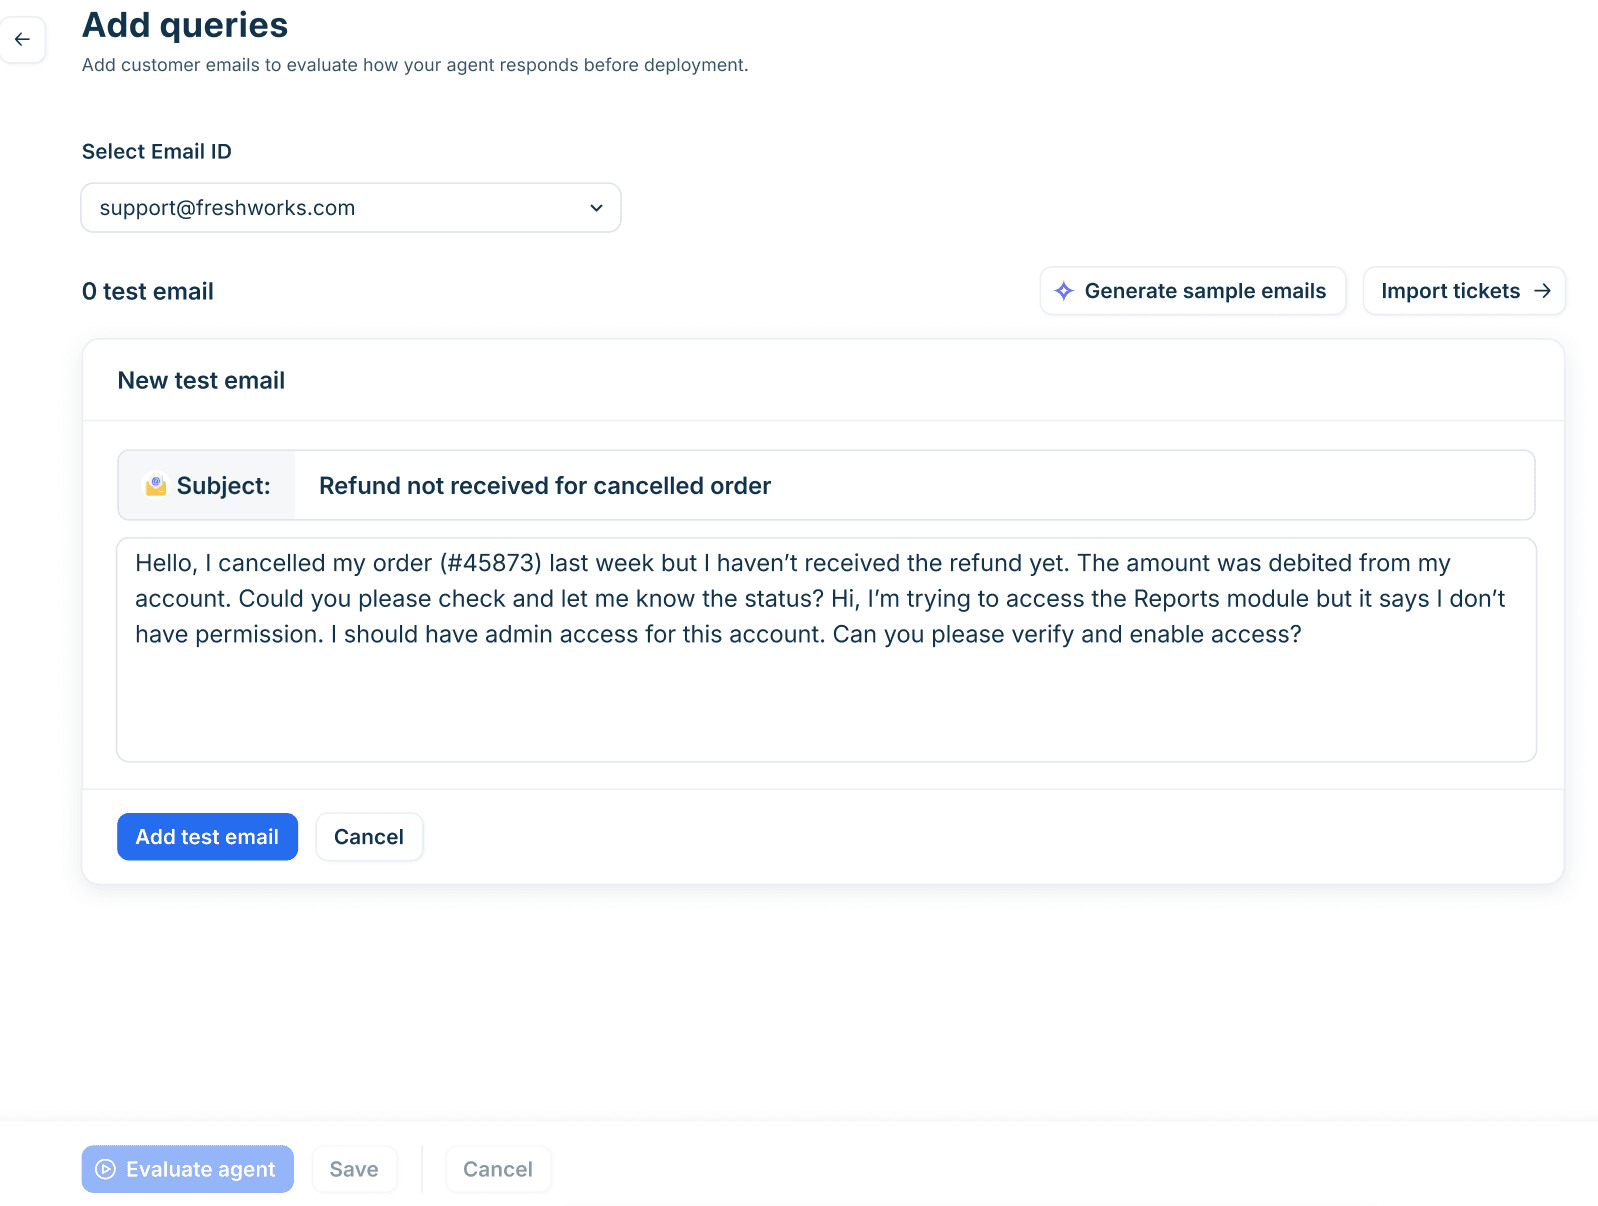
Das Cloud-ERP-Unternehmen Qontro hat diesen Vergleich zur Gewohnheit gemacht statt zur Startschranke. Sein eesel-Agent entwirft bei jedem neuen Freshdesk-Ticket, und das Team vergleicht jeden Entwurf mit der Antwort, die ein Mensch tatsächlich gesendet hat. Wo der Entwurf falsch war, weist das meist auf einen fehlenden Hilfeartikel oder eine Regel hin, die präziser werden muss, und das beheben sie. Etwa jeder zehnte Entwurf geht inzwischen mit wenig oder gar keiner Bearbeitung raus, und der Anteil steigt langsam. Einen vollständigen Testplan finden Sie unter Testen von KI-Support-Agenten und in den Prüfungen unter Testen vor dem Start.
Schritt 6: Das Training aktuell halten
Das Training mit Tickets ist kein einmaliger Import. Ihre Produkte, Richtlinien und Kunden ändern sich, und eine KI, die aus den Tickets des letzten Jahres lernte, veraltet langsam.
- Nach Zeitplan neu synchronisieren. Das dänische Softwareunternehmen Timengo synchronisiert sein Freshdesk Help Center jeden Sonntag neu, crawlt seine Dokumentation jeden Montag neu, holt offene Tickets wöchentlich und die komplette Ticket-Historie monatlich. Die Bots von Norden-Frisia synchronisieren aus Zendesk, sodass eine Änderung an einem Artikel zu Dachträgern oder Behindertenrabatten den Bot ohne neues Training erreicht.
- Tickets ausmustern, wenn sich eine Richtlinie ändert. Wenn Sie die Rückgabefrist aktualisieren, sollten die alten Tickets, die sie nennen, noch am selben Tag den Trainingssatz verlassen.
- Neue Tickets nach Lücken durchsuchen. Die Fragen, die die KI diesen Monat nicht beantworten konnte, sind die Hilfeartikel des nächsten Monats. HubSpot markiert Wissenslücken bei Tickets, die der Agent nicht beantworten konnte, und Gorgias' Opportunities zeigt Themen, die seine KI "has repeatedly handed over to your team" (Gorgias Opportunities). Eine sich selbst aktualisierende Wissensdatenbank ist das Ziel, bei der ein Mensch jede Änderung freigibt.
- Führen Sie vierteljährlich ein Audit des Wissens durch, auf das sich die KI stützt. Ein Audit der KI-Wissensdatenbank findet mehr veraltete Antworten als jede Prompt-Anpassung.
Häufige Fehler beim Training von KI mit alten Tickets
- Alles importieren, „um sicherzugehen“. Mehr Tickets bedeuten mehr alte Richtlinien und mehr uneinheitliche Entscheidungen. Erst kuratieren.
- Der KI sagen, sie solle manche Tickets ignorieren, statt sie zu entfernen. Anweisungen filtern Wissen nicht zuverlässig. Wenn aus einer Queue nicht gelernt werden soll (Testdaten, ein altes Produkt, Tickets eines anderen Teams), schließen Sie sie vom Import aus.
- Entscheidungen aus Beispielen lernen. Erstattungslimits und Eskalationsregeln gehören schriftlich festgehalten, wo Sie sie testen können.
- Personenbezogene Daten vergessen, bis die Rechtsabteilung fragt. Schwärzen Sie die Trainingskopie, bevor etwas indexiert wird.
- Mit Trainingsdaten testen. Halten Sie aktuelle Tickets zurück, sonst schmeichelt Ihnen Ihre Punktzahl.
- Zuerst zum Fine-Tuning greifen. Es ist die langsamste, teuerste Option und behebt das seltenste Problem.
- Den Start für das Ende halten. In der Pilotphase finden Sie die Lücken, die Ihre Historie nicht abdeckte.
Wie eesel aus Ihren alten Tickets lernt
Ich gebe offen zu, dass ich hier voreingenommen bin, aber eesel wurde um genau diesen Ablauf herum gebaut, deshalb lohnt es sich zu zeigen, wie er auf die sechs Schritte passt.
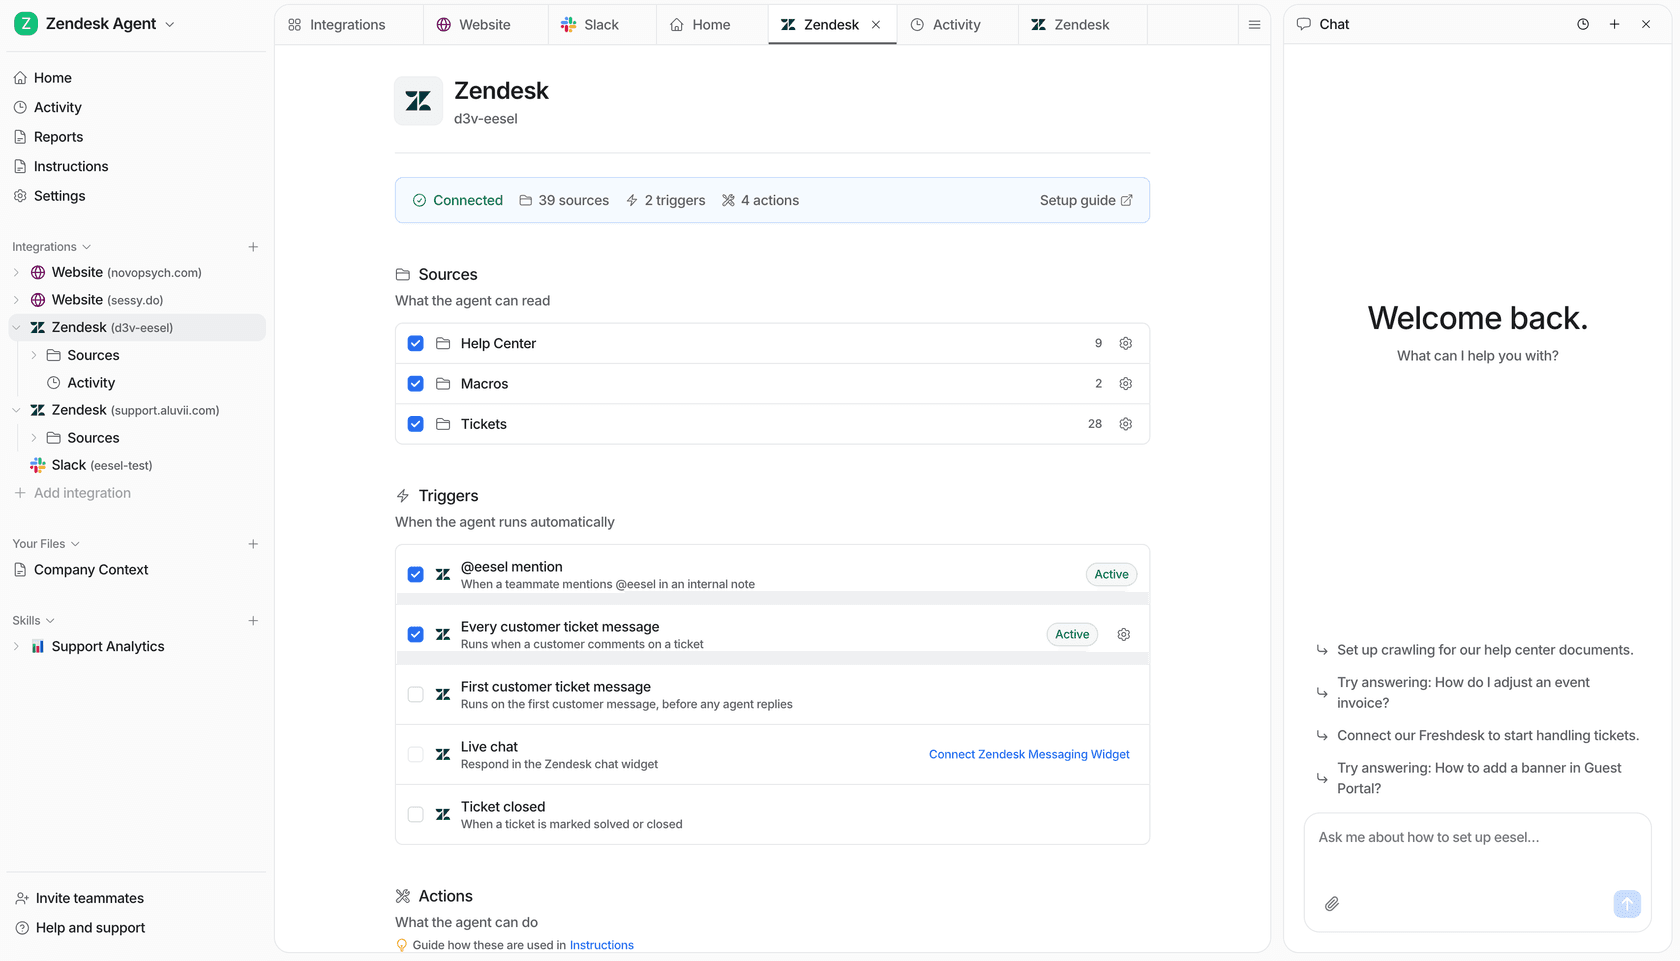
- Import mit Kontrolle. Mit einer vollständigen Verbindung zu Zendesk, Freshdesk oder Gorgias liest eesel Ihr Help Center, Ihre Makros und alten Tickets. Der erste Import ist eine Stichprobe von bis zu 1.000 aktuellen gelösten Tickets, und Sie können nach Status und Datum filtern, um mehr zu importieren (Zendesk-Einrichtungsdokumentation). Wenn aus einer Quelle nicht gelernt werden soll, schalten Sie sie auf der Integrationsseite ab, denn wie die Dokumentation es ausdrückt, hindert die Anweisung, alte Tickets zu ignorieren, sie nicht daran, sie zu finden: "does not stop it finding them; the switch does."
- Personenbezogene Daten vor dem Indexieren maskiert. Alte Tickets laufen durch einen Detektor für 15 Arten personenbezogener Daten, ersetzt durch typisierte Masken wie
[REDACTED:EMAIL], und Tickets, die sich nicht bereinigen lassen, werden übersprungen statt roh gespeichert (Dokumentation zur PII-Schwärzung). - Nachspielen vor dem Livegang. Der Simulation-Skill spielt aktuelle gelöste Tickets nach, bewertet jede Antwort gegen das, was Ihr Team gesendet hat, und schlägt Anweisungsänderungen vor. Auf echten Tickets läuft nichts, bis Sie eine Automatisierung anlegen, und die meisten Teams beginnen mit Entwürfen.
- Korrekturen, die bleiben. Wenn Sie im Chat eine Antwort korrigieren, schreibt eesel die Korrektur in seine eigenen Anweisungen, sodass die Korrektur nächste Woche noch gilt.
- Eine CLI für die Export- und Import-Technik. Wenn Sie das lieber skripten oder von einem Coding-Agenten wie Claude Code oder Cursor erledigen lassen, steuert die eesel CLI denselben Agenten aus einem Terminal, mit JSON-Ausgabe.
eesel integrations sources zendeskzeigt, was die Quellen Help Center, Makros und Tickets enthalten,eesel integrations download start zendeskkopiert sie in eesels Wissen, und miteesel chatbitten Sie ihn, einen bestimmten Datumsbereich zu importieren oder eine Simulation auszuführen. Es ist derselbe Agent wie im Dashboard, alles, was Sie dort einrichten, erscheint in beiden.
Der schwedische Elektrofahrzeug-Händler Nordbutiker ist ein gutes Beispiel für die Idee „kuratieren, nicht kippen“. Er betreibt vier Shops in Schweden, Norwegen, Dänemark und Finnland, und der Bot jedes Shops lernt aus den gelösten Tickets der eigenen Zendesk-Marke, sodass die Antworten widerspiegeln, was die Mitarbeiter dieses Shops tatsächlich gesagt haben. Alles, was die Website und alte Tickets nicht abdecken, etwa Ersatzteile und Garantiefälle, geht an einen Menschen.
KI mit Ihren alten Tickets trainieren mit eesel
Wenn Sie auf jahrelanger Helpdesk-Historie sitzen und eine KI wollen, die wie Ihre besten Mitarbeiter antwortet, ist eesel der kürzeste Weg, den ich kenne. Es stößt zu Zendesk, Freshdesk oder Gorgias wie ein neuer Mitarbeiter, der Ihr Help Center, Ihre Makros und Ihre besten alten Tickets schon gelesen hat, mit maskierten personenbezogenen Daten. Dann spielt es Ihre aktuellen Tickets nach und zeigt Ihnen, wo es danebengelegen hätte, bevor es eine einzige echte Antwort entwirft.
Das überzeugte Norden-Frisia: In der Testwoche verband das Team Zendesk, zog die Makros und die letzten drei Monate an Tickets herein und meldete sich binnen Tagen an. Der kostenlose Tarif enthält 100 Credits ohne Karte, und bezahlte Tarife beginnen bei $299/month für 500 Credits, wobei ein Ticket einen Credit kostet, egal wie viele Antworten hin- und hergehen (eesel-Preise). Probieren Sie eesel mit Ihrer eigenen Ticket-Historie aus und sehen Sie die Entwürfe, bevor Sie etwas bezahlen.