

Das beste KI-Modell für Support-Tickets 2026 ist nach den Zahlen Qwen 3.8 Max, aber das Modell ist nicht die Variable, die entscheidet, ob Ihre Warteschlange funktioniert. Auf τ-bench, dem einzigen öffentlichen Benchmark, bei dem ein KI-Agent Antworten aus einer echten Wissensdatenbank mit 698 Dokumenten abrufen und danach darauf handeln muss, erreicht Qwen 3.8 Max 55,2 % beim ersten Versuch, Claude Opus 5 kommt auf 48,7 %, und Claude Fable 5, das teuerste Modell auf dem Markt, landet mit 39,7 % auf Platz sechs.
Jetzt kommt der Teil, der ändern sollte, was Sie als Nächstes tun. Nehmen Sie ein Modell und halten Sie es konstant. Claude Opus 4.5 erreicht 92,3 % in der Telecom-Domäne, in der die Antwort hinter einem Tool-Aufruf liegt, und 24,7 % in der Banking-Domäne, in der die Antwort in einem Stapel Dokumente liegt. Dasselbe Modell, dieselbe Woche, 68 Punkte Unterschied, allein bestimmt davon, wie das Wissen gespeichert war. Der Abstand zwischen dem besten und dem schlechtesten Modell im aktuellen Feld beträgt 30 Punkte. Der Abstand, der dadurch entsteht, wo Sie Ihre Dokumentation ablegen, beträgt 68.
Auch das Kostenargument steht auf dem Kopf. Claude Opus 5 kostet bei realistischen Token-Mengen etwa 0,11 $ pro Ticket. Zendesk berechnet zusätzlich 1,50 $ pro automatisierter Lösung. Sie feilschen um 7 % der Rechnung.
Also: Wählen Sie ein solides Mittelklasse-Modell, stecken Sie den eingesparten Aufwand in Ihre Wissensdatenbank und Ihre Eskalationsregeln, und testen Sie das Ganze an Ihrer eigenen Ticket-Historie, bevor ein Kunde es sieht. Genau diesen letzten Schritt übernimmt eesel: Es spielt Ihre vergangenen Tickets erneut ab und bewertet die Antworten der KI im Vergleich zu dem, was Ihr Team tatsächlich gesendet hat.
Die Frage, die mir gestellt wird, und die, die tatsächlich entscheidet
Ich baue bei eesel KI-Agenten, und die häufigste Frage technischer Support-Leiter, die KI-Kundenservice-Software evaluieren, ist irgendeine Variante von „Welches Modell sollen wir nehmen?" Das ist eine vernünftige Frage. Meistens ist sie aber auch die falsche erste Frage.
Ich weiß das, weil ich gesehen habe, was passiert, wenn Teams sie beantworten und dann aufhören. Einige unserer eigenen Kunden sind abgewandert, um direkt auf den Frontier-APIs selbst etwas zu bauen. Ehrlich betrachtet stehen auf dieser Liste ein AR- und Bautechnik-Unternehmen und eine DTC-Beauty-Marke, Letztere direkt auf der Claude-API. Das ist keine Kritik an ihnen. Es sind kompetente Engineering-Teams, und die API ist wirklich gut. Aber jedes dieser Teams hat für das Modell optimiert, und das Modell war nie der schwierige Teil.
Der Engineering-Leiter eines Bitcoin-Automaten-Unternehmens in unserem Team-Plan, das eine Confluence-Basis mit 300 Artikeln betreibt, hat die andere Seite klar formuliert:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Zwei Teams, dieselbe Ausgangsfrage, gegensätzliche Schlüsse. Der Unterschied zwischen ihnen ist nicht, welches Modell sie gewählt haben. Es ist, ob sie eine Möglichkeit hatten zu erkennen, ob das Ding funktioniert.
Dieser Beitrag ist mein Versuch, die Modellfrage ordentlich mit echten Zahlen zu beantworten und dann zu zeigen, warum die Antwort weniger wichtig ist als das, was darunter liegt.
Es gibt einen Benchmark genau dafür, und fast niemand zitiert ihn
Jeder Modell-Launch zitiert MMLU, SWE-bench, GPQA oder einen der aggregierten Intelligenzindizes. Keiner davon sagt etwas Nützliches darüber, ob ein Modell ein Support-Ticket abschließen kann, denn ein Support-Ticket abzuschließen ist kein Wissenstest. Es ist eine Abfolge: eine unklare Anfrage verstehen, die relevante Richtlinie finden, die richtigen Tools in der richtigen Reihenfolge aufrufen, Dinge ablehnen, die man nicht tun darf, und die Datenbank im richtigen Zustand hinterlassen. Das ist der Unterschied zwischen einem Sprachmodell und einem funktionierenden KI-Ticketsystem.
Sierra hat dafür einen Benchmark gebaut, und er heißt τ-bench. Das ursprüngliche τ-bench-Paper erschien 2024 mit den Domänen Retail und Airline. τ²-bench fügte 2025 eine Telecom-Domäne hinzu, und sein wichtigster Beitrag war, dass auch der Nutzer handelt, sodass der Agent einen Kunden durch Schritte führen muss, die nur der Kunde ausführen kann. So sieht technischer Support in der Realität aus. Das Ergebnis des Papers ist deutlich: Die Leistung sinkt erheblich, sobald der Agent einen Nutzer anleiten muss, statt nur für ihn zu handeln.
2026 kam dann die Version, die für Support-Teams am wichtigsten ist. τ³-bench führte τ-Knowledge ein, eine Banking-Domäne, in der der Agent mit einer Wissensdatenbank statt einer aufgeräumten Tool-Liste arbeiten muss.
So sieht diese Wissensdatenbank aus, laut Sierras eigenem Bericht: 698 Dokumente in 21 Produktkategorien, etwa 195.000 Tokens. Jede Aufgabe braucht im Schnitt 18,6 Dokumente und 9,5 Tool-Aufrufe, manche bis zu 33. Bewertet wird, ob der Agent den korrekten finalen Datenbankzustand erzeugt hat, nicht, ob die Antwort schön klang.
Wenn Sie sich je gefragt haben, warum sich Ihr Hilfecenter gegen die KI zu sperren scheint: Das ist die Benchmark-Version Ihres Hilfecenters. Es ist auch der Grund, warum Deflection-Leitfäden mehr Zeit mit Inhalten verbringen als mit Modelleinstellungen.
Die Retrieval-Klippe
Dieses Diagramm würde ich jedem an die Wand hängen, der KI für Ticketsysteme evaluiert.
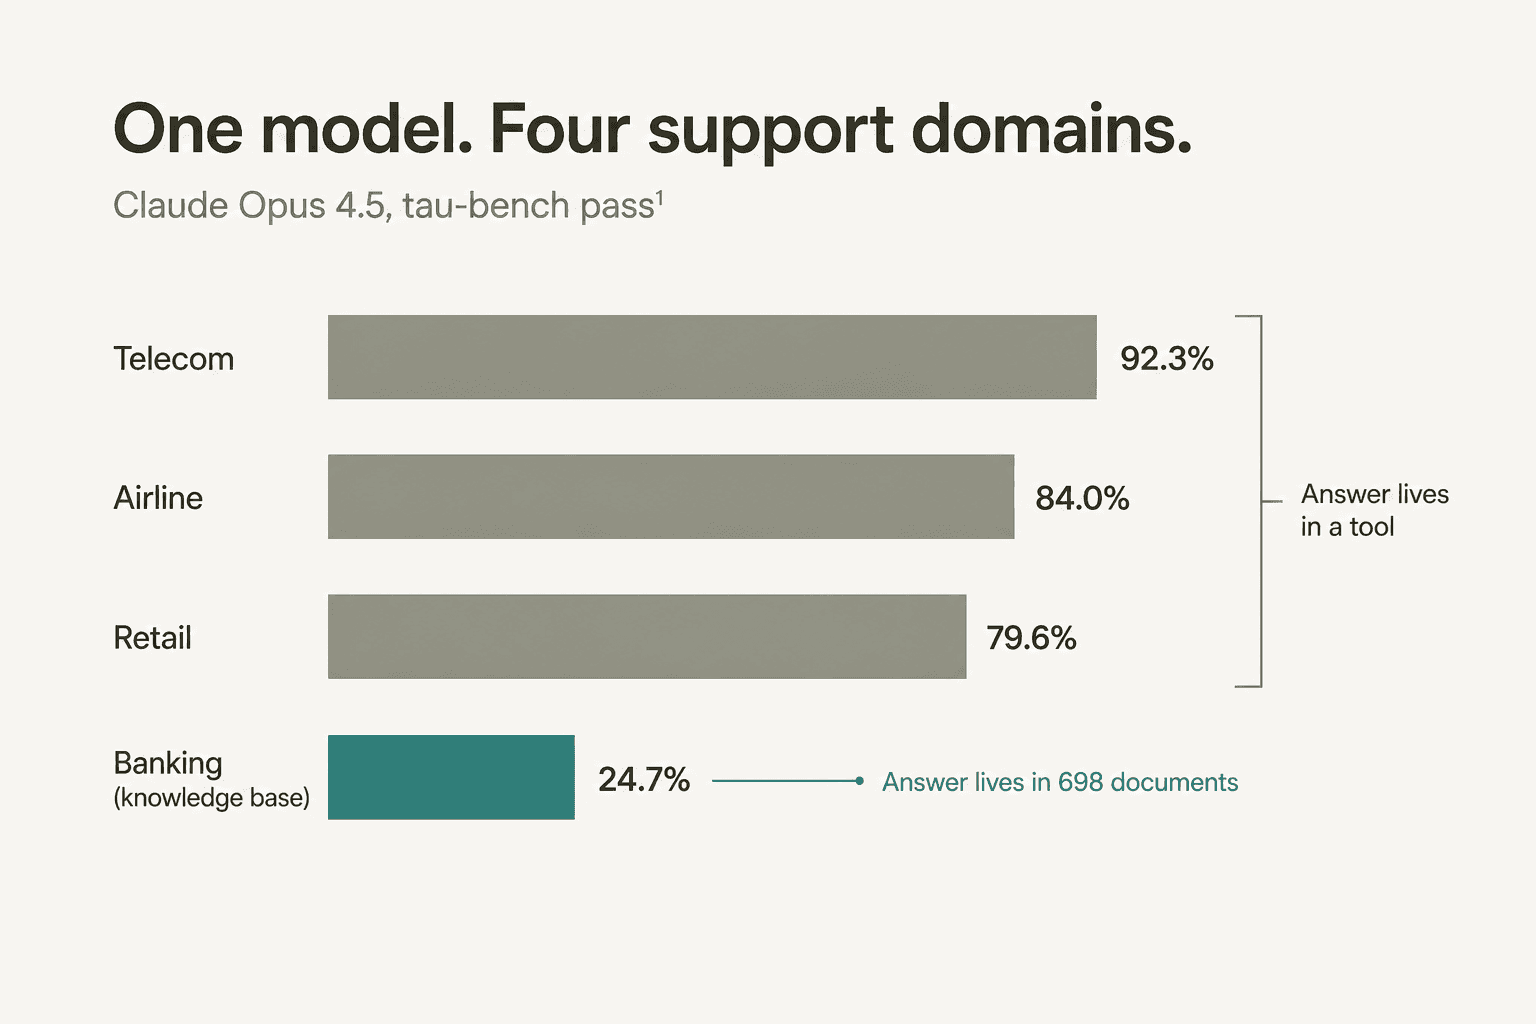
Ein Modell. Ein Evaluierungslauf. Vier Domänen. Telecom 92,3 %, Airline 84,0 %, Retail 79,6 %, Banking 24,7 %.
Die ersten drei Domänen geben dem Agenten einen sauberen Satz Tools, und die Antwort ist durch deren Aufruf erreichbar. Die vierte zwingt den Agenten, die Antwort zuerst in Dokumenten zu finden. Diese eine Änderung kostet 68 Punkte, mehr als die gesamte Spanne zwischen dem besten und dem schlechtesten Frontier-Modell im selben Test.
Qwen3.5-397B zeigt dasselbe Muster noch drastischer: 97,81 % bei Telecom gegenüber 9,79 % bei Banking. Ein Einbruch um 88 Punkte bei denselben Gewichten.
Ich möchte vorsichtig sein, was das beweist und was nicht. Es ist ein einzelner Benchmark, und ein synthetischer. Aber der Mechanismus, den er offenlegt, ist genau der Mechanismus, den ich in der Produktion sehe. Wenn mir ein Kunde sagt, sein KI-Wissensdatenbank-Chatbot sei „nicht intelligent genug", dann ist in etwa neun von zehn Fällen das Modell in Ordnung und das Retrieval liefert die falschen drei Absätze.
Die Rangliste 2026 für Support-Tickets
Sierra hat am 04.08.2026 eine neue Charge ausgeführt, die den Großteil der aktuellen Frontier abdeckt. Alle diese Einträge nutzten dieselbe Retrieval-Konfiguration, denselben GPT-5.2-Nutzersimulator, dieselbe Benchmark-Version und vier Durchläufe, sodass sie sich sauber miteinander vergleichen lassen.
| Modell | Anbieter | Richtig im 1. Versuch | Richtig 4 von 4 | Effort-Einstellung |
|---|---|---|---|---|
| Qwen 3.8 Max | Qwen | 55,2 % | 35,1 % | xhigh |
| Claude Opus 5 | Anthropic | 48,7 % | 32,0 % | max |
| Grok 4.5 | xAI | 47,9 % | 32,0 % | high |
| GPT-5.6 Sol | OpenAI | 46,9 % | 27,8 % | xhigh |
| Meta Muse Spark 1.1 | Meta | 40,5 % | 20,6 % | xhigh |
| Claude Fable 5 | Anthropic | 39,7 % | 28,9 % | max |
| Claude Opus 4.8 | Anthropic | 39,7 % | 22,7 % | max |
| GLM-5.2 | Z.ai | 37,1 % | 13,4 % | xhigh |
| Kimi K3 | Moonshot AI | 37,1 % | 17,5 % | max |
| Inkling | Thinking Machines Lab | 25,0 % | 11,3 % | max |
An dieser Tabelle fallen einige Dinge auf.
Das teuerste Modell ist nicht das beste. Claude Fable 5 kostet 10 $ pro Million Input-Tokens und 50 $ pro Million Output-Tokens. Qwen 3.8 Max kostet 2 $ und 6 $. Das günstigere Modell erreicht bei der Support-Aufgabe 15,5 Punkte mehr. Wenn Sie angenommen haben, dass der Frontier-Preis auch Frontier-Support-Leistung kauft, tut er das nicht.
Die Abstände zwischen den ersten vier sind klein. Von Qwen 3.8 Max zu GPT-5.6 Sol sind es 8,3 Punkte, und von Opus 5 zu Grok 4.5 weniger als ein Punkt. Das sind keine verschiedenen Klassen von Werkzeugen. Es sind Nachbarn.
Der Fortschritt ist real, aber langsam. Claude Opus 4.5 erreichte in dieser Domäne im Februar 24,7 %. Opus 5 verdoppelte das bis August auf 48,7 %. Echter Fortschritt über zwei Generationen. Es bedeutet trotzdem, dass das Modell öfter falsch als richtig liegt, und das ist ein ganz anderer Ausgangspunkt als das, was ein Chatbot-Anbietervergleich meist impliziert.
Zwei naheliegende Modelle fehlen. Weder Gemini 3.7 Flash noch DeepSeek V4 Flash hat eine Einreichung in dieser Domäne, daher kann ich sie hier nicht ehrlich einordnen. Ältere Gemini-Einträge nutzten ein anderes Retrieval-Setup, was sie nicht vergleichbar macht, statt sie einfach schlechter dastehen zu lassen.
Ein methodischer Hinweis, den man sich merken sollte: Die älteren Einträge der Rangliste nutzten andere Retrieval-Konfigurationen, daher sind Vergleiche zwischen Chargen wackeliger, als sie aussehen. Sierra hat außerdem die Banking-Domäne im Juli 2026 neu bewertet und sagt, dass Ergebnisse vor dieser Korrektur nicht vergleichbar sind. Wer einen Banking-Wert aus der ersten Jahreshälfte zitiert, zitiert wahrscheinlich einen veralteten.
Einmal richtig ist nicht jedes Mal richtig
Die Spalte, die die meisten überspringen, ist die, die ich zuerst ansehen würde.
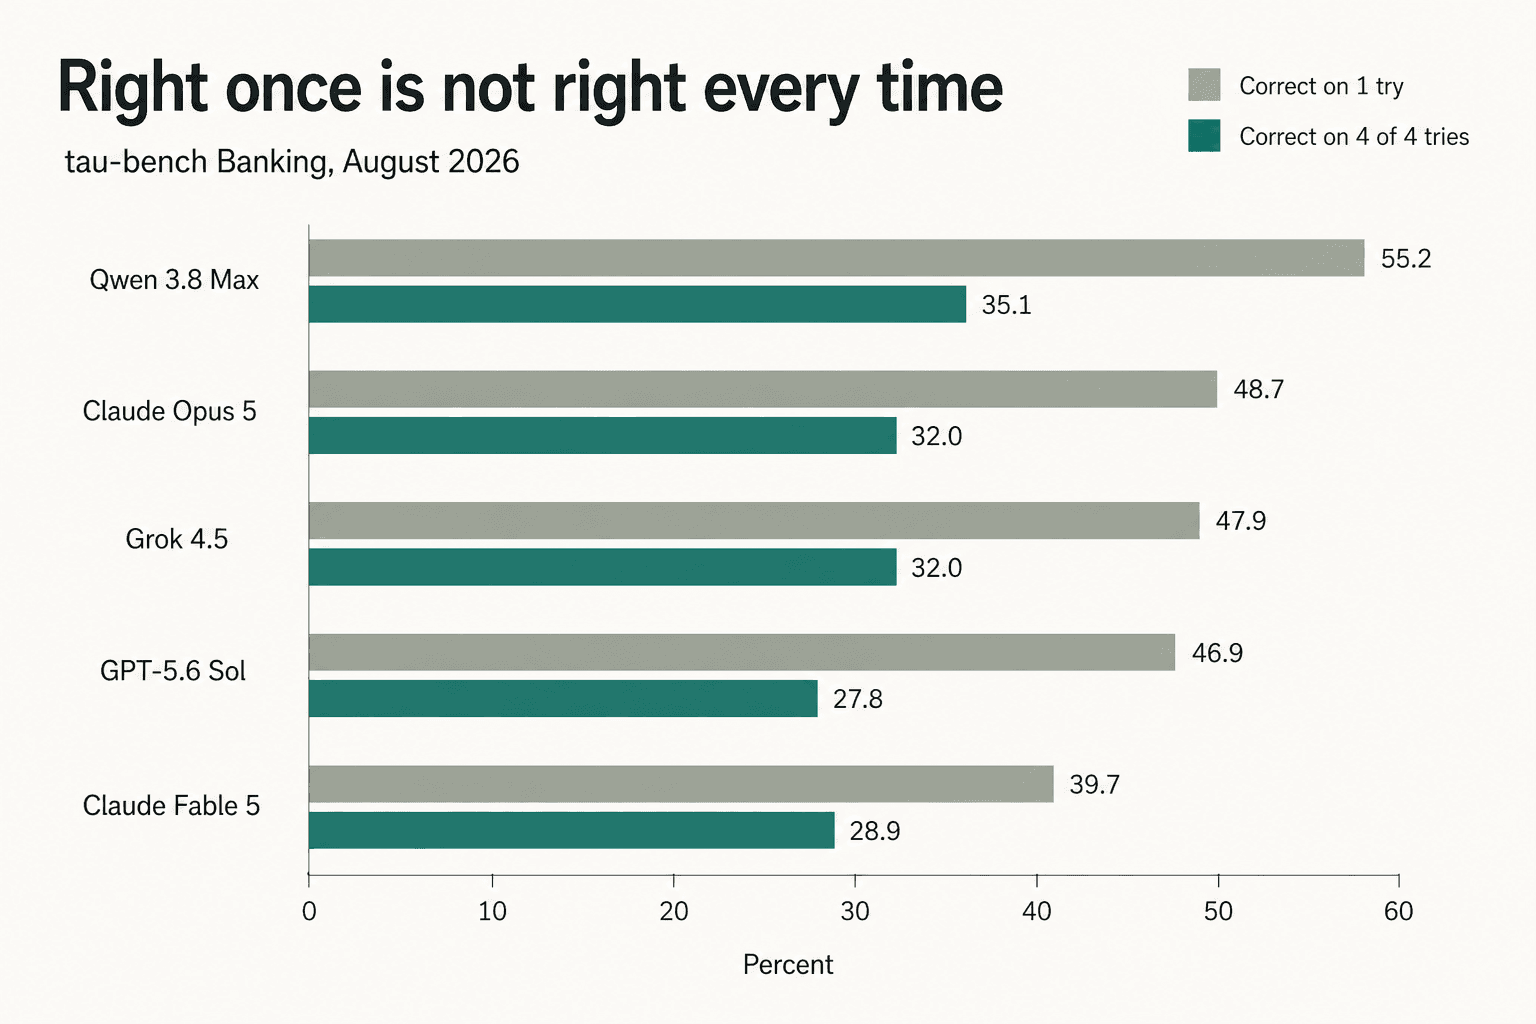
τ-bench berichtet pass^k, das fragt, ob ein Modell dieselbe Aufgabe bei jedem von k unabhängigen Versuchen richtig gelöst hat. Pass^1 heißt „es kann das". Pass^4 heißt „es macht das zuverlässig".
Das beste Modell im Feld ist bei 35,1 % dieser Aufgaben zuverlässig korrekt. Opus 5 fällt von 48,7 % auf 32,0 %. GPT-5.6 Sol fällt von 46,9 % auf 27,8 %. GLM-5.2 stürzt regelrecht ab, von 37,1 % auf 13,4 %, was zeigt, dass es gut rät, statt konsistent zu schlussfolgern.
Diese Spanne zwischen pass^1 und pass^4 ist die Zahl, die entscheidet, ob Sie eine KI mit einer Warteschlange allein lassen können. Ein Modell mit 48,7 % pass^1 und 32,0 % pass^4 ist kein Modell, das die Hälfte Ihrer Tickets löst. Es ist ein Modell, das denselben Tickettyp je nach Tag unterschiedlich behandelt.
Eine CX-Leiterin einer DTC-Supplement-Marke mit rund 7.000 Gorgias-Tickets im Monat hat mir die operative Version davon besser gesagt als jeder Benchmark:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist pass^k als Geschäftsanforderung formuliert. Varianz ist kein Qualitätsproblem, das man mit einem besseren Modell löst, sondern ein Routing-Problem, das man mit konfidenzbasierter Eskalation löst. Jeder ernsthafte Support-Einsatz, an dem ich beteiligt war, landet hier, und deshalb ist ein Copilot-Setup oft die sicherere erste Phase gegenüber voller Autonomie.
Die drei Arten, wie Modelle bei einem echten Ticket tatsächlich scheitern
Sierra hat die Fehlertaxonomie zusammen mit dem Benchmark veröffentlicht, und sie zu lesen fühlte sich unangenehm vertraut an. Das sind keine exotischen KI-Fehler. Es sind genau die drei Dinge, über die sich Support-Manager beschweren.
Es übersieht die Richtlinie, die von einer anderen Richtlinie abhängt. Im Beispiel des Benchmarks möchte ein Kunde eine Transaktion anfechten und eine Erhöhung seines Kreditlimits beantragen. Der Agent sucht die Anfechtungsrichtlinie, findet sie und reicht die Anfechtung zuerst ein, weil der Kunde sie in dieser Reihenfolge genannt hat. Die Kreditlimit-Richtlinie sucht er nie, und sie besagt, dass Limiterhöhungen automatisch abgelehnt werden, solange eine Anfechtung offen ist. Der Kunde erhält eine Ablehnung, die ein menschlicher Agent vermieden hätte, indem er die beiden Schritte in der anderen Reihenfolge ausgeführt hätte.
Es meldet Erfolg für etwas, das fehlgeschlagen ist. Viele Tools des Benchmarks müssen vor der Nutzung freigeschaltet werden. Wenn der Agent diesen Schritt überspringt und einen Fehler zurückbekommt, halluzinieren laut Sierras Bericht manche Agenten eine Erfolgsmeldung an den Nutzer. Das ist die Fehlerart, die Sie einen Kunden kostet statt nur ein Ticket. Ein dänisches B2B-Fahrzeugtelematik-Team auf Zendesk mit etwa 200 Tickets im Monat, auf dem Weg zu 2.000, erlebte die Verbraucherversion davon, als ihr Bot Unterstützung für Automarken bestätigte, die nicht in der Datenbank standen, weil die Wissensdatenbank „wir unterstützen alle Modelle" sagte.
Es glaubt dem Kunden. Wenn der simulierte Nutzer behauptet, seine Anfechtung sei genehmigt worden, schreiben Agenten häufig die Gutschrift gut, ohne den tatsächlichen Status zu prüfen. Jedes Support-Team kennt eine Version davon. Ein eCommerce-Support-Manager sagte es in unserem eigenen Dashboard-Chat unmissverständlich:
"stop promising customer things we cant do. we cannot guarantee this customer's order to them by friday"
Keines dieser drei Probleme wird durch ein größeres Modell gelöst. Sie werden gelöst, indem man begrenzt, was der Agent anfassen darf. Es gibt einen Kommentar auf Hacker News, der das besser formuliert als die meiste Anbieter-Dokumentation:
"Give your LLM the same level of permissions that you would give a human you just hired in the same role. The examples given, tricking the customer support LLM into sending text messages to all users, or into transferring money, are not things that you would ever give a human customer support agent the tools to do."

Das ist die gesamte Sicherheits- und Zuverlässigkeitshaltung in zwei Sätzen, und sie zu übernehmen kostet nichts. So wird auch die meiste dauerhafte Kundenservice-Automatisierung gebaut, eine enge Berechtigung nach der anderen.
Was jedes Modell pro Ticket tatsächlich kostet
Lassen Sie mich echte Zahlen nennen, denn „kommt auf Ihre Nutzung an" ist keine Antwort.
Ein mit Retrieval beantwortetes Support-Ticket hat eine ziemlich vorhersehbare Form. Rechnen wir mit 15.000 Input-Tokens (System-Prompt, Richtlinie, die abgerufenen Wissensdatenbank-Abschnitte, Gesprächsverlauf) und 1.500 Output-Tokens (die Antwort plus Reasoning-Tokens, die bei allen großen Anbietern zum Output-Preis berechnet werden). Ihre Zahlen werden abweichen, aber die Verhältnisse zwischen den Modellen nicht.
| Modell | Input / Output pro 1 Mio. | Kosten pro 1.000 Tickets | Pro Ticket |
|---|---|---|---|
| Claude Fable 5 | $10.00 / $50.00 | $225.00 | $0.225 |
| GPT-5.6 Sol | $5.00 / $30.00 | $120.00 | $0.120 |
| Claude Opus 5 | $5.00 / $25.00 | $112.50 | $0.113 |
| Kimi K3 | $3.00 / $15.00 | $67.50 | $0.068 |
| GPT-5.6 Terra | $2.00 / $12.00 | $48.00 | $0.048 |
| Claude Sonnet 5 | $2.00 / $10.00 | $45.00 | $0.045 |
| Qwen 3.8 Max | $2.00 / $6.00 | $39.00 | $0.039 |
| Claude Haiku 4.5 | $1.00 / $5.00 | $22.50 | $0.023 |
| Gemini 3.7 Flash | $0.75 / $3.75 | $16.88 | $0.017 |
| GPT-5.6 Luna | $0.20 / $1.20 | $4.80 | $0.005 |
| DeepSeek V4 Flash | $0.22 / $0.66 | $4.29 | $0.004 |
Die Preise stammen von der jeweiligen Preisseite des Anbieters. Die Werte von Anthropic und Qwen sind im Abschnitt oben verlinkt; die übrigen finden sich in OpenAIs Preisliste und der von Google, die von DeepSeek weiter unten verlinkt.
In dieser Tabelle stecken vier Fallen.
Gemini-Preise sind Aktionspreise. Googles 0,75 $ und 3,75 $ gelten bis zum 31. Dezember 2026 und verdoppeln sich dann am 1. Januar auf 1,50 $ und 7,50 $. Wenn Sie heute ein Kostenmodell auf Gemini 3.7 Flash aufbauen, bauen Sie es auf dem Preis des nächsten Jahres auf.
DeepSeek berechnet jetzt nach Tageszeit. DeepSeeks Preisliste nennt Spitzenzeiten von 01:00 bis 04:00 und 06:00 bis 10:00 UTC zu exakt dem doppelten Preis der Nebenzeit, sodass aus den oben genannten 0,22 $ und 0,66 $ in diesen Fenstern 0,44 $ und 1,32 $ werden. Diese Zeiten folgen den chinesischen Geschäftszeiten, die für eine US- oder europäische Support-Warteschlange meist außerhalb der Hauptlastzeit liegen. Das ist eine echte Eigenheit zu Ihren Gunsten, aber auch eine brüchige.
Die 2 $ und 10 $ von Sonnet 5 sind ein Einführungspreis. Anthropics veröffentlichter Preis kehrt am 31. August 2026 auf 3 $ und 15 $ zurück. Das sind zwei Wochen ab dem Zeitpunkt dieses Schreibens.
Datenresidenz bringt einen Aufschlag mit sich. Anthropic wendet einen Faktor von 1,1 an, wenn Sie die Inferenz auf die USA beschränken, und OpenAI berechnet 10 % Aufschlag auf regionale Verarbeitungs-Endpunkte für Modelle, die nach dem 5. März 2026 erschienen sind. Wenn Sie personenbezogene Kundendaten unter einer Residenzanforderung verarbeiten, rechnen Sie das ein.
Probieren Sie die Zahlen mit Ihrem eigenen Volumen aus
Das Modell macht etwa 7 % Ihrer Rechnung aus
Lassen Sie diesen Rechner mit einem realistischen Plattform-Zähler laufen, und die Form der Antwort ändert sich nicht mehr.
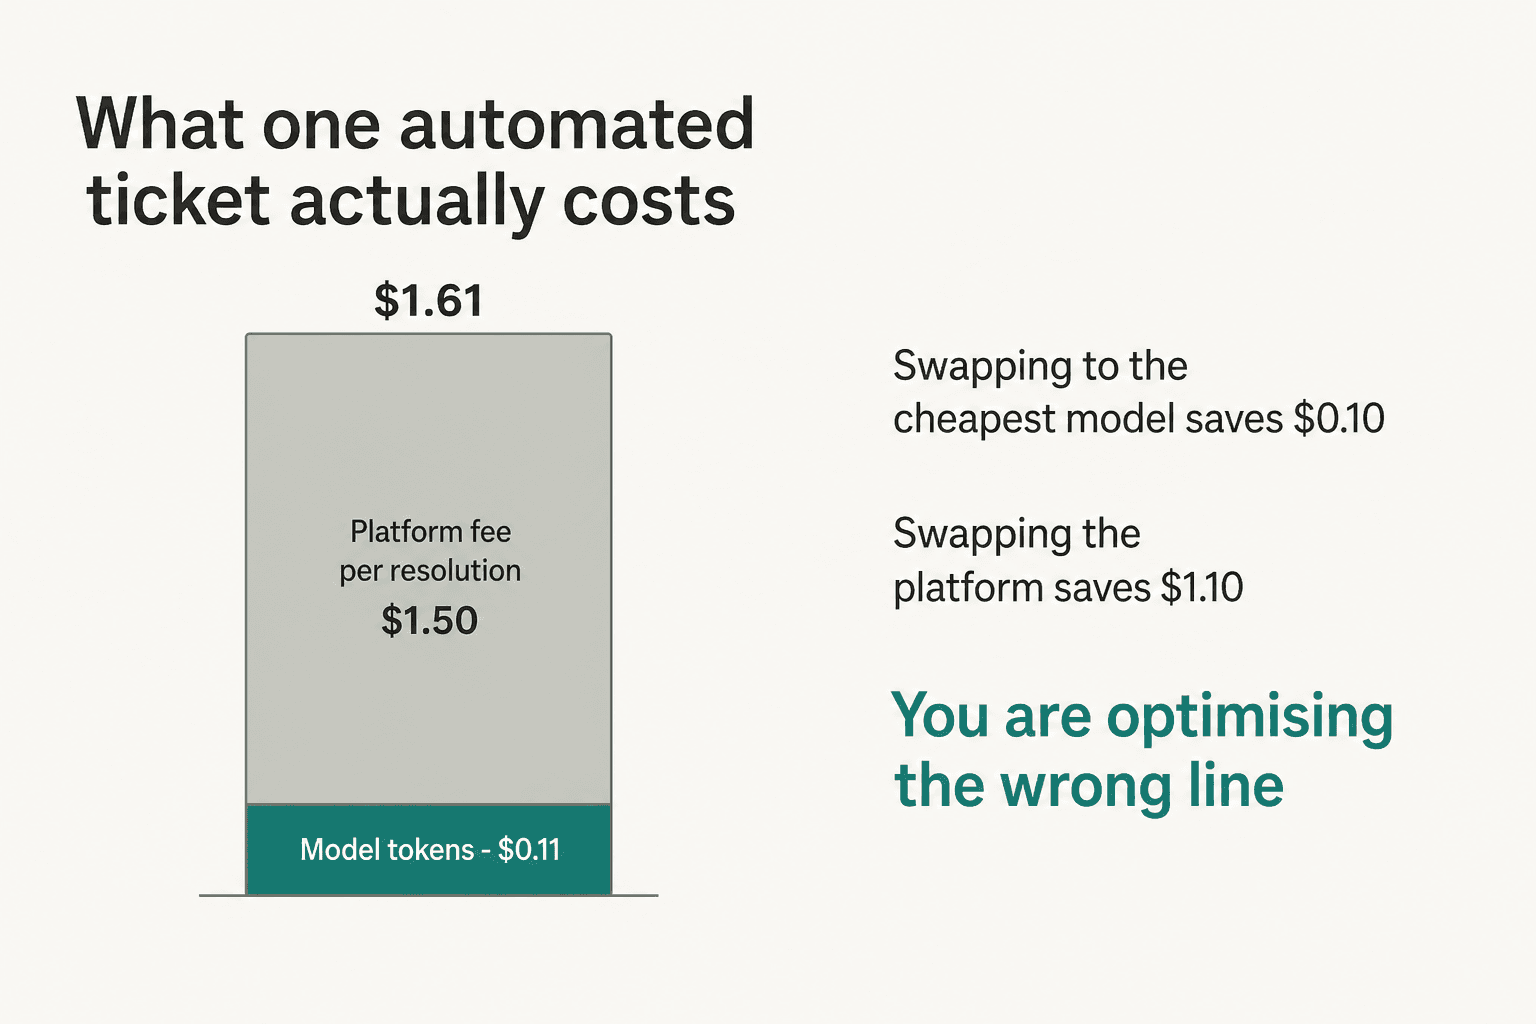
Zendesk veröffentlicht 1,50 $ pro automatisierter Lösung bei Commitment und 2,00 $ bei Pay-as-you-go, versteckt in der Plan-Vergleichstabelle statt auf den Plan-Karten. Gorgias berechnet je nach Plan 0,85 $ bis 1,00 $ pro automatisierter Interaktion. Freshdesk berechnet 0,49 $ pro Session über die enthaltenen 500 hinaus. Help Scout kostet 0,75 $ pro Lösung, mit der fairsten Regel der Kategorie: eine Lösung pro Konversation, egal wie viele Fragen die KI darin beantwortet.
Setzen Sie Claude Opus 5 hinter Zendesks Commitment-Preis, und Ihre Kosten pro Ticket betragen 1,61 $, von denen die eigentliche Intelligenz 0,11 $ ausmacht. Der Wechsel zum günstigsten Modell auf dem Markt spart Ihnen sechs Cent und kostet Sie neun Benchmark-Punkte. Das ist der schlechteste Tausch in diesem gesamten Beitrag.
Auch die Abrechnungseinheit ist wichtiger als der Preis. Ein Session-Zähler berechnet erneut, wenn ein gelöstes Ticket am nächsten Tag wieder aufgeht. Ein Interaktions-Zähler berechnet auch dann, wenn die KI an einen Menschen übergibt. Ist Ihre Wiedereröffnungsquote hoch, kosten diese beiden Details mehr als jede Modellentscheidung. Unsere Aufschlüsselung zur KI-Lösungsquote erklärt, wie sich die Definitionen zwischen Anbietern unterscheiden. Für den Vergleich mit einer Personalbasis siehe KI- versus menschliche Agentenkosten.
Welches Modell sollten Sie also tatsächlich wählen
Hier ist meine ehrliche Einschätzung, mit Begründung statt einem Achselzucken über Ihre spezifischen Bedürfnisse.
Wenn Sie die besten Support-Werte wollen und Datenresidenz kein Hindernis ist: Qwen 3.8 Max. Es führt die Knowledge-Domäne mit 55,2 % an und kostet 2 $ und 6 $, weniger als die Hälfte von Opus 5s Output-Preis. Der Haken ist real, und Sie sollten ihn ernsthaft abwägen: Es wird über Alibaba Cloud bereitgestellt, was für die meisten westlichen Support-Teams, die personenbezogene Kundendaten verarbeiten, zuerst ein Compliance-Gespräch ist und erst dann ein technisches. Prüfen Sie Ihre AVV-Pflichten, bevor Sie den Benchmark prüfen.
Wenn Sie einen im Westen gehosteten Standard brauchen: Claude Opus 5 oder GPT-5.6 Sol. Sie liegen im Benchmark innerhalb von zwei Punkten und bei den Kosten innerhalb von acht Cent pro tausend Tickets. Opus 5 hat eine etwas bessere Vier-von-vier-Zuverlässigkeit, 32,0 % gegenüber 27,8 %, was zählt, wenn Sie unbeaufsichtigt automatisieren. Beide sind gut dokumentiert und haben echte Enterprise-Verträge im Rücken.
Wenn Sie hohes Volumen mit einer sauberen, kleinen Wissensdatenbank betreiben: Gemini 3.7 Flash oder Claude Haiku 4.5. Für keines von beiden gibt es eine τ-bench-Banking-Einreichung, daher kann ich sie nicht ehrlich gegen das Feld einordnen. Was ich sagen kann: Die Retrieval-Klippe wirkt in beide Richtungen. Wenn Ihre Wissensdatenbank aus 40 gut geschriebenen Artikeln statt 698 chaotischen Dokumenten besteht, ähnelt die Aufgabe viel stärker der Telecom-Domäne, in der fast alles über 80 % erreicht. Prüfen Sie den Aktionspreis auf der Gemini-Seite sorgfältig.
Wenn Sie kostenbeschränkt sind und Varianz akzeptieren können: DeepSeek V4 Flash. Es ist mit Abstand die günstigste glaubwürdige Option, und die Nebenzeiten passen tatsächlich gut zu westlichen Geschäftszeiten. Zwei Vorbehalte. Die Bedingungen der bezahlten API schweigen zur Nutzung für Training, statt ausdrücklich zu schützen, und es gibt keine veröffentlichte Zero-Retention-Option, daher ist es kein Drop-in für Kundendaten. Und Artificial Analysis hat eine hohe Halluzinationsrate gemessen, genau die falsche Fehlerart für eine kundensichtbare Antwort.
Verzichten Sie bei dieser Aufgabe auf Claude Fable 5. Es ist ein hervorragendes Modell und das teuerste hier, mit 10 $ und 50 $. Im Support-Benchmark liegt es auf Platz sechs, hinter Opus 5 und GPT-5.6 Sol, die beide halb so viel oder weniger kosten. Nach den Daten gibt es keine Lesart, in der es die richtige Wahl für eine Ticket-Warteschlange ist. Dasselbe gilt für Kimi K3: Mit 3 $ und 15 $ kostet es mehr als Qwen 3.8 Max und erreicht 18 Punkte weniger.
Eines noch, das ich deutlich benennen möchte: Die Halluzinationsraten sind in dieser Generation in die falsche Richtung gegangen. Artificial Analysis hat gemessen, dass die Rate von Claude Opus 5 um 14 Punkte auf 50 % gestiegen ist und Gemini 3.7 Flash auf 64,5 % zurückgefallen ist, nach 55,6 % bei Gemini 3.6 Flash, obwohl die Genauigkeit stieg. Die Modelle wurden klüger und zugleich selbstsicherer falsch. Für KI im Kundenservice ist dieser Tausch schlecht, anders als bei einem Coding-Assistenten, denn eine falsche Antwort geht direkt an einen Kunden.
Was Sie beheben sollten, bevor Sie das Modell-Dropdown anfassen
Wenn die Retrieval-Klippe real ist, und ich halte die Belege für stark, dann liegt der Hebel hier.
Beheben Sie zuerst die Wissensdatenbank. Das ist die Änderung mit dem höchsten Ertrag. In der τ-bench-Diskussion auf Hacker News gibt es eine Demonstration dieses Prinzips, die mir im Gedächtnis geblieben ist: Jemand schrieb die Richtliniendokumente des Benchmarks in klare Entscheidungsbäume und nummerierte Schritte um, ohne das Modell oder die Aufgaben anzufassen, und steigerte GPT-5-mini um 22 %. Die eigene Erklärung des Autors, warum, ist die schärfste Zeile im Thread:
"If a model only performs well once the rules are clarified, that's still revealing something important about its agency: it's brittle when policies are ambiguous, but much stronger when they're structured."
Zweiundzwanzig Punkte durch das Umschreiben von Dokumentation. Kein Modell-Upgrade kommt dem nahe. Unsere Leitfäden zu KI für Wissensmanagement und den besten Wissensdatenbank-Tools behandeln die praktische Seite.
Begrenzen Sie die Tools, wie Sie es bei einem neuen Mitarbeiter tun würden. Zurück zum Thema Berechtigungen. Wenn die KI keine Erstattungen über einem Schwellenwert ausstellen kann, kann man sie nicht dazu überreden. Das ist günstiger und zuverlässiger, als ihr per Prompt zu verbieten, und es unterscheidet ein echtes KI-Teammitglied von einem Chatbot mit API-Schlüsseln. Funktionierende Agenten-Beispiele haben eher schmale Tool-Listen als clevere Prompts.
Routen Sie nach Konfidenz, nicht nach Tickettyp. Pass^k sagt, dass dasselbe Modell dasselbe Ticket über Läufe hinweg unterschiedlich behandelt. Die Antwort ist nicht ein besseres Modell, sondern die KI ablehnen zu lassen. Richten Sie Übergabe-Regeln ein, die „Ich bin nicht sicher" als gültiges, häufiges Ergebnis behandeln statt als Fehler. Hier zahlt sich auch Agenten-Coaching aus, weil die abgelehnten Tickets zeigen, was Sie als Nächstes schreiben sollten.
Messen Sie in der Produktion die richtigen Dinge. Ein Hacker-News-Kommentator beschrieb, wie ein Anbieter τ-bench Airline über einen gleitenden 32-Tage-Durchschnitt verfolgte, zusammen mit der Fehlerrate bei Tool-Aufrufen und der Fehlerrate bei strukturierten Ausgaben. Das ist ein besseres Dashboard als die Lösungsquote allein, weil es „das Modell hat es falsch gemacht" von „das Modell hat das falsche Tool aufgerufen" trennt. Unser Beitrag zu Kundenservice-Kennzahlen zeigt, womit Sie diese kombinieren sollten.
Testen Sie vor dem Go-live an Ihrer eigenen Historie. Jeder Benchmark in diesem Beitrag ist die Warteschlange von jemand anderem. Ihre hat andere Produkte, andere Sonderfälle und einen anderen Ton. Der einzige Test, der Ihnen sagt, ob ein Modell für Sie funktioniert, ist ein Replay Ihrer eigenen gelösten Tickets.
Dieser letzte Punkt ist nicht optional, und es ist der Schritt, den Teams, die auf der Roh-API bauen, am häufigsten überspringen. Es ist auch der Grund, warum ein Benchmark-Ranking Ihre Shortlist informieren und niemals entscheiden sollte.
eesel für Ihre Ticket-Warteschlange testen
Alles oben führt zum selben Schluss: Das Modell ist eine Komponente, und was entscheidet, ob Ihre Support-Automatisierung funktioniert, ist das Gerüst darum. Dieses Gerüst ist eesel.
Der Teil, auf den ich angesichts der Argumentation dieses Beitrags besonders hinweisen würde, ist die Simulation. Sie können eesel bitten, eine Simulation über Ihre jüngsten Tickets zu laufen, und es spielt Hunderte Ihrer vergangenen Tickets erneut ab, bewertet die Antworten der KI im Vergleich zu dem, was Ihr Team tatsächlich gesendet hat, und liefert dann die Lücken und vorgeschlagene Änderungen an den Anweisungen zurück. Es ist das pass^k-Problem, bearbeitet mit Ihren eigenen Daten statt denen eines Benchmarks. Es prognostiziert Ihnen keine Lösungsquote, und ich wäre skeptisch gegenüber jedem Anbieter, der das behauptet.

Es verbindet sich mit Zendesk, Gorgias, Freshdesk, Front, Help Scout, HubSpot, Salesforce und Jira Service Management. Der Preis ist ein fester Monatspreis ab 299 $/Monat für 500 Credits (1 Credit pro Ticket oder Chat), ohne Gebühr pro Platz. Es gibt einen kostenlosen Plan mit 100 Credits ohne Kreditkarte, was für die meisten Teams genug echte Tickets zum Testen sind.
Wenn Sie die letzte Woche Modellnamen in einer Tabelle verglichen haben, ist das die Abkürzung: Wählen Sie eines der ersten vier, verbinden Sie Ihren Helpdesk, spielen Sie Ihre eigenen Tickets erneut ab und lassen Sie die Ergebnisse sagen, ob das Modell je das Problem war.