

Fronts KI-Agenten-Bewertung ist ein Tool namens Compass, und der Teil, den Sie vor dem Go-Live ausführen, ist sein Tab Simulationen, der nur für Autopilot-Agenten funktioniert. Eine Simulation spielt eine echte Unterhaltung gegen von Ihnen geschriebene Kriterien ab, sendet nichts an Kunden und begrenzt jeden Lauf auf 10 Austausche. Nach dem Launch bewertet Compass laufende Antworten mit Smart QA und Smart CSAT. Es prüft das von Ihnen beschriebene Verhalten, nicht ob eine Antwort zu Ihrem Hilfecenter passt, lesen Sie also auch die Transkripte. Compass hat keine Zusatzgebühr, während Autopilot bei 0,05 $ pro Unterhaltung beginnt.
eesel arbeitet in Front als KI-Helpdesk-Teammitglied, das Entwürfe als interne Kommentare verfasst, und jeder Rollout wird zuerst gegen die eigenen vergangenen Unterhaltungen des Teams simuliert. Mit der eesel CLI kann ein KI-Coding-Agent freigegebenes Wissen hochladen, etwa exportierte Front-Hilfeartikel und gespeicherte Antworten, dann Testfragen stellen und die Antworten prüfen, bevor etwas live geht. Das Verbinden des Front-Posteingangs selbst braucht weiterhin die Freigabe eines Admins.
Was ist Fronts KI-Agenten-Bewertung, und wo befindet sie sich?
Es ist Compass, und es befindet sich auf der eigenen Seite des Agenten in den Unternehmenseinstellungen. Fronts Compass-Artikel sagt, dass es Admins hilft, KI-Agenten zu testen, die Gesprächsqualität zu messen, Leistungssignale zu verfolgen und Empfehlungen zu erhalten. Sie benötigen Unternehmens-Admin-Rechte und einen bestehenden Agenten. Drei Tabs übernehmen die Arbeit: Simulationen zum Testen vor der Bereitstellung, Performance zur Überwachung der Gesundheit und Antworten zum Lesen jeder KI-Nachricht.
Die Benennung brauchte ein paar Monate, um sich zu festigen, daher führen Suchen nach "Scorecards" oder "Bewertungsberichte" in Fronts Dokumenten ins Leere. Im August bat ein Front-Community-Manager um Design-Partner für eine Reihe von Tools, um "jede KI-Interaktion zu bewerten, zu diagnostizieren, was schiefgelaufen ist, und Änderungen vor dem Go-Live zu validieren". Am 6. Oktober stellte Front Compass vor in seinen Produkt-Updates, und die Zusammenfassung vom 26. Oktober listet Agenten-Bewertung und Agenten-Testing als zwei getrennte Punkte.
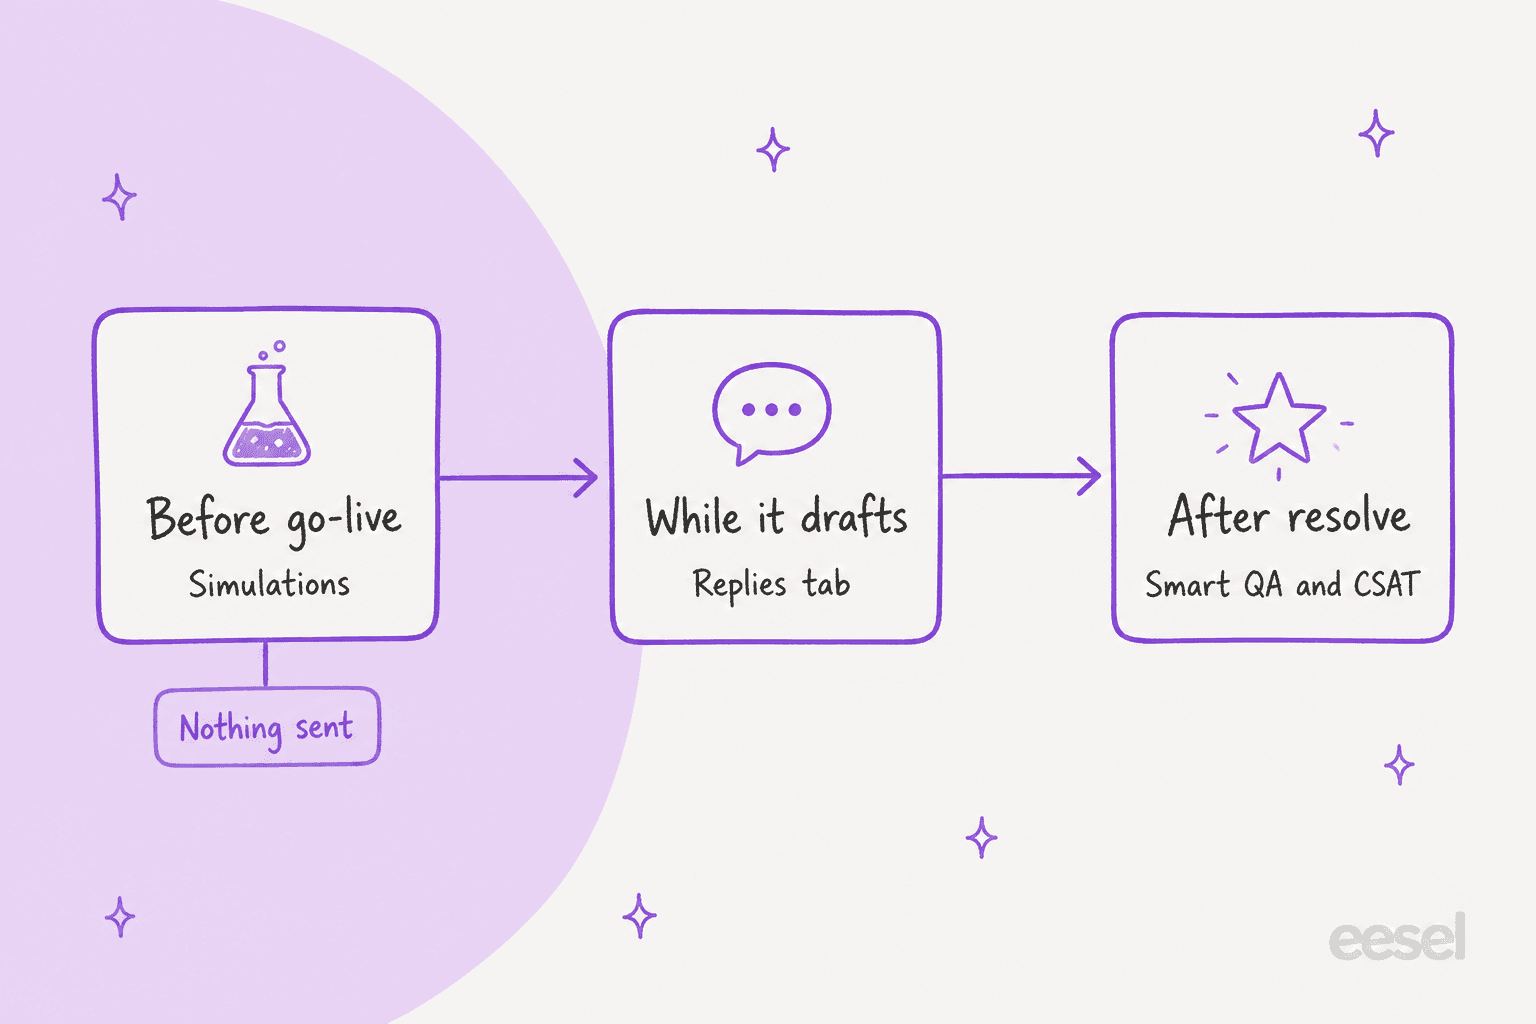
Ich lese die Bewertung in drei Ebenen, und das Bild oben ist, wie ich es einem Support-Lead erklären würde. Vor dem Go-Live führen Sie Simulationen aus, während der Agent Entwürfe verfasst lesen Sie den Tab Antworten, und nachdem eine Unterhaltung gelöst ist, bewerten Smart QA und Smart CSAT sie. Jede Ebene beantwortet eine andere Frage, was für das Widget weiter unten wichtig ist.
Welche Front-Pläne und Add-ons braucht es?
Compass selbst ist kostenlos, aber das, was es bewertet, meist nicht. Fronts Launch-Beitrag sagt, dass externe Agenten auf allen Plänen verfügbar sind, Autopilot ein nutzungsbasiertes Add-on auf allen Plänen ist und Compass für beide ohne zusätzliche Gebühr funktioniert. Die Nutzung von Compass mit Autopilot braucht das Autopilot-Add-on.
| Baustein | Was Front sagt | Quelle |
|---|---|---|
| Externe Agenten (Claude, Codex, Sierra und andere) | Auf allen Plänen verfügbar | Front-Launch-Beitrag |
| Autopilot-Agenten | Nutzungsbasiertes Add-on auf allen Plänen, ab 0,05 $ pro Unterhaltung | Front-Preise |
| Compass (Simulationen, Performance, Antworten) | Keine zusätzliche Gebühr, Autopilot-Add-on für Autopilot-Agenten nötig | Compass-Artikel |
| Smart QA und Smart CSAT | Im neuesten Enterprise-Plan ohne Zusatzkosten enthalten | Smart-QA-Artikel |
| Enterprise-Sitzplatz | 105 $ pro Sitzplatz im Monat, jährlich abgerechnet | Front-Preise |
Der Smart-QA-Artikel ergänzt eine 30-tägige Enterprise-Testphase für Teams auf anderen Plänen, gestartet aus der Regelvorlage. Was die Dokumente nicht sagen, ist, ob ein Professional-Kunde, der Autopilot hinzufügt, Smart-QA-Bewertungen für die Antworten der KI erhält. Der Compass-Artikel sagt, Smart QA wird für KI-Agenten automatisch eingeschaltet, und der Smart-QA-Artikel sagt, es ist eine Enterprise-Funktion, also fragen Sie Front, bevor Sie dafür budgetieren. Mein Beitrag Front-Preise hat die Zahlen pro Sitzplatz, und Front AI behandelt die breitere Produktlinie.
Wie funktionieren Front-Simulationen?
Sie erstellen ein Set von Test-Unterhaltungen, geben jeder Kriterien und führen sie aus. Ein Set ist eine benannte Gruppe verwandter Simulationen, die Sie nach jeder Änderung als Baseline erneut ausführen, laut dem Compass-Artikel. Die Schritte:
- Öffnen Sie den Agenten, wählen Sie Simulationen und klicken Sie auf Set erstellen. Benennen Sie es und wählen Sie optional eine Smart-QA-Scorecard.
- Klicken Sie auf Simulation erstellen. Wählen Sie eine aktuelle offene Unterhaltung aus den ausgewählten Posteingängen oder geben Sie eine Unterhaltungs- oder Ticket-ID ein.
- Fügen Sie Simulationskriterien hinzu und klicken Sie dann auf Erstellen und ausführen.
- Für viele Unterhaltungen auf einmal fügen Sie durch Kommas getrennte IDs ein. Jede wird zu ihrer eigenen Simulation, und Set ausführen führt alle aus.
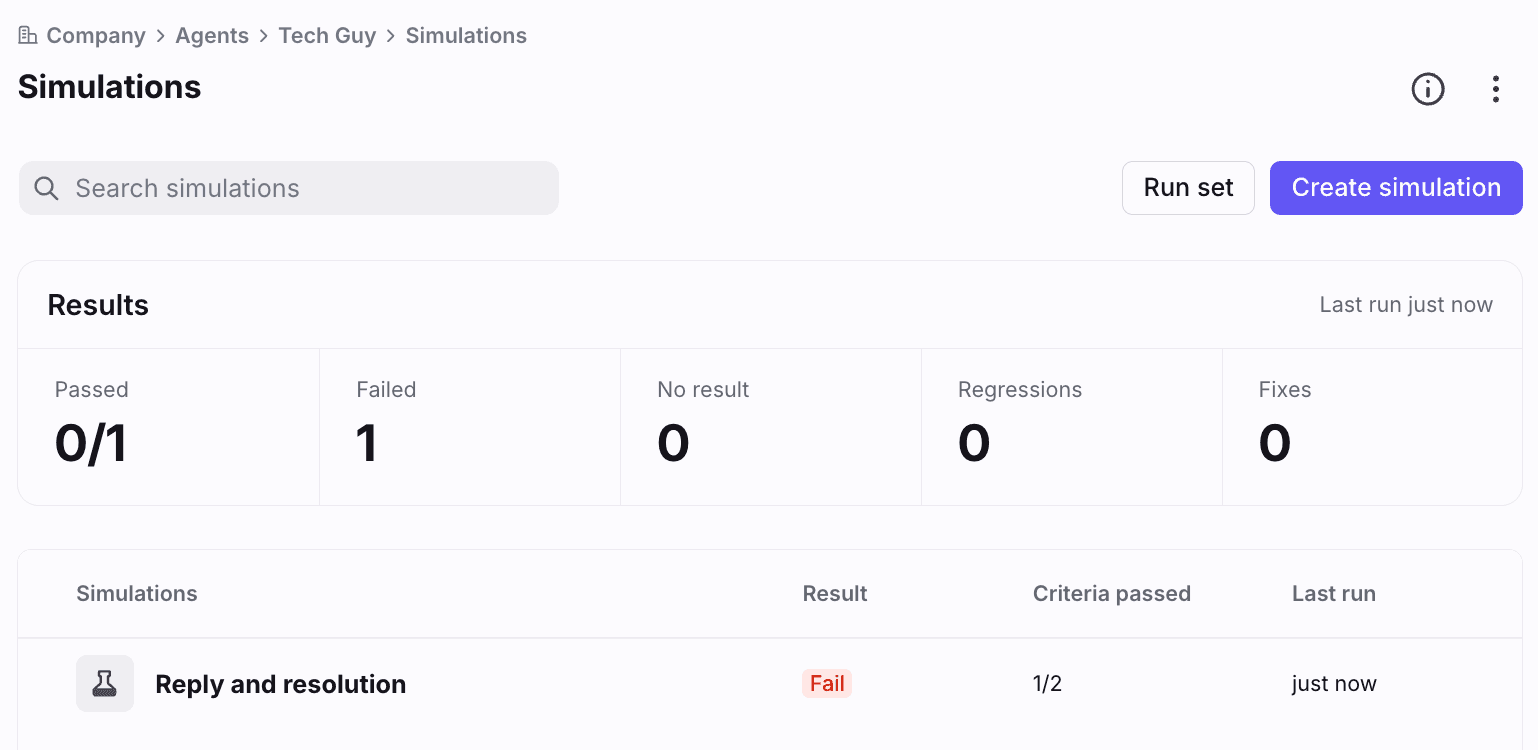
Das Ergebnis-Panel oben zählt bestanden, fehlgeschlagen, kein Ergebnis, Regressionen und Korrekturen. Fronts Hilfeartikel sagt, dass jede Unterhaltung gegen den Agenten mit einem simulierten Kunden läuft, begrenzt auf 10 Hin-und-Her-Austausche, und Läufe sind unbegrenzt. Nichts erreicht einen echten Kunden, keine laufende Unterhaltung ändert sich, und die Analysen bleiben unberührt.
Die Kriterien sind, wo die Arbeit liegt. Sie schreiben einen Namen und eine Beschreibung des erwarteten Verhaltens, klicken auf Skala generieren, um Bestehen- und Durchfallen-Bedingungen zu erhalten, und ein Validator markiert alles, was vage, gebündelt oder nicht überprüfbar ist, bis es als "Gute Definition" gilt. Front schlägt drei Starter vor: Der Agent behauptet nie, eine Aktion ausgeführt zu haben, die er nicht ausgeführt hat, er eskaliert, wenn er sollte, und er eskaliert nicht, wenn er nicht sollte. Das sind dieselben drei Fehler, die ich in das erste Testset jedes Support-Agenten einbauen würde.
Was kann eine Front-Simulation sehen, und was nicht?
Das ist die Grenze, die am meisten zählt. Eine Simulation bewertet Verhalten anhand sichtbarer Beweise, und der Compass-Artikel listet auf, was diese Beweise sind. Der Validator kann gesendete Nachrichten, interne Notizen, Tags, Posteingangswechsel, Zuweisung, Ticketstatus, Connector-Aufrufe und wie die Unterhaltung endete sehen. Er kann nicht den Inhalt oder die Reihenfolge eines Playbooks, den Text eines Wissensartikels, benutzerdefinierte Felder, Kontaktdatensätze, Entwürfe oder Anhänge sehen.
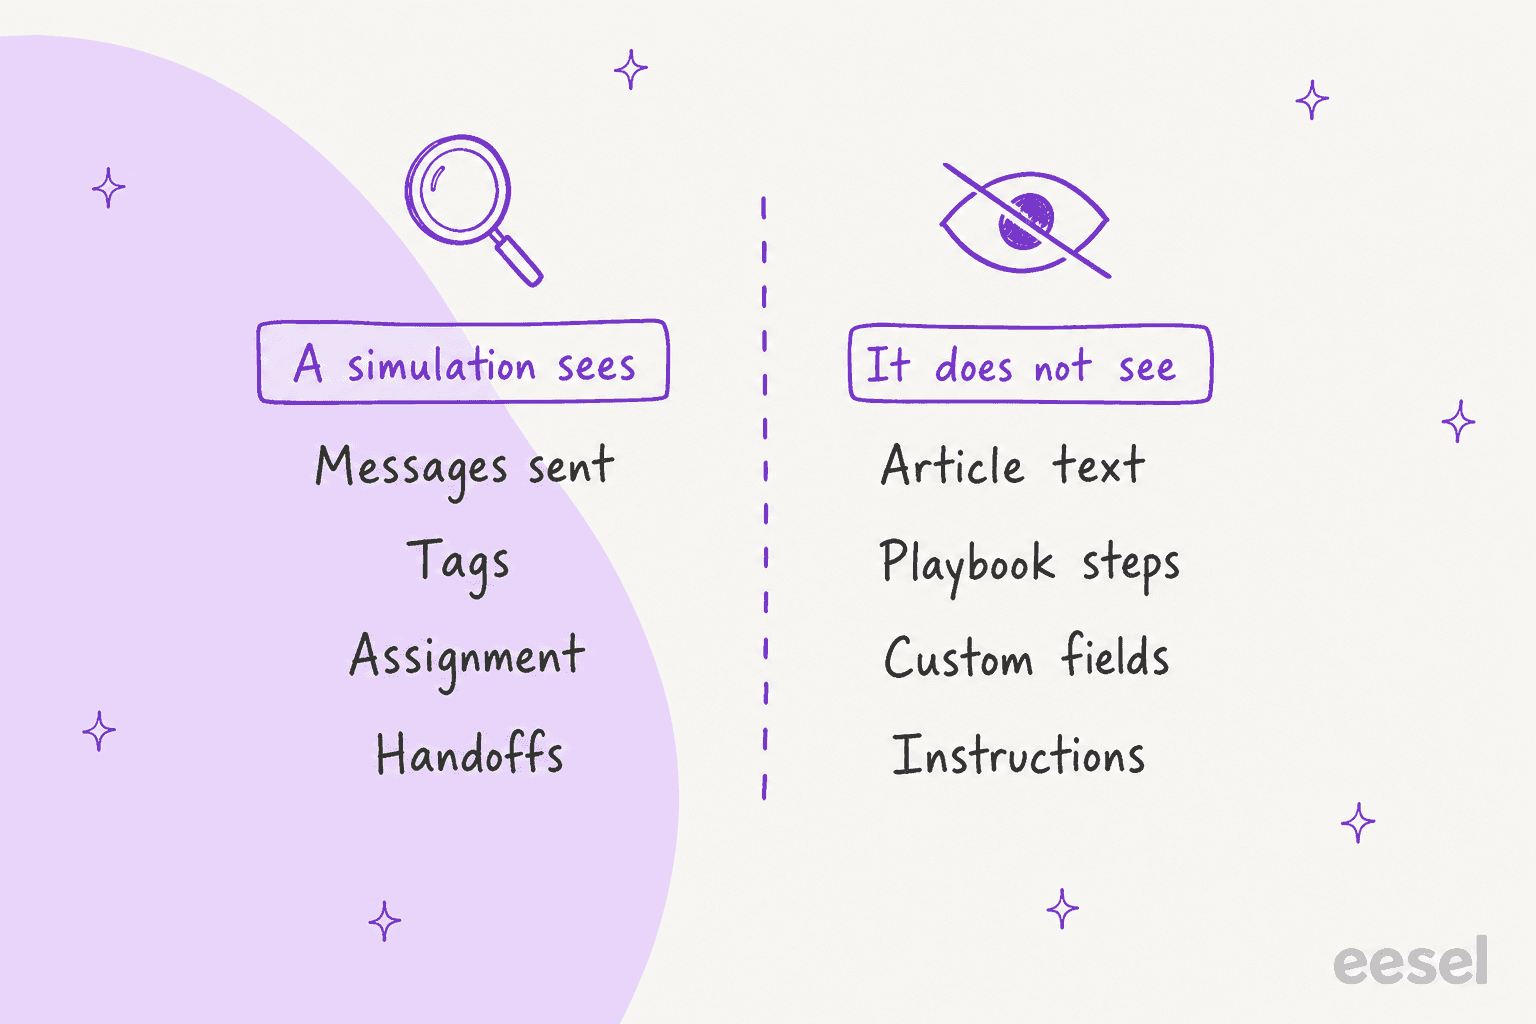
Agenten-Anweisungen, Richtlinien und Tonfall-Einstellungen sind ebenfalls verborgen, außer der Agent bezieht sich auf sie, ohne sie auszusprechen. Fronts FAQ sagt unmissverständlich, dass Kriterien Antworten nicht gegen Wissensquellen oder Playbooks prüfen können, daher der Rat, verhaltensbasierte Kriterien zu schreiben und das Transkript für Genauigkeit zu lesen. Eine bestandene Simulation beweist, dass der Agent sich wie beschrieben verhalten hat, nicht dass seine Antwort richtig war. Der Artikel listet Tonfall und Formatierung als Aufgabe der Smart-QA-Scorecard und sagt, sie aus den Kriterien herauszuhalten.
Bei einer Rückerstattungsfrage bedeutet das, "eskaliert an eine Person, wenn der Kunde Geld zurück verlangt" ist ein gutes Kriterium, und "zitiert das korrekte 30-Tage-Fenster" ist nicht testbar, weil der Artikeltext für den Validator unsichtbar ist. Das zweite würden Sie durch das Lesen des Transkripts erfassen, und mein Leitfaden zu adversarial testing sowie die Glossareinträge zu AI hallucination und AI grounding behandeln, warum dieses Lesen wichtig ist.
Wie liest man ein Simulationsergebnis?
Öffnen Sie eine Simulation, und Sie erhalten das Transkript, die Kriterien und ein Urteil. Fronts Artikel sagt, die Detailansicht zeigt eine Unterhaltungsvorschau und Ergebnisse, mit Laufverlauf und erneuten Läufen im Dreipunkt-Menü, und Pfeilanzeigen, die den aktuellen Lauf mit früheren vergleichen, um Fortschritt oder Rückschritte zu zeigen.
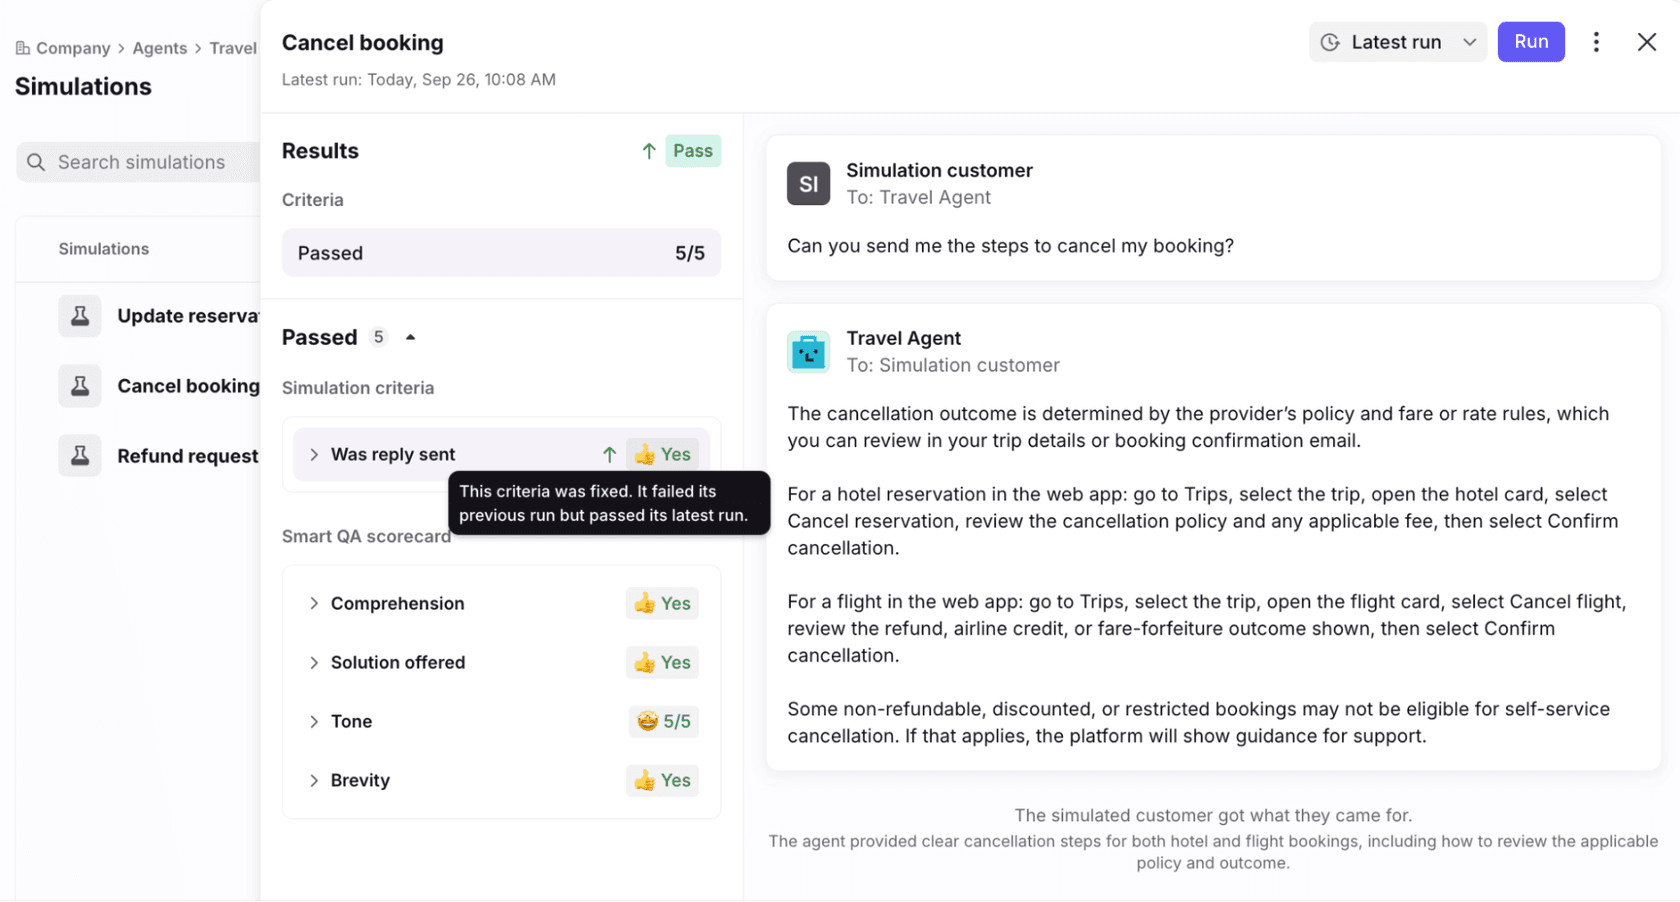
Im Screenshot trägt ein Kriterium, das beim letzten Lauf durchfiel und bei diesem bestand, einen Tooltip, der besagt, es sei korrigiert worden, und die Smart-QA-Scorecard ist darunter angehängt. Das ist der Kreislauf, für den Front designt: Anweisungen oder Wissen ändern, dasselbe Set erneut ausführen und sowohl auf Rückschritte als auch auf Korrekturen achten. Smart QA bewertet nur Antworten, also wenn der Agent korrekt still bleibt und eskaliert, gilt die Scorecard nicht, aber Ihre Kriterien schon.
Was misst Compass, sobald der Agent live ist?
Compass bewertet jede Antwort als Kein Signal, Gut, Okay oder Schlecht, aufgebaut aus fünf Signalen. Der Compass-Artikel nennt sie:
- Smart CSAT. Läuft automatisch auf KI-Antworten in gelösten Unterhaltungen und leitet Zufriedenheit ab. Menschliche Teammitglieder werden durch diesen Pfad nicht bewertet.
- Smart QA. Läuft 24 Stunden nach der Lösung auf KI-Antworten, mit einer Standard-Scorecard aus Kürze, Tonfall, angebotene Lösung und Verständnis.
- Entwurfs-Bearbeitungsgrad. Erkennt, ob ein KI-Entwurf unverändert gesendet, leicht bearbeitet, stark bearbeitet oder verworfen wurde.
- Teammitglied-Feedback. Daumen hoch oder runter zu Entwürfen und Antworten, mit optionalen Details, die nur Admins sehen können.
- Abgeleitetes Feedback. Fronts KI leitet ein Signal aus Korrekturen oder starken Bearbeitungen ab.
Der Tab Performance fasst diese zusammen mit Lösungs- und Beteiligungskennzahlen und einer Liste namens Chancen. Front sagt, das helfe zu beurteilen, ob ein Agent gesund genug ist, um die Abdeckung zu erweitern oder von Entwürfen zu automatischen Antworten zu wechseln, und was zuerst zu beheben ist.
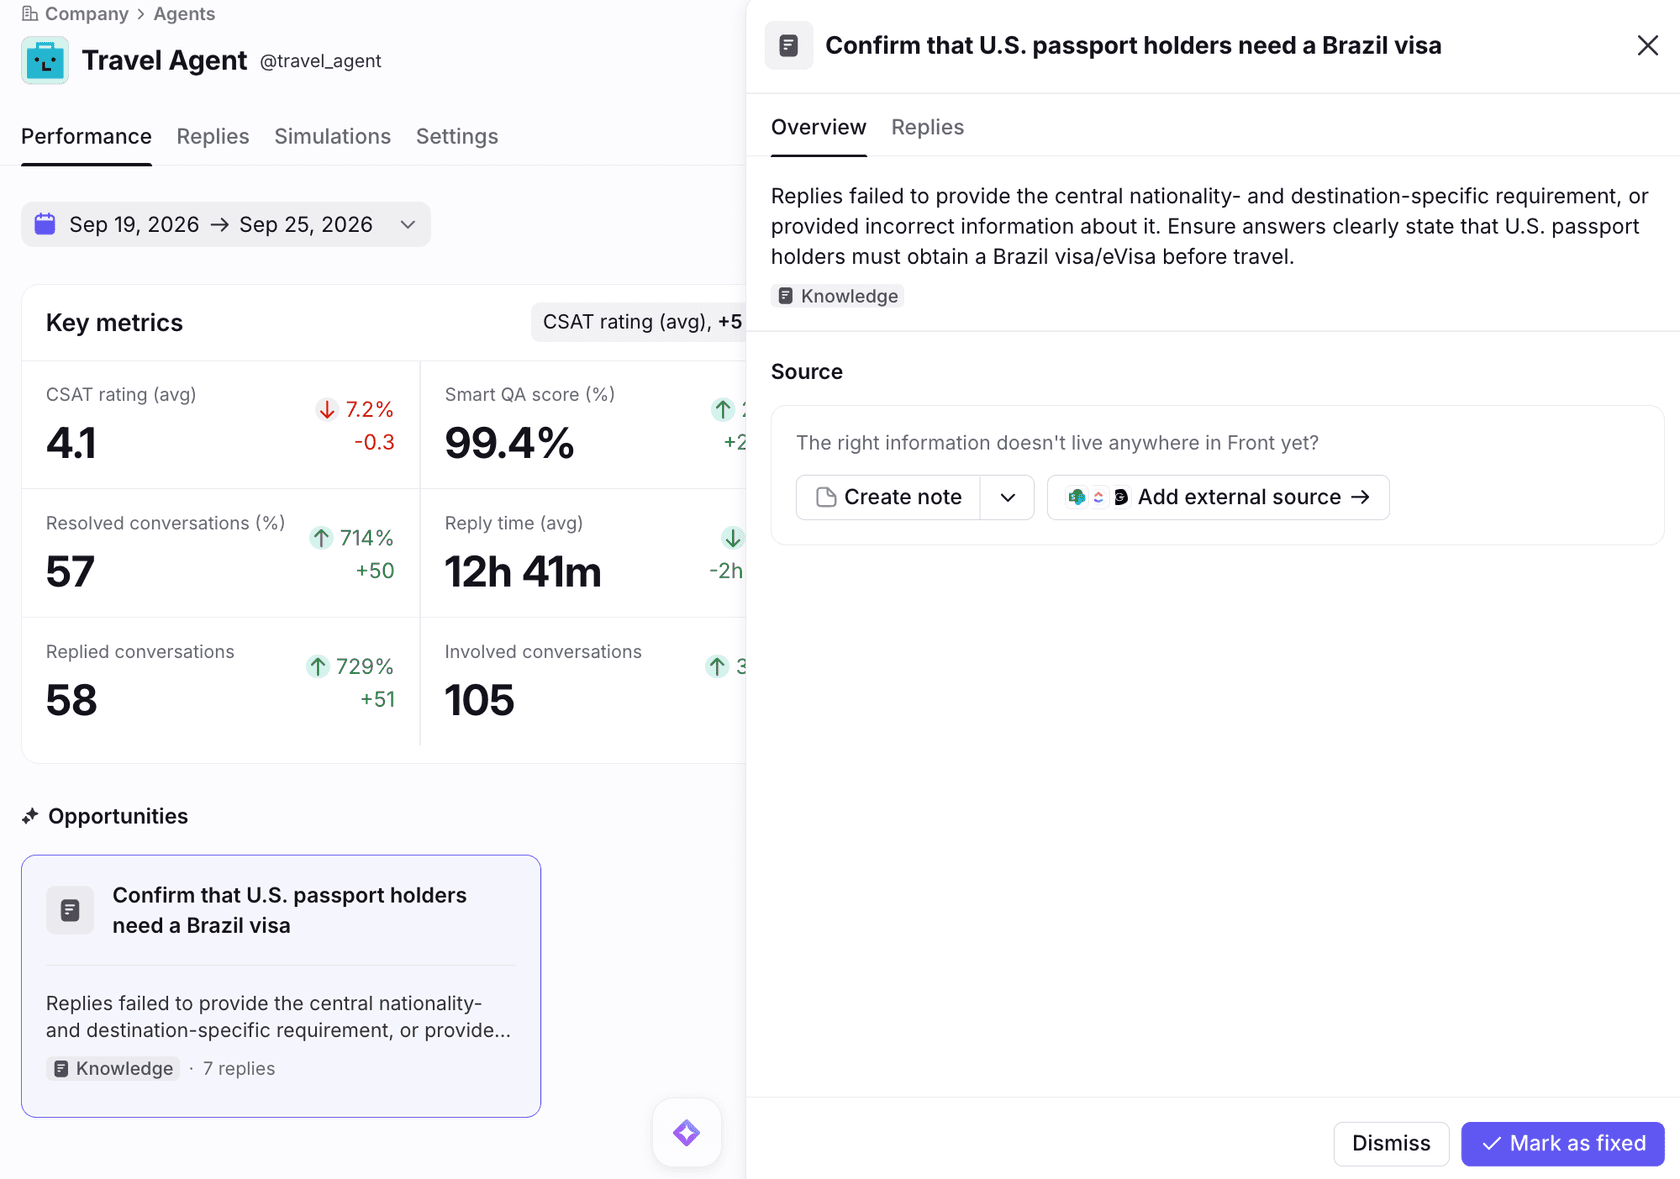
Eine Chance zeigt eine Zusammenfassung, eine Lückenart und wie viele Antworten sie betrifft, und die vorgeschlagene Korrektur verweist meist auf Wissen oder Agenten-Anweisungen. In Fronts Beispiel waren Antworten zu einer Brasilien-Visumpflicht falsch, und das Panel bietet an, eine Notiz zu erstellen oder eine externe Quelle hinzuzufügen. Der Tab Antworten listet jeden Entwurf und jede automatische Antwort mit Filtern für Posteingang, Antworttyp, Thema und Signal und zeigt die Quellen hinter jeder. Wenn Sie sich auf CSAT als Ihre Hauptkennzahl verlassen, denken Sie daran, dass es hier abgeleitet ist, und mein Beitrag AI CSAT behandelt, wie weit man dem vertrauen sollte.
Fronts Smart-QA- und Smart-CSAT-Artikel setzen die Grenzen. Nur geteilte Posteingangs-Unterhaltungen zählen, jede braucht mindestens eine eingehende und eine ausgehende Nachricht, und die Unterhaltung muss gelöst oder archiviert sein. Englisch ist die einzige offiziell unterstützte Sprache. Regeln sind nicht rückwirkend, daher wird Verlauf vor der Existenz einer Regel nicht bewertet. Front berichtet etwa 99 % Genauigkeit bei faktischen Inhalten für Smart QA und etwa 90 % Übereinstimmung mit Kunden-CSAT für Smart CSAT, was Fronts eigene Zahlen sind.
Funktioniert die Bewertung für externe Agenten wie Claude oder Sierra?
Teilweise. Fronts Launch-Beitrag sagt, Compass bewertet jede Unterhaltung, die von Agenten auf Autopilot oder einem anderen Anbieter bearbeitet wird, und Compass ist für beide kostenlos. Der Compass-Artikel sagt, das Agenten-Testing, der Tab Simulationen, ist nur für Autopilot-Agenten, und für externe Agenten sind die Quellen im Tab Antworten das durch den MCP weitergegebene Wissen. Ein externer Agent erhält also eine Live-Bewertung, aber Sie testen ihn mit Ihrem eigenen Testsystem, bevor Sie ihn verbinden. Fronts Launch-Beitrag zitiert einen Kunden, Next Level Sports, der sagt, Compass gebe seinem Support- und Engineering-Team einen Ort, um KI-Antworten zu überprüfen und die Qualität zu messen.
Welches Front-Tool beantwortet welche Frage?
Wählen Sie die Frage, die Sie beantworten wollen, und das Tool ändert sich. Dieses Widget ist meine eigene Zusammenfassung von Fronts Artikeln, daher ist die letzte Zeile jedes Panels, wo Sie das Detail nachlesen.
Regel-Testing ist der Ausreißer, weshalb ich es auflisten. Fronts Regel-Testing-Artikel prüft, ob eine Unterhaltung die Bedingungen und Aktionen einer Regel erfüllt, auf jedem Plan, mit der Option, eine simulierte Unterhaltung von Grund auf zu erstellen. Es lohnt sich, dies auf die Regel laufen zu lassen, die Unterhaltungen Ihrem Agenten zuweist, wie mein Beitrag Front load balancing für Zuweisungsgrenzen erklärt.
Wie würde ich einen Front-KI-Agenten mit diesen Tools einführen?
Starten Sie mit Entwürfen, testen Sie in Sets und erweitern Sie nur, wenn die Signale übereinstimmen. Fronts Autopilot-Agenten-Artikel beschreibt einen entwurfserstellenden Agenten, der Entwürfe für neue Unterhaltungen erstellt, eingerichtet mit nur-Entwurfs-Anweisungen und einer aus der Vorlage "An KI-Agent zuweisen" aufgebauten Regel. Von dort aus:
- Bauen Sie ein Set aus 15 bis 20 Unterhaltungen. Mischen Sie einfache Fragen, Rückerstattungsanfragen, verärgerte Kunden und Dinge, die der Agent ablehnen sollte. Front sagt, eine vielfältige Stichprobe gebe breitere Abdeckung, und ich würde aus dem letzten Monat echten Traffics schöpfen.
- Fügen Sie die drei Starter-Kriterien hinzu. Behauptet nie, eine Aktion ausgeführt zu haben, die er nicht ausgeführt hat; eskaliert, wenn er sollte; eskaliert nicht, wenn er nicht sollte.
- Ausführen, jedes Transkript lesen, beheben, erneut ausführen. Beobachten Sie die Rückschritts-Pfeile nach jeder Änderung an Anweisungen oder Wissen.
- Gehen Sie als entwurfserstellender Agent live. Prüfen Sie den Tab Antworten auf Entwurfs-Bearbeitungsgrad und Teammitglied-Daumen, nicht nur den Durchschnittswert.
- Verschieben Sie Themen einzeln zu automatischen Antworten. Nutzen Sie den Tab Performance und die Liste Chancen zur Entscheidung, und behalten Sie Regeln und Zeitziele als Ihre Punktetafel. Meine Beiträge Front time goal rules und SLA best practices behandeln diese Seite.
Das Übergabeverhalten verdient eigene Kriterien. Wenn der Agent eskaliert, muss die Unterhaltung bei der richtigen Person mit Kontext ankommen, was meine Beiträge AI agent handoff best practices und AI escalation durchgehen. Das Glossar hat Einträge zu escalation rate und AI guardrails.
Was sagen Fronts Dokumente nicht über die Bewertung von KI-Agenten?
Einiges, und jede Lücke ist etwas, das ich Front fragen oder testen würde, bevor ich mich darauf verlasse.
- Plan-Gating für Smart QA bei KI-Antworten. Laut einem Artikel in Enterprise enthalten, laut einem anderen automatisch aktiviert, und keine Seite bringt das für einen Professional-Kunden mit Autopilot in Einklang.
- Ob Simulationen Live-Systeme aufrufen. Der Validator kann Connector-Aufrufe sehen, aber die Dokumente sagen nicht, ob ein simulierter Lauf echte oder sandboxed Tools trifft.
- Eine Bestehensschwelle. Es gibt keine vorgeschlagene Bestehensrate oder Set-Größe außer "eine vielfältige Stichprobe verwenden".
- Vergleich mit dem, was Ihr Team gesendet hat. Kriterien beschreiben Verhalten. Der Artikel beschreibt keine Bewertung gegen die Antwort, die eine Person tatsächlich auf dieser Unterhaltung geschrieben hat.
- Sprachen in Compass. Der Compass-Artikel schweigt dazu. Die Artikel zu Smart QA und Smart CSAT sagen, nur Englisch wird offiziell unterstützt.
- Export- oder API-Zugriff. Ich fand keine Erwähnung des Exports von Simulationsergebnissen oder des Ausführens von Sets über die API.
- Stimmen von außen. Fronts Compass-Beitrag in der Community hatte 0 Antworten und 122 Aufrufe, als ich ihn las, daher habe ich noch keine Praktiker-Bewertung zum Zitieren.
Nichts davon macht Compass zu einem schwachen Tool. Ein kriterienbasierter Simulator mit Validator, Laufverlauf und Rückschritts-Pfeilen ist ein echtes Testsystem. Es ist ein anderes Design als das Nachspielen von Verlauf, was der Vergleich ist, der mich als Nächstes interessiert.
Wie testet eesel einen KI-Agenten, bevor er Front-Kunden antwortet?
eesel testet gegen Ihre eigenen vergangenen Unterhaltungen, und Front testet gegen von Ihnen geschriebene Kriterien. Die beiden ergänzen sich, und ich würde mich nicht allein deswegen für eines entscheiden. Die eesel-Simulation spielt vergangene Tickets mit abgeschaltetem Versand ab, verfasst eine Antwort auf jedes, vergleicht sie mit dem, was Ihr Team tatsächlich gesendet hat, gruppiert die Ergebnisse nach Thema und ordnet Korrekturen nach Wirkung. Der Bericht trennt Treffer, Teiltreffer, korrekte Übergaben und tatsächliche Fehlschläge. eesels eigenes Dokumentationsbeispiel sind 20 gelöste Tickets, von denen 17 der Antwortqualität des Teams entsprechen.
| Front-Compass-Simulationen | eesel-Simulation | |
|---|---|---|
| Was getestet wird | Verhalten gegen von Ihnen geschriebene Kriterien | Antworten gegen das, was Ihr Team tatsächlich gesendet hat |
| Testeingabe | Unterhaltungs-IDs aus Ihren Posteingängen | Vergangene Tickets oder generierte Fälle ohne Helpdesk |
| Kundenseite | Simulierter Kunde, maximal 10 Austausche | Eine verfasste Antwort pro vergangenem Ticket |
| Gilt für | Nur Autopilot-Agenten | Den eesel-Agenten |
| Sendet an Kunden | Nein | Nein |
| Nach einem Lauf | Set erneut ausführen, Pfeile lesen | Korrekturen als einfache Satzregeln gespeichert, dann erneut ausführen |
Fronts mehrstufiger simulierter Kunde ist das, was eesels Replay nicht nachbildet, und eesels eigene Simulationsseite sagt, mehrstufige Chats mit KI-gespielten Personas werden besser von einem eigenen Simulator des Helpdesks bedient. Umgekehrt beschreibt Fronts Artikel nicht, eine Antwort gegen eine Referenzantwort zu prüfen, was dort hilft, wo das Nachspielen von Verlauf nützt.
Der erarbeitete Teil ist für mich die Rollout-Reihenfolge. eesel lässt seit Jahren KI auf laufenden Support-Warteschlangen laufen, und die Gewohnheit, die sich hielt, ist, dass nichts einem Kunden antwortet, bevor es gegen den eigenen Verlauf dieses Teams nachgespielt und dann ein bis zwei Wochen auf laufenden Tickets als Entwurf verfasst wurde. Norden-Frisia, eine deutsche Fährlinie, nutzte eine Testwoche mit den letzten drei Monaten an Tickets und Makros, bevor sie abonnierte. Textla begann mit einer Testphase, in der eesel nur interne Notizen hinterließ, damit das Team sehen konnte, was es gesagt hätte, und Innr prüft weiterhin jeden Entwurf und arbeitet auf autonome Antworten für eine ausgewählte Menge an Themen hin. Keines der drei nutzt Front, lesen Sie es also als dieselbe Methode auf anderen Helpdesks.
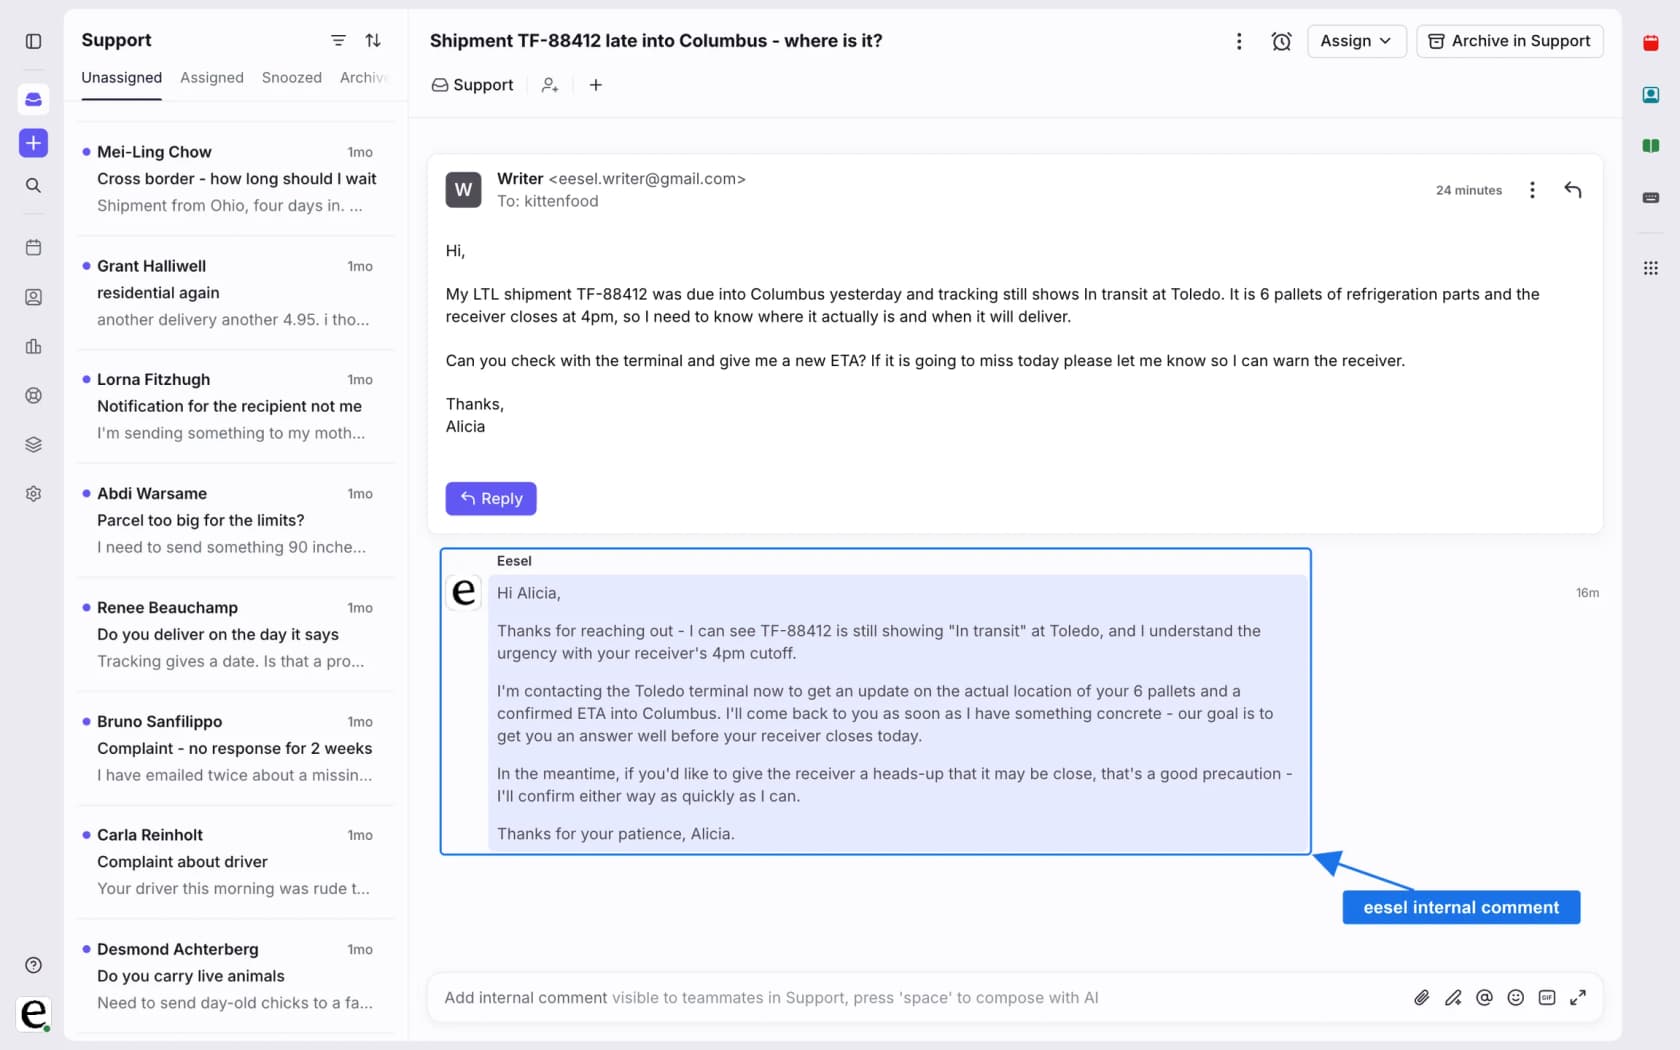
Bei Front listen eesels Integrationsdokumente Trigger für eine Kundennachricht, eine erste Nachricht, eine @eesel-Erwähnung und eine archivierte Unterhaltung, mit Aktionen zum Antworten, einen internen Kommentar hinterlassen, taggen, zuweisen, Felder aktualisieren und archivieren. Die Dokumente empfehlen, mit internen Kommentaren zu beginnen, und beschreiben keine Front-spezifische Simulation, daher würde ich die Wiedergabe an einer kleinen Stichprobe ausführen und den Bericht lesen. Die CLI hilft bei diesem Kreislauf. eesel files upload ./refund-policy.pdf fügt freigegebenes Wissen hinzu, eesel chat "what's our refund policy?" testet eine Antwort, eesel approvals listet zurückgehaltene Aktionen, und --dry-run zeigt eine Vorschau eines Schreibvorgangs. Die CLI-Dokumente erwähnen keine Simulationen, daher laufen diese im Dashboard.
eesel in Ihrem Front-Posteingang testen
Wenn Sie die Replay-zuerst-Version dieses Prozesses wollen, tritt eesel als KI-Helpdesk-Teammitglied Ihrem geteilten Front-Posteingang bei. Es liest Ihr Hilfecenter und vergangene Unterhaltungen, verfasst Antworten als interne Kommentare und kann taggen und zuweisen, sodass Ihr Team echte Entwürfe prüft, bevor etwas gesendet wird. Führen Sie die Simulation mit Ihrem eigenen Verlauf aus, behalten Sie Ihre Regeln und Zeitziele als Punktetafel, und erweitern Sie auf direkte Antworten, sobald die Entwürfe dem entsprechen, was eine Person schreiben würde. Kostenpflichtige Pläne starten bei 299 $ im Monat für 500 Credits, und es gibt einen kostenlosen Plan mit 100 Credits, um es an ein paar echten Unterhaltungen zu testen (eesel-Preise).
Für die Einrichtung siehe meinen Leitfaden adding AI to Front, die Übersicht best AI for Front und Front vs eesel. Zum Vergleich siehe meine Front review und Front alternatives. Für den Rest der Front-Einrichtung zeigen Front ticket status rules, Front shared inbox ownership und Front required resolution fields, wo die Arbeit eines Agenten ankommt, und das Glossar erklärt shared inbox, support quality assurance und resolution rate. Try eesel an ein paar echten Unterhaltungen, bevor Sie sich entscheiden.