

Fünf geprüfte Tickets pro Agent und Monat ergeben einen Qualitätswert, der um etwa 31 Punkte danebenliegen kann. Die Lösung ist also nicht eine bessere Tabelle, sondern jedes Ticket mit KI zu bewerten und das Ergebnis als Signal zu behandeln, das ein Mensch überprüft. Zendesk, Gorgias, Front, HubSpot und Freshdesk bieten jeweils eine Version davon an, und sie decken sehr unterschiedliche Teile eines Tickets ab (Gorgias bewertet 3 Kriterien mit KI, HubSpot 3, bei Zendesk schreibst du die Kriterien selbst).
Was die meisten Leitfäden übersehen: Sobald ein KI-Agent die repetitiven Tickets übernimmt, sind die übrigen Tickets für deine Mitarbeitenden schwieriger. Die Bearbeitungszeit steigt, das Volumen pro Agent sinkt, und eine Scorecard aus der Zeit vor der KI wertet deine besten Leute ab. Bei Question Beauty hat eesel in einem Monat etwa 280 von 990 Gorgias-Tickets selbst geschlossen und etwa 250 mit einer Notiz an einen Menschen übergeben. Die menschliche Warteschlange ist also eine andere Aufgabe als die, für die die alten Ziele gesetzt wurden. Ich zeige die Rechnung zur Stichprobengröße, die neu gewichtete Scorecard, mit der ich starten würde, und wie du KI-Bewertungen fair hältst.
Wie viele Reviews braucht der Wert eines Agenten wirklich?
Weit mehr als fünf. Ein Wert aus fünf geprüften Tickets ist hauptsächlich Glück, und die Rechnung ist die Standardrechnung für jede Erfolgsquote.
Nimm einen Agenten, der ein Kriterium tatsächlich in 85 % der Fälle erfüllt. Bei 5 Reviews im Monat beträgt die 95-%-Fehlermarge etwa 31 Punkte: Das Dashboard könnte für dieselbe Person im selben Monat 55 % oder 100 % anzeigen. Bei 20 Reviews sind es etwa 16 Punkte, bei 100 etwa 7 und bei 500 (jedes Ticket) etwa 3. Das ist meine eigene Rechnung mit der Normalapproximation, im Widget unten mit einer Endlichkeitskorrektur.
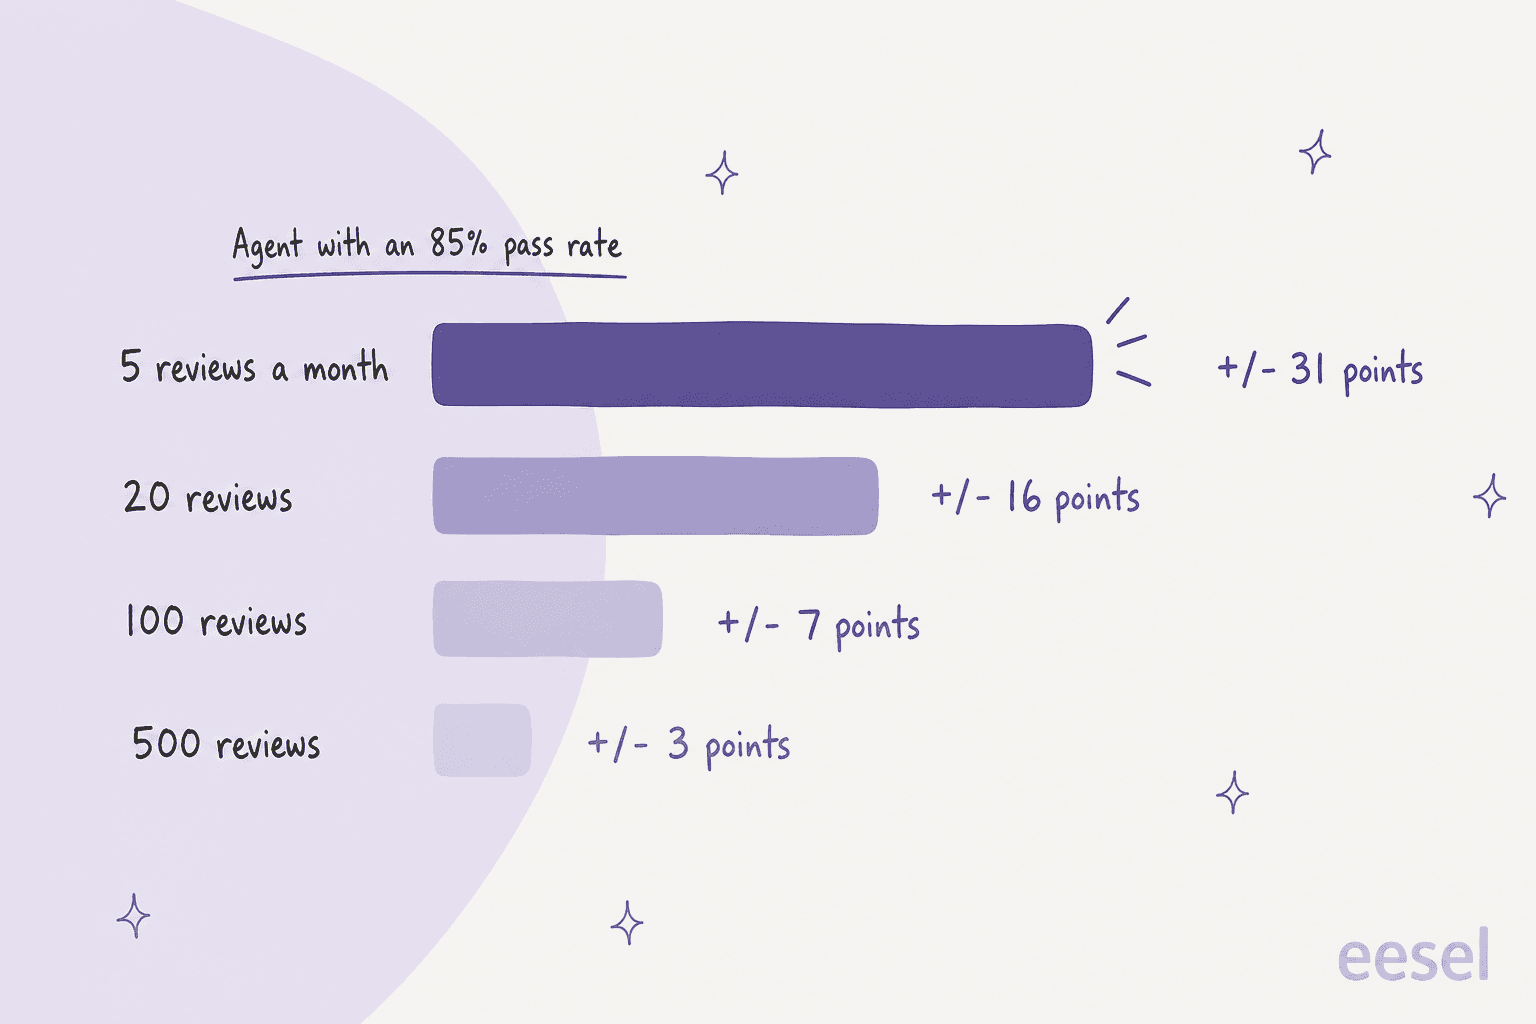
Noch schlimmer wird es beim Vergleich von Personen. Um einen 85-%-Agenten sicher von einem 75-%-Agenten zu unterscheiden, brauchst du jeweils rund 120 bewertete Tickets. Ein Teamleiter, der 5 bis 10 Tickets pro Woche aus etwa 500 monatlichen Tickets eines Agenten prüft, kommt da nie hin. Leo Gasperin hat genau das in seinem früheren Team beschrieben, und ein Kommentator hat es auf den Punkt gebracht:
"sampling creates confidence, but not clarity."

Probiere deine eigenen Zahlen aus. Das Widget unten nutzt dein Ticketvolumen und deine Anzahl an Reviews.
Gib dein eigenes Ticketvolumen und deine Review-Anzahl ein, um zu sehen, wie breit der Bereich ist. Die letzte Karte zeigt die Review-Anzahl, die nötig ist, um zwei Agenten mit 10 Punkten Abstand zu unterscheiden.
Den grundsätzlichen Fall für den Verzicht auf Stichproben habe ich in Qualitätssicherung im Callcenter behandelt, die praktische Variante in Support-QA mit KI. Die Kurzfassung hier: KI-Bewertung lohnt sich allein wegen der größeren Grundgesamtheit.
Was sollte eine Scorecard zur Agentenleistung messen?
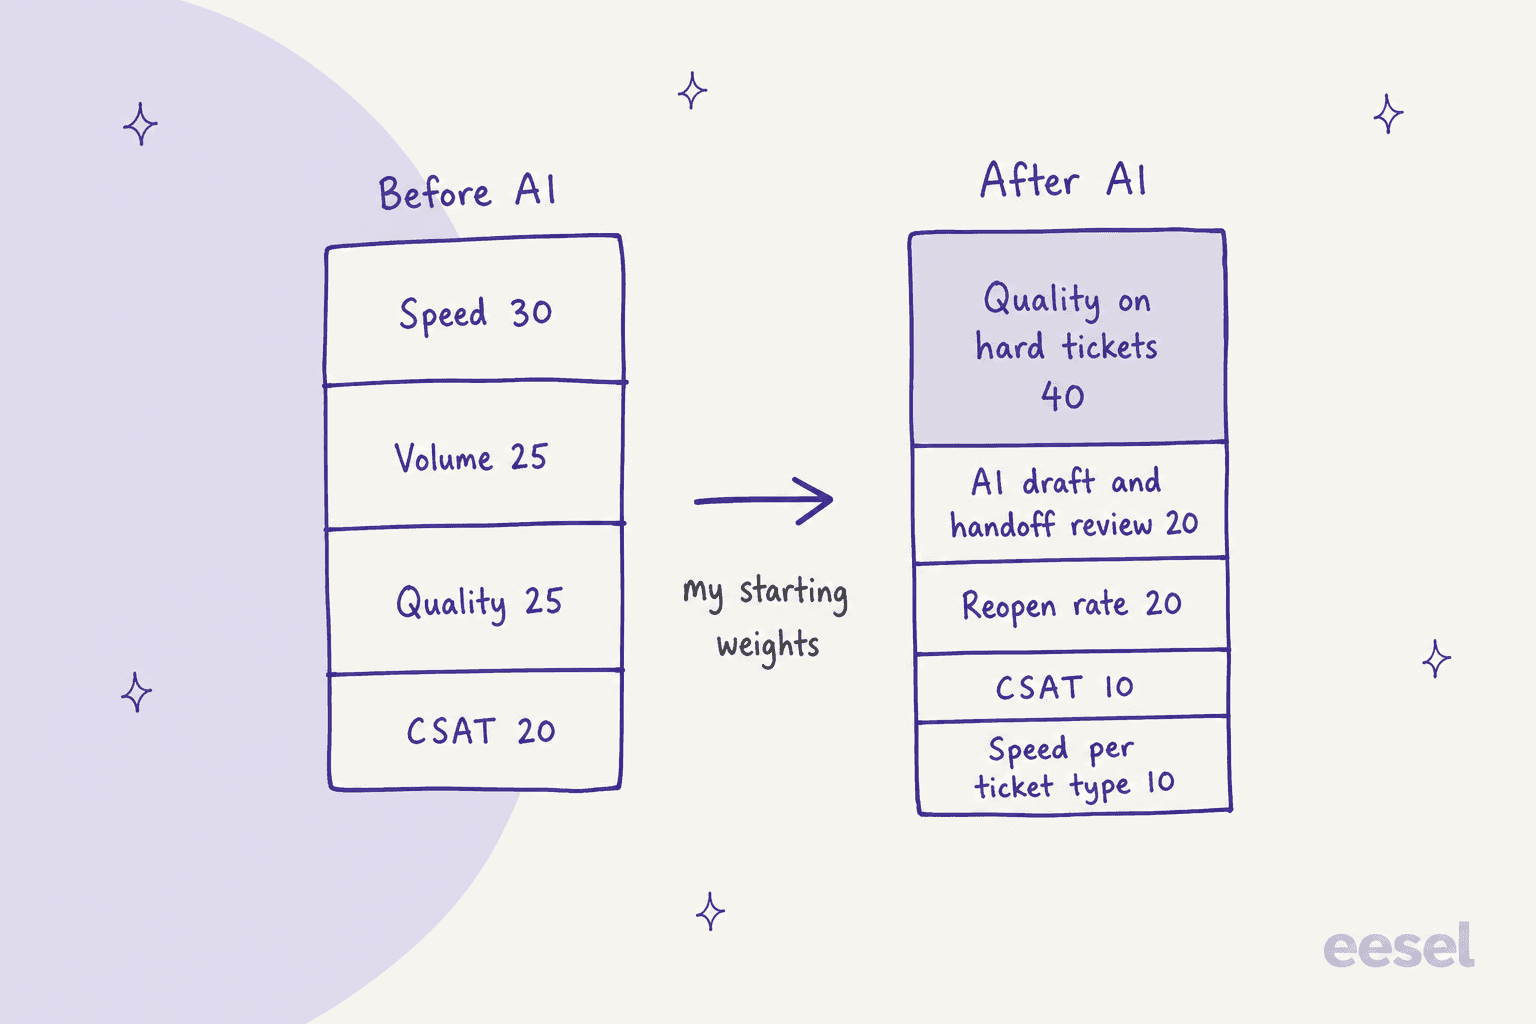
Vier Dinge, und keines davon ist allein die Geschwindigkeit: Qualität, Ergebnis, Kundensicht und Effizienz pro Tickettyp. Der übliche Rat ist ein gewichteter Wert (etwa Qualität 40, Produktivität 25, Kundenerlebnis 25, Zuverlässigkeit 10), und diese Form ist in Ordnung. Bei den Gewichten machen Teams die Fehler.
| Bereich | Beispielmessung | Was sie dir zeigt | Die Falle |
|---|---|---|---|
| Qualität | KI-bewertete Empathie, Genauigkeit, Lösung | Hat die Antwort ihren Zweck erfüllt? | Ein Kriterium, das die KI nicht beurteilen kann (Gorgias überlässt Genauigkeit und Markenstimme Menschen) |
| Ergebnis | Wiedereröffnungsrate, Lösung beim ersten Kontakt | Ist das Problem gelöst geblieben? | Agenten, die schnell schließen und später wiedereröffnen |
| Kundensicht | CSAT | Fühlte sich der Kunde gut unterstützt? | Wenige Umfrageantworten pro Agent, also dasselbe Rauschproblem |
| Effizienz | Durchschnittliche Bearbeitungszeit pro Tickettyp | Ist die Arbeit gut organisiert? | Eine einzige Mischzahl für einfache und schwierige Tickets |
Für die vollständige Kennzahlenliste gehen meine Beiträge zu Kundenservice-KPIs und Produktivität von Callcenter-Agenten tiefer. Wenn du Review-Kriterien von Grund auf schreibst, liefern dir QA-Feedback-Beispiele Formulierungen, die coachen statt benoten.
Was ändert sich, wenn ein KI-Agent die einfachen Tickets übernimmt?
Deine menschliche Warteschlange wird schwieriger, und jede Zahl pro Agent, die du vor der KI festgelegt hast, misst jetzt eine andere Aufgabe. Die KI beantwortet die Fragen zum Bestellstatus und die Wie-geht-das-Fragen, also landen bei einem Menschen die Erstattungsentscheidung, der verärgerte Kunde und das, was der Bot nicht lösen konnte.
Ein Callcenter-Mitarbeiter auf Reddit beschrieb das, nachdem ein KI-Sprachagent vor die Telefone geschaltet wurde:
"At this point, it's handling a lot of "routine" calls. Which means the calls that come through to us humans are more complicated, or people who are upset about the AI messing something up."

Die Zahlen bestätigen das Gefühl. Bei Question Beauty hat eesel in einem Monat (8. August bis 8. September 2026) etwa 990 Gorgias-Tickets bearbeitet, etwa 960 Antworten gesendet, etwa 280 Tickets selbst geschlossen und etwa 250 mit einer internen Notiz an einen Menschen übergeben. Erstattungen, Beschwerden und Großhandelsanfragen gehen immer an einen Menschen. Die Agenten dieses Teams sind nicht langsamer als vorher; sie sehen „Wo ist meine Bestellung?“ einfach nicht mehr. Die Bearbeitungszeit pro Ticket steigt und die Tickets pro Agent sinken, und beides ist kein Leistungsproblem.
Mit dieser Neugewichtung würde ich starten. Es sind meine Startgewichte, kein Benchmark, passe sie also nach deiner ersten Kalibrierungsrunde an. Was sich ändert:
- Streiche Volumenziele für Einzelpersonen. Die geschlossenen Tickets pro Agent sinken zwangsläufig, wenn die KI die einfachen abfängt. Verfolge stattdessen die gesamten Agentenstunden in der Warteschlange, wie ich in KI zur Senkung der Bearbeitungszeit erkläre.
- Miss die Geschwindigkeit pro Tickettyp. Ein Erstattungsticket und ein Passwort-Reset sollten nie denselben Maßstab teilen. Gorgias berechnet die Ticket-Bearbeitungszeit bereits nur für Tickets, die ein Mensch bearbeitet hat, und lässt Tickets aus, die sein AI Agent gelöst hat. Übernimm diese Regel in jedem Helpdesk.
- Füge eine Zeile für die Zusammenarbeit mit der KI hinzu. Agenten genehmigen, bearbeiten oder verwerfen jetzt Entwürfe und erhalten Übergaben. Bei smava hat eesel in einem Monat auf einem gemeinsamen Zendesk etwa 15.300 Antwortentwürfe vorbereitet, und ein Agent genehmigt einen Entwurf oder schreibt @eesel in eine Notiz, um ein anderes Makro anzufordern. Das gut zu prüfen ist eine Fähigkeit: Ein Wert für „falschen Entwurf erkannt“ und „hilfreiche Übergabenotiz hinterlassen“ gehört auf die Karte.
- Prüfe die Übergabe, nicht nur die Antwort. Wenn die KI übergibt und die Bestellung bereits geprüft ist, ist das Übergabequalität, und sie beeinflusst die Zahlen des Agenten stärker als seine Tippgeschwindigkeit.
Ein Reddit-Kommentator mit fast 30 Jahren Erfahrung im Support hat die Kosten des Ignorierens klar benannt:
"Except now imagine an eight-hour shift where practically EVERY conversation you receive is an escalation, an angry customer, an unusual problem or something the AI already couldn't solve."
Das ist auch eine Frage des Coachings und der Dienstplanung. Die Personalseite behandle ich in KI für die Personalplanung im Support und die Schichtseite in KI für die Schichtübergabe.
Welche Helpdesk-Tools bewerten die Agentenqualität mit KI?
Fünf Helpdesks bieten etwas Natives an, und sie unterscheiden sich stärker, als das Marketing vermuten lässt. Ich habe die Dokumentation und Preisseite jedes Anbieters gelesen, daher verwendet die Tabelle unten nur deren Formulierungen und Preise.
| Helpdesk | Was bewertet wird | Wie viel vom Ticket die KI beurteilt | Preis laut Anbieter |
|---|---|---|---|
| Zendesk QA | Jede Interaktion, von Menschen und KI-Agenten; eingebaute Kategorien wie Empathie oder Lösung, plus eigene promptbasierte Kategorien | Was auch immer du in die Scorecard schreibst | QA-Add-on in jedem Suite-Tarif, Preis nicht angegeben; Workforce Engagement Bundle kostet 50 $ pro Agent und Monat bei jährlicher Abrechnung |
| Gorgias Auto QA | Geschlossene Tickets, bewertet 12 Stunden nach dem Schließen | 3 Kriterien (Vollständigkeit der Lösung, Kommunikation, Sprache); 4 weitere (Genauigkeit, Effizienz, interne Compliance, Markenstimme) nur manuell | Standardmäßig aktiv mit einem AI-Agent-Abonnement, das 1,50 $ pro automatisierter Interaktion über dem Tariflimit kostet |
| Front Smart QA | Jedes Ticket anhand anpassbarer Scorecards, plus Smart CSAT | Kriterien, die du definierst | Als im Enterprise-Tarif enthalten angegeben, 105 $ pro Platz und Monat bei jährlicher Abrechnung |
| HubSpot QA score | Geschlossene Help-Desk-Tickets, 1 bis 5 | 3 Kriterien (Ton, Klarheit, Empathie); Beta | Service Hub Enterprise, 150 $ pro Platz und Monat |
| Freshdesk Quality Coach | Gelöste Konversationen, den Agenten im Posteingang angezeigt, plus ein Quality-Score-Bericht für Admins | 6 Parameter (Eröffnung und Abschluss, Pünktlichkeit, Antwortqualität, Stimmung, Grammatik, Füllwörter) | In den Freddy-Copilot-Einstellungen aktivierbar; Freddy AI Copilot kostet 29 $ pro Agent und Monat in Pro und Enterprise |
Ein paar Dinge, die mir beim direkten Vergleich aufgefallen sind:
- Zendesk ist am flexibelsten und beim Preis am wenigsten transparent. Du schreibst die Kriterien selbst, und Spotlight markiert Abwanderungsrisiken und festgefahrene Schleifen. Das AI Agent QA vergleicht außerdem die Werte von Bots und Menschen nebeneinander. Der Preis dafür ist ein Verkaufsgespräch. Die Einrichtung gehe ich in Zendesk-QA-Scorecard-Kriterien und Zendesk QA für KI-Agenten durch.
- Gorgias ist bei seinen Grenzen am ehrlichsten. Die Dokumentation sagt klar, dass Genauigkeit und Markenstimme nur manuell bewertet werden können, dass benutzerdefinierte Kriterien derzeit nicht verfügbar sind und dass Tickets unter 250 Zeichen, Social-Tickets und Telefonanrufe übersprungen werden. Das ist nützlich: Du weißt, welche Hälfte deiner Scorecard weiterhin einen Menschen braucht. Zur Kostenseite siehe Gorgias AI Agent Preise.
- Front bündelt QA mit CSAT-Ableitung, sodass du eine Qualitätssicht und eine KI-abgeleitete Zufriedenheitssicht an einem Ort bekommst. Front-Preise enthält die Tarifdetails.
- Die von HubSpot ist die vorsichtigste. Sie ist in der Beta und nur für Enterprise; ob sich das für den Platzpreis lohnt, klärt HubSpot Service Hub AI.
- Die von Freshdesk ist die älteste, und der Hilfeartikel stammt von 2024, prüfe ihn also gegen deinen Tarif, bevor du einen Prozess darauf aufbaust. Die Tarife stehen in Freshdesk-Preise.
Wenn du keines davon nutzt oder eine herstellerneutrale Sicht willst, vergleicht Tools zur Qualitätssicherung im Kundensupport die eigenständigen QA-Plattformen.
Wie hältst du KI-Bewertungen fair gegenüber Agenten?
Behandle jeden Wert als Signal, das Tickets für einen Menschen zum Lesen auswählt, nie als Urteil. Die Anbieter sagen das selbst: Der Hilfeartikel von HubSpot warnt, dass seine QA-Werte ungenau sein können und nicht die alleinige Grundlage für Coaching, Leistungs-, Vergütungs-, Disziplinar- oder andere Entscheidungen über eine Person sein sollten.
Den Ablauf, den ich fahren würde:
- Bewerte jedes Ticket mit KI. Das ist die Lösung für die Grundgesamtheit aus dem ersten Abschnitt.
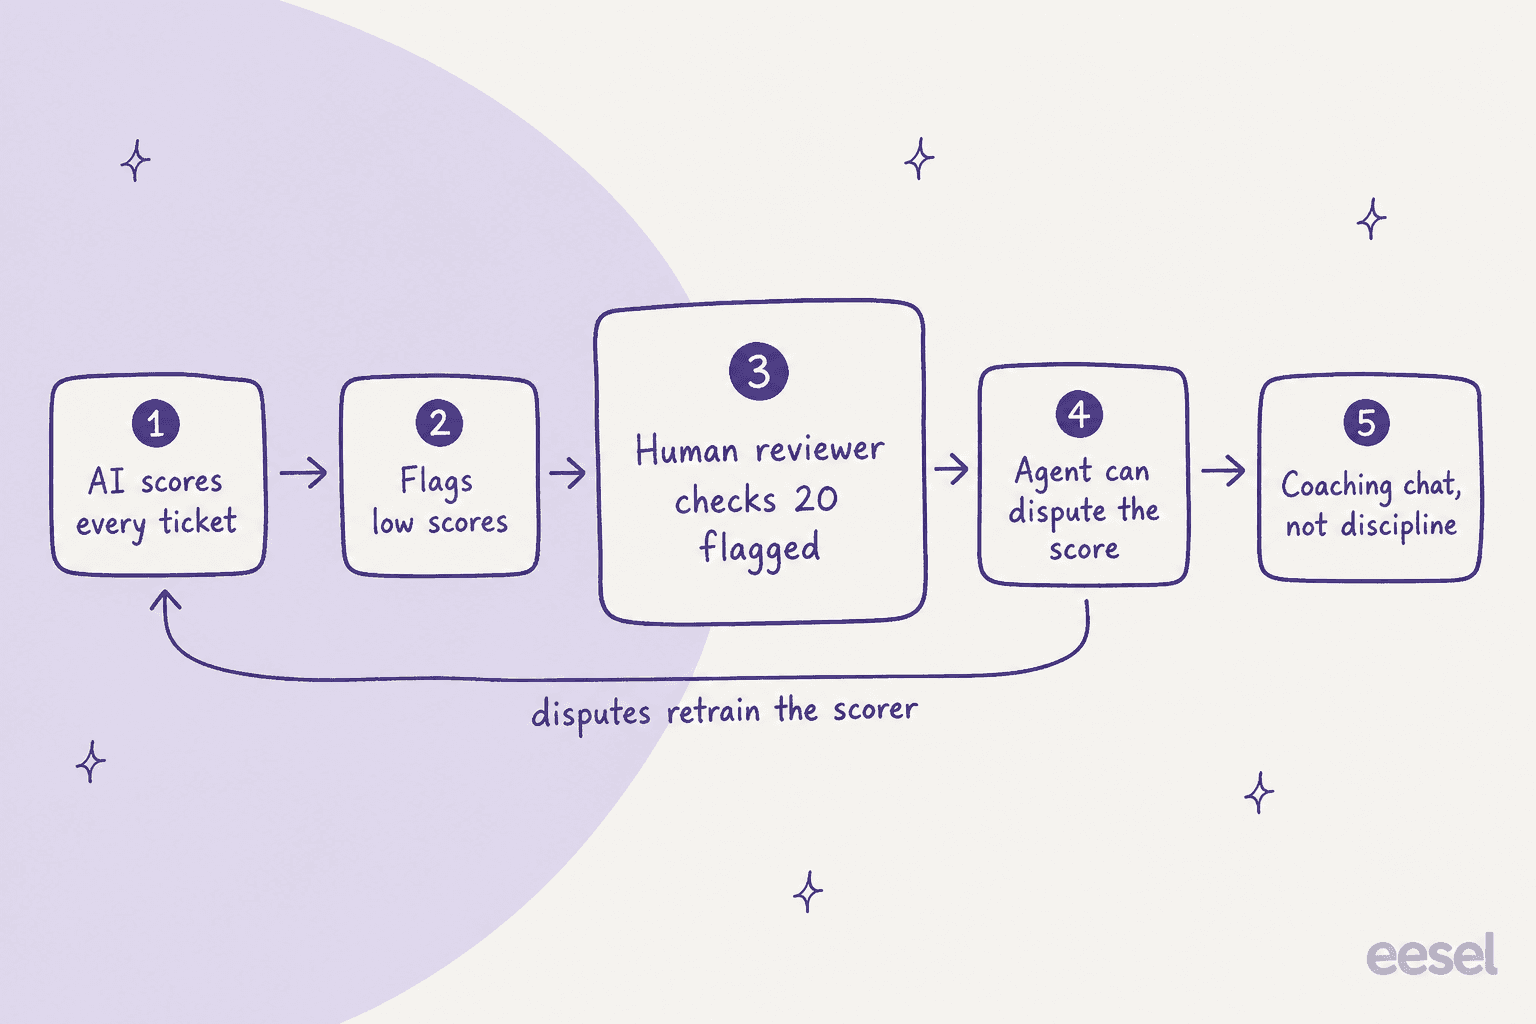
- Lies die markierten selbst. Zwanzig markierte Tickets pro Woche und Team sind besser als fünf zufällige pro Agent, denn du liest dort, wo das Signal ist.
- Kalibriere. Lass zwei Menschen dieselben 20 Tickets bewerten und vergleiche sie dann mit der KI. Wo sie abweichen, korrigiere die Formulierung des Kriteriums, nicht die Personen. Ein G2-Thread dazu fragt genau, wie Teams die menschliche Kalibrierung neben der KI-Bewertung beibehalten, und die übliche Antwort lautet, dass KI der erste Durchgang ist und menschliche Sitzungen bleiben.
- Lass Agenten widersprechen. Gorgias lässt einen Reviewer jeden Teil eines Werts bearbeiten und nutzt diese Änderungen zum Feintuning des Modells. Selbst wenn dein Tool das nicht kann, macht ein Agent, der sagen kann „dieser Wert ist falsch, hier ist der Grund“, das System genauer und vertrauenswürdiger.
- Diszipliniere nie allein aufgrund der Stimmung. Stimmungs- und Tonwerte bestrafen Menschen, die die wütendsten Kunden bekommen, und das ist nach der KI-Entlastung jeder.
Mein Beitrag zu KI-Stimmungsanalyse für den Support erklärt, warum Stimmung ein schlechtes Maß für einen einzelnen Agenten ist. Fairness ist auch der Grund, warum ich einen Bewerter testen würde, bevor ich ihm vertraue, so wie du einen KI-Agenten simulieren würdest.
Wie machst du aus Bewertungen Coaching?
Wähle pro Agent und Monat ein Verhalten, zeige zwei Tickets und vereinbare eine Änderung. Die Bewertungen finden die Tickets; die Arbeit leistet das Gespräch.
Ein 30-Tage-Plan, in der Reihenfolge, in der ich ihn umsetzen würde:
- Woche 1, Grundgesamtheit festlegen. Schalte die KI-QA deines Helpdesks ein und lass sie jedes geschlossene Ticket bewerten. Schau noch nicht auf Rankings pro Agent.
- Woche 2, kalibrieren. Führe die 20-Ticket-Prüfung von oben durch und schreibe jedes Kriterium um, das Menschen und KI unterschiedlich lesen.
- Woche 3, neu gewichten. Wechsle zur Scorecard für die Zeit nach der KI: kein individuelles Volumenziel, Geschwindigkeit pro Tickettyp, eine Zeile für die Prüfung von Entwürfen und Übergaben.
- Woche 4, Einzelgespräche starten. Eine Stärke und eine Gewohnheit pro Agent, mit den zwei Tickets als Beleg. Agenten mit KI coachen und Coaching-Software für den Kundensupport behandeln die Werkzeuge, und KI-Agent-Coaching für den Support behandelt das Coaching der KI selbst.
Bei neuen Mitarbeitenden funktioniert derselbe Ablauf schneller, da KI-Entwürfe als Praxisbeispiele dienen: siehe Onboarding von Kundensupport-Agenten.
Wie passt eesel zur Agentenleistung?
eesel bewertet deine menschlichen Agenten nicht. Es verändert, woran sie arbeiten. eesel ist ein KI-Helpdesk-Teammate, das in deinem bestehenden Helpdesk sitzt, die repetitiven Tickets beantwortet oder entwirft und den Rest mit einer Notiz an einen Menschen übergibt, sodass die Bewertung, die du für dein Team aufbaust, die verbleibende Arbeit widerspiegelt. eesel betreibt KI seit Jahren in echten Support-Warteschlangen, und jede Einführung wird zuerst gegen historische Tickets simuliert. Das liefert dir die Vorher-nachher-Sicht auf die menschliche Warteschlange, die eine faire Scorecard braucht.
Drei veröffentlichte Kundengeschichten zeigen das Muster auf verschiedenen Helpdesks:
- Gorgias: Bei Question Beauty hat eesel in einem Monat etwa 960 Antworten gesendet und etwa 280 von 990 Tickets geschlossen; etwa 250 gingen mit bereits angehängter Bestellabfrage an einen Menschen.
- Zendesk: smava bearbeitet etwa 27.000 Tickets pro Monat in einem Zendesk für zwei Marken. eesel hat etwa 14.600 davon kategorisiert und etwa 15.300 Entwürfe vorbereitet, und Menschen genehmigen oder leiten jeden Entwurf um.
- Freshdesk: Bei SamCart antwortet eesel nur auf Tickets, solange kein Agent zugewiesen ist, und sobald ein Teammitglied das Ticket übernimmt, endet der Anteil der KI. Das ist eine klare Linie, um zu entscheiden, wessen Tickets auf wessen Scorecard gehören.

Um die KI selbst zu beurteilen, nutze die Scorecard für KI-Support-Piloten, den Leitfaden zur KI-Lösungsquote und Eindämmung und Eskalationsqualität. Zur Kostenseite bietet KI-Agent versus menschlicher Agent: Kosten den Vergleich.
Teste eesel für die Tickets, nach denen dein Team nicht bewertet werden sollte
Wenn deine Agenten nach Passwort-Resets und Fragen zum Bestellstatus bewertet werden, gib diese zuerst an eesel ab und gewichte die Scorecard um das, was übrig bleibt, neu. eesel verbindet sich mit Zendesk, Freshdesk, Gorgias, HubSpot und Front und lernt aus deinem Help Center und vergangenen Tickets.
Die eesel-Preise sind feste Credit-Tarife: Ein Ticket oder ein Chat kostet 1 Credit, egal wie lang er dauert, der kostenlose Tarif enthält 100 Credits, um alle Funktionen zu testen, und bezahlte Tarife beginnen bei 299 $ im Monat für 500 Credits. Teste eesel mit deinen eigenen Tickets und sieh, wie viel deiner Warteschlange die einfache Sorte ist.