

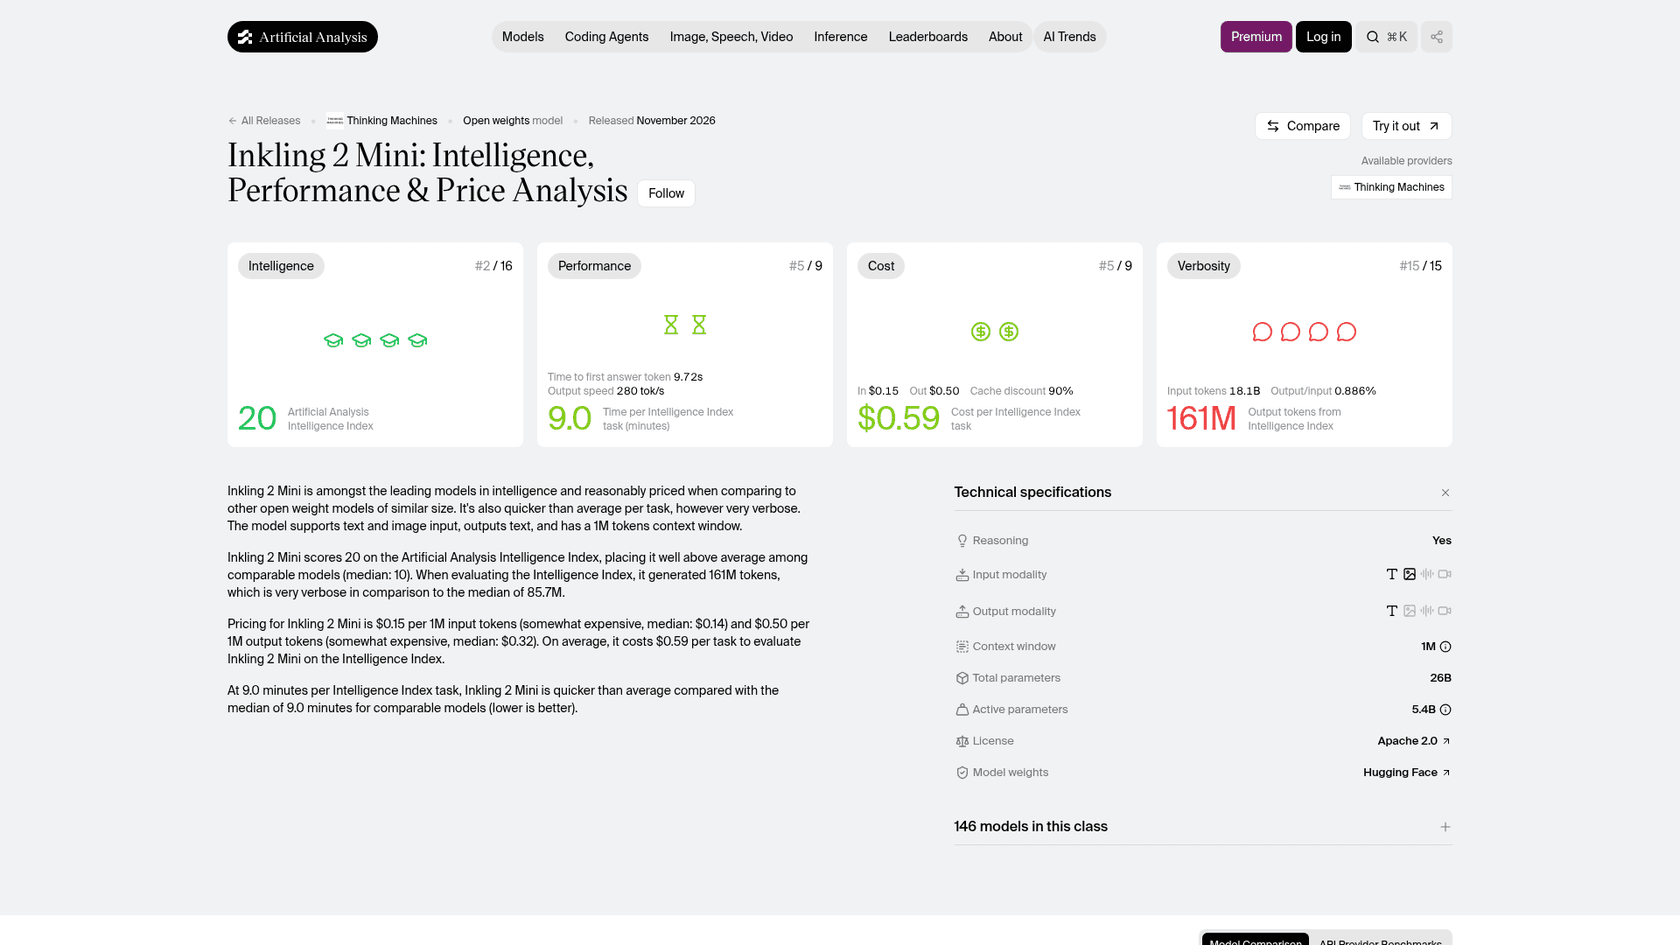
Inkling 2 Minis Schlüsselzahl ist die Kosten pro Aufgabe: Artificial Analysis bewertet es mit 20 Punkten, gleichauf mit Qwen3.8-27B, bei 0,59 $ pro Aufgabe gegenüber 3,53 $ und 9,0 Minuten pro Aufgabe gegenüber 34,5. Es ist ein geloopftes Modell mit 26,4B Parametern unter Apache 2.0, das in etwa 20 GB passt. Der Tausch betrifft das Wissen: Das Lab nennt es weniger leistungsfähig als Inkling 2 Small bei den meisten Auswertungen, und es gibt falsche Fakten selbstsicherer wieder.
Für Support-Teams macht das es zu einer schnellen, günstigen Engine, die trotzdem Verankerung in Ihrem Hilfecenter und einen Test an vergangenen Tickets braucht, und genau das ist die Aufgabe, die eesel rund um jedes Modell übernimmt, das Sie wählen.
Was ist Inkling 2 Mini?
Inkling 2 Mini ist das kleinere Geschwistermodell von Inkling 2 Small in der zweiten Generation von Thinking Machines Lab, angekündigt am 20. November 2026. Es hat 26,4B Gesamtparameter, nimmt Text und Bilder als Eingabe, gibt Text aus und erscheint mit offenen Gewichten. Seine Hugging-Face-Modellkarte nennt Apache 2.0 und einen Kontext von 1 Mio. Tokens.
Ich baue bei eesel Funktionen und KI-Agenten, deshalb lese ich bei einem neuen Modell zuerst, wie es gebaut ist, bevor ich die Benchmark-Tabelle lese. Mini ist dabei ungewöhnlich, was ich weiter unten behandle. Das ist auch, warum eesel ein Kommandozeilen-Tool hat: Mit der eesel CLI kann ein KI-Coding-Agent genehmigtes Wissen wie exportierte Hilfeartikel und gespeicherte Antworten hochladen, die Anweisungen des Support-Agenten ändern und Testfragen stellen, bevor irgendetwas live geht, egal welches Modell darunterliegt. Den Helpdesk selbst anzubinden, muss aber weiterhin jemand mit Admin-Zugriff freigeben.
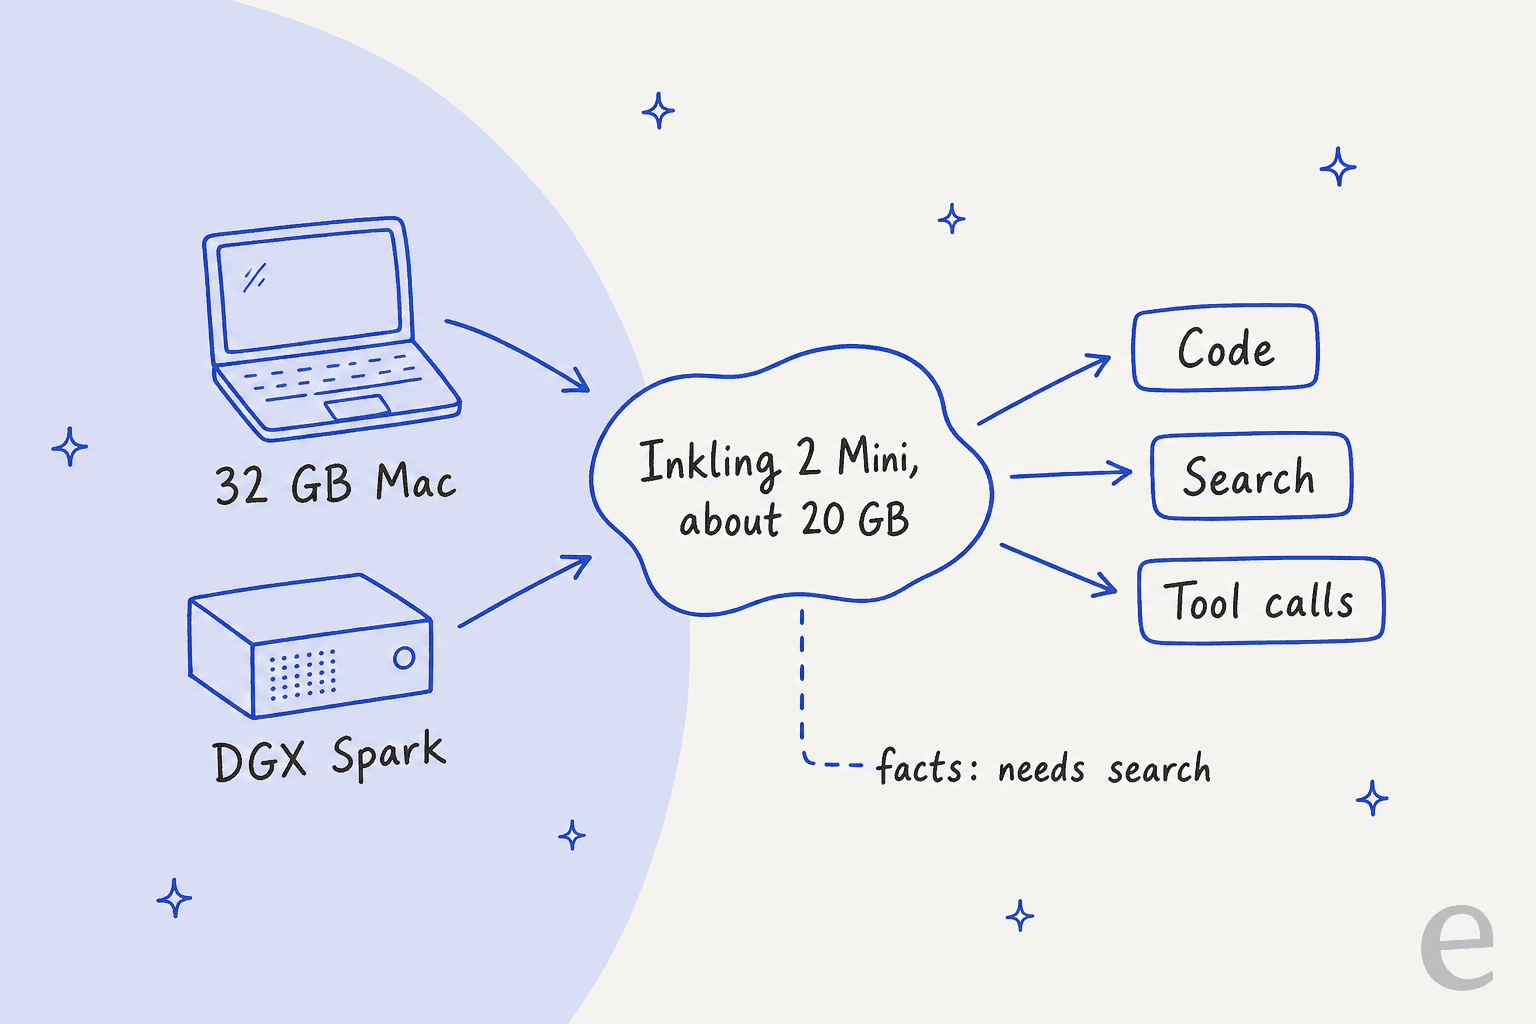
Die Zahlen, die auf der Karte zählen: 3,4B Parameter aktiv pro Token, ein Checkpoint von etwa 20 GB und eine Forschungsvariante namens TML-d24-varloop-research, mit der Sie wählen können, wie viele Loop-Durchläufe das Modell ausführt. Die Karte nennt einen NVIDIA DGX Spark oder Apple-Silicon mit 32 GB Speicher als Zielhardware.
Eine Sache vorab. Der Ankündigungstext nennt 3,4B aktive Parameter, während die Spec-Tabelle und Artificial Analysis 5,4B nennen. Beide haben auf ihre Art recht: 3,4B sind gespeichert und aktiv, und 5,4B ist die Zahl, wenn man die Schichten dazurechnet, die dreimal laufen.
Wie schneidet Inkling 2 Mini im Vergleich zu Inkling 2 Small ab?
Mini ist kleiner, günstiger pro Aufgabe und schneller, dafür bei den meisten Tests schwächer. Die Specs stammen von den jeweiligen Modellkarten, die Preise von der Tinker-Preisseite, und Scores und Geschwindigkeiten von Artificial Analysis' Small- und Qwen3.8-27B-Seiten, zusätzlich zur unten gezeigten Mini-Seite.
| Inkling 2 Mini | Inkling 2 Small | Qwen3.8-27B | |
|---|---|---|---|
| Veröffentlicht | 20. Nov. 2026 | 5. Nov. 2026 | Aug. 2026 |
| Gesamt- / aktive Parameter | 26,4B / 3,4B (5,4B mit Loops) | 594B / 17B | 27B |
| Eingabe | Text, Bild | Text, Bild | n/a |
| Kontext (Karte) | 1M | 1M | n/a |
| Lizenz | Apache 2.0 | Apache 2.0 | n/a |
| Eingabe / zwischengespeichert / Ausgabe pro 1 Mio. | $0.15 / $0.015 / $0.50 | $0.30 / $0.03 / $1.00 | $0.50 / n/a / $3.00 |
| AA Intelligence Index v5.0.1 | 20 | 31 | 20 |
| Ausgabegeschwindigkeit (AA) | 280 Tokens/s | 118 Tokens/s | 53 Tokens/s |
| Zeit bis zum ersten Antwort-Token (AA) | 9,7s | 39,7s | 144,1s |
| Minuten pro AA-Index-Aufgabe | 9,0 | 21,2 | 34,5 |
| Kosten pro AA-Index-Aufgabe | $0.59 | $1.18 | $3.53 |
| Ausgabe-Tokens im Index-Lauf | 161M | 154M | nicht verglichen |
Die Qwen-Spalte ist Artificial Analysis' eigene Angabe, und „n/a" heißt, dass ich diese Zelle nicht verifiziert habe. Zwei Vorbehalte zur Mini-Spalte. Erstens steht Mini nicht auf Tinkers Liste für serverless Inference, und Artificial Analysis zeigt keine öffentliche API dafür, die Kosten pro Aufgabe sind also der Tinker-Sampling-Satz angewendet auf gemessene Tokens, kein Preis, den Sie heute kaufen können. Zweitens schrieb Mini 161M Tokens im Index-Lauf, mehr als Smalls 154M und fast doppelt so viel wie der Median von 85,7M, den Artificial Analysis für vergleichbare Modelle angibt. Das sagt deutlich, dass das Modell sehr weitschweifig ist.
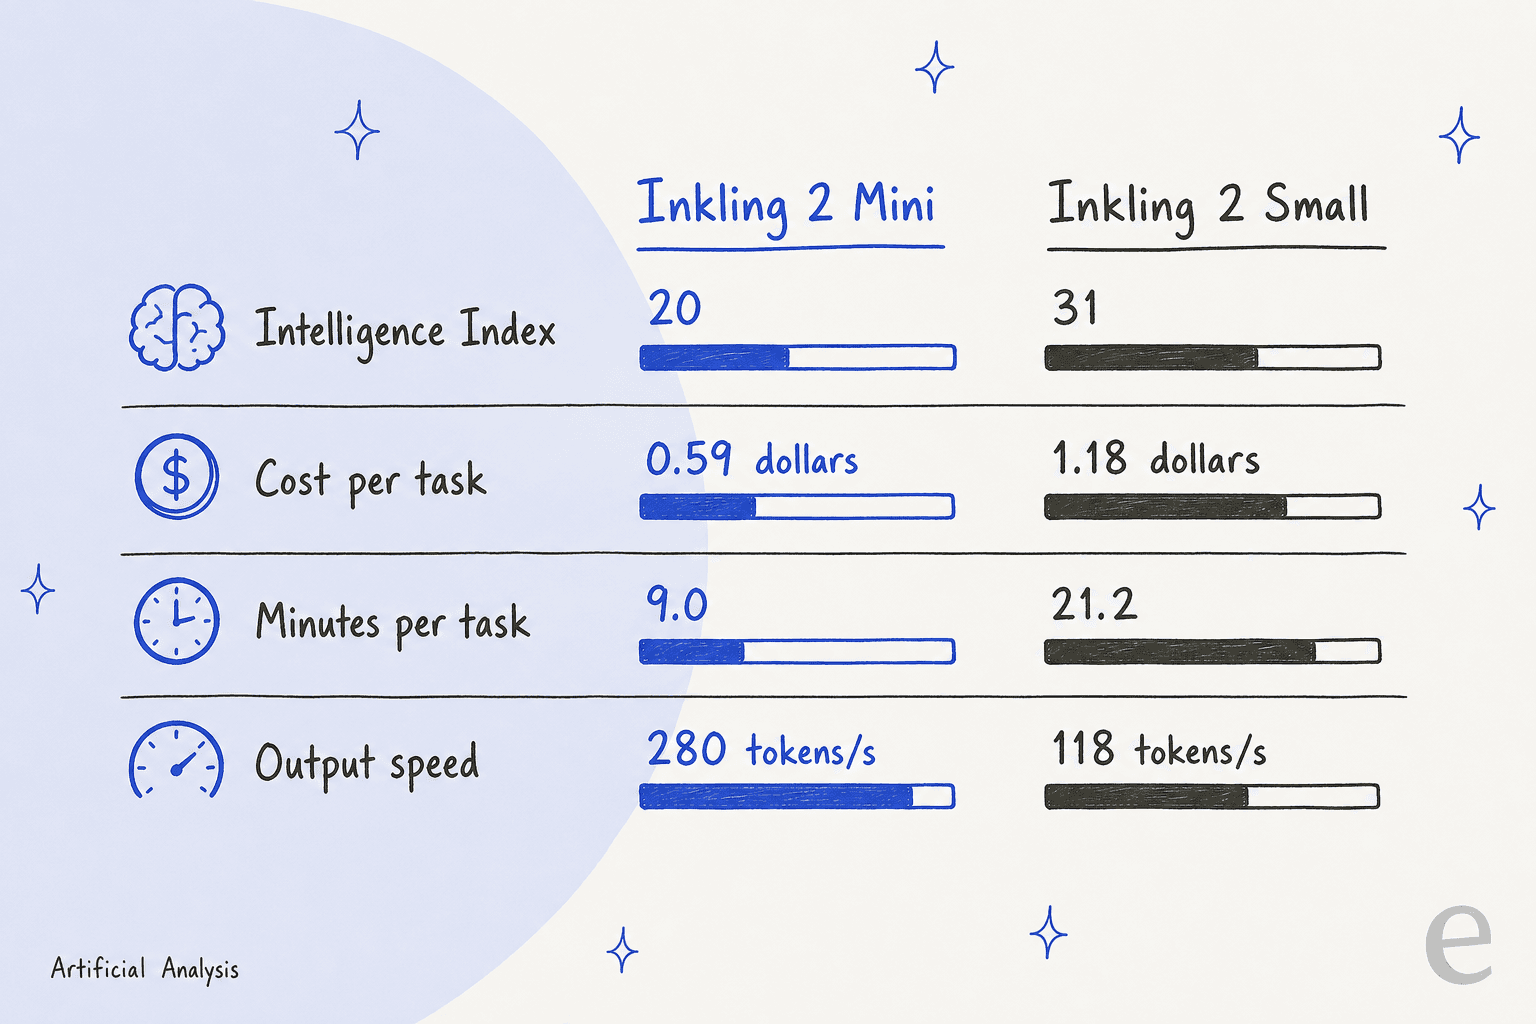
Mini liegt 11 Punkte unter Small und kostet halb so viel pro Aufgabe. Die eigene Karte des Labs sagt es deutlicher: Das Modell sei „bei den meisten unserer Auswertungen weniger leistungsfähig als Inkling 2 Small", mit den größten Lücken beim Faktenwissen. Die Ausnahme ist lange agentische Arbeit, wo das Lab sagt, Mini „nähere sich" Small bei seinem PMPP-Hard-Test an. Die älteren Familienmitglieder werden in den Beiträgen zu Inkling, Inkling-Small und Inkling 2 Small behandelt.
Eine Korrektur zum Small-Bild, das ich früher geschrieben habe. Zum Start waren Smalls Gewichte geschlossen. Sie sind seitdem auf Hugging Face unter Apache 2.0 erschienen, und Artificial Analysis listet jetzt DeepInfra, Nebius und Together als Hoster, mit Geschwindigkeits- und Kostenzahlen, die sich dadurch verschoben haben. Ich verwende oben die aktuellen Zahlen.
Wie funktioniert ein geloopftes Modell?
Ein geloopfter Transformer nutzt dieselben Schichten mehr als einmal pro Token. Inkling 2 Mini speichert 24 Schichten in vier Blöcken zu je sechs, und die beiden mittleren Blöcke laufen dreimal, sodass jedes Token 48 Schicht-Durchläufe passiert. Die Modellkarte sagt, das Loopen der mittleren Schichten habe das Loopen der letzten Schichten bei 27 von 28 Auswertungen übertroffen.
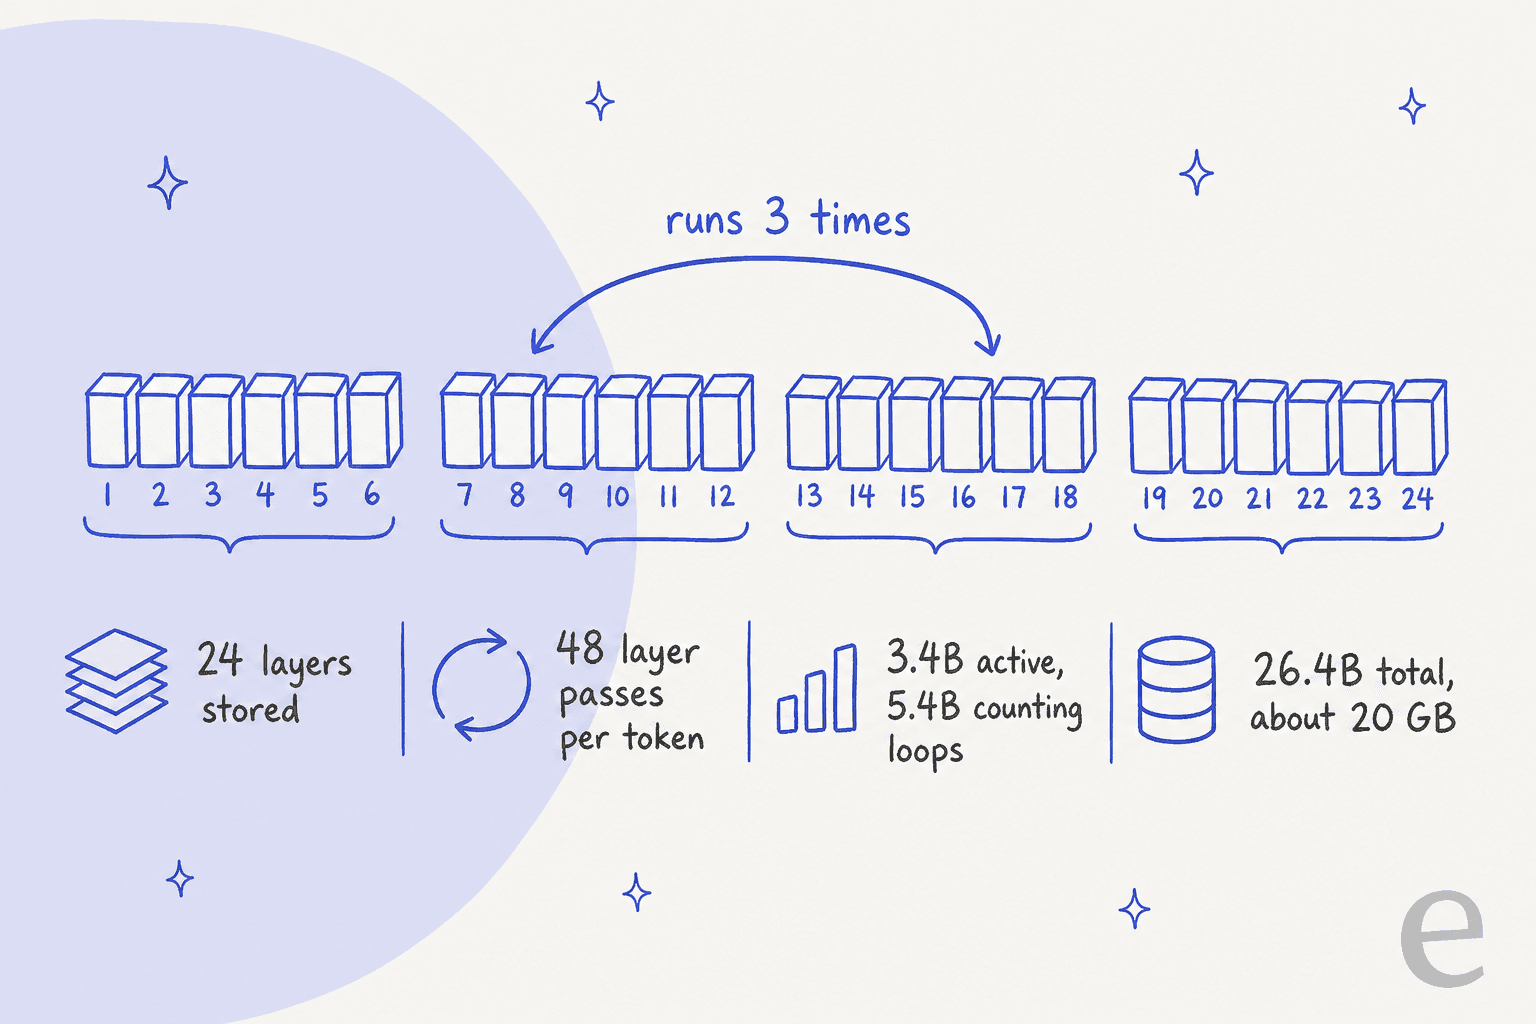
Der Punkt ist der Speicher. Telefone, Laptops und kleine Server sind durch die Menge an Gewichten begrenzt, die sie halten können, nicht durch die Rechenleistung, die sie aufbringen können. Das Wiederverwenden von Schichten kauft zusätzliches Denken pro Token, ohne die Datei zu vergrößern. Drei weitere Details von der Karte:
- Training. Expertenschichten wurden in NVFP4 (4-Bit) vom Pretraining bis zum Reinforcement Learning trainiert, und die letzten vier Schichten in 8-Bit, sodass die ausgelieferten Gewichte den trainierten entsprechen, ohne Konvertierungsschritt.
- Schrumpfen. Das Lab hat das Modell auf halbem Weg durchs Training von 384 auf 128 Experten pro Schicht reduziert und es dann mit 1T Tokens Distillation von einem größeren internen Inkling-Modell geheilt.
- Der Haken. Loopen fügt kein Wissen hinzu. Das Lab schreibt, Wissen sei größtenteils eine Funktion der Gesamtparameterzahl, Fakten verbessern sich also nicht mit mehr Durchläufen.
Diese letzte Zeile ist die, die man für den Rest dieses Beitrags im Kopf behalten sollte.
Was kostet Inkling 2 Mini?
Auf Tinker samplet Inkling 2 Mini zu 0,15 $ pro 1 Mio. Eingabe-Tokens, 0,015 $ pro 1 Mio. zwischengespeicherte Eingabe-Tokens und 0,50 $ pro 1 Mio. Ausgabe-Tokens. Fine-Tuning („train") kostet 0,75 $ pro 1 Mio. Tokens bei 64K Kontext und 1,50 $ bei 256K. Inkling 2 Small ist beim Sampling genau doppelt so teuer. Die Preise stammen von der Tinker-Preisseite des Anbieters; ich habe keinen Drittanbieter-Preis verwendet.
Drei Dinge verändern die tatsächliche Rechnung:
- Serverless ist für Mini nicht offen. Die Preisseite beschränkt serverless Inference auf Inkling 2 Small, Inkling und Inkling-Small, und die OpenRouter-Seite zeigt keinen Preis. Heute sind die realistischen Wege Tinker-Sampling oder die eigene Hardware.
- Weitschweifige Ausgabe frisst die Ersparnis. Der Preis pro Token ist halb so hoch wie bei Small, aber Mini schreibt etwa genauso viele Tokens pro Aufgabe, sodass die Lücke pro Aufgabe zu Small etwa 2x beträgt, dasselbe Verhältnis wie bei den Preisen pro Token. Ausgabe-Tokens sind die Einheit, die über die Rechnung entscheidet.
- Lokal ist eine andere Rechnung. Auf der eigenen Maschine sind die Kosten Hardware und Zeit, keine Tokens, und genau für diesen Fall hat das Lab Mini gebaut.
Für eine Budgetsicht im Support zeigt der Leitfaden Kosten von KI im Kundenservice, wie der Modellpreis neben Sitzplätzen, Lösungen und Einrichtung steht.
Wo hat Inkling 2 Mini Schwächen?
Wissen, Mehrfach-Chats und Terminal-Sitzungen. Das Lab berichtet seine eigenen Lücken, was Anerkennung verdient. Auf seiner eigenen Karte liegt Minis AA-Omniscience-Nicht-Halluzinationsrate bei 63,4%, wenn es also auf diesem Test eine Antwort nicht kennt, rät es in etwas mehr als einem Drittel der Fälle, statt es zu sagen. Die Karte stellt Mini außerdem hinter Qwen3.8-27B bei MultiChallenge (50,0%) und ComplexConstraints (33,4%), und gleichauf bei niedrigen 5,6% bei Terminal Bench 4.0.
Frühe Nutzer bemerkten dasselbe Muster. Ein Hacker-News-Tester ließ einen Coding-Prompt mit abgeschalteten Tools laufen:
"The model burned through 19200 thinking tokens on this task (which was the hard limit I had set) and didn't finish."

Derselbe Nutzer sagte, mit erlaubter Suche sei es zu einer Lösung gekommen, habe aber trotzdem den falschen Hook-Namen verwendet. Ein anderer Kommentator war über Agenten-Benchmarks direkter:
"Big fan of open weights but those Terminal Bench numbers are pretty abysmal."
Der Launch-Thread erreichte 473 Punkte und 72 Kommentare auf Hacker News, und das meiste Lob galt Größe und Geschwindigkeit, nicht der Genauigkeit. Die Lesart des Labs ist, dass Mini die Wissenslücke „überwindet", indem es Suche und Tools nutzt, was zu dem passt, was der Tester sah: Es wurde besser, sobald es nachschlagen konnte.
Wo Mini tatsächlich führt, ist agentische Arbeit, die größtenteils aus Suche und Tool-Calls besteht. Das Lab berichtet 79,2% bei SWE-bench Verified (nur Bash), gegenüber 77,8% für Qwen3.8-27B, plus 79,0% bei BrowseComp und 82,7% bei MCP Atlas. Das sind die Zahlen des Labs, gelaufen auf seinem eigenen Harness, deshalb würde ich auf externe Läufe warten, bevor ich sie als gesichert behandle. Gemini 3.8 Flash, DeepSeek V4 Flash und Kimi K3 sind die größeren gehosteten Optionen, wenn Sie keine lokalen Gewichte brauchen.
Lässt sich Inkling 2 Mini auf einem Laptop betreiben?
Ja, und das ist für die meisten Entwickler die eigentliche Schlagzeile. Die Modellkarte sagt, ein DGX Spark oder eine Apple-Maschine mit 32 GB oder mehr Unified Memory reiche aus, und es gibt quantisierte GGUF-Builds für llama.cpp, Ollama und ähnliche Apps. Das Lab zitiert außerdem eine Stanford-Effizienzstudie auf einem DGX Spark, bei der Mini 0,703 bei seinem Intelligenz-pro-Watt-Maß erreichte, gegenüber 0,430 für Qwen3.6-35B-A3B.
Die reale Geschwindigkeit ist weniger klar. Das Lab hat für seine Laptop-Demo keine Tokens-pro-Sekunde-Zahl veröffentlicht. Ein Hacker-News-Nutzer mit einer älteren Maschine berichtete:
"I'm getting 20 tokens/s running the 4-bit version on my 2021 M1 Max MacBook pro with 64Gb."
Ein anderer Kommentator merkte an, dass llama.cpp einen separaten Pull Request brauchte, um Loop-Unterstützung hinzuzufügen, eine veraltete Runtime das Modell also eventuell nicht lädt. Für andere Runtimes siehe llama.cpp-Alternativen. Die 280 Tokens pro Sekunde, die Artificial Analysis listet, sind eine gehostete Messung, nicht das, was ein Laptop leisten wird.
Lohnt sich Inkling 2 Mini für den Support?
Es lohnt sich, es als Engine zu testen, nicht als Agent. Ein Support-Agent ist ein Modell plus Ihre Dokumente, Ihre Tools, Ihre Übergaberegeln und eine Möglichkeit, es zu prüfen, bevor Kunden es sehen. Minis Versprechen (günstig, schnell, stark mit Tools) passt zu den werkzeugintensiven Teilen, und seine Schwäche (selbstsichere falsche Fakten) ist der Teil, den Sie nicht unbeaufsichtigt lassen können. Eine Halluzination in einer Rückerstattungsantwort kostet weit mehr als die Tokens, die Sie gespart haben.
Deshalb behandelt eesel das Modell als austauschbar. Ein KI-Helpdesk-Teammitglied tritt Ihrer bestehenden Warteschlange bei, lernt aus Ihrem Hilfecenter und vergangenen Tickets und wird an historischen Tickets simuliert, bevor es live geht, sodass eine neue Engine an Ihren Fragen beurteilt wird, nicht an der Tabelle eines Labs. SamCart ist ein gutes Beispiel für diesen Aufbau. Es betreibt einen Agenten auf Freshdesk-Tickets und einen weiteren im Website-Chat, beide antworten aus rund 280 Hilfecenter-Artikeln. Bei Tickets antwortet der Agent nur, bis ein Teammitglied übernimmt, und eine Anfrage nach einem Menschen beendet seinen Zug. Nichts davon hängt davon ab, welches Modell darunterliegt.
Wenn Sie Mini selbst ausprobieren möchten, geben Sie ihm zuerst eine begrenzte Aufgabe:
- Wählen Sie eine enge Aufgabe, etwa das Entwerfen von Antworten aus einem festen Artikel-Set.
- Begrenzen Sie Ausgabe und Züge, wie es die Modellkarte empfiehlt, weil die minimale Reasoning-Einstellung das Reasoning nicht vollständig abschaltet.
- Spielen Sie vergangene Tickets ab und vergleichen Sie mit Ihren menschlichen Antworten, wie in KI-Support-Simulationstests und KI-Support-Agent-Tests.
- Begrenzen Sie, was es tun kann, mit den Ideen aus KI-Support-Agent-Berechtigungen.
- Beobachten Sie es nach dem Start, mit den Traces, die in KI-Support-Agent-Observability beschrieben sind.
Für eine breitere Auswahl vergleichen die besten KI-Modelle für Support-Tickets und die besten KI-Kundensupport-Agenten Modelle und Produkte bei support-spezifischen Tests, und der Leitfaden Freshdesk-KI-Agent zeigt, wie eine Helpdesk-native Option aussieht.
Möchten Sie ein Modell, das Sie tauschen können, ohne Ihren Support-Aufbau neu zu bauen? eesel testen: Es funktioniert wie eine neue Mitarbeiterin, die sich in Minuten in Ihren Helpdesk einbindet, Ihr Hilfecenter schon kennt und an Ihren vergangenen Tickets getestet wird, bevor sie mit einem Kunden spricht.
Was sollten Sie noch lesen?
Verfolgen Sie die Inkling-Familie? Das sind die nächstverwandten Beiträge:
- Die Inkling-2-Small-Review, der nächste Vergleich zu diesem Beitrag.
- Die Inkling-Small-Review und die Inkling-Review für die erste Generation.
- Inkling-Small-Alternativen, wenn Sie zwischen kleinen offenen Modellen wählen.
- Glossareinträge zu Large Language Models, Fine-Tuning, KI-Agenten und RAG.