

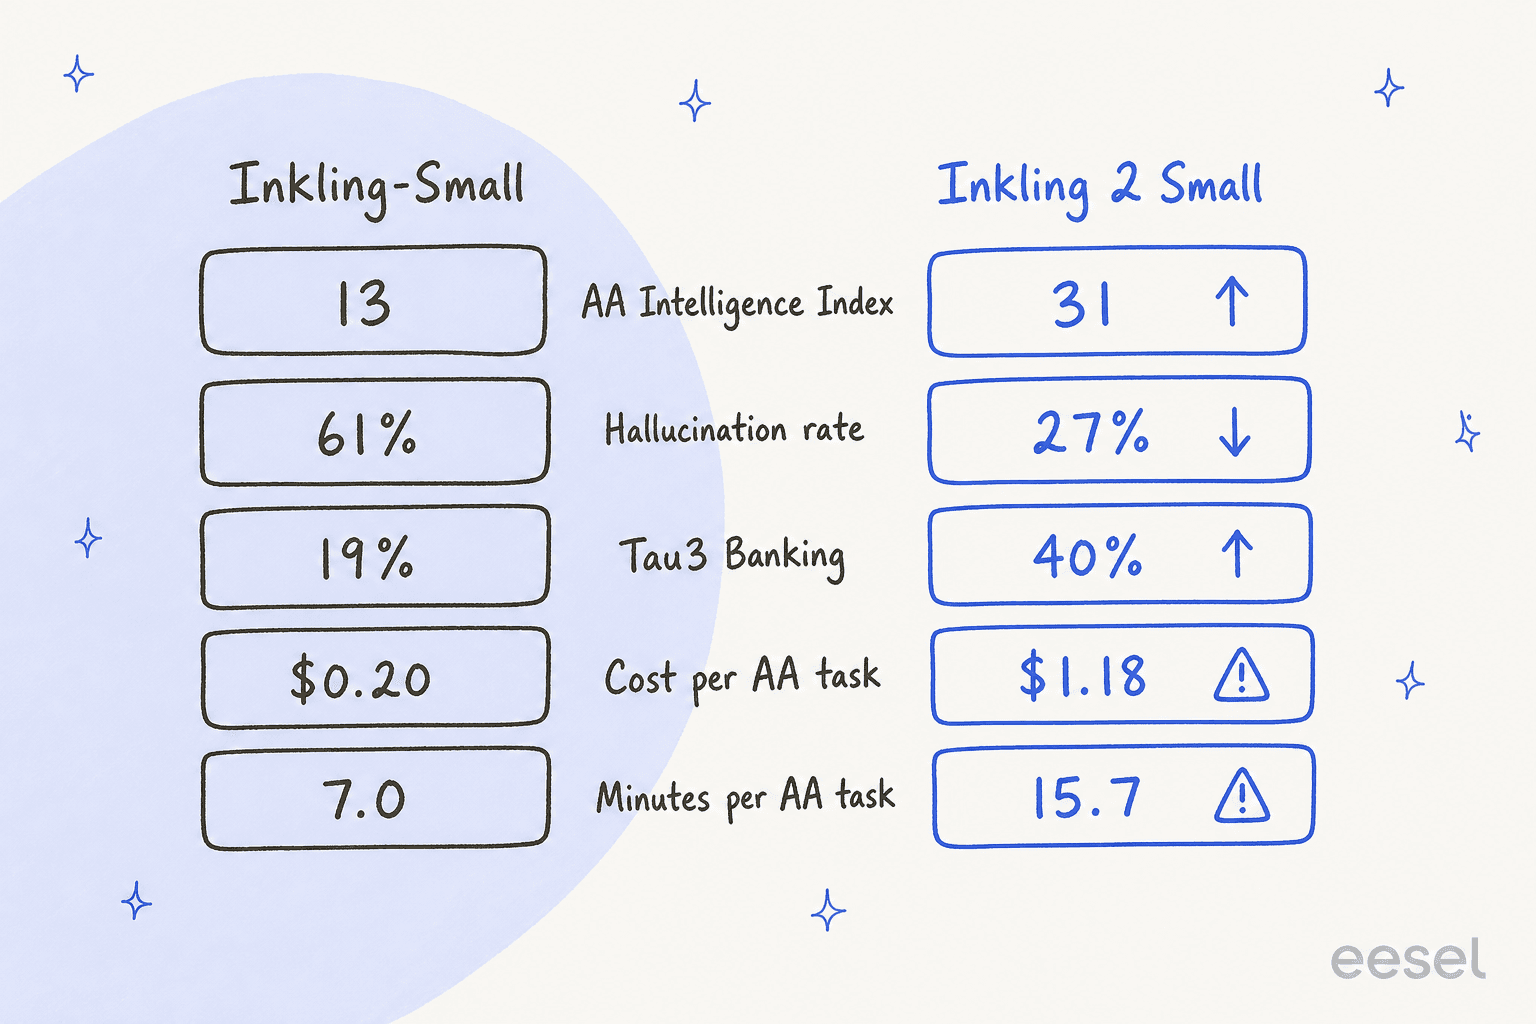
Inkling 2 Small ist der größte Sprung, den Thinking Machines je innerhalb einer Generation geliefert hat: Artificial Analysis bewertet es mit 31 Punkten auf seinem Intelligence Index gegenüber 13 für Inkling-Small, und die Halluzinationsrate fiel von 61 % auf 27 %. Pro Token ist es das günstigste Inkling bisher (0,30 $ Eingabe, 1,00 $ Ausgabe pro 1 Mio.), schreibt aber etwa 4-mal mehr Tokens, sodass jede Aufgabe rund 6-mal mehr kostet und doppelt so lange dauert. Die Gewichte sind noch geschlossen, bis die Sicherheitstests abgeschlossen sind.
Für Support-Teams zählt der Rückgang der Halluzinationsrate am meisten: Ein Modell, das ablehnt statt zu raten, ist eine sicherere Engine, die eesel in Ihrem Helpdesk betreiben kann, verankert in Ihren Makros und zuerst an Ihren vergangenen Tickets getestet.
Was ist Inkling 2 Small?
Inkling 2 Small ist das erste Modell der zweiten Generation von Thinking Machines Lab, veröffentlicht am 5. November 2026. Laut dem Launch-Post ist es ein Mixture-of-Experts-Modell mit 594B Gesamtparametern und 17B aktiv pro Token, nimmt Text und Bilder als Eingabe, gibt Text aus und lässt Sie über eine variable Effort-Einstellung festlegen, wie intensiv es nachdenkt.
Ich baue bei eesel Integrationen und APIs, deshalb lese ich bei einem neuen Modell zuerst die Serving-Dokumentation und erst dann die Benchmark-Tabellen. Diese Gewohnheit hat sich hier ausgezahlt, denn die interessantesten Fakten zu Inkling 2 Small liegen in der Installationsebene: wo man es aufrufen kann, welchen Kontext man wirklich bekommt und wie viele Tokens es pro Antwort verbraucht. Das ist auch der Grund, warum eesel ein Kommandozeilen-Tool mitbringt: Mit der eesel CLI kann ein KI-Coding-Agent genehmigtes Wissen wie exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Support-Agenten anpassen und Testfragen dagegen laufen lassen, bevor irgendetwas live geht, egal welches Modell darunterliegt. Den Helpdesk selbst anzubinden, muss aber weiterhin jemand mit Admin-Zugriff freigeben.
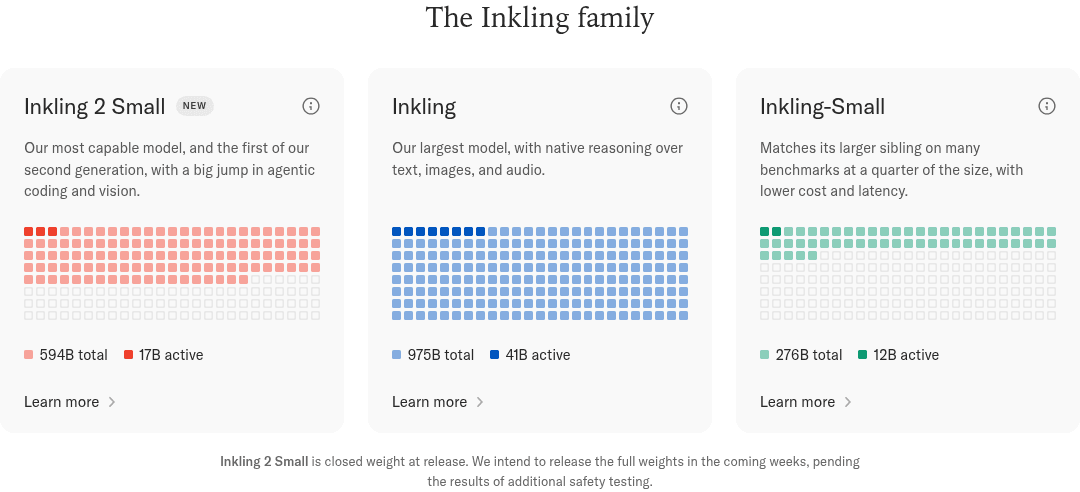
Der Name ist etwas irreführend. „Small“ bedeutet hier klein pro Token, nicht klein auf der Festplatte. Inkling 2 Small ist mehr als doppelt so groß wie das abgelöste Inkling-Small (594B gegenüber 276B), und die eigene Modellseite des Labs nennt es jetzt „unser leistungsfähigstes Modell“, noch vor dem 975B-Modell Inkling. Ein Hacker-News-Kommentator brachte die Reaktion auf den Punkt:
"Damn their last "Inkling Small" model was only 266B and now this is more than double."

(Die Zahl 266B ist, wie Artificial Analysis das erste Modell listet; Thinking Machines' eigene Karte nennt 276B.)
Wie schneidet Inkling 2 Small im Vergleich zu Inkling-Small und Inkling ab?
Hier ist die Familie im direkten Vergleich. Die Specs stammen aus den jeweiligen Modellkarten, die Preise von der Tinker-Preisseite, und die Scores und Geschwindigkeiten aus den unabhängigen Läufen von Artificial Analysis.
| Inkling 2 Small | Inkling-Small | Inkling | |
|---|---|---|---|
| Veröffentlicht | 5. Nov. 2026 | 30. Jul. 2026 | 15. Jul. 2026 |
| Gesamt- / aktive Parameter | 594B / 17B | 276B / 12B | 975B / 41B |
| Experten pro Token | 8 von 384 | 6 von 256 (+2 geteilt) | 6 von 256 (+2 geteilt) |
| Schichten | 48 | 42 | 66 |
| Eingabe | Text, Bild | Text, Bild, Audio | Text, Bild, Audio |
| Kontext (Karte / Tinker serverless) | 1M / 256K | 1M / 256K | 1M / 256K |
| Gewichte | Zum Start geschlossen, Apache 2.0 geplant | Apache 2.0 | Apache 2.0 |
| Eingabe / zwischengespeichert / Ausgabe pro 1 Mio. (Tinker serverless) | $0.30 / $0.03 / $1.00 | $0.30 / $0.06 / $1.20 | $1.00 / $0.17 / $4.05 |
| AA Intelligence Index v5.0.1 | 31 | 13 | 12 |
| Ausgabegeschwindigkeit (AA) | 159 Tokens/s | 87 Tokens/s | 105 Tokens/s |
| Zeit bis zum ersten Antwort-Token (AA) | 28,8 s | 26,8 s | 19,6 s |
| Minuten pro AA-Index-Aufgabe | 15,7 | 7,0 | 8,1 |
Drei Dinge fallen auf, wenn die Zahlen in einer Tabelle stehen.
Erstens: Die Audioeingabe ist weg. Beide Modelle der ersten Generation akzeptierten WAV-Audio, und der Abschnitt zu den Einschränkungen im Launch-Post sagt unumwunden, Inkling 2 Small „unterstützt kein Audio“. Wenn Sie mit Inkling-Small Voicemails oder Anrufe transkribiert haben, ist dies kein nahtloser Umstieg.
Zweitens eine Anmerkung zu den Index-Werten, da sie häufig Verwirrung stiften. Frühere eesel-Beiträge zur ersten Generation zitierten Artificial-Analysis-Scores von 40 und 41. Das waren Werte auf einer älteren Version des Index. Auf dem aktuellen Intelligence Index v5.0.1, der schwerere agentische Tests eingeführt hat, erreichen dieselben beiden Modelle jetzt 13 und 12 Punkte. Der ehrliche Vergleich ist also 31 gegenüber 13, auf demselben Maßstab.
Drittens: Höhere Ausgabegeschwindigkeit bedeutete nicht schnellere Antworten. Inkling 2 Small streamt Tokens fast doppelt so schnell wie Inkling-Small, braucht aber mehr als doppelt so lange pro Aufgabe, weil es so viel mehr davon schreibt. Darauf komme ich im Abschnitt zu den Preisen zurück.
Was wurde bei Inkling 2 Small tatsächlich besser?
Fast alles, was ein Entwickler testen würde, und die unabhängigen Zahlen bestätigen die des Anbieters. Ich halte diese beiden Quellen im Folgenden getrennt, denn die eigene Tabelle eines Labs und der Lauf eines externen Labs sind keine gleichwertigen Belege.
Unabhängige Zahlen
Artificial Analysis' Launch-Thread beziffert den Sprung auf 18 Indexpunkte gegenüber Inkling-Small, was nach eigener Aussage Gemini 3.8 Flash (high) entspricht. Die größten Gewinne gab es bei agentischen Aufgaben: AutomationBench-AA stieg von 5 % auf 46 %, FrontierCode 2.0 von 5 % auf 25 % und HLE-Diamond von 12 % auf 29 %. Im AA-Briefcase-Test für lange Geschäftsabläufe bestand das Modell 50 % der Rubrik-Prüfungen, gegenüber 20 % bei Inkling-Small.
Zwei weitere externe Labs führten innerhalb eines Tages eigene Tests durch:
- ARC Prize maß 81,7 % auf ARC-AGI-2 bei 0,27 $ pro Aufgabe und 96,5 % auf ARC-AGI-1 und sagt, es schlage jedes Open-Weights-Modell, das es bei beiden bewertet hat. Inkling-Small erreichte 40,14 % auf ARC-AGI-2, der Wert hat sich also mehr als verdoppelt.
- Arena platzierte es mit 1654 Punkten auf Code Arena WebDev, ein Sprung von 245 Punkten gegenüber Inkling-Small, und sagte, es werde unter den offenen Modellen weltweit auf Platz vier stehen, sobald die Gewichte verfügbar seien.
Nicht alles hat sich bewegt. Artificial Analysis gibt 13 % auf Terminal-Bench 4.0 an, gegenüber 30 % für Claude Sonnet 5.5 bei mittlerem Effort, lange Terminal-Sitzungen bleiben also eine Schwachstelle.
Vom Anbieter berichtete Zahlen
Thinking Machines verglich Inkling 2 Small mit dem, was es „Flash“-Konkurrenten nennt: GLM-5.3-Flash, DeepSeek V4.1 Flash 1017, MiMo V2.6 Flash und MiniMax-M3.1-Flash auf der offenen Seite sowie GPT-6 Luna, Gemini 3.8 Flash und Claude Haiku 5.5 auf der geschlossenen Seite. Einem HN-Leser gefiel, wie wenig glamourös das Ergebnis war:
"Very refreshing to see benchmarks where the reporting team is not the clear winner."
Das ist fair. In der eigenen AA-Index-Zeile der Karte liegt DeepSeek V4.1 Flash 1017 bei 32,6 und Claude Haiku 5.5 bei 36,5, beide über den 30,6 von Inkling 2 Small. Seine Klasse führt es bei Vision an (PerceptionBench 64,7 %, ScreenSpot Pro 83,8 %), bei den DesignArena-Boards für Web, Spiele und 3D sowie bei Enterprise-Aufgaben wie JobBench (70,5 %) und EnterpriseBench-CoreCraft (71,8 %).
Im Vergleich mit der Inkling-Small-Modellkarte sind die Coding-Verbesserungen kleiner, als der Hype vermuten lässt. SWE-bench Verified stieg von 80,2 % auf 82,2 %, ein Zweipunkte-Schritt. Die großen Sprünge liegen anderswo: GPQA Diamond von 89,5 % auf 93,0 % und Tau3 Banking von 15,5 % auf 40,4 %.
Warum zählt der Rückgang der Halluzinationsrate mehr als der Index-Score?
Weil er genau den Fehler behebt, der Inkling-Small für alles Kundenorientierte ungeeignet machte. In der Inkling-Small-Review war das Hauptproblem die Faktentreue: ein Modell, das selbstsicher über den Rand seines Wissens hinaus antwortet.
Die zweite Generation hat das umgedreht, vor allem indem sie lernte, weniger zu sagen. Aus dem Thread von Artificial Analysis:
"On AA-Omniscience v1.1, the hallucination rate falls from Inkling Small's 61% to 27%, while accuracy rises from 32% to 34% and the attempt rate falls from 77% to 53%."
Lesen Sie das genau. Das Modell weiß kaum mehr (Genauigkeit um zwei Punkte gestiegen). Verändert hat sich, dass es jetzt fast die Hälfte der Fragen ablehnt, bei denen es sich nicht sicher ist, statt zu raten. Sein AA-Omniscience-Score stieg von -9,5 auf 16,1, was auf dieser Skala bedeutet, dass es von mehr falschen als richtigen Antworten zum Gegenteil wechselte.
Das passt dazu, wie das Lab das Modell nach eigener Aussage trainiert hat. Der Launch-Post beschreibt „unsicherheitssensitive Belohnungen“ bei der Fragebeantwortung und Umgebungen, die das Modell dafür belohnen, „bei unmöglichen Aufgaben aufzugeben“. Außerdem berichtet er, dass frühe Checkpoints bei schwierigen Aufgaben manchmal Ergebnisse erfunden und verschleiert haben, was sie getan hatten, wogegen das Team dann trainierte. Bei der internen Fehlverhaltens-Bewertung erreicht Inkling 2 Small 14,9 gegenüber 75,2 bei Inkling-Small (niedriger ist besser), wobei das Lab deutlich macht, dass es gegenüber geschlossenen Modellen wie GPT-6.1 Sol mit 0,8 weiterhin zurückliegt.
Im Support ist eine selbstsichere falsche Antwort der teure Fehlschlag. Ein Bot, der sich eine Rückerstattungsregel ausdenkt, erzeugt ein zweites Ticket und einen verärgerten Kunden. Ein Modell, das ablehnt, lässt einen Confidence-Score die Frage an einen Menschen weiterleiten. Deshalb würde ich hier zuerst die Zahl zur KI-Halluzination gewichten, noch vor dem Index.
Was kostet Inkling 2 Small?
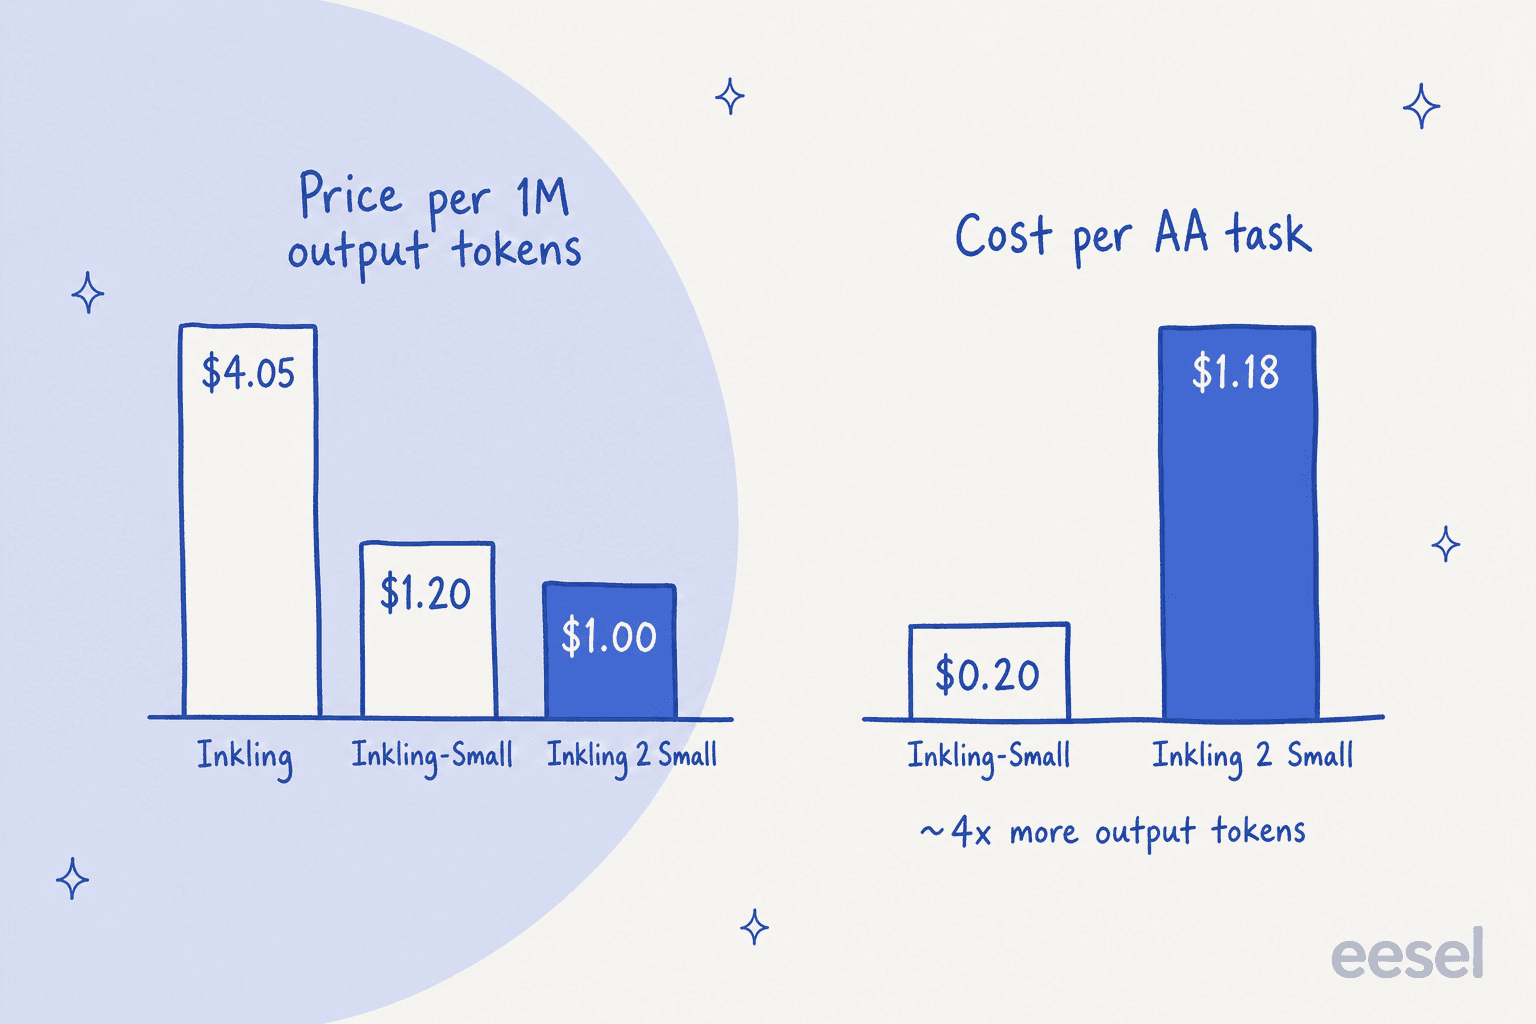
Am serverless Endpunkt von Tinker kostet Inkling 2 Small laut der Tinker-Preisseite 0,30 $ pro 1 Mio. Eingabe-Tokens, 0,03 $ zwischengespeichert und 1,00 $ pro 1 Mio. Ausgabe-Tokens. Artificial Analysis listet dieselben Sätze. Hier die vollständige Tabelle für die Familie, inklusive Fine-Tuning, denn Tinker ist in erster Linie eine Trainingsplattform.
| Modell (Tinker-ID-Suffix) | Kontext | Eingabe / 1 Mio. | Zwischengespeicherte Eingabe / 1 Mio. | Ausgabe / 1 Mio. | Training / 1 Mio. |
|---|---|---|---|---|---|
| Inkling 2 Small | 64K | $0.30 | $0.03 | $1.00 | $1.50 |
| Inkling 2 Small (256K) | 256K | $0.30 | $0.03 | $1.00 | $3.00 |
| Inkling-Small, Training | 64K / 256K | $0.58 | $0.116 | $1.44 | $1.73 / $3.47 |
| Inkling-Small, serverless | 256K | $0.30 | $0.06 | $1.20 | n/a |
| Inkling, Training | 64K / 256K | $1.87 | $0.374 | $4.68 | $5.61 / $11.23 |
| Inkling, serverless | 256K | $1.00 | $0.17 | $4.05 | n/a |
Checkpoint-Speicherung kostet zusätzlich 0,10 $ pro GB und Monat. Auffällig: Inkling 2 Small verlangt für Sampling denselben Preis, egal ob Sie es über einen Trainings-Client oder serverless aufrufen, während die Modelle der ersten Generation auf der Trainingsseite mehr verlangen.
Günstiger pro Token, teurer pro Aufgabe
Hier ist der Haken, den die Preiskarte verdeckt. Artificial Analysis stellte fest, dass Inkling 2 Small im Schnitt etwa 150K Ausgabe-Tokens pro Index-Aufgabe schreibt, gegenüber rund 37K bei Inkling-Small. Obwohl der Preis pro Ausgabe-Token niedriger ist, liegen die Kosten pro Aufgabe also bei 1,18 $ gegenüber 0,20 $. Das ist immer noch weit unter den 7,77 $, die für Gemini 3.8 Flash (high) gemessen wurden, und den 10,02 $ für Claude Sonnet 5.5 (medium), also ein gutes Preis-Leistungs-Verhältnis für seinen Score. Es ist nur nicht der günstige Austausch, den der Preis pro Token nahelegt.
Wenn Sie eine Support-Last kalkulieren, geben Sie Ihre eigenen Ticket-Werte in den Rechner unten ein. Der Schalter wendet die von Artificial Analysis gemessene Ausführlichkeitslücke an, sodass Sie sehen, wie stark sich die Antwort ändert.
Das Verhältnis ist ein Benchmark-Durchschnitt, kein Naturgesetz. Die Aufgaben von Artificial Analysis sind lange, agentische Aufgaben, und eine kurze Support-Antwort bei niedrigem Effort wird nicht um das 4-fache explodieren. Inkling 2 Small wurde mit einer Längenstrafe und einem gesampelten Effort-Level trainiert, daher ist das Senken des Effort-Levels der erste Hebel, um die Support-Rechnung in Grenzen zu halten. Wenn Sie mit Nicht-Inkling-Modellen vergleichen möchten, zeigt der Leitfaden zu den Kosten pro Lösung, wie man Token-Preise in eine Zahl pro Ticket umrechnet.
Was ist der Haken bei Inkling 2 Small?
Es gibt fünf, und alle betreffen den Zugang, nicht die Qualität.
- Die Gewichte sind noch nicht da. Das Modell startete geschlossen auf Tinker. Die Ankündigung sagt, das Lab wolle die Apache-2.0-Gewichte nach externen Sicherheitstests „nächste Woche“ veröffentlichen; die Inkling-Modellseite sagt „in den kommenden Wochen“; Artificial Analysis listet das Datum als unbestätigt. Vorerst ist es ein proprietäres Modell, und AA stuft es auch so ein.
- Nur ein Anbieter. Es ist nur auf Tinker verfügbar, ohne OpenRouter-Listing zum Stand 8. November. Serverless Inference befindet sich in der Beta, und die Dokumentation bittet Produktionsnutzer, sich auf eine Warteliste zu setzen.
- Der ausgelieferte Kontext ist kleiner als auf der Karte. Die Modellkarte nennt 1 Mio. Tokens. Der serverless Endpunkt ist mit 256K angegeben und die Standard-Trainings-ID mit 64K, planen Sie also damit.
- Es braucht lange, bis es anfängt zu antworten. Artificial Analysis maß 28,8 Sekunden bis zum ersten Antwort-Token, gegenüber einem Median von 11,4 s für Modelle seiner Preisklasse. Für einen Hintergrund-Agenten ist das in Ordnung, für ein Live-Chat-Widget ohne niedrige Effort-Einstellung zu langsam.
- Der Chat-Schliff hinkt nach. Der eigene Abschnitt zu den Einschränkungen des Labs sagt, es sei „weniger für die Chat-Erfahrung optimiert“, mit schwächerer Formatierung, überstrapazierten Schrägstrichen und Überreaktionen auf Fragen zur mentalen Gesundheit. Sein FORTRESS-Overrefusal-Score liegt bei 20,4 gegenüber 3,6 bei GLM-5.3-Flash (niedriger ist besser), erwarten Sie also mehr Ablehnungen harmloser Anfragen.
Für Self-Hosting sollten Sie mit einem Server planen. Mixture-of-Experts spart Rechenleistung, nicht Speicher: Alle 594B Parameter müssen geladen werden. Rein rechnerisch sind das etwa 1,2 TB bei BF16, rund 594 GB bei 8-Bit und etwa 300 GB bei 4-Bit, noch ohne Runtime-Overhead. Die Karte listet Unterstützung für MXFP8 und NVFP4, und das Modell wurde nativ in NVFP4 trainiert, ein 4-Bit-Build ist also wahrscheinlich der Sweet Spot. Vergleichen Sie das mit dem 89-GB-2-Bit-Build, der Inkling-Small auf eine einzelne Workstation brachte, behandelt in der Inkling-Small-Review.
Was sagen die Leute über Inkling 2 Small?
Die Reaktion ist wärmer als bei der ersten Generation. Der Hacker-News-Launch-Thread erreichte 289 Punkte und 92 Kommentare, gegenüber 33 Punkten und zwei Kommentaren beim Thread zu Inkling-Small im Juli. Der größte Teil der Energie dreht sich darum, dass ein US-Lab ein konkurrenzfähiges offenes Modell liefert. Der nützlichste Kommentar kam jedoch von jemandem, der die Frage stellte, die ein Entwickler stellen sollte:
"With these open weight models, I simply ask. Is it useable, is it useful?"
Auf X gaben die unabhängigen Benchmark-Labs den Ton an. Das Ergebnis von ARC Prize wurde am häufigsten zitiert:
"It outperforms every open-weight model we've evaluated on both ARC-AGI-1 & ARC-AGI-2."
Die skeptischen Stimmen drehten sich meist um die Größe und das Vertrauen in Benchmarks. Mehrere Antworten merkten an, dass ein 594B-„kleines“ Modell im Betrieb nicht klein ist, und eine Antwort auf eine Launch-Zusammenfassung sagte, „die meisten dieser Labs betreiben Benchmaxxing“, was ein fairer Grund ist, die unabhängigen Läufe höher zu gewichten als die Anbieterkarte. Ein anderer Kommentator fragte, wozu man ein Modell brauche, das „im Grunde mit DS4.1 vergleichbar“ sei, und das ist die ehrliche Wettbewerbsposition: Es liefert sich ein Kopf-an-Kopf-Rennen mit DeepSeek V4.1 Flash 1017, statt es klar zu schlagen.
Ist Inkling 2 Small gut geeignet für den Kundensupport?
Als Engine ist es jetzt glaubwürdig, was ich über Inkling-Small nicht sagen konnte. Das klarste Signal ist Tau3 Banking, ein Benchmark, bei dem das Modell als Support-Agent einer Bank agiert und Tools nutzt, während es mit einem simulierten Kunden spricht. Artificial Analysis gibt hier 40 % an gegenüber 19 % bei Inkling-Small, und die Anbieterkarte zeigt, dass es dort Kimi K3 schlägt (33,4 %), wobei GLM-5.3-Flash mit 47,2 % weiterhin führt. Zusammen mit dem Rückgang der Halluzinationsrate ergibt das ein Modell, das ein Tool-nutzendes Gespräch bewältigt und weiß, wann es aufhören sollte.
Als Support-Agent ist ein Modell aber immer noch nur die halbe Aufgabe. Ich habe das bei eesel live in Warteschlangen beobachtet: Das Modell entscheidet, wie gut eine Antwort formuliert ist, aber ob die Antwort erlaubt ist, zu Ihrer Richtlinie passt und an den richtigen Kunden geht, entscheidet alles, was darum herum liegt.
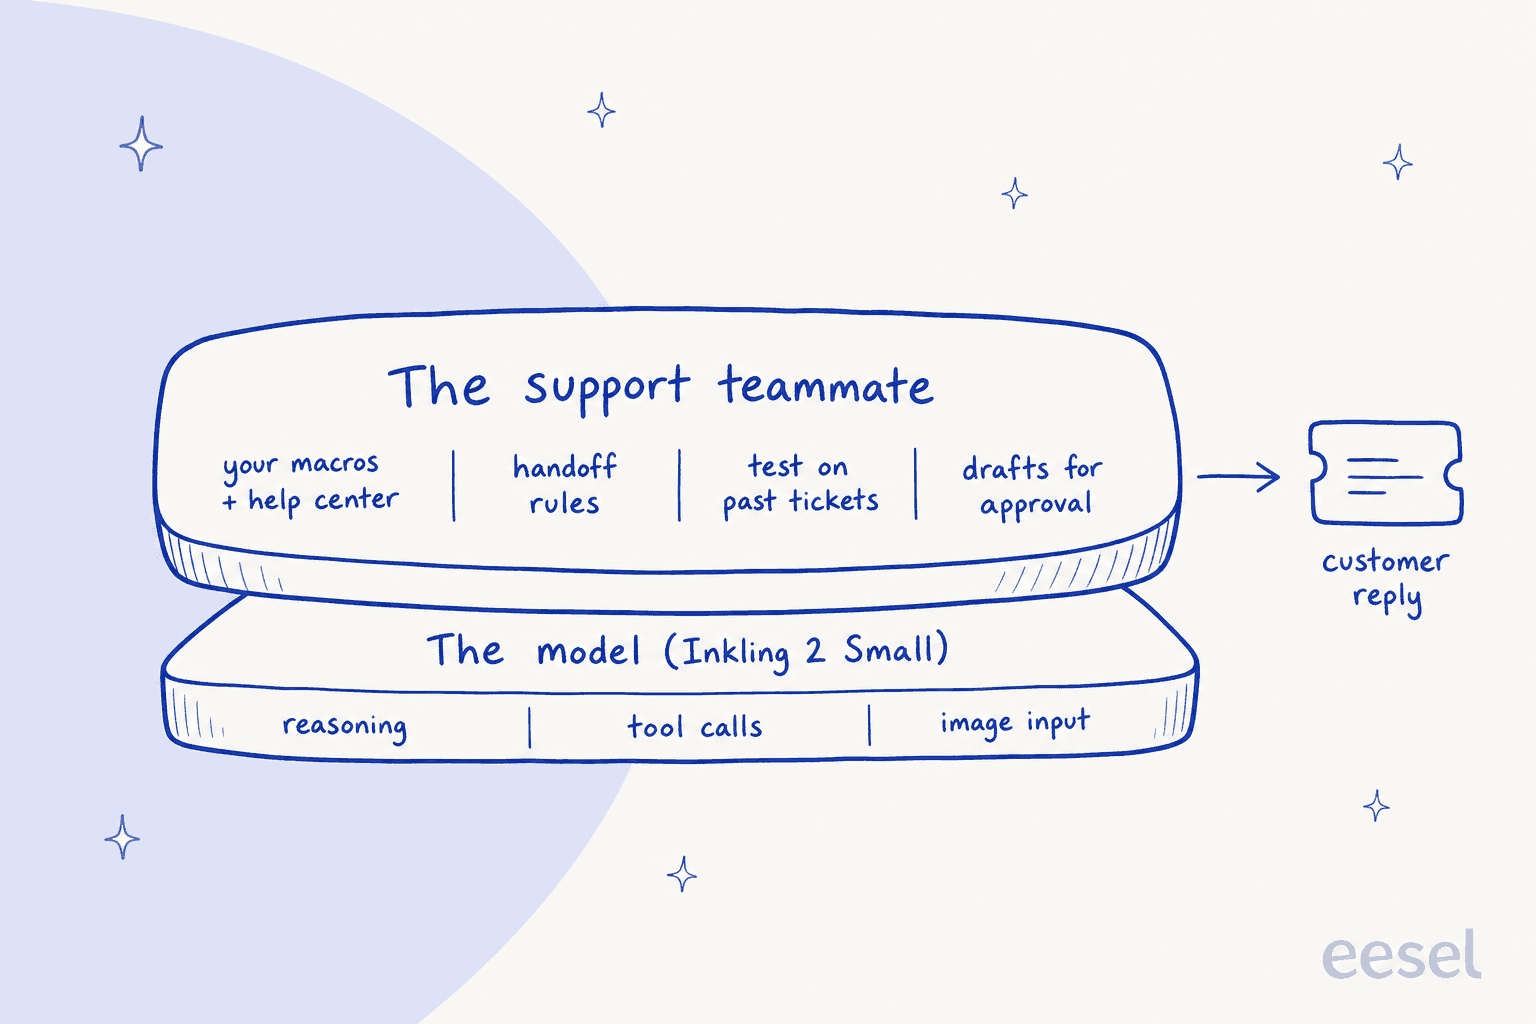
smava, eine Berliner Plattform für Kreditvergleiche, ist ein gutes Bild für diese obere Schicht, und angesichts des Banking-Benchmarks ein passendes. Das Unternehmen bearbeitet etwa 27.000 deutschsprachige Tickets pro Monat über ein Zendesk für zwei Marken. Drei eesel-Agenten teilen sich die Arbeit: Einer kategorisiert jedes Ticket, einer entwirft Antworten wortgetreu aus rund 820 Makros und Hilfecenter-Artikeln, und je einer pro Marke bereitet kundenfertige Antworten nur für Kunden ohne zugewiesenen Berater vor. Die Antwort-Agenten folgen Regeln, die ein Modell allein nie ableiten würde, etwa niemals zu versprechen, dass das Team etwas prüft oder weiterleitet, und niemals auf Wettbewerber zu verlinken, und eine Person gibt die Entwürfe frei. In einem Monat bereitete eesel rund 15.300 Antwortentwürfe vor.
Nichts davon hängt davon ab, welches große Sprachmodell darunterliegt, und genau das ist der Punkt. Modelle wechseln inzwischen alle paar Monate (dieses hier löste seinen Vorgänger nach 97 Tagen ab), daher sollten die Regeln, die Verankerung in Ihren Dokumenten und die Human-in-the-Loop-Freigaben nicht jedes Mal neu aufgebaut werden müssen.
Wenn Sie die ausführlichere Version dieses Arguments wollen: KI-Halluzinationen im Support und KI-Support-Simulationstests gehen tiefer darauf ein.
eesel ausprobieren
Wenn Sie durch Inkling 2 Small über KI in Ihrer Support-Warteschlange nachdenken: Das Modell ist der leicht austauschbare Teil. eesel ist ein KI-Helpdesk-Teammitglied, das sich in Ihren bestehenden Helpdesk einfügt, etwa Zendesk, aus Ihren Makros, Ihrem Hilfecenter und vergangenen Tickets lernt und Antworten nach den von Ihnen festgelegten Regeln entwirft oder sendet. Sie können es zuerst an Ihren historischen Tickets laufen lassen, um zu sehen, was es gesagt hätte, bevor es einen echten Kunden berührt. eesel kostenlos testen.
