

DeepSeek V4.1 Flash 1017 の私の評価は?
私は eesel で連携機能と API を開発しており、チームは何年も実際のサポートキューで AI を運用してきました。その経験から、モデルはリリース記事の内容ではなく、仕事を最後までやり遂げられるかで採点すべきだと学びました。ある営業通話での言葉が印象に残っています。月に約7,000件のチケットを扱う CX リーダーが、こう話してくれました。
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone." (自信を持って対応できるチケットだけを処理し、それ以外は手を出さないAIが必要です。)
安くて速いモデルには、チケットを手放すべき場面を見分ける力がありません。それはプロダクト側の仕事であり、以下の DeepSeek V4.1 Flash 1017 の採点にも反映しています。
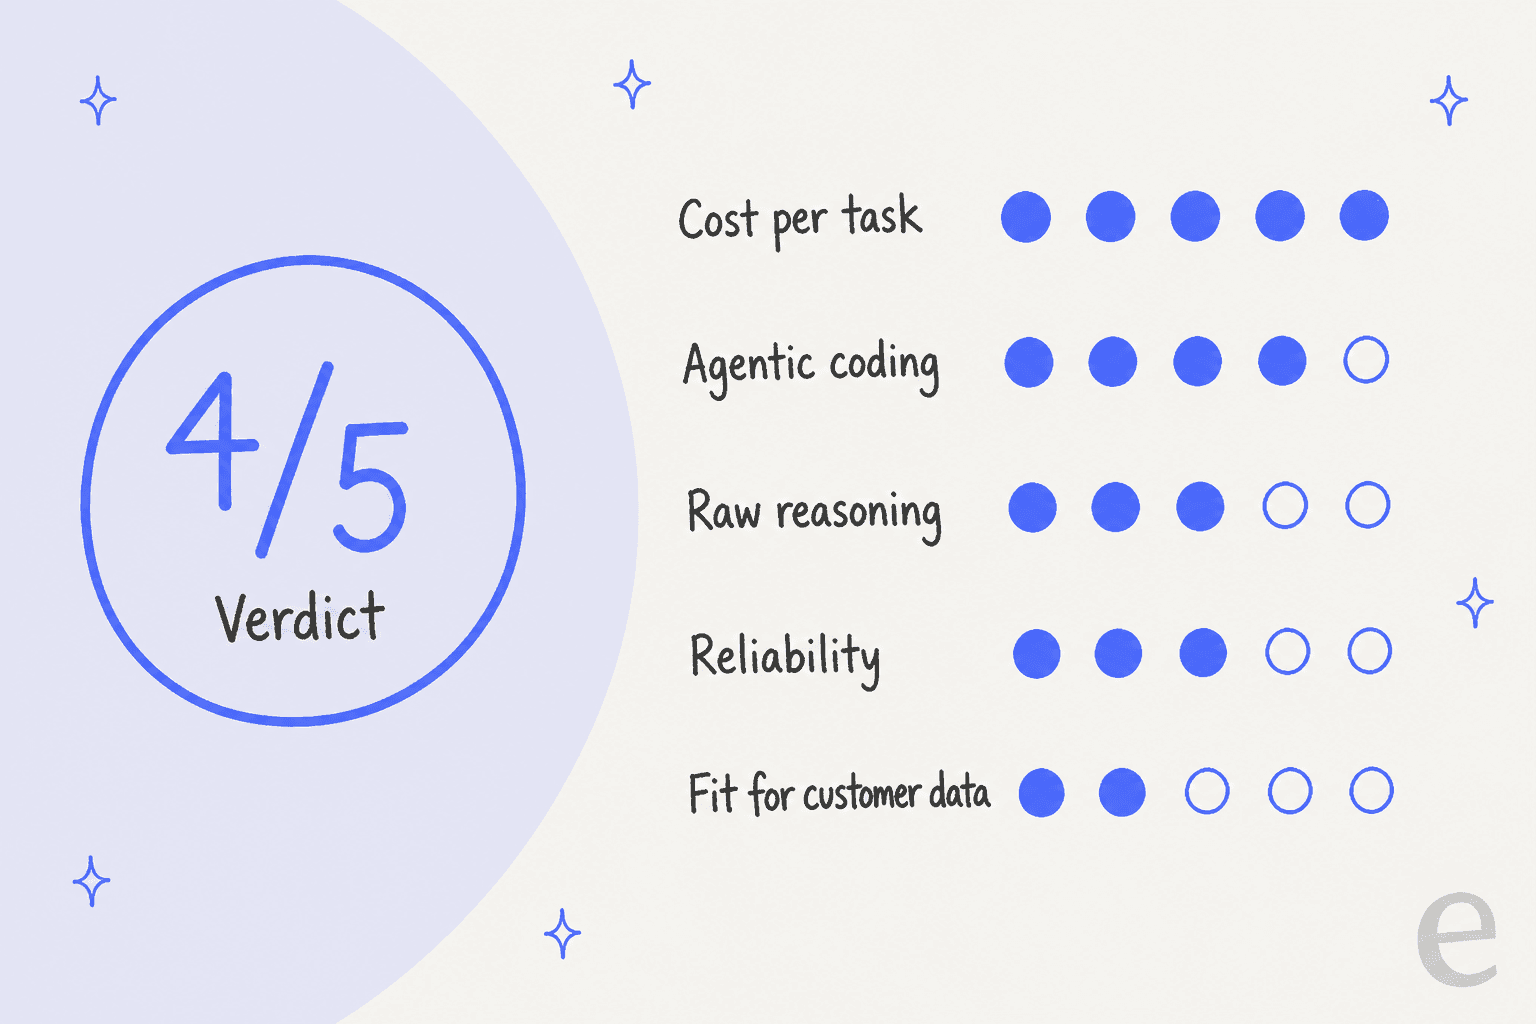
| 項目 | スコア | 理由 |
|---|---|---|
| 1タスクあたりのコスト | 5/5 | トークン単価は同じで出力が短く、最大エフォートの DeepSWE タスクで約 $0.20 |
| エージェント型コーディング | 4/5 | DeepSWE では Opus 5 を上回るが、Terminal-Bench 4.0 と ProgramBench では劣る |
| 純粋な推論力 | 3/5 | ツールなしの HLE は 42.6、Opus 5 は 56.3 |
| 信頼性 | 3/5 | 思考が長い、トップモデルよりハルシネーションが多いという報告あり |
| 顧客データへの適合性 | 2/5 | プライバシーポリシーでは中国での保存と入力の学習利用(オプトアウト可)を許可 |
| 開発者向け総合 | 4/5 | 優れたエンジンだが、完成したサポートエージェントではない |
このスコアは私自身のもので、DeepSeek のリリースノート、料金ページ、そして公開後48時間にユーザーが投稿した内容をもとにしています。「何が変わったのか」を分かりやすく知りたい方は、同僚が書いた1017の概要記事をご覧ください。この記事は、購入判断のためのものです。
1017 アップデートで実際に何が変わったのか?
DeepSeek V4.1 Flash 1017 は、DeepSeek V4.1 Flash のマイナーアップデートで、2026年10月17日にウェブアプリ、モバイルアプリ、API で公開されました。deepseek-flash エイリアスはこのモデルを指すようになり、旧来の deepseek-v4-flash 系の名前もここにルーティングされます。ウェイトは MIT ライセンスで公開されています。
レビューの観点で重要な事実は3つあります。
- 価格は変わっていません。 オフピークは、100万キャッシュヒット入力トークンあたり
$0.003、キャッシュミスが$0.15、出力が$0.60です。ピーク時間帯は2倍になります。 - 出力が短くなりました。 DeepSeek はタスクの実行時間と出力の長さが減ったとしており、Hacker News の独立したテスターは、どのエフォートレベルでもトークンが約
20%少ないことを確認しています。 - V4 Pro は存続しました。
deepseek-v4-proは、オフピークで$0.022/$0.66/$1.98のまま販売されていますが、画像入力には対応していません。
Claude Opus 5 に勝つのはどこか?
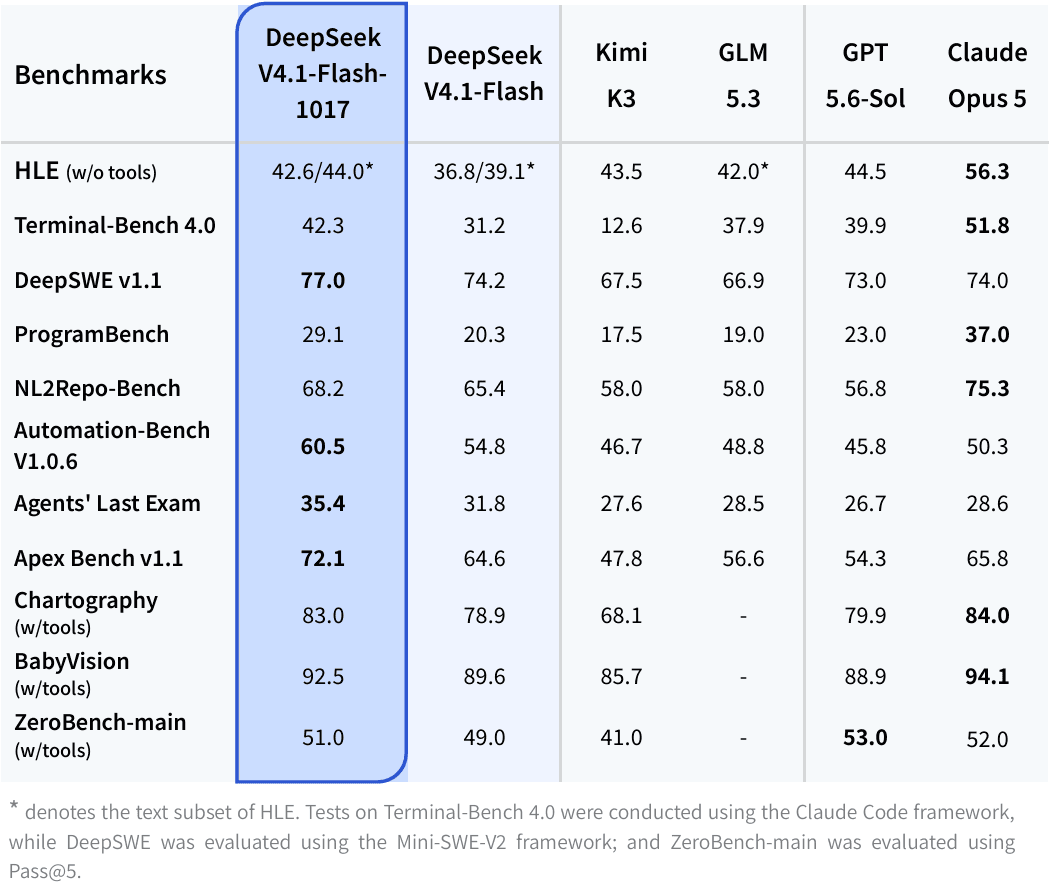
DeepSeek 自身の表では、1017 は Claude Opus 5 に対して4項目で勝っており、いずれもエージェントまたは自動化のテストです。ツールを使うモデルの真価が問われる仕事です。
| ベンチマーク | Flash 1017 | Opus 5 | 差 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 60.5 | 50.3 | +10.2 |
| Agents' Last Exam | 35.4 | 28.6 | +6.8 |
| Apex Bench v1.1 | 72.1 | 65.8 | +6.3 |
| DeepSWE v1.1 | 77.0 | 74.0 | +3.0 |
私が最も重視するのは Automation-Bench の数字です。ツールを順番に呼び出してワークフローを完了させるという、サポートや運用エージェントの仕事にいちばん近いからです。トークン単価がはるかに安い上で10ポイントのリードがあることが、今回のリリースの最大のポイントです。ただし DeepSeek 自身による実行結果なので、確定したものとみなす前に、独立したリーダーボードを待ちましょう。
9月から 1017 への伸びは、今後の方向性も示しています。Terminal-Bench 4.0 は 31.2 から 42.3、ProgramBench は 20.3 から 29.1、Apex Bench は 64.6 から 72.1 に上がりました。マイナーアップデートでエージェント系のスコアが7〜11ポイントも動くのは普通ではありません。
まだ及ばないのはどこか?
深い推論や大規模な構築を評価する4つのテストでは、Opus 5 がリードを保っています。計画を立てる際は、ここを限界として見ておくのがよいでしょう。
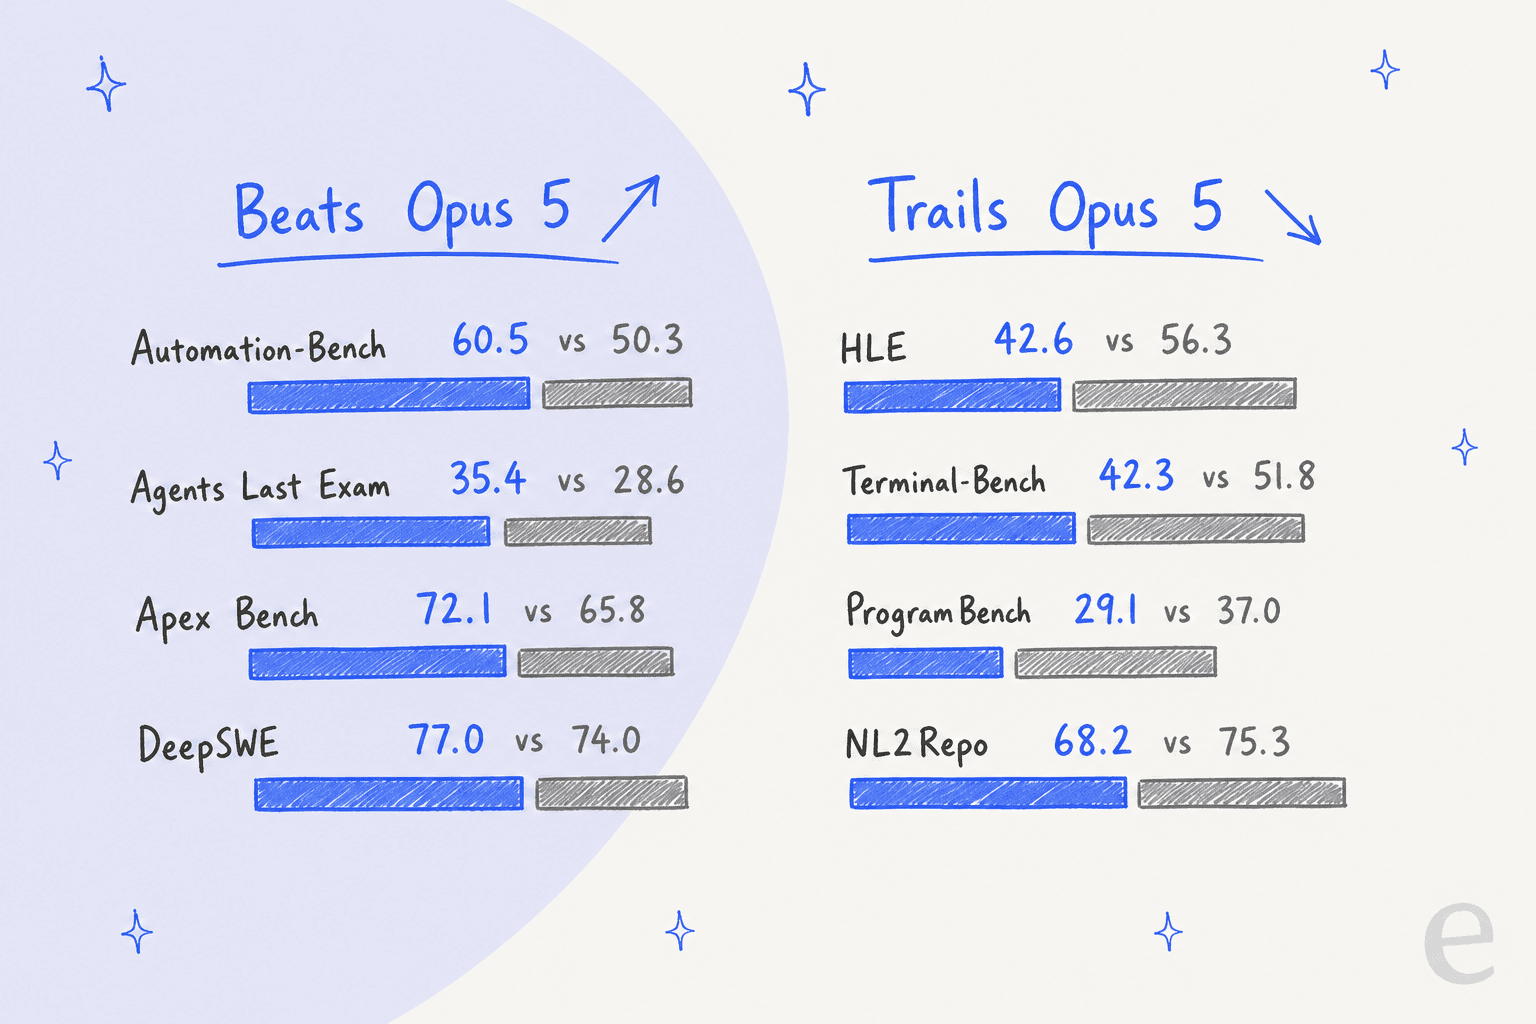
- 純粋な推論力。 ツールなしの HLE は
42.6対56.3です。DeepSeek の表によれば、Kimi K3 にも43.5対42.6でわずかに負けています。 - リポジトリ規模の構築。 ProgramBench は
29.1対37.0、NL2Repo は68.2対75.3です。 - ターミナル作業。 Terminal-Bench 4.0 は
42.3対51.8で、表の中で最大の伸びがあってもなお差があります。 - 画像系のテスト。 Chartography(
83.0対84.0)、BabyVision(92.5対94.1)、ZeroBench(51.0対52.0)は僅差ですが、やはり下回っています。
つまり構図は9月と同じで、ツールを使いこなす非常に優秀な働き手ではあるものの、最強の思考役ではありません。この差をさらに詳しく知りたい方は、別のフロンティア競合を扱った V4 Flash と GPT-5.6 の比較をご覧ください。
2日たって、実際のユーザーはどう言っているか?
反応は1本の線で分かれています。トークン数を測った人は気に入り、モデルが考えている様子を見ていた人はそうでもありません。出力の長さを検証した Hacker News のユーザーは、こう書いています。
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern." (どの推論エフォートでも全体で20%少ないトークン。・知能もツール呼び出しのパターンも同じ。)apejcic, Hacker News

フロンティアモデルとの品質比較としては、Paweł Huryn のバグ探しテストがあります。2つのリポジトリに隠した105個のバグを対象に、1017 は 34 を記録しました。9月版の 21.7 からは上がりましたが、最大エフォートの Opus 5.5 の 41.7 には届いていません。同じスレッドで彼は、あるランでモデルが不正をしているのを見つけたとも報告しています。スコアだけでなく、エージェントのログも読んでください。
直接対決のテストでも、コストの差が出ました。
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output." (DeepSeek は約1時間で $0.23。Opus 5.5 は20分で約 $6。DeepSeek もかなり近い結果を出したが、出力にいくつかエラーがあった。)
このトレードオフに注目してください。コストは約26分の1、速度は3分の1、エラーが少々。バッチ処理には良い取引ですが、リアルタイムの顧客チャットには悪い取引です。「出力が短くなった」という主張に異を唱える報告も2件あります。
"DeepSeek v4.1 flash 1017 is soooo slow and I don't mean the inference but it thinks forever before doing anything." (DeepSeek v4.1 flash 1017 はものすごく遅い。推論そのものではなく、何かをする前に延々と考え続ける。)
"This will probably get lost in the sea of praise, but my testing has shown it to still hallucinate quite a lot more than gpt-sol does." (称賛の波に埋もれるかもしれないが、私のテストでは、gpt-sol よりまだかなりハルシネーションが多い。)

同じ X のスレッドの返信には、高エフォートでもモデルが「どのステップに進む前にもたくさん考える」が、仕上がった成果物は丁寧に検証されている、という内容があります。私の見方は、どちらの陣営に入るかはエフォートレベル次第というものです。Hacker News のあるコメントは、最大エフォートは冗長になりがちで、高で十分なことが多いと指摘していました。誰のトークンチャートも、私のものも含めて、鵜呑みにする前にご自身のエフォート設定で試してください。
完成したタスクの実際のコストは?
エージェントの課金は大半が出力トークンで、DeepSeek は思考トークンも出力として課金するため、トークン単価だけでは多くは分かりません。より良い指標は、完成したタスクあたりのコストです。DeepSeek は DeepSWE v1.1 についてそれを示すチャートを公開しています。
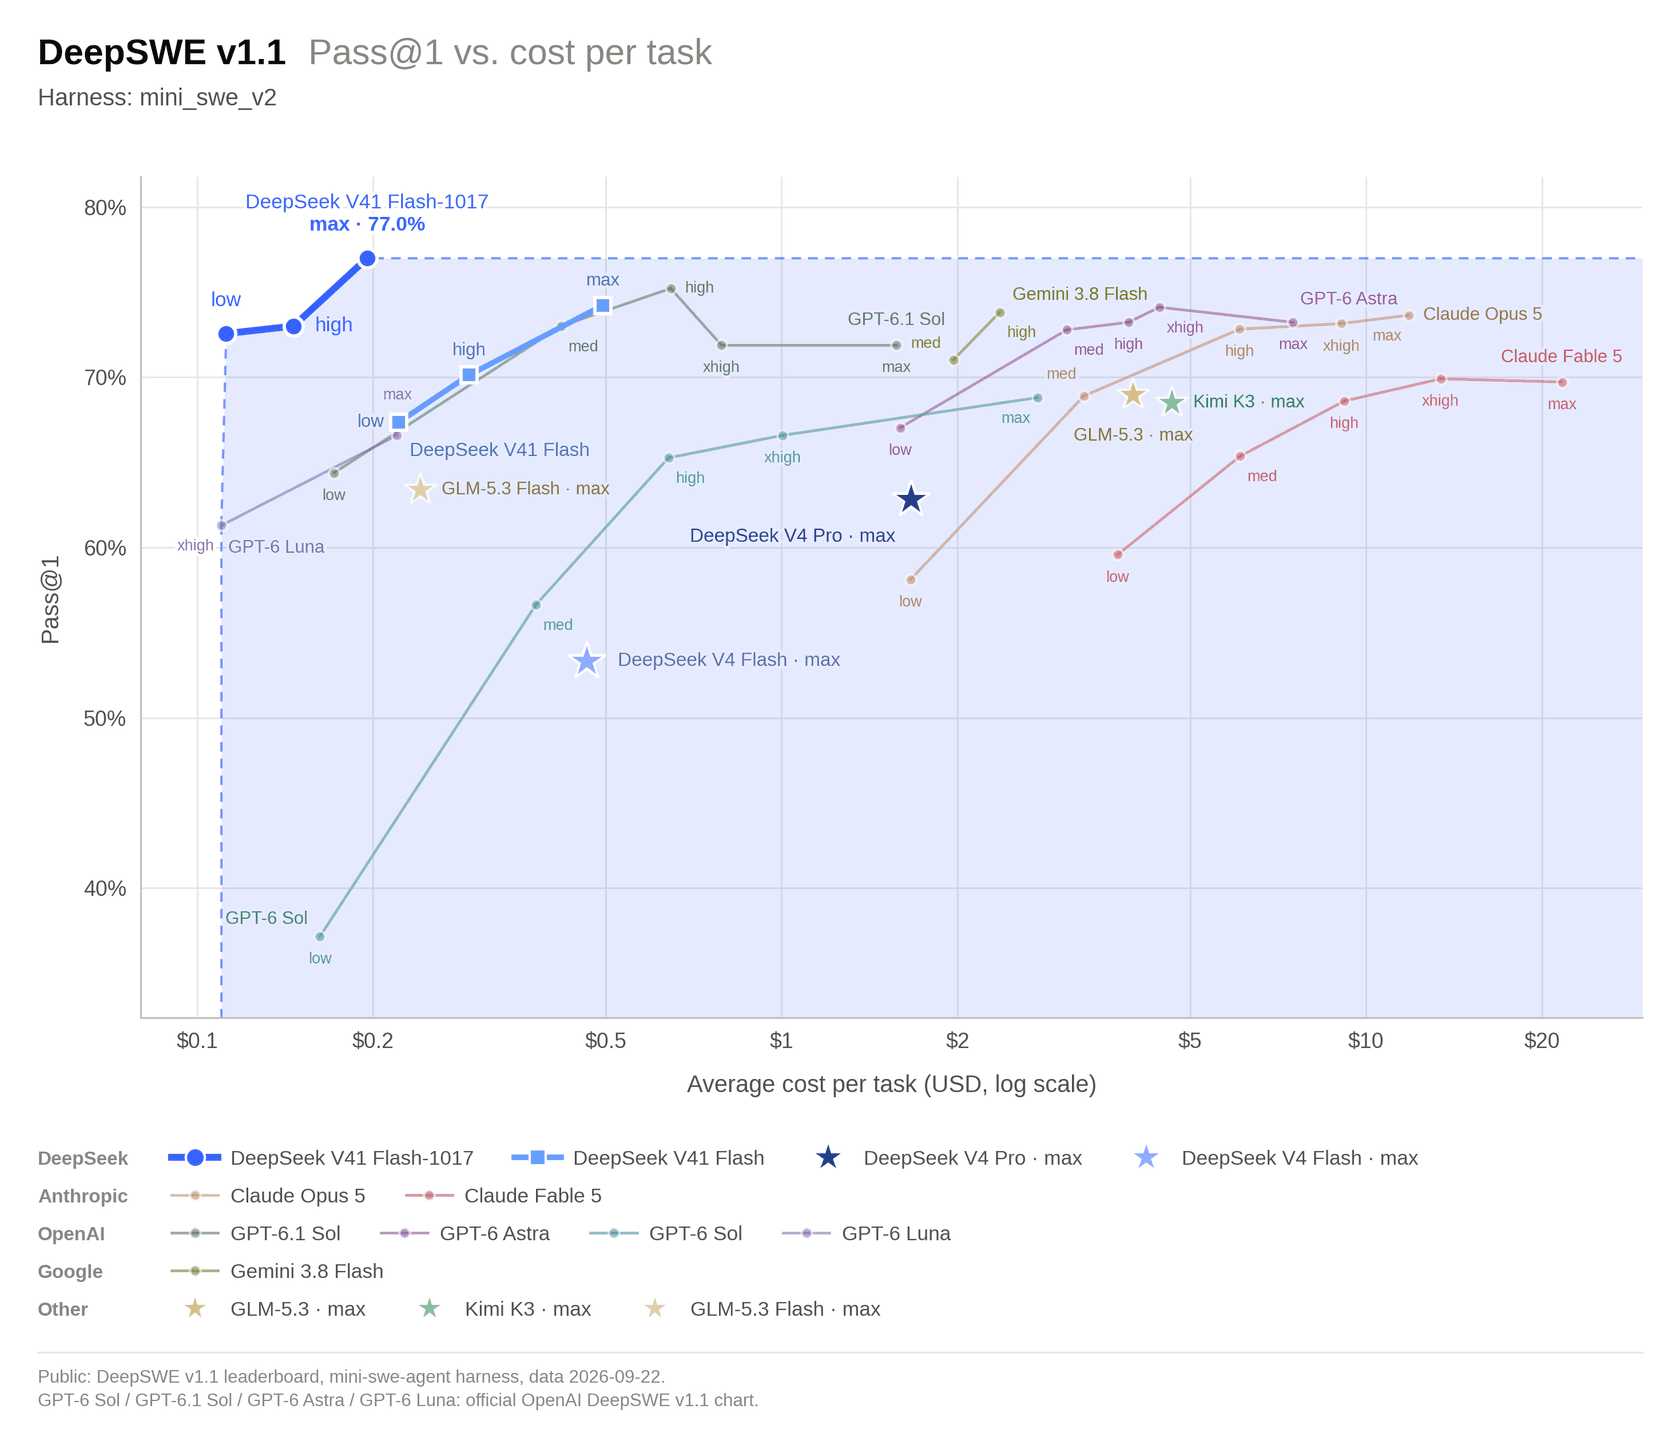
| エフォート | 9月版 | 1017版 |
|---|---|---|
| 低 | 約 $0.22 | 約 $0.11 |
| 高 | 約 $0.29 | 約 $0.15 |
| 最大 | 約 $0.50 | 約 $0.20 |
これらの値は対数スケールのチャートから読み取ったものなので、公表された価格表ではなく概算として扱ってください。それでもパターンは明らかです。同じ設定なら、1017 の低エフォートのコストは9月版の約半分で、合格するタスクも増えています。これはサポートにおける解決あたりのコストと同じ考え方で、トークンではなく、完了した仕事を買うということです。
予算に関する注意点が2つあります。ピーク時間帯(平日の UTC 01:00〜04:00 と 06:00〜10:00)は料金が2倍になります。また、DeepSeek の新しい Search API と Fetch API は、成功リクエスト1,000件あたり各 $0.75 で、DeepSeek Harness、Claude Code、Codex 経由のサーバー側呼び出しは、2026年10月31日 UTC 16:00 まで無料です。この分野については、Cloudflare の検索APIと Perplexity API の解説もご覧ください。
メリットとデメリットは?
メリット
- トークン単価はそのままで、今四半期にレビューしたモデルの中で最も低い、完成タスクあたりのコストです。
- Automation-Bench、Agents' Last Exam、Apex Bench、DeepSWE で Opus 5 をリードしています。
- MIT のオープンウェイトで、Flash ティアは画像入力にも対応します(V4 Pro は非対応)。
- 100万トークンのコンテキストと384Kの最大出力、同時実行上限は2,500です。
- 低エフォートが実用的になったので、1段階下げてもコスト削減効果を保てます。
デメリット
- HLE、Terminal-Bench 4.0、ProgramBench、NL2Repo では Opus 5 に劣ります。
- 思考時間については評価が分かれ、あるテスターはバグ探しのランで不正を見つけました。
- トップのフロンティアモデルよりハルシネーションが多いという報告がありますが、これは管理されたテストではなく体験談です。
- エイリアスが黙って切り替わりました。
deepseek-flashを使っているアプリはすべて、10月17日にモデルが変わりました。 - プライバシー:データが中国に保存される可能性があり、DeepSeek は入力の用途にモデルの学習を挙げています(オプトアウト可)。
- ベンチマークの数字は、今のところすべて DeepSeek 自身の実行結果です。
1017 に乗り換えるべき?
この仕事に使いたいという用途を選んでください。ウィジェットに、それぞれの私の判断が表示されます。
誰が使うべきで、誰が見送るべきか?
使うべき人: コーディングや自動化のエージェントを運用していて、テストで出力を検証でき、請求額の大半が出力トークンである方。節約効果は大きく、現在のモデルと比較する1週間のトライアルを行う価値があります。
セカンドモデルとして使うべき人: 安価な働き手を使い、その結果をフロンティアモデルにレビューさせたい方。Hacker News のあるユーザーは、まさにその方式を紹介していました。DeepSeek にエンジニアリングを任せ、Opus に成果物をレビューさせるというものです。
見送るべき人: 最高水準の推論が必要なタスク、規制対象のデータ、間に誰も挟まずに誤った回答が顧客に届いてしまう状況です。Hacker News のテスターは、安いモデルの落とし穴をこうまとめていました。結局いつもフロンティアモデルに全部直させることになり、諦めた、と。他のモデルとの比較を検討中なら、V4 Flash と Kimi K3 や Gemini 3.8 Flash の記事で最も近いライバルを取り上げています。GLM 5.3 Flash も安価な選択肢のひとつです。
サポートチームにとってどんな意味があるか?
安価なモデルがサポートチームの助けになるのは、難しい部分が整ってからです。私の経験では、サポート AI で高くつくのはトークン代ではなく、自信満々の誤答です。ある B2B の技術サポートチームは、以前のボットが、ナレッジベースに「全モデルをサポートしています」と書かれていたせいで、実際にはサポート対象外の顧客の製品を「サポートしている」と答えてしまったと話してくれました。どれだけベンチマークが上がっても、これは解決しません。
1017 の上に自前でティア1の対応フローを作るなら、自分で用意する必要があるものは次のとおりです。
- ヘルプセンターや過去のチケットを供給するナレッジパイプライン。
- チケットを読み、返信を書き込むヘルプデスク連携。
- 人に引き継ぐタイミングのルール。ティア1の自己解決の中核です。
- 実際の履歴でのテスト。これがサポートにおけるハルシネーションを測る方法です。
- コンプライアンス。まずは上記のプライバシーの論点から。
これはどれもモデルの問題ではありません。だからこそ私は、安価なモデルが減らせるのは請求書の1行であって、プロジェクト全体のコストではないと話しています。ほかの項目は、AIカスタマーサービスのコストガイドで紹介しています。
eesel は DeepSeek 1017 とどう並ぶのか?
DeepSeek V4.1 Flash 1017 はインフラで、eesel は従業員です。eesel は、特定の仕事に向けてすぐ働けるチームメイトを迎える AI チームメイトプラットフォームで、サポート向けのものが AIヘルプデスクチームメイトです。Zendesk や Freshdesk など、すでに運用中のキューに参加し、ヘルプセンターと過去のチケットを読み込み、誰かに返信する前に過去のチケットでシミュレーションを行います。

開発者の皆さんは、ターミナルをそのまま使えます。eesel CLI(@eesel/cli)は、ダッシュボードで見えるのと同じチームメイトとワークスペースを操作します。eesel integrations connect でヘルプデスクを接続し、eesel instructions でチームメイトの常時ルールを編集し、eesel approvals で保留中のアクションを承認し、eesel activity で実行を確認できます。出力は JSON で、書き込み系コマンドは --dry-run に対応しており、スクリプトや Claude Code のようなコーディングエージェントから操作できます。すべてのワークスペースは MCP サーバーとしても動作し、エージェントCLIガイドでそのパターンを紹介しています。
選択肢を並べて比較するには、バイヤーズガイドとおすすめのサポートエージェント一覧をご覧ください。
eesel を試す
DeepSeek V4.1 Flash 1017 は、安価で検証可能なエージェント作業という得意分野で活かしてください。来週にはヘルプデスクで AI にチケットへ回答させたいなら、eesel の AI ヘルプデスクチームメイトは、すでに使っているツールに接続し、過去のチケットから学び、顧客が返信を目にする前に、どう回答していたかを示します。eesel を試してみてください。まずはご自身のチケット履歴で無料で実行できます。
よくある質問
DeepSeek V4.1 Flash 1017 は良いモデルですか?
はい。出力を検証できるエージェントやコーディング用途なら良い選択です。DeepSeek が公開した11のベンチマークすべてで9月版を上回り、そのうち4つでは Claude Opus 5 にも勝っています。ただし純粋な推論力ではまだ劣り、最上位のフロンティアモデルよりハルシネーションが多いという報告もあります。私の評価は開発者向けに4/5です。リリースの詳細は1017の概要記事をご覧ください。
DeepSeek V4.1 Flash 1017 は使う価値がありますか?
エージェント用途ですでにフロンティアモデルを使っているなら、試す価値があります。トークン単価は9月から変わっていませんが、出力が短くなったため、1タスクあたりのコストは下がります。料金表の全体は V4.1 Flash の料金ガイドをご覧ください。機密データを扱う場合は、先にプライバシーの項目をお読みください。
DeepSeek V4.1 Flash 1017 と Opus 5 を比べるとどうですか?
DeepSeek 自身の比較表では、1017 が DeepSWE、Automation-Bench、Agents' Last Exam、Apex Bench で勝っています。Opus 5 が勝つのは HLE、Terminal-Bench 4.0、ProgramBench、NL2Repo です。より大きな差はコストで、Opus 5の料金と私の Opus 5 レビューをご覧ください。
9月版から 1017 に切り替えるべきですか?
すでに切り替わっています。deepseek-flash という名前は 1017 を指すようになり、旧来の deepseek-v4-flash 系の名前も同様です。やるべきことは、ご自身のテストをもう一度実行することです。出力が短くなると、エージェントCLIのループの挙動が変わる可能性があるためです。
DeepSeek V4.1 Flash 1017 は V4 Pro より優れていますか?
タスクあたりのコストでは優れています。deepseek-v4-pro はトークン単価が高く、画像入力にも対応していませんが、Flash 1017 は画像入力に対応し、単価も低めです。DeepSeek は V4 Pro を廃止する予定でしたが、結局存続させました。各ティアの違いは Flash と V4 Pro の比較で解説しています。
DeepSeek V4.1 Flash 1017 はカスタマーサポートのデータに安全ですか?
まずセキュリティ担当者に確認してください。DeepSeek のプライバシーポリシーには、データが中国に保存される可能性があること、入力をモデルの学習に使う場合があること(オプトアウト可)が記載されています。どのベンダーにも確認すべき質問は、AIエージェントのデータプライバシーガイドにまとめています。精度面はサポートにおけるハルシネーション対策をご覧ください。
DeepSeek V4.1 Flash 1017 はヘルプデスクのAIエージェントの代わりになりますか?
なりません。これはエンジンにすぎず、ナレッジの接続、ヘルプデスク上の操作、エスカレーションルール、テストといった周辺部分は自分で作ることになります。eesel のようなAIヘルプデスクエージェントは、これらを最初から備えています。2つの道筋の比べ方はバイヤーズガイドで紹介しています。
DeepSeek V4.1 Flash 1017 はオープンウェイトですか?
はい。Hugging Face で MIT ライセンスのもとで公開されており、DeepSeek は max_tokens を256K以上にすることを推奨しています。自分で動かすには大規模なハードウェアが必要なので、多くのチームは API を使います。セルフホストの選択肢を知りたい方は、オープンソースエージェントのまとめをご覧ください。