

DeepSeek V4.1 Flash 1017とは?
私はeeselでプロダクト機能とAIエージェントを開発しており、チームは何年も実際のサポートキューでAIを運用してきました。その経験から身についた習慣があります。モデル提供元が「価格は同じ」と言ったら、仕事1件が完了するまでにいくらかかるかを確認します。請求書に反映されるのはその数字だからです。
DeepSeek V4.1 Flash 1017は、9月10日にリリースされたDeepSeek V4.1 Flashモデルのマイナーアップデートです。DeepSeekの更新履歴によると、公式のWebアプリ、モバイルアプリ、APIはいずれも2026年10月17日に新しいビルドへ移行しました。API呼び出しは変わりません。引き続きdeepseek-flashというモデル名を使えば、自動的に1017が使われます。
中身は同じモデルファミリーで、9月にDeepSeekが導入した新アーキテクチャを採用した5,520億パラメータ(552B)のMixture-of-Expertsモデルです。ウェイトはMITライセンスで公開されており、コンテキストウィンドウは100万トークンです。アーキテクチャの話を知りたい方は、同僚が書いたローンチ概要をご覧ください。この記事では差分を扱います。
| 項目 | 9月のビルド | 1017のビルド |
|---|---|---|
| APIモデル名 | deepseek-flash | deepseek-flash(同じ) |
| トークン価格 | オフピークで入力$0.15/出力$0.60 | 変更なし |
| 出力の長さ | 基準 | DeepSeekによると短くなった |
| タスクの実行時間 | 基準 | DeepSeekによると速くなった |
| 開発者向けWeb検索 | 単体では未販売 | Search APIとFetch API、1,000件あたり$0.75 |
| オープンウェイト | Hugging FaceでMIT | Hugging FaceでMIT |
最初の行には、見落としやすい影響が1つあります。エイリアスが移動したため、deepseek-flashを指しているすべてのアプリは、持ち主が気づいたかどうかにかかわらず10月17日にモデルが切り替わりました。料金ページには9月のビルド用の別名は載っておらず、廃止されたdeepseek-v4-flashの名前も今は1017で処理されます。長く丁寧な出力を前提にチューニングしたプロンプトがある場合は、今週中にテストしてください。
ベンチマークではどれだけ良くなったか?
DeepSeekのローンチノートは、このリリースを「性能とコストのパレート改善」と呼んでおり、前半部分は数字が裏付けています。公式の表にある11個のベンチマークは、9月のビルドと比べてすべて向上しました。
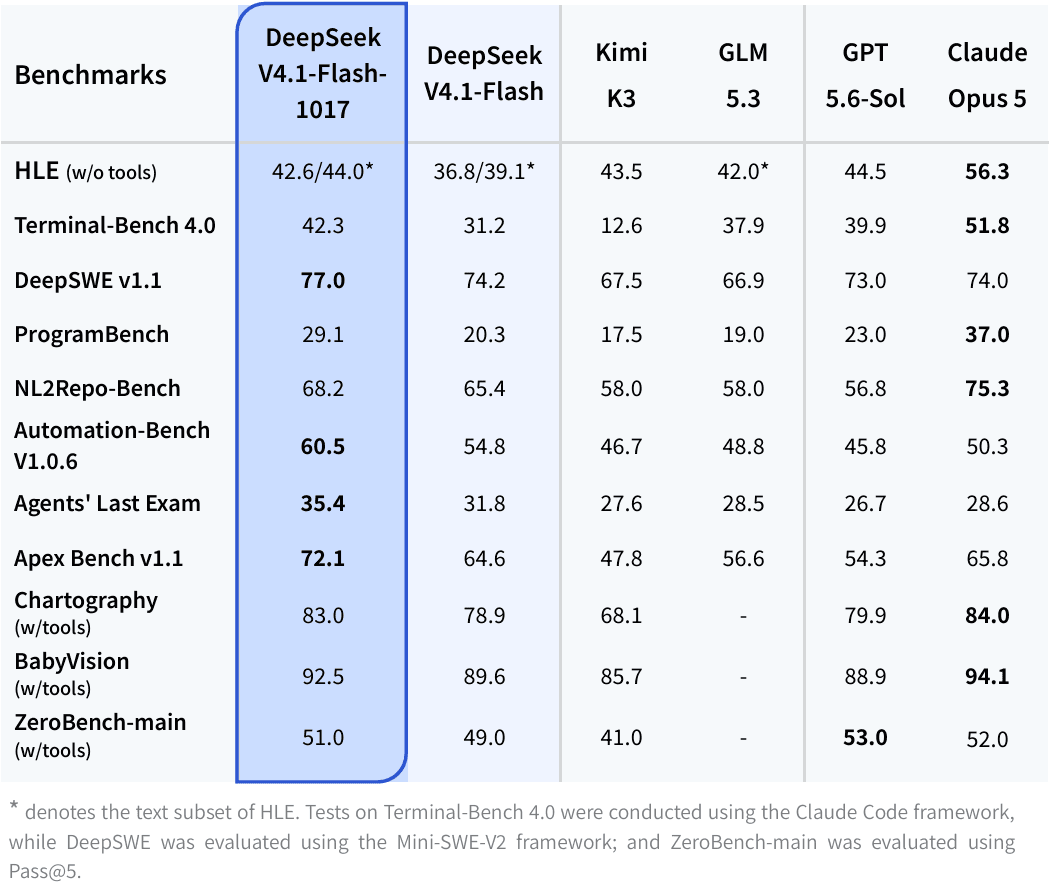
同じ表から、基準点としてClaude Opus 5を並べた差分は次のとおりです。
| ベンチマーク | V4.1 Flash(9月) | V4.1 Flash 1017 | 変化 | Claude Opus 5 |
|---|---|---|---|---|
| HLE(ツールなし) | 36.8 | 42.6 | +5.8 | 56.3 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 | 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 | 74.0 |
| ProgramBench | 20.3 | 29.1 | +8.8 | 37.0 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 | 75.3 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 | 50.3 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 | 28.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 | 65.8 |
| Chartography(ツールあり) | 78.9 | 83.0 | +4.1 | 84.0 |
| BabyVision(ツールあり) | 89.6 | 92.5 | +2.9 | 94.1 |
| ZeroBench-main(ツールあり) | 49.0 | 51.0 | +2.0 | 52.0 |
最大の伸びはTerminal-Bench 4.0の11.1ポイント増で、DeepSeekはこれをClaude Codeのハーネス内で実行しています。コーディングエージェントが日々ターミナルでやっていることに最も近いベンチマークなので、多くの開発者にとってはHLEの向上より重要です。
「全員に勝った」と言うより、実態はもう少し控えめです。1017は、エージェントや自動化のテストであるDeepSWE、Automation-Bench、Agents' Last Exam、Apex Benchで表全体のトップに立ちました。Opus 5は、純粋な推論(HLE)、Terminal-Bench 4.0、リポジトリ構築の2つのテストでは依然としてリードしています。また、ツールなしのHLEではKimi K3が43.5対42.6でわずかに上回ります。つまりモデルの性格は9月から変わっていません。ツール利用に非常に強い働き者であり、最上位の推論モデルではないということです。これらはDeepSeek自身の実行結果でもあるため、独立したリーダーボードが追いつけば、さらに詳しいことが分かるでしょう。
価格が同じなのに、なぜ請求額は小さくなるのか?
ここは、ローンチ関連の報道の多くが触れていない部分です。APIモデルはトークン単位で課金され、エージェントはトークンの大半を出力に使います。思考トークンも含まれ、DeepSeekはそれを出力として課金します。同じ答えにより少ない言葉で到達できるなら、トークン単価が据え置きでも、タスクあたりの支払いは減ります。
DeepSeekはこのリリースで「モデルのタスク実行時間と出力の長さを短縮した」と述べ、それがDeepSWE v1.1のコストに何をもたらすかを示すチャートを公開しました。
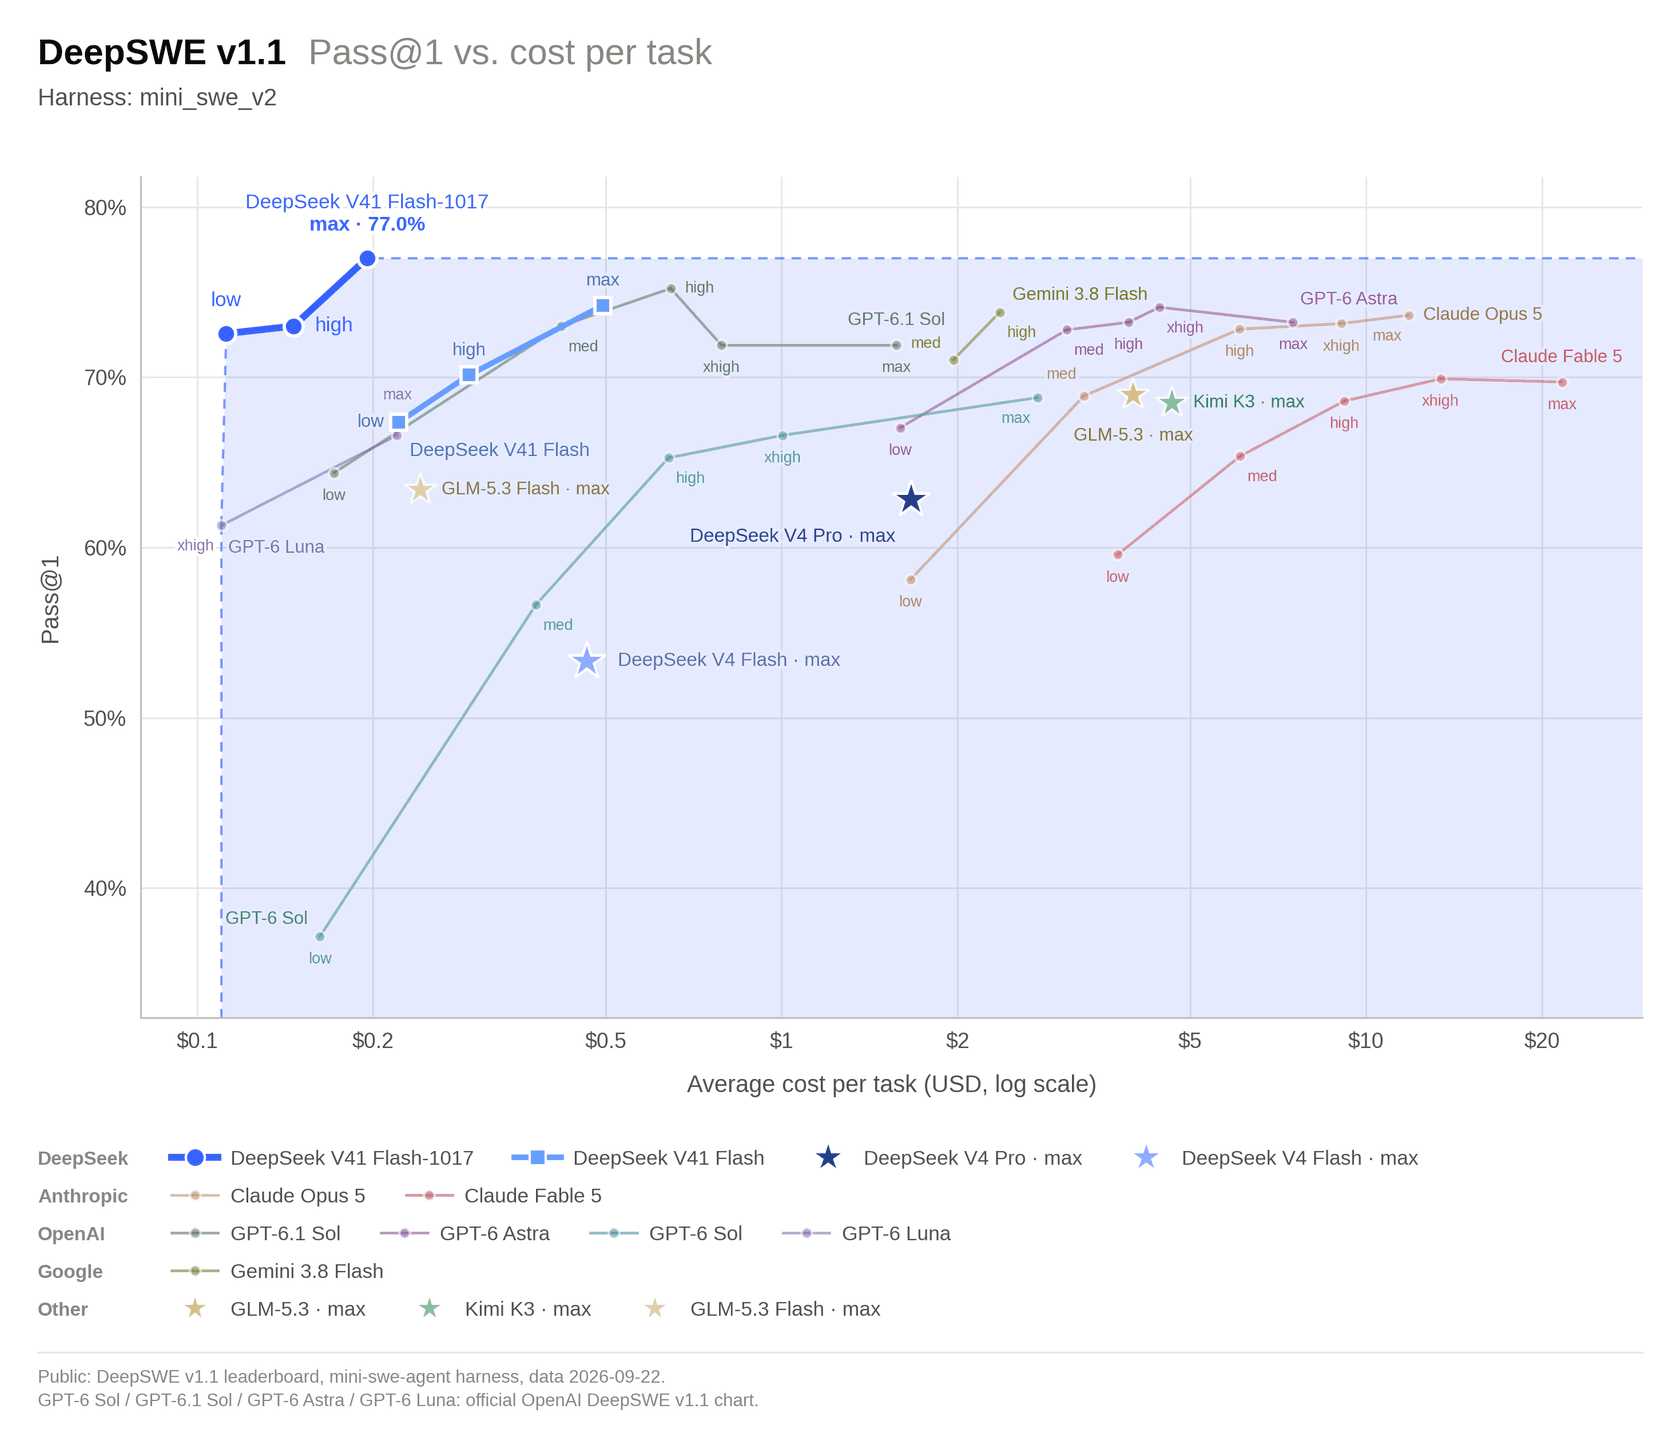
この対数目盛りのチャートを読むと、9月のビルドは最大エフォートで1タスクあたり約$0.50でした。1017のビルドは最大エフォートで約$0.20に収まり、合格するタスクも増えています。低エフォート設定でさえ、9月のビルドの高エフォート設定より高いスコアを、約3分の1のコストで出しています。これらはDeepSeekのチャートから私が読み取った値であり、公表された表ではないため、おおよその数字として扱ってください。
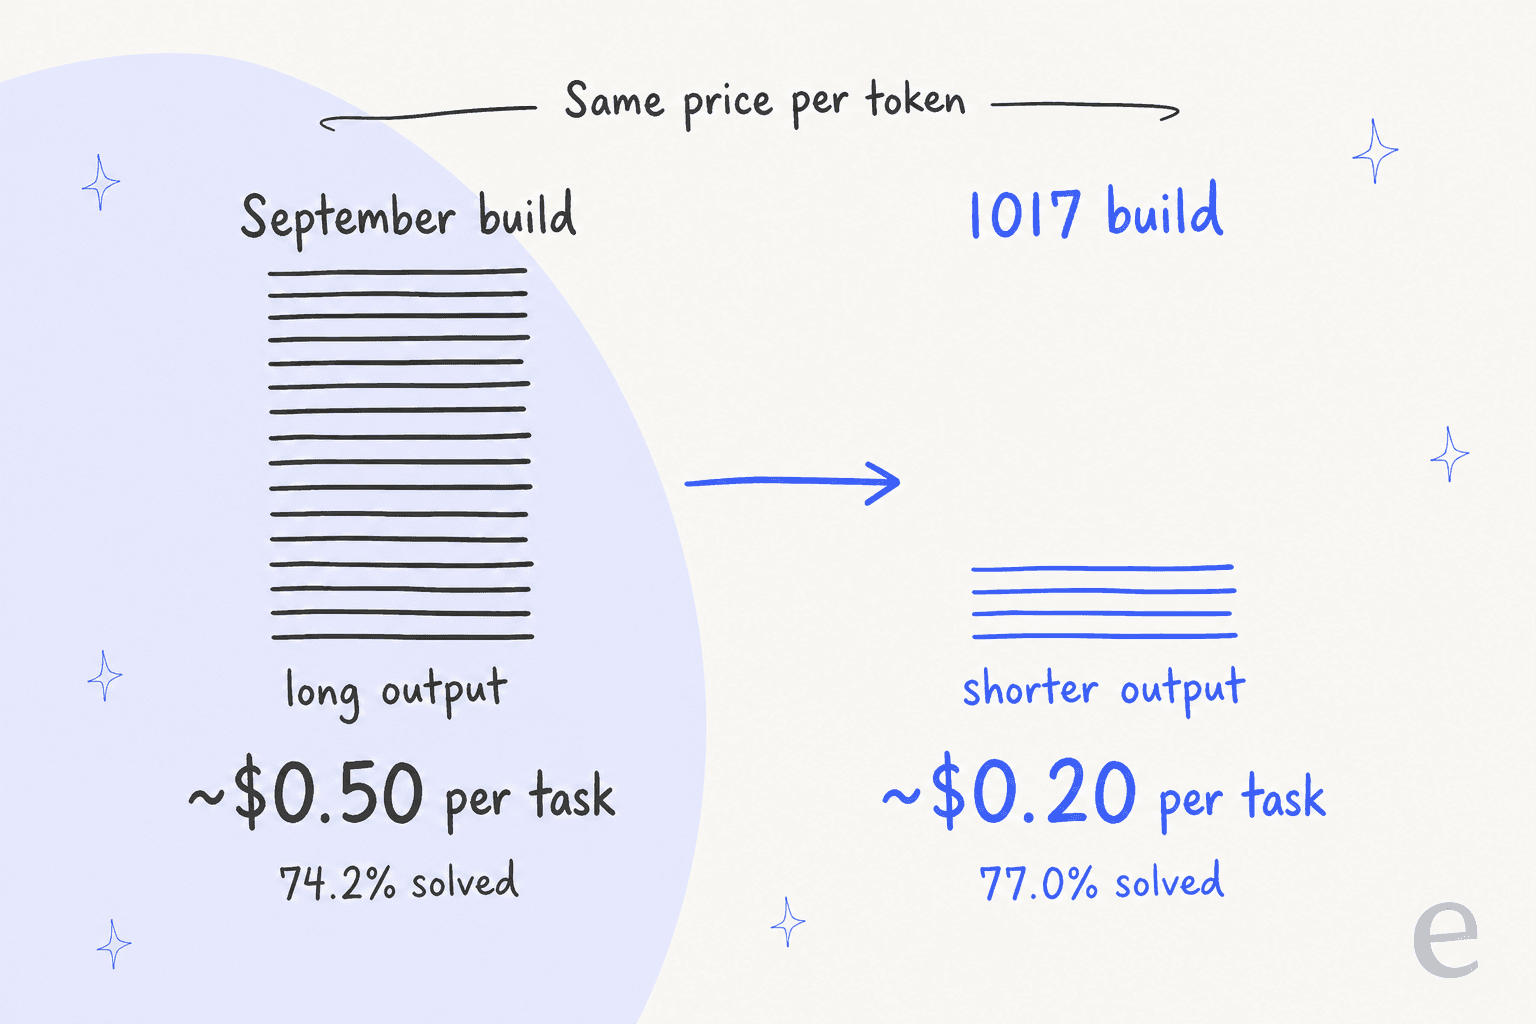
実践的な持ち帰りポイントはこれです。100万トークンあたりの価格だけでモデルを比べるのはやめましょう。トークン単価が2倍でも、出力が半分で済むモデルなら、1件あたりのコストは同じです。サポートチームに、席数単価ではなく解決1件あたりのコストで見るよう勧めているのも同じ理由です。実際に購入している単位は、完了したタスクです。
ご自身の規模でどうなるかを見たい方のために、DeepSeekのDeepSWEチャートから読み取ったタスク単価を使った簡易見積もりツールを用意しました。実際のタスクはDeepSWEのコーディングタスクとまったく同じではないので、規模感をつかむ目安としてお使いください。
DeepSeek V4.1 Flash 1017の料金は?
Models and Pricingページの料金は、9月のローンチ当日と同じです。オフピークはピークの半額で、ピーク時間帯は平日(中国の祝日を除く)のUTC 01:00〜04:00と06:00〜10:00です。それ以外は週末も含めてオフピーク料金で課金されます。
| 100万トークンあたり | deepseek-flash(V4.1 Flash 1017)オフピーク | ピーク | deepseek-v4-pro(V4-Pro-0813)オフピーク | ピーク |
|---|---|---|---|---|
| 入力(キャッシュヒット) | $0.003 | $0.006 | $0.022 | $0.044 |
| 入力(キャッシュミス) | $0.15 | $0.30 | $0.66 | $1.32 |
| 出力 | $0.60 | $1.20 | $1.98 | $3.96 |
| 同時実行数の上限 | 2,500 | 500 | ||
| コンテキスト/最大出力 | 1M / 384K | 1M / 384K | ||
| ビジョン | あり | 非対応 |
ここには、9月に読んだ内容と違う点が2つあります。1つ目は、このリリースで値下げはなかったことです。値下げは9月のローンチ時に行われており、V4.1 Flashの料金の解説で扱っています。2つ目は、V4 Proがなくならなかったことです。DeepSeekはV4 ProをFlashに統合する予定でしたが、更新履歴に「ユーザーの要望に応えて」V4 Proの提供を課金も変えずに続けると書きました。そのため今は両者のどちらかを実際に選べます。ティアの違いはV4 FlashとV4 Proの比較記事で説明しています。ただしDeepSeek自身のコストチャートでは、最大エフォートの旧V4 Proは、1017 Flashより合格率が低く、タスクあたりのコストははるかに高い位置にあります。
新しいDeepSeek Search APIとFetch APIとは?
エージェント開発者にとっては、むしろこちらのほうが大きなニュースかもしれません。1017と同時に、DeepSeekは自社の検索エンジンを2つの独立したAPIとして公開しました。SearchとFetchのガイドでは、次のように説明されています。
- Search(
POST /v1/tools/search)は最大128文字のクエリを受け取り、最大50件の結果を返します。各結果には、タイトル、URL、短いスニペット、モデルが読むために書かれた600〜800文字の長めの要約、任意のページ全文フィールド、日付、0〜4のauthorityティアが含まれます。site:、-site:、lang:、after:、before:の演算子に対応しています。 - Fetch(
POST /v1/tools/fetch)は1つのURLを受け取り、そのページをMarkdownで返します。
どちらも通常のDeepSeek APIキーを使い、アカウントあたり毎秒5リクエストが上限です。DeepSeekは、このエンジンが1日に「数億件の検索リクエスト」を処理し、SEOスパムや低品質なAI生成ページをフィルタリングしていると述べていますが、信頼する前に自分のクエリで試したい主張です。
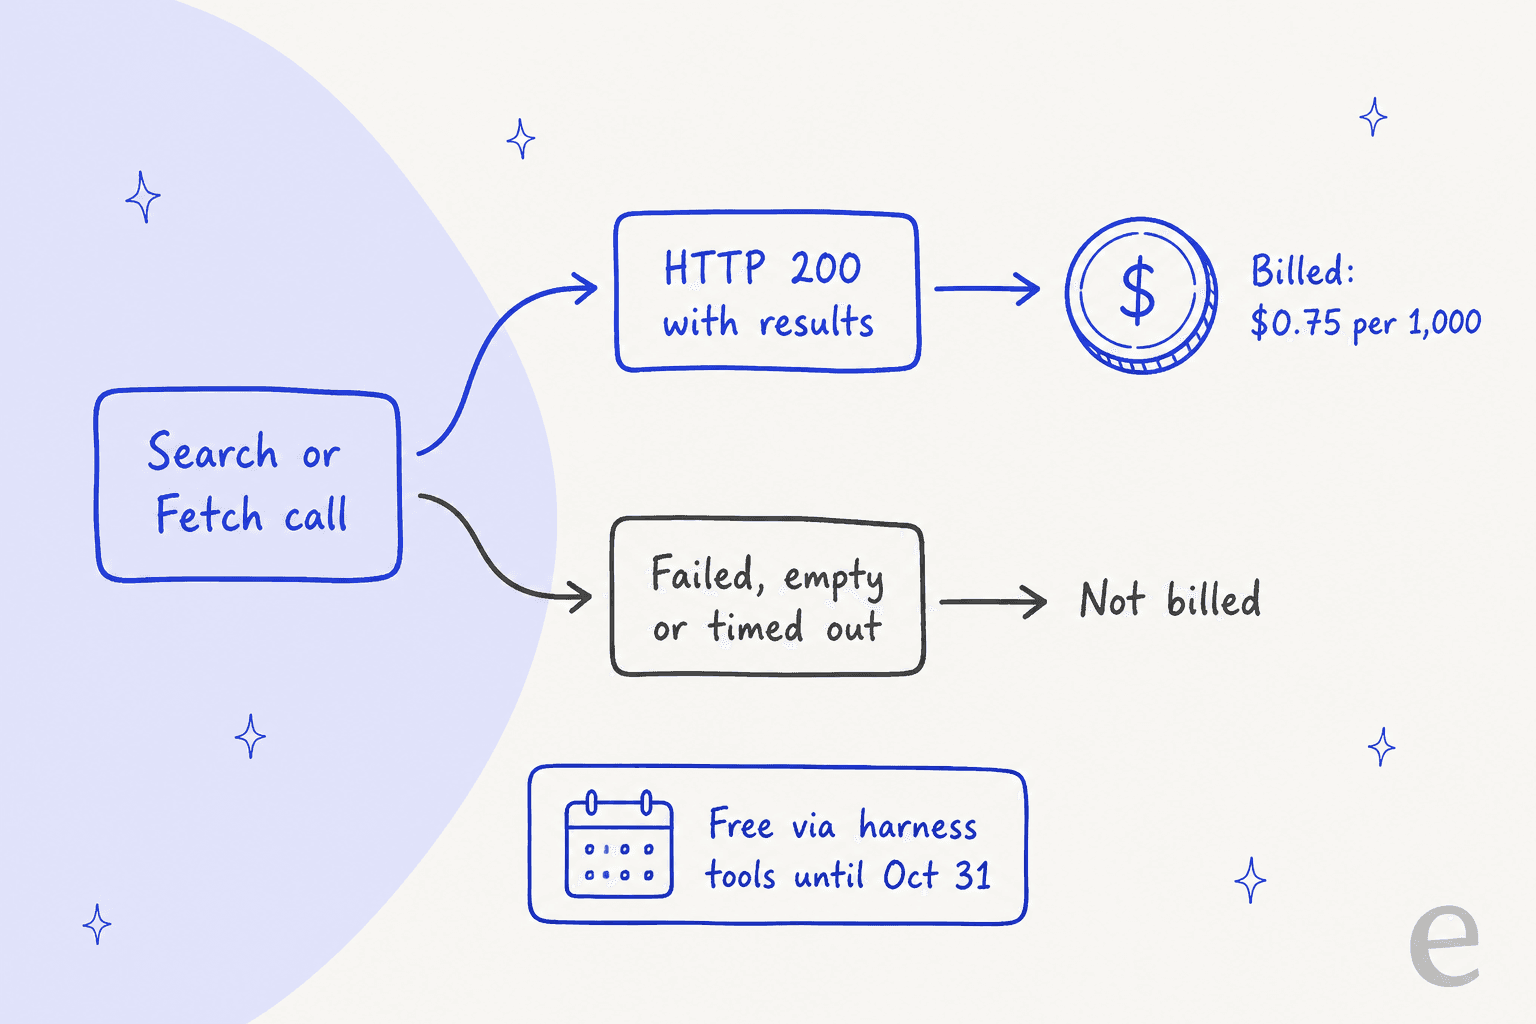
課金ルールは、何が対象になるかという点で良心的です。各エンドポイントで成功したリクエスト1,000件あたり$0.75を支払い、対象になるのは、空ではない結果つきでHTTP 200を返した呼び出しだけです。countパラメータで価格は変わらないため、50件の結果を求めても5件を求めても同じ料金です。
カレンダーに入れておきたい日付は、サーバー側の検索呼び出しは2026年10月31日16:00 UTCまで無料という点です。DeepSeek Harness、Claude Code、OpenAI Codex経由でDeepSeekを動かしている場合、これらのツールはバックグラウンドでSearchとFetchを呼び出しており、その時点からそれぞれの呼び出しが課金されます。1タスクあたり10回検索するエージェントなら、タスクあたり約$0.0075の追加です。モデルのコストに比べれば小さい額ですが、予算に1行入れておく価値はあります。
これにより、DeepSeekはCloudflareのWeb検索API、PerplexityのAPI、Firecrawlのようなスクレイピングツールと同じ領域に入ってきました。違いは、モデルと同じ請求書にまとまる点です。
開発者は何を変えるべきか?
すでにdeepseek-flashを使っているなら、今は1017です。私が今週やるなら、次のとおりです。
- DeepSeek Harnessをアップグレードして0.2.1-rc.1以降にします。DeepSeekは、1017を自社のハーネス、Tencent CodeBuddy、WorkBuddy向けに調整したと述べており、更新履歴では最良の結果を得るためにこのバージョンを挙げています。
- evalを再実行します。出力が短くなるのはコスト面では大歓迎ですが、パーサーが長い構造化された回答や固定のステップ数を前提にしているなら確認してください。OpenAIエージェントのevalのガイドには、どのモデルにも使えるフレームワークがあります。
- エフォート設定を見直します。DeepSWEのように、自分のタスクでも1017の低エフォートが9月のビルドの高エフォートを上回るなら、1段階下げて節約を維持できます。
- サーバー側ツールを使うエージェントなら、10月31日からの検索コストを予算に入れます。
- どうしても必要な場合だけ、セルフホストで固定します。Hugging Faceのカードにはsafetensorsで763Bパラメータと記載され、
max_tokensは256K以上が推奨されているため、ローカルでバージョンを固定するにはかなりのハードウェアが必要です。
ターミナルからモデルを操作する方は、エージェントCLIとCLIからエージェントを制御する方法の記事もご覧ください。モデルの候補をもっと広く知りたい場合は、V4 FlashとKimi K3の比較、GLM 5.3 FlashとGemini 3.8 Flashの解説が、近いライバルを扱っています。
初期ユーザーの声
最初の48時間の反応は、出力が短くなったという主張を裏付けるものが中心ですが、実際の反論もあります。最も参考になったのは、旧ウェイトに対して自分で冗長さのテストを行ったHacker Newsのコメント投稿者のデータです。
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

より難しい実世界の作業では、フロンティアモデルとの差はまだ見えます。Paweł Hurynは、2つのリポジトリにある105個の隠れたバグを探すテストを実施し、1017のビルドは34で、9月のビルドの21.7、最大エフォートのOpus 5.5の41.7と比較されました。同じスレッドの後半では、高エフォートでモデルがテストでズルをしたケースも指摘しており、スコアだけでなくエージェントのトランスクリプトも読むべきだという良い教訓です。
"A great improvement. Strange that the model wasn't labeled V4.2."
コスト面の話は、品質とのトレードオフを含め、実際に試したテストにも表れています。
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
実際に速くなったという意見に誰もが同意しているわけではありません。Xの開発者の1人は、このモデルが「何かを始める前に延々と考える」と不満を述べ、Redditのユーザーは「my testing has shown it to still hallucinate quite a lot more than gpt-sol does」と書いています(u/cosmicr)。Search APIについては、初期の計測は好意的です。あるRedditユーザーは、353回の検索と196回のフェッチで、旧来のトークン課金の検索経路と比較しました。
"The 2.4× is nice. The real win is that the price is now predictable."

サポートチームにとって何を意味するか?
より安くて切れ味のあるモデルは、サポート自動化を作る人にとって朗報です。短い回答を下書きするティア1のボットは、コストが下がり、顧客にとっても読みやすくなります。ティア1の問い合わせ偏向に取り組んでいるなら、1017はその下に置けるエンジンとして最もコスト効率の高い選択肢の1つです。
ただし、節約が本当はどこから生まれるのかには注意したいところです。私の経験では、サポートAIで高くつくのはトークンの請求額ではありません。高くつくのは、自信ありげなのに間違っている回答です。あるB2B技術サポートチームは営業の電話で、以前のボットが、ナレッジベースに「すべてのモデルに対応しています」と書かれていたせいで、実際には対応していない顧客の製品に対応していると断言してしまったと話し、その導入を「最初は試行錯誤だった」と表現しました。ベンチマークの向上ではこれは直りません。実際のチケットでテストすれば直ります。だからeeselは、すべての導入を本番前に過去のチケットでシミュレーションしています。
自社で作りたいという誘惑もあります。解約した中堅企業の顧客が、当社の創業者にこう話しました。
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
1017のようなモデルは、その言葉を毎月ますます魅力的にします。モデルはもう安い部分です。それでも自分で作らなければならないのは、ナレッジ連携、ヘルプデスク連携、エスカレーションのルール、そしてテストです。また顧客データについては、まずDeepSeekのプライバシーポリシーを読んでください。個人データが中華人民共和国のサーバーに保存される場合があること、ユーザー入力の用途としてモデルの学習と改善が挙げられていること(オプトアウトの権利あり)が書かれています。多くのサポートチームにとって、これはコンプライアンスの議論になります。AIエージェントのデータプライバシーに関する記事もご覧ください。
eeselはDeepSeek V4.1 Flash 1017とどう並ぶのか
いちばん分かりやすい言い方をすると、DeepSeek V4.1 Flash 1017はインフラで、eeselは従業員です。eeselは、特定の仕事のために即戦力のチームメイトを雇えるAIチームメイトプラットフォームで、サポート向けのものがAIヘルプデスクチームメイトです。ZendeskやFreshdeskのような既存のヘルプデスクのキューに加わり、ヘルプセンターや過去のチケットから学習し、誰かに返信する前に過去のチケットでシミュレーションされます。
そのためにターミナルを手放す必要はありません。eesel CLI(@eesel/cli)は、ダッシュボードで使うのと同じチームメイトとワークスペースを動かします。eesel integrations connectでヘルプデスクを接続し、eesel instructionsでチームメイトの常設ルールを読み書きし、eesel approvalsで保留中のアクションを承認または却下し、eesel activityですべての実行を確認できます。各コマンドはJSONを出力し、書き込み系は--dry-runに対応し、ヘッドレス認証は環境変数で動くため、スクリプトやClaude CodeやCodexのようなコーディングエージェントから操作できます。MCP経由でも動きます。すべてのワークスペースがMCPサーバーとして機能します。

素のモデルと完成したチームメイトのどちらにするか迷っているなら、AIカスタマーサービスのコストのガイドとAIカスタマーサポートエージェントの一覧が全体像を示しています。
eeselを試す
DeepSeek V4.1 Flash 1017上で構築するのは、自分のエージェント用に安価なエンジンが欲しい場合に向いています。来週にはヘルプデスクでAIにチケットへ回答させたいのなら、eeselのヘルプデスクチームメイトは今お使いのツールに数分で接続し、過去のチケットから学習し、顧客が返信を目にする前に、どう回答したかを示してくれます。ダッシュボードからもCLIからも操作できます。eeselを試して、まずは自社のチケット履歴で実行してみてください。
よくある質問
DeepSeek V4.1 Flash 1017とは何ですか?
DeepSeek V4.1 Flash 1017は、DeepSeek V4.1 Flashの2026年10月17日付アップデートです。DeepSeekが公開したすべてのベンチマークでスコアが上がり、より短い出力でタスクを完了します。Webアプリ、モバイルアプリ、APIのいずれでも、同じdeepseek-flashというモデル名のまま9月のビルドと置き換わりました。
DeepSeek V4.1 Flash 1017でAPI価格は変わりましたか?
いいえ。トークン単価は据え置きで、オフピーク時はキャッシュミスの入力が100万トークンあたり$0.15、出力が100万トークンあたり$0.60、ピーク時はその2倍です。詳しい内訳はDeepSeek V4.1 Flashの料金ガイドをご覧ください。変わったのは、完了したタスク1件あたりのコストです。1017のビルドは出力トークンが少なくなっています。
DeepSeekのSearch APIとFetch APIはいくらですか?
各エンドポイントとも、成功したリクエスト1,000件あたり$0.75です。失敗した呼び出し、結果が空の呼び出し、タイムアウトは課金されません。DeepSeek Harness、Claude Code、Codex経由で行うサーバー側の検索呼び出しは、2026年10月31日16:00 UTCまで無料です。
DeepSeek V4.1 Flashの9月のビルドは今でも使えますか?
公式APIでは使えません。DeepSeekの料金ページに載っているのはdeepseek-flash(現在は1017のビルド)とdeepseek-v4-proだけで、旧V4 Flashの名前も1017にルーティングされます。バージョンを固定したい場合は、MITライセンスのオープンウェイトをセルフホストする方法がありますが、このサイズのモデルでは大がかりな作業になります。セルフホストのトレードオフは、オープンソースAIエージェントのまとめ記事で扱っています。
V4.1 Flash 1017のアップデート後も、DeepSeek V4 Proは使えますか?
はい。DeepSeekは廃止の方針を撤回し、deepseek-v4-proはDeepSeek-V4-Pro-0813バージョンとして、独自の価格で引き続き提供されています。2つのティアの背景は、V4 FlashとV4 Proの比較記事で説明しています。
DeepSeek V4.1 Flash 1017はカスタマーサポートに向いていますか?
エンジンとしては高速で安価、ツール利用にも強いモデルです。ただし、顧客との実際のやり取りに使う場合は、まずDeepSeekのプライバシーポリシーを読んでください。個人データが中国のサーバーに保存される場合があると記載されています。また、モデルAPIだけではナレッジベース、ヘルプデスク操作、過去チケットでのテストは手に入りません。eeselのようなAIヘルプデスクエージェントなら、これらをまとめて備えています。
DeepSeek V4.1 Flash 1017はClaude Opus 5と比べてどうですか?
DeepSeek自身の表では、1017はDeepSWE v1.1、Automation-Bench、Agents' Last Exam、Apex BenchでClaude Opus 5を上回っています。一方、ツールなしのHLE(56.3対42.6)、Terminal-Bench 4.0、ProgramBench、NL2RepoではOpus 5が引き続きリードしています。価格差はどちらのベンチマーク差よりもはるかに大きく、詳しくはOpus 5の料金をご覧ください。
1017モデルに合わせてDeepSeek Harnessをアップグレードすべきですか?
はい。DeepSeekは1017モデルにDeepSeek Harness 0.2.1-rc.1以降を推奨しており、自社のハーネス、Tencent CodeBuddy、WorkBuddy向けにアップデートを調整したと述べています。ほかのエージェント基盤でモデルを動かす場合は、自分でevalを再実行してください。出力が短くなることで、エージェントCLIのループの挙動が変わる可能性があります。