

DeepSeekが、見ることのできるモデルを公開しました。2026年8月21日です。deepseek-v4-flash-vision-expは通常のV4-Flashとまったく同じ料金で、1Mのコンテキストウィンドウも変わらず、画像は通常の入力トークンとして課金されます。
ただし、発表は面白い部分を埋もれさせています。DeepSeek自身の説明では、ビジョン版はテキストでV4-Flashに「matches」するとされています。ところが同社のベンチマーク表はそれ以上のことを示しています。ビジョン版は、7つのテキストエージェントベンチマークのうち6つでテキスト専用モデルを上回っています。DeepSWEでは5ポイント近く、Toolathlon-Verifiedでは5.5ポイントです。つまり、本当に問うべきは画像のことではなく、テキストのトラフィックを実験的ビルドに移すかどうかです。
そして落とし穴です。モデルが見る前に、すべての画像はおよそ800×800ピクセルに押しつぶされ、384トークンが上限になります。5000ピクセルのスクリーンショットもサムネイルも、リサイズ後には同じものになるので料金は同じです。つまり、この定額は太っ腹なのではなく、解像度の上限を料金表の形で書いたものです。
私はeeselで連携とAPIまわりを出荷しており、リリースノートはdiffを読むように読みます。何が変わったか、何が黙って変わらなかったか、午前2時に呼び出されるのは何か。ここで面白いのは、静かに消えた2つの機能です。FIM補完がなくなり、モデル文字列にビルド日付がありません。月曜日にテストしたものが、金曜日にトラフィックを処理しているものと同じとは限らないのです。
そしてこれをサポートキューに向けるなら、何が解決されるのかをはっきりさせてください。顧客のスクリーンショットを読むのは簡単な半分です。難しい半分は、その顧客に届く前に答えが正しいと分かっていることで、これはより大きなモデルの問題ではなく、グラウンディングとテストの問題です。だからこそeeselは、ライブのチケットに答える前に、実際の過去チケットでエージェントをリプレイします。
DeepSeekが実際に出荷したもの
今回のリリースは3つが同時に出たもので、見出しになったのはそのうち1つだけです。
ビジョンモデル。deepseek-v4-flash-vision-expは、Chat Completions、Anthropic互換の/messagesエンドポイント、またはResponses APIを通じて、テキストと同じリクエストで画像を受け取ります。対応形式はJPEG、PNG、GIF、WebPで、ビジョンガイドによると、形式はファイル名や宣言されたMIMEタイプではなく、ファイルの中身から判別されます。
**無料のFiles API。**画像を一度アップロードすれば、以降はリクエストをまたいでfile_idで参照できます。画像1枚あたりの上限も32 MiBから64 MiBに上がり、思う以上に重要です。
**ハーネスのリリース。**同じ日にDeepSeek Harness 0.1.1が公開され、すでに対応が組み込まれています。
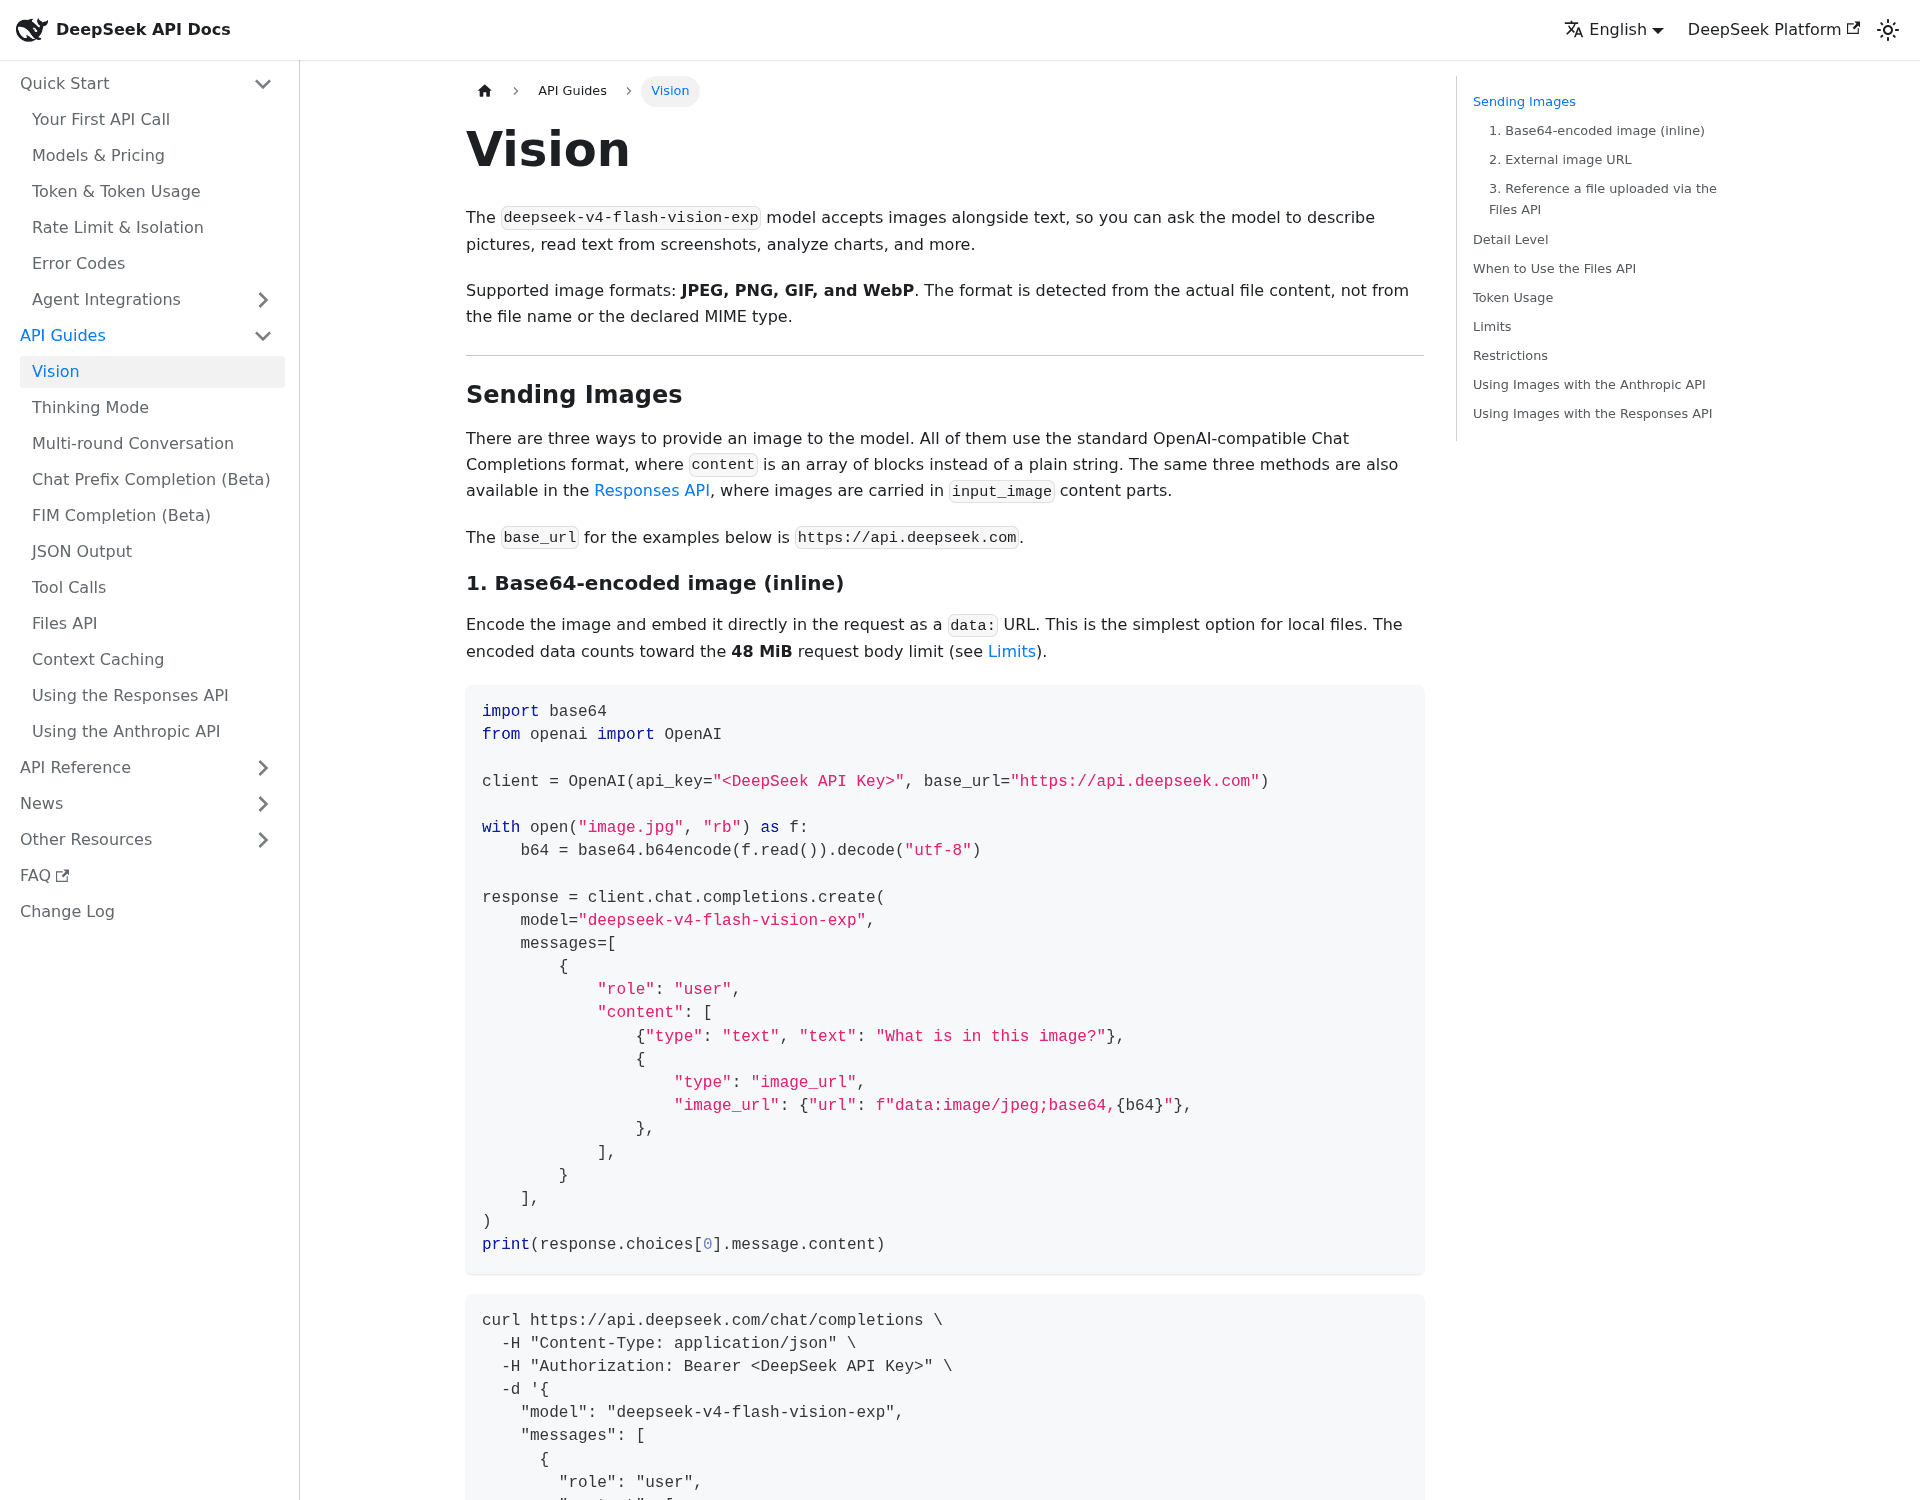
アーキテクチャは、派生元のモデルから変わっていません。OpenRouterのモデルページによると、合計284Bのうちアクティブ13Bのスパースなmixture-of-expertsです。コンテキストは1Mトークン、最大出力は384K、同時実行数は2,500のままです。すでにDeepSeek V4 Flashで構築しているなら、モデル文字列を差し替えるだけで移行は完了します。
脚注のように見えて、そうではない細部が1つあります。画像はuserメッセージでしか受け付けられません。systemやassistantのメッセージに入れると400が返ってきます。エージェントのループがツールの出力をアシスタントのターンに詰め込んでいるなら、それは設定変更ではなく書き直しです。
384トークンの上限が設計のすべて
モデルを軸に何かを計画する前に、ここを理解しておく価値があります。
推論の前に、DeepSeekは入ってくるすべての画像をリサイズします。およそ384×384ピクセル未満のものは、アスペクト比を保ったまま拡大されます。それより大きいものは、やはりアスペクト比を保ったまま、総ピクセル数が800×800の画像とほぼ同じになるまで縮小されます。結果として画像1枚あたり384トークンという厳格な上限になり、ドキュメントもその帰結をはっきり書いています。2000×2000の画像と5000×5000の画像は、同じ数のトークンを消費します。
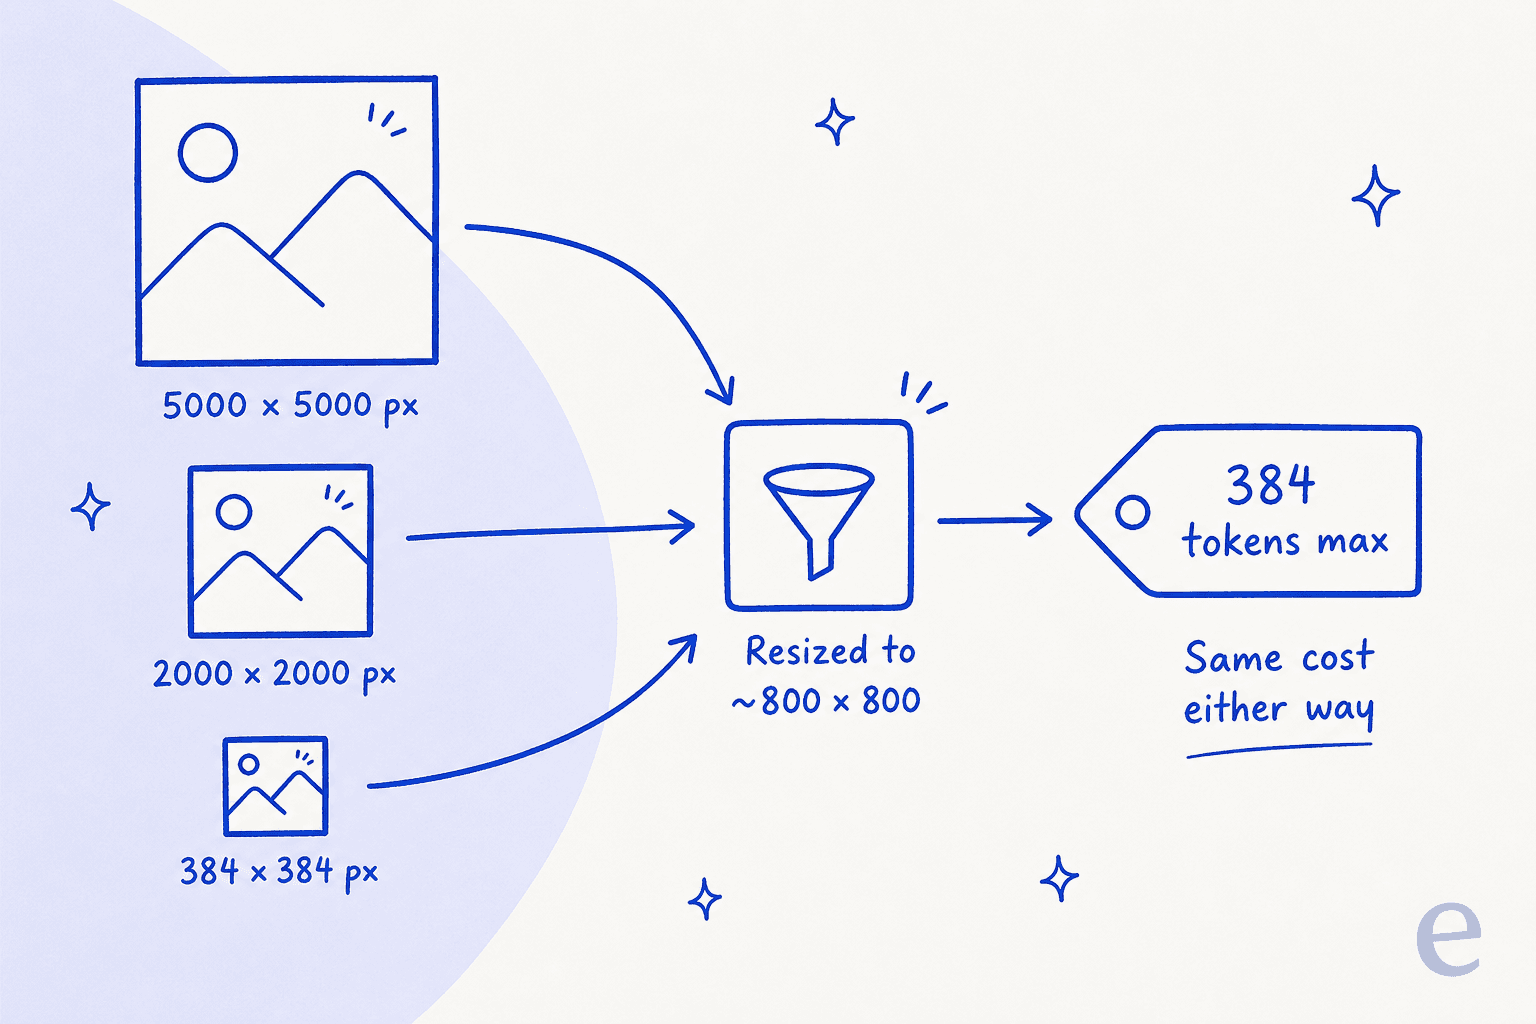
つまり画像はほぼ無料です。入力100万トークンあたり$0.22のオフピーク料金では、384トークンは約**$0.00008**です。Hacker Newsのコメント投稿者が計算し、ほぼ同じ結論に達しました。
"400 tokens per image results in 2,500 images per dollar, if I'm not mistaken."

彼は正しく、その数字は少し噛みしめる価値があります。この水準では、見るコストはほとんどのエージェント予算の中で端数に丸められます。
しかしここで、価格と解像度は2つではなく1つの決定です。安いのは、見方が粗いからです。そのスレッド全体で最も鋭い反応は、短いものでした。
"Oof 800 by 800 kills a lot of use cases"
もっともで、スレッドはその後、実際どれほど重要かを長く議論しました。人々が落ち着いた回避策は、クロップとズームのツールです。モデルに高解像度画像の一部領域を要求する能力を与え、全体をぼかして読む代わりに、600×600の切り出しをネイティブの精細さで読ませます。うまくいったと報告した人が何人もいました。一方で、明らかな限界を指摘する人もいました。9つの切り出しを1つの空間的な理解に縫い合わせ直すのはそれ自体が難しい問題で、図面で物を数えたり関係をたどったりするところで破綻する、というものです。
どちらの陣営も正しく、ただ対象とする作業が違います。ボタンが正しい位置に描画されたかの確認は、800×800への縮小でも十分に耐えます。レシートの8ptの文字を読むのは耐えません。
detailパラメータもあり、主に「しないこと」で知っておく価値があります。lowは速度のために512×512に縮小します。high、original、autoは現在すべて同じ意味で、元の画像を保持したうえで、結局は標準のリサイズをかけます。手を伸ばせる高解像度モードは存在しません。
ベンチマーク表は発表より多くを語る
DeepSeekのリリースノートは、ビジョンモデルのテキスト面を1語で表しています。V4-Flashに「matches」するというものです。同時に公開された表は、そこまでは言っていません。
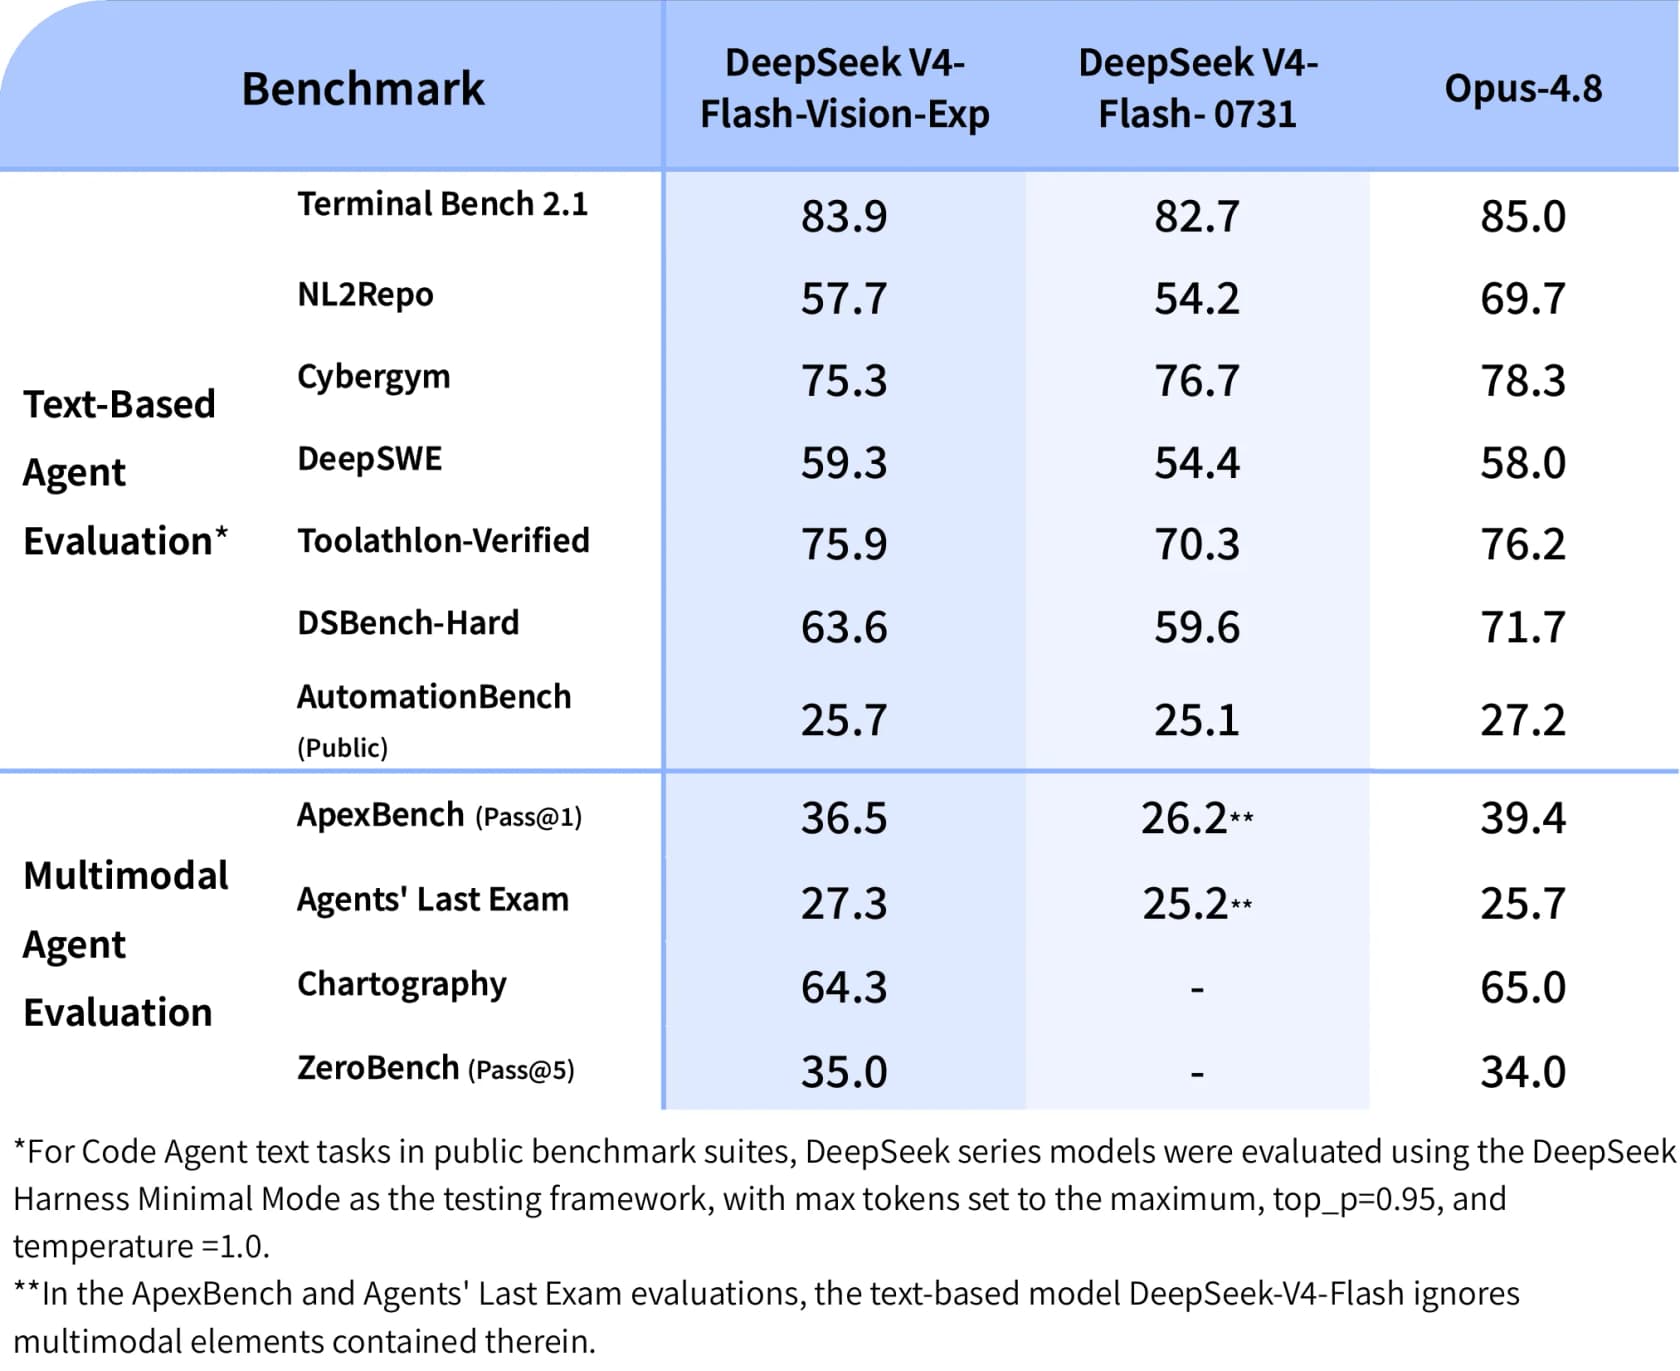
テキストベースのエージェントの行を並べると、ビジョン版が7つのうち6つを取っています。
| テキストエージェントのベンチマーク | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
DeepSWEは4.9ポイント、Toolathlon-Verifiedは5.6ポイント動いています。これは丸め誤差ではありません。DeepSWEでは、ビジョン版はOpus-4.8も59.3対58.0でわずかに上回っています。「テキストでmatches」という表現は、DeepSeek自身のハーネスがここで測ったものを過小評価しており、これらの行からコーディングやツール利用のモデルを選ぶなら、画像を1枚も送らなくてもビジョン版のほうが良い選択です。
次にマルチモーダル側です。ここは枠組みをもう一度見直す価値があります。
| マルチモーダルのベンチマーク | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | – | 65.0 |
| ZeroBench (Pass@5) | 35.0 | – | 34.0 |
*DeepSeek自身の脚注:ApexBenchとAgents' Last Examでは、テキストベースのV4-Flashはタスクのマルチモーダル要素を無視します。
この脚注が多くの役割を果たしています。マルチモーダルのエージェントベンチマークでの「V4-Flashに対する大きな飛躍」は、一方のモデルが見られて他方が見られないことを測っている部分があり、それは事実ですが能力の向上と同じではありません。誠実な比較はOpus-4.8の列にあり、そこでは接戦です。DeepSeekはApexBenchで2.9、Chartographyで0.7及ばず、Agents' Last ExamとZeroBenchではわずかに上回ります。「Opus-4.8に近い」は妥当な主張であり、AnthropicのAPI料金のごく一部で使えるモデルとしては、これこそが見出しです。
読み違えないための注意が2つあります。DeepSeekシリーズの数値はすべて、top_p=0.95とtemperature=1.0でのDeepSeek Harness Minimal Modeによるもので、ベンダー自前の足場です。また、これらはベンダーによる公開初日の数値で、独立した再現ではありません。当社のものを含め、あらゆる一次情報の表と同じように扱ってください。
実際のコスト
料金表は通常のV4-Flashと同一で、これがリリース全体で最も役に立つ事実でしょう。オフピークで100万トークンあたり、キャッシュヒット$0.007、キャッシュミス$0.22、出力$0.66です。ピーク時はこの3つがすべて2倍になります。ピーク時間は月曜から金曜のUTC 01:00〜04:00と06:00〜10:00で、米国やEUのワークロードは、地理的な偶然によって大半が安い料金で課金されることになります。
また、定価はほとんどの人が実際に払う金額ではありません。OpenRouter自身のテレメトリでは、観測されたキャッシュヒット率が88.9%に達しているため、実効入力価格は定価$0.22に対して100万あたり$0.03073です。出力はほとんど動かず、定価$0.66に対して実効$0.6595です。お金の行き先で言えば、キャッシュは入力側でほぼすべての仕事をし、出力側では何もしません。つまり請求は、端数の丸め誤差がついた出力トークンの請求になります。
自分の数字を入れてみましょう。
現実的なスクリーンショット駆動のエージェントをこれに通しても、形は変わりません。画像はほとんど目立たず、請求は出力トークンです。そこで指摘しておきたい数字があります。OpenRouterでの最初の3日間に、このモデルはプロンプト25Bトークン、コンプリーション69.6Mトークン、そして推論139Mトークンを消費しており、推論はコンプリーションのおよそ2倍で動いています。思考モードは既定でオンで、推論トークンは出力料金で課金されます。したがって、コストモデルが出力を「回答の長さ」として扱っているなら、3倍ほど外れています。同じ罠はDeepSeek V4 Flashの料金の解説にも出てきて、ベンダー間で料金表をそのまま比較するとなぜこれほど誤解を招くのかの、かなりの部分を説明しています。OpenAIのAPIを解決単位課金のサポートツールと比べたことがある人は、反対側から同じ問題に出会っています。
実際に引っかかる制限
ほとんどは余裕のある制限です。ただし2つは違います。
| 制限 | 値 |
|---|---|
| 対応形式 | JPEG、PNG、GIF、WebP |
| 1リクエストあたりの最大画像数 | 600 |
| リクエスト本文のサイズ | 48 MiB |
| 画像1枚の最大サイズ(base64 / URL) | 32 MiB |
| 画像1枚の最大サイズ(Files API) | 64 MiB |
| 1リクエストあたりの画像合計の最大サイズ | 64 MiB、file_id使用時は200 MiB |
| 画像の最大寸法 | 1辺8192 px |
| 15枚以上のときの最大寸法 | 1辺4096 px |
| 外部URLの長さ | 8192文字 |
| 外部画像のダウンロードタイムアウト | 60秒 |
1リクエストに600枚というのは大きな余裕です。しかし、リクエストが15枚以上の画像を含むと寸法の規則が静かに半分になる点に注目してください。これはまさにバッチ文書処理ジョブの形です。そして外部URLの60秒というダウンロード枠は、テストでは問題なく動き、遅い顧客CDNに向けた最初の瞬間に断続的な失敗を出し始める類のものです。パイプラインで画像が重要なら、Files APIは後回しにする最適化ではなく、より安全な既定の選択です。
手放すもの
2つあり、どちらも発表の箇条書きには載っていません。
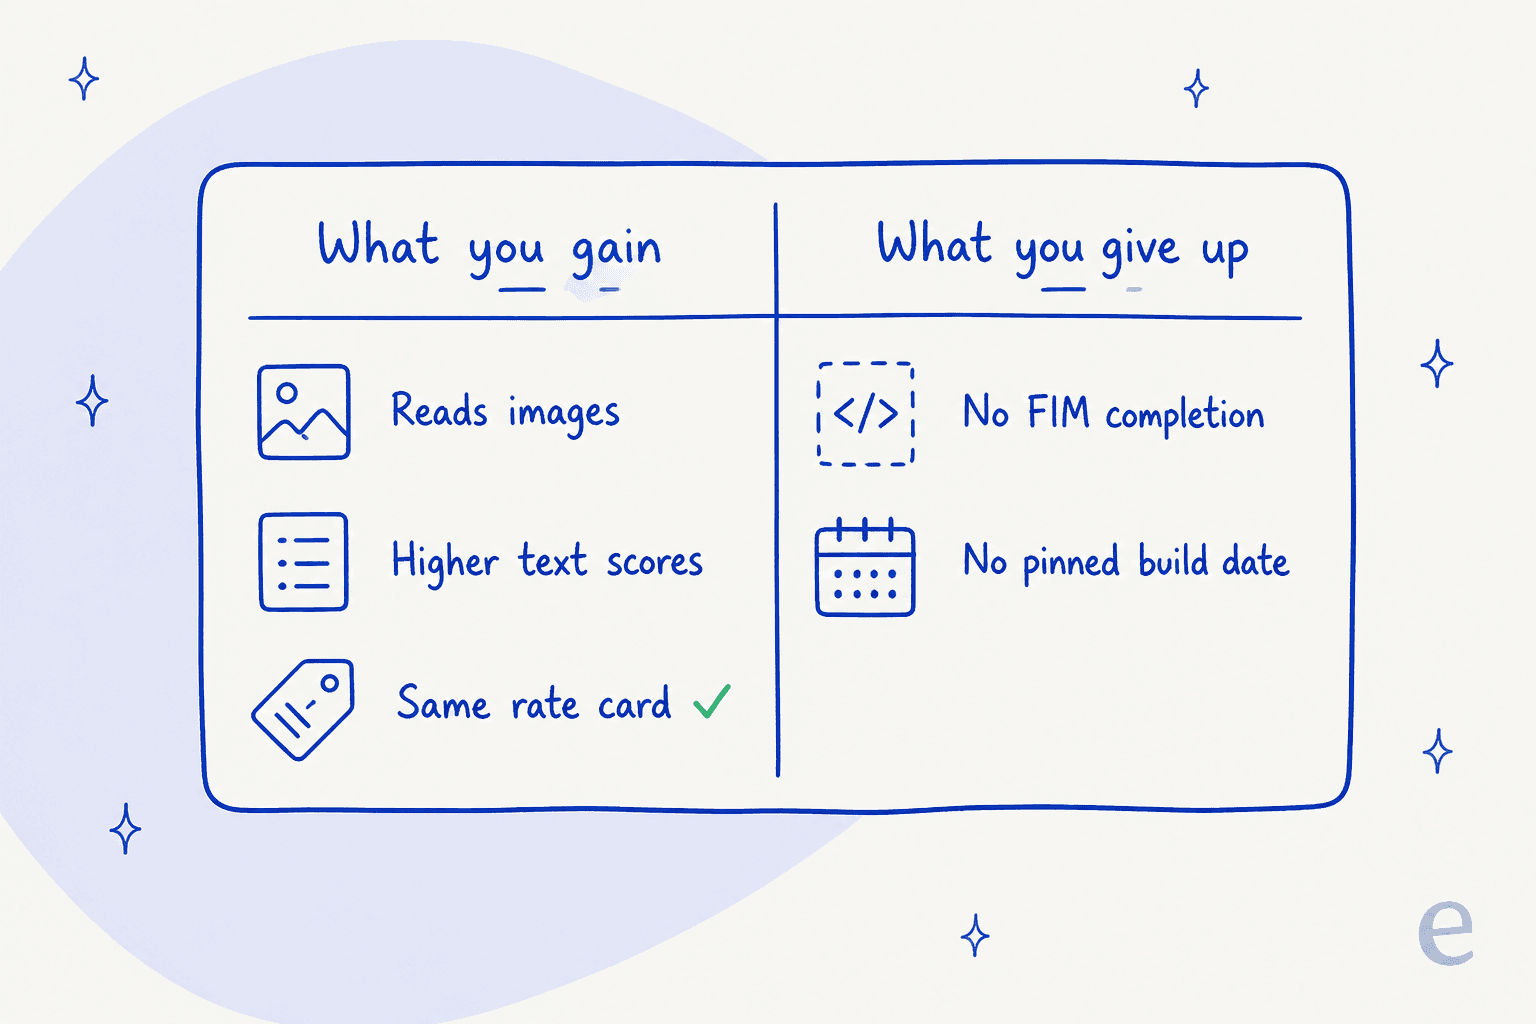
**FIM補完は非対応です。**通常のV4-FlashとV4-Proはどちらも非思考モードでfill-in-the-middleを提供していますが、料金ページではビジョンビルドについて「Not supported」と記載されています。インラインのコード補完にFIMを使っているなら、このモデルはそのまま置き換えられず、これがリリースで唯一の確実な障害です。
**ビルド日付がありません。**こちらはもっと微妙で、私がまだ本番トラフィックを移さない理由です。料金表がバージョンをどう命名しているか見てください。通常のFlashはDeepSeek-V4-Flash-0731、ProはDeepSeek-V4-Pro-0813、そしてビジョンビルドは単なるDeepSeek-V4-Flash-Vision-Expです。日付のあるビルドは、根拠をもって扱えるビルドです。スタンプのないexpラベルは動く標的であり、Hacker Newsのコメント投稿者も同じようにロードマップを読んでいました。
"most likely a preview. they often release the preview via API, get more training data, post train some more then release the weight. i would expect to see it perform better in a few weeks or a month."
そのとおりなら、この記事の数値には賞味期限があり、今週あなたが走らせる評価にもあります。実験的エンドポイントを使う際の普通のコストです。それを受け入れたことを忘れたときに、初めて問題になります。
実トラフィック最初の72時間が示すこと
ベンダーのベンチマークは別の話です。ここでは、OpenRouterによる、モデルの最初の3日間のルーティング層自身の計測値を示します。
- P50スループットは85トークン/秒、P50レイテンシは1.11秒です。
- **ツール呼び出しのエラー率は1.27%。**マルチモーダルなエージェント作業が売りのモデルとして、最初に確認したい数字で、問題ありません。
- **稼働率100%、可用性99.93%**ですが、プロバイダは1つだけです。DeepSeekが直接提供しているので、迂回できるフェイルオーバー先はありません。
- **キャッシュヒット率90.4%**で、実効入力価格を定価の約7分の1まで引き下げています。
ただし、分布の裾は見ておく価値があります。P99レイテンシは18.34秒、P99のエンドツーエンドは99.94秒です。バッチジョブには十分な分布ですが、人が待つものには厳しく、顧客の前に置くあらゆるAIエージェントと同じトレードオフです。
トラフィックの内訳が最も興味深い部分です。上位の利用者はすべてコーディング用ハーネスです。Claude Codeが9.58Bトークン、piが4.56B、Hermes Agentが3.3B、それにDeepSeek自身のマルチモーダルブリッジのハーネスが3.12Bです。チャットモデルとして使っている人はいません。コードベースと画面に向けており、7つのうち6つのテキストベンチマークで勝っていることと見事に符合します。
安価なビジョンモデルがここまで響いた理由について、もう1つ文脈があります。通常のV4-Flashは、何か月も見えているふりをしていたようです。
"It tried to recreate vision by analyzing pixels on 3 separate projects I had it working on."
別のコメント投稿者は、試行がセッションを壊し続けたので、0731にスクリーンショットを開くのをやめるよう指示しなければならなかったと述べています。その基準に比べれば、単に画像を見るモデルは、ぼやけていても本物の改善です。
使うべき人と、待つべき人
**今すぐ使うべきなのは、**画面とコードベースに対してエージェントのループを回していて、すでにV4-Flashを使っていて、FIMに依存していない人です。テキストのベンチマークだけでもモデル文字列の差し替えは正当化され、ビジョンは上乗せです。バッチの文書作業も合いますが、自分の文書がリサイズに耐えるかを先に確認していることが条件です。
**待つべきなのは、**固定されたビルドが必要な人、FIMが必要な人、画像が細部に依存している人です。アナログの文字盤、密な図面、レシートの小さな印字は、計画の前提にする前に必ずテストしてください。Hacker Newsのスレッドを貫いた時計を読む議論は、1回きりのビジョン判定がいかにノイズだらけかをよく示しています。あるコメント投稿者の失敗が、別の人が10回走らせたら10回中9回の正解になり、モニターに貼っておくべき一文を生みました。
"Lesson learned to double check what I read on the internet."
**もっとよく考えるべきなのは、**これをサポートキューに向ける人です。顧客のスクリーンショットはサポートで最も価値の高い入力の1つですが、同時に800×800の上限とは最悪の相性です。顧客がスクリーンショットを送る理由そのものが、中の小さな文字だからです。生のモデルをライブのキューにつなぐ前に、サポート向けモデルの選び方と、どのLLMがサポートに向くかについての記事をお読みください。
スクリーンショットだらけのサポートキューのためのeesel
このモデルがサポートチームに何を解決するのかを正確にしておきたいと思います。需要のシグナルが手元にあるからです。eeselをZendeskのコパイロットとして使っている、バケーションレンタル向けのサポート代行会社のお客様が、完全な自律運用に進めない理由をはっきり教えてくれました。
"Eesel is currently unable to analyze images, and our customers frequently share screenshots. Our agents are currently required to read these images and manually transfer the knowledge to Eesel."
これは本当に満たされていないニーズで、このようなモデルがいずれ埋めるでしょう。ただし、ビジョンモデルが実際にどちらの半分を埋めるのかは、はっきりさせる価値があります。ピクセルを読むのは簡単な半分です。そこから正確でポリシーに沿った答えを出すのが難しい半分で、AIサポートを出荷したことのある誰もがつまずいてきたのも、こちらの半分です。
私たちは、自信ありげなボットが、ナレッジベースに"we support all models"とあったのを文字どおりに受け取り、対応していない車種に対応していると顧客に静かに伝えていたのを見たことがあります。月に約200件のチケットを扱う、Zendeskを使うテレマティクスのチームでの話です。ビジョンエンコーダのどこにも、その種の失敗を直すものはありません。直せるのは、エージェントを実際の履歴に根づかせ、顧客が触れる前に挙動を実証することで、だからすべてのeeselの導入は、まず過去のチケットでリプレイされ、一度に1つのチケットタイプに絞り込まれます。

ですから、キューがスクリーンショットだらけだからDeepSeekのビジョンモデルを評価するのであれば、2つのテストを正しい順番で行ってください。1つ目は、リサイズ後の実際の画像をモデルが読めるかどうか。2つ目は、こちらのほうが重要ですが、返ってくる答えが自分で送っていたはずのものかどうかです。eeselはこの2つ目のテストを、本番開始前にチケット履歴でシミュレーションし、席数ではなくチケット単位で課金し、信頼度の基準を下回るものは人に回すことで行います。**eeselを試す**のは無料です。ご自身のチケットでのウォークスルーも予約できます。
DeepSeekのラインナップの中での位置づけ
ファミリーを整理するなら、短く言うとこうです。deepseek-v4-flash-vision-expは0731のFlashビルドのフォークで、ビジョンエンコーダを取り付け、FIMを外したものです。Proクラスのモデルではなく、何かを置き換えるものでもありません。
- DeepSeek V4 Flashはテキストのベースラインで、本番で使う固定ビルドとして今も位置づけられます。
- FlashとProの比較は、安い階層が現在は高い階層を上回るという奇妙な状況を扱っています。
- FlashとKimi K3の比較とFlashとGPT-5.6の比較は、ベンダーをまたぐ比較を扱います。
- Qwen 3.8 MaxとFlashの比較は最も近いオープンウェイトの争いで、Kimi K3はもう1つ注目すべき存在です。
- DeepSeek V3.2は、まだ使っている場合のための前世代です。
- V4-Flashのレビューと代替のまとめが、より広い全体像を扱います。
そして、モデル選びではなくサポート自動化の視点でここに来たのなら、より役に立つ読み物はスタックの下の層にあります。
- モデルが実際にどこに位置するか:AIによるチケット管理とAIヘルプデスクエージェント。
- 多くの場合モデルより重要な検索の問題:RAGとLLMの比較。
- キューの作業がどう見えるか:チケットの偏向とチケットの分類。
- トリアージの順序と量:チケットの優先順位付け、初回応答の自動化、チケット削減。
- 人が関与するパターン:サポート向けAIコパイロット。
- ベンダーの売り文句が混同されるときの用語:エージェントとチャットボットの比較。
- 予算を左右する2つの比較:解決あたりのコストとAIエージェントと人間のエージェントのコスト比較。基準はAIカスタマーサービスのコストです。
結論
DeepSeekは、画像を実質無料で読むモデルを出荷し、そのついでに、派生元よりも優れたテキストモデルを出荷しました。どちらも本物で、どちらも安価です。
天秤にかけるべき2点は、発表が先頭に置いていないものです。すべての画像は、モデルが見る前におよそ800×800に平らにされるので、ここでのビジョンは点検ではなく一瞥です。そしてビルドには日付がないので、今週測ったものはすべて、動く標的に対する測定です。
画面とコードに対するエージェントのループなら、入力$0.22、出力$0.66でこれは良い取引です。スクリーンショットがそのままチケットであるサポートキューなら、計画の前提にする前にリサイズをテストし、画像を読むことは、そもそも問題が起きる部分ではなかったことを心に留めておいてください。
よくある質問
DeepSeek V4 Flash Vision Expとは何ですか?
model='deepseek-v4-flash-vision-exp'で呼び出すと、同じリクエスト内でテキストと一緒に画像を受け付けます。DeepSeek V4 Flashの派生版で、合計284B・アクティブ13Bのmixture-of-expertsアーキテクチャと1Mのコンテキストウィンドウは同じです。DeepSeek V4 Flash Vision Expの料金はいくらですか?
DeepSeekは画像をどのように課金しますか?
DeepSeek V4 Flash Vision ExpはV4-Flashより優れていますか?
DeepSeek V4 Flash Vision Expの落とし穴は何ですか?
0731のような固定のスタンプではなくDeepSeek-V4-Flash-Vision-Expと記載されているため、実験的ビルドはテスト当日から本番当日までの間に、足元で変わる可能性があります。DeepSeek V4 Flash Vision Expはサポート向けに顧客のスクリーンショットを読めますか?
DeepSeek APIに画像を送るにはどうすればよいですか?
file_idです。Files APIは無料で使えます。Files API経由にすると、画像1枚あたりの上限も32 MiBから64 MiBに上がります。認証とOpenAI互換のベースURLは、DeepSeek APIのウォークスルーで扱っています。