

deepseek-v4-flash-vision-exp について丸一週間、読み込みました。ドキュメント。ベンチマーク表の全体。3日分の本番テレメトリ。そしてローンチスレッドの153件すべてのコメントです。最も有用な発見は、これがビジョンモデルのリリースの皮をかぶった、より優れたテキストモデルだということです。DeepSeek自身の表では、7つのテキストエージェント系の行のうち6つでV4-Flashに勝っています。そして今のところ最大の公開利用者は? 画像を一度も送らないコーディングツールです。
ビジョン部分そのものについては、正直な要約はローンチの告知よりも狭く、反発の声よりも狭いものになります。レイアウト、グラフの形、スクリーンショットの構造は扱えます。小さな文字では崩れます。すべての画像が何より先に800×800付近へ縮小されるからで、オンにできる高解像度モードはありません。あるテスターのキャプション検証セットでは12問中6問正解、競合は11問正解でした。ただ、スコアより失敗の仕方のほうが重要です。「Salisbury」とラベルを付けたWells大聖堂の写真を渡されると、同意してしまいました。ベンチマークの話も、読み直すと甘くなります。目玉のDeepSWEの数字は競合の誤差範囲に収まり、マルチモーダルの伸びは一部「片方は見えて片方は見えない」ことを測っているだけで、表全体がローンチ当日のDeepSeek自身のハーネスから出たものです。
サポートキューにこれを向けるつもりなら、同意してしまう失敗こそ立ち止まるべき点です。渡されたラベルをそのまま肯定するモデルは、サポートでお金がかかる失敗の典型であり、大きなモデルでも直りません。直すのは、実際のヘルプコンテンツにエージェントを根拠づけ、お客様が一語も目にする前に過去のチケットで再生することです。それがまさにeeselの作られた目的です。
何をテストし、何をテストしなかったか
私はeeselでAIエージェントを作っているので、こうしたリリースではまず仕組みから入るのが習性です。モデルに実際に何が見せられるのか。重みが1ピクセルを見る前にハーネスが何をするのか。そして実際の入力が届き始めたとき、失敗がどこに現れるのか。このレビュー全体がその視点で書かれています。
方法論ははっきり書いておきます。適切な割引をして読めるようにするためです。ビジョンガイドを1行ずつ読み、料金ページでも同じことをし、その後OpenRouterから3日分の実際の本番テレメトリを取得しました。
次に、495ポイント、153コメントに達したローンチスレッドのコメントを1件ずつすべて確認しました。ここで実機結果を引用する場合、手を動かしたのは他の人で、誰なのかを明記しています。
やらなかったこと。数百枚の画像に対する、私自身の統制されたビジョン評価です。これは重要です。このスレッドからの最大の教訓は、少数サンプルのビジョンテストは自信満々の誤った結論を生むことであり、この記事が扱っているまさにその誤りを犯すのは格好がつかないからです。ですからこれは私のベンチマークではなく、証拠のレビューとして受け取ってください。
リリースを最初から最後まで、料金計算と制限の全一覧つきで知りたい方は、私のローンチ解説をご覧ください。この記事は、これが良いものかどうかだけを扱います。
時計テストは、ビジョンモデルのレビューでやってはいけないことの事例研究
ローンチスレッド全体で最も読まれたやり取りは、時計の話です。順に追う価値があります。ビジョンのレビューがどう迷走するかを示す、私が見た中で最もきれいな例だからです。
最初は単純な失敗報告でした。
"It fails the simple clock test for me which Qwen3.8 27B got (nearly) right."

詳細はこの要約より悪いものでした。描画されたアナログ時計を渡されて、DeepSeekは5:10と答え、時針を3時間外し、しかもどの針が何色かも取り違えていました。Qwen3.8 27Bは8:10と答えました。実際の時刻は08:09:25だったので、両者とも間違いで、間違い方が違っただけです。その違いについてのあるコメント者の見立ては、多くのベンチマーク解説より鋭いものでした。
"Also worth noting that both models got it wrong. Qwen made a mistake that humans very good at reading clocks would make. Deepseek made a mistake that a human who had just learned to read clocks would make."
そこで誰かがやり直し、結果がひっくり返りました。
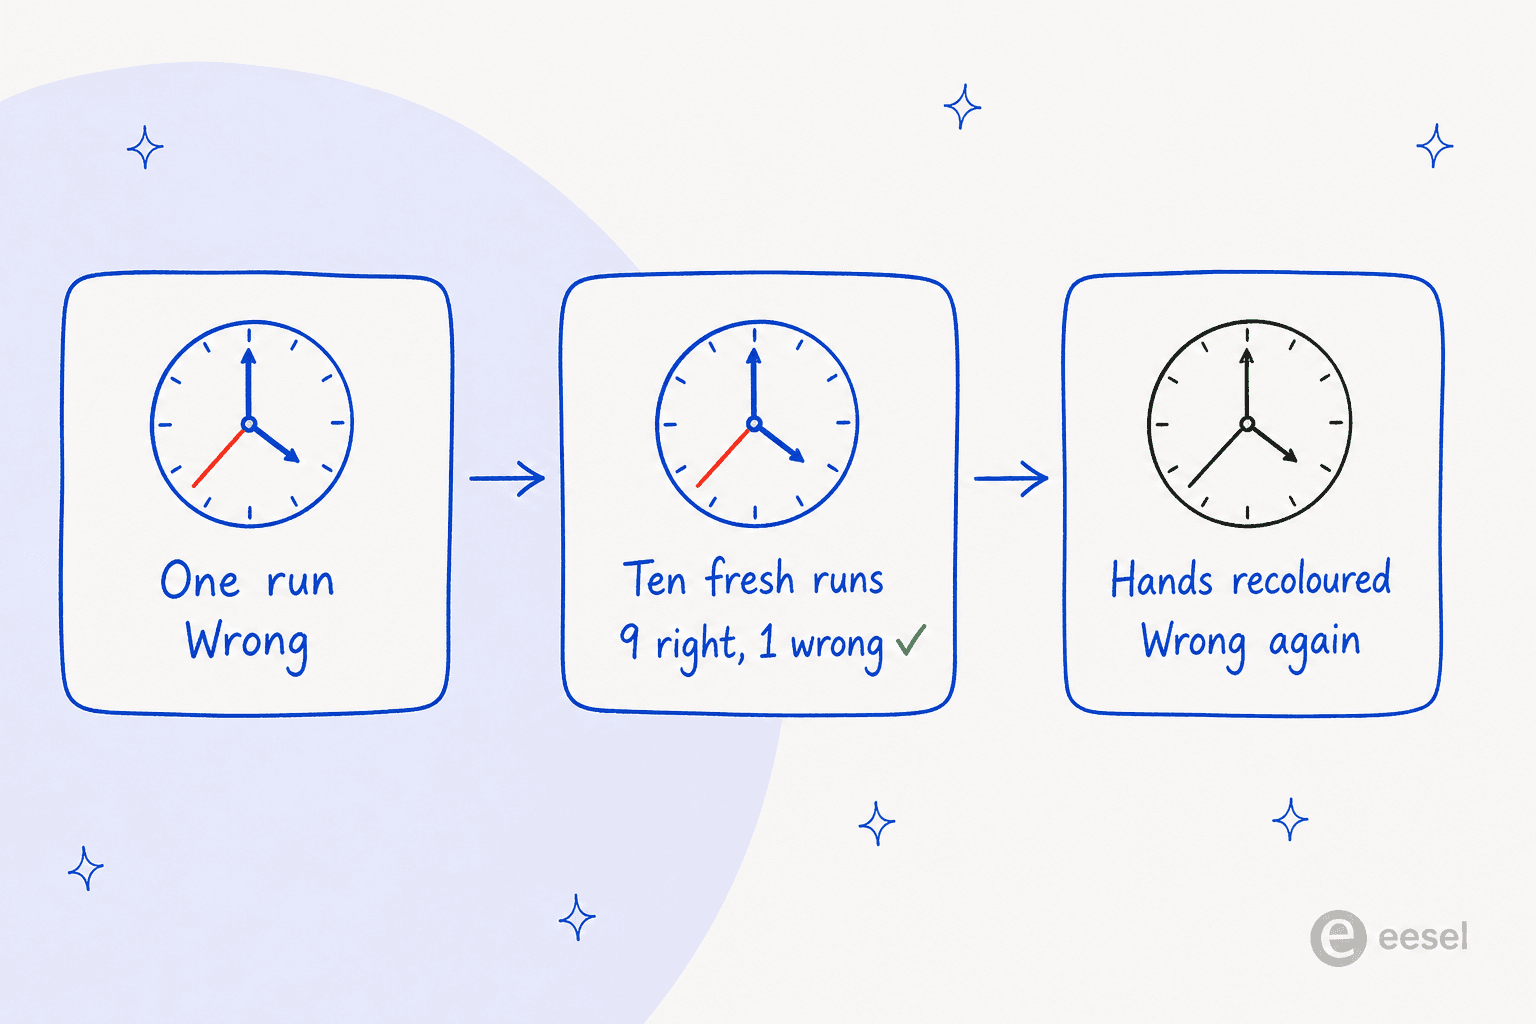
"I now ran the test 10 times total, fresh session every time, and DS4 got it right 9 out of 10 times. Lesson learned to double check what I read on the internet."
では、モデルは問題ないのか? そう単純ではなく、ここからが面白いところです。3人が別々に、この再実行を検証しました。
1つ目は、採点が甘かったこと。9回の「正解」はすべて8:10で、文字盤上の実際の時刻は8:09:25でした。ある読者が直接指摘しています。
"fwiw the clock reads 8:09:25 not 8:10:25 although it would be passable to read it as 8:10 if there were no second hand"
2つ目は、テスト画像そのものが変だったこと。時計の針がすべて違う色で、普通の時計の見た目とはまったく違います。デザインに自分も惑わされたと認めた読者もいました。
"I know that the hand lengths and thicknesses on this image are correct but for some reason I, a totally human person who grew up when analog clocks were still common, see this and think the hand on the 5 is the minute hand."
3つ目は、診断として決定的な点です。元の投稿者がその提案を受け入れ、すべての針を黒にして再実行しました。DeepSeekは8:25と答え、秒針を完全に見失って分針に格上げしました。これは、針の長さではなく針の色に頼っていたことを強く示唆します。つまり9/10は本物でした。ただしその理由は、誰もが想定したものではありませんでした。
そして、このサブスレッド全体を捉え直す発見は、同じ画像を他のあらゆるモデルで試した人から出ました。
"Gemini 3.7 Flash and 5.6-Sol (on all reasoning levels) also answer 8:10:25. The new "stealth" Ox Alpha also replies with the same. Opus 5 replies with 8:10 (no seconds). Not sure why this is so hard for them; Gemini is especially good at vision and I would have expected better from it."
テストされたどのモデルも8:09:25にたどり着きませんでした。Geminiも、Opus 5も、どの推論レベルでも同じです。つまり、n=1ではDeepSeekの弱点に見えたものが、最先端モデル全体に共通する盲点だったことになり、騒動全体はこのモデルの話ではなく、アナログ時計の話に収まりました。
このテストがそもそも妥当なのかという、もっともな反論もあり、ある読者がうまく述べています。
"Reading any analog clock at any time level (edit: and a non-noisy vector rendered image at that) is absolutely table stakes for an allegedly frontier flagship vision model. As much as 1:1 OCR."
この見方には共感します。しかも仮定の課題ではありません。あるコメント者は、子ども向けの時計読みゲームのQAを、Godotビルドのスクリーンショットを撮らせてコーディングエージェントに頼んだと書いていて、これはまさに実際のソフトウェア作業の中にあるこの問題です。
とはいえ、運用上の教訓は壁に貼っておきたいものです。**単一のビジョンテストは、ほとんど何も教えてくれません。**同一条件の実行間のばらつきだけで、判定が覆るほど大きかった。刺激の設計が失敗の仕方を変え、採点のしきい値がスコアを変えました。実際の仕事でビジョンモデルを評価するなら、これも含めて、自分の入力で何度も実行し、そして厳しく採点してください。デモを信じるのではなく、きちんとしたサポートQAの背後にある原則と同じです。
リサイズが実際に効くところ、効かないところ
仕組みは単純で、このモデルについて最も重要な点でもあります。推論の前に、DeepSeekはすべての画像を、縦横比を保ったまま総ピクセル数が800×800の画像とほぼ同じになるようリサイズします。その結果、1枚あたり384トークンという固定の上限が生まれ、ドキュメントはその帰結を端的に述べています。2000×2000の画像と5000×5000の画像は、同じトークン数を消費します。
あるコメント者は、ドキュメントよりうまくこの数字を実感させてくれました。
"800x800 is 640,000 pixels, or 0.64 Megapixels. That is less than the resolution of computer screens from 1995, Super VGA which has around 0.79 MPs."
ここで有用な問いは「0.64MPで足りるか」ではなく、「何に対して足りるか」です。そして答えはほぼ完全に文字サイズで分かれ、タスクの難しさはほとんど関係しません。
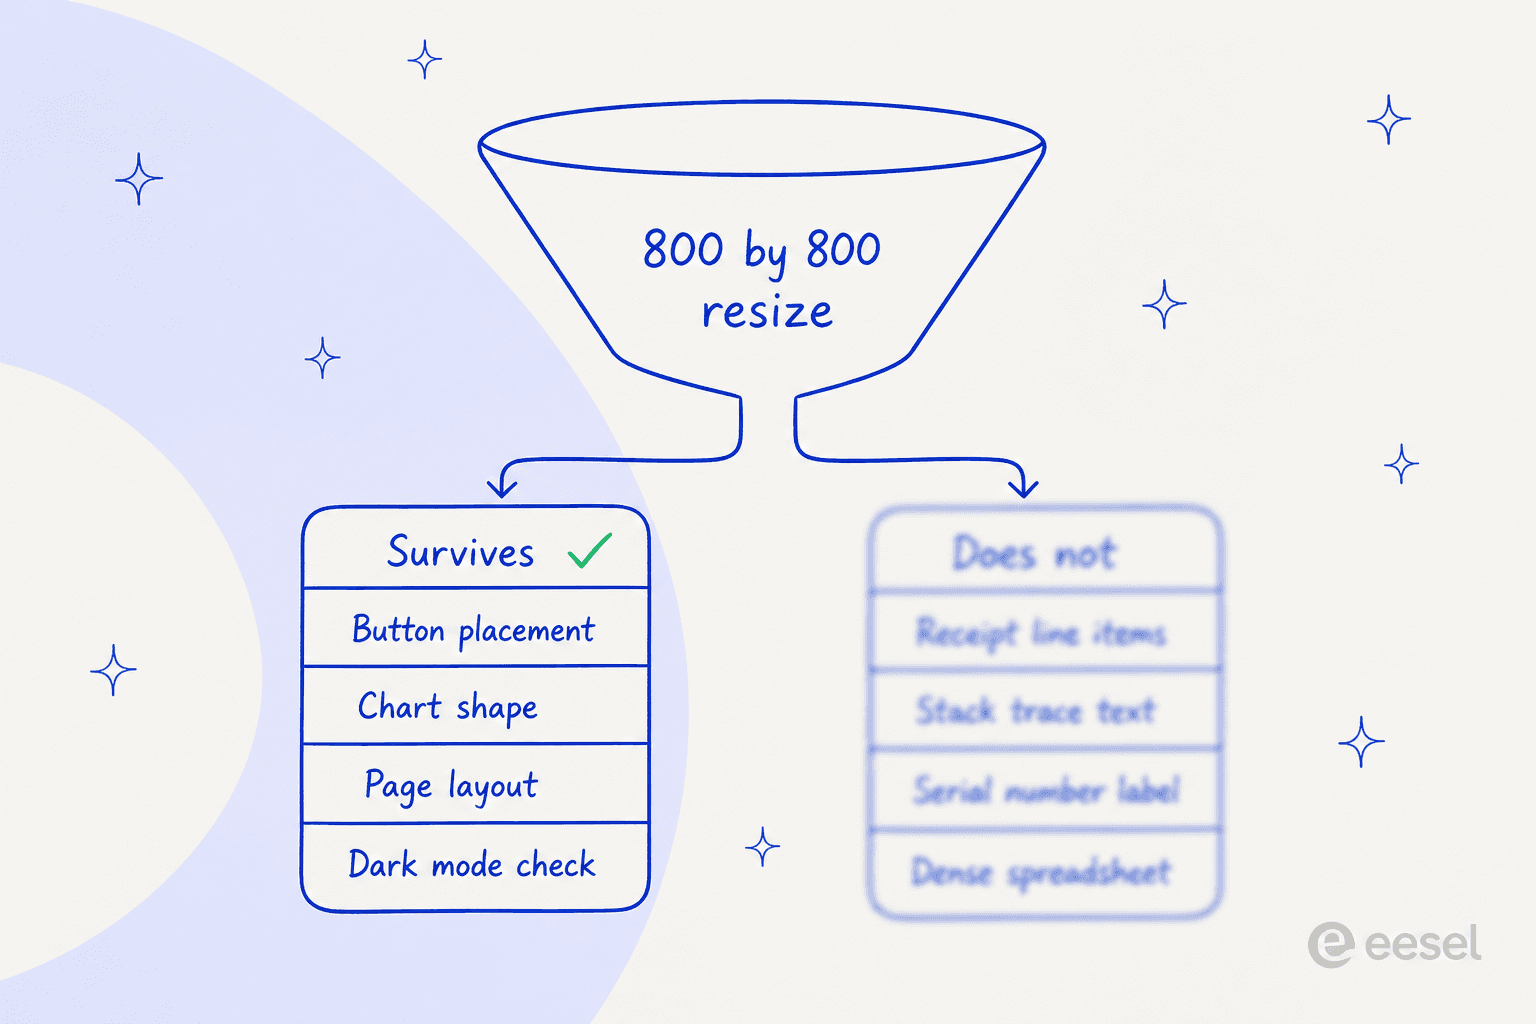
ボタンが正しい位置に描画されたかの確認、グラフの形の読み取り、ダークモードのレイアウトの検証、ページ構造の確認。これらはどれも縮小に余裕で耐えます。レシートの明細、エラーダイアログ内のスタックトレース、製品ラベルのシリアル番号、密度の高いスプレッドシート。これらは崩れる領域です。ドキュメント1ページ分はちょうど境界線上で、ある読者がすぐに指摘しました。
"It's useful but for OCR and a lot of other applications it needs to be a bit higher (eg: putting in a full A4 / Letter sized page)"
経験則ではなく具体的にするために、あなた自身の入力で計算できるようにしました。実際に送る画像の寸法と、その中の最小テキストの高さ(ピクセル)を入力してください。
2560×1440のスクリーンショットで14pxのUI文字なら、最小の文字は5.8pxになります。通常の1920×1080のスクリーンショットなら7.8pxです。通常のUI文字を含む通常のスクリーンショットは、基準を満たしません。そして気まずいのは、返ってくるのが、ときどき間違っているもっともらしい回答であって、明白な失敗ではないことです。
スレッドが共同でたどり着いた回避策はクロップツールで、あるコメント者は実際に使っているパイプラインを具体的に書いていました。
"When the LLM tries to read an image, it will be resized by DeepSeek's server to 800x800, which might be a bit blurry. The LLM will then crop a smaller image from the high resolution image (using e.g. the
converttool via bash) and will then read the small cropped image. This image will still be resized to 800x800 by DeepSeek's server, but since it is already small, there is no or little loss of quality."
これは機能し、自分の環境でも動いたと複数の人が確認しています。ただし無料ではありません。同じ発想のグリッド分割版、つまり大きな画像をタイル状に分けて全セルを処理する方法は、あるコメント者の見積もりで少なくとも2倍のトークンがかかり、9つのクロップを1つの空間的理解へ縫い合わせるのも別の問題です。自分で作るなら、すでに保守しなければならないツール呼び出しループの上に載る、相応の量のハーネス作業になります。注目に値するオープンソースのエージェントの中には、似た仕組みをすでに備えているものもあります。
そして、安くて速いモデルは解像度に上限を設けるしかない、という擁護は、競合を前にすると持ちこたえません。まさにそれを主張した人がいて、すぐに返信がありました。
"Gemini "flash" models have an option for media resolution, including a high resolution option for screenshots."
これはスレッド全体で最も公平な比較です。速度とコストが同じ階層の競合がこの設定を公開していて、Googleはその上にエージェント型ビジョンを構築してきました。DeepSeekのdetailパラメータは同じことをしそうに見えて、しません。lowは実際に512×512へ縮小しますが、high、original、autoは現状すべて同じ意味で、元画像を保持したうえで標準のリサイズを適用します。
また、実際の用途ではこの上限は問題にならなかったという報告も多かったことは言っておくべきです。ある人はこう率直に述べました。
"It can read and extract information from screenshots and PDFs just fine (my setup). No need to worry about edge cases."
別の人は、スクリーンショットが800pxを超えるなら、そもそも撮り方を工夫できたはずだと指摘しました。どちらも妥当です。上限は欠陥ではなく制約であり、影響を受けるかどうかは、何に向けるかで決まります。
ベンチマーク表は見た目より甘い
ここから数字です。多くのレビューが、よく読まずに転載する部分です。
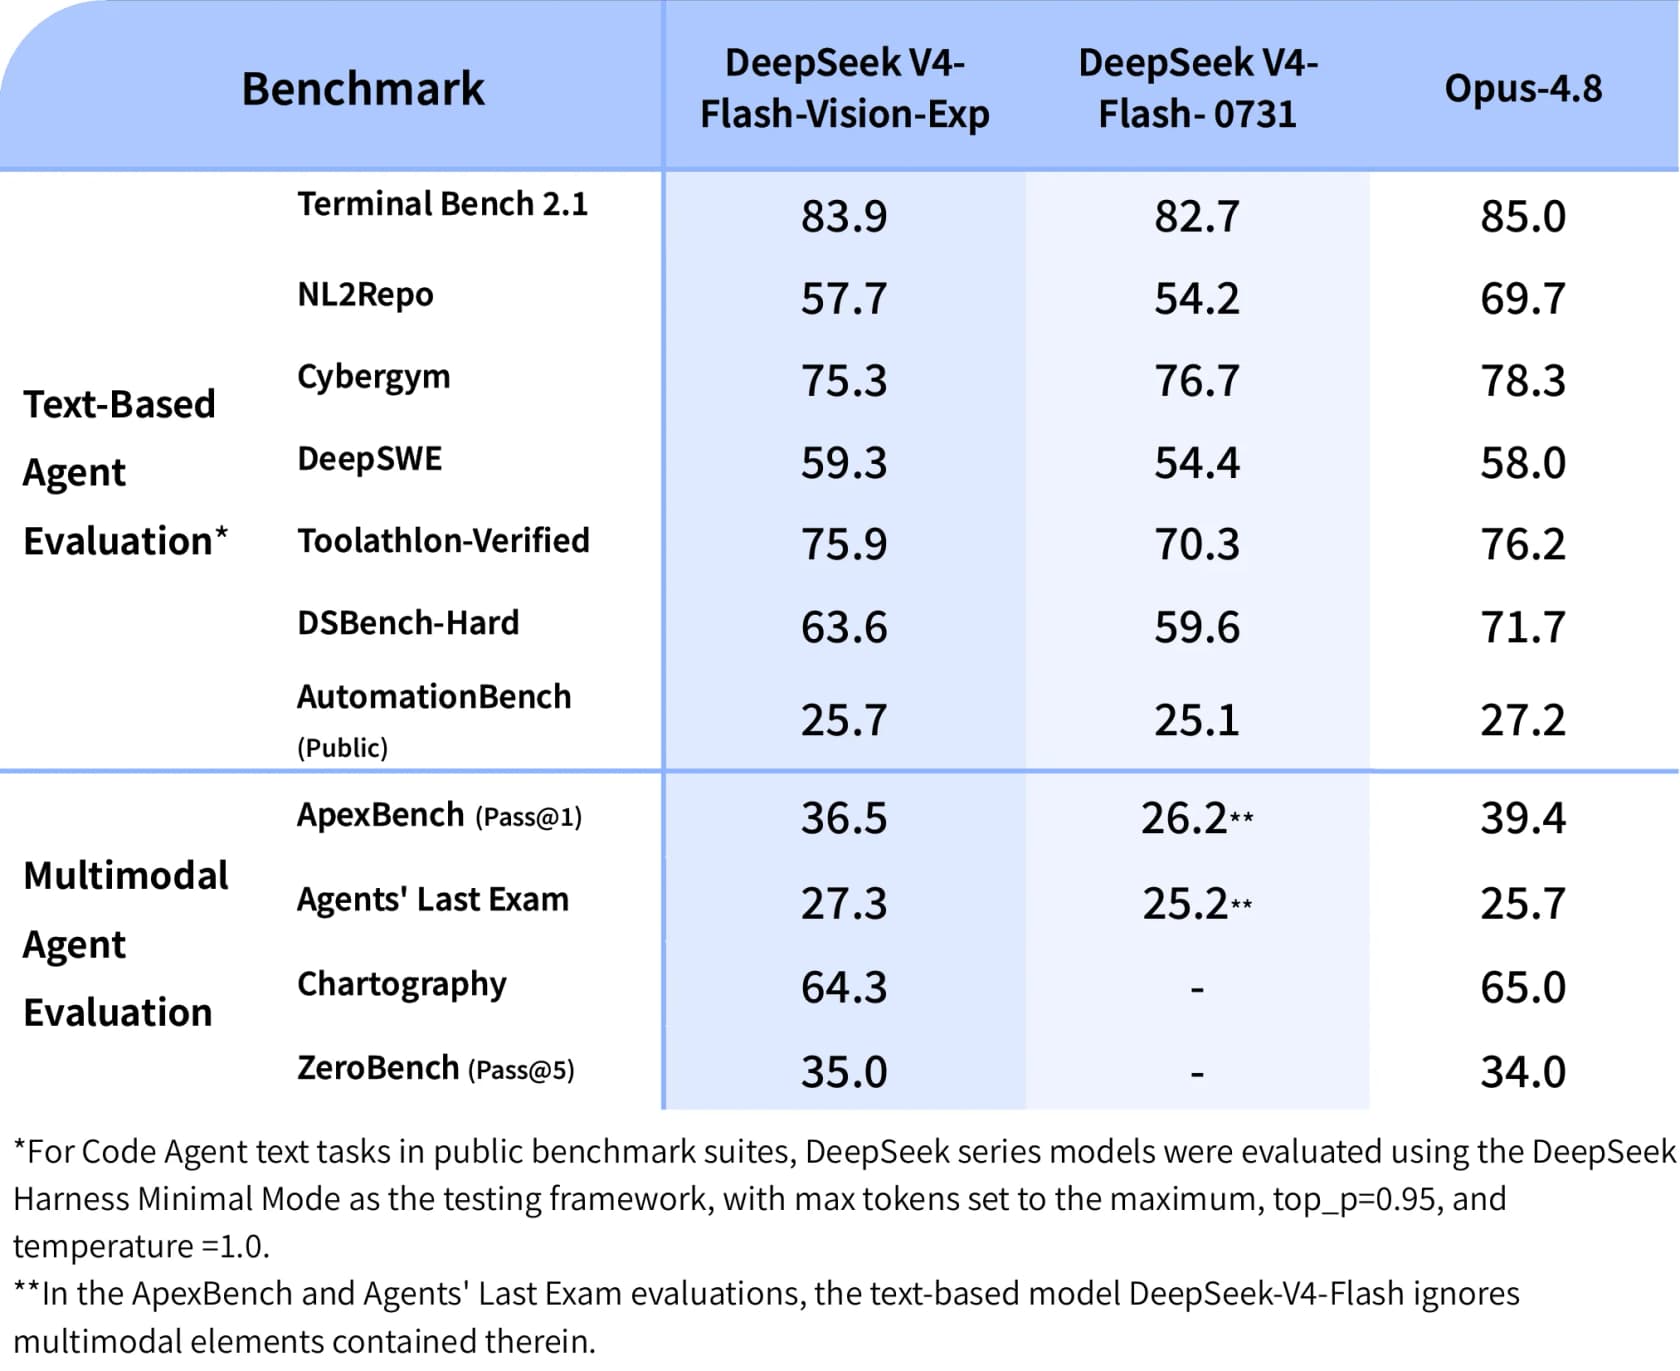
まず、成り立つ部分から。7つのテキストエージェント系の行のうち、ビジョン版はテキスト専用のV4-Flashを6つで上回っています。DeepSWEは59.3対54.4、Toolathlon-Verifiedは75.9対70.3、NL2Repoは57.7対54.2、DSBench-Hardは63.6対59.6、Terminal Bench 2.1は83.9対82.7、AutomationBenchは25.7対25.1です。唯一の負けはCybergymで、75.3対76.7です。DeepSeek自身のリリースノートは、テキストではV4-Flashに「匹敵する」と述べていて、自分たちの結果を大きく控えめに言っています。
その上に3つの留保があり、いずれもローンチの報道より丁寧に表を読んだ誰かから出たものです。
**目玉の数字は競合の誤差範囲と重なっている。**DeepSWEの行で、ある読者が区間を並べて確認しました。
"The DeepSWE benchmark they report (59.3%) overlaps with the confidence interval of 5.6-Sol Medium (61% +/- 2%), but likely at 1/18th the cost (they did not report the DeepSWE benchmark cost, but v4-flash had this cost ratio against Sol Medium)."
つまり「DeepSWEで最先端モデルに勝つ」は、実際には「統計的には区別がつかず、価格はごく一部」です。それでも良い結果ですが、主張は別物です。さらに、1/18というコスト比はV4-Flashから推定したもので、今回の実行について公表されたものではなく、全体がDeepSWEの公式な検証を受けていません。
**比較対象のモデルが有利に選ばれている。**2人目の読者は、コストの話のために選ばれた比較相手が、利用できる中で最も近いものではないと指摘しました。
"The closer comparison would be 5.6-Luna. On DeepSWE at Xhigh it's 57% at 1/6 the cost of Sol M, on Max it's 67% at 1/3rd the cost."
割安なGPT-5.6の派生版と比べると、コストと性能の差はかなり縮まります。それでも進歩ではあります。ただ、段違いの飛躍とはとても言えません。
**マルチモーダルの「飛躍」は、一部は見える能力を測っているだけ。**これはDeepSeek自身の脚注にあります。ApexBenchとAgents' Last Examでは、テキスト専用V4-Flashの列は、タスクのマルチモーダルな要素を無視して採点されており、そのため26.2と25.2になっています。したがって36.5と26.2の比較は、能力の向上と同じくらい「片方は見えて片方は見えない」ことを測っています。誠実な比較はOpus-4.8の列で、DeepSeekはApexBenchで2.9、Chartographyで0.7及ばず、その後Agents' Last ExamとZeroBenchでわずかに上回ります。
見落としやすい枠組みの点がもう1つあります。この表のDeepSeekシリーズの数字はすべて、top_p=0.95、temperature=1.0のDeepSeek Harness Minimal Modeから、つまりベンダー自身の足場で、ローンチ当日に出たものです。ファーストパーティの表は有用ですが、再現ではありません。ベンダーの表はすべてそう扱うべきで、私自身のモデル比較の表も例外ではありません。
自信満々の同意のほうが悪い失敗
ここは私が何度も立ち返る実機結果です。このスレッドで唯一、採点済みのセットと名前のついた失敗パターンが付いているからです。
あるコメント者は小さなキャプション検証ベンチマークを運用しています。モデルに画像と主張された対象を渡し、その主張が正しいかを尋ねるものです。問いは「これは私が言うとおりのものか」であり、「これは何か」ではありません。彼はそれをDeepSeekとByteDanceのseed 2.1 turboで実行しました。
"Asked "Is this Salisbury Cathedral" and supplied a picture of Wells Cathedral, it answers "Yes, the west facade of Salisbury Cathedral". Bytedance seed 2.1 turbo correctly says no. Similar results for a picture of Manhattan Bridge sent as Brooklyn Bridge, Chartres Cathedral sent as Notre Dame, etc."
12枚のセットでのスコアは、DeepSeekが6、seed 2.1 turboが11でした。同じセットでのより広いランキングは、Gemini 3.7 Flashが首位、次にseed、GPT-5.6-Luna、その後に2つのQwenビルドで、テキストでも私のQwen対V4-Flashの比較がほぼ同じ順序に落ち着きます。本人も、本物のVLMベンチマークスイートに比べて小さなセットだという留保を自分で述べていて、スレッドでは、小さなコーディング向けモデルはそもそもランドマーク認識を学習していない、という妥当な指摘もありました。
どちらも本当です。それでも、私の読みでは興味深いのはランドマークのスコアではありません。興味深いのは、「いいえ」と言わず、「はい、そしてこれは私がでっち上げた自信ありげな詳細です」と答えたことです。Salisbury大聖堂の西側ファサードは、間違った建物にくっついた、具体的で権威ありげな装飾です。これは解像度の問題ではなく、どんな高解像度モードでも直りません。渡された前提にモデルが同意しているのです。
サポートの仕事をしているなら、この失敗はもう経験済みのはずです。私が自分のメモで読み返した通話では、BtoBの技術サポートチームが、ボットがデータベースにないブランドに対しても「はい、お客様の車種に対応しています」と答えるのを目にしていました。ヘルプセンターに「全車種に対応」と書いてあったからです。ボットは正しく読み、誤った前提から推論していて、チームが導入期を表した言葉は「trial and error in the beginning」でした。形は同じで、分野が違うだけです。自信満々の同意は、ぼやけた読み間違いより危険です。ぼやけた読み間違いは通常、間違って見えますが、自信満々の同意は決して間違って見えないからです。それは本物のエージェントと台本どおりのチャットボットを分ける線でもあり、チケットデフレクションが成果になるか、苦情キューになるかを決めます。
だから「モデルがスクリーンショットを見られるか」はサポートの問いの簡単な半分で、簡単な半分は、モデルのリリースが答えられる部分です。難しい半分は、答えが正しいかどうかです。それはエージェントが何を拠り所にしてよいか、そして分からない瞬間にどう振る舞うかで決まります。つまり検索とガードレールの問題であり、ビジョンの問題ではなく、RAGと素のLLM呼び出しの違いです。
誰もスクリーンショットに撮らない信頼性の姿
153件のコメントのうち、APIエラー、5xx、レート制限、障害を報告した人はいませんでした。公開から3日の実験的エンドポイントとしては良い兆候です。ただ、レイテンシ分布を報告した人もいませんでした。興味深い数字はまさにそこにあります。
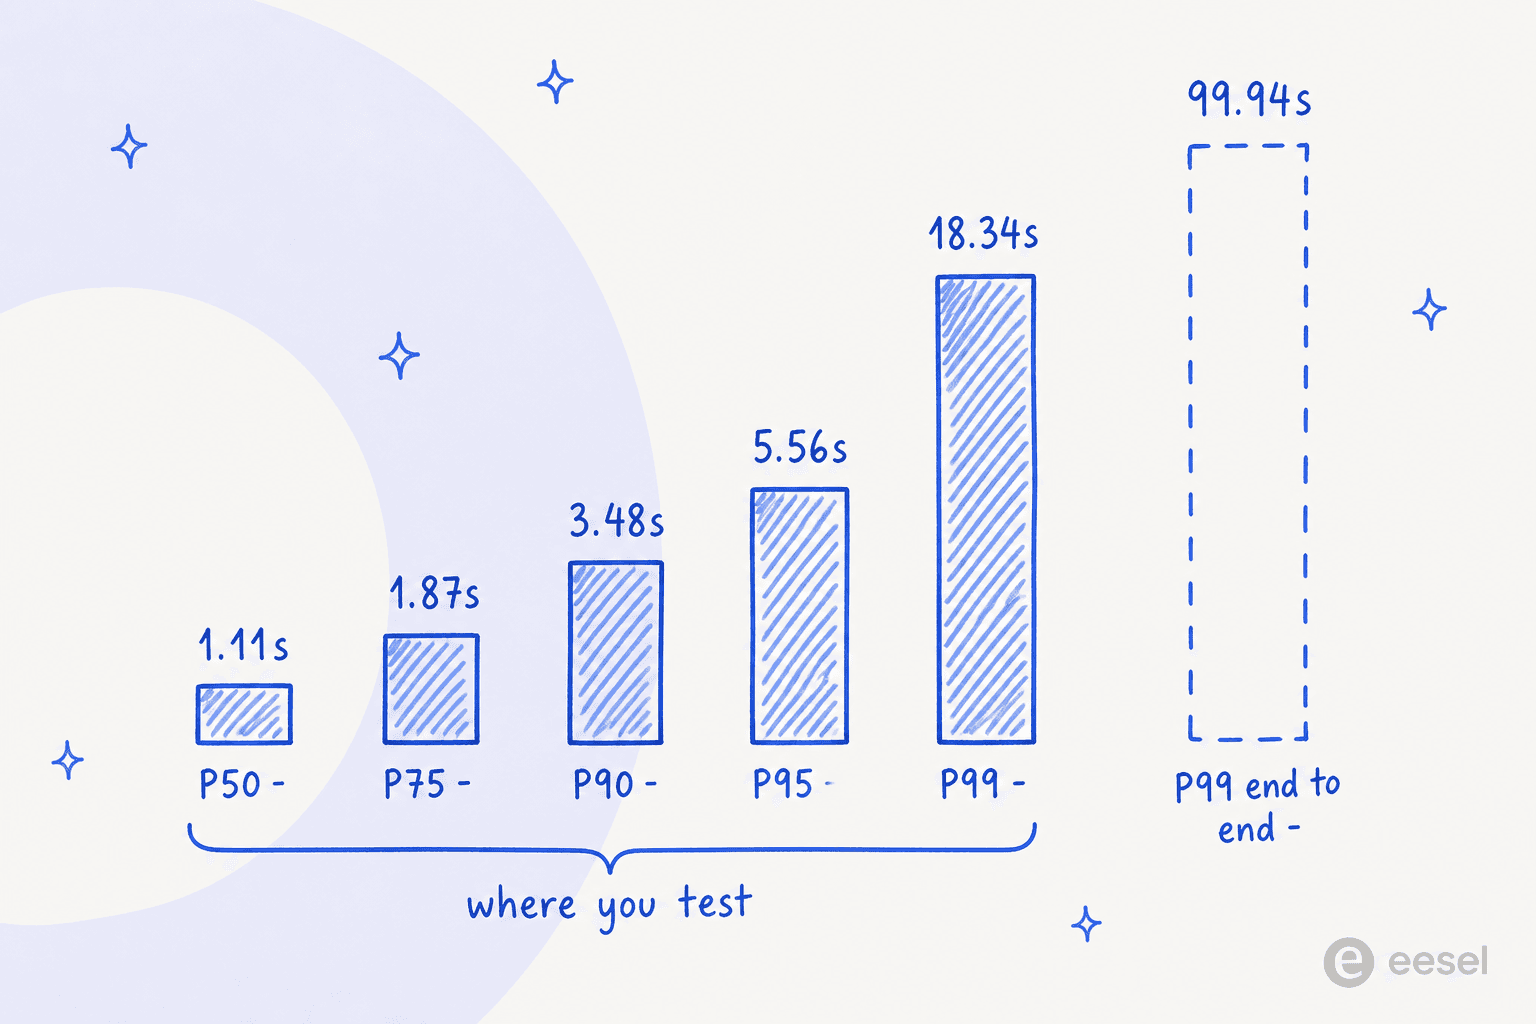
3日分の本番トラフィックから:P50レイテンシは1.11秒、スループットは毎秒85トークン、稼働率は100%。速いモデルで、この価格帯としては中央値が優秀です。あるコメント者自身のトランスクリプトもそれを裏づけていて、1枚の画像で思考に368ms、合計4.4秒でした。
次に、その右側を見てください。P90は3.48秒、P95は5.56秒、P99は18.34秒です。エンドツーエンドでは、P99は99.94秒まで跳ね上がります。ツール呼び出しのエラー率は平均1.27%で、競争力があります(Gemini 3.7 Flashは最良のエンドポイントで1.41%)。同じ期間の可用性は99.93%でした。
これの実際上の帰結は、ベンチマークではなくタイムアウトの予算です。中央値が1秒だからと10秒のクライアントタイムアウトを設定すると、およそ100件に1件のリクエストを落とすことになります。1つのタスクで12回のツール呼び出しを行うエージェントループでは、呼び出しごとの100分の1が、タスク9件に1件ほどに膨らみます。フェイルオーバーもありません。このモデルを提供しているのは1つのプロバイダだけなので、遅くなった瞬間、ルーターには送り先がありません。何らかの初回応答の自動化を組んでいるなら、お客様が体験するのは中央値ではなく、裾の部分です。
実際にこのモデルを呼んでいるのは誰か
これは全く予想していなかった発見で、私の結論を動かしたものです。
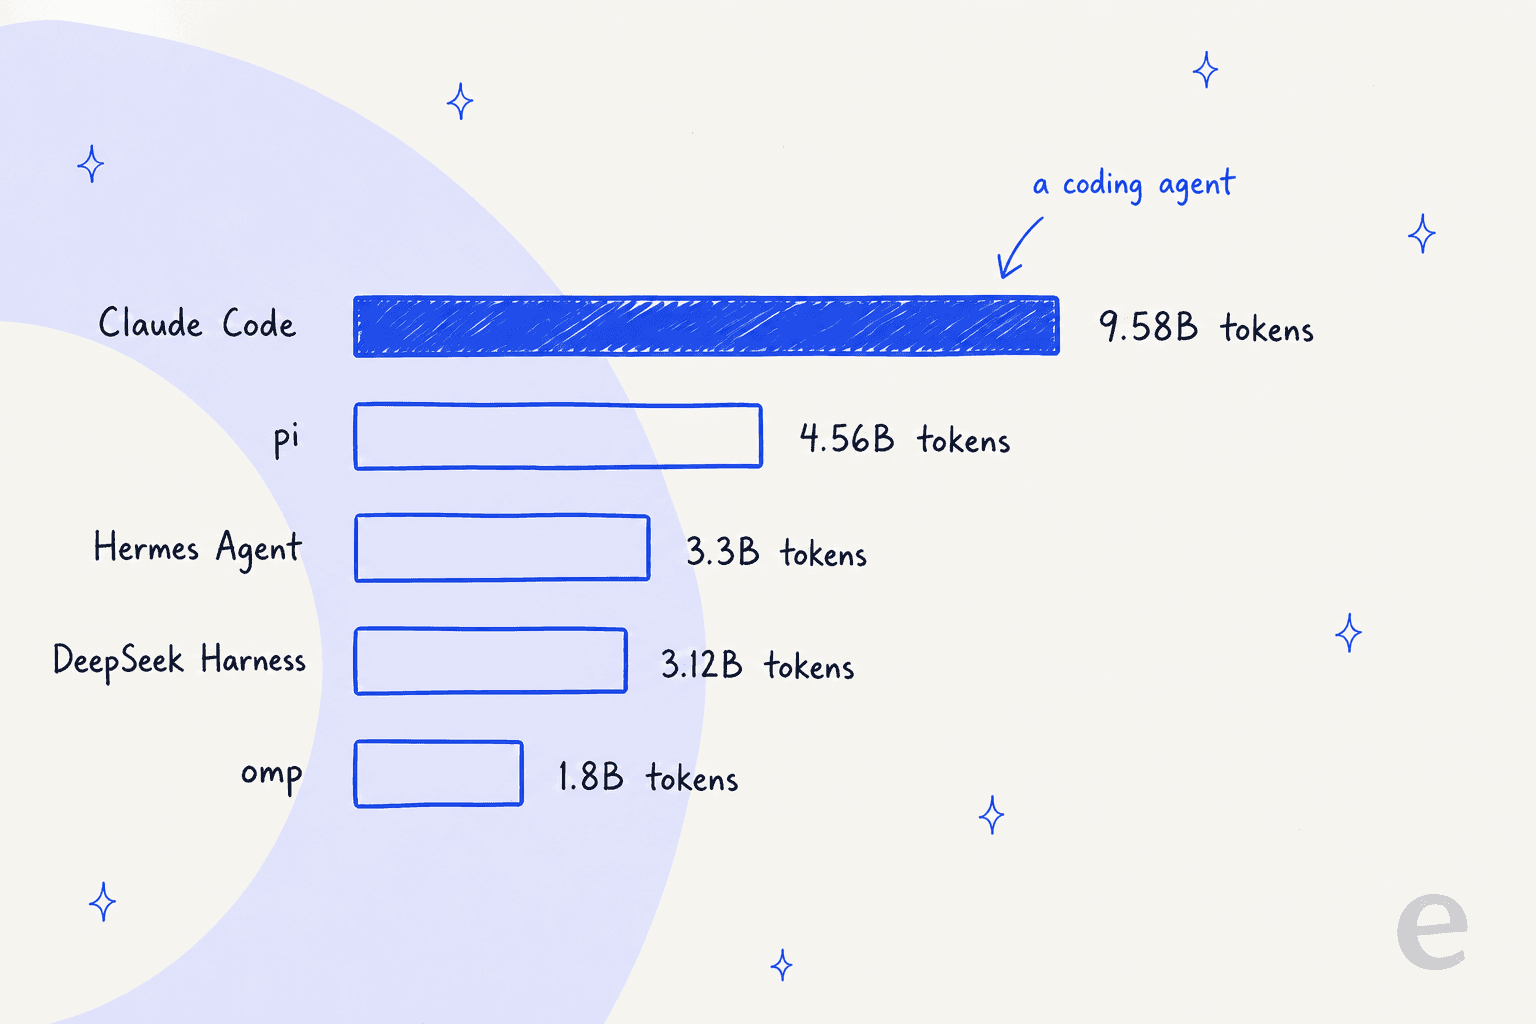
最初の数日間にdeepseek-v4-flash-vision-expへ最も多くのトラフィックを流した公開アプリは、順に、Claude Codeが95.8億トークン、piが45.6億、Hermes Agentが33億、DeepSeek自身のマルチモーダルブリッジハーネスが31.2億、ompが18億です。DeepSeek初のビジョンモデルの最大の単独利用者は、コーディングツールです。この上位5つのうち、明示的に画像を扱うのは1つだけです。
トークンの内訳も、別の角度から同じ話をしています。最初の数日間で、プロンプトトークンは250億、コンプリーショントークンは6,960万、推論トークンは1億3,900万でした。プロンプト対コンプリーションの比は約359対1で、これは大規模なコードベースやツール出力をコンテキストウィンドウに詰め込むエージェントの特徴であり、画像キャプション作業の特徴ではありません。知っておくべきコストの落とし穴も示しています。推論はコンプリーションの約2倍で動いており、思考モードはデフォルトでオンで、推論は出力料金で課金されます。ですから、コストモデルが出力を回答の長さとして扱っているなら、3倍ほどずれます。V4-Flashの料金内訳が説明しているのと同じ落とし穴です。
スレッドの誰かが当然の続きの質問をしていて、これが正しい問いだと思います。
"I've been using v4-flash without vision for this months — it's my go-to for code tasks. Now with vision, I'm wondering: if this model can do everything the text-only version does (plus see images), why keep the text-only one around?"
誰もはっきりした答えを返しておらず、公開されている証拠からは、下の2つの欠けている機能と、名前に付いたexpという語を除けば、返せる答えもありません。
静かに欠けている2つのこと
どちらも仕様表にしか現れず、どちらもマーケティングより重要です。
**FIM補完がなくなっている。**料金ページでは、Fill-in-the-Middle補完は非思考モードでdeepseek-v4-flashとdeepseek-v4-proの両方で利用可能とされ、ビジョン版については「Not supported」とされています。インラインのコード補完にFIMを使っているなら、このモデルは元になったモデルの置き換えにはなりません。DeepSWEの行がどれだけ良く見えてもです。
**日付スタンプがない。**MODEL VERSIONの欄はDeepSeek-V4-Flash-Vision-Expで、兄弟モデルはDeepSeek-V4-Flash-0731とDeepSeek-V4-Pro-0813です。ビルドを固定することはできません。上で述べた実行間のばらつきを踏まえると、これは本物の評価上の問題になります。月曜にベンチマークしたモデルが、金曜にあなたのトラフィックを処理しているモデルと同じである保証はなく、そうでないことを示すバージョン文字列もありません。実験的エンドポイントなら許容できます。お客様の前に出すものには許容できません。
3つ目の欠落は、慎重に報告する価値があります。スレッド自身がこれを訂正したからです。あるコメント者は、画像をツール呼び出しの結果として返せないと述べました。それはスクリーンショット検証型のエージェントループにとって深刻な制約になります。別の人がそれを訂正しました。制限があるのはChat Completionsで、Responses APIとAnthropic互換のMessagesエンドポイントはツール出力の画像を受け付けます。元のコメント者はドキュメントを引用して、function_call_output内のinput_imageがこのモデルでは本物の画像として処理されると確認しました。つまり能力はあり、3つの面のうち2つで使えます。Chat Completionsの上で構築しているなら、あなたにとっては書き直しです。
書き直しの話をもう少し。既存のエージェントに影響する制限がもう1つあります。画像はuserメッセージでのみ受け付けられます。systemやassistantメッセージに入れると400が返ります。多くのエージェントループはツール出力をassistantのターンに保存しており、そうしたループは、画像が1枚でも通る前に、まず変更が必要です。OpenAIのファイル処理と他社のものとの間で移行したことがある人なら、こうした細かい形の違いがどれほど積み重なるかご存じでしょう。
他のビジョンモデルと比べてどうか
料金表と実測性能は、列を比較可能に保つため、すべて同じ情報源のものです。1点留保があります。DeepSeekの期間は3日間です。モデルが3日しか経っていないからで、他は1週間の期間です。画像ではなくテキストでの直接対決は、V4-Flash対Kimi K3をご覧ください。
| モデル | 入力 /M | 出力 /M | キャッシュ読み取り /M | 最良P50レイテンシ | 最良スループット | 稼働率 | 解像度の制御 |
|---|---|---|---|---|---|---|---|
| DeepSeek V4 Flash Vision Exp | $0.22 | $0.66 | $0.007 | 1.11s | 85 tps | 100.00% | 高解像度モードなし |
| Gemini 3.7 Flash | $1.50 | $7.50 | $0.15 | 1.70s | 197 tps | 99.74% | あり、メディア解像度 |
| Qwen3.8-Max | $2.00 | $6.00 | $0.25 | 1.83s | 45 tps | 100.00% | 記載なし |
| GPT-5.6 | $4.00 | $20.00 | $0.40 | 3.55s | 45 tps | 98.50% | あり、detailレベル |
価格では勝負になりません。DeepSeekは、表示上の入力料金でGemini 3.7 Flashの約6.8分の1、GPT-5.6の18分の1で、4つの中で中央値のレイテンシも最も低いです。正直な注釈が2つあります。Geminiは現在OpenRouterで販促割引(Vertex経由で75%オフ、AI Studio経由で50%オフ)があり、その差の大部分を一時的に埋めています。そしてキャプションのベンチマークでGeminiを1位にしたテスター自身が、それが候補に入ったのは割引のおかげだと述べています。
キャッシュの経済性にも一言必要です。定価より全体像を大きく変えるからです。DeepSeekで観測されたキャッシュヒット率は88.9%で、これにより実効の入力価格は表示の$0.22に対して100万あたり$0.03073まで下がります。出力はほとんど動かず、実効$0.6595に対して表示$0.66です。つまりここでの請求は、端数の誤差が付いた出力の請求であり、表示上の入力価格を並べる比較は、間違った列を比べています。AIワークロードが実際にいくらかかるかを計算するなら、100万あたりの単価よりも、解決あたりのコストについての私のメモのほうが有用な枠組みです。人間のエージェントとの比較は、同じ計算のもう半分です。
私の結論
**使うべき人:**ワークロードがテキストエージェント、コーディング、ツール利用で、現在DeepSeek V4 Flashを使っている場合。ベンチマークの7行中6行が一方を指し、実際のトラフィックの傾向も同じ方向を指していて、価格は同じで、モデル文字列を差し替えるだけで移行は完了です。私のV4-Flashレビューが、これを測る基準線です。まずFIMの使用状況を確認してください。
**使うべき人:**画像の仕事が構造的なもの、つまりレイアウト確認、グラフの形、UIの検証、スクリーンショットのトリアージ、デザインからコードへの変換の場合。オフピークで1枚あたり約$0.00008なので、見るコストは切り捨てられてゼロになり、0.64MPは「正しく描画されたか」には十分すぎます。同じ理屈で、添付ファイルに対する大量のチケット分類にも安く使えます。
**クロップツールを作るべき人:**求めているのが細部の精度の場合。このパターンは実証済みで、すでに複数の人が本番で動かしており、かかるのは精度ではなくトークンとハーネスの複雑さです。この価格なら妥当な取引です。
**他を探すべき人:**細部こそが仕事の場合、特にモデルに主張を肯定させるのではなく否定させたい場合。小さな文字、ページ全体規模の文書OCR、キャプション検証。これらはどれも、解像度の制御を公開しているものに任せたほうがうまくいきます。ここでの明白な比較対象はGeminiのFlashシリーズです。この価格帯の残りは、V4-Flashの代替のまとめでカバーしています。そしてオープンウェイトが重要なら、スレッドの複数の人が公開を期待している一方で、確認した人は誰もいないので、それを前提に計画しないでください。
**待つべき人:**再現性が要件の場合。日付スタンプなし、さらに実行間の実際のばらつきという組み合わせは、認証が必要なものには悪い組み合わせです。名前のexpは、そこで正直な働きをしています。
もう少し広い見方として、モデルをレビューするのではなく選ぶ人へ。このリリースは、DeepSeekのビジョンよりテキストラインを支持する、より良い論拠になっています。V4 Proと並べ、次にKimi K3と並べ、1年前のV3.2の位置と並べると、テキストエージェントの価格性能曲線は一貫して同じ方向に曲がり続けています。ビジョン部分は、有能で安価なおまけで、意図的にぼやけています。
回答が正しくなければならないサポートキューのためのeesel
あなたのキューがお客様のスクリーンショットでいっぱいでここにたどり着いたのなら、モデルのリリースが解決することと解決しないことを率直に述べさせてください。
お客様がスクリーンショットを送るのは、小さくて具体的な何かがうまくいかなかったからです。エラーダイアログ。請求書の1行、あるいは保存できないフィールド。サポートで最も価値の高い入力であり、解像度の上限とは最悪の相性です。小さな文字そのものが情報だからです。そしてモデルがそれを完璧に読み取ったとしても、より難しい問題がまだ待っています。Salisbury大聖堂の問題、つまり誤った前提の上に築かれた流暢で自信に満ちた回答が、あなた自身のブランドで実際のお客様に送られることです。

それに対するeeselの答えは、お客様より先に、間違った回答をあなたに見てもらうことです。ヘルプデスクとヘルプコンテンツを接続し、本番に出す前に、過去のチケットでエージェントを再生します。どのチケットを処理できたか、どれをしくじったか、そして使ったはずの言葉を、正確に確認できます。単独で回答してよい範囲と、すぐ人に回す範囲を設定し、すべてのアクションは上のログに表示され、元に戻せます。初日からキューを任せるのは重いと感じるなら、まずはエージェントの下書きを作るAIコパイロットとして始めてください。スイッチを入れてから事後検証を読むのとは正反対です。
それが、安価なビジョンモデルでは手に入らない部分であり、キューのAIがお金を節約するか信頼を失わせるかを決める部分でもあります。ご自身のチケットで動くところを見たいなら、eeselを無料で試してください。
まだ候補を絞る段階なら、私の実用的なメモサポート向けモデルの選び方から始めてください。その次は、サポート業務に合うLLMはどれかが良い読み物で、AIヘルプデスクエージェントが日々実際に何をするのかも、もう1つの読む価値のある記事です。