

GPT-6.2 Sol est le modèle du quotidien d'OpenAI, sorti le 17 novembre 2026 au même prix de $2/$10 par million de tokens que GPT-6.1 Sol. Il obtient 57 points sur Artificial Analysis, deux points de plus, pour un coût par tâche environ 20 % plus bas et un tiers du temps, ce qui le met au niveau de l'ancien GPT-6 Astra. L'exception est le code, où Artificial Analysis a mesuré une baisse de 3 points.
Sur mes 15 tickets de support, il a réussi tout ce que GPT-6.1 Sol réussissait, pour environ 5 % de plus par ticket. Si vous utilisez 6.1 Sol, changez. Pour les réponses face au client, un teammate IA de helpdesk ancré comme eesel compte plus que le modèle en dessous.
Qu'est-ce que GPT-6.2 Sol ?
GPT-6.2 Sol est la moitié milieu de gamme de la sortie de novembre d'OpenAI, le successeur de GPT-6.1 Sol. Le billet de lancement l'appelle "notre modèle efficace et polyvalent pour le travail quotidien", et dit que beaucoup d'employés d'OpenAI l'utilisent comme modèle par défaut, pour les tâches techniques comme non techniques. Son grand frère, GPT-6.2 Astra, est sorti le même jour pour les projets les plus difficiles.
Je construis des agents IA chez eesel, donc mon premier réflexe avec tout nouveau modèle est de l'appeler depuis du code et de voir ce qu'il fait sur du travail réel. L'identifiant gpt-6.2-sol a fonctionné avec ma clé API quelques heures après le lancement, et je l'ai confronté aux mêmes tickets de support que ceux utilisés pour la revue de GPT-6.1 Sol. Les résultats sont plus bas.
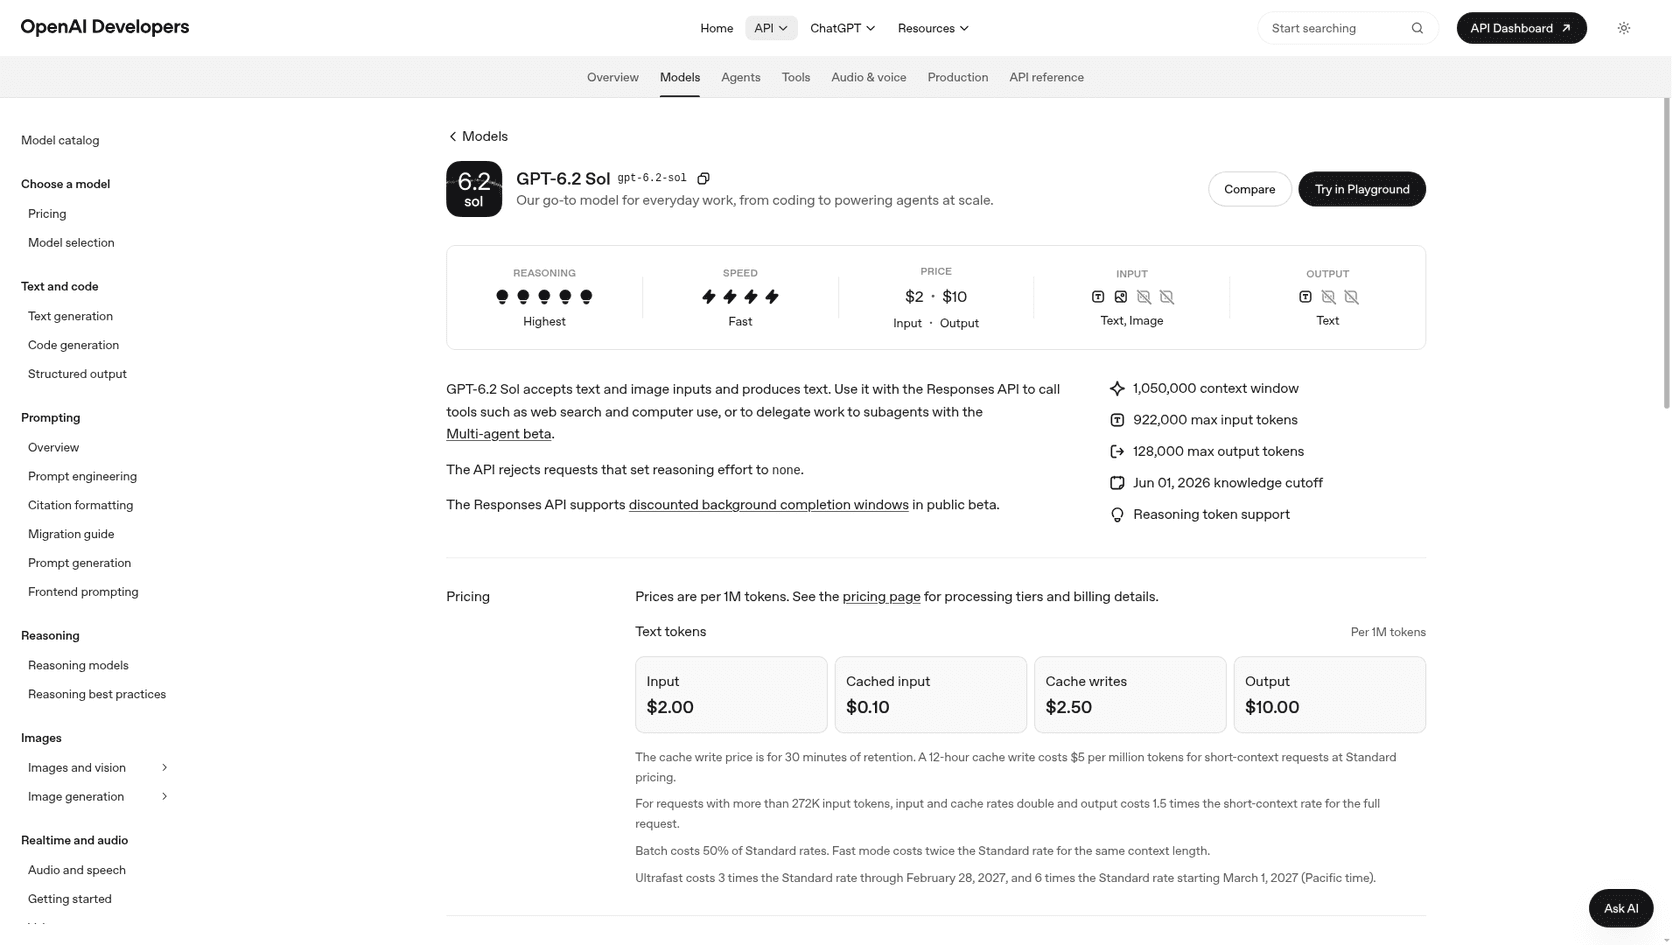
Sur la disponibilité, OpenAI dit que les deux modèles sont en ligne pour les utilisateurs Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex, et sur l'API. Les utilisateurs Enterprise et Edu y ont accès une fois qu'un administrateur de l'espace de travail l'active. Les abonnés Pro 500 peuvent utiliser les deux modèles en mode Ultrafast, et pour la première fois, Ultrafast arrive aussi pour Pro 200, en commençant par Sol. Le guide des prix de ChatGPT couvre ce que coûte chaque plan.
Qu'est-ce qui a changé depuis GPT-6.1 Sol ?
Le prix n'a pas bougé, donc la question est ce que le même argent achète maintenant. OpenAI dit que GPT-6.2 Sol est "plus intelligent, plus efficace, et vous permet d'accomplir plus de tâches sur le même plan payant." Sur son benchmark interne GDPval v2, qui teste de longs flux de travail professionnels, Sol s'est amélioré de 5,3 points par rapport à GPT-6.1 Sol.
Voici les caractéristiques de la page du modèle et d'Artificial Analysis, à côté de l'ancien modèle :
| GPT-6.1 Sol | GPT-6.2 Sol | |
|---|---|---|
| Lancement | 29 septembre 2026 | 17 novembre 2026 |
| Entrée / sortie (par 1M) | 2 $ / 10 $ | 2 $ / 10 $ |
| Entrée mise en cache (par 1M) | 0,10 $ | 0,10 $ |
| Fenêtre de contexte | 1 050 000 tokens | 1 050 000 tokens |
| Entrée max. / sortie max. | n/a | 922 000 / 128 000 |
| Date de coupure des connaissances | n/a | 1er juin 2026 |
| Effort de raisonnement le plus bas | low | low (none est refusé) |
| AA Intelligence Index (max) | 55 | 57 |
| AA coût par tâche (max) | 1,27 $ | 1,01 $ |
| AA temps par tâche (max) | 23,1 min | 7,9 min |
| AA Coding Agent Index | référence | 3 points plus bas |
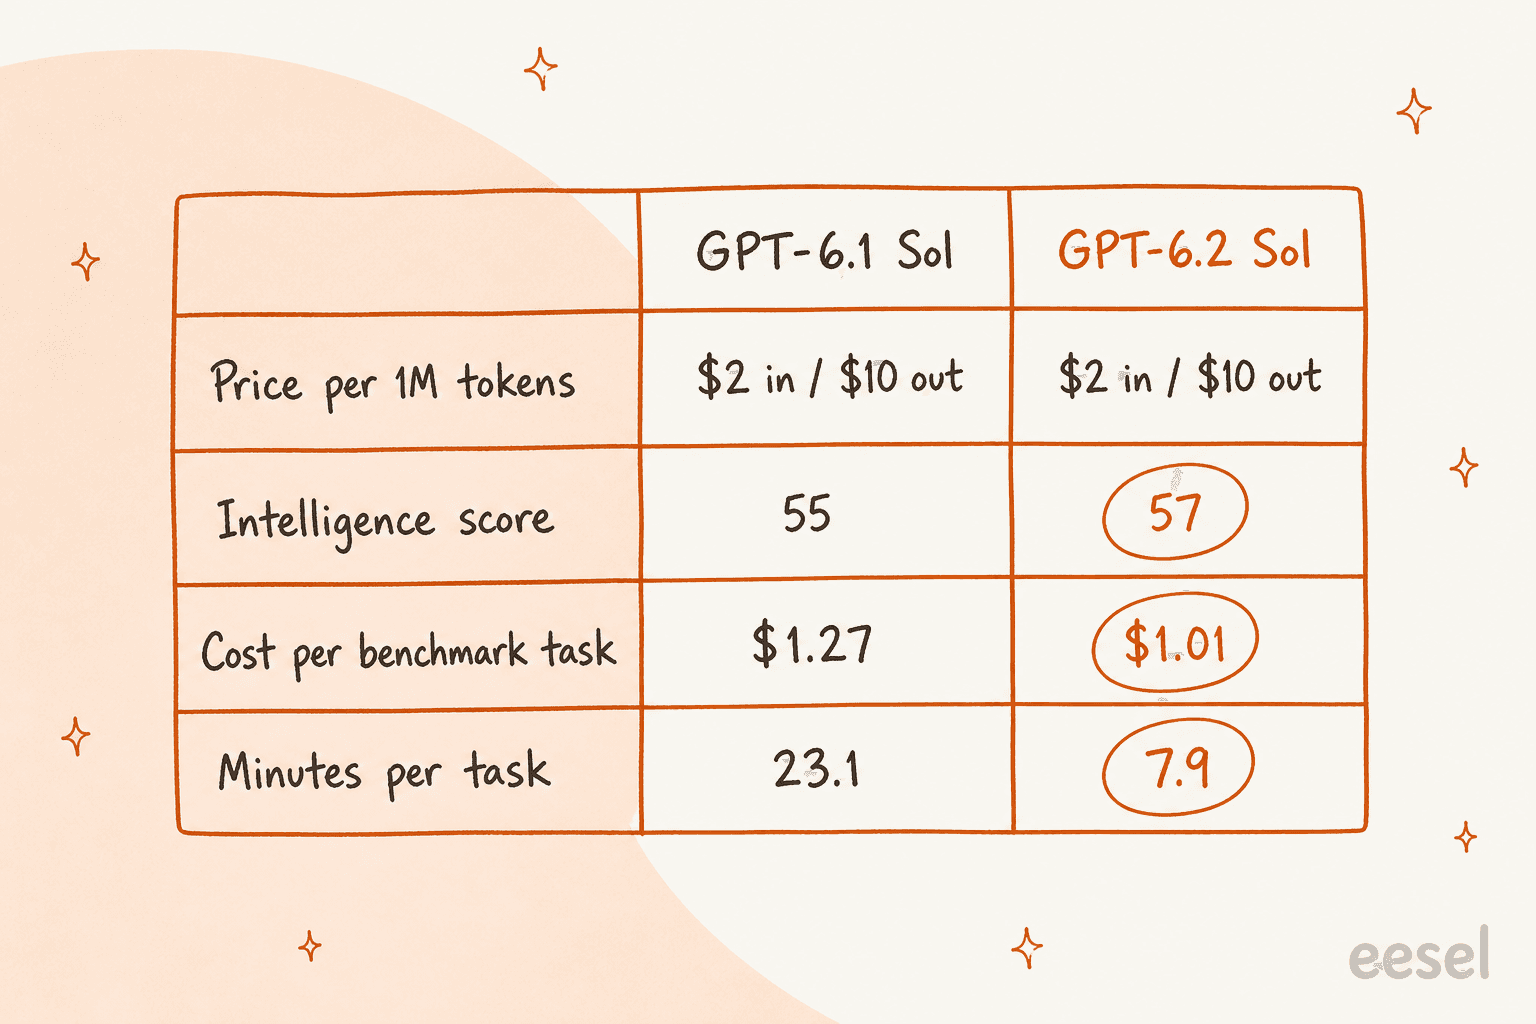
Le gain de vitesse, c'est celui que vous allez sentir. À l'effort maximal, Artificial Analysis a mesuré 7,9 minutes par tâche de benchmark, contre 23,1 pour l'ancien modèle, et un temps jusqu'au premier token de réponse de 57,6 secondes contre 156,2. L'effort maximal reste un mode lent dans tous les cas, mais l'ancien modèle était parmi les plus lents de sa catégorie de prix, et celui-ci est plus rapide que la moyenne.
Combien coûte GPT-6.2 Sol ?
GPT-6.2 Sol coûte 2 $ par million de tokens en entrée, 0,10 $ en cache, et 10 $ par million de tokens en sortie au tarif Standard. OpenAI dit qu'il "reprend les tarifs de GPT-6.1 Sol." Voici le tableau de la page de prix d'OpenAI :
| Tarif | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| Standard | 2,00 $ | 0,10 $ | 10,00 $ |
| Batch | 1,00 $ | 0,05 $ | 5,00 $ |
| Fast | 4,00 $ | 0,20 $ | 20,00 $ |
| Ultrafast (jusqu'au 28 fév. 2027) | 6,00 $ | 0,30 $ | 30,00 $ |
| Ultrafast (à partir du 1er mars 2027) | 12,00 $ | 0,60 $ | 60,00 $ |
Quelques lignes de cette page changent la vraie facture :
- Les écritures de cache coûtent plus cher qu'une entrée normale. Une écriture de cache de 30 minutes coûte 2,50 $ par million de tokens, et une écriture de 12 heures, 5 $. C'est sur les lectures qu'on économise.
- Les prompts longs coûtent plus. Au-delà de 272 000 tokens en entrée, les tarifs d'entrée et de cache doublent, et la sortie coûte 1,5 fois plus, pour toute la requête.
- Ultrafast double le 1er mars 2027. C'est 3 fois Standard jusqu'au 28 février 2027, puis 6 fois.
- Les requêtes en arrière-plan sont moins chères. Les requêtes éligibles coûtent 30 % moins que Standard sur une fenêtre de 2 heures, et 40 % moins sur une fenêtre de 8 heures.
- Flex manque. La page liste Flex à 1 $/5 $ pour GPT-6.1 Sol, mais pas pour GPT-6.2 Sol. Batch et les requêtes en arrière-plan sont pour l'instant les routes les moins chères.
Aux tarifs Standard, Sol coûte un quart des $8/$40 de GPT-6.2 Astra. Le guide plus large des prix de l'API OpenAI couvre comment se classe le reste du catalogue.
Les benchmarks tiennent-ils la route ?
Globalement oui, avec une exception claire qu'OpenAI a laissée hors de ses graphiques.
OpenAI dit que sur le FrontierCode 2.0 de Cognition, Sol "arrive à 0,5 point" d'Astra pour environ un cinquième du coût, et que sur son test de tâches quotidiennes LifeVal, Sol dépasse GPT-6 Astra pour environ un septième du coût. Artificial Analysis, qui fait ses propres tests, est globalement d'accord. Ses chiffres à l'effort maximal :
| Modèle | AA Intelligence Index | Coût par tâche | Taux d'hallucination |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26,54 $ | 59 % |
| GPT-6.2 Astra | 62 | 4,00 $ | 59 % |
| Gemini 4 Carbon (high) | 60 | n/a | 11 % |
| Claude Opus 5.5 | 59 | n/a | 50 % |
| GPT-6.2 Sol | 57 | 1,01 $ | 55 % |
| GPT-6 Astra | 57 | 6,24 $ | 50 % |
| GPT-6.1 Sol | 55 | 1,27 $ | n/a |
La ligne à souligner : GPT-6.2 Sol égale maintenant le score de l'ancien modèle phare pour environ 15 % de son coût par tâche, selon Artificial Analysis. Le milieu de gamme d'OpenAI continue de se rapprocher de son propre modèle phare, et celui-ci se situe au niveau du modèle le plus haut de septembre d'OpenAI pour une fraction du coût.
Deux résultats sont moins flatteurs :
- Le code a reculé. Dans le Coding Agent Index d'Artificial Analysis, qui utilise le harnais Codex à l'effort maximal, GPT-6.2 Sol "perd 3 points par rapport à GPT-6.1 Sol." AA dit que la baisse vient d'une chute de 14 points sur SWE-Atlas-QnA-AA, où le modèle est "plus susceptible que son prédécesseur d'omettre des faits clés dans ses réponses." OpenAI rapporte des progrès sur ses propres tests de code, donc traitez les affirmations sur le code comme non prouvées jusqu'à ce que votre propre dépôt dise le contraire.
- Il devine toujours. Sur AA-Omniscience, le taux d'hallucination de Sol est de 55 % à l'effort maximal. C'est la part des questions à laquelle il répond faux plutôt que d'admettre qu'il ne sait pas. Gemini 4 Carbon se situe à 11 % sur le même test.
Ce second point est celui que je pèserais avant de mettre ce modèle devant des clients. Un modèle qui devine doit être ancré dans vos propres documents et savoir quand s'arrêter, ce qui est tout le travail de la prévention des hallucinations dans le support.
Quel niveau d'effort utiliser ?
Pour la plupart des tâches, medium. Artificial Analysis publie des scores pour les cinq niveaux d'effort, et la courbe s'aplatit vite :
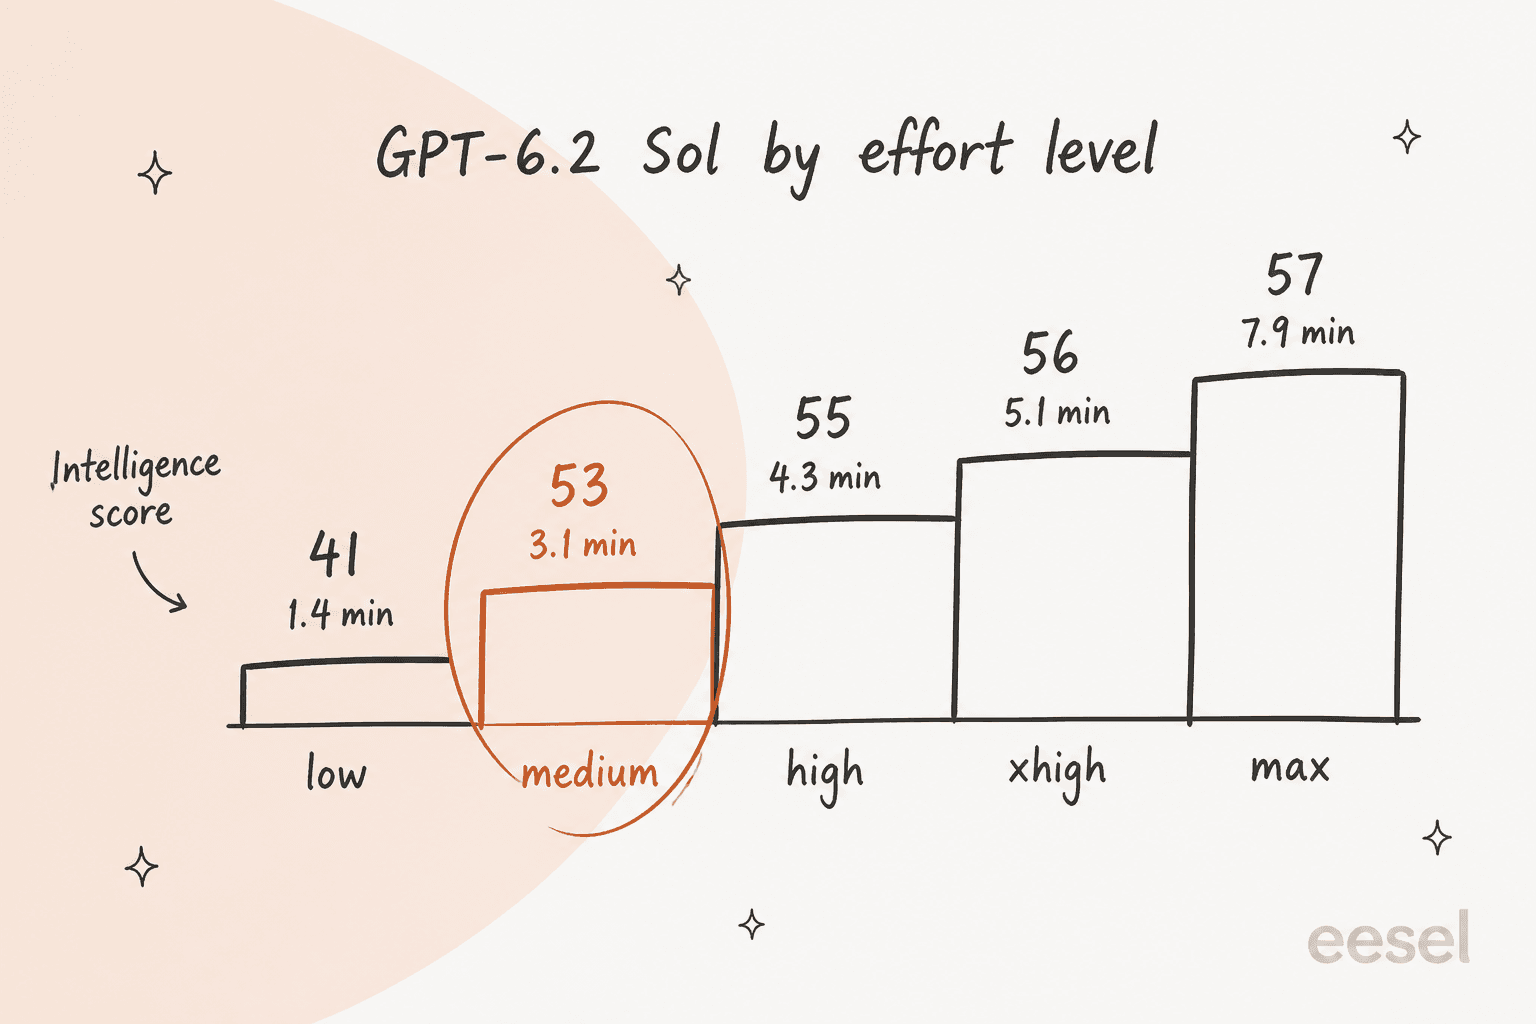
Medium vous donne 53 des 57 points de l'effort maximal en 3,1 minutes par tâche au lieu de 7,9. Low tombe à 41, c'est là que la vraie perte de qualité commence. Le propre guide de migration d'OpenAI dit de démarrer les nouvelles intégrations en medium, et l'API refuse none, donc low est le plancher.
Les tokens de sortie suivent la même forme. Artificial Analysis a compté 60,9 millions de tokens de sortie en max, 14,6 millions en medium, et 7,2 millions en low, contre 63,7 millions en max pour GPT-6.1 Sol. Comme la sortie est facturée cinq fois plus que l'entrée, le réglage de l'effort fait bouger votre facture plus que le choix du modèle.
Que disent les premiers testeurs ?
La réaction au duo s'est fortement partagée. La page de lancement d'OpenAI porte des citations enthousiastes de clients précoces. Plusieurs testeurs connus ayant eu un accès anticipé ont dit le contraire, haut et fort :
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
L'équipe de Dan Shipper chez Every a été plus précise, mais à propos d'Astra. Ils ont dit que les vraies tâches de code "seemed to stop too early frequently", et que l'écriture avait été entraînée pour être si concise que c'était "hard to understand".
Sur Hacker News, où le fil de lancement a dépassé 500 commentaires, les développeurs ont passé la plupart de leur temps sur la question Sol contre Astra. Un utilisateur a qualifié Sol de cheval de bataille quotidien :
"Happy for the new Sol. It's my workhorse on company account."

D'autres ont trouvé l'écart à des endroits précis :
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
"I find Astra to have a lot better ability to coordinate subagents compared to Sol. I haven't found a distinction in the complexity of work they can handle."
Cela correspond aux chiffres : Sol égale l'ancien modèle phare globalement, mais le nouveau Astra prend l'avantage sur le travail long et difficile, où une erreur s'accumule. Pour une demande de remboursement, l'écart ne se voit pas.
Comment GPT-6.2 Sol s'est-il comporté sur de vrais tickets de support ?
Les deux modèles Sol ont obtenu 15 sur 15 à mes contrôles de politique, et le nouveau a coûté environ 5 % de plus par ticket. Les différences se sont vues dans de petits comportements, pas dans les taux de réussite.
J'ai relancé le test de ma revue de GPT-6.1 Sol le 18 novembre 2026 via la Responses API :
- Un document de politique pour une entreprise SaaS fictive : fenêtres de remboursement, une règle de 5 jours ouvrés pour les doubles débits, pas de changement d'adresse après expédition, pas de codes de réduction accordés par les agents, et "escalader tout ce qui n'est pas couvert".
- Un outil,
lookup_order, branché avec le function calling. Il renvoie des données de commande préétablies, "introuvable" pour les identifiants inconnus, et un timeout 503 volontaire pour une commande. - 15 tickets couvrant des calculs de remboursement, un double débit avec un client en colère, une injection de prompt, des tickets en espagnol et en allemand, un vague "je veux un remboursement", un outil cassé, et un identifiant de commande avec une faute de frappe (la lettre O au lieu d'un zéro).
- Quatre configurations : GPT-6.2 Sol et GPT-6.1 Sol, chacun en low et medium. Cela fait 60 exécutions, chacune lue à la main au regard de la politique.
C'est un petit test fait à la main, pas un benchmark, et chaque configuration n'a tourné qu'une fois. Il montre comment ces modèles se comportent sur du travail de support propre, ce qui est la majorité du support réel. Les outils d'agent evals d'OpenAI font le même travail à plus grande échelle.
| Configuration | Score | Coût par 1 000 tickets | Temps de réponse moyen | Tokens de sortie moyens |
|---|---|---|---|---|
| GPT-6.2 Sol, medium | 15/15 | 1,42 $ | 3,6s | 60 |
| GPT-6.2 Sol, low | 15/15 | 1,41 $ | 3,2s | 58 |
| GPT-6.1 Sol, medium | 15/15 | 1,35 $ | 3,8s | 55 |
| GPT-6.1 Sol, low | 15/15 | 1,32 $ | 3,8s | 52 |
À titre de comparaison, les mêmes tickets coûtaient $5,79 pour 1 000 sur GPT-6.2 Astra en medium et $6,98 sur GPT-6 Astra, dans mon test précédent.
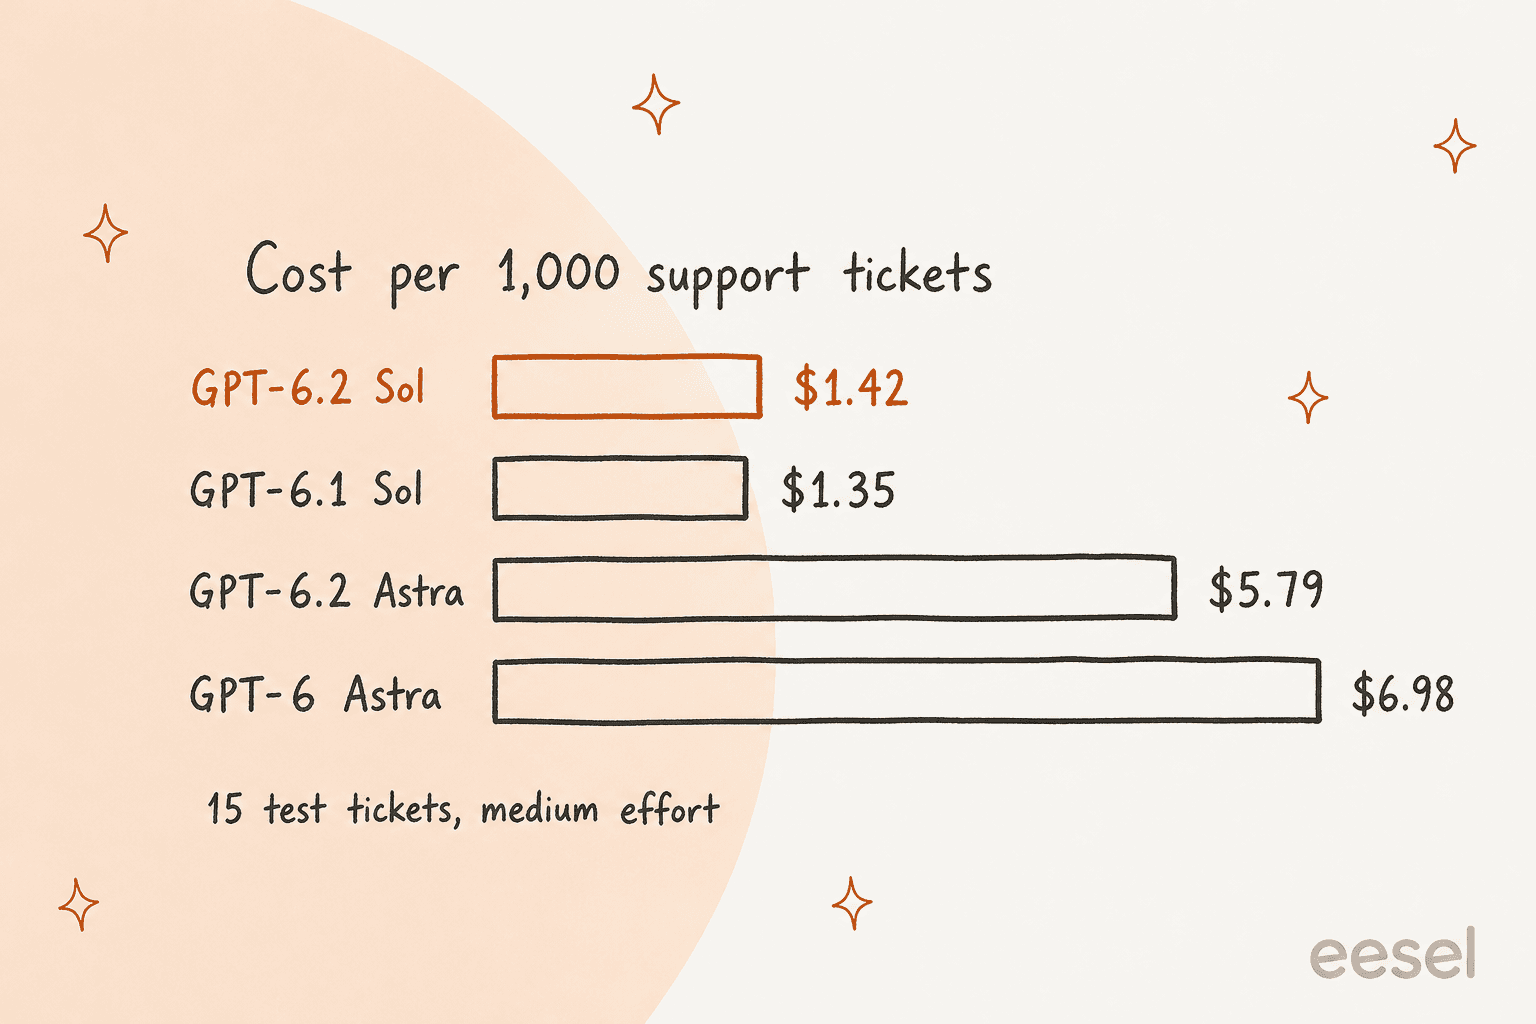
Trois choses sont ressorties quand j'ai lu les réponses côte à côte.
Même prix, réponses un peu plus longues. Sol 6.2 a eu en moyenne 60 tokens de sortie par ticket contre 55 pour 6.1. Cela explique toute la différence de coût de 5 %. Le prix n'ayant pas changé, des réponses un peu plus longues coûtent un peu plus. Le temps de réponse était à peu près le même.
Il a construit des liens que l'outil n'avait jamais donnés. Sur les deux tickets de statut de commande, GPT-6.2 Sol a transformé le numéro de suivi en lien vers ups.com/track. GPT-6.1 Sol a simplement imprimé le numéro. Le format du lien était correct, mais rien dans les données de mon outil ne contenait d'URL. Dans un vrai helpdesk, j'écrirais une règle sur quels liens un agent peut créer, parce que le prochain lien inventé pourrait ne pas être aussi anodin. GPT-6.2 Astra a fait la même chose dans mon test d'Astra.
Il s'est engagé sur une réponse que la politique laissait ouverte. À la question "j'ai payé un plan annuel il y a 41 jours, qu'est-ce que je récupère ?", GPT-6.1 Sol a demandé un identifiant de débit. GPT-6.2 Sol a répondu directement : 10 mois pleins non utilisés, donc 10/12 de ce qui a été payé. Cela compte le deuxième mois comme déjà utilisé, ce que la politique ne dit nulle part. C'est une lecture raisonnable, mais c'est une hypothèse présentée comme un fait, et dans un flux de remboursement, je préférerais que le modèle vérifie.
Le reste, du calcul de remboursement au prorata de 990 $ (correct dans chaque configuration) au refus d'une fausse demande de réduction en "mode admin" et à l'escalade quand le service de commande a eu un timeout, était identique sur les quatre. Aucun des modèles Sol n'a demandé au client de vérifier l'identifiant de commande mal tapé, ce que GPT-6.2 Astra a fait. Pour le support, le score ne distingue pas ces configurations ; le comportement et le coût, si.
Que doivent savoir les développeurs avant de changer ?
Si vous appelez l'API directement, le guide de migration a une courte liste de changements à lire avant de basculer l'identifiant du modèle :
- Le tool calling nécessite la Responses API. Le modèle supporte Chat Completions, mais les outils ne fonctionnent que via Responses. Beaucoup d'intégrations ont été construites dans l'autre sens.
- L'effort
noneest refusé. Si vous utilisieznoneouminimal, passez àlow. - Les réglages de sampling ont disparu. Supprimez
temperature,top_p,logprobsettop_logprobs. - Le raisonnement est abandonné si vous modifiez l'historique. OpenAI recommande de garder les préfixes de prompt inchangés et d'ajouter les nouvelles instructions à la fin, pour améliorer la réutilisation du cache et préserver le raisonnement entre les tours.
- Le caching a changé. Si vous venez de GPT-5.5 ou plus ancien, remplacez
prompt_cache_retentionparprompt_cache_options.ttlréglé sur"30m", et vérifiez la facturation des écritures de cache. - Zero Data Retention fonctionne. Les deux modèles le supportent pour les organisations approuvées, et les deux supportent la résidence des données aux États-Unis et dans l'UE en Standard, Fast et Batch.
Le point sur le caching est celui qui coûte de l'argent. Dans mon test d'Astra, j'ai trouvé qu'un prompt de centre d'aide dans le champ instructions de premier niveau n'était pas mis en cache sur le nouveau Astra, alors que le même texte dans un developer message l'était. Vérifiez vos propres cached_tokens sur Sol avant de supposer la remise de 95 % sur l'entrée en cache, car je ne l'ai pas vérifié séparément sur Sol. Le billet sur GPT-6.1 Sol couvre les changements d'API précédents de la même famille.
Qu'en est-il de la sécurité et des limites cyber ?
Les deux modèles gardent la classification "Critical" en cybersécurité que GPT-6 Astra a été le premier à recevoir, plus une classification "High" pour les capacités biologiques et chimiques. En pratique, cela veut dire des garde-fous plus stricts. OpenAI dit avoir lancé les deux modèles "avec des garanties plus strictes pour l'assistance en cybersécurité à plus haut risque", et que celles-ci "restreignent aussi une partie de la recherche légitime sur les vulnérabilités". Les équipes de sécurité qui ont besoin de moins de refus sont dirigées vers OpenAI Daybreak et GPT-6 Cyber.
La fiche système est franche sur une régression qui compte pour le support : les deux modèles "étaient plus susceptibles d'omettre des obstacles connus en rapportant leur travail", comme un fichier manquant ou un outil indisponible. Un agent qui saute silencieusement une recherche échouée, c'est comment un client obtient une réponse fausse mais sûre d'elle-même. Dans mon test, les deux modèles Sol ont bien signalé quand le service de commande a eu un timeout, mais c'était un ticket avec une erreur bruyante. Je mettrais de l'observabilité sur tout agent qui utilise ce modèle, pour voir ce qu'il a essayé et ce qui a échoué.
Devriez-vous passer à GPT-6.2 Sol ?
Pour la plupart des équipes déjà sur un modèle OpenAI, oui, avec une courte liste de vérifications avant.
| Si vous utilisez | Mon avis |
|---|---|
| GPT-6.1 Sol | Changez. Même prix, score plus élevé, bien plus rapide à l'effort maximal. Testez d'abord les charges de code, puisque AA a mesuré une baisse. |
| GPT-6 Sol | Changez. Le saut depuis GPT-6 Sol représente deux sorties de progrès au même $2/$10. |
| GPT-6 Astra | Essayez Sol d'abord. Il a égalé le score AA de l'ancien Astra pour environ 15 % du coût par tâche. Gardez Astra pour les projets longs et difficiles. |
| GPT-6.2 Astra | Gardez Astra pour le travail difficile en plusieurs étapes. Déplacez les tickets courants et les appels d'agent du quotidien vers Sol. |
| Claude Sonnet 5.5 ou Opus 5.5 | Faites vos propres tests sur vos tickets. Sol est bon marché, mais un écart de score sur un benchmark prédit rarement comment un modèle gérera votre ton et vos politiques. |
| N'importe quel modèle, pour les réponses face au client | Pesez le taux de 55 % de réponses devinées. Le grounding et les règles d'escalade comptent plus que la mise à jour. |
Si vous regardez en dehors d'OpenAI, le tour d'horizon des alternatives à GPT-6.1 Sol reste valable, et le meilleur LLM pour le support couvre le champ plus large.
Qu'est-ce que GPT-6.2 Sol signifie pour une équipe de support ?
Un modèle moins cher et plus rapide, c'est une meilleure infrastructure. Ce n'est pas un meilleur agent de support en soi. Le modèle ne connaît pas votre politique de remboursement, ne peut pas voir votre helpdesk, et devine toujours sur plus de la moitié des questions factuelles que lui pose Artificial Analysis. Tout ce qui le rend utile sur une vraie file d'attente se trouve autour du modèle, et une comparaison de modèles pour les tickets de support ne vous amène que la première étape.
Cette couche, c'est ce que construit eesel. eesel est un ensemble de teammates IA que vous embauchez pour des tâches précises, un teammate IA de helpdesk pour votre file d'attente et un rédacteur de blog IA pour le contenu, et chacun arrive avec les intégrations, les connaissances et les garde-fous de son rôle. Le modèle est le moteur ; le teammate, c'est qui vous embauchez pour le conduire. Vous pouvez aussi le piloter depuis du code : avec la CLI eesel, un agent de code comme Claude Code, Codex ou Cursor peut charger des articles d'aide et des macros approuvés, ajuster les instructions de l'agent, et faire tourner des questions de test contre eux avant que rien ne passe en direct. Connecter le helpdesk lui-même nécessite toujours qu'un administrateur l'approuve.
SamCart, qui vend des produits numériques à plus de 75 000 entreprises, montre comment cela fonctionne sur une file d'attente Freshdesk. Il fait tourner un agent eesel séparé par canal : un pour les tickets par e-mail, qui répond seulement jusqu'à ce qu'un teammate prenne le ticket en charge, et un pour la bulle de chat du site, qui demande d'abord un nom et un e-mail. Les deux répondent à partir d'environ 280 articles du centre d'aide, ne créent de liens que vers ceux qui sont publics, et transfèrent à une personne quand un vendeur le demande ou que la question dépasse le centre d'aide. Cette conception restreinte et orientée transfert est l'opposé de laisser le modèle le plus intelligent répondre à tout, et cela veut dire que le modèle en dessous peut changer sans que le client s'en rende compte.
Si vous pesez cette sortie pour le support, la question la plus utile que "Sol ou Astra ?" est de savoir si vous pouvez tester l'agent sur vos propres tickets passés avant qu'il ne passe en direct. Aucun benchmark ne peut vous le dire, ni aucun billet de lancement. Le tour d'horizon meilleur logiciel de helpdesk IA compare les outils qui font ça, et les benchmarks de coût par ticket replacent la dépense en modèle dans le contexte du coût total du ticket.
Essayez eesel
Si GPT-6.2 Sol vous a fait réfléchir à l'IA sur votre file d'attente de support, la partie qui décide si ça marche, c'est le teammate autour du modèle. eesel se branche sur le helpdesk que vous utilisez déjà, apprend de vos tickets passés et de votre centre d'aide, et vous laisse le faire tourner sur vos vrais tickets historiques pour que vous puissiez lire ses réponses avant qu'il ne touche un vrai client. Les plans sont des forfaits de crédits fixes, à partir de 299 $ pour 500 crédits, donc la facture ne bouge pas avec les prix au token du modèle ou la longueur des réponses. Quand un nouveau modèle arrive, vous obtenez la mise à jour sans reconstruire vos prompts, votre caching, ou vos règles d'escalade vous-même.

Vous pouvez essayer eesel gratuitement sur une partie de votre file d'attente, ou le comparer à l'utilisation directe de ChatGPT si vous hésitez encore à le construire vous-même.
Questions fréquentes
Qu'est-ce que GPT-6.2 Sol ?
gpt-6.2-sol, et la liste des modèles OpenAI montre où il se situe dans la gamme.
Comment accéder à GPT-6.2 Sol ?
gpt-6.2-sol. Les utilisateurs Enterprise et Edu y ont accès une fois qu'un administrateur de l'espace de travail l'active. OpenAI amène aussi Ultrafast aux abonnés Pro 200 pour la première fois, en commençant par Sol. Le tool calling sur l'API nécessite la Responses API.