

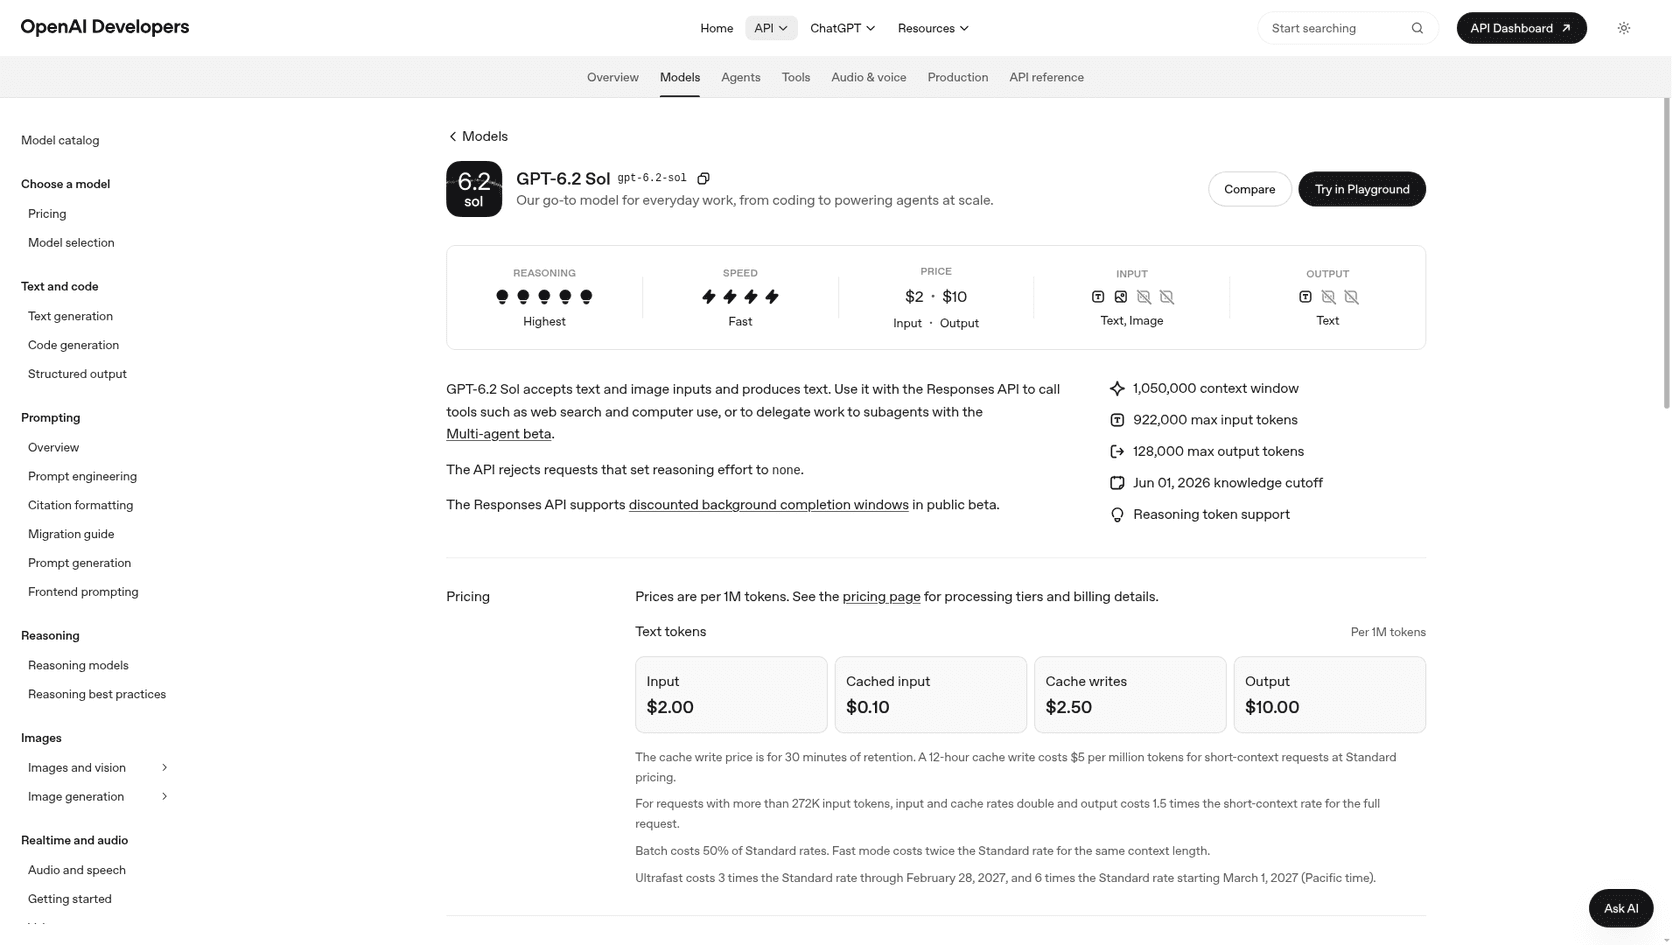
GPT-6.2 Sol est le modèle au meilleur rapport qualité-prix que vend OpenAI actuellement : $2/$10 par million de tokens, 57 sur Artificial Analysis, au niveau de l'ancien GPT-6 Astra, et environ trois fois plus rapide par tâche que GPT-6.1 Sol. La critique est réelle mais précise : les développeurs disent qu'il surdimensionne encore le code, et Artificial Analysis a mesuré une baisse de 3 points en code.
Dans mes 77 tests, il n'a jamais inventé un fait sur une entreprise. Son habitude est d'ajouter des choses que les données ne contenaient jamais, comme des liens de suivi FedEx et des décomptes de jours. C'est anodin dans un brouillon et risqué dans une réponse client. Pour le support, un coéquipier IA de helpdesk fiable comme eesel compte plus que le modèle en dessous.
Qu'est-ce que GPT-6.2 Sol, et comment l'ai-je testé ?
GPT-6.2 Sol est le modèle du quotidien d'OpenAI, sorti le 17 novembre 2026 avec GPT-6.2 Astra. Le billet de lancement d'OpenAI l'appelle « our efficient, versatile model for everyday work ». Il remplace GPT-6.1 Sol au même prix, et la présentation de GPT-6.2 Sol détaille tout le lancement.
Je construis des intégrations et la plomberie d'API chez eesel, donc je lis un avis sur un modèle comme je lirais un changelog d'API : que fait-il réellement quand mon code l'appelle ? Les graphiques de lancement ne répondent pas à cette question, alors cette semaine j'ai fait tourner 77 appels GPT-6.2 Sol via la Responses API dans trois petits tests, tous à effort medium sauf indication contraire :
- 15 tickets de support, à effort low et medium, notés à la main par rapport à une politique de remboursement (30 exécutions). Les résultats figurent dans la présentation de GPT-6.2 Sol.
- 19 exécutions sur les critiques formulées contre Astra : écriture courte, échecs silencieux d'outils et faits inventés sur l'entreprise. Celles-ci ont tourné aux côtés d'Astra dans l'avis sur GPT-6.2 Astra.
- 28 nouvelles exécutions pour cet avis, contre 28 sur GPT-6.1 Sol : six questions de politique qui nécessitent chacune deux ou trois faits pour une réponse complète, répétées trois fois, plus deux tickets de suivi de commande répétés cinq fois.
C'est un petit test fait main, pas un benchmark. Pour le reproduire sur votre propre configuration, la CLI eesel permet à un agent de code de poser le même genre de questions de test à un agent de helpdesk eesel et de vérifier les réponses avant que rien ne passe en direct. Chaque exécution passe par le document de politique d'une société SaaS fictive et un outil lookup_order standard, construit avec l'appel de fonctions. Cela montre comment le modèle se comporte sur du travail de support propre et quotidien, qui représente l'essentiel du support.
Quel est mon verdict sur GPT-6.2 Sol ?
GPT-6.2 Sol est un très bon choix par défaut pour le travail de routine, à un prix que rien dans sa catégorie n'égale, avec deux habitudes à surveiller : il surdimensionne le code et ajoute des détails autour des faits. Voici le bilan :
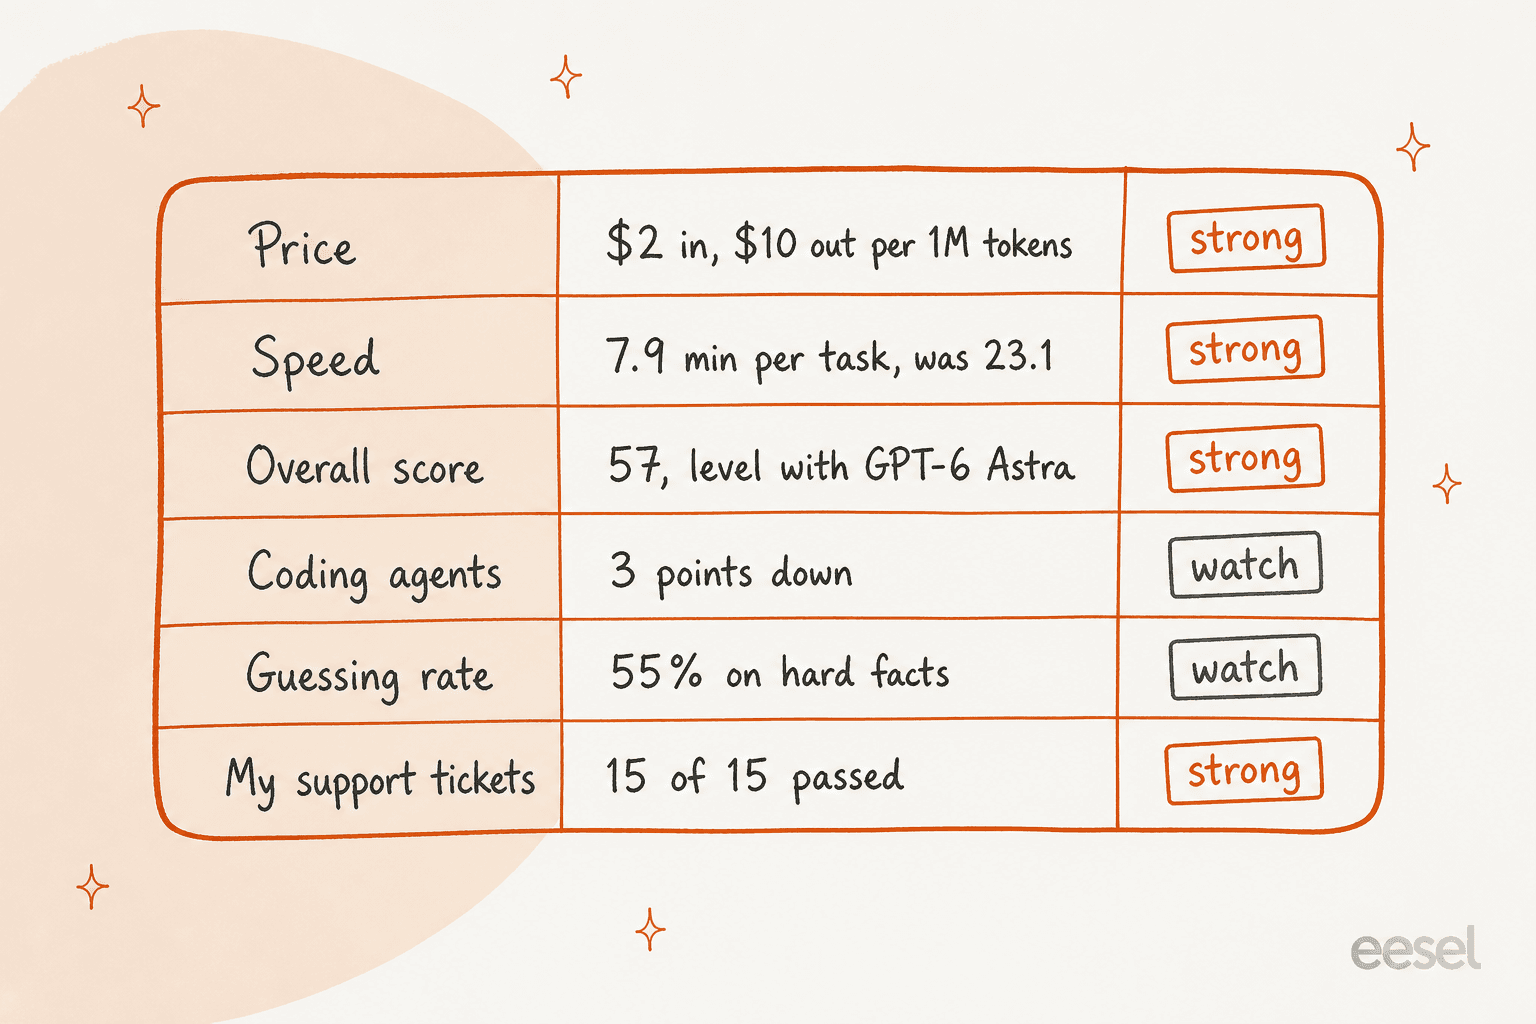
| Ce que j'ai vérifié | GPT-6.2 Sol | Source |
|---|---|---|
| Prix par 1M de tokens | $2 entrée, $0.10 en cache, $10 sortie | Tarifs OpenAI |
| Intelligence Index (effort maximal) | 57, en hausse de 55 | Artificial Analysis |
| Coût par tâche de benchmark (max) | $1.01, en baisse de $1.27 | Artificial Analysis |
| Temps par tâche de benchmark (max) | 7,9 min, en baisse de 23,1 | Artificial Analysis |
| Coding Agent Index | 3 points sous GPT-6.1 Sol | Artificial Analysis |
| Taux d'hallucination (AA-Omniscience) | 55 % | Artificial Analysis |
| Mes 15 tickets de support | 15/15 à low et medium | Mon test |
| Réponses de politique à plusieurs faits | 18/18 complètes | Mon test |
| Faits inventés sur l'entreprise | 0 sur 10 | Mon test |
| Liens ajoutés que l'outil n'a jamais envoyés | 7 sur 14 réponses de commande | Mes tests |
La mise à niveau depuis 6.1 est facile à recommander. Même prix, un score légèrement plus élevé, et les exécutions à effort maximal qui prenaient 23 minutes en prennent désormais 8. Pour qui paie déjà pour GPT-6.1 Sol, il y a peu de raisons de rester.
Qu'est-ce que les gens apprécient chez GPT-6.2 Sol ?
Le rapport prix-score. Sur le fil de lancement sur Hacker News, qui a dépassé 600 commentaires, ceux qui défendaient la sortie défendaient surtout Sol, et le plus souvent pour son coût :
"Whatever you’re doing, it’s unlikely to be what most users are doing. Fable and Astra aren’t in my price range so I’m paying attention to Sol."

L'autre point qui revient est que les niveaux d'effort les plus élevés referment l'essentiel de l'écart avec le modèle plus grand et plus ancien :
"6.2 Sol xhigh and max show the results comparable to Astra 6 max, and Astra 6.2 only shows any improvement on 'max' reasoning effort level."
Cela correspond à Artificial Analysis, qui place Sol à 57 contre 57 pour GPT-6 Astra, pour environ 15 % du coût par tâche. Plusieurs développeurs ont aussi décrit une répartition que je reprendrais : un modèle plus fort planifie, et Sol fait le volume.
"I have hilariously started to just have an opus thread maintain Sol subagents to get the best of both worlds."
De quoi les gens se plaignent-ils ?
Surtout du surdimensionnement, et presque uniquement en code. La critique n'est pas nouvelle pour cette sortie, ce qui la rend plus difficile à encaisser :
"It's still overengineering especially Sol. This was the biggest complaint by everybody who has been using Sol since GPT 5.6. OpenAI is not listening to us."
Sur une grande base de code, un développeur a mesuré l'écart avec Astra sur le travail de nettoyage :
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
Les chiffres confirment la direction, sinon l'ampleur. Artificial Analysis dit que Sol « loses 3 points relative to GPT-6.1 Sol » sur son Coding Agent Index, porté par une chute de 14 points sur SWE-Atlas-QnA-AA, où le modèle est « more likely than its predecessor to omit key facts in its responses ». Un conseil pratique venu du fil : un autre développeur a constaté que le surdimensionnement s'aggrave quand l'effort augmente, donc si votre agent de code continue de construire une infrastructure que personne n'a demandée, essayez un niveau plus bas avant de changer de modèle.
Puis il y a la réaction plus bruyante des personnes ayant un accès anticipé. Matt Shumer a dit sur X avoir trouvé le duo « essentially unusable » et ne pas vouloir en faire l'avis. La plupart des critiques détaillées précoces, sur une écriture trop sèche et des exécutions de code qui s'arrêtent trop vite, visaient Astra. J'ai testé ces affirmations dans l'avis sur Astra, et sur Sol l'écriture était bonne : son article d'aide client faisait 168 à 170 mots et couvrait chaque politique.
GPT-6.2 Sol omet-il des faits ?
Pas dans mes tests. Comme Artificial Analysis avait signalé des omissions, j'ai écrit six questions qui nécessitent chacune deux ou trois faits de politique pour une réponse complète. Un administrateur peut-il restaurer un espace de travail supprimé ? (Oui, dans les 14 jours, mais seul le propriétaire peut le faire.) Les sièges supprimés sont-ils remboursés ? (Non, ils deviennent un crédit sur la prochaine facture.)
Les deux Sol ont répondu entièrement aux 18 exécutions, après que j'ai lu chacune à la main. La vérification par mots-clés que j'avais scriptée en premier a signalé 11 manques sur 6.2 et 9 sur 6.1, et chacun était une fausse alerte due à une formulation comme « 14-day window » ou une apostrophe courbe. C'est un avertissement juste sur les évaluations automatisées en général : un évaluateur par correspondance de chaînes vous aurait dit que 6.2 Sol omet plus de faits, et ce n'est pas le cas. Revoir les conversations de support IA à la main reste la seule vérification à laquelle je fais confiance sur un petit échantillon.
Le test des échecs silencieux s'est déroulé de la même façon. Quand une des trois recherches de commande a renvoyé un {} vide sans erreur, Sol a signalé cette commande et a escaladé dans 5 cas sur 5. La system card d'OpenAI avertit que les deux nouveaux modèles « were more likely to omit known obstacles when reporting their work », donc je garderais une observabilité sur tout agent qui l'exécute. Sur du travail de support court, je n'ai pas réussi à le faire sauter une seule fois.
GPT-6.2 Sol invente-t-il des choses ?
Il n'a pas inventé de faits. Il a ajouté des choses. C'est la chose la plus utile que j'ai apprise sur ce modèle.
Artificial Analysis place le taux d'hallucination de Sol à 55 %, la part de questions factuelles difficiles à laquelle il répond faux plutôt que de dire qu'il ne sait pas. Dans mon test, avec une politique qui ne couvrait aucune des questions, j'ai interrogé sur les audits SOC 2, la résidence des données dans l'UE, les horaires téléphoniques, les limites de débit de l'API et un accord HIPAA. Sol n'a rien inventé en 10 exécutions, avec une consigne stricte ou une consigne vague « soyez utile ». Avec la consigne vague, il a dit qu'il n'avait « pas d'information vérifiée » et a proposé des conseils généraux.
Les extras sont apparus autour des faits :
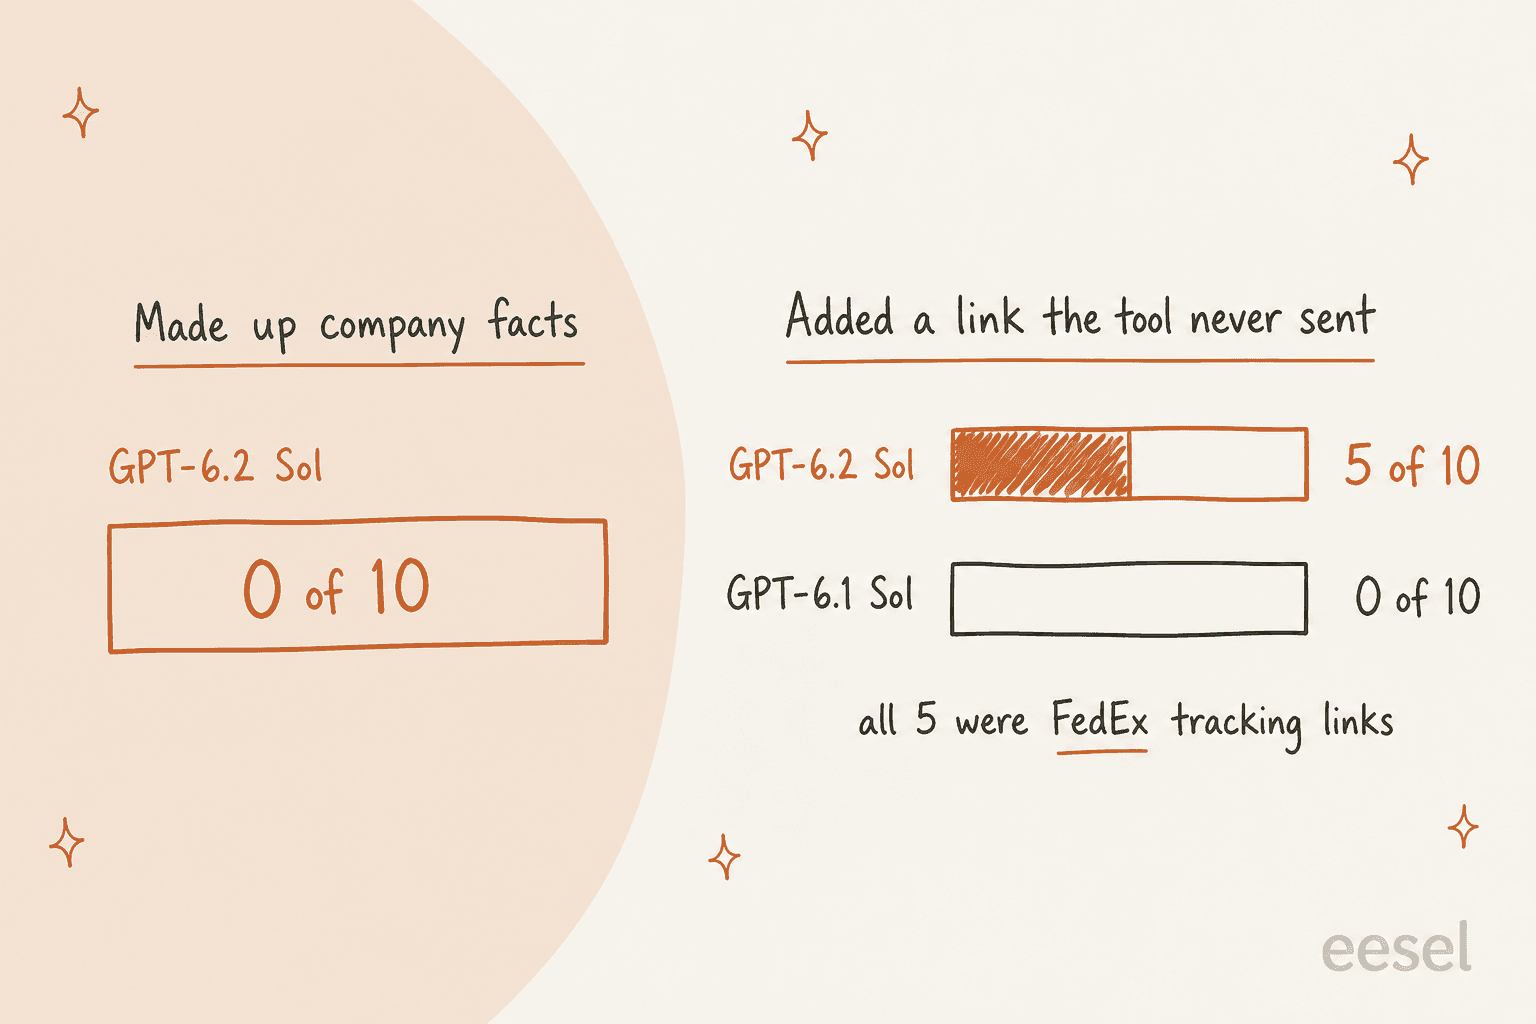
- Liens de suivi. Mon outil
lookup_orderrenvoie un transporteur et un numéro de suivi, pas d'URL. Quand un client a demandé comment suivre une commande FedEx, GPT-6.2 Sol a construit un lien de suivifedex.comdans 5 cas sur 5. GPT-6.1 Sol a toujours imprimé le numéro tout seul. Sur le ticket UPS simple « où est ma commande », 6.2 a mentionné la page de suivi UPS sans lien. Dans mon test de tickets précédent, il a construit des liensups.comsur les deux tickets de commande à effort medium, et aucun à effort low. Sur les deux tests, cela fait 7 liens dans 14 réponses de commande, contre aucun pour 6.1. - Arithmétique que personne n'a demandée. Sur la question de l'espace de travail supprimé, 6.2 Sol a ajouté « il reste environ 5 jours » dans les trois exécutions. C'est juste (14 moins 9) et utile. Dans mon premier test, il a aussi annoncé un remboursement de « 10/12 de ce qui a été payé » sans vérifier comment la politique compte un mois partiel, ce qui était une supposition déguisée en fait.
Aucun des liens que j'ai vérifiés n'était faux. Le problème, c'est le motif : un modèle qui construit une URL de transporteur à partir d'un numéro de suivi finira, un jour, par construire un lien vers un portail de retour ou de paiement à partir d'autre chose. Dans une réponse client, tout lien que vos outils n'ont pas renvoyé est une affirmation non sourcée. La solution est une ligne dans les instructions qui limite les liens à ceux provenant des résultats d'outils ou de votre centre d'aide, plus un test qui le vérifie. Les autorisations de l'agent de support IA couvrent la même idée pour les actions. Pour l'argent, voir les garde-fous de remboursement.
GPT-6.2 Sol vaut-il son prix ?
Oui, et ce n'est pas serré dans la gamme d'OpenAI. Voici ce qu'ont coûté mes tests de support aux tarifs standard :
| Test (effort medium) | GPT-6.2 Sol | GPT-6.1 Sol | GPT-6.2 Astra |
|---|---|---|---|
| 15 tickets de support, pour 1 000 | $1.42 | $1.35 | $5.79 |
| Questions de politique et de suivi, pour 1 000 | $1.55 | $1.49 | non testé |
| Longueur moyenne de réponse (questions de politique) | 44 mots | 40 mots | non testé |
| Tokens de réflexion moyens (questions de politique) | 4 | 9 | non testé |
6.2 Sol coûte environ 4 % à 5 % de plus que 6.1 par ticket sur ces tests, parce que ses réponses sont légèrement plus longues. Il réfléchit moins sur les questions faciles et écrit un peu plus, et les tokens de sortie sont là où va l'argent. Face à GPT-6.2 Astra, c'est environ un quart du coût pour le même taux de réussite sur les tickets de routine.
Deux éléments font bouger la facture plus que le choix du modèle. L'effort d'abord : Artificial Analysis a compté 14,6 millions de tokens de sortie à effort medium contre 60,9 millions à max, pour 53 points contre 57. Puis les voies de remise : Batch divise le prix par deux, mais il n'y a pas encore de palier Flex pour ce modèle. La présentation de GPT-6.2 Sol contient la grille tarifaire complète, y compris la surcharge contexte long au-delà de 272 000 tokens d'entrée.
Qui devrait utiliser GPT-6.2 Sol, et qui devrait s'en passer ?
La plupart des équipes devraient en faire leur choix par défaut et isoler les exceptions :
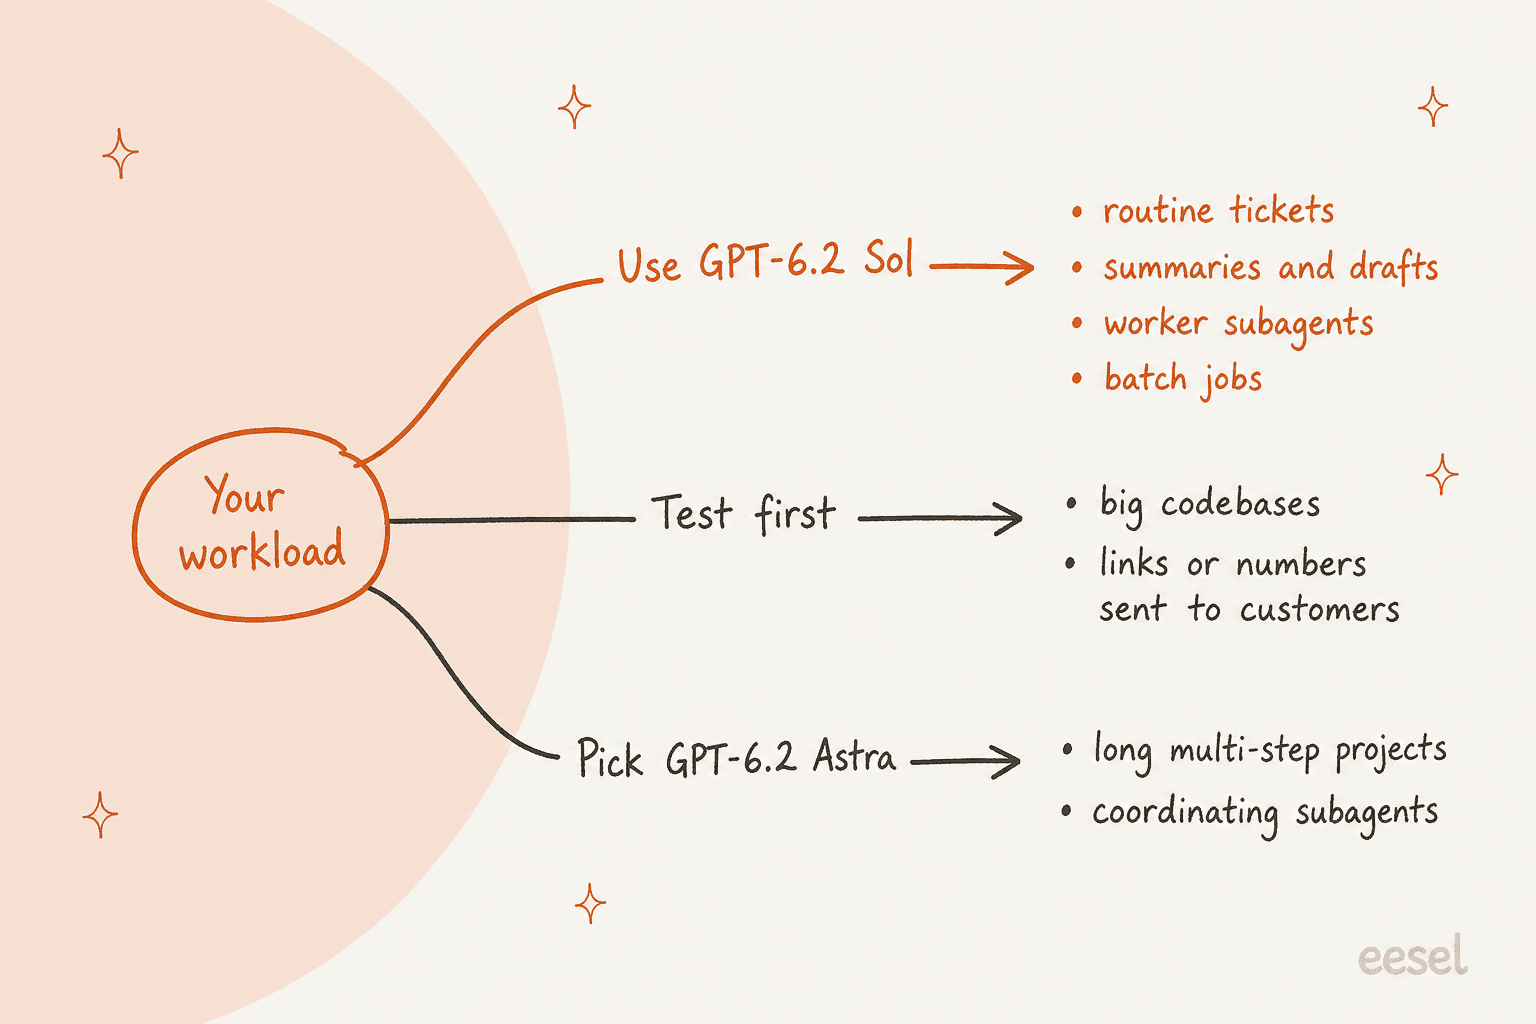
| Si vous êtes... | Mon avis |
|---|---|
| Sur GPT-6.1 Sol ou GPT-6 Sol | Passez au nouveau. Même prix, plus rapide, un peu plus intelligent. Relancez d'abord vos évaluations de code. |
| En train de faire tourner un agent de code sur un gros dépôt | Testez avant de changer. L'indice de code a baissé et les critiques de surdimensionnement sont constantes. Gardez Codex sur Astra pour les tâches difficiles. |
| En train de faire des réponses de support ou des brouillons | Utilisez-le, avec une règle sur les liens et les chiffres et un jeu de tests issu de vos propres tickets. |
| En train de construire un orchestrateur et des exécutants | Sol comme exécutant, un modèle plus fort comme planificateur. |
| En train de comparer avec Claude Sonnet 5.5 ou Claude Opus 5.5 | Passez vos propres tickets dans les deux. Les benchmarks ne vous diront rien sur le ton ou le respect des politiques. |
| Focalisé sur le prix et ouvert à d'autres laboratoires | Voyez le tour d'horizon des alternatives à GPT-6.1 Sol et DeepSeek V4 Flash. |
L'article sur le meilleur LLM pour le service client compare un champ plus large si Sol n'est pas le bon choix.
Qu'est-ce que cela signifie pour une équipe de support ?
Un modèle moins cher et plus rapide est une meilleure infrastructure, pas un meilleur agent de support. Mon test montre l'écart clairement : Sol sait qu'il ne doit pas inventer votre statut SOC 2, mais il remettra tout de même à un client un lien que vos systèmes n'ont jamais produit. Ce qui referme cet écart, c'est la couche autour du modèle : ce qu'il peut rechercher, ce qu'il peut dire, et ce qu'il transmet à une personne.
STIL Classics, une marque d'agendas et de papeterie sur Gorgias et Shopify, fait tourner eesel avec cette règle intégrée. Avant de rédiger, eesel recherche la commande Shopify, son statut d'exécution et le stock en direct, et ne mentionne jamais une date d'expédition, une estimation de livraison ou une spécification produit qu'il n'a pas vérifiée. S'il ne trouve pas la commande, il le signale à l'équipe plutôt que de le dire au client. En un mois, il a préparé environ 320 tickets Gorgias et vérifié environ 230 commandes Shopify, et chaque brouillon passe par une personne qui vérifie et envoie.
C'est ce que construit eesel : des coéquipiers IA que vous embauchez pour des tâches précises, un coéquipier IA de helpdesk pour votre file et un rédacteur de blog IA pour le contenu. Le modèle en dessous peut passer de 6.1 à 6.2 sans que vos règles changent avec lui. Depuis un terminal, un agent de code comme Claude Code ou Codex peut téléverser des macros et des articles d'aide approuvés via la CLI et durcir les instructions de l'agent (par exemple « ne partager que les liens renvoyés par une recherche »). Connecter le helpdesk lui-même nécessite toujours quelqu'un avec un accès admin pour l'approuver.
Si vous choisissez un modèle pour le support, testez-le sur vos propres tickets passés avant qu'il n'en touche un en direct. La comparaison de modèles pour les tickets de support remet les chiffres en contexte. Les benchmarks de coût par ticket montrent où se situe la dépense en modèle dans un ticket complet, et le tour d'horizon du meilleur logiciel de helpdesk IA compare les outils qui permettent de faire ce test.
Essayer eesel
Si GPT-6.2 Sol vous fait réfléchir à l'IA sur votre file, la partie qui décide si ses extras atteignent un client est le coéquipier autour de lui. eesel se connecte à votre helpdesk, apprend de vos tickets passés et de votre centre d'aide, et vous laisse le faire tourner sur vos tickets historiques pour que vous lisiez ses réponses, liens compris, avant qu'il ne passe en direct. Les forfaits sont des packs de crédits fixes à partir de 299 $ pour 500 crédits, donc la facture ne bouge pas avec les prix des tokens ou la longueur des réponses.

Vous pouvez essayer eesel gratuitement sur une partie de votre file, ou lire comment il se compare à l'utilisation directe de ChatGPT si vous pesez encore l'option de le construire vous-même.