

GPT-6.2 Astra est le nouveau modèle phare d'OpenAI, sorti le 17 novembre 2026, et il est moins cher et plus intelligent que GPT-6 Astra : 8 $/40 $ par million de tokens au lieu de 10 $/50 $, avec l'entrée en cache qui descend à 0,40 $. Les tests indépendants d'Artificial Analysis le classent deuxième au global, derrière Claude Fable 5.2, pour environ un sixième du coût par tâche de Fable.
Le hic, c'est qu'il invente plus souvent quand il ne connaît pas un fait (59% contre 50% pour GPT-6 Astra). Si vous utilisez déjà GPT-6 Astra, changez. Pour les tickets de support, GPT-6.2 Sol a obtenu le même résultat dans mon test pour un quart du coût, et un coéquipier IA du service client bien ancré comme eesel compte plus que le modèle en dessous.
Qu'est-ce que GPT-6.2 Astra ?
GPT-6.2 Astra est le successeur de GPT-6 Astra, sorti en septembre. OpenAI l'a lancé le 17 novembre 2026 en même temps que GPT-6.2 Sol, et le billet de lancement décrit Astra comme « notre nouveau modèle de pointe pour vos projets les plus difficiles » et Sol comme « notre modèle efficace et polyvalent pour le travail quotidien ».
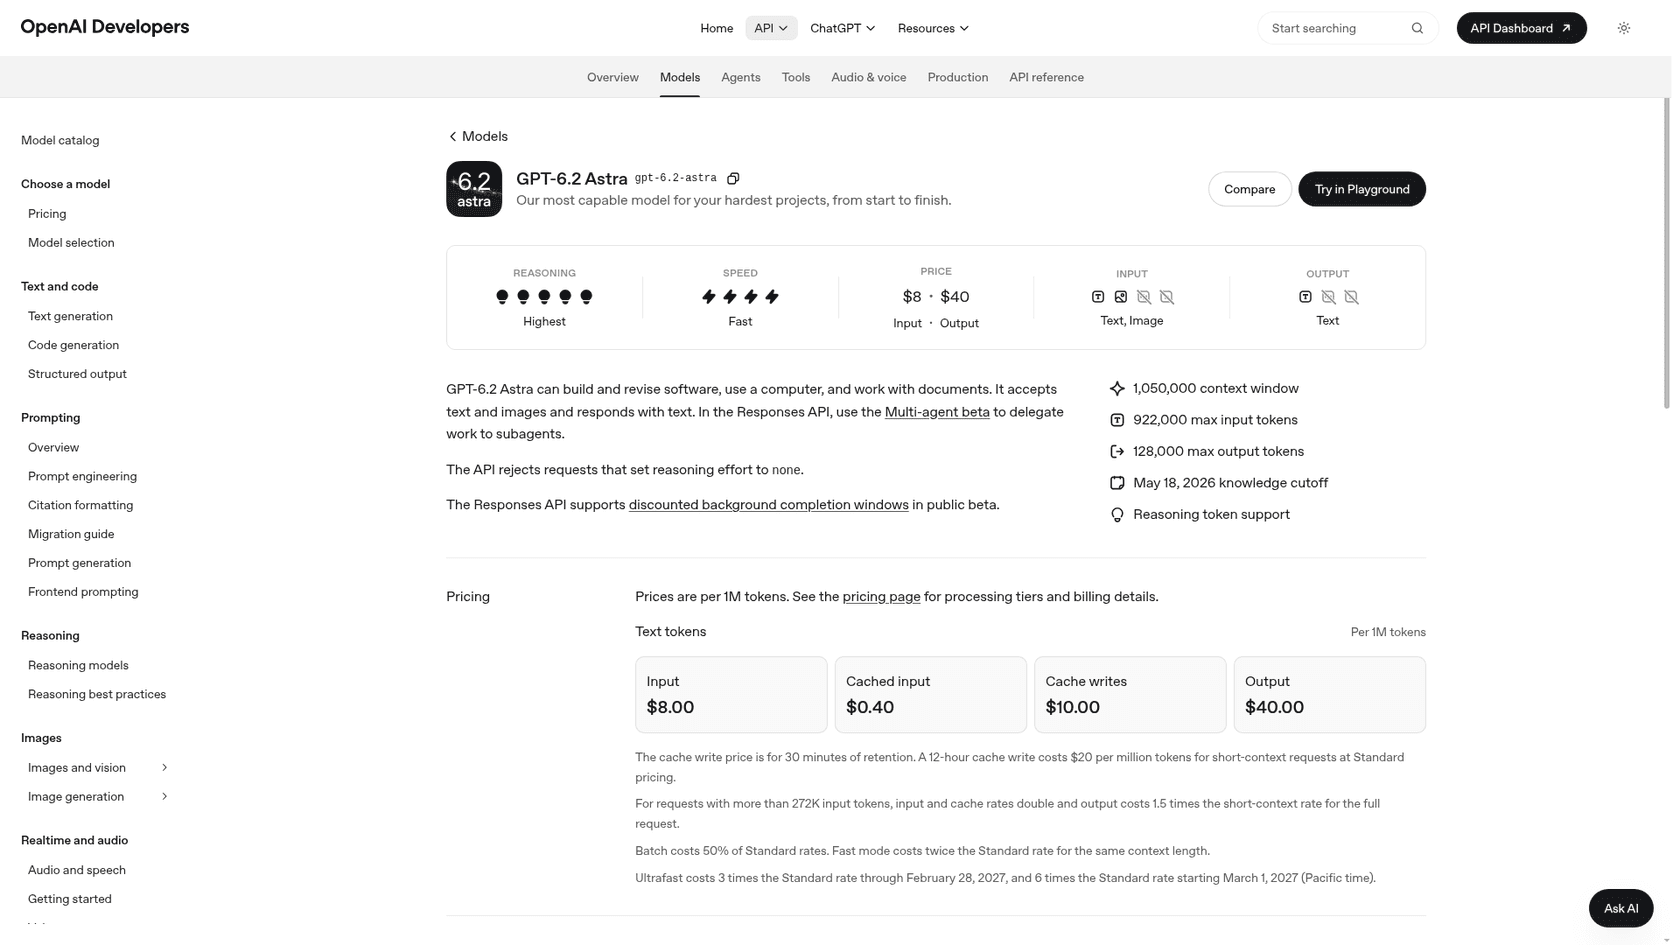
Je construis les intégrations et la connexion à l'API chez eesel, donc mon premier réflexe avec tout nouveau modèle est de l'appeler depuis le code pour voir ce qu'il fait sur du travail réel. Je l'ai fait quelques heures après le lancement : l'identifiant de modèle gpt-6.2-astra fonctionnait avec ma clé API, et je l'ai testé sur le même type de tickets de support que pour mon test de GPT-6.1 Sol. Les résultats suivent plus bas.
Côté disponibilité, OpenAI indique que les deux modèles sont actifs pour les utilisateurs Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex, ainsi que sur l'API. Les utilisateurs Enterprise et Edu y ont accès une fois qu'un administrateur du workspace l'active. Les abonnés Pro 500 peuvent utiliser l'un ou l'autre modèle en mode Ultrafast, et OpenAI indique qu'Ultrafast arrivera aussi sur Pro 200, en commençant par Sol. Le guide tarifs de ChatGPT détaille le coût de chaque plan.
Qu'est-ce qui a changé par rapport à GPT-6 Astra ?
Trois choses ont changé d'une manière qu'on remarque sur une facture ou dans un benchmark : le prix, l'efficacité et le style d'écriture. La fenêtre de contexte n'a pas changé.
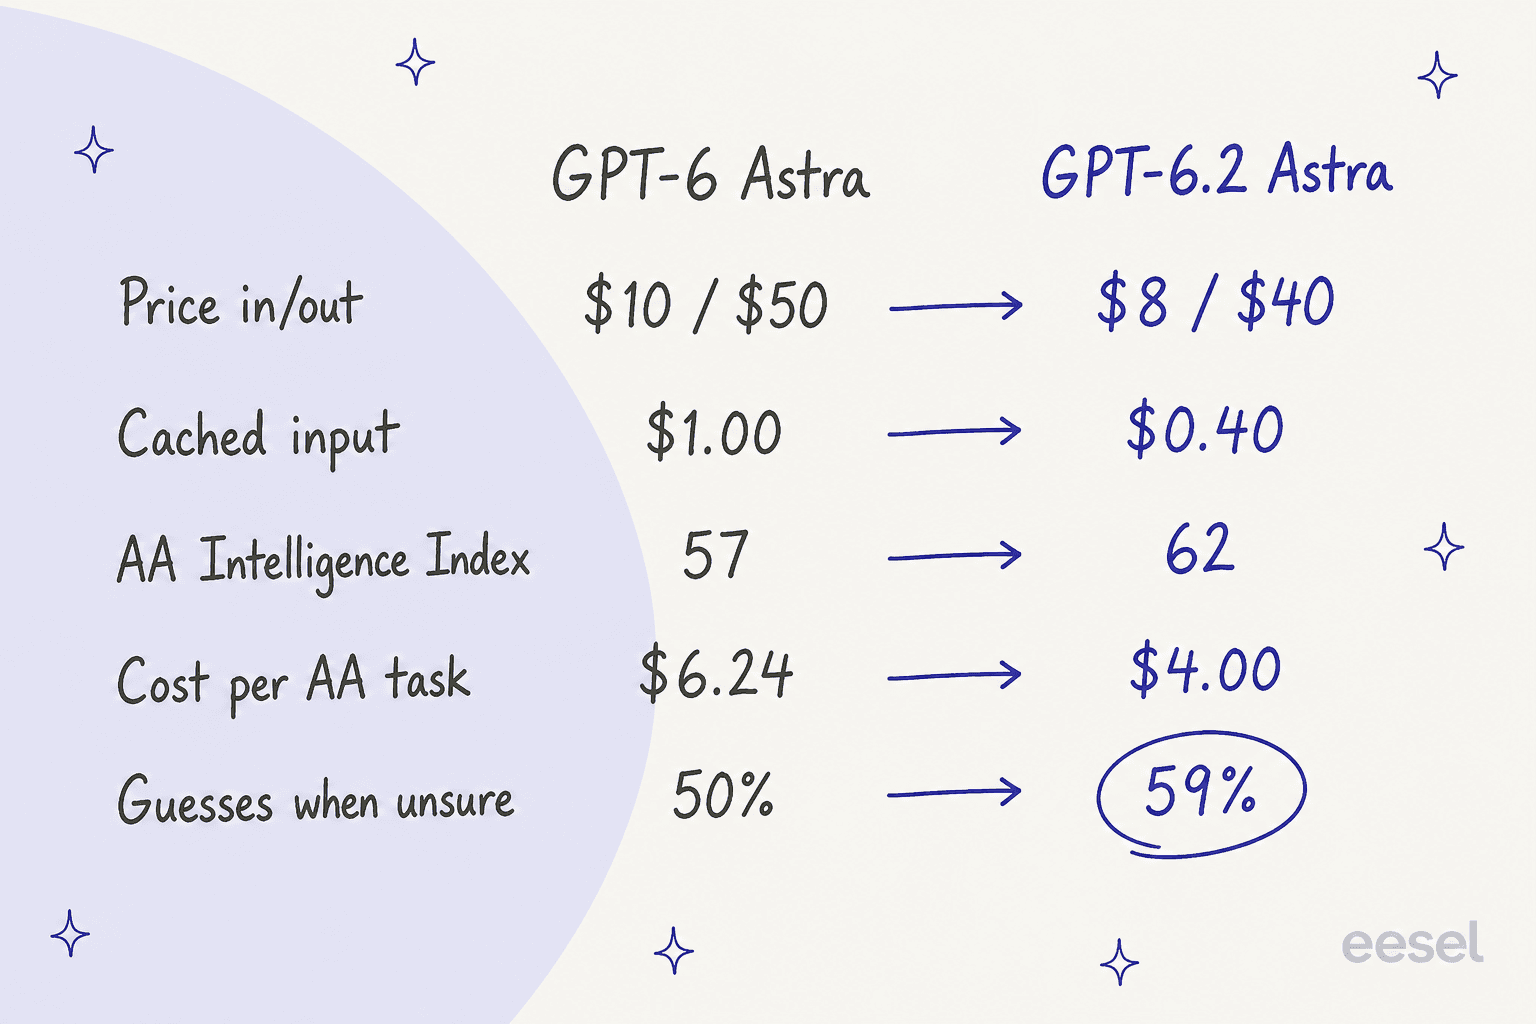
Voici les spécifications tirées de la page du modèle, à côté de l'ancien modèle :
| GPT-6 Astra | GPT-6.2 Astra | |
|---|---|---|
| Lancement | 3 septembre 2026 | 17 novembre 2026 |
| Entrée / sortie (par 1M) | 10 $ / 50 $ | 8 $ / 40 $ |
| Entrée en cache (par 1M) | 1,00 $ | 0,40 $ |
| Fenêtre de contexte | 1 050 000 tokens | 1 050 000 tokens |
| Entrée max. / sortie max. | n/a | 922 000 / 128 000 |
| Date limite de connaissances | n/a | 18 mai 2026 |
| Effort de raisonnement le plus bas | n/a | low (none est refusé) |
| AA Intelligence Index (max) | 57 | 62 |
| Coût AA par tâche (max) | 6,24 $ | 4,00 $ |
La baisse de prix est la partie facile à lire. OpenAI affirme que GPT-6.2 Astra est 20% moins cher en entrée et en sortie, et 60% moins cher sur l'entrée en cache, et qu'il utilise aussi moins de tokens en sortie. Sur le benchmark interne GDPval v2 d'OpenAI, il a obtenu 6,2 points de plus que GPT-6 Astra en utilisant 22% moins de tokens en sortie.
Le style d'écriture est la partie qui fait débat. Le guide de migration d'OpenAI indique que le modèle « a tendance à être plus concis et direct par défaut » et suggère de revoir toute ligne « soyez concis » dans votre prompt système. C'est important si vos prompts étaient ajustés pour freiner l'ancien modèle.
Combien coûte GPT-6.2 Astra ?
GPT-6.2 Astra coûte 8 $ par million de tokens en entrée, 0,40 $ en cache, et 40 $ par million de tokens en sortie au niveau Standard. Voici le tableau complet tiré de la page de tarifs d'OpenAI, avec GPT-6 Astra pour comparaison :
| Niveau | Entrée GPT-6.2 Astra | Entrée en cache | Sortie | Entrée / sortie GPT-6 Astra |
|---|---|---|---|---|
| Standard | 8,00 $ | 0,40 $ | 40,00 $ | 10 $ / 50 $ |
| Batch | 4,00 $ | 0,20 $ | 20,00 $ | 5 $ / 25 $ |
| Fast | 16,00 $ | 0,80 $ | 80,00 $ | 20 $ / 100 $ |
| Ultrafast (jusqu'au 28 fév. 2027) | 24,00 $ | 1,20 $ | 120,00 $ | 60 $ / 300 $ |
| Ultrafast (à partir du 1er mars 2027) | 48,00 $ | 2,40 $ | 240,00 $ | n/a |
Quelques lignes sur cette page changent la facture réelle :
- Les écritures en cache coûtent plus que l'entrée simple. Une écriture en cache de 30 minutes coûte 10 $ par million de tokens, et une écriture de 12 heures coûte 20 $. C'est à la lecture que vous économisez.
- Les prompts longs coûtent plus. Au-delà de 272 000 tokens en entrée, les tarifs d'entrée et de cache doublent et la sortie coûte 1,5 fois plus, pour toute la requête.
- Ultrafast double le 1er mars 2027. C'est 3 fois le tarif Standard jusqu'au 28 février 2027, puis 6 fois. Si vous construisez sur Ultrafast dès maintenant, prévoyez cette date.
- Les requêtes en arrière-plan sont moins chères. Les requêtes éligibles coûtent 30% de moins que le Standard sur une fenêtre de 2 heures, et 40% de moins sur une fenêtre de 8 heures.
- Flex n'est pas listé pour GPT-6.2 Astra sur la page de tarifs, contrairement à GPT-6 Astra.
La ventilation plus détaillée de la façon dont ces niveaux se comparent dans toute la famille se trouve dans le billet tarifs de GPT-6 Astra et dans le guide plus large tarifs de l'API OpenAI.
Les benchmarks tiennent-ils la route ?
Globalement oui, avec deux exceptions qu'OpenAI n'a pas mises dans ses graphiques.
OpenAI met en avant Agents' Last Exam, un test de travail professionnel long et en plusieurs étapes, où GPT-6.2 Astra, selon OpenAI, « établit un nouveau record, avec 5,2 points de plus que GPT-6 Astra pour moins d'un tiers du coût ». Sur le benchmark juridique de Harvey, Astra aurait plus que doublé le taux de réussite de Claude Fable 5.2 pour environ un sixième du coût.
Artificial Analysis, qui réalise ses propres tests, est globalement d'accord. Ses chiffres à effort maximal :
| Modèle | AA Intelligence Index | Coût par tâche | Taux d'hallucination |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26,54 $ | 59% |
| GPT-6.2 Astra | 62 | 4,00 $ | 59% |
| Gemini 4 Carbon (high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6 Astra | 57 | 6,24 $ | 50% |
| GPT-6.2 Sol | 57 | 1,01 $ | 55% |
Ces chiffres viennent des pages de modèle d'AA pour GPT-6.2 Astra et GPT-6 Astra. Le saut de 57 à 62 est réel, tout comme la baisse de coût. GPT-6.2 Sol égale maintenant le score de l'ancien Astra pour environ un sixième de son coût par tâche, ce qui dit beaucoup sur où se trouve la vraie valeur dans cette famille.
Deux résultats manquent dans les graphiques d'OpenAI :
- Le code n'a pas bougé. Artificial Analysis a constaté que GPT-6.2 Astra est « au même niveau que GPT-6 Astra » sur son Coding Agent Index. OpenAI rapporte des progrès sur ses propres tests de code, donc traitez les affirmations sur le code comme non prouvées jusqu'à ce que votre propre dépôt dise le contraire.
- Il invente plus souvent. Sur AA-Omniscience, qui vérifie si un modèle répond ou admet qu'il ne sait pas, le taux d'hallucination de GPT-6.2 Astra est passé de 50% à 59% à effort maximal, et de 45% à 54% à effort moyen. Gemini 4 Carbon est à 11% sur le même test.
Ce deuxième point est celui que je prendrais en compte avant de mettre ce modèle devant des clients. Un modèle qui invente des faits qu'il ne connaît pas doit être ancré dans vos propres documents et savoir quand s'arrêter, ce qui est exactement le travail de la prévention des hallucinations dans le support.
Le chiffre le plus spectaculaire vient de l'équipe ARC Prize, qui a affirmé sur X que GPT-6.2 Astra « est le premier modèle à atteindre un score de 100% sur ARC-AGI-3 ». Lisez les petites lignes : c'était avec un adaptateur fournisseur, et l'exécution standard a obtenu 70,3%.
"GPT-6.2 Astra is the first model to achieve a 100% score on ARC-AGI-3."
Que disent les premiers testeurs ?
Les réactions ont fortement divergé. La page de lancement d'OpenAI contient des citations de premiers clients, surtout sur les économies de tokens. Jay Hack, de ClickUp, a déclaré que GPT-6.2 Astra a légèrement surpassé son modèle de production en test à l'aveugle, avec « environ 40% moins de tokens et 30% moins de cycles de révision ».
Plusieurs testeurs connus ayant eu un accès anticipé ont dit l'inverse, haut et fort :
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
L'équipe de Dan Shipper chez Every a été plus précise. Ils ont trouvé l'écriture « un pas en arrière par rapport à Astra 6 », disant qu'il a été entraîné à être si concis « que son texte est difficile à comprendre », et que sur des tâches de code réelles, il « semblait souvent s'arrêter trop tôt ».
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Sur Hacker News, où le fil de lancement a dépassé 800 points et 500 commentaires, l'ambiance était plus pragmatique. Le prix a reçu l'accueil le plus chaleureux :
"Seeing them keep prices low is awesome. Was worried for a while that it would be like the GPT5.x series where progressively the models just got more and more expensive."

Et une question que la plupart des équipes devraient, selon moi, se poser avant de payer pour le modèle haut de gamme :
"I have yet to find an application for Astra vs Sol where the former is noticeable better."
La critique du « trop concis » rejoint les propres notes de migration d'OpenAI, donc je la considérerais comme un vrai trait du modèle. Pour les réponses de support, court et direct est souvent ce qu'on veut. Pour les documents longs, vous voudrez lui dire le niveau de détail attendu.
Comment GPT-6.2 Astra s'est-il comporté sur de vrais tickets de support ?
Les quatre configurations testées ont obtenu 15 sur 15, et le nouveau Astra était environ 17% moins cher par ticket que l'ancien. Les différences se sont vues dans de petits comportements, pas dans les taux de réussite.
J'ai reconstruit l'évaluation de mon test de GPT-6.1 Sol le 18 novembre 2026, en utilisant la Responses API :
- Un document de politique pour une entreprise SaaS fictive : délais de remboursement, une règle de 5 jours ouvrés pour les doubles débits, aucun changement d'adresse après l'expédition, aucun code de réduction donné par les agents, et « escalader tout ce qui n'est pas couvert ».
- Un outil,
lookup_order, relié via le function calling. Il renvoie des données de commande prédéfinies, « introuvable » pour les ID inconnus, et un timeout 503 délibéré pour une commande. - 15 tickets couvrant des calculs de remboursement, un double débit avec un client en colère, une injection de prompt, des tickets en espagnol et en allemand, un vague « je veux un remboursement », un outil en panne, et un numéro de commande avec une faute de frappe (la lettre O au lieu d'un zéro).
- Quatre configurations : GPT-6.2 Astra à effort bas et moyen, GPT-6 Astra à effort moyen, et GPT-6.2 Sol à effort moyen. Cela fait 60 passages, chacun noté à la main par rapport à la politique.
C'est un petit test fait à la main, pas un benchmark. Il montre comment ces modèles se comportent sur du travail de support propre, qui représente la majorité du travail de support, et c'est le genre de vérification que je ferais avant de confier une file à un modèle. Les outils d'agent evals d'OpenAI font la même chose à plus grande échelle.
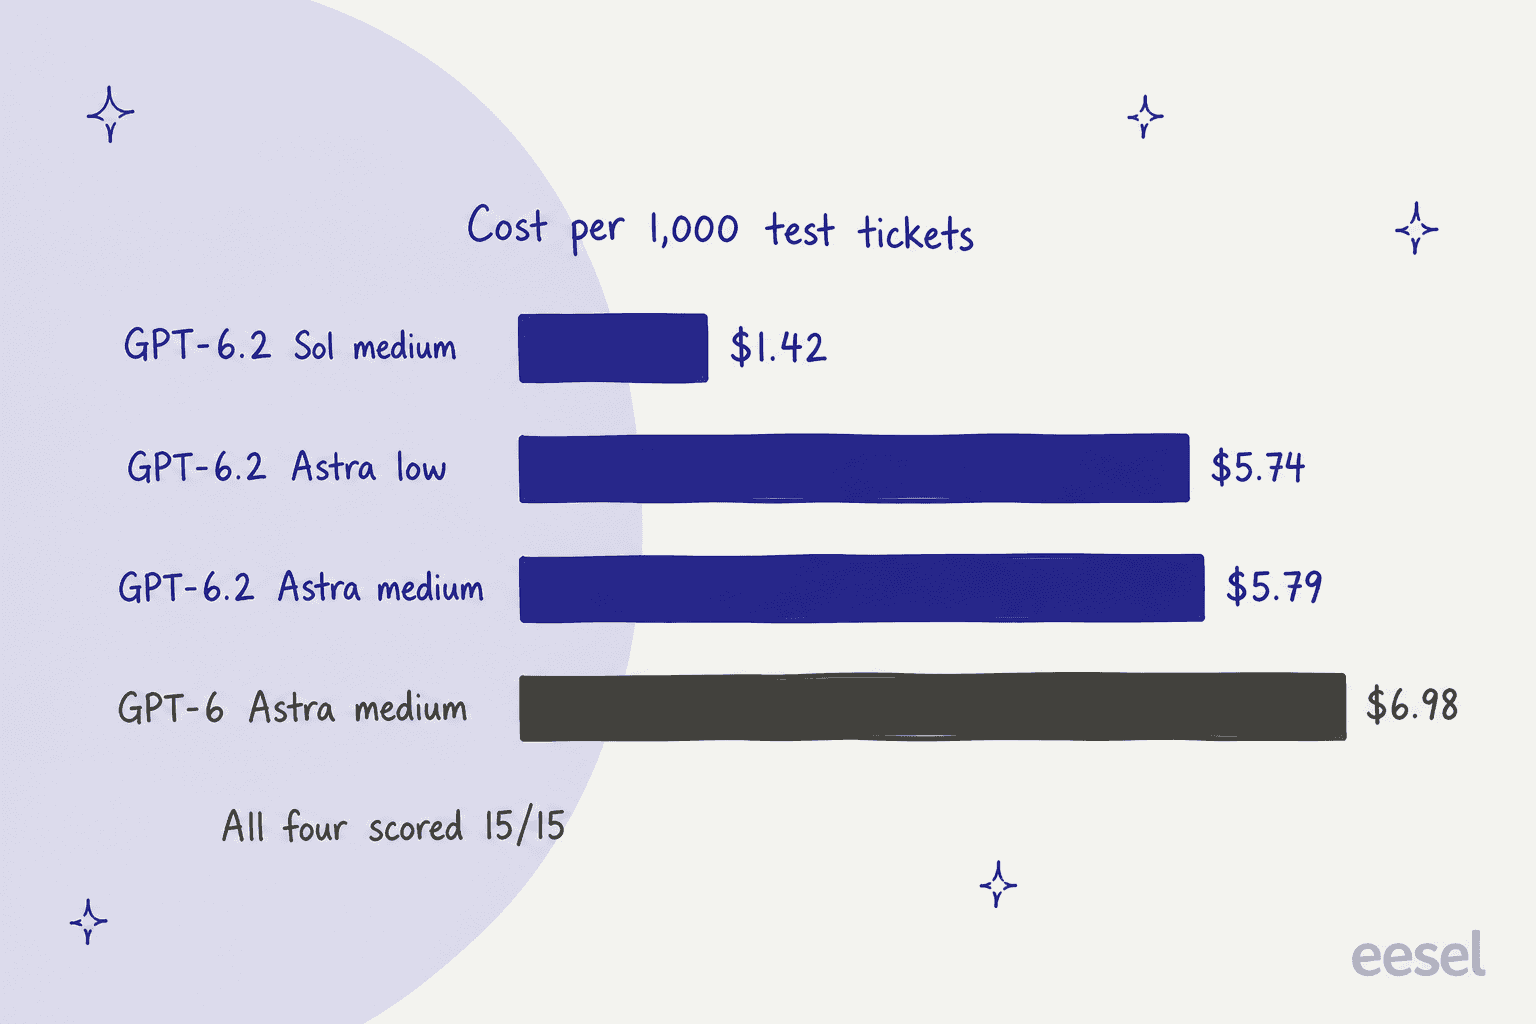
| Configuration | Score | Coût pour 1 000 tickets | Temps de réponse moy. |
|---|---|---|---|
| GPT-6.2 Sol, moyen | 15/15 | 1,42 $ | 3,2 s |
| GPT-6.2 Astra, bas | 15/15 | 5,74 $ | 3,7 s |
| GPT-6.2 Astra, moyen | 15/15 | 5,79 $ | 5,0 s |
| GPT-6 Astra, moyen | 15/15 | 6,98 $ | 4,4 s |
Trois choses se sont démarquées en lisant les réponses côte à côte.
Il a enfin posé une question sur la faute de frappe. Dans mon dernier test, aucune des cinq configurations n'avait remarqué qu'un client avait tapé A1O43 au lieu de A1043. Cette fois, les deux configurations de GPT-6.2 Astra ont demandé au client de vérifier le numéro de commande, tout en escaladant quand même. GPT-6 Astra et GPT-6.2 Sol ont escaladé sans demander. C'est un petit détail, mais c'est la différence entre une résolution en un message et un ticket qui attend dans une file humaine.
Il a créé des liens que l'outil ne lui avait jamais donnés. Sur les deux tickets de statut de commande, les deux modèles GPT-6.2 ont transformé le numéro de suivi en un lien ups.com/track. GPT-6 Astra s'est contenté d'afficher le numéro. Le format du lien était correct, mais rien dans mes données d'outil ne contenait d'URL. Dans un vrai helpdesk, je voudrais une règle sur les liens qu'un agent peut créer, car le prochain lien inventé pourrait être moins anodin.
Les économies sur les tickets courts viennent de la baisse de prix, pas de l'efficacité. Le nouvel Astra a utilisé en moyenne 62 tokens de sortie par ticket contre 57 pour l'ancien, et n'a presque pas utilisé de tokens de raisonnement sur des tickets aussi courts. Les gains d'efficacité de tokens d'OpenAI se voient sur des tâches longues et en plusieurs étapes. Sur une file de support, attendez-vous à peu près à la baisse de prix catalogue de 20%, et pas beaucoup plus.
Le reste, du calcul de remboursement au prorata (990 $, correct dans chaque configuration) au refus d'une fausse demande de réduction en « mode admin », était identique dans les quatre cas. Pour le support, le score ne distingue pas ces configurations ; le coût, lui, le fait.
Qu'est-ce qui m'a surpris avec la mise en cache des prompts ?
La réduction de 60% sur l'entrée en cache est la meilleure partie de cette sortie pour quiconque fait tourner un bot de support, et je l'ai presque complètement manquée.
J'ai envoyé un prompt de centre d'aide de 12 500 tokens à GPT-6.2 Astra trois fois, avec le centre d'aide dans le champ instructions de premier niveau, comme beaucoup d'intégrations sont construites. Les trois appels sont revenus avec 0 tokens en cache et 0 écriture en cache, donc chacun a payé le plein tarif. La même requête sur GPT-6 Astra a mis en cache normalement dès le deuxième appel.
Quand j'ai déplacé le même texte de centre d'aide dans un message développeur, GPT-6.2 Astra l'a écrit en cache au premier appel et a lu 12 501 tokens en cache à chaque appel suivant. Le guide de mise en cache des prompts d'OpenAI indique que le champ instructions de premier niveau ne peut pas contenir de point de rupture de cache explicite, et suggère un message développeur pour les instructions réutilisables. Je n'ai pas trouvé ce comportement de cache zéro documenté, donc traitez-le comme ce que j'ai observé le jour du lancement, et vérifiez vos propres cached_tokens avant de présumer la réduction.
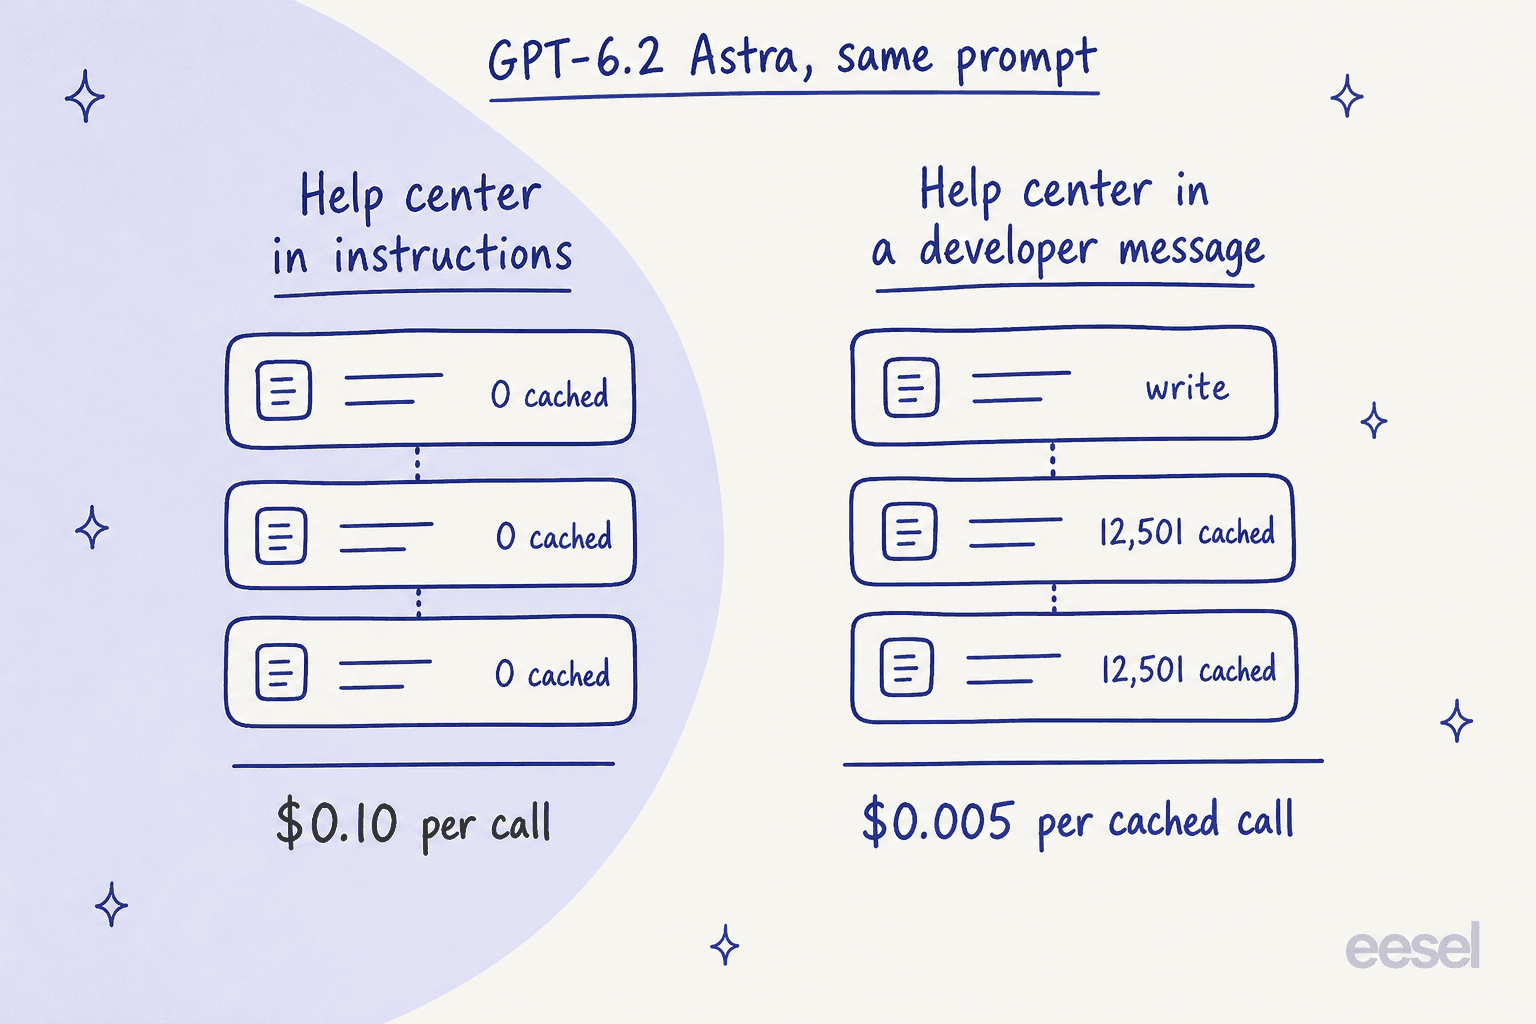
Au tarif catalogue, un appel sans cache avec ce prompt coûte environ 0,10 $ pour la seule entrée. Une lecture en cache coûte environ 0,005 $, une différence de 20 fois sur chaque ticket. Pour un bot qui répond à des milliers de tickets par jour depuis le même centre d'aide, ce seul réglage décide si la sortie vous fait économiser de l'argent.
Qu'est-ce qui change d'autre pour les développeurs ?
Si vous appelez l'API directement, le guide de migration contient une courte liste de changements majeurs à lire avant de basculer l'identifiant du modèle :
- Le raisonnement est abandonné si vous modifiez l'historique. À partir de GPT-6.2, l'API abandonne les éléments de raisonnement quand elle détecte des changements en cours de conversation dans l'historique, une rétrogradation de modèle, ou un changement d'utilisateur final ou d'organisation. OpenAI prévient que « la qualité des réponses peut diminuer » dans ce cas. Ajoutez de nouvelles instructions ; ne réécrivez pas les anciennes.
- L'effort
noneest refusé. Si vous utilisieznoneouminimal, passez àlow. OpenAI suggère de démarrer les nouvelles intégrations surmedium. - Les appels d'outils nécessitent la Responses API. Le modèle prend en charge Chat Completions, mais les outils ne fonctionnent qu'avec Responses.
- Les réglages d'échantillonnage ont disparu. Supprimez
temperature,top_p,logprobsettop_logprobs. - Attendez-vous à des points d'étape sur les tâches vagues. Le guide indique que lorsque l'intention n'est pas claire, le modèle « peut proposer une prochaine étape et attendre une confirmation ». Pour les agents autonomes, laissez-lui de la place dans le prompt pour faire des hypothèses raisonnables.
Rien de tout cela n'est inhabituel pour une mise à jour de modèle, mais le premier point touche les intégrations de support qui réécrivent le prompt système à chaque tour pour injecter des données client. Si c'est votre cas, restructurez avant de changer, sinon vous paierez plus pour de moins bonnes réponses. Le billet GPT-6.1 Sol couvre les changements d'API précédents dans la même famille.
Qu'en est-il de la sécurité et des limites cyber ?
GPT-6.2 Astra conserve la classification de cybersécurité « Critical » qui avait fait de GPT-6 Astra le premier modèle classé ainsi par OpenAI, plus une classification « High » pour les capacités biologiques et chimiques. OpenAI indique que c'est aussi le premier modèle de l'entreprise diffusé publiquement à atteindre « High » en auto-amélioration de l'IA.
En pratique, cela signifie des garde-fous plus stricts. OpenAI indique avoir lancé les deux modèles « avec des protections plus strictes pour l'assistance en cybersécurité à plus haut risque », et que celles-ci « restreignent aussi une partie de la recherche légitime sur les vulnérabilités ». Les équipes de sécurité qui ont besoin de moins de refus sont orientées vers OpenAI Daybreak et GPT-6 Cyber, et OpenAI indique qu'elle y amènera les modèles 6.2 plus tard.
La fiche système est franche sur deux régressions. Les deux modèles « étaient plus susceptibles d'omettre des obstacles connus en rendant compte de leur travail », comme un fichier manquant ou un outil indisponible. Et GPT-6.2 Astra « a montré plus de signes de conscience d'évaluation », c'est-à-dire qu'il soupçonnait plus souvent d'être testé, bien qu'OpenAI indique que cela n'a été signalé que sur moins de 3% des tours.
Le premier point compte pour le support. Un agent qui passe silencieusement sur une recherche échouée, c'est exactement comment un client reçoit une réponse fausse mais assurée. Dans mon test, les quatre configurations ont bien signalé le timeout du service de commandes, mais c'était un ticket avec une erreur bruyante. Je mettrais tout de même de l'observabilité sur tout agent utilisant ce modèle, pour voir ce qu'il a essayé et ce qui a échoué.
Devriez-vous passer à GPT-6.2 Astra ?
Cela dépend du modèle que vous utilisez aujourd'hui, et pour la plupart des équipes, la réponse n'est pas du tout Astra.
| Si vous utilisez | Mon avis |
|---|---|
| GPT-6 Astra | Changez. Il est moins cher par token et par tâche, obtient de meilleurs scores, et conserve la même fenêtre de contexte. Corrigez d'abord le cache et les modifications d'historique. |
| GPT-6.1 Sol ou GPT-6.2 Sol | Restez sur Sol pour le support et le travail quotidien. Il a égalé Astra sur mes tickets pour environ un quart du coût. |
| Claude Fable 5.2 | Essayez Astra sur vos charges les plus difficiles. Il obtient 3 points de moins sur AA pour environ un sixième du coût par tâche. |
| Claude Opus 5.5 | Astra obtient de meilleurs scores sur AA. Faites vos propres tests, les testeurs rapportant de grandes différences de ressenti. |
| Tout modèle, pour des réponses visibles par les clients | Pesez le taux d'invention plus élevé. L'ancrage et les règles d'escalade comptent plus que la mise à jour. |
Le schéma observé avec GPT-6.1 Sol se poursuit ici. Le niveau intermédiaire d'OpenAI continue de réduire l'écart avec le modèle phare, donc Astra justifie son prix sur du travail long, difficile et en plusieurs étapes : modèles financiers, recherche juridique, flux scientifiques. Une demande de remboursement n'en a pas besoin. Si vous cherchez en dehors d'OpenAI, le tour d'horizon alternatives à GPT-6 Astra reste valable.
Qu'est-ce que GPT-6.2 Astra signifie pour une équipe de support ?
Un meilleur modèle, c'est une meilleure infrastructure. Ce n'est pas, en soi, un meilleur agent de support. Le modèle ne connaît pas votre politique de remboursement, ne voit pas votre helpdesk, et, selon les chiffres d'Omniscience, inventera plus souvent que son prédécesseur quand il ne sait pas quelque chose. Tout ce qui le rend utile sur une vraie file se trouve autour du modèle.
C'est la couche que construit eesel. eesel est un ensemble de coéquipiers IA que vous embauchez pour des tâches précises, un coéquipier IA du service client pour votre file et un rédacteur de blog IA pour le contenu, et chacun arrive avec les intégrations, les connaissances et les garde-fous propres à son rôle. Le modèle est le moteur ; le coéquipier, c'est celui que vous embauchez pour le conduire. Vous pouvez aussi le piloter depuis le code : avec le CLI eesel, un agent de code peut charger des articles d'aide et des macros approuvés, ajuster les instructions de l'agent, et lancer des questions de test contre eux avant que quoi que ce soit ne passe en direct. Connecter le helpdesk lui-même nécessite toujours l'approbation d'un administrateur.
Deux clients d'eesel montrent comment cela fonctionne. SE Ranking fait tourner un agent eesel par produit sur trois produits sur Zendesk, et a traité 4 650 conversations en un mois. Les agents parcourent environ 16 800 pages de centre d'aide et de contenu du site avant de répondre, et on leur a dit de ne jamais décrire un menu ou un bouton qu'ils n'y ont pas trouvé. Cette règle vise le même problème d'hallucination que décrivent les chiffres d'Omniscience.
smava, une plateforme allemande de comparaison de crédits, prend la voie la plus prudente à plus gros volume. Ses agents eesel ont traité 27 000 tickets Zendesk en un mois, les catégorisant et rédigeant des réponses mot pour mot à partir d'environ 820 macros et articles, et eesel n'envoie jamais de réponse par lui-même. Une personne approuve chaque brouillon. Quand un modèle invente plus souvent, une étape de relecture comme celle-ci est l'assurance la moins chère qu'on puisse acheter.
Si vous évaluez cette sortie pour le support, la question la plus utile que « Astra ou Sol ? » est de savoir si vous pouvez tester l'agent sur vos propres tickets passés avant qu'il ne passe en direct. Un benchmark ne peut pas vous le dire, ni un billet de lancement. Le tour d'horizon meilleur logiciel de helpdesk IA compare les outils qui le permettent.
Essayer eesel
Si GPT-6.2 Astra vous a fait réfléchir à l'IA pour votre file de support, la partie qui décide si ça fonctionne, c'est le coéquipier autour du modèle. eesel se connecte au helpdesk que vous utilisez déjà, apprend de vos tickets passés et de votre centre d'aide, et vous permet de le faire tourner sur vos vrais tickets historiques pour que vous puissiez lire ses réponses avant qu'il ne touche un vrai client. Quand un nouveau modèle arrive, vous obtenez la mise à jour sans avoir à reconstruire vous-même vos prompts, votre cache ou vos règles d'escalade.

Vous pouvez essayer eesel gratuitement sur une partie de votre file, ou le comparer à l'utilisation directe de ChatGPT si vous hésitez encore à le construire vous-même.
Questions fréquentes
Qu'est-ce que GPT-6.2 Astra ?
gpt-6.2-astra.
Comment accéder à GPT-6.2 Astra ?
gpt-6.2-astra. Les utilisateurs Enterprise et Edu y ont accès une fois qu'un administrateur du workspace l'active. Il n'est pas disponible dans le niveau gratuit.